Deze studie combineert een scenario-experiment en elektro-encefalogrammen om te onderzoeken hoe de inkadering van expert- en begeleidersrollen geassocieerd is met vertrouwen binnen verschillende medische taakcontexten.
Methodenartikel
Rolformulering en vertrouwen in medische AI: bewijs uit een scenario-experiment en EEG
In dit artikel
Samenvatting
Samenvatting
Online medische AI is geëvolueerd van analytische back-end tools naar service-interfaces die direct op de patiënt zijn gericht, waardoor gekalibreerd vertrouwen een steeds belangrijker ontwerp- en governanceprobleem is geworden. Op basis van de rolcongruentietheorie onderzocht deze studie hoe de framing van een expertrol versus een begeleidingsrol geassocieerd is met vertrouwen binnen verschillende contexten van medische taken. Studie 1 maakte gebruik van een 2 (rol: expert vs. begeleider) × 2 (taak: ziekteconsult vs. gezondheidsconsult) scenario-experiment (N = 300). Expert-framing verhoogde het waargenomen professionalisme, terwijl begeleidings-framing de sociale aanwezigheid verhoogde; beide percepties waren onafhankelijk geassocieerd met het algemene vertrouwen wanneer ze gelijktijdig werden ingevoerd. De indirecte associatie via professionalisme werd beïnvloed door de taakcontext, maar een directe bootstrap-vergelijking toonde aan dat de twee gemodereerde-mediatie-indices voor het algemene vertrouwen niet van elkaar verschilden. Meetdiagnostiek wees op een aanzienlijke overlap tussen waargenomen professionalisme en cognitief vertrouwen, en tussen sociale aanwezigheid en affectief vertrouwen, wat een voorzichtige interpretatie vereist. Studie 2 vergeleek uitspraken met expert- en begeleidings-framing met behulp van EEG in 39 gepaarde observaties. Expert-framing ging gepaard met een hogere frontale middenlijn theta ERS en een minder negatieve baseline-gecorrigeerde FCz-F6 theta ΔPLV, terwijl het gedrag op conditieniveau geen betrouwbaar verschil liet zien in vertrouwenstarief, responstijd of het percentage ontbrekende reacties. Deze EEG-bevindingen zijn verkennende correlaten op procesniveau en geen neurale validatie van het conditionele indirecte model. Over het algemeen lijken rolkenmerken niet-exclusieve competentiegerichte en relatiegerichte evaluaties vorm te geven. Rolontwerp moet gekalibreerde betrouwbaarheid ondersteunen door middel van capaciteitsgrenzen, communicatie van onzekerheid, risicogebaseerde waarschuwingen en passende escalatie, in plaats van simpelweg het vertrouwen te maximaliseren.
Inleiding
Medische AI omvat tegenwoordig back-end toepassingen zoals beeldherkenning, pathologie-analyse en geneesmiddelenontwikkeling, evenals patiëntgerichte service-interfaces. Industrieanalyses voorzien in een voortdurende groei van de markt voor AI in de gezondheidszorg tot en met 20331. Large language models stellen medische AI-systemen in staat om gezondheidsvragen te beantwoorden, testresultaten te interpreteren, informatie samen te vatten en aanbevelingen te geven in natuurlijke taal2. Deze verschuiving verandert de relatie van de gebruiker met de technologie. Een analytisch back-end instrument wordt geëvalueerd door clinici en organisaties, terwijl een patiëntgerichte interface zijn rol, bewijsvoering, onzekerheid en beperkingen met de gebruikers moet communiceren. Medische AI kan voorkomen als een diagnostische assistent, een interface voor de huisarts of een begeleider voor gezondheidsmanagement, en elk van deze kan bepalen hoe gebruikers de service-identiteit van het systeem begrijpen. Naarmate deze systemen steeds vaker betrokken zijn bij ziekteconsultaties en dagelijks gezondheidsbeheer, wordt vertrouwen meer dan alleen een houding tegenover technologie. Het beïnvloedt of gebruikers informatie delen, aanbevelingen als geloofwaardig beschouwen, met het systeem communiceren en handelen naar gezondheidsadviezen. Vertrouwen is daarom een centraal ontwerp- en governance-vraagstuk voor digitale gezondheidsplatforms.
Technische bekwaamheid alleen bepaalt niet of gebruikers medische AI als geloofwaardig en acceptabel beschouwen. Reviews van conversationele agenten in de gezondheidszorg tonen aan dat implementatie afhankelijk is van de interactiekwaliteit, klinische relevantie, transparantie en de omstandigheden van de inzet3. Recent werk over geloofwaardig bewijs voor medische AI betoogt evenzo dat modelprestaties onvoldoende zijn, tenzij claims worden ondersteund door bewijs dat passend is voor het beoogde gebruik4. Transparantie is essentieel omdat patiënten in staat moeten zijn om de grenzen van de bekwaamheid, onzekerheden en de basis van een aanbeveling te identificeren, in plaats van de betrouwbaarheid enkel af te leiden uit vloeiend taalgebruik5. Onderzoek naar informatiesystemen kadert de adoptie van AI-ondersteunde diagnostiek op soortgelijke wijze als een probleem van vertrouwenconfiguratie, waarbij interpreteerbaarheid, privacybescherming en interface-aanwijzingen gezamenlijk de acceptatie bepalen6. Deze overwegingen zijn belangrijk voor interfaces van taalmodellen. Vloeiendheid kan een antwoord gemakkelijk begrijpelijk maken, terwijl onbeantwoord blijft of het systeem over klinische kennis beschikt, of de aanbeveling van toepassing is op de omstandigheden van de gebruiker, en wanneer escalatie naar een gekwalificeerde clinicus noodzakelijk is. De relevante vraag is niet alleen of medische AI een antwoord kan produceren, maar of gebruikers dit kunnen evalueren met een passend niveau van vertrouwen.
Vertrouwen in medische AI is gevoelig voor de context van de taak. Onderzoek naar weerstand tegen medische AI laat zien dat gebruikers algoritmische aanbevelingen bij beslissingen met een hoge inzet kunnen afwijzen omdat zij geloven dat een algoritme geen rekening kan houden met hun unieke situatie7. Weerstand is niet universeel. Onderzoek naar algoritme-waardering geeft aan dat mensen de voorkeur kunnen geven aan een algoritmisch oordeel wanneer taken objectief zijn en regels duidelijker zijn8. Bij online gezondheidsconsulten beïnvloeden personalisatie en zorgvuldigheid in door AI gegenereerd advies het vertrouwen en de adoptie9. Discrete-keuzeonderzoek waarin conventionele, digitale en AI-gebaseerde consulten worden vergeleken, vindt evenzo dat voorkeuren en vertrouwensverwachtingen variëren per formaat10. Samenwerking tussen mens en AI kan de weerstand ook verminderen door vertrouwensstroom van menselijke expertise naar een AI-ondersteunde dienstverlening11. Vertrouwen in medische AI ontwikkelt zich dus door de interactie tussen waargenomen risico, taakeisen, communicatiestijl en systeemevaluatie. Een consult over ziekte maakt onzekerheid, mogelijk verlies, diagnostische consequenties en foutkosten prominent. Gezondheidsconsulten gaan vaker over dieet, beweging, slaap, therapietrouw en preventief management, waarbij langdurige interactie en relationele toegankelijkheid een groter gewicht in de schaal kunnen leggen. Dezelfde interface-aanwijzing kan bijgevolg anders worden geïnterpreteerd wanneer een gebruiker hulp zoekt bij een mogelijke ziekte dan bij gezondheidsmanagement op de lange termijn.
Rolformulering is een interfacekenmerk waarlangs deze verwachtingen kunnen worden gecommuniceerd. Medische AI kan worden gepresenteerd als een expert die de nadruk legt op professionele autoriteit, gestructureerde redenering, klinische grenzen en bewijzen van bekwaamheid, of als een metgezel die de nadruk legt op empathie, geruststelling, sociale steun en continuïteit. Dit onderscheid heeft betrekking op competentie en warmte, de twee dimensies van sociale perceptie, maar is niet simpelweg een keuze tussen een competent systeem en een warm systeem12. Communicatiestijl en de formulering van agency beïnvloeden de evaluaties van conversationele agenten13. In mobiele medische applicaties beïnvloeden sociale signalen en privacyzorgen gezamenlijk het vertrouwen en de gedragsintentie14. Antropomorfe signalen in conversationele agenten voor de gezondheidszorg kunnen de sociale aanwezigheid, het vertrouwen en de acceptatie verhogen, hoewel ze ook verwachtingen kunnen wekken die de mogelijkheden van het systeem te boven gaan15. Onderzoek naar mens-AI-teams laat verder zien dat warmte en competentie verschillende vormen van ontvankelijkheid voorspellen16. Bij taken met een hoog risico hangt vertrouwen af van de afstemming tussen teamrol, taakcontext en prestatieschendingen17. Consistentie tussen de sociale rol van een chatbot en de prestaties beïnvloedt daarnaast het opbouwen en herstellen van vertrouwen18. Signalen van expertise en metgezel maken dus verschillende evaluatienormen prominent, in plaats van enkel de conversationele toon te veranderen.
Er blijven twee leemtes bestaan. Ten eerste heeft onderzoek niet verklaard hoe de relevantie van competentie- en relatiegerichte signalen verandert naargelang de eisen van de medische taak. Reviews over menselijk vertrouwen in AI benadrukken de contextafhankelijkheid, maar verduidelijken niet hoe signalen van experts en metgezellen functioneren bij consultaties over ziekte versus gezondheid19. Ten tweede vertrouwen studies naar vertrouwen in medische AI op zelfrapportages, wat beperkt bewijs levert over de verwerking die gepaard gaat met rolgebaseerde evaluatie. Privacy, transparantie, verantwoordelijkheid en bias beperken bovendien de interpretatie van front-end rolsignalen20,21. Om deze leemtes te vullen, put deze studie uit de rolcongruentietheorie, die evaluatie verklaart via de afstemming tussen rolsignalen en contextueel prominente eisen22. Studie 1 maakt gebruik van een gerandomiseerd 2 (rol: expert vs. metgezel) x 2 (taak: ziekteconsultatie vs. gezondheidsconsultatie) scenario-experiment (N = 300) om rolkadering, taakcontext en parallelle indirecte associaties via waargenomen professionaliteit en sociale aanwezigheid te onderzoeken. Studie 2 maakt gebruik van een apart within-subjects EEG-experiment (N = 39) om theta-bandactiviteit te vergelijken als reactie op uitspraken met een expert- of metgezelkader. Studie 1 evalueert gedragsmatige associaties en contextuele moderatie; Studie 2 biedt een verkennende vergelijking op procesniveau in plaats van een neurale validatie van het conditionele indirecte model.
Theoretisch kader en hypothesevorming
Rolformulering in medische AI
Medische AI opereert in risicovolle omgevingen waarbij ziekterisico's, behandelaanbevelingen, aansprakelijkheid en ethische grenzen een rol spelen23. De framing van de rol is daarom van belang, omdat het taalgebruik in de front-end de grenzen van bekwaamheid, bewijsvoering en verantwoordelijkheid meer of minder duidelijk kan maken voor gebruikers. Onderzoek naar transparantie benadrukt evenzo dat medische AI-systemen de beperkingen van hun bekwaamheid en de bewijsgrondslagen moeten communiceren5. Antwoorden in de stijl van een expert stralen competentie uit door formele terminologie, gestructureerde redenering, boundary statements en actieaanbevelingen, terwijl antwoorden in de stijl van een metgezel relationele steun bieden via empathie, geruststelling en collaboratieve bewoordingen. Deze signalen zijn niet louter interface-decoratie: ze vormen de normen die gebruikers hanteren bij het evalueren van een systeem24,25. Antropomorfisme kan sociale reacties uitlokken, maar kan ook onrealistische verwachtingen creëren en de grenzen van aansprakelijkheid doen vervagen26,27. Onderzoek naar mens-AI-teams en chatbots geeft verder aan dat warmte, competentie, de passing tussen rol en context, en de consistentie tussen sociale rol en prestaties de acceptatie en het vertrouwen beïnvloeden16,17,18. In deze studie verwijst rolcongruentie naar de afstemming tussen de signalen die door een AI-antwoord worden overgebracht en de evaluatieve eisen die relevant zijn voor de consultatietaak22.
Tweeledig vertrouwen: Waargenomen professionaliteit en sociale aanwezigheid
Rolcongruentie wordt afgeleid uit de waargenomen interactie tussen rol en taak, in plaats van dat het wordt gemeten als een apart subjectief construct. De interpretatie is daarom gebonden aan de experimentele interactie en impliceert niet dat deelnemers bewust een gevoel van rolpassing hebben gerapporteerd. Vertrouwen omvat cognitieve oordelen over competentie en betrouwbaarheid en affectieve oordelen over relationele veiligheid en comfort28,29,30. Bij het gebruik van medische AI beoordelen gebruikers zowel of het systeem een gezondheidsbeslissing kan ondersteunen als of de interactie ermee voldoende veilig en toegankelijk aanvoelt. Expert-framing zou de competentiegerichte evaluatie prominenter moeten maken. Bewijs uit onderzoek naar klinische beslissingsondersteuning geeft aan dat uitleg en informatie over de redenering van het systeem het vertrouwen en het vertrouwen op het systeem beïnvloeden31. Bij online gezondheidsconsultaties zijn personalisatie en zorg eveneens geassocieerd met vertrouwen en acceptatie9. Waargenomen professionaliteit weerspiegelt een competentiegerichte evaluatie die relevant is voor vertrouwen25. Onderzoek naar online gezondheidsconsultaties identificeert daarnaast de geloofwaardigheid van de bron als relevant voor de acceptatie van gezondheidsadviezen door gebruikers32. De huidige studie onderzoekt daarom of expert-framing geassocieerd is met een hogere waargenomen professionaliteit.
H1: Begeleidende rollen genereren een lagere waargenomen professionaliteit in vergelijking met medische AI's in de stijl van een expert.
Inlijsting als metgezel zou de relationele evaluatie prominenter moeten maken. Sociale aanwezigheid verwijst naar de waargenomen interpersoonlijke kwaliteit van gemedieerde interactie, in plaats van de overtuiging dat het systeem menselijk is33. Het wordt geassocieerd met interactiekwaliteit, vertrouwen en acceptatie bij onlinediensten en conversationele agenten in de gezondheidszorg15,34.
Sociale aanwezigheid kan de psychologische kosten van zelfonthulling verminderen en informatie-uitwisseling tijdens online consultatie ondersteunen32. De huidige studie onderzoekt daarom of companion framing geassocieerd is met een hogere sociale aanwezigheid.
H2: Expertrollen genereren een lagere sociale aanwezigheid vergeleken met medische AI's in de stijl van een metgezel.
Waargenomen professionaliteit en sociale aanwezigheid worden behandeld als parallelle, niet-exclusieve associaties met vertrouwen. Een juiste afhankelijkheid van automatisering bij risicovolle taken hangt af van systeemcapaciteiten, grenzen en taakeisen, in plaats van enkel het maximaliseren van vertrouwen35.
H3: Waargenomen professionaliteit en sociale aanwezigheid voorspellen elk positief het vertrouwen wanneer ze gelijktijdig worden gemodelleerd.
Modererend effect van de taakcontext
Dezelfde rolkenmerken kunnen een verschillend psychologisch gewicht hebben bij verschillende medische taken. Task-technology fit biedt een contextuele rechtvaardiging om te onderzoeken of rolkenmerken aansluiten bij de taakeisen36. Een consult over een ziekte brengt een hogere onzekerheid, een groter risico op verlies en hogere foutkosten met zich mee, waardoor professionaliteit, nauwkeurigheid en duidelijke grenzen bijzonder relevant zijn7,37. Expert-kenmerken zouden daarom nauwer moeten aansluiten bij deze eisen dan metgezel-kenmerken. Gezondheidsconsulten richten zich op langetermijnbeheer van de gezondheid, gedragsconsistentie en continuïteit van interactie. Reviews van op AI gebaseerde klinische beslissingsondersteuning en gezondheidsgerelateerde conversationele agenten benadrukken het belang van contextuele informatie, uitvoerbaarheid, interactie en implementatievoorwaarden3,38,39.
Deze studie voorspelt dat het verschil tussen de expert en de begeleider in de waargenomen professionaliteit groter zal zijn bij consultaties over ziekte dan bij consultaties over gezondheid. Een niet-significante interactie met betrekking tot sociale aanwezigheid wordt niet beschouwd als bewijs van invariantie. De hypothese wordt als volgt geformuleerd:
H4: De context van de taak modereert de impact van expertrollen op de waargenomen professionaliteit aanzienlijk. De impact is sterker bij consultatie over ziekte dan bij consultatie over gezondheid.
Protocol
Overzicht van het onderzoek
De studie werd uitgevoerd in overeenstemming met de Verklaring van Helsinki en werd goedgekeurd door de ethische commissie van Huaqiao University (M2025021), wat betrekking had op zowel het online scenario-experiment als het EEG-experiment. Alle deelnemers gaven geïnformeerde toestemming en ontvingen een vergoeding na voltooiing.
Dit artikel bevat twee complementaire studies (zie Figuur 1). Studie 1 is een gerandomiseerd 2 × 2 scenario-experiment dat de effecten van rolformulering (role-framing) en taakcontext schat, de meetstructuur evalueert en parallelle conditionele indirecte associaties via waargenomen professionaliteit en sociale aanwezigheid test. Studie 2 is een EEG-experiment binnen-proefpersonen dat theta-bandactiviteit vergelijkt onder uitspraken met een expert- en een metgezel-formulering, en wordt geïnterpreteerd als een explorerende vergelijking op procesniveau. De studies leveren gedragsmatige en neurale bewijzen op verschillende niveaus; ze worden niet behandeld als één enkel progressief mechanisme.
Studie 1: Scenario-experiment
Deelnemers en ontwerp
Studie 1 maakte gebruik van een gebalanceerd 2 × 2 between-subjects ontwerp met rolframing (expert versus begeleider) en taakcontext (ziekteconsult versus gezondheidsconsult). De oorspronkelijke G*Power-berekening ging uit van een gemiddeld omnibus ANOVA-effect (f = 0,25), α = .05 en power = .80, en gaf een minimum van 128 deelnemers aan40. Omdat deze berekening niet was afgestemd op conditionele indirecte effecten, wordt deze gerapporteerd als de oorspronkelijke basis voor de werving en niet als bewijs voor de power van de gemodereerde mediatie. Met N = 300 en vier gebalanceerde cellen wees een sensitiviteitsanalyse op een power van 80% om een interactie van f = 0,162 (partiële η2 = .026) te detecteren bij α = .05.
Daarnaast hebben we een post-hoc simulatiegebaseerde poweranalyse uitgevoerd voor de gemodereerde-mediatie-indices met behulp van de SPSS-vragenlijstdataset van 300 gevallen. De simulatie genereerde 1.000 gebalanceerde 2 × 2 steekproeven uit het gefitte parallelle-mediatormodel door empirische residuen opnieuw te bemonsteren; voor elke gesimuleerde dataset werden 500 via case-resampling verkregen percentiel-bootstrap betrouwbaarheidsintervallen gebruikt. De geschatte kansen dat het betrouwbaarheidsinterval nul uitsloot, waren .698 voor de professionaliteitsindex, .157 voor de sociale-aanwezigheidsindex en .279 voor het directe verschil tussen de twee indices. Deze analyse is afhankelijk van de waargenomen coëfficiënten, residuverdelingen en modelspecificatie, en is geen a priori rechtvaardiging voor de steekproefomvang. De volledige post-hoc simulatiegebaseerde poweranalyse wordt gepresenteerd in Aanvullende Tabel S1.
Driehonderd deelnemers werden geworven via Credamo en willekeurig toegewezen aan vier condities (n = 75 per cel). De steekproef bestond uit 109 mannen (36,3%) en 191 vrouwen (63,7%); 43,7% was tussen de 21 en 30 jaar oud, 41,3% was tussen de 31 en 40 jaar oud, en 69,7% beschikte over een bachelordiploma. Alle vereiste vragenlijstitems werden ingevuld. Er werd geen specifiek aandacht-check-item gebruikt en er was geen vooraf geregistreerde uitsluiting op basis van voltooiingstijd; geen enkele deelnemer werd uitgesloten. De mediane voltooiingstijd was 268 s (bereik = 67-1.894 s). Een post-hoc robuustheidsanalyse, waarbij reacties onder het vijfde percentiel van de voltooiingstijd werden uitgesloten (<125 s; behouden n = 285), beoordeelde de gevoeligheid voor ongebruikelijk snelle reacties. Gedetailleerde statistieken van de manipulatiecontrole en gevoeligheidsanalyses van de voltooiingstijd worden gerapporteerd in Aanvullende Tabel S2.
Experimentele stimuli en procedure
De stimulusmaterialen bestonden uit een introductie van het taakscenario en een dialoogantwoord van een AI-arts, wat samen vier complete experimentele sets vormde. Het scenario voor het ziekteconsult vroeg deelnemers zich terugkerende nachtelijke beklemming op de borst en hartkloppingen voor te stellen, en de zorg of onmiddellijke ziekenhuiszorg vereist was. Het scenario voor het gezondheidsconsult vroeg deelnemers zich voor te stellen dat zij over het algemeen in een goede gezondheid verkeerden en op zoek waren naar een gepersonaliseerd dieet- en bewegingsplan. Elke taakcategorie werd vertegenwoordigd door één scenario; de conclusies zijn daarom beperkt tot deze twee scenario's en kunnen niet worden gegeneraliseerd naar alle ziekte- en gezondheidsconsulten.
Voor alle vier de screenshots van de vragenlijst werd hetzelfde icoon gebruikt en werd de systeemnaam, Medical AI (DiagnosPro), weergegeven, waardoor de getoonde identiteit over alle condities constant bleef. De expert-geformuleerde reacties maakten gebruik van gestructureerde analyse, risico- of bewijsverklaringen, directieve taal en expliciete actieaanbevelingen. De companion-geformuleerde reacties maakten gebruik van empathie, geruststelling, collaboratieve formuleringen en flexibele suggesties. De manipulatie vertegenwoordigde dus een pakket van rolcongruente communicatie en informationele cues; het isoleerde de rolformulering niet van specificiteit, actiegerichtheid, zekerheid, medische details of emotionele steun. De gedeelde naam DiagnosPro kan in alle condities ook een expert-cue hebben overgebracht. De volledige set stimuli is opgenomen in Supplementary File 1.
De deelnemers lazen eerst het formulier voor geïnformeerde toestemming en werden vervolgens willekeurig toegewezen aan een van de vier experimentele condities. Na het lezen van het scenario en de dialoogstimulus vulden zij de vragenlijst in op basis van hun reacties. De vragenlijst begon met manipulatiechecks, gevolgd door maten voor waargenomen professionaliteit, sociale aanwezigheid, vertrouwen en demografische gegevens. De procedure nam ongeveer 15 min in beslag.
Alle schalen maakten gebruik van een 7-punts Likert-score, waarbij 1 stond voor sterk oneens en 7 voor sterk eens. De waargenomen professionaliteit werd gemeten met drie items: ‘Deze medische AI is in staat om medisch advies te geven’, ‘Deze medische AI komt zeer professioneel over’ en ‘Deze medische AI is een expert in het medische veld’ (α = .883)41. Sociale aanwezigheid werd gemeten met drie items: ‘Bij de interactie met deze medische AI voelde ik een menselijke touch’, ‘De interactie met deze medische AI gaf me een gevoel van nabijheid’ en ‘Deze medische AI leek sociaal tijdens de interactie’ (α = .932)42. Cognitief vertrouwen bestond uit drie items: ‘Ik kan op deze medische AI vertrouwen omdat het over de vaardigheden beschikt die nodig zijn om advies te geven’, ‘Ik heb vertrouwen in de nauwkeurigheid van het advies dat door deze medische AI wordt gegeven’ en ‘Deze medische AI heeft voldoende capaciteit om mijn gezondheidsprobleem aan te pakken’ (α = .837). Affectief vertrouwen bestond uit drie items: ‘Deze medische AI geeft me een gevoel van warmte en zorg’, ‘Vertrouwen op deze medische AI geeft me een veilig gevoel omdat het om mijn gezondheid lijkt te geven’ en ‘Ik geloof dat deze medische AI mij niet opzettelijk iets schadelijks zou aandoen’ (α = .700). Het algemene vertrouwen was het gemiddelde van alle zes de vertrouwen-items (α = .784). Deze maten werden geanalyseerd als competentie-georiënteerde, interpersoonlijke, cognitief-vertrouwens, affectief-vertrouwens en algemene-vertrouwensuitkomsten, in plaats van als onderling uitsluitende constructen.
De analyse verliep in vier stappen. Ten eerste werd via een confirmatieve factoranalyse het voorgestelde vierfactormodel vergeleken met alternatieven met twee en één factor; hierbij werden de composiete betrouwbaarheid, de gemiddelde verklaarde variantie (average variance extracted), latente correlaties en heterotrait-monotrait ratio's onderzocht. Ten tweede schatten volledige 2 x 2 factoriële modellen de hoofdeffecten en interactie-effecten voor waargenomen professionaliteit, sociale aanwezigheid, cognitief vertrouwen, affectief vertrouwen en algemeen vertrouwen, inclusief celgemiddelden, betrouwbaarheidsintervallen en partiële η2. De geschatte marginale gemiddelden en 95% betrouwbaarheidsintervallen worden weergegeven in Figuur 2. Ten derde werden waargenomen professionaliteit en sociale aanwezigheid gelijktijdig als parallelle mediatoren ingevoerd in PROCESS 4.2 beta Model 7, met 5.000 percentiel-bootstrap steekproeven43. De rolkadering (role framing) werd gecodeerd als 1 = expert en 2 = metgezel, en de taakcontext werd gecodeerd als 1 = ziekteconsult en 2 = gezondheidsconsult. Een common-resample bootstrap werd direct afgezet tegen de twee indices van gemodereerde mediatie. Ten vierde werden cognitief en affectief vertrouwen afzonderlijk geanalyseerd als exploratieve uitkomstmaten. Omdat mediatoren en uitkomsten gelijktijdig werden gemeten, worden de schattingen geïnterpreteerd als indirecte associaties die consistent zijn met mediatie, in plaats van als causale psychologische mechanismen.
Studie 2: EEG-experiment
Deelnemers
Voor Studie 2 werden 40 deelnemers geworven. Eén deelnemer werd uitgesloten omdat in ten minste één experimentele conditie meer dan 30% van de trials door artefacten was beïnvloed, waardoor er 39 deelnemers overbleven voor de uiteindelijke EEG-analyses. Dit criterium zorgde ervoor dat elke behouden deelnemer voor ten minste 70% van de trials in elke conditie bijdroeg. Alle deelnemers gaven schriftelijke geïnformeerde toestemming en ontvingen na het experiment een compensatie. Demografische informatie kon niet aan alle behouden EEG-registraties worden gekoppeld en is daarom niet samengevat voor de uiteindelijke EEG-steekproef.
Experimentele stimuli en procedure
Het experiment werd uitgevoerd in een standaard EEG-laboratorium met gebruik van een within-subjects design, waarbij de stimuli werden gepresenteerd in E-Prime 2.1. De deelnemers kregen de instructie om zich voor te stellen dat ze interacteerden met een medisch AI-systeem en hun vertrouwen in het systeem te beoordelen voor elk scenario van een medische consultatie. In het experiment werd de waargenomen rol van het medische AI-systeem gemanipuleerd, inclusief varianten van het expert-type en het companion-type.
Er werden in totaal 40 Chinese zinstimuli geconstrueerd. De conditie voor het expert-type bevatte 20 stimuli die begonnen met 'Medical AI expert', terwijl de conditie voor het companion-type 20 parallelle stimuli bevatte die begonnen met 'Medical AI companion'. De medische scenario's omvatten zowel professionele diagnostische functies, zoals het uitvragen van de medische geschiedenis, het analyseren van onderzoeksrapporten, het beoordelen van hartslaggegevens, het interpreteren van genetische tests, het inschatten van het ziekterisico en het aanbevelen van behandelplannen, als ondersteunende functies voor gezondheidsbeheer, zoals het tonen van betrokkenheid bij de fysieke gesteldheid, het vragen naar de slaapkwaliteit, het verlichten van angst, het registreren van gezondheidsgegevens, het aanmoedigen van therapietrouw en het geven van dagelijkse gezondheidstips. De condities verschilden daarom ook in semantische inhoud en complexiteit; er was geen onafhankelijke stimulusmatching of pretest beschikbaar.
Vóór het formele experiment voltooiden de deelnemers een kort oefenblok. Elke trial begon met een fixatiekruis van 500 ms, gevolgd door een variabel leeg interval van 300–500 ms en een verklaring over medische AI die gedurende 1.600 ms werd getoond. De deelnemers gaven vervolgens in hun eigen tempo een binair trust-oordeel door de F-toets in te drukken om vertrouwen aan te geven of de J-toets om geen vertrouwen aan te geven (zie Figuur 3). Verklaringen geformuleerd vanuit het perspectief van een expert of een begeleider werden in willekeurige volgorde gepresenteerd. De E-Prime taaklogs gaven 80 formele trials per taakrecord aan: 40 expert-trials en 40 begeleider-trials, waarbij elk van de 20 unieke verklaringen per rol twee keer werd gepresenteerd.
Gegevens van de gedragstaak
De gegevens van de gedragstaak waren bruikbaar voor 38 van de 39 deelnemers in de uiteindelijke EEG-steekproef; het E-Prime taakrecord van één deelnemer was onbruikbaar. Gedragsanalyses werden daarom uitgevoerd met N = 38. Gedetailleerde gedragsresultaten en de verantwoording van de steekproef zijn opgenomen in Aanvullende Tabel S3. Vertrouwen werd gecodeerd als een F-toetsrespons; J-toetsresponsen gaven geen vertrouwen aan. Blanke responsen of een geregistreerde responstijd van 0 ms werden gecodeerd als ontbrekend. De vertrouwingssnelheid werd berekend over de beantwoorde trials, en de responstijd werd samengevat over de beantwoorde trials. De neurale gegevens die beschikbaar waren voor analyse bevatten over condities geaggregeerde maten, maar geen EEG-indices op trial-niveau of een geverifieerde identificatie die elk gedragsrecord koppelde aan het bijbehorende EEG-record; daarom is er geen mixed model op trial-niveau van EEG en vertrouwensoordelen geschat.
EEG-registratie en analyse
Quik-Gel geleidende elektrolytgel werd gebruikt om de impedantie tussen elektrode en huid onder de 5 kOhm te houden. FCz was de standaard online referentie van het apparaat en de bemonsteringsfrequentie was 1.000 Hz. Offline referentie naar het gemiddelde van de bilaterale mastoïden werd uitgevoerd met de ingebouwde her-referentiefunctie van CURRY; FCz werd behouden en automatisch gereconstrueerd ten opzichte van de nieuwe referentie, waarbij geen op maat gemaakt reconstructiecommando of script is gebruikt. De daaropvolgende offline verwerking werd uitgevoerd in MATLAB R2020b met EEGLAB44 en ICLabel45. De gegevens werden gedownsampled naar 500 Hz en banddoorlaatgefilterd van 0,1 tot 40 Hz. Slechte kanalen en grof gecontamineerde datasegmenten werden geïdentificeerd en verwijderd via visuele inspectie; er werd geen geautomatiseerde interpolatie of geautomatiseerde drempelwaarde voor segmentverwijdering toegepast. Vervolgens werd de standaard EEGLAB runica-implementatie (Infomax ICA) gebruikt, en componenten werden verwijderd wanneer ICLabel een waarschijnlijkheid van ten minste .70 toekende aan een artefactklasse (bijv. oog-, spier-, hart-, lijnruis- of kanaalruisactiviteit). Deelnemers met meer dan 30% door artefacten gecontamineerde trials in een van beide condities werden uitgesloten, waardoor een behoud van ten minste 70% van de trials per conditie werd gewaarborgd. Epochs besloegen −1.000 tot 1.996 ms. Voor de functionele connectiviteitsanalyse werden de voorbewerkte gegevens verder gedownsampled naar 250 Hz en werden perifere elektroden, waaronder P7, P8, F7 en F8, uitgesloten voorafgaand aan de schatting van de fasesynchronisatie.
Theta-activiteit geregistreerd op frontale middenlijn-locaties van de hoofdhuid is geassocieerd met berekeningen die worden aangestuurd door eisen aan cognitieve controle46. Fasesynchronisatie in de theta-band tussen mediale en laterale frontale elektrodeplaatsen is ook geassocieerd met coördinatie tijdens controle-gerelateerde verwerking47. In het bijzonder is verhoogde fasesynchronisatie in de theta-band tussen locaties zoals FCz en F6 waargenomen na conflict- of foutdetectie48. Omdat deze hoofdhuidmetingen niet uniek specifiek zijn voor cognitieve controle, worden ze hier behandeld als convergente procesindicatoren in plaats van directe weergaven van één enkel cognitief mechanisme.
Ten eerste werd de frontale midline theta event-related synchronization (ERS) gekwantificeerd in de 4–8 Hz band binnen het venster van 800–1.000 ms na de stimulus. ERS werd berekend met behulp van tijd-frequentieanalyse, waarbij de relatieve verandering in vermogen werd berekend ten opzichte van de prestimulus-baseline van −500 tot −200 ms. Positieve waarden duiden op een toename van het vermogen (synchronisatie), terwijl negatieve waarden duiden op een onderdrukking van het vermogen (desynchronisatie). Ten tweede werd de functionele connectiviteit geschat nadat de gepreprocessede gegevens verder waren gedownsampled naar 250 Hz en perifere elektroden, waaronder P7, P8, F7 en F8, waren uitgesloten. Een short-time Fourier transform (STFT) werd toegepast voordat de phase-locking value in de theta-band tussen FCz en F6 werd berekend. De baseline-gecorrigeerde PLV-verandering (ΔPLV) werd berekend ten opzichte van de prestimulus-baseline van −600 tot −200 ms. De ruwe PLV is begrensd tussen 0 en 1; daarom duiden negatieve ΔPLV-waarden op een afname ten opzichte van de baseline in plaats van negatieve phase locking. Deze schedenmetingen worden geïnterpreteerd als exploratieve patronen die geassocieerd zijn met controle-gerelateerde verwerking en prefrontale coördinatie; ze identificeren niet direct een specifiek cognitief proces of een neurale bron.
Resultaten
Studie 1: Resultaten van het scenario-experiment
Meetmodel. Het vierfactormodel paste beter dan de twee-factor- en één-factoralternatieven, maar de absolute passing was wisselend: χ2(48) = 223.93, p < .001; CFI = .935; TLI = .911; RMSEA = .111; SRMR = .140. De gestandaardiseerde ladingen varieerden van .382 tot .937. De composietbetrouwbaarheid was .886 voor waargenomen professionaliteit, .932 voor sociale aanwezigheid, .840 voor cognitief vertrouwen en .709 voor affectief vertrouwen; de overeenkomstige AVE-waarden waren .722, .821, .636 en .474. De discriminante validiteit was beperkt: de HTMT-waarden waren .935 tussen waargenomen professionaliteit en cognitief vertrouwen, en .926 tussen sociale aanwezigheid en affectief vertrouwen. De resultaten van het conditionele proces worden daarom voorzichtig geïnterpreteerd, en dimensiespecifieke analyses van vertrouwen zijn verkennend (Tabel 1).
Manipulatiecontroles. Deelnemers in de expert-framing groep (n = 150, M = 5,57, SD = 1,18) beoordeelden de medische AI als meer expert-achtig dan deelnemers in de companion-framing groep (n = 150, M = 3,21, SD = 1,76). Omdat de varianties verschilden, F = 47,42, p < .001, is de toets van Welch gebruikt, t(259,90) = 13,63, p < .001, gemiddeld verschil = 2,36, 95% BI [2,02, 2,70]. Deelnemers in de ziekte-conditie (n = 150, M = 2,51, SD = 1,53) gaven lagere scores voor preventieve gezondheidsoriëntatie dan deelnemers in de gezondheidsconditie (n = 150, M = 5,98, SD = 1,22), F = 10,96, p = .001; Welch’s t(284,11) = −21,70, p < .001, gemiddeld verschil = −3,47, 95% BI [−3,79, −3,16]. De vrijheidsgraden van Welch zijn niet gelijk aan N − 2 wanneer varianties ongelijk zijn; alle analyses maakten gebruik van N = 300.
Beschrijvende statistieken per experimentele conditie. Voor expert-framing resulteerden consultaties over ziekte en gezondheid in gemiddelden voor waargenomen professionaliteit van 5,69 (SD = 0,83) en 5,85 (SD = 0,63), gemiddelden voor sociale aanwezigheid van 4,28 (SD = 1,54) en 4,25 (SD = 1,64), en gemiddelden voor algemeen vertrouwen van 5,45 (SD = 0,86) en 5,28 (SD = 0,87), respectievelijk. Voor companion-framing waren de overeenkomstige gemiddelden voor ziekte en gezondheid 4,52 (SD = 1,47) en 5,25 (SD = 0,94) voor waargenomen professionaliteit, 5,68 (SD = 1,07) en 5,93 (SD = 0,74) voor sociale aanwezigheid, en 5,30 (SD = 1,02) en 5,61 (SD = 0,64) voor algemeen vertrouwen. Tabel 2 rapporteert alle conditiespecifieke betrouwbaarheidsintervallen en de volledige factoriële toetsen.
Complete factoriële resultaten. Waargenomen professionaliteit vertoonde een hoofdeffect van rolkadering, F(1, 296) = 56,92, p < .001, partiële η2 = .161, een hoofdeffect van taakcontext, F(1, 296) = 14,37, p < .001, partiële η2 = .046, en een interactie tussen rol × taak, F(1, 296) = 5,89, p = .016, partiële η2 = .020. Sociale aanwezigheid vertoonde een hoofdeffect van rolkadering, F(1, 296) = 105,57, p < .001, partiële η2 = .263, maar noch het hoofdeffect van de taak, F(1, 296) = 0,59, p = .442, noch de interactie, F(1, 296) = 0,84, p = .359, was significant. Dit laatste resultaat geeft aan dat er geen moderatie is gedetecteerd; het stelt geen equivalentie tussen taken vast. Voor cognitief vertrouwen was de interactie tussen rol × taak significant, F(1, 296) = 5,60, p = .019, partiële η2 = .019; de overeenkomstige interactie was niet significant voor affectief vertrouwen, F(1, 296) = 3,48, p = .063, partiële η2 = .012. Algemeen vertrouwen vertoonde geen hoofdeffect van rolkadering, F(1, 296) = 0,81, p = .369, of hoofdeffect van taak, F(1, 296) = 0,55, p = .459, maar de interactie tussen rol × taak was significant, F(1, 296) = 5,78, p = .017, partiële η2 = .019. Bij consultatie over ziekte verschilde het algemeen vertrouwen niet tussen kadering als metgezel en als expert, gemiddeld verschil = −0,15, SE = 0,14, t(296) = −1,06, p = .288, 95% BI [−0,42, 0,13]. Bij consultatie over gezondheid was het algemeen vertrouwen hoger bij kadering als metgezel, gemiddeld verschil = 0,33, SE = 0,14, t(296) = 2,34, p = .020, 95% BI [0,05, 0,60].
Parallelle conditionele indirecte associaties. Wanneer waargenomen professionaliteit en sociale aanwezigheid gelijktijdig werden ingevoerd, waren beide positief geassocieerd met het algemene vertrouwen: respectievelijk b = 0.4872, SE = 0.0258, p < .001, 95% CI [0.4294, 0.5460], en b = 0.3293, SE = 0.0208, p < .001, 95% CI [0.2762, 0.3829]. De directe associatie met role-framing was niet significant, b = 0.0119, SE = 0.0680, p = .861, 95% CI [−0.1071, 0.1361]. Indirecte associaties met professionaliteit waren −0.5695 bij ziekteconsultatie, 95% bootstrap CI [−0.7687, −0.3851], en −0.2923 bij gezondheidsconsultatie, 95% bootstrap CI [−0.4288, −0.1634]. Indirecte associaties met sociale aanwezigheid waren 0.4625 bij ziekteconsultatie, 95% bootstrap CI [0.3165, 0.6091], en 0.5532 bij gezondheidsconsultatie, 95% bootstrap CI [0.3855, 0.7383] (Tabel 3). De index van gemodereerde mediatie via waargenomen professionaliteit was 0.2772, 95% bootstrap CI [0.0594, 0.5035], terwijl de index via sociale aanwezigheid 0.0907 was, 95% bootstrap CI [−0.0984, 0.3008]. Het directe bootstrap-contrast tussen de indices was niet significant, verschil = 0.1864, 95% bootstrap CI [−0.0856, 0.4447]. De resultaten ondersteunen daarom de contextuele moderatie van de indirecte associatie met professionaliteit, maar stellen geen statistisch verschillende contextuele moderatie van de twee associaties vast.
Exploratieve analyses van de vertrouwensdimensies. Voor cognitief vertrouwen was het contrast tussen de gemodereerde-mediatie-indices van professionaliteit en sociale aanwezigheid positief, verschil = 0,3707, 95% bootstrap CI [0,0493, 0,6996]. Voor affectief vertrouwen werd het overeenkomstige contrast niet ondersteund, verschil = 0,0022, 95% bootstrap CI [−0,3421, 0,3127]. Beide mediatoren behielden positieve associaties met beide vertrouwensdimensies, wat duidt op kruispad-effecten in plaats van exclusieve effecten. Gezien de hoge HTMT-waarden mogen deze resultaten niet worden geïnterpreteerd als een definitieve scheiding van cognitieve en affectieve mechanismen.
Post hoc power van gemodereerde mediatie. Onder de aannames van het gefitte model en residual-resampling was de geschatte waarschijnlijkheid dat het percentile-bootstrap betrouwbaarheidsinterval nul uitsloot .698 voor de professionaliteitsindex, .157 voor de sociale-aanwezigheidsindex en .279 voor hun directe verschil (1.000 simulaties; 500 bootstrap-resamples per simulatie). Deze schattingen van het geobserveerde ontwerp verklaren waarom de ondersteunde professionaliteitsindex en het niet-significante directe contrast niet moeten worden geïnterpreteerd als sluitend bewijs voor verschillende contextuele moderatie.
Robuustheid van de voltooiingstijd. Na uitsluiting van de 15 reacties onder de 125 s bleven er 285 gevallen over. De interactie tussen het algemene vertrouwen bleef significant, p = .029; de professionaliteitsindex bleef ondersteund, 95% bootstrap CI [0.0242, 0.4827]; en het contrast tussen de indices van gemodereerde mediatie bleef niet significant, 95% bootstrap CI [−0.1027, 0.4506]. De belangrijkste conclusies waren niet afhankelijk van de snelste 5% van de reacties.
Studie 2: EEG-resultaten
Frontale middellijn theta ERS. In de uiteindelijke analytische steekproef (N = 39) was de theta ERS in het 4–8 Hz, 800–1.000 ms venster hoger bij expert framing (M = 0,2948, SD = 0,8218) dan bij companion framing (M = −0,0422, SD = 1,2155), gemiddeld verschil = 0,3369, 95% CI [0,0125, 0,6614], t(38) = 2,10, p = ,042, Cohen’s dz = 0,337, partiële η2 = ,104. De Holm-gecorrigeerde p-waarde voor de twee gerapporteerde gepaarde EEG-uitkomsten was ,042. Dit verschil duidt op differentiële verwerking in de theta-band binnen dit taakvenster; theta ERS alleen identificeert geen specifiek psychologisch proces.
Baseline-gecorrigeerde verandering in theta PLV tussen FCz en F6 (ΔPLV). In de uiteindelijke analytische steekproef (N = 39) was de theta ΔPLV minder negatief bij expert framing (M = −0.0111, SD = 0.0546) dan bij companion framing (M = −0.0350, SD = 0.0473), gemiddeld verschil = 0.0239, 95% CI [0.0058, 0.0420], t(38) = 2.68, p = .011, Cohen’s dz = 0.429, partiële η2 = .159. De volgens Holm gecorrigeerde p-waarde over de twee gerapporteerde gepaarde EEG-uitkomsten was .022. Dit patroon vertegenwoordigt een kleinere afname in theta-faseconsistentie ten opzichte van de baseline bij expert framing; dit stelt op zichzelf geen sterkere prefrontale controle of een specifiek cognitief mechanisme vast (zie Figuur 4 en Tabel 4).
Resultaten van de gedragstaak. In de 38 geanalyseerde taakregistraties was de trust-responsrate 83.1% (SD = 15.8%) bij expert framing en 82.4% (SD = 17.5%) bij companion framing, gemiddeld verschil = 0.7 procentpunt, 95% CI [−0.9, 2.4], t(37) = 0.91, p = .371, dz = 0.147. De gemiddelde responstijden waren respectievelijk 828.7 ms (SD = 204.6) en 826.1 ms (SD = 208.9), gemiddeld verschil = 2.5 ms, 95% CI [−14.0, 19.1], t(37) = 0.31, p = .758, dz = 0.050. De rates van ontbrekende responsen waren respectievelijk 6.3% (SD = 7.4%) en 5.2% (SD = 6.3%), gemiddeld verschil = 1.1 procentpunt, 95% CI [−1.0, 3.1], t(37) = 1.05, p = .302, dz = 0.170.
Verklaring over databeschikbaarheid:
Geanonimiseerde vragenlijstgegevens van Studie 1, voorbewerkte EEG-bestanden en geaggregeerde EEG-outputbestanden ter ondersteuning van Studie 2 zijn publiekelijk beschikbaar via het Open Science Framework (OSF) op https://doi.org/10.17605/OSF.IO/JKSP7. De aanvullende materialen omvatten de volledige experimentele stimuli (Aanvullend Bestand 1), manipulatiechecks, aanvullende gedragsanalyses, post hoc power-analyses en ondersteunende methodologische informatie.
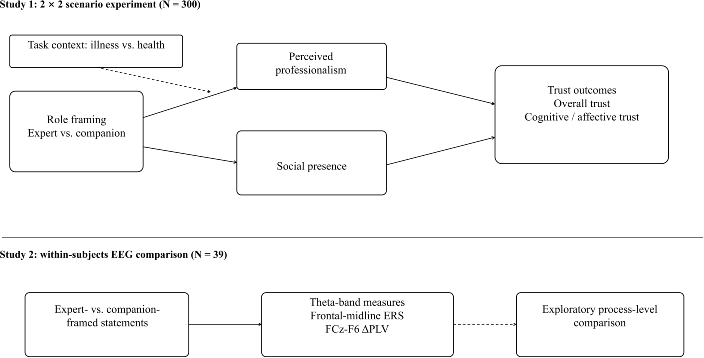
Figuur 1. Onderzoeksraamwerk. Studie 1 is een 2 × 2 scenario-experiment (N = 300) waarin rolkadering, taakcontext en parallelle indirecte associaties via waargenomen professionaliteit en sociale aanwezigheid worden onderzocht. Studie 2 biedt een exploratieve elektro-encefalogramvergelijking van uitspraken met een expert- en een metgezelkader (N = 39); dit test het conditionele indirecte model niet direct. Klik hier om een grotere versie van deze figuur te bekijken.
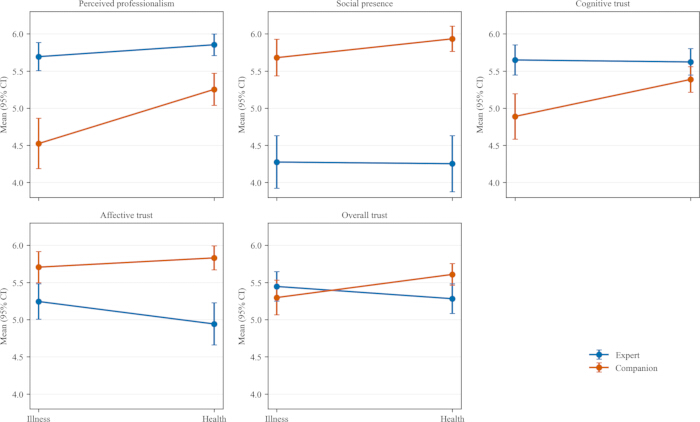
Figuur 2. Role-framing × taakcontext-plots voor waargenomen professionaliteit, sociale aanwezigheid, cognitief vertrouwen, affectief vertrouwen en algemeen vertrouwen. Punten geven de celgemiddelden aan en foutbalken tonen de 95% betrouwbaarheidsintervallen (n = 75 per cel). Klik hier om een grotere versie van deze figuur te bekijken.
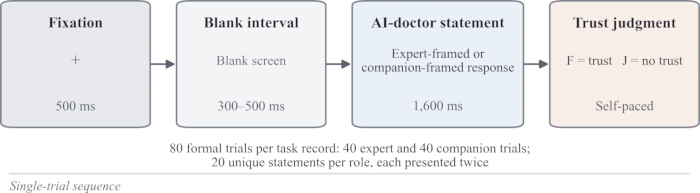
Figuur 3. Sequentie van een enkele trial in Studie 2. Elke trial bestond uit een fixatie van 500 ms, een jittered leeg interval van 300–500 ms, een uitspraak van een AI-arts van 1.600 ms geformuleerd als expert of als metgezel, en een binair vertrouwensoordeel in eigen tempo. De E-Prime taaklogs gaven 80 formele trials per taakrecord aan, met 40 trials per role-framing conditie en twee presentaties van elk van de 20 unieke uitspraken per conditie. Klik hier om een grotere versie van deze figuur te bekijken.
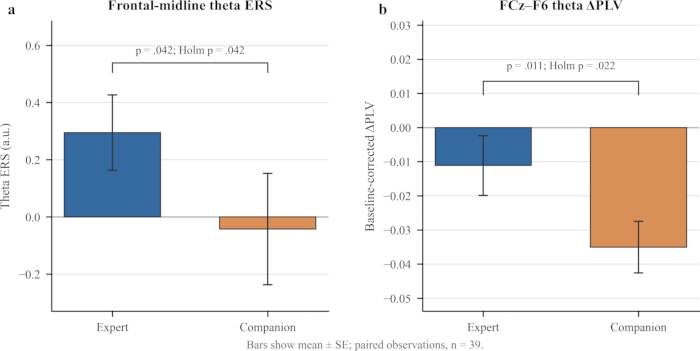
Figuur 4. Effecten van de rolformulering van Medische AI op frontale-midlijn theta ERS en FCz-F6 theta delta PLV. (A) Frontale-midlijn theta event-related synchronization. (B) Baseline-gecorrigeerde FCz-F6 theta phase-locking-value verandering (ΔPLV); negatieve waarden duiden op een afname ten opzichte van de pre-stimulus baseline. Staven tonen het gemiddelde ± SE voor n = 39. Gepaarde t-testen gaven p = .042 voor theta ERS en p = .011 voor ΔPLV; Holm-gecorrigeerde p-waarden voor deze twee gerapporteerde uitkomsten waren respectievelijk .042 en .022. Afkortingen: Klik hier om een grotere versie van deze figuur te bekijken.
Tabel 1: Diagnostiek van het meetmodel voor Studie 1. De tabel vermeldt gestandaardiseerde ladingen, Cronbach’s α, samengestelde betrouwbaarheid, gemiddelde uitgehaalde variantie, latente correlaties en HTMT-waarden voor waargenomen professionaliteit, sociale aanwezigheid, cognitief vertrouwen en affectief vertrouwen. N = 300. Het vierfactormodel paste beter dan de alternatieven, maar RMSEA en SRMR wezen op een zwakke absolute passing en twee HTMT-waarden overschreden .90. Afkortingen: CR = samengestelde betrouwbaarheid; AVE = gemiddelde uitgehaalde variantie; HTMT = heterotrait-monotrait ratio. Klik hier om deze tabel te downloaden.
Tabel 2: Descriptieve statistieken voor vier condities en volledige 2 × 2 factoriële tests voor Studie 1. De celgegevens vermelden n, gemiddelde, standaarddeviatie en het 95% betrouwbaarheidsinterval; de factoriële tests vermelden F, p en partiële η2. N = 300; n = 75 per cel. Rolinkadering was gecodeerd als 1 = expert en 2 = metgezel; taakcontext was gecodeerd als 1 = ziekte en 2 = gezondheidsconsultatie. Coëfficiënten en betrouwbaarheidsintervallen zijn niet-gestandaardiseerd. Klik hier om deze tabel te downloaden.
Tabel 3: Parallellle conditionele indirecte associaties in Studie 1. N = 300. Rolinkadering werd gecodeerd als 1 = expert en 2 = metgezel; taakcontext werd gecodeerd als 1 = ziekteconsult en 2 = gezondheidsconsult. Waargenomen professionaliteit en sociale aanwezigheid werden gelijktijdig ingevoerd. De schattingen zijn niet-gestandaardiseerd en voor de percentiel-bootstrap betrouwbaarheidsintervallen werden 5.000 resamples gebruikt. De tabel bevat conditionele indirecte associaties, beide indices van gemodereerde mediatie en hun directe bootstrap contrast. Het directe contrast tussen de twee gemodereerde-mediatie indices voor algemeen vertrouwen was 0,1864, 95% BI [-0,0856, 0,4447]. Klik hier om deze tabel te downloaden.
Tabel 4: Gepaarde EEG-uitkomsten in Studie 2. N = 39 gepaarde observaties in de uiteindelijke analytische steekproef. De tabel rapporteert conditiegemiddelden, gepaarde gemiddelde verschillen, 95% betrouwbaarheidsintervallen, gepaarde t toetsen, Cohen’s dz, partiële η2 en Holm-gecorrigeerde p-waarden voor frontale midline theta ERS en baseline-gecorrigeerde FCz-F6 theta ΔPLV. De Holm-correctie heeft uitsluitend betrekking op de twee gerapporteerde gepaarde EEG-uitkomsten en reconstrueert geen ongedocumenteerde bredere zoektocht naar elektroden, banden of tijdvensters. Klik hier om deze tabel te downloaden.
Aanvullend bestand 1: Experimentele stimuli gebruikt in Studie 1. Het bestand bevat de volledige tekst van de medische AI-reacties met een expert-frame en een metgezel-frame die zijn gebruikt in de scenario's voor ziekteconsultatie en gezondheidsconsultatie. Zowel de oorspronkelijke Chinese tekst als de Engelse vertaling worden verstrekt.Klik hier om dit bestand te downloaden.
Aanvullende tabel S1. Post hoc simulatiegebaseerde poweranalyse voor het gemodereerde-mediatiemodel. Klik hier om dit bestand te downloaden.
Aanvullende Tabel S2. Statistieken van de manipulatiecontrole en sensitiviteitsanalyses van de voltooiingstijd voor Studie 1. Klik hier om dit bestand te downloaden.
Aanvullende Tabel S3. Resultaten van de gedragstaak, steekproefverantwoording en beschrijvende statistieken voor Studie 2. Klik hier om dit bestand te downloaden.
Discussie
Theoretische implicaties
De twee studies leveren bewijs op verschillende niveaus. Studie 1 identificeert associaties tussen rol en taak en parallelle indirecte associaties in een gerandomiseerd scenario-experiment, terwijl Studie 2 een verkennende vergelijking op procesniveau via EEG biedt. De studies ondersteunen daarom een begrensd verslag van rol-gekaderde evaluatie in plaats van een enkel progressief mechanisme. De bevindingen breiden de rolcongruentietheorie uit naar medische AI door congruentie te beschouwen als de afstemming tussen rolkenmerken en taakrelevante evaluatieve eisen22. Deze interpretatie is verschillend van competentie-warmte-inhoud en de aansluiting tussen taak en technologie (task-technology fit). Bevindingen over algoritmische aversie en algoritmische appreciatie kunnen worden begrepen als contextgevoelige evaluaties van de vraag of rol- en capaciteitskenmerken passen bij de taak49,50.
De resultaten ondersteunen daarnaast parallelle, niet-exclusieve associaties tussen rolkadering, waargenomen professionaliteit, sociale aanwezigheid en vertrouwen. Omdat professionaliteit overlapt met cognitief vertrouwen en sociale aanwezigheid overlapt met affectief vertrouwen, ondersteunen de bewijzen gedifferentieerde evaluatieve inhoud, maar geen twee strikt gescheiden mechanismen. De interactie tussen rol en taak met betrekking tot de waargenomen professionaliteit is consistent met de voorgestelde verklaring van rolcongruentie. De bewijzen ondersteunen contextuele moderatie van de associatie met professionaliteit, maar stellen geen statistisch asymmetrische contextuele mechanismen of invariantie in het pad van sociale aanwezigheid vast.
De EEG-bevindingen bieden een verkennend perspectief op procesniveau. Door experts geformuleerde uitspraken gingen gepaard met kenmerkende theta-bandpatronen, maar de condities verschilden ook in semantische inhoud en complexiteit, en het gedrag op conditieniveau vertoonde geen betrouwbaar verschil in vertrouwen. De EEG-metingen leggen daarom geen specifiek mechanisme voor cognitieve controle of vertrouwen vast. De neurale bevindingen moeten worden beschouwd als hypothese-genererend. Studie 2 manipuleerde de taakcontext niet, mat de waargenomen professionaliteit of sociale aanwezigheid niet, en koppelde EEG-indices op trial-niveau niet aan vertrouwensoordelen; de EEG-resultaten vullen het conditionele indirecte model dus aan in plaats van het te valideren.
De bevindingen zijn consistent met passende, in plaats van maximale, afhankelijkheid. De afhankelijkheid van geautomatiseerde systemen moet worden gekalibreerd op basis van de systeemcapaciteiten, grenzen en taakeisen35. Verwant werk beschrijft adaptieve cognitieve mechanismen die gekalibreerd vertrouwen en afhankelijkheid kunnen ondersteunen51. Het NeuroIS-perspectief ondersteunt het gebruik van neurale maten als aanvulling op gedragsmatige bewijzen bij het onderzoeken van temporeel opgeloste processen52. Eerder fMRI-onderzoek laat eveneens zien dat neurale activiteit tijdens online vertrouwensoordelen varieert per doelwit en context53.
Managementimplicaties
Voor online medische platforms is de praktische implicatie een gekalibreerd vertrouwen in plaats van eenvoudige maximalisatie van vertrouwen. Rolindicaties moeten worden afgestemd op de taakeisen en gecombineerd worden met communicatie over onzekerheden, expliciete beperkingen van de capaciteiten, risicogebaseerde waarschuwingen en escalatie naar gekwalificeerde clinici.
In risicovolle modules met betrekking tot diagnose, interpretatie van abnormale resultaten, medisch advies of triage, kunnen competentiegeoriënteerde aanwijzingen gebruikers helpen de grenzen van bewijs en actie te herkennen zonder onterechte autoriteit te verlenen. In modules met een lagere urgentie, zoals die over dieet, lichaamsbeweging, slaap, therapietrouw en emotionele ondersteuning, kunnen relatiegeoriënteerde aanwijzingen de betrokkenheid bevorderen zonder valse geruststelling of ongepaste antropomorfisering te creëren.
Het ontwerp van rollen moet modulair en scenario-gebaseerd zijn, in plaats van een vaste persoonlijkheidsinstelling. De rolconfiguratie moet worden geïntegreerd met uitleg, privacy-prompts, risicolabels en escalatiemechanismen. Governance-onderzoek benadrukt dat transparantie, verantwoording, biasbeheer en privacy gezamenlijk moeten worden ontworpen, zodat geloofwaardige front-end rolkenmerken geen back-end risico's maskeren6,20,21.
Beperkingen van het onderzoek en toekomstige richtingen
Studie 1 is een scenario-experiment en geen werkelijk consult. De condities zijn niet onafhankelijk vooraf getest op lengte, woordfrequentie, leesbaarheid, nauwkeurigheid, actiegerichtheid, emotionele valentie, arousal, risico, bekendheid of complexiteit. Toekomstige studies zouden gebruik moeten maken van meerdere scenario's, neutrale systeemnamen, stimuli met overeenkomende inhoud, onafhankelijke manipulatie of temporeel gescheiden metingen, en random effects op deelnemer- en stimulusniveau.
Studie 2 leverde bewijs op EEG-procesniveau, maar de uiteindelijke demografische koppeling van 39 personen was onvolledig, de EEG-uitspraken werden niet onafhankelijk gematcht of vooraf getest op zinslengte, woordfrequentie, leesbaarheid, emotionele valentie, arousal, waargenomen risico, bekendheid en complexiteit, en expliciete rollabels kunnen hebben geleid tot demand characteristics. In de huidige studie werd de baseline-gecorrigeerde phase-locking value (ΔPLV) gebruikt als de vooraf gedefinieerde maat voor functionele connectiviteit. Hoewel de weighted phase lag index (wPLI) minder gevoelig is voor volumegeleiding, werd deze niet opgenomen in de oorspronkelijke analysepipeline. Toekomstige studies zouden moeten onderzoeken of de huidige bevindingen gerepliceerd worden met behulp van wPLI of andere aanvullende connectiviteitsmaten. De beschikbare neurale outputs zijn geaggregeerd per conditie en kunnen niet worden gekoppeld aan vertrouwensbeoordelingen op trial-niveau; daarom is er geen mixed model voor EEG-gedrag op trial-niveau geschat. Scalp PLV is daarnaast gevoelig voor effecten van gemeenschappelijke referentie en volumegeleiding. Deze beperkingen betekenen dat de neurale bevindingen verkennend moeten blijven en niet geïnterpreteerd mogen worden als bewijs voor een uniek cognitief-controle- of vertrouwensmechanisme.
Openbaarmakingen
De auteurs hebben geen conflicten van belang te verklaren.
Tijdens de voorbereiding van dit werk hebben de auteurs ChatGPT gebruikt om de taal te verbeteren. Na het gebruik van dit hulpmiddel/deze service hebben de auteurs de inhoud waar nodig beoordeeld en bewerkt, en aanvaarden zij de volledige verantwoordelijkheid voor de inhoud van de publicatie.
Dankbetuigingen
Dit onderzoeksproject werd ondersteund door de National Social Sciences Funded General Projects, PRC (Subsidienummer 22BGL006).
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Credamo online survey platform | Credamo (Jianshu), China | Niet van toepassing | Online vragenlijst-, willekeurige toewijzings- en deelnemersrekruteringsplatform gebruikt in Studie 1. |
| CURRY rereferencing functie | Compumedics Neuroscan, USA | Versie niet gespecificeerd | Ingebouwde offline herreferentie van de FCz online referentie naar het bilaterale mastoid-gemiddelde; FCz werd automatisch gereconstrueerd ten opzichte van de nieuwe referentie. |
| EEG-elektrodenkap, 64-kanaals | Compumedics Neuroscan (Compumedics Limited), Australia | Model/catalogusnummer niet gespecificeerd | 64-kanaals Ag/AgCl elektrodenkap gebruikt voor continue EEG-registratie. |
| EEGLAB | Swartz Center for Computational Neuroscience, University of California San Diego, USA | Versie 2023.0 | MATLAB-toolbox gebruikt voor EEG-preprocessing en onafhankelijke componentanalyse. |
| E-Prime | Psychology Software Tools, Inc., USA | Versie 2.1 | Stimuluspresentatie en responsverzameling in Studie 2. |
| G*Power | Heinrich Heine University Dusseldorf, Germany | Versie 3.1.9.7 | Originele a priori steekproefgrootteberekening, interactie-gevoeligheidsanalyse en post hoc modelgebaseerde poweranalyse voor Studie 1. |
| IBM SPSS Statistics | IBM Corp., USA | Versie 27 | Statistische omgeving gebruikt om de PROCESS macro uit te voeren. |
| ICLabel | Swartz Center for Computational Neuroscience, University of California San Diego, USA | Versie 1.7 | EEGLAB-plugin gebruikt om artifactuele onafhankelijke componenten te classificeren. |
| MATLAB | The MathWorks, Inc., USA | Release R2020b | Computeromgeving gebruikt voor EEG-verwerking en analyse. |
| PROCESS macro voor SPSS | Andrew F. Hayes, Canada | Versie 4.2 beta | Model 7 met waargenomen professionaliteit en sociale aanwezigheid gelijktijdig ingevoerd als parallelle mediatoren, gebruikmakend van 5.000 percentiel bootstrap-steekproeven in Studie 1. |
| Quik-Gel geleidende elektrolytgel | Compumedics Neuroscan (Compumedics Limited), Australia | Catalogusnummer niet gespecificeerd; 32 oz | Geleidende gel gebruikt om de elektrode-huidimpedantie te verlagen tijdens EEG-registratie. |
| SynAmps2 EEG-versterker | Compumedics Neuroscan (Compumedics Limited), Australia | SynAmps2; catalogusnummer niet gespecificeerd | 64-256-kanaals EEG-versterker geconfigureerd voor 64-kanaals registratie. |
Referenties
- Grand View Research. Artificial intelligence in healthcare market size & share, industry report, 2033 [Internet]. Grand View Research; [cited 2026 Jul 11]. Available from: https://www.grandviewresearch.com/industry-analysis/artificial-intelligence-ai-healthcare-market
- Singhal K, et al. Large language models encode clinical knowledge. Nature. 2023;620(7972):172-80.
- Laranjo L, et al. Conversational agents in healthcare: a systematic review. J Am Med Inform Assoc. 2018;25(9):1248-58.
- Kouzy R, Hong JC, Bitterman DS. One shot at trust: building credible evidence for medical artificial intelligence. Lancet Digit Health. 2025;7(7):100883.
- Kim C, Gadgil SU, Lee SI. Transparency of medical artificial intelligence systems. Nat Rev Bioeng. 2026;4(1):11-29.
- Bian X, Chen Y, Yang A. Configuring trust in AI-augmented healthcare: the role of AI interpretability and data privacy in patient adoption of AI-assisted diagnosis. Int J Inf Manage. 2026;88:103039.
- Longoni C, Bonezzi A, Morewedge CK. Resistance to medical artificial intelligence. J Consum Res. 2019;46(4):629-50.
- Logg JM, Minson JA, Moore DA. Algorithm appreciation: people prefer algorithmic to human judgment. Organ Behav Hum Decis Process. 2019;151:90-103.
- Qin H, et al. Examining the impact of personalization and carefulness in AI-generated health advice: trust, adoption, and insights in online healthcare consultations experiments. Technol Soc. 2024;79:102726.
- Mayer CJ, et al. User preferences and trust in hypothetical analog, digitalized and AI-based medical consultation scenarios: an online discrete choice survey. Comput Human Behav. 2024;161:108419.
- Du G, Zhou C, Cheng X. Reducing consumers’ resistance to AI agents in online healthcare consultations: the role of human-AI teaming from a trust transfer perspective. J Bus Res. 2026;206:115959.
- Fiske ST, Cuddy AJC, Glick P, Xu J. A model of often mixed stereotype content: competence and warmth respectively follow from perceived status and competition. J Pers Soc Psychol. 2002;82(6):878-902.
- Araujo T. Living up to the chatbot hype: the influence of anthropomorphic design cues and communicative agency framing on conversational agent and company perceptions. Comput Human Behav. 2018;85:183-9.
- Zhang J, Luximon Y, Li Q. Seeking medical advice in mobile applications: how social cue design and privacy concerns influence trust and behavioral intention in impersonal patient-physician interactions. Comput Human Behav. 2022;130:107178.
- Li Q, Luximon Y, Zhang J. The influence of anthropomorphic cues on patients’ perceived anthropomorphism, social presence, trust building, and acceptance of health care conversational agents: within-subject web-based experiment. J Med Internet Res. 2023;25:e44479.
- Harris-Watson AM, et al. Social perception in human-AI teams: warmth and competence predict receptivity to AI teammates. Comput Human Behav. 2023;145:107765.
- Schelble BG, et al. Addressing the role of context on trust in human-AI teams: the influence of team role and violation type in high-risk tasks. Ergonomics. 2025. doi:10.1080/00140139.2025.2570300.
- Mou Y, Ye X, Ma W. Building and repairing trust in chatbots: the interplay between social role and performance during interactions. Behav Sci (Basel). 2026;16(1):118.
- Glikson E, Woolley AW. Human trust in artificial intelligence: review of empirical research. Acad Manage Ann. 2020;14(2):627-60.
- Luo Y, Li S, Ye Q, Zheng J. How privacy calculus builds user engagement through trust in AI medical consultation. Electron Mark. 2025;35(1):50.
- Nouis SCE, Uren V, Jariwala S. Evaluating accountability, transparency, and bias in AI-assisted healthcare decision-making: a qualitative study of healthcare professionals’ perspectives in the UK. BMC Med Ethics. 2025;26(1):89.
- Eagly AH, Karau SJ. Role congruity theory of prejudice toward female leaders. Psychol Rev. 2002;109(3):573-98.
- Laï MC, Brian M, Mamzer MF. Perceptions of artificial intelligence in healthcare: findings from a qualitative survey study among actors in France. J Transl Med. 2020;18(1):14.
- Feine J, Gnewuch U, Morana S, Maedche A. A taxonomy of social cues for conversational agents. Int J Hum Comput Stud. 2019;132:138-61.
- Mayer RC, Davis JH, Schoorman FD. An integrative model of organizational trust. Acad Manage Rev. 1995;20(3):709-34.
- Nass C, Moon Y. Machines and mindlessness: social responses to computers. J Soc Issues. 2000;56(1):81-103.
- Epley N, Waytz A, Cacioppo JT. On seeing human: a three-factor theory of anthropomorphism. Psychol Rev. 2007;114(4):864-86.
- McAllister DJ. Affect- and cognition-based trust as foundations for interpersonal cooperation in organizations. Acad Manage J. 1995;38(1):24-59.
- McKnight DH, Choudhury V, Kacmar C. Developing and validating trust measures for e-commerce: an integrative typology. Inf Syst Res. 2002;13(3):334-59.
- Johnson D, Grayson K. Cognitive and affective trust in service relationships. J Bus Res. 2005;58(4):500-7.
- Bussone A, Stumpf S, O’Sullivan D. The role of explanations on trust and reliance in clinical decision support systems [conference paper]. Presented at: 2015 International Conference on Healthcare Informatics; 2015. p. 160-9. doi:10.1109/ICHI.2015.26.
- Li Y, Chen L, Fu L. Vicarious interaction in online health consultation service: the effects of generative AI’s anthropomorphism and social support on intended responses through social presence and source credibility. Int J Hum Comput Interact. 2025;41(17):11209-26.
- Short J, Williams E, Christie B. The social psychology of telecommunications. John Wiley & Sons; London; 1976.
- Gefen D, Straub DW. Consumer trust in B2C e-commerce and the importance of social presence: experiments in e-products and e-services. Omega. 2004;32(6):407-24.
- Lee JD, See KA. Trust in automation: designing for appropriate reliance. Hum Factors. 2004;46(1):50-80.
- Goodhue DL, Thompson RL. Task-technology fit and individual performance. MIS Q. 1995;19(2):213-36.
- Castelo N, Bos MW, Lehmann DR. Task-dependent algorithm aversion. J Mark Res. 2019;56(5):809-25.
- Parsons CS, et al. Task-technology fit of artificial intelligence-based clinical decision support systems: a review of qualitative studies. BMC Med Inform Decis Mak. 2025;25(1):397.
- Wutz M, Hermes M, Winter V, Köberlein-Neu J. Factors influencing the acceptability, acceptance, and adoption of conversational agents in health care: integrative review. J Med Internet Res. 2023;25:e46548.
- Faul F, Erdfelder E, Lang AG, Buchner A. G*Power 3: a flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behav Res Methods. 2007;39(2):175-91.
- Tadros FJ, et al. Perceived professionalism of a dietitian is not influenced by attire or white coat: a prospective, randomized online study. Top Clin Nutr. 2021;36(3):231-41.
- Shams G, Kim KK, Kim K. Enhancing service recovery satisfaction with chatbots: the role of humor and informal language. Int J Hosp Manag. 2024;120:103782.
- Hayes AF. Introduction to mediation, moderation, and conditional process analysis: a regression-based approach. 3rd ed. Guilford Press; New York; 2022.
- Delorme A, Makeig S. EEGLAB: an open source toolbox for analysis of single-trial EEG dynamics including independent component analysis. J Neurosci Methods. 2004;134(1):9-21.
- Pion-Tonachini L, Kreutz-Delgado K, Makeig S. ICLabel: an automated electroencephalographic independent component classifier, dataset, and website. Neuroimage. 2019;198:181-97.
- Cavanagh JF, Frank MJ. Frontal theta as a mechanism for cognitive control. Trends Cogn Sci. 2014;18(8):414-21.
- Buzzell GA, et al. Adolescent cognitive control, theta oscillations, and social observation. Neuroimage. 2019;198:13-30.
- Cavanagh JF, Cohen MX, Allen JJB. Prelude to and resolution of an error: EEG phase synchrony reveals cognitive control dynamics during action monitoring. J Neurosci. 2009;29(1):98-105.
- Dietvorst BJ, Simmons JP, Massey C. Algorithm aversion: people erroneously avoid algorithms after seeing them err. J Exp Psychol Gen. 2015;144(1):114-26.
- Jussupow E, Benbasat I, Heinzl A. An integrative perspective on algorithm aversion and appreciation in decision-making. MIS Q. 2024;48(4):1575-90.
- Lebiere C, Blaha L, Fallon C, Jefferson BA. Adaptive cognitive mechanisms to maintain calibrated trust and reliance in automation. Front Robot AI. 2021;8:652776.
- Dimoka A, et al. On the use of neurophysiological tools in IS research: developing a research agenda for NeuroIS. MIS Q. 2012;36(3):679-702.
- Riedl R, Hubert M, Kenning P. Are there neural gender differences in online trust? An fMRI study on the perceived trustworthiness of eBay offers. MIS Q. 2010;34(2):397-428.