Dit longitudinale protocol combineert herhaalde beoordelingen met de Care Dependency Scale met growth mixture modeling om verschillende trajecten van verpleegkundige afhankelijkheid na een acuut myocardinfarct te identificeren en om demografische, klinische en psychosociale factoren te evalueren die geassocieerd zijn met het lidmaatschap van een trajectklasse.
Onderzoeksartikel
Latente klassen van verpleegkundige afhankelijkheidstrajecten en bijbehorende factoren bij patiënten met een acuut myocardinfarct
* These authors contributed equally
In dit artikel
Samenvatting
Samenvatting
Deze studie had tot doel latente klassen van trajecten van verpleegkundige afhankelijkheid te identificeren bij patiënten met een acuut myocardinfarct (AMI) en factoren te onderzoeken die geassocieerd zijn met het lidmaatschap van een trajectklasse. Deze longitudinale observationele studie in één centrum omvatte 260 patiënten met AMI die tussen januari 2024 en januari 2026 werden opgenomen in het Linquan County People's Hospital. De nulmeting van de studie werd gedefinieerd als het tijdstip na een succesvolle spoedbehandeling en het herstel van het bewustzijn. Verpleegkundige afhankelijkheid werd beoordeeld met de Care Dependency Scale (CDS) bij de nulmeting (T1), op dag 3 na opname (T2), bij ontslag (T3) en 1 maand na ontslag (T4). Growth mixture modeling werd gebruikt om verschillende longitudinale trajectklassen te identificeren. Klinische en psychosociale kenmerken werden vervolgens geëvalueerd met behulp van multinomiale logistische regressie om factoren te identificeren die onafhankelijk geassocieerd waren met het lidmaatschap van een trajectklasse. Er werden vier verschillende trajecten van verpleegkundige afhankelijkheid geïdentificeerd: Type Hoge Onafhankelijkheid-Langzame Verbetering (C1, n = 6, 25,4%), Type Matige Afhankelijkheid-Snelle Verslechtering (C2, n = 54, 20,8%), Type Hoge Afhankelijkheid-Significante Verbetering (C3, n = 90, 34,6%) en Type Hoge Afhankelijkheid-Langzame Verergering (C4, n = 50, 19,2%). Leeftijd, burgerlijke staat, depressieve en angstklachten, sociale steun en voorgeschiedenis van onderliggende aandoeningen vertoonden onafhankelijke klasse-specifieke associaties met het trajectlidmaatschap. Verpleegkundige afhankelijkheid vertoonde aanzienlijke interindividuele heterogeniteit onder patiënten met AMI, waarbij vier verschillende longitudinale trajecten werden geïdentificeerd. Factoren die geassocieerd zijn met het lidmaatschap van een trajectklasse kunnen helpen bij het identificeren van patiënten die een nauwere verpleegkundige beoordeling en individuele follow-up vereisen; de effectiviteit van interventies die op deze factoren zijn gericht, behoeft echter prospectieve evaluatie.
Inleiding
Een acuut myocardinfarct (AMI) wordt gewoonlijk veroorzaakt door een plotselinge occlusie van de kransslagaders, wat resulteert in een sterke afname of onderbreking van de myocardiale bloedstroom en daaropvolgende myocardiale necrose. AMI blijft een ernstige, levensbedreigende cardiovasculaire aandoening omdat een verminderde myocardfunctie en acute complicaties de korte- en langetermijnresultaten aanzienlijk kunnen beïnvloeden1. Reperfusiestrategieën, waaronder percutane coronaire interventie en trombolytische therapie, kunnen de coronaire bloedstroom herstellen en hebben de acute behandeling van AMI aanzienlijk verbeterd. Desalniettemin blijven sommige patiënten, zelfs na een succesvolle acute behandeling, beperkingen ervaren in de zelfzorg en de activiteiten van het dagelijks leven en hebben zij bijgevolg verschillende niveaus van verpleegkundige ondersteuning nodig2.
Verpleegkundige afhankelijkheid kan de kwaliteit van leven, sociale participatie, functionele recuperatie en het algehele rehabilitatieproces van patiënten beïnvloeden3. Voorgaand onderzoek naar AMI heeft zich voornamelijk gericht op diagnostische en therapeutische strategieën, preventie en management van complicaties en prognostische factoren. Eerder cross-sectioneel onderzoek bij patiënten met coronaire hartziekten na percutane coronaire interventie heeft fragiliteit, zelfeffectiviteit en psychologische status geïdentificeerd als factoren die geassocieerd zijn met zorgafhankelijkheid; echter kan een beoordeling op één enkel tijdstip de veranderingen in afhankelijkheid binnen een patiënt niet karakteriseren of heterogene herstelpatronen in de loop van de tijd onderscheiden4. Door de verpleegkundige afhankelijkheid herhaaldelijk op vier tijdstippen te beoordelen en growth mixture modeling toe te passen, breidt de huidige studie eerdere statische analyses uit door latente patiëntsubgroepen met verschillende longitudinale trajecten te identificeren. Het identificeren van deze heterogene patronen kan clinici helpen om patiënten met verschillende rehabilitatieprofielen te herkennen en kan een basis vormen voor geïndividualiseerde verpleegkundige beoordeling, follow-up en ondersteunende zorg.
Hiertegenover was deze studie erop gericht om verschillende longitudinale klassen van verpleegkundige afhankelijkheid te identificeren, vanaf de nulmeting na de spoedbehandeling tot 1 maand na ontslag bij patiënten met AMI, en om demografische, klinische en psychosociale factoren te onderzoeken die geassocieerd zijn met het lidmaatschap van een trajectklasse. Gezien het verkennende karakter van de studie waren er geen directionele hypothesen vooraf gespecificeerd met betrekking tot specifieke trajectklassen.
Protocol
De studie werd uitgevoerd bij de Afdeling Spoedeisende Hulp van het Linquan County People’s Hospital in Fuyang, Anhui, China. Het studieprotocol is beoordeeld en goedgekeurd door de ethische commissie van het Linquan County People’s Hospital (goedkeuringsnummer 24XNLC-HL1015). Van alle deelnemers is vóór inclusie schriftelijke geïnformeerde toestemming verkregen. Alle procedures met menselijke deelnemers werden uitgevoerd in overeenstemming met de institutionele ethische vereisten en de geldende ethische principes.
Studieomgeving en identificatie van deelnemers
De studie werd uitgevoerd als een enkelcentrum longitudinaal observationeel onderzoek bij de afdeling spoedeisende hulp van het Linquan County People’s Hospital in Fuyang, Anhui, China. Deelnemers werden geworven tussen januari 2024 en januari 2026 en werden gevolgd vanaf de baseline na de spoedbehandeling tot 1 maand na ontslag.
Er is gebruikgemaakt van gemaksteekproeven om geschikte patiënten te identificeren die waren opgenomen met een acuut myocardinfarct (AMI). Dezelfde geschiktheidscriteria en screeningsprocedures zijn toegepast op alle potentiële deelnemers. Omdat gemaksteekproeven selectiebias kunnen introduceren, is deze potentiële bron van bias meegewogen bij de interpretatie van de generaliseerbaarheid van de bevindingen.
In totaal werden 287 patiënten gescreend, waarvan er 27 niet werden geïncludeerd. Acht patiënten hadden eerder een myocardinfarct doorgemaakt, zes waren niet in staat de studieassessments te voltooien vanwege een verminderd bewustzijn of cognitieve functiestoornissen, vijf hadden andere organische hartaandoeningen, vier hadden maligne tumoren, multi-orgaanfalen of andere ernstige systemische ziekten, en vier weigerden deelname. De resterende 260 patiënten werden in de studie geïncludeerd.
Geschiktheidscriteria en definitie van de nullijn
Patiënten werden geïncludeerd als zij een vastgestelde klinische diagnose van AMI hadden, hun eerste episode van myocardinfarct doormaakten, ≥18 jaar oud waren, een intact bewustzijn en voldoende cognitieve functie hadden om de beoordelingen van de studie te begrijpen en te voltooien, en schriftelijke geïnformeerde toestemming hadden gegeven. Patiënten met andere organische hartaandoeningen, maligne tumoren, multi-orgaanfalen of andere ernstige systemische organische ziekten werden uitgesloten.
De inschrijving was beperkt tot patiënten met een eerste myocardinfarct om heterogeniteit te verminderen die geassocieerd is met eerdere infarcten, eerdere revascularisatie, chronische functionele beperkingen na een infarct en reeds bestaande aanpassingen in zelfzorg of rehabilitatie, waarvan ze allemaal onafhankelijk de initiële verpleegkundige afhankelijkheid en de daaropvolgende trajectpatronen kunnen beïnvloeden.
T1 werd gedefinieerd als het tijdstip na een succesvolle spoedbehandeling en het herstel van het bewustzijn, waarbij de deelnemer in staat was om de vereiste beoordelingen betrouwbaar uit te voeren.
Verzameling van demografische en cardiovasculaire klinische gegevens
Een specifiek voor de studie ontwikkelde algemene informatievragenlijst werd gebruikt om gegevens te verzamelen over leeftijd, geslacht, body mass index (BMI), burgerlijke staat, classificatie van de hartfunctie, type myocardinfarct, reperfusiestrategie en voorgeschiedenis van onderliggende aandoeningen. Demografische en psychosociale informatie werd verkregen via vragenlijstbeoordeling en inzage in medische dossiers, naar gelang van de situatie. Cardiovasculaire klinische kenmerken, waaronder de classificatie van de hartfunctie, het type myocardinfarct, de reperfusiestrategie en de voorgeschiedenis van onderliggende aandoeningen, werden op basis van vooraf gedefinieerde definities uit de medische dossiers van de indexopname gehaald. De classificatie van de hartfunctie werd uit het medische dossier van de indexopname gehaald en voor de analyse ingedeeld in Klasse I–II of Klasse III–IV. Het type myocardinfarct werd geclassificeerd als ST-segment elevatie myocardinfarct (STEMI) of non-ST-segment elevatie myocardinfarct (NSTEMI) op basis van de diagnose die tijdens de indexopname was vastgesteld. De voorgeschiedenis van onderliggende aandoeningen werd dichotoom gecodeerd als nee (0) of ja (1), waarbij "ja" aangaf dat er ten minste één vooraf gedefinieerde chronische comorbiditeit in de medische voorgeschiedenis was gedocumenteerd.
Percutane coronaire interventie (PCI) en trombolytische therapie werden geregistreerd op basis van de behandeling die daadwerkelijk is ontvangen tijdens de indexopname, in plaats van het beoogde behandelplan. De oorspronkelijke continue waarden voor leeftijd en BMI werden behouden voor de statistische analyse.
Herhaalde beoordeling van de verpleegkundige afhankelijkheid
De Care Dependency Scale (CDS5) werd afgenomen op T1. De schaal bevat 15 items. Elk item werd gescoord van 1 (volledig afhankelijk) tot 5 (bijna onafhankelijk), wat resulteerde in een totale score variërend van 15 tot 75. Hogere scores duidden op een grotere mate van onafhankelijkheid en een lagere verpleegkundige afhankelijkheid. Volgens de vastgestelde CDS-classificatie duiden scores van 60–69 op een beperkte mate van zorgafhankelijkheid, terwijl scores van 70–75 duiden op bijna volledige onafhankelijkheid; daarom werd in de huidige studie een totale CDS-score <70 beschouwd als indicatief voor verpleegkundige afhankelijkheid4,5.
De CDS-beoordeling werd herhaald op dag 3 na opname (T2), bij ontslag (T3) en 1 maand na ontslag (T4). Om inconsistenties in de metingen te minimaliseren, werden bij alle beoordelingen dezelfde instructies, itemvolgorde, scoreregels en assistentieprocedures gehanteerd. De T4-beoordeling vond plaats tijdens de geplande follow-up één maand na ontslag, ofwel persoonlijk in de polikliniek, ofwel telefonisch wanneer een persoonlijk bezoek niet mogelijk was. In beide situaties nam een getraind lid van het onderzoeksteam alle CDS-items af met behulp van dezelfde gestandaardiseerde instructies, itemvolgorde en scorecriteria.
Alle 260 geïncludeerde deelnemers voltooiden de CDS op alle vier de tijdstippen, en er was geen uitval van deelnemers tijdens de observatieperiode van 1 maand.
Baseline psychosociale beoordeling
De Hamilton Depression Rating Scale met 17 items (HAMD-17)6 werd eenmalig afgenomen op T1. Items 1–3, 7–1, 15 en 17 werden gescoord van 0 tot 4, terwijl items 4–6, 12–14 en 16 werden gescoord van 0 tot 2. De scores per item werden opgeteld om een totaalscore tussen 0 en 54 te verkrijgen, waarbij hogere scores duiden op ernstigere depressieve symptomen.
De Generalized Anxiety Disorder-7 (GAD-7)7 werd eenmaal afgenomen op T1. Elk van de zeven items werd gescoord van 0 (helemaal niet) tot 3 (bijna elke dag), wat resulteerde in een totale score variërend van 0 tot 21. Hogere scores duidden op ernstigere angstsymptomen.
De Social Support Rating Scale (SSRS)8 werd eenmalig afgenomen op T1. De schaal bestond uit 10 items. Items 1–4 en 8–10 werden beoordeeld op een 4-puntschaal van 1 tot 4; item 5 werd gescoord van 1 tot 4 op basis van het gerapporteerde niveau van steun; en items 6 en 7 werden gescoord op basis van het aantal beschikbare steunbronnen. De totale score varieerde van 12 tot 6, waarbij hogere scores duidden op meer sociale steun.
Alle CDS- en psychosociale beoordelingen werden afgenomen of begeleid door getrainde leden van het onderzoeksteam. Voorafgaand aan de inschrijving van deelnemers kregen de beoordelaars gestandaardiseerde training in het afnemen van de vragenlijsten, de interpretatie van items, de toegestane ondersteuning en de scoreprocedures. Gedurende de gehele studie werden dezelfde gestandaardiseerde instructies, itemvolgorde en scorecriteria gehanteerd. Het was niet vereist dat dezelfde beoordelaar een individuele deelnemer op elk tijdstip evalueerde; consistentie tussen beoordelaars werd gewaarborgd door gestandaardiseerde training en uniforme beoordelingsprocedures. Deelnemers werden gevraagd de vragenlijsten zoveel mogelijk zelfstandig in te vullen. Wanneer deelnemers problemen ondervonden met lezen, begrip of schrijven, werd gestandaardiseerde één-op-één ondersteuning geboden zonder antwoorden te suggereren, items namens de deelnemer te interpreteren of de antwoorden van de deelnemer te wijzigen.
Kwaliteitscontrole van gegevens en omgang met ontbrekende gegevens
Voorafgaand aan het afnemen van de vragenlijst werden de deelnemers geïnformeerd over het doel van het onderzoek, de procedures voor voltooiing en de vertrouwelijkheidseisen. Voor alle deelnemers werden gestandaardiseerde instructies en identieke beoordelingsprocedures gehanteerd. De ingevulde vragenlijsten werden onmiddellijk gecontroleerd op weggelaten of duidelijk ongeldige antwoorden. Wanneer een item onbeantwoord was gebleven, werd de deelnemer gevraagd het weggelaten item te herzien en, indien gewenst, een antwoord te geven. Wanneer ondersteuning bij de vragenlijst nodig was, suggereerden, interpreteerden of verstrekten de medewerkers van de studie geen antwoorden namens de deelnemer. Klinische variabelen werden geëxtraheerd aan de hand van vooraf gedefinieerde definities, en de ingevulde formulieren werden geverifieerd vóór de gegevensinvoer.
Alle 260 deelnemers voltooiden de CDS-beoordelingen op T1–T4, zonder uitval tijdens de follow-up. De longitudinale CDS-gegevens en de demografische, klinische en psychosociale variabelen die in de gerapporteerde analyses waren opgenomen, waren volledig. Daarom werden alle 260 deelnemers in de analyses opgenomen en was er geen data-imputatie nodig.
Groei-mengmodelanalyse van longitudinale CDS-scores
Growth mixture modeling (GMM) werd uitgevoerd met Mplus versie 8.3. Er werd een ongeconditioneerd GMM-model zonder covariabelen gefit, waarbij CDS_T1, CDS_T2, CDS_T3 en CDS_T4 werden ingevoerd als continue manifeste variabelen.
Oplossingen met één tot vijf klassen werden sequentieel gefit met behulp van robuuste maximum likelihood-schatting (MLR). Om het risico op convergentie naar een lokaal maximum te verminderen, werden 1.0 willekeurige sets startwaarden gegenereerd, waarvan de beste 200 werden behouden voor de optimalisatie in de laatste fase. Voor elke oplossing werden een normale beëindiging, replicatie van de beste log-likelihood over de willekeurige starts en de afwezigheid van ontoelaatbare parameterschattingen bevestigd.
Het Akaike Information Criterion (AIC), Bayesian Information Criterion (BIC), steekproefomvang-gecorrigeerd BIC (aBIC), entropie, Lo-Mendell-Rubin gecorrigeerde likelihood-ratio test (LMR-LRT) en bootstrap likelihood-ratio test (BLRT) werden voor elke oplossing genoteerd. Lagere AIC-, BIC- en aBIC-waarden werden geïnterpreteerd als een indicatie van een betere relatieve modelfit, terwijl entropiewaarden dichter bij 1 wezen op een duidelijkere scheiding tussen de klassen.
Elke k-klasse oplossing werd vergeleken met de corresponderende k − 1 oplossing met behulp van de LMR-LRT en BLRT. Het uiteindelijke model werd niet uitsluitend geselecteerd op basis van afnemende informatiecriteria; convergentiestabiliteit, klassegrootte, posterior lidmaatschapskanselijkheden, parsimonie en klinische interpreteerbaarheid werden tevens meegewogen. Elke deelnemer werd toegewezen aan de klasse met de hoogste posterior lidmaatschapskanselijkheid, en klasse-specifieke gemiddelde posterior kanselijkheden werden berekend als een aanvullende maat voor de classificatiekwaliteit.
Analyse van herhaalde CDS-metingen
Om binnen-proefpersoon veranderingen in CDS-scores over T1, T2, T3 en T4 in de totale cohort te evalueren, werd eenweg herhaalde-metingen variantieanalyse (RM-ANOVA) uitgevoerd met het meetmoment als binnen-proefpersoon factor. De aannames van benaderde normaliteit en sfericiteit werden getoetst. Sfericiteit werd geëvalueerd met de toets van Mauchly, en Greenhouse–Geisser-gecorrigeerde resultaten werden gebruikt wanneer de aanname van sfericiteit werd geschonden. Alle toetsen waren tweezijdig, en P < 0.05 werd beschouwd als statistisch significant.
Univariante vergelijkingen over trajectklassen
Analyses anders dan GMM werden uitgevoerd met IBM SPSS Statistics versie 26.0. Leeftijd, BMI, HAMD-17, SSRS en GAD-7 scores werden geanalyseerd als continue variabelen zonder categorisering.
Continue variabelen met eenApproximately normale verdeling werden uitgedrukt als gemiddelde ± standaarddeviatie en vergeleken tussen de vier trajectklassen met behulp van eenweg-variantieanalyse. Categorische variabelen werden uitgedrukt als deelnemersaantallen en vergeleken met de Pearson chi-kwadraat-toets. Alle P-waarden waren tweezijdig, en P < 0,05 werd gebruikt als drempelwaarde voor het identificeren van variabelen voor opname in het initiële multivariabele model.
In de univariate analyse voldeden leeftijd, burgerlijke staat, classificatie van de hartfunctie, type myocardinfarct, PCI, trombolytische therapie, HAMD-17 score, SSRS score, GAD-7 score en voorgeschiedenis van onderliggende aandoeningen aan het criterium P < 0,05 en werden daarom opgenomen in het initiële multivariabele model. Geslacht en BMI voldeden niet aan dit criterium.
Multinomiale logistische regressie en modeldiagnostiek
De vier trajectklassen werden behandeld als een nominale uitkomst, en er werd een multinomiale logistische regressie uitgevoerd in plaats van een binaire logistische regressie. C1 (Hoge Onafhankelijkheid-Langzame Verbetering) werd aangewezen als de referentiecategorie voor de uitkomst.
Alle variabelen met P < 0,05 in de univariate analyses werden opgenomen in het initiële model. Vervolgens werd backward likelihood-ratio selectie toegepast, waarbij variabelen met P > 0,10 sequentieel werden verwijderd. Statistisch significante hoofdeffecten werden behouden in het definitieve model.
Multicollineariteit werd beoordeeld aan de hand van tolerantiewaarden en de variance inflation factor (VIF). In de definitieve analyse varieerden de tolerantiewaarden van ongeveer 0,81 tot 0,97 en de VIF-waarden van 1,03 tot 1,24, wat aantoont dat er geen sprake was van substantiële multicollineariteit.
Het testen van interacties werd beperkt tot vooraf gespecificeerde, klinisch plausibele termen om het risico op overfitting te verminderen. Drie vooraf gespecificeerde interacties — leeftijd × geschiedenis van onderliggende ziekten, burgerlijke staat × SSRS-score en HAMD-17-score × GAD-7-score — werden individueel geëvalueerd met likelihood-ratio-toetsen. De overeenkomstige P-waarden waren respectievelijk 0,65, 0,301 en 0,908; daarom werden geen van de interactietermen behouden.
De algehele modelprestatie werd geëvalueerd met behulp van de likelihood-ratio-toets ten opzichte van het intercept-only-model; Pearson- en deviance goodness-of-fit-toetsen; Cox-Snell, Nagelkerke en McFadden pseudo-R2-statistieken; classificatienauwkeurigheid; convergentie; en een beoordeling van volledige of quasi-volledige separatie.
Voor alle definitieve predictoren werden gecorrigeerde odds ratio's (ORs) met 95% betrouwbaarheidsintervallen (CIs) gerapporteerd voor de vergelijkingen C2 versus C1, C3 versus C1 en C4 versus C1. Brede CIs werden geïnterpreteerd als een indicatie van beperkte precisie in plaats van definitief bewijs voor grote effectgroottes.
Overwegingen en rapportage van de steekproefgrootte
Er werd geen enkele universele drempelwaarde voor de steekproefomvang toegepast op het GMM. De adequaatheid van de steekproef werd beoordeeld in relatie tot de modelcomplexiteit, klasseproporties, klassescheiding, patronen van ontbrekende gegevens, entropie, posterior-waarschijnlijkheden en convergentie9.
Er is geen formele a priori simulatiegebaseerde powerberekening uitgevoerd, omdat het onderzoek een exploratief longitudinaal onderzoek was op basis van de beschikbare geschikte populatie gedurende de vooraf gedefinieerde wervingsperiode. De uiteindelijke oplossing met vier klassen bestond uit 6, 54, 90 en 50 deelnemers en leverde een entropiewaarde op van 0,879, met gemiddelde posterior-waarschijnlijkheden variërend van 0,871 tot 0,927.
Voor multinomiale logistische regressie werd de adequaatheid van de steekproef beoordeeld met betrekking tot het aantal deelnemers in elke uitkomstcategorie en het aantal potentiële predictorparameters10. Omdat sommige trajectklassen relatief klein waren, werd de regressieanalyse geïnterpreteerd als een explorerende associatieanalyse in plaats van als de ontwikkeling van een definitief voorspellingsmodel.
De observationele studie is gerapporteerd in overeenstemming met het Strengthening the Reporting of Observational Studies in Epidemiology (STROBE)-raamwerk, inclusief het studieontwerp, de setting, de deelnemersstroom, de gegevensbronnen, potentiële bronnen van bias, de omvang van de studie, de statistische methoden, de omgang met ontbrekende gegevens, de belangrijkste resultaten, de beperkingen en de generaliseerbaarheid.
Resultaten
Deelnemersstroom en volledigheid
Tijdens de wervingsperiode werden 287 patiënten met AMI beoordeeld op geschiktheid. Zevenentwintig patiënten werden niet geïncludeerd: acht hadden een eerder myocardinfarct doorgemaakt, zes waren niet in staat de studiebeoordelingen te voltooien vanwege een verminderd bewustzijn of cognitieve functies, vijf hadden andere organische hartaandoeningen, vier hadden maligne tumoren,多orgaanfalen of andere ernstige systemische ziekten, en vier weigerden deelname. De overige 260 deelnemers namen deel aan de studie, voltooiden alle vier de CDS-beoordelingen tot 1 maand na ontslag en werden opgenomen in het uiteindelijke GMM en de daaropvolgende analyses. Er waren geen ontbrekende longitudinale CDS-waarden, geen uitval tijdens de follow-up en geen ontbrekende demografische, klinische of psychosociale gegevens waarvoor imputatie nodig was in de gerapporteerde analyses.
Selectie van het GMM met vier klassen
De fit-indices verbeterden progressief van de éénklasse- naar de vierklasse-oplossing (Tabel 1). De vierklasse-oplossing leverde AIC = 6978.826, BIC = 7047.822, aBIC = 6978.741, entropie = 0.879, LMR-LRT P = 0.027 en BLRT P < 0.001 op. De door het model geschatte klassenproporties waren 25.8%, 21.0%, 34.1% en 19.1%. Wanneer een vijfde klasse werd toegevoegd, namen AIC, BIC en aBIC bescheiden af tot respectievelijk 6963.213, 7038.208 en 6962.613, en steeg de entropie naar 0.912. Echter, noch de LMR-LRT (P = 0.128) noch de BLRT (P = 0.063) wezen op een statistisch significante verbetering. Daarnaast bestond de vijfde klasse slechts uit 6.4% van de steekproef. Daarom werd het vierklasse-model behouden, omdat dit de gewenste balans bood tussen model fit, stabiliteit, parsimonie, klassengrootte en klinische interpreteerbaarheid.
Convergentie en classificatiekwaliteit
De oplossing met vier klassen werd normaal beëindigd, en de optimale log-likelihood werd 18 keer gereproduceerd over verschillende willekeurige startpunten. Er werden geen ontoelaatbare parameterschattingen waargenomen. De gemiddelde posterior-waarschijnlijkheden voor het lidmaatschap van de meest waarschijnlijke klasse waren 0,914 voor C1, 0,889 voor C2, 0,927 voor C3 en 0,871 voor C4, wat wijst op een acceptabele klassenseparatie.
Totale verpleegkundige afhankelijkheid over de tijd
De gemiddelde totale CDS-scores waren 48,28 ± 10,25 bij T1, 54,16 ± 14,33 bij T2, 52,82 ± 12,17 bij T3 en 56,58 ± 15,15 bij T4. Een één-weg ANOVA voor herhaalde metingen toonde een significant algemeen verschil in CDS-scores over de vier meetmomenten aan (F = 13,692, P < 0,001). Op groepsniveau stegen de CDS-scores op dag 3, daalden ze licht bij ontslag en stegen ze opnieuw 1 maand na ontslag. De grotere variabiliteit die bij latere tijdstippen werd waargenomen, suggereerde dat het algemene gemiddelde patroon aanzienlijke heterogeniteit tussen de deelnemers maskeerde.
Trajectoriepatronen
De toewijzing aan klassen identificeerde zeer waarschijnlijk vier trajecten: C1, Hoge Onafhankelijkheid-Langzame Verbetering (n = 66, 25,4%); C2, Matige Afhankelijkheid-Snelle Verslechtering (n = 54, 20,8%); C3, Hoge Afhankelijkheid-Significante Verbetering (n = 90, 34,6%); en C4, Hoge Afhankelijkheid-Langzame Verergering (n = 50, 19,2%; Figuur 1). De gemiddelde CDS-scores voor C1 waren respectievelijk 55,50, 59,00, 60,00 en 64,00 bij T1–T4; die voor C2 waren 50,00, 49,00, 39,00 en 39,00; die voor C3 waren 43,22, 59,35, 61,86 en 70,90; en die voor C4 waren 46,00, 44,00, 42,00 en 40,00.
Univariante klassevergelijkingen
De leeftijd verschilde significant tussen C1–C4 (respectievelijk 58.20 ± 7.80, 61.50 ± 7.40, 55.80 ± 7.60 en 63.10 ± 7.20 jaar; F = 12.572, P < 0.001; Tabel 2). De BMI verschilde niet significant tussen de klassen (respectievelijk 23.60 ± 2.70, 23.40 ± 2.80, 23.80 ± 2.90 en 23.50 ± 2.60 kg/m2; F = 0.270, P = 0.847), en de geslachtsverdeling was ook vergelijkbaar (χ2 = 0.142, P = 0.986). Significante verschillen werden waargenomen voor de burgerlijke staat (χ2 = 14.749, P = 0.002), de classificatie van de hartfunctie (χ2 = 15.283, P = 0.002), het type myocardinfarct (χ2 = 15.035, P = 0.002), PCI (χ2 = 12.863, P = 0.005), trombolytische therapie (χ2 = 15.622, P = 0.001) en de voorgeschiedenis van onderliggende ziekten (χ2 = 27.903, P < 0.001).
De gemiddelde HAMD-17-scores waren respectievelijk 10,80 ± 2,70, 13,10 ± 2,90, 11,20 ± 2,60 en 14,10 ± 3,00 voor C1–C4 (F = 19,040, P < 0,001). De gemiddelde SSRS-scores waren respectievelijk 43,00 ± 4,80, 38,50 ± 5,00, 42,00 ± 4,90 en 36,80 ± 5,10 (F = 20,742, P < 0,001), en de gemiddelde GAD-7-scores waren respectievelijk 9,50 ± 2,50, 12,10 ± 2,80, 10,00 ± 2,60 en 13,70 ± 3,00 (F = 30,585, P < 0,001).
Definitieve multinomiale regressie
Kandidaat-predictoren werden gecodeerd zoals weergegeven in Tabel 3. Backward likelihood-ratio selectie hield leeftijd, burgerlijke staat, HAMD-17, SSRS, GAD-7 en voorgeschiedenis van onderliggende ziekten aan in het uiteindelijke multinomiale logistische regressiemodel (Tabel 4). Voor C2 versus C1 was het getrouwd zijn geassocieerd met een lagere kans op lidmaatschap van C2 (gecorrigeerde OR = 0,241, 95% BI = 0,095–0,612, P = 0,003), terwijl hogere HAMD-17-scores (OR = 1,324, 95% BI = 1,121–1,564), hogere GAD-7-scores (OR = 1,374, 95% BI = 1,160–1,626), lagere SSRS-scores (OR = 0,787, 95% BI = 0,711–0,871) en een voorgeschiedenis van onderliggende ziekten (OR = 3,107, 95% BI = 1,212–7,968) geassocieerd waren met lidmaatschap van C2. Leeftijd was in deze vergelijking niet statistisch significant (P = 0,089). Voor C3 versus C1 was leeftijd de enige statistisch significante behouden predictor (OR = 0,954, 95% BI = 0,912–0,997, P = 0,036).
Voor C4 versus C1 waren een hogere leeftijd (OR = 1.077, 95% BI = 1.005–1.154), een ongehuwde status (gehuwd: OR = 0.248, 95% BI = 0.085–0.720), hogere HAMD-17-scores (OR = 1.466, 95% BI = 1.214–1.772), lagere SSRS-scores (OR = 0.727, 95% BI = 0.646–0.819), hogere GAD-7-scores (OR = 1.605, 95% BI = 1.318–1.955) en een geschiedenis van onderliggende aandoeningen (OR = 4.454, 95% BI = 1.511–13.134) geassocieerd met lidmaatschap van C4.
Modeldiagnostiek
Het uiteindelijke multinomiale model zorgde voor een significante verbetering ten opzichte van het model met enkel een intercept (likelihood-ratio χ2 = 190,966, df = 18, P < 0,001). De goodness-of-fit tests van Pearson (χ2 = 745,020, df = 759, P = 0,635) en deviance (χ2 = 515,576, df = 759, P > 0,999) wezen niet op een slechte modelpassing. De pseudo-R2-waarden van Cox-Snell, Nagelkerke en McFadden waren respectievelijk 0,520, 0,557 en 0,270, en de classificatienauwkeurigheid was 53,1%. Het model convergeerde na zeven iteraties, zonder bewijs van volledige of quasi-volledige separatie. Enkele schattingen voor een geschiedenis van onderliggende ziekten hadden relatief brede 95% BI's, wat duidt op een beperkte precisie en een voorzichtige interpretatie van deze associaties ondersteunt.
DATAbeschikbaarheid:
De ruwe gegevens die de bevindingen van deze studie ondersteunen, worden bij het artikel geleverd als Aanvullend Bestand 1.
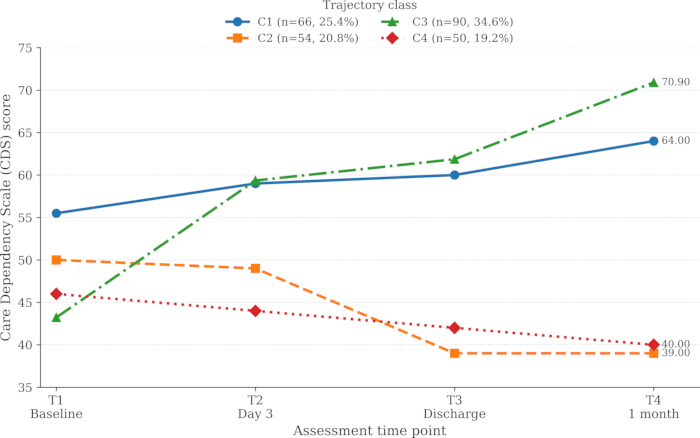
Figuur 1: Longitudinale trajecten van verpleegkundige afhankelijkheid bij patiënten met een acuut myocardinfarct. De vier latente trajectklassen geïdentificeerd door GMM waren Hoge Onafhankelijkheid-Langzame Verbetering (C1, n = 66, 25,4%), Matige Afhankelijkheid-Snelle Verslechtering (C2, n = 54, 20,8%), Hoge Afhankelijkheid-Significante Verbetering (C3, n = 90, 34,6%) en Hoge Afhankelijkheid-Langzame Verergering (C4, n = 50, 19,2%). T1 vertegenwoordigt de baseline na succesvolle spoedeisende hulp en herstel van het bewustzijn; T2 vertegenwoordigt dag 3 na opname; T3 vertegenwoordigt het ontslag; en T4 vertegenwoordigt 1 maand na ontslag. De y-as vertegenwoordigt de klasse-specifieke gemiddelde CDS-score, waarbij hogere scores duiden op een grotere onafhankelijkheid en een lagere verpleegkundige afhankelijkheid. Afkortingen: AMI = acuut myocardinfarct; CDS = Care Dependency Scale; GMM = growth mixture modeling. Klik hier om een grotere versie van deze figuur te bekijken.
| Model | AIC | BIC | aBIC | Entropie | LMR-LRT p-waarde | BLRT p-waarde | Klasseproportie (%) |
| 1 | 7353.11 | 7384.108 | 7355.567 | — | — | — | — |
| 2 | 7141.412 | 7184.409 | 7156.355 | 0.726 | 0.002 | <0.001 | 48.2/51.8 |
| 3 | 7032.275 | 7086.271 | 7049.704 | 0.813 | 0.015 | <0.001 | 35.1/42.7/22.2 |
| 4 | 6978.826 | 7047.822 | 6978.741 | 0.879 | 0.027 | <0.001 | 25.8/21.0/34.1/19.1 |
| 5 | 6963.213 | 7038.208 | 6962.613 | 0.912 | 0.128 | 0.063 | 29.7/31.2/20.4/12.3/6.4 |
Tabel 1: Fit-indices voor growth mixture models met één tot vijf klassen van trajecten van verpleegkundige afhankelijkheid. Lagere waarden voor het informatiecriterium duiden op een betere relatieve modelfit, terwijl entropiewaarden dichter bij 1 duiden op een duidelijkere scheiding van klassen. De LMR-LRT en BLRT vergelijken een model met k klassen met het overeenkomstige model met k − 1 klassen. Klasseproporties zijn door het model geschatte proporties; definitieve aantallen en percentages deelnemers zijn gebaseerd op de meest waarschijnlijke posterior klasse-toewijzing. Afkortingen: AIC = Akaike Information Criterion; BIC = Bayesian Information Criterion; aBIC = sample-size-adjusted Bayesian Information Criterion; LMR-LRT = Lo-Mendell-Rubin adjusted likelihood-ratio test; BLRT = bootstrap likelihood-ratio test.
| Item | Classificatie | Hoge onafhankelijkheid-langzame verbetering (C1) (n = 66) | Matige afhankelijkheid-snelle achteruitgang (C2) (n = 54) | Hoge afhankelijkheid-significante verbetering (C3) (n = 90) | Hoge afhankelijkheid-langzame verergering (C4) (n = 50) | Statistiek | P waarde |
| Leeftijd (jaar) | − | 58.20 ± 7.80 | 61.50 ± 7.40 | 55.80 ± 7.60 | 63.10 ± 7.20 | 12.572 | <0.001 |
| Geslacht | Mannelijk | 43 | 35 | 58 | 31 | 0.142 | 0.986 |
| Vrouwelijk | 23 | 19 | 32 | 19 | |||
| BMI (kg/m²) | — | 23.60 ± 2.70 | 23.40 ± 2.80 | 23.80 ± 2.90 | 23.50 ± 2.60 | 0.27 | 0.847 |
| Burgerlijke staat | Gehuwd | 46 | 24 | 64 | 25 | 14.749 | 0.002 |
| Ongehuwd / Gescheiden / Weduwe(naar) | 20 | 30 | 26 | 25 | |||
| Classificatie van de hartfunctie | Klasse I–II | 41 | 22 | 60 | 20 | 15.283 | 0.002 |
| Klasse III–IV | 25 | 32 | 30 | 30 | |||
| Type myocardinfarct | ST-segmentelevatie | 50 | 35 | 44 | 37 | 15.035 | 0.002 |
| Niet-ST-segmentelevatie | 16 | 19 | 46 | 13 | |||
| Percutane coronaire interventie | Ja | 45 | 38 | 62 | 21 | 12.863 | 0.005 |
| Nee | 21 | 16 | 28 | 29 | |||
| Trombolytische therapie | Ja | 52 | 49 | 66 | 29 | 15.622 | 0.001 |
| Nee | 14 | 5 | 24 | 21 | |||
| HAM-D score | − | 10.80 ± 2.70 | 13.10 ± 2.90 | 11.20 ± 2.60 | 14.10 ± 3.00 | 19.04 | <0.001 |
| SSRS-score | − | 43.00 ± 4.80 | 38.50 ± 5.00 | 42.00 ± 4.90 | 36.80 ± 5.10 | 20.742 | <0.001 |
| GAD-7-score | - | 9.50 ± 2.50 | 12.10 ± 2.80 | 10.00 ± 2.60 | 13.70 ± 3.00 | 30.585 | <0.001 |
| Geschiedenis van onderliggende ziekten | Ja | 20 | 32 | 28 | 34 | 27.903 | <0.001 |
| Nee | 46 | 22 | 62 | 16 |
Tabel 2: Univariabele analyse van kenmerken over de trajectklassen van verpleegkundige afhankelijkheid. Continue variabelen worden weergegeven als gemiddelde ± standaarddeviatie en zijn vergeleken met behulp van eenweg-variantieanalyse. Categorische variabelen worden weergegeven als deelnemersaantallen en zijn vergeleken met behulp van Pearson chi-kwadraat-toetsen. Alle P-waarden zijn tweezijdige globale vergelijkingen over de vier trajectklassen. Afkortingen: BMI = body mass index; HAMD-17 = 17-item Hamilton Depression Rating Scale; SSRS = Social Support Rating Scale; GAD-7 = Generalized Anxiety Disorder-7; PCI = percutane coronaire interventie.
| Variabele | Omschrijving van de opdracht |
| Leeftijd | Ingevoerd als oorspronkelijke waarde |
| Burgerlijke staat | Ongehuwd/Gescheiden/Weduwe(naar) = 0; Gehuwd = 1 |
| Classificatie van de hartfunctie | Klasse Ⅰ, Ⅱ = 0; Klasse Ⅲ, Ⅳ = 1 |
| Type infarct | Geen ST-segmentelevatie = 0; ST-segmentelevatie = 1 |
| Interventionele therapie | Nee = 0; Ja = 1 |
| Trombolytische therapie | Nee = 0; Ja = 1 |
| HAMD-score | Ingevoerd als oorspronkelijke waarde |
| SSRS-score | Ingevoerd als oorspronkelijke waarde |
| GAD-7-score | Ingevoerd als oorspronkelijke waarde |
| Anamnese van onderliggende ziekten | Nee = 0; Ja = 1 |
Tabel 3: Codering van kandidaat-predictoren voor multinomiale logistische regressie. Leeftijd, HAMD-17, SSRS en GAD-7 werden ingevoerd met behulp van hun oorspronkelijke continue waarden. Voor dichotome variabelen diende de categorie die als 0 werd gecodeerd als referentiecategorie: ongehuwd/gescheiden/weduwe/-naar voor burgerlijke staat; hartfunctie Klasse I–II; NSTEMI; geen PCI; geen trombolytische therapie; en geen voorgeschiedenis van onderliggende aandoeningen. Afkortingen: HAMD-17 = Hamilton Depression Rating Scale met 17 items; SSRS = Social Support Rating Scale; GAD-7 = Generalized Anxiety Disorder-7; NSTEMI = non-ST-segment elevation myocardinfarct; PCI = percutane coronaire interventie.
| Groepsvergelijking | Variabele | β | SE | Wald χ²² | P | Gecorrigeerde OR (95% BI) |
| C2 versus C1 | Leeftijd | 0.052 | 0.03 | 2.885 | 0.089 | 1.053 (0.992–1.118) |
| Getrouwd | −1.422 | 0.475 | 8.951 | 0.003 | 0.241 (0.095–0.612) | |
| HAMD-17 | 0.281 | 0.085 | 10.893 | <0.001 | 1.324 (1.121–1.564) | |
| SSRS | −0.240 | 0.052 | 21.236 | <0.001 | 0.787 (0.711–0.871) | |
| GAD-7 | 0.317 | 0.086 | 13.607 | <0.001 | 1.374 (1.160–1.626) | |
| Onderliggende aandoeningen | 1.134 | 0.48 | 5.567 | 0.018 | 3.107 (1.212–7.968) | |
| C3 versus C1 | Leeftijd | −0.047 | 0.023 | 4.389 | 0.036 | 0.954 (0.912–0.997) |
| Getrouwd | 0.085 | 0.367 | 0.054 | 0.817 | 1.088 (0.531–2.233) | |
| HAMD-17 | 0.053 | 0.064 | 0.682 | 0.409 | 1.054 (0.930–1.195) | |
| SSRS | −0.048 | 0.034 | 1.982 | 0.159 | 0.953 (0.891–1.019) | |
| GAD-7 | 0.078 | 0.066 | 1.375 | 0.241 | 1.081 (0.949–1.231) | |
| Onderliggende aandoeningen | 0.019 | 0.374 | 0.003 | 0.959 | 1.020 (0.490–2.123) | |
| C4 tegenover C1 | Leeftijd | 0.074 | 0.035 | 4.438 | 0.035 | 1.077 (1.005–1.154) |
| Getrouwd | −1.394 | 0.544 | 6.574 | 0.01 | 0.248 (0.085–0.720) | |
| HAMD-17 | 0.383 | 0.097 | 15.733 | <0.001 | 1.466 (1.214–1.772) | |
| SSRS | −0.318 | 0.06 | 27.91 | <0.001 | 0.727 (0.646–0.819) | |
| GAD-7 | 0.473 | 0.101 | 22.111 | <0.001 | 1.605 (1.318–1.955) | |
| Onderliggende aandoeningen | 1.494 | 0.552 | 7.332 | 0.007 | 4.454 (1.511–13.134) |
Tabel 4: Multinomiale logistische regressieanalyse van factoren geassocieerd met het lidmaatschap van het traject van verpleegkundige afhankelijkheid. C1, Hoge Onafhankelijkheid-Langzame Verbetering, werd gespecificeerd als de referentiecategorie. Gecorrigeerde OR's en 95% CI's worden gerapporteerd voor C2 versus C1, C3 versus C1 en C4 versus C1. Het uiteindelijke hoofdeffectmodel werd verkregen via backward likelihood-ratio selectie. Het uiteindelijke model vertoonde een significante verbetering ten opzichte van het intercept-only model (likelihood ratio χ2 = 190.966, df = 18, P < 0.001), met een Nagelkerke pseudo-R2 van 0.557 en een algehele classificatienauwkeurigheid van 53,1%. Afkortingen: OR = odds ratio; CI = betrouwbaarheidsinterval; HAMD-17 = Hamilton Depression Rating Scale met 17 items; SSRS = Social Support Rating Scale; GAD-7 = Generalized Anxiety Disorder-7.
Aanvullend bestand 1: Ruwe gegevens ter ondersteuning van de bevindingen van deze studie.Klik hier om dit bestand te downloaden.
Discussie
De longitudinale veranderingen in verpleegkundige afhankelijkheid moeten descriptief worden geïnterpreteerd. Op het niveau van de volledige cohort was de gemiddelde CDS-score 48,28 ± 10,25 op T1, wat wijst op aanzienlijke behoeften aan verpleegkundige zorg in de vroege fase na een AMI1. De CDS-score steeg naar 54,16 ± 14,3 op T2 tijdens de acute behandeling en het vroege herstel12, nam bescheiden af tot 52,82 ± 12,17 bij ontslag, en steeg opnieuw naar 56,58 ± 15,15 één maand na ontslag. Voorgaand onderzoek heeft uitdagingen belicht met betrekking tot deelname aan cardiale rehabilitatie na een AMI13; de huidige studie heeft echter niet direct beoordeeld of deelname aan rehabilitatie of andere specifieke factoren verantwoordelijk waren voor de waargenomen temporele veranderingen. Latente-klasse-analyse toonde verder aan dat het algemene gemiddelde patroon vier wezenlijk verschillende trajecten maskeerde. Deze heterogeniteit is breed consistent met eerder onderzoek naar cardiovasculaire trajecten, waaronder trajecten van gezondheidsgerelateerde kwaliteit van leven na een AMI14 en zelfzorgtrajecten bij patiënten met coronaire hartziekten15. Verschillen in het aantal en de vorm van de klassen tussen studies kunnen verschillen weerspiegelen in de gemeten constructen, beoordelingsschema's, patiëntenpopulaties, follow-up duur en benaderingen van latente-klasse-modellering.
Verschillende protocolstappen zijn cruciaal voor de reproduceerbaarheid. Ten eerste moet T1 consistent worden gedefinieerd. De nulmeting moet plaatsvinden na een succesvolle spoedbehandeling en het herstel van het bewustzijn, aangezien een eerdere beoordeling eerder een voorbijgaande klinische instabiliteit kan vastleggen dan een betrouwbare functionele toestand. Ten tweede moet de toediening van de CDS worden gestandaardiseerd over alle vier de tijdspunten, omdat wijzigingen in instructies of ondersteuningsprocedures kunstmatige longitudinale verschillen kunnen introduceren. Ten derde moeten de initiële psychosociale beoordelingen duidelijk worden onderscheiden van de herhaalde CDS-beoordelingen. De HAMD-17, GAD-7 en SSRS werden één keer afgenomen bij T1, terwijl de CDS herhaaldelijk werd afgenomen bij T1–T4. Ten slotte moet GMM worden gefit met voldoende willekeurige startwaarden en worden geëvalueerd door de optimale log-likelihood, toelaatbare parameterschattingen, posterior-waarschijnlijkheden en klinisch relevante klasgroottes te repliceren, in plaats van deze uitsluitend te selecteren op basis van dalende AIC- of BIC-waarden.
De selectie van de oplossing met vier klassen illustreert een belangrijke overweging bij mengselmodellering. Het toevoegen van een vijfde klasse verminderde de informatiecriteria gering op en verhoogde de entropie; de oplossing met vijf klassen vertoonde echter geen statistisch significante verbetering volgens noch de LMR-LRT (P = 0,128) noch de BLRT (P = 0,063) en introduceerde een kleine subgroep die slechts 6,4% van de steekproef omvatte met beperkte aanvullende klinische differentiatie. In soortgelijke toepassingen mag elke extra klasse daarom niet automatisch worden geïnterpreteerd als een betekenisvolle biologische of klinische subgroep. Een eenvoudigere oplossing moet opnieuw worden overwogen wanneer een model een zeer kleine klasse produceert, een instabiele convergentie vertoont, een niet-gereproduceerde optimale log-likelihood oplevert, onwaarschijnlijke trajecten produceert of aanzienlijke veranderingen in de klassensamenstelling vertoont als reactie op kleine wijzigingen in de startwaarden. Omgekeerd kan een statistisch eenvoudiger model ongepast zijn als het klinisch verschillende, duidelijk gescheiden longitudinale patronen samenvoegt.
De analyse van geassocieerde factoren moet worden geïnterpreteerd als verkennend in plaats van predictief of causaal. Leeftijd vertoonde klasse-specifieke associaties met het trajectlidmaatschap. Vorige prospectieve studies bij patiënten met AMI hebben een hogere leeftijd geïdentificeerd als een belangrijke correlaat van een subsequent verval in de gezondheidstoestand en de activiteiten van het dagelijks leven16,17. De burgerlijke staat was ook geassocieerd met het trajectlidmaatschap, en een systematische review en meta-analyse hebben associaties gerapporteerd tussen de burgerlijke staat of partnerstatus en door de patiënt gerapporteerde uitkomsten na een myocardinfarct18. Een lagere waargenomen sociale steun is geassocieerd met een slechtere gezondheidstoestand en depressieve symptomen na AMI19, terwijl psychische nood na een myocardinfarct klinisch ook relevant is20. Prospectief bewijs heeft een lage waargenomen sociale steun verder gekoppeld aan slechtere fysieke en mentale gezondheidsuitkomsten na AMI21. Een voorgeschiedenis van onderliggende ziekten was geassocieerd met verschillende trajectvergelijkingen in de huidige studie, en eerder bewijs heeft multimorbiditeit gekoppeld aan functionele beperkingen bij patiënten met een voorgeschiedenis van AMI2. Desalniettemin heeft de huidige analyse de fysiologische, gedragsmatige of psychosociale mechanismen die ten grondslag liggen aan deze associaties niet geëvalueerd. De bevindingen mogen daarom niet worden geïnterpreteerd als bewijs dat het modificeren van deze factoren noodzakelijkerwijs het lidmaatschap van een trajectklasse zou veranderen.
Deze methode kent verschillende beperkingen. De studie werd uitgevoerd in één enkel centrum met behulp van gemaksteekproeven, wat kan hebben geleid tot selectiebias en de externe validiteit kan hebben beperkt. Alleen patiënten die een eerste myocardinfarct ondergingen werden geïncludeerd; daarom is het mogelijk dat de geïdentificeerde trajectstructuur niet generaliseerbaar is naar patiënten met recidieven. De follow-up eindigde 1 maand na ontslag, waardoor een beoordeling van de vraag of de vier trajectklassen over langere perioden stabiel blijven, niet mogelijk was. Belangrijke cardiovasculaire variabelen, waaronder de linkerventrikelejectiefractie, Killip-klasse, kenmerken van het schuldige vat, procedureel succes, complicaties in het ziekenhuis, gedetailleerde medicamenteuze therapie, B-type natriuretisch peptide, inspanningstolerantie en deelname aan gestructureerde cardiale rehabilitatie, werden niet systematisch meegenomen. Residuële confounding gerelateerd aan ziekte-ernst, behandelintensiteit en rehabilitatiestatus kan daarom niet worden uitgesloten.
Een verdere beperking heeft betrekking op de precisie van sommige klasse-specifieke regressieschattingen. Er is geen formele a priori simulatiegebaseerde steekproefgrootteberekening uitgevoerd. Hoewel het vier-klasse GMM een stabiele convergentie en een bevredigende classificatiekwaliteit vertoonde, waren sommige trajectgroepen relatief klein. Brede betrouwbaarheidsintervallen voor geselecteerde schattingen, in het bijzonder die voor een geschiedenis van onderliggende ziekten, dienen daarom met voorzichtigheid te worden geïnterpreteerd. Grotere prospectieve multicenter-cohorten met langere follow-upperioden, uitgebreidere cardiovasculaire fenotypering en onafhankelijke replicatie zijn nodig om de geïdentificeerde klassestructuur en de daarmee geassocieerde factoren te bevestigen. Ondanks deze beperkingen biedt het gecombineerde repeated-CDS- en GMM-raamwerk een praktische aanpak voor het identificeren van heterogene patronen in het vroege herstel en kan dit een meer geïndividualiseerde verpleegkundige beoordeling en follow-up bij AMI-populaties faciliteren.
Openbaarmakingen
De auteurs verklaren dat er geen concurrerende belangen zijn. Er zijn geen tools voor kunstmatige intelligentie (AI) gebruikt bij de voorbereiding, het schrijven, het bewerken of het genereren van figuren voor dit manuscript.
BIJDRAGEN VAN DE AUTEURS:
Alle auteurs hebben bijgedragen aan het concept en het ontwerp van de studie, de gegevensverzameling en interpretatie, en de voorbereiding en revisie van het manuscript. Alle auteurs hebben de definitieve versie van het manuscript beoordeeld en goedgekeurd en gaan ermee akkoord verantwoordelijk te zijn voor alle aspecten van het werk
Dankbetuigingen
De auteurs danken de patiënten die aan het onderzoek hebben deelgenomen en het klinische personeel dat heeft geholpen bij het afnemen van de vragenlijsten, de gegevensverzameling en de follow-up. Dit onderzoek heeft geen specifieke subsidie ontvangen van enige financieringsinstantie in de publieke, commerciële of non-profitsector.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Care Dependency Scale (CDS) | Dijkstra A, Buist G, Dassen T | N/A | Originele schaal voor beoordeling van zorgafhankelijkheid in de verpleegkunde met 15 items; hogere scores duiden op een grotere onafhankelijkheid. |
| Care Dependency Scale, Chinese versie | Zhang SQ, Zhu YM, Li L, et al. | N/A | Chinese versie/validatiebron geciteerd in het manuscript en gebruikt ter ondersteuning van de toepassing van de CDS in deze studie. |
| Vragenlijst voor Algemene Informatie | Studieteam, Linquan County People’s Hospital | Door studie ontwikkeld; geen catalogusnummer | Studie-specifiek formulier gebruikt voor het verzamelen van leeftijd, geslacht, BMI, burgerlijke staat, classificatie van de hartfunctie, type MI, reperfusiestrategie en voorgeschiedenis van onderliggende aandoeningen. |
| Generalized Anxiety Disorder-7 (GAD-7) | Spitzer RL, Kroenke K, Williams JBW, Löwe B | N/A | Gepubliceerde angstschaal met 7 items, eenmaal afgenomen bij de nulmeting (T1). |
| Hamilton Depression Rating Scale, 17-item (HAMD-17) | Hamilton M | N/A | Gepubliceerde depressieschaal beoordeeld door een clinicus; de scoremethode met 17 items werd gebruikt bij de nulmeting (T1). |
| IBM SPSS Statistics | IBM Corp. | Versie 26.0 | Statistische software gebruikt voor beschrijvende statistiek, eenweg-ANOVA, chi-kwadraattoetsen en multinomiale logistische regressie. |
| IBM SPSS Statistics 26 Documentatie | IBM Corp. | Documentatie versie 26 | Officiële documentatiebron voor IBM SPSS Statistics 26. |
| Mplus | Muthén & Muthén | Versie 8.3 | Statistische software gebruikt voor het fitten van growth mixture-modellen met één tot vijf klassen; Versie 8.3 werd uitgebracht op 30 april 2019. |
| Mplus User's Guide | Muthén & Muthén | Achtste Editie / Versie 8 | Officiële gebruikersdocumentatie voor Mplus Versie 8, gebruikt als methodologische softwarebron. |
| Social Support Rating Scale (SSRS) | Xiao SY | N/A | Gepubliceerde Chinese schaal voor sociale steun met 10 items, eenmaal afgenomen bij de nulmeting (T1). |
| STROBE Cohortstudie Checklist | STROBE Initiative | Cohortstudie-checklist | Rapportagechecklist gebruikt om de volledigheid van het verslag van de longitudinale observationele studie te beoordelen. |
| STROBE Statement | STROBE Initiative | Richtlijn 207 | Rapportagerichtlijn voor observationele studies; gebruikt als rapportagebron voor studiedesign, deelnemers, bias, statistische methoden, resultaten en beperkingen. |
Referenties
- Cai D, et al. Sex differences in outcomes in patients with acute myocardial infarction. BMC Cardiovasc Disord. 2025;25(1):272.
- Liu M, et al. A patient with acute myocardial infarction with electrocardiogram Aslanger's pattern. BMC Cardiovasc Disord. 2024;24(1):3.
- Yu F, Yuan X, Fu S. Optimizing emergency nursing protocols to enhance outcomes in patients with acute myocardial infarction: a retrospective study. Medicine (Baltimore). 2025;104(23):e41412.
- Guo J, Chen Y, Dai Y, Chen Q, Wang X. Influencing factors of care dependence in patients with coronary heart disease after percutaneous coronary intervention: a cross-sectional study. Nurs Open. 2023;10(1):241-251.
- Zhang SQ, Zhu YS, Li L, Ye WQ. Reliability and validity analysis of the Chinese version of the Care Dependency Scale for elderly patients. J Nurs Sci. 2014;29(3):7-9. [in Chinese].
- Li CQ, Zhong GK. Application of several commonly used mental health rating scales in psychiatry. Chin J Clin Rehabil. 2005;(12):34. [in Chinese].
- Spitzer RL, Kroenke K, Williams JBW, Löwe B. A brief measure for assessing generalized anxiety disorder: the GAD-7. Arch Intern Med. 2006;166(10):1092-1097.
- Xiao SY. The theoretical basis and research application of the Social Support Rating Scale. J Clin Psychiatry. 1994;4(2):98-100. [in Chinese].
- Muthén LK, Muthén BO. How to use a Monte Carlo study to decide on sample size and determine power. Struct Equ Modeling. 2002;9(4):599-620.
- Pate A, et al. Minimum sample size for developing a multivariable prediction model using multinomial logistic regression. Stat Methods Med Res. 2023;32(3):555-571.
- Shen Y, et al. Observation on the application effect of stressor perception and response meticulous nursing in the perioperative period of acute myocardial infarction. Altern Ther Health Med. 2024;30(1):63-67.
- Nakamura K, Ohbe H, Uda K, Fushimi K, Yasunaga H. Early rehabilitation after acute myocardial infarction: a nationwide inpatient database study. J Cardiol. 2021;78(5):456-462.
- Wang L, Liu J, Fang H, Wang X. Factors associated with participation in cardiac rehabilitation in patients with acute myocardial infarction: a systematic review and meta-analysis. Clin Cardiol. 2023;46(11):1450-1457.
- Munyombwe T, et al. Quality of life trajectories in survivors of acute myocardial infarction: a national longitudinal study. Heart. 2020;106(1):33-39.
- Ingadóttir B, Svavarsdóttir MH, Jurgens CY, Lee CS. Self-care trajectories of patients with coronary heart disease: a longitudinal, observational study. Eur J Cardiovasc Nurs. 2024;23(7):780-788.
- Hajduk AM, Dodson JA, Murphy TE, Chaudhry SI. A risk model for decline in health status after acute myocardial infarction among older adults. J Am Geriatr Soc. 2023;71(4):1228-1235.
- Hajduk AM, et al. Risk model for decline in activities of daily living among older adults hospitalized with acute myocardial infarction: the SILVER-AMI study. J Am Heart Assoc. 2020;9(19):e015555.
- Zhu C, Tran PM, Leifheit EC. Association of marital/partner status and patient-reported outcomes following myocardial infarction: a systematic review and meta-analysis. Eur Heart J Open. 2023;3(2):oead018.
- Leifheit-Limson EC, et al. The role of social support in health status and depressive symptoms after acute myocardial infarction: evidence for a stronger relationship among women. Circ Cardiovasc Qual Outcomes. 2010;3(2):143-150.
- Levine GN, et al. Post-myocardial infarction psychological distress: a scientific statement from the American Heart Association. Circulation. 2025;152(16):e298-e310.
- Bucholz EM, et al. Effect of low perceived social support on health outcomes in young patients with acute myocardial infarction: results from the VIRGO (Variation in Recovery: Role of Gender on Outcomes of Young AMI Patients) study. J Am Heart Assoc. 2014;3(5):e001252.
- Bagai A, et al. Multimorbidity, functional impairment, and mortality in older patients stable after prior acute myocardial infarction: insights from the TIGRIS registry. Clin Cardiol. 2022;45(12):1277-1286.