Deze computationele studie presenteert een compartiment-bewuste workflow voor het benchmarken van openbare transcriptomen van respiratoire virussen, waarbij wordt aangetoond dat gastheerresponsen in de neus en het bloed een beperkte concordantie op genniveau vertonen, maar toch reproduceerbare, biologisch interpreteerbare compartiment-specifieke modules opleveren over onafhankelijke datasets, klinische vergelijkingen, longitudinale herstelprocessen en robuustheidsanalyses.
Onderzoeksartikel
Compartiment-bewuste benchmarking van transcriptomen van respiratoire virussen voor gastresponsmodules in neus- en bloedmonsters: een computationele studie
In dit artikel
Samenvatting
Samenvatting
Openbare transcriptomen van respiratoire virussen zijn waardevol voor het bestuderen van gastheerresponsen, maar verschillen in weefselbron, definitie van controles en studieontwerp kunnen gepoolde analyses vertroebelen. We hebben een compartiment-bewuste computationele workflow ontwikkeld om te bepalen of reproduceerbare activiteit van de gastheerrespons kan worden geïdentificeerd terwijl de biologische context van neus en bloed behouden blijft. De gepaarde pediatrische cohort GSE17827 diende als ankerdataset, bestaande uit transcriptomen van neusswabs en volbloed bij symptomatische picornavirusinfectie, symptomatische infectie met het respiratoir syncytieel virus, asymptomatische detectie van picornavirus en virus-negatieve controles. Na filtering door het HUGO Gene Nomenclature Committee (HGNC) werden 27.685 genen geanalyseerd. Afzonderlijke proteïne-coderende neus- en bloedmodules van 50 genen werden gedefinieerd op basis van de sterkste positieve responsen en vastgelegd vóór externe evaluatie. Effecten op genniveau in neus en bloed waren vrijwel onafhankelijk (Pearson r = 0,015), en de modules deelden zes verkennende genen met een overlap in rangschikking (Jaccard-index = 0,064). Desondanks scheidde de neusmodule infectie van controles in onafhankelijke cohorten van de bovenste luchtwegen, met areas under the receiver operating characteristic curve (AUROC's) van 0,749, 0,693 en 0,609, terwijl de bloedmodule AUROC's behaalde van 0,832, 0,924 en 0,870 in externe bloedcohorten. In longitudinale gegevens van natuurlijke infecties namen de gematchte scores af van acute ziekte tot ontslag, met gepaarde delta's van 0,436 voor neusmonsters en 0,30 voor bloed. Drie aanvullende benchmarkdatasets bestaande uit 6 externe monsters, samen met random-gene nulls, module-size sweeps, bootstrap-stabiliteit, marker-programma-correlaties en variantiepartitionering, definieerden de robuustheid en beperkingen van de workflow. De Pandya 3-messenger ribonucleïnezuur (mRNA) set bleef sterker voor discriminatie tussen viraal en bacterieel, terwijl de bloedmodule ook toenam bij bacteriële pneumonie. Deze bevindingen ondersteunen compartiment-specifieke modules als herbruikbare scores voor gastheerrespons-activiteit voor cohortvergelijking en het volgen van herstel, in plaats van universele pan-weefsel biomarkers of op zichzelf staande pathogeenclassificatoren.
Inleiding
Transcriptomische signaturen van de gastheer worden op grote schaal gebruikt om infectieuze syndromen te classificeren en immuunresponsen tussen verschillende pathogenen te vergelijken1,2,3,4,5. Respiratoire virussen activeren vaak overlappende interferon-gestimuleerde genen (ISG's), inflammatoire mediatoren en antigenpresentatie-routes6,7,8,9,10. Recente gepaarde en longitudinale studies tonen daarnaast aan dat lokale responsen in de luchtwegen en systemische responsen kunnen verschillen in timing, cellulaire compositie en magnitude11. Dit vraagstuk beperkt zich niet alleen tot influenza, het respiratoir syncytieel virus (RSV), rhinovirus en SARS-CoV-2. Het humaan metapneumovirus blijft een belangrijke oorzaak van luchtweginfecties, maar de literatuur over de respons van de gastheer en interventies is nog in ontwikkeling12,13. Deze waarnemingen bij diverse respiratoire virusinfecties benadrukken verder de verschillen tussen lokale responsen in de luchtwegen en systemische responsen van de gastheer14. Voor computationele gastheer-virusstudies is de praktische vraag daarom niet alleen of er een respons bestaat. De vraag is of publieke data hergebruikt kunnen worden via een transparante workflow die de weefselcontext behoudt en reproduceerbare scores voor de respons van de gastheer oplevert.
De meeste openbare transcriptoomdatasets van respiratoire virussen waren niet ontworpen voor zuivere cross-virus- of cross-weefselinferentie. Weefselbron, timing, ernst, leeftijd, controledefinitie en platform variëren vaak gelijktijdig. High-throughput expressiedatasets zijn bovendien gevoelig voor ongewenste technische variatie en variatie op studieniveau15,16. Een gepoolde analyse kan daarom een sterke interferon- of inflammatoire signatuur blootleggen, terwijl de oorsprong ervan wordt versluierd. Neusmonsters leggen de epitheliale en mucosale immuunbiologie vast, terwijl volbloed systemische leukocytenresponsen weerspiegelt. Het behandelen van deze compartimenten als uitwisselbaar maakt een score eenvoudig te berekenen, maar moeilijk te interpreteren.
We hebben de analyse gebaseerd op GSE17827, een gepaarde neus-bloedcohort uit dezelfde studie, in plaats van op de grootste beschikbare discovery-collectie17. De cohort is klein, maar het vermindert confounding tussen studies wanneer de effectgroottes van neus en bloed worden vergeleken. Het omvat symptomatische picornavirusinfectie, symptomatische RSV-infectie, asymptomatische picornavirusdetectie en virusnegatieve controles. We hebben het daarom uitsluitend gebruikt als anker voor afzonderlijke compartimentspecifieke modules. Het lidmaatschap van de modules werd vastgelegd vóór de externe testen. De stabiliteit van de selectie uit de kleine cohort werd onderzocht middels gestratificeerde bootstrap-resampling, random-gene nulls en gevoeligheidsanalyses van de modulegrootte.
We hebben een benchmarkinglaag toegevoegd met bacteriële en niet-infectieuze comparatoren. GSE6390 bevat volbloedmonsters van acute luchtweginfecties, gelabeld als viraal, bacterieel of niet-infectieus18. GSE4012 bevat monsters van ernstige community-acquired pneumonie, systemisch inflammatoir responssyndroom (SIRS) en gezonde controles19. Deze cohorten testen of een module een algemene gastrespons-activiteit of pathogeen-klasse-specificiteit weerspiegelt. GSE53543 werd afzonderlijk geanalyseerd als een ex vivo benchmark voor rhinovirus-perturbatie van perifere bloedmononucleaire cellen (PBMC). Dit meet de leukocytenrespons onder een gecontroleerde stimulus, maar is niet gelijk aan een natuurlijke infectie.
Onze uitgangspunten zijn bewust conservatief. We proberen geen universele antivirale signatuur aan te tonen op basis van heterogene publieke data. In plaats daarvan onderzoeken we of een compartiment-bewuste workflow modulescores kan produceren die nuttig blijven na externe toetsing. Het beoogde gebruik is complementair aan diagnostische classificeerders zoals Pandya 3-mRNA. Deze modules scoren de gastheerresponsactiviteit in het neusslijmvlies en in het bloed over verschillende cohorten, herstelstadia en symptoomgradiënten heen. Ze zijn niet ontworpen om de klasse van het pathogeen vast te stellen.
Protocol
In deze studie werden gedeïdentificeerde, openbaar beschikbare gegevens opnieuw geanalyseerd; er was geen sprake van nieuwe werving, interventie of monstername. Institutionele ethische goedkeuring en nieuwe geïnformeerde toestemming waren daarom niet vereist voor de huidige secundaire analyse. Ethische goedkeuring en geïnformeerde toestemming voor de oorspronkelijke studies werden gerapporteerd door de respectievelijke generatoren van de gegevens.
Studie-ontwerp en workflow-logica
We hebben een retrospectieve bioinformatica-studie uitgevoerd met publieke data met behulp van datasets die zijn gedeponeerd in de Gene Expression Omnibus20,21. Er zijn geen nieuwe patiëntmonsters, celcultuur-experimenten, diermodellen of wet-lab validaties gegenereerd. De workflow maakte gebruik van een anchor-first ontwerp. GSE17827 werd gebruikt voor de schatting van de effectgrootte, moduleconstructie, cross-compartiment concordantie en symptoomgradiëntanalyse. Onafhankelijke datasets werden pas geïntroduceerd nadat het modulelidmaatschap was vastgesteld. De workflow bestond uit paired-compartment anchoring, HGNC-mapping en eiwitcoderende filtering, afzonderlijke constructie van neus- en bloedmodules, weefsel-gematchte en longitudinale validatie, klinische benchmarking en robuustheidsanalyses. De bevestigende analyses bestonden uit de vastgelegde weefsel-gematchte en longitudinale tests. De overlap-gen, symptoomgradiënt, marker-programma en variantie-analyses waren explorerend of beschrijvend.
Ankercohort en primaire contrastanalyse
GSE17827 bevat expressieprofielen van neusswabs en volbloed van 26 kinderen: 9 symptomatische picornavirusgevallen, 5 asymptomatische picornavirusdetecties, 6 symptomatische RSV-gevallen en 6 asymptomatische virusnegatieve controles17. Bij twee RSV-gevallen ontbraken bloedmonsters. Het volledige ankerontwerp bevatte daarom 50 monsters, en de primaire contrastanalyse tussen geïnfecteerd versus controle bevatte 40 monsters nadat asymptomatische picornavirusdetecties waren uitgesloten van de moduleconstructie. Voor de primaire contrastanalyse werden symptomatische picornavirus- en symptomatische RSV-monsters geclassificeerd als geïnfecteerd, en asymptomatische virusnegatieve monsters als controles. Asymptomatische picornavirusdetecties werden niet als controles beschouwd, omdat virale detectie zonder symptomen biologisch verschilt van virusnegatieve gezondheid. Deze monsters werden buiten de moduleconstructie gehouden en later gebruikt voor een symptoomgradiëntanalyse.
Probe-mapping en preprocessing
GSE17827 werd geprofileerd op GPL23126. Transcript-cluster-identificatoren werden gekoppeld aan gensymbolen met behulp van het Clariom D Human na36, hg38 annotatiebestand dat is verspreid via GEO-platform GPL24539. Alleen HGNC-goedgekeurde symbolen werden behouden2. Controleprobes, ERCC-probes, niet-gemapte transcriptclusters en niet-goedgekeurde symbolen werden verwijderd. Meerdere transcriptclusters die naar hetzelfde goedgekeurde symbool mappen, werden samengevoegd op basis van de mediaanexpressie. Na filtering en samenvoeging waren 27.685 genen beschikbaar voor de anchor-analyse. Een log₂(x + 1) transformatie werd alleen toegepast wanneer het 95ste percentiel van de expressiematrix 50 overschreed, wat duidt op een niet-gelogde intensiteitsschaal. Genen met meer dan 20% missende waarden werden verwijderd; de resterende missende waarden werden vervangen door de mediaan binnen het gen. Elk gen werd vervolgens gestandaardiseerd over alle monsters in die dataset als z = (x − gemiddelde)/standaarddeviatie van het monster (ddof = 1). Genen met nulvariantie kregen een gestandaardiseerde waarde van 0 toegewezen. De constructie van modules werd beperkt tot vermeldingen die in de volledige HGNC-set zijn geclassificeerd als proteïnecoderende genen.
Analyse van de effectgrootte en moduleconstructie
Neus- en bloedcompartimenten werden afzonderlijk geanalyseerd. Symptomatische virale monsters werden vergeleken met virusnegatieve controles met behulp van Hedges g gestandaardiseerde gemiddelde verschillen en tweezijdige Welch-toetsen23. Hedges g werd berekend als het verschil tussen het gemiddelde van de geïnfecteerde groep en de controlegroep, gedeeld door de gepoolde standaarddeviatie en vermenigvuldigd met de correctie voor kleine steekproeven 1 − 3/(4df − 1), waarbij df = ninfected + ncontrol − 2. Welch-toetsen werden uitgevoerd met ongelijke varianties. Benjamini–Hochberg false discovery rates werden berekend voor alle geteste genen binnen elk compartiment24. Omdat geen enkel proteïne-coderend gen voldeed aan de vooraf gespecificeerde strikte combinatie van FDR < 0,05 en Hedges g > 0,8 in de kleine ankercohort, werden genen met een positief effect eerst gerangschikt op basis van een oplopende tweezijdige Welch P-waarde, en vervolgens op basis van een aflopende Hedges g, waarbij het gensymbool als definitieve tie-breaker diende. De top 50 genen vormden elk primair module. Vijftig genen werden a priori gekozen als een gematigde modulegrootte die biologische breedte behield, terwijl het verlies van ontbrekende genen over verschillende platforms werd beperkt. Deze modulegrootte werd niet afgestemd op de externe AUROC. Sensitiviteitsanalyses met 10, 25, 50, 100 en 20 genen gaven hetzelfde kwalitatieve resultaat voor de ankerscheiding. Het doel was reproduceerbaarheid op moduleniveau, niet de ontdekking van individuele genen.
Overeenstemming tussen compartimenten
Schattingen van Hedges g in neus- en bloedmonsters werden per gen op elkaar afgestemd en vergeleken met behulp van Pearson- en Spearman-correlaties. De overlap tussen de top 50 neusmodules en de top 50 bloedmodules werd samengevat door het aantal overlappende genen en de Jaccard-index. Overlappende genen werden geïnterpreteerd als verkennende kandidaten voor rangorde-overlap tussen compartimenten, in plaats van gevalideerde geconserveerde biomarkers.
Externe weefselspecifieke validatie
Voor de validatie van de module-score werden onafhankelijke openbare datasets met interpreteerbare brongroepen gebruikt. De validatie voor de bovenste luchtwegen omvatte RSV-neusspoelingmonsters uit GSE41374 en de SARS-CoV-2-datasets GSE152075 en GSE156063. De bloedvalidatie omvatte GSE17110 en twee afzonderlijk genormaliseerde GSE3890-eenheden: GPL1058 (36 monsters; 28 RSV en 8 controles) en GPL684 (138 monsters; 107 RSV en 31 controles). Voor elke externe dataset werden probes gekoppeld aan HGNC-symbolen, en dubbele symbolen werden samengevoegd op basis van de mediaanexpressie. Dezelfde transformatie, filtering van ontbrekende waarden, mediaanimputatie en regels voor z-standaardisatie per gen die voor de ankerdataset waren gebruikt, werden binnen elke dataset toegepast. Een module-score werd berekend als het ongewogen gemiddelde van de gestandaardiseerde expressiewaarden voor de vertegenwoordigde modulegenen. AUROC, gemiddelde precisie en Welch-test FDR werden gerapporteerd als draagbaarheidsmetrieken, niet als schattingen van de klinische diagnostische prestaties.
Grote klinische benchmark- en ex vivo perturbatie-datasets
Twee whole-blood datasets werden gebruikt als klinische benchmarks in plaats van als discovery-cohorten. In GSE6390 werden monsters op basis van de gedeponeerde metadata over infectiestatus toegewezen aan virale luchtweginfectie (n = 17), bacteriële luchtweginfectie (n = 73) of niet-infectieuze aandoening (n = 90); monsters zonder een van deze ondubbelzinnige labels werden uitgesloten18. In GSE4012 werden de gedeponeerde diagnosevelden gekoppeld aan influenza A-pneumonie (n = 39), bacteriële pneumonie zonder influenza (n = 61), SIRS zonder pneumonie (n = 40), gezonde controles (n = 36) of gemengde bacteriële/influenza-pneumonie (n = 14)19. Gemengde bacteriële/influenza-monsters werden beschreven, maar uitgesloten van binaire benchmark-contrasten.
GSE53543 bevat 196 ex vivo PBMC-profielen van 98 individuen. Elk individu leverde één monster met alleen medium en één monster dat gedurende 24 h werd blootgesteld aan rhinovirus 16; subject-identificatoren bevestigden 98 volledige paren. De belangrijkste benchmark rapporteerde de AUROC over de 98 gestimuleerde en 98 ongestimuleerde monsters, omdat AUROC een rangscheidingsmetriek is. De koppeling van subjecten werd behouden in de metadata en gebruikt in een gepaarde sensitiviteitsanalyse van scoreverschillen. Dit experiment werd afzonderlijk geanalyseerd van natuurlijke klinische infectie en werd niet gebruikt om klinische diagnostische claims te ondersteunen.
Ruwe GEO-seriematrices werden gedownload voor GSE63990, GSE4012 en GSE53543. GPL571 werd gebruikt voor GSE63990, GPL6947 voor GSE4012 en GPL1058 voor GSE53543. Probes werden gekoppeld aan door HGNC goedgekeurde symbolen, en dubbele koppelingen werden samengevoegd op basis van de mediane expressie. Er werd gebruikgemaakt van gedeponeerde genormaliseerde matrices. De algemene 95e-percentielregel activeerde een log₂(x + 1) transformatie alleen voor matrices op een niet-logaritmische schaal. GSE53543 was door de oorspronkelijke onderzoekers al log₂-getransformeerd, rang-invariant genormaliseerd en gecorrigeerd voor de verwerkingsdag, waardoor er geen extra log-transformatie werd toegepast. Na het verwijderen van genen met meer dan 20% ontbrekende waarden en het imputeren van de resterende ontbrekende waarden met de mediaan, werd elk gen z-gestandaardiseerd over alle monsters binnen de betreffende dataset. De benchmarklaag bevatte 470 klinische volbloedmonsters en 196 ex vivo PBMC-monsters.
Referentiesignatuur-benchmarking
De anker-nasale en bloedmodules werden gebenchmarkt ten opzichte van drie ongewogen referentiesets. De officiële Pandya 33-mRNA-set werd overgenomen uit Aanvullende Tabel 1 van het oorspronkelijke classifier-rapport5. De Andres-Terre-comparator bestond uit 3 interferon-georiënteerde genen, gecureerd uit de gerapporteerde multi-virus-signatuur3. De Hallmark-comparator bestond uit een kernsubset van 3 interferon-alfa-genen die gekoppeld is aan de MSigDB HALLMARK_INTERFERON_ALPHA_RESPONSE-set25,26. Volledige genlijsten voor alle drie de referentiesets worden verstrekt in Aanvullende Gegevens 1. Deze referentiescores bootsen de oorspronkelijke gewogen classifiers niet na. Voor elke dataset werd een score berekend als het ongewogen gemiddelde van de beschikbare z-scores per gen; er waren ten minste drie vertegenwoordigde genen vereist, en het aantal vertegenwoordigde genen werd gerapporteerd. Benchmark-contrasten waren viraal versus bacterieel, viraal versus niet-infectieus, viraal versus bacterieel-of-niet-infectieus, viraal versus gezond/controle en bacterieel versus gezond/controle, waar de vereiste groepen beschikbaar waren. AUROC en gemiddelde precisie werden geïnterpreteerd als benchmarking-statistieken. Welch-test P-waarden werden gecorrigeerd met behulp van de Benjamini–Hochberg-procedure over alle geldige dataset-contrast-module-combinaties in de benchmarktabel.
Onafhankelijke longitudinale validatie
De gekoppelde datasets van acute fase versus ontslag GSE9741 en GSE9742 werden uitsluitend gebruikt voor longitudinale validatie27. Monsters die in de gedeponeerde metadata waren gelabeld als RSV-enkelinfectie (RSVsi) of rhinovirus (hRV) vormden de primaire analyse; RSV-co-infecties (RSVco) werden alleen behouden in de aanvullende output. Acute en ontslaglabels werden geëxtraheerd uit de monstertitels. Monsters werden gekoppeld op basis van dataset, compartiment, virusgroep en proefpersoon-identificatie, waarbij alleen proefpersonen met beide tijdspunten werden behouden. De primaire gecombineerde groep bestond uit 38 RSVsi- en 30 hRV-paren (68 paren per compartiment).
Geen genselectie, moduleverfijning of drempelwaarde-optimalisatie is toegepast op GSE9741 of GSE9742. Deze datasets werden gereserveerd voor externe validatie. Probe-identificatoren werden gekoppeld aan goedgekeurde HGNC-symbolen, en dubbele symbolen werden samengevoegd op basis van de mediaanexpressie. Dezelfde 95e-percentiel log-transformatie regel, filter voor ontbrekende waarden, mediaan-imputatie en procedures voor z-standaardisatie per gen binnen de dataset werden toegepast voordat de vaste GSE17827 module-scores werden berekend.
Voor elk weefsel en elke module werden de scores voor de acute fase en bij ontslag gekoppeld per proefpersoon en virusgroep. Het verschil tussen de acute fase en het ontslag werd voor elk paar berekend. De Cohen dz werd berekend als het gemiddelde gekoppelde verschil gedeeld door de standaarddeviatie van de steekproef. Tweezijdige gekoppelde t-toetsen en tweezijdige Wilcoxon-voorwaardelijke rangtoetsen werden gerapporteerd, samen met de AUROC voor de scheiding tussen de scores van de acute fase versus ontslag. Benjamini–Hochberg FDR-waarden werden berekend over alle 20 geldige gekoppelde t-toetsen in de volledige longitudinale output (twee datasets, twee modulebronnen en vijf vooraf gespecificeerde samenvattingen van virusgroepen).
Symptoomgradiënt- en post-hoc-analyse
Nadat het modulelidmaatschap was vastgesteld, werden de uitgesloten asymptomatische picornavirusdetecties in GSE17827 uitsluitend gebruikt voor de symptoomgradiëntanalyse. De ordinale klinische score was 0 voor virusnegatieve controles, 1 voor asymptomatische picornavirusdetecties en 2 voor symptomatische infectie. De Spearman-correlatie werd gebruikt om de ordinale trend te beoordelen, terwijl de Kruskal-Wallis-test de algemene verschillen tussen de drie groepen beoordeelde. Tweezijdige Mann-Whitney U post-hoc-testen vergeleken de drie groepsparen. De Benjamini-Hochberg-correctie werd per compartiment afzonderlijk toegepast op de familie van drie paarsgewijze vergelijkingen.
Functionele verrijking
Genen uit de nasale en bloedmodules werden geanalyseerd met Enrichr via gseapy met gebruik van de bibliotheken MSigDB Hallmark 2020, Reactome 202 en GO Biological Process 202325,26,28,29,30,31. Enrichr maakte gebruik van het standaard over-representatiekader gebaseerd op de exacte toets van Fisher. Door de bibliotheek gerapporteerde Benjamini–Hochberg-gecorrigeerde P waarden < 0,05 werden als significant beschouwd. De acht meest significante termen per module over de drie geraadpleegde bibliotheken werden gerangschikt op basis van de gecorrigeerde P waarde. Verrijkingsresultaten werden uitsluitend gebruikt voor interpretatie.
Robuustheids-, markerprogramma- en variantieanalyses
Robuustheidsanalyses testten of de resultaten afhankelijk waren van de modulegrootte of toevallige selectie. Modulegroottes van 10, 25, 50, 10 en 20 genen werden geëvalueerd. Voor de nulanalyse met willekeurige genen bestond het geschikte universum uit HGNC proteïne-coderende genen die vertegenwoordigd waren in de verwerkte GSE117827-matrix. Vijfhonderd sets van 50 genen werden zonder vervanging gesampled met een NumPy random seed van 2026062. Bootstrap-herselectie werd beperkt tot de 1.0 proteïne-coderende genen met een positief effect die het hoogst waren gerangschikt in de oorspronkelijke anchor-analyse voor elk compartiment. In elk resample werden de positieve proteïne-coderende genen gerangschikt op basis van een stijgende tweezijdige Welch P-waarde en vervolgens op basis van een dalend gemiddeld verschil. De top 50 genen werden geselecteerd. De genstabiliteit werd berekend als het aantal selecties gedeeld door 10. De 20 genen met de hoogste selectiefrequentie in elk compartiment werden weergegeven.
Scores van marker-programma's werden gebruikt als beschrijvende hulpmiddelen in plaats van als schattingen van celfracties. Zes gecureerde programma's werden geëvalueerd: epitheliaal (EPCAM, KRT8, KRT18, KRT19, MUC1, KRT5, KRT14, SCGB1A1, FOXJ1), monocyten/macrofagen (LYZ, LST1, S100A8, S10A9, FCGR3A, FCGR1A, CD14, MS4A7, CTSS), neutrofielen (S10A8, S10A9, MPO, ELANE, CEACAM8, FCGR3B, OLFM4, MMP8), T/NK (CD3D, CD3E, TRAC, NKG7, GNLY, PRF1, GZMB, KLRD1, IL7R), B/plasma (MS4A1, CD79A, CD79B, MZB1, JCHAIN, IGHG1, SDC1) en myeloïde interferon (SIGLEC1, IFI27, IFI4L, ISG15, MX1, OAS1, RSAD2, IFIT3). Elke programmascore werd berekend als het gemiddelde van de beschikbare z-scores per gen, waarbij minimaal drie vertegenwoordigde genen vereist waren. Spearman P-waarden werden gecorrigeerd met de Benjamini–Hochberg-procedure over de volledige familie van dataset-module-programmacorrelaties. Eénweg eta-kwadraat werd berekend als de som van kwadraten tussen de groepen gedeeld door de totale som van kwadraten voor elk module-factorpaar. Rijen waarin de relevante factor ontbrak, werden uitgesloten van die berekening. Deze analyse was beschrijvend en corrigeerde niet voor wederzijds gecorreleerde factoren.
Reproduceerbaarheid
Alle analyses werden uitgevoerd met gescripte workflows in Python 3.12.13, met de softwarepakketten en versies zoals vermeld in de Tabel met Materialen. Voor gerandomiseerde procedures werd een vaste seed van 2026062 gebruikt. Publieke GEO-expressiematrices werden verwerkt met een consistente projectstructuur waarin ruwe inputs, verwerkte gegevens, statistische outputs, tabellen en figuren waren gescheiden. Moduledefinities, records van steekproefcuratie, schattingen van de effectgrootte, validatiestatistieken, verrijkingsresultaten, robuustheidsanalyses en brondata voor figuren zijn bewaard gebleven ter ondersteuning van onafhankelijke verificatie. De analysecode, specificaties van afhankelijkheden en ondersteunende afgeleide gegevens zijn beschikbaar zoals beschreven in de verklaring over gegevensbeschikbaarheid.
Resultaten
Anchor-stap benchmarking maakte weefselspecifieke van pan-weefsel gen-effecten onderscheid
De gecureerde GSE17827 anchor-matrix bevatte 27.685 HGNC-goedgekeurde genen. Het primaire nasale contrast omvatte 15 symptomatische geïnfecteerde en 6 virus-negatieve controlemonsters; het bloedcontrast omvatte 13 symptomatische geïnfecteerde en 6 controles (Tabel 1). Omdat deze kleine cohort geen stabiele ontdekking van individuele genen kan ondersteunen, werd deze gebruikt als een gepaarde-compartiment anchor. Stabiliteit werd geëvalueerd op moduleniveau door middel van bootstrap-resampling, random-gene nul-testen, externe validatie en sensitiviteitsanalyses van de modulegrootte.
| [Tekst ontbreekt. Voer a.u.b. de brontekst in die vertaald moet worden.] | Groep | Conditie | Primair contrast | n |
| Bloed | RSV | Geïnfecteerd | Ja | 4 |
| Bloed | asymptomatisch picornavirus | Secundair | Nee | 5 |
| Bloed | Symptomatisch picornavirus | Geïnfecteerd | Ja | 9 |
| Bloed | Virusnegatieve controle | Controle | Ja | 6 |
| Neusaal | RSV | Geïnfecteerd | Ja | 6 |
| Neusaal | Asymptomatisch picornavirus | Secundair | Nee | 5 |
| Neusaal | Symptomatisch picornavirus | Geïnfecteerd | Ja | 9 |
| Neusaal | Virusnegatieve controle | Controle | Ja | 6 |
Tabel 1: Ontwerp van de GSE17827-ankerset na curatie van het primaire contrast. Monsterverdeling over bloed- en neuscompartimenten in de gepaarde ankerdataset na curatie van het primaire contrast. Symptomatische monsters van het respiratoir syncytieel virus (RSV) en symptomatische picornavirusmonsters werden geclassificeerd als geïnfecteerd en opgenomen in het primaire contrast, terwijl virusnegatieve controles werden geclassificeerd als controles en opgenomen in het primaire contrast. Asymptomatische picornavirusmonsters werden aangemerkt als secundair en uitgesloten van de moduleconstructie; deze werden uitsluitend gebruikt in de exploratieve analyse van de symptoomgradiënt. Bij twee RSV-gevallen ontbraken bloedmonsters, wat resulteerde in vier bloed- en zes neusmonsters van RSV.
Over de 27.685 gedeelde genen waren de Hedges g schattingen voor neus en bloed bijna niet gecorreleerd (Pearson r = 0,015; Figuur 1). Dit resultaat is voortgekomen uit één studie en is minder onderhevig aan verschillen tussen studies dan een gepoolde vergelijking over verschillende cohorten. De dichte centrale wolk laat zien dat de meeste genen in beide compartimenten niet op een vergelijkbare manier bewogen. De gemarkeerde overlappende genen waren uitzonderingen aan de top van beide ranglijsten. Dit patroon ondersteunt de constructie van afzonderlijke neus- en bloedmodules.
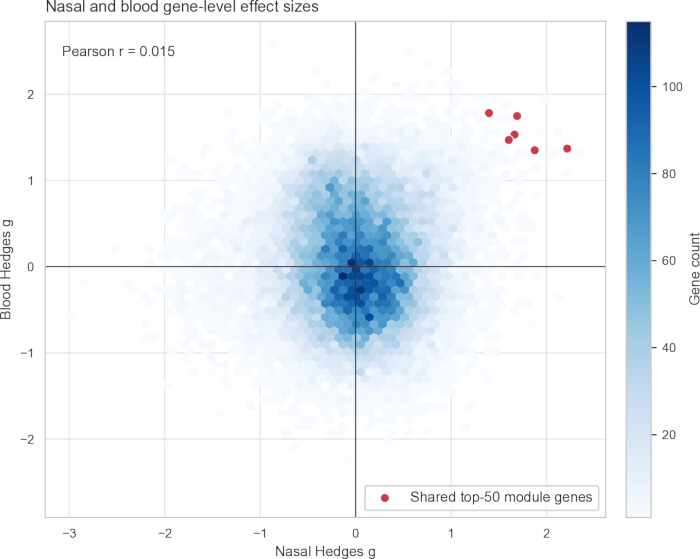
Figuur 1Effectgroottes op genniveau in neus- en bloedmonsters in de gepaarde GSE117827-ankercohort. Hegges g waarden vergelijken symptomatische infectie met virusnegatieve controles voor 27.685 genen. Nasale schattingen (15 geïnfecteerd, 6 controles) worden op de x-as weergegeven, en bloedschattingen (13 geïnfecteerd, 6 controles) worden op de y-as weergegeven. Hexagonale bin-schaduwing geeft het aantal genen per bin aan. Rode punten geven de zes genen aan die gedeeld worden tussen de top-50 nasale en bloedmodules. Pearson r = 0.015. Klik hier om een grotere versie van deze figuur te bekijken.
Moduleconstructie resulteerde in een kleine interferon-gecentreerde overlap
De top 50 neus- en bloedmodules deelden zes genen: ISG15, ACRBP, IFIT1, RSAD2, CCRL2 en XAF1 (Jaccard-index = 0,064; Tabel 2; Figuur 2). ISG15, IFIT1, RSAD2 en XAF1 zijn consistent met interferon-gerelateerde antivirale biologie32,3,34. CCRL2 kan beter worden geïnterpreteerd in de context van inflammatoire leukocytenmigratie35. ACRBP heeft geen vastgestelde antivirale rol. Alle zes de genen worden voor de transparantie gerapporteerd, maar geen van deze genen wordt geclaimd als een gevalideerde cross-tissue biomarker. Hun individuele FDR-waarden waren niet significant in de kleine ankercohort. De belangrijkste conclusie berust daarom op de vastgelegde validatie op moduleniveau, en niet op de overlaplijst.
| Gen | Neushechtingen g | Nasale FDR | Bloedheggen g | Bloed FDR | Interpretatie |
| ISG15 | 2.215 | 0.213 | 1.369 | 0.442 | Interferon-gestimuleerd antiviraal gen; verkennende overlap |
| ACRBP | 1.69 | 0.205 | 1.748 | 0.429 | Geen vastgestelde antivirale rol; behouden ter transparantie |
| IFIT1 | 1.875 | 0.213 | 1.35 | 0.442 | Interferon-gestimuleerd antiviraal gen; verkennende overlap |
| RSAD2 | 1.663 | 0.213 | 1.532 | 0.442 | Interferon-gestimuleerd antiviraal gen; verkennende overlap |
| CCRL2 | 1.396 | 0.217 | 1.782 | 0.442 | Context van inflammatoire leukocytenmigratie; niet virus-specifiek |
| XAF1 | 1.603 | 0.226 | 1.47 | 0.442 | Interferon-gekoppelde apoptosefactor; verkennende overlap |
Tabel 2: Volledige explorerende overlap tussen de hoogst gerangschikte neus- en bloedmodules. Voor alle zes de gedeelde genen worden de Hedges g voor neus en bloed en de gen-specifieke FDR-waarden gerapporteerd. Alle zes de genen worden beschouwd als explorerende rank-overlap-kandidaten omdat de gen-specifieke FDR-waarden niet significant waren in de kleine ankercohort. ACRBP is behouden ter transparantie, ondanks het ontbreken van een vastgestelde antivirale rol. Geen van de zes genen wordt gepresenteerd als een gevalideerde universele biomarker; het primaire bewijs is gebaseerd op externe validatie op moduleniveau.
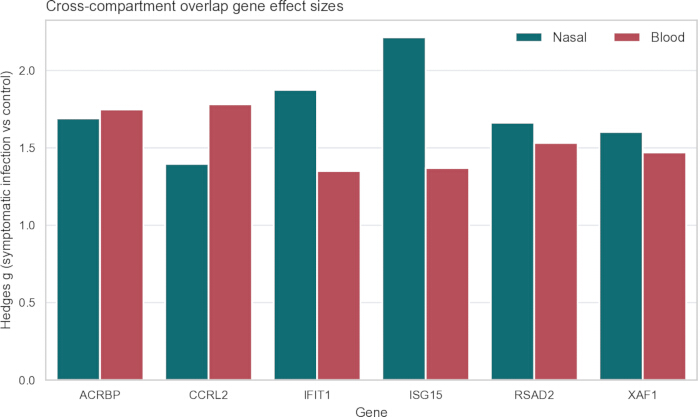
Figuur 2Effectgroottes van de zes exploratieve genen met overlap tussen neus- en bloedwaarden. Neuzal- en bloedhedges g Schattingen worden getoond voor ACRBP, CCRL2, IFIT1, ISG15, RSAD2 en XAF1 in GSE17827. Positieve waarden duiden op een hogere expressie bij symptomatische infectie dan bij virusnegatieve controles. De volledige overlap wordt getoond ter transparantie; de FDR-waarden voor individuele genen waren niet significant, en deze genen worden niet gepresenteerd als gevalideerde universele biomarkers. Klik hier om een grotere versie van deze figuur te bekijken.
Functionele verrijking bood een biologische controle op de inhoud van de modules
Beide modules waren verrijkt voor interferon- en antivirale paden, hoewel de gensamenstelling en de sterkte van de verrijking verschilden (Figuur 3). De acht meest significante termen per module worden weergegeven. Voor de neusmodule behoorden Hallmark interferon-gamma respons (gecorrigeerde P = 2,23 × 10⁻24), Hallmark interferon-alpha respons (gecorrigeerde P = 1,40 × 10⁻2), Reactome interferon-alpha/beta signalering (gecorrigeerde P = 3,64 × 10⁻19) en GO defensierespons op virus (gecorrigeerde P = 5,47 × 10⁻15) tot de leidende termen. De bloedmodule vertoonde dezelfde brede biologie bij een lagere verrijkingssterkte: interferon-alpha respons (gecorrigeerde P = 3,87 × 10⁻6), Reactome interferon-alpha/beta signalering (gecorrigeerde P = 5,70 × 10⁻6), interferon-gamma respons (gecorrigeerde P = 8,89 × 10⁻6) en defensierespons op virus (gecorrigeerde P = 1,07 × 10⁻4). Deze resultaten ondersteunen de biologische coherentie zonder dat dit impliceert dat de genrangschikkingen per compartiment identiek zijn.
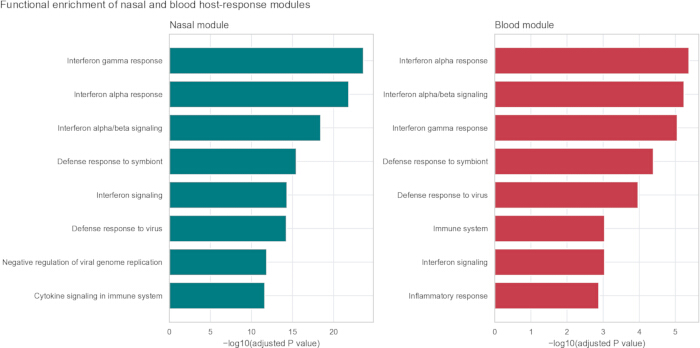
Figuur 3Geselecteerde verrijkings termen voor de neus- en bloedmodules. Overrepresentatieanalyse werd uitgevoerd met Enrichr met gebruik van Hallmark 2020, Reactome 202 en GO Biological Process 2023. De acht termen met de kleinste volgens Benjamini–Hochberg gecorrigeerde P waarden voor elke module worden weergegeven. De staaflengte representeert −log10(gecorrigeerd P waarde). De linker- en rechterpanelen tonen respectievelijk de neus- en bloedmodules. Termen worden weergegeven met een hoofdletter aan het begin van de zin. Verrijkingsanalyse heeft het modulelidmaatschap niet veranderd. Klik hier om een grotere versie van deze figuur te bekijken.
Bevroren modules werden getest in weefsel-overeenkomstige externe validatie
De bevroren nasale module behaalde AUROC's van 0,749 in GSE41374, 0,693 in GSE152075 en 0,609 in GSE156063 (Tabel 3; Figuur 4). De bevroren bloedmodule behaalde AUROC's van 0,832 in GSE17110, 0,924 in de GSE3890 GPL1058-eenheid en 0,870 in de GPL684-eenheid. De prestaties van de interne ankers zijn weggelaten omdat deze door de constructie optimistisch bevooroordeeld zijn. Externe AUROC's worden beschouwd als samenvattingen van de overdraagbaarheid. Ze stellen geen klinische sensitiviteit, specificiteit of diagnostische gereedheid vast.
| Cohort | Monster/virus | Module | n positief | n negatief | Representatieve genen | AUROC | Gemiddelde precisie | Welch-test FDR |
| GSE152075 | SARS-CoV-2 bovenste luchtwegen | Neusafficien | 430 | 54 | 50 | 0.693 | 0.935 | 2.20 × 10⁻⁴ |
| GSE156063 | SARS-CoV-2 bovenste luchtwegen | Neusafficien | 93 | 10 | 49 | 0.609 | 0.51 | 1.38 × 10⁻² |
| GSE1710 | SARS-CoV-2 volbloed | Bloed | 4 | 10 | 50 | 0.832 | 0.959 | 7.94 × 10⁻⁴ |
| GSE3890-GPL1058 | RSV volbloed | Bloed | 28 | 8 | 50 | 0.924 | 0.979 | 7.94 × 10⁻⁴ |
| GSE3890-GPL684 | RSV volbloed | Bloed | 107 | 31 | 49 | 0.87 | 0.962 | 3.47 × 10⁻¹⁵ |
| GSE41374 | RSV neusspoeling | Neusafficien | 76 | 10 | 50 | 0.749 | 0.951 | 2.63 × 10⁻² |
Tabel 3: Externe validatie van de module-score met weefselmatching. De vergrendelde neusmodule werd getest in GSE41374, GSE152075 en GSE156063, en de vergrendelde bloedmodule werd getest in GSE1710 en de GSE3890 platformunits GPL10558 en GPL684. De tabel rapporteert het aantal positieve en negatieve monsters, de gerepresenteerde modulegenen, AUROC, gemiddelde precisie en de Welch-test FDR. De interne ankerprestaties zijn weggelaten. AUROC en gemiddelde precisie worden gerapporteerd als samenvattingen van de overdraagbaarheid en niet als schattingen van de klinische diagnostische prestaties.
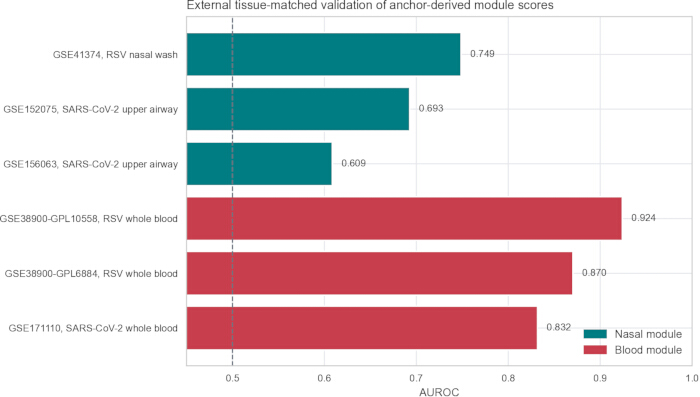
Figuur 4Externe overdraagbaarheid van weefsel-overeenkomstige modulescores. De AUROC's worden weergegeven voor de nasale module in GSE41374 (76 RSV, 10 controles), GSE152075 (430 SARS-CoV-2, 54 controles) en GSE156063 (93 SARS-CoV-2, 10 controles), en voor de bloedmodule in GSE1710 (4 SARS-CoV-2, 10 controles), GSE3890-GPL1058 (28 RSV, 8 controles) en GSE3890-GPL684 (107 RSV, 31 controles). De scores zijn ongewogen gemiddelden van de weergegeven z-waarden per gen. De stippellijn geeft AUROC = 0,5 aan. De waarden zijn samenvattingen van de overdraagbaarheid en geen klinische diagnostische schattingen. Klik hier om een grotere versie van deze figuur te bekijken.
Longitudinale validatie testte of scores dalen tijdens het herstel
De bijbehorende datasets GSE97741/GSE9742 boden een onafhankelijke validatiesetting voor natuurlijke infectie met acute monsters en monsters bij ontslag van gehospitaliseerde kinderen27. Deze monsters werden niet gebruikt als gezonde controledata voor de ontdekking. Ze werden gebruikt om te beoordelen of de module-scores, afgeleid van ankers, afnamen van de acute ziekte tot het ontslag.
Voor de vooraf gespecificeerde gecombineerde groep met enkelvoudige RSV-infectie en rhinovirus werden 68 gepaarde proefpersonen per weefsel geanalyseerd (Tabel 4; Figuur 5). De bloedmodule nam af van acute ziekte tot ontslag in het bloed (gemiddelde delta = 0,30; Cohen dz = 0,740; gepaarde toets FDR = 1,98 × 10⁻7; AUROC = 0,765). De nasale module nam eveneens af in nasofaryngeale monsters (gemiddelde delta = 0,436; Cohen dz = 0,47; gepaarde toets FDR = 3,06 × 10⁻4; AUROC = 0,679). Gepaarde trajecten en hun standaardfouten tonen aan dat de daling op groepsniveau niet werd veroorzaakt door enkele ongepaarde extremen.
| Dataset | Voorbeeldbron | Module | Weefselgematcht | n paren | Gemiddelde delta bij ontslag na acute opname | Cohen Het lijkt erop dat u slechts twee letters hebt ingevoerd ("dz"). Kunt u de volledige Engelse brontekst verstrekken die u vertaald wilt hebben naar het Nederlands? Zodra u de tekst aanlevert, zal ik deze vertalen volgens de strikte wetenschappelijke richtlijnen voor JoVE. | AUROC | Gepaarde-test FDR |
| GSE97741 | Bloed | Bloed | Ja | 68 | 0.330 | 0.740 | 0.765 | 1,98 × 10⁻⁷ |
| GSE97741 | Bloed | Neusaal | Nee | 68 | 0.479 | 0.721 | 0.755 | 3,19 × 10⁻⁷ |
| GSE97742 | Nasofaryngeaal | Bloed | Nee | 68 | 0.361 | 0.914 | 0.845 | 9,42 × 10⁻¹⁰ |
| GSE9742 | Nasofaryngeaal | Neusaal | Ja | 68 | 0.436 | 0.477 | 0.679 | 3,06 × 10⁻⁴ |
Tabel 4: Onafhankelijke longitudinale validatie van acute fase versus ontslag. De tabel rapporteert het aantal volledige paren, het gemiddelde verschil in score tussen de acute fase en ontslag, Cohen dz, AUROC en de FDR van de gepaarde toets voor de vaste modules in GSE9741 en GSE9742. Een positieve delta duidt op een hogere modulescore tijdens acute ziekte. De FDR-waarden van de gepaarde toets zijn Benjamini-Hochberg-gecorrigeerde tweezijdige gepaarde t-toets P-waarden, berekend over alle 20 geldige gepaarde t-toetsen in de volledige longitudinale output.
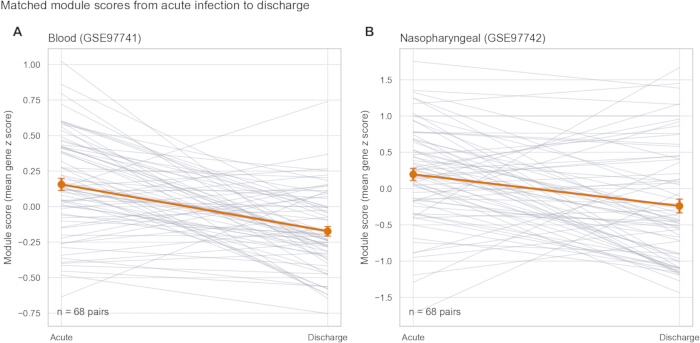
Figuur 5Gepaarde veranderingen in module-scores van acute ziekte tot ontslag. (A) Blood-module-scores in volbloed (GSE9741). (B) Scores van de nasale module in nasofaryngeale monsters (GSE9742). Elk paneel bevat 68 volledige subjectparen: 38 RSV-enkelvoudige infecties en 30 rhinovirusinfecties. Dunne lijnen verbinden measurements van gematchte subjecten. Oranje punten geven de groepsgemiddelden aan en oranje foutenbalken geven de standaardfout van het gemiddelde aan. Tweezijdig gepaard t testen en Wilcoxon-toetsen met tekens en rangen werden uitgevoerd; Benjamini-Hochberg FDR-correctie werd toegepast op de 20 geldige longitudinale gepaarde t tests. Klik hier om een grotere versie van deze figuur te bekijken.
De cross-compartimententesten onthulden een nuttige nuance. De bloedmodule toegepast op nasofaryngeale monsters leverde een AUROC van 0,845 op, ondanks dat de individuele effectgroottes voor neus en bloed in de anchor zwak concordant waren. Inspectie van gepaarde trajecten toonde een consistente daling van de score aan in plaats van een omgekeerde labeldistributie. Dit resultaat is dus geen bewijs dat dezelfde individuele genen in beide weefsels domineren. Het geeft aan dat een gecoördineerd interferon/inflammatoir programma kan worden samengevat door verschillende, maar gedeeltelijk redundante genensets. Compartimentspecificiteit is het sterkst op het niveau van genranking en is niet absoluut op pathway- of scoreniveau.
Uitgesloten asymptomatische detecties testten het gedrag van de symptoomgradiënt
Asymptomatische picornavirusdetecties in GSE117827 werden uitgesloten van de moduleconstructie om te voorkomen dat ze in de primaire controlegroep werden opgenomen. Deze uitgesloten groep diende vervolgens als biologische controle. In beide compartimenten namen de modulescores toe over de geordende groepen van virusnegatieve controles, asymptomatische picornavirusdetectie en symptomatische infectie (Figuur 6A,B).
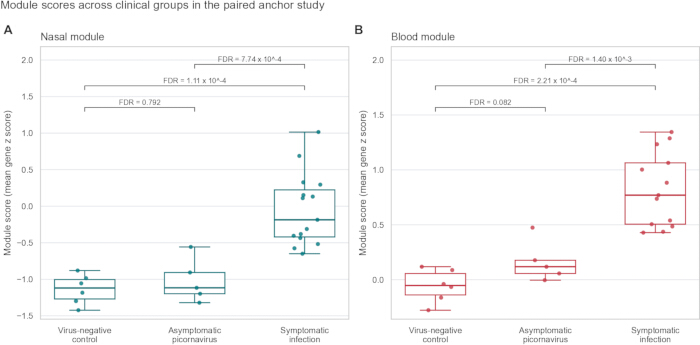
Figuur 6Module-scores over de uitgesloten symptoomgradiënt. (A) Nasale module: 6 virusnegatieve controles, 5 asymptomatische picornavirusdetecties en 15 symptomatische infecties. (B) Bloedmodule: 6 virusnegatieve controles, 5 asymptomatische picornavirusdetecties en 13 symptomatische infecties. Punten representeren individuele monsters. De middenlijnen geven de medianen aan; de boxen beslaan het 25e tot het 75e percentiel; en de whiskers reiken tot de meest extreme waarden binnen 1,5 keer het interkwartielbereik. Labels vermelden tweezijdige Mann-Whitney U post-hoc vergelijkingen met Benjamini-Hochberg correctie over drie vergelijkingen per compartiment. Klik hier om een grotere versie van deze figuur te bekijken.
De nasale module correleerde met de ordinale symptoomscore (Spearman rho = 0.818, P = 3.28 × 10⁻7; Kruskal-Wallis P = 1.57 × 10⁻4). De bloedmodule vertoonde een vergelijkbare gradiënt (rho = 0.861, P = 6.89 × 10⁻8; Kruskal-Wallis P = 1.92 × 10⁻4). Na correctie binnen elke familie van drie vergelijkingen verschilde symptomatische infectie in beide compartimenten van de controles en de asymptomatische detecties. Asymptomatische detecties verschilden niet van virus-negatieve controles (nasaal FDR = 0.792; bloed FDR = 0.082). De modules volgden daarom de symptomatische gastheerrespons-activiteit duidelijker dan de virale detectie alleen.
Klinische benchmarks bepaalden de grens tussen gastheerrespons en pathogeenspecificiteit
Klinische benchmarks bepaalden het onderscheid tussen gastheerresponsactiviteit en pathogeenclassificatie (Tabel 5; Figuur 7). In GSE6390 leverde de nasale module AUROC's op van 0,782 voor virale versus bacteriële aandoeningen en 0,791 voor virale versus niet-infectieuze aandoeningen. De bloedmodule leverde respectievelijk AUROC's op van 0,678 en 0,753. De Pandya 3-mRNA comparator presteerde beter, met AUROC's van respectievelijk 0,867 and 0,852. Dit resultaat is te verwachten voor een set die is ontworpen voor viraal/niet-viraal onderscheid en laat zien dat de anker-modules niet gepresenteerd moeten worden als vervangende diagnostische classificatoren.
| Dataset | Contrast | Nasale verankering | Ankerbloed | Pandya 3 mRNA | Andres-Terre ISG | Kenmerkend interferon-alfa |
| GSE6390 | Viraal versus bacterieel | 0.782 | 0.678 | 0.867 | 0.833 | 0.831 |
| GSE6390 | Viraal versus niet-infectieus | 0.791 | 0.753 | 0.852 | 0.851 | 0.848 |
| GSE40012 | Virale versus bacteriële pneumonie | 0.755 | 0.789 | 0.893 | 0.867 | 0.872 |
| GSE40012 | Virale pneumonie versus SIRS | 0.897 | 0.907 | 0.985 | 0.965 | 0.956 |
| GSE40012 | Virale pneumonie versus gezond | 0.804 | 0.986 | 0.923 | 0.906 | 0.891 |
| GSE40012 | Bacteriële pneumonie versus gezond | 0.476 | 0.917 | 0.465 | 0.391 | 0.378 |
| GSE53543 | Ex vivo rhinovirus-gestimuleerde versus ongestimuleerde PBMC's | 1 | 0.957 | 1 | 1 | 1 |
Tabel 5: AUROC-benchmark voor anker-modules en referentie-sets van gastheerresponsen. GSE63990 en GSE4012 zijn klinische cohorten van volbloed. GSE53543 is een ex vivo PBMC-perturbatie-experiment met 98 gepaarde proefpersonen en wordt apart gerapporteerd van de natuurlijke klinische cohorten. Referentie-sets werden gescoord als ongewogen gen-gemiddelden in plaats van als hun oorspronkelijke gewogen classifiers. AUROC-waarden worden gerapporteerd als benchmarkmetrieken en niet als schattingen van de klinische diagnostische prestaties.
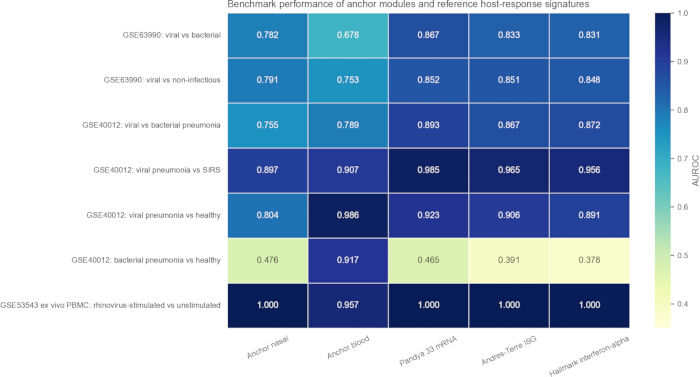
Figuur 7AUROC-benchmarking van ankermodules en referentiesets van gastheerrespons. Rijen vertegenwoordigen vooraf gespecificeerde contrasten in GSE6390, GSE40012 en GSE53543; kolommen vertegenwoordigen de twee anker-modules en drie ongewogen referentiesets. GSE53543 is gelabeld als ex vivo rhinovirus-gestimuleerde versus ongestimuleerde PBMC's en wordt apart gepresenteerd van de natuurlijke klinische cohorten. De Hallmark-comparator is gelabeld als Hallmark interferon-alfa. Celwaarden geven de AUROC's aan die zijn gebruikt voor methoden-benchmarking en mogen niet worden geïnterpreteerd als schattingen van de klinische diagnostische prestaties. Klik hier om een grotere versie van deze figuur te bekijken.
GSE4012 heeft deze grens verder aangescherpt. De Pandya-comparator bereikte AUROC's van 0,893 voor virale versus bacteriële pneumonie en 0,985 voor virale pneumonie versus SIRS. De bloedmodule scheidde influenza A-pneumonie van gezonde controles (AUROC = 0,986) en van SIRS (AUROC = 0,907), maar scheidde ook bacteriële pneumonie van gezonde controles (AUROC = 0,917). De bloedmodule meet daarom brede systemische inflammatoire en interferon-geassocieerde activiteit. Het is niet virus-specifiek, en een hoge score kan geen pathogeenklasse toewijzen.
In de afzonderlijke GSE53543 ex vivo PBMC-benchmark bereikten de neusmodule en de interferon-comparatoren een AUROC van 1,0 voor rhinovirus-gestimuleerde PBMC's vergeleken met PBMC's die alleen met medium waren behandeld; de bloedmodule bereikte een AUROC van 0,957. Alle 98 proefpersonen droegen gepaarde condities bij. Dit gecontroleerde resultaat ondersteunt de responsiviteit van de gescorede programma's op rhinovirus-stimulatie. Het is geen schatting van de klinische diagnostische prestaties.
Robuustheidscontroles testten de modulegrootte, willekeurige alternatieven en selectiestabiliteit
De scheiding van ankers bleef ongewijzigd over de 10, 25, 50, 10 en 200 hoogst gerangschikte genen (Figuur 8A). Deze interne AUROC's vormen geen externe validatie, maar ze tonen aan dat het kwalitatieve resultaat niet afhankelijk was van de keuze voor exact 50 genen. In 50 willekeurige sets van 50 genen waren de medianen van de nul-AUROC 0,489 voor neus en 0,705 voor bloed; de overeenkomstige 9ste percentielen waren 0,72 en 0,872 (Figuur 8B). De waargenomen modules overschreden deze nuldistributies. Bootstrap-selectiefrequenties waren verspreid in plaats van geconcentreerd in een enkele invariante lijst (Figuur 8C). Deze bevinding is een direct gevolg van de kleine steekproef van ankers. Het ondersteunt een stabiel aggregaatsignaal, terwijl het waarschuwt tegen het beschouwen van elk geselecteerd gen als vaststaand.
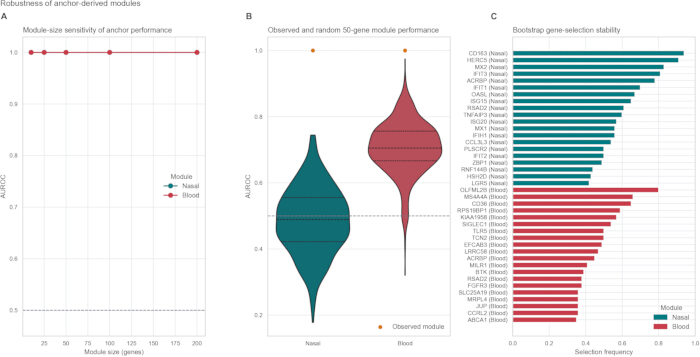
Figuur 8Analyses van de robuustheid met betrekking tot modulegrootte, willekeurige genen en bootstrap. (A) Anchor AUROC bij modulegroottes van 10, 25, 50, 10 en 20 genen; deze waarden representeren interne sensitiviteitscontroles. (B) AUROC-distributies van 50 willekeurige sets van 50 proteïnecoderende genen, zonder teruglegging getrokken uit de genen die vertegenwoordigd zijn in GSE117827 (seed = 20260622). Oranje punten geven de waargenomen AUROC's van de modules aan. Horizontale lijnen in elke vioolplot geven het 25ste percentiel, de mediaan en het 75ste percentiel aan. (C) Bootstrap-herselectie werd beperkt tot de 1.0 proteïne-coderende genen met het sterkste positieve effect die in de oorspronkelijke anchor-analyse het hoogst waren gerangschikt voor elk compartiment. De staven tonen de 20 genen met de hoogste selectiefrequentie per compartiment; de selectiefrequentie werd berekend als het aantal selecties gedeeld door 10. Klik hier om een grotere versie van deze figuur te bekijken.
Markerprogramma- en variantieanalyses verduidelijkten wat de scores meten
Over GSE40012, GSE53543 en GSE6390 correleerden beide modules het meest consistent met het myeloïde interferonprogramma (Figuur 9A). De correlaties voor de neusmodule waren 0,812, 0,878 en 0,882; de correlaties voor de bloedmodule waren 0,517, 0,843 en 0,74. De variantiepartitionering was beschrijvend (Tabel 6; Figuur 9B). Voor de bloedmodule verklaarden conditie en gedetailleerde groep meer variantie (eta-kwadraat = 0,282 en 0,250, respectievelijk) dan dataset (0,06), monstertype (0,026) of brongroep (0,025). Voor de neusmodule verklaarden gedetailleerde groep en conditie eveneens meer variantie dan dataset, monstertype of brongroep. Biologische conditie en gedetailleerde groep waren dus verantwoordelijk voor grotere fracties van de variantie in de module-score dan dataset of monstertype, hoewel niet-nul effecten van dataset en compositie een beperking blijven bij het hergebruik van bulk publieke data.
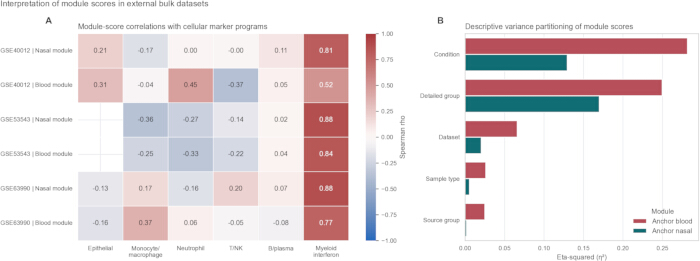
Figuur 9Correlaties tussen marker en programma en beschrijvende variantiepartitionering. (A) Spearman-correlaties tussen modulescores en scores van zes marker-programma's in GSE4012, GSE53543 en GSE63990. Programma's vereisten ten minste drie vertegenwoordigde genen. P waarden werden aangepast voor alle correlaties tussen dataset, module en programma. Lege cellen duiden combinaties aan die niet beschikbaar of niet schatbaar waren na toepassing van de vereisten voor genen en monsters. (B) Eenweg eta-kwadraat (η2; tussengroepen-som van kwadraten/totale som van kwadraten) voor conditie, gedetailleerde groep, dataset, monstertype en brongroep. De analyse omvatte 934 bloedmodule-scores en 1.469 neusmodule-scores en is beschrijvend, niet causaal. Klik hier om een grotere versie van deze figuur te bekijken.
| Module | Factor | Eta-kwadraat | n monsters |
| Anchor bloed | Conditie | 0.282 | 934 |
| Anchor bloed | Gedetailleerde groep | 0.25 | 934 |
| Anchor bloed | Dataset | 0.06 | 934 |
| Anchor bloed | Monstertype | 0.026 | 934 |
| Anchor bloed | Brongroep | 0.025 | 934 |
| Anchor neus | Gedetailleerde groep | 0.17 | 1469 |
| Anchor neus | Conditie | 0.13 | 1469 |
| Anchor neus | Dataset | 0.021 | 1469 |
| Anchor neus | Monstertype | 0.06 | 1469 |
| Anchor neus | Brongroep | 0.02 | 1469 |
Tabel 6: Descriptieve variantiepartitionering van modulescores. Voor elk module-factorpaar wordt één rij weergegeven, met de bijbehorende eta-kwadraat en steekproefomvang. Eta-kwadraat werd berekend als de som van kwadraten tussen groepen gedeeld door de totale som van kwadraten, nadat rijen waarin de relevante modulescore of factor ontbrak, waren uitgesloten. Factoren werden individueel geëvalueerd; daarom is de analyse descriptief, wordt er niet gecorrigeerd voor wederzijds gecorreleerde factoren en mag de analyse niet causaal worden geïnterpreteerd.
Beschikbaarheid van gegevens:
Alle transcriptomische datasets die in deze studie zijn geanalyseerd, zijn publiek toegankelijk via de Gene Expression Omnibus onder de accessienummers GSE117827, GSE41374, GSE152075, GSE156063, GSE1710, GSE3890, GSE9741, GSE9742, GSE6390, GSE40012 en GSE53543. De uit de analyse voortvloeiende gegevens ten grondslag aan de belangrijkste figuren en tabellen, evenals de analysecode, zijn op redelijk verzoek verkrijgbaar bij de corresponderende auteur. In deze studie zijn geen beperkte of nieuw gegenereerde gegevens op deelnemerniveau gebruikt.
Discussie
De belangrijkste les is operationeel: begin met het bemonsterde compartiment en niet met de grootste samengevoegde matrix. GSE17827 is klein, maar het gepaarde ontwerp maakt een directe vergelijking tussen neus en bloed binnen één studie mogelijk. De correlatie van het effect op genniveau die nagenoeg nul is, laat zien dat een samengevoegde pan-weefsel ranglijst substantiële compartimentele structuren zou maskeren. Afzonderlijke modules waren daarom een meer verdedigbaar ontwerp. Hun externe en longitudinale prestaties ondersteunen reproduceerbare gastrespons-activiteit op moduleniveau, in plaats van een universele genlijst.
Overdraagbaarheid op genniveau en moduleniveau is verschillend. De bloedmodule presteerde goed in longitudinale nasofaryngeale monsters (AUROC 0.845), ondanks een zwakke concordantie tussen individuele effectgroottes in neus- en bloedmonsters. De gepaarde trajecten vertoonden geen labelomkeer. Een waarschijnlijkere verklaring is pathway-redundantie: gecoördineerde interferon- en inflammatoire activiteit kan worden samengevat door verschillende subsets van genen in verschillende compartimenten6,7,8,9,10,1,32,3,34. Dit is de reden waarom we de modules beschrijven als compartiment-bewust in plaats van compartiment-exclusief. De exacte rangschikkingen verschillen, maar een gedeelde component op pathway-niveau blijft detecteerbaar. Bulk-profielen mengen expressieveranderingen bovendien met veranderingen in de celcompositie. Correlaties tussen marker-programma's kunnen dit probleem signaleren, maar ze kunnen geen cel-resolute mechanismen bieden36,37.
De klinische benchmarks definiëren een tweede grens. De Pandya 3-mRNA- en interferon-comparatoren waren sterker voor het onderscheid tussen viraal- versus bacterieel. De anker-modules beantwoorden een andere vraag: hoe sterk vertoont een monster een acuut gastheerrespons-programma? De bloedmodule nam ook toe bij bacteriële pneumonie. Het moet daarom worden geïnterpreteerd als een brede systemische inflammatoire/interferon-activiteitsscore, en niet als een virus-specifieke classifier. Een hoge score kan cohortvergelijkingen, het volgen van de respons of de beschrijving van de inflammatoire status ondersteunen, maar het kan de pathogeen niet identificeren. Het groeiende klinische belang van virussen zoals het humane metapneumovirus pleit verder voor pathogeen-diverse, weefselspecifieke validatie in plaats van extrapolatie vanuit een beperkte set virussen12,13.
De zes overlapgenen zijn exploratief. ISG15, IFIT1, RSAD2 en XAF1 hebben aannemelijke interferon-gerelateerde rollen32,3,34; CCRL2 is geassocieerd met inflammatoire leukocytenmigratie35; ACRBP heeft geen vastgestelde antivirale interpretatie. De kleine cohort en de niet-significante FDR-waarden per gen beletten sterkere claims. De methodologische innovatie ligt elders: een gepaarde anker binnen dezelfde studie, vergrendelde compartiment-specifieke modules, weefsel-gematchte externe tests, gepaarde herstelanalyse, benchmarking met klinische comparatoren en expliciete controles op randomisatie, grootte, bootstrap, marker en variantie. Deze bewijshierarchie biedt een conservatief kader voor de interpretatie van de resultaten.
Er blijven verschillende beperkingen bestaan. De ankercohort bevat slechts 15 geïnfecteerde en 6 controle neussamples en 13 geïnfecteerde en 6 controle bloedsamples. Bootstrap-resultaten bevestigen dat het lidmaatschap van individuele genen niet volledig stabiel is. Symptomatisch RSV en picornavirus werden gecombineerd, waardoor ankereffecten niet virusspecifiek zijn. Externe cohorten verschillen in leeftijd, platform, ernst, timing en definitie van de controlegroep. GSE53543 is een ex vivo gepaarde perturbatiestudie. GSE6390 en GSE4012 leveren nuttige klinische vergelijkingsgegevens, maar geen gepaarde neus- en bloedbemonstering. Virale load, symptoomduur, zuurstofbehoefte en ernst waren niet consistent beschikbaar. Een sterker prospectief ontwerp zou neusswabben en bloed verzamelen van dezelfde deelnemers op overeenkomstige tijdstippen, metingen van de virale load en symptomen, bacteriële en symptomatische virusnegatieve vergelijkingsgroepen en cel-resolutie validatie1,14,36,37.
Concluderend ondersteunen huidige publieke transcriptomen reproduceerbare activiteitsmodules van de gastheerrespons in neus- en bloedmonsters wanneer de weefselcontext behouden blijft. Ze ondersteunen geen uitwisselbare pan-weefsel gen-signatuur. De gekoppelde anchor vertoonde weinig concordantie op genniveau, terwijl locked module scores overdroegen binnen overeenkomstige weefsels en afnamen tijdens het herstel. De respons van de bloedmodule bij bacteriële pneumonie en de superieure prestaties van een gevestigde classifier bij het onderscheiden van viraal versus bacterieel definiëren het beoogde gebruik: deze modules beschrijven de activiteit van de gastheerrespons en ondersteunen transparante benchmarking van cohorten; ze zijn geen stand-alone pathogeenclassifiers. De analysecode en afgeleide gegevens zijn beschikbaar zoals beschreven in de verklaring over databeschikbaarheid om onafhankelijke verificatie en hergebruik van de workflow te ondersteunen.
Openbaarmakingen
De auteurs verklaren dat er geen financiële of niet-financiële belangenverstrengelingen zijn die relevant zijn voor dit werk.
Dankbetuigingen
De auteurs danken de onderzoekers en deelnemers van de openbare GEO-studies die in dit werk zijn geanalyseerd. Geen enkele andere persoon voldeed aan de criteria voor auteurschap. Dit onderzoek heeft geen specifieke subsidie ontvangen van enige financieringsinstantie in de publieke, commerciële of non-profitsector.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Andres-Terre multi-virus interferon-gestimuleerde genenset | Andres-Terre et al. | 33-gen comparator; Supplementary Data 1 | Ongewogen interferon-georiënteerde comparator samengesteld uit de gerapporteerde multi-virus signature; de volledige genenlijst is opgenomen in Supplementary Data 1. |
| Enrichr | Ma'ayan Laboratory | Geraadpleegd op 18 augustus 2026; RRID:SCR_01575 | Resource voor overrepresentatie van genensets, geraadpleegd via gseapy. |
| Gene Expression Omnibus | National Center for Biotechnology Information | GEO; RRID:SCR_05012 | Publieke transcriptoom-repository gebruikt voor toegang tot de geanalyseerde datasets. |
| Gene Ontology | Gene Ontology Consortium | GO Biological Process 2023; RRID:SCR_0281 | Functionele annotatiebibliotheek gebruikt via Enrichr. |
| GPL1058 | NCBI GEO | GPL1058 | Platform voor GSE53543 en de validatie-eenheid van 36 monsters uit GSE3890. |
| GPL23126 | NCBI GEO | GPL23126 | Expressieplatform voor GSE17827. |
| GPL24539 | NCBI GEO | Clariom_D_Human.na36.hg38. probeset.csv | Clariom D Human na36, hg38 annotatie gebruikt voor GSE17827 transcript-cluster mapping. |
| GPL571 | NCBI GEO | GPL571 | Platformannotatie toegepast op GSE6390. |
| GPL684 | NCBI GEO | GPL684 | Platform voor de validatie-eenheid van 138 monsters van RSV whole-blood uit GSE3890. |
| GPL6947 | NCBI GEO | GPL6947 | Platformannotatie toegepast op GSE4012. |
| GSE17827 | NCBI GEO | GSE17827 | Primaire gekoppelde nasal-swab en whole-blood anchor dataset. |
| GSE152075 | NCBI GEO | GSE152075 | Externe SARS-CoV-2 validatiedataset van de bovenste luchtwegen. |
| GSE156063 | NCBI GEO | GSE156063 | Externe SARS-CoV-2 validatiedataset van de bovenste luchtwegen. |
| GSE1710 | NCBI GEO | GSE1710 | Externe SARS-CoV-2 whole-blood validatiedataset. |
| GSE38900 | NCBI GEO | GSE3890; GPL1058 en GPL684 | Externe RSV whole-blood validatie, geanalyseerd als afzonderlijk genormaliseerde platformeenheden van 36 en 138 monsters. |
| GSE4012 | NCBI GEO | GSE40012 | Benchmark voor klinische influenza A pneumonie, bacteriële pneumonie, SIRS en gezonde controles. |
| GSE41374 | NCBI GEO | GSE41374 | Externe RSV nasal-wash validatiedataset. |
| GSE53543 | NCBI GEO | GSE53543 | Gekoppelde ex vivo PBMC rhinovirus perturbatie-benchmark met 98 proefpersonen en 196 monsters. |
| GSE6390 | NCBI GEO | GSE63990 | Klinische virale, bacteriële en niet-infectieuze whole-blood benchmark. |
| GSE9741 | NCBI GEO | GSE9741 | Longitudinale whole-blood validatiedataset acute-versus-discharge. |
| GSE9742 | NCBI GEO | GSE9742 | Longitudinale nasofaryngeale validatiedataset acute-versus-discharge. |
| gseapy | gseapy developers | Versie 1.3.1 | Python-interface gebruikt voor het opvragen van Enrichr. |
| HGNC gene symbol resource | HUGO Gene Nomenclature Committee | Geraadpleegd op 18 augustus 2026; RRID:SCR_02827 | Goedgekeurde resource voor normalisatie van gensymbolen en proteïne-coderende classificatie. |
| Matplotlib | Matplotlib development team | Versie 3.1.1 | Figuurgeneratie. |
| MSigDB Hallmark genensets | Broad Institute | Hallmark 2020; RRID:SCR_016863 | Hallmark enrichment-bibliotheek geraadpleegd via Enrichr. |
| MSigDB Hallmark interferon-alfa respons genenset | Broad Institute | HALLMARK_INTERFERON_ALPHA_ RESPONSE; core subset van 3 genen in Supplementary Data 1 | Ongewogen interferon-alfa comparator; de exacte subset is opgenomen in Supplementary Data 1. |
| NumPy | NumPy developers | Versie 2.5.2 | Numerieke berekeningen en seeded random sampling. |
| pandas | pandas development team | Versie 3.0.5 | Verwerking van tabelgegevens. |
| Pandya 3-mRNA gastrespons genenset | Pandya et al. | Supplementary Table 1; Supplementary Data 1 | Officiële set van 3 genen gescoord als een ongewogen comparator. |
| Python | Python Software Foundation | Versie 3.12.13 | Computationele analyse-omgeving. |
| Reactome | Reactome | Reactome 202; RRID:SCR_03485 | Pathway enrichment-bibliotheek geraadpleegd via Enrichr. |
| scikit-learn | scikit-learn developers | Versie 1.9.0 | AUROC- en average-precision berekeningen. |
| SciPy | SciPy developers | Versie 1.18.0 | Welch, paired t, Wilcoxon, Mann–Whitney en correlatietests. |
| Seaborn | Seaborn development team | Versie 0.13.2 | Statistische graphics. |
| statsmodels | statsmodels developers | Versie 0.14.6 | Statistische utilities. |
Referenties
- Zaas AK, et al. Gene expression signatures diagnose influenza and other symptomatic respiratory viral infections in humans. Cell Host Microbe. 2009;6(3):207-17.
- Woods CW, et al. A host transcriptional signature for presymptomatic detection of infection in humans exposed to influenza H1N1 or H3N2. PLoS One. 2013;8(1):e52198.
- Andres-Terre M, et al. Integrated, multi-cohort analysis identifies conserved transcriptional signatures across multiple respiratory viruses. Immunity. 2015;43(6):1199-211.
- Herberg JA, et al. Diagnostic test accuracy of a 2-transcript host RNA signature for discriminating bacterial vs viral infection in febrile children. JAMA. 2016;316(8):835-45.
- Pandya R, et al. A machine learning classifier using 33 host immune response mRNAs accurately distinguishes viral and non-viral acute respiratory illnesses in nasal swab samples. Genome Med. 2023;15(1):64.
- Ioannidis I, et al. Plasticity and virus specificity of the airway epithelial cell immune response during respiratory virus infection. J Virol. 2012;86(10):5422-36.
- Mejias A, et al. Whole blood gene expression profiles to assess pathogenesis and disease severity in infants with respiratory syncytial virus infection. PLoS Med. 2013;10(11):e1001549.
- Blanco-Melo D, et al. Imbalanced host response to SARS-CoV-2 drives development of COVID-19. Cell. 2020;181(5):1036-45.e9.
- Hadjadj J, et al. Impaired type I interferon activity and inflammatory responses in severe COVID-19 patients. Science. 2020;369(6504):718-24.
- Mick E, et al. Upper airway gene expression reveals suppressed immune responses to SARS-CoV-2 compared with other respiratory viruses. Nat Commun. 2020;11(1):5854.
- Yoshida M, et al. Local and systemic responses to SARS-CoV-2 infection in children and adults. Nature. 2022;602(7896):321-7.
- Jamali MC, et al. Respiratory infections by human metapneumovirus: epidemiological evidence and treatment prospects. Res J Pharm Technol. 2026;19(8):3905-12. doi:10.52711/0974-360X.2026.00549.
- Gao G, Lin R, Ma D. Human metapneumovirus: pathogenesis, epidemiology, diagnostic technologies, and potential intervention strategies. Virol J. 2025;22(1):376.
- Lim FY, et al. homeRNA self-blood collection enables high-frequency temporal profiling of presymptomatic host immune kinetics to respiratory viral infection: a prospective cohort study. EBioMedicine. 2025;112:105531.
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-27.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882-3.
- Yu J, et al. Host gene expression in nose and blood for the diagnosis of viral respiratory infection. J Infect Dis. 2019;219(7):1151-61.
- Tsalik EL, et al. Host gene expression classifiers diagnose acute respiratory illness etiology. Sci Transl Med. 2016;8(322):322ra11.
- Parnell GP, et al. A distinct influenza infection signature in the blood transcriptome of patients with severe community-acquired pneumonia. Crit Care. 2012;16(4):R157.
- Edgar R, Domrachev M, Lash AE. Gene Expression Omnibus: NCBI gene expression and hybridization array data repository. Nucleic Acids Res. 2002;30(1):207-10.
- Barrett T, et al. NCBI GEO: archive for functional genomics data sets-update. Nucleic Acids Res. 2013;41(D1):D991-5.
- Tweedie S, et al. Genenames.org: the HGNC and VGNC resources in 2021. Nucleic Acids Res. 2021;49(D1):D939-46.
- Welch BL. The generalization of Student's problem when several different population variances are involved. Biometrika. 1947;34(1-2):28-35.
- Benjamini Y, Hochberg Y. Controlling the false discovery rate: a practical and powerful approach to multiple testing. J R Stat Soc Series B Stat Methodol. 1995;57(1):289-300.
- Subramanian A, et al. Gene set enrichment analysis: a knowledge-based approach for interpreting genome-wide expression profiles. Proc Natl Acad Sci U S A. 2005;102(43):15545-50.
- Liberzon A, et al. The Molecular Signatures Database Hallmark Gene Set Collection. Cell Syst. 2015;1(6):417-25.
- Do LAH, et al. Host transcription profile in nasal epithelium and whole blood of hospitalized children under 2 years of age with respiratory syncytial virus infection. J Infect Dis. 2018;217(1):134-46.
- Ashburner M, et al. Gene Ontology: tool for the unification of biology. Nat Genet. 2000;25(1):25-9.
- The Gene Ontology Consortium. The Gene Ontology resource: enriching a GOld mine. Nucleic Acids Res. 2021;49(D1):D325-34.
- Gillespie M, et al. The Reactome pathway knowledgebase 2022. Nucleic Acids Res. 2022;50(D1):D687-92.
- Kuleshov MV, et al. Enrichr: a comprehensive gene set enrichment analysis web server 2016 update. Nucleic Acids Res. 2016;44(W1):W90-7.
- Schoggins JW, et al. A diverse range of gene products are effectors of the type I interferon antiviral response. Nature. 2011;472(7344):481-5.
- Schneider WM, Chevillotte MD, Rice CM. Interferon-stimulated genes: a complex web of host defenses. Annu Rev Immunol. 2014;32:513-45.
- Perng YC, Lenschow DJ. ISG15 in antiviral immunity and beyond. Nat Rev Microbiol. 2018;16(7):423-39.
- Schioppa T, et al. Molecular basis for CCRL2 regulation of leukocyte migration. Front Cell Dev Biol. 2020;8:615031.
- Avila Cobos F, et al. Benchmarking of cell type deconvolution pipelines for transcriptomics data. Nat Commun. 2020;11(1):5650.
- Maden SK, et al. Challenges and opportunities to computationally deconvolve heterogeneous tissue with varying cell sizes using single-cell RNA-sequencing datasets. Genome Biol. 2023;24(1):288.