Dit onderzoekswerk presenteert een aanpak, FusionNetX, waarbij de feature-fusiecapaciteiten van DenseNet121 en EfficientNetB7 zijn uitgebreid voor de classificatie van hersentumoren op vijf openbaar beschikbare datasets middels data-augmentatie, preprocessing en hybrid model-aanpassing (intermediate Fusion), waarbij resultaten tussen 98,77% en 99,89% werden behaald en er werd beter gepresteerd op meerdere evaluatieparameters.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Methodenartikel
FusionNetX: Een deep feature fusion-model op basis van MRI en deep learning voor verbeterde detectie van hersentumoren
In dit artikel
Samenvatting
Samenvatting
Hersentumoren worden beschouwd als een van de dodelijkste ziekten ter wereld, en een verkeerde diagnose brengt het leven van patiënten in gevaar en verlaagt de overlevingskans. Magnetic resonance imaging (MRI) met technieken op basis van deep learning, met name convolutionele neurale netwerken, is cruciaal om dit obstakel te overwinnen, omdat het een gedetailleerder onderzoek van de interne structuur van de hersenen mogelijk maakt en uitstekende leer- en voorspellingsmogelijkheden biedt. De behoefte aan een nauwkeurige diagnose van tumoren in de hersenen is nog steeds aanzienlijk. Daarom wordt een verbeterd DL-model op basis van feature-fusion (FusionNetX) voorgesteld dat gebruikmaakt van de sterke punten van twee vooraf getrainde modellen, DenseNet121 en EfficientNetB7, met behulp van aangepaste hyperparameters voor fine-tuning, inclusief trainbare en niet-trainbare lagen. Het voorgestelde FusionNetX-model is toegepast op vijf publiek beschikbare datasets van hersentumoren: Br35H, Figshare, Sartaj, Masoud en Balanced Brain Tumor. Er zijn enkele preprocessing-stappen toegepast om de beeldkwaliteit te verbeteren en overfitting aan te pakken door middel van resizing en data-augmentatie. Met behulp van diverse prestatie-evaluatiemetrieken, zoals nauwkeurigheid, verlies, positieve voorspellende waarde, negatieve voorspellende waarde, true positive rate, true negative rate, F1-score, false negative rate en false positive rate, bleek het voorgestelde FusionNetX-model een nauwkeurigheid te hebben van 99.33% voor Br35H, 99.13% voor Figshare, 99.89% voor Masoud, 99.19% voor BBT-Dataset en 98.77% voor Sartaj. Daarnaast werden de vijf hersentumordatasets geëvalueerd met behulp van late fusion en attention-based fusion om het belang van het voorgestelde FusionNetX-model aan te tonen; de resultaten waren aanzienlijk beter, met winsten van 0.3% tot 1.9% over alle datasets. Bovendien is de receiver operating characteristic-curve berekend, en de resultaten van diverse prestatie-evaluatiemetrieken geven aan dat het voorgestelde FusionNetX-model hersentumoren nauwkeurig kan detecteren en voorspellen, waardoor zorgverleners kunnen helpen om tijdig beslissingen te nemen.
Inleiding
Kanker is tegenwoordig de dodelijkste ziekte in het menselijk lichaam vanwege de ernst en de groeisnelheid, terwijl diverse vormen van kanker, zoals hersentumoren, borstkanker, longnoduli, nierkanker en andere, in het menselijk lichaam worden aangetroffen, wat leidt tot een stijging van het sterftecijfer. Kanker ontwikkelt zich wanneer cellen of weefsels in het lichaam van een persoon zich abnormaal vermenigvuldigen. Wanneer kanker metastaseert, kan het andere menselijke organen beschadigen en gevaarlijker worden1. Omdat de hersenen elke lichamelijke functie aansturen, kan elke beschadiging daaraan verstrekkende gevolgen hebben voor het gehele lichaam. Dat is waarom hersentumoren of hersenkanker zo dodelijk zijn voor mensen2. Bovendien zijn goedaardige en kwaadaardige hersentumoren de twee belangrijkste categorieën waarin ze worden onderverdeeld. "Goedaardig" betekent in essentie niet-kankergeuzen; het is louter een probleem in de hersenen dat kan worden verholpen door de omgeving te wijzigen. Maar in het geval van maligniteit wordt het als gevaarlijk beschouwd vanwege de metastatische aard, waarbij abnormale cellen of weefsels naar of vanuit andere lichaamsdelen bewegen, waardoor ook andere organen worden verstoord en de kans op kanker in het lichaam toeneemt3.
Daarnaast worden hypofysetumoren, meningeomen en gliomen, volgens de American Brain Tumor Association en de Wereldgezondheidsorganisatie (WHO), beschouwd als de drie belangrijkste categorieën hersenkankers4. Gliomen ontstaan uit gliacellen, die neuronen in de hersenen voeden. Hypofysetumoren beginnen in de hypofyse, die zich aan de basis van de hersenen bevindt en verantwoordelijk is voor diverse lichaamsfuncties; meningeomen daarentegen beginnen in de meninges, de vliezen die de hersenen en het ruggenmerg beschermen. Verder worden er veelvuldig verschillende medische beeldvormingsmodaliteiten gebruikt om interne lichaamsdelen voor diagnostische doeleinden te onderzoeken, waaronder röntgenfoto's, computertomografie (CT)-scans en magnetic resonance imaging (MRI)5,6. Elke beeldvormingsmodaliteit heeft zijn eigen voor- en nadelen. MRI is een beeldvormingsmodaliteit die gedetailleerde beelden levert van zachte weefsels en cellen in het lichaam, met name in de hersenen. Kanker gaat gepaard met abnormaal weefsel of cellen in het lichaam, en MRI levert gedetailleerde beelden van deze abnormaliteiten, waardoor het een nuttigere beeldvormingsmodaliteit is voor het diagnosticeren van hersentumoren of kanker. Bovendien is MRI veiliger dan andere beeldvormingsmodaliteiten, omdat er tijdens het onderzoek van de interne lichaamsanatomie geen schadelijke straling vrijkomt.
Daarnaast worden er veel computationele methodologieën ingezet om de diagnostische uitdagingen bij hersentumoren aan te pakken, waaronder machine learning (ML), beeldverwerking (IP) en deep learning (DL), waarbij elke benadering wordt toegepast op beelden van verschillende beeldvormingsmodaliteiten om de kanker te diagnosticeren7. Deze benaderingen leren de verborgen patronen en structuren van verschillende objecten in beelden om kanker te diagnosticeren door patronen in het aangetaste gebied te identificeren. Elke computationele benadering heeft zijn eigen voor- en nadelen in het diagnostische proces. Benaderingen op basis van ML en IP extraheren handmatig ontworpen kenmerken (handcrafted features), wat meestal leidt tot onnauwkeurige voorspellingen en foutieve diagnoses, vooral bij grotere datasets8. Om de problemen met handmatige kenmerkextractie te overwinnen, is er een verschuiving naar deep learning-gebaseerde modellen, gewoonlijk convolutionele neurale netwerken (CNN)-modellen genoemd, die de beste kenmerken uit beelden automatisch leren en extraheren om tumoren nauwkeurig te diagnosticeren. DL-gebaseerde benaderingen worden nu algemeen gebruikt in medische beeldvorming om ziekten in het menselijk lichaam te diagnosticeren, vooral voor de vroege en nauwkeurige detectie van hersentumoren, borstkanker, longkanker en andere ziekten, vanwege hun vermogen om complexe patronen in grootschalige data te leren en te extraheren, wat resulteert in nauwkeurigere resultaten9. Het belangrijkste probleem bij een DL-model is het verbruik van meer resources en data-sampling, wat wordt opgelost door een andere deep learning-gebaseerde benadering genaamd transfer learning10 (TL), waarbij vooraf getrainde (pretrained) modellen worden gebruikt om de ziekte te diagnosticeren, wat tijd en resources bespaart. Vroege en nauwkeurige diagnose van gezondheidsproblemen wordt mogelijk gemaakt door pretrained modellen, die al basiskenmerken met betrekking tot textuur, kleur, randen en meer hebben geleerd van een grote dataset. Deze modellen kunnen vervolgens worden overgebracht naar een nieuwe dataset die nog nooit eerder is gezien door gebruik te maken van het model en hyperparameters, alsook trainbare en niet-trainbare lagen toe te voegen11. Er is aanzienlijk onderzoek gedaan naar de classificatie van hersentumoren, en Tabel 112,13,14,15,16,17,18,19,20,21,22,23 presenteert de details van dit onderzoek, inclusief de benaderingen, datasets en resultaten. Toch is er nog geen onderzoek uitgevoerd waarbij een methodologie is gebruikt die twee transfer learning-modellen combineert voor robuuste kenmerkextractie en regularisatietechnieken aanpast om een soepele training en testen te garanderen. Uitgebreide evaluatie van de voorgestelde methodologie biedt inzicht in de modelprestaties over verschillende kenmerken van hersentumoren.
| Ref | Benadering | Datasteekproeven | Resultaten | Beperkingen |
| 12 | Aangepaste CNN | Br35H | Nauwkeurigheid = 97,45%, | Er is nog steeds behoefte aan verbeteringen in de resultaten; in plaats van een zelfgemaakte CNN te gebruiken, is het beter om een bestaand CNN-model met modificaties te gebruiken. |
| Verlies = 0,1141%, | ||||
| Recall = 98,09%, | ||||
| F1-score = 97,69%, | ||||
| Precisie = 97,29%, | ||||
| Augmented Br35H | Nauwkeurigheid = 98,99%, | |||
| Precisie = 98,90%, | ||||
| Verlies = 0,0570%, | ||||
| Recall = 98,91%, | ||||
| F1-score = 99,04% | ||||
| 13 | Feature Fusion DNN-model | Br35H | Nauwkeurigheid = 98,22%, | Er is nog steeds behoefte aan verbeteringen in de resultaten, en in plaats van een aangepast model te gebruiken, is er nog steeds behoefte aan het gebruik van een bestaand model voor feature fusion. |
| FNR = 1,77%, | ||||
| Sensitiviteit = 98,2%, | ||||
| F1-score = 98%, | ||||
| Specificiteit = 98%, | ||||
| Figshare | Nauwkeurigheid = 98,01%, | |||
| Sensitiviteit = 96,03%, | ||||
| F1-score = 96%, | ||||
| Specificiteit = 98,67%, | ||||
| FNR = 3,96% | ||||
| 14 | AlexNet met SGD | Br35H | Nauwkeurigheid = 98,79%, | Er is nog steeds behoefte aan enkele verbeteringen in de resultaten, en we moeten ook enkele geavanceerde CNN-gebaseerde modellen testen op verschillende datasteekproeven. |
| MCR = 1,20%, | ||||
| Sensitiviteit = 98,98%, | ||||
| Specificiteit = 98,58%, | ||||
| F1-score = 98,82% | ||||
| 15 | InceptionV3 | Figshare | Nauwkeurigheid = 98,89%, | De auteurs gebruikten de Figshare-dataset, die drie klassen tumoren bevat; in plaats van deze te classificeren, classificeren zij of er een tumor aanwezig is of niet, en er is nog steeds behoefte aan verbeteringen in de resultaten evenals het categoriseren van de tumorklassen. |
| SensitiviteitB = 95,28%, | ||||
| SensitiviteitM = 94,47% | ||||
| 16 | Geoptimaliseerde ResNet50 | Figshare | Nauwkeurigheid = 99,03%, | Andere parameters voor prestatie-evaluatie moesten worden berekend met verdere verbeteringen in de resultaten. |
| Recall = 99%, | ||||
| F1-score = 99% | ||||
| 17 | Res-BRNet | Br35H | Nauwkeurigheid = 98,22%, | Er is nog steeds behoefte aan verbeteringen in de resultaten. |
| Sensitiviteit = 98,11%, | ||||
| Precisie = 98,22%, | ||||
| Figshare | F1-score = 98,41% | |||
| 18 | ResNet101 + DenseNet121 | Figshare | Nauwkeurigheid = 99,18%, | Er is een kleine verbetering in de resultaten en er is behoefte aan het controleren van meer datasets met betrekking tot hersentumoren. |
| Recall = 99,11%, | ||||
| F1-score = 99,08, | ||||
| Precisie = 99,07%, | ||||
| Sartaj | Nauwkeurigheid = 97,24%, | |||
| Recall = 97,58%, | ||||
| F1-score = 97,28%, | ||||
| Precisie = 97,06%, | ||||
| 19 | CNN-SVM | Brats | Nauwkeurigheid = 98,02%, | Er is behoefte aan het toepassen van enkele bestaande modellen met SVM, en er is nog steeds behoefte aan verbeteringen in de resultaten. |
| F1-score = 98,31%, | ||||
| Precisie = 98,09%, | ||||
| Sensitiviteit = 98,53%, | ||||
| Specificiteit = 97,30%, | ||||
| Sartaj | Nauwkeurigheid = 96,83%, | |||
| Precisie = 95,36%, | ||||
| Sensitiviteit = 94,73%, | ||||
| Specificiteit = 97,56%, | ||||
| F1-score = 95% | ||||
| 20 | Fine-tuned EfficientNetB3 | Figshare | Nauwkeurigheid = 98,70% | Er is behoefte aan de bovengenoemde varianten van EfficientNetB3 om de resultaten te verbeteren. |
| Sartaj | Nauwkeurigheid = 97,50% | |||
| 21 | InceptionV4 | Masoud | Nauwkeurigheid = 98,7%, | Enkele verbeteringen in de resultaten zijn vereist door het gebruik van meer datasets. |
| Precisie = 99%, | ||||
| Sensitiviteit = 98%, | ||||
| Specificiteit = 99%, | ||||
| F1-score = 99,1% | ||||
| 22 | VGG16 | Masoud | Nauwkeurigheid = 98% | Er is behoefte aan verbeteringen in de resultaten door het controleren van meer deep neural network-modellen. |
| 23 | MFR-CNN | Masoud | Nauwkeurigheid = 94%, | Het is een complexe architectuur die wordt gebruikt in deze voorgestelde oplossing. |
| Recall = 96%, | ||||
| F1-score = 96%, | ||||
| Precisie = 96%, |
Tabel 1: Een vergelijkend onderzoek naar het meest recente onderzoekswerk.De tabel vat bestaand onderzoek samen, samen met de gehanteerde benaderingen, data-samples, resultaten en beperkingen. Klik hier om deze tabel te downloaden.
Tabel 1 geeft een overzicht van bestaande benaderingen, waarbij de beperkingen in het verbeteren van de resultaten worden belicht en de noodzaak van het gebruik van reeds bestaande DL-modellen wordt benadrukt, terwijl hun prestaties worden geëvalueerd aan de hand van diverse statistische parameters, alles binnen een efficiënt kader dat beter presteert op verschillende datasets van hersentumoren.
Studiedoelstellingen en probleemstelling
Handmatige interpretatie is tijdrovend en is onderhevig aan interobservervariabiliteit; daarom is een snelle en nauwkeurige categorisering van hersentumortypes op basis van MRI essentieel voor de klinische besluitvorming. De meeste huidige DL-benaderingen voor geautomatiseerde classificatie van hersentumoren zijn gebaseerd op een enkel backbone-netwerk of eenvoudige fusie op beslissingsniveau, waardoor de complementaire kenmerkrepresentaties van meerdere vooraf getrainde architecturen niet volledig worden benut. Bovendien worden deze methoden vaak slechts op een enkele dataset gevalideerd, wat het vertrouwen in hun generaliseerbaarheid beperkt.
Dit onderzoeksproject heeft tot doel een volledige en nauwkeurige methode te ontwikkelen en te leveren voor het diagnosticeren van hersenkankers in menselijke hersenen met behulp van een dual-backbone DL-framework (EfficientNetB7 en DenseNet121), dat gebruikmaakt van complementaire kenmerkrepresentaties om een robuuste classificatie van hersentumoren op basis van MRI mogelijk te maken. Daarnaast wordt de robuustheid van het framework geëvalueerd over meerdere onafhankelijke publieke datasets. Deze aanpak kan radiologen en paramedici helpen om hersentumoren snel en effectief te diagnosticeren, waardoor levens van patiënten kunnen worden gered door tijdige herkenning en classificatie mogelijk te maken.
Om een specifiek onderzoeksprobleem op te lossen en de doelen van dit onderzoeksproject te bereiken, zijn dit de onderzoeksvragen en de bijdragen om deze vragen te beantwoorden: 1) Is de fusie op kenmerkniveau (intermediair) van twee vooraf getrainde backbone-netwerken beter dan beslissingsniveau-fusie (laat) en aandachtgebaseerde fusietechnieken voor de classificatie van hersentumoren? 2) Zal het voorgestelde systeem consistente classificatieprestaties leveren in meerdere onafhankelijk verkregen MRI-datasets van hersentumoren?
De reikwijdte van deze studie is beperkt tot classificatie op beeldniveau (2D MRI-doorsnede), gebruikmakend van vijf publiekelijk beschikbare MRI-datasets van hersentumoren (Br35H, Figshare, Sartaj, Masoud en BBT-Dataset); deze zijn onafhankelijk geëvalueerd en niet over verschillende datasets heen; en er is gebruikgemaakt van de specifieke architectuur, preprocessing-pipeline en experimentele configuratie zoals beschreven in de sectie methodologie. De studie omvat geen validatie op patiëntniveau of testen in een klinische implementatieomgeving.
De belangrijkste bijdragen van dit onderzoek zijn als volgt: 1) De primaire bijdrage van dit onderzoek is het gebruik van dubbele voorgetrainde modellen voor een betere kenmerkextractie, waaronder DenseNet121 en EfficientNetb7 met geoptimaliseerde hyperparameters. 2) Een innovatieve modelarchitectuur met een geavanceerde regularisatietechniek, geïntegreerd met geconcateneerde kenmerken van een dubbel voorgetraind model voor robuuste prestaties. 3) Er is een effectieve data-augmentatiestrategie toegepast om de diversiteit van de trainingssamples te vergroten, zodat meer generieke en specifieke kenmerken kunnen worden geleerd en overfitting-problemen kunnen worden overwonnen. 4) De prestaties van het voorgestelde model werden beoordeeld op vijf verschillende openbaar beschikbare datasets van hersentumoren, met de focus op diverse statistische evaluatieparameters, waaronder nauwkeurigheid, misclassificatiepercentage, precisie, negatieve voorspellende waarde, sensitiviteit, specificiteit, F1-score, vals-negatievenpercentage en vals-positievenpercentage.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
De meest bedreigende ziekte ter wereld is een hersentumor. Een nauwkeurige diagnose kan gunstig zijn voor de overleving van patiënten. Er is echter nog steeds behoefte aan een nauwkeurig diagnostisch systeem dat hersentumoren in een vroeg stadium kan detecteren. Om dit probleem aan te pakken, is er een betrouwbaardere techniek voorgesteld voor het nauwkeurig detecteren van hersentumoren in hun vroege stadia door gebruik te maken van een hybride duaal deep learning-mechanisme met geoptimaliseerde hyperparameters en nauwkeurig afgestelde lagen op basis van de DenseNet121- en EfficientNetB7-modellen. De voorgestelde aanpak gebruikt 2D MRI-beelden als input en geeft een voorspelling van ofwel de aanwezigheid van een tumor of geen aanwezigheid van een tumor voor de binaire classificatiedataset Br35H, en een categorisering van de tumor voor vier andere multiclass-classificatiedatasets. Deze sectie demonstreert daarom de belangrijkste stappen van de voorgestelde aanpak, van gegevensverzameling tot de uiteindelijke output, inclusief gegevensverwerving, gegevensvoorbewerking, gegevenssplitsing, modelselectie, kenmerkextractie, tumorvoorspelling en evaluatie van het voorgestelde model, zoals weergegeven in Figuur 1.
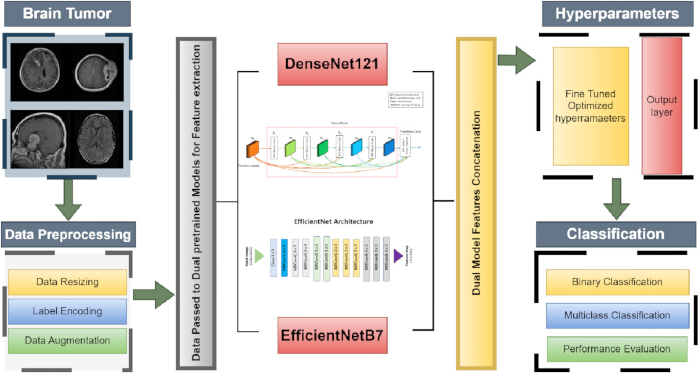
Figuur 1: Workflow van de voorgestelde methodologie. Dit diagram toont de algemene architectuur van het voorgestelde model, inclusief data-acquisitie en preprocessing; twee vooraf getrainde modellen voor kenmerkextractie; concatenatie van hun kenmerken; en hyperparameter-optimalisatie voor de classificatie van het tumortype en -categorie. Klik hier om een grotere versie van deze figuur te bekijken.
Gegevensverwerving
Bij elk experimenteel onderzoek is de eerste stap de data-acquisitie. Hiervoor zijn vijf verschillende publiek beschikbare datasets gekozen, waaronder Br35H24, Figshare25, Sartaj26, Masoud27 en de op MRI-beelden gebaseerde dataset van hersentumoren uit de open-source bibliotheek Kaggle28, die reeds door vele onderzoekers zijn gebruikt voor de diagnose en detectie van hersentumoren. De Br35H-dataset bevat 3.000 beelden bestaande uit twee klassen: gezonde en ongezonde (tumor) hersenbeelden, met 1.500 beelden per klasse, terwijl de Figshare-dataset 3.064 beelden bevat, onderverdeeld in drie groepen op basis van het tumortype: 1.426 beelden van glioom, 708 beelden van meningeom en 930 beelden van hypofysetumoren. De Sartaj-dataset bevat 3.264 beelden gecategoriseerd in vier tumor-klassen: glioom (926 beelden), meningeom (937 beelden), hypofysetumoren (901 beelden) en gezond of geen tumor (500 beelden). Daarnaast bevat de Masoud-dataset eveneens vier verschillende tumor-klassen, waarvan de beelden zijn afkomstig uit de drie bovengenoemde datasets, met een totaal van 7.023 beelden, die verder zijn gecategoriseerd in glioom (1.621 beelden), meningeom (1.645 beelden), hypofyse (1.757 beelden) en gezond of geen tumor (2.000 beelden). De laatst gekozen dataset is een op MRI-beelden gebaseerde dataset, die ook vier klassen bevat met in totaal 5.248 beelden, verder onderverdeeld in tumortypen, waaronder 1.312 glioom-beelden, 1.312 meningeom-beelden, 1.312 hypofyse-beelden en 1.312 beelden van gezond of geen tumor, die reeds gelijkmatig over de tumortypen zijn verdeeld en worden beschouwd als een gebalanceerde dataset.
Gegevensvoorbewerking
Na de gegevensacquisitie is de volgende stap de preprocessing, wat essentieel is voor betere resultaten en nuttiger is voor computationele benaderingen om de beste kenmerken uit de gegevens te extraheren en te leren, wat leidt tot nauwkeurigere resultaten. De eerste stap die werd toegepast, was het herschalen van de beelden. Vijf openbaar beschikbare datasets met verschillende klassen en beeldformaten, zelfs binnen dezelfde dataset voor verschillende tumorklassen, zijn gekozen en uniform herschaald naar 224 x 224 voor een betere modelinterpretatie en leerbaarheid. Daarnaast werd data-augmentatie toegepast op alle datasets door extra monsters vanuit verschillende hoeken te genereren, waardoor de kenmerkextractie en het leren door DL-modellen werden verbeterd. Hiervoor werd een rotatiebereik van 7% toegepast op alle beelden, waarbij ze tot 7 graden werden gedraaid. Verder werd een random shift van 5% toegepast op alle beelden, zowel horizontaal als verticaal, met een verschuiving van 5% in hoogte en breedte ten opzichte van de originele beelden. Daarna werden de beelden met 10% ingezoomd ten opzichte van de originele beelden, en tot slot werden alle beelden horizontaal en verticaal gespiegeld. De belangrijkste reden voor het uitvoeren van data-augmentatie29 is om overfitting te overwinnen en de generalisatie van modellen te verbeteren door te trainen op diverse getransformeerde versies van de originele datamonsters. Voordat de datasets werden gesplitst in training- en validatiesets, werd label-encoding toegepast, wat nuttiger is bij het berekenen van het verlies (loss) tijdens training en validatie, terwijl de datamonsters tegelijkertijd essentiëler worden voor modellen om de labels correct te verwerken. Daarnaast is de dataset verdeeld in trainings- en validatiesets, met een verhouding van 80% tot 20%30 voor elk, en Tabel 2 toont de totale distributie van datamonsters en hun trainings- en validatieverhoudingen.
| Dataset | Tumorklassen | Totaal aantal afbeeldingen | Trainingsafbeeldingen | Validatieafbeeldingen |
| Br35H | Gezond | 1500 | 1200 | 300 |
| Tumor | 1500 | 1200 | 300 | |
| Totaal aantal afbeeldingen | 3000 | 2400 | 600 | |
| Figshare | Glioom | 1426 | 1141 | 285 |
| Meningeoom | 708 | 566 | 142 | |
| Hypofyse | 930 | 744 | 186 | |
| Totaal aantal afbeeldingen | 3064 | 2451 | 613 | |
| Sartaj | Glioom | 926 | 741 | 185 |
| Meningeoom | 937 | 749 | 188 | |
| Geen tumor | 500 | 400 | 100 | |
| Hypofyse | 901 | 721 | 180 | |
| Totaal aantal afbeeldingen | 3264 | 2611 | 653 | |
| Masoud | Glioom | 1621 | 1297 | 324 |
| Meningeoom | 1645 | 1316 | 329 | |
| Geen tumor | 2000 | 1600 | 400 | |
| Hypofyse | 1757 | 1405 | 352 | |
| Totaal aantal afbeeldingen | 7023 | 5618 | 1405 | |
| Gebalanceerde dataset van hersentumoren (BBT-Dataset) | Glioom | 1312 | 1050 | 262 |
| Meningeoom | 1312 | 1050 | 262 | |
| Geen tumor | 1312 | 1050 | 262 | |
| Hypofyse | 1312 | 1050 | 262 | |
| Totaal aantal afbeeldingen | 5248 | 4200 | 1048 |
Tabel 2: Verdeling van de dataset. De tabel toont klas-specifieke statistieken van het totale aantal afbeeldingen, evenals de aantallen voor training en validatie in hersentumordatasets.
De Br35H-dataset bestaat uit 3000 afbeeldingen, waarvan er 2400 zijn geselecteerd voor training en 600 voor validatie. De Figshare-dataset omvat 3064 afbeeldingen. Van alle afbeeldingen zijn er 2451 geselecteerd voor training en de resterende 613 voor validatie. De Sartaj-dataset bevat in totaal 3264 afbeeldingen, waarvan 2611 zijn gebruikt voor training en de overige 653 voor validatie. De Masoud-dataset bevat in totaal 7023 afbeeldingen; hiervan zijn 5618 gebruikt voor training en de resterende 1405 voor validatie. De BBT-dataset bevat in totaal 5248 afbeeldingen. Van het totaal aantal afbeeldingen werden er 4200 gebruikt voor trainingsdoeleinden, terwijl de overige 1048 afbeeldingen werden gebruikt voor validatiedoeleinden. Daarnaast illustreert Figuur 2 hieronder de verschillende afbeeldingen van hersentumoren.
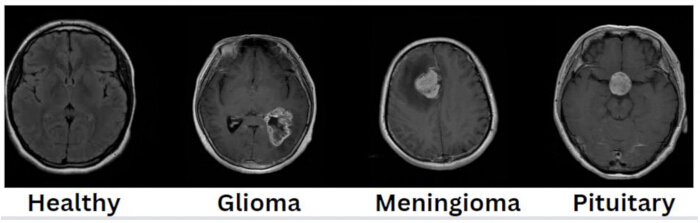
Figuur 2: Beelden van hersentumoren, inclusief tumortypen. De dataset bevat vier beelden van gezond hersenweefsel en drie beelden van tumoren: glioom, meningeoom en hypofyse. Klik hier om een grotere versie van deze figuur te bekijken.
Voorgesteld model
Na de voorverwerkingsfase is de volgende stap het voorstellen van een trainingsmodel dat specifiek effectief is voor de classificatie van hersentumoren. Hiervoor is een efficiënt model voor training voorgesteld, specifiek voor het classificeren van hersentumoren. In dit kader wordt een nieuw en efficiënt, op hybride feature-fusie gebaseerd pretrained model voorgesteld, inclusief DenseNet12131,32 en EfficientNetB733, welke werden gebruikt om de kenmerken uit de beelden te extraheren; vervolgens werden deze geëxtraheerde kenmerken geconcatenneerd en doorgegeven aan verschillende gefinetunede hyperparameters, inclusief trainbare en niet-trainbare lagen, om hersentumoren nauwkeurig te diagnosticeren. Dit is geïmplementeerd op vijf verschillende openbaar beschikbare datasets, die in de bovenstaande relevante secties zijn besproken. Verder is het DenseNet121-model in 2017 ontwikkeld door Gao Huang en zijn medewerkers en bestaat dit uit 121 lagen. Het hoofddoel van dit model was het maximaliseren van feature-hergebruik en het vermijden van het vanishing gradient-probleem34. De lagen in dit model zijn georganiseerd in dense blocks, die elk meerdere convolutionele lagen bevatten die kenmerken extraheren en leren. Elke laag gebruikt de feature map van alle voorafgaande lagen als input, en de output hiervan is verbonden met de outputs van die lagen en wordt in een feed-forward-wijze als input doorgegeven aan volgende lagen in hetzelfde blok. Daarnaast worden tussen de dense blocks transitielagen toegevoegd, elk bestaande uit een 1 × 1 convolutionele laag, een BatchNormalization-laag en 2 × 2 average pooling-lagen, die de feature map reduceren om de complexiteit van het model te beheersen. Bovendien wordt een laatste laag toegevoegd met een SoftMax-activatiefunctie (AF) vóór een global average pooling-laag voor classificatie. Het fundamentele ontwerp van het DenseNet121-model is hieronder weergegeven in Figuur 334.
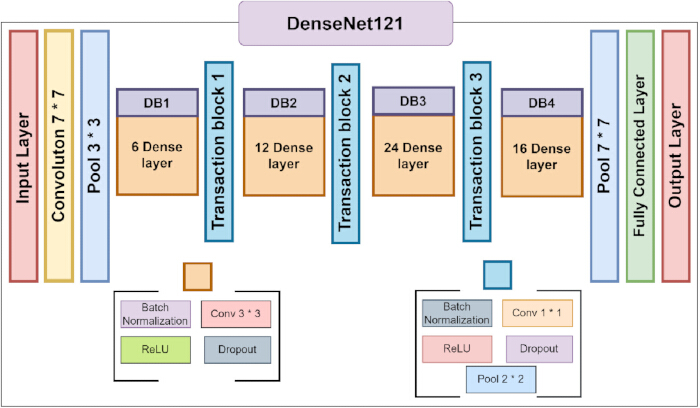
Figuur 3: Architecturale details van DenseNet12134. Deze figuur toont de architecturale details van het DenseNet121-model, inclusief alle dense blocks en transitieblokken. Klik hier om een grotere versie van deze figuur te bekijken.
Verder werd het EfficientNetB7-model in 2019 ontwikkeld door Tan en Lee. Het behoort tot de EfficientNet-familie, met varianten van B0 tot B7, en het hoofddoel is om andere modellen te overtreffen terwijl er minder parameters en minder rekenkracht worden gebruikt. De modelbreedte (aantal kanalen per laag), diepte (aantal lagen) en resolutie kunnen allemaal worden geoptimaliseerd via compound scaling, wat de kernfunctie van het model is. Bovendien bestaat dit model uit MBConv (mobile inverted bottleneck convolutional) blokken, die een 1 × 1 convolutionele expansielaag hebben die verantwoordelijk is voor het uitbreiden van kanalen, een depthwise separable convolution die verantwoordelijk is voor het toepassen van convolutie op elk kanaal afzonderlijk, en een 1 × 1 convolutionele projectielaag die het aantal kanalen terugbrengt naar het oorspronkelijke aantal. Daarnaast bestaat elk MBConv-blok uit Squeeze and Excitation (SE) blokken35, die kanaal-specifieke kenmerken herkalibreren, waardoor het netwerk zich kan concentreren op de belangrijkste kenmerken. Verder wordt in plaats van sigmoid of een andere AF de Swish-functie gebruikt; deze presteert beter dan ReLU doordat negatieve waarden worden toegelaten, wat de gradiëntstroom bevordert. Bovendien wordt voor classificatiedoeleinden een uiteindelijke outputlaag met een SoftMax AF toegevoegd vóór een global average pooling-laag. Figuur 435 toont het basisontwerp van het EfficientNetB7-model, terwijl Figuur 5 de aanbevolen modelarchitectuur laat zien.
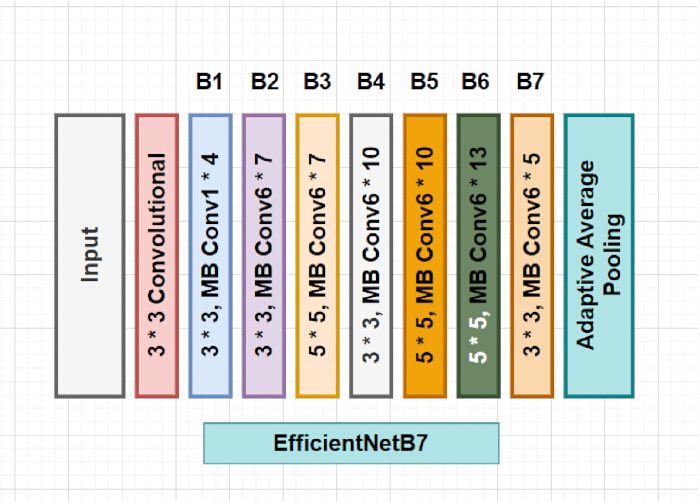
Figuur 4: Architectonisch detail van EfficientNetB735. Deze figuur toont het architectonisch detail van het EfficientNetB7-model, inclusief alle mobile inverted bottleneck convolutionele blokken. Klik hier om een grotere versie van deze figuur te bekijken.
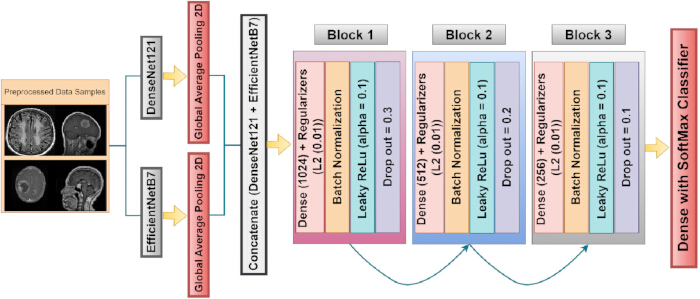
Figuur 5: Voorgestelde hybride gefuseerde modelarchitectuur. De voorgestelde architectuur illustreert hoe voorbewerkte beelden worden doorgegeven aan de feature-extractor, die bestaat uit drie aangepaste blokken met verschillende hyperparameters, gevolgd door een outputlaag. Klik hier om een grotere versie van deze figuur te bekijken.
Daarnaast werden eerste kenmerken geëxtraheerd uit de vooraf getrainde DenseNet121- en EfficientNetB7-modellen. De bijgewerkte gewichten van de vooraf getrainde modellen werden geladen in de getrainde modellen, waarbij de niet-trainbare basislagen van de modellen werden bevroren om te voorkomen dat het model opnieuw getraind zou worden. Dit zou het model moeten helpen om de beste kennis uit het verleden te behouden, deze aan te passen in het licht van nieuwe datasamples om de convergentie te verbeteren, en zich te concentreren op extra lagen om te trainen en geavanceerde kenmerken te extraheren. De onderstaande vergelijkingen 1 en 2 tonen de werking van de DenseNet121- en EfficientNetB7-modellen.
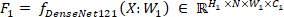 (1)
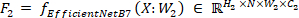 (2)
De bovenstaande vergelijkingen 1 en 2 tonen de werking van het vooraf getrainde model met betrekking tot kenmertextractie; F1 staat voor de output-featuremaps gegenereerd door het vooraf getrainde DenseNet121-model en F2 staat voor de output-featuremaps gegenereerd door het vooraf getrainde EfficientNetB7-model door verwerking toe te passen op de input-afbeeldingen, weergegeven door X. Verder zijn W1 en W2 de leerbare parameters of gewichten geassocieerd met de eerste blokken en lagen van respectievelijk de DenseNet121- en EfficientNetB7-modellen. Bovendien vertegenwoordigen ∈ RN ×H1×W1×C1 en ∈ RN ×H2×W2×C2 respectievelijk de dimensionaliteit van de output-featuremaps van de DenseNet121- en EfficientNetB7-modellen, met dimensies van H1 ×N×W1×C1 en H2 ×N×W2×C2, waarbij N de batchgrootte van de afbeeldingen vertegenwoordigt, die is vastgesteld op 16. Verder vertegenwoordigt H1×W1 respectievelijk de hoogte en breedte van de afbeeldingen voor het DenseNet121-model en H2×W2 de hoogte en breedte van de afbeeldingen voor het EfficientNetB7-model, waarbij is gekozen voor afmetingen van 224 × 224. C1 en C2 vertegenwoordigen respectievelijk het kleurkanaal voor de DenseNet121- en EfficientNetB7-modellen. Nadat de output-featuremaps van het model zijn verkregen als 2560 kanalen output van EfficientNetB7 en 1024 van DenseNet121, wordt de global average pooling 2D36 laag toegepast op de output-featuremaps om de ruimtelijke dimensie te reduceren door het gemiddelde van alle ruimtelijke dimensies naar een enkele vector te brengen, wat gemakkelijker is om door te geven naar de volgende laag voor betere kenmertextractie en patroonherkenning in termen van interpreteerbare kenmerken.
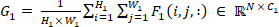 (3)
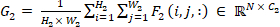 (4)
De bovenstaande vergelijkingen 3 en 4 tonen de werking van de global average pooling 2D-laag toegepast op respectwelijks de DenseNet121- en EfficientNetB7-modellen, waarbij  en
 de procedure laten zien voor het normaliseren van de som door te delen door het totale aantal ruimtelijke locaties voor beide modellen, om ervoor te zorgen dat de gepoolde output een gemiddelde is in plaats van een eenvoudige som.
 en
 representeren de sommatie over de ruimtelijke dimensies van de feature maps, terwijl i en j worden gebruikt voor het itereren over respectwelijks de hoogte en breedte, om de feature maps voor beide modellen op te tellen. Verder representeren F1(i, j, :) en F2(i, j, :) de waarden van de feature maps op specifieke ruimtelijke posities (i, j) over alle kanalen voor respectwelijks de DenseNet121- en EfficientNetB7-modellen. Deze pooling-operatie aggregeert ruimtelijke informatie tot een compactere en nauwkeurigere representatie, terwijl de belangrijkste kenmerken in elke afbeelding behouden blijven. Bovendien worden de outputs van de global average pooling-lagen geconcateneerd om een enkele feature vector per sample te produceren, wat vaak wordt gebruikt om kenmerken van verschillende modellen te fuseren en de prestaties te verbeteren door gebruik te maken van de sterke punten van beide modellen; vergelijking 5 laat zien hoe dit werkt.
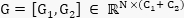 (5)
Bovenstaande vergelijking 5 toont de concatenatieprocedure van twee verschillende model-featurevectoren [G1, G2], waarbij G1 de featurevector van het DenseNet121-model vertegenwoordigt en G2 de featurevector van het EfficientNetB7-model, terwijl de vorm van de geconcatenereerde featurevector wordt weergegeven door RN ×(C1+ C2), waarbij N de batchgrootte is, wat het aantal monsters vertegenwoordigt dat parallel wordt verwerkt, en (C1+ C2) het totale aantal features is dat respectievelijk uit model 1 en 2 wordt verkregen, wat ongeveer 3584 is en parallel wordt verwerkt; de geconcatenereerde output-featurevector wordt weergegeven door G. Verder zijn er drie verschillende blokken toegevoegd om het gefuseerde model aan te passen voor het extraheren van complexere features, het verbeteren van de generalisatie en het voorkomen van overfitting, om zo nauwkeurigere en efficiëntere resultaten te verkrijgen. Elk blok bestaat uit een dense layer met een verschillend aantal neuronen; het eerste blok heeft 1024 neuronen in zijn dense layers, die zich richten op het vastleggen van een breed scala aan features en meer generieke patronen in de data, terwijl het tweede blok 512 neuronen in zijn dense layer heeft, die de features specifiek verfijnen door de dimensionaliteit te verminderen en zich te concentreren op specifiekere patronen. Het derde blok bevat 256 neuronen in zijn dense layer, die de features specifieker distilleren om ervoor te zorgen dat alleen de meest relevante features en patronen naar de outputlaag worden doorgegeven voor het uitvoeren van een relevantere taak. Bovendien zijn L2-regularisatiebenaderingen37 toegevoegd aan elke dense layer in elk blok om overfitting te voorkomen door grotere gewichten te bestraffen, wat er ook toe leidt dat het model complexer wordt. Er is ook een dropoutlaag38 geïntroduceerd na elk blok om willekeurig respectievelijk 30%, 20% en 10% van de neuronen voor blok 1, 2 en 3 te negeren, wat de netwerken dwingt om robuustere features te ontwikkelen die niet afhankelijk zijn van een enkel neuron. Verder is, om het trainingsproces te stabiliseren, een BatchNormalization-laag39 toegepast na elke dense layer, wat ervoor zorgt dat de activaties binnen een stabiel bereik blijven en het model helpt om problemen zoals vanishing gradients en exploding gradients tijdens de trainingsfase te vermijden. Daarnaast heeft deze BatchNormalization-laag het trainingsproces versneld, waardoor het model sneller kon convergeren door het loss-landschap te egaliseren, wat het voor optimizers gemakkelijker maakte om globale minima te vinden. Verder is in elk blok, om non-lineariteit te produceren, leaky ReLU-activatie40 gebruikt, waardoor het model complexe patronen kan leren; leaky ReLU heeft voordelen ten opzichte van andere activatiefuncties doordat het ervoor zorgt dat het neuron niet inactief wordt door een kleine, on-nul gradiënt toe te staan voor negatieve inputs. Verder toont de onderstaande vergelijking 6 de werking van de verschillende blokken die zijn geïntegreerd in het hybride gefuseerde model.
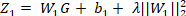 (6)
Nadat de geconcateneerde vector is verkregen, wordt G door de dense layer (volledig verbonden) van blok 1 geleid met 1024 neuronen, waarbij de gewichtsmatrix W1 de inputvector G transformeert naar een 1024-dimensionale outputvector en elk element in de outputvector een lineaire combinatie is van de inputfeatures. Vervolgens wordt de biasvector b1 toegevoegd aan elk van de 1024 elementen in de output, waardoor het model de output van de inputfeatures onafhankelijk kan verschuiven. Daarnaast straft de L2-regularisatieterm: λ||W1||22 grote gewichten af, wat voorkomt dat het model overmatig afhankelijk wordt van een enkel neuron, wat helpt bij het vermijden van overfitting. Hierbij is de gewichtsmatrix van een specifieke laag in het neurale netwerk W1, terwijl ||W1||22 de gekwadrateerde L2-norm van de gewichtsmatrix W1 aanduidt en λ de regularisatieparameter is die de mate van toegepaste regularisatie beheerst, welke in alle blokken is ingesteld op 0,1. Z1 wordt de nieuwe feature-representatie na toepassing van de dense layer en de L2-regularisatie op de input uit de geconcateneerde vector G, zoals weergegeven in vergelijking 6.
Nadat de output van de dense-laag van blok 1 was verkregen als Z1, werd de BatchNormalization-laag toegepast om het trainingsproces te versnellen; onderstaande vergelijking 7 laat zien hoe dit werkt.
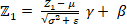 (7)
σ2 representeert de variantie van de output van de laatste laag Z1 over de batch, terwijl μ het gemiddelde is van de output Z1, welke afzonderlijk voor elk neuron wordt berekend, zijnde 1024 in de eerste dense laag. Daarentegen is ε een kleine constante die is toegevoegd om numerieke stabiliteit te waarborgen en deling door nul te voorkomen. De genormaliseerde output kan door het model worden aangepast via de leerbare schaalparameter γ, terwijl de genormaliseerde output kan worden verschoven door de leerbare shiftparameter β. Ten slotte zorgt de genormaliseerde output Z1, na toepassing van de BatchNormalization-laag op de output van de dense laag, ervoor dat de activaties een consistente distributie hebben over de verschillende lagen, wat helpt bij het stabiliseren en versnellen van de training. Na de BatchNormalization gaat de genormaliseerde output Z1 door de leaky ReLU-activatiefunctie, die niet-lineariteit in het netwerk introduceert om het leren van complexe patronen in de data te ondersteunen. In plaats van ReLU of een andere activatiefunctie is gekozen voor leaky ReLU; dit is een gemodificeerde versie van de ReLU-functie die ook kleine negatieve waarden meeneemt in plaats van deze op 0 te zetten, zoals bij de ReLU-activatiefunctie, om zo het 'dying ReLU'-probleem te overwinnen. Vergelijking 8 hieronder laat zien hoe dit werkt.
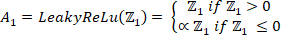 (8)
Waarbij Z1 de output is van de BatchNormalization-laag, die als input naar Leaky ReLU wordt doorgegeven om non-lineariteit toe te passen, terwijl ∝ een kleine constante is die wordt gebruikt om de helling van het negatieve deel van de functie te bepalen. Verder geeft A1 de output weer die wordt verkregen na het toepassen van de non-lineariteit. Ten slotte wordt een dropout-laag toegepast op de output A1 die als input wordt ontvangen van de Leaky ReLu-activatie, zoals weergegeven in vergelijking 9.
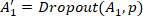 (9)
Waarbij A1 de oorspronkelijke output van de activatiefunctie is die is ontvangen van de laatste ReLu-activatiefunctie, en waarbij p de dropout-rate is, die varieert tussen 0 en 1 en is gekozen als respectievelijk 0,3, 0,2 en 0,1 voor drie bloklagen, enkel om een fractie van de neuronen weg te laten. Verder toont A1′ de gewijzigde output na toepassing van de dropout-laag, waarbij sommige neuronen op 0 zijn gezet. Het belangrijkste voordeel van dit gebruik is het voorkomen van overfitting-problemen en het verminderen van co-adaptatie. Vervolgens wordt de output van blok 1, A1′, opnieuw doorgegeven aan het volgende blok om opnieuw abstractere kenmerken te extraheren, waarbij dezelfde parameters als in blok 1 zijn toegepast, met als enig onderscheid 512 neuronen in de dense layer in plaats van 1024 en een dropout-rate van 0,2 in plaats van 0,3; de overige operationele sequenties zijn hetzelfde, zoals beschreven in de onderstaande vergelijkingen 10 tot 13.
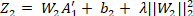 (10)
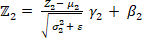 (11)
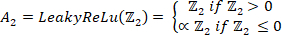 (12)
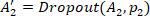 (13)
Nadat de output van blok 1 is verkregen als A1′, wordt deze door de dense layer (volledig verbonden) van blok 2 geleid met 512 neuronen, waarbij de gewichtsmatrix W2 de inputvector A1′ transformeert in een 512-dimensionale outputvector, en elk element in de outputvector een lineaire combinatie is van de inputkenmerken. Vervolgens wordt de biasvector b2 toegevoegd aan elk van de 512 elementen in de output, waardoor het model de output van de inputkenmerken onafhankelijk kan verschuiven. Daarnaast is L2-regularisatie toegepast waarbij λ||W2||22 grote gewichten bestraft, wat dient om overfitting te beperken door te voorkomen dat het model een overmatige afhankelijkheid plaatst bij een specifiek neuron in dit specifieke blok. Hierbij is W2 de gewichtsmatrix van een specifieke laag in het neurale netwerk, terwijl λ de regularisatieparameter is die de mate van toegepaste regularisatie beheerst, welke is ingesteld op 0.1. Z2 wordt de nieuwe kenmerkrepresentatie na toepassing van de dense layer en L2-regularisatie op de input uit blok 1, zoals weergegeven in vergelijking 10.
Verder werd de BatchNormalization-laag toegepast op de nieuwe feature Z2, die werd gebruikt om het trainingsproces te versnellen; σ22 representeert de variantie over de batch, terwijl μ2 het gemiddelde is van de output Z2. Hoewel ε een kleine constante is die is toegevoegd om de numerieke stabiliteit te waarborgen, is γ een leerbare schaalparameter waarmee het model de genormaliseerde output kan aanpassen, en β is een leerbare verschuivingsparameter waarmee het model de genormaliseerde output kan verschuiven. Ten slotte, na het toepassen van de BatchNormalization-laag, zoals weergegeven in vergelijking 11, ging de genormaliseerde output Z2 door de leaky ReLU AF, wat non-lineariteit in het netwerk produceerde, zoals weergegeven in vergelijking 12. Hierbij behoort Z2 tot de output van de BatchNormalization-laag, die als input naar Leaky ReLU gaat voor het realiseren van de non-lineariteit. Terwijl A2 de output weergeeft die is verkregen na het toepassen van de non-lineariteit.
Ten slotte wordt een dropout-laag toegepast op de output A2 die als input is ontvangen van de Leaky ReLU-activatie, zoals weergegeven in vergelijking 13. Hierbij is A2 de output van de laatste ReLU-activatiefunctie en is p2 de dropout-rate, die voor dit blok op 0,2 is ingesteld om een fractie van de neuronen weg te laten. Verder toont A2′ de aangepaste output na toepassing van de dropout-laag, waarbij sommige neuronen op 0 zijn gezet. Vervolgens wordt de output van blok 2, A2′, opnieuw doorgegeven aan het derde blok om opnieuw meer abstracte kenmerken te extraheren. Hierbij zijn dezelfde parameters toegepast als in blok 2, met als enige verschillen 256 neuronen in de dense layer in plaats van 512 en een dropout-rate van 0,1 in plaats van 0,2; de overige operationele sequenties zijn gelijk, zoals beschreven in de onderstaande vergelijkingen 14 tot 17.
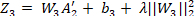 (14)
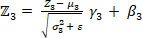 (15)
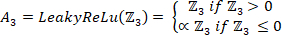 (16)
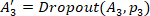 (17)
Nadat de output van blok 2 is verkregen als A2′, wordt deze doorgegeven aan de dense layer (volledig verbonden) van blok 3 met 256 neuronen, waarbij de gewichtsmatrix W3 de inputvector A2′ transformeert naar een 256-dimensionale outputvector, en elk element in de outputvector een lineaire combinatie is van de inputkenmerken. Vervolgens wordt de biasvector b3 toegevoegd aan elk van de 256 elementen in de output, waardoor het model de output van de inputkenmerken onafhankelijk kan verschuiven. Verder is er L2-regularisatie toegepast waarbij λ||W3||22 grote gewichten bestraft; dit voorkomt dat het model overmatig afhankelijk wordt van een enkel neuron, wat helpt bij het vermijden van overfitting. Hierbij is W3 de gewichtsmatrix van een specifieke laag in het neurale netwerk, terwijl de graad van de toegepaste regularisatie wordt gecontroleerd door de regularisatieparameter λ, die is ingesteld op 0,01. Z3 wordt de nieuwe kenmerkrepresentatie na toepassing van de dense layer en de L2-regularisatie op de input vanuit blok 3, zoals weergegeven in vergelijking 14.
Verder is de BatchNormalization-laag toegepast op de nieuwe kenmerk Z3, wat werd gebruikt om het trainingsproces te versnellen; σ32 vertegenwoordigt de variantie over de batch, terwijl μ3 het gemiddelde is van de output Z3. Daarbij is ε de kleine constante die wordt toegevoegd voor numerieke stabiliteit. De genormaliseerde output kan door het model worden aangepast met de leerbare schaalparameter γ3 en worden verschoven met de leerbare shiftparameter β3. Ten slotte, na het toepassen van de BatchNormalization-laag, zoals weergegeven in vergelijking 15, ging de genormaliseerde output Z3 door de leaky ReLU-activeringsfunctie, die voor non-lineariteit in het netwerk zorgde, zoals weergegeven in vergelijking 16. Hierbij behoort Z3 tot de output van de BatchNormalization-laag, die als input naar Leaky ReLU gaat om non-lineariteit te genereren. Terwijl A3 de output laat zien die wordt verkregen na het toepassen van de non-lineariteit.
Ten slotte wordt een dropout-laag toegepast op de output A3 die als input wordt ontvangen van de Leaky ReLU-activatie, zoals weergegeven in vergelijking 17. Hierbij is A3 de output van de laatste ReLU-activatiefunctie, en p3 de dropout-rate, die voor dit blok op 0.1 is gesteld om een fractie van de neuronen te verwijderen. Verder toont A3′ de gewijzigde output na toepassing van de dropout-laag, waarbij sommige neuronen op 0 zijn gezet.
Verder wordt de output van blok 3 A3′ door de laatste dichte laag geleid voor classificatiedoeleinden met een K-aantal neuronen dat het werkelijke aantal klassen in de dataset vertegenwoordigt, zoals beschreven in vergelijking 18 hieronder.
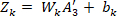 (18)
De gewichtsmatrix gekoppeld aan de dikke laag is Wk, die verantwoordelijk is voor het transformeren van de 256-dimensionale vector A3′ naar een k-dimensionale vector, die de geleerde kenmerken uit het vorige blok representeert en als output dient. Verder representeert bk de bias-vector die de voorspelling aanpast om te garanderen dat de activatiefunctie een output ongelijk aan nul heeft wanneer de input nul is, en Zk is de output van de laatste laag vóór de toepassing van de activatiefunctie, welke de logits per klasse produceert; tot slot is een SoftMax41-classifier toegepast die de logit Zk omzet in de waarschijnlijkheid van elke klasse, zoals weergegeven in vergelijkingen 19 en 20.
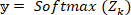 (19)
 (20)
Waarbij de voorspelde waarschijnlijkheid van de ide klasse wordt weergegeven door yi, K het aantal klassen is, terwijl Zk, i de logit is voor de ide klasse, en eZk, i de exponentiële waarde is van de logit van de ide klasse. y toont de waarschijnlijkheidsverdeling van alle mogelijke klassen en zorgt ervoor dat de som van de waarschijnlijkheden 1 is. Tabel 3 hieronder geeft de details van de hyperparameters die zijn gebruikt om het voorgestelde hybride model te trainen, inclusief de architecturale details die zijn toegepast voor verbeterde reproduceerbaarheid en prestaties.
| Hyperparameters | Voorgesteld model (FusionNetX) |
| Afbeeldingsgrootte | 224 × 224 |
| Backbone-architectuur | Voorgeconfigureerde EfficientNetB7 en DenseNet121 als BBA1 en BBA2 |
| Data-augmentatie | Rotatiebereik = 7, |
| Breedte/hoogte – verschuivingsbereik tot 0,05, | |
| Zoombereik tot 0,01, | |
| Horizontaal/verticaal spiegelen | |
| Gegevenssplitsingsverhouding | 80% voor training en 20% voor validatie via gestratificeerde steekproefmeting met een vaste random_state = 42 |
| Kenmerkextractie en -fusie | Global average pooling wordt toegepast op de output van elke backbone: 2560 voor BBA1 en 1024 voor BBA2, die vervolgens worden gefuseerd om 3584 gezamenlijke kenmerkvectoren te verkrijgen. |
| Samenstelling van het volledig verbonden blok | 3 volledig verbonden blokken met 1 outputlaag. Elk blok bevat L2-regularisatie (λ=0,01), BatchNormalization, LeakyReLU (α=0,01), Dropout van (0,3, 0,2 en 0,1) en een verborgen dimensie van respectievelijk (1024, 512, 256). Er is geen extra skip-verbinding geïntroduceerd in de fusion head. |
| Activeringsfunctie | Leaky ReLU & SoftMax |
| Optimizer en leersnelheid | Adam met 0,00001 vastgesteld zonder learning rate scheduler. |
| Verliesfunctie | sparse_categorical_crossentropy |
| Batchgrootte | 16 |
| Epochs | 100 vaste epochs voor elke dataset |
| Gebruikt platform | Kaggle Notebook met een P100 GPU en 16 GB VRAM met de TensorFlow- en Keras-platforms. |
Tabel 3: Hyperparameters gebruikt voor het trainen van het voorgestelde model en de voorgestelde architecturale details.Deze tabel geeft de structurele en architecturale details van het voorgestelde model, samen met de gefinetunede parameters en de implementatieomgeving.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Dit deel beschrijft de resultaten van het testen van het voorgestelde dual feature fusion-model op vijf open-source datasets over hersenkankers, waaronder de datasets Br35H, Figshare, Sartaj, Masoud en Balanced Brain tumor, waarbij hun prestaties worden geëvalueerd aan de hand van verschillende statistische evaluatieparameters, waaronder nauwkeurigheid42,43,44, misclassificatiegraad (MCR)45, precisie, ook...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Zoals geconcludeerd, werkte het voorgestelde model als volgt: Ten eerste werd de afbeeldingsgrootte vastgesteld op 224 × 224, wat een gematigde grootte is voor elk deep learning-model om geschikte kenmerken uit de datasamples te extraheren en te leren terwijl alle belangrijke informatie behouden blijft; vervolgens werd data-augmentatie uitgevoerd, wat gunstig is om datasamples in meer diverse richtingen te creëren, wat een belangrijke rol speelt bij het extraheren van kenmerken vanuit verschillende vlakken of hoeken. Het...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs hebben niets te melden en hebben geen belangenconflict. Bovendien zijn er geen AI-tools gebruikt voor het genereren van het manuscript of de figuren.
Dankbetuigingen
De auteurs zijn dankbaar voor de ondersteuning geboden door het Princess Nourah bint Abdulrahman University Researchers Supporting Project (PNURSP2026R192), Princess Nourah bint Abdulrahman University, Riyad, Saoedi-Arabië. De auteurs danken tevens de deelnemers aan het onderzoek en de instellingen die hebben bijgedragen aan dit onderzoek.
Financiering:
Dit werk werd ondersteund door een beurs van de National Research Foundation of Korea (NRF), gefinancierd door de Koreaanse overheid (MSIT) (Nr. RS-2023-00218176) en het Soonchunhyang University Research Fund. Princess Nourah bint Abdulrahman University Researchers Supporting Project nummer (PNURSP2026R192), Princess Nourah bint Abdulrahman University, Riyadh, Saudi-Arabië.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Br35H Brain Tumor Dataset | Kaggle (datasetbijdrager) | https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection | Openbare dataset; binaire classificatie (tumor / geen tumor) 300 MRI-beelden |
| Figshare Brain Tumor Dataset | Kaggle / Figshare | https://doi.org/10.6084/m9.figshare.1512427 | Openbare dataset; multiclass (glioom, meningeoom, hypofysetumor) 3064 MRI-beelden |
| Sartaj Brain Tumor Classification MRI Dataset | Kaggle (dataset door Sartaj Bhuvaji) | https://doi.org/10.34740/kaggle/dsv/12745533 | Openbare dataset; multiclass (glioom, meningeoom, geen tumor, hypofysetumor) 3264 MRI-beelden |
| Masoud Brain Tumor MRI Dataset | Kaggle (dataset door Masoud Nickparvar) | https://doi.org/10.34740/kaggle/dsv/14832123 | Openbare dataset; multiclass (glioom, meningeoom, geen tumor, hypofysetumor) 7023 MRI-beelden |
| BBT-Dataset (Brain Tumor Dataset) | Kaggle (datasetbijdrager) | https://doi.org/10.34740/kaggle/dsv/6758053 | Openbare dataset; gebalanceerde multiclass hersentumor 5248 MRI-beelden |
| Python | Python Software Foundation | https://www.python.org | Programmeertaal, versie 3.10.13 |
| TensorFlow / Keras | Google / TensorFlow-ontwikkelaars | https://www.tensorflow.org | Deep learning-framework; modelconstructie, training en evaluatie, versie 2.15.0 |
| EfficientNetB7 (pretrained) | Google / Keras Applications | https://keras.io/api/applications/efficientnet/ | ImageNet-pretrained backbone; kenmerkextractie |
| DenseNet121 (pretrained) | Keras Applications | https://keras.io/api/applications/densenet/ | ImageNet-pretrained backbone; kenmerkextractie |
| scikit-learn | scikit-learn-ontwikkelaars (NumFOCUS) | https://scikit-learn.org | Labelcodering, train-test split, evaluatiemetrieken (classificatierapport, verwarringsmatrix, ROC/AUC) |
| OpenCV (cv2) | OpenCV-team | https://opencv.org | Laden en schalen van beelden |
| NumPy | NumPy-ontwikkelaars (NumFOCUS) | https://numpy.org | Numerieke berekeningen en array-operaties |
| pandas | pandas-ontwikkelteam (NumFOCUS) | https://pandas.pydata.org | Dataorganisatie en tabellering van metrieken |
Referenties
- He Z, et al. A review on methods for diagnosis of breast cancer cells and tissues. Cell Prolif. 2020;53(7):e12822. doi:10.1111/cpr.12822.
- Siegel RL, Giaquinto AN, Jemal A. Cancer statistics, 2024. CA Cancer J Clin. 2024;74(1):12–49.
- Varuna Shree N, Kumar TNR. Identification and classification of brain tumor MRI images with feature extraction using DWT and probabilistic neural network. Brain Inform. 2018;5(1):23–30.
- Ghoreishi Mokri SM, Valadbeygi N, Grigoryeva V. Diagnosis of glioma, menigioma and pituitary brain tumor using MRI images recognition by deep learning in Python. EAI Endorsed Trans Intell Syst Mach Learn Appl. 2024;1:1–9.
- Sadeghi MH, et al. Deep learning in ovarian cancer diagnosis: a comprehensive review of various imaging modalities. Pol J Radiol. 2024;89:e30–e48.
- Anari S, Safarpour H, Cunneen M, Bendechache M. AR-EpiAid: an augmented reality decision support system for real-time interpretation of multimodal epilepsy data [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468245.
- Iyortsuun NK, et al. A review of machine learning and deep learning approaches on mental health diagnosis. Healthcare (Basel). 2023;11(3):285. doi:10.3390/healthcare11030285.
- An Q, Rahman S, Zhou J, Kang JJ. A comprehensive review on machine learning in the healthcare industry: classification, restrictions, opportunities, and challenges. Sensors (Basel). 2023;23(9):4178. doi:10.3390/s23094178.
- Iqbal S, Qureshi AN, Li J, Mahmood T. On the analyses of medical images using traditional machine learning techniques and convolutional neural networks. Arch Comput Methods Eng. 2023;30:3173–3233.
- Chhimpa GR, et al. A transfer learning-driven fine-tuning of YOLOv10 for improved brain tumor detection in MRI images. Sci Rep. 2026;16:98. doi:10.1038/s41598-025-28813-w.
- Akbarian S, Seyyed-Kalantari L, Khalvati F, Dolatabadi E. Evaluating knowledge transfer in the neural network for medical images. IEEE Access. 2023;11. doi:10.1109/ACCESS.2023.3283216.
- Meena G, Mohbey KK, Acharya M, Lokesh K. An improved convolutional neural network-based model for detecting brain tumors from augmented MRI images. J Auton Intell. 2023;6:1–19.
- Ata MM, Yousef RN, Karim FK, Khafaga DS. An improved deep structure for accurately recognizing brain tumors. Comput Syst Sci Eng. 2023;46(2):1597–1616.
- Khushi HMT, et al. Performance analysis of state-of-the-art CNN architectures for brain tumour detection. Int J Imaging Syst Technol. 2024;34:e22949. doi:10.1002/ima.22949.
- Agarwal M, et al. Deep learning for enhanced brain tumor detection and classification. Results Eng. 2024;22:102117. doi:10.1016/j.rineng.2024.102117.
- Peddinti AS, Maloji S. Optimised ResNet50 for multiclass classification of brain tumors. Scalable Comput Pract Exp. 2024;25(3):1667–1680.
- Zahoor MM, et al. Brain tumor MRI classification using a novel deep residual and regional CNN. Biomedicines. 2024;12(7):1395. doi:10.3390/biomedicines12071395.
- Chen W, et al. A robust approach for multitype classification of brain tumors using deep feature fusion. Front Neurosci. 2024;18:1288274. doi:10.3389/fnins.2024.1288274.
- Suryawanshi S, Patil SB. Efficient brain tumor classification with a hybrid CNN-SVM approach in MRI. J Adv Inf Technol. 2024;15:340–354.
- Reyes D, Sánchez J. Performance of convolutional neural networks for the classification of brain tumors using magnetic resonance imaging. Heliyon. 2024;10:e25468. doi:10.1016/j.heliyon.2024.e25468.
- Bibi N, et al. A transfer learning-based approach for brain tumor classification. IEEE Access. 2024;12:111218–111238.
- Albalawi E, et al. Integrated approach of federated learning with transfer learning for classification and diagnosis of brain tumor. BMC Med Imaging. 2024;24:110. doi:10.1186/s12880-024-01261-0.
- Alkhatib AJ, et al. Diagnosing brain tumors from MRI images through a multi-fused CNN with auxiliary layers. Sustain Mach Intell J. 2024;6(1):4–13.
- Hamada A. Br35H: Brain Tumor Detection 2020 [dataset]. Kaggle; 2020. Available from: https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection.
- Cheng J. Brain tumor dataset [dataset]. Figshare; 2024. Available from: https://doi.org/10.6084/m9.figshare.1512427.
- Bhuvaji S. Brain Tumor Classification (MRI) [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/12745533.
- Nickparvar M. Brain Tumor MRI Dataset [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/14832123.
- Jayanti V. Brain Tumor MRIs [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/6758053.
- Tuteja P, et al. Augmented multimodal fusion for optimized brain tumor detection: evaluation and comparative analysis. J Vis Exp. 2025;(220):e67822. doi:10.3791/67822.
- Rasool N, et al. CNN-TumorNet: leveraging explainability in deep learning for precise brain tumor diagnosis on MRI images. Front Oncol. 2025;15:1554559. doi:10.3389/fonc.2025.1554559.
- Huang G, Liu Z, van der Maaten L, Weinberger KQ. Densely connected convolutional networks [conference paper]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition; Honolulu, HI, USA; 2017. p. 4700–4708. Available from: https://openaccess.thecvf.com/content_cvpr_2017/html/Huang_Densely_Connected_Convolutional_CVPR_2017_paper.html.
- Tuteja P, Wani MA, Wani NA, Bedi J. EASE-Net: an explainable AI-based segmentation and ensemble network for interpretable brain tumor diagnosis and classification in MRI images. Arab J Sci Eng. 2026;in press. doi:10.1007/s13369-026-11350-7.
- Tan M, Le QV. EfficientNet: rethinking model scaling for convolutional neural networks [conference paper]. Presented at: 36th International Conference on Machine Learning; Long Beach, CA, USA; 2019. p. 6105–6114. Available from: https://proceedings.mlr.press/v97/tan19a.html.
- Vellaichamy AS, Swaminathan A, Varun C, Kalaivani S. Multiple plant leaf disease classification using DenseNet-121 architecture. Int J Electr Eng Technol. 2021;12(5):38–57.
- Naidji MR, Elberrichi Z. Automatic detection of COVID-19 from chest X-ray images using the EfficientNet-B7 CNN model with channel-wise attention. Int J Comput Digit Syst. 2024;15:1443–1456.
- Malla PP, Sahu S, Alutaibi AI. Classification of tumors in brain MR images using a deep convolutional neural network and global average pooling. Processes. 2023;11(3):679. doi:10.3390/pr11030679.
- Shi G, Zhang J, Li H, Wang C. Enhance the performance of deep neural networks via L2 regularization on the input of activations. Neural Process Lett. 2019;50:57–75.
- Srivastava N, et al. Dropout: a simple way to prevent neural networks from overfitting. J Mach Learn Res. 2014;15:1929–1958.
- Ioffe S, Szegedy C. Batch normalization: accelerating deep network training by reducing internal covariate shift [conference paper]. Presented at: 32nd International Conference on Machine Learning; Lille, France; 2015. p. 448–456. Available from: https://proceedings.mlr.press/v37/ioffe15.html.
- Varshney M, Singh P. Optimizing nonlinear activation functions for convolutional neural networks. Signal Image Video Process. 2021;15:1323–1330.
- Bera S, Shrivastava VK. Analysis of various optimizers on a deep convolutional neural network model in the application of hyperspectral remote-sensing image classification. Int J Remote Sens. 2020;41:2664–2683.
- Safarpour H, et al. A dual-phase segmentation framework utilizing Gumbel-Softmax and a cascaded Swin Transformer for multiclass brain tumor segmentation. Research Square. 2025:doi:10.21203/rs.3.rs-7093467/v1.
- Seyrek EC, Uysal M. A comparative analysis of various activation functions and optimizers in a convolutional neural network for hyperspectral image classification. Multimed Tools Appl. 2024;83:53785–53816.
- Maxwell AE, Warner TA, Guillén LA. Accuracy assessment in convolutional neural network-based deep-learning remote-sensing studies—part 1: literature review. Remote Sens (Basel). 2021;13(13):2450. doi:10.3390/rs13132450.
- Villon S, et al. A new method to control error rates in automated species identification with deep-learning algorithms. Sci Rep. 2020;10:10972. doi:10.1038/s41598-020-67573-7.
- Rasool N, et al. TransResUNet: revolutionizing glioma brain tumor segmentation through transformer-enhanced residual UNet. IEEE Access. 2024;12:72105–72116.
- Chen Y, et al. Evaluation efficiency of hybrid deep-learning algorithms with neural-network decision-tree and boosting methods for predicting groundwater potential. Geocarto Int. 2022;37:5564–5584.
- Alakus TB, Turkoglu I. Comparison of deep-learning approaches to predict COVID-19 infection. Chaos Solitons Fractals. 2020;140:110120. doi:10.1016/j.chaos.2020.110120.
- Ranjbarzadeh R, et al. Explainable attention-guided Swin Transformer networks for brain tumor segmentation from 3D MRI. Lect Notes Netw Syst. 2026;1730:110–128. Available from: https://lero.ie/bibliography/explainable-attention-guided-swin-transformer-networks-for-brain-tumor-segmentation-from-3d-mri/.
- Ranjbarzadeh R, et al. A global-local 3D brain tumor segmentation model using vision transformers and axial state-space modeling [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468214.
- Hussain SS, et al. Next-generation automation in neuro-oncology: advanced neural networks for MRI-based brain tumor segmentation and classification. IEEE Access. 2025;13:41141–41158.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.