Dit artikel presenteert een door mensen gesuperviseerde computationele workflow om recurrente representaties van vrouwen in 433 Chinese exportschilderijen uit het Qing-tijdperk te onderzoeken. Zeven referentiecategorieën voor mensen en terugkerende visuele aanwijzingen karakteriseren patronen binnen het corpus, terwijl de bevindingen beperkt blijven tot de geselecteerde afbeeldingen en geen maatstaf vormen voor de sociale realiteit of de historische receptie van de Qing-dynastie.
Onderzoeksartikel
Vrouwelijke identiteit en klasse-imaginatie in Chinese exportschilderijen uit de Qing-dynastie: Een met kunstmatige intelligentie ondersteunde studie naar crossculturele interpretatie
In dit artikel
Samenvatting
Samenvatting
Deze studie onderzocht terugkerende representaties van vrouwelijke identiteit en visuele signalen voor klassenstatus in een corpus van 433 Chinese exportschilderijen uit de Qing-dynastie, gedateerd tussen 1757 en 1911. De workflow combineerde CLIP ViT-B/32 voor voorlopige etikettering, lokalisatie ondersteund door het Segment Anything Model (SAM), dimensionaliteitsreductie en clustering, en handmatige iconografische codering door twee onafhankelijke codeurs. CLIP-labels werden gebruikt voor de voorlopige organisatie, SAM diende als hulpmiddel voor lokalisatie, en geadjudiceerde menselijke codering leverde de referentiecategorieën. De geaggregeerde resultaten identificeerden zeven menselijke referentiecategorieën: elite/schoonheid (n = 112), arbeid (n = 72), huishoudelijk (n = 64), dienstmeisje (n = 58), ritueel/bruiloft (n = 45), markt (n = 43) en uitvoerend (n = 39). Voorlopige computationele labels kwamen overeen met de menselijke referentielabels voor 356 van de 433 schilderijen (82,2%), waarbij de recall op categorieniveau varieerde van 73,3% tot 88,4%. Terugkerende combinaties van kleding, ruimtelijke setting, objecten, houding en afgebeelde sociale relaties werden gebruikt om de visuele profielen van deze categorieën te karakteriseren. Evaluatie van de 433 AI-menselijke labelparen op casusniveau leverde uitgebreide precision-, recall- en F1-scores op categorieniveau op, samen met een confusiematrix die de classificatiepatronen detalieert. Cluster-validatie ondersteunde de geselecteerde clustering-oplossing en toonde een correspondentie aan tussen de afgeleide clusters en de door mensen gedefinieerde referentiecategorieën. Over het algemeen wijzen recurrente combinaties van kleding, ruimtelijke setting, objecten, houding en sociale relaties op gepatroneerde picturale typologieën binnen het gesamplede corpus. Deze bevindingen karakteriseren de visuele representatie in Chinese exportschilderijen uit de Qing-dynastie, maar mogen niet worden geïnterpreteerd als directe maten van juridische status, geleefde ervaring, marktvraag of historische buitenlandse receptie.
Inleiding
Chinese exportschilderijen uit de Qing-dynastie maakten vanaf het einde van de achttiende eeuw deel uit van de commerciële en culturele netwerken die Kanton en andere verzamelcentra verbonden met Euro-Amerikaanse kopers1,2,3,4,5. Handelaren, reizigers, diplomaten, missionarissen en verzamelaars verwierven deze schilderijen als draagbare handelsgoederen, souvenirs, bronnen van visuele informatie en representaties van plaatsen, beroepen, productie, gewoonten en sociale typen. Hun circulatie weerspiegelde daarom zowel de praktijken in Chinese ateliers als de verwachtingen van externe markten.
De buitenlandse vraag was gericht op herkenbare onderwerpen, seriële formats, herhaalde motieven en scènes die verzameld en vergeleken konden worden. Ateliers pasten media, schaal, compositie en onderwerp aan voor de verkoop, terwijl kopers vaak de voorkeur gaven aan begrijpelijke weergaven van ambachten, ceremonies, interieurs, tuinen, straten en pittoreske sociale typen. Herhaalde versies van scènes uit de Canton-ateliers tonen verder aan hoe kunstenaars en assistenten iconografie en westerse beeldmiddelen aanpasten voor overzeese opdrachtgevers1,2,3,4,5. Hoewel de marktvraag mogelijk heeft beïnvloed wat er werd geproduceerd en bewaard, meet het huidige corpus de voorkeuren of reacties van individuele kopers niet direct.
Deze schilderijen moeten daarom worden beschouwd als selectieve en gemedieerde bronnen in plaats van als uitputtende verslagen van het dagelijks leven. De scènes kunnen sociale praktijken idealiseren, vereenvoudigen, standaardiseren of aanpassen via atelierconventies, marktselectie, museumverwerving, catalogisering en digitalisering1,2,3,4,5. De historische interpretatie moet onderscheid maken tussen kenmerken die direct in de schilderijen waarneembaar zijn en gevolgtrekkingen over de afgebeelde personen, de productieomstandigheden en de betekenissen die latere toeschouwers aan de werken hebben toegekend.
Vrouwelijke figuren bieden een gerichte manier om dit onderscheid te onderzoeken. Kleding, kapsel, houding, ruimtelijke setting, objecten, activiteiten en relaties met andere figuren kunnen vrouwen indelen in visueel terugkerende rollen, waaronder categorieën als elite/schoonheid, huishoudelijk, dienstmeisje, arbeid, markt, podiumkunst en ritueel/bruiloft. Deze categorieën zijn analytische beschrijvingen van picturale patronen en stellen op zichzelf geen juridische rang, rijkdom, beroep, etniciteit, Banner- of Han-affiliatie, moreel karakter of geleefde identiteit vast.
Digitale kunstgeschiedenis en computervisie kunnen grootschalige vergelijkingen van gedigitaliseerde visuele collecties faciliteren, terwijl ze tegelijkertijd een kritische toetsing mogelijk maken van de aannames die in computationele modellen zijn ingebed6,7. Visie-taalmodellen kunnen helpen bij het identificeren en organiseren van terugkerende visuele motieven, hoewel culturele bias een belangrijke beperking blijft wanneer hedendaagse modelvocabularies worden toegepast op historische, niet-Westerse beelden8. Gerelateerd computationeel onderzoek naar traditionele Chinese schilderkunst demonstreert op soortgelijke wijze de waarde van het combineren van kwantitatieve patroondetectie met historisch gefundeerde interpretatie9.
Deze studie richt zich op drie vragen: (1) Welke door mensen gecodeerde en beoordeelde categorieën voor vrouwelijke identiteit zijn in het corpus vertegenwoordigd? (2) Welke combinaties van kleding, ruimtelijke setting, objecten, houding en sociale relaties karakteriseren deze categorieën? (3) Hoe variëren de algehele exacte-match nauwkeurigheid en de recall op categorieniveau over de zeven categorieën? De workflow maakt gebruik van computationele benaderingen van traditionele Chinese schilderkunst9, terwijl de historische claims beperkt blijven tot de geselecteerde afbeeldingen en de gedocumenteerde analyses.
De beoogde bijdrage is zowel historiografisch als technisch. Vergelijking op corpusniveau kan terugkerende beeldformules identificeren die vervolgens door middel van nauwkeurige historische analyse kunnen worden gecontextualiseerd. Deze benadering kan onderzoek naar gender, hiërarchie, representaties van het dagelijks leven en interculturele ontmoetingen informeren, zonder de frequentie van beelden als bewijs voor sociale prevalentie of visuele gelijkenis als bewijs voor historische identiteit te beschouwen.
Protocol
Studieontwerp en analytische eenheid
Elk schilderij of catalogusrecord werd beschouwd als één analytische eenheid. Er werd gebruikgemaakt van een corpusgebaseerd observationeel ontwerp, waarbij metadata-beoordeling, voorlopige computationele organisatie, onafhankelijke handmatige codering en kunsthistorische interpretatie werden gecombineerd. De studieperiode werd vastgesteld op 1757–1911, en binnen dit tijdsbestek werden in- en uitsluitingscriteria toegepast. Historische kunstwerken en de bijbehorende catalogusmetadata werden geanalyseerd. Wanneer distributies over datumintervallen van ongelijke duur werden vergeleken, werden de aantallen genormaliseerd naar de duur van het interval, terwijl potentiële overlevings- en acquisitiebiases werden meegewogen in de interpretatie.
Constructie en selectie van het corpus
Kandidaatrecords werden opgehaald uit de geciteerde museumcatalogi, digitale archieven en gepubliceerde catalogi. Voor elk kandidaatrecord werden de instelling, titel, datum of datumbereik, medium, inventaris- of catalogusnummer, stabiele bron-URL, ophaaldatum en rechtenverklaring bewaard. Bronlinks werden behouden, zelfs wanneer het bijbehorende afbeeldingsbestand wettelijk niet herdistribueerd kon worden. De beschreven screeningsprocedure begon met 612 kandidaatsafbeeldingen. Hiervan werden er 85 uitgesloten omdat ze buiten de periode 1757–1911 of de export-schildertraditie vielen, 58 werden uitgesloten omdat het moderne reproducties waren, vervaagde records of incorrecte onderwerpen afbeeldden, 29 werden uitgesloten omdat ze geen identificeerbare vrouwelijke figuur of onvoldoende beeldresolutie hadden, en 7 werden uitgesloten vanwege onvoldoende metadata. Het uiteindelijke analytische corpus bestond uit 433 records.
Standaardisatie van metadata en preprocessing van afbeeldingen
Aan elk schilderij in het uiteindelijke analytische corpus werd een stabiele QEP-identificator toegewezen, variërend van QEP_001 tot QEP_433. Geassocieerde museummetadata werden behouden, waaronder instelling, inventarisnummer, titel, datum, medium of materialen, plaats van herkomst, bronlink en de beschikbare catalogusbeschrijving. Voor de visuele analyse werden het voorlopige AI-label, de door mensen beoordeelde categorie, het aantal vrouwelijke figuren, de leeftijdsgroep, de houding, de kleding, de ruimtelijke setting, geassocieerde objecten en sociale relaties geregistreerd. Elk schilderij werd geclassificeerd in een van de zeven primaire categorieën: elite/schoonheid, huiselijk, dienstmeisje, arbeid, markt, podiumkunst of ritueel/bruiloft. Voor scènes met meerdere vrouwelijke figuren werd de centrale figuur geïdentificeerd op basis van visuele prominentie en narratieve centraliteit. Wanneer geen enkele vrouwelijke figuur dominant was, werd de primaire categorie toegewezen op basis van de belangrijkste afgebeelde activiteit en de algehele context van de scène. Overlappende categorieën werden opgelost door prioriteit te geven aan de afgebeelde activiteit en de scènecontext boven kleding of uiterlijk alleen. Ambigue gevallen werden onafhankelijk beoordeeld door beide codeurs en via consensus opgelost. Bronafbeeldingen werden opgeslagen in JPEG- of PNG-formaat. Alleen webpagina-randen, cataloguskaders of niet-afbeeldingsmarges werden bijgesneden. Geschilderde inhoud werd niet gereconstrueerd, opnieuw gekleurd, verbeterd of gerestaureerd.
Voorlopige labeling op basis van CLIP
De CLIP ViT-B/32 beeldencoder werd gebruikt voor een voorlopige analyse van de gelijkenis tussen afbeelding en tekst9. Kandidaten voor identiteitstermen waren elite woman, domestic woman, female servant, working woman, market woman, female performer, bride en ritual woman. Scenetermen waren Chinese interior, garden, street market, workshop, tea production, textile work en ceremonial scene. De volledige set prompt-templates, hun volgorde, eventuele prompt-ensemblering, tekstnormalisatieprocedures, beslisregels, betrouwbaarheidsscores en gelijke scores werden voor elke afbeelding bewaard.
De volledige promptlijst werd consistent toegepast op alle afbeeldingen met behulp van het OpenAI CLIP ViT-B/32-model, geïmplementeerd in Python 3.10 met PyTorch 2.0.1 en het OpenAI CLIP-pakket. De inferentie werd uitgevoerd op een CUDA-ondersteunde GPU met een batchgrootte van 32 en FP32-precisie. Elke afbeelding werd herschaald en centraal bijgesneden tot 224 × 224 pixels, en de RGB-kanalen werden genormaliseerd met de voorbewerkingstransformatie die bij het ViT-B/32-model hoort. Tekstprompts werden samengesteld met behulp van de hierboven gedefinieerde identiteits- en scènedescriptoren en gecodeerd met de CLIP-tekstencoder. De cosinusovereenkomst werd berekend tussen de genormaliseerde afbeelding- en tekst-embeddings, waarbij de prompt met de hoogste overeenkomstscore werd toegewezen als het voorlopige AI-label. De overeenkomstscores voor alle kandidaatlabels werden bewaard voor een daaropvolgende menselijke beoordeling. Er werd gebruikgemaakt van een vaste random seed van 42, en identieke voorbewerkingsprocedures, prompt-templates en beslisregels werden toegepast op alle 433 schilderijen.
SAM-ondersteunde lokalisatie
Het Segment Anything Model (SAM) werd strikt gebruikt om figuren, kledingstukken, meubels, gereedschappen, rituele objecten en architectonische regio's te lokaliseren voor menselijke visuele inspectie. Er moet worden benadrukt dat SAM geen deel uitmaakte van de classificatie-pipeline; de maskers, uitsneden en afgeleide kenmerken waren gescheiden van de CLIP-labeling en clusteringprocessen, waardoor werd gewaarborgd dat de toepassing van SAM lokalisatiehulpmiddelen bood zonder de classificatieprestaties te beïnvloeden of op te pompen.
Handmatige puntprompts of bounding boxes werden indien nodig toegepast om de lokalisatie van visuele elementen te verfijnen. SAM-maskers werden gegenereerd voor vrouwelijke figuren, kledingstukken, meubels, gereedschappen, rituele objecten en architecturale elementen, waarbij elk segmentatieresultaat visueel werd gecontroleerd op een passende regionale dekking. De resulterende maskers ondersteunden de identificatie en beoordeling van relevante iconografische kenmerken, maar werden niet gebruikt voor CLIP-labeling of categorie-toewijzing.
Dimensionaliteitsreductie en clustering
CLIP-beeldembeddings werden berekend, en UMAP met cosinusafstand werd gebruikt voor tweedimensionale visualisatie10. De representatie die voor clustering werd gebruikt, samen met de bijbehorende voorbehandelingsprocedure, dimensionaliteit en afstandsdefinitie, werd vastgelegd.
K-means en hiërarchische clustering werden toegepast op de representaties van beeldkenmerken om terugkerende visuele groeperingen binnen het corpus te identificeren11. Kandidaat K-means oplossingen voor k = 5–9 werden geëvalueerd met behulp van de silhouette-coëfficiënt en de Davies–Bouldin index. K-means++ initialisatie werd gebruikt met n_init = 10, max_iter = 300, tol = 1 × 10⁻4 en random_state = 42. Hiërarchische clustering werd uitgevoerd middels agglomeratieve clustering met average linkage en cosinusafstand. Kandidaat oplossingen werden vergeleken op basis van kwantitatieve validatie-indices, clusterstabiliteit en kunsthistorische interpreteerbaarheid, waarbij de uiteindelijke clusteroplossing werd geselecteerd vanwege de meest coherente representatie van terugkerende visuele patronen. De resulterende clustertoewijzing voor elk van de 433 schilderijen werd behouden voor de daaropvolgende vergelijking met de handmatig gecodeerde categorieën.
Handmatige codering, training en adjudicatie
Twee codeurs beoordeelden onafhankelijk alle 433 afbeeldingen met behulp van een versiebeheerde codebook dat de primaire categorie, het aantal figuren, de leeftijdsgroep, de houding, kleding, de ruimtelijke setting, objecten en sociale relaties besloeg. Codeurspecifieke verslagen werden bewaard vóór de adjudicatie. De codeurs hadden relevante achtergronden in kunstgeschiedenis en visuele analyse en werden getraind met behulp van de gestandaardiseerde coderingshandleiding en representatieve voorbeelden uit het schilderijcorpus. Vóór de formele codering voltooiden zij een kalibratie-oefening met 30 schilderijen om een consistente interpretatie van de zeven identiteitscategorieën en vijf dimensies van visuele aanwijzingen te bevorderen.
Tijdens de formele codering hebben beide codeurs onafhankelijk alle geschikte schilderijen geëvalueerd, waarbij ze blind waren voor elkaars coderingsbeslissingen, de voorlopige AI-labels en de clustertoewijzingen. De inter-codeur betrouwbaarheid werd beoordeeld met behulp van Cohen's kappa. De waargenomen kappawaarde voor de primaire identiteitscategorie was 0,88, en de categorische variabelen voor visuele aanwijzingen varieerden van 0,79 tot 0,92, wat duidt op een sterke overeenstemming tussen de codeurs. Meningsverschillen werden opgelost door middel van discussie en consensus, waarna de beoordeelde categorie- en visuele-aanwijzingscodes werden vastgelegd voor verdere analyse12. De labels van vóór de beoordeling werden bewaard.
AI-menselijke overeenstemming en prestatieschatting
De door mensen vastgestelde categorie werd gebruikt als referentie voor beschrijvende vergelijking met één voorlopig AI-label per schilderij. De algehele exacte-match-nauwkeurigheid werd berekend als 356/433 (82,2%). De recall per categorie werd berekend als het aantal exacte AI-menselijke matches gedeeld door de menselijke referentieondersteuning voor elke categorie. Categorieondersteuning, exacte matches, mismatches en de overeenkomstige noemers werden expliciet gerapporteerd.
Op basis van de 433 gepaarde labels van AI en mens op casusniveau werden de fout-positieven voor de doelklasse, de precisie per categorie, de recall en de F1-scores berekend. Er werd een volledige verwarringsmatrix opgesteld om de classificatiepatronen buiten de diagonaal te analyseren, wat vervolgens diende als leidraad voor de beoordeling van mismatches, de documentatie van de foutentaxonomie en de adjudicatieregels.
Reproduceerbaarheidspakket en materialen
De computationele workflow en ondersteunende onderzoeksmaterialen werden georganiseerd in een versiebeheerde repository. Het reproduceerbaarheidspakket is ontworpen om scripts te bevatten voor preprocessing, CLIP-analyse, SAM-lokalisatie, UMAP, clustering, overeenkomstanalyse en figuurgeneratie, samen met het codeboek voor handmatige codering, configuratiebestanden, afhankelijkheidsinformatie, op caseniveau afgeleide outputs en een machineleesbare inventaris van beeldbronnen en rechteninformatie. Er is een persistente identificatie toegewezen aan de gearchiveerde onderzoeksmaterialen om de reproduceerbaarheid en het hergebruik te vergemakkelijken.
Microsoft Excel 2021 werd gebruikt voor het organiseren en beheren van metadata. Voor de computationele analyses werden CLIP ViT-B/32 gebruikt voor de voorlopige vision-language labeling, SAM voor de lokalisatie van visuele elementen, UMAP met cosinusafstand voor dimensiereductie, en K-means en hiërarchische clustering voor exploratieve patroonanalyse. Clustering-oplossingen werden geëvalueerd met behulp van de silhouette-coëfficiënt en de Davies-Bouldin-index, en de overeenstemming tussen codeurs werd beoordeeld met Cohen's kappa. De softwareomgeving, modelconfiguraties, computationele instellingen en random seeds die gedurende de workflow zijn gebruikt, werden gedocumenteerd ter ondersteuning van de reproduceerbaarheid.
Resultaten
Corpusconstructie en beschrijvende compositie
Figuur 1 presenteert het overzicht van het corpus in vier panelen. Figuur 1A toont het gerapporteerde screeningsproces van 612 kandidaatrecords naar 43 behouden records. Figuur 1B toont representatieve voorbeelden van media en formaten. Figuur 1C presenteert de aantallen over vier datumintervallen, en Figuur 1D vat de samenstelling van de bronnen en media van het corpus samen. Omdat de datumintervallen ongelijkmatige perioden beslaan, beschrijven deze aantallen de compositie van het bemonsterde corpus en mogen zij niet worden geïnterpreteerd als historische productiesnelheden.
Tabel 1 vat de geaggregeerde kenmerken van het corpus samen. Museumcollecties waren verantwoordelijk voor 302 records, digitale archieven voor 81 en gepubliceerde catalogi voor 50. Media werden gecategoriseerd als exportaquarel (n = 176), pith-paper schilderij (n = 12), exportalbumblad (n = 83), figuratieve schildering (n = 41) en overig formaat (n = 21). Metadata werden gecategoriseerd als compleet (n = 28), gedeeltelijk (n = 18) of minimaal (n = 27). Vrouwelijke figuren werden gecategoriseerd als centraal (n = 214), secundair (n = 102) of meervoudig (n = 17). Elk classificatieblok bestond uit alle 43 records.
Voorlopige AI-labels en menselijke referentiecategorieën
Tabel 2 vat de geaggregeerde overeenstemming samen tussen de voorlopige door AI gegenereerde labels en de menselijke referentiecategorieën over de 43 schilderijen, terwijl Aanvullende Tabel 1 de overeenkomstige voorlopige AI-labels op casusniveau, de classificaties van de codeurs, de geoordeelde menselijke referentiecategorieën, de matchstatus en de clustertoewijzingen bevat. Over het geheel genomen kwamen de AI- en menselijke referentielabels voor 356 schilderijen overeen, wat overeenkomt met een nauwkeurigheid van exacte overeenstemming van 82,2%. De recall op categorieniveau werd berekend als de proportie exacte AI-menselijke overeenstemmingen ten opzichte van de menselijke referentieondersteuning voor elke categorie.
De recall op categorieniveau varieerde van 73,3% voor rituele/bruiloftsscènes (33/45) tot 88,4% voor elite/schoonheid (9/12). De recall was 84,7% voor arbeid (61/72), 82,1% voor optreden (32/39), 79,7% voor huishoudelijk (51/64), 79,3% voor bedienden (46/58) en 79,1% voor markt (34/43). In totaal was de exacte overeenstemming 356/43 (82,2%). Evaluatie van de paren op casusniveau maakte de berekening van precisie en F1-scores over alle zeven categorieën mogelijk, variërend van 74,5% tot 89,2% voor de precisie en 0,75 tot 0,8 voor de F1-scores. Een uitgebreide confusiematrix met details over fout-positieven van de doelklasse en off-diagonale patronen is opgenomen in Aanvullende Figuur 1.
Gerapporteerde samenvattingen van computationele patronen
Figuur 2 presenteert vier weergaven van de gerapporteerde computationele analyse. Figuur 2A toont een galerij van negen schilderijen met gekleurde segmentatie-overlays die worden gebruikt voor visuele lokalisatie en review. Figuur 2B toont een UMAP-spreidingsdiagram van de gerapporteerde CLIP-afbeeldingsembeddings, met dichtheidscontouren gelabeld C1–C7. Figuur 2C vergelijkt het gerapporteerde aantal schilderijen (gevulde stippen) met de recall op categorieniveau (open cirkels), en Figuur 2D presenteert een galerij van representatieve schilderijen gegroepeerd volgens dezelfde labels. Cluster-validatie ondersteunde de geselecteerde clustering-oplossing, die een silhouette-score van 0,54 en een Davies–Bouldin-index van 0,92 opleverde. De mapping van cluster naar menselijke categorie toonde een sterke overeenstemming, waarbij elk afgeleid cluster hoofdzakelijk correspondeerde met een specifieke referentiecategorie van mensen.
Tabel 3 presenteert zeven gerapporteerde computationele profielen met steekproeven die overeenkomen met de ondersteuning van de zeven menselijke referentiecategorieën. De kruistabel van cluster per categorie is opgenomen in Aanvullende Tabel 2 en toont de distributie van de zeven beoordeelde menselijke referentiecategorieën over de clusters C1–C7. Analyse van deze clustertoewijzingen op casusniveau toonde aan dat de computationele clustering visuele structuren herstelde die nauw overeenkwamen met de zeven menselijke referentiecategorieën.
Associaties van visuele aanwijzingen en interpretatieve synthese
Tabel 4 vat de kwalitatieve profielen van visuele aanwijzingen samen die zijn gebruikt om de zeven door mensen gecodeerde categorieën te karakteriseren. Deze profielen beschrijven terugkerende associaties tussen kleding, ruimtelijke setting, houding, objecten en sociale relaties. Ze zijn niet afgeleid van een kwantitatieve kruistabel en hebben daarom geen juridische status, etniciteit, sociale causaliteit of publieksreceptie vastgesteld.
Figuur 3 integreert beschrijvende kwantitatieve samenvattingen van de gecodeerde visuele kenmerken met een interpretatief conceptueel model. Figuur 3A presenteert de zeven vastgestelde menselijke referentiecategorieën en hun steekproefgroottes. Figuur 3B toont de relatieve associaties tussen deze categorieën en gecodeerde visuele markeringen over vijf dimensies: kleding, ruimtelijke setting, objecten, houding en sociale relaties. De weergegeven associatiestrachten zijn berekend op basis van de annotaties op casusniveau binnen elke menselijke referentiecategorie. Figuur 3C vat de relaties samen tussen menselijke referentiecategorieën, dimensies van visuele markeringen en archetypen van klasimplicaties, met behulp van gewogen stromen afgeleid van gecodeerde observaties. Deze kwantitatieve relaties karakteriseren terugkerende representationele patronen binnen de geselecteerde schilderijen en mogen niet worden geïnterpreteerd als schattingen van historische demografische of sociale verdelingen. Figuur 3D presenteert een conceptueel crosscultureel interpretatiemodel en moet worden begrepen als een historisch onderbouwd interpretatief kader in plaats van een empirisch getest causaal pad.
Geïntegreerde interpretatie van visuele patronen
Binnen het corpus werden de zeven categorieën van vrouwelijke identiteit gekenmerkt door terugkerende combinaties van kleding, ruimtelijke setting, objecten, houding en sociale relaties. Deze combinaties leverden beschrijvend bewijs voor patroonmatige visuele conventies binnen de geselecteerde schilderijen. Historische interpretaties met betrekking tot gender, hiërarchie en transculturele bemiddeling bleven inferentieel.
Samen identificeerden de geaggregeerde resultaten zeven menselijke referentiecategorieën voor vrouwelijke identiteit en vijf terugkerende dimensies die werden gebruikt om deze te karakteriseren: kleding, ruimtelijke setting, objecten, houding en sociale relaties. Voorlopige AI-labels kwamen overeen met de vastgestelde menselijke categorieën voor 356 van de 43 schilderijen (82,2%), waarbij de laagste recall op categorieniveau werd waargenomen voor rituele/bruiloftsscènes (73,3%). Deze bevindingen ondersteunden de descriptieve organisatie en vergelijking van het corpus. De AI-menselijke labels op casusniveau maakten schattingen van de precisie en de F1-score op categorieniveau mogelijk. Afzonderlijk identificeerde de clusteranalyse structuren die overeenkwamen met de zeven menselijke referentiecategorieën. Desalniettemin karakteriseren deze computationele bevindingen visuele representatieconventies in plaats van causale claims te stellen over de historische sociale realiteit of de receptie door het publiek.
DATAbeschikbaarheid:
De gegevens die deze studie ondersteunen, inclusief metadata, broninformatie en screeningsgegevens, zijn beschikbaar via Zenodo op https://doi.org/10.5281/zenodo.21130291.
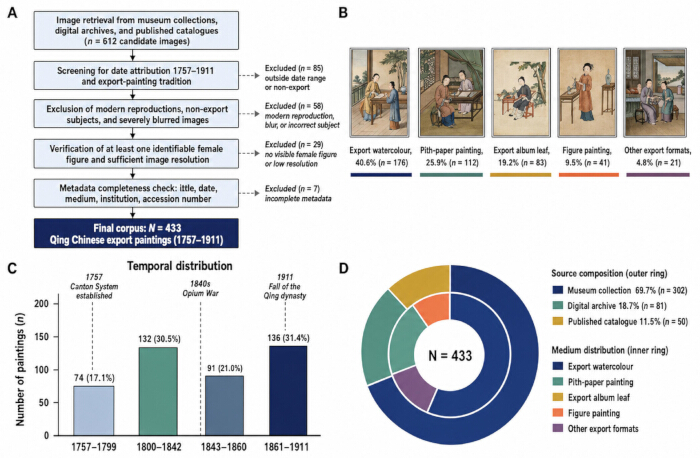
Figuur 1Corpusconstructie en beschrijvende compositie van de steekproef van 43 schilderijen. (A) Sequentiële screening van 612 kandidaatbeelden, resulterend in 43 geschikte schilderijen. Uitsluitingen bestonden uit schilderijen buiten de studieperiode of de export-schildertraditie (n = 85), moderne reproducties, onscherpe beelden of onjuiste onderwerpen (n = 58), beelden zonder een identificeerbare vrouwelijke figuur of met onvoldoende resolutie (n = 29), en records met onvoldoende metadata (n = 7). (BRepresentatieve voorbeelden van vijf media en formaten: exportaquarel (40,6%, n = 176), mergpapierschilderij (25,9%, n = 12), blad uit exportalbum (19,2%, n = 83), figuratief schilderij (9,5%, n = 41) en andere exportformaten (4,8%, n = 21).C) Verdeling van de bemonsterde schilderijen over vier chronologische intervallen. (D) Verdeling van verzamelbronnen (buitenring) en media/formaten (binnenring). De percentages zijn gebaseerd op de totale steekproef (N = 433) en afgerond op één decimaal. Klik hier om een grotere versie van deze figuur te bekijken.
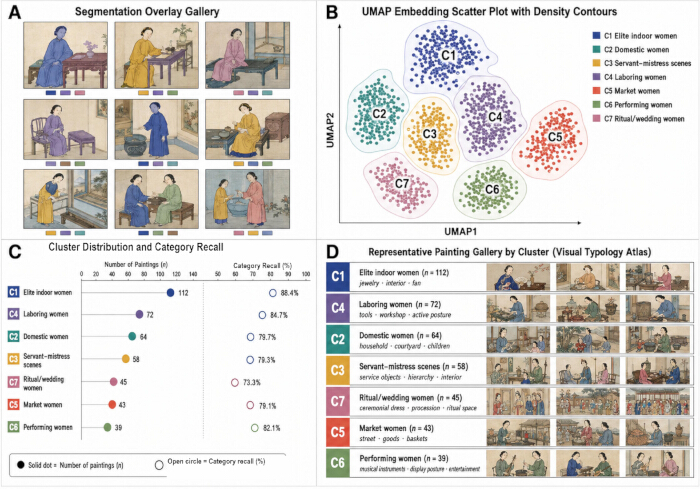
Figuur 2Gerapporteerde segmentatie, embedding-visualisatie, clusterdistributie, categorieriturn en representatieve schilderijen. (A) Galerij van negen schilderijen met gekleurde segmentatie-overlays die worden gebruikt om figuren of visuele elementen voor beoordeling te lokaliseren. (B) UMAP-spreidingsdiagram van de gerapporteerde CLIP-beeldembeddings met dichtheidscontouren en labels C1–C7. (C) Gerapporteerd aantal schilderijen (ingevulde stippen, bovenste as) en categorische herinnering (open cirkels, onderste as); categorische herinnering is gelijk aan het aantal exacte overeenkomsten gedeeld door de menselijke referentiesupport. Er worden geen betrouwbaarheidsintervallen of foutbalken weergegeven. (D) Galerij met representatieve schilderijen gegroepeerd op C1–C7 labels, waarbij afbeeldingen zijn geselecteerd op basis van hun nabijheid tot de respectievelijke clustercentroïden. Afkortingen: AI = kunstmatige intelligentie; CLIP = Contrastive Language–Image Pre-training; SAM = Segment Anything Model; UMAP = Uniform Manifold Approximation and Projection; C1–C7 = gerapporteerde labels 1–7. Klik hier om een grotere versie van deze figuur te bekijken.
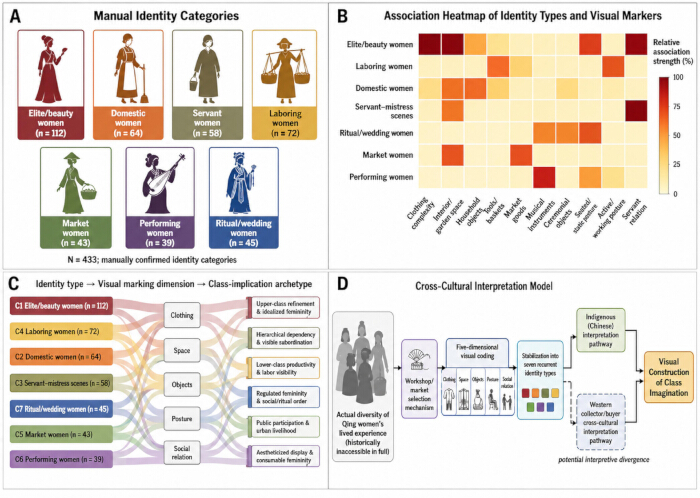
Figuur 3Associaties met visuele aanwijzingen en crosscultureel interpretatiekader. (A) Zeven beoordeelde vrouwelijke identiteitscategorieën van menselijke referentie en hun steekproefgroottes binnen het corpus van 43 schilderijen. (B) Associatie-heatmap die de relatieve sterkte van de relaties tussen de zeven referentiecategorieën voor mensen en gecodeerde visuele markeringen voor kleding, ruimtelijke setting, objecten, houding en sociale relaties weergeeft. De associatiesterktes zijn afgeleid van de annotaties op casusniveau binnen elke categorie. (CAlluviale weergave die de gewogen relaties samenvat tussen menselijke referentiecategorieën, visuele markeringsdimensies en klasse-implicatie-archetypen op basis van de gecodeerde observaties.D) Conceptueel crosscultureel interpretatiemodel dat afgebeelde activiteiten, workshop- en marktselectie, vijfdimensionale visuele codering, recurrente identiteitstypes en potentiële interpretatieve paden met elkaar verbindt. Klik hier om een grotere versie van deze figuur te bekijken.
Tabel 1: Corpuskenmerken en volledigheid van metadata (N = 43). Aantallen en percentages vatten zes afzonderlijke blokken samen: datuminterval, bron, medium of formaat, volledigheid van metadata, representatie van vrouwelijke figuren en scènetype. Elk blok gebruikt N = 43 als noemer en telt op tot 43; de percentages zijn corpusproporties binnen het blok, afgerond op één decimaal. Klik hier om dit bestand te downloaden.
Tabel 2: Voorlopige AI-labels en menselijke referentiecategorieën (N = 433). Ondersteuning (Support) staat voor het aantal schilderijen dat aan elke menselijke referentiecategorie is toegewezen. Exacte overeenkomsten (Exact matches) duiden op schilderijen waarbij het voorlopige AI-gegenereerde label overeenkwam met de menselijke referentiecategorie. De recall op categorieniveau is berekend als het aantal exacte overeenkomsten gedeeld door het aantal menselijke referentieondersteuningen. Klik hier om dit bestand te downloaden.
Tabel 3: Samenvatting van het gerapporteerde computationele profiel. C1–C7 reproduceren de gevalideerde profielgroottes en dominante labels. De integratie van clustertoewijzingen op casusniveau en de kruistabel van cluster per categorie bevestigt dat unsupervised clustering effectief visuele structuren heeft vastgelegd die overeenkomen met de zeven menselijke referentiecategorieën. Klik hier om dit bestand te downloaden.
Tabel 4: Kwalitatieve profielen van identiteitscategorieën voor vrouwen en klassegerelateerde visuele aanwijzingen. Aantallen en percentages vatten de menselijke referentiecategorieën samen, terwijl kleding, ruimte, objecten, houding en sociale relaties de terugkerende visuele profielen karakteriseren die met elke categorie geassocieerd worden. De klassegerelateerde interpretaties vertegenwoordigen iconografische lezingen van beeldpatronen in plaats van directe maten van historische sociale status. Klik hier om dit bestand te downloaden.
Aanvullende figuur 1: Confusiematrix waarin de voorlopige AI-labels worden vergeleken met de geoordeelde menselijke referentiecategorieën voor het corpus van 43 schilderijen. De rijen vertegenwoordigen de geoordeelde menselijke referentiecategorieën (werkelijke labels) en de kolommen vertegenwoordigen de voorlopige door CLIP gegenereerde categorieën (voorspelde labels). De celwaarden geven het aantal schilderijen aan voor elke AI-menselijke labelcombinatie. Diagonale cellen vertegenwoordigen exacte AI-menselijke overeenkomsten, waarbij de bijbehorende recall op categorieniveau als percentage wordt weergegeven. Niet-diagonale cellen vertegenwoordigen mismatches tussen de voorlopige AI-classificatie en de geoordeelde menselijke referentiecategorie. De totale nauwkeurigheid van de exacte overeenkomsten was 82.2% (356/43). Klik hier om dit bestand te downloaden.
Aanvullende Tabel 1: Vergelijking op casusniveau van voorlopige AI-labels, geoordeelde menselijke referentiecategorieën en UMAP-clustertoewijzingen. Elke rij vertegenwoordigt een van de 43 Chinese exportschilderijen uit de Qing-periode die zijn opgenomen in het analytische corpus. De tabel vermeldt de stabiele QEP-afbeeldingsidentifier, het voorlopige CLIP ViT-B/32 label, onafhankelijke classificaties van Menselijke Coder 1 en Menselijke Coder 2, de geoordeelde menselijke referentiecategorie, de status van de AI-menselijke match en de UMAP-clustertoewijzing. “Exact Match” geeft overeenstemming aan tussen het voorlopige AI-label en de geoordeelde menselijke referentiecategorie; “Mismatch” geeft een verschil aan. De geoordeelde menselijke categorie diende als de referentieclassificatie voor de analyses van de AI-menselijke overeenstemming. Klik hier om dit bestand te downloaden.
Aanvullende tabel 2: Kruistabel van menselijke referentiecategorieën en computationele clustertoewijzingen. De rijen representeren de zeven vastgestelde menselijke referentiecategorieën en de kolommen representeren clusters C1–C7 verkregen uit de computationele clusteranalyse. Celwaarden geven het aantal schilderijen aan dat is toegewezen aan elke categorie-clustercombinatie. Totale ondersteuning representeert het aantal schilderijen in elke menselijke referentiecategorie. De concentratie van waarnemingen over de categorie-clustercombinaties biedt een beschrijvende beoordeling van de correspondentie tussen de onafhankelijk afgeleide computationele clusters en de vastgestelde menselijke referentiecategorieën. Klik hier om dit bestand te downloaden.
Discussie
Binnen de verstrekte samenvattingen van aggregaten werden 433 records ingedeeld in zeven menselijke referentiecategorieën en beschreven via vijf families van visuele aanwijzingen. Elite/beauty was de grootste categorie (112/433), en 356 voorlopige labels kwamen overeen met de gerapporteerde menselijke referentie (82,2%). Dit zijn corpusobservaties. Ze ondersteunen de studie naar recurrente picturale formules, maar niet de sterkere stelling dat de formules de Qing-samenleving getrouw reproduceren of een specifieke reactie teweegbrachten bij buitenlandse publieken13.
Prescriptief genderdiscours, de positie binnen het huishouden, arbeid en de wetgeving van de Qing-dynastie gaven vorm aan het leven van vrouwen zonder dit uniform te bepalen. Wetenschappelijk onderzoek naar vrouwen tijdens de Hoog-Qing periode documenteert hun deelname aan arbeid, schrijven, rituelen, religie en entertainment, naast de prescriptieve regimes met betrekking tot familie en kuisheid. De Acht Banieren vormden een erfelijke en multi-etnische statusgroep die werd gedefinieerd door wetgeving en administratieve praktijk; het lidmaatschap van een Banier mag daarom niet automatisch worden gelijkgesteld aan de Mantsjoe-etniciteit14,15,16,17. In deze studie zijn kleding, houding, objecten en omgeving picturale aanwijzingen en geen bewijs voor juridische rang, Banier/Han-affiliatie, etniciteit, morele conformiteit of geleefde identiteit. Voor dergelijke claims zou archief- en juridisch bewijs vereist zijn.
De computationele bevindingen vereisen daarnaast culturele en technische terughoudendheid. Er mag niet van worden aangenomen dat algemene visie-taalmodellen cultureel neutraal zijn. Gepubliceerde resultaten van CulturalVQA tonen een ongelijkmatige prestatie over regio's en culturele facetten, maar die benchmark heeft CLIP ViT-B/32 niet geëvalueerd en maakte geen gebruik van historische Oost-Aziatische kunst8,18,19. Dit motiveert daarom juist, in plaats van te vervangen, een case-matched benchmark op dit corpus. Totdat een dergelijk experiment beschikbaar is, dient CLIP als een voorlopig organisatorisch hulpmiddel en niet als een autoriteit op het gebied van de Qing-identiteit of hiërarchie. De computationele pijplijn bevestigde dat SAM uitsluitend functioneerde als ondersteurend bewijs voor lokalisatie; er werden geen maskers of op maskers gebaseerde kenmerken gebruikt als input voor labeling of clustering, waardoor werd gewaarborgd dat de visuele categorisering uitsluitend steunde op de globale semantische embeddings van de ongesegmenteerde afbeeldingen. Wetenschap over digitaal erfgoed benadrukt daarnaast culturele sensitiviteit, interdisciplitair toezicht, toegankelijkheid, gegevensbescherming en transparante workflows20.
Historisch gezien ligt de relevantie van de patronen in de handel in exportbeschilderingen: Chinese werkplaatsen en de buitenlandse vraag selecteerden en standaardiseerden onderwerpen die draagbaar, begrijpelijk en verzamelbaar waren; herhaalde beelden uit werkplaatsen tonen bovendien kopiëren met variatie aan in plaats van puur mechanische duplicatie1,2,3,4,5. Het corpus kan daarom bijdragen aan geschiedenissen van gender, hiërarchie, beelden van het dagelijks leven en crossculturele ontmoetingen door aan te tonen welke formules op grote schaal terugkeren. Het toont niet aan dat de beelden uitputtende etnografische verslagen zijn. Computationele vergelijking kan een leidraad vormen voor nauwgezette analyse en crossculturele contextualisering21, terwijl productieregistraties, aankoophistorie en bewijzen van receptie de basis moeten vormen voor claims over marktintentie of de betekenis voor het publiek.
Affectieve en cognitieve respons blijft een richting voor verder onderzoek in plaats van een resultaat van de huidige studie. Shi en collega's combineerden voorkeursbeoordelingen, latent-dimensieanalyse en eye-tracking om emotionele, formeel-esthetische en cognitieve paden te onderscheiden in reacties op Xiashi Pinprick Lantern-schilderijen22. Een vergelijkbaar ontwerp zou kunnen testen of kijkers verschillend letten op kleding, objecten, houding of hiërarchie in exportschilderijen. Omdat deze studie geen beoordelingen, eye-tracking of andere publieksgegevens heeft verzameld, kan het geen emotionele opwinding, visuele saillantie of receptie afleiden uit enkel de inhoud van de afbeeldingen.
De beperkingen zijn theoretisch, methodologisch en praktisch. Theoretisch gezien vereenvoudigen categorieën van materiële aanwijzingen gender, huishoudelijke relaties, juridische hiërarchie, etniciteit en geleefde ervaringen. Methodologisch gezien worden gevolgtrekkingen beperkt door overleving, verzameling, digitalisering, metadata, zero-shot-modellen, codering en bias door ongelijkmatige perioden. Hoewel de analytische pijplijn een robuuste patroondetectie demonstreert, onderstrepen deze structurele biases de noodzaak om computationele resultaten te behandelen als analyses van picturale conventies in plaats van als transparante vensters naar de sociale realiteit van de Qing-dynastie. Praktisch gezien beperken beeldrechten de herdistributie, en de resultaten zijn mogelijk niet generaliseerbaar over verschillende instellingen, perioden, media of computationele omgevingen. Met inachtneming van deze beperkingen biedt de studie een door mensen gesuperviseerd kader om herhaalde visuele observaties om te zetten in toetsbare historische vragen in plaats van geautomatiseerde conclusies. Omdat het een interpretatieve studie is en geen interventie, is er geen vooruitgang geëvalueerd richting een Sustainable Development Goal (SDG) of indicator. Het onderwerp is niettemin relevant voor Doel 5, en de rechtenbewuste documentatie en crossculturele educatieve inkadering zijn conceptueel afgestemd op targets 11.4 en 4.7; er is geen SDG-resultaat gemeten. Het bijgevoegde reproduceerbaarheidspakket stemt de studie af op recente oproepen voor transparante digitale erfgoed-workflows en op FAIR-vereisten voor persistente identificatoren, rijke metadata, licenties, herkomst en herbruikbare gegevens, algoritmen, tools en workflows20,23.
Openbaarmakingen
De auteurs hebben niets te melden.
Dankbetuigingen
De auteurs danken het Victoria and Albert Museum, het British Museum, het Metropolitan Museum of Art, het Smithsonian National Museum of Asian Art, het Peabody Essex Museum, het Hong Kong Museum of Art, de British Library, het Getty Research Institute en andere instellingen en catalogusteams wiens online registers de ontdekking van het corpus hebben ondersteund. Toegang tot een online register impliceert geen toestemming voor het herdistribueren van de afbeelding; rechten op paneelniveau en bronlinks zijn daarom afzonderlijk gedocumenteerd. De auteurs erkennen tevens de open onderzoeksgemeenschappen die CLIP en SAM ondersteunen, evenals de administratieve ondersteuning van de City University of Macau en de Guangdong Polytechnic Normal University.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| CLIP ViT-B/32 | OpenAI | OpenAI CLIP, ViT-B/32 | Visueel-talig model gebruikt voor de eerste analyse van de gelijkenis tussen afbeeldingen–teksten en het toewijzen van voorlopige AI-labels. |
| Computationele workstation | Computationele workstation van de auteurs’ | CUDA-compatibele GPU; exacte hardwareconfiguratie dient te worden vermeld | Workstation gebruikt voor CLIP- en SAM-inferentie en computationele analyses; specificaties van de GPU, CPU, RAM, het besturingssysteem en CUDA moeten worden vermeld vanuit de oorspronkelijke runtime-omgeving. |
| Matplotlib | Matplotlib development team | Python-pakket; exacte versie dient te worden vermeld | Gebruikt voor computationele visualisatie en het genereren van analysefiguren en plots. |
| Microsoft Excel 2021 | Microsoft Corporation | Microsoft Excel 2021 | Gebruikt voor metadata-organisatie, screeningrecords en beheer van tabulaire onderzoeksgegevens. |
| NumPy | NumPy developers | Python-pakket; exacte versie dient te worden vermeld | Gebruikt voor numerieke berekeningen en manipulatie van afbeelding-kenmerk- en analysematrixen. |
| pandas | pandas development team | Python-pakket; exacte versie dient te worden vermeld | Gebruikt voor de verwerking van gestructureerde gegevens, metadataverwerking en organisatie van analytische resultaten op casusniveau. |
| Python 3.10 | Python Software Foundation | Python 3.10 | Programmeeromgeving gebruikt om de computationele workflow voor beeldanalyse te implementeren. |
| PyTorch 2.0.1 | PyTorch Foundation | PyTorch 2.0.1 | Deep-learning framework gebruikt voor het uitvoeren van CLIP-gebaseerde beeld- en tekstcodering en GPU-inferentie. |
| scikit-learn | scikit-learn developers | Python-pakket; exacte versie dient te worden vermeld | Gebruikt voor K-means clustering, agglomeratieve clustering, silhouetcoëfficiënt, Davies–Bouldin-index en berekeningen van de kappa van Cohen’s. |
| Segment Anything Model (SAM) | Meta AI Research | SAM | Segmentatiemodel gebruikt om vrouwelijke figuren, kledingstukken, meubilair, gereedschappen, rituele objecten en architecturale regio's te lokaliseren voor visuele inspectie. |
| umap-learn | McInnes et al. | UMAP Python-implementatie | Gebruikt voor dimensiereductie en tweedimensionale visualisatie van CLIP-beeldimbeddings met cosinusafstand. |
Referenties
- Gao J, Zhang Y, Liu J, Sousa JP. A digital humanities approach to Chinese export watercolours: a case study on the Victoria and Albert Museum collection. Digit Scholarsh Humanit. 2026;41(2):692-714.
- Liu H, Fu C, Li W. Silk road heritage: the artistic representation of port trading culture in the images of characters in Qing Dynasty Guangzhou export paintings. PLoS One. 2024;19(10):e0308309.
- Ao J, Ye Z, Li W, Ji S. Impressions of Guangzhou city in Qing Dynasty export paintings in the context of trade economy: a color analysis of paintings based on k-means clustering algorithm. Herit Sci. 2024;12:77.
- Mok MKW. Chinese export paintings: a marketing success story. Cambridge Scholars Publishing; Newcastle upon Tyne; 2025.
- Yaron E. The many versions of the painting of Tingqua's studio: painting copying and originality in nineteenth-century Canton. Humanit Soc Sci Commun. 2020;7:132.
- Impett L, Offert F. There is a digital art history. Vis Resour. 2022;38(2):186-209.
- Münster S. Artificial intelligence for digital heritage innovation: setting up a R&D agenda for Europe. Heritage. 2024;7(2):794-816.
- Foka A, Griffin G. AI, cultural heritage, and bias: some key queries that arise from the use of GenAI. Heritage. 2024;7(11):6125-6136.
- Zhang W. Computational approaches for traditional Chinese painting: from the Six Principles of Painting perspective. J Comput Sci Technol. 2024;39(2):269-285.
- McInnes L, Healy J, Saul N, Großberger L. UMAP: Uniform Manifold Approximation and Projection. J Open Source Softw. 2018;3(29):861.
- Rousseeuw PJ. Silhouettes: a graphical aid to the interpretation and validation of cluster analysis. J Comput Appl Math. 1987;20:53-65.
- Cohen J. A coefficient of agreement for nominal scales. Educ Psychol Meas. 1960;20(1):37-46.
- Stejskal J. Art-historical empiricism and digital visualization of cultural heritage. Synthese. 2025;205:132.
- Mann S. Precious records: women in China's long eighteenth century. Stanford University Press; Stanford; 1997.
- Porter DC. Slaves of the emperor: service, privilege, and status in the Qing Eight Banners. Columbia University Press; New York; 2023.
- Sommer MH. Sex, law, and society in late imperial China. Stanford University Press; Stanford; 2000.
- Theiss JM. Disgraceful matters: the politics of chastity in eighteenth-century China. University of California Press; Berkeley; 2005.
- Nayak S, et al. Benchmarking vision language models for cultural understanding [conference paper]. Presented at: 2024 Conference on Empirical Methods in Natural Language Processing; Miami, Florida, USA; 2024. https://aclanthology.org/2024.emnlp-main.329/
- Vitaloni C, Shullani D, Baracchi D. A comparative study of vision language models for Italian cultural heritage. Heritage. 2025;8(3):95.
- Li W. Systematic review: a scientometric analysis of the status, trends and challenges in the application of digital technology to cultural heritage conservation (2019-2024). npj Herit Sci. 2025;13:90.
- Zhang W, et al. CultiVerse: towards cross-cultural understanding for paintings with large language model [conference paper]. Presented at: 33rd ACM International Conference on Multimedia; Dublin, Ireland; 2025. https://doi.org/10.1145/3746027.3755698
- Shi W. A dual-path approach to emotional arousal and visual cognition in intangible cultural heritage: the case of Xiashi Pinprick Lantern Pictures. Digit Scholarsh Humanit. 2026;41(1):376-395.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.