VoiceNet-RAI integreert MFCC-kenmerken, meertalige wav2vec 2.0-embeddings en EfficientNet-Lite voor de classificatie van geslacht en leeftijd op basis van stemgegevens. Het framework behaalt een nauwkeurigheid tot 97,87% op de Engelstalige subset en ondersteunt verantwoorde toepassingen in spraakherkenning, authenticatie en digitale forensica.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Onderzoeksartikel
VoiceNet: Een verantwoord meertalig spraakframework op basis van kunstmatige intelligentie voor gender- en leeftijdclassificatie
127 weergaven
⸱
11 september 2026
In dit artikel
Samenvatting
Samenvatting
Nauwkeurige classificatie van geslacht en leeftijd op basis van stemgegevens is essentieel voor gepersonaliseerde, veilige en ethische mens-computerinteractie (HCI). Met het toenemende gebruik van grote, vooraf getrainde spraakmodellen zoals wav2vec 2.0, is er behoefte aan een verantwoorde benutting van deze representaties voor meertalige en privacybewuste demografische inferentie. Deze studie stelt VoiceNet-RAI voor, een deep learning (DL) raamwerk dat Mel-Frequency Cepstral Coefficients (MFCC's) integreert met transformer-gebaseerde meertalige wav2vec 2.0-embeddings binnen een EfficientNet-Lite-architectuur om nauwkeurige, eerlijke en transparante classificatie in diverse linguïstische contexten te ondersteunen. Het raamwerk combineert contextuele en spectrale informatie om de robuustheid onder variabele opnameomstandigheden te verbeteren. Experimenten met meertalige spraakgegevens uit 28 talen tonen sterke classificatieprestaties aan, waarbij de Engelse subset een nauwkeurigheid van 97,87%, een precisie van 98,61%, een recall van 98,70% en een F1-score van 98,65% behaalde. Externe validatie met de Mozilla Common Voice-dataset leverde een nauwkeurigheid van 98,27% op voor geslachtclassificatie, wat de generaliseerbaarheid naar een onafhankelijke dataset aantoont. Ablatieanalyse toonde verder aan dat het combineren van MFCC- en wav2vec 2.0-kenmerken de prestaties verbeterde in vergelijking met ruwe representaties of representaties die uitsluitend op MFCC's waren gebaseerd. Deze resultaten tonen het potentieel aan van hybride spectraal-contextuele spraakrepresentaties voor robuuste en verantwoorde classificatie van geslacht en leeftijd.
Inleiding
Stemherkenning is een kerncomponent van menselijke communicatie waarmee individuen hun gevoelens, gedachten en doelen uiten. Menselijke stemmen worden geproduceerd via een biologisch proces waarbij lucht uit de longen wordt uitgeademd en door articulatieorganen zoals de lippen, tong en tanden in geluid wordt omgezet1. Het oor speelt een essentiële rol bij stemidentificatie en kan onderscheid maken tussen mannenstemmen en vrouwenstemmen op basis van kenmerken zoals volume en toonhoogte. Eén kenmerk dat bijdraagt aan aanzienlijke verschillen in stemtoonhoogte tussen mannen en vrouwen is seksueel dimorfisme2. Leeftijds- en geslachtclassificatie op basis van de stem is relevant voor talrijke toepassingen, waaronder mens-machine-interactie, geautomatiseerde geslachtsherkenning, gepersonaliseerde begroetingen, preclassificatie van spraakemoties en geslacht-gebaseerde oproepclassificatie3.
Spraak is een intrinsiek onderdeel van menselijke interactie. De menselijke stem bevat meerdere kenmerken die per individu verschillen en informatie kunnen verschaffen over emotionele en mentale toestanden, evenals over leeftijd en geslacht. Deze multidimensionale kenmerken kunnen worden benut in toepassingen zoals stemgebaseerde beveiligingssystemen en spraakgerichte systemen voor kunstmatige intelligentie (AI). Andere gebieden waarin stemanalyse belangrijk is, zijn systemen voor automatische sprekersverificatie (ASV) en emotiegebaseerde AI-systemen. Stemgebaseerde invoersystemen kunnen daarnaast de zoekruimte binnen databases verkleinen4,5. Bovendien kunnen op AI gebaseerde beveiligingssystemen stemgegevens gebruiken voor toepassingen zoals strafrechtelijke onderzoeken en slachtofferbescherming. Mannelijke en vrouwelijke stemmen vertonen verschillende kenmerken vanwege variaties in de resonantie-eigenschappen van het spraakkanaal. Deze kenmerken kunnen uit spraaksignalen worden geëxtraheerd in een vorm die geschikt is voor computationele verwerking, waardoor genderclassificatie op basis van stemgegevens mogelijk wordt6,7. Daarom zijn effectieve leeralgoritmen vereist voor stemgebaseerde genderclassificatie. Deep Learning (DL)-algoritmen zijn bijzonder geschikt voor spraakgerelateerde classificatie vanwege hun vermogen om complexe patronen uit audiogegevens te leren. Afhankelijk van de architectuur kunnen dergelijke modellen convolutionele, recurrente, temporeel-convolutionele of volledig verbonden lagen bevatten. Deze lagen kunnen relevante akoestische kenmerken leren, waaronder toon en toonhoogte. Eenmaal getraind kan een model het geslacht classificeren op basis van eerder niet geziene audio-opnamen8. Een ander belangrijk onderzoeksgebied binnen machine learning (ML) is leeftijdsclassificatie op basis van stemopnamen. ML-algoritmen kunnen akoestische kenmerken zoals toonhoogte, timbre en amplitude gebruiken om leeftijdsgerelateerde patronen te identificeren. Technieken zoals Principal Component Analysis (PCA) kunnen ook worden toegepast om informatieve patronen uit spraakgegevens te extraheren en potentieel de classificatieprestaties te verbeteren9.
DL heeft sterke prestaties getoond in toepassingen zoals beeld-, emotie- en spraakherkenning. Diepe Neurale Netwerken (DNN's) worden in het bijzonder veelvuldig gebruikt voor spraakgerelateerde taken. In deze studie worden DL-gebaseerde benaderingen toegepast op stemclassificatie in combinatie met gevestigde technieken voor kenmerkextractie. Mel-Frequency Cepstral Coefficients (MFCC's) leggen relevante spectrale kenmerken van spraaksignalen vast en bieden een efficiënte representatie voor verdere verwerking. De geëxtraheerde kenmerken worden vervolgens geïntegreerd in een transfer-learning framework voor stemgebaseerde gender- en leeftijdclassificatie10,1.
Recente studies hebben in toenemende mate zelf-gesuperviseerde en op Transformers gebaseerde spraakrepresentaties aangenomen voor de classificatie van sprekerkenmerken. Onderzoekers hebben demografische biases, waaronder gender- en leeftijdsbiases, onderzocht in zelf-gesuperviseerde spraakmodellen zoals HuBERT en wav2vec 2.0, waarbij het belang van fairness-aware evaluatie werd benadrukt12. Recentelijk hebben op Transformers gebaseerde taal-onafhankelijke benaderingen de effectiviteit aangetoond van geleerde contextuele spraakrepresentaties voor genderherkenning onder meertalige en ruisachtige omstandigheden13. Sinha et al. onderzochten verder laag-specifieke wav2vec 2.0 representaties voor leeftijd- en genderclassificatie en toonden aan dat verschillende Transformer-lagen variërende niveaus van spreker-gerelateerde informatie vastleggen14. Deze ontwikkelingen vormen de motivatie voor het voorgestelde VoiceNet-RAI framework, dat conventionele op MFCC gebaseerde spectrale informatie combineert met contextuele wav2vec 2.0 representaties, terwijl meertalige overwegingen en Responsible AI worden geïntegreerd.
Recente studies hebben aangetoond dat de leeftijd en het geslacht van een spreker kunnen worden gekenmerkt met behulp van zowel conventionele akoestische kenmerken als representaties op basis van deep learning. Benaderingen die akoestische en temporele informatie combineren, hebben aangetoond dat complementaire spraakkenmerken de prestaties van de classificatie van leeftijd en geslacht kunnen verbeteren15,16. Verwant onderzoek heeft ook aangetoond dat getransformeerde spraakkenmerken, gegenereerd met behulp van deep bottleneck-representaties, de prestaties van de classificatie van de leeftijd en het geslacht van de spreker kunnen verbeteren17. Deze bevindingen ondersteunen het bredere gebruik van spectrale, temporele en geleerde representaties voor classificatietaken met spraak en uit spraak afgeleide signalen.
Verschillende studies hebben de herkenning van leeftijd en geslacht uit spraak onderzocht met behulp van machine-learning en deep-learning benaderingen18,19,20,21,2,23,24,25,26,27,28,29,30. Recentere benaderingen hebben getransformeerde MFCC-representaties en diepe neurale netwerken verkend voor de classificatie van de leeftijd en het geslacht van de spreker31, terwijl meertalige en taalafhankelijke variabiliteit belangrijke overwegingen blijven bij de ontwikkeling van robuuste stemgebaseerde demografische classificatiesystemen. Verschillen in uitspraak, fonetische structuur, sprekerkenmerken en opnameomstandigheden kunnen de generaliseerbaarheid van modellen over talen en populaties heen verminderen. Bijgevolg kan het gebruik van complementaire spectrale en contextuele spraakrepresentaties de robuustheid in meertalige omgevingen verbeteren.
Hoewel hybride benaderingen voorheen meerdere akoestische kenmerken of ensemble-classificatoren hebben gecombineerd voor stemgebaseerde demografische herkenning, onderscheidt VoiceNet-RAI zich door twee complementaire niveaus van spraakrepresentatie te integreren binnen een uniform raamwerk. Specifiek behouden conventionele MFCC-kenmerken gelokaliseerde spectrale en vocale eigenschappen, terwijl wav2vec 2.0 contextualiseerde representaties biedt die zijn geleerd uit ruwe spraak met behulp van een Transformer-encoder. In plaats van uitsluitend te vertrouwen op handmatig ontworpen akoestische descriptoren of een enkele diepe representatie, voert VoiceNet-RAI een fusie op kenmerkniveau uit van temporeel geaggregeerde MFCC- en wav2vec 2.0-representaties, om vervolgens de resulterende hybride representatie te verfijnen met EfficientNet-Lite. De wetenschappelijke noviteit ligt daarom in de gecoördineerde integratie van spectrale, zelf-gesuperviseerde contextuele en lichtgewicht diepe representaties voor gender- en leeftijdclassificatie, samen met meertalige evaluatie, validatie met onafhankelijke datasets en een analyse van subgroup fairness. Deze combinatie breidt conventionele hybride spraakclassificatie-pipelines uit voorbij nauwkeurigheid-georiënteerde kenmerkfusie naar een raamwerk dat gelijktijdig rekening houdt met representatiecomplementariteit, lichtgewicht modelontwerp, generaliseerbaarheid en Responsible AI.
De belangrijkste bijdragen van dit onderzoek omvatten de ontwikkeling van een methode voor het identificeren van geslacht en leeftijd op basis van stemgegevens door MFCC- en wav2vec 2.0-kenmerken te integreren met EfficientNet-Lite. Er zijn uitgebreide experimenten uitgevoerd op een dataset van stemopnamen uit 28 talen, waarbij originele kenmerken, MFCC-kenmerken, wav2vec 2.0-kenmerken en hun combinaties zijn geëvalueerd met ML- en DL-modellen. De modelprestaties worden beoordeeld met behulp van zowel de volledige meertalige dataset als de Engelstalige subset. Het raamwerk wordt verder geëvalueerd vanuit meertalige en Responsible AI-perspectieven via subgroup-analyses specifiek voor geslacht en taal, spreker-onafhankelijke evaluatie en validatie met behulp van de Mozilla Common Voice-dataset. Daarnaast worden de prestaties van het voorgestelde raamwerk vergeleken met state-of-the-art benaderingen uit de bestaande literatuur, en worden cross-validatieresultaten verstrekt. Er is een aanzienlijke hoeveelheid gerelateerd onderzoek uitgevoerd, en Tabel 1 vat deze studies samen, inclusief de modellen, datasets en gerapporteerde resultaten19,20,21,2,23,24,25,26,27,28,29,30,31.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Voor deze studie werden de publiek beschikbare BVC Challenging Voice Set en Mozilla Common Voice-datasets gebruikt zonder directe betrokkenheid van deelnemers. Daarom waren institutionele ethische goedkeuring en aanvullende geïnformeerde toestemming niet vereist. Er werden alleen gegevens verwerkt die noodzakelijk waren voor de classificatie van geslacht en leeftijd, en er is geen poging ondernomen om individuele sprekers te identificeren. De volledige workflow-methodologie van het voorgestelde framework wordt weergegeven in Figuur 1.
Gegevensverwerving
De dataset die in de voorgestelde benadering is gebruikt, bestond uit .wav-audiobestanden afkomstig van de BVC Challenging Voice Set, een openbaar beschikbare stemdataset ontwikkeld door de Biometrics Vision and Computing (BVC)-groep en gehost op GitHub32. De dataset bevatte stemopnamen van 526 personen, waaronder 36 mannelijke en 190 vrouwelijke sprekers. Deze bestond uit ongeveer 3.964 opnamen, inclusief zowel enkelvoudige als meervoudige zinopnamen van elke spreker. Tabel 2 vat de demografische kenmerken, taaldekking, opname-eigenschappen, data-partitioneringsstrategie en voorbewerkingsinstellingen samen die zijn gebruikt voor de spraakdatasets in het voorgestelde VoiceNet-RAI-framework.
Kenmerkextractie
Audiobestanden werden verwerkt om essentiële eigenschappen te extraheren, die vervolgens in een CSV-bestand werden opgeslagen. Metadata, waaronder leeftijd, geslacht en de uitspraak van de spreker, werd geëxtraheerd uit de bijbehorende README-bestanden. Python, samen met het SciPy-pakket, werd gebruikt om de WAV-bestanden te verwerken en relevante kenmerken te extraheren. De Fast Fourier Transform (FFT) en frequentiefuncties van NumPy werden ingezet om de audiosignalen om te zetten van het tijddomein naar het frequentiedomein. De WAV-bestanden representeerden de amplitude als functie van de tijd; echter waren frequentiegerelateerde kenmerken die mannen- en vrouwenstemmen konden onderscheiden van groter belang voor de classificatietaak3.
Om de audiosignalen om te zetten in representaties in het frequentiedomein, werd de Discrete Fourier-transformatie (DFT) geïmplementeerd met behulp van het FFT-algoritme. De Fourier-transformatie zet een signaal in het tijddomein om in een frequenciespectrum. Omdat dit spectrum geen temporele informatie behoudt, werd het audiosignaal verdeeld in overlappende segmenten en werd de Fourier-transformatie op elk segment toegepast met de Short-Time Fourier Transform (STFT)-methode. De functie np.fft.fft genereerde het complexe frequenciespectrum, terwijl np.fft.fftfreq de bijbehorende steekproeffrequenties leverde. In de voorbeeldmap waren 10 audiobestanden van één spreker beschikbaar. Elk WAV-bestand werd verwerkt met glijdende vensters van 20 ms om de dominante frequenties te extraheren. Een audio-opname van 4 seconden produceerde bijvoorbeeld een lijst van 20 frequentiewaarden. Voor een map met 10 opnames werden de 10 bijbehorende lijsten, elk met 20 frequentiewaarden, gecombineerd tot een lijst van lijsten. Frequenties werden gefilterd om waarden tussen 20 Hz en 280 Hz te behouden, terwijl potentiële ruis rond 50 Hz werd uitgesloten.
Hybride MFCC- en wav2vec 2.0-kenmerkrepresentatie
Om zowel hoogwaardige contextuele spraakrepresentaties als laagwaardige akoestische kenmerken vast te leggen, maakte deze studie gebruik van een hybride kenmerkextractiestrategie die MFCC-kenmerken integreerde met Transformer-gebaseerde wav2vec 2.0-embeddings.
MFCC-kenmerkextractie
Mel-Frequency Cepstral Coefficients (MFCC's) zijn veelgebruikte kenmerken in spraak- en audiosignaalverwerking, in het bijzonder voor toepassingen zoals spraakherkenning en sprekeridentificatie34,35. In deze studie transformeerde de MFCC-extractie de audiosignalen in kenmerkvectoren die perceptueel relevante eigenschappen van spraak vertegenwoordigen. Het proces begon met pre-emphasis om hoge-frequentiecomponenten te versterken, gevolgd door framing en windowing om het signaal op te delen in korte, overlappende frames. Elk audiofragment werd eerst geresampled naar 16 kHz en gesegmenteerd in frames van 25 ms met een overlap van 10 ms. Vervolgens werd de Fast Fourier Transform op elk frame toegepast om het signaal van het tijdsdomein naar het frequentiedomein om te zetten.
Het resulterende frequentiespectrum werd door een reeks Mel-filterbanken geleid die de niet-lineaire frequentierespons van de menselijke auditieve perceptie benaderden. Deze filterbanken legden de nadruk op perceptueel relevantere frequenties, terwijl de bijdrage van minder informatieve frequenties werd verminderd. Vervolgens werd het logaritme van de output van elke filterbank berekend om de logaritmische gevoeligheid van het menselijk gehoor voor luidheid te benaderen. Daarna werd een Discrete Cosinus Transformatie (DCT) toegepast op de logaritmische energieën van de filterbanken om de coëfficiënten te decorreleren en een compacte representatie van het audiosignaal te genereren. De resulterende coëfficiënten, bekend als MFCC's, legden belangrijke spectrale kenmerken van spraak vast. MFCC's werden gebruikt voor gender- en leeftijdclassificatie omdat ze akoestische kenmerken vastleggen die stemmen op basis van deze eigenschappen differentiëren.
wav2vec 2.0 embedding-extractie
Het wav2vec 2.0 Base-model is vooraf getraind op grootschalige niet-gelabelde spraakcorpora. Het model bestond uit een meerlaagse Transformer-encoder die ruwe golfvorm-inputs verwerkte en gecontextualiseerde spraak-embeddings genereerde36.
Gegeven een invoergolfvorm x ∈ RT, produceerde het wav2vec 2.0-model een reeks latente representaties:
Z = {z1,z1,....,zn},zi ∈ R768 (1)
waarbij elke embedding-vector een dimensionaliteit van 768 had. Om een representatie met een vaste lengte te verkrijgen die geschikt is voor classificatie, werd een temporele mean pooling-operatie toegepast over alle tijdstappen.
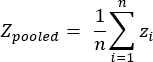 (2)
Mechanisme voor kenmerkfusie
De MFCC- en wav2vec 2.0-kenmerken werden gefuseerd via concatenatie op kenmerkniveau. Specifiek werden de MFCC-kenmerken eerst geaggregeerd middels temporele middeling om een vector met een vaste lengte te produceren.
m ∈ R40 (3)
De uiteindelijke hybride kenmerkvector werd als volgt verkregen:
h = [m || zpooled] ∈ R808 (4)
waarbij || concatenatie aanduidt. Deze fusie combineerde diepe contextuele embeddings met handmatig ontworpen spectrale kenmerken, waardoor het model zowel hoogwaardige semantische informatie als fijnmazige akoestische patronen kon vastleggen.
Alle audiofragmenten werden eerst geresampled naar 16 kHz. MFCC-kenmerken werden per frame berekend en temporeel gemiddeld om een vaste 40-dimensionale vector te produceren, terwijl wav2vec 2.0-embeddings via mean-pooling over de tijd werden verwerkt om een 768-dimensionale representatie te verkrijgen. Omdat beide sets kenmerken vóór de fusie werden omgezet in vectoren met een vaste lengte, was temporele uitlijning op frameniveau niet vereist. De resulterende MFCC- en wav2vec-representaties werden vervolgens geconcateneerd tot een hybride kenmerkvector van 808 dimensies voordat deze aan het classificatiemodel werden doorgegeven.
Integratie met EfficientNet-Lite
De gefuseerde kenmerkvector, h, werd herschaald naar een formaat dat geschikt was voor kenmerkleren en werd als input aan het EfficientNet-Lite-model geleverd voor training. Een volledig verbonden projectielaag bracht de 808-dimensionale vector eerst over naar een hoger-dimensionale latente ruimte, waarna de EfficientNet-Lite-blokken de hiërarchische kenmerken verfijnden. Batch-normalisatielagen en dropout-lagen werden gebruikt om overfitting te verminderen en de generalisatie van het model te verbeteren. De SoftMax-activatiefunctie werd gebruikt om de uiteindelijke voorspelde kansen voor de gender- en leeftijdsklassen te genereren. De gefuseerde representatie, h ∈ R808, werd aanvankelijk behandeld als een eendimensionale kenmerkvector en via een volledig verbonden projectielaag geleid die deze naar 4.096 dimensies bracht. De geprojecteerde representatie werd vervolgens herschaald naar een 1 × 64 × 64 tensor voordat deze aan de EfficientNet-Lite-architectuur werd toegevoerd.
Om de representatie van spraakkenmerken met één enkel kanaal te kunnen verwerken, in plaats van de conventionele invoer van afbeeldingen met drie kanalen, is de oorspronkelijke convolutionele invoerlaag van EfficientNet-Lite aangepast van drie naar één invoerkanaal. De overige feature-extractieblokken van EfficientNet-Lite zijn behouden zonder grote architecturale wijzigingen. Er is een adaptieve global average pooling-laag toegepast op de uiteindelijke feature maps om een representatie van vaste lengte te genereren. De oorspronkelijke classificatiekop is vervangen door een taakspecifieke fully connected-laag met twee output-units voor genderclassificatie en het corresponderende aantal output-units voor de vooraf gedefinieerde leeftijdsgroepen. Ten slotte is de SoftMax-activatiefunctie toegepast om klassewaarschijnlijkheden te genereren. De voorgestelde hybride representatie combineerde moderne self-supervised spraak-embeddings met traditionele signaalverwerkingskenmerken. De wav2vec 2.0-embeddings legden contextuele informatie en lange-afstandsafhankelijkheden vast, terwijl de MFCC-kenmerken aanvullende akoestische informatie op laag niveau boden. De integratie van deze representaties verbeterde de classificatieprestaties, in het bijzonder onder ruisgevoelige en meertalige spraakcondities.
ML-classifier
In dit onderzoek werd de prestatie van meerdere ML-algoritmen geanalyseerd voor stemgebaseerde classificatie van geslacht en leeftijdsgroep.
Random Forest
Random Forest (RF) werd gebruikt als een robuuste Machine Learning (ML)-classifier, waarbij meerdere Decision Trees (DT's) werden gecombineerd om de voorspellingsnauwkeurigheid te verbeteren en overfitting te verminderen. RF werkte via een ensemble-learningprocedure waarbij voorspellingen van meerdere bomen werden samengevoegd om de uiteindelijke voorspelling te genereren37,38. Deze aanpak stelde RF in staat om diverse patronen in de data vast te leggen, terwijl de overfitting die gewoonlijk geassocieerd wordt met individuele DT's werd verminderd. De willekeurigheid die tijdens de constructie van de bomen werd geïntroduceerd, verbeterde de generaliseerbaarheid van het model, waardoor RF geschikt was voor classificatietaken zoals de classificatie van geslacht en leeftijd op basis van stemgegevens.
Logistische regressie
Logistische Regressie (LR) werd gebruikt als statistisch ML-model voor classificatie39. Bij binaire classificatie schat LR de waarschijnlijkheid van een uitkomst op basis van de inputkenmerken met behulp van de logistische (sigmoïde) functie, en de resulterende waarschijnlijkheden worden gebruikt om klassevoorspellingen te genereren. LR was ook toepasbaar op multiclasse-classificatieproblemen waarbij meer dan twee klassen betrokken waren. Voor multiclasse-classificatie maakte LR gebruik van benaderingen zoals one-vs-rest of SoftMax-regressie, afhankelijk van de classificatie-instelling.
Extra Tree Classifier
De Extra Trees Classifier (ETC) werd gebruikt als een ensemble learning-algoritme dat meerdere DT's combineerde om voorspellingen te genereren40,41. In tegenstelling tot RF introduceert ETC extra willekeur door tijdens de constructie van de bomen willekeurig kandidaat-kenmerken en splitsingsdrempels te selecteren. Deze procedure genereerde minder gecorreleerde bomen en verminderde de gevoeligheid van het model voor individuele kenmerken, waardoor de robuustheid tegen ruis werd verbeterd. De Gini-index werd gebruikt als splitsingscriterium om het belang van kenmerken te evalueren en de gegevens te partitioneren.
Support Vector Machine
Support Vector Machine (SVM) werd gebruikt als een ML-classifier om een optimale beslissingsgrens in een hoogdimensionale kenmerkruimte te identificeren42. Het doel was om een hypervlak te bepalen dat de marge tussen klassen maximaliseerde. Een grotere marge tussen de beslissingsgrens en de dichtstbijzijnde datapunten ondersteunde over het algemeen een betere klassenseparatie en generalisatie. SVM was toepasbaar op verschillende ML-taken, waaronder classificatie, regressie en kenmerkgebaseerde data-analyse.
Convolutionele Neurale Netwerken
Convolutionele Neurale Netwerken (CNN's) werden gebruikt als Deep Learning (DL)-modellen voor classificatietaken met gestructureerde representaties van beeld- en audiogegevens. Eendimensionale CNN's (1D-CNN's) zijn daarnaast veelvuldig toegepast op sequentiële en tekstuele gegevens. CNN-architecturen maakten gebruik van convolutionele filters en pooling-operaties om discriminerende kenmerken uit de inputgegevens te extraheren43,4. Voor de classificatie van geslacht en leeftijd op basis van stemgegevens werden CNN's toegepast op spraakafgeleide representaties om patronen te leren die geassocieerd zijn met toonhoogte, frequentie, klankkleur en andere vocale kenmerken die relevant zijn voor het onderscheiden van geslacht- en leeftijdsgroepen.
VGG19
VGG19 werd gebruikt als DL-architectuur, gekenmerkt door een diepe, relatief uniforme hiërarchische structuur voor kenmerkextractie45. De architectuur maakte gebruik van kleine 3 × 3 convolutionele filters over 19 lagen, waardoor progressieve extractie van discriminerende kenmerken mogelijk was. Wanneer VGG19 werd toegepast op spraakafgeleide representaties, legde het zowel laagwaardige akoestische patronen, zoals variaties in toonhoogte en frequentie, als hoogwaardige discriminerende kenmerken vast. De diepe architectuur maakte progressieve kenmerkabstractie mogelijk voor het modelleren van vocale eigenschappen geassocieerd met geslacht en leeftijd.
EfficientNet-Lite
EfficientNet-Lite werd gebruikt als een computationeel efficiënte DL-architectuur46,47. Het model maakte gebruik van een gebalanceerde schalingsstrategie om sterke classificatieprestaties te behalen, terwijl er minder computationele middelen nodig waren dan bij zwaardere DL-architecturen. De compound scaling-benadering hield gezamenlijk rekening met de modeldiepte, breedte en inputresolutie om een efficiënte kenmerkextractie te realiseren.
EfficientNet-Lite werd gekozen voor het voorgestelde VoiceNet-RAI-framework vanwege de lichtgewicht architectuur en de gunstige balans tussen classificatieprestaties en modelcomplexiteit. In vergelijking met zwaardere architecturen maakte het gebruik van efficiënte convolutionele blokken en compound scaling om effectief kenleerproces te bereiken met minder parameters en lagere computationele vereisten. Deze eigenschappen maakten EfficientNet-Lite geschikt voor het voorgestelde framework voor spraakclassificatie en boden het potentieel voor implementatie in omgevingen met beperkte middelen.
MobileNet
MobileNet werd gebruikt als een lichtgewicht DL-architectuur voor toepassingen met beperkte computationele middelen, waaronder mobiele omgevingen en edge computing48. De computationele efficiëntie werd primair bereikt door depthwise separable convolutions, die het aantal parameters en computationele bewerkingen verminderden in vergelijking met conventionele convolutionele architecturen. Deze kenmerken maakten MobileNet geschikt voor het evalueren van gender- en leeftijdclassificatie op basis van stemgegevens, terwijl de computationele vereisten relatief laag bleven.
InceptionV3
InceptionV3 werd gebruikt als diepe architectuur om hiërarchische kenmerken te extraheren uit spraakafgeleide representaties49. De architectuur maakte gebruik van convolutionele, pooling- en mixed-operaties om kenmerken op verschillende abstractieniveaus te extraheren. Voor de classificatie van geslacht en leeftijd op basis van stemgegevens werd InceptionV3 ingezet om complexe akoestische patronen en hiërarchische representaties te leren die geassocieerd zijn met variaties in vocale kenmerken.
Evaluatieparameters
Nauwkeurigheid was een van de meest gebruikte evaluatiematen voor classificatietaken50. Hoewel nauwkeurigheid een nuttige maatstaf bood voor de algehele classificatieprestaties, leverde het niet altijd een volledige beoordeling op, met name bij ongebalanceerde datasets. Daarom werden aanvullende metrieken, waaronder precisie, recall en de F1-score, gebruikt om de modelprestaties te evalueren. Deze metrieken boden een completere beoordeling door rekening te houden met correcte en incorrecte voorspellingen voor elke klasse.
Nauwkeurigheid werd gedefinieerd als de verhouding tussen correct geclassificeerde waarnemingen en het totale aantal waarnemingen. Hoewel nauwkeurigheid bijzonder informatief is voor gebalanceerde datasets, was de dataset die in deze studie is gebruikt ongebalanceerd. Daarom werden True Positives (TP), False Positives (FP), True Negatives (TN) en False Negatives (FN) meegewogen bij het berekenen en interpreteren van de classificatiemetrieken. De onderstaande vergelijking representeert de standaarddefinitie van nauwkeurigheid:
Nauwkeurigheid = (TP+TN)/(TP+TN+FP+FN)×10 (5)
Precisie beoordeelt het vermogen van de classifier om uitsluitend relevante instanties terug te geven:
Precisie= TP/(TP+FP) ×10 (6)
Recall, ook bekend als sensitiviteit, meet het vermogen van de classifier om alle relevante instanties te identificeren:
Recall= TP/(FN+TP) × 10 (7)
De F1-score combineert precisie en recall in één enkele maatstaf en is bijzonder nuttig voor het evalueren van de classificatieprestaties bij ongebalanceerde datasets:
F1-score = 2 ×(PPV ×TPR)/(TPR+PPV) × 10 (8)
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Experimental results for age and gender classification were evaluated using MFCC-based and hybrid feature representations with ML and DL models. The dataset was partitioned into training and testing sets at an 80:20 ratio, with 80% used for training and 20% for testing. Speaker-level partitioning was applied to prevent recordings from the same speaker from appearing in both sets.
The hyperparameters and implementation details of the proposed framework are summarized in Table 3...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
In deze studie is een geautomatiseerd raamwerk ontwikkeld en geëvalueerd voor de classificatie van geslacht en leeftijd op basis van stemgegevens door de integratie van MFCC-kenmerken en wav2vec 2.0-embeddings met EfficientNet-Lite. In de initiële experimenten behaalde EfficientNet-Lite een nauwkeurigheid van 83,48%, een precisie van 82,87%, een recall van 84,28% en een F1-score van 83,54% met behulp van de oorspronkelijke kenmerken. Na de integratie van MFCC-kenmerken verbeterde de prestatie aanzienlijk, met een nauwkeu...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs hebben geen belangenconflicten te melden.
Dankbetuigingen
De auteurs willen graag het Princess Nourah bint Abdulrahman University Researchers Supporting Project nummer (PNURSP2026R748), Princess Nourah bint Abdulrahman University, Riyadh, Saoedi-Arabië bedanken voor de financiering van dit onderzoek.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| BVC Challenging Voice Set | Biometrics Vision and Computing Group / OgeNI | BVC Challenging Voice Set | https://github.com/OgeNI/BVC_Challenging_Voice_Set |
| EfficientNet-Lite | EfficientNet-Lite, exacte gebruikte variant | https://github.com/tensorflow/tpu/tree/master/models/official/efficientnet/lite | |
| Grafische Processor (GPU) | NVIDIA | Tesla K80 | https://www.nvidia.com/ |
| Mozilla Common Voice Dataset | Mozilla Foundation | Common Voice, versie gebruikt in experimenten | https://www.kaggle.com/datasets/mozillaorg/common-voice/data |
| NumPy | NumPy Developers | Exacte versie gebruikt in experimenten | https://numpy.org/ |
| Processor | Intel | Intel Core i7-8265U | https://www.intel.com/ |
| Python | Python Software Foundation | Exacte versie gebruikt in experimenten | https://www.python.org/ |
| PyTorch | PyTorch Foundation | Exacte versie gebruikt in experimenten | https://pytorch.org/ |
| Scikit-learn | Scikit-learn Developers | Exacte versie gebruikt in experimenten | https://scikit-learn.org/ |
| SciPy | SciPy Developers | Exacte versie gebruikt in experimenten | https://scipy.org/ |
| wav2vec 2.0 Base | Meta AI | facebook/wav2vec2-base | https://huggingface.co/facebook/wav2vec2-base |
| Windows 1 | Microsoft | Windows 1, exacte editie/build indien beschikbaar | https://www.microsoft.com/windows/windows-1 |
Referenties
- Pahwa A, Aggarwal G. Speech feature extraction for gender recognition. Int J Image Graph Signal Process. 2016;8:17.
- Ericsdotter C, Ericsson AM. Gender differences in vowel duration in read Swedish: Preliminary results. Work Pap Lund Univ Dep Linguist Phon. 2001;49:34-37.
- Gamit MR, Dhameliya K, Bhatt NS. Classification techniques for speech recognition: A review. Int J Emerg Technol Adv Eng. 2015;5:58-63.
- Rabiner LR, Juang BH. Fundamentals of Speech Recognition. PTR Prentice Hall; Englewood Cliffs, NJ; 1993.
- Hansen JHL, Hasan T. Speaker recognition by machines and humans: A tutorial review. IEEE Signal Process Mag. 2015;32(6):74-99.
- Zhang Y, et al. Towards end-to-end speech recognition with deep convolutional neural networks [conference presentation]. Presented at: Interspeech 2016; San Francisco, CA; 2016. p. 410-414. Available from: https://www.isca-archive.org/interspeech_2016/zhang16b_interspeech.html
- Kabil SH, Muckenhirn H, Magimai-Doss M. On learning to identify genders from raw speech signal using CNNs [conference presentation]. Presented at: Interspeech 2018; Hyderabad, India; 2018. p. 287-291. Available from: https://www.isca-archive.org/interspeech_2018/kabil18_interspeech.html
- Albawi S, Mohammed TA, Al-Zawi S. Understanding of a convolutional neural network [conference presentation]. Presented at: 2017 International Conference on Engineering and Technology (ICET); Antalya, Türkiye; 2017. p. 1-6. Available from: https://ieeexplore.ieee.org/document/8308186
- Abdi H, Williams LJ. Principal component analysis. Wiley Interdiscip Rev Comput Stat. 2010;2(4):433-459.
- Mavaddati S. Voice-based age, gender, and language recognition based on ResNet deep model and transfer learning in spectro-temporal domain. Neurocomputing. 2024;580:127429.
- Jiang H, et al. 3WD-DRT: A three-way decision enhanced dynamic routing transformer for cost-sensitive multimodal sentiment analysis. Inf Sci. 2026;725:122704.
- Jameel HK, Al Ghrairi AHT, Neamah MM. Self-supervised learning for speech recognition: A review. Dijlah J Eng Sci. 2026;3(2).
- Anidjar OH, Yozevitch R. Transformer-based language-independent gender recognition in noisy audio environments. Sci Rep. 2025;15(1):14421.
- Sinha A, Kathania HK, Kurimo M. A study on the layer-wise transferability of self-supervised learning features for children's speech processing tasks. Speech Commun. 2026;180:103392.
- Li M, Han KJ, Narayanan SS. Automatic speaker age and gender recognition using acoustic and prosodic level information fusion. Comput Speech Lang. 2013;27(1):151-167.
- Sánchez-Hevia HA, Gil-Pita R, Utrilla-Manso M, Rosa-Zurera M. Age group classification and gender recognition from speech with temporal convolutional neural networks. Multimed Tools Appl. 2022;81:3535-3552.
- Abu Mallouh A, Qawaqneh Z, Barkana BD. New transformed features generated by deep bottleneck extractor and a GMM–UBM classifier for speaker age and gender classification. Neural Comput Appl. 2018;30:2581-2593.
- Almomani A, et al. Age and gender classification using backpropagation and bagging algorithms. Comput Mater Contin. 2023;74(2):3045-3062.
- Sahar RM, Rao TS, Anuradha S, Rao BS. Performance analysis of ML algorithms to detect gender based on voice. In: Recent Trends in Intensive Computing. 2021. p. 163-171. Available from: https://journals.sagepub.com/doi/abs/10.3233/APC210192
- Kone VS, et al. Voice-based gender and age recognition system [conference presentation]. Presented at: 2023 International Conference on Advancement in Computation & Computer Technologies (InCACCT); Gharuan, India; 2023. p. 74-80. Available from: https://ieeexplore.ieee.org/document/10141801
- Alhussein M, Muhammad G. Voice gender recognition under unconstrained environments using self-attention. Appl Acoust. 2021;175:107823.
- Yücesoy E. Automatic age and gender recognition using ensemble learning. Appl Sci. 2024;14(16):6868.
- Alnuaim AA, et al. Speaker gender recognition based on deep neural networks and ResNet50. Wirel Commun Mob Comput. 2022;2022:4444388.
- Ibrahim F, Nahar KMO, Al-Shannaq MA. Gender identification and age estimation of Arabic speaker using machine learning. J Theor Appl Inf Technol. 2020;98(19):3242-3256.
- Kannapiran P, Sindha MMR. Voice-based gender recognition model using FRT and LightGBM. Teh Vjesn. 2023;30:282-291.
- Alkhammash EH, Hadjouni M, Elshewey AM. A hybrid ensemble stacking model for gender voice recognition approach. Electronics. 2022;11:1750.
- Mutiany M, Herlistiono IO. Gender detection by voice using deep learning. Int J Innov Sci Res Technol. 2020;5(10):841-845.
- Raahul A, Sapthagiri R, Pankaj PK, Vijayarajan V. Voice based gender classification using machine learning. IOP Conf Ser Mater Sci Eng. 2017;263(4):042083. Available from: https://iopscience.iop.org/article/10.1088/1757-899X/263/4/042083
- Iloanusi O, et al. Voice recognition and gender classification in the context of native languages and lingua franca [conference presentation]. Presented at: 2019 6th International Conference on Soft Computing & Machine Intelligence (ISCMI); Johannesburg, South Africa; 2019. p. 175-179. Available from: https://ieeexplore.ieee.org/document/9004306
- Gupta Y, Gangwar K, Singhal M, Hemavathi D. Gender and age recognition using audio data-artificial neural networks. In: Soft Computing for Security Applications: Proceedings of ICSCS 2021. Springer; 2022. p. 449-470. Available from: https://link.springer.com/chapter/10.1007/978-981-16-5301-8_34
- Qawaqneh Z, Mallouh AA, Barkana BD. Deep neural network framework and transformed MFCCs for speaker’s age and gender classification. Knowl-Based Syst. 2017;115:5-14.
- OgeNI. BVC Challenging Voice Set [Internet]. GitHub; 2025 [cited 2026 Aug 16]. Available from: https://github.com/OgeNI/BVC_Challenging_Voice_Set
- Oppenheim AV, Schafer RW. Discrete-Time Signal Processing. 3rd ed. Pearson; Upper Saddle River, NJ; 2010.
- Logan B. Mel frequency cepstral coefficients for music modeling [conference presentation]. Presented at: International Society for Music Information Retrieval Conference (ISMIR); Plymouth, UK; 2000. Available from: https://ismir.net/conferences/ismir-2000/
- Davis SB, Mermelstein P. Comparison of parametric representations for monosyllabic word recognition in continuously spoken sentences. IEEE Trans Acoust Speech Signal Process. 1980;28(4):357-366.
- Baevski A, Zhou H, Mohamed A, Auli M. wav2vec 2.0: A framework for self-supervised learning of speech representations [conference presentation]. Presented at: Advances in Neural Information Processing Systems 33 (NeurIPS 2020); Virtual; 2020. p. 12449-12460. Available from: https://proceedings.neurips.cc/paper/2020/hash/92d1e1eb1cd6f9fba3227870bb6d7f07-Abstract.html
- Yıldırım Ş, Bingöl MS. Metaheuristic approaches to enhance voice-based gender identification using machine learning methods. Appl Sci. 2025;15(23):12815.
- Breiman L. Random forests. Mach Learn. 2001;45:5-32.
- Hosmer DW Jr, Lemeshow S, Sturdivant RX. Applied Logistic Regression. 3rd ed. Wiley; Hoboken, NJ; 2013.
- Geurts P, Ernst D, Wehenkel L. Extremely randomized trees. Mach Learn. 2006;63:3-42.
- Yücesoy E, Nabiyev VV. A new approach with score-level fusion for the classification of a speaker age and gender. Comput Electr Eng. 2016;53:29-39.
- Cortes C, Vapnik V. Support-vector networks. Mach Learn. 1995;20:273-297.
- Abdel-Hamid O, et al. Convolutional neural networks for speech recognition. IEEE/ACM Trans Audio Speech Lang Process. 2014;22(10):1533-1545.
- Nasaruddin N, Pratama Tresma MAP, Muchamad MK, Fuadi Z. Voice frequency-based gender classification using convolutional neural network for smart home. IEEE Access. 2024;12:104190-104203.
- Simonyan K, Zisserman A. Very deep convolutional networks for large-scale image recognition [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); San Diego, CA; 2015. Available from: https://iclr.cc/archive/www/2015.html
- Tan M, Le QV. EfficientNet: Rethinking model scaling for convolutional neural networks [conference presentation]. Presented at: 36th International Conference on Machine Learning (ICML); Long Beach, CA; 2019. p. 6105-6114. Available from: https://proceedings.mlr.press/v97/tan19a.html
- Ertam F. An effective gender recognition approach using voice data via deeper LSTM networks. Appl Acoust. 2019;156:351-358.
- Zhao L, Wang L, Jia Y, Cui Y. A lightweight deep neural network with higher accuracy. PLoS One. 2022;17(8):e0271225.
- Szegedy C, et al. Rethinking the Inception architecture for computer vision [conference presentation]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition (CVPR); Las Vegas, NV; 2016. p. 2818-2826. Available from: https://openaccess.thecvf.com/content_cvpr_2016/html/Szegedy_Rethinking_the_Inception_CVPR_2016_paper.html
- Sokolova M, Lapalme G. A systematic analysis of performance measures for classification tasks. Inf Process Manag. 2009;45(4):427-437.
- Mozilla Common Voice Project. Common Voice Dataset [Internet]. 2024 [cited 2024 Jun 18]. Available from: https://www.kaggle.com/datasets/mozillaorg/common-voice/data
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.