Dit protocol integreert multimodale gedragsregistraties om observeerbare correlaten van cognitieve inspanning en de functionele effectiviteit van revisie bij schriftelijke vertaling en sight interpreting van het Engels naar het Chinees te beoordelen. Het combineert keystroke logging, schermopname, audioanalyse, transcriptiegebaseerde codering en gestandaardiseerde kwaliteitsbeoordeling.
Methodenartikel
Een gedragsprotocol voor het beoordelen van cognitieve inspanning en strategische revisie bij Engels-Chinese vertaal- en zichtvertaaltaken
In dit artikel
Samenvatting
Samenvatting
Dit artikel presenteert een multimodaal gedragsprotocol voor het onderzoeken van observeerbare correlaten van cognitieve inspanning en strategische revisie tijdens geschreven vertaling en sight translating van het Engels naar het Chinees. Toetsenbordlogs en schermopnames worden gesynchroniseerd voor de geschreven vertaling, terwijl audio-opnamen en letterlijke transcripties worden gebruikt voor sight translating. Revisie- en zelfcorrectie-episoden worden gecodeerd op type en op functionele uitkomst (effectief, neutraal of nadelig), onafhankelijk van holistische beoordelingen van de outputkwaliteit. In een demonstratie met 62 deelnemers, verdeeld over een novice- en een getrainde groep, voltooiden beide groepen de twee taakcondities in een tegengebalanceerde volgorde. De getrainde deelnemers hadden hogere gemiddelde scores voor de outputkwaliteit bij de geschreven vertaling (20,1 ± 2,1 vs. 16,8 ± 2,3) en sight translating (18,9 ± 2,4 vs. 15,4 ± 2,6), en een groter aandeel effectieve revisies of zelfcorrecties. Omdat pauzes, deleties, onset-latentie en revisiedichtheid indirect en taakgevoelig zijn, worden zij geïnterpreteerd als gedragsmatige correlaten die triangulatie vereisen, in plaats van als directe maten van een unitaire construct. Het protocol is bedoeld voor gecontroleerde expositoire teksten en kan worden aangepast aan andere taalparen na herkalibratie van de verwerking van de invoermethode, pauwedrempels, tekstvergelijkbaarheid en scoringsprocedures.
Inleiding
Engels-Chinese schriftelijke vertaling en sight interpreting vereisen begrip van de brontekst, cross-linguïstische overdracht en formulering in de doeltaal, maar ze leggen verschillende taakvoorwaarden op. Schriftelijke vertaling staat recursief lezen en uitgesteld redigeren toe, terwijl sight interpreting orale productie vereist onder striktere tijdsbeperkingen. Cognitieve belasting, verwerkingsmoeilijkheid en cognitieve inspanning zijn verwante, maar niet uitwisselbare constructen: belasting heeft betrekking op de taakeisen, terwijl inspanning betrekking heeft op de middelen die een deelnemer onder die eisen investeert. Cognitieve inspanning is latent en multidimensionaal; daarom worden latentie, pauzes, weglatingen en revisiedichtheid hier behandeld als gedragsmatige correlaten die planning, monitoring, motorische processen of moeilijkheid kunnen weerspiegelen en die gezamenlijk moeten worden geïnterpreteerd in plaats van als directe metingen van inspanning1,2,3,4,5,6,7,8.
Procesgeoriënteerd onderzoek combineert productscores met tijdgelijktijdig gedragsverledenen om vast te stellen wanneer en hoe vertaalbeslissingen worden genomen. Keystroke logging is informatief voor productie- en revisiesequenties, maar de compositie van Chinese invoermethoden kan fysieke toetsgebeurtenissen scheiden van de definitief ingevoerde tekens; gesynchroniseerde schermopnamen zijn daarom nodig om de zichtbare tekststatus te reconstrueren9,10,11. Pauzedrempels zijn analytische keuzes in plaats van universele cognitieve grenzen, en kortere drempels kunnen conclusies op basis van pauzes materieel veranderen8,12. Het protocol vereist bijgevolg expliciete synchronisatiecontroles, gevoeligheidsanalyses van de drempelwaarden en het scheiden van taakspecifieke van gedeelde maten.
Alleen de frequentie van revisies geeft niet aan of monitoring een output verbetert. Schriftelijke revisies en orale zelfcorrecties kunnen gericht zijn op lexicale keuze, syntaxis, betekenis of stijl, maar hun functionele resultaat moet worden beoordeeld ten opzichte van de bronbetekenis en het direct voorafgaande doelsegment. Onderzoek naar sight-interpreteren bij Engels-Chinees en Chinees-Engels procesverloop laat zien dat training, directionaliteit, oog-stemcoördinatie en taalspecifieke probleemtriggers de prestatiepatronen kunnen beïnvloeden13,14,15,16. Om deze reden worden episodetype, episoderesultaat, de kwaliteit van het eindproduct en leveringsgerelateerd gedrag als afzonderlijke variabelen gecodeerd.
Het protocol is ontworpen voor volwassen lerenden of getrainde vertalers/tolken die werken met korte, niet-gespecialiseerde expositorische teksten in gecontroleerde computersessies. Het is het meest geschikt wanneer toetsaanslag- en schermopnamen kunnen worden vastgelegd voor schriftelijke productie, en wanneer audio van hoge kwaliteit kan worden opgenomen voor mondelinge productie. Het raamwerk kan worden aangepast aan andere taalparen, maar tekstmatching, segmentatie in informatie-eenheden, toetsenbord- of invoermethodegedrag, pausedrempels en beoordelingsankers moeten voor elk taalpaar en schrift opnieuw worden gevalideerd17. De demonstratie vergelijkt taakcondities in plaats van alle verschillen uitsluitend aan de modaliteit toe te schrijven, aangezien ook de tekstlengte, tijdslimieten, outputmodus en herzimmogelijkheden verschillen.
Protocol
Alle methoden waarbij menselijke proefpersonen betrokken waren, zijn uitgevoerd in overeenstemming met de institutionele richtlijnen en hebben expliciete goedkeuring ontvangen van de Menselijke Onderzoeksethische Commissie van het Guilin Institute of Information Technology (goedkeuringsnummer UYHAJ2025899). Van alle deelnemers is voorafgaand aan hun deelname schriftelijke geïnformeerde toestemming verkregen. Raadpleeg de Tabel met Materialen voor een volledige lijst van de apparatuur en software die in deze studie zijn gebruikt.
1. Werving van deelnemers en groepsindeling
- Werving van 62 deelnemers, bestaande uit studenten Engels of vertaalstudies en professionele tolkstudenten. Verifieer dat alle deelnemers moedertaalsprekers van het Chinees zijn met een normaal of tot normaal gecorrigeerd gezichtsvermogen en gehoor.
- Wijs deelnemers met minder dan 12 maanden gestructureerde vertaalopleiding toe aan de beginnersgroep, en deelnemers met ten minste 12 maanden aan de getrainde groep. Rapporteer de eerdere ervaring met schriftelijke vertaling en gezichtsvertaling afzonderlijk voor alle deelnemers.
- Screen de deelnemers vóór de taaktoewijzing om personen uit te sluiten die al bekend waren met de bronteksten, een ongecorrigeerd sensorisch defect hebben of niet in staat zijn de gestandaardiseerde Chinese invoermethode te gebruiken.
- Sluit taken na de opname alleen uit om vooraf vastgestelde redenen, zoals het verboden gebruik van externe hulpmiddelen, onvolledige uitvoering, corrupte bestanden of onbruikbare audio.
- Houd een logboek bij van de uitgesloten taken zonder persoonlijk identificeerbare informatie. Rapporteer de uiteindelijke geanalyseerde steekproef consistent in de tekst en Figuur 1A–D.
2. Materiaalselectie en pilotavaluatie
- Selecteer korte Engelse expositieve teksten uit algemene academische, educatieve, sociale of publiekscommunicatiedomeinen. Gebruik teksten voor schriftvertaling van ongeveer 180–220 woorden en teksten voor sight-interpreting van ongeveer 120–160 woorden.
- Stem de tekstlengte, lexicale moeilijkheidsgraad, syntactische complexiteit, informatiedichtheid en topicfamiliariteit op elkaar af of pas deze statistisch aan over de verschillende taakcondities.
- Instrueer drie tweetalige experts om onafhankelijk de lexicale moeilijkheidsgraad, syntactische complexiteit, informatiedichtheid, topicfamiliariteit en geschiktheid voor overdracht te scoren op een schaal van 1 tot 5 (1 = zeer laag, 5 = zeer hoog).
- Bereken een two-way random-effects intraclass correlatiecoëfficiënt (ICC) met een 95% betrouwbaarheidsinterval voor de gemiddelde scores. Herzie items die een slechte overeenstemming vertonen (ICC < 0,75).
- Behoud tekstparen alleen wanneer de gestandaardiseerde matchingvariabelen binnen een tolerantiemarge van ±10% vallen.
- Definieer een informatie-eenheid als de kleinste propositie in de brontekst die één onafhankelijk scorebaar idee, relatie of gebeurtenis uitdrukt. Los onenigheid over de afbakening op vóór de uitvoering van de taak.
- Test de instructies, invoermethode, synchronisatie, geluidskwaliteit en tijdslimieten via een pilot met deelnemers die niet zijn opgenomen in de hoofdanalyse. Registreer de verdeling van de voltooiingstijden en het aandeel dat elke tijdslimiet bereikt.
- Herzie een tekst of tijdslimiet wanneer pilotdeelnemers ceiling- of floor-effecten vertonen, aanhoudende ambiguïteit ervaren of wanneer er sprake is van instabiliteit in de opnames. Documenteer elke wijziging voorafgaand aan de start van de hoofdstudie.
3. Toediening van de taak en opstelling van de registratie
- Test de deelnemers individueel in een rustige, geluidsgeïsoleerde kamer met gebruik van gestandaardiseerde hardware- en softwareconfiguraties.
- Lees een gestandaardiseerd instructiescript voor en sta één niet-experimenteel oefenitem toe. Verbied het gebruik van woordenboeken, zoekmachines, generatieve kunstmatige intelligentie, machinevertaling en externe corpora.
- Balanceer de twee taakvolgordes (eerst schriftelijke vertaling vs. eerst sight translation) binnen elke trainingsgroep en hanteer een rustinterval van 5 minuten.
- Stel de allocatielijst op voordat de werving is voltooid en houd de toewijzing geheim tot de geschiktheid is bevestigd. Als er meerdere bronteksten worden gebruikt, balanceer dan de tekstidentiteit onafhankelijk van de taakvolgorde en bewaar een tekst-ID variabele voor analyse.
- Presenteer de Engelse brontekst continu en instrueer de deelnemer om een accurate, natuurlijke Chinese vertaling te produceren in het daarvoor bestemde invoerveld. Sta onbeperkt bewerken toe, maar verbied strikt het plakken van externe tekst.
- Pas de limiet van 20 minuten toe die in de pilot is vastgesteld zonder een aftelklok weer te geven, en leg vast of deze limiet is bereikt.
- Leg het volledige proces van de schriftelijke vertaling continu vast met behulp van keystroke logging-software gesynchroniseerd met continue schermopname. Bewaar de definitieve vertaalresultaten samen met de tijdstempel-logbestanden voor daaropvolgende gedragsextractie.
- Presenteer de brontekst voor de sight translation op het scherm en instrueer de deelnemer om te beginnen met een mondelinge Chinese weergave zonder schriftelijke aantekeningen.
- Pas de limiet van 6 minuten consequent toe en leg vast of deze limiet is bereikt. Maak onderscheid tussen een tijdslimitede waarneming en een regulier voltooide waarneming.
- Neem de mondelinge output op met digitale audio-opnamesoftware. Maak strikte verbatim transcripties van deze opnamen om daaropvolgende codering te faciliteren.
4. Extractie van gedragsmatige procesindicatoren
- Extraheer gedragsmatige correlaten van de schrijftaak uit de logbestanden, waarbij de initiële latentie wordt gedefinieerd als het interval vanaf het begin van de stimulus tot het eerste definitief ingevoerde Chinese karakter.
- Extraheer de totale taaktijd, het aantal en de duur van pauzes, de verwijderingssnelheid, de revisiedichtheid en de productiesnelheid. Bewaar de ruwe tijdstempels en de exacte noemer die is gebruikt voor elke genormaliseerde maatstaf.
- Gebruik 2 s als de operationele drempelwaarde voor een schrijfpauze. Vermeld of pauzes tijdens cursornavigatie, tekstselectie of de selectie van kandidaten in de invoermethode zijn inbegrepen.
- Extraheer gedragsmatige correlaten van de mondelinge taak uit de waveform en het geverifieerde transcript, waarbij de onset-latentie wordt gedefinieerd als het interval vanaf de presentatie van de stimulus tot de eerste betekenisvolle uiting in de doeltaal.
- Sluit inademing, het schrapen van de keel en afgebroken niet-lexicale geluiden uit van de onset-latentie. Extraheer de totale vertaaltijd, stille pauzes, gevulde pauzes, herhalingen, valse starts, zelfcorrecties en de spreeksnelheid.
- Definieer een mondelinge stille pauze als een stilte binnen een uiting van ten minste 1,0 s. Controleer de pauzegrenzen aan de hand van de waveform en het geverifieerde transcript, en sluit begin- en eindstilte uit van de telling van de pauzes binnen uitingen.
- Stel voor elke afgenomen taak een kwaliteitscontrolerapport op. Documenteer of het toepasselijke procesbestand leesbaar en volledig is, of het transcript is geverifieerd en of de codering is voltooid of is beoordeeld. Bewaar het originele verslag en registreer eventuele correcties in het audit-spoor.
5. Codering van strategische revisie en orale zelfcorrectie
- Reconstrueer elke geschreven revisie door het toetsenbordlogboek, de schermvideo en de definitieve tekst op elkaar af te stemmen.
- Beschouw een episode als een continue reeks bewerkingen gericht op hetzelfde doelsegment, en sluit de episode zodra de productie elders wordt hervat gedurende ten minste 2 s of wanneer een ander segment wordt bewerkt.
OPMERKING: Maak bij Chinese invoer onderscheid tussen wijzigingen in de compositie vóór de definitieve bevestiging (pre-commitment) en verwijderingen in de doeltekst na de bevestiging (post-commitment), en codeer alleen dat laatste als tekstuele revisies. - Wijs één primair revisietype toe op basis van semantische, syntactische, lexicale of stilistische wijzigingen. Sta een secundaire tag toe voor overlappende gevallen, maar gebruik de primaire tag voor wederzijds uitsluitende tellingen. Pas de uitgewerkte voorbeelden toe die zijn verstrekt in Supplementary File 1.
- Maak een verbatim transcript met tijdstempels voordat de orale zelfcorrectie wordt gecodeerd. Instrueer de eerste transcribeerder om lexicale inhoud, gevulde pauzes, herhalingen, valse starts, afbrekingen en onverstaanbare passages te markeren.
- Laat een tweede getrainde reviewer het transcript controleren aan de hand van de audio en discrepanties oplossen, terwijl de oorspronkelijke audio-tijdstempels behouden blijven.
- Definieer een orale zelfcorrectie als een expliciete herformulering die een direct voorafgaand segment in de doeltaal vervangt, aanvult of corrigeert. Leid geen covert monitoring af uit enkel stilte. Pas dezelfde lexicale, syntactische, semantische en stilistische beslisregels toe op orale zelfcorrectie.
- Codeer een exacte herhaling zonder correctieve wijziging als disfluentie, een afgebroken start gevolgd door een nieuwe constructie als een valse start plus correctie, en een weglating of vertaalfout zonder expliciete herformulering als een outputfout.
- Wanneer de audio onduidelijk is of wanneer twee categorieën even aannemelijk blijven, markeer de episode dan als ambigu. Behoud voorlopige tags voor ambigue episodes en beoordeel deze voordat de betrouwbaarheidsanalyse plaatsvindt.
- Beoordeel het functionele resultaat door de doelsegmenten vóór en na de episode te vergelijken met de broninformatie-eenheid en de lokale doelcontext. Maak dit oordeel voordat de definitieve holistische score bekend wordt gemaakt. Gebruik een wijziging in de holistische score niet als definitie van effectiviteit.
- Codeer ten minste 20% van de outputs, geselecteerd over beide groepen en taakvolgordes, dubbel en bereken de betrouwbaarheid op basis van de onafhankelijke codes vóór de definitieve beoordeling.
- Train opnieuw en codeer opnieuw wanneer de interbeoordelaarsbetrouwbaarheid onder een Cohen’s kappa van 0,80 zakt. Documenteer deze exacte drempelwaarde en alle genomen correctieve maatregelen.
6. Kwaliteitsevaluatie en statistische modellering
- Scoor elke definitieve geschreven vertaling en sight-interpreting renditie met de analytische rubriek van 25 punten in Aanvullend Bestand 1.
- Beoordeel nauwkeurigheid, volledigheid, lexicale passendheid, coherentie en natuurlijkheid van de doeltaal op een schaal van 0 tot 5 met behulp van de opgegeven ankers. Interpoleer scorecriteria niet na inspectie van de groepslidmaatschap.
- Instrueer beoordelaars om zowel de audio als het geverifieerde transcript te gebruiken voor de dimensies van sight interpreting. Analyseer pauze- en disfluentiematen apart van de scores uit de rubriek.
- Train twee onafhankelijke beoordelaars met behulp van het codeboek en ten minste 10 oefenuitvoeringsresultaten, waarbij de beoordelaars blind zijn voor de participantengroep en de taakvolgorde.
- Bereken na onafhankelijke scoring en episode-codering de betrouwbaarheid vóór de discussie. Los onenigheid op door consensus en raadpleeg een derde beoordelaar alleen wanneer consensus niet kan worden bereikt.
- Rapporteer een twee-weg random-effects, absolute-agreement intraclass correlatiecoëfficiënt voor gemiddelde continue kwaliteitsscores. Rapporteer Cohen's kappa voor de primaire categorische revisiecode en een aparte kappa voor de effectieve/neutrale/nadelige uitkomstcode. Vermeld het exacte aantal en percentage dubbel gecodeerde episodes.
- Verifieer dat elk procesbestand leesbaar en volledig is vóór de analyse, lijn de logs van de schrijfopdrachten uit met de bijbehorende schermopnamen, en verifieer de transcripten aan de hand van de audio.
- Registreer uitlijningsfouten, verstaanbaarheidsproblemen en correctieve acties in een kwaliteitscontrolelogboek. Normaliseer frequentiematen met 100 informatie-eenheden van de brontekst voor de pauzefrequentie en 100 geproduceerde Chinese karakters voor de dichtheid van de geschreven revisie.
- Codeer de functionele uitkomst onafhankelijk van de uiteindelijke holistische kwaliteitsscore. Codeer een episode als effectief wanneer het segment na revisie de tekst verbetert zonder nieuwe problemen te introduceren, als neutraal wanneer het geen materiële wijziging teweegbrengt, en als nadelig wanneer het een fout introduceert.
- Bereken de effectieve ratio als het aantal effectieve episodes gedeeld door alle classificeerbare episodes, waarbij ambigue episodes uit de noemer worden uitgesloten.
- Analyseer de demonstratie als een exploratieve dataset met herhaalde metingen. Specificeer het fixed-effects model om de totale kwaliteitsscore te voorspellen op basis van taakconditie, trainingsgroep, pauzemetrieken, revisiedichtheid, effectieve ratio, disfluentiebelasting en spreeksnelheid.
- Voeg een random intercept voor participanten toe, en voeg random effects voor de brontekst alleen toe als het ontwerp voldoende onafhankelijk gesamplede teksten bevat.
- Centreer continue predictoren, inspecteer residuen en controleer op collineariteit. Rapporteer de schattingsmethode, softwareversie, β, SE, 95% CI, exacte p-waarden, variantiecomponenten, AIC, BIC en marginale/conditionele R2. Beschrijf de analyse als exploratief en vermijd bevestigende causale beweringen.
- Exporteer een reproduceerbaar analysepakket met gedeïdentificeerde gegevens, woordenlijst, codeboek, rubriek, softwaregegevens, scripts en output. Bevestig dat elke figuur- en tabelwaarde herleidbaar is naar een benoemde variabele en analysestap vóór publicatie.
Resultaten
Basiskenmerken van deelnemers en beschikbaarheid van gegevens
De vragenlijst omvatte 62 deelnemers (31 beginners en 31 getrainden), en het taakblad bevatte 124 records, wat wijst op twee voltooide taakrecords per deelnemer (Tabel 1). De beginnersgroep had minder dan 12 maanden gestructureerde vertaaltraining (waargenomen maximum, 8,6 maanden), terwijl de getrainde groep minstens 12 maanden training had (waargenomen minimum, 13,3 maanden). Leeftijd, geslacht, duur van het leren van Engels, vaardigheidsniveau en de verdeling van de taakvolgorde waren vergelijkbaar tussen de groepen. Figuur 1 rapporteert de uiteindelijke geanalyseerde steekproef en maakt correct onderscheid tussen taakspecifieke gegevens: toetsaanslaglogs en schermopnames zijn van toepassing op schriftelijke vertaling, audio- en letterlijke transcripties zijn van toepassing op gezichtstolken, en kwaliteitsbeoordelingen zijn op beide van toepassing.
Gedragsprofielen over taakcondities heen
Gedragsprofielen verschilden tussen de twee taakcondities en tussen de trainingsgroepen (Tabel 2; Figuur 2A–E). Bij schriftelijke vertaling waren de voltooiingstijden langer en waren de gemiddelde pauzes langer, terwijl bij gezichtsvertaling meer pauzes per 100 informatie-eenheden onder de gerapporteerde drempelwaarde voorkwamen. Binnen elke taakconditie voltooide de getrainde groep de taken sneller en behaalden zij hogere gemiddelde outputscores. Deze contrasten mogen niet worden geïnterpreteerd als zuivere modaliteitseffecten, aangezien ook de tekstlengte, de tijdslimiet, de outputmodus en de mogelijkheid tot revisie verschilden. Pauzes zijn niet uniform verstorend: een pauze kan wijzen op onopgeloste moeilijkheden, succesvolle planning, monitoring of activiteit van de invoermethode, waardoor pauzemetrieken samen met revisie-, leverings- en kwaliteitsmetrieken worden geïnterpreteerd.
Strategische herziening, zelfherstel en voorspellende modellering
Het coderingskader scheidde het type episode van de functionele uitkomst (Tabel 3; Figuur 3A–D). Getrainde deelnemers produceerden meer geschreven revisie-episodes dan novices (12,4 ± 3,7 vs. 8,9 ± 3,0 per taak), terwijl de totale orale zelfcorrectie niet significant verschilde tussen de groepen (4,9 ± 1,6 vs. 4,4 ± 1,5 per taak). De getrainde groep had desondanks een groter aandeel effectieve episodes in beide taken. De gerapporteerde samenvatting van de mixed-effects in Tabel 4 presenteert associaties in plaats van causale paden; Figuur 3E toont daarom de gerapporteerde fixed-effect schattingen en betrouwbaarheidsintervallen in plaats van een causaal diagram.
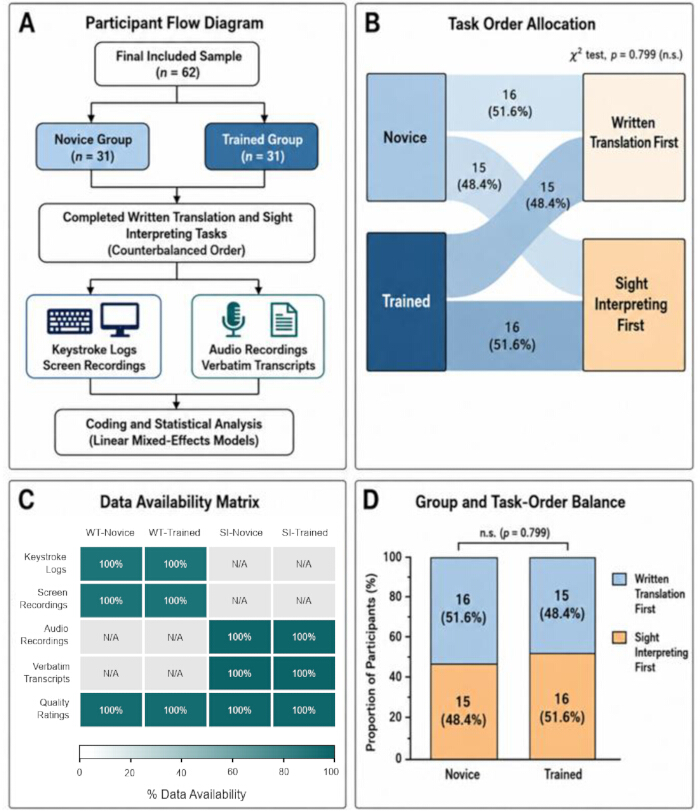
Figuur 1: Deelnemersstroom, toewijzing van taakvolgorde en beschikbaarheid van taakspecifieke gegevens. (A) Definitieve geanalyseerde steekproef van 62 deelnemers en 124 taakgegevens. (B) Gebalanceerde toewijzing van de taakvolgorde binnen de groepen beginners en getrainden. (C) Beschikbaarheidsmatrix waarin toetsenbordaanslaglogs en schermopnamen uitsluitend van toepassing zijn op geschreven vertaling, audio-opnamen en letterlijke transcripties uitsluitend op gezichtsvertaling, en kwaliteitsbeoordelingen op beide taken. (D) Balans tussen groep en volgorde (chi-kwadraattoets, p = 0,799). n = 62 deelnemers (31 per groep). Klik hier om een grotere versie van deze figuur te bekijken.
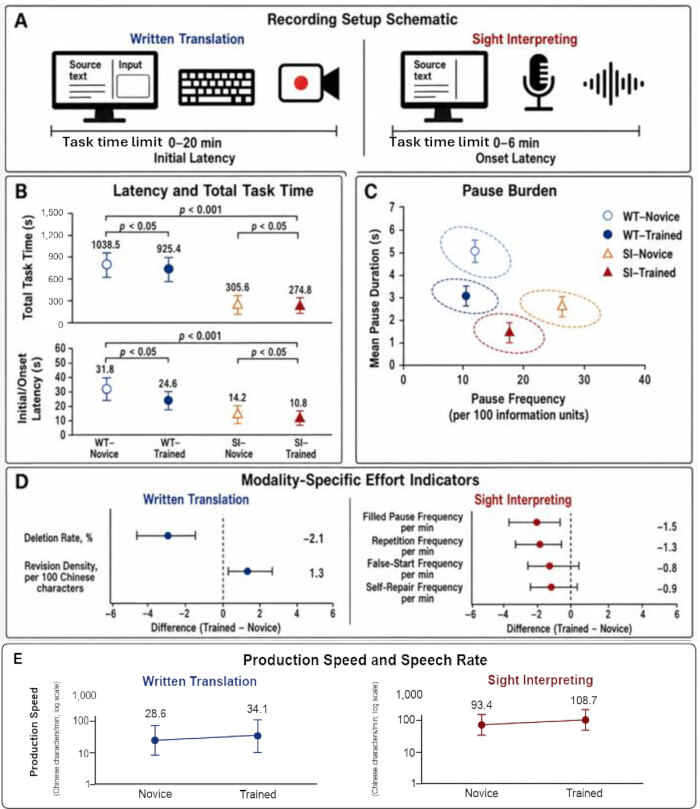
Figuur 2: Gedragsprofielen bij taken van geschreven vertaling en visueel vertalen. (A) Taakspecifieke opstelling voor opname. (B) Initiële/onset latentie en totale taaktijd. (C) Gezamenlijke distributie van paufefrequentie en gemiddelde pauzeduur. (D) Taakspecifieke indicatoren voor deletie, revisie en orale disfluentie. (E) Geschreven productie-snelheid en orale spraaksnelheid. In panelen B, C en E geven de punten en foutenbalken de groepsgemiddelden ± SD weer; in paneel D geven de punten de gemiddelde verschillen tussen getrainde en beginnende vertalers weer en tonen de foutenbalken de 95% betrouwbaarheidsintervallen. n = 31 deelnemers per groep. In paneel E wordt de y-as op een logaritmische schaal weergegeven. Klik hier om een grotere versie van deze figuur te bekijken.
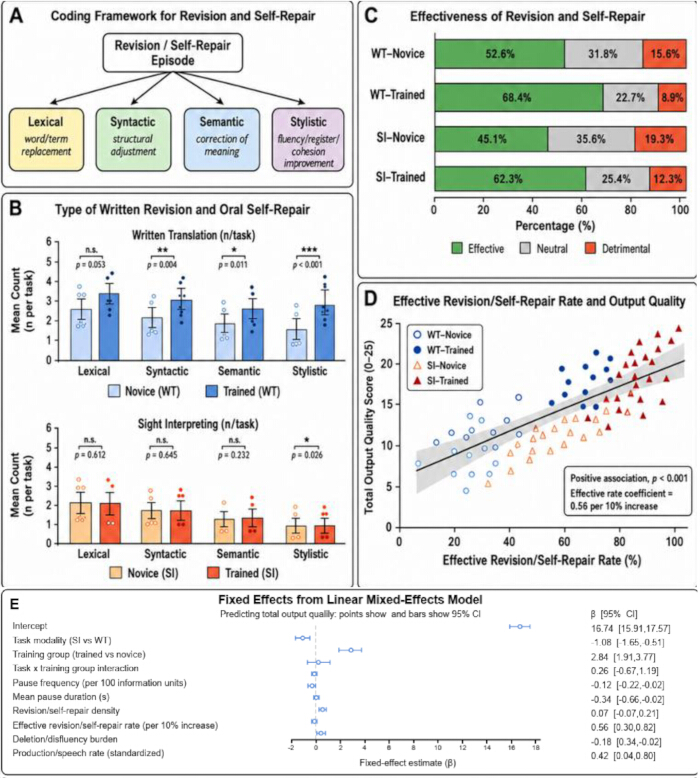
Figuur 3: Associaties tussen revisie/zelfcorrectie-codering, functionele uitkomst en outputkwaliteit. (A) Beslisraamwerk voor het onafhankelijk toewijzen van episodetype en functionele uitkomst. (B) Gemiddelde aantallen lexicale, syntactische, semantische en stilistische episoden in elke taakconditie. (C) Gemiddelde proporties effectieve, neutrale en nadelige episoden. (D) Beschrijvende associatie tussen de frequentie van effectieve episoden en de totale score voor outputkwaliteit. (E) Forest plot die de vaste effecten weergeeft uit een lineair mixed-effects model met 95% betrouwbaarheidsintervallen (gedetailleerd in Tabel 4); de plot is associatief en vertegenwoordigt geen causaal padmodel. Klik hier om een grotere versie van deze figuur te bekijken.
| Variabelen | Novicegroep (n = 31) | Getrainde groep (n = 31) | p waarde |
| Leeftijd, jaren | 21.9 ± 1.7 | 22.4 ± 1.9 | 0.279 |
| Vrouw, n (%) | 22 (71.0) | 21 (67.7) | 0.779 |
| Duur van het leren van de Engelse taal, jaren | 12.4 ± 2.1 | 12.9 ± 2.2 | 0.36 |
| Score voor Engelse taalvaardigheid | 548.6 ± 41.3 | 562.4 ± 45.8 | 0.216 |
| Duur van de vertaaltraining, maanden | 5.6 ± 3.0 | 18.7 ± 5.4 | <0.001 |
| Interpretatie van de trainingsduur, maanden | 2.3 ± 2.1 | 13.9 ± 5.7 | <0.001 |
| Eerdere schriftelijke vertaalervaring ≥5 taken, n (%) | 9 (29.0) | 24 (77.4) | <0.001 |
| Voorafgaande ervaring met interpretatiepraktijk ≥5 taken, n (%) | 5 (16.1) | 20 (64.5) | <0.001 |
| Geschreven vertaling eerst, n (%) | 16 (51.6) | 15 (48.4) | 0.799 |
| Eerste interpretatie van het zicht, n (%) | 15 (48.4) | 16 (51.6) | 0.799 |
Tabel 1: Kenmerken van deelnemers en baseline taal-trainingsprofielen per groep. Variabelen worden weergegeven als gemiddelde ± standaarddeviatie voor continue gegevens en als aantallen (percentages) voor categorische gegevens. De gerapporteerde p-waarden weerspiegelen vergelijkingen tussen groepen om de demografische balans bij baseline te verifiëren en de beoogde verschillen in trainingsduur te bevestigen.
| Variabelen | Geschreven vertaling beginners (n = 31) | Geschreven vertaling Getraind (n = 31) | Zichtinterpretatie beginner (n = 31) | Gezichtsinspirerende getrainde groep (n = 31) | Taakeffect p | Groepseffect p |
| Initiële latentietijd/aanstaltijd, s | 31.8 ± 12.4 | 24.6 ± 9.7 | 14.2 ± 5.6 | 10.8 ± 4.2 | <0.001 | 0.003 |
| Totale taaktijd, s | 1038.5 ± 168.2 | 925.4 ± 151.6 | 305.6 ± 59.3 | 274.8 ± 50.7 | <0.001 | 0.004 |
| Pauzefrequentie, per 100 informatie-eenheden | 18.6 ± 6.1 | 14.2 ± 5.0 | 24.8 ± 7.4 | 19.6 ± 6.3 | <0.001 | 0.001 |
| Gemiddelde pauzeduur, s | 4.1 ± 1.2 | 3.3 ± 1.0 | 2.7 ± 0.8 | 2.3 ± 0.7 | 0.012 | 0.002 |
| Productie-/spreeksnelheid, Chinese karakters/min | 28.6 ± 6.7 | 34.1 ± 7.5 | 93.4 ± 18.9 | 108.7 ± 20.4 | 0.001 | |
| Deletieratio, % | 8.9 ± 3.4 | 6.8 ± 2.7 | 0.009 | |||
| Revisiedichtheid, per 100 Chinese karakters | 7.6 ± 2.8 | 8.9 ± 3.1 | 0.087 | |||
| Frequentie van gevulde pauzes, per min. | 5.7 ± 1.9 | 4.2 ± 1.6 | 0.002 | |||
| Repetitiefrequentie, per min | 4.9 ± 1.8 | 3.6 ± 1.4 | 0.004 | |||
| Frequentie van vals starten, per min | 2.8 ± 1.1 | 2.0 ± 0.9 | 0.006 | |||
| Zelfherstelfrequentie, per min | 4.8 ± 1.7 | 3.9 ± 1.4 | 0.031 | |||
| Totale kwaliteitsscore, 0–25 | 16.8 ± 2.3 | 20.1 ± 2.1 | 15.4 ± 2.6 | 18.9 ± 2.4 | 0.002 | <0.001 |
| Nauwkeurigheid, 0–5 | 3.4 ± 0.7 | 4.1 ± 0.6 | 3.1 ± 0.8 | 3.8 ± 0.7 | 0.004 | <0.001 |
| Volledigheid, 0–5 | 3.3 ± 0.8 | 4.0 ± 0.6 | 3.0 ± 0.8 | 3.7 ± 0.7 | 0.006 | <0.001 |
| Lexicale adequaatheid, 0–5 | 3.2 ± 0.7 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.6 | 0.041 | <0.001 |
| Coherentie, 0–5 | 3.5 ± 0.6 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.6 | 0.003 | <0.001 |
| Natuurlijkheid in de doeltaal, 0–5 | 3.4 ± 0.7 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.7 | 0.007 | <0.001 |
Tabel 2: Indicatoren voor het gedragsproces en de outputkwaliteit over de taakcondities en groepen.Waarden zijn uitgedrukt als gemiddelde ± standaarddeviatie. De gerapporteerde p-waarden geven de hoofdeffecten aan van de taakmodaliteit (schriftelijke vertaling versus sight translation) en de trainingsachtergrond (novice versus getraind) op elke proces- en kwaliteitsvariabele.
| Variabelen | Schriftelijke vertaling Onervaren | Schriftelijke vertaling Getraind | p-waarde | Direct vertalen Onervaren | Direct vertalen Getraind | p-waarde |
| Lexicale revisie/zelfcorrectie, n/taak | 3.4 ± 1.5 | 4.2 ± 1.7 | 0.053 | 1.8 ± 0.8 | 1.7 ± 0.7 | 0.612 |
| Syntactische revisie/zelfcorrectie, n/taak | 2.1 ± 1.1 | 3.0 ± 1.2 | 0.004 | 1.1 ± 0.7 | 1.2 ± 0.8 | 0.645 |
| Semantische revisie/zelfcorrectie, n/taak | 1.8 ± 1.0 | 2.5 ± 1.1 | 0.011 | 0.9 ± 0.6 | 1.1 ± 0.7 | 0.232 |
| Stilistische revisie/zelfcorrectie, n/taak | 1.6 ± 0.9 | 2.7 ± 1.2 | <0.001 | 0.6 ± 0.4 | 0.9 ± 0.6 | 0.026 |
| Totaal aantal revisie/zelfcorrectie-episoden, n/taak | 8.9 ± 3.0 | 12.4 ± 3.7 | <0.001 | 4.4 ± 1.5 | 4.9 ± 1.6 | 0.209 |
| Effectieve episoden, % | 52.6 ± 13.5 | 68.4 ± 12.1 | <0.001 | 45.1 ± 14.2 | 62.3 ± 13.0 | <0.001 |
| Neutrale episoden, % | 31.8 ± 10.4 | 22.7 ± 8.8 | 0.001 | 35.6 ± 11.7 | 25.4 ± 9.6 | 0.001 |
| Nadelige episoden, % | 15.6 ± 7.1 | 8.9 ± 5.6 | <0.001 | 19.3 ± 8.6 | 12.3 ± 6.8 | 0.001 |
Tabel 3: Type en effectiviteit van schriftelijke revisies en orale zelfcorrecties over verschillende taakcondities. Episodetypen worden gerapporteerd als gemiddelde aantallen per taak (± standaarddeviatie), en functionele uitkomsten worden gerapporteerd als gemiddelde percentages (± standaarddeviatie). De p-waarden geven de significantie van de verschillen tussen groepen binnen elke taakmodaliteit aan.
| Vaste effecten | β | SE | 95% BI | p-waarde |
| Intercept | 16.74 | 0.42 | 15.91 tot 17.57 | <0.001 |
| Taakmodaliteit: sight interpreting vs geschreven vertaling | -1.08 | 0.29 | -1.65 tot -0.51 | <0.001 |
| Trainingsgroep: getraind vs novice | 2.84 | 0.47 | 1.91 tot 3.77 | <0.001 |
| Taakmodaliteit × trainingsgroep | 0.26 | 0.47 | -0.67 tot 1.19 | 0.581 |
| Pauzefrequentie, per 100 informatie-eenheden | -0.12 | 0.05 | -0.22 tot -0.02 | 0.018 |
| Gemiddelde pauzeduur, s | -0.34 | 0.16 | -0.66 tot -0.02 | 0.041 |
| Revisie-/zelfcorrectiedichtheid | 0.07 | 0.07 | -0.07 tot 0.21 | 0.334 |
| Effectieve revisie-/zelfcorrectiesnelheid, per 10% toename | 0.56 | 0.13 | 0.30 tot 0.82 | <0.001 |
| Verwijdering-/disfluentiebelasting | -0.18 | 0.08 | -0.34 tot -0.02 | 0.027 |
| Productie-/spreeksnelheid, gestandaardiseerd | 0.42 | 0.19 | 0.04 tot 0.80 | 0.032 |
Tabel 4: Gerapporteerde vaste effecten uit het lineaire mixed-effects model dat de totale outputkwaliteit voorspelt. De samenvatting bevat de niet-gestandaardiseerde coëfficiënten (β), standaardfouten (SE), 95% betrouwbaarheidsintervallen (CI) en exacte p-waarden voor alle gespecificeerde taak- en gedragsvoorspellers.
Discussie
Deze studie demonstreert een multimodaal protocol voor het meten van observeerbare procesindicatoren en het coderen van strategische revisie bij schriftelijke vertaling en sight interpreting van het Engels naar het Chinees. Het protocol meet geen unitaire variabele van cognitieve inspanning rechtstreeks. In plaats daarvan worden latentie, pauzes, deleties en revisiepatronen geïnterpreteerd als taakgevoelige gedragsmatige correlaten waarvan de betekenis afhangt van triangulatie met gesynchroniseerde opnames en bewijzen van de outputkwaliteit1,2,3,4,5,6,7,8. De twee taken verschillen bovendien in materialen, timing, outputmodus en revisiemogelijkheden; de representatieve contrasten beschrijven daarom verschillen in taakcondities in plaats van geïsoleerde modaliteitseffecten. De belangrijkste analytische bijdrage is de scheiding van revisiefrequentie en functioneel resultaat. In de gerapporteerde samenvattingen maakten getrainde participanten meer schriftelijke revisies, niet minder, terwijl het totaal aantal orale zelfcorrecties niet significant verschilde tussen de groepen. Hun hogere proporties effectieve episodes suggereren dat het monitoren van de kwaliteit informatiever kan zijn dan de ruwe frequentie, maar deze interpretatie is afhankelijk van transparante beslisregels, onafhankelijke codering van de resultaten en gerapporteerde betrouwbaarheid. Het codeboek en de uitgewerkte voorbeelden in Aanvullend Bestand 1 zijn bedoeld om dit onderscheid reproduceerbaar te maken in plaats van promotioneel.
Kritieke stappen zijn de uitlijning tussen verschillende opnames, de audiokwaliteit, de verificatie van het transcript en de consistentie van de codering. Beschikbare tijdstempels en aanwijzingen voor taakgrenzen moeten worden gecontroleerd bij het uitlijnen van logs en opnames. Audio moet voor transcriptie worden geïnspecteerd op clipping en verstaanbaarheid, en voorgestelde pauzegrenzen moeten worden geverifieerd aan de hand van de golfvorm en het transcript. Voor Chinese invoer mogen toetsaanslagen tijdens het samenstellen niet worden gelijkgesteld aan revisies van definitief geplaatste tekens. Deze controles en correctieve acties moeten worden bijgehouden in een kwaliteitscontrollog.
Verschillende beperkingen binden de interpretatie. De demonstratie maakt gebruik van cohorten van studenten en trainees, korte algemene expositieve teksten, verschillende taaklengtes en tijdslimieten, en een steekproef op basis van beschikbaarheid. De taakcondities verschillen bovendien in outputmodus en revisiemogelijkheden, en de dataset bevat geen onafhankelijk gesampelde brontekst-identificatoren om variatie op tekstniveau te schatten. Daarnaast zijn pauzedrempelwaarden operationele keuzes, en langere pauzes kunnen zowel productieve planning als onopgeloste moeilijkheden weerspiegelen. Generalisatie naar professionals, gespecialiseerde domeinen, andere taalparen of andere schriftsystemen vereist revalidatie van materialen, de afhandeling van invoermethoden, drempelwaarden en scoreankers.
Toekomstig onderzoek kan de gedragsgegevens combineren met eye-tracking, pupillometrie of subjectieve maatstaven voor werkbelasting om te testen welke pauzes en revisies corresponderen met aandacht, ervaren inspanning of succesvolle planning5,6,13,14,15,16. Shreve et al. maakten gebruik van eye-tracking bij sight translation en mogen niet worden geciteerd als een pupillometriestudie18; pupillometrie wordt direct besproken door Seeber5. Dergelijke multimodale uitbreidingen moeten het onderscheid behouden tussen taakeis, geïnvesteerde inspanning, geobserveerd gedrag en prestaties. Het huidige protocol is daarom het best te gebruiken als een transparant kader voor procesbeoordeling waarvan de indicatoren claims over latente cognitieve inspanning ondersteunen, maar niet op zichzelf vaststellen.
Openbaarmakingen
De auteurs melden geen commerciële of financiële belangenconflicten. Met betrekking tot het gebruik van kunstmatige intelligentie verklaren de auteurs dat OpenAI Codex tijdens het revisieproces strikt is gebruikt ter ondersteuning bij taalredactie, consistentiecontroles, het voorbereiden van bijgehouden revisies en het regenereren van figuurindelingen op basis van door de auteurs verstrekte gegevens. De auteurs hebben alle door AI ondersteunde resultaten zorgvuldig beoordeeld en dragen de volledige verantwoordelijkheid voor de nauwkeurigheid, integriteit en originaliteit van het definitieve manuscript. Het gestructureerde werkboek dat ten grondslag ligt aan de gerapporteerde samenvattingen is openbaar beschikbaar op Zenodo (https://doi.org/10.5281/zenodo.21189434). Aanvullend bestand 1 bevat de codeerhandleiding en de vaste kwaliteitsrubriek.
Dankbetuigingen
De auteur bedankt het Guilin Institute of Information Technology voor de laboratoriumondersteuning, de tweetalige experts die de bronteksten hebben geëvalueerd, de onafhankelijke beoordelaars en de deelnemers. Dit onderzoek heeft geen specifieke subsidie ontvangen van enige financieringsinstantie in de publieke, commerciële of non-profit sector.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Software voor akoestische analyse (Praat) | Paul Boersma and David Weenink | https://www.fon.hum.uva.nl/praat/ | |
| Desktopcomputer | Dell | OptiPlex | |
| Software voor digitale audio-opname (Audacity) | Audacity Team | https://www.audacityteam.org/ | |
| Software voor toetsaanslagregistratie (Inputlog) | University of Antwerp | https://www.inputlog.net/ | |
| Software voor schermopname (OBS Studio) | OBS Project | https://democreator.wondershare.com/ | |
| Software voor statistische analyse (SPSS) | IBM | Version 27 |
Referenties
- Gieshoff AC, Heeb AH. Cognitive load and cognitive effort: probing the psychological reality of a conceptual difference. Transl Cogn Behav. 2023;6(1):3–28.
- Sweller J, van Merriënboer JJG, Paas F. Cognitive architecture and instructional design. Educ Psychol Rev. 1998;10(3):251–96.
- Paas F, Tuovinen JE, Tabbers H, Van Gerven PWM. Cognitive load measurement as a means to advance cognitive load theory. Educ Psychol. 2003;38(1):63–71.
- Gile D. Basic Concepts and Models for Interpreter and Translator Training. Amsterdam: John Benjamins; 2009.
- Seeber KG. Cognitive load in simultaneous interpreting: measures and methods. Target. 2013;25(1):18–32.
- Ferreira A, Schwieter JW, Gottardo A, Jones JA. Cognitive effort in direct and inverse translation performance: insight from eye-tracking technology. Cad Trad. 2016;36(3):60–80.
- Zou D, Zhang J. Measuring the invisible: clarifying the concept of cognitive effort in translation and interpreting processes. Curr Trends Transl Teach Learn E. 2023;10:217–58.
- Lacruz I, Shreve GM, Angelone E. Average pause ratio as an indicator of cognitive effort in post-editing: a case study. Workshop on Post-Editing Technology and Practice. San Diego: Association for Machine Translation in the Americas; 2012. p. 21–30.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589–604.
- Ma X, Li D. Effect of word order asymmetry on the cognitive load of English–Chinese sight translation: Evidence from eye movement data. Transl Interpret Stud. 2024;19(1):105–31.
- Leijten M, Van Waes L. Keystroke logging in writing research: using Inputlog to analyze and visualize writing processes. Written Commun. 2013;30(3):358–92.
- Heilmann A, Neumann S, editors. Dynamic pause assessment of keystroke logged data for the detection of complexity in translation and monolingual text production. Proceedings of the Workshop on Computational Linguistics for Linguistic Complexity; 2016; Osaka: COLING.
- Su W, Li D. Identifying translation problems in English-Chinese sight translation: an eye-tracking experiment. Transl Interpret Stud. 2019;14(1):110–34.
- Su W, Li D. Exploring processing patterns of Chinese-English sight translation: an eye-tracking study. Babel. 2020;66(6):999–1024.
- Su W, Li D. Exploring the effect of interpreting training: eye-tracking English-Chinese sight interpreting. Lingua. 2021;256:103094.
- Su W. Eye-voice span in sight interpreting: an eye-tracking investigation. Perspectives. 2023;31(5):969–85.
- Rojo López AM, Muñoz Martín R. Research Methods in Cognitive Translation and Interpreting Studies. Amsterdam: John Benjamins; 2025.
- Shreve GM, Lacruz I, Angelone E. Cognitive effort, syntactic disruption, and visual interference in a sight translation task. Transl Interpret Stud. 2010;5(1):63–84.
Herprints en machtigingen
Dit artikel is gepubliceerd
Video binnenkort beschikbaar