Dit artikel presenteert een reproduceerbare bio-informatica-workflow die publieke transcriptomische datasets, machine learning, externe validatie, kwantitatieve reverse transcriptie PCR, Connectivity Map-screening en moleculaire docking integreert om biomarkers voor pulmonale hypertensie en potentiële therapeutische verbindingen te identificeren.
Onderzoeksartikel
Bio-informatische en machine-learning-identificatie van biomarkers voor pulmonale hypertensie en kandidaat-therapeutische verbindingen
In dit artikel
Samenvatting
Samenvatting
Deze studie had als doel longhypertensie (PH)-geassocieerde moleculaire biomarkers en kandidaat kleine moleculaire verbindingen te identificeren met behulp van openbare transcriptomische gegevens en onafhankelijke validatiebronnen. Drie Gene Expression Omnibus-datasets (GSE22356, GSE33463 en GSE48149) werden geïntegreerd na normalisatie, probe-annotatie en ComBat batch-effectcorrectie. Voor de identificatie van kernkenmerkgenen werden differentieel expressieonderzoek, gewogen gen-coexpressienetwerkanalyse, functionele verrijkingsanalyse, eiwit-eiwitinteractienetwerkanalyse en drie machine-learning-algoritmen gebruikt. De diagnostische prestaties werden geëvalueerd met behulp van receiver operating characteristic-curves. Externe validatie omvatte een onafhankelijke longweefselcohort (GSE117261), een single-cell RNA-sequencing dataset van de longslagader (GSE210248) en kwantitatieve reverse transcription PCR-validatie in onafhankelijke longweefselmonsters. Op Connectivity Map gebaseerde drug repositioning en moleculaire docking werden gebruikt om kandidaatverbindingen te screenen. Achtentachtig differentieel tot expressie gebrachte genen werden geïdentificeerd, waarbij CXCL10, JUN, IFIH1, MX1 en TLR7 werden geselecteerd als kernkenmerkgenen. In de onafhankelijke GSE117261 longweefselcohort vertoonde JUN de sterkste externe ondersteuning, terwijl de replicatie van de andere genen variabel was. Kwantitatieve reverse transcription PCR in 20 biologisch onafhankelijke monsters van pulmonale arteriële hypertensie en 20 controlemonsters bevestigde de upregulatie van alle vijf de genen. Zowel het schijnbare vijf-gen qRT-PCR-model als 100 herhaalde gestratificeerde five-fold cross-validatieanalyses leverden een area under the curve van 1,000 op, hoewel de kleine cohort een voorzichtige interpretatie en onafhankelijke prospectieve validatie vereist. Single-cell-analyse van GSE210248 ondersteunde een veranderde communicatie tussen immuun- en structurele cellen en fenotypische switching van gladde spiercellen. BRD-K91900765/VX-745 scoorde het hoogst in de Connectivity Map-screening. MAPK14/p38α, het vastgestelde farmacologische doelwit, werd opgenomen als een positief referentiedocking-eiwit, terwijl docking tegen de vijf biomarker-geassocieerde eiwitten als verkennend werd beschouwd. Deze bevindingen ondersteunen de vijf genen als kandidaat PH-biomarkers en VX-745 als een computationele drug-repositioning hypothese die experimentele validatie vereist.
Inleiding
Pulmonale hypertensie (PH) is een progressief cardiopulmonaal syndroom dat wordt gekenmerkt door een aanhoudend verhoogde pulmonale arteriële druk, een toegenomen pulmonale vasculaire weerstand en uiteindelijk falen van de rechterventrikel. Huidige hemodynamische criteria definiëren PH als een gemiddelde pulmonale arteriële druk in rust van >20 mmHg, gemeten via rechterhartkatheterisatie1. Onder de verschillende klinische subtypen is pulmonale arteriële hypertensie (PAH) een van de ernstigste vormen en wordt deze gekenmerkt door progressieve pulmonale vasculaire remodellering. De pathologische kenmerken omvatten endotheliale dysfunctie, abnormale proliferatie en migratie van gladde spiercellen in de pulmonale arteriën, activatie van adventitiële fibroblasten, depositie van de extracellulaire matrix, infiltratie van inflammatoire cellen en vernauwing of obliteratie van de distale pulmonale arteriën2. Deze veranderingen geven aan dat PH/PAH niet alleen een stoornis van vasoconstrictie is, maar ook een complexe vasculaire remodelleringsziekte die wordt gedreven door gecoördineerde moleculaire, cellulaire en immuun-inflammatoire mechanismen.
Huidige PAH-therapieën richten zich voornamelijk op de pathways van prostacycline, endotheline, stikstofoxide–oplosbaar guanylaatcyclase en fosfodiësterase type 53˒4. Hoewel deze behandelingen de symptomen, de inspanningscapaciteit en hemodynamische parameters verbeteren, blijven hun effecten grotendeels vasodilatatoir en hemodynamisch. Hun vermogen om gevestigde pulmonale vasculaire remodellering omkeerbaar te maken is beperkt, en veel patiënten blijven ziekteprogressie ervaren ondanks combinatietherapie. Daarom is het identificeren van nieuwe moleculaire biomarkers en therapeutische kandidaten die het remodelleringsproces weerspiegelen een belangrijke onvervulde behoefte. In het bijzonder zijn immuun-inflammatoire activatie, interferon-gerelateerde signalering, Toll-like receptor-pathways, chemokine-gemedieerde immuunrekrutering en fenotypische switching van gladde spiercellen naar voren gekomen als potentiële bijdragers aan de progressie van PH/PAH5˒6.
Transcriptomische datasets met een hoge doorvoer bieden waardevolle bronnen voor het identificeren van ziekte-geassocieerde moleculaire signaturen bij PH/PAH. Echter, studies gebaseerd op een enkele dataset worden vaak beperkt door kleine steekproefgroottes, batcheffecten, platformheterogeniteit en onvoldoende validatie. Differentieel expressie-analyse kan genen met een veranderde expressie identificeren, maar legt mogelijk niet volledig de ziekte-gerelateerde co-expressiemodules of interacties op netwerkniveau vast. Weighted gene co-expression network analysis (WGCNA) kan genmodules identificeren die geassocieerd zijn met ziektekenmerken, terwijl proteïne-proteïne interactie (PPI) netwerkanalyse sterk verbonden genen binnen biologische netwerken kan onthullen. Machine-learning methoden kunnen daarnaast genen met diagnostische of classificatiewaarde prioriteren. Echter, vertrouwen op een enkel algoritme kan model-specifieke bias introduceren. Het integreren van differentieel expressie-analyse, WGCNA, PPI netwerkanalyse en meerdere machine-learning algoritmen kan daarom de robuustheid van biomarker-ontdekking verbeteren.
Een andere grote uitdaging bij transcriptomische biomarkerstudies is de biologische interpretatie. Bulk-weefselsignalen kunnen wijzigingen in genexpressie binnen residente vasculaire cellen, infiltratie van immuuncellen of veranderde proporties van meerdere celpopulaties weerspiegelen. Single-cell RNA-sequencing biedt de mogelijkheid om uit bulk-data afgeleide kandidaatgenen in een cellulaire context te plaatsen. Bij PH/PAH omvat pulmonale vasculaire remodellering endotheelcellen, gladde spiercellen, fibroblasten, monocyten/macrofagen, lymfocyten en andere immuun- of structurele cellen. Ziekteprogressie is bovendien geassocieerd met veranderde cel-celcommunicatie en fenotypische switching van gladde spiercellen. Daarom kan het combineren van bulk-transcriptomische screening met single-cell validatie helpen bepalen of kandidaatbiomarkers geassocieerd zijn met immuunactivatie, vasculaire structurele remodellering of een onbalans in multicellulaire communicatie.
Naast de ontdekking van biomarkers kunnen transcriptomische signatures worden gebruikt voor computationele drug repositioning. De Connectivity Map (CMap) koppelt ziekte-geassocieerde genexpressieprofielen aan kleine moleculen die deze signatures kunnen omkeren of moduleren7. In combinatie met compound-curatie en moleculaire docking kan deze strategie experimenteel testbare therapeutische hypothesen genereren. Hoewel CMap-voorspellingen en moleculaire docking de werkzaamheid van een geneesmiddel niet kunnen vaststellen, kunnen ze kandidaat-verbindingen prioriteren voor toekomstige target-bindingassays, celgebaseerde experimenten en validatie in diermodellen.
Er is een geïntegreerde en reproduceerbare workflow ontwikkeld om biomarkers voor PH/PAH en kandidaat-therapeutische verbindingen te identificeren. Drie openbare transcriptomische datasets van de Gene Expression Omnibus werden geïntegreerd na normalisatie en correctie voor batch-effecten. Voor het screenen van robuuste kenmerkgenen werden differentiële expressieanalyse, WGCNA, functionele verrijkingsanalyse, PPI-netwerkanalyse en drie machine-learning-algoritmen gebruikt. ROC-analyse (receiver operating characteristic), een onafhankelijke validatiecohort van longweefsel, bewijs uit single-cell RNA-sequencing van de longslagader en kwantitatieve reverse transcription PCR-validatie in onafhankelijke monsters werden gebruikt om de geselecteerde genen verder te evalueren. Tot slot werden CMap-gebaseerde geneesmiddel-repositionering en moleculaire docking toegepast om kandidaat-verbindingen te identificeren. De nieuwheid van deze studie ligt in het gelaagde validatiekader, dat bulk-transcriptomische ontdekking, prioritering via machine-learning, onafhankelijke validatie, experimentele bevestiging via kwantitatieve reverse transcription PCR, mechanistische interpretatie op single-cell-niveau en computationele screening van verbindingen met elkaar verbindt. De hypothese van de studie was dat PH/PAH wordt aangestuurd door een gecoördineerd immuun-inflammatoir en vasculair remodelleringsprogramma, en dat robuuste genen binnen dit programma kunnen dienen als kandidaat-biomarkers en mogelijkheden bieden voor geneesmiddel-repositionering.
Protocol
De publieke Gene Expression Omnibus (GEO) datasets die in deze studie zijn geanalyseerd, bevatten gede-identificeerde transcriptomische gegevens uit eerder gepubliceerde studies en vereisten geen aanvullende ethische goedkeuring. De ethische commissie van de Huaihua University heeft de onafhankelijke validatiestudie met kwantitatieve reverse transcriptie-PCR (qRT-PCR) op menselijk longweefsel goedgekeurd (goedkeuringsnr. 2024(A05112)). Vóór de monstername is schriftelijke geïnformeerde toestemming verkregen van alle deelnemers of hun wettelijk gemachtigde vertegenwoordigers. De goedkeurings- en toestemmingsprocedures waren van toepassing op alle 20 longweefselmonsters van patiënten met pulmonale arteriële hypertensie (PAH) en de 20 controlemonsters die zijn opgenomen in de qRT-PCR-validatie. De onderzoeksinstrumenten die voor dit protocol zijn gebruikt, staan vermeld in de Tabel met Materialen.
1. Verzameling en preprocessing van publieke transcriptomische datasets
Microarray-datasets GSE22356, GSE33463 en GSE48149 met betrekking tot pulmonale hypertensie (PH) zijn verkregen uit de GEO-database. PH/pulmonale arteriële hypertensie (PAH)- en controlemonsters werden geëxtraheerd op basis van de oorspronkelijke fenotype-annotaties. Expressiematrices en platformannotatiebestanden werden gedownload met behulp van reproduceerbare R-scripts en het GEOquery-pakket.
Probe-annotatie en mapping van gensymbolen werden consistent over de datasets uitgevoerd. Wanneer meerdere probes aan hetzelfde gen gekoppeld waren, werd de gemiddelde expressiewaarde berekend. Kwantielnormalisatie werd toegepast en genen met een lage expressie of lage variantie werden verwijderd. De datasets werden samengevoegd en batch-effecten werden gecorrigeerd met behulp van het ComBat-algoritme in het sva-pakket8. De correctie werd geëvalueerd met behulp van boxplots en principale componentenanalyse.
2. Identificatie van differentieel tot expressie gekomen genen
Het limma-pakket werd gebruikt om expressieniveaus tussen PH- en controlevoorbeelden in de batch-gecorrigeerde expressiematrix te vergelijken9. Er werd een lineair model gefit en empirische Bayes-statistieken werden toegepast. Differentieel tot expressie gebrachte genen werden gedefinieerd op basis van een gecorrigeerde P-waarde <0,05 en een absolute log2-fold change > 0,585. De resultaten werden gevisualiseerd met behulp van volcano plots en heatmaps.
3. Constructie van het gewogen gen-co-expressienetwerk
Een gewogen gen-co-expressienetwerk werd geconstrueerd met behulp van het WGCNA-pakket10. Er werd sampleclustering uitgevoerd om uitschieters te detecteren. De soft-thresholding power werd geselecteerd op basis van de scale-free topology fit index. Genmodules werden geïdentificeerd met behulp van het dynamische tree-cutting algoritme. Module eigengenes werden gecorreleerd met het PH-fenotype, en de ziekte-geassocieerde module met de sterkste correlatie werd geselecteerd. Genen in de sleutelmodule werden geïntersecteerd met de differentieel tot expressie gebrachte genen om consensusgenen te verkrijgen.
4. Functionele verrijkingsanalyse
Categorieën voor biologische processen, cellulaire componenten en moleculaire functies van de Gene Ontology werden geanalyseerd met behulp van clusterProfiler11. Voor de identificatie van signaleringsroutes werd een pathway-enrichmentanalyse uitgevoerd met de Kyoto Encyclopedia of Genes and Genomes12. Een P-waarde < 0,05 en een q-waarde < 0,2 werden gehanteerd als drempelwaarden voor verrijking, en de verrijkte termen werden gevisualiseerd met behulp van bubble plots11.
5. Constructie van het eiwit-eiwitinteractienetwerk en identificatie van hub-genen
De consensus-genenlijst werd ingediend bij de STRING-database, waarbij Homo sapiens als soort werd geselecteerd en een drempelwaarde voor interactiebetrouwbaarheid van > 0,4 werd gehanteerd13. Het interactiebestand werd geïmporteerd in Cytoscape, waarna de CytoHubba-plug-in werd gebruikt om genen te rangschikken op basis van de graad van de knoop. Sterk verbonden genen werden gedefinieerd als hub-genen.
6. Selectie van diagnostische kenmerkgenen met behulp van machine learning
Er werden drie onafhankelijke algoritmen voor kenmerkselectie toegepast. Ten eerste werd logistische regressie met de least absolute shrinkage and selection operator uitgevoerd met behulp van het glmnet-pakket en 10-voudige kruisvalidatie om genen met coëfficiënten ongelijk aan nul te identificeren14. Ten tweede werd recursieve kenmerkeliminatie met support vector machines toegepast om redundante kenmerken te verwijderen en de subset van kenmerken te selecteren die de hoogste nauwkeurigheid bij de kruisvalidatie behaalde15. Ten derde werd een random forest-model geconstrueerd, waarbij de kenmerken werden gerangschikt op basis van de gemiddelde afname in de Gini-onzuiverheid16. De intersectie van de genensets afgeleid van de drie algoritmen werd gebruikt om de uiteindelijke set kernkenmerk-genen te definiëren. Het pROC-pakket werd gebruikt voor het genereren van receiver operating characteristic-curven en het berekenen van de waarden voor de oppervlakte onder de curve17.
7. Validatie van kerngenen met behulp van onafhankelijke bulk- en single-cell-datasets
GSE117261 werd gebruikt als een onafhankelijke externe validatiecohort van longweefsel, bestaande uit 58 PAH-monsters en 25 controlemonsters van afgewezen donoren18. Deze dataset is niet gebruikt bij de discovery-analyse van differentiële expressie, de constructie van het gewogen gen-co-expressienetwerk of de feature-selectie via machine learning. De expressiematrix werd genormaliseerd en geannoteerd, en de differentiële expressie werd geanalyseerd met limma v3.68.0. De Benjamini-Hochberg-correctie voor de false-discovery-rate werd toegepast op het gehele geannoteerde transcriptoom. Receiver operating characteristic (ROC)-curves voor individuele genen werden berekend met pROC v1.19.0.1, DeLong 95% betrouwbaarheidsintervallen en Youden-index-afkapwaarden. Een verkennend logistisch regressiemodel met vijf genen werd gefit binnen GSE117261, en de interne prestaties hiervan werden aanvullend geëvalueerd met behulp van herhaalde nested cross-validatie.
GSE210248 (Tabel 1) werd gebruikt als validatiedataset voor single-cell longslagaderen, bestaande uit monsters van drie patiënten met PAH en drie gezonde donoren19. De gegevens werden verwerkt met Seurat v5.5.1 voor kwaliteitscontrole, normalisatie, dimensionaliteitsreductie, clustering en celannotatie20. De belangrijkste celpopulaties, waaronder endotheelcellen, gladde spiercellen, fibroblasten, monocyten/macrofagen en T/natural killer-cellen, werden geïdentificeerd. Cel-celcommunicatie werd geanalyseerd met CellChat v2.1.2 en de CellChatDB.human ligand-receptor-database21. Er werd een CellChat-object gemaakt van de genormaliseerde Seurat-expressiematrix en de metadata van de celtypen. Overexpressie-genen en ligand-receptor-interacties werden geïdentificeerd; communicatiewaarschijnlijkheden werden berekend; interacties met celgroepen van minder dan 10 cellen werden verwijderd; en communicatienetwerken op routeniveau werden afgeleid en geaggregeerd. Deze dataset werd uitsluitend gebruikt voor externe mechanistische validatie en niet voor modeltraining.
| Item | Beschrijving |
| Dataset | GSE210248 |
| Gegevenstype | 10x Genomics/druppelgebaseerde single-cell RNA-sequencing; high-throughput transcriptomische profilering |
| Menselijke monsters | Drie longslagadermonsters van patiënten met PAH en drie longslagadermonsters van gezonde donoren |
| Weefselbron | Ex vivo longslagaderweefsel, dat primair de cellulaire ecologie van de longvasculaire wand en het vasculaire remodelleringsproces weerspiegelt |
| Belangrijkste analytisch doel | Celtypelokalisatie, fenotypische switch van gladdespiercellen, communicatie tussen immuun- en structurele cellen en mechanistische consistentievalidatie van kandidaatgenen |
Tabel 1: Basisinformatie voor de GSE210248 single-cell validatiedataset. De tabel vat de dataset-accessienummer, het sequencersplatform, de weefselbron, de monstersamenstelling en het analytische doel van de single-cell validatieanalyse van de longslagader samen.
8. Validatie van genexpressie via qRT-PCR
De qRT-PCR-validatie omvatte 20 biologisch onafhankelijke PAH-longweefselmonsters van patiënten met PH/PAH en 20 biologisch onafhankelijke controlemonsters van longweefsel. Totaal RNA werd geëxtraheerd met gebruik van de Total RNA Extraction Kit. De RNA-concentratie en -zuiverheid werden bepaald met een spectrofotometer, en de RNA-integriteit werd geëvalueerd via agarosegelelektroforese. Alleen RNA-monsters met A260/280-waarden tussen 1,8 en 2,1 en zonder zichtbare degradatie werden opgenomen.
Gelijke hoeveelheden RNA werden omgezet in complementair DNA via reverse-transcriptie met behulp van de Solarbio Universal RT-PCR Kit (AMV; catalogusnr. RP1200). Kwantitatieve PCR voor CXCL10, JUN, IFIH1, MX1 en TLR7 werd uitgevoerd met SYBR Green PCR Master Mix op een Real-Time PCR-systeem. Elk biologisch monster werd geanalyseerd in drie technische replica's, samen met controles zonder template en zonder reverse-transcriptie. De gemiddelde Ct-waarde van de drie technische replica's werd gebruikt voor de daaropvolgende analyse; technische replica's werden niet als onafhankelijke waarnemingen beschouwd. Er werden primers gebruikt die exon-exonovergangen overspannen en amplicons van 80–200 bp produceren (Tabel 2). De primerspecificiteit werd geverifieerd met behulp van NCBI Primer-BLAST en smeltcurve-analyse22.
β-actine (ACTB) werd gebruikt als intern referentiegen om de expressieniveaus van de doelgenen te normaliseren. De relatieve expressie werd berekend met de 2-ΔΔCt methode23. Voor vergelijkingen tussen groepen werden tweezijdige Mann-Whitney U-toetsen gebruikt op basis van de datadistributie, en er werd een Benjamini-Hochberg-correctie voor de false-discovery-rate toegepast over de vijf genen. ROC-curves voor individuele genen werden gegenereerd met DeLong 95% betrouwbaarheidsintervallen, en optimale afkapwaarden werden geselecteerd met behulp van de Youden-index. Het logistische regressiemodel met vijf genen werd aanvankelijk gefit en geëvalueerd op dezelfde 40 biologische monsters; deze schatting werd daarom gedefinieerd als de schijnbare in-sample prestatie. Om mogelijke overfitting te beoordelen, werden 100 gestratificeerde five-fold cross-validatie herhalingen uitgevoerd met een L2-geregulariseerd logistisch regressiemodel, waarna de gepoolde out-of-fold ROC-prestatie werd berekend.
| Gen | RefSeq-toegangsnummer | Forward primer (5'′–3′) | Reverse primer (5'′–3′) | Productgrootte (bp) | Tm (°C) | Exon-overspanning |
| CXCL10 | NM_001565.4 | GTCAAGCCAT AATTGTTC | ATAGTGCCAG GGTAGAGT | 141 | 46.1 | Ja |
| JUN | NM_002228.4 | ACAAGTGGCA GAGTCCCG | CGCCCAAGTT CAACAACC | 152 | 54.5 | Ja |
| IFIH1 | NM_022168 | GCACAGAGCG GTAGACCCT | GCCCTGAAGC ACGAGATG | 182 | 54.7 | Ja |
| MX1 | NM_002462.5 | TTAGCCGTGG TGATTTAGC | CAAGGTGGAG CGATTCTG | 156 | 52.3 | Ja |
| TLR7 | NM_016562.4 | ATTGCCCTCGT TGTTATA | TTCCTGGAGTT TGTTGAT | 179 | 48.1 | Ja |
| ACTB | NM_001101.3 | CTCACCATGGAT GATGATATCGC | AGGAATCCTTCT GACCCATGC | 194 | 56.2 | Ja |
Tabel 2: Primersequenties gebruikt voor kwantitatieve reverse transcriptie-PCR. De tabel vermeldt de doelgenen, RefSeq-accessienummers, forward- en reverse primersequenties, productgroottes, smelttemperaturen en de exon-overspanningstatus van de primers gebruikt voor qRT-PCR.
9. Screening van kandidaatverbindingen en moleculaire docking
De upgereguleerde en downgereguleerde core-gene signatures werden ingediend bij de Connectivity Map-database om kleine moleculen te identificeren die voorspeld werden het PH-geassocieerde expressieprofiel om te keren7. Kandidaten werden gerangschikt op basis van de Logit-score en de voorspellingswaarschijnlijkheid.
De driedimensionale structuur van BRD-K91900765/VX-745 is verkregen uit PubChem onder CID 303852524. Farmacologische informatie over de verbinding is gecureerd uit openbare medicatiedatabanken, en structurele descriptoren zijn berekend met behulp van DrugBank en SwissADME25,26. Proteïnestructuren zijn verkregen uit de RCSB Protein Data Bank met behulp van de volgende PDB-identificatoren: CXCL10, 1LV9; JUN, 1JUN; IFIH1, 3B6E; MX1, 5GTM; TLR7, 7CYN; en MAPK14/p38α, 1OUK27. Blinde holte-detectie en moleculaire docking zijn uitgevoerd met CB-Dock2 v2.0 met de AutoDock Vina v1.2.0 scoring engine28,29. Proteïne- en ligandbestanden zijn geüpload naar CB-Dock2, kandidaat-holtes zijn automatisch gedetecteerd en docking is uitgevoerd binnen de holte-specifieke boxen die door de server zijn gegenereerd. Voor elk proteïne zijn de holte-identificator, Vina-score, holtevolume, het centrum van de docking-box, de afmetingen van de docking-box en het proteïne-ligandcomplexbestand geregistreerd. De pose met de meest negatieve Vina-score is geselecteerd als de best gerangschikte voorspelde conformatie. MAPK14/p38α is opgenomen als het gevestigde farmacologische doelwit en positieve referentiedocking-proteïne voor VX-745. Docking tegen CXCL10, JUN, IFIH1, MX1 en TLR7 was verkennend en werd niet geïnterpreteerd als bewijs voor directe farmacologische targeting, binding, inhibitie of effectiviteit.
10. Statistische analyse en reproduceerbaarheidscontrole
Alle statistische analyses werden uitgevoerd in R, tenzij anders aangegeven. Tweezijdige P-waarden < 0,05 werden beschouwd als statistisch significant. Correctie voor meervoudig testen werd toegepast op de analyses van differentiële expressie, verrijking, externe validatie en qRT-PCR, zoals hierboven gespecificeerd. Kruisvalidatie werd gebruikt om de stabiliteit van de machine-learningmodellen en de gecombineerde qRT-PCR-modellen te beoordelen.
Resultaten
Preprocessing van openbare transcriptomische gegevens en identificatie van differentieel tot expressie gebrachte genen
Integratie en ComBat-correctie van GSE22356, GSE33463 en GSE48149 verminderden de systematische verschillen tussen de datasets. Boxplots lieten zien dat de expressieverdelingen van de monsters consistenter werden na correctie. Principale componentenanalyse wees uit dat de monsters vóór correctie voornamelijk clusterden op basis van de bron van de dataset, maar na correctie meer gemengd raakten, wat duidt op een effectieve reductie van het batch-effect (Figuur 1).
Met drempelwaarden van een absolute log2 fold change >0,585 en een gecorrigeerde P-waarde < 0,05 werden 78 differentieel tot expressie gebrachte genen geïdentificeerd, waaronder 44 upgereguleerde en 34 downgereguleerde genen (Figuur 2A). De heatmap liet zien dat interferon-gerelateerde genen, waaronder XAF1, MX1, IFI44L, EPSTI1, PARP9, IFIH1, CXCL10, GBP1, STAT1, SAMHD1, TNFSF10 en TLR7, over het algemeen upgereguleerd waren in PH-gerelateerde monsters. In contrast hiermee waren erytroïde-gerelateerde genen, waaronder HBG1, HBD, ALAS2, CA1 en SLC4A1, over het algemeen downgereguleerd (Figuur 2B).
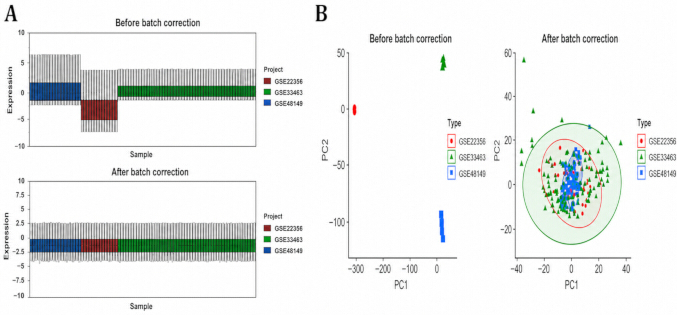
Figuur 1: Batch-effectcorrectie. (A) Boxplots van de samengevoegde expressiematrix voor en na ComBat-correctie. (B) Principal component analysis-plots die de monsterverdelingen tonen voor en na de batch-effectcorrectie. Klik hier om een grotere versie van deze figuur te bekijken.
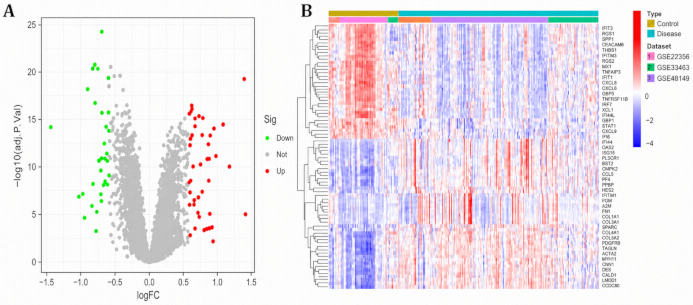
Figuur 2: Differentieel tot expressie gekomen genen. (A) Volcano plot die opgereguleerde en neergereguleerde genen in PH-gerelateerde monsters weergeeft. (B) Heatmap die differentieel tot expressie gekomen genen tussen de controle- en ziektegroepen weergeeft. Klik hier om een grotere versie van deze figuur te bekijken.
Constructie van een gewogen gen-co-expressienetwerk en functionele verrijking
De clustering van de monsters vertoonde een stabiele algemene clustering zonder duidelijke uitschieters (Figuur 3A). De fit-index voor de schaalvrije topologie naderde 0,8 bij een macht van 9, en β = 9 werd gekozen voor de constructie van het netwerk (Figuur 3B). Genclustering en identificatie van dynamische modules leverden meerdere co-expressiemodules op (Figuur 3C). De blauwe module vertoonde de sterkste associatie met de PH-status (r = 0,55, P = 1 × 10⁻¹⁹), terwijl de turquoise en grijze modules ook correlaties met PH vertoonden (Figuur 3D).
Consensusgenen, verkregen door de genen van de modules uit de gewogen gen-coexpressienetwerkanalyse te kruisen met de differentieel tot expressie gebrachte genen, waren verrijkt voor antivirale immuunverdediging, NF-κB- en JAK-STAT-regulatie, responsen op ontstekingsfactoren, binding van cytokinen en chemokinereceptoren en transcriptionele regulatie (Figuur 4A). Verrijkingsanalyse via de Kyoto Encyclopedia of Genes and Genomes identificeerde interacties tussen cytokinen en cytokinereceptoren, chemokinesignalering, NOD-achtige receptorsignalering, Toll-achtige receptorsignalering, tumornecrosefactorsignalering en interleukine-17-signalering (Figuur 4B), wat immuun-inflammatoire dysregulatie ondersteunt als moleculaire basis voor pulmonale vasculaire remodellering.
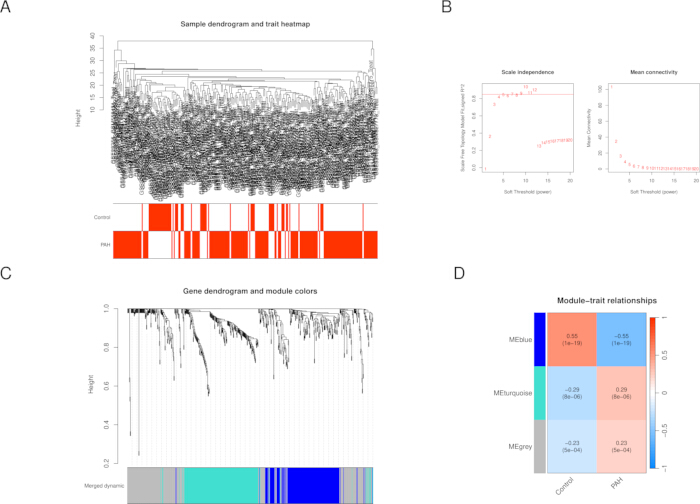
Figuur 3: Gewogen gen-co-expressienetwerkanalyse. (A) Clusterboom van monsters en heatmap van kenmerken. (B) Plot voor de selectie van de soft-threshold. (C) Dendrogram van genen en modulekleuren. (D) Heatmap van de relatie tussen modules en kenmerken. Klik hier om een grotere versie van deze figuur te bekijken.
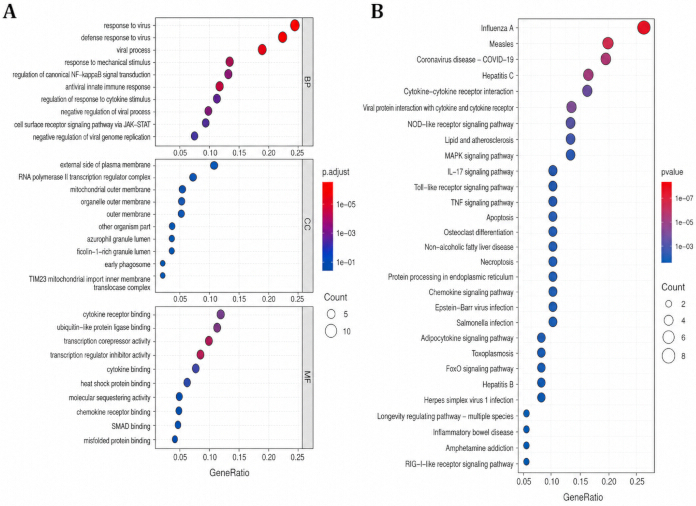
Figuur 4: Functionele verrijkingsanalyse. (A) Gene Ontology-verrijkingsresultaten voor de consensusgenen. (B) Kyoto Encyclopedia of Genes and Genomes-padverrijkingsresultaten voor de consensusgenen. Klik hier om een grotere versie van deze figuur te bekijken.
Netwerk van eiwit-eiwitinteracties en screening op hub-genen
Het STRING-netwerk van eiwit-eiwitinteracties, opgebouwd uit de consensusgenen, onthulde een onderling verbonden immuun-inflammatoir netwerk (Afbeelding 5A). Ranking op basis van graad via CytoHubba liet zien dat FN1, CD44, JUN, TGFB1, CXCL8 en BCL2 een hoge connectiviteit hadden (Afbeelding 5B). Deze hub-genen kunnen betrokken zijn bij inflammatoire signalering, celadhesie, remodellering van de extracellulaire matrix en structurele remodellering van de pulmonale vaten.
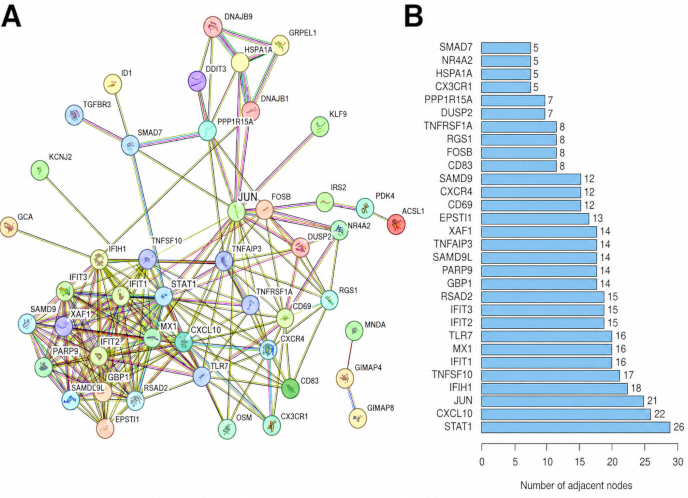
Figuur 5: Eiwit-eiwitinteractienetwerk en hub-genen. (A) STRING-eiwit-eiwitinteractienetwerk van de consensusgenen. (B) Op basis van graad gerangschikte hub-genen geïdentificeerd met behulp van CytoHubba. Klik hier om een grotere versie van deze figuur te bekijken.
Kenmerkselectie via machine learning en diagnostische prestaties
Regressie via de least absolute shrinkage and selection operator identificeerde zes kandidaatgenen met niet-nul coëfficiënten na kruisvalidatie (Figuur 6A, B). Support vector machine-recursive feature elimination behield acht genen en leverde een kruisvalidatie-accuraatheid van 0.883 en een fout van 0.117 op (Figuur 7A). De random forest out-of-bag fout stabiliseerde wanneer het aantal bomen ≥100 was, waarbij IFIH1, JUN en TLR7 tot de belangrijkste genen behoorden op basis van de importance score (Figuur 7B).
De doorsnee van de least absolute shrinkage and selection operator, support vector machine-recursive feature elimination en random forest-resultaten identificeerde vijf kerngenen: CXCL10, JUN, IFIH1, MX1 en TLR7 (Figuur 8A). Receiver operating characteristic-analyse van enkelvoudige genen toonde een matige tot goede diagnostische discriminatie, met area under the curve-waarden van 0,842 voor IFIH1, 0,833 voor JUN, 0,827 voor TLR7, 0,814 voor CXCL10 en 0,759 voor MX1 (Figuur 8B).
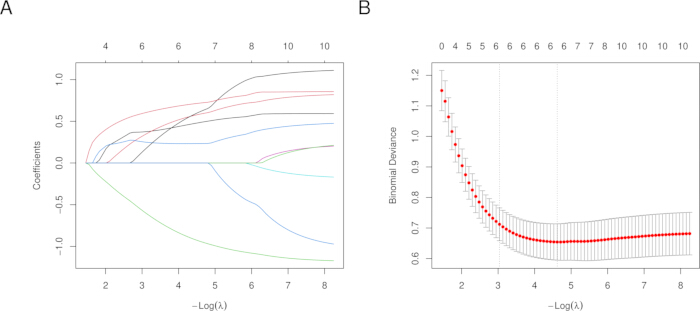
Figuur 6: Least absolute shrinkage and selection operator-regressieanalyse. (A) Coëfficiëntpad gegenereerd door de least absolute shrinkage and selection operator-regressie. (B) Plot van de cross-validatiefout. Klik hier om een grotere versie van deze figuur te bekijken.
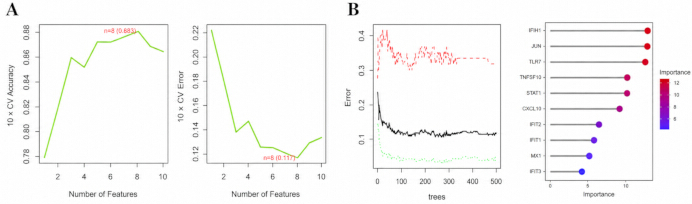
Figuur 7: Support vector machine-recursieve kenmerkeliminatie en random forest-analyses. (A) Plot van kenmerkselectie via support vector machine-recursieve kenmerkeliminatie. (B) Random forest-model en rangschikking van genbelangrijkheid. Klik hier om een grotere versie van deze figuur te bekijken.
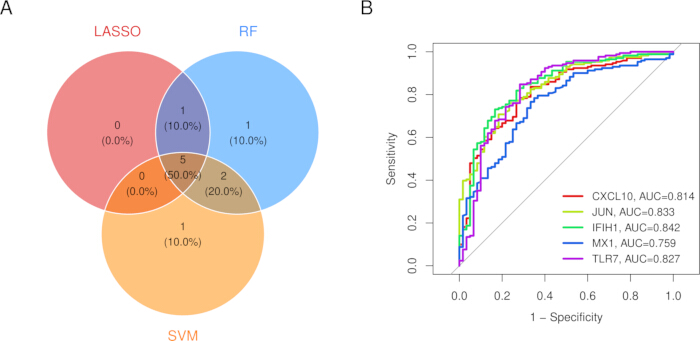
Figuur 8: Samenvatting van machine learning. (A) Venn-diagram dat de overlap van de drie algoritmen voor kenmerkselectie laat zien. (B) Receiver operating characteristic-curves voor de vijf kerngenen. Klik hier om een grotere versie van deze figuur te bekijken.
Externe validatie in GSE117261
GSE117261 werd gebruikt als een onafhankelijke validatiecohort van longweefsel en was niet opgenomen in de screening op differentiële expressie, de constructie van het gewogen gen-co-expressienetwerk of de kenmerkselectie via machine learning (Tabel 3). De voltooide validatieresultaten lieten een heterogene replicatie zien over de vijf genen (Tabel 4). CXCL10 was verhoogd (log₂ fold change = 0.677; P = 0.0410; FDR = 0.144) en leverde een AUC op van 0.639 (95% CI, 0.491–0.786), met een cutoff van 6.245, een sensitiviteit van 0.724 en een specificiteit van 0.600. JUN was verhoogd (log₂ fold change = 0.463; P = 0.00248; FDR = 0.0194) en leverde een AUC op van 0.714 (95% CI, 0.593–0.835), met een cutoff van 8.708, een sensitiviteit van 0.707 en een specificiteit van 0.720.
IFIH1 (log2 fold change = 0.107; P = 0.371; FDR = 0.591; AUC = 0.543, 95% CI, 0.398–0.687), MX1 (log2 fold change = 0.109; P = 0.488; FDR = 0.690; AUC = 0.475, 95% CI, 0.337–0.614) en TLR7 (log2 fold change = -0.050; P = 0.543; FDR = 0.733; AUC = 0.546, 95% CI, 0.414–0.679) voldeden niet aan de vooraf vastgestelde criteria voor externe ondersteuning. TLR7 vertoonde bovendien een richting die tegenovergesteld was aan het qRT-PCR resultaat. Het verkennende vijf-genenmodel dat binnen GSE117261 werd gefit en geëvalueerd, leverde een schijnbare AUC op van 0,740, terwijl herhaalde geneste kruisvalidatie een AUC van 0,656 opleverde. Hierdoor ontving JUN de sterkste onafhankelijke ondersteuning, vertoonde CXCL10 beperkt richtingconsistent bewijs, en was de replicatie van IFIH1, MX1 en TLR7 zwak of discordant.
| Item | Beschrijving |
| Toegangscode dataset | GSE117261 |
| Gegevensbron | Gene Expression Omnibus (GEO) |
| Monstertype | Transcriptomische microarray-gegevens van menselijk longweefsel |
| Steekproefomvang | 58 PAH-monsters en 25 controlemonsters van afgewezen donoren |
| Platform | GPL6244 / Affymetrix Human Gene 1.0 ST Array |
| Validatiedoelstelling | Expressieverschillen, ROC-analyse van enkelvoudige genen en exploratieve gecombineerde ROC-modellering van vijf genen voor CXCL10, JUN, IFIH1, MX1 en TLR7 |
| Rol in deze studie | Onafhankelijke externe validatiedataset; niet opgenomen in de oorspronkelijke training, WGCNA of feature-selectieanalyses |
Tabel 3: Basisinformatie voor de GSE117261 onafhankelijke externe validatiedataset. De tabel geeft een samenvatting van de bron van de dataset, het monstertype, de steekproefomvang, het platform, de validatiedoelen en de rol van GSE117261 in de studie.
| Gen/model | PAH n | Controle n | log2 fold change | P-waarde | FDR | AUC | AUC 95% BI | Youden cutoff | Sensitiviteit | Specificiteit |
| CXCL10 | 58 | 25 | 0.677 | 0.041 | 0.144 | 0.639 | 0.491–0.786 | 6.245 | 0.724 | 0.6 |
| JUN | 58 | 25 | 0.463 | 0.00248 | 0.019 | 0.714 | 0.593–0.835 | 8.708 | 0.707 | 0.72 |
| IFIH1 | 58 | 25 | 0.107 | 0.371 | 0.591 | 0.543 | 0.398–0.687 | 5.3 | 0.759 | 0.44 |
| MX1 | 58 | 25 | 0.109 | 0.488 | 0.69 | 0.475 | 0.337–0.614 | 6.833 | 0.724 | 0.4 |
| TLR7 | 58 | 25 | -0.05 | 0.543 | 0.733 | 0.546 | 0.414–0.679 | 4.065 | 0.138 | 1 |
| Vijfgenenmodel (schijnbaar/in-sample) | 58 | 25 | / | / | / | 0.74 | 0.621–0.859 | 0.613 | 0.845 | 0.6 |
| Vijfgenenmodel (herhaalde geneste CV) | 58 | 25 | / | / | / | 0.656 | 0.517–0.795 | 0.655 | 0.845 | 0.52 |
Tabel 4: Actuele expressieverschillen en ROC-validatieresultaten voor GSE117261. De tabel rapporteert de steekproefgroottes van de PAH- en controlegroep, log₂-vouwveranderingen, P-waarden, gecorrigeerde waarden voor de foutieve-ontdekkingssnelheid, AUC's, 95%-betrouwbaarheidsintervallen, Youden-index-afkapwaarden, sensitiviteiten, specificiteiten en interpretaties voor de vijf genen en verkennende gecombineerde modellen.
Validatie van kwantitatieve reverse transcriptie-PCR
Validatie via kwantitatieve reverse transcriptie PCR omvatte 20 biologisch onafhankelijke longweefselmonsters van PAH en 20 biologisch onafhankelijke controlemonsters, waarbij voor elk biologisch monster het gemiddelde van drie technische replica's werd genomen. CXCL10, JUN, IFIH1, MX1 en TLR7 waren significant opgereguleerd bij PAH (Tabel 5; Figuur 9A). De gemiddelde relatieve expressiewaarden waren ongeveer 3,470 voor CXCL10, 2,560 voor JUN, 2,760 voor IFIH1, 2,650 voor MX1 en 2,580 voor TLR7. De overeenkomstige P-waarden/FDR-waarden waren respectievelijk 1,43 × 10⁻7/7,15 × 10⁻7, 4,17 × 10⁻5/4,17 × 10⁻5, 1,10 × 10⁻5/1,38 × 10⁻5, 1,58 × 10⁻6/2,63 × 10⁻6 en 1,37 × 10⁻6/2,63 × 10⁻6.
ROC-analyse van individuele genen op basis van qRT-PCR-expressie toonde AUC's van 0,988 voor CXCL10 (95% BI, 0,961–1,000), 0,880 voor JUN (95% BI, 0,758–1,000), 0,908 voor IFIH1 (95% BI, 0,820–0,995), 0,945 voor MX1 (95% BI, 0,874–1,000) en 0,948 voor TLR7 (95% BI, 0,886–1,000) (Figuur 9B; Tabel 5). Het logistische regressiemodel met vijf genen behaalde een schijnbare AUC van 1,000 (DeLong 95% BI: 1,000–1,000), met een sensitiviteit en specificiteit van 1,000 (Figuur 9C). De consistentie van de expressierichting tussen de validatie via kwantitatieve reverse transcriptie-PCR en GSE117261 werd gevisualiseerd met een heatmap (Figuur 9D). Omdat dezelfde 40 monsters werden gebruikt voor zowel het fitten als de evaluatie, weerspiegelde dit de schijnbare in-sample prestatie. In 100 herhalingen van gestratificeerde vijfvoudige kruisvalidatie met een L2-geregulariseerd logistisch regressiemodel bleef de gepoolde out-of-fold AUC ook 1,000 (95% BI, 1,000–1,000), en elke herhaling leverde een AUC van 1,000 op. Ondanks deze interne stabiliteit was de cohort klein en blijft onafhankelijke prospectieve validatie noodzakelijk. Directionele vergelijking met GSE117261 toonde concordante stijgingen voor CXCL10, JUN, IFIH1 en MX1, maar een discordante richting voor TLR7 (Figuur 9D).
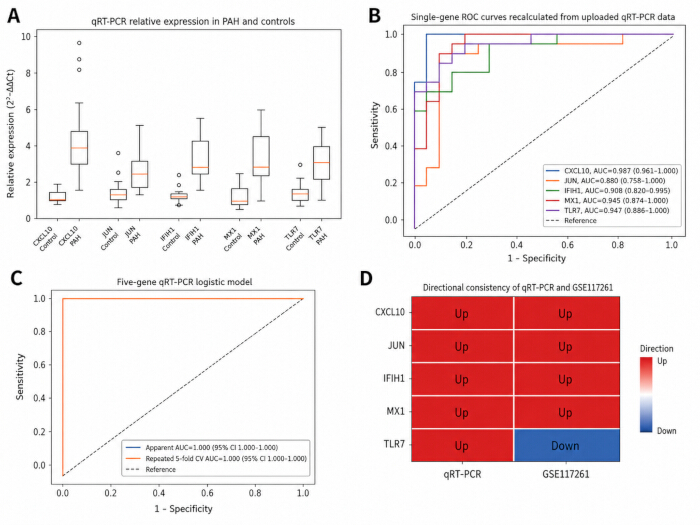
Figuur 9: Validatie via kwantitatieve reverse transcriptie PCR. (A) Boxplots die de relatieve expressie van CXCL10, JUN, IFIH1, MX1 en TLR7 tonen in 20 biologisch onafhankelijke PAH-longweefselmonsters en 20 biologisch onafhankelijke controlemonsters. Elk biologisch monster werd in drie technische replica's gemeten, waarbij de gemiddelde Ct-waarde voor de analyse is gebruikt. Voor elke boxplot vertegenwoordigt de middenlijn de mediaan, de box het interkwartielbereik, de whiskers reiken tot 1,5 keer het interkwartielbereik en individuele punten buiten de whiskers vertegenwoordigen uitschieters. (B) ROC-curven voor individuele genen op basis van qRT-PCR expressiewaarden; AUC's en DeLong 95% betrouwbaarheidsintervallen worden getoond. (C) ROC-curven voor het logistische regressiemodel van vijf genen, waarbij zowel de schijnbare/in-sample prestatie als de gepoolde out-of-fold prestatie van 100 herhaalde gestratificeerde vijfvoudige cross-validatieanalyses worden getoond. (D) Heatmap die de consistentie in expressierichting tussen qRT-PCR en GSE117261 toont; CXCL10, JUN, IFIH1 en MX1 waren concordant verhoogd, terwijl TLR7 discordant was. Klik hier om een grotere versie van deze figuur te bekijken.
| Gen/model | PAH n | Controle n | Controle 2^-ΔΔCt, gemiddelde ± SD | PAH 2^-ΔΔCt, gemiddelde ± SD | Richting | p-waarde | FDR (valse ontdekkingsgraad) | AUC (oppervlak onder de curve) | AUC 95% BI | Youden-indexafkapwaarde | Sensi- activiteit | Specifi- stad | Validatietype | ||||
| CXCL10 | 20 | 20 | 1.099 ± 0.502 | 3.470 ± 1.043 | Opgereguleerd | 1,43E-07 | 7,15E-07 | 0.987 | 0.961–1.000 | 2.028 | 1 | 0.95 | Single-gene qRT-PCR-analyse | ||||
| JUN | 20 | 20 | 1.158 ± 0.738 | 2.560 ± 1.609 | Op gereguleerd | 4,17E-05 | 4,17E-05 | 0.88 | 0.758–1.000 | 1.423 | 0.85 | 0.9 | qRT-PCR-analyse van een enkel gen | ||||
| IFIH1 | 20 | 20 | 1.091 ± 0.440 | 2.760 ± 1.398 | Opgereguleerd | 1,10E-05 | 1,38E-05 | 0.908 | 0.820–0.995 | 1.579 | 0.8 | 0.85 | Single-gen qRT-PCR-analyse | ||||
| MX1 | 20 | 20 | 1.132 ± 0.582 | 2.650 ± 1.085 | Opgereguleerd | 1,58E-06 | 2,63E-06 | 0.945 | 0.874–1.000 | 1.779 | 0.9 | 0.9 | Single-gene qRT-PCR-analyse | ||||
| TLR7 | 20 | 20 | 1.080 ± 0.444 | 2.580 ± 1.284 | Opgereguleerd | 1,37E-06 | 2,63E-06 | 0.947 | 0.886–1.000 | 1.764 | 0.85 | 0.9 | Single-gene qRT-PCR-analyse | ||||
| Vijfgenenmodel (schijnbaar/in-sample) | 20 | 20 | Niet van toepassingen kabel | Niet van toepas- kabel | Niet van toepassing | / | / | 1 | 1.000–1.000 | 0.998 | 1 | 1 | Dezelfde 40 biologische monsters die zijn gebruikt voor modelaanpassing en evaluatie | ||||
| Vijf-genenmodel (100× herhaalde 5-voudige CV) | 20 | 20 | Niet van toepassing kabel | Niet van toepass- kabel | Niet van toepassing | / | / | 1 | 1.000–1.000 | 0.716 | 1 | 1 | Interne kruisvalidatie met behulp van L2-geregulariseerde logistische regressie | ||||
Tabel 5: Volledige qRT-PCR expressie- en ROC-resultaten voor CXCL10, JUN, IFIH1, MX1 en TLR7, inclusief de analyses van het gecombineerde model van vijf genen. De tabel vermeldt de steekproefgroottes van PAH en controles, relatieve expressiewaarden, expressierichtingen, P-waarden, op de false-discovery-rate gecorrigeerde waarden, AUC's, 95% betrouwbaarheidsintervallen, Youden-index afkapwaarden, sensitiviteiten, specificiteiten en validatietypen voor de individuele genen en gecombineerde modellen.
Single-cell transcriptomische validatie in GSE210248
GSE210248 leverde mechanistische ondersteuning op celniveau door aan te tonen dat pulmonale arteriële remodellering bij PAH gepaard ging met een veranderde communicatie tussen immuuncellen en vasculaire structurele cellen. Deze observatie was in overeenstemming met de bulk-transcriptomische verrijking van inflammatoire responsen, chemokine-signalering, Toll-like receptor-signalering en tumornecrosefactor-signalering.
Bewijs op basis van single-cell-analyse suggereerde dat het signaleringsnetwerk van de longslagader bij PAH verschoof naar structurele cellen, waaronder gladde spiercellen en fibroblasten. Gladde spiercellen vertoonden meerdere toestanden, waaronder zuurstof-senserend/pericyt-achtig, contractiel, synthetisch en fibroblast-achtig. Deze resultaten ondersteunen een ziektemodel waarin immuun-inflammatoire activatie en remodellering van vasculaire structurele cellen gezamenlijk de progressie van PH/PAH aansturen.
Screening van kandidaatverbindingen en moleculaire docking
Screening met de Connectivity Map identificeerde BRD-K91900765 als de hoogst gerangschikte kandidaatverbinding onder de top 10 hits, met een Logit-score van 10,13 en een voorspelde waarschijnlijkheid van 0,085 (Figuur 10). Curatie van de verbinding toonde aan dat BRD-K91900765 overeenkomt met VX-745/neflamapimod, een selectieve p38α/MAPK14-remmer met een PubChem-verbindingidentificator van 3038525 en een moleculaire massa van 436,27 g/mol (Tabel 6).
Exploratieve docking van BRD-K91900765/VX-745 met de vijf biomarker-geassocieerde eiwitten leverde top Vina-scores op van -7,5 kcal/mol voor CXCL10, -7,6 kcal/mol voor JUN, -7,5 kcal/mol voor IFIH1, -8,7 kcal/mol voor MX1 en -8,1 kcal/mol voor TLR7 (Tabellen 7–11; Figuur 11A–E). Deze resultaten gaven enkel een voorspelde structurele compatibiliteit aan en stelden de vijf eiwitten niet vast als directe farmacologische targets. Voorlopige voorspellingen voor absorptie, distributie, metabolisme, excretie en toxiciteit suggereerden dat de verbinding verschillende drug-like eigenschappen bezit, hoewel de relatief hoge berekende cLogP verdere evaluatie vereist (Tabel 12). Docking tegen het gevestigde VX-745 target, MAPK14/p38α (PDB ID: 1OUK), werd opgenomen als positieve referentieanalyse. De belangrijkste MAPK14-holte, C1, leverde een Vina-score op van -7,9 kcal/mol, een holtevolume van 3560 Å3, een docking-box centrum van (2, 22, 34) en afmetingen van (22, 31, 31) (Tabel 13; Figuur 11F).
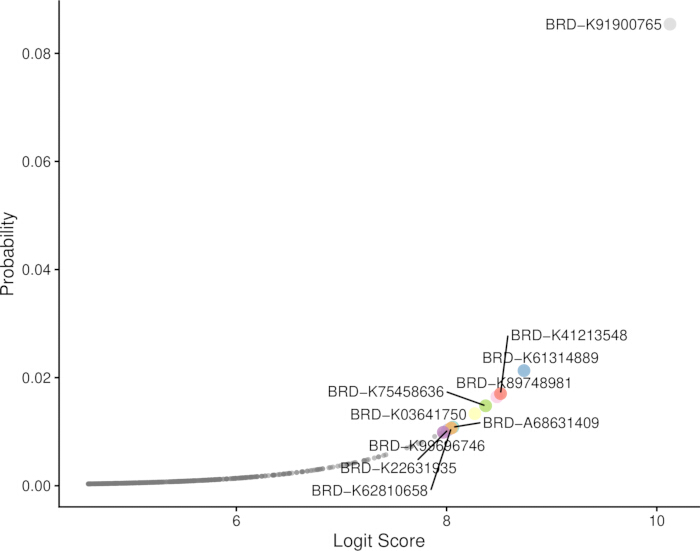
Figuur 10: Rangschikking van kandidaatverbindingen uit de Connectivity Map. Rangschikking van de kandidaatverbindingen die zijn geïdentificeerd via Connectivity Map-screening. BRD-K91900765 was de hoogst gerangschikte verbinding, met een Logit-score van 10,13 en een voorspelde waarschijnlijkheid van 0,085. Klik hier om een grotere versie van deze figuur te bekijken.
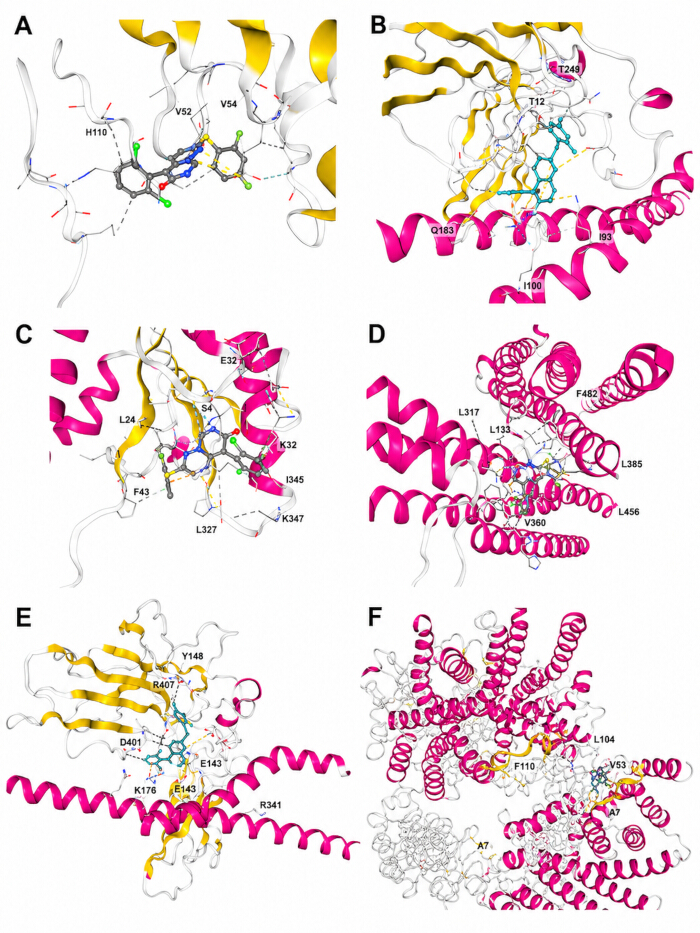
Figuur 11: Driedimensionale moleculaire docking-diagrammen voor BRD-K91900765/VX-745. (A) Exploratieve docking met CXCL10. (B) Exploratieve docking met JUN. (C) Exploratieve docking met IFIH1. (D) Exploratieve docking met MX1. (E) Exploratieve docking met TLR7. (F) Positieve referentiedocking met het gevestigde farmacologische doelwit MAPK14/p38α (PDB ID: 1OUK). Panelen A–E geven de voorspelde structurele compatibiliteit aan en bewijzen geen directe farmacologische targeting. Klik hier om een grotere versie van deze figuur te bekijken.
| Item | Beschrijving |
| CMap/Broad ID | BRD-K91900765 (veelvoorkomend batchformaat: BRD-K91900765-001-xx-x) |
| Gangbare naam/aliassen | VX-745; neflamapimod; VRT-031745; VD-31745 |
| Chemische naam | 5-(2,6-dichlorophenyl)-2-(2,4-difluorophenyl)sulfanylpyrimido[1,6-b]pyridazin-6-one |
| PubChem CID | 3038525 |
| CAS-nummer | 209410-46-8 |
| Molecuulformule / relatieve moleculaire massa | C19H9Cl2F2N3OS; 436.27 g/mol |
| Kanonieke SMILES | C1=CC(=C(C(=C1)Cl)C2=C3C=CC(=NN3C=NC2=O)SC4=C(C=C(C=C4)F)F)Cl |
| InChIKey | VEPKQEUBKLEPRA-UHFFFAOYSA-N |
| Vastgesteld primair farmacologisch doelwit | MAPK14/p38α; p38β-inhibitie is ook gerapporteerd met een lagere selectiviteit dan p38α |
Tabel 6: Chemische en farmacologische informatie voor BRD-K91900765/VX-745. De tabel geeft een overzicht van de verbindingidentificatoren, aliassen, chemische naam, molecuulformule, moleculaire massa, structurele descriptoren en het vastgestelde farmacologische doelwit van BRD-K91900765/VX-745.
| CurPocket ID | Vina-score (kcal/mol) | Cavumvolume (ų) | Centrum (x, y, z) | Dockingformaat (x, y, z) |
| C1 | -7.5 | 7568 | 49, 15, 4 | 34, 33, 35 |
| C4 | -7 | 160 | 46, 0, 4 | 22, 22, 22 |
| C3 | -6 | 208 | 34, 15, 9 | 22, 22, 22 |
| C2 | -5.8 | 465 | 45, -6, 19 | 22, 22, 22 |
| C5 | -5.1 | 150 | 63, 0, 20 | 22, 22, 22 |
Tabel 7: Voorspelde docking-pockets voor BRD-K91900765/VX-745 met CXCL10 (PDB ID: 1LV9). De tabel vermeldt de gerangschikte cavity-identificatoren, Vina-scores, cavity-volumes, centra van de docking-box en dimensies van de docking-box gegenereerd door CB-Dock2.
| CurPocket ID | Vina-score (kcal/mol) | Cavumvolume (ų) | Centrum (x, y, z) | Dockingformaat (x, y, z) |
| C3 | -7.6 | 1593 | 26, 35, 70 | 22, 22, 22 |
| C2 | -7.5 | 1927 | 25, 21, 60 | 35, 22, 22 |
| C1 | -7.4 | 5420 | 32, 37, 48 | 35, 22, 31 |
| C5 | -6 | 464 | 26, 5, 48 | 22, 22, 22 |
| C4 | -5.3 | 683 | 59, 32, 39 | 22, 22, 22 |
Tabel 8: Voorspelde docking-pockets voor BRD-K91900765/VX-745 met JUN (PDB ID: 1JUN). De tabel vermeldt de gerangschikte caviteits-identificatoren, Vina-scores, caviteitsvolumes, centra van de docking-box en dimensies van de docking-box gegenereerd door CB-Dock2.
| CurPocket ID | Vina-score (kcal/mol) | Caviteitsvolume (ų) | Centrum (x, y, z) | Dockinggrootte (x, y, z) |
| C1 | -7.5 | 583 | 15, 4, 17 | 22, 22, 22 |
| C3 | -7.2 | 146 | 19, 21, 24 | 22, 22, 22 |
| C4 | -6.6 | 141 | 31, 19, 15 | 22, 22, 22 |
| C2 | -6.2 | 273 | 38, 9, 24 | 22, 22, 22 |
| C5 | -6.2 | 125 | 27, -7, 10 | 22, 22, 22 |
Tabel 9: Voorspelde docking-pockets voor BRD-K91900765/VX-745 met IFIH1 (PDB ID: 3B6E). De tabel rapporteert de gerangschikte caviteits-identificatoren, Vina-scores, caviteitsvolumes, centra van de docking-box en afmetingen van de docking-box gegenereerd door CB-Dock2.
| CurPocket ID | Vina-score (kcal/mol) | Caviteitsvolume (ų) | Centrum (x, y, z) | Docking-grootte (x, y, z) |
| C1 | -8.7 | 523 | -18, -14, -5 | 22, 22, 22 |
| C4 | -7.3 | 262 | -13, -6, -9 | 22, 22, 22 |
| C3 | -7 | 306 | 12, 12, -7 | 22, 22, 22 |
| C2 | -6.9 | 408 | -3, 1, -12 | 22, 22, 22 |
| C5 | -6.2 | 179 | 24, 25, 13 | 22, 22, 22 |
Tabel 10: Voorspelde docking-pockets voor BRD-K91900765/VX-745 met MX1 (PDB ID: 5GTM). De tabel vermeldt de gerangschikte caviteits-identificatoren, Vina-scores, caviteitsvolumes, centra van de docking-box en dimensies van de docking-box gegenereerd door CB-Dock2.
| CurPocket ID | Vina-score (kcal/mol) | Caviteitsvolume (ų) | Midden (x, y, z) | Dockinggrootte (x, y, z) |
| C2 | -8.1 | 7347 | 112, 137, 148 | 33, 28, 35 |
| C3 | -8.1 | 2604 | 124, 124, 176 | 30, 22, 22 |
| C1 | -8 | 7676 | 137, 112, 148 | 34, 29, 35 |
| C5 | -6.9 | 1976 | 117, 157, 88 | 22, 22, 22 |
| C4 | -6.6 | 2040 | 132, 92, 91 | 22, 22, 22 |
Tabel 11: Voorspelde docking-pockets voor BRD-K91900765/VX-745 met TLR7 (PDB ID: 7CYN). De tabel vermeldt de gerangschikte caviteitsidentificatoren, Vina-scores, caviteitsvolumes, centra van de docking-box en dimensies van de docking-box gegenereerd door CB-Dock2.
| Categorie | Parameter | Resultaat | Interpretatie |
| Fysisch-chemische eigenschap | Molecuulgewicht | 436,27 g/mol | Onder de 500 Da, conform de drempelwaarde voor molecuulgewicht van Lipinski |
| Fysisch-chemische eigenschap | cLogP | Ongeveer 5,49 | Iets hoger dan 5, wat duidt op een hoge lipofiliteit en de noodzaak om rekening te houden met oplosbaarheid en aspecifieke binding |
| Fysisch-chemische eigenschap | TPSA | Ongeveer 47,26 Ų | Laag polair oppervlak, wat consistent is met een potentieel gunstige membraanpermeabiliteit |
| Drug-likeness | HBA/HBD | mei-00 | Voldoet aan de Lipinski-drempelwaarden voor waterstofbrugacceptoren en -donoren |
| Drug-likeness | Roteerbare bindingen | 3 | Lage conformationele flexibiliteit, gunstig voor stabiele bindingsconformaties |
| Structurele alerts | PAINS/Brenk-waarschuwingen | Niet gedetecteerd | Geen algemene pan-assay-interferentie of reactieve structurele waarschuwingen gedetecteerd |
| Toxiciteitsvoorspelling | Ames-mutageniteitsonderzoek | Voorspelde non-Ames toxiciteit | Suggereert een laag voorspeld mutageniteitsrisico; experimentele validatie is nog steeds vereist |
| Toxiciteitspredictie | Carcinogeniteit | Voorspeld niet-carcinogeen | Suggereert een relatief laag voorspeld carcinogeen risico op lange termijn; experimentele validatie is nog vereist |
| Farmacokinetische opmerking | Orale beschikbaarheid/doordringing van de hersenen | Literatuur en databases wijzen op een oraal beschikbaar, hersenpenetrant klein molecuul | In overeenstemming met de ontwikkelingsachtergrond als p38α-remmer is een herwaardering voor PH-indicaties nog steeds noodzakelijk |
Tabel 12: Voorlopige fysisch-chemische voorspellingen, drug-likeness, ADMET en toxiciteit voor BRD-K91900765/VX-745. De tabel vat de voorspelde fysisch-chemische eigenschappen, drug-likeness-maten, structurele alerts, toxiciteitseindpunten en farmacokinetische kenmerken samen. Deze computationele voorspellingen zijn voorlopig en vervangen geen experimentele farmacokinetische of toxicologische validatie.
| CurPocket ID | Vina-score (kcal/mol) | Caviteitsvolume (ų) | Centrum (x, y, z) | Dockinggrootte (x, y, z) |
| C1 | -7.9 | 3560 | 2, 22, 34 | 22, 31, 31 |
| C5 | -7.5 | 254 | -9, 28, 60 | 22, 22, 22 |
| C3 | -7.4 | 351 | 12, 7, 37 | 22, 22, 22 |
| C2 | -6.3 | 827 | 18, 5, 28 | 22, 22, 22 |
| C4 | -6.3 | 334 | -16, 17, 38 | 22, 22, 22 |
Tabel 13: Voorspelde docking-pockets voor BRD-K91900765/VX-745 met het vastgestelde farmacologische doelwit MAPK14/p38α (PDB ID: 1OUK), opgenomen als positieve referentieanalyse. De tabel vermeldt de gerangschikte caviteitsidentificatoren, Vina-scores, caviteitsvolumes, centra van de docking-box en dimensies van de docking-box, gegenereerd met behulp van dezelfde docking-workflow die is toegepast op de vijf biomarker-geassocieerde eiwitten.
Collectief ondersteunen de discovery-analyses en de qRT-PCR-resultaten CXCL10, JUN, IFIH1, MX1 en TLR7 als kandidaat-biomarkers voor PH/PAH die geassocieerd zijn met immuun-inflammatoire dysregulatie en pulmonale vasculaire remodellering, hoewel de onafhankelijke GSE117261-replicatie het sterkst was voor JUN en variabel voor de overige genen. BRD-K91900765/VX-745 is een computationeel geprioriteerde kandidaat voor geneesmiddelenherpositionering met een plausibel mechanisme van MAPK14/p38α-inhibitie; validatie van target-binding, cellulaire effecten, farmacokinetiek, toxiciteit en diermodellen is vereist voordat een therapeutische interpretatie kan worden gegeven.
DATABESCHIKBAARHEID:
Alle publieke transcriptomische datasets die in deze studie zijn gebruikt, zijn beschikbaar via de Gene Expression Omnibus-database onder de toegangsnummers GSE22356, GSE33463, GSE48149, GSE117261 en GSE210248. Alle codebestanden, verwerkte datasets, gedeïdentificeerde qRT-PCR ruwe en geanalyseerde data, modeloutputs en input-/outputbestanden voor moleculaire docking zijn samengevoegd in een gestructureerde Zenodo-repository. De repository bevat een README waarin elk bestand, de software- en pakketversies, de volgorde van scriptuitvoering en de volledige stappen voor reproductie worden beschreven - https://zenodo.org/records/21682282
Discussie
Er is een geïntegreerde en reproduceerbare workflow ontwikkeld om moleculaire biomarkers en kandidaat-therapeutische verbindingen geassocieerd met PH/PAH te identificeren door een combinatie van publieke transcriptomics, gewogen gen-co-expressienetwerkanalyse, functionele verrijking, eiwit-eiwitinteractienetwerkanalyse, drie machine-learningalgoritmen, externe validatie, interpretatie van single-cell transcriptomics, bevestiging via kwantitatieve reverse transcriptie-PCR, Connectivity Map-screening en moleculaire docking. CXCL10, JUN, IFIH1, MX1 en TLR7 werden consequent prioriterend gesteld als kernkenmerkgenen en collectief toegewezen aan een immuun-inflammatoire en interferon-gerelateerde moleculaire as. Deze bevindingen ondersteunen het concept dat PH/PAH niet alleen een hemodynamische stoornis is, maar ook een complexe vasculaire remodelleringsziekte waarbij immuunactivatie, inflammatoire signalering, aangeboren nucleïnezuursensing en structurele en cellulaire fenotypische veranderingen een rol spelen2,5,6.
Het diagnostische potentieel van de vijf genen werd ondersteund door kenmerkselectie met meerdere algoritmen en ROC-analyse in de discovery-cohort. Onafhankelijke validatie in GSE117261 was heterogeen in plaats van uniform: JUN voldeed aan de vooraf vastgestelde FDR- en AUC-criteria, CXCL10 vertoonde een directioneel consistente nominale toename zonder transcriptome-brede FDR-significantie, IFIH1 en MX1 vertoonden beperkte replicatie, en TLR7 vertoonde een inconsistente richting. Deze resultaten ondersteunen de bewering niet dat alle vijf de genen onafhankelijk zijn gevalideerd en wijzen op mogelijke effecten van cohortsamenstelling, weefselheterogeniteit, platformverschillen en ziektesevereity. In contrast hiermee bevestigde qRT-PCR in 20 PAH- en 20 controle-longweefselmonsters een significante upregulatie van alle vijf de genen en gunstige ROC-prestaties voor de individuele genen.
Het logistische model van de qRT-PCR met vijf genen behaalde een schijnbare AUC van 1,000 (95% BI, 1,000–1,000), en de gepoolde out-of-fold AUC bleef 1,000 in 100 herhaalde gestratificeerde five-fold cross-validation analyses. Desondanks werd het model ontwikkeld met slechts 40 biologische monsters, en volledige scheiding in een kleine retrospectieve cohort kan leiden tot optimistische en instabiele schattingen van de prestaties. Het panel moet daarom worden beschouwd als een explorerende moleculaire signatuur in plaats van een klinisch gevalideerd diagnostisch instrument. Grotere multicentrische cohorts, vooraf vastgestelde modelcoëfficiënten, validatie op eiwitniveau, immunohistochemie en prospectieve testen zijn vereist voordat klinische vertaling kan plaatsvinden.
Van de vijf kerngenen kan CXCL10 de rekrutering van immuuncellen en de lokale inflammatoire amplificatie binnen de micro-omgeving van de pulmonale vaten bevorderen. IFIH1 en TLR7 zijn betrokken bij de aangeboren detectie van nucleïnezuren en kunnen wijzen op de activering van antivirale-achtige inflammatoire pathways. MX1 is een klassiek interferon-gestimuleerd gen en kan een downstream-marker zijn voor de activering van de type I interferon-pathway. JUN is een stress-responsieve transcriptiefactor die inflammatoire stimulatie koppelt aan celproliferatie, apoptose en weefselremodellering. Samen suggereren deze genen een biologisch coherent model waarin aangeboren immuunactivatie en interferon-gerelateerde signalering interageren met vasculaire remodelleringsprocessen bij PH/PAH. Deze interpretatie is consistent met eerdere bewijzen dat inflammatie, immuniteit en interferon-gerelateerde pathways bijdragen aan de pathobiologie van PAH2,5,6.
Validatie op single-cell-niveau bood een mechanistische context voor de bevindingen uit de bulk-analyse. GSE210248 suggereerde dat pulmonale arteriële remodellering bij PAH gepaard ging met een veranderde communicatie tussen immuuncellen en vasculaire structurele cellen, waaronder gladde spiercellen, fibroblasten, endotheelcellen en monocyten/macrofagen. De aanwezigheid van meerdere fenotypische toestanden van gladde spiercellen, waaronder contractiel, synthetisch, zuurstof-senserend/pericyte-achtig en fibroblast-achtig, ondersteunt een ziektemodel waarin immuunactivatie en structurele remodellering van cellen gelijktijdig optreden. Dit cellulaire bewijs is belangrijk omdat bulk-transcriptomische signalen kunnen voortkomen uit veranderde celproporties, infiltratie van immuuncellen of transcriptionele veranderingen in residente vasculaire cellen. De single-cell-analyse plaatst CXCL10, JUN, IFIH1, MX1 en TLR7 daarom binnen een multicellulair ecosysteem van pulmonale vasculaire remodellering in plaats van binnen een proces van één enkel celtype18,19,20,21.
De analyse voor drug-repositioning identificeerde BRD-K91900765, overeenkomend met VX-745/neflamapimod, als de hoogst gerangschikte computationele kandidaat. VX-745 is een selectieve p38α/MAPK14-remmer, en de relatie ervan met inflammatoire stresspaden maakt het mechanistisch plausibel in de context van PH/PAH-geassocieerde inflammatie30. Docking tegen MAPK14/p38α werd daarom opgenomen als een mechanistisch relevante positieve referentieanalyse. Daarentegen was docking tegen CXCL10, JUN, IFIH1, MX1 en TLR7 exploratief en wees dit enkel op een voorspelde structurele compatibiliteit; het toonde niet aan dat deze biomarker-geassocieerde eiwitten directe doelen van VX-745 zijn of stelde directe binding, doelremming of therapeutische effectiviteit vast. Een biologisch plausibelere hypothese is dat VX-745 de geïdentificeerde immuun-inflammatoire en interferon-gerelateerde transcriptionele signatuur indirect kan moduleren door MAPK14 te remmen. Connectivity Map-voorspellingen, docking-scores en ADMET-schattingen blijven computationele bewijzen. Verder onderzoek dient biochemische target-binding assays, experimenten in pulmonale arteriële endotheel- en gladde spiercellen, inflammatoire stimulatiemodellen, farmacokinetische en toxicologische evaluaties en validatie in diermodellen te bevatten.
Recente experimentele studies naar hypoxische pulmonale hypertensie hebben ook de belangrijkheid benadrukt van de communicatie tussen neutrofielen en pulmonale vasculaire cellen. HCK-gemedieerde interacties tussen neutrofielen en gladde spiercellen van de longslagader en SERPINB3-gemedieerde interacties tussen neutrofielen en endotheelcellen zijn gerapporteerd als bijdragers aan pulmonale vasculaire remodellering31˒32. De SERPINB3–STAT1/3-as is bijzonder relevant voor de huidige bevindingen, aangezien interferon-gerelateerde, STAT1- en JAK–STAT-signalen werden geïdentificeerd in de transcriptomische analyses. Samen ondersteunen deze waarnemingen de interpretatie dat activatie van immuuncellen en communicatie met vasculaire structurele cellen kunnen bijdragen aan de progressie van PH/PAH.
De studie heeft verschillende sterke punten. Meerdere openbare datasets en batch-effectcorrectie werden gebruikt om dataset-specifieke bias te verminderen. Differentiële expressieanalyse, gewogen gen-co-expressienetwerkanalyse, eiwit-eiwitinteractieanalyse en drie machine-learning-algoritmen werden gecombineerd om de robuustheid van de kenmerken te verbeteren. Onafhankelijke bulk-validatie, qRT-PCR-bevestiging en single-cell-bewijsvoering boden complementaire maar niet-identieke bewijslagen. De heterogene bevindingen van GSE117261 en de kleine qRT-PCR-cohort benadrukken ook belangrijke beperkingen, waaronder onvolledige externe replicatie, potentiële weefsel- en platformspecifieke effecten en het risico op overfitting. De ontdekking van biomarkers werd tevens uitgebreid naar screening van kandidaat-verbindingen, maar de docking-analyses blijven hypothese-genererend. Toekomstige studies dienen de vijf genen te valideren in grotere onafhankelijke cohorten met behulp van ruimtelijke transcriptomica, proteomics, immunohistochemie en organoïde- of vascular-on-chip-modellen. Over het algemeen blijven CXCL10, JUN, IFIH1, MX1 en TLR7 kandidaat-biomarkers voor PH/PAH die gekoppeld zijn aan immuun-inflammatoire en interferon-gerelateerde vasculaire remodellering, terwijl BRD-K91900765/VX-745 een computationele kandidaat voor drug-repositioning is waarvan de therapeutische relevantie experimentele validatie vereist.
Openbaarmakingen
De auteurs verklaren dat er geen concurrerende belangen zijn.
Dankbetuigingen
Deze studie werd ondersteund door het Hunan Innovative Province Construction Project (Nr. 2022JJ30465).
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| 2× SYBR Green PCR Mastermix | Beijing Solarbio Science & Technology Co., Ltd. | Catalogusnr. SR1110 | Kleurstofgebaseerde kwantitatieve real-time PCR-amplificatie en fluorescentiedetectie |
| AI21.msvmRFE.R en e1071 | Aangepast R-script met het CRAN e1071-pakket | AI21.msvmRFE.R; e1071 v1.7-17 | Support vector machine-recursieve kenmerkeliminatie |
| Agarose | Beijing Solarbio Science & Technology Co., Ltd. | Catalogusnr. A8201; CAS 9012-36-6 | Beoordeling van de integriteit van totaal RNA middels agarosegelelektroforese |
| Apparatuur voor agarosegelelektroforese | Beijing Liuyi Biotechnology Co., Ltd. | Model DYCZ-24DN | Elektroforetische beoordeling van RNA-integriteit |
| AutoDock Vina-scoremodule | Center for Computational Structural Biology, Scripps Research | v1.2.0; RRID: SCR_011958 | Scoring van eiwit-ligandposities binnen de CB-Dock2-workflow |
| CB-Dock2 | Cao Laboratory, CB-Dock2 webserver | v2.0; geraadpleegd juli 2026 | Blinde holte-detectie en moleculaire docking van VX-745 met de geselecteerde proteïnestructuren |
| CellChat | CellChat R-pakket | v2.1.2 | Afleiding en visualisatie van cel-celcommunicatie vanuit de single-cell expressiematrix |
| CellChatDB.human | Geleverd met het CellChat R-pakket | CellChatDB.human; subset uitgescheiden signalering; minimale celdrempel = 10 | Menselijke ligand-receptor interactiedatabase voor CellChat |
| clusterProfiler | Bioconductor R-pakket | v4.20.0; Bioconductor release 3.23 | Verrijkingsanalyses van de Gene Ontology en de Kyoto Encyclopedia of Genes and Genomes |
| Connectivity Map (CMap/CLUE) | Broad Institute | L1000/CLUE-bron; RRID: SCR_016204; geraadpleegd in juli 2026 | Computationele analyse voor drug-repositioning |
| Op maat gemaakte oligonucleotide-primers | Beijing Solarbio Science & Technology Co., Ltd. | Op maat gesynthetiseerd; primersequenties vermeld in Tabel 2 | Amplificatie van ACTB, CXCL10, JUN, IFIH1, MX1 en TLR7 |
| cytoHubba | Cytoscape App Store | v0.1 | Rangschikking van hub-genen op basis van graad in het proteïne-proteïne interactienetwerk |
| Cytoscape | Cytoscape Consortium | v3.10.4; RRID: SCR_003032 | Visualisatie en analyse van eiwit-eiwitinteractienetwerken |
| DrugBank | DrugBank Kennisbank | v6.0; RRID: SCR_002700 | Curatie van verbindingidentiteit en farmacologische informatie |
| Gel-documentatiesysteem | Beijing Liuyi Biotechnology Co., Ltd. | Model WO-9413B | Visualisatie en registratie van resultaten van de RNA-integriteit op agarosegel |
| Gene Expression Omnibus (GEO) | National Center for Biotechnology Information | GSE22356, GSE33463, GSE48149, GSE117261 en GSE210248; RRID: SCR_005012 | Ophalen van bulk- en single-cell transcriptomische datasets |
| GEOquery | Bioconductor R-pakket | v2.80.0; Bioconductor release 3.23 | Programmatisch downloaden en importeren van GEO-expressie- en fenotypedata |
| glmnet | CRAN R-pakket | v5.0 | Logistische regressie via de least absolute shrinkage and selection operator en geregulariseerde logistische modellering |
| limma | Bioconductor R-pakket | v3.68.0; Bioconductor release 3.23; RRID: SCR_010943 | Analyse van differentiële expressie en empirische Bayes-statistiek |
| NanoDrop-spectrofotometer | Thermo Fisher Scientific | NanoDrop ND-1000; software v3.8 | Meting van de RNA-concentratie en de A260/280 en A260/230 zuiverheidsratio's |
| NCBI Primer-BLAST | National Center for Biotechnology Information | Webtool; RRID: SCR_003095; geraadpleegd juli 2026 | Verificatie van primerspecificiteit |
| pROC | CRAN R-pakket | v1.19.0.1; RRID: SCR_024286 | Receiver operating characteristic-analyse, DeLong-betrouwbaarheidsintervallen en Youden-index-afkapwaarden |
| Protein Data Bank (PDB) | RCSB Protein Data Bank | CXCL10: 1LV9; JUN: 1JUN; IFIH1: 3B6E; MX1: 5GTM; TLR7: 7CYN; MAPK14/p38α: 1OUK; RRID: SCR_012820 | Ophalen van experimenteel bepaalde eiwitstructuren voor moleculaire docking |
| PubChem | National Center for Biotechnology Information | PubChem CID 3038525; RRID: SCR_004284 | Ophalen van de driedimensionale structuur en chemische identificatoren van BRD-K91900765/VX-745 |
| R | R Foundation for Statistical Computing | v4.6.1; RRID: SCR_001905 | Statistische informatica, gegevensverwerking, machine learning en visualisatie |
| randomForest | CRAN R-pakket | v4.7-1.2 | Featureselectie en rangschikking van variabele-belangrijkheid met Random Forest |
| Real-time PCR-systeem | Stratagene, nu Agilent Technologies | Mx3000P Real-Time PCR-systeem | qRT-PCR-amplificatie, fluorescentieacquisitie, smeltcurve-analyse en Ct-export |
| Seurat | CRAN R-pakket; Satija Laboratory | v5.5.1; RRID: SCR_016341 | Kwaliteitscontrole, normalisatie, dimensionaliteitsreductie, clustering en annotatie van single-cell RNA-sequencing |
| Kopieer de gewenste hoeveelheid van de oplossing in een steriele centrifugebuis met behulp van een micropipet. Draai de buis centrifugeer voor 30 seconden bij 10.000 x g om eventuele onopgeloste resten te bezinken. Pipetteer vervolgens het supernatant voorzichtig over in een nieuwe, steriele buis en discard de pellet. Bewaar de gefilterde oplossing bij 4 °C voor onmiddellijk gebruik of bij -20 °C voor langdurige bewaring. | STRING-consortium | v12.0; RRID: SCR_005223 | Constructie van een eiwit-eiwitinteractienetwerk |
| sva (ComBat) | Bioconductor R-pakket | v3.60.0; Bioconductor release 3.23 | Correctie van batch-effecten tussen datasets |
| SwissADME | Swiss Institute of Bioinformatics | Webserver; geraadpleegd in juli 2026 | Prescreening van drug-likeness, fysisch-chemische eigenschappen en ADME |
| Kit voor totale RNA-extractie | Beijing Solarbio Science & Technology Co., Ltd. | Catalogusnr. R1200 | Extractie en purificatie van totaal RNA uit longweefselmonsters |
| Universele RT-PCR Kit (AMV) | Beijing Solarbio Science & Technology Co., Ltd. | Catalogusnr. RP1200 | Omzetting van totaal RNA in complementair DNA via reverse transcriptie |
| WGCNA (Weighted Gene Co-expression Network Analysis) | CRAN R-pakket | v1.74 | Constructie van gewogen gen-co-expressienetwerken en module-trait-analyse |
Referenties
- Simonneau G, et al. Haemodynamic definitions and updated clinical classification of pulmonary hypertension. Eur Respir J. 2019;53(1):1801913. doi: 10.1183/13993003.01913-2018.
- Rabinovitch M, Guignabert C, Humbert M, Nicolls MR. Inflammation and immunity in the pathogenesis of pulmonary arterial hypertension. Circ Res. 2014;115(1):165–175.
- Humbert M, et al. 2022 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Heart J. 2022;43(38):3618–3731.
- Galiè N, et al. 2015 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Respir J. 2015;46(4):903–975.
- Soon E, et al. Elevated levels of inflammatory cytokines predict survival in idiopathic and familial pulmonary arterial hypertension. Circulation. 2010;122(9):920–927.
- George PM, et al. Evidence for the involvement of type I interferon in pulmonary arterial hypertension. Circ Res. 2014;114(4):677–688.
- Subramanian A, et al. A next-generation Connectivity Map: L1000 platform and the first 1,000,000 profiles. Cell. 2017;171(6):1437–1452.e17.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. doi: 10.1093/nar/gkv007.
- Langfelder P, Horvath S. WGCNA: an R package for weighted correlation network analysis. BMC Bioinformatics. 2008;9:559. doi: 10.1186/1471-2105-9-559.
- Yu G, Wang LG, Han Y, He QY. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284–287.
- Kanehisa M, Goto S. KEGG: Kyoto Encyclopedia of Genes and Genomes. Nucleic Acids Res. 2000;28(1):27–30.
- Szklarczyk D, et al. The STRING database in protein–protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638–D646.
- Friedman J, Hastie T, Tibshirani R. Regularization paths for generalized linear models via coordinate descent. J Stat Softw. 2010;33(1):1–22.
- Guyon I, Weston J, Barnhill S, Vapnik V. Gene selection for cancer classification using support vector machines. Mach Learn. 2002;46:389–422.
- Breiman L. Random forests. Mach Learn. 2001;45(1):5–32.
- Robin X, et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. doi: 10.1186/s12859-011-0077-8.
- Stearman RS, et al. Systems analysis of the human pulmonary arterial hypertension lung transcriptome. Am J Respir Cell Mol Biol. 2019;60(6):637–649.
- Crnkovic S, et al. Single-cell transcriptomics reveals skewed cellular communication and phenotypic shift in pulmonary artery remodeling. JCI Insight. 2022;7(20):e153471. doi: 10.1172/jci.insight.153471.
- Hao Y, et al. Integrated analysis of multimodal single-cell data. Cell. 2021;184(13):3573–3587.e29.
- Jin S, et al. Inference and analysis of cell–cell communication using CellChat. Nat Commun. 2021;12(1):1088. doi: 10.1038/s41467-021-21246-9.
- Bustin SA, et al. MIQE 2.0: revision of the Minimum Information for Publication of Quantitative Real-Time PCR Experiments guidelines. Clin Chem. 2025;71(6):634–651.
- Livak KJ, Schmittgen TD. Analysis of relative gene expression data using real-time quantitative PCR and the 2−ΔΔCt method. Methods. 2001;25(4):402–408.
- Kim S, et al. PubChem 2023 update. Nucleic Acids Res. 2023;51(D1):D1373–D1380.
- Knox C, et al. DrugBank 6.0: the DrugBank Knowledgebase for 2024. Nucleic Acids Res. 2024;52(D1):D1265–D1275.
- Daina A, Michielin O, Zoete V. SwissADME: a free web tool to evaluate pharmacokinetics, drug-likeness, and medicinal chemistry friendliness of small molecules. Sci Rep. 2017;7:42717. doi: 10.1038/srep42717.
- Burley SK, et al. RCSB Protein Data Bank: powerful new tools for exploring 3D structures of biological macromolecules for basic and applied research and education. Nucleic Acids Res. 2021;49(D1):D437–D451. doi: 10.1093/nar/gkaa1038.
- Eberhardt J, Santos-Martins D, Tillack AF, Forli S. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61(8):3891–3898. doi: 10.1021/acs.jcim.1c00203.
- Liu Y, et al. CB-Dock2: improved protein-ligand blind docking by integrating cavity detection, docking, and homologous template fitting. Nucleic Acids Res. 2022;50(W1):W159–W164. doi: 10.1093/nar/gkac394.
- Duffy JP, et al. The discovery of VX-745: a novel and selective p38α kinase inhibitor. ACS Med Chem Lett. 2011;2(10):758–763.
- Sheng Y, et al. Crocin inhibits neutrophil migration and activation to treat hypoxic pulmonary hypertension through targeting HCK. Phytomedicine. 2025;148:157334. doi: 10.1016/j.phymed.2025.157334.
- Cui H, et al. Leonurine ameliorates hypoxic pulmonary hypertension by inhibiting cross-talk between neutrophils and endothelial cells via SERPINB3 targeting. Int Immunopharmacol. 2026;176:116467. doi: 10.1016/j.intimp.2026.116467.