Deze studie identificeert vijf biomarkers gerelateerd aan cuproptose en ferroptose bij colitis ulcerosa via geïntegreerde machine learning, single-cell RNA-sequencing en experimentele validatie, wat inzichten biedt voor klinische diagnostiek en gerichte immunotherapie.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Onderzoeksartikel
Het targeten van ferroptose en cuproptose bij colitis ulcerosa: bevindingen uit uitgebreide bio-informatica en experimentele validatie
In dit artikel
Samenvatting
Samenvatting
Ulceratieve colitis (UC) is een aanhoudende darmziekte met een onvolledig gedefinieerde pathogenese en toenemende prevalentie en ziekenhuisopnamecijfers in nieuw geïndustrialiseerde landen. Bij UC verstoort overmatige celdood van het darmepitheel de mucosale barrière en triggert dit ontstekingsreacties. Ferroptose en cuproptose zijn twee onlangs beschreven vormen van gereguleerde celdood. De meeste studies naar UC hebben deze processen afzonderlijk onderzocht; hun gecombineerde rollen in de progressie van UC zijn echter nog onvoldoende gekarakteriseerd. Om hun synergistische rollen in de pathogenese van UC te onderzoeken, hebben we een stapsgewijze aanpak gebruikt met grootschalige transcriptomische profilering om kandidaat-targets te identificeren, gevolgd door validatie in in vitro-modellen. Differentieel tot expressie gebrachte genen (DEGs) werden gekruist met ferroptose-gerelateerde genen (FRGs) en cuproptose-gerelateerde genen (CRGs). De overlappende targets werden geprioriteerd met behulp van een consensus van machine learning-algoritmen en gewogen gen-coexpressienetwerkanalyse (WGCNA). Vijf biomarkers — LCN2, IDO1, CXCL2, NOS2 en CD274 — waren significant upgereguleerd bij UC. Single-cell-analyse karakteriseerde hun expressie over verschillende celtypen, waarbij LCN2 en NOS2 primair verrijkt waren in epitheelcellen. De mechanistische relevantie van deze markers werd verder geëvalueerd via in vitro-assays. Behandeling met ferroptose- of cuproptose-remmers verlichtte de UC-geassocieerde ontsteking en moduleerde de biomarker-expressie in Caco-2-celmodellen. Deze bevindingen identificeren vijf biomarkers die geassocieerd zijn met de progressie van UC en leveren experimenteel bewijs dat hun potentiële toepassing in klinische diagnostiek en therapeutische interventie ondersteunt.
Inleiding
Ulceratieve colitis (UC) is een recidiverende inflammatoire darmziekte die gepaard gaat met een groeiende wereldwijde ziektelast en aanzienlijke langetermijnbehandelingskosten1,2. Hoewel aminosalicylaten, corticosteroïden, biologicals en therapieën met kleine moleculen de behandelingsopties hebben uitgebreid, blijft een duurzame remissie voor veel patiënten moeilijk te bereiken3,4. Deze onvervulde klinische behoefte benadrukt het belang van het identificeren van reproduceerbare moleculaire markers en hanteerbare mechanismen die een vroegere diagnose en mechanisme-gestuurde therapie kunnen ondersteunen5.
Ferroptose is een ijzerafhankelijke vorm van gereguleerde celdood die wordt aangedreven door lipideperoxidatie, glutathione-depletie en een verminderde GPX4-activiteit6. Verhoogde ijzer- en malondialdehyde-spiegels bij UC zijn consistent met ferroptotische epitheliale schade, terwijl experimentele activering van de SLC7A11–GSH–GPX4-as of directe inhibitie van ferroptose de darmbarrière kan beschermen7,8.
Cuproptose, beschreven in 2022, wordt in gang gezet wanneer koper bindt aan gelipoyeerde mitochondriale eiwitten, wat resulteert in eiwitaggregatie en proteotoxische stress9. Omdat de darm een centrale rol speelt bij de koperhuishouding, kan verstoring van deze route oxidatieve en inflammatoire epitheliale schade bij UC versterken10.
Ferroptose en cuproptose kunnen convergeren via metaalion-onbalans, mitochondriaal metabolisme, glutathiondepletie en oxidatieve stress11. Het blijft echter onduidelijk of deze interactie een reproduceerbare moleculaire signatuur produceert bij UC en of een dergelijke signatuur reageert op pathway-specifieke inhibitie.
De hypothese van de studie was dat ontregelde interactie tussen ferroptose en cuproptose bij UC convergeert naar een reproduceerbare biomarker-signatuur, die geprioriteerd kan worden over bulk- en single-cell transcriptomische datasets en kan worden afgezwakt door padspecifieke inhibitie in een model van intestinale epitheliale beschadiging. Overeenkomstig werden multicohort bio-informatica, machine learning, single-cell analyse en gerichte Caco-2 experimenten geïntegreerd om kandidaat-biomarkers te identificeren en functioneel te evalueren (Figuur 1).
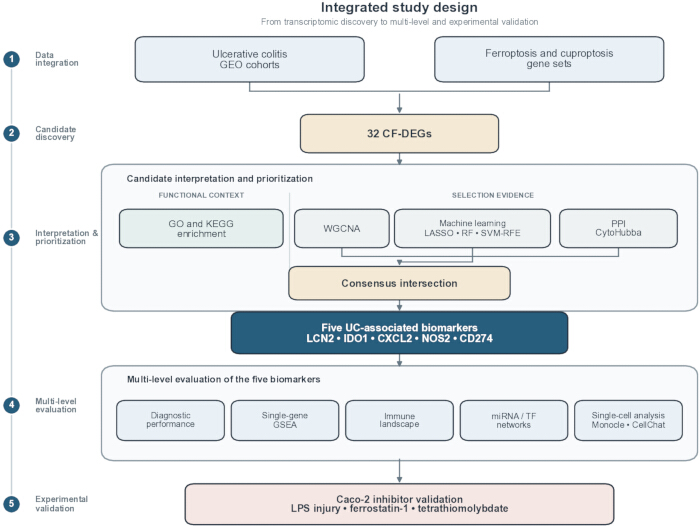
Figuur 1: Workflow van het onderzoek. Geïntegreerde workflow voor transcriptomische screening van meerdere cohorten, prioritering van biomarkers op basis van machine learning en netwerkanalyse, single-cell lokalisatie en validatie op basis van inhibitoren in Caco-2-cellen. UC: colitis ulcerosa; GEO: Gene Expression Omnibus; WGCNA: weighted gene co-expression network analysis; PPI: proteïne-proteïne interactie; ROC: receiver operating characteristic; GSEA: gene set enrichment analysis. Klik hier om een grotere versie van deze figuur te bekijken.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Voor deze studie zijn gebruikgemaakt van publiekelijk beschikbare datasets en commercieel verkrijgbare menselijke cellijnen. Er waren geen menselijke proefpersonen, recent verzameld menselijk weefsel of gewervelde dieren betrokken; daarom was goedkeuring van een institutionele ethische commissie niet vereist. De onderzoeksinstrumenten, software en online bronnen die in het protocol zijn gebruikt, staan vermeld in de Tabel met Materialen.
1. Gegevensverwerking voor differentieel expressieonderzoek
Om de transcriptomische discovery- en validatiecohorten vast te stellen, is de Gene Expression Omnibus (GEO) database doorzocht met de term “ulcerative colitis”. Vier datasets—GSE87466, GSE92415, GSE107499 en GSE75214—werden gebruikt als trainingsset, terwijl GSE47908 werd gereserveerd voor externe validatie. De trainingsdatasets werden genormaliseerd en batch-gecorrigeerd met ComBat in Sangerbox 3.0, terwijl de validatiedataset onafhankelijk werd verwerkt.
In totaal werden 583 ferroptose-gerelateerde genen (FRG's) verkregen uit FerrDB en aangevuld met genen die in de literatuur zijn beschreven om bias door een enkele bron te verminderen12Een set van 96 cuproptose-gerelateerde genen (CRG's) werd samengesteld op basis van gepubliceerde studies.12,13,14Differentiële expressie werd geanalyseerd met limma met drempelwaarden van |log₂ vouwverandering > 1 en Benjamini-Hochberg-gecorrigeerd P < 0.05. Diagnostische plots van normalisatie, batchcorrectie, differentiële expressie en clustering zijn opgenomen in Aanvullende figuur 1De monstersamenstelling, platforms en cohorttoewijzingen zijn vermeld in Aanvullende tabel 1.
2. Identificatie van CF-DEGs in UC
Pearson-correlatieanalyse werd uitgevoerd met drempelwaarden van |r| > 0,5 en P < 0,05 om co-expressie van FRGs en CRGs te identificeren. De resulterende genenset werd gekruist met de differentieel tot expressie gebrachte genen (DEGs) om cuproptose-ferroptose co-expressie differentieel tot expressie gebrachte genen (CF-DEGs) te identificeren.
3. Verrijkingsanalyse
Verrijkingsanalyses voor Gene Ontology (GO) en de Kyoto Encyclopedia of Genes and Genomes (KEGG) werden uitgevoerd met clusterProfiler en het Bioinformatics.com.cn platform. Een volgens Benjamini–Hochberg gecorrigeerde P < 0,05 werd gebruikt als significantiedrempel. De verrijkingsplots zijn opgenomen in Aanvullende Figuur 2.
4. Gewogen gen-co-expressienetwerkanalyse (WGCNA)
De modulaire structuur die ten grondslag ligt aan de genexpressieprofielen werd geanalyseerd met behulp van weighted gene co-expression network analysis (WGCNA). Abnormale monsters werden geïdentificeerd en uitgesloten via hiërarchische clustering in combinatie met de goodSamplesGenes-functie. Vervolgens werd een geschikte soft-thresholding power (β) bepaald om te voldoen aan het criterium van de schaalvrije topologie voor de netwerkconstructie.
De verwerkte expressiegegevens werden gebruikt om een topologische overlapmatrix (TOM) op te stellen voor gen-co-expressieanalyse. Met behulp van de dynamic tree-cutting benadering werden genen met zeer consistente expressiepatronen georganiseerd in genmodules, waarvan elke module ten minste 100 genen bevatte. Associaties tussen module eigengenes (MEs) en fenotypes werden geanalyseerd om modules te identificeren die geassocieerd zijn met het ziekteproces en om de overeenkomstige genensets te extraheren. De WGCNA-screeningsdiagnostiek zijn weergegeven in Aanvullende figuur 3.
5. Selectie van biomarkers
Om kandidaten voor experimentele follow-up te prioriteren, werden drie machine-learning-algoritmen parallel toegepast15. Least absolute shrinkage and selection operator (LASSO)-regressie werd gebruikt voor kenmerkselectie, random forest met ntree = 500 werd gebruikt om de belangrijkheid van genen te rangschikken, en support vector machine–recursive feature elimination (SVM-RFE) werd gebruikt om de subset van kenmerken met de laagste cross-validatiefout te identificeren. De volledige screeningsdiagnostiek is weergegeven in Aanvullende Figuur 5.
De belangrijkheid van genen werd geëvalueerd op basis van de bijdrage van individuele genen aan de classificatienauwkeurigheid, en hooggeplaatste genen werden verzameld om een voorlopige genenset te genereren16. Het SVM-RFE-algoritme voerde feature-screening en modeloptimalisatie uit via iteratieve feature-eliminatie, waardoor de optimale subset van features voor classificatie kon worden geïdentificeerd17. Genen die in alle drie de algoritmen voorkwamen, werden beschouwd als kandidaat-biomarkers geïdentificeerd via machine learning.
De CF-DEG's werden gebruikt voor de constructie van een eiwit-eiwitinteractienetwerk (PPI), waarbij CytoHubba werd aangewend om de kernknopen te rangschikken. De intersectie van de belangrijkste WGCNA-modules, de drie outputgegevens van machine learning en de PPI-kernset definieerde vijf geïntegreerde kandidaat-biomarkers: LCN2, IDO1, CXCL2, NOS2 en CD274. Deze genen werden geclassificeerd als UC-geassocieerde diagnostische kandidaten. Vervolgexperimenten met inhibitoren classificeerden LCN2, IDO1, CXCL2 en NOS2 verder als ferroptose-inhibitie-responsieve markers en CD274 als een cuproptose-inhibitie-responsieve marker. Deze genen werden niet beschouwd als bewezen upstream-regulatoren van een van beide pathways.
6. Ontwikkeling van het voorspellende model en evaluatie via meerdere methoden
Om het klinische translationele potentieel van de geïdentificeerde gen-signatuur te evalueren, is een nomogram geconstrueerd met behulp van het rms-pakket om de diagnostische prestaties te beoordelen. De prestaties van het model werden geëvalueerd met een kalibratiecurve, de Hosmer–Lemeshow (HL)-test en de concordantie-index (C-index) van Harrell.
De kalibratie van het model werd beoordeeld met behulp van de HL-test en de gemiddelde absolute fout (MAE). Een P-waarde > 0,05 en een MAE < 0,1 werden vastgesteld als drempelwaarden voor respectievelijk een aanvaardbare modelpassing en nauwkeurigheid. Er werden Receiver operating characteristic (ROC)-curven gegenereerd, en de oppervlakte onder de curve (AUC) werd berekend om de voorspellende prestaties van het nomogram voor UC te evalueren. Een onafhankelijke dataset werd gebruikt om de generaliseerbaarheid en stabiliteit van het model te beoordelen.
7. Gene set enrichment analyse (GSEA)
In de trainingset werd een Spearman-correlatieanalyse uitgevoerd tussen elke biomarker en alle andere genen. De correlatieresultaten werden gerangschikt om een geordende genenset te genereren. Gene set enrichment analysis (GSEA) werd uitgevoerd met de c2.cp.kegg_medicus.v2025.1.Hs.symbols genenset van de Molecular Signatures Database (MSigDB) als referentie. Biologische paden met P < 0,05 werden beschouwd als significant verrijkt.
8. Analyse van het immuunlandschap
De CIBERSORT-tool en de LM22-signatuurmatrix werden gebruikt om deconvolutieanalyse van de expressiegegevens uit te voeren en de proporties van 22 immuunceltypen te schatten. Vervolgens werd een Spearman-correlatieanalyse uitgevoerd om de associaties tussen de vijf biomarkers en de immuunceltypen te beoordelen.
9. Analyse van het regulatoire netwerk
Informatie over de regulatie door gen-gerelateerde transcriptiefactoren (TF) en microRNA (miRNA) werd verkregen uit de geïntegreerde ChEA3- en TarBase 9.0-databanken via het NetworkAnalyst-platform. MiRNA's die geassocieerd waren met ten minste twee knooppunten werden opgenomen in het regulatienetwerk.
10. RNA-seq van individuele cellen
De UC single-cell datasets GSE116222, bestaande uit drie gezonde en drie UC-monsters, en GSE214695, bestaande uit zes gezonde en zes UC-monsters, werden geïntegreerd. Cellen werden behouden wanneer zij 200–5.000 gedetecteerde genen, >1.000 unieke moleculaire identificatoren, < 30% mitochondriale transcripten, < 3% hemoglobinetranscripten en < 50% ribosomale transcripten bevatten. Voor de normalisatie werd de NormalizeData-functie gebruikt en Harmony werd ingezet voor batchcorrectie voorafgaand aan clustering en annotatie.
Na filtering werden de gegevens genormaliseerd met de functie NormalizeData. Harmony werd gebruikt om batch-effecten tussen monsters te minimaliseren. Uniform manifold approximation and projection (UMAP) en t-distributed stochastic neighbor embedding (t-SNE) werden toegepast voor dimensionaliteitsreductie en celclustering om lokale en globale structuren binnen de celpopulatie te karakteriseren. In totaal werden 31.712 hoogwaardige cellen behouden voor verdere analyse. Celtypen werden geannoteerd op basis van canonieke celmarkergenen.
Pseudotijd-analyse werd uitgevoerd met Monocle 2 om veranderingen in de toestanden van epitheliale en myeloïde cellen uit UC-weefsels te onderzoeken. Cellulaire ontwikkelingstrajecten en verschillen tussen groepen werden geëvalueerd, en expressiepatronen van biomarkers langs het pseudotijdstraject werden gevisualiseerd.
CellChat werd gebruikt om de cel-celcommunicatie tussen epitheliale en myeloïde cel-subsets te evalueren. Subpopulatie-specifieke expressiepatronen werden geïntegreerd om interactiekansen en belangrijke signaleringsroutes tussen epitheliale en myeloïde cellen af te leiden en om hun potentiële intercellulaire regulatoire netwerken te karakteriseren.
11. Celexperimenten
Humane Caco-2 colonadenocarcinoomcellen werden gekweekt in Dulbecco’s modified Eagle medium met 10% foetaal runderserum, 100 U/mL penicilline en 100 µg/mL streptomycine bij 37 °C in 5% CO₂. Caco-2-cellen werden gekozen als een reproduceerbaar epitheel monolayer-model voor intestinale barrière- en ontstekingsbeschadigingsassays; hun maligne oorsprong beperkt echter de directe generalisatie naar niet-maligne colonepitheel. Informatie over de passage was niet beschikbaar in de gearchiveerde experimentele verslagen.
Een in vitro ontsteking-schademodel werd vastgesteld door cellen 24 h lang bloot te stellen aan 1 µg/mL lipopolysacharide (LPS). Cellen werden toegewezen aan een dimethylsulfoxide-vehikelcontrolegroep, een LPS-only groep, een LPS + 4 µM ferrostatin-1 groep, of een LPS + 40 µM tetrathiomolybdaat groep, met overeenkomstige uiteindelijke oplosmiddelconcentraties. De LPS-only groep diende als positieve schade-/modelcontrole voor de inhibitor-rescue vergelijkingen.
- Celviabiliteit
De celviabiliteit werd beoordeeld met een celviabiliteitsassay volgens de instructies van de fabrikant. Na incubatie bij 37 °C gedurende ongeveer 2 u werd de absorbentie bij 450 nm gemeten met een microplate reader. - Meting van MDA- en Fe²⁺-niveaus
Intracellulaire malondialdehyde (MDA)- en Fe2⁺-niveaus werden gemeten met de bijbehorende assaykits volgens de instructies van de fabrikanten. Totaal eiwit werd gekwantificeerd met een bicinchoninezuurassay, en elke meting werd genormaliseerd naar het eiwitgehalte van het betreffende monster. - Fluorescente probe-assay voor koperionen
Na verwijdering van het cultuurmedium werd een Cu2⁺-specifieke fluorescente probe toegevoegd tot een eindconcentratie van 1 µM en 30 min geïncubeerd bij 37 °C. Beelden werden onmiddellijk zonder wassen vastgelegd met een omgekeerde fluorescentiemicroscoop bij excitatie- en emissiegolflengten van respectievelijk 510 en 578 nm. De acquisitie-instellingen werden constant gehouden voor alle groepen, en de schaalbalk van de afbeelding werd gekalibreerd op 50 µm. - RT-qPCR
Totaal RNA werd geïsoleerd met een op fenol-guanidinium gebaseerd RNA-extractiereagens. Complementair DNA werd gesynthetiseerd uit 1 µg RNA met een first-strand complementair DNA-synthesekits, en op SYBR Green gebaseerde reagentia werden gebruikt voor real-time PCR. Elke reactie werd in technische triplicaat uitgevoerd. De primersequenties zijn opgenomen in Aanvullende Tabel 2, en de relatieve messenger RNA-overvloed werd berekend met de 2⁻ΔΔCt methode.
12. Statistische analyse
Normaliteit en homogeniteit van de variantie werden respectievelijk beoordeeld met de Shapiro–Wilk-toets en de mediaan-gecentreerde Levene-toets. Gegevens die aan beide aannames voldeden, werden geanalyseerd met een ongepairede tweezijdige t-toets of een eenweg-variantieanalyse gevolgd door de Tukey-toets voor eerlijk significante verschillen. Wanneer aan een van de aannames niet werd voldaan, werd de t-toets van Welch of de variantieanalyse van Welch gevolgd door Games–Howell-vergelijkingen gebruikt.
Resultaten worden weergegeven als gemiddelde ± standaarddeviatie. De werkelijke aantallen biologische replica's, exacte tweezijdige P-waarden en assumptiecontroles zijn vermeld in Aanvullende Tabel 3. Het gearchiveerde bronblad van Figuur 13 bevat minder controlereplica's voor panelen A (n = 4), C (n = 4) en F (n = 2), terwijl alle andere paneel-/groepcombinaties n = 6 bevatten.
Computationele analyses werden uitgevoerd met R en de workflows van limma, WGCNA, clusterProfiler, glmnet, randomForest, e1071, pROC, rms, Seurat v4, Harmony, Monocle 2, CellChat en Cytoscape/CytoHubba. Gebruikte online bronnen waren FerrDB, GEO, STRING, ChEA3, TarBase 9.0, NetworkAnalyst, CIBERSORT/LM22, MSigDB, Bioinformatics.com.cn en Sangerbox 3.0.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Identificatie en functionele annotatie van co-expressiegenen voor cuproptose en ferroptose
Vier trainingsdatasets bestaande uit 421 UC-monsters en 97 gezonde controles werden geïntegreerd. Er werden in totaal 551 differentieel tot expressie gebrachte genen geïdentificeerd, waaronder 362 opgereguleerde en 189 neergereguleerde genen. Correlatieanalyse leverde 444 ferroptose-cuproptose-gecorreleerde genen op, en de overlap met de differentieel tot expressie gebrachte genen result...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Deze studie integreerde bulk-transcriptomics, machine learning, single-cell-analyse en gerichte celexperimenten om de crosstalk tussen ferroptose en cuproptose bij UC te onderzoeken. Vijf UC-geassocieerde diagnostische kandidaten waren reproduceerbaar in zowel de discovery- als validatiecohorten, waren hoofdzakelijk gelokaliseerd in epitheliale en myeloïde compartimenten en vertoonden een expressie in Caco-2-cellen die reageerde op pathway-inhibitie. Deze bevindingen ondersteunen een gefaseerde workflow waarbij computati...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs hebben niets te melden.
Dankbetuigingen
Dit werk werd ondersteund door het Young Qihuang Scholar Project van de National Administration of Traditional Chinese Medicine (beurs nr. 2022256). Er wordt dank uitgesproken aan alle leden van de onderzoeksteams van de Liaoning University of Traditional Chinese Medicine en het Third Affiliated Hospital of Liaoning University of Traditional Chinese Medicine voor de technische ondersteuning en bijdragen aan datacuratie en bio-informatica-analyse.
OpenAI Codex (OpenAI) is tijdens de revisie uitsluitend gebruikt ter ondersteuning bij het redigeren van de Engelse taal, de opmaak van het document en controles van de figuurkwaliteit. Alle wetenschappelijke inhoud, analyses, citaties en de uiteindelijke presentatie zijn beoordeeld en geverifieerd door de auteurs, die de volledige verantwoordelijkheid dragen voor het manuscript.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| BCA-proteineanalysekit | Beyotime Institute of Biotechnology | P0010 | Eiwitkwantificering voor normalisatie. |
| Bioinformatics.com.cn | Bioinformatics.com.cn | Online platform; geraadpleegd in 2026 | GO/KEGG-visualisatie- en analyseplatform. |
| Caco-2-cellijn | ATCC | HTB-37 | Menselijke colorectale adenocarcinoom-cellijn gebruikt voor het model van epitheliale beschadiging. |
| Cell Counting Kit-8 | GLPBio | GK10001 | Cell-viabiliteitsassay gemeten bij 450 nm. |
| CIBERSORT met LM22-signatuur | CIBERSORT-ontwikkelaars | LM22 | Deconvolutie van 22 immuuncelfracties. |
| ChEA3 | Ma'ayan Laboratory | Online platform; geraadpleegd 2026 | Verrijking van transcriptiefactoren en voorspelling van regulatoire netwerken. |
| CO2 incubator | Niet opgenomen | Omdat er geen brontekst is verstrekt, kan ik geen vertaling uitvoeren. Voer aub de Engelse tekst in die u vertaald wilt hebben naar het Nederlands. | Bevochtide incubator gebruikt voor kweek bij 37 °C en 5% CO22. |
| Cu2+ fluorescente probe | BIOFOUNT | CAS 98907-26-7 | Intracellulair Cu2+ fluorescentiedetectie. |
| Cytoscape met CytoHubba | Cytoscape Consortium | Versie niet geregistreerd | Visualisatie van PPI en rangschikking van kernknooppunten. |
| Dulbecco's modified Eagle medium | Gibco | 11965092 | Caco-2-celkweekmedium. |
| Dimethylsulfoxide | Niet opgenomen | Omdat er geen brontekst is verstrekt, kan ik geen vertaling produceren. Voer aub de Engelse tekst in die u vertaald wilt hebben naar het Nederlands. | Voertuigcontrole. |
| Foetaal runderserum | Niet opgenomen | Omdat u geen brontekst heeft verstrekt, is er geen inhoud om te vertalen. Voeg alstublieft de Engelse tekst toe die u naar het Nederlands vertaald wilt hebben. | Mediumsupplement op 10%. |
| Fe2+ Assaykit | Abcam | ab83366 | Meting van intracellulair Fe2+. |
| FerrDB | FerrDB-ontwikkelaars | Online database; geraadpleegd in 2026 | Bron van ferroptose-gerelateerde genen. |
| Ferrostatin-1 | Sigma-Aldrich | SML0583 | Ferroptose-remmer; eindconcentratie 4 µM. |
| Harmonie | Broad Institute/gemeenschap | Versie niet geregistreerd | Batchcorrectie voor single-cell analyse. |
| Inverteerde fluorescentiemicroscoop | Olympus | IX71 | Cu2+ fluorescentie-imaging bij 510/578 nm excitatie/emissie. |
| Lipopolysaccharide | Niet opgenomen | Omdat er geen brontekst is verstrekt, kan ik geen vertaling produceren. Voeg aub de Engelse tekst toe die u vertaald wilt hebben naar het Nederlands. | Inflammatoire letselstimulus bij 1 µg/mL gedurende 24 u. |
| Malondialdehyde-assaykit | Beyotime Institute of Biotechnology | S0131S | Meting van lipideperoxidatie. |
| Microplate-lezer | Niet opgenomen | Omdat er geen brontekst is verstrekt, kan er geen vertaling worden gemaakt. Voeg aub de Engelse tekst toe die u vertaald wilt hebben naar het Nederlands. | Absorptiemeting bij 450 nm. |
| Monocle | Bioconductor/gemeenschap | Versie 2 | Pseudotijdanalyse van individuele cellen. |
| Database voor Moleculaire Signaturen | Broad Institute | c2.cp.kegg_medicus.v2025.1.Hs | Referentiegenenset voor GSEA. |
| NetworkAnalyst | NetworkAnalyst-ontwikkelaars | Online platform; geraadpleegd 2026 | Integratie van transcriptiefactor- en miRNA-netwerken. |
| Penicilline–streptomycine | Niet opgenomen | Niet van toepassing | 100 U/mL penicilline en 100 µg/mL streptomycine. |
| R | R Foundation for Statistical Computing | Versie niet geregistreerd | Bioinformatica-analyseomgeving. |
| R-pakketset | CRAN/Bioconductor | Pakketopbouw niet geregistreerd | workflows voor limma, WGCNA, clusterProfiler, glmnet, randomForest, e1071, pROC en rms. |
| Real-time PCR-systeem | Niet opgenomen | Het is niet van toepassing. | SYBR Green RT-qPCR-instrument. |
| RevertAid First Strand cDNA Synthese Kit | Thermo Fisher Scientific | K1622 | Synthese van het eerste cDNA-streng vanuit 1 µg RNA. |
| Sangerbox | Ontwikkelaars van de Sangerbox | 3.0 | Normalisatie en ComBat-batchcorrectie. |
| Seurat | Satija Lab/community | Versie 4 | Kwaliteitscontrole, normalisatie, clustering en visualisatie op single-cell niveau. |
| Statistische analysesoftware | Niet opgenomen | Omdat er geen brontekst is verstrekt, kan ik geen vertaling genereren. Voer a.u.b. de Engelse tekst in die u wilt laten vertalen naar het Nederlands. | Statistische analyse van de oorspronkelijke celexperimenten. |
| U hebt geen tekst opgegeven om te vertalen. Voer a.u.b. de brontekst in die u naar het Nederlands vertaald wilt hebben. | STRING-consortium | Online database; geraadpleegd 2026 | Eiwit–constructie van eiwitinteractienetwerken |
| SYBR Green real-time PCR-reagentia | Takara | RR820A | Kwantitatieve real-time PCR. |
| TarBase | DIANA-tools | 9.0 | Experimenteel ondersteund miRNA–geninteracties |
| Tetrathiomolybdaat | Sigma-Aldrich | 323446 | Koperchelaatvormer; eindconcentratie 40 µM. |
| TRIzol-reagens | Takara | 9108 | Totale RNA-extractie. |
Referenties
- Fu M, Wang QW, Liu YR, Chen SJ. The role of the three major intestinal barriers in ulcerative colitis in the elderly. Ageing Res Rev. 2025;108:102752. https://doi.org/10.1016/j.arr.2025.102752.
- Le Berre C, Honap S, Peyrin-Biroulet L. Ulcerative colitis. Lancet. 2023;402:571–584.
- Wangchuk P, Yeshi K, Loukas A. Ulcerative colitis: Clinical biomarkers, therapeutic targets, and emerging treatments. Trends Pharmacol Sci. 2024;45:892–903.
- Kobayashi T, et al. Ulcerative colitis (primer). Nat Rev Dis Primers. 2020;6:74. https://doi.org/10.1038/s41572-020-0205-x.
- Huang J, et al. Comprehensive analysis of cuproptosis-related genes in immune infiltration and diagnosis in ulcerative colitis. Front Immunol. 2022;13:1008146. https://doi.org/10.3389/fimmu.2022.1008146.
- Liu Y, et al. Development and experimental validation of machine learning-based disulfidptosis-related ferroptosis biomarkers in inflammatory bowel disease. Genes. 2025;16:496. https://doi.org/10.3390/genes16050496.
- Hu W, et al. HIF-1α alleviates ferroptosis in ulcerative colitis by regulation of GPX4. Cell Death Dis. 2025;16:542. https://doi.org/10.1038/s41419-025-07883-8.
- Zhao C, et al. FXR acts as a therapeutic target for ulcerative colitis via suppressing ferroptosis. Mol Med. 2025;31:258. https://doi.org/10.1186/s10020-025-01305-3.
- Tsvetkov P, et al. Copper induces cell death by targeting lipoylated TCA cycle proteins. Science. 2022;375:1254–1261.
- Liu J, et al. Unveiling the cuproptosis in colitis and colitis-related carcinogenesis: A multifaceted player and immune moderator. Research (Wash D C). 2025;8:0698. https://doi.org/10.34133/research.0698.
- Liu N, Chen M. Crosstalk between ferroptosis and cuproptosis: From mechanism to potential clinical application. Biomed Pharmacother. 2024;171:116115. https://doi.org/10.1016/j.biopha.2023.116115.
- Hao S, et al. Development of prognostic model incorporating a ferroptosis/cuproptosis-related signature and mutational landscape analysis in muscle-invasive bladder cancer. BMC Cancer. 2024;24:958. https://doi.org/10.1186/s12885-024-12716-1.
- Wang Z, et al. Exosomes secreted by macrophages upon copper ion stimulation can promote angiogenesis. Mater Sci Eng C Mater Biol Appl. 2021;123:111981. https://doi.org/10.1016/j.msec.2021.111981.
- Zou M, Zhang W, Zhu Y, Xu Y. Identification of 6 cuproptosis-related genes for active ulcerative colitis with both diagnostic and therapeutic values. Medicine (Baltimore). 2023;102:e35503. https://doi.org/10.1097/MD.0000000000035503.
- Chen W, Miao J, Chen J, Chen J. Development of machine learning models for diagnostic biomarker identification and immune cell infiltration analysis in PCOS. J Ovarian Res. 2025;18:1. https://doi.org/10.1186/s13048-024-01582-8.
- Lv JH, et al. WGCNA combined with machine learning to find potential biomarkers of liver cancer. Medicine (Baltimore). 2023;102:e36536. https://doi.org/10.1097/MD.0000000000036536.
- Wu Q, Yang C, Huang C, Lin Z. Screening key genes for intracranial aneurysm rupture using LASSO regression and the SVM-RFE algorithm. Front Med. 2025;11:1487224. https://doi.org/10.3389/fmed.2024.1487224.
- Tang D, Pu B, Liu S, Li H. Identification of cuproptosis-associated subtypes and signature genes for diagnosis and risk prediction of ulcerative colitis based on machine learning. Front Immunol. 2023;14:1142215. https://doi.org/10.3389/fimmu.2023.1142215.
- Yang C, et al. Identification of cuproptosis hub genes contributing to the immune microenvironment in ulcerative colitis using bioinformatic analysis and experimental verification. Front Immunol. 2023;14:1113385. https://doi.org/10.3389/fimmu.2023.1113385.
- Yadav SK, et al. Fecal Lcn-2 level is a sensitive biological indicator for gut dysbiosis and intestinal inflammation in multiple sclerosis. Front Immunol. 2022;13:1015372. https://doi.org/10.3389/fimmu.2022.1015372.
- Luo Q, et al. Bioinformatics analysis reveals potential crosstalk genes and molecular mechanisms between ulcerative colitis and psoriasis. Arch Dermatol Res. 2024;317:118. https://doi.org/10.1007/s00403-024-02856-1.
- Nielsen OH, et al. Rectal dialysate and fecal concentrations of neutrophil gelatinase-associated lipocalin, interleukin-8, and tumor necrosis factor-alpha in ulcerative colitis. Am J Gastroenterol. 1999;94:2923–2928.
- Sun Y, et al. Natural polyphenol rutin inhibits ferroptosis in ulcerative colitis by regulating lipid metabolism via blocking the LCN2-ALOX15 axis. Food Funct. 2025;16:7169–7186.
- Sofia MA, et al. Tryptophan metabolism through the kynurenine pathway is associated with endoscopic inflammation in ulcerative colitis. Inflamm Bowel Dis. 2018;24:1471–1480.
- Shon WJ, et al. Severity of DSS-induced colitis is reduced in Ido1-deficient mice with down-regulation of TLR-MyD88-NF-kB transcriptional networks. Sci Rep. 2015;5:17305. https://doi.org/10.1038/srep17305.
- Zeng T, et al. Indoleamine 2, 3-dioxygenase 1 enhances hepatocytes ferroptosis in acute immune hepatitis associated with excess nitrative stress. Free Radic Biol Med. 2020;152:668–679.
- Pavlidis P, et al. Interleukin-22 regulates neutrophil recruitment in ulcerative colitis and is associated with resistance to ustekinumab therapy. Nat Commun. 2022;13:5820. https://doi.org/10.1038/s41467-022-33333-3.
- Urzua U, et al. The ovarian transcriptome of reproductively aged multiparous mice: Candidate genes for ovarian cancer protection. Biomolecules. 2020;10:113. https://doi.org/10.3390/biom10010113.
- Zahn A, et al. Transcript levels of different cytokines and chemokines correlate with clinical and endoscopic activity in ulcerative colitis. BMC Gastroenterol. 2009;9:13. https://doi.org/10.1186/1471-230X-9-13.
- Yi Q, et al. Application of genomic selection and experimental techniques to predict cell death and immunotherapeutic efficacy of ferroptosis-related CXCL2 in hepatocellular carcinoma. Front Oncol. 2022;12:998736. https://doi.org/10.3389/fonc.2022.998736.
- Kolios G, Valatas V, Ward SG. Nitric oxide in inflammatory bowel disease: A universal messenger in an unsolved puzzle. Immunology. 2004;113:427–437.
- Cheng F, et al. Identification of differential intestinal mucosa transcriptomic biomarkers for ulcerative colitis by bioinformatics analysis. Dis Markers. 2020;2020:8876565. https://doi.org/10.1155/2020/8876565.
- Tratensek A, et al. Oxidative stress-related biomarkers as promising indicators of inflammatory bowel disease activity: A systematic review and meta-analysis. Redox Biol. 2024;77:103380. https://doi.org/10.1016/j.redox.2024.103380.
- Zhang JL, et al. Jatrorrhizine alleviates ulcerative colitis via regulating gut microbiota and NOS2 expression. Gut Pathog. 2022;14:41. https://doi.org/10.1186/s13099-022-00516-7.
- Li H, et al. Development of a prognostic model based on ferroptosis-related genes for colorectal cancer patients and exploration of the biological functions of NOS2 in vivo and in vitro. Front Oncol. 2023;13:1133946. https://doi.org/10.3389/fonc.2023.1133946.
- Seibt TM, Proneth B, Conrad M. Role of GPX4 in ferroptosis and its pharmacological implication. Free Radic Biol Med. 2019;133:144–152.
- Holland T, Mattner J. Intestinal eosinophils: Characterization of elusive granulocytes as anti-bacterial and immunomodulatory effector cells in colitis. Signal Transduct Target Ther. 2023;8:321. https://doi.org/10.1038/s41392-023-01588-4.
- Nguyen J, et al. Overexpression of programmed death ligand 1 in refractory inflammatory bowel disease. Hum Pathol. 2022;126:19–27.
- Shen Z, et al. Exploration of a screening model for intrahepatic cholangiocarcinoma patients prone to cuproptosis and mechanisms of the susceptibility of CD274-knockdown intrahepatic cholangiocarcinoma cells to cuproptosis. Cancer Gene Ther. 2023;30:1663–1678.
- Niu Y, et al. Platelet activation stimulates macrophages to enhance ulcerative colitis through PF4/CXCR3 signaling. Int J Mol Med. 2025;55:78. https://doi.org/10.3892/ijmm.2025.5499.
- Qu F, et al. The role of macrophage polarization in ulcerative colitis and its treatment. Microb Pathog. 2025;199:107227. https://doi.org/10.1016/j.micpath.2025.107227.
- Danne C, Skerniskyte J, Marteyn B, Sokol H. Neutrophils: From IBD to the gut microbiota. Nat Rev Gastroenterol Hepatol. 2024;21:184–197.
- Zhao Q, et al. CD4+ T cell activation and concomitant mTOR metabolic inhibition can ablate microbiota-specific memory cells and prevent colitis. Sci Immunol. 2020;5:eabc6373. https://doi.org/10.1126/sciimmunol.abc6373.
- Chen E, et al. Inflamed ulcerative colitis regions associated with MRGPRX2-mediated mast cell degranulation and cell activation modules, defining a new therapeutic target. Gastroenterology. 2021;160:1709–1724.
- Xu H, Wu C, Wang D, Wang H. Alleviating effect of Nexrutine on mucosal inflammation in mice with ulcerative colitis: Involvement of the RELA suppression. Immun Inflamm Dis. 2024;12:e1147. https://doi.org/10.1002/iid3.1147.
- Luo Y, et al. Rab27A promotes cellular apoptosis and ROS production by regulating the miRNA-124-3p/STAT3/RelA signalling pathway in ulcerative colitis. J Cell Mol Med. 2020;24:11330–11342.
- Pace F, Watnick PI. The interplay of sex steroids, the immune response, and the intestinal microbiota. Trends Microbiol. 2021;29:849–859.
- Rodriguez J, Olivares M, Delzenne NM. Implication of the gut microbiota in metabolic inflammation associated with nutritional disorders and obesity. Mol Nutr Food Res. 2021;65:e1900481. https://doi.org/10.1002/mnfr.201900481.
- Ojha R, et al. Emerging role of circulating microRNA in the diagnosis of human infectious diseases. J Cell Physiol. 2019;234:1030–1043.
- Tian Y, et al. LncRNA CDKN2B-AS1 relieved inflammation of ulcerative colitis via sponging miR-16 and miR-195. Int Immunopharmacol. 2020;88:106970. https://doi.org/10.1016/j.intimp.2020.106970.
- Kulkarni N, Pathak M, Lal G. Role of chemokine receptors and intestinal epithelial cells in the mucosal inflammation and tolerance. J Leukoc Biol. 2017;101:377–394.
- Stadnyk AW. Intestinal epithelial cells as a source of inflammatory cytokines and chemokines. Can J Gastroenterol. 2002;16:241–246.
- Xu Y, Chen N. DUOX2-mediated innate immune hyperactivation drives macrophage M1 polarization via the APP-CD74 axis in inflammatory bowel disease. Presented at: 19th Congress of the European Crohn’s and Colitis Organisation (ECCO 2026); Stockholm, Sweden; 2026. https://academic.oup.com/ecco-jcc/article/20/Supplement_1/jjaf231.232/8432779.
- Shi CL, et al. Single-nucleus transcriptome unveils the role of ferroptosis in ischemic stroke. Heliyon. 2024;10:e32727. https://doi.org/10.1016/j.heliyon.2024.e32727.
- Tu H, et al. Integrated single-cell analysis with experimental validation reveals ANXA2 as a therapeutic target for ferroptosis in inflammatory bowel disease. Am J Transl Res. 2026;18:91–111.
- Yan C, et al. Exploring the anti-ferroptosis mechanism of Kai-Xin-San against Alzheimer's disease through integrating network pharmacology, bioinformatics, and experimental validation strategy in vivo and in vitro. J Ethnopharmacol. 2024;326:117915. https://doi.org/10.1016/j.jep.2024.117915.
- Shaik JP, Ahmad A. Pharmacological mechanism of cinnamic acid in the treatment of prostate cancer by network pharmacology. Archives of Medical Reports. 2024;1(2):1–6. https://doi.org/10.26524/amr.2024.2.1.
- Nimmagadda S, Patel S, MR Vishwathika. Targeting ferroptosis: A novel therapeutic avenue in osteoarthritis and bone degeneration. Archives of Medical Reports. 2025;2(5):6–9. https://doi.org/10.26524/amr.2025.5.2.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.