Dit protocol integreert de-identificatie, normalisatie van terminologie, bronverificatie en reproduceerbare visualisatie om auditeerbare, geaggregeerde resultaten te genereren uit real-world poliklinische dossiers van traditionele Chinese geneeskunde.
Methodenartikel
Brongecontroleerde mining en visualisatie van praktijkgegevens van Traditional Chinese Medicine-casussen met gebruik van de Hegan Jianpi-formule
* These authors contributed equally
In dit artikel
Samenvatting
Samenvatting
Poliklinische dossiers van traditionele Chinese geneeskunde (TCM) uit de praktijk bevatten longitudinale informatie over diagnoses, syndroomelementen, symptoombeschrijvingen en geïndividualiseerde recepten, maar hun semi-gestructureerde formaat bemoeilijkt reproduceerbare analyses. Dit artikel presenteert een brongecontroleerd protocol voor het omzetten van gedeïdentificeerde casusverslagen in traceerbare aggregeertabellen en publicatiewaardige visualisaties. De workflow definieert geschiktheidscriteria en analyse-eenheden, behoudt koppelingen tussen oorspronkelijke en genormaliseerde terminologie, verifieert alle gerapporteerde tellers en noemers, en regenereert figuren vanuit geversioneerde brontabellen. Toegepast op dossiers van januari 2015 tot en met juni 2024, identificeerde het protocol 555 geschikte receptbezoeken van 396 patiënten. De uiteindelijke dataset bevatte 324 genormaliseerde kruidenlabels en 9.339 instanties van kruidengebruik. De workflow genereerde parallelle ziekte-spectra voor westerse geneeskunde en TCM, een expliciet spectrum van syndroomelementen en een co-occurrentiematrix, kruid-frequentie- en materia medica-profielen, een uit de anamnese afgeleid symptoomspectrum van 37 termen, 15 gerichte associatieregels, hiërarchische clustering en naar diagnose gestratificeerde heatmaps van kruidengebruik. In 474 bezoeken (85,41%) werd minstens één vooraf gespecificeerd trefwoord uit de anamnese gedetecteerd. Wanneer het institutionele beleid dit toestaat, kan een door mensen begeleide optie voor kunstmatige intelligentie (AI) helpen bij terminologiecontroles, het beoordelen van consistentie tussen bestanden en de afstemming van bijschriften op figuren. Elk gebruik van AI moet worden gedocumenteerd in een apart auditverslag en mag de beoordeling van brongegevens niet vervangen. Door governance, normalisatie, berekening, klinische interpretatie en visuele output te integreren in één reproduceerbare workflow, transformeert deze methode verspreide klinische documentatie in een controleerbare onderzoeksbron. Het protocol kan worden aangepast aan andere datasets van expert-praktijken, multicentrische terminologieprojecten en prospectieve klinische dataplatforms.
Inleiding
Praktijkgegevens van poliklinische patiënten in de traditionele Chinese geneeskunde (TCM) bewaren longitudinale klinische redeneringen via narratieve symptomen, parallelle diagnostische systemen, syndroombeschrijvingen en geïndividualiseerde voorschriften. Vroeg werk op het gebied van kennisontdekking erkende casusverslagen als complexe ervaringsgegevens die specifieke informaticamethoden vereisen voordat hun patronen betrouwbaar kunnen worden bestudeerd1. Vervolgonderzoek heeft aangetoond dat synonieme symptoomuitdrukkingen, fijnmazige entiteiten en lokaal gedocumenteerde diagnostische termen genormaliseerd moeten worden zonder de oorspronkelijke bewoordingen uit te wissen2,3,4,5,6. Gegevens uit elektronische patiëntendossiers (EPD) kunnen ook computationeel onderzoek naar voorschriften en het gebruik van herbruikbare analytische instrumenten ondersteunen, mits de klinische context en de herkomst van de gegevens zichtbaar blijven7,8. Er zijn daarom gezaghebbende materia-medica-referenties nodig om kruidnamen, verwerkingsvormen, eigenschappen, smaken en meridiaantoewijzingen te standaardiseren9,10. Op rapportageniveau vereisen de RECORD- en STROBE-verklaringen transparante beschrijvingen van gegevensbronnen, geschiktheidsregels, variabelen en analytische beslissingen, terwijl de FAIR-principes de nadruk leggen op traceerbare en herbruikbare onderzoeksobjecten11,12,13. Deze overwegingen zijn vooral belangrijk wanneer dossiers herhaalde bezoeken, ontbrekende velden, overlappende terminologie en vrije tekst bevatten. De beoordeling van de geschiktheid voor gebruik moet betrekking hebben op volledigheid, conformiteit, plausibiliteit en overeenstemming tussen bronnen14,15. De-identificatie van vrije tekst vereist tevens expliciete procedures en menselijke controle, omdat geautomatiseerde methoden nuttige klinische inhoud kunnen behouden terwijl er residuele privacyrisico's overblijven16,17,18.
Zodra het beheer en de terminologie zijn vastgesteld, kunnen frequentieprofilering, association-rule mining en hiërarchische clustering complementaire inzichten bieden in de structuur van voorschriften19,20,21. Netwerk- en science-mappingmethoden tonen verder aan hoe gecoördineerde visuele representaties relaties kunnen onthullen die een enkele gerangschikte lijst niet kan vastleggen22,23,24,25. Recente studies naar reumatoïde artritis met depressie, Januskinase-remmers bij colitis ulcerosa en reumatoïde artritis met fibromyalgie illustreren de waarde van versie-vastgelegde ophaalcriteria, co-occurrence-netwerken, clustering, temporele interpretatie en expliciete vermeldingen van analytische beperkingen26,27,28. De huidige studie past deze overdraagbare ontwerpprincipes toe op het minen van klinische dossiers in plaats van op literatuur-bibliometrie. In de brondossiers verwijst Hegan Jianpi Formula naar een op ervaring gebaseerde formule geassocieerd met de praktijk van Professor Nai-li Yao29,30. Gerelateerde publicaties beschrijven zijn bredere klinische benadering van lever-milt-harmonisatie en milt-maag29,30. In dit methodeartikel identificeert de naam van de formule uitsluitend de context van het brondossier en stelt deze geen vaste samenstelling, dosis, behandelindicatie of claim over de effectiviteit vast. De computationele workflow maakt gebruik van deterministische regels en algemene statistische methoden. Reproduceerbare computationele praktijk vereist daarnaast het behoud van inputs, documentatie van parameters, gescripte transformaties en controleerbare outputs31,32. Een door mensen begeleide optie voor kunstmatige intelligentie (AI) kan helpen bij terminologiecontroles, consistentiecontroles tussen bestanden en visuele kwaliteitscontrole, mits het gebruik ervan wordt gedocumenteerd. Klinische expertise, privacywaarborgen en verantwoordelijke menselijke besluitvorming moeten primair blijven (Supplementary Table 1)33,34. Het algemene doel van deze methode is om gedeïdentificeerde TCM-casusdossiers om te zetten in een gecontroleerde keten van outputs, gestratificeerd naar ziekte, syndroom, symptoom, kruidengebruik, associatie, clustering en diagnose. Het uitgewerkte voorbeeld maakt gebruik van 555 in aanmerking komende voorschriftbezoeken van 396 patiënten om aan te tonen hoe beheer, normalisatie, computationele analyse, klinische interpretatie en visuele publicatie geïntegreerd kunnen worden zonder patiëntgegevens, exacte details van de formulering, doseringsverhoudingen of voorschrijfinstructies prijs te geven.
Protocol
Deze retrospectieve analyse van geanonimiseerde klinische dossiers is beoordeeld en goedgekeurd door de Medische Ethiekcommissie van het Guang'anmen Hospital, China Academy of Chinese Medical Sciences (goedkeuringsnr. 2026-108-KY; 13 juli 2026). De vereiste voor geïnformeerde toestemming is door de commissie komen te vervallen.
1. Stel ethiek, bestuur en gegevensbeveiliging vast
- Wijs een beheerder van gegevens, een brongegevenanalist, een beoordelaar van klinische terminologie, een kwantitatieve beoordelaar en een onderzoeker aan die bevoegd is om de release van geaggregeerde gegevens goed te keuren. Noteer elke rol in het projectlogboek.
- Stel een gegevensbeheerplan op waarin het toegestane bronsysteem, de studieperiode, velden, opslaglocatie, toegangsrechten, back-upprocedure, bewaartermijn en beperkingen voor de koppelingssleutel worden gespecificeerd.
- Exporteer alleen de minimale variabelen die nodig zijn voor de vooraf vastgestelde analyse. Neem een lokale patiëntidentifier, bezoekdatum, leeftijd of geboortedatum (indien toegestaan), geslacht, westerse diagnose, TCM-ziektenaam, gedeïdentificeerde tekst over de voorgeschiedenis, tongtekst, pulstekst, syndroomtekst en velden voor voorgeschreven kruiden op.
- Verwijder namen, nationale identificatienummers, telefoonnummers, gedetailleerde adressen, verzekeringsnummers, contactgegevens en andere directe identifiers binnen de gecontroleerde institutionele omgeving. Vervang elk medisch dossiernummer door een projectspecifieke patiëntidentifier.
- Scan tekstvelden op resterende identifiers en maskeer elk gedetecteerd item. Bewaar elke koppelingssleutel gescheiden van de analytische dataset en sluit deze uit van werk-, samenwerkings- en indieningsmappen.
- Bewaar de initiële gedeïdentificeerde export als een alleen-lezen snapshot van de bron. Noteer de bestandsnaam, creatiedatum, rij-aantal, kolom-aantal, bestandsgrootte en checksum in een bronmanifest.
- Maak aparte mappen aan voor bronbestanden, werkbestanden, woordenlijsten, geaggregeerde tabellen, figuren, scripts en auditgegevens.
- Beperk vrijgegeven of gedeelde materialen tot geaggregeerde tabellen, goedgekeurde gedeïdentificeerde woordenlijsten, scripts en publicatiefiguren. Upload geen identificeerbare of potentieel re-identificeerbare gegevens naar openbare generatieve AI-systemen, niet-goedgekeurde clouddiensten of openbare repositories.
OPMERKING: Wanneer het institutionele beleid AI-ondersteuning onder menselijk toezicht toestaat, lever dan alleen gedeïdentificeerde tekstuittreksels of geaggregeerde tabellen aan. Noteer het doel, de beoordeelde output, de geaccepteerde correctie, de beoordelaar en de datum in het auditlogboek.
2. Definieer de regel voor recordidentificatie en de analyse-eenheden
- Definieer de instelling, de poliklinische setting, het verantwoordelijke klinische team, het elektronisch patiëntendossiersysteem en de bronperiode vóór de screening. Gebruik voor het uitgewerkte voorbeeld gegevens gedateerd van januari 2015 tot en met juni 2024.
- Sla de regel voor cohortidentificatie op in een beperkt, versiebeheerd bestand voordat de analytische resultaten worden onderzocht. Leg geaccepteerde terminologievarianten en alle inclusie- en exclusievoorwaarden vast zonder vertrouwelijke formuledetails in het manuscript prijs te geven.
- Pas de versiebeveiligde regel voor recordidentificatie toe op het niveau van het receptbezoek na normalisatie van de kruidennamen. Finaliseer de bronbestanden, woordenboeken, cohortregel en analyseparameters als één enkele releaseset.
- Maak een nieuwe versie en genereer alle afhankelijke outputs opnieuw wanneer een versiebeveiligd component wijzigt. Wijzig de regel voor cohortidentificatie niet na het onderzoeken van ziekteverdelingen, kruidenfrequenties, associatieregels of clusters.
- Neem een polikliniekbezoek op wanneer dit binnen de versiebeveiligde studieperiode valt, is gekoppeld aan een geldige projectpatiëntidentifier, een interpreteerbaar receptrecord bevat en voldoet aan de beperkte regel voor recordidentificatie.
- Sluit exacte dubbele exporten uit, records buiten de studieperiode, records zonder een interpreteerbaar recept en rijen die niet voldoen aan de versiebeveiligde identificatieregel. Ken één primaire exclusiereden toe aan elke uitgesloten rij.
- Maak onderscheid tussen herhaalde exporten en echte follow-upbezoeken. Verwijder alleen exacte systeem- of exportdubbelen en behoud echte herhaalde bezoeken.
- Ken stabiele identifiers toe aan patiënten en receptbezoeken. Maak een cohortmanifest op dat de bronversie, regelversie, screeningsstatus, inclusie- of exclusiereden, patiëntidentifier, bezoekidentifier en reviewerstatus bevat.
- Gebruik één record per unieke patiënt voor vaste demografische samenvattingen, inclusief leeftijd en geslacht. Gebruik het receptbezoek als analyse-eenheid voor analyses van ziekten, syndromen, geschiedenistrefwoorden, tong, pols, kruiden, associatieregels en clustering.
- Scheid de geschiktheid voor het cohort van de beschikbaarheid van variabelen. Behoud een anders geschikte visitatie wanneer een variabele-specifiek veld ontbreekt en rapporteer de evalueerbare noemer voor elke analyse.
- Bevries het cohortmanifest vóór de beschrijvende analyse. Leg het aantal geschikte receptbezoeken en unieke patiënten vast, en genereer alle afhankelijke outputs opnieuw als een beslissing over de geschiktheid wijzigt.
3. Normaliseer de terminologie en bewaar het audit-spoor
- Maak aparte, versiebeheerde woordenlijsten voor kruiden, Westerse diagnoses, TCM-ziektenamen, syndroomelementen, trefwoorden voor de anamnese, tongtermen, polstermen en materia-medica-attributen.
- Neem in elke woordenlijst de oorspronkelijke term, de genormaliseerde term, de termcategorie, het bronveld, de regel, de referentiebron, de versie van de woordenlijst, de beoordelaar, de beoordelingsdatum en opmerkingen op. Behoud elke oorspronkelijke term na normalisatie.
- Normaliseer namen van Chinese geneeskrachtige materialen (CMM) met behulp van gezaghebbende nomenclatuurreferenties9,10. Corrigeer typografische varianten en systeemafkortingen, terwijl klinisch relevante bewerkingsvormen behouden blijven.
- Behoud bewerkingskwalificaties, waaronder stir-fried (geroosterd), vinegar-processed (met azijn bewerkt), honey-fried (met honing geroosterd), ginger-processed (met gember bewerkt), wine-processed (met wijn bewerkt), charred (verschroeid) en raw (rauw), als afzonderlijke labels.
- Houd orthografisch of klinisch verschillende kruiden gescheiden. Voeg Bai Shao niet samen met Bai Zhu en leid geen kruid af uit een ambigue afkorting zonder broncontrole.
- Behoud de oorspronkelijke dosis en eenheid in afzonderlijke velden indien beschikbaar. Verwijder dosistekst alleen bij het construeren van kruidenaanwezigheidsvariabelen op bezoekniveau.
- Interpreteer de frequentie van voorkomen niet als cumulatieve dosis of behandelintensiteit.
- Normaliseer Westerse en TCM-ziektenamen onafhankelijk van elkaar. Behoud het diagnosesysteem en de status van de hoofddiagnose, en vertaal een TCM-ziektelabel niet naar een Westerse diagnose tenzij beide expliciet zijn geregistreerd.
- Definieer bij het eerste gebruik een getranslitereerd TCM-ziektelabel indien dit nodig is voor de oriëntatie van de lezer. Behoud het oorspronkelijke bronlabel.
- Splits tekst met meerdere expliciete syndromen met behulp van versie-geblokkeerde scheidingstekens en map bronuitdrukkingen naar genormaliseerde syndroomelementen. Verwijder dubbele genormaliseerde elementen binnen een bezoek.
- Houd expliciete syndroomteksten gescheiden van overgeërfde of op scores gebaseerde indicatorcolommen.
- Behoud de oorspronkelijke velden voor tong, pols, gestructureerde symptomen en gede-identificeerde anamnese als afzonderlijke dataproducten. Behandel een overeenkomst met een trefwoord uit de anamnese niet als gelijkwaardig aan een door een clinicus ingevoerd gestructureerd symptoom.
- Laat één beoordelaar elk ambigu of veel-op-één mapping voorstellen en laat dit verifiëren door een tweede klinische beoordelaar. Sluit onzekere mappings uit van vrijgegeven analyses totdat broncontrole deze heeft opgelost.
- Controleer op lege genormaliseerde labels, één-op-veel mappings, veel-op-één mappings, dubbele woordenlijstvermeldingen, niet-beoordeelde termen en onbedoeld verlies van bewerkingslabels. Bevries de versies van de woordenlijsten voordat aggregaattabelen worden gegenereerd.
4. Controleer bronvelden en vergrendel rapporteerbare outputs
- Maak een bewijsmateriaalregister aan met één rij voor elke bewering in het manuscript, tabel en figuurpaneel. Registreer de analyse-eenheid, het bronveld, de bronversie, de dictionary-versie, de scriptversie, de teller, de noemer, het uitvoerbestand, de reviewer en de goedgekeurde formulering.
- Herbereken de aantallen geschikte bezoeken en unieke patiënten, demografische samenvattingen, ziekteaantallen, expliciete syndroomaantallen, historie-trefwoordaantallen, frequenties van gecombineerde kruiden en totalen van kruidengebruik direct vanuit de versiegeblokkeerde bestanden.
- Vergelijk elke herberekende waarde met de overeenkomstige waarde in het manuscript, de spreadsheet of de figuur. Corrigeer het manuscript en genereer afhankelijke outputs opnieuw telkens wanneer een discrepantie wordt bevestigd.
- Los elke discrepantie op op bronveldniveau. Registreer de reden, de correctie, de reviewer en de datum in het bewijsmateriaalregister voordat het betreffende resultaat wordt vrijgegeven.
- Verifieer of elke aggregaattabel het genormaliseerde label, de teller, de noemer, de definitie van het percentage, de analyse-eenheid en de bronidentificatie bevat die nodig zijn om de overeenkomstige bewering te reproduceren.
- Verifieer de noemer die voor elk percentage is gebruikt. Gebruik unieke patiënten voor vaste demografische kenmerken en receptbezoeken voor dynamische klinische en receptvariabelen.
- Vergelijk figuurlabels, waarden, volgorde en paneeldefinities met hun versiegeblokkeerde aggregaattabellen. Genereer elke figuur opnieuw na een tabelcorrectie in plaats van de geplotte waarden handmatig te bewerken.
- Vraag een klinisch reviewer om de terminologie-mapping te verifiëren. Vraag een kwantitatief reviewer om aantallen, ratio's, regelmetrieken en noemers van heatmaps te verifiëren.
- Blokkeer het bewijsmateriaalregister, de aggregaattabellen en de figuurbronnen onder één versie-identificatie voordat het manuscript wordt samengesteld.
5. Genereer beschrijvende spectra en co-occurrence-outputs
- Genereer samenvattingen van leeftijd en geslacht op patiëntniveau op basis van één rij per unieke patiënt. Behoud en rapporteer onbekende categorieën expliciet.
- Genereer afzonderlijk de ziektespectra volgens de westerse geneeskunde en de TCM op het niveau van voorschrift per bezoek. Behoud het oorspronkelijke diagnostische systeem en bereken de leidende genormaliseerde labels met een gemeenschappelijke noemer van bezoeken.
- Genereer het syndroom-elementenspectrum vanuit het expliciete genormaliseerde syndroomtekstveld. Splits termen met behulp van versiegefixeerde scheidingstekens, verwijder dubbele termen binnen een bezoek en bereken de frequenties op bezoekniveau.
- Bouw de co-occurrence matrix van syndromen op basis van dezelfde token-sets binnen bezoeken. Codeer de knooppuntgrootte op basis van bezoekfrequentie en de randbreedte of heatmap-intensiteit op basis van het aantal paarsgewijze co-occurrences.
- Specificeer vooraf een exact woordenboek van geschiedenis-trefwoorden wanneer symptoomgegevens voornamelijk narratief zijn. Scan uitsluitend het gedeïdentificeerde veld van de voorgeschiedenis en tel elk concept maximaal één keer per bezoek.
- Bereken de proportie in aanmerking komende bezoeken die ten minste één trefwoord uit de voorgeschiedenis bevatten en rangschik alle trefwoordtellingen. Exporteer de volledige tabel en de uitgezette subset.
- Genereer frequenties van samengevoegde kruiden op basis van genormaliseerde voorschrifttgegevens. Tel elk genormaliseerd kruidenlabel maximaal één keer per bezoek en behoud klinisch relevante bewerkingsvormen als afzonderlijke labels.
- Genereer profielen voor de vier seizoenen (Four-Qi), vijf smaken en meridiaan-tropisme vanuit het versiegefixeerde materia medica-woordenboek. Behandel de vier seizoenen als een enkelwaardige categorie voor elke eigenschapgecodeerde kruidsvoorkoming.
- Behandel de vijf smaken en het meridiaan-tropisme als multi-label attributen. Vermeld de eigenschapgecodeerde noemer en behoud de afzonderlijke analyse-eenheid.
- Exporteer voor elk beschrijvend domein één machinaal leesbare aggregeerde tabel voordat de definitieve figuren worden gegenereerd.
6. Voer associatieregel- en hiërarchische clusteranalyses uit
- Stel een binaire recept-bezoek-per-kruid matrix op vanuit de versie-gefixeerde genormaliseerde receptentabel. Gebruik één rij per in aanmerking komend bezoek en één kolom per genormaliseerd kruidenlabel.
- Bereken support, confidence en lift voor gerichte associatieregels voor enkelvoudige kruiden19. Behoud de richting van elke regel, aangezien confidence afhankelijk is van het antecedent.
- Pas de vooraf gespecificeerde drempelwaarden toe van support ≥ 0.30, confidence ≥ 0.70 en lift > 1.0. Exporteer elke behouden regel met het aantal co-occurrenties en alle drie de metrieken.
- Teken de volledige set behouden regels als een gericht bipartiet regelnetwerk en een geordend regelsterkteprofiel. Codeer de breedte van de netwerkverbindingen op basis van support en de kleur van de verbindingen op basis van lift.
- Codeer de puntgrootte op basis van support en annoteer confidence in het geordende profiel.
- Verifieer dat beide regelweergaven dezelfde set behouden regels bevatten en de richting van de regels behouden. Los elke discrepantie op aan de hand van de geëxporteerde regeltabel vóór publicatie.
- Selecteer de 20 kruid-aanwezigheidsvariabelen met de hoogste frequentie voor hiërarchische clustering. Bereken paarsgewijze Jaccard-afstanden en pas average linkage toe.
- Label het dendrogram met genormaliseerde kruidennamen. Interpreteer de nabijheid van takken uitsluitend als gelijkenis in occurrence-patronen op bezoekniveau.
- Exporteer de binaire matrixspecificatie, regeltabel, netwerklijst van verbindingen, invoervolgorde voor clustering, afstandsmatrix en linkage-matrix vóór het genereren van de figuren.
- Vraag een kwantitatieve reviewer om één regelmetriek handmatig te reproduceren. Vergelijk elke netwerkverbinding met de regeltabel.
- Voer de volledige workflow voor regels en clustering opnieuw uit telkens wanneer de cohort, het terminologiewoordenboek of de kruid-aanwezigheidsmatrix wijzigt.
- Voer voor het uitgewerkte voorbeeld een deterministische sensitiviteitsanalyse van één bezoek per patiënt uit door het vroegste record in de bronvolgorde per patiënt te behouden. Vergelijk de resulterende 12 regels met de 15 regels uit de analyse op bezoekniveau.
- Rapporteer de wijziging als een beschrijvend resultaat van robuustheid in plaats van validatie op patiëntniveau. Gebruik de deterministische herberekening zoals vermeld in Supplementary File 1.
7. Genereer diagnose-gestratificeerde patronen en het kader voor klinische interpretatie
- Select klinisch relevante hoofdstrata van westerse diagnoses voordat de diagnose-specifieke kruidenverdelingen worden geïnspecteerd.
- Tel elk genormaliseerd kruidenlabel maximaal één keer per bezoek binnen elk diagnose-stratum. Bereken de prevalentie als het aantal bezoeken dat het label bevat, gedeeld door het totaal aantal in aanmerking komende bezoeken in dat stratum.
- Gebruik dezelfde getoonde set kruiden en een vaste kleurenschaal van 0%–100% over de diagnose-strata heen. Toon celwaarden om een exacte interpretatie te behouden.
- Rapporteer de teller en noemer voor elke getoonde cel in een onafhankelijke geaggregeerde tabel.
- Bouw een apart klinisch interpretatiepaneel na voltooiing van de beschrijvende heatmap. Houd berekende resultaten en expertinterpretaties visueel gescheiden.
- Vul de aanwijzingslaag uitsluitend in met termen die herleidbaar zijn naar de versie-geblokkeerde geschiedenis-trefwoordentabel of expliciete genormaliseerde syndroomtekst.
- Vraag twee klinische beoordelaars om overeenstemming te bereiken over beknopte contextuele interpretaties van de geselecteerde aanwijzingen. Registreer de beoordelaars en de definitieve bewoording in het bewijsmagister.
- Koppel elke contextuele interpretatie aan een onderzoeksdoel, zoals variabele selectie, prospectieve validatie of hypothesegeneratie.
- Gebruik gestreepte, niet-directionele verbindingslijnen voor de interpretatielaag. Laat informatie over dosering, vaste samenstelling en behandelingsaanbevelingen weg.
- Beoordeel de heatmap en het interpretatiepaneel samen. Zorg ervoor dat de berekende prevalentie, de expertcontext en het toekomstige onderzoeksgebruik duidelijk gescheiden blijven.
8. Stel het reproduceerbaarheidspakket samen en verifieer dit
- Exporteer het bronmanifest, het cohortmanifest, de woordenboekversies, het bewijsregister, de analysescripts, de aggregaattabellen, de figuurbronnen en de definitieve figuren naar afzonderlijke mappen.
- Benoem elk bestand met een stabiel figuur- of tabelnummer en de versiedatum. Bewaar één gezaghebbende huidige versie en archiveer vervangen resultaten afzonderlijk.
- Genereer elke figuur als één meerdelig afbeeldingsbestand. Exporteer een PDF met een hoge resolutie en een PNG van 300 dpi voor beoordeling.
- Plaats de figuurbijschriften in het manuscript en houd deze buiten de afbeeldingsbestanden. Beschrijf elk paneel, elke analyse-eenheid, de noemer en de visuele codering.
- Bereid voor elke tabel één onafhankelijk XLSX-bestand voor.
- Vraag een onafhankelijke beoordelaar om de getallen in het manuscript te vergelijken met de aggregaattabellen en de percentages met hun tellers en noemers.
- Vergelijk de randen van de regels met de regelentabel en de heatmapcellen met de bronmatrix.
- Voer geautomatiseerde controles uit op consistentie van bestandsnamen, vereiste secties, figuurafmetingen, aantal tabellen, aantal referenties, resten van sjablonen en verboden bewoordingen.
- Vraag het klinische auteursteam om de terminologie, interpretatie, grenzen van intellectueel eigendom, auteurgegevens, volgorde van financiering, ethische bewoordingen en de definitieve set figuren te beoordelen.
- Verwijder bestanden op patiëntniveau, koppelingssleutels, onbeperkte vrije tekst, interne correspondentie en tijdelijke beoordelingsartefacten uit het indieningspakket.
- Bevries het vrijgegeven pakket en leg de versie, datum, checksum, manuscriptversie en de status van goedkeuring door de auteurs vast. Maak een nieuwe versie en een wijzigingslogboek aan voor elke volgende correctie.
Resultaten
Succesvolle toepassing van het protocol resulteerde in een traceerbare keten die de gedeïdentificeerde bronsnapshot, het cohortmanifest, de terminologiewoordenboeken, de aggregaattabellen, de scripts en de definitieve figuren met elkaar verbond. De versie-geblokkeerde screeningsprocedure identificeerde 555 in aanmerking komende receptbezoeken van 396 unieke patiënten. Figuur 1 vat de drie gecoördineerde fasen van de methode samen: governance, terminologienormalisatie en analyse met klinische review. De bijbehorende transparantie- en auditdocumentatie, inclusief de grens voor uitsluitend geaggregeerde gegevens bij AI-ondersteunde review, wordt verstrekt in Aanvullende Tabel 1.
De uiteindelijke cohort bestond uit 555 in aanmerking komende receptbezoeken van 396 unieke patiënten (Figuur 2 en Tabel 1). Daadwerkelijke herhaalbezoeken werden behouden voor dynamische klinische en receptvariabelen, terwijl leeftijd en geslacht werden samengevat na deduplicatie op patiëntniveau. De leeftijd van de patiënten varieerde van 13 tot 94 jaar, met een gemiddelde van 47,11 jaar en een standaarddeviatie van 14,88 jaar. De cohort omvatte 228 vrouwelijke patiënten (57,58%), 167 mannelijke patiënten (42,17%) en 1 patiënt met een onbekend geslacht (0,25%). Deze scheiding van analyse-eenheden behield de longitudinale ontmoetingen zonder de demografische noemer op te blazen.
De ziektespectra volgens de westerse geneeskunde en de Traditionele Chinese Geneeskunde (TCM) zijn samengevat in Figuur 3. Westerse diagnoses waren voornamelijk geconcentreerd in gastro-intestinale, hepatobiliaire en pancreatische aandoeningen. Via hiërarchische groepering werden 271 bezoeken toegewezen aan gastro-intestinale aandoeningen, 222 aan hepatobiliaire of pancreatische aandoeningen en 62 aan andere systemen (Figuur 3A). De belangrijkste individuele diagnoses waren chronische gastritis bij 133 bezoeken (23,96%), vette lever bij 77 bezoeken (13,87%) en levercirrose bij 46 bezoeken (8,29%), gevolgd door chronische atrofische gastritis, buikpijn, chronische hepatitis B, dyspepsie, refluxoesofagitis, chronische oppervlakkige gastritis en chronische pancreatitis (Figuur 3C en Tabel 2).
Het overeenkomstige spectrum van TCM-ziektemodellen organiseerde dezelfde bezoeken volgens een parallel diagnostisch systeem. Ziektebenamingen van de milt-maag of darmen waren verantwoordelijk voor 280 bezoeken, ziektebenamingen van de lever-galblaas voor 223, qi-bloed-vloeistofstoornissen voor 26, geest-borst-hoofdstoornissen voor 12, meridiaan- of ledemaatstoornissen voor 5, gynaecologische stoornissen voor 4 en overige categorieën voor 5 bezoeken (Figuur 3B). Wei pi, een behouden TCM-ziektelabel voor epigastrische volheid of ongemak, werd in 163 bezoeken genoteerd (29,37%). Ji-ziekte (een TCM-bronlabel van het accumulatietype), Gan zhuo (letterlijk: leverfixatie; een behouden klassiek TCM-ziektelabel), Bi-ziekte (obstructieziekte) en Xiao ke (uitputtingsdorst) werden behouden als TCM-bronlabels en zijn niet omgezet in moderne biomedische diagnoses. Gan pi, een TCM-ziektelabel dat wordt gebruikt in de hedendaagse Chinese consensus voor leververvettingsstoornissen, werd in 77 bezoeken genoteerd (13,87%).35De bronvelden voor de westerse geneeskunde en de traditionele Chinese geneeskunde (TCM) bleven onafhankelijk en werden niet door elkaar vervangen (Figuur 3D en Tabel 3). Xie xie (losse of waterige ontlastingen) en Fu xie (diarree) waren aparte oorspronkelijke TCM-ziektelabels, die respectievelijk 6 en 2 keer werden geregistreerd, en geen van beide werd gelijkgesteld aan een moderne biomedische diagnose. Door de twee spectra naast elkaar weer te geven, bleef de logica van elk diagnostisch systeem behouden, terwijl de klinische breedte van de brongegevens werd aangetoond.
Het expliciete genormaliseerde syndroom-tekstveld bevatte 555 in aanmerking komende bezoekrijen. Na deduplicatie binnen het bezoek waren de belangrijkste elementen milt in 362 bezoeken (65,23%), lever in 304 (54,77%), qi-deficiëntie in 295 (53,15%), maag in 171 (30,81%), vochtigheid in 151 (27,21%) en qi-stagnatie in 109 (19,64%; Afbeelding 4A and Tabel 4). Hitte, waterretentie, bloed, bloedstase, kanalen, nier, hart en yin-deficiëntie maakten het restant van het weergegeven spectrum uit. De percentages waren niet-exclusief omdat meerdere syndroomelementen tijdens één bezoek konden voorkomen.
Het netwerk en de telmatrix werden gegenereerd uit dezelfde token-sets op bezoekniveau (Figuur 4B,C). Er was sprake van frequente co-registratie gecentreerd rond milt-, lever- en qi-deficiëntie, met aanvullende verbindingen naar maag, vochtigheid, qi-stagnatie, hitte en waterretentie. Door één versie-gefixeerde matrix te gebruiken voor de frequentieplot, het netwerk en de heatmap, werd gewaarborgd dat alle drie de panelen dezelfde onderliggende bewijsvoering op verschillende detailniveaus vertegenwoordigden. De herstelde audit identificeerde 0 exacte matches tussen syndroomtekst/indicator over 555 rijen en een gemiddelde Jaccard-gelijkenis tussen tekst en indicator van 0,1806. De indicator-kolommen werden daarom uitgesloten van de inhoudelijke rapportage. De behouden materialen bevatten geen reconstrueerbare distributievectoren van vóór de opschoning; bijgevolg is de distributieve stabiliteit tussen versies niet geschat. De sensitiviteitsanalyse van één bezoek per patiënt behandelde in plaats daarvan het effect van herhaalde bezoeken. De resultaten van de bronaudit en de datakwaliteit zijn samengevat in Aanvullende Tabel 2.
Na terminologienormalisatie en het behoud van klinisch relevante bewerkingsvormen bevatten de 555 bezoeken 324 verschillende samengevoegde kruidenlabels en 9.339 instanties van kruidengebruik. Bai Shao werd geregistreerd in 531 bezoeken (95,68%), gevolgd door Fu Ling in 520 (93,69%), Dang Gui in 510 (91,89%), Chi Shao in 467 (84,14%) en geroosterde Bai Zhu in 361 (65,05%); Figuur 5A en Tabel 5). De rang-frequentiecurve van 36 leidende labels vertoonde een steil segment met een hoge frequentie, gevolgd door een geleidelijk breder wordende staart (Figuur 5B), wat een compacte weergave biedt van de componenten voor de gedeelde achtergrond en de geïndividualiseerde voorschriften. De mappings van bron naar genormaliseerde vorm, verwerkingskwalificaties, standaard CMM-namen, bronsoorten en bewijsgrenzen die ten grondslag liggen aan de kruidennomenclatuur zijn gedocumenteerd in Aanvullende tabel 3.
Het aanvullende materia-medica woordenboek bevatte 9.115 eigenschapscoderingen van kruidengebruik. De belangrijkste Four-Qi categorieën waren warm (2.588, 28,39%), licht koud (2.339, 25,66%), neutraal (2.330, 25,56%) en koud (1.221, 13,40%; Figuur 5C). Na normalisatie van de terminologie voor de smaak van verbindingen waren de belangrijkste vijf-smaakcategorieën bitter (4.488, 49,24%), zoet (4.377, 48,02%) en scherp (2.893, 31,74%) (Figuur 5D). De codering van meridiaan-tropisme werd geleid door milt (5.541, 60,79%), lever (4.801, 52,67%), long (3.358, 36,84%), maag (2.988, 32,78%) en hart (2.702, 29,64%; Figuur 5E). Figuur 5F registreert de afzonderlijke analyse-eenheden op visit-niveau en eigenschapscodering en hun link voor reproduceerbaarheid. Samen laten deze panelen zien hoe voorschrijfrequentie en gestandaardiseerde materia-medica descriptoren kunnen worden samengevat zonder verwerkingsspecifieke terminologie te reduceren.
Het vooraf vastgestelde historie-woordenboek bevatte 37 exacte symptoomconcepten. In 474 van de 555 geschikte bezoeken (85,41%) werd ten minste één concept gedetecteerd. De meest voorkomende termen waren droge keel in 178 bezoeken (32,07%), vermoeidheid in 151 (27,21%), slechte slaap in 139 (25,05%), abdominale distensie in 115 (20,72%), acid reflux in 100 (18,02%), bittere smaak in 99 (17,84%), brandend maagzuur in 90 (16,22%), hik in 87 (15,68%), boeren in 87 (15,68%) en dunne ontlasting in 77 (13,87%; Figuur 6A,B en Tabel 6).
De volledige rang-frequentiecurve toonde de volledige distributie van 37 termen, terwijl de cumulatieve lijn de concentratie van alle trefwoorddetecties over de rangen samenvatte (Figuur 6C). Figuur 6D legt de reproduceerbare sequentie vast die is gebruikt om het spectrum te genereren: het woordenboek vastzetten, gede-identificeerde historieteksten scannen, concepten binnen elk bezoek dedupliceren en geaggregeerde aantallen en percentages exporteren.
Voor de associatieregel-mining werd gebruikgemaakt van de versie-geblokkeerde aanwezigheidsmatrix met 555 rijen van recept-bezoek per kruid. Vijftien gerichte enkel-kruidregels voldeden aan de criteria support ≥ 0,30, confidence ≥ 0,70 en lift > 1,0 (Figuur 7A,B en Tabel 7). De behouden support-waarden varieerden van 0,3009 tot 0,7892, de confidence-waarden van 0,7302 tot 0,9748 en de lift-waarden van 1,0010 tot 1,1226.
Het meest frequent samen geregistreerde gerichte paar was Chi Shao > Fu Ling, gebaseerd op 438 bezoeken, met een support van 0,7892, een confidence van 0,9379 en een lift van 1,0010. De omgekeerde regel had dezelfde support en een confidence van 0,8423, wat aantoont waarom de richting van de regel behouden moet blijven. De gevoeligheid van de drempelwaarden behield respectievelijk 18, 11, 21, 14, 7 en 4 regels bij een support ≥ 0,25 of ≥ 0,35, confidence ≥ 0,65 of ≥ 0,75, of lift > 1,02 of > 1,05. In de analyse van één bezoek per patiënt kwam hetzelfde paar voor in 316 bezoeken, met een support van 0,7980, confidence van 0,9489 en lift van 0,9994; daarom werd het niet behouden onder het criterium lift > 1,0. De resultaten van de drempelperturbaties en de gevoeligheid bij herhaalbezoeken zijn opgenomen in Aanvullende Tabel 4, en de deterministische herberekening is opgenomen in Aanvullend Bestand 1. Bijgevolg mag een hoge support op bezoekniveau niet worden geïnterpreteerd als validatie op patiëntniveau.
De hoogste liftwaarden werden waargenomen voor Gan Cao > stir-fried Bai Zhu (1,1226) en Gan Cao > Chi Shao (1,1200). Figuur 7A integreert alle 15 behouden regels in een gericht bipartiet netwerk, waarbij de breedte van de verbinding de support codeert en de kleur van de verbinding de lift codeert. Figuur 7B rangschikt dezelfde regels op basis van lift, schaalt elk punt naar support en annoteert de confidence. De twee panelen maken hiermee onderscheid tussen de netwerktopologie en de kwantitatieve sterkte van de regels, in plaats van dezelfde visuele weergave te dupliceren.
Hiërarchische clustering van de 20 meest frequente kruidvariabelen maakte gebruik van de Jaccard-afstand en gemiddelde koppeling (Figuur 7C). Het dendrogram biedt een globale weergave van de gelijkenis in aanwezigheidspatronen op bezoekniveau, wat complementair is aan de lokale directionele informatie verstrekt door de associatieregels. Samen laten de panelen zien hoe complementaire analytische perspectieven kunnen worden afgestemd op één enkele versie-gefixeerde binaire matrix.
De diagnose-gestratificeerde prevalentie werd berekend voor vetlever (77 bezoeken), levercirrose (46 bezoeken) en chronische gastritis (133 bezoeken; Figuur 8A en Tabel 8). Bai Shao, Fu Ling en Dang Gui vertoonden een hoge prevalentie in alle drie de strata. Bij bezoeken vanwege levercirrose was er sprake van prominente documentatie van Dan Shen (95,65%), azijn-behandeld E Zhu (86,96%), azijn-behandeld Bie Jia (84,78%) en Sheng Huang Qi (60,87%). Bezoeken vanwege vetlever vertoonden een hogere prevalentie van Yin Chen (41,56%) en Ze Xie (31,17%) dan de andere strata, terwijl bezoeken vanwege chronische gastritis een recidiverend gebruik van Huang Lian (44,36%), Mu Xiang (34,59%) en Chai Hu (36,09%) vertoonden. De heatmap biedt derhalve een compacte beschrijvende vergelijking van geaggregeerde voorschrijfpatronen binnen de belangrijkste klinische contexten.
Figuur 8B scheidt de berekening van de interpretatie. Geverifieerde historische aanwijzingen worden gekoppeld aan beknopte expertcontexten en vervolgens aan onderzoeksdoeleinden, waaronder het contextualiseren van syndroomelementen, het vergelijken van diagnose-gestratificeerde patronen, het selecteren van variabelen voor prospectieve validatie en het genereren van vervolgvragen. Dit laatste paneel demonstreert hoe klinische expertise de analytische output kan verrijken, terwijl deze zichtbaar gescheiden blijft van de berekende prevalentie.
Figuur 8C vat de reproduceerbaarheid en de releasegrenzen samen door bron-geverifieerde of geheranalyseerde componenten te onderscheiden van elementen die voorzichtigheid of verdere bevestiging vereisen. Deze laatste auditlaag voorkomt dat onopgeloste of niet reconstrueerbare analytische producten worden gepresenteerd als gevalideerde resultaten.
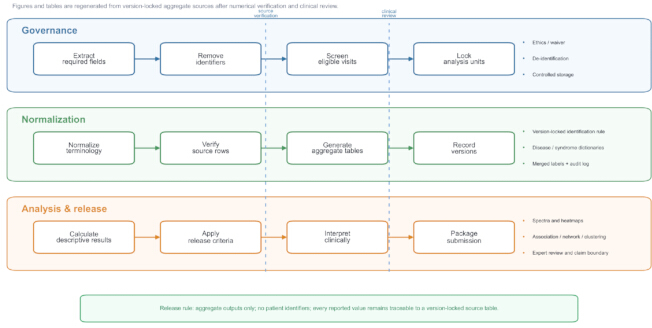
Figuur 1: Workflow voor het minen van brongecontroleerde casusverslagen. Governance, normalisatie van terminologie, geaggregeerde analyse, klinische beoordeling en het pakket voor release worden weergegeven als opeenvolgende fasen van de workflow. Blauwe, groene en oranje banden onderscheiden de domeinen van de workflow, en verticale stippellijnen geven de audit-gates aan. Pijlen geven de volgorde van de workflow aan en impliceren geen biologische causaliteit. De release-regel specificeert dat alleen geaggregeerde outputs worden vrijgegeven, patiëntidentificatoren worden uitgesloten en elke gerapporteerde waarde traceerbaar blijft naar een versie-vergrendelde brontabel. Foutenbalken zijn niet van toepassing. Klik hier om een grotere versie van deze figuur te bekijken.
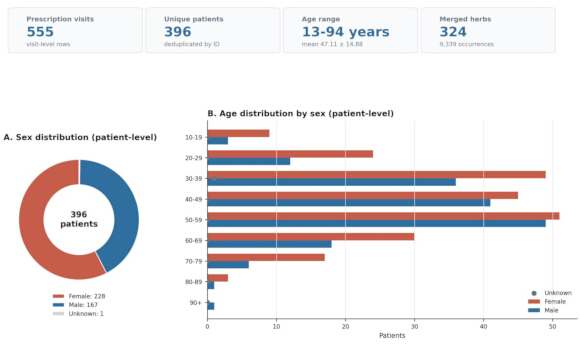
Figuur 2: Datasetprofiel en demografische gegevens op patiëntniveau. De samenvattingsvakken rapporteren 555 voorschrijfbezoeken, 396 unieke patiënten, een leeftijd bereavement op patiëntniveau van 13–94 jaar met een gemiddelde leeftijd van 47,11 ± 14,88 jaar, en 324 samengevoegde kruidenlabels die 9.339 gevallen van kruidengebruik vertegenwoordigen. (A) Geslachtsverdeling op patiëntniveau onder 396 unieke patiënten, inclusief categorieën vrouw, man en onbekend. (B) Leeftijdsverdeling op patiëntniveau per geslacht onder dezelfde 396 patiënten. De samenvattingsvakken maken gebruik van de weergegeven noemers op bezoekniveau of patiëntniveau, indien van toepassing. Kleuren onderscheiden geslachtscategorieën en samenvattingselementen en hebben geen inferentiële betekenis. Klik hier om een grotere versie van deze figuur te bekijken.
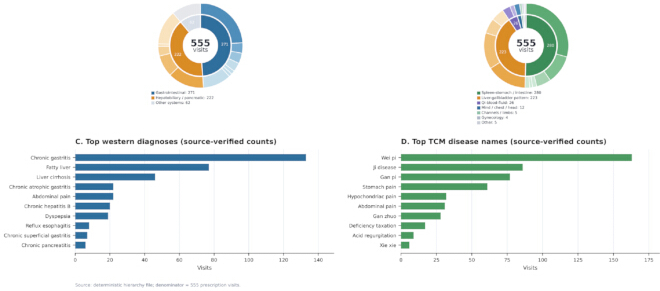
Figuur 3: Ziektespectra verkregen uit receptbezoeken. (A) Hiërarchische westerse ziektegroepen en (B) hiërarchische TCM-ziektegroepen afgeleid van 555 in aanmerking komende receptbezoeken. (C) Leidende genormaliseerde westerse diagnoses en (D) leidende genormaliseerde TCM-ziektenamen uit dezelfde noemer op bezoekniveau. Ringsegmenten en staven vertegenwoordigen het aantal bezoeken; kleuren onderscheiden diagnostische systemen of categorieën en vertegenwoordigen geen behandelingseffecten. Behouden TCM-bronlabels zijn gedefinieerd in Tabel 3: Wei pi (epigastrische volheid of ongemak), Ji-ziekte (accumulatie-type bron-TCM-label), Gan pi (een TCM-ziektelabel gebruikt voor vetleverstoornissen), Gan zhuo (letterlijk, leverfixatie; een behouden klassiek TCM-ziektelabel), Bi-ziekte (belemmeringsziekte), Xiao ke (verkwistingsdorst), Xie xie (lossere of waterige ontlasting) en Fu xie (diarree). Deze glosses zetten de bronlabels niet om in moderne biomedische diagnoses. Klik hier om een grotere versie van deze figuur te bekijken.
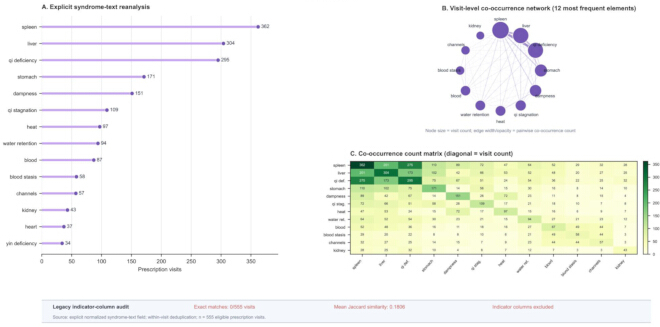
Figuur 4: Expliciet spectrum en co-occurrence-structuur van syndroomteksten. (A) Frequenties op bezoekniveau van 14 genormaliseerde syndroomelementen na deduplicatie binnen bezoeken, waarbij 555 in aanmerking komende voorschrijfbezoeken als noemer zijn gebruikt. (B) Co-occurrence-netwerk van de 12 meest frequente syndroomelementen; de grootte van de knoop representeert de bezoekfrequentie, en de breedte en opaciteit van de verbinding representeren de aantallen paarsgewijze co-occurrences. (C) Bijbehorende symmetrische matrix van co-occurrence-aantallen; de diagonale cellen representeren individuele bezoekfrequenties en de cellen buiten de diagonaal representeren paarsgewijze co-occurrence-aantallen. De auditstrip rapporteert 0 exacte matches tussen syndroomtekst en indicator over 555 rijen en een gemiddelde Jaccard-similariteit tussen tekst en indicator van 0,1806; daarom werden de legacy-indicatorcolommen uitgesloten van de inhoudelijke rapportage. In de matrix staat Qi def. voor qi-deficiëntie, Qi stag. voor qi-stagnatie en Water ret. voor waterretentie. Het kleurenpalet is beschrijvend. Er zijn geen foutenbalken van toepassing. Klik hier om een grotere versie van deze figuur te bekijken.
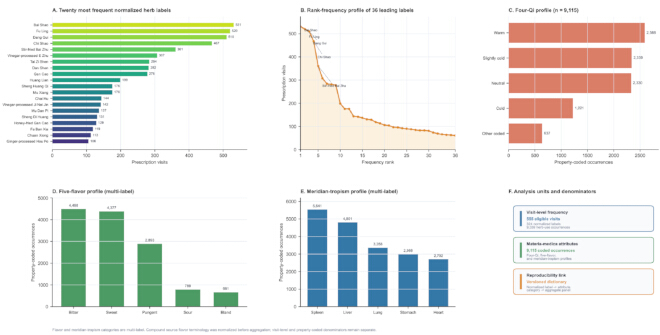
Figuur 5: Hoogfrequente kruiden en genormaliseerde materia medica-attribuutprofielen. (A) De twintig meest voorkomende genormaliseerde kruidenlabels onder 555 in aanmerking komende consulten. (B) Rang-frequentieprofiel van 36 leidende genormaliseerde kruidenlabels. (C) Four-Qi-verdeling gebaseerd op 9.115 eigenschapscoderende kruidengebruiken; Four-Qi is enkelwaardig voor elk gecodeerd gebruik. (D) Vijf-smakenverdeling en (E) meridiaan-tropismeverdelingen gebaseerd op dezelfde eigenschapscoderende noemer; beide zijn multi-label attributen, waardoor de categorie-aantallen niet exclusief zijn. (F) Analyse-eenheden op consultniveau en eigenschapscoderingsniveau en hun reproduceerbaarheidslink. Staaflengtes vertegenwoordigen aantallen en kleuren maken onderscheid tussen de panelen. Foutenbalken zijn niet van toepassing. Klik hier om een grotere versie van deze figuur te bekijken.
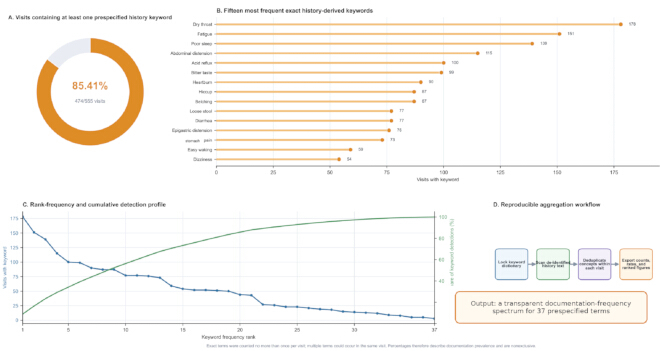
Figuur 6: Spectrum van uit de anamnese afgeleide symptoomtrefwoorden en reproduceerbare aggregatieworkflow. (A) Proportie van 555 geschikte consulten die ten minste één vooraf gespecificeerd anamnese-trefwoord bevatten; 474 consulten (85,41%) bevatten ten minste één trefwoord. (B) Vijftien meest frequente, exact uit de anamnese afgeleide symptoomconcepten. (C) Volledige rang-frequentieverdeling van 37 termen en het cumulatieve aandeel van trefwoorddetecties. (D) Versie-gefixeerde workflow van het vooraf gespecificeerde woordenboek naar de geaggregeerde outputs. Elk concept werd maximaal één keer geteld per consult, terwijl meerdere concepten in hetzelfde consult konden voorkomen. Oranje balken representeren trefwoordaantallen, en de kleuren in de workflow onderscheiden de verschillende verwerkingsfasen. Foutenbalken zijn niet van toepassing. Klik hier om een grotere versie van deze figuur te bekijken.
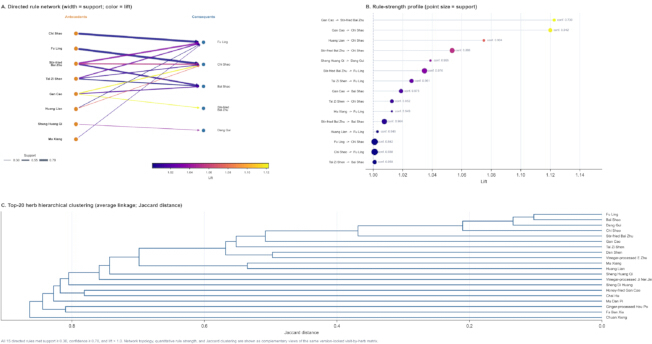
Figuur 7: Gerichte associatieregels voor kruiden en hiërarchische clustering. (A) Gericht bipartiet netwerk van alle 15 associatieregels voor enkelvoudige kruiden die voldoen aan de vooraf vastgestelde drempelwaarden voor support ≥ 0,30, confidence ≥ 0,70 en lift > 1,0. De lijndikte vertegenwoordigt de support en de lijnkleur vertegenwoordigt de lift. (B) Profiel van de regelsterkte van dezelfde 15 regels, gerangschikt op lift; de puntgrootte vertegenwoordigt de support en de aangrenzende labels geven de confidence (conf.) weer. (C) Hiërarchische clustering met average-linkage van de 20 meest voorkomende variabelen voor de aanwezigheid van kruiden met behulp van de Jaccard-afstand. Alle panelen gebruiken receptbezoeken als analyse-eenheid en beschrijven co-registratiepatronen in plaats van effectiviteit, synergie of een aanbevolen vaste combinatie. Foutenbalken zijn niet van toepassing. Klik hier om een grotere versie van deze figuur te bekijken.
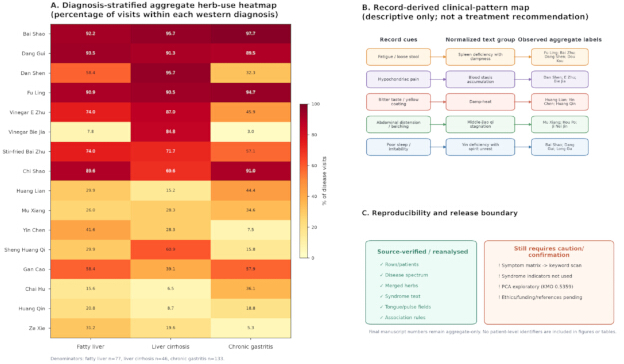
Figuur 8: Op diagnose gestratificeerde aggregaat-kruidenpatronen, klinische patroonkaart en release-grens. (A) Op diagnose gestratificeerde heatmap die de prevalentie op bezoekniveau toont van 16 genormaliseerde kruidenlabels bij vette lever (n = 77), levercirrose (n = 46) en chronische gastritis (n = 133). Elke cel representeert het percentage in aanmerking komende bezoeken binnen het overeenkomstige stratum van de westerse diagnose, met een vaste kleurenschaal van 0%–100%. (B) Op dossiers gebaseerde klinische patroonkaart die geverifieerde aanwijzingen uit dossiers koppelt aan genormaliseerde tekstgroepen en waargenomen aggregaat-kruidenlabels. Gestreepte, niet-directionele connectoren onderscheiden deze beschrijvende interpretatielaag van de berekende prevalentie; het paneel vormt geen behandelaanbeveling. (C) Reproduceerbaarheid en release-grens die bron-geverifieerde of geheranalyseerde componenten onderscheiden van items die voorzichtigheid of bevestiging vereisen. Klik hier om een grotere versie van deze figuur te bekijken.
| Maateenheid | Waarde | Eenheid/noemer | Status |
| Voorschriftbezoeken | 555 | 555 voorschriftbezoeken | geverifieerd vanuit herstelde XLSX |
| Unieke patiënten | 396 | 396 unieke patiënten | geverifieerd vanuit herstelde XLSX |
| Leeftijdsbereik op patiëntniveau | 13-94 | jaar | geverifieerd |
| Gemiddelde leeftijd op patiëntniveau +/- SD | 47.11 +/- 14.88 | jaar | geverifieerd |
| Gemiddelde leeftijd op bezoekniveau +/- SD | 48.22 +/- 15.82 | jaar | geverifieerd |
| Geslacht op patiëntniveau | Vrouw 228; man 167; onbekend 1 | 396 patiënten | geverifieerd |
| Geslacht op bezoekniveau | Vrouw 327; man 227; onbekend 1 | 555 bezoeken | geverifieerd |
| Samengevoegde kruiden | 324 | unieke samengevoegde namen | geverifieerd |
| Aantal voorkomens van samengevoegde kruidengebruiken | 9339 | 555 voorschriftbezoeken | geverifieerd |
Tabel 1: Datasetprofiel. Demografische kenmerken op patiëntniveau en variabelen op niveau van voorschrijfbezoek worden gerapporteerd met gebruik van hun respectievelijke noemers. Genormaliseerde kruidentotalen worden eveneens verstrekt.
| Naam van de ziekte | Telling | Percentage bezoeken |
| Chronische gastritis | 133 | 24 |
| Leververvetting | 77 | 13.9 |
| Levercirrose | 46 | 8.3 |
| Chronische atrofische gastritis | 22 | 4 |
| Buikpijn | 22 | 4 |
| Chronische hepatitis B | 20 | 3.6 |
| Dyspepsie | 19 | 3.4 |
| Refluxoesofagitis | 8 | 1.4 |
| Chronische superficiële gastritis | 7 | 1.3 |
| Chronische pancreatitis | 6 | 1.1 |
| Ulceratieve colitis | 6 | 1.1 |
| Galblaaspoliep | 6 | 1.1 |
| Postcholecystectomiesyndroom | 6 | 1.1 |
| Intestinale dysfunctie | 6 | 1.1 |
| Galstenen | 6 | 1.1 |
| Chronische hepatitis | 5 | 0.9 |
| Vermoeidheid | 5 | 0.9 |
| Gastro-intestinale dysfunctie (onzeker origineel label) | 5 | 0.9 |
| Chronische gastritis (onzeker oorspronkelijk label) | 5 | 0.9 |
| Auto-immuun levercirrose | 4 | 0.7 |
Tabel 2: Belangrijkste genormaliseerde westerse diagnoses. Aantallen en percentages van de belangrijkste genormaliseerde westerse diagnoses vastgesteld tijdens 555 in aanmerking komende receptbezoeken. Voor de percentages is het aantal in aanmerking komende receptbezoeken als noemer gebruikt.
| TCM-ziektenaam | Tellen | Percentage bezoeken |
| Wei pi (epigastrische volheid of ongemak) | 163 | 29.4 |
| Ji-ziekte (accumulatie-type bron-TCM label) | 86 | 15.5 |
| Gan pi (TCM-ziektelabel gebruikt voor leververvettingsstoornissen) | 77 | 13.9 |
| Maagpijn | 61 | 11 |
| Hypochondrische pijn | 32 | 5.8 |
| Buikpijn | 31 | 5.6 |
| Gan zhuo (letterlijk, leverfixatie; een behouden klassieke TCM-ziektelabel) | 28 | 5 |
| Tekortheffing | 17 | 3.1 |
| Zuurregurgitatie | 9 | 1.6 |
| Xie xie (losse of waterige ontlasting) | 6 | 1.1 |
| Slapeloosheid | 4 | 0.7 |
| Dysenterie | 4 | 0.7 |
| Hoofdpijn | 4 | 0.7 |
| Bi-ziekte (belemmeringsziekte) | 4 | 0.7 |
| Menstruatiestoornis | 3 | 0.5 |
| Borstbelemmering | 3 | 0.5 |
| Zweetstoornis | 3 | 0.5 |
| Obstipatie | 3 | 0.5 |
| Fu xie (diarree) | 2 | 0.4 |
| Xiao ke (uitmagrende dorst) | 2 | 0.4 |
Tabel 3: Belangrijkste genormaliseerde TCM-ziektenamen. Aantallen en percentages van de belangrijkste genormaliseerde TCM-ziektenamen geregistreerd over 555 in aanmerking komende receptbezoeken. De percentages gebruiken de in aanmerking komende receptbezoeken als noemer. Behouden bronlabels en verklarende glossen impliceren geen equivalentie met moderne biomedische diagnoses.
| Rangschikking | Syndroomcomponent | Consultaties voor recepten | In aanmerking komende bezoeken | Bezoekpercentage |
| 1 | milt | 362 | 555 | 65.23% |
| 2 | lever | 304 | 555 | 54.77% |
| 3 | qi-deficiëntie | 295 | 555 | 53.15% |
| 4 | maag | 171 | 555 | 30.81% |
| 5 | vochtigheid | 151 | 555 | 27.21% |
| 6 | qi-stagnatie | 109 | 555 | 19.64% |
| 7 | warmte | 97 | 555 | 17.48% |
| 8 | waterretentie | 94 | 555 | 16.94% |
| 9 | Bloed | 87 | 555 | 15.68% |
| 10 | bloedstase | 58 | 555 | 10.45% |
| 11 | kanalen | 57 | 555 | 10.27% |
| 12 | nier | 43 | 555 | 7.75% |
| 13 | hart | 37 | 555 | 6.67% |
| 14 | yin-deficiëntie | 34 | 555 | 6.13% |
Tabel 4: Belangrijkste genormaliseerde syndoomelementen. Syndoomelementen werden geëxtraheerd uit expliciete genormaliseerde syndroomtekst en gededupliceerd binnen elk voorschrijfbezoek. De aantallen gebruiken 555 in aanmerking komende voorschrijfbezoeken als noemer; de percentages zijn niet-exclusief omdat meerdere syndoomelementen binnen één bezoek kunnen voorkomen.
| Samengevoegd kruidenlabel | Telling | Percentage van de bezoeken |
| Bai Shao | 531 | 95.7 |
| Fu Ling | 520 | 93.7 |
| Dang Gui | 510 | 91.9 |
| Chi Shao | 467 | 84.1 |
| Roergebakken Bai Zhu | 361 | 65 |
| Azijn-verwerkte E Zhu | 307 | 55.3 |
| Tai Zi Shen | 284 | 51.2 |
| Dan Shen | 282 | 50.8 |
| Gan Cao | 278 | 50.1 |
| Huang Lian | 199 | 35.9 |
| Sheng Huang Qi | 176 | 31.7 |
| Mu Xiang | 176 | 31.7 |
| Chai Hu | 144 | 25.9 |
| Met azijn bewerkte Ji Nei Jin | 142 | 25.6 |
| Mu Dan Pi | 137 | 24.7 |
| Sheng Di Huang | 131 | 23.6 |
| Honinggefrituurde Gan Cao | 129 | 23.2 |
| Fa Ban Xia | 119 | 21.4 |
| Chuan Xiong | 113 | 20.4 |
| Met gember bewerkte Hou Po | 106 | 19.1 |
| Yin Chen | 104 | 18.7 |
| Sheng Bai Zhu | 97 | 17.5 |
| Dou Kou | 96 | 17.3 |
| Sheng Long Gu | 92 | 16.6 |
| Zhe Bei Mu | 90 | 16.2 |
| Huang Qin | 88 | 15.9 |
| Dang Shen | 85 | 15.3 |
| Met azijn bewerkte Bie Jia | 83 | 15 |
| Gui Zhi | 83 | 15 |
| Sheng Mu Li | 81 | 14.6 |
| Jiao Zhi Zi | 74 | 13.3 |
| He Huan Hua | 69 | 12.4 |
| Met wijn bewerkt Huang Jing | 66 | 11.9 |
| Chen Pi | 64 | 11.5 |
| Ze Xie | 63 | 11.4 |
| Jin Qian Cao | 61 | 11 |
Tabel 5: Belangrijkste genormaliseerde kruidenlabels op basis van frequentie per voorschrijfbezoek. Elk genormaliseerd kruidenlabel is maximaal één keer per voorschrijfbezoek geteld. Aantallen en percentages gebruiken 555 in aanmerking komende voorschrijfbezoeken als noemer, en klinisch relevante verwerkingsvormen zijn als afzonderlijke labels behouden.
| Rang | Uit geschiedenis afgeleid trefwoord | Voorschrijfbezoeken | In aanmerking komende bezoeken | Bezoekpercentage |
| 1 | Droge keel | 178 | 555 | 32.07% |
| 2 | Vermoeidheid | 151 | 555 | 27.21% |
| 3 | Slechte slaap | 139 | 555 | 25.05% |
| 4 | Buikopblazing | 115 | 555 | 20.72% |
| 5 | Zuurreflux | 100 | 555 | 18.02% |
| 6 | Bittere smaak | 99 | 555 | 17.84% |
| 7 | Brandend maagzuur | 90 | 555 | 16.22% |
| 8 | Hik | 87 | 555 | 15.68% |
| 9 | Boeren | 87 | 555 | 15.68% |
| 10 | Zachte ontlasting | 77 | 555 | 13.87% |
| 11 | Diarree | 77 | 555 | 13.87% |
| 12 | Epigastrische distensie | 76 | 555 | 13.69% |
| 13 | Maagpijn | 73 | 555 | 13.15% |
| 14 | Snel wakker worden | 59 | 555 | 10.63% |
| 15 | Duizeligheid | 54 | 555 | 9.73% |
| 16 | Braken | 52 | 555 | 9.37% |
| 17 | Misselijkheid | 52 | 555 | 9.37% |
| 18 | Stomme pijn | 51 | 555 | 9.19% |
| 19 | Spanningspijn | 50 | 555 | 9.01% |
| 20 | Gebrek aan eetlust | 44 | 555 | 7.93% |
| 21 | Buikpijn | 43 | 555 | 7.75% |
| 22 | Druk op de borst | 27 | 555 | 4.86% |
| 23 | Prikkelbaarheid | 26 | 555 | 4.68% |
| 24 | Hoofdpijn | 23 | 555 | 4.14% |
| 25 | Borborygmus | 23 | 555 | 4.14% |
| 26 | Epigastrisch ongemak | 21 | 555 | 3.78% |
| 27 | Hartkloppingen | 19 | 555 | 3.42% |
| 28 | Gele urine | 18 | 555 | 3.24% |
| 29 | Vreemd-lichaamsgevoel | 15 | 555 | 2.70% |
| 30 | Stekende pijn | 14 | 555 | 2.52% |
| 31 | Constipatie | 13 | 555 | 2.34% |
| 32 | Slaperigheid | 12 | 555 | 2.16% |
| 33 | Faryngeaal vreemd-lichaamsgevoel | 9 | 555 | 1.62% |
| 34 | Overmatig zweten | 8 | 555 | 1.44% |
| 35 | Hypochondrische pijn | 5 | 555 | 0.90% |
| 36 | Tenesmus | 5 | 555 | 0.90% |
| 37 | Droge ontlasting | 3 | 555 | 0.54% |
Tabel 6: Belangrijkste symptoomtrefwoorden afgeleid uit de voorgeschiedenis. Exacte symptoomconcepten gedetecteerd in gedeïdentificeerde tekst van de voorgeschiedenis. Elk concept werd maximaal één keer geteld per voorschrijfbezoek, terwijl meerdere concepten binnen hetzelfde bezoek konden voorkomen. Aantallen en percentages maken gebruik van 555 in aanmerking komende voorschrijfbezoeken als noemer.
| Antecedent | Gevolg | Gelijktijdige bezoeken | Ondersteuning | Betrouwbaarheid | Tillen |
| Chi Shao | Fu Ling | 438 | 0.7892 | 0.9379 | 1.0010 |
| Fu Ling | Chi Shao | 438 | 0.7892 | 0.8423 | 1.0010 |
| Gebakken Bai Zhu | Fu Ling | 350 | 0.6306 | 0.9695 | 1.0348 |
| Gewokte Bai Zhu | Bai Shao | 348 | 0.6270 | 0.9640 | 1.0076 |
| Gewokte Bai Zhu | Chi Shao | 320 | 0.5766 | 0.8864 | 1.0535 |
| Tai Zi Shen | Fu Ling | 273 | 0.4919 | 0.9613 | 1.0260 |
| Tai Zi Shen | Bai Shao | 272 | 0.4901 | 0.9577 | 1.0010 |
| Gan Cao | Bai Shao | 271 | 0.4883 | 0.9748 | 1.0189 |
| Gan Cao | Chi Shao | 262 | 0.4721 | 0.9424 | 1.1200 |
| Tai Zi Shen | Chi Shao | 242 | 0.4360 | 0.8521 | 1.0127 |
| Gan Cao | Gebakken Bai Zhu | 203 | 0.3658 | 0.7302 | 1.1226 |
| Huang Lian | Fu Ling | 187 | 0.3369 | 0.9397 | 1.0029 |
| Huang Lian | Chi Shao | 180 | 0.3243 | 0.9045 | 1.0750 |
| Sheng Huang Qi | Dang Gui | 168 | 0.3027 | 0.9545 | 1.0388 |
| Mu Xiang | Fu Ling | 167 | 0.3009 | 0.9489 | 1.0127 |
Tabel 7: Gerichte associatieregels voor kruiden die voldoen aan de vooraf gespecificeerde drempelwaarden. Regels werden gegenereerd uit 555 binaire rijen met voorschrijfbezoeken met een support ≥ 0.30, confidence ≥ 0.70 en lift > 1.0. Support gebruikt 555 voorschrijfbezoeken als noemer, en de richting van de regel is behouden omdat confidence directioneel is.
| Kruidenlabel | Leververvetting (n) | Leververvetting (N) | Leververvetting (%) | Levercirrose (n) | Levercirrose (N) | Levercirrose (%) | Chronische gastritis (n) | Chronische gastritis (N) | Chronische gastritis (%) |
| Bai Shao | 71 | 77 | 92.21% | 44 | 46 | 95.65% | 130 | 133 | 97.74% |
| Dang Gui | 72 | 77 | 93.51% | 42 | 46 | 91.30% | 119 | 133 | 89.47% |
| Dan Shen | 45 | 77 | 58.44% | 44 | 46 | 95.65% | 43 | 133 | 32.33% |
| Fu Ling | 70 | 77 | 90.91% | 43 | 46 | 93.48% | 126 | 133 | 94.74% |
| Azijn-behandelde E Zhu | 57 | 77 | 74.03% | 40 | 46 | 86.96% | 61 | 133 | 45.86% |
| Azijn-verwerkt Bie Jia | 6 | 77 | 7.79% | 39 | 46 | 84.78% | 4 | 133 | 3.01% |
| Roergebakken Bai Zhu | 57 | 77 | 74.03% | 33 | 46 | 71.74% | 76 | 133 | 57.14% |
| Chi Shao | 69 | 77 | 89.61% | 32 | 46 | 69.57% | 121 | 133 | 90.98% |
| Huang Lian | 23 | 77 | 29.87% | 7 | 46 | 15.22% | 59 | 133 | 44.36% |
| Mu Xiang | 20 | 77 | 25.97% | 13 | 46 | 28.26% | 46 | 133 | 34.59% |
| Yin Chen | 32 | 77 | 41.56% | 13 | 46 | 28.26% | 10 | 133 | 7.52% |
| Sheng Huang Qi | 23 | 77 | 29.87% | 28 | 46 | 60.87% | 21 | 133 | 15.79% |
| Gan Cao | 45 | 77 | 58.44% | 18 | 46 | 39.13% | 77 | 133 | 57.89% |
| Chai Hu | 12 | 77 | 15.58% | 3 | 46 | 6.52% | 48 | 133 | 36.09% |
| Huang Qin | 16 | 77 | 20.78% | 4 | 46 | 8.70% | 25 | 133 | 18.80% |
| Ze Xie | 24 | 77 | 31.17% | 9 | 46 | 19.57% | 7 | 133 | 5.26% |
Tabel 8: Prevalentie van kruidengebruik gestratificeerd naar diagnose. Tellers, noemers en prevalentie op bezoekniveau van 16 genormaliseerde kruidenlabels bij vetlever (n = 77), levercirrose (n = 46) en chronische gastritis (n = 133). Elk kruidenlabel werd maximaal één keer geteld per in aanmerking komend voorschrijfbezoek.
Aanvullende Tabel 1: AI-ondersteunde transparantie- en auditrapportage. Documentatie waarin het verslag van de oorspronkelijke analyse wordt onderscheiden van de consistentiebeoordeling in de revisiefase, uitgevoerd op 21 augustus 2026. De tabel bevat de tool/het model/de versie, de reikwijdte van de input, het doel, de geïdentificeerde mismatch in de cardinaliteit van de Four-Qi, de menselijke correctie, gebruiksbeperkingen, informatie over de beoordelaar, de afhandeling en het prompt-sjabloon. Er zijn geen ruwe gegevens op patiëntniveau aan het AI-systeem verstrekt. Klik hier om dit bestand te downloaden.
Aanvullende tabel 2: Uitkomsten van de datakwaliteit van de bronaudit. De volledigheid van de herstelde velden, auditbevindingen, analytische acties en vrijgegeven statussen worden gerapporteerd voor bronvelden uit de klinische gegevens en legacy-analytische structuren. De tabel documenteert de uitsluiting van niet-verzoende legacy-syndroomindicatoren, de correctie van eerdere totalen van kruiden, de afwezigheid van reconstrueerbare distributievectoren vóór de opschoning voor de schatting van de stabiliteit over versies heen, en hoeveelheden die niet gereconstrueerd konden worden. Klik hier om dit bestand te downloaden.
Aanvullende tabel 3: Mapping van kruidennomenclatuur. Gecontroleerde weergavelabels van kruiden zijn gekoppeld aan verwerkingskwalificaties, standaardnamen van Chinese medicinale materialen (CMM), bronterminologie, botanische, zoölogische of minerale bronnen, referentieversies, bewijslocatoren en bewijsgrenzen. Verwerkingsspecifieke labels zijn behouden waar deze klinisch relevant zijn. Klik hier om dit bestand te downloaden.
Aanvullende tabel 4: Drempelwaarde- en herhaalbezoek-gevoeligheidsanalyses. Perturbaties van de drempelwaarde voor associatieregels, vergelijkingen van regelsets met één bezoek per patiënt, gevoeligheidsstatistieken voor Chi Shao > Fu Ling en de afstandvergelijking van de clustering-input voor 190 paren worden gerapporteerd. Klik hier om dit bestand te downloaden.
Aanvullend bestand 1: Script voor deterministische drempelwaarde en gevoeligheid voor herhaalbezoeken. Deterministisch script dat is gebruikt om geaggregeerde drempelwaarde- en gevoeligheidsmetrieken voor herhaalbezoeken te reproduceren uit de versie-geblokkeerde brondata-set. Het bestand bevat geen gegevens op patiëntniveau. Klik hier om dit bestand te downloaden.
Discussie
De centrale bijdrage van dit protocol is een volledig en controleerbaar traject van gede-identificeerde TCM-patiëntendossiers naar geaggregeerde onderzoeksfiguren. De meest kritische stappen zijn het vastleggen van de cohort-identificatieregel voordat de analytische resultaten worden geïnspecteerd, het onderscheid maken tussen unieke patiënten en voorschrijfbezoeken, het behouden van elke koppeling van oorspronkelijke naar genormaliseerde termen, en het verifiëren van elke teller en noemer voor de visualisatie. Deze controles transformeren datacleaning van een onzichtbare preliminaire activiteit naar een gedocumenteerd onderdeel van de methode. Ze zorgen er ook voor dat de workflow in overeenstemming is met RECORD, STROBE, FAIR en gevestigde kaders voor de datakwaliteit van EPD11,12,13,14,15. Een resultaat wordt pas als gereed voor publicatie beschouwd wanneer het bronveld, de analyse-eenheid, de woordenboekversie, de berekeningsregel, de noemer, de tabel, de figuur en de beslissing van de reviewer in het bewijskader kunnen worden teruggevonden.
De methode is innovatief omdat governance, terminologierekayasa, computation, visualisatie en klinische review zijn geïntegreerd in plaats van als afzonderlijke taken te worden behandeld. Een enkele expliciete syndroommatrix genereert het frequentiespectrum, het co-occurrentienetwerk en de heatmap. Een enkele matrix van recept-bezoek-per-kruid ondersteunt frequentiesamenvattingen, gerichte associatieregels en hiërarchische clustering19,20,21. Een enkele op diagnose gestratificeerde tabel ondersteunt zowel exacte percentages als de uiteindelijke heatmap. De analytische workflow maakt gebruik van gescripte, reproduceerbare open-source tools36,37,38,39,40, waardoor een correctie in een bovenstrooms woordenboek of cohortbeslissing kan worden doorgevoerd in alle afhankelijke output. Eerder werk met klinische datawarehouses demonstreert evenzo het belang van brongekoppelde preprocessing en gestructureerd hergebruik van gegevens41,42. Deze architectuur vermindert handmatige transcriptie, handhaaft de uitlijning tussen grafische coderingen en brontabellen, en faciliteert auditing, onderwijs en overdracht naar andere onderzoeksteams.
Drie recente database-miningstudies bieden nuttige ontwerpprincipes, hoewel hun analyse-eenheid een publicatie is in plaats van een klinisch bezoek. De studie naar reumatoïde artritis en depressie combineert een vooraf gedefinieerde zoekstrategie met analyses van land, instelling, auteur, tijdschrift, trefwoord en tijdlijn26. De studie naar colitis ulcerosa en Januskinase-remmers maakt gebruik van gecoördineerde samenwerking, co-citatie, clustering en burst-analyses om persistente thema's te onderscheiden van opkomende onderzoeksfronten27. De studie naar reumatoïde artritis en fibromyalgie breidt bibliometrische mapping uit met bio-informatica, terwijl een onderscheid tussen de twee bewijslagen wordt gehandhaafd28. Het huidige protocol past hetzelfde principe van gecoördineerde, maar niet-uitwisselbare analytische perspectieven toe. Overdracht naar gynaecologie, respiratoire geneeskunde, reumatologie of een andere specialisatie vereist de reconstructie van specialisme-specifieke velden, terminologiewoordenboeken, in- en exclusieregels, uitkomsten en klinische beoordelingsprocedures voordat de regelset opnieuw kan worden gebruikt. Ziekte-spectra, syndroomnetwerken, symptoomtrefwoorden, associatieregels, clustering en diagnose-gestratificeerde patronen komen allemaal voort uit versie-gefixeerde bronnen, maar elk beantwoordt een specifieke vraag en behoudt zijn eigen noemer en interpretatiegrens.
Door mensen getoezichte AI kan een extra laag van kwaliteitscontrole bieden wanneer deze wordt beperkt tot goedgekeurde, gedeïdentificeerde fragmenten of geaggregeerde materialen. Binnen deze workflow kan AI terminologie tussen bestanden vergelijken, inconsistenties tussen bijschriften en tabellen markeren, labels identificeren die buiten de grenzen van figuren vallen, verifiëren of elke weergegeven netwerkknoop een geldige verbinding heeft en duidelijkere bewoordingen suggereren. AI bepaalt geen geschiktheid van cohorten, verzint geen terminologiekoppelingen, leidt geen behandelingseffecten af en vervangt geen beoordeling van brongegevens. Deze taakverdeling is in lijn met de bredere visie dat medische AI het menselijk oordeel moet ondersteunen in plaats van de verantwoordelijkheid te vertroebelen33. Het weerspiegelt daarnaast de nadruk van DECIDE-AI op transparante menselijke factoren, foutafhandeling en verantwoorde evaluatie34. Daarom moeten het doel van elke prompt, de beoordeelde output, de geaccepteerde correctie, de beoordelaar en de datum worden bewaard in het auditlogboek wanneer AI-ondersteuning wordt gebruikt.
Het oplossen van problemen is bijzonder belangrijk wanneer een resultaat klinisch plausibel lijkt, maar niet voldoet aan de bronreconciliatie. In dergelijke gevallen moet de verdere interpretatie worden opgeschort totdat de discrepantie is teruggevoerd naar de bepaling van de geschiktheid, deduplicatie, terminologiemapping, veldselectie, keuze van de noemer of de samenstelling van de figuren. Alle afhankelijke resultaten moeten na correctie opnieuw worden gegenereerd. Het uitgewerkte voorbeeld blijft een retrospectieve dataset van één centrum met expert-polikliniekpatiënten, waarin herhaalde bezoeken niet onafhankelijk van elkaar zijn. De sensitiviteitsanalyse van één bezoek per patiënt reduceerde de behouden regelset van 15 naar 12, terwijl het lidmaatschap van alle 20 belangrijkste kruiden behouden bleef. Over alle 190 ongeordende paren onder deze 20 gedeelde variabelen was de Pearson-correlatie 0,9944, de Spearman-rho 0,9836, de gemiddelde absolute verandering in de Jaccard-afstand 0,0146 en de maximale verandering 0,0528 (Aanvullende tabel 4). Bijgevolg dient een hoge ondersteuning op bezoekniveau niet te worden geïnterpreteerd als validatie op patiëntniveau. Het spectrum van geschiedenis-trefwoorden weerspiegelt de letterlijke documentatie in plaats van een gevalideerde symptoomscala. Samenvattingen van de materia medica zijn gewogen op basis van frequentie in plaats van dosis. Associatieregels beschrijven het gezamenlijk vastleggen in plaats van causaliteit. Diagnose-gestratificeerde heatmaps zijn beschrijvend en stellen geen vergelijkende effectiviteit, ziektespecificiteit of behandelingsnoodzaak vast.
Het protocol kan worden toegepast op onderzoek naar de overdracht van klinische expertise, de beschrijving van cohorten van specialistische poliklinieken, harmonisatie van terminologie in multicenterstudies, kwaliteitsbeoordeling van documentatie, variabele selectie voor prospectieve registers en privacybewuste voorbereiding van geaggregeerde samenwerkingsdatasets. Toekomstig werk kan prospectieve gestructureerde symptoomverzameling, patiëntgeclusterde modellen, expliciete dosisvariabelen, vooraf gespecificeerde vergelijkende hypothesen, externe validatie, geversioneerde terminologiediensten, privacybewuste berekeningen en interactieve bewijslagers bevatten. Natural-language processing en AI-ondersteunde review kunnen repetitieve curatie verder verminderen wanneer deze worden aangestuurd door versie-gefixeerde regels en menselijke verificatie. In bredere zin stelt het protocol in staat om verspreide klinische ervaring om te vormen tot een transparant onderzoeksobject dat kan worden geïnspecteerd, gereproduceerd, betwist en uitgebreid. De methode zet frequentie niet om in effectiviteit; in plaats daarvan zet het ongedocumenteerde analytische beslissingen om in zichtbaar bewijs, wat een basis biedt voor striktere klinische vragen en duurzamer real-world TCM-onderzoek.
Openbaarmakingen
De auteurs verklaren dat er geen concurrerende belangen zijn.
Dankbetuigingen
OpenAI Codex (gpt-5.6-luna en gpt-5.6-sol) werd uitsluitend gebruikt tijdens de revisie van het manuscript voor consistentiecontroles op aggregaatniveau over verschillende bestanden en voor suggesties met betrekking tot de formulering. Er zijn geen gegevens op patiëntniveau aan het AI-systeem verstrekt. Alle door AI ondersteunde resultaten werden op 21 augustus 2026 onafhankelijk geverifieerd aan de hand van de bronmaterialen door Tian Xia. De auteurs hebben de uiteindelijke inhoud beoordeeld en goedgekeurd en dragen de volledige verantwoordelijkheid voor het manuscript. Dit project werd ondersteund door het National Key Research and Development Program of China, Key Special Project on Modernization of Traditional Chinese Medicine (No. 2025YFC3512800); het National Science and Technology Major Project of China (Project No. 2026ZD0554100; Subproject No. 2026ZD0554101); het Central High-level Traditional Chinese Medicine Hospital Clinical Research and Achievement Translation Capacity Improvement Project, Special Project for Inheriting the Academic Experience of Renowned Senior Traditional Chinese Medicine Experts (No. HLCMHPP2023016); en de Natural Science Foundation of Xinjiang Uygur Autonomous Region (No. 2025D01C213).
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Spreadsheets voor geaggregeerde reanalyse | Door auteur gegenereerde lokale bestanden | Niet van toepassing | Gebruikt voor geaggregeerde tellingen, tabellen en het genereren van figuren. |
| Geanonimiseerde export van poliklinische dossiergegevens | Institutioneel elektronisch medisch dossier-systeem | Niet van toepassing | Alleen gebruikt in de gecontroleerde institutionele omgeving; records op patiëntniveau maken geen deel uit van de indieningsmaterialen. |
| lxml | lxml project | 6.1.1 | Softwareversie gebruikt voor namespace-bewarende serialisatie tijdens regeneratie in de revisiefase; geen historische versie van de oorspronkelijke analyse. |
| Matplotlib | Matplotlib project (matplotlib.org) | 3.11.1 | Versie waargenomen in de regeneratieomgeving van de revisiefase en SVG-metadata van Figuur 3; geen historische versie van de oorspronkelijke analyse. |
| NetworkX | NetworkX project | PyPI package: networkx | Package-identificatie geregistreerd; de exacte versie uit de revisiefase is niet geverifieerd in de overgenomen omgeving. |
| NumPy | NumPy project | 2.3.5 | Softwareversie gebruikt om de herziene geaggregeerde outputs te regenereren; geen historische versie van de oorspronkelijke analyse. |
| openpyxl | openpyxl project | 3.1.5 | Softwareversie gebruikt om de herziene geaggregeerde XLSX-outputs te schrijven; geen historische versie van de oorspronkelijke analyse. |
| pandas | pandas project | 3.0.1 | Softwareversie gebruikt om de herziene geaggregeerde outputs te regenereren; geen historische versie van de oorspronkelijke analyse. |
| PyMuPDF | PyMuPDF project | 1.28.2 | Softwareversie gebruikt voor regeneratie van herziene figuur-outputs in de revisiefase; geen historische versie van de oorspronkelijke analyse. |
| Python | Python Software Foundation | 3.13.15 | Softwareversie gebruikt om de herziene geaggregeerde outputs te regenereren; geen historische versie van de oorspronkelijke analyse. |
| SciPy | SciPy project | PyPI package: scipy | Package-identificatie geregistreerd; de exacte versie uit de revisiefase is niet geverifieerd in de overgenomen omgeving. |
Referenties
- Wang YH, et al. Study on knowledge discovery in traditional Chinese medical case records [in Chinese]. Zhong Xi Yi Jie He Xue Bao. 2007;5(4):368-372.
- Wang Y, et al. Automatic symptom name normalization in clinical records of traditional Chinese medicine. BMC Bioinformatics. 2010;11:40.
- Zhou L, et al. Natural language processing algorithms for normalizing expressions of synonymous symptoms in traditional Chinese medicine. Evid Based Complement Alternat Med. 2021;2021:6676607.
- Chu X, et al. Quantitative knowledge presentation models of traditional Chinese medicine (TCM): a review. Artif Intell Med. 2020;103:101810.
- Zhang T, et al. Constructing fine-grained entity recognition corpora based on clinical records of traditional Chinese medicine. BMC Med Inform Decis Mak. 2020;20:64.
- Wang Q, et al. A study of entity-linking methods for normalizing Chinese diagnosis and procedure terms to ICD codes. J Biomed Inform. 2020;105:103418.
- Zhang H, et al. Transformer- and generative adversarial network-based inpatient traditional Chinese medicine prescription recommendation: development study. JMIR Med Inform. 2022;10(5):e35239.
- Dan W, et al. SinoMedminer: an R package and Shiny application for mining and visualizing traditional Chinese medicine herbal formulas. Chin Med. 2025;20:80.
- Chinese Pharmacopoeia Commission. Pharmacopoeia of the People's Republic of China. 2025 ed. China Medical Science and Technology Press; Beijing; 2025.
- Editorial Committee of Zhonghua Bencao, State Administration of Traditional Chinese Medicine. Zhonghua Bencao. 10 vols. Shanghai Scientific and Technical Publishers; Shanghai; 1999. ISBN: 7532351068. Available from: National Diet Library record
- Benchimol EI, et al. The REporting of studies Conducted using Observational Routinely-collected health Data (RECORD) statement. PLoS Med. 2015;12(10):e1001885.
- von Elm E, et al. The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: guidelines for reporting observational studies. Lancet. 2007;370(9596):1453-1457.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Weiskopf NG, Weng C. Methods and dimensions of electronic health record data quality assessment: enabling reuse for clinical research. J Am Med Inform Assoc. 2013;20(1):144-151.
- Kahn MG, et al. A harmonized data quality assessment terminology and framework for the secondary use of electronic health record data. EGEMS (Wash DC). 2016;4(1):18.
- Kovačević A, Bašaragin B, Milošević N, Nenadić G. De-identification of clinical free text using natural language processing: a systematic review of current approaches. Artif Intell Med. 2024;151:102845.
- Meystre SM, et al. Text de-identification for privacy protection: a study of its impact on clinical text information content. J Biomed Inform. 2014;50:142-150.
- Neamatullah I, et al. Automated de-identification of free-text medical records. BMC Med Inform Decis Mak. 2008;8:32.
- Agrawal R, Srikant R. Fast algorithms for mining association rules in large databases. Presented at: 20th International Conference on Very Large Data Bases; Santiago, Chile; 1994. p. 487-499.
- Hahsler M, Grün B, Hornik K. arules: a computational environment for mining association rules and frequent item sets. J Stat Softw. 2005;14(15):1-25.
- Murtagh F, Contreras P. Algorithms for hierarchical clustering: an overview. WIREs Data Min Knowl Discov. 2012;2(1):86-97.
- van Eck NJ, Waltman L. Software survey: VOSviewer, a computer program for bibliometric mapping. Scientometrics. 2010;84(2):523-538.
- Chen C. CiteSpace II: detecting and visualizing emerging trends and transient patterns in scientific literature. J Am Soc Inf Sci Technol. 2006;57(3):359-377.
- Aria M, Cuccurullo C. bibliometrix: an R-tool for comprehensive science mapping analysis. J Informetr. 2017;11(4):959-975.
- Donthu N, et al. How to conduct a bibliometric analysis: an overview and guidelines. J Bus Res. 2021;133:285-296.
- Zhao Y, Chen GY, Fang M. Research trends of rheumatoid arthritis and depression from 2019 to 2023: a bibliometric analysis. J Multidiscip Healthc. 2024;17:4465-4474.
- Wang Y, et al. Research trends and hotspots in JAK inhibitors for ulcerative colitis: a bibliometric analysis from 2015 to 2024. J Multidiscip Healthc. 2025;18:6755-6771.
- Chen G, Yan Z, Wang Y, Tao Q. Rheumatoid arthritis and fibromyalgia syndrome: a bibliometric and bioinformatics perspective on comorbidity research. J Multidiscip Healthc. 2025;18:6811-6827.
- Wang SL, et al. Yao Naili's experience in applying the harmonizing liver and spleen method. Journal of Traditional Chinese Medicine. 2008;49(7):596-597.
- Wang L, et al. Analysis of Professor Naili Yao's experience in treating spleen-stomach diseases [in Chinese]. Lishizhen Med Mater Med Res. 2022;33(6):1436-1438.
- Sandve GK, Nekrutenko A, Taylor J, Hovig E. Ten simple rules for reproducible computational research. PLoS Comput Biol. 2013;9(10):e1003285.
- Munafò MR, et al. A manifesto for reproducible science. Nat Hum Behav. 2017;1:0021.
- Topol EJ. High-performance medicine: the convergence of human and artificial intelligence. Nat Med. 2019;25(1):44-56.
- Vasey B, et al. Reporting guideline for the early-stage clinical evaluation of decision support systems driven by artificial intelligence: DECIDE-AI. Nat Med. 2022;28(5):924-933.
- Branch of Gastrointestinal Diseases, China Association of Chinese Medicine. Expert consensus on traditional Chinese medicine diagnosis and treatment of Gan pi (2023). Chinese Journal of Integrative Digestive Diseases. 2024;32(9):741-747.
- McKinney W. Data structures for statistical computing in Python [conference paper]. Presented at: 9th Python in Science Conference; Austin, TX; 2010. p. 56-61. doi:10.25080/Majora-92bf1922-00a.
- Harris CR, et al. Array programming with NumPy. Nature. 2020;585(7825):357-362.
- Virtanen P, et al. SciPy 1.0: fundamental algorithms for scientific computing in Python. Nat Methods. 2020;17(3):261-272.
- Hunter JD. Matplotlib: a 2D graphics environment. Comput Sci Eng. 2007;9(3):90-95.
- Hagberg AA, Schult DA, Swart PJ. Exploring network structure, dynamics, and function using NetworkX. Presented at: 7th Python in Science Conference; Pasadena, CA; 2008. p. 11-15. doi:10.25080/TCWV9851.
- Zhou X, et al. Development of traditional Chinese medicine clinical data warehouse for medical knowledge discovery and decision support. Artif Intell Med. 2010;48(2-3):139-152.
- Liu B, et al. Data processing and analysis in real-world traditional Chinese medicine clinical data: challenges and approaches. Stat Med. 2012;31(7):653-660.