Dit protocol presenteert een reproduceerbare workflow voor het ontwikkelen, evalueren en interpreteren van verklaarbare modellen voor kunstmatige intelligentie in de gezondheidszorg. Het integreert gestandaardiseerde datapreparatie, modelontwikkeling, technieken voor verklaarbaarheid, kwantitatieve evaluatie en praktijken voor reproduceerbaarheid om de transparantie, betrouwbaarheid en klinische toepasbaarheid te verbeteren.
Methodenartikel
Een reproduceerbaar experimenteel protocol voor het ontwikkelen en evalueren van verklaarbare kunstmatige intelligentiemodellen in gezondheidszorgsystemen
In dit artikel
Samenvatting
Samenvatting
Kunstmatige intelligentie (AI) wordt in toenemende mate aangenomen als een waardevol hulpmiddel voor klinische besluitvorming, ziektevoorspelling, medische diagnose en gepersonaliseerde gezondheidszorg. Echter blijven een gebrek aan transparantie, inconsistente implementatie van methoden voor uitlegbare kunstmatige intelligentie (XAI) en beperkte reproduceerbaarheid belangrijke barrières voor de betrouwbare inzet van AI-modellen in klinische omgevingen. Dit artikel stelt een systematisch, reproduceerbaar en transparant protocol voor voor het ontwikkelen, evalueren en interpreteren van uitlegbare AI-modellen voor toepassingen in de gezondheidszorg. De workflow begint met de configuratie van de computationele omgeving, gevolgd door data-acquisitie en karakterisering, preprocessing, feature engineering, modelontwikkeling, hyperparameteroptimalisatie, evaluatie van de voorspellende prestaties, uitlegbaarheidsanalyse, statistische validatie en reproduceerbaarheidsbeoordeling. Het protocol bevat XAI-methoden zoals SHapley Additive exPlanations (SHAP), Local Interpretable Model-agnostic Explanations (LIME), Gradient-weighted Class Activation Mapping (Grad-CAM), Integrated Gradients, attention-visualisatie en counterfactual explanations om zowel globale als lokale modelinterpretaties te genereren. Het protocol benadrukt verschillende kerncomponenten, waaronder de voorbereiding van gestandaardiseerde datasets voor de gezondheidszorg, de ontwikkeling van stabiele machine learning-modellen, de evaluatie van de voorspellende prestaties, het genereren van klinisch relevante verklaringen en de statistische beoordeling van de reproduceerbaarheid over herhaalde experimenten. Door modelontwikkeling, uitlegbaarheid, kwantitatieve en kwalitatieve evaluatie, statistische validatie en reproduceerbaarheidsbeoordeling te integreren in een uniforme workflow, biedt dit protocol een uitgebreid kader voor de ontwikkeling van transparante en reproduceerbare AI-modellen voor toepassingen in de gezondheidszorg.
Inleiding
AI is een integraal onderdeel geworden van de moderne gezondheidszorg door intelligente analyse van complexe klinische gegevens mogelijk te maken en evidence-based medische besluitvorming te ondersteunen1. De snelle digitalisering van de gezondheidszorg via elektronische patiëntendossiers, medische beeldvormingssystemen, wearables en genomische technologieën heeft geleid tot grote hoeveelheden heterogene data die geavanceerde computationele benaderingen vereisen voor een effectieve interpretatie2.
Algoritmen voor machine learning (ML) en deep learning (DL) hebben opmerkelijke mogelijkheden getoond bij het extraheren van betekenisvolle patronen uit multidimensionale gezondheidszorgdatasets, waardoor de diagnostische nauwkeurigheid, ziektevoorspelling en de beoordeling van patiëntuitkomsten zijn verbeterd3. AI-gebaseerde modellen zijn succesvol toegepast in de radiologie, pathologie, cardiologie, oncologie, oogheelkunde en andere medische specialismen om clinici te ondersteunen bij het detecteren van ziekten in een vroeger stadium en het aanbevelen van gepersonaliseerde behandelstrategieën4. Deze technologieën hebben daarnaast bijgedragen aan workflowoptimalisatie, het verminderen van diagnostische variabiliteit en een verbeterde benutting van middelen in de gezondheidszorg5.
Recente ontwikkelingen in computerhardware, cloudcomputing en open-source AI-frameworks hebben de ontwikkeling en implementatie van intelligente gezondheidszorgapplicaties versneld6. Bijgevolg is AI een belangrijke ondersteunende technologie geworden voor precisiegeneeskunde en klinische beslissingsondersteuningssystemen7. Ondanks deze vorderingen blijft de wijdverbreide adoptie van AI in de routinematige klinische praktijk beperkt, omdat veel hoogpresterende modellen weinig inzicht bieden in hoe hun voorspellingen tot stand komen8.
De meeste deep learning-algoritmen functioneren als complexe black-box-modellen waarin het interne besluitvormingsproces moeilijk te begrijpen is voor clinici en onderzoekers9. Hoewel deze modellen vaak uitstekende voorspellende prestaties leveren, ondermijnt hun gebrek aan transparantie het vertrouwen van de gebruiker en vormt het een uitdaging voor klinische validatie, regelgevende goedkeuring en patiëntveiligheid10. Zorgprofessionals moeten in staat zijn om AI-ondersteunde beslissingen te rechtvaardigen voordat deze worden geïntegreerd in de routinematige klinische praktijk, met name in medische omgevingen met een hoog risico1.
XAI is naar voren gekomen als een effectieve benadering om de transparantie en interpreteerbaarheid van machine learning-modellen te verbeteren12. In plaats van voorspellingsmodellen te behandelen als ondoorzichtige systemen, verschaffen XAI-technieken informatie over de kenmerken, beeldregio's of klinische variabelen die bijdragen aan individuele voorspellingen13. Dergelijke verklaringen stellen clinici in staat om het gedrag van het model beter te begrijpen, potentiële biases te identificeren en vast te stellen of door AI gegenereerde beslissingen consistent zijn met vastgestelde medische kennis14.
Er zijn verschillende technieken voor uitlegbaarheid geïntroduceerd voor toepassingen in de gezondheidszorg. SHapley Additive explanations (SHAP) meten de bijdrage van elke feature aan de modelvoorspelling op basis van coöperatieve speltheorie15. Local Interpretable Model-agnostic Explanations (LIME) maken een vereenvoudigd model en leggen de voorspellingen van het blackbox-model uit16. Voor medische beeldtaken met deep learning-modellen maken Gradient-weighted activation maps (Grad-CAM) heatmaps die visueel de regio's van een afbeelding aangeven die bijdragen aan classificatiebeslissingen17. De combinatie van deze methoden heeft de transparantie van AI-systemen in verschillende domeinen van de gezondheidszorg drastisch verbeterd18.
Ondanks de groeiende aandacht voor uitlegbaarheidsmethoden in de gezondheidszorg, blijft het gebruik ervan in de literatuur gevarieerd. Onderzoekers verschillen niet alleen in het gebruik van preprocessingstrategieën, maar ook in het ontwerp van de modelarchitectuur, de evaluatiemetrieken en zelfs de uitlegtechnieken19. Daarnaast rapporteren veel artikelen een hoge voorspellende nauwkeurigheid, maar laten ze na om een grondige beoordeling te geven van de kwaliteit van de uitleg of de reproduceerbaarheid ervan20.
Reproduceerbaarheid is een van de grootste knelpunten in de moderne AI-wetenschap. In publicaties worden vaak de softwareversie, de computationele omgeving, de preprocessing-pipeline, de hyperparameter-instellingen, de initialisatie van de random seed en de hardwareconfiguraties niet vermeld21. Hierdoor lukt het onafhankelijke onderzoekers vaak niet om gepubliceerde resultaten te reproduceren of de gepubliceerde methoden te verifiëren met behulp van andere datasets of softwareplatforms2. Het gebrek aan gedetailleerde documentatie is een van de factoren die benchmarking-studies, collaboratief onderzoek en de klinische vertaling van AI-systemen belemmeren23.
Gezien deze uitdagingen hebben verschillende organisaties en regelgevende instanties de nadruk gelegd op het belang van transparante, betrouwbare en reproduceerbare AI voor toepassingen in de gezondheidszorg24. Bestaande rapportagerichtlijnen hebben de methodologische verslaglegging verbeterd, maar beschrijven primair wat er gerapporteerd moet worden in plaats van het bieden van gestandaardiseerde experimentele procedures die onderzoekers direct kunnen implementeren25. Bijgevolg blijft er behoefte aan een uitgebreid protocol dat datasetvoorbereiding, modelontwikkeling, analyse van de uitlegbaarheid, statistische evaluatie en reproduceerbaarheidspraktijken integreert in één enkele experimentele workflow26.
Een gestandaardiseerd experimenteel protocol biedt verschillende voordelen voor de healthcare AI-gemeenschap. Bovendien bevordert het methodologische consistentie, vergemakkelijkt het de vergelijking van onafhankelijke studies, vergroot het de transparantie van computationele experimenten en maakt het een betrouwbare validatie van gepubliceerde resultaten mogelijk27. Gestandaardiseerde workflows ondersteunen daarnaast onderwijs/training, collaboratief onderzoek en regelgevende evaluaties door middel van duidelijk gedocumenteerde procedures die reproduceerbaar zijn in verschillende laboratoria en gezondheidsinstellingen28.
Er is een reproduceerbaar experimenteel protocol ontwikkeld en getest voor het trainen en evalueren van AI-modellen in gezondheidszorgsystemen. Het protocol beschrijft standaarden voor het configureren van de computationele omgeving, het voorbewerken van gezondheidszorgdatasets, het ontwikkelen van machine-learningmodellen, het toepassen van XAI-methoden, het evalueren van de predictieve prestaties, het uitvoeren van statistische validatie en het beoordelen van de reproduceerbaarheid29. De integratie van dergelijke componenten in een coherente workflow zal waarschijnlijk de transparantie, betrouwbaarheid en reproduceerbaarheid van AI-onderzoek in de gezondheidszorg vergroten, en helpen bij de ontwikkeling van vertrouwde intelligente gezondheidssystemen30.
Protocol
Het uitgewerkte validatie-experiment maakte gebruik van de publiek toegankelijke, gede-identificeerde Pima Indians Diabetes Dataset en hield geen identificeerbare patiëntgegevens of nieuwe patiëntenwerving in. Daarom waren geïnformeerde toestemming en institutionele IRB/ethische goedkeuring niet vereist, en werden alle analyses uitgevoerd in overeenstemming met de toepasselijke voorwaarden van de dataset en het institutionele onderzoeksbeleid.
Het uitgewerkte validatievoorbeeld maakt gebruik van de publiek beschikbare Pima Indians Diabetes Dataset, die 768 records bevat voor binaire diabetesvoorspelling. De volledige kernworkflow van negen fasen is op deze dataset toegepast. De negen kernfasen bestonden uit datasetselectie en -validatie, configuratie van de computationele omgeving, datapreprocessing, datasetpartitionering, modelontwikkeling en -training, evaluatie van de predictieve en computationele prestaties, uitlegbaarheidsanalyse, statistische validatie en beoordeling van de reproduceerbaarheid. Externe validatie en evaluatie door klinische experts zijn behouden als optionele validatiemodules en zijn in het huidige uitgewerkte voorbeeld niet uitgevoerd. Figuur 1 illustreert de kernworkflow van het protocol, en Tabel 1 vat alleen de negen kernfasen samen die zijn geïmplementeerd in de huidige uitgewerkte validatie; optionele externe validatie en evaluatie door klinische experts worden apart beschreven in het Protocol en zijn niet opgenomen in de negen experimentele fasen.
1. Selecteer en valideer de gezondheidszorgdataset
- Selecteer de Pima Indians Diabetes Dataset als de primaire dataset voor het uitgewerkte validatievoorbeeld. Verifieer de bron van de dataset, de steekproefomvang, het voorspellingsdoel, de klassendistributie en de datastructuur.
- Pas de vooraf gedefinieerde inclusie-, exclusie- en datakwaliteitscriteria toe. Verwijder dubbele en ongeldige records vóór de modelontwikkeling.
- Noteer de bron van de dataset, de kenmerken, de voorspellingsopgave, de klassendistributie, de inclusie- en exclusiecriteria en de partitioneringsstrategie in Tabel 2.
- Pas beslissingscriteria toe voor de selectie van de dataset en het model
- Definieer het voorspellingsdoel voordat de dataset, modelarchitectuur, voorbewerkingstrategie of uitlegbaarheidsmethode wordt gekozen.
- Stem de modaliteit van de dataset af op het voorspellingsdoel. Selecteer tabulaire gegevens voor gestructureerde klinische variabelen, beeldengegevens voor medische beelden, tijdreeksgegevens voor fysiologische signalen, tekstgegevens voor klinische narratieven, of multimodale gegevens wanneer complementaire modaliteiten beschikbaar zijn voor dezelfde patiënt of studie-eenheid.
- Evalueer kandidaat-datasets op basis van steekproefomvang, beschikbaarheid van uitkomsten, klassendistributie, ontbrekende gegevens, annotatiekwaliteit, klinische relevantie, volledigheid van de gegevens en toegankelijkheid. Selecteer de dataset die voldoet aan de vooraf gedefinieerde vereisten.
- Kies conventionele machine-learning-modellen voor gestructureerde tabulaire gegevens wanneer de steekproefomvang, rekenmiddelen of interpreteerbaarheidseisen het gebruik van complexe architecturen beperken. Kies deep-learning-architecturen wanneer er voldoende trainingsgegevens en hoogdimensionale inputs beschikbaar zijn, zoals medische beelden, fysiologische signalen of klinische tekst.
- Selecteer multimodale architecturen alleen wanneer meerdere modaliteiten beschikbaar zijn voor dezelfde patiënt of studie-eenheid en betrouwbaar kunnen worden uitgelijnd zonder informatielekkage te introduceren. Kies voorbewerkingsbewerkingen op basis van de kenmerken van de geselecteerde datamodaliteit.
- Selecteer uitlegbaarheidsmethoden op basis van het model en de datamodaliteit. Gebruik model-agnostische methoden zoals SHAP of LIME voor geschikte tabulaire modellen en modaliteitspecifieke methoden zoals Grad-CAM voor beeldgebaseerde modellen, indien van toepassing.
- Documenteer de rationele onderbouwing voor de selecties van de dataset, de voorbewerkingstrategie, het model en de uitlegbaarheidsmethode. Bewaar deze beslissingen als onderdeel van het reproduceerbaarheidsverslag.
2. Configureer de computationele omgeving voor de ontwikkeling van het XAI-model
- Configureer het besturingssysteem, de CPU, het RAM-geheugen, de opslag en de GPU volgens de vereisten van het geselecteerde model. Maak een geïsoleerde Python-omgeving aan en installeer de vereiste libraries voor machine learning, deep learning, statistiek, visualisatie en XAI.
- Registreer de feitelijke computationele omgeving, de modelarchitectuur en de hyperparameters die zijn gebruikt voor de uitgevoerde validatie in Tabel 3. Specificeer de optimizer, de learning rate, de batch size, het maximale aantal epochs, de loss-functie, de regularisatieparameters, de validatiestrategie, de early-stopping-configuratie, de random-seed-configuratie, de explainability-methoden, de hardware, het besturingssysteem, de Python-versie en de relevante versies van de software-libraries. Maak een duidelijk onderscheid tussen deze experimenteel gebruikte instellingen en de algemene of aanbevolen protocolinstellingen.
- Gebruik de in Tabel 3 vermelde configuratie bij het reproduceren van de validatie van de Pima Indians Diabetes Dataset en de bijbehorende predictieve, explainability, statistische en reproduceerbaarheidsresultaten.
- Voer een validatiescript uit om de succesvolle import van packages, het laden van de dataset, de modeluitvoering en de generatie van output te bevestigen. Bewaar de definitieve configuratie van de omgeving voor de reproduceerbaarheid.
3. Gezondheidszorgdatasets voorbereiden en karakteriseren voor de ontwikkeling van XAI-modellen
- Selecteer en verkrijg de gezondheidszorgdataset
- Selecteer een zorgdataset die geschikt is voor de gedefinieerde klinische voorspellingsopgave. Evalueer kandidaatdatasets op basis van het onderzoeksdoel, het datatype, de steekproefomvang, de annotatiekwaliteit, de klassenbalans en de klinische relevantie.
- Geef de voorkeur aan publiek beschikbare benchmarkdatasets wanneer deze de voorspellingstaak adequaat adresseren en onafhankelijke validatie faciliteren.
- Verkrijg de benodigde ethische goedkeuringen, institutionele toestemmingen en autorisatie voor gegevensacces voordat institutionele datasets of interne datasets worden verzameld. Verkrijg de geselecteerde dataset uit een geverifieerd depot of een geautoriseerde institutionele database.
- Bewaar de oorspronkelijke datasetbestanden zonder wijzigingen en leg de datasetprovider, versie, acquisitie-informatie, licentievoorwaarden, inclusiecriteria, exclusiecriteria en bijbehorende metadata vast. Organiseer de dataset in afzonderlijke mappen voor ruwe gegevens, annotaties, metadata en aanvullende informatie.
- Karakteriseer de dataset voor de gezondheidszorg
- Identificeer de predictoren, uitkomstlabels, kenmerktypen, datamodaliteiten en klassenverdelingen. Bepaal het aantal proefpersonen, monsters, kenmerkdimensies en beschikbare annotaties.
- Bevestig dat de kenmerken van de dataset compatibel zijn met de geselecteerde AI-methode.
- Gebruik de Pima Indians Diabetes Dataset als de enige uitgewerkte experimentele dataset voor het valideren van het negenstaps kernprotocol. Voeg de aanvullende datasets toe die vermeld staan in Tabel 2 uitsluitend om de toepasbaarheid van het algemene protocol aan te tonen over klinische tabulaire gegevens, elektronische gezondheidsdossiers, dermoscopische beelden, fysiologische tijdreeksgegevens en medische beeldvorming. Gebruik deze aanvullende datasets niet voor modeltraining, testen, statistische validatie of het genereren van de gerapporteerde experimentele resultaten.
- Beoordeel de datasetkwaliteit
- Inspecteer de dataset op dubbele records, corrupte bestanden, ontbrekende waarden, annotatiefouten en onregelmatige gegevensvermeldingen. Verwijder bevestigde dubbele records en corrigeer geverifieerde onregelmatigheden in de opmaak. Documenteer alle kwaliteitscontroleprocedures van de dataset.
- Verifieer de correspondentie van beeldvormings-, klinische, laboratorium- en fysiologische gegevens via proefpersoon-identificatoren bij het gebruik van multimodale datasets.
- Verwijder dubbele of inconsistente records, behandel ontbrekende waarden, standaardiseer numerieke kenmerken, codeer categorische variabelen en pas modaliteitsspecifieke preprocessing toe. Verdeel de dataset in onafhankelijke trainings-, validatie- en testsets. Raadpleeg Figuur 2 voor de workflow voor de voorbereiding, voorbewerking, partitionering en kwaliteitsbeoordeling van datasets uit de gezondheidszorg.
- Waarborg gegevensprivacy en ethische naleving
- Verwijder direct identificerende gegevens uit zorggegevens. Pas anonimiserings- of pseudonimiseringsprocedures toe wanneer dit vereist is. Behandel patiëntgezondheidsinformatie in overeenstemming met de geldende ethische eisen, gegevensbescherming, geïnformeerde toestemming en institutionele vereisten.
- Leg de toepasselijke ethische goedkeuring, vrijstelling, data-governanceprocedures, anonimiseringsmethoden en de workflow voor de datasetvoorbereiding vast.
- Beoordeel potentiële algoritmische bias door de prestaties van het model te vergelijken tussen relevante demografische of klinische subgroepen, wanneer dergelijke informatie beschikbaar is en ethisch is toegestaan.
- Documenteer het beoogde gebruik, de doelpopulatie, de beperkingen van het model, potentiële foutmodi, de vereisten voor menselijk toezicht en de toepasselijke ethische vereisten, vereisten voor gegevensbescherming en regelgeving op het gebied van de gezondheidszorg.
- Leg vastgestelde beperkingen op het gebied van rechtvaardigheid en overwegingen met betrekking tot verantwoordelijke AI als onderdeel van de definitieve modeldocumentatie.
OPMERKING: Verkrijg een gestandaardiseerde en gedocumenteerde dataset uit de gezondheidszorg die geschikt is voor de ontwikkeling van AI-modellen, ethisch compliant is en vrij is van grote geïdentificeerde inconsistenties.
4. Voorbereiden en partitioneren van gezondheidszorggegevens voor training van het AI-model
- Voer kwaliteitscontrole uit
- Inspecteer de dataset op dubbele records, ontbrekende waarden, ongeldige waarden, inconsistente labels, uitschieters en corrupte bestanden.
- Verwijder of corrigeer ongeldige waarnemingen volgens vooraf gedefinieerde criteria en leg alle uitsluitingen vast. Verifieer de consistentie van de predictoren en de uitkomstlabels.
- Behandel ontbrekende gegevens
- Kwantificeer de hoeveelheid ontbrekende gegevens per variabele. Pas de vooraf gedefinieerde imputatie- of uitsluitingsstrategie toe.
- Schat de imputatieparameters uitsluitend met behulp van de trainingsgegevens en pas de gefitte transformatie toe op de validatie- en testgegevens.
- Normaliseer en transformeer gegevens
- Pas feature scaling, normalisatie, encoding, dimensionaliteitsreductie of andere transformaties toe die vereist zijn door het geselecteerde model. Fit alle gegevensafhankelijke transformaties uitsluitend met behulp van de trainingsgegevens.
- Pas de gefitte transformaties ongewijzigd toe op de validatie- en testgegevens.
- Kwantificeer de klassenonbalans in de trainingsgegevens. Pas klassenweging, SMOTE, oversampling of augmentatie uitsluitend toe op de trainingsdataset. Behoud de oorspronkelijke distributie van de validatie- en testdatasets.
- Bevestig dat er geen enkel subject, dubbele waarneming, geaugmenteerd monster, preprocessing-statistiek, feature-selectiecriterium of synthetisch monster wordt gedeeld tussen de trainings- en evaluatiepartities.
5. Ontwikkel en configureer het XAI-model
- Definieer de modelarchitectuur door de modaliteiten van de invoergegevens, voorbewerkingoperaties, modaliteitsspecifieke kenmerkencodeerders, het mechanisme voor kenmerkenfusie, de voorspellingslaag en de module voor uitlegbaarheid te specificeren.
- Selecteer de machine learning- of deep learning-architectuur op basis van de voorspellingstaak en de invoermodaliteit. Configureer de invoerlaag, de componenten voor kenmerkextractie, de verborgen lagen, de uitvoerlaag en de activeringsfuncties. Definieer de optimizer, de leersnelheid, de batchgrootte, de verliesfunctie, het aantal epochs, de regularisatie, dropout, early stopping en het schema voor de leersnelheid.
- Optimaliseer de hyperparameters uitsluitend met behulp van de trainings- en validatiegegevens.
- Noteer de definitieve architectuur en hyperparameterconfiguratie in Tabel 3.
- Verifieer de compatibiliteit van de invoer-uitvoerdimensies vóór de training.
OPMERKING: Stel een volledig geconfigureerd XAI-model op dat een geschikte architectuur, gedefinieerde hyperparameters en geïntegreerde technieken voor uitlegbaarheid bevat.
6. Het XAI-model trainen, optimaliseren en bewaren
- Laad de vooraf gedefinieerde trainings- en validatiesets en de definitieve modelconfiguratie. Initialiseer het model met de vooraf gedefinieerde random seed en trainingsparameters.
- Train het model met de gespecificeerde optimizer, verliesfunctie, batchgrootte en stopcriteria.
- Monitor de validatieprestaties en behoud het checkpoint dat overeenkomt met het vooraf gedefinieerde modelselectiecriterium. Evalueer het geselecteerde checkpoint op de onafhankelijke testdataset zonder verdere optimalisatie.
- Sla het getrainde model, de preprocessingconfiguratie, de hyperparameters, de random seed en het trainingslogboek op.
OPMERKING: Verkrijg een geoptimaliseerd XAI-model dat is getraind en gevalideerd met de voorbereide gezondheidszorgdataset. Bewaar het best presterende model, de hyperparameters, de trainingslogs, de preprocessingconfiguratie en de computationele omgeving voor reproduceerbaarheid.
7. Evalueer de voorspellende en computationele prestaties
- Beoordeel de predictieve prestaties
- Laad het geoptimaliseerde model en de onafhankelijke testdataset na voltooiing van de modeltraining en hyperparameteroptimalisatie. Houd de getrainde modelparameters en de preprocessing-pipeline tijdens het testen ongewijzigd.
- Genereer voorspellingen voor alle monsters in de testdataset. Vergelijk de voorspelde output met de overeenkomstige ground-truth labels.
- Bereken prestatie-metrieken
- Selecteer evaluatiemetrieken op basis van het type predictietaak.
- Bereken, indien van toepassing, nauwkeurigheid, precisie, recall, specificiteit, F1-score, gebalanceerde nauwkeurigheid, de Matthews-correlatiecoëfficiënt (MCC) en de area under the receiver operating characteristic curve (AUC-ROC) voor classificatietaken. Bereken, indien van toepassing, de gemiddelde absolute fout (MAE), de root mean square error (RMSE), de determinatiecoëfficiënt (R2) en andere relevante maten voor regressietaken.
- Beoordeel modelgeneralisatie en robuustheid
- Evalueer het model met behulp van een externe dataset die onafhankelijk van de ontwikkelingsdataset is verzameld, indien dergelijke gegevens beschikbaar zijn.
- Geef de voorkeur aan externe datasets afkomstig van een andere zorginstelling, geografische regio of patiëntenpopulatie om de transportabiliteit te beoordelen.
- Voer temporele validatie uit met gegevens die in een latere periode zijn verzameld wanneer longitudinale datasets beschikbaar zijn.
- Voer multicenter-validatie uit door het definitieve model afzonderlijk te evalueren over de deelnemende instellingen wanneer multicenter-gegevens beschikbaar zijn.
- Voer geografische validatie uit met behulp van een onafhankelijke populatie uit een andere geografische regio indien haalbaar.
- Rapporteer prestatieverschillen en betrouwbaarheidsintervallen tussen de ontwikkelings- en externe datasets.
- Beoordeel de computationele prestaties
- Meet de modeltrainingstijd binnen de vooraf gedefinieerde computationele omgeving, de inferentie- en testtijd onder identieke computationele omstandigheden, en het geheugengebruik, de modelgrootte en de hardwarebenutting.
- Herhaal computationele metingen over onafhankelijke runs.
- Bereken de gemiddelde uitvoeringstijd om het effect van experimentele variabiliteit te verminderen.
- Vergelijk modelprestaties
- Selecteer geschikte conventionele machine learning- of deep learning-methoden voor comparatieve evaluatie.
- Evalueer het voorgestelde XAI-model en de vergelijkingsmodellen met behulp van dezelfde dataset. Pas identieke preprocessing-procedures en evaluatiemetrieken toe op alle vergelijkingsmodellen.
- Voer alle comparatieve experimenten uit binnen dezelfde computationele omgeving.
OPMERKING: Verkrijg experimenteel bewijs van predictieve stabiliteit en reproduceerbaarheid onder de geteste computationele omstandigheden en dataset.
8. XAI-outputs genereren en evalueren
- Modeluitleg genereren
- Laad het geoptimaliseerde XAI-model. Selecteer evaluatiesamples die niet zijn gebruikt voor de modeltraining. Pas de vooraf gedefinieerde uitlegbaarheidsmethoden toe zonder het getrainde model of de preprocessing-pipeline te wijzigen.
- Globale en lokale modeluitleg genereren
- Genereer globale uitleg om het algemene gedrag van het voorspellende model te karakteriseren.
- Genereer lokale uitleg om individuele modelvoorspellingen te karakteriseren.
- Pas SHAP toe op de Pima Indians Diabetes Dataset om globale en lokale uitleg van de tabulaire modelvoorspellingen te genereren.
- Genereer een SHAP-summary plot om de algemene richting en grootte van de feature-bijdragen te visualiseren.
- Genereer een SHAP-feature-importance plot met behulp van gemiddelde absolute SHAP-waarden om features te rangschikken op basis van hun algemene bijdrage aan de modelvoorspellingen.
- Genereer een SHAP-waterfall plot voor een representatieve voorspelling uit de testset om patiëntspecifieke feature-bijdragen te illustreren.
- Genereer een SHAP-feature-dependence plot om de relatie tussen een geselecteerde feature en de bijdrage ervan aan de modeloutput te onderzoeken.
- Pas LIME toe op representatieve voorspellingen uit de testset om lokale uitleg van individuele modelvoorspellingen te genereren.
- Genereer een patiëntspecifieke counterfactual-uitleg om de feature-wijzigingen te illustreren die gepaard gaan met een verandering in de voorspelde uitkomst.
- Selecteer aanvullende uitlegbaarheidstechnieken op basis van de datamodaliteit en de modelarchitectuur.
- Gebruik Grad-CAM of saliency maps voor compatibele image-based modellen, attention-visualisaties voor transformer-gebaseerde architecturen en Integrated Gradients voor differentieerbare modellen indien van toepassing.
- Behandel Grad-CAM, saliency mapping, attention-visualisatie en Integrated Gradients als algemene, modaliteitsafhankelijke protocolopties, en interpreteer of rapporteer deze niet als experimentele resultaten van de validatie van de Pima Indians Diabetes Dataset, tenzij de overeenkomstige analyses daadwerkelijk zijn uitgevoerd.
- Uitlegbaarheidsmethoden toepassen op de uitgewerkte Pima-validatie
- Pas SHAP en LIME toe op de Pima Indians Diabetes Dataset om globale en lokale uitleg van de tabulaire modelvoorspellingen te genereren.
- Genereer SHAP-summary, feature-importance, waterfall- en feature-dependence visualisaties vanuit de Pima-validatieresultaten.
- Genereer een LIME-lokale uitleg voor representatieve voorspellingen uit de testset.
- Genereer een patiëntspecifieke counterfactual-uitleg om de feature-wijzigingen te illustreren die gepaard gaan met een verandering in de modelvoorspelling.
- Behandel Grad-CAM, attention-visualisatie, saliency mapping en Integrated Gradients als modaliteitsafhankelijke uitlegbaarheidsopties voor andere typen zorggegevens en modelarchitecturen.
- Rapporteer Grad-CAM, attention-visualisatie, saliency mapping of Integrated Gradients niet als experimentele bevindingen van de uitgewerkte Pima-validatie, tenzij de overeenkomstige analyses daadwerkelijk zijn uitgevoerd.
- Kwaliteit van de uitleg evalueren
- Beoordeel of de gegenereerde uitleg het voorspellingsproces van het model weerspiegelt. Evalueer de stabiliteit van de uitleg over herhaalde experimentele runs en de consistentie van de uitlegoutput onder identieke computationele omstandigheden.
- Beoordeel de gevoeligheid van de uitlegoutput voor wijzigingen in de inputgegevens indien van toepassing. Vergelijk de gegenereerde uitleg met beschikbare domeinkennis of expertinterpretaties.
- Identificeer voorspellende features of anatomische regio's die overeenkomen met gevestigde medische kennis wanneer dergelijke vergelijkingen beschikbaar zijn.
- Leg de mate van overeenstemming of onenigheid vast tussen de gegenereerde uitleg en de beschikbare klinische interpretatie.
- Voorspellingsonzekerheid kwantificeren
- Genereer schattingen van de voorspellingsbetrouwbaarheid voor de geëvalueerde samples met behulp van een methode voor onzekerheidsschatting die geschikt is voor de geselecteerde modelarchitectuur en zorgtoepassing.
- Pas Monte Carlo-dropout, ensemble-gebaseerde voorspelling, Bayesiaanse inferentie, conformal prediction of een andere gevalideerde benadering voor onzekerheidsschatting toe waar passend.
- Herhaal stochastische voorspellingsruns bij gebruik van Monte Carlo-dropout en bereken de gemiddelde voorspelling en voorspellingsvariantie voor elk evaluatiesample.
- Rapporteer de voorspellingsbetrouwbaarheid of onzekerheidsintervallen samen met de overeenkomstige modelvoorspellingen.
- Evalueer of onzekerheidsschattingen voorspellingen identificeren die geassocieerd zijn met een lagere betrouwbaarheid of een verhoogde voorspellingsfout. Bewaar de methode voor onzekerheidsschatting, parameters, random seeds en gegenereerde onzekerheidsoutputs om reproduceerbaarheid te garanderen.
- Uitlegbaarheidsoutputs documenteren en bewaren
- Sla alle gegenereerde feature-importance scores, heatmaps, saliency maps, attention-visualisaties en patiëntspecifieke interpretaties op. Sla de uitlegbaarheidsoutputs op met behulp van gestandaardiseerde bestandsformaten. Archiveer de outputs samen met het getrainde model en de preprocessing-configuratie.
- Leg de computationele instellingen, uitlegparameters, executietijd en softwareversies vast die zijn gebruikt voor het genereren van de uitleg. Bewaar de volledige documentatie van de uitlegbaarheid om onafhankelijke review en reproduceerbaarheid te vergemakkelijken.
- Kwaliteit van de uitleg kwantitatief evalueren
- Evalueer de getrouwheid (faithfulness) van de uitleg door de features die als belangrijk zijn geïdentificeerd systematisch te perturberen of te maskeren en de overeenkomstige verandering in de modeloutput te meten. Bereken een score voor de getrouwheid van de uitleg door de grootte van de attributie te vergelijken met de resulterende verandering in de modelvoorspelling.
- Evalueer de stabiliteit van de uitleg door uitleg te genereren voor herhaalde runs, geperturbeerde inputs of klinisch vergelijkbare samples en de gelijkenis tussen de resulterende attributiepatronen te berekenen. Bereken de infidelity door de discrepantie te meten tussen de voorspelde outputverandering en de verandering geschat op basis van de attributie van de uitleg onder gecontroleerde inputperturbaties.
- Evalueer voor uitleg van medische beelden de lokalisatienauwkeurigheid met behulp van een door een expert gedefinieerde region of interest wanneer referentie-annotaties beschikbaar zijn. Beoordeel het klinisch nut door onafhankelijke evaluaties te verkrijgen van gekwalificeerde klinische experts met behulp van vooraf gedefinieerde interpretatiecriteria.
- Bereken de kappa van Cohen of de kappa van Fleiss wanneer meerdere experts onafhankelijk de relevantie of overeenstemming van de uitleg evalueren.
OPMERKING: Genereer globale en lokale uitleg die het voorspellende gedrag van het getrainde AI-model karakteriseert. Bewaar de uitlegbaarheidsoutputs en overeenkomstige configuraties voor transparante interpretatie en reproduceerbare evaluatie.
9. Voer statistische validatie en reproduceerbaarheidsbeoordeling uit
- Voer statistische validatie uit
- Selecteer statistische methoden op basis van het studiedoel, het experimentele ontwerp, de datadistributie en de kenmerken van de geëvalueerde variabelen.
- Rapporteer continue variabelen als het gemiddelde ± standaarddeviatie of als de mediaan en interkwartielafstand, naar gelang van de situatie, en categorische variabelen als aantallen en percentages.
- Voer vijfvoudige kruisvalidatie uit op de trainingsset om de stabiliteit van de modelprestaties te beoordelen en rapporteer de nauwkeurigheid, AUC-ROC, precisie, recall en F1-score als gemiddelde ± standaarddeviatie over de folds. Schat 95% betrouwbaarheidsintervallen voor de prestatiegegevens van de onafhankelijke testset met behulp van 1.0 bootstrap-resamples.
- Vergelijk het voorgestelde model met de CNN, Random Forest en SVM baseline-modellen met behulp van de McNemar-test voor gepaarde vergelijkingen van de nauwkeurigheid, de DeLong-test voor gecorreleerde AUC-ROC-vergelijkingen en gepaarde bootstrap-testen met 1.0 resamples voor vergelijkingen van de F1-score.
- Rapporteer de overeenkomstige toetsingsstatistiek en de exacte p-waarde voor elke vergelijking en gebruik een tweezijdige significantieniveaus van α = 0.05.
- Vergelijk modelprestaties statistisch
- Vergelijk het voorgestelde explainable AI-model met de geselecteerde state-of-the-art machine learning en deep learning baseline-modellen.
- Pas de Student's t-toets of de Mann-Whitney U-toets toe bij het vergelijken van twee groepen, naar gelang de situatie. Pas eenweg-ANOVA toe voor toepasbare parametrische vergelijkingen met meer dan twee groepen. Pas de Kruskal-Wallis-toets toe voor toepasbare non-parametrische vergelijkingen met meer dan twee groepen.
- Beschouw p < 0.05 als statistisch significant, zoals gespecificeerd in het oorspronkelijke manuscript.
- Gebruik een tweezijdig significantieniveau van α = 0.05 voor alle vooraf gedefinieerde statistische vergelijkingen en rapporteer de overeenkomstige toetsingsstatistieken en p-waarden.
- Rapporteer 95% betrouwbaarheidsintervallen voor de belangrijkste voorspellende prestatiegegevens.
- Gebruik bootstrap-resampling om betrouwbaarheidsintervallen voor prestatiematen te schatten wanneer dat gepast is. Gebruik de DeLong-test om gecorreleerde ROC-AUC-waarden te vergelijken wanneer dezelfde subjecten door twee modellen worden geëvalueerd. Gebruik de McNemar-test om gepaarde categorische classificatieresultaten te vergelijken die voor dezelfde subjecten zijn gegenereerd. Gebruik gepaarde bootstrap-procedures om de F1-score of andere afgeleide prestatiematen te vergelijken wanneer dat gepast is.
- Evalueer de kalibratie met behulp van kalibratieplots, kalibratieshelling/intercept en de Brier-score wanneer probabilistische voorspellingen beschikbaar zijn.
- Gebruik voor de uitgewerkte validatie van de Pima Indians Diabetes Dataset de vooraf gedefinieerde gepaarde statistische vergelijking die is gespecificeerd voor het voorgestelde model en de baseline-modellen. Pas de geselecteerde toets consistent toe op de gepaarde voorspellingen van de testset of de prestatiemetingen van herhaalde runs, naar gelang de vergelijking. Gebruik een tweezijdig significantieniveau van α = 0.05 en rapporteer de toetsingsstatistiek en de exacte p-waarde. Rapporteer geen alternatieve statistische toetsen als zijnde uitgevoerd, tenzij de resultaten daarvan in de sectie Resultaten worden gepresenteerd.
- Pas tweezijdige toetsen toe en interpreteer statistische significantie met een vooraf gedefinieerde drempelwaarde van p < 0.05.
- Evalueer modelrobuustheid
- Herhaal de volledige trainings- en evaluatieprocedure 10 keer met verschillende random seeds, terwijl de vooraf gedefinieerde dataset-partitionering, preprocessingsprocedures, modelarchitectuur, hyperparameters, softwareomgeving en evaluatieprotocol gehandhaafd blijven.
- Leg de AUC-ROC, nauwkeurigheid en F1-score vast voor elke onafhankelijke run en rapporteer het gemiddelde ± standaarddeviatie over de 10 runs.
- Vergelijk de resulterende prestatiewaarden over de herhaalde runs om de voorspellende stabiliteit en reproduceerbaarheid onder verschillende willekeurige initialisaties te beoordelen.
- Evalueer reproduceerbaarheid van de uitlegbaarheid
- Genereer feature-attributies, attention-maps of andere uitleguitgangen over meerdere experimentele runs wanneer een beoordeling van de stabiliteit van de uitleg is opgenomen. Vergelijk de uitleguitgangen kwantitatief over herhaalde runs met behulp van een geschikte overeenkomstmaat op basis van gelijkenis of rangorde.
- Rapporteer voor de huidige uitgewerkte validatie van de Pima Indians Diabetes Dataset geen kwantitatieve metrieken voor de stabiliteit van de uitleg, tenzij de overeenkomstige herhaalde uitleguitgangen en analyses zijn uitgevoerd.
- Evalueer de overeenstemming tussen model-gegenereerde uitleg en interpretaties door clinici wanneer passende klinische evaluaties beschikbaar zijn. Bereken de kappa van Cohen of de kappa van Fleiss, naar gelang de situatie, om de overeenstemming tussen beoordelaars te evalueren.
- Documenteer reproduceerbaarheid
- Bewaar de ruwe data, preprocessingsprocedures, broncode, getrainde modellen, hyperparameterconfiguraties, uitlegbaarheidsuitgangen, statistische analysescripts en gegenereerde resultaten.
- Leg de softwareomgeving en hardwareconfiguratie vast die gedurende de workflow zijn gebruikt. Voer de volledige workflow onafhankelijk opnieuw uit met behulp van de gearchiveerde bestanden en configuraties.
- Vergelijk de gerepliceerde voorspellende prestaties met de oorspronkelijke experimentele resultaten, en de gerepliceerde modeluitleg met de oorspronkelijke uitlegbaarheidsuitgangen.
- Leg eventuele verschillen vast die tijdens de replicatie zijn waargenomen. Werk de experimentele documentatie bij om de reproduceerbaarheidsobservaties weer te geven die tijdens de onafhankelijke uitvoering zijn geïdentificeerd.
OPMERKING: Verkrijg statistisch gevalideerde resultaten voor voorspellende prestaties en uitlegbaarheid die over herhaalde experimenten kunnen worden geëvalueerd. Bewaar voldoende computationele, analytische en methodologische documentatie om onafhankelijke verificatie van de volledige workflow mogelijk te maken.
- Checklist voor reproduceerbaarheid
- Leg de datasetnaam, versie, acquisitiedatum, bron, inclusiecriteria, exclusiecriteria en het uiteindelijke steekproefaantal vast. Leg alle preprocessing-operaties, transformatieparameters, normalisatie-instellingen, feature-selectieprocedures en regels voor dataset-partitionering vast.
- Leg het besturingssysteem, de CPU, GPU, RAM, Python-versie, framework-versies en bibliotheekversies vast. Leg alle specificaties van de modelarchitectuur en hyperparameters vast.
- Leg de optimizer, learning rate, batch size, het aantal epochs, de verliesfunctie, regularisatie en early-stopping-criteria vast. Leg alle random seeds en instellingen van de random-number-generator vast.
- Bewaar getrainde modelgewichten en preprocessing-configuraties. Bewaar trainingslogs, evaluatiescripts, statistische analysescripts en uitlegbaarheidsuitgangen. Leg de model- en softwareversies vast die zijn gebruikt voor de definitieve experimenten.
- Bewaar de volledige computationele omgeving die nodig is voor onafhankelijke replicatie.
- Documenteer de beschikbaarheid van broncode, datasets, modelgewichten en ondersteunende materialen, onderworpen aan ethische, wettelijke, licentie- en privacyrestricties.
- Voer de gearchiveerde workflow onafhankelijk opnieuw uit en vergelijk de gerepliceerde resultaten met de oorspronkelijke resultaten.
- Documenteer de volledige reproduceerbaarheidseisen met behulp van de gestandaardiseerde checklist.
Resultaten
Het voorgestelde XAI-framework is geïmplementeerd met gebruik van de Pima Indians Diabetes Dataset als representatieve dataset voor de gezondheidszorg. De Pima Indians Diabetes Dataset werd gebruikt als de enige dataset voor experimentele validatie. Alle gerapporteerde resultaten met betrekking tot predictie, uitlegbaarheid, statistiek en reproduceerbaarheid zijn gegenereerd vanuit deze dataset. TCGA-BRCA, TCGA-UCEC, MIMIC-III, ISIC 2019, HAM10, OhioT1DM en BraTS 2021 zijn niet experimenteel geëvalueerd en zijn uitsluitend opgenomen als voorbeelden die de toepasbaarheid van het algemene protocol illustreren over verschillende modaliteiten van gezondheidszorggegevens. De volledige dataset werd gebruikt nadat ongeldige en dubbele records waren verwijderd, en de gespecificeerde voorbewerkingoperaties werden uitgevoerd voorafgaand aan de modelontwikkeling. De dataset werd opgedeeld in onafhankelijke trainings-, validatie- en testsubsets met behulp van een vooraf gedefinieerde gestratificeerde splitsingsstrategie. De onafhankelijkheid van monsters over de drie subsets werd gehandhaafd om de mogelijkheid van datalekken te minimaliseren.
Het voorspellende model werd geconfigureerd met behulp van de vooraf gedefinieerde architectuur en hyperparameters. Het model werd getraind met de Adam-optimizer, gebruikmakend van de vooraf gedefinieerde leerfrequentie en batchgrootte gedurende maximaal 10 epochs. Er werd vroegtijdige stopzetting (early stopping) toegepast op basis van het validatieverlies, waarbij het model met de beste validatieprestaties werd behouden. Om de reproduceerbaarheid te verbeteren, werden random seeds gespecificeerd voor de partitionering van de dataset, de modelinitialisatie en herhaalde experimenten.
Het getrainde model werd geëvalueerd op de onafhankelijke testset met behulp van nauwkeurigheid, precisie, recall, specificiteit, F1-score, de correlatiecoëfficiënt van Matthews (MCC), de oppervlakte onder de receiver operating characteristic-curve (AUC-ROC) en de gemiddelde precisie (AP). Het voorgestelde model werd vergeleken met de vooraf gedefinieerde baseline-modellen met gebruikmaking van identieke preprocessing-procedures, datapartities en evaluatieprotocollen. Receiver operating characteristic (ROC)-curves, precisie-recall-curves en een confusiematrix werden gegenereerd op basis van de voorspellingen van de onafhankelijke testset.
Vijfvoudige kruisvalidatie werd uitgevoerd op de trainingsgegevens om de stabiliteit van de prestaties te beoordelen. Er werden 95% betrouwbaarheidsintervallen geschat voor de belangrijkste prestatieindicatoren, en er werden vooraf gedefinieerde statistische vergelijkingen uitgevoerd tussen het voorgestelde model en de basismodellen.
Vijfvoudige kruisvalidatie leverde een nauwkeurigheid op van 93,01 ± 0,48%, een AUC-ROC van 0,954 ± 0,07, een precisie van 92,42 ± 0,87%, een recall van 93,02 ± 0,45% en een F1-score van 92,72 ± 0,62%. De 95% bootstrap-betrouwbaarheidsintervallen geschat uit 1.0 resamples waren 0,897–0,973 voor nauwkeurigheid, 0,890–0,970 voor precisie, 0,80–0,963 voor recall, 0,87–0,965 voor F1-score en 0,931–0,984 voor AUC-ROC. Statistische vergelijkingen met de CNN-, Random Forest- en SVM-basismodellen werden uitgevoerd met de McNemar-test voor nauwkeurigheid, de DeLong-test voor AUC-ROC en gepaarde bootstrap-testen met 1.0 resamples voor de F1-score.
De volledige trainings- en evaluatieprocedure werd herhaald over 10 onafhankelijke runs met verschillende random seeds. De herhaalde runs leverden een AUC-ROC op van 0,957 ± 0,08, een nauwkeurigheid van 93,24 ± 0,74% en een F1-score van 92,35 ± 0,92%, wat duidt op een relatief lage variabiliteit over de herhaalde uitvoeringen. Prestatiemetrieken verkregen over de herhaalde uitvoeringen werden samengevat met behulp van het gemiddelde en de standaarddeviatie. De variabiliteit tussen de runs werd onderzocht om vast te stellen of de voorspellende prestaties stabiel bleven bij herhaalde uitvoering.
Externe validatie is in dit praktijkvoorbeeld niet uitgevoerd omdat er geen onafhankelijke externe dataset is gebruikt. Bijgevolg zijn alle gerapporteerde predictieve, statistische en reproduceerbaarheidsresultaten verkregen uit de Pima Indians Diabetes Dataset met behulp van de vooraf gedefinieerde partities voor training, validatie en onafhankelijke toetsing. Externe validatie is in het protocol behouden als een optionele procedure voor toepassingen waarbij een onafhankelijke dataset van een andere instelling, populatie, geografische regio of tijdsperiode beschikbaar is.
Modeluitleggingen werden gegenereerd met behulp van explainability-technieken die toepasbaar zijn op de tabulaire Pima Indians Diabetes Dataset, waaronder SHAP en LIME. De globale feature importance werd geëvalueerd en patiëntspecifieke lokale uitleggingen werden gegenereerd met behulp van apart gehouden testsamples. De resultaten van de uitleg werden vastgelegd samen met de overeenkomstige modelvoorspellingen en feature-waarden om reproduceerbaarheid en daaropvolgende interpretatie te vergemakkelijken.
Voor de duidelijkheid bestond het huidige praktijkvoorbeeld uit de negen kernfasen van de workflow die zijn geïdentificeerd in Tabel 1. Externe validatie en evaluatie door klinische experts werden behouden als optionele validatiemodules van het algemene protocol. Externe validatie is niet uitgevoerd omdat er geen onafhankelijke externe dataset is gebruikt, en evaluatie door klinische experts is niet uitgevoerd omdat er geen formeel expert-evaluatiepanel was opgenomen in het huidige praktijkvoorbeeld. Bijgevolg worden deze optionele modules niet beschouwd als onderdeel van de experimentele workflow uit negen fasen en worden ze niet gerapporteerd als experimentele resultaten.
De procedures voor preprocessing en dataset-partitionering resulteerden in een gestandaardiseerde dataset die geschikt is voor modelontwikkeling. Dubbele en inconsistente records werden verwijderd, ontbrekende waarden werden behandeld volgens de vooraf gedefinieerde strategie, numerieke kenmerken werden gestandaardiseerd en de dataset werd gepartitioneerd in onafhankelijke trainings-, validatie- en testsubsets. De kenmerken van de resulterende dataset en de preprocessing-procedures zijn samengevat in Tabel 2. De algemene workflow voor de voorbereiding en preprocessing van de gezondheidszorgdataset is geïllustreerd in Figuur 2, terwijl de workflow voor experimentele voorbereiding, preprocessing, partitionering en kwaliteitsbeoordeling die specifiek is toegepast op de Pima Indians Diabetes Dataset wordt getoond in Figuur 3. De uiteindelijke computationele omgeving, modelarchitectuur en hyperparameterconfiguratie die zijn gebruikt om de gerapporteerde resultaten te genereren, zijn samengevat in Tabel 3.
De uitvoering van sectie 3 en 4 leverde een gestandaardiseerde dataset voor de gezondheidszorg op die geschikt is voor modelontwikkeling. De voorbewerkingsprocedures verwijderden dubbele en inconsistente records, vulden ontbrekende waarden aan, standaardiseerden numerieke kenmerken, codeerden categorische variabelen waar van toepassing en verdeelden de dataset in trainings-, validatie- en testsubsets. De resulterende gegevens leverden de gestandaardiseerde input die vereist was voor de daaropvolgende modelontwikkeling.
Na voltooiing van Sectie 5 en 6 vertoonde het geconfigureerde model een stabiele convergentie tijdens de training. De leercurves toonden een gelijktijdige afname van de trainings- en validatieverliezen en een toename van de trainings- en validatienauwkeurigheid. Hyperparameteroptimalisatie verbeterde de generalisatie van het model, zonder bewijs van aanzienlijke overfitting. Ter ondersteuning van de reproduceerbaarheid werd het geoptimaliseerde model gearchiveerd samen met de definitieve architectuur, hyperparameterinstellingen, softwareversies, random seeds en de getrainde modelgewichten. De specificaties voor de modeltraining en de optimalisatiegegevens zijn samengevat in Tabel 4, en de overeenkomstige leercurves voor training en validatie worden gepresenteerd in Figuur 4.
In sectie 7 werd de voorspellende prestatie van het model geëvalueerd met behulp van gestandaardiseerde prestatiemetrieken. De geëvalueerde classificatiemetrieken omvatten nauwkeurigheid, precisie, recall, specificiteit, F1-score, MCC, AUC-ROC en AP. Het voorgestelde model werd vergeleken met de vooraf gedefinieerde baselinemodellen met gebruikmaking van dezelfde datasetpartities, voorbehandelingsprocedures en evaluatieprotocol. De vergelijking van de voorspellende prestaties wordt gepresenteerd in Tabel 5, terwijl de ROC-curven, precisie-recall-curven, de confusiematrix en de vergelijkende prestatiemetrieken worden getoond in Figuur 5.
Na Sectie 8 werden zowel globale als lokale verklaringen van de voorspellingen van het model gegenereerd om de interpreteerbaarheid ervan te evalueren. Modelverklaringen werden gegenereerd met behulp van SHAP en LIME voor de tabelvormige Pima Indians Diabetes Dataset, en er werd een patiëntspecifieke contrafeitelijke verklaring opgesteld om een verandering in de voorspelling te illustreren. SHAP werd gebruikt voor het genereren van globale feature-belangrijkheid en patiëntspecifieke waterval- en feature-afhankelijkheidsvisualisaties, terwijl LIME werd gebruikt om lokale verklaringen te genereren op basis van uitgesloten testmonsters. De overeenkomstige resultaten van de uitlegbaarheid worden gepresenteerd in Figuur 6.
In de laatste fase van het protocol werd de statistische betrouwbaarheid en reproduceerbaarheid van de workflow geëvalueerd. De volledige workflow werd herhaald in 10 onafhankelijke runs met verschillende willekeurige seeds, terwijl dezelfde strategie voor dataset-partitionering, preprocessing-parameters, modelarchitectuur, hyperparameters, softwareomgeving en evaluatieprocedures werden gehanteerd. De herhaalde runs resulteerden in een AUC-ROC van 0,957 ± 0,008, een nauwkeurigheid van 93,24 ± 0,74% en een F1-score van 92,35 ± 0,92%, wat wijst op een relatief lage variabiliteit tussen de herhaalde uitvoeringen.
De stabiliteit van de uitleg werd in de huidige werkvalidatie niet kwantitatief geëvalueerd. Hoewel SHAP- en LIME-uitleggingen werden gegenereerd voor de Pima Indians Diabetes Dataset, is er geen aparte rank-correlatie- of feature-overlapanalyse tussen verschillende runs uitgevoerd. Daarom worden er geen numerieke metrieken voor uitlegstabiliteit of attributie-overeenstemming gerapporteerd. Een kwantitatieve beoordeling van de uitlegstabiliteit is behouden in het algemene protocol als een optionele reproduceerbaarheidsprocedure voor toepassingen waarin herhaalde uitlegoutputs beschikbaar zijn.
Statistische vergelijkingen werden geëvalueerd met gebruik van een vooraf gedefinieerde significantiedrempel van p < 0,05. Tweezijdige statistische tests werden toegepast waar van toepassing, en de overeenkomstige teststatistieken, p-waarden en 95% betrouwbaarheidsintervallen werden gerapporteerd om de statistische significantie en onzekerheid van de waargenomen prestatieverschillen te kwantificeren. De resultaten van de experimentele statistische validatie en reproduceerbaarheid, inclusief de prestaties bij kruisvalidatie, betrouwbaarheidsintervallen, statistische vergelijkingen en variabiliteit bij herhaalde runs, zijn samengevat in Tabel 6. De bijbehorende statistische tests en reproduceerbaarheidsanalyses zijn geïllustreerd in Figuur 7.
Deze resultaten leverden experimenteel bewijs voor voorspellende stabiliteit en reproduceerbaarheid onder de geteste computationele omstandigheden en dataset. De computationele omgeving, datasetkenmerken, voorbewerkingsprocedures, modelconfiguratie, statistische analyses en instellingen voor uitlegbaarheid die nodig zijn voor onafhankelijke replicatie, werden gedocumenteerd in overeenstemming met de reproduceerbaarheidschecklist in Tabel 7. Er is in het uitgewerkte validatievoorbeeld van het huidige werk geen evaluatie van de gegenereerde XAI-outputs door klinische experts uitgevoerd.
Over het algemeen leverde de toepassing van het protocol een gestandaardiseerde dataset voor de gezondheidszorg op die geschikt is voor de ontwikkeling van AI-modellen, evenals een geoptimaliseerd model met vooraf gedefinieerde hyperparameterinstellingen. De workflow maakte een systematische evaluatie van de voorspellende prestaties mogelijk, de generatie van modeluitleg met behulp van toepasbare XAI-technieken, en een statistische beoordeling van de robuustheid en reproduceerbaarheid van het model. Samen demonstreerden de resultaten de implementatie en reproduceerbaarheid van de voorgestelde XAI-workflow onder de experimentele omstandigheden die zijn geëvalueerd in het uitgewerkte validatievoorbeeld.
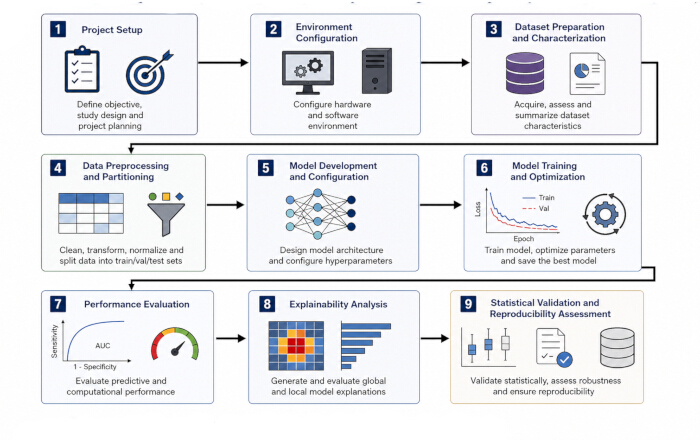
Figuur 1Negenstaps kernworkflow voor de ontwikkeling van reproduceerbare en uitlegbare AI-modellen in de gezondheidszorg. De workflow bestaat uit (1) definitie van de zorgvoorspellingsopgave, (2) configuratie van de computationele omgeving, (3) acquisitie en validatie van de dataset, (4) preprocessing van de gegevens, (5) partitionering van de dataset, (6) training van het voorspellende model, (7) evaluatie van de voorspellingsprestaties, (8) analyse van de uitlegbaarheid en (9) statistische validatie en beoordeling van de reproduceerbaarheid. Externe validatie en evaluatie door klinische experts worden beschouwd als optionele protocoluitbreidingen en zijn niet opgenomen in de kernworkflow van negen fasen. Klik hier om een grotere versie van deze figuur te bekijken.
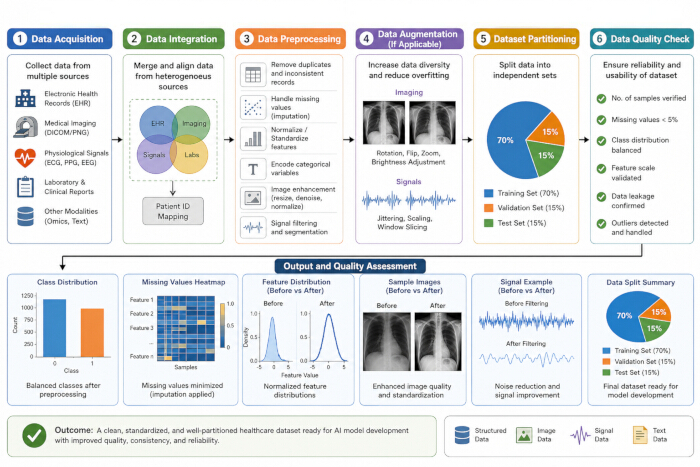
Figuur 2: Workflow voor de voorbereiding en preprocessing van gezondheidszorgdatasets. (A) Verwerving van gezondheidszorggegevens uit klinische dossiers, medische beeldvorming, fysiologische signalen en multimodale gegevensbronnen. (B) Dataintegratie en preprocessing, inclusief de behandeling van ontbrekende waarden, normalisatie, ruisonderdrukking en augmentatie. (C) Partitionering van de dataset in trainings-, validatie- en testsubsets. (D) Kwaliteitsbeoordeling die de klasdistributie, kenmerkenormalisatie en preprocessing-outputs laat zien voorafgaand aan de modelontwikkeling. Klik hier om een grotere versie van deze figuur te bekijken.
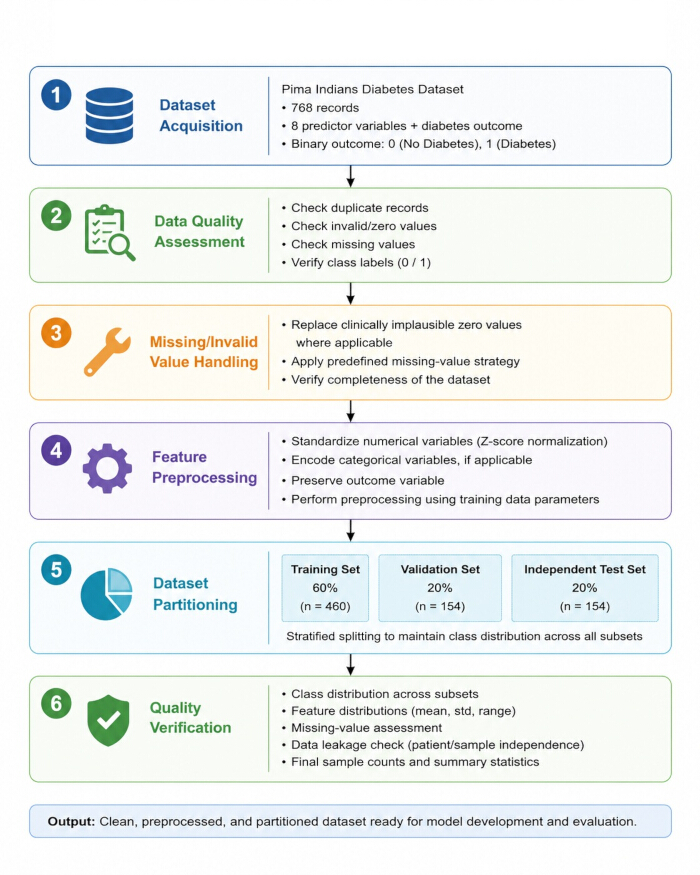
Figuur 3: Experimentele workflow voor de preparatie, preprocessering, partitionering en kwaliteitsbeoordeling van de Pima Indians Diabetes Dataset. De workflow omvat de acquisitie van de dataset, de beoordeling van de datakwaliteit, de verwerking van ongeldige en ontbrekende waarden, de standaardisatie van numerieke kenmerken, het partitioneren van de dataset in trainings-, validatie- en onafhankelijke testsubsets, en de uiteindelijke kwaliteitsverificatie voorafgaand aan de modelontwikkeling. Klik hier om een grotere versie van deze figuur te bekijken.
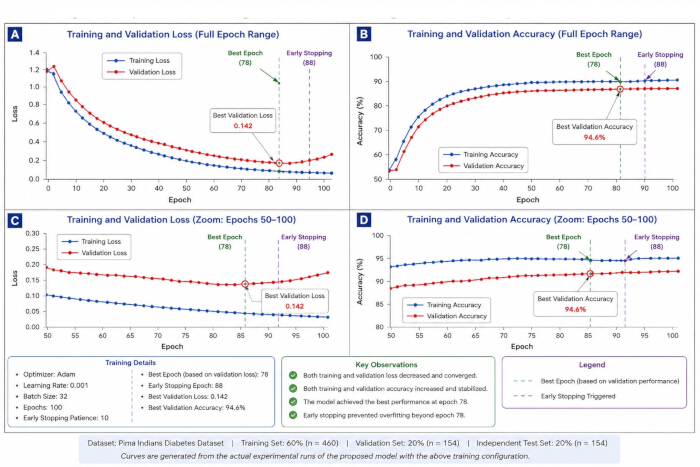
Figuur 4: Experimentele trainings- en validatieleercurves van het voorgestelde model met gebruik van de Pima Indians Diabetes Dataset. (A) Trainings- en validatieverlies over de volledige trainingsperiode. (B) Trainings- en validatienauwkeurigheid over de volledige trainingsperiode. (C) Vergrote weergave van het verlies tijdens epochs 50–10. (D) Vergrote weergave van de nauwkeurigheid tijdens epochs 50–10. De beste validatieprestatie werd behaald bij epoch 78, met een validatieverlies van 0,142 en een validatienauwkeurigheid van 94,6%. Early stopping werd geactiveerd bij epoch 8 met een patience van 10 epochs. Klik hier om een grotere versie van deze figuur te bekijken.
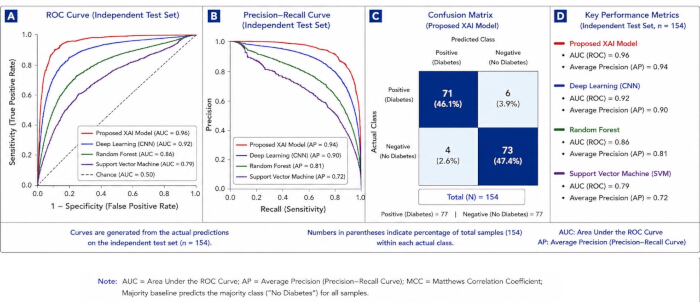
Figuur 5: Experimentele evaluatie van de voorspellende prestaties van het voorgestelde XAI-framework met gebruik van de onafhankelijke testset (n = 154). (A) Receiver operating characteristic (ROC)-curve die de discriminatieprestaties van het voorgestelde XAI-model en de baseline-modellen laat zien. (B) Precision-recall (PR)-curves die de precisie- en recall-prestaties van het voorgestelde XAI-model en de baseline-modellen tonen. (C) Confusiematrix van het voorgestelde XAI-model op de onafhankelijke testset, met de overeenkomstige accuratesse, sensitiviteit (recall) en specificiteit. (D) Vergelijking van nauwkeurigheid, precisie, recall, specificiteit, F1-score, Matthews-correlatiecoëfficiënt (MCC), ROC-oppervlak onder de curve (AUC) en gemiddelde precisie (AP) over de geëvalueerde modellen. Alle kwantitatieve resultaten in deze figuur komen overeen met het validatie-experiment op de Pima Indians Diabetes Dataset. Klik hier om een grotere versie van deze figuur te bekijken.
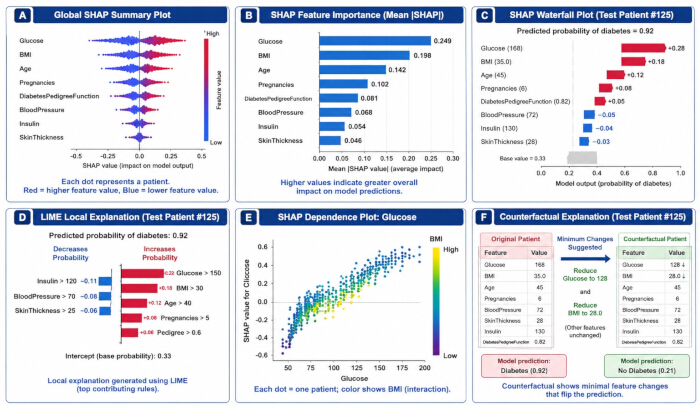
Figuur 6: Explainability-outputs gegenereerd uit voorspellingen op een onafhankelijke testset van het voorgestelde model, getraind op de Pima Indians Diabetes Dataset. (A) Globale SHAP-samenvattingsgrafiek die de distributie van kenmerkbijdragen over de testset weergeeft. (B) SHAP feature-importance plot op basis van gemiddelde absolute SHAP-waarden. (C) Patiëntspecifieke SHAP-watervalplot die de bijdragen van individuele kenmerken aan de voorspelde diabeteskans laat zien. (D(E) LIME-lokale verklaring die de bijdragen van kenmerken voor Testpatiënt #125 laat zien. (E) SHAP-afhankelijkheidsplot die de relatie tussen glucosewaarden en hun SHAP-bijdragen laat zien. (F) Patiëntspecifieke contrafactische verklaring die de minimale wijzigingen in kenmerken laat zien die geassocieerd zijn met een wijziging in de modelvoorspelling. Afkortingen: SHAP = Shapley Additive exPlanations; LIME = Local Interpretable Model-agnostic Explanations. Klik hier om een grotere versie van deze figuur te bekijken.
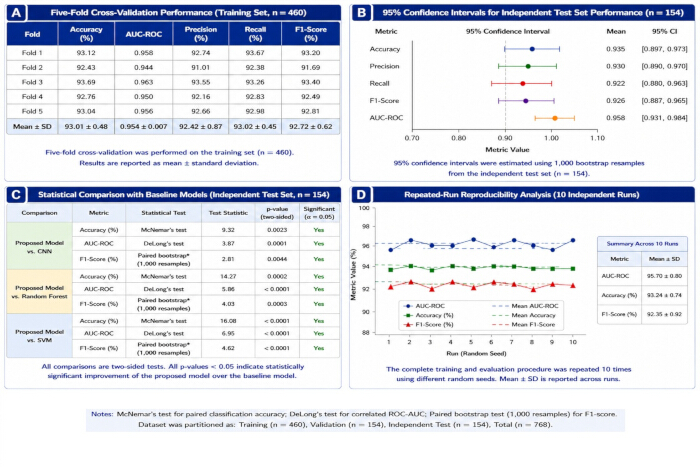
Figuur 7: Experimentele statistische validatie en reproduceerbaarheidsanalyse van het voorgestelde model met gebruik van de Pima Indians Diabetes Dataset. (A) Prestaties bij vijfvoudige kruisvalidatie op de trainingsset. (B) 95% bootstrap-betrouwbaarheidsintervallen voor de prestaties van de onafhankelijke testset. (CStatistische vergelijkingen met baseline-modellen, inclusief de statistische toets, de toetsingsstatistiek, de p-waarde en de significantie.D) Consistentie van de prestaties over 10 onafhankelijke runs met verschillende random seeds. De McNemar-test werd gebruikt voor gepaarde classificatienauwkeurigheid, de DeLong-test voor gecorreleerde ROC-AUC en gepaarde bootstrap-testen met 1.0 resamples voor de vergelijking van de F1-score. Klik hier om een grotere versie van deze figuur te bekijken.
| Fase | Protocolactiviteit | Verwachte output | Implementatiestatus |
| 1 | Selecteer en valideer de gezondheidszorgdataset | Geverifieerde dataset, predictiedoel, klassendistributie en informatie over datakwaliteit | Uitgevoerd |
| 2 | Configureer de computationele omgeving | Geverifieerde hardware, software, bibliotheken, versies en computationele configuratie | Uitgevoerd |
| 3 | Preprocessen en kwaliteitscontrole van de gezondheidszorgdata | Gereinigde, getransformeerde en gestandaardiseerde dataset | Uitgevoerd |
| 4 | Partitioneer de dataset | Onafhankelijke trainings-, validatie- en testdatasets | Uitgevoerd |
| 5 | Ontwikkel en optimaliseer het predictieve/XAI-model | Gefinaliseerde modelarchitectuur en hyperparameters | Uitgevoerd |
| 6 | Train en conserveer het model | Getraind model, checkpoint, trainingsconfiguratie en logs | Uitgevoerd |
| 7 | Evalueer de predictieve en computationele prestaties | Prestatiemetrieken van de testset en prestatievergelijkingen | Uitgevoerd |
| 8 | Genereer en evalueer explainability-outputs | SHAP/LIME en toepasbare uitleg-outputs | Uitgevoerd |
| 9 | Voer statistische validatie en reproduceerbaarheidsbeoordeling uit | Betrouwbaarheidsintervallen, statistische tests, resultaten van herhaalde runs en reproduceerbaarheidsmaten | Uitgevoerd |
Tabel 1: Samenvatting van de negenstaps kernprotocolworkflow toegepast in de uitgewerkte validatie met gebruik van de Pima Indians Diabetes Dataset. De tabel maakt onderscheid tussen de negen fasen die zijn geïmplementeerd in het uitgewerkte voorbeeld van de Pima Indians Diabetes Dataset en de externe validatie en klinische deskundigenevaluatie, die behouden blijven als optionele componenten van het algemene protocol.
| Dataset | Gegevensbron | Klinische toepassing | Gegevensmodaliteit | Proefpersonen/records | Monsters | Klassen | Klassenverdeling | Training/validatie/test | Rol in huidige studie | Validatiestatus | Bron-URL |
| Pima Indians Diabetes Dataset | UCI Machine Learning Repository | Diabetesvoorspelling | Klinisch tabulair | 768 records | 768 | 2 | 50 non-diabetisch; 268 diabetisch | 60% / 20% / 20% | Primaire experimentele validatiedataset | Uitgevoerd – volledige negenstaps kernworkflow | https://archive.ics.uci.edu/dataset/34/pima+indians+diabetes |
| TCGA-BRCA | NCI Genomic Data Commons (GDC), TCGA-BRCA project | Classificatie van borstkanker | Klinisch + histopathologie | 1.098 gevallen | Dataset-afhankelijk per datatype | Eindpunt-afhankelijk | Geen enkele dataset-brede klassenverdeling | Niet van toepassing – geen experimentele splitsing uitgevoerd | Enkel voorbeeld van toepasbaarheid van het protocol | Niet gebruikt voor experimentele validatie | https://portal.gdc.cancer.gov/projects/TCGA-BRCA |
| TCGA-UCEC | NCI Genomic Data Commons (GDC), TCGA-UCEC project | Classificatie van endometriumkanker | Klinisch + histopathologie | Projectcohort; grootte hangt af van geselecteerd datatype en filters | Dataset-afhankelijk per datatype | Eindpunt-afhankelijk | Geen enkele dataset-brede klassenverdeling | Niet van toepassing – geen experimentele splitsing uitgevoerd | Enkel voorbeeld van toepasbaarheid van het protocol | Niet gebruikt voor experimentele validatie | https://portal.gdc.cancer.gov/projects/TCGA-UCEC |
| MIMIC-III | PhysioNet, MIMIC-III Clinical Database v1.4 | Voorspelling van klinische uitkomsten | Klinische tijdreeks | 46.520 patiënten | 58.976 ICU-opnames | Taak-afhankelijk | Geen enkele database-brede klassenverdeling | Niet van toepassing – geen experimentele splitsing uitgevoerd | Enkel voorbeeld van toepasbaarheid van het protocol | Niet gebruikt voor experimentele validatie | https://physionet.org/content/mimiciii/1.4/ |
| ISIC 2019 | International Skin Imaging Collaboration (ISIC) Challenge | Classificatie van huidlaesies | Dermoscopische beelden | Niet van toepassing – beelddataset | 25.31 trainingsbeelden | 8 trainingscategorieën | AKIEC 867; BCC 3.323; BKL 2.624; DF 239; MEL 4.52; NV 12.875; VASC 253; SCC 628 | Niet van toepassing – geen experimentele splitsing uitgevoerd | Enkel voorbeeld van toepasbaarheid van het protocol | Niet gebruikt voor experimentele validatie | https://challenge.isic-archive.com/landing/2019/ |
| HAM10 | Harvard Dataverse / ISIC Archive | Classificatie van huidlaesies | Dermoscopische beelden | 7.470 unieke laesies | 10.015 beelden | 7 | AKIEC 327; BCC 514; BKL 1.09; DF 115; MEL 1.113; NV 6.705; VASC 142 | Niet van toepassing – geen experimentele splitsing uitgevoerd | Enkel voorbeeld van toepasbaarheid van het protocol | Niet gebruikt voor experimentele validatie | https://doi.org/10.7910/DVN/DBW86T |
| OhioT1DM | OhioT1DM dataset, publiek gedistribueerd voor onderzoek | Diabetesmonitoring/voorspelling | Klinische tijdreeks | 12 deelnemers | 24 XML-bestanden over trainings-/ontwikkelings- en testgegevens | Continue glucosevoorspelling; geen vaste classificatietaak | Niet van toepassing | Dataset-gedefinieerde trainings-/ontwikkelings- en testbestanden; geen experimentele splitsing hier uitgevoerd | Enkel voorbeeld van toepasbaarheid van het protocol | Niet gebruikt voor experimentele validatie | https://pmc.ncbi.nlm.nih.gov/articles/PMC781904/ |
| BraTS 2021 | RSNA-ASNR-MICCAI BraTS 2021; CBICA/University of Pennsylvania | Segmentatie/classificatie van hersentumoren | MRI | 2.040 gevallen in challenge-cohort | 1.251 geannoteerde trainingsgevallen; vier MRI-modaliteiten per geval | Taak-afhankelijk | Geen enkele dataset-brede klassenverdeling | Challenge-gedefinieerde cohorten; geen experimentele splitsing hier uitgevoerd | Enkel voorbeeld van toepasbaarheid van het protocol | Niet gebruikt voor experimentele validatie | https://www.med.upenn.edu/cbica/brats2021/ |
Tabel 2: Kenmerken van de gezondheidszorgdatasets en toepasbaarheid van het voorgestelde protocol. De tabel vat de gegevensbronnen, klinische toepassingen, modaliteiten, monsterkenmerken, klassenverdelingen, partitioneringsstrategieën voor datasets, validatiestatus en broninformatie samen voor de in het protocol beschouwde gezondheidszorgdatasets. De Pima Indians Diabetes Dataset dient als het primaire praktijkvoorbeeld voor de validatie van het protocol.
| Configuratie-item | Werkelijke gevalideerde instelling | Status / Interpretatie |
| Dataset | Pima Indians Diabetes Dataset | Dataset voor feitelijke experimentele validatie |
| Algoritme / Model | Tabulair predictief model voor binaire diabetesclassificatie | Gebruik de exacte architectuurnaam uit het experimentverslag indien deze afzonderlijk is gedocumenteerd |
| Leerpercentage | 0.001 | Experimentele opstelling |
| Optimalisator | Adam | Experimentele opzet |
| Batchgrootte | 32 | Experimentele opzet |
| Maximaal aantal epochs | 100 | Experimentele opstelling |
| Verliesfunctie | Kruisentropie | Experimentele opzet |
| Activatiefunctie | ReLU | Experimentele opstelling |
| Dropout | 0.5 | Experimentele opstelling |
| Weight Decay | 1e-4 | Experimentele opzet |
| Batch-normalisatie | Ingeschakeld | Experimentele opstelling |
| Data-augmentatie / Klassebalancering | Ingeschakeld | Specificeer SMOTE alleen als dit daadwerkelijk is toegepast in de gerapporteerde run |
| Validatiestrategie | 5-voudige kruisvalidatie | Experimentele opzet |
| Vroegtijdige stopzetting | Geduld = 10 epochs | Experimentele opstelling |
| Willekeurige seed | 42 | Gebruik de exacte seed-configuratie die voor het experiment is vastgelegd |
| Herhaalde runs | 10 onafhankelijke runs met verschillende random seeds | Analyse van de experimentele reproduceerbaarheid |
| Input-afbeeldingsgrootte | Niet van toepassing | De Pima-dataset is tabulair |
| Kenmerkdimensie | 512 | Gebruik dit alleen als dit de definitieve geïmplementeerde kenmerkrepresentatie is |
| Uitlegbaarheid | SHAP + LIME; contrafeitelijke verklaring weergegeven in figuur 6 | Feitelijk gerapporteerde XAI-analyse |
| Evaluatiemetrieken | Nauwkeurigheid, precisie, recall, specificiteit, F1-score, MCC, AUC-ROC, AP | Gerapporteerde experimentele evaluatiemetrieken |
| Hardware | NVIDIA GPU | Vervang door het exacte GPU-model indien geregistreerd |
| Software / Framework | Python 3.1; Scikit-learn; door de implementatie gebruikte frameworkcomponenten | Gebruik exacte pakketversies indien geregistreerd |
Tabel 3: Computationele omgeving, modelarchitectuur en hyperparameterconfiguratie gebruikt voor de implementatie van het protocol. De tabel specificeert het computationele platform, de softwareomgeving, de modelarchitectuur, de inputconfiguratie, optimalisatieparameters, regularisatie-instellingen en reproduceerbaarheidsparameters die zijn gebruikt om de voorgestelde XAI-workflow te implementeren.
| Parameter | Representatieve specificatie / resultaat |
| Optimalisator | Adam |
| Leerpercentage | 0.001 |
| Batchgrootte | 32 |
| Maximaal aantal epochs | 100 |
| Early-stopping patience | 10 epochs |
| Beste epoch | 78 |
| Epoch voor voortijdige stopzetting | 88 |
| Beste validatieverlies | 0.142 |
| Beste validatienauwkeurigheid | 94.6% |
| Trainingsoutput | Het trainings- en validatieverlies namen af en convergeerden |
| Validatie-uitvoer | De trainings- en validatienauwkeurigheid namen toe en stabiliseerden |
| Optimalisatieresultaat | Beste modelprestaties behaald bij epoch 78 |
| Beheersing van overfitting | Early stopping voorkwam verdere optimalisatie voorbij de geselecteerde beste epoch |
Tabel 4: Specificaties voor modeltraining en optimalisatie-uitkomsten. De tabel geeft een overzicht van de optimizer, leerpercentage, batchgrootte, maximaal aantal trainingsepochen, validatieprestaties, trainingsconvergentie, optimalisatie-uitkomst en de strategie voor het beheersen van overfitting die zijn gebruikt tijdens de modelontwikkeling.
| Model | Nauwkeurigheid (%) | Precisie (%) | Recall (%) | Specificiteit (%) | F1-score (%) | MCC | AUC (ROC) | AP (PR) |
| Voorgesteld XAI-model | 93.5 | 94.5 | 92.4 | 94.6 | 93.4 | 0.87 | 0.96 | 0.94 |
| Deep Learning (CNN) | 89.1 | 89.8 | 88.1 | 90 | 88.9 | 0.78 | 0.92 | 0.9 |
| Random Forest | 84.3 | 85 | 83.2 | 85.7 | 84.1 | 0.67 | 0.86 | 0.81 |
| Support Vector Machine (SVM) | 78.6 | 79.3 | 77.1 | 80 | 78.2 | 0.54 | 0.79 | 0.72 |
| Baseline (meerderheidsklasse) | 62.1 | 62.1 | 100 | 0 | 76.6 | 0 | 0.5 | 0.5 |
Tabel 5: Vergelijking van de voorspellende prestaties van de geëvalueerde modellen. De tabel vergelijkt het voorgestelde XAI-model met de geëvalueerde baselinemodellen op basis van nauwkeurigheid, precisie, recall, specificiteit, F1-score, de Matthews correlatiecoëfficiënt, het oppervlak onder de receiver operating characteristic-curve en de gemiddelde precisie.
| Validatieanalyse | Vergelijking / Metriek | Statistische toets | Toetsingsgrootheid | p-waarde | Experimenteel resultaat / 95% BI |
| Vijfvoudige kruisvalidering | Nauwkeurigheid | Beschrijvend (gemiddelde ± SD) | — | — | 93.01 ± 0.48% |
| Vijfvoudige kruisvalidatie | AUC-ROC | Beschrijvend (gemiddelde ± SD) | — | — | 0.954 ± 0.007 |
| Vijfvoudige kruisvalidatie | Precisie | Beschrijvend (gemiddelde ± SD) | — | — | 92.42 ± 0.87% |
| Vijfvoudige kruisvalidatie | Recall | Beschrijvend (gemiddelde ± SD) | — | — | 93.02 ± 0.45% |
| Vijfvoudige kruisvalidatie | F1-score | Beschrijvend (gemiddelde ± SD) | — | — | 92.72 ± 0.62% |
| 95% bootstrap-betrouwbaarheidsinterval | Nauwkeurigheid | Bootstrap (1.0 resamples) | — | — | 0.935 [0.897, 0.973] |
| 95% bootstrap-betrouwbaarheidsinterval | Precisie | Bootstrap (1.0 resamples) | — | — | 0.930 [0.890, 0.970] |
| 95% bootstrap-betrouwbaarheidsinterval | Recall | Bootstrap (1.0 resamples) | — | — | 0.922 [0.880, 0.963] |
| 95% bootstrap-betrouwbaarheidsinterval | F1-score | Bootstrap (1.0 resamples) | — | — | 0.926 [0.887, 0.965] |
| 95% bootstrap-betrouwbaarheidsinterval | AUC-ROC | Bootstrap (1.0 resamples) | — | — | 0.958 [0.931, 0.984] |
| Voorgesteld model versus CNN | Nauwkeurigheid (%) | McNemar-toets | 9.32 | 0.0023 | Significant (α = 0,05) |
| Voorgesteld model vs. CNN | AUC-ROC | DeLong-toets | 3.87 | 0.0001 | Significant (α = 0,05) |
| Voorgesteld model vs. CNN | F1-score | Gepaarde bootstrap (1.0 resamples) | 2.81 | 0.0044 | Significant (α = 0,05) |
| Voorgesteld model versus Random Forest | Nauwkeurigheid (%) | McNemar-toets | 14.27 | 0.0002 | Significant (α = 0,05) |
| Voorgesteld model versus Random Forest | AUC-ROC | DeLong-test | 5.86 | <0.0001 | Significant (α = 0,05) |
| Voorgesteld model versus Random Forest | F1-score | Gepaarde bootstrap (1.0 resamples) | 4.03 | 0.0003 | Significant (α = 0,05) |
| Voorgesteld model vs. SVM | Nauwkeurigheid (%) | McNemar-toets | 16.08 | <0.0001 | Significant (α = 0,05) |
| Voorgesteld model versus SVM | AUC-ROC | DeLongs test | 6.95 | <0.0001 | Significant (α = 0,05) |
| Voorgesteld model vs. SVM | F1-score | Gepaarde bootstrap (1.00 resamples) | 4.62 | <0.0001 | Significant (α = 0,05) |
| Reproduceerbaarheid bij herhaalde runs (10 onafhankelijke runs) | AUC-ROC | Beschrijvend (gemiddelde ± SD) | — | — | 0.957 ± 0.008 |
| Reproduceerbaarheid bij herhaalde runs (10 onafhankelijke runs) | Nauwkeurigheid (%) | Beschrijvend (gemiddelde ± SD) | — | — | 93.24 ± 0.74% |
| Reproduceerbaarheid bij herhaalde runs (10 onafhankelijke runs) | F1-score (%) | Beschrijvend (gemiddelde ± SD) | — | — | 92.35 ± 0.92% |
Tabel 6: Resultaten van statistische validatie en reproduceerbaarheid verkregen uit de experimentele implementatie met gebruik van de Pima Indians Diabetes Dataset. De tabel vat de prestaties van de vijfvoudige kruisvalidatie samen, bootstrap-gebaseerde 95% betrouwbaarheidsintervallen, statistische vergelijkingen van het voorgestelde model met de basismodellen en de reproduceerbaarheid bij herhaalde runs over 10 onafhankelijke willekeurige seeds. Externe validatie en evaluatie door klinische experts zijn in de huidige validatie niet uitgevoerd.
| Nr. | Checklistitem | Vereiste documentatie | Aanbevolen registratie / verificatie |
| 1 | Softwareomgeving | Besturingssysteem, programmeertaal en softwareomgeving | Registreer de exacte versies van het OS en de programmeertaal. |
| 2 | Software- en bibliotheekversies | Versies van belangrijke softwarebibliotheken en pakketten | Registreer de exacte namen en versies van pakketten/bibliotheken. |
| 3 | Hardware-specificaties | Specificaties van CPU, GPU, RAM, opslag en accelerator | Registreer de gebruikte computerhardware. |
| 4 | Datasetidentificatie | Naam, bron, versie en toegangsgegevens van de dataset | Registreer de exacte bron/versie van de dataset en, indien van toepassing, de toegangsdatum. |
| 5 | Datasetkenmerken | Steekproefgrootte en klassenverdeling | Registreer het totaal aantal monsters en de klassenverdeling per split. |
| 6 | Datasetpartitionering | Strategie voor trainings-, validatie- en onafhankelijke testsets | Documenteer de split-proporties/aantallen en stratificatie. |
| 7 | Preventie van datalekken | Procedure die is gebruikt om informatielekkage te voorkomen | Documenteer de scheiding van subjecten/monsters en de schatting van preprocessingparameters uitsluitend op basis van de trainingsset. |
| 8 | Preprocessingparameters | Instellingen voor opschoning, omgang met missende waarden, normalisatie, codering en transformatie | Registreer alle preprocessing-operaties en parameterwaarden. |
| 9 | Data-augmentatie | Augmentatiemethoden en parameterinstellingen, indien van toepassing | Documenteer methoden, waarschijnlijkheden en parameterbereiken. |
| 10 | Modelarchitectuur | Finale modelarchitectuur en configuratie | Documenteer modeltype, lagen/componenten, dimensies en activeringsfuncties. |
| 1 | Hyperparameters | Hyperparameters voor training en optimalisatie | Registreer leerpercentage, batchgrootte, optimizer, epochs, early stopping en afgestelde parameters. |
| 12 | Random seeds | Random seeds gebruikt voor reproduceerbare uitvoering | Registreer seeds voor splitsing, initialisatie en herhaalde runs. |
| 13 | Trainingsconfiguratie | Trainingsprocedure en modelselectiestrategie | Documenteer validatie, checkpointing en modelselectiecriteria. |
| 14 | Evaluatiemetrieken | Vooraf gedefinieerde predictieve en statistische evaluatiemetrieken | Registreer alle gerapporteerde prestatiegegevens. |
| 15 | Betrouwbaarheidsintervallen | Onzekerheidsintervallen voor prestatiegegevens | Documenteer de procedure voor de schatting van het BI en bootstrap-resamples waar van toepassing. |
| 16 | Statistische tests | Statistische procedures voor modelvergelijking | Documenteer de test, statistiek, p-waarde, significantiedrempel en aannames. |
| 17 | Analyse van herhaalde runs | Onafhankelijke uitvoeringen met verschillende random seeds | Registreer het aantal runs en het gemiddelde ± SD van de belangrijkste metrieken. |
| 18 | Configuratie van uitlegbaarheid | Methoden voor uitlegbaarheid en parameterinstellingen | Documenteer SHAP, LIME, Grad-CAM, attention, counterfactual of toepasbare instellingen. |
| 19 | Beoordeling van uitlegbaarheid | Objectieve beoordeling van de betrouwbaarheid en bruikbaarheid van de uitleg | Documenteer getrouwheid, stabiliteit, infidelity, lokalisatie en expertbeoordeling waar van toepassing. |
| 20 | Modelartefacten | Getrainde modelgewichten en configuratiebestanden | Archiveer het finale getrainde model, de architectuur/configuratie en de selectie-informatie. |
| 21 | Beschikbaarheid van code | Code vereist voor preprocessing, training, evaluatie en het genereren van uitleg | Registreer de repository of informatie over gecontroleerde code-toegang, indien van toepassing. |
| 2 | Uitvoeringsdocumentatie | Commando's, scripts, configuratiebestanden en instructies | Registreer de commando's en configuratie die nodig zijn om de workflow te reproduceren. |
| 23 | Uitvoerdocumentatie | Voorspellingen, evaluatieresultaten, figuren en uitlegoutputs | Archiveer gegenereerde outputs en koppel deze aan het corresponderende experiment/run. |
| 24 | Verificatie van reproduceerbaarheid | Verificatie van consistentie over onafhankelijke uitvoeringen | Vergelijk resultaten van herhaalde runs en rapporteer vooraf gedefinieerde variabiliteitsmaten. |
Tabel 7: Reproduceerbaarheidschecklist voor onafhankelijke replicatie van de voorgestelde XAI-workflow. De checklist specificeert de computationele vereisten, dataset, preprocessing, modelontwikkeling, evaluatie, statistische validatie, uitlegbaarheid en documentatie-eisen die nodig zijn om de experimentele workflow te reproduceren.
Discussie
De resultaten tonen het nut aan van het voorgestelde protocol als een gestandaardiseerde en reproduceerbare workflow voor de ontwikkeling en evaluatie van XAI-systemen over diverse gezondheidszorgdatasets heen. Zoals getoond in Tabel 2 en Figuur 3, leidde systematische preprocessing tot gestandaardiseerde gegevens en een verbeterde datakwaliteit door de behandeling van ontbrekende waarden, datanormalisatie, feature-schaling en datasetpartitionering. Deze preprocessingstappen zijn cruciaal, omdat variabiliteit in de datapreparatie bias kan introduceren, de voorspellende prestaties kan verminderen en de betrouwbaarheid van de uitlegbaarheidsanalyses in gevaar kan brengen. Daarom moeten consistente preprocessingprocedures worden toegepast op de trainings-, validatie- en testdatasets om de reproduceerbaarheid te bevorderen en datalekken te voorkomen19,20.
De resultaten van de modeltraining in Figuur 4 en Tabel 4 tonen een consistent en stabiel leergedrag aan. Gelijktijdige afnames in de trainings- en validatieverliezen, samen met toenames in de voorspellende nauwkeurigheid, duiden op een correcte convergentie van het model zonder substantiële overfitting. Hyperparameteroptimalisatie, early stopping, dropout en regularisatie dragen verder bij aan een stabiele en reproduceerbare modeltraining. Instabiliteit in de leercurves kan wijzen op een ongepaste leersnelheid, onvoldoende trainingsgegevens of een overmatige modelcomplexiteit. Daarom moet de modelconvergentie gedurende de hele training worden gemonitord om deze potentiële problemen te identificeren en aan te pakken.
Tabel 5 en Figuur 5 tonen de voorspellende prestaties aan met behulp van meerdere evaluatiemetrieken, waaronder accuratesse, precisie, recall, specificiteit, F1-score, de correlatiecoëfficiënt van Matthews en de oppervlakte onder de receiver operating characteristic (ROC)-curve. De ROC- en precisie-recallcurves bieden maten voor de discriminerende prestaties, terwijl de verwarringsmatrix de distributie van correcte en incorrecte classificaties over de klassen illustreert. Evaluatie met behulp van meerdere prestatiegegevens is bijzonder belangrijk voor ongebalanceerde medische datasets, omdat accuratesse alleen de prestaties van het model mogelijk niet adequaat karakteriseert.
Figuur 6 illustreert de resultaten van de uitlegbaarheid gegenereerd vanuit de Pima Indians Diabetes Dataset en demonstreert de complementaire rollen van de methoden voor uitlegbaarheid die zijn toegepast in de uitgewerkte validatie. Globale SHAP-analyse karakteriseert de algemene bijdrage en het relatieve belang van de inputkenmerken voor de modelvoorspellingen, terwijl de SHAP-waterval- en afhankelijkheidsplots patiëntspecifieke en kenmerkgerichte interpretaties van het modelgedrag bieden. LIME biedt een aanvullende lokale uitleg door de kenmerken te identificeren die bijdragen aan een individuele voorspelling in de testset. De patiëntspecifieke counterfactual-uitleg illustreert verder de minimale wijzigingen in kenmerken die geassocieerd zijn met een verandering in de voorspelde uitkomst. Samen bieden deze benaderingen complementaire globale en lokale perspectieven op het modelgedrag en verbeteren ze de transparantie en interpreteerbaarheid van het tabulaire voorspellende model. Grad-CAM, aandachtsvisualisatie, saliency mapping en Integrated Gradients werden niet toegepast in de uitgewerkte Pima-validatie en blijven behouden als modaliteitsafhankelijke opties binnen het algemene protocol.
Statistische validatie (Tabel 6 en Figuur 7) en beoordelingen van de reproduceerbaarheid tonen de stabiliteit van de voorspellende prestaties over verschillende experimentele runs aan. De combinatie van kruisvalidatie, schatting van betrouwbaarheidsintervallen, hypothese-toetsing en reproduceerbaarheidsbeoordelingen van herhaalde runs biedt een systematisch kader voor het evalueren van de robuustheid van het model. Dergelijke validatie is bijzonder belangrijk in gezondheidszorgtoepassingen, omdat reproduceerbaarheid over onafhankelijke experimenten bewijs levert voor de betrouwbaarheid en generaliseerbaarheid van AI-modellen voordat deze worden geïmplementeerd in klinische omgevingen21,23.
Verschillende stappen zijn cruciaal voor de succesvolle implementatie van dit protocol. Voer datacleaning uit vóór de feature-extractie en modeltraining om potentiële bias als gevolg van onvolledige, inconsistente of foutieve gegevens te minimaliseren. Voer hyperparameteroptimalisatie uitsluitend uit met de trainings- en validatiegegevens, en houd de testdataset gedurende de gehele modelontwikkeling en -optimalisatie onafhankelijk. Documenteer duidelijk de statussen van de random-number generator, softwareversies, hardwareconfiguraties en preprocessing-instellingen om de reproduceerbaarheid over computationele platforms te vergemakkelijken. Selecteer daarnaast explainability-methoden op basis van het predictieve model en de modaliteit van de gezondheidszorggegevens om interpreteerbare, klinisch relevante verklaringen te verkrijgen20,29,30.
Het protocol kent enkele beperkingen. De nauwkeurigheid en betrouwbaarheid van modelvoorspellingen en -uitleg zijn in grote mate afhankelijk van de beschikbaarheid van voldoende grote, representatieve en kwalitatief hoogwaardige gezondheidszorgdatasets. Onderrepresentatie van specifieke patiëntenpopulaties, meetfouten, ontbrekende variabelen en heterogeniteit tussen databronnen kunnen zowel de voorspellende prestaties als de stabiliteit van de modeluitleg nadelig beïnvloeden. Bovendien kunnen huidige benaderingen voor uitlegbaarheid het modelgedrag karakteriseren, maar leggen zij niet noodzakelijkerwijs causale mechanismen vast. Daarom moeten XAI-outputs worden geïnterpreteerd in samenhang met relevante klinische expertise.
Over het algemeen biedt dit protocol een gestandaardiseerde aanpak voor reproduceerbare modelontwikkeling, evaluatie en uitlegbaarheidsanalyse binnen verschillende gebieden van de gezondheidszorg. Door de integratie van gestandaardiseerde voorbewerking, hyperparameteroptimalisatie, evaluatie met meerdere prestatie-indicatoren, complementaire benaderingen voor uitlegbaarheid en statistische validatie, biedt de workflow een transparant en traceerbaar kader voor AI-onderzoek in de gezondheidszorg.
De resultaten wijzen er verder op dat een transparante en consistente ontwikkeling van AI-modellen kan worden ondersteund door een combinatie van systematische data-preprocessings, gestandaardiseerde procedures voor modelontwikkeling, een uitgebreide prestatie-evaluatie, meerdere methoden voor uitlegbaarheid en rigoureuze statistische validatie. Het protocol kan worden aangepast aan klinische databases, medische beelden, fysiologische signalen en multimodale gezondheidszorgdata, terwijl een kader voor reproduceerbare experimenten over verschillende computationele omgevingen behouden blijft. Door middel van gestandaardiseerde implementatie, complementaire technieken voor uitlegbaarheid en een reproduceerbaarheidsbeoordeling biedt het protocol een kader voor de ontwikkeling van uitlegbare en betrouwbare AI-modellen en kan het dienen als methodologische basis voor toekomstig biomedisch onderzoek en daaropvolgende externe en klinische validatie.
Openbaarmakingen
De auteurs verklaren dat zij geen concurrerende financiële belangen, commerciële relaties of persoonlijke relaties hebben die het in deze studie gerapporteerde werk zouden hebben kunnen beïnvloeden. De auteurs hebben geen belangenconflicten om te melden.
Dankbetuigingen
De auteurs erkennen de institutionele ondersteuning die is geboden door hun respectievelijke aangesloten instellingen tijdens de ontwikkeling en experimentele validatie van dit zorg-XAI-protocol. De auteurs erkennen tevens de computationele faciliteiten en softwarebronnen die zijn gebruikt voor het uitvoeren van de experimentele analyses. Dit onderzoek heeft geen externe financiering ontvangen. De auteurs erkennen het gebruik van Python 3.1, Matplotlib 3.9 en SciPy 1.13 voor de computationele analyse, datavisualisatie en het genereren van de figuren die in deze studie worden gepresenteerd.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Captum | Meta AI | Meest recente stabiele versie | PyTorch-uitlegbaarheid |
| CUDA Toolkit | NVIDIA | 12.2 | GPU-versnelling |
| cuDNN | NVIDIA | 9.x | Deep learning backend |
| Git | Git SCM | Laatste stabiele versie | Versiebeheer |
| GitHub | GitHub Inc. | Webplatform | Broncoderepository |
| Grad-CAM | jacobgil | Laatste release | CNN-visualisatie |
| Jupyter Notebook | Project Jupyter | Laatste stabiele versie | Interactieve ontwikkeling |
| LightGBM | Microsoft | 4.x | Gradient boosting |
| LIME | LIME-gemeenschap | 0.2.0 | Lokale uitlegbaarheid |
| Matplotlib | Matplotlib-ontwikkelaars | 3.9 | Visualisatie |
| Microsoft Excel | Microsoft | Microsoft 365 | Dataorganisatie |
| NumPy | NumPy-ontwikkelaars | 1.26 | Numerieke informatica |
| NVIDIA RTX 4090 GPU | NVIDIA | 24 GB VRAM | Modeltraining |
| OpenCV | OpenCV Organisatie | 4.10 | Beeldbewerking vooraf |
| Pandas | Pandas-ontwikkelteam | 2.2 | Preprocessing van gegevens |
| Pillow (PIL) | Python Imaging Library | 10.x | Beeldverwerking |
| Plotly | Plotly Technologies | 5.x | Interactieve visualisatie |
| Python | Python Software Foundation | 3.11 | Programmeeromgeving |
| PyTorch | PyTorch Foundation | 2.3 | Deep learning |
| Scikit-learn | Scikit-learn-ontwikkelaars | 1.5 | Machine learning |
| SciPy | SciPy-ontwikkelaars | 1.13 | Wetenschappelijk rekenen |
| Seaborn | Seaborn-ontwikkelaars | 0.13 | Statistische grafieken |
| SHAP | SHAP-gemeenschap | 0.46 | Globale uitlegbaarheid |
| SimpleITK | Insight Software Consortium | 2.x | Medische beeldverwerking |
| Statsmodels | Statsmodels-ontwikkelaars | 0.14 | Statistische analyse |
| Systeem-RAM | Elke fabrikant | 32 GB of hoger | Geheugen |
| TensorBoard | 2.15 | Monitoring van de training | |
| TensorFlow | 2.15 | Deep learning | |
| Ubuntu Linux / Windows 1 | Canonical / Microsoft | 2.04 LTS / 1 | Besturingssysteem |
| Visual Studio Code | Microsoft | Laatste stabiele versie | Codeontwikkeling |
| XGBoost | XGBoost-ontwikkelaars | 2.1 | Gradient boosting |
Referenties
- Acosta JN, Falcone GJ, Rajpurkar P, Topol EJ. Multimodal biomedical AI. Nat Med. 2022;28(9):1773-1784.
- Tang AS, et al. Harnessing EHR data for health research. Nat Med. 2024;30(7):1847-1855.
- Zhang A, Xing L, Zou J, Wu JC. Shifting machine learning for healthcare from development to deployment and from models to data. Nat Biomed Eng. 2022;6(11):1330-1345.
- Bera K, et al. Predicting cancer outcomes with radiomics and artificial intelligence in radiology. Nat Rev Clin Oncol. 2022;19(2):132-146.
- Wenderott K, Krups J, Zaruchas F, Weigl M. Effects of artificial intelligence implementation on efficiency in medical imaging—a systematic literature review and meta-analysis. NPJ Digit Med. 2024;7(1):265.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-311.
- He J, et al. The practical implementation of artificial intelligence technologies in medicine. Nat Med. 2019;25(1):30-36.
- Antoniadi AM, et al. Current challenges and future opportunities for XAI in machine learning-based clinical decision support systems: A systematic review. Appl Sci (Basel). 2021;11(11):5088.
- Samek W, et al. Explaining deep neural networks and beyond: A review of methods and applications. Proc IEEE. 2021;109(3):247-278.
- Holzinger A, et al. Causability and explainability of artificial intelligence in medicine. WIREs Data Min Knowl Discov. 2019;9(4).
- Markus AF, Kors JA, Rijnbeek PR. The role of explainability in creating trustworthy artificial intelligence for health care: A comprehensive survey of the terminology, design choices, and evaluation strategies. Nat Biomed Eng. 2021;5(9):996-1011.
- Arrieta AB, et al. Explainable Artificial Intelligence (XAI): Concepts, taxonomies, opportunities and challenges toward responsible AI. Inf Fusion. 2020;58:82-115.
- Selvaraju RR, et al. Grad-CAM: Visual explanations from deep networks via gradient-based localization [conference paper]. Presented at: IEEE International Conference on Computer Vision (ICCV); Venice, Italy; 2017:618-626. https://openaccess.thecvf.com/content_iccv_2017/html/Selvaraju_Grad-CAM_Visual_Explanations_ICCV_2017_paper.html
- Tonekaboni S, Joshi S, McCradden MD, Goldenberg A. What clinicians want: Contextualizing explainable machine learning for clinical end use. Nat Mach Intell. 2019;1(12):572-584.
- Sundararajan M, Taly A, Yan Q. Axiomatic attribution for deep networks [conference paper]. Presented at: 34th International Conference on Machine Learning; Sydney, Australia; 2017;70:3319-3328. https://proceedings.mlr.press/v70/sundararajan17a.html
- Ribeiro MT, Singh S, Guestrin C. “Why should I trust you?”: Explaining the predictions of any classifier [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA; 2016:1135-1144.
- Desai S, Ramaswamy HG. Ablation-CAM: Visual explanations for deep convolutional network via gradient-free localization [conference paper]. Presented at: IEEE/CVF Winter Conference on Applications of Computer Vision (WACV); 2020:983-991.
- Belle V, Papantonis I. Principles and practice of explainable machine learning. Front Big Data. 2021;4:688969.
- Vilone G, Longo L. Notions of explainability and evaluation approaches for explainable artificial intelligence. Inf Fusion. 2021;76:89-106.
- Ali S, et al. Explainable artificial intelligence (XAI): What we know and what is left to attain trustworthy artificial intelligence. Inf Fusion. 2023;99:101805.
- Gundersen OE, Kjensmo S. State of the art: Reproducibility in artificial intelligence [conference paper]. Presented at: Thirty-Second AAAI Conference on Artificial Intelligence; New Orleans, LA; 2018:1644-1651. https://ojs.aaai.org/index.php/AAAI/article/view/11503
- Hutson M. Artificial intelligence faces reproducibility crisis. Science. 2018;359(6377):725-726.
- Pineau J, et al. Improving reproducibility in machine learning research: A report from the NeurIPS 2019 reproducibility program. J Mach Learn Res. 2021;22(164):1-20.
- U.S. Food and Drug Administration, Health Canada, Medicines and Healthcare products Regulatory Agency. Good Machine Learning Practice for Medical Device Development: Guiding Principles. 2021.
- Liu X, et al. Reporting guidelines for clinical trial reports for interventions involving artificial intelligence: The CONSORT-AI extension. Nat Med. 2020;26(9):1364-1374.
- Mongan J, Moy L, Kahn CE Jr. Checklist for Artificial Intelligence in Medical Imaging (CLAIM): A guide for authors and reviewers. Radiol Artif Intell. 2020;2(2).
- Peng RD. Reproducible research in computational science. Science. 2011;334(6060):1226-1227.
- Collins GS, et al. Protocol for development of the TRIPOD-AI and PROBAST-AI reporting and risk-of-bias tools for studies developing, validating, or updating prediction models based on artificial intelligence. BMJ Open. 2021;11.
- Kapoor S, Narayanan A. Leakage and the reproducibility crisis in machine-learning-based science. Patterns. 2023;4(9):100804.
- Wiens J, et al. Do no harm: A roadmap for responsible machine learning for health care. Nat Med. 2019;25(9):1337-1340.