Geïntegreerde bulk- en single-cell transcriptomische analyses identificeerden zes diagnostische biomarkers voor keloïden die gerelateerd zijn aan het heemmetabolisme. Experimentele validatie ondersteunde de dysregulatie van de feline leukemia virus subgroup C receptor 1 (FLVCR1) in keloïde fibroblasten, terwijl moleculaire docking (+)-gallocatechine identificeerde als een potentiële FLVCR1-interacterende verbinding die verdere functionele onderzoeken rechtvaardigt.
Onderzoeksartikel
Identificatie van biomarkers gerelateerd aan het heemmetabolisme in keloïden middels transcriptoomanalyse en gekweekte menselijke fibroblasten
In dit artikel
Samenvatting
Samenvatting
Keloïd is een fibroproliferatieve aandoening met een hoge recidiefkans en een onduidelijke pathogenese, waarbij effectieve therapeutische doelwitten ontbreken. Recent bewijs suggereert dat metabole herprogrammering, in het bijzonder in het heemmetabolisme, fibrose kan aansturen. Deze studie onderzoekt de rol van het heemmetabolisme, met een focus op de feline leukemia virus subgroup C receptor 1 (FLVCR1), in de pathogenese van keloïd en verkent het diagnostische en therapeutische potentieel hiervan. We hebben bulk RNA-seq datasets en single-cell RNA-seq data (scRNA-seq) geanalyseerd. Middels differentiële expressie, least absolute shrinkage and selection operator (LASSO) en random forest (RF) modellen werden diagnostische biomarkers geïdentificeerd die gerelateerd zijn aan het heemmetabolisme. Er werd onderzoek gedaan naar immuuninfiltratie, single-cell mapping, de constructie van microRNA (miRNA) netwerken en moleculaire docking met verbindingen uit de traditionele Chinese geneeskunde. Er werden zes biomarkers geïdentificeerd die gerelateerd zijn aan het heemmetabolisme, waarmee een diagnostisch nomogram met een hoge nauwkeurigheid werd gevormd. FLVCR1, verrijkt in endotheelcellen en melanocyten, correleerde negatief met T follicular helper cells, wat wijst op immunometabole crosstalk. Analyse van het miRNA-reguleringsnetwerk onthulde vijf miRNA's die alle zes biomarkers gezamenlijk targeten. Moleculaire docking identificeerde (+)-gallocatechine als een hoog-affiniteitsligand voor FLVCR1. Deze bevindingen suggereren een associatie tussen FLVCR1-gerelateerd heemmetabolisme en immuunveranderingen in de pathogenese van keloïd. Het biomarkerpanel vertoonde exploratief diagnostisch potentieel, en (+)-gallocatechine werd geïdentificeerd als een kandidaat-verbinding die interageert met FLVCR1 en verdere validatie vereist. Deze studie plaatst keloïd binnen het metabo-fibrotische spectrum en stelt metabool-immuuninterventie voor als een nieuwe therapeutische strategie.
Inleiding
Keloïd, een fibroproliferatieve aandoening die wordt gekenmerkt door overmatige depositie van extracellulaire matrix die zich uitstrekt buiten de grenzen van de oorspronkelijke huidbeschadiging, treft 4–16% van de wereldbevolking, met een aanzienlijk hogere prevalentie bij personen van Afrikaanse, Aziatische en Hispanische afkomst1,2. Ondanks het histologisch benigne karakter veroorzaakt keloïd aanzienlijke fysieke en psychosociale lasten door aanhoudende pruritus, pijn, functionele contracturen en cosmetische misvorming. Huidige therapeutische modaliteiten, waaronder intralesionele corticosteroïden, chirurgische excisie, radiotherapie en lasertherapie, blijven suboptimaal, met recidieven van meer dan 50% na monotherapie3,4,5. Deze therapeutische impasse onderstreept een fundamentele lacune in ons begrip van de pathogenese van keloïd, in het bijzonder de upstream-factoren die de fibrotische cascade initiëren en in stand houden buiten de canonieke profibrotische signalering.
Huidig onderzoek heeft zich voornamelijk gericht op canonieke paden, zoals TGF-β/Smad-signalering en aberrante fibroblastactivatie6,7,8. Hoewel infiltratie van immuuncellen — in het bijzonder M2-gepolariseerde macrofagen, regulatoire T-cellen en gedisreguleerde dendritische cellen — is gedocumenteerd in keloïdweefsels9,10, beschouwen deze onderzoeken immuunalteraties grotendeels als downstreamgevolgen van fibroblastdysfunctie in plaats van als upstream-orchestratoren. Cruciaal is dat de metabole programma's die deze immunofibrotische crosstalk actief kunnen vormgeven, volledig onontdekt blijven in de pathogenese van keloïden11,12,13. Deze kennishiaat is opvallend, gezien opkomende paradigma's bij fibrotische aandoeningen waarin metabole herprogrammering fungeert als een hoofdregulator van weefselremodellering.
Metabole herprogrammering is recent naar voren gekomen als een centraal knooppunt in fibrogeneze in meerdere organsystemen. Bij pulmonale en hepatische fibrose triggert een ontregelde heemhomeostase — door een gewijzigde expressie van transporters, scavengers of biosynthetische enzymen — oxidatieve stress, ferroptose en steriele inflammatie, die collageendepositie direct bevorderen14. Heemaccumulatie activeert het NLRP3-inflammasoom om fibroblastactivatie aan te drijven, terwijl een deficiëntie van de feline leukemia virus subgroup C receptor 1 (FLVCR1) weefselfibrose verergert door onopgeloste heemtoxiciteit. Deze bevindingen positioneren het heemmetabolisme niet louter als een huishoudelijk proces, maar als een dynamisch signaleringscentrum dat in staat is tot het initiëren van fibrotische cascades — een paradigma dat nog moet worden getest bij cutane fibroproliferatieve aandoeningen.
De plausibiliteit van heem-gemedieerde immunomodulatie wordt verder ondersteund door mechanisch bewijs uit modellen voor kanker en chronische ontsteking. Heem functioneert als een signaleringsmolecuul dat het lot van immuuncellen direct moduleert: het bevordert M1-naar-M2 macrofaagpolarisatie via TLR4/NF-κB-signalering15, beïnvloedt T-celdifferentiatie via Bach2-gemedieerde transcriptionele repressie16, en reguleert kritisch de rijping van dendritische cellen via FLVCR1-afhankelijke heemexport17,18. Opvallend is dat FLVCR1, een heemexporter in het plasmamembraan die essentieel is voor de cellulaire heemhomeostase, onlangs is geïmpliceerd bij de ontwikkeling van immuuncellen en endotheliale dysfunctie19. Deze convergente bewijslijnen positioneren FLVCR1 als een plausibel moleculair knooppunt dat de dysregulatie van het heemmetabolisme verbindt met pathologische immuunremodellering—een hypothese met verstrekkende implicaties voor de pathogenese van keloïden, gezien de kenmerkende immuunrijke micro-omgeving daarvan.
Ondanks aanzienlijke vooruitgang in het begrip van de interactie tussen heem en het immuunsysteem in andere ziektecontexten, is het nog volledig onverkend of een ontregeld heemmetabolisme fungeert als een stroomopwaartse drijver die het pathologische immuunlandschap bij keloïden initieert of versterkt. Deze kritieke kenniskloof rechtvaardigt dringend onderzoek om verschillende onderling verbonden redenen: keloïden delen kenmerkende pathologische eigenschappen — waaronder aanhoudende ontsteking en oxidatieve stress — met metabolisch gedreven fibrotische aandoeningen zoals pulmonale en hepatische fibrose, wat wijst op een potentiële gemeenschappelijkheid in de onderliggende regulatiemechanismen. De op FLVCR1 gerichte heemexportmachinerie is mechanistisch gevalideerd in niet-cutane weefsels om direct belangrijke immuunfuncties te sturen, zoals macrofaagpolarisatie en dendritische celrijping, wat een solide theoretische basis biedt voor extrapolatie naar de immunopathologie van keloïden20. Het belangrijkste is dat het targeten van deze metabool-immuunas een kans biedt voor een paradigmaverschuiving om verder te gaan dan de huidige symptomatische therapieën die enkel stroomafwaartse fibrotische effecten onderdrukken, waardoor interventie stroomopwaarts bij de metabole oorsprong van de ziekteprogressie mogelijk wordt21.
Op basis van deze redenering hebben we verondersteld dat FLVCR1-gecentreerde ontregeling van het heemmetabolisme het immuunmicro milieu actief herstructureert om de pathogenese van keloïden aan te drijven. Om deze hypothese systematisch te valideren, hebben we bulk- en single-cell transcriptomische analyses geïntegreerd in een meerlaagse aanpak: eerst identificeerden en valideerden we diagnostische biomarkers geassocieerd met het heemmetabolisme in keloïdweefsels met behulp van machine learning-algoritmen en verificatie in een onafhankelijke cohort; vervolgens brachten we de ruimtelijke expressiepatronen van deze biomarkers in kaart over verschillende cellulaire compartimenten—waaronder endotheelcellen, fibroblasten, melanocyten en immuunsubsets—via mapping met single-cell resolutie; daarna bepaalden we hun kwantitatieve correlaties met specifieke immuuncelpopulaties om functionele immuun-metabole koppelingen vast te stellen; en tot slot construeerden we een FLVCR1-gecentreerd microRNA (miRNA) regulerend netwerk en voerden we moleculaire docking uit met verbindingen uit de traditionele Chinese geneeskunde om behandelbare interventiepunten te identificeren. Dit uitgebreide onderzoek onthult niet alleen een voorheen niet erkende as tussen heemmetabolisme en immuniteit bij de pathogenese van keloïden, maar levert ook een translationeel relevant biomarkerpanel op met zowel diagnostisch als therapeutisch potentieel voor deze hardnekkige fibroproliferatieve aandoening.
Protocol
Ethische goedkeuring en geïnformeerde toestemming waren niet van toepassing op deze studie omdat alle gegevens afkomstig waren uit openbaar toegankelijke databases, waaronder de Gene Expression Omnibus (GEO), en er geen identificeerbare menselijke participanten of dierlijke proefpersonen direct betrokken waren.
Gegevensverwerving en voorbewerking
De genen die geassocieerd zijn met het heemmetabolisme werden verkregen uit de Molecular Signatures Database (MSigDB; zie de Tabel met materialen and Aanvullende Tabel S1), inclusief gensets van REACTOME_Heme_Biosynthesis, REACTOME_Heme_Degradation, Wikipathway_Heme_Biosynthesis, REACTOME_Scavenging_Heme_from_Plasma en HALLMARK_Heme_Metabolism. Alle in deze studie geanalyseerde datasets zijn verkregen uit openbaar toegankelijke bronnen. Twee bulk-genexpressie microarray-datasets werden opgehaald uit de Gene Expression Omnibus (GEO)-database: GSE44270, bestaande uit 18 keloïd- en 14 normale huidmonsters, en GSE7890, bestaande uit 10 keloïd- en 9 normale huidmonsters. GSE44270 en GSE7890 werden respectievelijk gegenereerd op de platforms GPL6244 en GPL570. De series matrix-bestanden en de bijbehorende monsterinformatie werden gedownload en geïmporteerd in de R-omgeving. Omdat de expressiewaarden in de series matrix-bestanden al waren gepreprocessed en genormaliseerd door de oorspronkelijke indieners van de data, werd er geen aanvullende log2-transformatie of normalisatie tussen monsters uitgevoerd. De twee datasets werden onafhankelijk verwerkt en niet samengevoegd omdat ze op verschillende microarray-platforms waren gegenereerd. De datasets werden gepreprocessed zoals hieronder beschreven (zie de Tabel met materialen). Genprobes werden gekoppeld aan hun overeenkomstige gensymbolen, en probes die geen genannotaties hadden of overeenkwamen met meerdere genen werden uitgesloten. Voor genen met meerdere probe-sets werd de expressiewaarde toegewezen op basis van het hoogste gedetecteerde expressieniveau. Daarnaast werden single-cell RNA-sequencinggegevens (scRNA-seq) uit GSE163973, bestaande uit drie keloidmonsters, gedownload en verwerkt volgens de kwaliteitscontrolenormen die zijn vastgesteld in de oorspronkelijke studie.
Screening en validatie van diagnostische markers gerelateerd aan het heemmetabolisme bij keloïden
Om differentieel tot expressie gebrachte genen die geassocieerd zijn met het heemmetabolisme in keloïden te identificeren, werd de Wilcoxon rank-sum toets toegepast op GSE44270 met behulp van de R-functie wilcox.test, met een significantiedrempel van P < 0.05. Om potentiële diagnostische markers voor keloïden te identificeren, werden twee machine-learningmodellen gebruikt: random forest (RF) en least absolute shrinkage and selection operator (LASSO) logistische regressie. De Random Forest-analyse werd uitgevoerd met een random seed van 1 om reproduceerbaarheid te garanderen (zie de Tabel met materialen). Het model werd geconstrueerd met 500 bomen (ntree = 500), en de genimportantie werd geëvalueerd op basis van de gemiddelde afname in node-onzuiverheid (IncNodePurity). Genen met importantiewaarden groter dan 0.3 werden geselecteerd als kandidaat-biomarkers afgeleid uit Random Forest. De LASSO logistische regressie werd uitgevoerd met α = 1, waarbij 50 lambda-waarden werden geëvalueerd tijdens de modeltraining (zie de Tabel met materialen). De optimale strafparameter werd bepaald middels 5-voudige kruisvalidatie met de cv.glmnet-functie, met een binomiale respons. Genen met niet-nul regressiecoëfficiënten werden behouden als LASSO-geselecteerde kandidaten. Ten slotte werd de intersectie van de genen die door Random Forest en LASSO-regressie waren geïdentificeerd, beschouwd als de uiteindelijke diagnostische gensignature. De uiteindelijke diagnostische gensignature werd geëvalueerd met behulp van een nomogram-gebaseerd model. Alle selectie van kenmerken en schattingen van modelparameters werden uitsluitend uitgevoerd in de discovery-cohort (GSE44270), en de vastgestelde signature van zes genen werd verder geëvalueerd in de onafhankelijke validatie-cohort (GSE7890). De diagnostische prestatie van het nomogram werd geëvalueerd door de oppervlakte onder de receiver operating characteristic-curve (AUC) te berekenen. Om de modelstabiliteit te onderzoeken, omvatte de analyse 5-voudige kruisvalidatie en 1.000 bootstrap-resampling-iteraties, waaruit een optimisme-gecorrigeerde AUC werd afgeleid. Vervolgens werd decision curve analysis (DCA) gebruikt om het potentiële netto voordeel van het nomogram te schatten; dit resultaat werd echter met voorzichtigheid geïnterpreteerd vanwege de kleine steekproefomvang.
Infiltratie van immuuncellen en correlatieanalyse
De verrijking van immuuncellen werd geëvalueerd via een single-sample gene set enrichment analysis (ssGSEA) (zie de Tabel van Materialen). De immuuncelsignatuurmatrix werd verkregen uit een eerder gepubliceerde studie van Charoentong et al.22 en bevatte 782 markergenen die 28 adaptieve en aangeboren immuuncelpopulaties vertegenwoordigen. De analyse werd uitgevoerd met een Gaussische kern op de continue, genormaliseerde microarray-expressiewaarden. Na het koppelen van de markergenen aan de expressiematrix was een minimale genenset-grootte van 10 vereist, en de resulterende ssGSEA-scores werden genormaliseerd. Alle overige instellingen bleven op hun standaardwaarden. Vervolgens werden Pearson-correlatiecoëfficiënten berekend om de relaties tussen de verrijkingsscores van immuuncellen en de expressie van diagnostische genen te beoordelen. De resulterende correlatiematrix werd gevisualiseerd als een correlatieplot, en geselecteerde associaties werden verder weergegeven als lollipop-plots (zie de Tabel van Materialen).
Verwerking en analyse van single-cell RNA-sequencinggegevens
Single-cell RNA-sequencinggegevens werden verkregen uit GSE163973, waarbij alleen de drie keloïdmonsters, KF1, KF2 en KF3, in de huidige analyse zijn opgenomen. De expressiegegevens werden geïmporteerd en verwerkt zoals hieronder beschreven (zie de Tabel met Materialen). Cellen met minder dan 200 of meer dan 6.000 totale unieke moleculaire identificatie (UMI)-counts werden uitgesloten, en voorspelde doubletten werden verwijderd. Genexpressie-counts voor elke cel werden genormaliseerd naar de totale cellulaire expressie, vermenigvuldigd met een schaalfactor van 10.000 en log-getransformeerd. Batch-geassocieerde variatie werd tijdens de dataschaling geregreerd, en de resulterende geschaalde residuen werden gebruikt voor downstream-analyse. De top 2.000 hoogvariabele genen werden geselecteerd op basis van hun gemiddelde expressie en dispersie, en op deze werd een hoofdcomponentenanalyse uitgevoerd. De eerste 15 hoofdcomponenten werden gebruikt om een k-nearest-neighbor-graaf te construeren op basis van Euclidische afstanden, die vervolgens werd omgezet in een shared nearest-neighbor-graaf. Cellen werden geclusterd met het Louvain-algoritme bij een resolutie van 0,8, en uniform manifold approximation and projection werd uitgevoerd met behulp van dezelfde 15 hoofdcomponenten. Celtypen werden geannoteerd volgens de celtype-definities die in de oorspronkelijke studie werden gerapporteerd, en de resulterende annotaties werden vastgelegd in het metadata-veld. Celtype-annotaties en clustertoewijzingen werden gevisualiseerd op de uniform manifold approximation and projection-coördinaten, en diagnostische genexpressie werd weergegeven over de geannoteerde celpopulaties.
Constructie van het miRNA–mRNA-regulerend netwerk
Het miRNA–mRNA-regulatienetwerk is geconstrueerd zoals hieronder beschreven (zie de Tabel met materialen). Homo sapiens is gekozen als organisme, en gen-identificatoren zijn opgegeven als Official Gene Symbols. Kandidaatgenen zijn ingevoerd in de Gene–miRNA Interactions-module, waarbij TarBase v9.0 is geselecteerd als interactiedatabase. TarBase bevat experimenteel gevalideerde miRNA–gen-regulatie-interacties. Voor de constructie van het netwerk zijn alleen experimenteel ondersteunde miRNA–mRNA-interacties met de ingevoerde kandidaatgenen behouden, terwijl voorspelde interacties zonder experimenteel bewijs zijn uitgesloten. Er is geen aanvullende drempelwaarde voor de betrouwbaarheidsscore (confidence-score) toegepast.
Structuurgebaseerde virtuele screening en moleculaire docking-analyse
Virtuele screening werd uitgevoerd om kandidaatliganden uit de verbindingenbibliotheek te prioriteren tegen menselijk FLVCR1 (feline leukemia virus subgroup C receptor-related protein 1; zie de Tabel met Materialen) met behulp van een structuurgebaseerde virtuele screeningsworkflow (SBVS). De driedimensionale structuur van menselijk FLVCR1 werd opgehaald uit de Protein Data Bank (PDB ID: 8UBZ). Deze structuur representeert choline-gebonden menselijk FLVCR1, bepaald via single-particle cryo-elektronenmicroscopie bij een globale resolutie van 3.02 Å (EMDB-toegang: EMD-42110). De experimenteel bepaalde structuur werd geselecteerd omdat deze de substraat-gebonden conformatie van FLVCR1 bevat en daarmee structurele informatie verschaft om de fysiologisch relevante ligand-bindingsholte te definiëren. Tijdens de receptorpreparatie werden de samen-opgeloste choline (CHT) en cholesterolhemisuccinaat (Y01) moleculen behouden om de structurele omgeving rond de substraat-ingangs- en ligand-bindingsregio te bewaren. De zoekruimte voor docking werd gedefinieerd rond de FLVCR1 substraat/ligand-bindingsholte, waarbij de samen-opgeloste choline-bindingsregio werd omvat. De grid-box was gecentreerd op x = 160.587 Å, y = 160.613 Å en z = 160.484 Å. De afmetingen van de docking-box werden ingesteld op [X × Y × Z Å] om een adequate dekking van de substraat-bindingsholte en de omliggende residuen te garanderen. Kandidaatverbindingen werden vervolgens gedockt in deze vooraf gedefinieerde bindingsregio. Docking-poses werden gerangschikt op basis van hun voorspelde bindingsaffiniteiten, waarbij negatievere docking-scores duidden op gunstigere voorspelde ligand–FLVCR1-interacties. De hoogst gerangschikte verbindingen werden geselecteerd voor daaropvolgende analyses van de bindingsmodus en de eiwit-ligand-interacties.
Moleculaire dynamicasimulatie en MM/GBSA-berekening van de vrije bindingsenergie
Moleculaire dynamica (MD)-simulatie werd gebruikt om het voorspelde eiwit-ligandcomplex verder te onderzoeken (zie de Tabel met materialen). De ligandtopologie werd voorbereid door General Amber Force Field (GAFF)-parameters toe te wijzen en restrained electrostatic potential (RESP)-ladingen te integreren. Het complex werd vervolgens beschreven met het Amber99SB-ILDN-krachtveld, geplaatst in een transferable intermolecular potential met 3 points-watermodel en geneutraliseerd met drie Na+⁺ ionen. Na energieminimalisatie via de steilste-afdalingmethode werd het systeem geëquilibreerd gedurende 100 ps onder het ensemble van constant aantal deeltjes, volume en temperatuur, en gedurende nog eens 100 ps onder het ensemble van constant aantal deeltjes, druk en temperatuur, met 100.000 stappen per fase. Vervolgens werd een productierun van 100 ns uitgevoerd bij 300 K en 1 bar met een tijdstap van 2 fs. De resulterende trajectorie werd geanalyseerd op de root mean square deviation (RMSD), root mean square fluctuation (RMSF), gyratie-straal (Rg), solvent-toegankelijk oppervlak (SASA), persistentie van waterstofbindingen en de vrije bindingsenergie bepaald via molecular mechanics/generalized Born surface area (MM/GBSA).
Celcultuur
De NHDF normale humane dermale fibroblastcellijn en de PKF primaire keloidfibroblastcellijn werden gekweekt in fibroblastgroeimedium aangevuld met 2% foetaal kalfsserum, recombinant humaan basaal fibroblastgroeifactor (1 ng/mL) en insuline (5 µg/mL). Beide cellijnen werden onderhouden in een bevochtigde incubator bij 37 °C met 5% CO₂ en werden gepasseerd zodra een confluentie van 80–90% was bereikt.
Western blot-analyse
Totaal eiwit werd geïsoleerd uit NHDF- en PKF-cellen met een lysisbuffer bestaande uit radioimmunoprecipitatie-assay, fenylmethylsulfonylfluoride, een protease-remmercocktail en fosfataseremmers. De eiwitconcentratie werd bepaald met een bicinchonininezuur-assay, waarna gelijke hoeveelheden eiwit werden gescheiden via natriumdodecylsulfaat-polyacrylamidegelelektroforese en overgebracht op een polyvinylideenfluoride-membraan. Het membraan werd gedurende 90 min bij kamertemperatuur geblokkeerd met 5% vetvrije melkpoeder bereid in Tween/Tris-gebufferde zoutoplossing, en vervolgens gedurende de nacht bij 4 °C geïncubeerd met primaire antilichamen tegen FLVCR1 (konijn polyklonaal, 1:1.000) en GAPDH (muis monoklonaal, 1:20.000). De volgende dag werd de incubatie met het secundaire antilichaam uitgevoerd gedurende 90 min bij kamertemperatuur. Bandintensiteiten werden gemeten met ImageJ, en relatieve eiwitniveaus werden genormaliseerd ten opzichte van de GAPDH-interne controle. Voor elke western blot-analyse werden minimaal drie onafhankelijke biologische replica's gebruikt.
Real-time fluorescent kwantitatieve reverse-transcriptie PCR (qRT-PCR) analyse
Totaal RNA werd geprepareerd uit NHDF- en PKF-cellen met de geraadpleegde kit. cDNA werd vervolgens gegenereerd met de geraadpleegde cDNA Synthesis Mix for qPCR (met dsDNase). qRT-PCR werd uitgevoerd op een real-time PCR-systeem, en de expressie van FLVCR1 werd gemeten met de geraadpleegde SYBR Green Fast Mix. GAPDH mRNA diende als interne referentie voor normalisatie. Elke qRT-PCR-reactie werd in technische triplicaten uitgevoerd, en de relatieve mRNA-niveaus werden berekend via de 2−ΔΔCt methode. Elk experiment werd minstens drie keer onafhankelijk uitgevoerd, en de primersequenties zijn opgenomen in Aanvullende Tabel S2.
Statistische analyse
Groepsverschillen werden getest met de Wilcoxon rank-sum test, en waarden worden gerapporteerd als het gemiddelde ± standaarddeviatie (SD). Associaties tussen continue variabelen werden onderzocht met behulp van de correlatiecoëfficiënt van Pearson. Resultaten met P < 0,05 werden beschouwd als statistisch significant. Significantieniveaus werden aangegeven als ns, P > 0,05; *, P < 0,05; **, P < 0,01; ***, P < 0,001; en ****, P < 0,0001.
Resultaten
Screening naar kandidaat diagnostische biomarkers voor keloïd met behulp van een machine learning-algoritme
In totaal werden 283 genen die gerelateerd zijn aan het heemmetabolisme in deze studie opgenomen. Differentieel expressieanalyse van de GSE44270-dataset, waarbij keloïd- en normale huidweefsels werden vergeleken, identificeerde 25 significant differentieel tot expressie gebrachte genen (Figuur 1A en Aanvullende Tabel S3). Om verder te screenen op ziekte-geassocieerde biomarkers, identificeerde LASSO-regressie 9 kandidaatgenen (Figuur 1B,C en Aanvullende Tabel S3), terwijl het random forest (RF)-algoritme 11 genen selecteerde met een hoge voorspellende waarde (Figuur 1D en Aanvullende Tabel S3). De overlap tussen de LASSO- en RF-resultaten werd gevisualiseerd met een Venn-diagram, wat resulteerde in zes kernbiomarkers, namelijk FLVCR1, TMCC2, EIF2AK1, XK, HPX en KEL (Figuur 1E en Aanvullende Tabel S3). Receiver operating characteristic (ROC)-analyse in de GSE44270-cohort toonde een gunstige diagnostische prestatie aan voor alle zes biomarkers, met AUC-waarden van 0,8016 voor FLVCR1, 0,7063 voor TMCC2, 0,7817 voor EIF2AK1, 0,7460 voor XK, 0,7500 voor HPX en 0,7857 voor KEL (Figuur 1F). Op basis van deze zes biomarkers werd vervolgens een diagnostisch nomogram voor keloïd geconstrueerd met behulp van het rms-pakket in R (Figuur 1G).
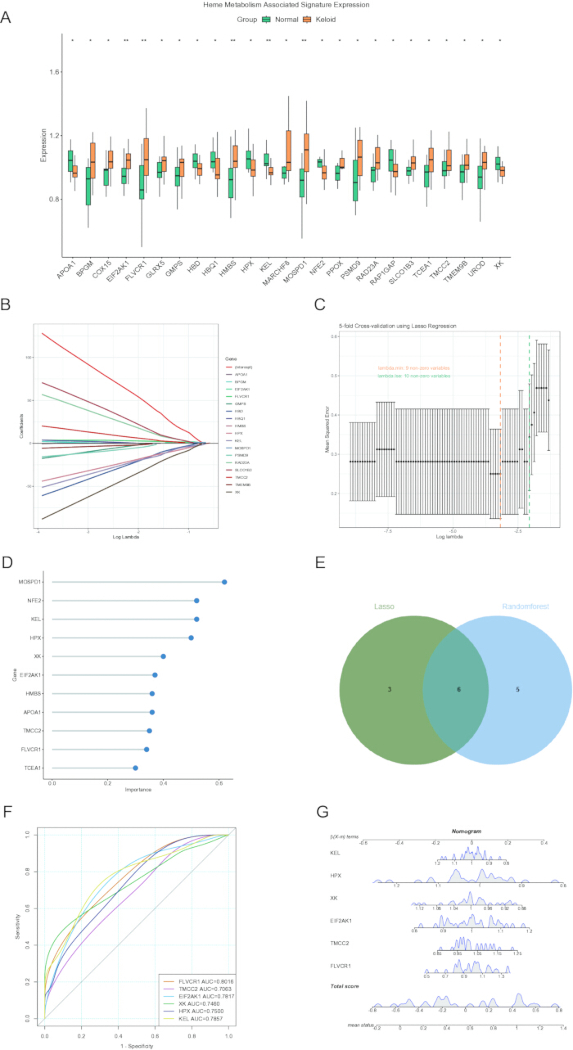
Figuur 1: Identificatie van kandidaatgenen gerelateerd aan het heemmetabolisme die geassocieerd zijn met keloïden met behulp van machine-learning-algoritmen. (A) Boxplot die de differentiële expressie van genen gerelateerd aan het heemmetabolisme illustreert tussen keloïd- en normaal weefsel. (B,C) LASSO logistieke regressieanalyse voor het screenen van kandidaatdiagnostische markers. (D) Kandidaatbiomarkers geselecteerd door het RF-algoritme. (E) Venn-diagram dat de overlappende genen toont die door de twee machine-learning-algoritmen zijn geïdentificeerd. (F) ROC-curve-analyse ter evaluatie van de diagnostische prestaties van de kandidaatbiomarkers. (G) Nomogram voor de voorspelling van keloïden op basis van de zes-genen-signatuur. Afkortingen: LASSO, least absolute shrinkage and selection operator; RF, random forest; ROC, receiver operating characteristic. Statistische significantie: ns, P > 0,05; *, P < 0,05; **, P < 0,01; ***, P < 0,001; en ****, P < 0,0001. Klik hier om een grotere versie van deze figuur te bekijken.
De predictieve prestatie van het diagnostische nomogram werd beoordeeld in zowel de trainingscohort (GSE44270) als de validatiecohort (GSE7890). Het model vertoonde een uitstekende diagnostische nauwkeurigheid, met respectievelijk AUC-waarden van 0,984 (95% CI: 0,950–1,000) en 0,922 (95% CI: 0,806–1,000) (Figuur 2A,D). Om de robuustheid en potentiële overfitting van de diagnostische handtekening van zes genen verder te evalueren, werden aanvullende interne validatieanalyses uitgevoerd in de discovery-cohort (GSE44270). Een vijfvoudige kruisvalidatie toonde een consistente discriminatieve prestatie over de subsets aan, met een gemiddelde AUC van 0,925, wat aangeeft dat het model een stabiele classificatieprestatie behield ondanks variaties in de trainingsmonsters. Bovendien leverde bootstrap-validatie met 1.000 resampled iteraties een gemiddelde AUC op van 0,930 (95% CI: 0,794–1,000). Na correctie voor potentieel optimisme veroorzaakt door de beperkte steekproefomvang bleef de optimisme-gecorrigeerde AUC 0,930, wat suggereert dat de diagnostische prestatie van de handtekening van zes genen relatief stabiel was na interne validatie. Daarnaast suggereerde een decision curve analysis (DCA) dat het nomogram een hoger potentieel netto voordeel vertoonde dan alternatieve diagnostische strategieën over een reeks drempelwaarschijnlijkheden, hoewel deze bevindingen met voorzichtigheid moeten worden geïnterpreteerd gezien de beperkte steekproefomvang (Figuur 2B,E). Daarnaast vertoonden keloidmonsters significant hogere risicoscores dan gezonde controles in zowel de trainings- als de validatiecohort (Figuur 2C,F), wat de stabiliteit en betrouwbaarheid van het diagnostische model verder aantoont.
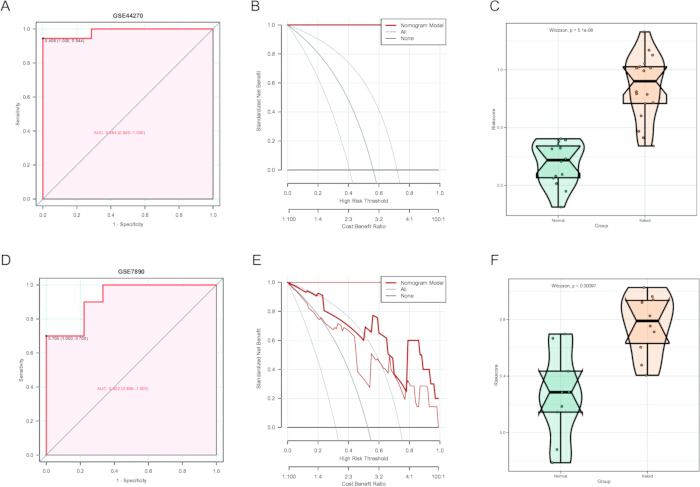
Figuur 2: Validatie van het nomogram voor de voorspelling van keloïden. (A) ROC-curve die de voorspellende prestatie van het nomogram in de GSE44270-dataset evalueert. (B) DCA die het klinische nut van het nomogram in GSE44270 evalueert. (C) Risicoscoreverdeling waarbij keloïd- en gezonde monsters in GSE44270 worden vergeleken. (D) ROC-curve die de voorspellende prestatie van het nomogram in de onafhankelijke GSE7890-dataset evalueert. (E) DCA die het klinische nut van het nomogram in GSE7890 evalueert. (F) Risicoscoreverdeling waarbij keloïd- en gezonde monsters in GSE7890 worden vergeleken. Afkortingen: ROC = receiver operating characteristic; DCA = decision curve analysis. Klik hier om een grotere versie van deze figuur te bekijken.
Diagnostische biomarkers zijn geassocieerd met de immuunkenmerken van keloïd
Om de relatie tussen de zes diagnostische biomarkers en de immuunmicro-omgeving te onderzoeken, werd een correlatieanalyse uitgevoerd om de associaties tussen biomarker-expressie en immuuncelinfiltratie te beoordelen. De resultaten onthulden dat alle zes biomarkers significant geassocieerd waren met meerdere infiltrerende immuuncelpopulaties (Figuur 3A). Specifiek was de expressie van FLVCR1 negatief geassocieerd met T-folliculaire helpercellen (Figuur 3B). TMCC2 vertoonde positieve correlaties met natural killer-cellen en geactiveerde dendritische cellen, terwijl het negatief correleerde met onrijpe dendritische cellen en onrijpe B-cellen (Figuur 3C–F). Daarnaast was de expressie van EIF2AK1 negatief geassocieerd met CD56dim natural killer-cellen (Figuur 3G), terwijl XK negatief geassocieerd was met eosinofielen (Figuur 3H).
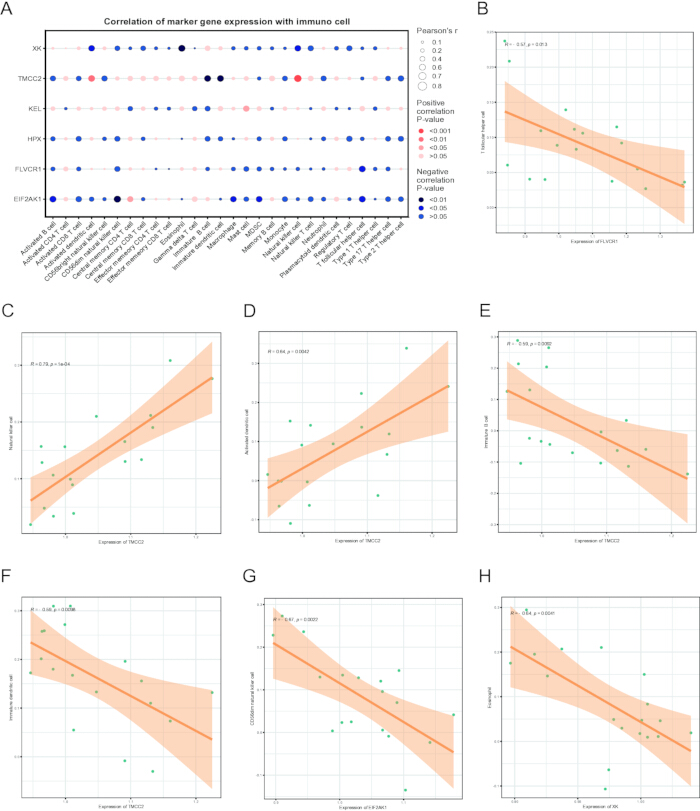
Figuur 3: Correlatie tussen kandidaatgenen gerelateerd aan het heemmetabolisme en immuuncelinfiltratie. (A) Heatmap die de correlaties tussen kandidaatgenen en immuuncelpopulaties weergeeft. Rood geeft positieve correlaties aan, terwijl blauw negatieve correlaties aangeeft. (B). Correlatie tussen FLVCR1-expressie en T-folliculaire helpercellen. (C-F) Correlaties tussen TMCC2-expressie en respectievelijk natural killer-cellen, geactiveerde dendritische cellen, onrijpe dendritische cellen en onrijpe B-cellen. (G) Correlatie tussen EIF2AK1-expressie en CD56dim natural killer-cellen. (H). Correlatie tussen XK-expressie en eosinofielen. Afkortingen: FLVCR1 = feline leukemia virus subgroup C receptor 1; TMCC2 = transmembrane and coiled-coil domains 2; EIF2AK1 = eukaryotic translation initiation factor 2 alpha kinase 1; CD56dim = cluster of differentiation 56 dim. Klik hier om een grotere versie van deze figuur te bekijken.
Analyse van transcriptoomgegevens van enkelcellen
Om de expressiepatronen van de geïdentificeerde diagnostische biomarkers binnen de keloid-micro-omgeving te karakteriseren, hebben we de single-cell RNA-sequencing dataset GSE163973 geanalyseerd. Na kwaliteitscontrole en data-integratie bleven er 21.488 hoogwaardige cellen over voor verdere analyses. Cellen met minder dan 200 of meer dan 6.000 totale unieke moleculaire identificatie (UMI)-counts werden uitgesloten, en potentiële doubletten werden geïdentificeerd en verwijderd met behulp van het DoubletDetection-pakket. De 2.000 genen met de grootste expressievariabiliteit werden geselecteerd, gevolgd door dimensionaliteitsreductie en visualisatie met Uniform Manifold Approximation and Projection (UMAP). Er werden in totaal 10 belangrijke celpopulaties geïdentificeerd, waaronder endotheelcellen, fibroblasten, spiervezels, keratinocyten, immuuncellen, lymfatische endotheelcellen, kliercellen, neurale cellen, melanocyten en een niet-geclassificeerde celpopulatie (Figuur 4A,B). Expressieprofilering onthulde duidelijke celtype-specifieke distributiepatronen van de diagnostische biomarkers. FLVCR1 werd voornamelijk tot expressie gebracht in endotheelcellen en melanocyten, terwijl EIF2AK1 een relatief hoge expressie vertoonde in neurale cellen, kliercellen en fibroblasten. HPX was primair verrijkt in melanocyten, terwijl KEL een predominante expressie vertoonde in kliercellen (Figuur 4C,D).
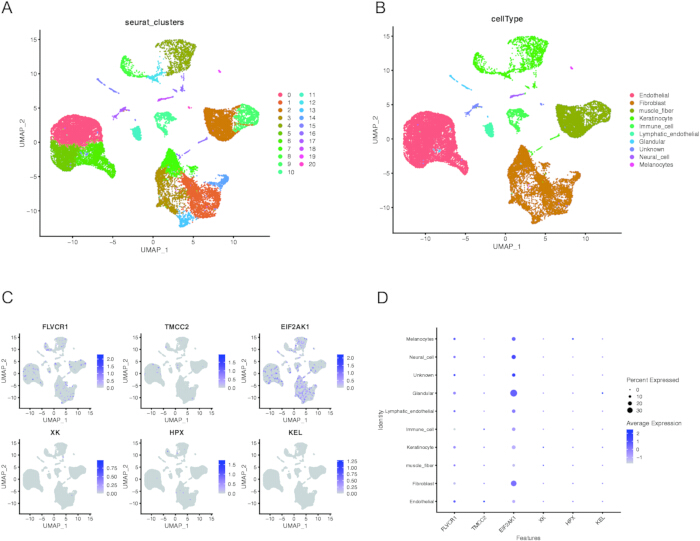
Figuur 4: Distributie van diagnostische biomarkers gerelateerd aan het heemmetabolisme in het single-cell transcriptoom van keloïden. (A) UMAP-plot die 21 celclusters toont bestaande uit 21.488 cellen uit keloïdmonsters. (B) Annotaties van celtypen gebaseerd op de annotaties gerapporteerd in de oorspronkelijke studie. (C) Feature-plots die de expressie van diagnostische biomarkers gerelateerd aan het heemmetabolisme over verschillende celtypen tonen. (D) Bubble-plot die de gemiddelde expressieniveaus en percentages cellen tonen die de diagnostische biomarkers gerelateerd aan het heemmetabolisme over verschillende celtypen tot expressie brengen. Afkorting: UMAP = uniform manifold approximation and projection. Klik hier om een grotere versie van deze figuur te bekijken.
Identificatie en interactienetwerkanalyse van kandidaat diagnostische biomarkers
Om de regulatiemechanismen ten grondslag aan de kandidaat-diagnostische biomarkers te onderzoeken, is een miRNA–mRNA-regulatienetwerk geconstrueerd. Om de betrouwbaarheid van de voorspelde interacties te verbeteren, werden overlappende miRNA's geïdentificeerd die zich richten op de kandidaat-biomarkers. In totaal werden 282 miRNA's verkregen die interageren met de zes diagnostische biomarkers, en het resulterende regulatienetwerk wordt getoond in Figuur 5. Opvallend is dat hsa-miR-34a-5p, hsa-let-7a-5p, hsa-let-7d-5p, hsa-let-7e-5p en hsa-miR-26b-5p voorspeld werden om gelijktijdig alle zes kandidaat-biomarkers te reguleren.
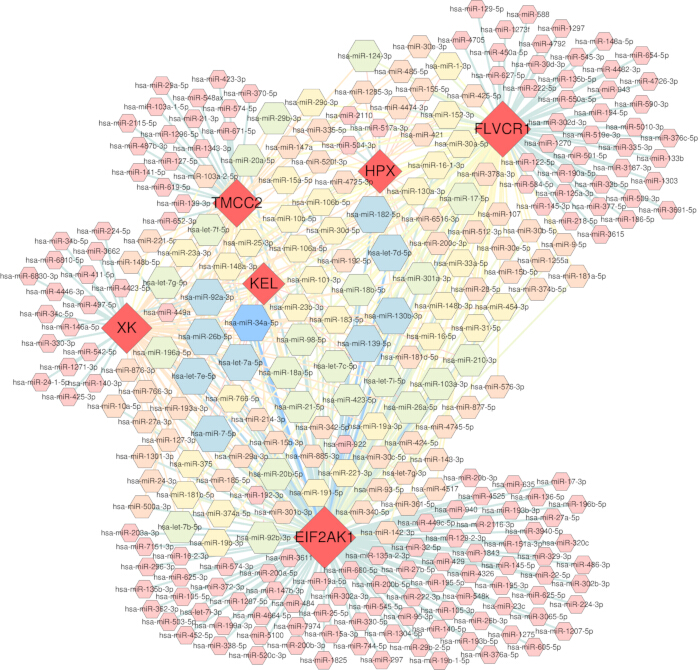
Figuur 5: miRNA-regulerend netwerk van diagnostische biomarkers gerelateerd aan het heemmetabolisme.Het netwerk illustreert de regulerende relaties tussen de zes diagnostische biomarkergenen (FLVCR1, HPX, TMCC2, KEL, XK en EIF2AK1) en hun geassocieerde miRNA's. Geenknooppunten vertegenwoordigen de diagnostische biomarkers, terwijl de omringende knooppunten miRNA's vertegenwoordigen. Randen geven experimenteel ondersteunde miRNA-mRNA-interacties aan. Afkortingen: FLVCR1 = feline leukemia virus subgroup C receptor 1; HPX = hemopexine; TMCC2 = transmembrane and coiled-coil domains 2; KEL = Kell metallo-endopeptidase; XK = X-linked Kx blood group; EIF2AK1 = eukaryotic translation initiation factor 2 alpha kinase 1; miRNA = microRNA; mRNA = messenger RNA. Klik hier om een grotere versie van deze figuur te bekijken.
Experimentele validatie van FLVCR1-expressie en moleculaire docking-analyse van potentiële therapeutische verbindingen
Om de bioinformatische bevindingen te valideren en de functionele relevantie van het geïdentificeerde hubgen te bevestigen, hebben we de expressie van FLVCR1 in PKF en NHDF experimenteel beoordeeld. Zowel qRT-PCR- als western blot-analyses toonden consistent aan dat FLVCR1 significant was upgereguleerd in keloidfibroblasten vergeleken met normale controles (Figuur 6A–C, Aanvullende figuur S1 en aanvullende tabel S4). Deze verhoogde cellulaire expressie ondersteunt de potentiële betrokkenheid van FLVCR1-geassocieerde verstoringen in het heemmetabolisme bij de pathogenese van keloïden.
Gezien de mogelijke betrokkenheid van FLVCR1 bij immuunveranderingen geassocieerd met het heemmetabolisme, hebben we vervolgens gezocht naar potentiële therapeutische verbindingen die FLVCR1 direct konden targeten om deze pathogene as te onderbreken. Er werd high-throughput virtuele screening uitgevoerd met behulp van een bibliotheek met verbindingen uit de traditionele Chinese geneeskunde (TCM) en de voorbereide proteïnestructuur. De 20 verbindingen met de meest gunstige docking-scores werden geselecteerd voor verdere evaluatie (Supplemetaire Tabel S5). In het algemeen duidt een lagere bindingsenergie op een sterkere bindingsaffiniteit, en docking-energieën onder −5 kcal/mol worden beschouwd als indicatief voor stabiele ligand-proteïne-interacties. Onder de gescreende verbindingen vertoonden (+)-Gallocatechin, (−)-Epicatechin, (−)-Gallocatechin en Cyanidine (chloride) gunstige bindingsaffiniteiten voor FLVCR1. Opvallend was dat (+)-Gallocatechin de sterkste interactie met FLVCR1 vertoonde door vier waterstofbruggen te vormen met GLU214, ASN245, GLN246 en GLN471, wat wijst op een stabiele ligand-proteïne-bindingsmodus (Figuur 6D–G). Deze bevindingen markeren (+)-gallocatechin als een veelbelovende kandidaat voor mechanisme-gebaseerde therapeutische interventie gericht op FLVCR1.
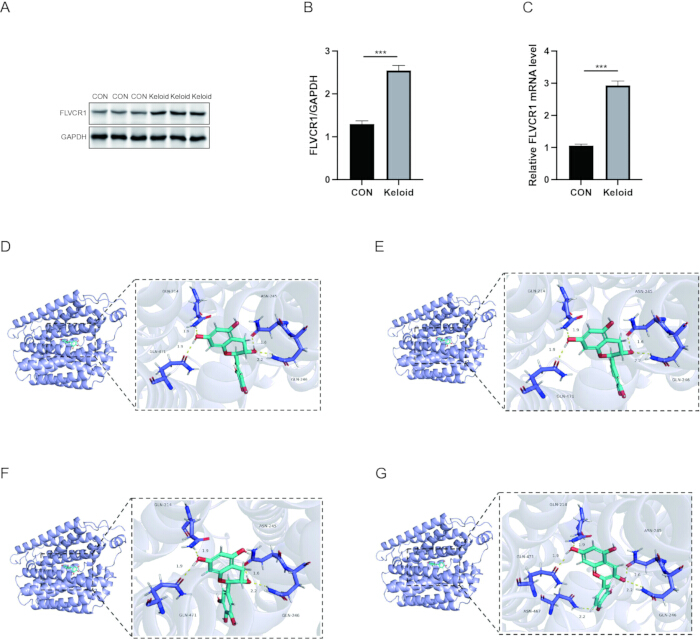
Figuur 6: Experimentele validatie van FLVCR1-expressie en moleculaire docking van potentiële verbindingen gericht op FLVCR1. (A) Representatieve western blot-afbeeldingen die de expressie van het FLVCR1-eiwit in CON en keloïd tonen. GAPDH diende als ladingscontrole. (B) Kwantificatie van FLVCR1-eiwitniveaus genormaliseerd naar GAPDH. (C) Relatieve mRNA-expressieniveaus van FLVCR1 in CON- en keloïd-fibroblasten werden bepaald via qRT-PCR. GAPDH werd gebruikt als interne referentie. (D–G) Driedimensionale weergaven van de voorspelde bindingsmodi tussen FLVCR1 en geselecteerde kleine molecuulverbindingen: (D) (+)-Gallocatechine. (E) (-)-Epicatechine. (F) (-)-Gallocatechine. (G) Cyanidine (chloride). Afkortingen: FLVCR1 = feline leukemia virus subgroup C receptor 1; CON, controle; GAPDH, glyceraldehyde-3-fosfaatdehydrogenase; qRT-PCR, kwantitatieve reverse transcriptie polymerasekettingreactie; SD, standaarddeviatie. Gegevens worden weergegeven als het gemiddelde ± SD. Statistische significantie: ns, P > 0,05; *, P < 0,05; **, P < 0,01; ***, P < 0,001; en ****, P < 0,0001. Klik hier om een grotere versie van deze figuur te bekijken.
Bevestiging van de stabiliteit van het FLVCR1–(+)-Gallocatechin-complex met moleculaire dynamicasimulatie
Om de betrouwbaarheid van de voorspelde bindingsmodus van ligand–eiwit te onderzoeken, werd een moleculaire dynamicasimulatie (MD) uitgevoerd voor het FLVCR1–(+)-gallocatechin-complex. De analyse richtte zich op de vraag of het complex structureel stabiel bleef over de tijd en of ligandbinding het conformationele gedrag van het eiwit veranderde, gebruikmakend van RMSD, RMSF, gyratie-straal (Rg), SASA, waterstofbruganalyse en MM/GBSA-berekeningen. RMSD-analyse (Figuur 7A) liet zien dat zowel het apo-eiwit als het ligand-gebonden complex initiële fluctuaties vertoonden gedurende de eerste 20 ns, gevolgd door geleidelijke stabilisatie, wat aantoont dat de systemen tijdens de simulatie een evenwicht bereikten. Na equilibratie bleef de RMSD-waarde van het FLVCR1–(+)-gallocatechin-complex onder de 0.2 nm, wat suggereert dat ligandbinding bijdroeg aan het behoud van de structurele stabiliteit van FLVCR1. RMSF-analyse (Figuur 7B) toonde aan dat de meeste residuen beperkte fluctuaties vertoonden gedurende de gehele simulatie, wat wijst op het behoud van de algemene eiwitintegriteit, terwijl verschillende flexibele regio's mogelijk loop-regio's vertegenwoordigen die betrokken zijn bij de accommodatie van het ligand. Bovendien gaven stabiele Rg- en SASA-profielen (Figuur 7C,D) aan dat het complex een compacte conformatie behield, zonder evidente structurele expansie of veranderingen in de blootstelling aan het oplosmiddel. Waterstofbruganalyse (Figuur 7E) onthulde dat het FLVCR1–(+)-gallocatechin-complex persistente intermoleculaire interacties behield, waarbij ongeveer 3–4 waterstofbruggen werden gevormd tijdens de simulatie, wat de stabiliteit van de ligand–eiwitassociatie ondersteunt. MM/GBSA-analyse toonde verder aan dat het FLVCR1–(+)-gallocatechin-complex een gunstige vrije bindingsenergie vertoonde (ΔGtotal = −34.87 ± 4.13 kcal/mol) (Suppletaire Tabel S6). Energie-decompositieanalyse wees uit dat van der Waals-interacties (ΔVDWAALS = −46.34 ± 2.16 kcal/mol) en elektrostatische interacties (ΔEelec = −14.09 ± 3.45 kcal/mol) de belangrijkste gunstige bijdragers waren aan de binding, ondanks de ongunstige bijdrage van de polaire solvatatie-energie (ΔGsolvation = 25.55 ± 0.74 kcal/mol) (Suppletaire Tabel S6). Gezamenlijk demonstreerden deze MD-simulatieresultaten dat (+)-gallocatechin een stabiel complex vormde met FLVCR1 en ondersteunden ze verder de betrouwbaarheid van de via docking voorspelde bindingsmodus.
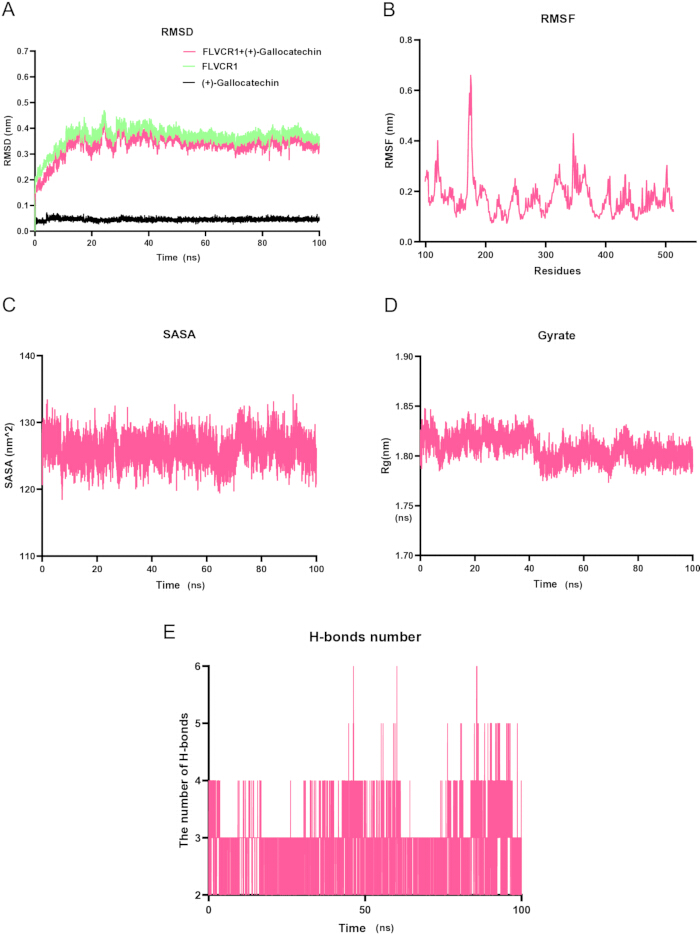
Figuur 7: Moleculaire dynamicasimulatie-analyse van het FLVCR1–(+)-Gallocatechin-complex. (A) RMSD-profielen van apo FLVCR1 en het FLVCR1–(+)-Gallocatechin-complex tijdens de 100 ns moleculaire dynamicasimulatie. (B) RMSF-profiel dat de fluctuaties op residuniveau van FLVCR1 tijdens de simulatie laat zien. (C) SASA-profiel dat veranderingen in het oplosmiddel-toegankelijke oppervlak van het FLVCR1–(+)-Gallocatechin-complex laat zien. (D) Rg-profiel dat de compactheid van het FLVCR1–(+)-Gallocatechin-complex tijdens de simulatie evalueert. (E) Waterstofbrug-analyse die de dynamische intermoleculaire interacties tussen FLVCR1 en (+)-Gallocatechin gedurende de simulatie laat zien. Afkortingen: FLVCR1 = feline leukemia virus subgroup C receptor 1; RMSD = root mean square deviation; RMSF = root mean square fluctuation; SASA = solvent-accessible surface area; Rg = straal van gyratie. Klik hier om een grotere versie van deze figuur te bekijken.
Beschikbaarheid van gegevens:
De publiek toegankelijke transcriptomische datasets die in deze studie zijn geanalyseerd, kunnen worden geraadpleegd via de Gene Expression Omnibus (GEO) onder de accession-nummers GSE44270, GSE7890 en GSE163973. De brondata die in deze studie zijn gegenereerd en ten grondslag liggen aan de experimentele validatie, waaronder qRT-PCR-metingen, originele western blot-afbeeldingen en kwantificeringsgegevens van de western blots, worden verstrekt als Aanvullende Figuur S1, Aanvullende Tabel S1, Aanvullende Tabel S2, Aanvullende Tabel S3 en Aanvullende Tabel S4. De resultaten van de moleculaire docking en de MM/GBSA-gegevens over de vrije bindingsenergie zijn eveneens opgenomen in Aanvullende Tabel S5 en Aanvullende Tabel S6.
Aanvullende Figuur S1: Originele gegevens van western blotting.Klik hier om dit bestand te downloaden.
Aanvullende tabel S1: Genen gerelateerd aan het heemmetabolisme.Klik hier om dit bestand te downloaden.
Aanvullende tabel S2: Primersequenties van geselecteerde genen. Klik hier om dit bestand te downloaden.
Aanvullende tabel S3: Machine-learningbenaderingen voor het identificeren van potentiële diagnostische biomarkers bij keloïden.Klik hier om dit bestand te downloaden.
Aanvullende tabel S4: Ruwe gegevens ter ondersteuning van de experimentele validatie van FLVCR1-expressie. Klik hier om dit bestand te downloaden.
Aanvullende tabel S5: Top 20 kandidaatverbindingen geïdentificeerd door moleculaire docking met FLVCR1.Klik hier om dit bestand te downloaden.
Aanvullende Tabel S6: MM/GBSA binding vrije-energie analyse van het FLVCR1–(+)-Gallocatechine complex.Klik hier om dit bestand te downloaden.
Discussie
Deze studie identificeert een potentiële associatie tussen ontregeld heemmetabolisme, FLVCR1-expressie en veranderingen in de immuunmicro-omgeving bij de vorming van keloïden. Door bulk- en single-cell transcriptomics te integreren, hebben we vastgesteld dat FLVCR1 fungeert als een moleculaire nexus die een deficiëntie in heemexport koppelt aan pathologische immuunherprogrammering, waardoor keloïden worden gepositioneerd binnen het opkomende spectrum van "metabo-fibrotische" aandoeningen23,24,25. Het potentiële belang van FLVCR1 wordt ondersteund door convergente bewijzen over meerdere analytische niveaus. Bulk transcriptomics onthulde een significante upregulatie ervan in keloïdweefsels met een robuuste diagnostische capaciteit, terwijl mapping op single-cell resolutie de expressie voornamelijk lokaliseerde in endotheelcellen en melanocyten—twee celtypen die kritisch betrokken zijn bij de pathogenese van keloïden via respectievelijk aberrante angiogenese en hyperpigmentatie26,27. Meest overtuigend is dat FLVCR1-expressie een sterke negatieve correlatie vertoonde met T-folliculaire helpercellen (Tfh), een lymfocytensubset die in toenemende mate wordt erkend voor het bevorderen van Th2-georiënteerde immuniteit en collageendepositie in fibrotische micro-omgevingen28. Eerdere studies hebben aangetoond dat FLVCR1-gemedieerde heemexport betrokken is bij de rijping van dendritische cellen en antigeenpresentatie29, wat wijst op een potentiële link tussen FLVCR1-geassocieerde heemhomeostase en immuunregulatie. De waargenomen upregulatie van FLVCR1 en de negatieve correlatie met Tfh-celinfiltratie kunnen daarom wijzen op veranderingen in de immuunhomeostase, waarbij mogelijk Tfh-geassocieerde profibrotische cytokinen zoals IL-4 en IL-13 betrokken zijn29,30,31.
Bovendien activeert intracellulaire heemaccumulatie als gevolg van FLVCR1-dysfunctie waarschijnlijk het NLRP3-inflammasoom—een mechanisme dat goed gedocumenteerd is bij hepatische fibrose, waarbij heem fungeert als een damage-associated molecular pattern (DAMP) dat steriele ontsteking uitlokt32,33,34. Een dergelijke activatie van het inflammasoom zou de afgifte van IL-1β/IL-18 bevorderen, wat M2-macrofaagpolarisatie stimuleert via TLR4/NF-κB-signalering en een zelfvoorzienende cyclus van oxidatieve stress en fibroblastactivatie creëert35,36. Gezamenlijk ondersteunen deze gegevens FLVCR1 als een kandidaat-biomarker en mogelijke contributor aan interacties tussen heemmetabolisme en immuniteit bij keloïden; de voorgestelde mechanistische cascade vereist echter directe functionele validatie. Intracellulaire heemretentie induceert eerst oxidatieve schade en activeert het inflammasoom, wat vervolgens leidt tot dysfunctie van dendritische cellen, waardoor een verschuiving naar folliculaire helper T-cellen en Th2-type immuunresponsen wordt bevorderd; deze immuunafwijking drijft de macrofaagpolarisatie verder richting het M2-fenotype, wat uiteindelijk resulteert in fibroblastactivatie en de progressie van fibrogenese.
Naast de solitaire werking van FLVCR1 onthult de synergetische dysregulatie van alle zes biomarkers een gecoördineerde ineenstorting van de heemhomeostase over meerdere regulatoire knooppunten. TMCC2, positief gecorreleerd met geactiveerde dendritische cellen maar negatief geassocieerd met onrijpe subsets, kan een compensatiemechanisme vertegenwoordigen dat probeert de immuuncompetentie te herstellen te midden van heemstress37,38. EIF2AK1, sterk tot expressie gebracht in keloid-fibroblasten en kliercellen, dient als een directe moleculaire sensor voor heemoverschot die eIF2α fosforyleert om de eiwitsynthese globaal te onderdrukken, terwijl stressresponsgenen selectief worden opgereguleerd39,40,41. Dit positioneert EIF2AK1 als de cruciale brug die heemaccumulatie vertaalt naar een fenotypische switch van fibroblasten—wat mogelijk verklaart waarom keloid-fibroblasten een verhoogde resistentie tegen apoptose en een overmatige collageenproductie vertonen42,43,44. HPX, de primaire plasma-heemscavenger, vertoonde een beperkte expressie in melanocyten, wat wijst op een celautonome poging om heemtoxiciteit binnen pigmentrijke compartimenten te bufferen45,46,47. De gelijktijdige dysregulatie van XK en KEL impliceert verder de heemverwerkingsmechanismen van de erytroïde lijn in de pathogenese van keloïden—een bevinding met intrigerende implicaties voor het begrijpen waarom keloïden vaak ontstaan op plekken van trauma met microhemorragie. In plaats van deze zes genen als onafhankelijke markers te beschouwen, interpreteren wij hun collectieve dysregulatie als bewijs voor een systeembreed falen in de heemcompartimentering, waarbij een aangetaste export (FLVCR1), sensing (EIF2AK1), scavenging (HPX) en membraantransport (XK, KEL) convergeren om een pro-fibrotische, heemrijke micro-omgeving te creëren.
Dit metabool-immuunmodel wordt verder versterkt door een overtuigende epigenetische laag: we identificeerden een ceRNA-netwerk waarin de downregulatie van specifieke miRNA's (bijv. de let-7-familie en miR-34a-5p) gelijktijdig heemmetabolisme-gerelateerde en fibrotische pathways kan derepresseren, hoewel dit regulatiemodel verdere validatie behoeft23. De ruimtelijke resolutie die single-cell analyse biedt, werpt licht op de cellulaire choreografie die ten grondslag ligt aan dit proces en demonstreert hoe metabole dysfunctie in structurele cellen actief de immuunrijke micro-omgeving voedt via paracriene heemsignalering, waardoor ons begrip verschuift van een "bulk tissue"-perspectief naar een dynamisch cellulair ecosysteemmodel48,49,50. Endotheliale heemaccumulatie zou vasculaire lekkage en leukocytenextravasatie kunnen bevorderen via inductie van heemoxygenase-1 en upregulatie van adhesiemoleculen, waardoor de immuunrijke micro-omgeving die in keloïden wordt waargenomen, wordt gevoed51,52,53. Gelijktijdig komt de expressie van FLVCR1 in melanocyten overeen met klinische observaties van keloïde hyperpigmentatie en suggereert dit metabole kwetsbaarheden die gedeeld worden tussen pigmentaire en fibrotische pathways — mogelijk gemedieerd door oxidatieve stressresponsen54,55. Deze ruimtelijke mapping transformeert ons begrip van een "bulk tissue"-perspectief naar een cellulair ecosysteemmodel waarin metabole dysfunctie in structurele cellen (endotheel, melanocyten) actief het gedrag van immuuncellen vormgeeft via paracriene heemsignalering.
Vanuit een translationeel standpunt behaalde ons nomogram, waarin alle zes biomarkers zijn geïntegreerd, een bijna perfecte diagnostische nauwkeurigheid, waarmee het elk enkele marker substantieel overtrof en een duidelijk klinisch netto voordeel demonstreerde via decision curve-analyse. Nog opvallender is dat moleculaire docking (+)-gallocatechine — een bioactief polyfenol dat ruim aanwezig is in groene thee en traditionele Chinese medicinale kruiden — identificeerde als een FLVCR1-ligand met een hoge affiniteit dat stabiele waterstofbruggen vormt met GLU-214, ASN-245, GLN-246 en GLN-471. Deze bevinding is bijzonder overtuigend gezien eerder bewijs dat catechines de collagesynthese onderdrukken, de secretie van transforming growth factor-beta 1 remmen en oxidatieve stress in keloidfibroblasten verminderen56,57,58. Wij hypothetiseren dat (+)-gallocatechine de FLVCR1-conformatie kan stabiliseren om de heem-exportcapaciteit te verhogen, waardoor de metabole trigger van fibrose bij de bron wordt onderbroken — een strategie die fundamenteel verschilt van huidige therapieën die enkel de downstream-collageproductie onderdrukken. Of dit type metabole interventie invloed kan hebben op de recidive van keloïden, vereist verdere experimentele en klinische validatie.
Natuurlijk heeft deze studie ook beperkingen. Ten eerste zijn onze analyses grotendeels computationeel, en de waargenomen associatie tussen de expressie van FLVCR1 en de infiltratie van T follicular helper (Tfh)-cellen stelt geen direct causaal verband vast. Flowcytometrische validatie van Tfh-cellen en functionele studies waarbij FLVCR1-knockdown of overexpressie in keloïde fibroblasten wordt toegepast, samen met assays voor interacties tussen fibroblasten en immuuncellen of assays met geconditioneerd medium, zijn nodig om de potentiële rol van FLVCR1 in de immuunregulatie te verduidelijken. Ten tweede kan de relatief kleine steekproefomvang onzekerheid en optimisme introduceren in de geschatte prestaties van de six-gene signature. Hoewel interne validatie is uitgevoerd, blijft een betrouwbare beoordeling van de diagnostische prestaties en kalibratie beperkt. Daarom moet het six-gene panel worden beschouwd als een verkennende moleculaire signatuur die verdere validatie in grotere, onafhankelijke cohorten vereist. Ten derde moet de single-cell dataset worden uitgebreid om interpatiënt-heterogeniteit en zeldzame celpopulaties beter in kaart te brengen. Ten vierde zou validatie van de expressie van biomarkers op proteïneniveau en ruimtelijke lokalisatie via immunohistochemie de klinische relevantie van onze bevindingen versterken. Ten slotte, hoewel moleculaire docking wijst op potentiële binding tussen (+)-gallocatechine en FLVCR1, zijn in vitro bindingsassays en in vivo effectiviteitsstudies nodig vóór klinische translatie. Ondanks deze beperkingen bieden onze bevindingen een multidimensionaal kader dat FLVCR1-geassocieerd heemmetabolisme koppelt aan immuunveranderingen bij keloïden en identificeren ze potentiële moleculaire biomarkers en therapeutische kandidaten voor verder onderzoek.
Openbaarmakingen
De auteurs hebben geen belangenconflicten te verklaren.
Bijdragen van de auteurs
Qiuyan Yang droeg bij aan het ontwerp van de studie. Jianping Zhang droeg bij aan de gegevensverzameling. Qiuyan Yang en Xiaofang Sun droegen bij aan de statistische analyse. Qiuyan Yang en Jing Wang droegen bij aan het maken van de diagrammen en het afronden van het manuscript. Alle auteurs hebben de definitieve versie van het manuscript gelezen en goedgekeurd.
Dankbetuigingen
Wij betuigen onze dank aan de onderzoekers die de datasets GSE44270, GSE7890 en GSE163973 hebben gegenereerd en openbaar hebben gedeeld via de Gene Expression Omnibus (GEO) database.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| AmberTools | Amber Project | https://ambermd.org/AmberTools.php | Versie 22; Generatie van ligandparameters met behulp van het GAFF force field |
| Anti-FLVCR1 | Proteintech | 26841-1-AP | |
| Anti-GAPDH | Proteintech | 60004-1-Ig | |
| AutoDock Vina | The Scripps Research Institute | https://vina.scripps.edu/ | Versie 1.2.3; Moleculaire docking en voorspelling van ligand-bindingsaffiniteit |
| AutoDockTools | The Scripps Research Institute | https://ccsb.scripps.edu/autodocksuite/adt/ | Versie 1.5.6; Voorbereiding van ligand en receptor voor moleculaire docking |
| BCA proteïne-assay kit | Servicebio | G2026 | |
| cDNA-synthesemix voor qPCR met dsDNase | UnionScript | Reverse transcriptie voor qRT-PCR | |
| ChemBio3D | PerkinElmer | https://revvitysignals.com/products/research/chemdraw | Versie 14.0; 3D conformationele optimalisatie en energie-minimalisatie van liganden |
| Chemiluminescentie-beeldvormingssysteem | Visualisatie van western blot banden | ||
| DoubletDetection pakket | GitHub / JonathanShor | https://github.com/JonathanShor/DoubletDetection | Detectie en verwijdering van voorspelde doubletten in scRNA-seq analyse |
| ECL chemiluminescent substraat | Western blot signaaldetectie | ||
| Foetaal kalfserum | 2% eindconcentratie; Supplement voor fibroblast kweekmedium | ||
| Fibroblast Growth Medium 2 | PromoCell | C-23020 | |
| FLVCR1- en GAPDH-primers | Supplemental Table S2 | qRT-PCR amplificatie van doel- en referentiegenen | |
| Gaussian | Gaussian, Inc. | https://gaussian.com/ | Gaussian 16W; Berekening van RESP atomaire ladingen voor ligandparameterisatie |
| Gelelektroforese-apparaat | SDS-PAGE proteïnescheiding | ||
| GEOquery pakket | Bioconductor | https://bioconductor.org/packages/GEOquery/ | Versie 2.68.0; Ophalen van genexpressie en metadata uit de GEO-database |
| ggplot2 pakket | CRAN | https://cran.r-project.org/package=ggplot2 | Versie 4.0.2; Datavisualisatie |
| glmnet pakket | CRAN | https://cran.r-project.org/package=glmnet | Versie 4.1.10; LASSO feature selectie |
| GROMACS | GROMACS Development Team | https://www.gromacs.org/ | Versie 2022.3; Moleculaire dynamica simulaties en trajectanalyse |
| GS AntiQ qPCR SYBR Green Fast Mix (Universal) | Genesand | SQ410 | |
| GSE163973 | GEO database | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE163973 | 3 keloidmonsters; Single-cell expressieanalyse |
| GSE44270 | GEO database | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE44270 | 18 keloid- en 14 normale monsters; Differentiële expressie en biomarker screening |
| GSE7890 | GEO database | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE7890 | 10 keloid- en 9 normale monsters; Onafhankelijke validatie van diagnostische biomarkers |
| GSVA pakket | Bioconductor | https://bioconductor.org/packages/GSVA/ | Versie 1.48.3; ssGSEA-gebaseerde analyse van immuuncelinfiltratie |
| HRP-geconjugeerd geit anti-muis IgG | Abcam | ab97040 | |
| HRP-geconjugeerd geit anti-konijn IgG | Abcam | ab97051 | |
| Bevochte CO2 incubator | 37 °C, 5% CO2; Onderhoud van NHDF- en PKF-cellen | ||
| ImageJ | National Institutes of Health | https://imagej.nih.gov/ij/ | Kwantificering van western blot bandintensiteit |
| Insuline | 5 μg/mL eindconcentratie; Supplement voor fibroblast kweekmedium | ||
| Molecular Signatures Database (MSigDB) | Broad Institute | https://www.gsea-msigdb.org/gsea/msigdb | Versie 2024.1.Hs; Bron van met heemmetabolisme geassocieerde gensets |
| NetworkAnalyst | NetworkAnalyst | https://www.networkanalyst.ca/ | Versie 3.0; Constructie van het miRNA-mRNA interactienetwerk |
| NHDF | Procell | CP-H106 | |
| Vetvrije melkpoeder | 5% oplossing; Membraanblokkering voor western blot analyse | ||
| Optische afdichtingsfolie of doppen | Afdichten van qRT-PCR reacties | ||
| PBS | Procell | PB180327 | |
| PDB ID: 8UBZ | RCSB PDB | https://www.rcsb.org/structure/8UBZ | Humane FLVCR1-structuur; Bron van de FLVCR1 proteïnestructuur voor structuurgebaseerde virtuele screening |
| Fosfataseremmers | Supplement voor proteïnelysebuffer | ||
| PKF | Procell | GCP-H235 | |
| PMSF | Servicebio | G2008-1ML | |
| pROC pakket | CRAN | https://cran.r-project.org/package=pROC | Versie 1.19.0.1; ROC-curve en AUC-analyse |
| Proteaseremmer-cocktail | Roche | 4693124001 | |
| Proteïne-transferapparaat | Transfer van proteïnen naar PVDF-membraan | ||
| PVDF-membraan | Millipore | IPVH08100 | |
| PyMOL | Schrödinger, LLC | https://pymol.org/ | Versie 2.6.1; Visualisatie en analyse van proteïne-ligand docking posities en moleculaire interacties |
| qRT-PCR platen of buisjes | Opzetten van qRT-PCR reacties | ||
| R | R Foundation for Statistical Computing | https://www.r-project.org/ | Versie 4.3.1; Statistische en bio-informatische analyses |
| randomForest pakket | CRAN | https://cran.r-project.org/package=randomForest | Versie 4.7.1.2; Random forest feature selectie |
| REACTOME_HEME_BIOSYNTHESIS; REACTOME_HEME_DEGRADATION; WIKIPATHWAYS_HEME_BIOSYNTHESIS; REACTOME_SCAVENGING_HEME_FROM_PLASMA; HALLMARK_HEME_METABOLISM | Molecular Signatures Database (MSigDB) | https://www.gsea-msigdb.org/gsea/msigdb | Versie 2024.1.Hs; 283 unieke genen na samenvoeging; Definitie van met heemmetabolisme geassocieerde genen |
| Real-time PCR-systeem | qRT-PCR amplificatie en detectie | ||
| Recombinant humane basale fibroblast groeifactor | 1 ng/mL eindconcentratie; Supplement voor fibroblast kweekmedium | ||
| RIPA-buffer | Servicebio | G2002 | |
| rms pakket | CRAN | https://cran.r-project.org/package=rms | Versie 6.7.1; Constructie van nomogram |
| SDS-PAGE reagentia of precast gels | Proteïnescheiding via SDS-PAGE | ||
| Seurat pakket | CRAN | https://satijalab.org/seurat/ | Versie 5.4.0; scRNA-seq preprocessing, clustering en visualisatie |
| TarBase | DIANA Tools | https://carolina.imis.athena-innovation.gr/diana_tools/ | Versie 9.0; Bron van experimenteel ondersteunde miRNA-mRNA interacties |
| Total RNA Kit II | Omega | R6934-01 | |
| Bibliotheek van actieve verbindingen uit traditionele Chinese geneeskunde | Bron van kandidaatverbindingen voor virtuele screening | ||
| Tween/Tris-gebufferde zoutoplossing | Bereiding van blokkeringsbuffer en membraanwassing | ||
| UnionScript First-strand cDNA Synthesis Mix voor qPCR (met dsDNase) | Genesand | SR511 |
Referenties
- Dirand Z, et al. Macrophage phenotype is determinant for fibrosis development in keloid disease. Matrix Biol. 2024;128:79-92.
- Fang X, et al. Hypertrophic scarring and keloids: epidemiology, molecular pathogenesis, and therapeutic interventions. MedComm (2020). 2025;6(10):e70381.
- Adler R, et al. Pentoxifylline and long-term risk of keloid formation: a real-world 10-year outcomes study using TriNetX. J Am Acad Dermatol. 2026;94(5):1561-3.
- Banerjee P, et al. Anti-fibrotic properties of a decellularized extracellular matrix scaffold from porcine small intestinal submucosa in normal human and keloid fibroblasts. Int J Mol Sci. 2025;26(24):11764.
- Chang YH, McGrath JA, Hsu CK. Regression of extensive keloids during imatinib therapy for gastrointestinal stromal tumor. JAMA Dermatol. 2025;161(12):1293-4.
- Wang QR, et al. CCL17 drives fibroblast activation in the progression of pulmonary fibrosis by enhancing the TGF-β/Smad signaling. Biochem Pharmacol. 2023;210:115475.
- Higuchi Y, et al. Cavin-2 promotes fibroblast-to-myofibroblast trans-differentiation and aggravates cardiac fibrosis. ESC Heart Fail. 2024;11(1):167-78.
- Zhang H, et al. Plasma apolipoprotein E protein attenuates pulmonary fibrosis through LRP1 and PLAU dual receptor-mediated TGF-β/Smad inhibition. J Adv Res. 2025. doi:10.1016/j.jare.2025.12.045.
- Chen Q, et al. Immune imbalance drives keloid pathogenesis: emerging targets for precision immunotherapy. Adv Wound Care (New Rochelle). 2026:21621918261417702.
- Deng CC, et al. Single-cell RNA-seq reveals immune cell heterogeneity and increased Th17 cells in human fibrotic skin diseases. Front Immunol. 2024;15:1522076.
- Wang Q, et al. Weighted gene co-expression network analysis and machine learning identified the lipid metabolism-related gene LGMN as a novel biomarker for keloid. Exp Dermatol. 2024;33(1):e14974.
- Zhang W, et al. New insights into keloid pathogenesis: biomarker potential for CDK7 and DDB2. Front Cell Dev Biol. 2025;13:1718189.
- Li W, et al. Altered arginine metabolism affects proliferation and radiosensitivity of keloids. Exp Dermatol. 2025;34(3):e70077.
- Jiang J, et al. Ambient fine particulate matter induces cardiac fibrosis through triggering ferroptosis by heme degradation induced-iron overload. Ecotoxicol Environ Saf. 2025;297:118227.
- Lin W, et al. Heme oxygenase-1 overexpression activates the IRF1/DRP1 signaling pathway to promote M2-type polarization of spinal cord microglia. Drug Dev Res. 2024;85(8):e70033.
- Knez J, Kovačič B, Goropevšek A. The role of regulatory T-cells in the development of endometriosis. Hum Reprod. 2024;39(7):1367-80.
- Voltarelli VA, et al. Heme: the lord of the iron ring. Antioxidants (Basel). 2023;12(5):1074.
- Wilks A, Egoshi R. Heme trafficking and the importance of handling nature's most versatile cofactor. Chem Rev. 2025;125(23):11358-78.
- Bertino F, et al. Dysregulation of FLVCR1a-dependent mitochondrial calcium handling in neural progenitors causes congenital hydrocephalus. Cell Rep Med. 2024;5(7):101647.
- Kumar A, et al. Iron regulates the quiescence of naive CD4 T cells by controlling mitochondria and cellular metabolism. Proc Natl Acad Sci U S A. 2024;121(17):e2318420121.
- Jiang H, et al. Gut microbiota dysbiosis in diabetic nephropathy: mechanisms and therapeutic targeting via the gut-kidney axis. Front Endocrinol (Lausanne). 2025;16:1661037.
- Charoentong P, et al. Pan-cancer immunogenomic analyses reveal genotype-immunophenotype relationships and predictors of response to checkpoint blockade. Cell Rep. 2017;18(1):248-62.
- Chen Y, et al. 5-ALA photodynamic metabolite-powered zero-waste ferroptosis amplifier for enhanced hypertrophic scar therapy. Nat Commun. 2025;16(1):8321.
- Li X, et al. Hypericin-mediated photodynamic therapy promotes apoptosis and inhibits fibrosis by inducing HMOX1-mediated ferroptosis in hypertrophic scar fibroblasts. J Photochem Photobiol B. 2025;273:113303.
- Chen Y, et al. Functional transdermal nanoethosomes enhance photodynamic therapy of hypertrophic scars via self-generating oxygen. ACS Appl Mater Interfaces. 2021;13(7):7955-65.
- Oh S, et al. Revealing the pathogenesis of keloids based on the status: active vs inactive. Exp Dermatol. 2024;33(5):e15088.
- Zhao S, et al. New anti-fibrotic strategies for keloids: insights from single-cell multi-omics. Cell Prolif. 2025;58(6):e13818.
- Yasujima T, et al. The role of FLVCR1 and FLVCR2 in choline transport in the Caco-2 intestinal epithelial cell model and rat small intestine. Biochim Biophys Acta Mol Basis Dis. 2025;1871(6):167883.
- Zhang M, Chen H, Qian H, Wang C. Characterization of the skin keloid microenvironment. Cell Commun Signal. 2023;21(1):207.
- Wang Y, et al. FoxC1 activates Notch3 signaling to promote the inflammatory phenotype of keloid fibroblasts and aggravates keloid. Exp Cell Res. 2025;444(2):114402.
- Zhang J, et al. ERG transcriptionally activates SFRP1 to promote apoptosis of keloid fibroblasts and inhibit epithelial-mesenchymal transition and fibrosis through the Wnt3a/β-catenin pathway. Arch Dermatol Res. 2025;317(1):467.
- Ramos-Tovar E, Muriel P. NLRP3 inflammasome in hepatic diseases: a pharmacological target. Biochem Pharmacol. 2023;217:115861.
- Brahadeeswaran S, et al. NLRP3: a new therapeutic target in alcoholic liver disease. Front Immunol. 2023;14:1215333.
- Xiao Y, et al. STING mediates hepatocyte pyroptosis in liver fibrosis by epigenetically activating the NLRP3 inflammasome. Redox Biol. 2023;62:102691.
- Paolucci T, et al. Quantum molecular resonance inhibits NLRP3 inflammasome/nitrosative stress and promotes M1 to M2 macrophage polarization: potential therapeutic effect in osteoarthritis model in vitro. Antioxidants (Basel). 2023;12(7):1358.
- Wei J, et al. FERM domain containing kindlin 1 knockdown attenuates inflammation induced by intracerebral hemorrhage in rats via NLR family pyrin domain containing 3/nuclear factor kappa B pathway. Exp Anim. 2023;72(3):324-35.
- Tao L, Zhou Y, Wu L, Liu J. Comprehensive analysis of sialylation-related genes and construct the prognostic model in sepsis. Sci Rep. 2024;14(1):18110.
- Sun Q, et al. Identification of hub genes and key pathways associated with sepsis progression using weighted gene co-expression network analysis and machine learning. Int J Mol Sci. 2025;26(9):4433.
- Chen JJ. HRI protein kinase in cytoplasmic heme sensing and mitochondrial stress response: relevance to hematological and mitochondrial diseases. J Biol Chem. 2025;301(5):108494.
- Chakrabarty Y, Yang Z, Chen H, Chan DC. The HRI branch of the integrated stress response selectively triggers mitophagy. Mol Cell. 2024;84(6):1090-100.e6.
- Bora P, et al. Drug repurposing screen identifies an HRI activating compound that promotes adaptive mitochondrial remodeling in MFN2-deficient cells. Proc Natl Acad Sci U S A. 2025;122(48):e2517552122.
- Zhang C, et al. CaMKII suppresses proteotoxicity by phosphorylating BAG3 in response to proteasomal dysfunction. EMBO Rep. 2024;25(10):4488-514.
- Chaabani H, et al. Trifloxystrobin induces oxidative stress-dependent activation of the OMA1-DELE1-HRI integrated stress response leading to apoptosis in human neuroblastoma cells. Environ Pollut. 2026;390:127562.
- Das R, et al. CMT2A-linked MFN2 mutation, T206I promotes mitochondrial hyperfusion and predisposes cells towards mitophagy. Mitochondrion. 2024;74:101825.
- De Simone G, et al. Heme scavenging and delivery: the role of human serum albumin. Biomolecules. 2023;13(3):575.
- Turilli-Ghisolfi ES, Lualdi M, Fasano M. Ligand-based regulation of dynamics and reactivity of hemoproteins. Biomolecules. 2023;13(4):683.
- Zhang P, et al. Risk factors and prediction models for cardiotoxicity induced by anthracyclines in malignant chemotherapy. Cancer Chemother Pharmacol. 2025;95(1):73.
- Petrillo S, et al. Endothelial cells require functional FLVCR1a during developmental and adult angiogenesis. Angiogenesis. 2023;26(3):365-84.
- Fiorito V, Tolosano E. Unearthing FLVCR1a: tracing the path to a vital cellular transporter. Cell Mol Life Sci. 2024;81(1):166.
- Manco M, et al. FLVCR1a controls cellular cholesterol levels through the regulation of heme biosynthesis and tricarboxylic acid cycle flux in endothelial cells. Biomolecules. 2024;14(2):149.
- Shi X, et al. Increased melanin induces aberrant keratinocyte-melanocyte-basal-fibroblast cell communication and fibrogenesis by inducing iron overload and ferroptosis resistance in keloids. Cell Commun Signal. 2025;23(1):141.
- Khunger N, Dash A. Impact of air pollution on skin pigmentation: mechanisms and protective strategies. Int J Dermatol. 2025;64(10):1788-801.
- Ahuja K, Raju S, Dahiya S, Motiani RK. ROS and calcium signaling are critical determinant of skin pigmentation. Cell Calcium. 2025;125:102987.
- Dutta A, Chakraborty S, Roy A, Mittal A, et al. Tissue fibrosis in cardiorenal syndrome: crosstalk between heart and kidneys. Nephrol Dial Transplant. 2025;40(7):1273-83.
- Noah AA, et al. Reversal of fibrosis and portal hypertension by empagliflozin treatment of CCl4-induced liver fibrosis: emphasis on gal-1/NRP-1/TGF-β and gal-1/NRP-1/VEGFR2 pathways. Eur J Pharmacol. 2023;959:176066.
- Murakami T, Shigeki S. Pharmacotherapy for keloids and hypertrophic scars. Int J Mol Sci. 2024;25(9):4674.
- Jin J, Zheng Z. Gut microbiota-derived metabolites in keloid and hypertrophic scarring. Front Microbiol. 2025;16:1644758.
- Aubert A, et al. Potential implications of granzyme B in keloids and hypertrophic scars through extracellular matrix remodeling and latent TGF-β activation. Front Immunol. 2024;15:1484462.