Deze workflow integreert bulk- en single-cell transcriptomics met preliminaire weefselanalyses van patiënten om MMP1 te prioriteren bij diabetische voetulcera. MMP1 vertoonde een expressiepatroon gecentreerd rond fibroblasten en een hogere weefsel abundantie, wat wijst op een associatie met matrixremodellering, terwijl de causaliteit en klinische bruikbaarheid onopgelost bleven.
Onderzoeksartikel
Integratieve bulk- en single-cell transcriptomics met weefselvalidatie prioriteren MMP1 bij diabetische voetulcera
* These authors contributed equally
In dit artikel
Samenvatting
Samenvatting
Cellulaire bronnen van reproduceerbare transcriptomische veranderingen bij het diabetische voetulcera (DFU) zijn nog onvolledig gedefinieerd. Deze studie integreerde differentieel-expressieanalyse, weighted gene co-expression network analysis (WGCNA), screening van genen gerelateerd aan diabetische perifere neuropathie (DPN), exploratieve feature-selectie via machine learning, twee externe bulk-transcriptomische datasets, single-cell analyse, netwerkanalyse van traditionele Chinese geneeskunde (TCM), en kwantitatieve polymerasekettingreactie (qPCR) en western blotting op patiëntweefsel. In GSE199939 (10 DFU- en 11 controlemonsters) werden 3.691 differentieel tot expressie gebrachte genen geïdentificeerd, waarbij de blauwe module van de WGCNA sterk geassocieerd was met DFU (r = 0,97, p = 5 × 10-13). De intersectie van de differentieel tot expressie gebrachte genen, hubgenen van de blauwe module en 1.062 DPN-gerelateerde genen leverde 77 kandidaten op. CCL7, CHEK1, MKI67, MMP1, MMP13 en TRPV2 werden ondersteund door ten minste twee feature-selectiemethoden; volledige scheiding bij support vector machine recursive feature elimination wekte zorgen over overfitting in de discovery-cohort. MMP1 vertoonde de grootste verandering in expressie in de discovery-cohort (log2 fold change = 9,854; gecorrigeerde p = 1,24 × 10⁻²⁹). In de samengevoegde GSE68183/GSE80178-matrix had MMP1 een gecorrigeerde p van 0,0159 en een area under the receiver operating characteristic curve (AUC) van 0,981. In GSE134431 was de expressie van MMP1 nominaal hoger in DFU dan in niet-geulcereerde diabetische voetbehuiding (p = 0,0225; gecorrigeerde p = 0,135; AUC = 0,808). Analyse van 69.944 cellen uit 24 monsters toonde de hoogste gemiddelde MMP1-expressie in fibroblasten, met een hogere expressie op monsterniveau in DFU-fibroblasten, keratinocyten en endotheelcellen. Assays op patiëntweefsel toonden een hogere MMP1 mRNA-abundantie in vier gematchte paren (gepaarde test op ΔCq, p = 3,04 × 10⁻⁵) en een hogere eiwitabundantie in drie gematchte paren (gepaarde p = 0,0107). Statistische replicatie was onvolledig. De bevindingen suggereren een associatie met matrix-remodellering gecentreerd rond fibroblasten, onderworpen aan beperkingen door transcripts per million (TPM) input in count-gebaseerde discovery-analyse, onvolledige records van single-cell preprocessing en kleine cohorten voor weefselassays. Causaliteit en klinisch nut blijven niet vastgesteld.
Inleiding
Het diabetische voetulcera is een ernstige en recidiverende complicatie van diabetes die voortvloeit uit de convergentie van neuropathie, repetitieve mechanische belasting, perifeer arterieel vaatlijden, infectiegevoeligheid en een verminderde weefselherstelcapaciteit. Hedendaagse schattingen geven aan dat wereldwijd jaarlijks miljoenen mensen zijn getroffen, waarbij de genezing vaak langdurig is en gepaard gaat met aanzienlijke risico's op recidive, hospitalisatie, amputatie van de onderste extremiteiten en overlijden1. Preventie en management zijn daarom niet alleen afhankelijk van lokale wondzorg, maar ook van het identificeren van het verlies van protectieve sensibiliteit, het verminderen van de plantaire druk, het behandelen van infectie en ischemie, en het aanpakken van systemische risicofactoren1,2. Diabetische perifere neuropathie is bijzonder relevant omdat progressieve sensorische dysfunctie het bewustzijn van druk, trauma en weefselafbraak kan verminderen, terwijl motorische en autonome afwijkingen de biomechanica van de voet en de integriteit van de huid verder kunnen beïnvloeden2,3. Op weefselniveau kan neuropathisch letsel samengaan met neuro-inflammatie, microvasculaire dysfunctie, metabole stress en defect herstel, waardoor een wondomgeving ontstaat waarin het letsel aanhoudt ondanks standaardzorg1,3.
Een succesvolle cutane genezing vereist gecoördineerde inflammatie, re-epithelialisatie, angiogenese, fibroblastactivatie, depositie van de extracellulaire matrix (ECM) en daaropvolgende matrixremodellering. Bij diabetes kunnen deze processen temporeel gedesorganiseerd raken: inflammatoire signalen kunnen actief blijven, de migratie van keratinocyten kan belemmerd zijn, endotheliale responsen kunnen onvoldoende zijn en fibroblasten kunnen een abnormale matrix produceren of organiseren. Fibroblasten staan centraal in de stromale fase van herstel omdat ze matrixeiwitten synthetiseren, de collageenarchitectuur reguleren, communiceren met immuun- en epitheelcellen en bijdragen aan wondcontractie. Studies met DFU-fibroblasten afkomstig van patiënten hebben aanhoudende abnormaliteiten aangetoond in ECM-gerelateerde transcriptie en matrixassemblage, wat het standpunt ondersteunt dat de status van de fibroblast een belangrijk onderdeel is van de biologie van chronische wonden4. Matrixmetalloproteïnasen (MMP's) nemen deel aan dit proces door ECM-substraten te splitsen en zo celmigratie, weefselomzetting en remodellering mogelijk te maken; hun effecten zijn echter afhankelijk van locatie, timing, substraatbeschikbaarheid en regulatie door weefselremmers van metalloproteïnasen (TIMP's)5. Een onbalans tussen proteolyse en matrixvervanging kan daarom samenhangen met een belemmerd herstel, maar een verhoogde expressie van een individuele MMP bepaalt op zichzelf niet of er sprake is van een schadelijke of gunstige rol. Matrixmetalloproteïnase 1 (MMP1), een interstitiële collagenase die kan deelnemen aan de omzetting van fibrillair collageen, is aangetroffen in gewijzigde vorm in DFU-weefsel, en eerdere klinische studies hebben MMP/TIMP-profielen gekoppeld aan de wondstatus of genezingstrajecten6,7. Deze waarnemingen ondersteunen verder onderzoek naar MMP1 bij DFU.
Transcriptomische profilering biedt een systematische aanpak voor het identificeren van moleculaire programma's die geassocieerd zijn met DFU, maar verschillende methodologische beperkingen bemoeilijken de interpretatie. Datasets van bulkweefsel middelen signalen over keratinocyten, fibroblasten, endotheelcellen, immuuncellen en andere compartimenten, waardoor het moeilijk is om vast te stellen of een kandidaat een veranderde expressie binnen een celtype weerspiegelt, verschuivingen in de cellulaire samenstelling, of beide. De vergelijkbaarheid tussen datasets kan bovendien worden beperkt door verschillen in platforms, normalisatiestrategieën, locaties van weefselafname, ernst van het ulcus, infectiestatus, ziektestadium en referentieweefsel. Belangrijk is dat niet-geulcereerde diabetische voet huid een klinisch relevante diabetische weefselcomparator is, maar niet uitwisselbaar is met gezonde huid. Single-cell RNA-sequencing kan het probleem van de cellulaire bron gedeeltelijk oplossen door heterogene celpopulaties en hun transcriptionele toestanden te ontleden. Een eerdere single-cell en ruimtelijke transcriptomische studie naar DFU identificeerde verschillende fibroblastpopulaties en toonde aan dat fibroblastprogramma's verschillen afhankelijk van de wondcontext en de genezingsstatus8. Deze bevindingen ondersteunen het gebruik van cel-resolute analyse om bulk-transcriptomische gegevens aan te vullen.
Methoden voor kenmerkselectie kunnen helpen bij het prioriteren van kandidaten uit hoogdimensionale expressiedata, maar biomedische studies met kleine steekproeven zijn bijzonder gevoelig voor optimistische schattingen en instabiele genselectie. Wanneer het aantal gemeten variabelen het aantal biologische monsters sterk overtreft, kan er een schijnbare perfecte scheiding optreden, zelfs wanneer generaliseerbare voorspellende informatie beperkt is. Het hergebruiken van dezelfde observaties voor kenmerkselectie, tuning en prestatiebeoordeling drijft de AUC verder op, waardoor geneste kruisvalidatie, locked models en werkelijk onafhankelijke testcohorten essentieel zijn voor het evalueren van de voorspellende prestaties9,10. Deze zorgen zijn relevant voor DFU-studies omdat publiek beschikbare cohorten vaak klein en heterogeen zijn. Database-gegevens over ingrediënten, targets en kruiden uit de traditionele Chinese geneeskunde werden bovendien uitsluitend gebruikt voor hypothesegeneratie.
Deze studie integreerde bulk-transcriptomics, WGCNA, screening van DPN-gerelateerde genen, featureselectie via machine learning, beoordeling van externe datasets, single-cell analyse, TCM-netwerkanalyse en validatie in patiëntweefsel. Kandidaatgenen die in de discovery-cohort waren geïdentificeerd, werden geëvalueerd in aanvullende transcriptomische datasets, en de belangrijkste kandidaat werd gelokaliseerd naar specifieke celtypen met behulp van single-cell data. Vervolgens werd MMP1 op mRNA- en proteïneniveau in patiëntweefsel onderzocht via qPCR en western blotting. Dit raamwerk was ontworpen om een reproduceerbare DFU-geassocieerde kandidaat te identificeren en de cellulaire en biologische context ervan te karakteriseren.
Protocol
Studieopzet en gegevensbronnen
De studie, inclusief de verzameling en het gebruik van weefselmonsters van patiënten voor qPCR- en western blot-validatie, is beoordeeld en goedgekeurd door de ethische commissie van het Wuhan Fourth Hospital (goedkeuringsnummer KY2024-161-01). Alle procedures met menselijk weefsel werden uitgevoerd in overeenstemming met het goedgekeurde protocol en de geldende ethische principes. Voor het transcriptomische onderdeel van de studie werden publiek beschikbare, gedeïdentificeerde datasets gebruikt. Van alle deelnemers wier weefselmonsters werden gebruikt voor de experimentele validatie, is schriftelijke geïnformeerde toestemming verkregen. De publiek beschikbare transcriptomische datasets werden in gedeïdentificeerde vorm geanalyseerd, en de toestemmingsprocedures voor de oorspronkelijke studies die de data genereerden, werden afgehandeld door de respectievelijke instellingen.
Deze studie integreerde bulk-transcriptomica, netwerkanalyse, kenmerkenselectie, single-cell analyse, TCM-netwerkvoorspelling en validatie in patiëntweefsel. De discovery-cohort bestond uit de Gene Expression Omnibus (GEO) dataset GSE199939 (10 DFU- en 11 controlemonsters). De externe bulk-transcriptomische beoordeling omvatte een samengevoegde GSE68183/GSE80178-matrix (9 DFU- en 6 controlemonsters) en GSE134431 (13 DFU- en 8 niet-geulcereerde diabetische voet-huid [DFS] monsters). Voor de single-cell analyse werd een voorbewerkt, SingleR-geannoteerd Seurat-object gebruikt dat was afgeleid van GSE165816, bestaande uit 69.944 cellen uit 24 monsters (14 DFU en 10 controles). De weefselbeoordeling omvatte vier gematchte DFU–periwound patiëntparen voor qPCR en drie gematchte paren voor western blotting, op basis van herwonnen assay-gegevens en door de auteur bevestigde koppelingen. Alle materialen en apparatuur die in deze studie zijn gebruikt, staan vermeld in de Tabel van Materialen.
Constructie van de DPN-gerelateerde genenset
DPN-gerelateerde genen werden opgehaald uit de Gene-database van het National Center for Biotechnology Information (NCBI) met behulp van rentrez. De zoektermen omvatten “diabetic peripheral neuropathy”, “diabetic neuropathy”, “diabetic polyneuropathy”, “painful diabetic neuropathy” en “diabetic sensorimotor polyneuropathy”, beperkt tot Homo sapiens. De geretourneerde identificatoren werden gekoppeld aan officiële gensymbolen, omgezet naar hoofdletters, opgeschoond en ontdubbeld. De uit de database afgeleide genen werden gecombineerd met een uit de literatuur gecureerde DPN-genenlijst en ontdubbeld, wat resulteerde in 1.062 DPN-gerelateerde genen. De volledige zoekstrings en de code voor het opschonen van identificatoren zijn opgenomen in de bijbehorende scripts; deze bevatten ook diabetische neuropathieën, diabetes in combinatie met distale symmetrische polyneuropathie of perifere neuropathie, en de MeSH-term Diabetic Neuropathies. Het uit de literatuur afgeleide onderdeel vereist nog steeds herleidbaarheid op citatieniveau.
Preprocessing van de ontdekkingscohort en analyse van differentiële expressie
De GSE199939-expressiematrix werd op basis van de monsteridentificatie uitgelijnd met de fenotypetabel. Dubbele gen-identificatoren werden uniek gemaakt. De gearchiveerde discovery-analyse rondde de expressiewaarden af en paste een negatief-binomiaal model toe met behulp van DESeq2 (versie 1.48.2), waarbij de groep als designfactor en DFU versus controle als contrast dienden. Genen met ontbrekende gecorrigeerde p-waarden werden uitgesloten. Meervoudig testen werd gecontroleerd met de Benjamini–Hochberg (BH)-procedure. Voor de gearchiveerde lijst met differentieel tot expressie gebrachte genen (DEG) werd een absolute log2 fold change van groter dan 1 en een BH-gecorrigeerde p < 0,05 gehanteerd. Vergelijking met de openbare GEO-bron bevestigde dat de input TPM was, en geen ruwe read-counts. Het afronden van TPM voldoet niet aan de vereiste van ruwe counts voor DESeq2. De oorspronkelijke schattingen zijn behouden, maar de validiteit van de discovery-statistieken en de daarvan afhankelijke WGCNA- en feature-selectieresultaten blijft onopgelost in afwachting van een passende heranalyse. De bronvergelijking is gedocumenteerd in het supplementaire archief.
Voor visualisatie werd de DESeq2 variance-stabilizing transformation (VST) toegepast met blind = FALSE. Er werd een principale componentanalyse (PCA) uitgevoerd op de VST-expressiematrix. De heatmap maakte gebruik van rijgewijze z-scores voor de 50 genen met de kleinste gecorrigeerde p-waarden. De PCA-implementatie centreerde en schaalde gengewijs getransformeerde waarden met prcomp met scale. = TRUE.
Gewogen gen-co-expressienetwerkanalyse
Voor WGCNA werden genen met counts groter dan 5 in ten minste drie GSE199939-monsters behouden. Groottefactoren werden geschat met DESeq2, VST werd toegepast met blind = TRUE, en de 5.000 genen met de grootste variantie over de monsters heen werden geselecteerd. De kwaliteit van monsters en genen werd beoordeeld met behulp van goodSamplesGenes, en voor de kwaliteitsbeoordeling op monsterniveau werd hiërarchische clustering met average-linkage gebruikt.
Een getekend netwerk werd geconstrueerd met WGCNA (versie 1.74). Kandidaat-machten van 1–10 en 12–30 in stappen van 2 werden geëvalueerd met pickSoftThreshold; er werd een doelwaarde van 0,85 gebruikt voor de passing van de schaalloze topologie, en de geselecteerde soft-thresholding macht was 18. Modules werden geïdentificeerd met blockwiseModules met behulp van een getekende adjacentie en een getekende topologische overlapmatrix, Pearson-correlatie, een minimale modulegrootte van 30, een merge cut height van 0,25, een hertoewijzingsdrempel van 1 × 10⁻⁶, pamRespectsDendro = FALSE en een maximale blokgrootte van 10.000.
Module-eigengenen werden gecorreleerd met een binair DFU-kenmerk. Niet-grijze modules met |r| > 0,5 en p < 0,05 werden beschouwd als DFU-geassocieerd. Voor elke geassocieerde module werd de gensignificantie (GS) gedefinieerd als de Pearson-correlatie tussen genexpressie en DFU-status, en het modulelidmaatschap (MM) als de Pearson-correlatie tussen genexpressie en het overeenkomstige module-eigengen. Hub-genen werden gedefinieerd door |MM| > 0,8 en |GS| > 0,5. De blauwe module, die de sterkste positieve associatie met DFU vertoonde, werd verder geanalyseerd. De hub-genen hiervan werden gekruist met de DEGs en de DPN-gerelateerde genset. De gerapporteerde hub-drempelwaarde maakt daarom gebruik van de absolute waarden van zowel MM als GS, ongeacht het teken van de correlatie.
Kenmerkprioritering op basis van machine learning
De 77 genen die gedeeld werden door de DEG-, blue-module hub-gene- en DPN-gerelateerde gensets werden geëvalueerd in GSE199939. Dubbele gensymbolen werden samengevoegd op basis van hun gemiddelde expressie. De kandidaat-genmatrix werd log2-getransformeerd wanneer de maximale waarde 50 overschreed, features met een nulvariantie werden verwijderd en de behouden features werden gestandaardiseerd. Er werd gebruikgemaakt van een random seed van 123. De geïmplementeerde volgorde was screening van kandidaten over de gehele cohort, samenvoegen van dubbele symbolen, conditionele log-transformatie, filtering van nulvariantie, centrering en schaling van de volledige cohort en algoritme-specifieke feature-selectie. De DEG- en WGCNA-screening maakten gebruik van de volledige discovery-cohort vóór de cross-validatie op algoritmeniveau. De gerapporteerde workflow vestigt daarom geen lekvrije geneste validatie, en de interne AUC's kunnen niet worden gebruikt als onbevooroordeelde schattingen van de voorspellende prestaties.
Er werden drie procedures voor kenmerkselectie toegepast. Ten eerste werd een logistische regressie met de least absolute shrinkage and selection operator (LASSO) uitgevoerd met glmnet (versie 5.0), binomiale familie, alpha = 1, classificatiefout als cross-validatiemaatstaf, geen aanvullende standaardisatie en vijfvoudige cross-validatie beperkt door de kleinste klasseomvang. Kenmerken bij lambda.1se werden geselecteerd; lambda.min werd alleen gebruikt als lambda.1se geen enkel gen selecteerde. Ten tweede werd een random forest met 1.000 bomen gefit met behulp van randomForest (versie 4.7-1.2); genen met een gemiddelde afname in Gini die minstens zo groot was als de gemiddelde belangrijkheid over de kandidaatgenen werden behouden. Ten derde werd lineaire support vector machine recursive feature elimination (SVM-RFE) geïmplementeerd met e1071 (versie 1.7-17), waarbij kenmerken werden gerangschikt op basis van het kwadraat van het lineaire gewicht op de volledige cohort voordat progressief kleinere subsets van kenmerken werden geëvalueerd via de AUC van leave-one-out cross-validatie (LOOCV). De rangschikking werd niet opnieuw berekend binnen elke trainingsfold. Voor het fitten van de lineaire SVM werden scale = FALSE en probability = TRUE gebruikt zonder een expliciet cost-tuning grid. De selectie van de LASSO-penalty maakte gebruik van de interne cross-validatie zonder een aparte externe evaluatieloop, en de random-forest belangrijkheid werd berekend op basis van de volledige cohort.
Geen enkel gen werd door alle drie de methoden geselecteerd; daarom werden genen die door ten minste twee methoden werden ondersteund, behouden. SVM-RFE produceerde een AUC van 1,00 over alle geëvalueerde subsetgroottes, waarna de kleinste subset met dezelfde score werd gekozen. Omdat deze volledige scheiding zorgen opriep over overfitting en een te optimistische beoordeling in de kleine discovery-cohort, werd de SVM-RFE AUC niet geïnterpreteerd als een schatting van de klinische prestaties. Er is geen vastgesteld multigen-model getest in een externe cohort; externe receiver operating characteristic (ROC)-analyses beoordeelden de expressie van individuele kandidaatgenen. Inspectie van het analysescript bevestigde dat de preprocessing en de SVM-feature-rangschikking niet beperkt waren tot de trainingsfolds. Dezelfde LOOCV-resultaten werden gebruikt om de subsetgrootte te bepalen, zonder een externe evaluatielus. Bijgevolg bevat deze workflow informatielekkage en ondersteunt deze uitsluitend de exploratoire prioritering van features.
Functionele verrijkingsanalyse
Over-representatieanalyses van Gene Ontology (GO) en de Kyoto Encyclopedia of Genes and Genomes (KEGG) werden uitgevoerd op het panel van zes genen. Gene-symbolen werden gekoppeld aan Entrez-identificatoren met org.Hs.eg.db (versie 3.21.0). De GO-analyse werd uitgevoerd met clusterProfiler (versie 4.16.0) over de ontologieën van biologische processen, cellulaire componenten en moleculaire functies. Voor de KEGG-verrijking werd de code voor het menselijke organisme (hsa) gebruikt. Significante termen werden gedefinieerd als een nominale p < 0,05 en een BH-gecorrigeerde p < 0,05. Omdat er slechts zes genen waren opgenomen, werd de verrijkingsanalyse primair gebruikt voor functionele annotatie. Het KEGG-script maakte gebruik van lokale KEGG.db-annotaties met enrichKEGG(use_internal_data = TRUE); de annotatie-release moet worden gedocumenteerd. De GO- en KEGG-scripts bevatten geen aangepast universum, waardoor de annotatiedatabases de standaardachtergronden bepaalden.
Externe bulk-transcriptomische beoordeling
Voor de samengevoegde GSE68183/GSE80178-matrix werden gensymbolen gestandaardiseerd en dubbele symbolen samengevoegd op basis van de gemiddelde expressie over de overeenkomstige rijen. De zes kandidaatgenen werden afgestemd op het fenotypebestand. Omdat de beschikbare bestanden de voorafgaande samenvoegings- en batchcorrectieprocedure niet volledig documenteerden, is deze dataset geanalyseerd zoals aangeleverd en voorzichtig geïnterpreteerd. Bijgevolg kan op basis van het verstrekte verwerkingsverslag noch de verwijdering van batch-effecten, noch de onafhankelijkheid van het groepsignaal ten opzichte van studie-effecten worden vastgesteld. Deze matrix biedt verkennende ondersteuning over verschillende datasets heen in plaats van een definitieve replicatie.
Voor GSE134431 werden de zes kandidaatgenen geëxtraheerd uit de matrix van reads per kilobase per miljoen gemapte reads (RPKM) en getransformeerd als log2(RPKM + 1). DFS werd gebruikt als de referentiegroep en DFU als de vergelijkingsgroep. DFS staat voor niet-geulcereerde diabetische voetstaphuid. De oorspronkelijk ingediende Figuur 4C toonde de ruwe RPKM; het herziene paneel maakt gebruik van de vermelde log2(RPKM + 1) schaal. Tweezijdige Wilcoxon-toetsen met normale benadering en continuïteitscorrectie en automatisch georiënteerde ROC-analyses werden op beide schalen geverifieerd en gaven identieke p-waarden en AUC's omdat de transformatie strikt monotonisch is.
Binnen elke bulk-validatiedataset werden expressieverschillen tussen groepen getest met tweezijdige Wilcoxon rank-sum tests, waarbij BH-correctie werd toegepast over de zes genen. ROC-curves werden berekend met pROC (versie 1.19.0.1), waarbij de richting automatisch door het pakket werd geselecteerd. AUC's en de bijbehorende 95% betrouwbaarheidsintervallen (CIs) werden berekend om discriminerende patronen tussen datasets te vergelijken. Het automatisch selecteren van de ROC-richting uit elke beoordelingsdataset kan leiden tot een optimistische discriminatie; deze single-gene AUC's zijn beschrijvend en valideren geen vooraf gespecificeerd klinisch voorspellingsmodel.
Lokalisatie op single-cell niveau en analyse op monster-niveau
Voor de single-cell analyse werd het opgeslagen Seurat-object biofsci_SingleR_annotated_MMP1_analyzed.rds van GSE165816 gebruikt, dat 22.889 genen en 69.944 cellen in de RNA-assay bevatte. De RNA-assay behield een non-negative integer counts-laag en een data-laag die was gegenereerd via LogNormalize met een schaalfactor van 10.000, gevolgd door een log1p-transformatie; dit laatste was geen TPM. Het object bevatte 2.000 variabele genen geselecteerd met de vst-methode (loess.span = 0,3; 20 bins van gelijke breedte), geschaalde expressie voor alle behouden genen (centering en scaling ingeschakeld; scale.max = 10), en 50 hoofdcomponenten berekend uit de variabele features met seed 42. De opgeslagen opdrachtenhistorie maakte gebruik van Harmony-dimensies 1–20 voor de constructie van nearest-neighbor en uniform manifold approximation and projection (UMAP). De neighbor-instellingen omvatten k = 20, Annoy met 50 bomen en Euclidische afstand, en een shared nearest-neighbor (SNN) pruning-drempel van 1/15. Voor clustering werd resolutie 0,8, algoritme 1, n.start = 10, n.iter = 10 en random.seed = 0 gebruikt. UMAP maakte gebruik van de uwot-implementatie, 30 neighbors, twee output-dimensies, een cosinus-afstandmetriek, min.dist = 0,3, spread = 1, learning.rate = 1 en seed 42. Het object behield een Harmony-reductie, maar de oorspronkelijke kwaliteitscontrole-grenswaarden, de volledige RunHarmony-aanroep inclusief de batch-covariabelen en de SingleR-referentie- en annotatie-instellingen voor dit geanalyseerde object konden niet worden hersteld. Celtype-labels, groepslabels en monster-identificatoren waren respectievelijk opgeslagen in SingleR_label, Group en orig.ident. Tien geannoteerde celtypen werden behouden: B-cellen, CD8+ T-cellen, endotheelcellen, epitheelcellen, fibroblasten, hematopoëtische stamcellen, keratinocyten, macrofagen, monocyten en neuronen.
MMP1-expressie werd samengevat per celtype. Cellen met een genormaliseerde MMP1-expressie groter dan nul werden geclassificeerd als MMP1-positief. Voor analyse op monsterniveau werd de gemiddelde genormaliseerde expressie berekend voor elke combinatie van monster en celtype. DFU- en controlemonsters werden binnen elk celtype vergeleken met behulp van tweezijdige Wilcoxon rank-sum tests, gevolgd door BH-correctie over alle geteste celtypen. De GEO-monsteraccession, in plaats van de individuele cel, was de eenheid die werd gebruikt in deze gerapporteerde vergelijkingen. De 24 accessions werden niet beschouwd als bewijs voor 24 onafhankelijke donoren. Het opgeslagen object bevatte geen geverifieerde donoridentificatie en herhaalde weefselafname binnen donoren werd niet gemodelleerd; de tests op monsterniveau worden bijgevolg geïnterpreteerd als verkennend. Deze samenvattingen middelen de genormaliseerde expressie binnen monster en celtype; het zijn geen count-summed pseudobulk differentiële expressiemodellen.
Tien functionele gensets werden gescoord met Seurat AddModuleScore. Spearman-correlaties tussen de per-cel MMP1-expressie en de modulescores werden berekend en BH-gecorrigeerd. Voor de exploratieve MMP1-high analyse werden de drie celtypen met de hoogste gemiddelde MMP1-expressie geselecteerd uit de celtypen die ten minste 50 cellen bevatten. Een globale afkapwaarde werd gedefinieerd als de mediane expressie onder MMP1-positieve cellen wanneer er meer dan 10 positieve cellen beschikbaar waren; anders gebruikte het script het algemene 75ste percentiel. Cellen boven deze afkapwaarde werden toegewezen aan de MMP1-high groep en de overige cellen aan de MMP1-low groep. FindMarkers maakte gebruik van een Wilcoxon-toets, logfc.threshold = 0.25 en min.pct = 0.1. Upgegradeerde genen met een gecorrigeerde p < 0.05 werden onderworpen aan GO-verrijking van biologische processen. Omdat de groepen werden gedefinieerd op basis van MMP1-expressie, werd deze analyse gebruikt om pathways te beschrijven die geassocieerd zijn met de MMP1-high status. Per-cel correlaties, hun gecorrigeerde p-waarden en de verrijking van MMP1-high versus MMP1-low zijn beschrijvend omdat afhankelijkheid binnen de monsters niet werd gemodelleerd. Individuele cellen werden niet geïnterpreteerd als onafhankelijke biologische replica's.
Voorspelling van TCM-ingrediënt-doelwit-kruid
De zes geprioriteerde genen werden gekoppeld aan kolom 4 van de lokale interactietabel tussen chemicaliën en genen van de Comparative Toxicogenomics Database (CTD). De records werden in kolom 7 beperkt tot Homo sapiens. Ingrediëntnamen werden ingekort en genormaliseerd naar kleine letters voor de matching, en dubbele koppelingen tussen ingrediënt-target en kruid-ingrediënt werden verwijderd. Ingrediënten werden gekoppeld aan kruiden met behulp van de referentietabel voor kruid-ingrediënten. Voor de database-verrijking werd een nominale p < 0,05 en een gecorrigeerde p < 0,05 gebruikt. Dubbele records van kruid-ingrediënt-target werden verwijderd vóór de samenvatting op basis van dekking. Voor de kruidverrijking werd clusterProfiler::enricher gebruikt met de kruid-ingrediënt-mapping als TERM2GENE, minGSSize = 1, maxGSSize = 500, pvalueCutoff = 1 en qvalueCutoff = 1, alvorens de nominale en BH-gecorrigeerde significantiedrempels toe te passen. Deze databaselinks kunnen veranderingen in expressie of activiteit beschrijven en bewijzen geen directe binding of een uniforme effectrichting.
Kruiden werden gerangschikt met behulp van de volgende dekkingsscore:
S = 3R + 5L +2T + 3C + 2I + N (1)
Hier is R het aantal MMP1-records, L het aantal MMP1-gekoppelde ingrediënten, T het aantal gedekte targets, C het aantal kerningrediënten, I de matrix-asindicator en N het totale aantal ingrediënten.
De kernbestanddelen waren quercetine, luteoline en berberine. De matrix-asindicator werd ingesteld op 1 wanneer een kruid zowel MMP1 als MMP13 besloeg en op 0 in andere gevallen. Van kandidaat-kruiden was vereist dat ze ten minste één MMP1-gekoppeld record bevatten en ofwel ten minste twee MMP1-gekoppelde bestanddelen, ofwel ten minste vier targets plus één kernbestanddeel. De score werd gebruikt om de databasedekking samen te vatten en werd niet beschouwd als een maat voor farmacologische werkzaamheid. De coëfficiënten definiëren een aangepaste, heuristische dekkingregel die de nadruk legt op MMP1-gekoppelde records en bestanddelen, een bredere targetdekking, de drie aangewezen bestanddelen en een gezamenlijke MMP1/MMP13-dekking. Ze zijn niet afgestemd op klinische uitkomsten of experimenteel gevalideerd, en alternatieve wegingen zouden de rangschikking van de kruiden kunnen veranderen.
Afname van patiëntweefsel en preliminaire qPCR- en western blot-beoordeling
Patiënten met klinisch gediagnosticeerde diabetische voetulcera die een klinisch geïndiceerde wonddebridement of chirurgische ingreep ondergingen in het Wuhan Fourth Hospital kwamen in aanmerking wanneer voetweefsel beschikbaar was en schriftelijke geïnformeerde toestemming was verkregen. De exclusiecriteria waren maligniteit op de bemonsteringsplaats, een niet-diabetische oorzaak van het ulcus, of onvoldoende hoeveelheid of kwaliteit van het weefsel voor de geplande assays. DFU-weefsel en niet-geulcereerd weefsel rondom de wond werden van dezelfde patiënt verkregen volgens het goedgekeurde studieprotocol. Dat laatste diende als een gematchte periwond-comparator; het was geen gezonde niet-diabetische huid. De qPCR-beoordeling bestond uit vier gematchte paren (vier DFU-monsters en vier overeenkomstige periwond-monsters), en western blotting bestond uit drie gematchte paren. De matching werd door de auteurs bevestigd voor elke assay; identiteit tussen assays werd niet gebruikt in de statistische vergelijkingen. Elke patiënt vormde de biologische eenheid, en technische PCR-wells waren herhaalde metingen binnen een monster. Deze voorlopige assays waren bedoeld om de expressie van MMP1 op weefselniveau te beoordelen en waren niet ontworpen om diagnostische prestaties, causaliteit of generaliseerbaarheid over DFU-fenotypes vast te stellen.
Voor qPCR-validatie werd totaal RNA geëxtraheerd uit weefselmonsters van patiënten met gebruik van een total RNA-extractiereagens volgens de instructies van de fabrikant. De RNA-concentratie en -zuiverheid werden spectrophotometrisch beoordeeld, en monsters met een A260/A280-ratio van 1,8–2,1 werden gebruikt voor daaropvolgende analyses. Totaal RNA (1 µg) werd reverse getranscribeerd met een Moloney murine leukemia virus (M-MLV) reverse-transcriptiekit in een finaal reactievolume van 20 µL. Het beschikbare instrumentproject identificeert een real-time PCR-systeem. Kwantitatieve PCR werd uitgevoerd met 2x SYBR Green PCR master mix in een reactie van 20 µL bestaande uit 10 µL 2x SYBR Green master mix, 0,4 µL van elk de forward- en reverse-primers, 2 µL complementair DNA (cDNA) en 7,2 µL nuclease-vrij water. Het amplificatieprogramma bestond uit een initiële denaturatie bij 95 °C gedurende 30 s, gevolgd door 40 cycli van 95 °C gedurende 5 s en 60 °C gedurende 30 s. Er werd een smeltcurve-analyse uitgevoerd om de amplificatiespecificiteit te verifiëren. De abundantie van het MMP1-transcript werd gemeten met β-actine (ACTB) als referentiegen. De primersequenties staan vermeld in Tabel 1. Voor de herziene gepaarde analyse werden de vijf technische wells per target binnen elk monster gemiddeld voordat de ΔCq-berekening werd uitgevoerd, en de relatieve MMP1-expressie werd berekend met de 2-ΔΔCq methode, waarbij de groep niet-geulcereerd periwound-weefsel als calibrator werd gebruikt. De herwonnen monsterparen waren NC–DFU, NC1–DFU1, NC2–DFU2 en NC3–DFU3, bevestigd door de auteurs als vier patiënt-gematchte paren. De vorige qPCR-plot gebruikte vijf technische-well-waarden van enkel NC en DFU; de herziene plot toont één waarde op monsterniveau na het middelen van de technische wells voor elk van de vier paren. De gepaarde inferentie maakte gebruik van ΔCq = gemiddelde Cq(MMP1) − gemiddelde Cq(ACTB), in plaats van fold-change-waarden op well-niveau. Het gearchiveerde instrumentproject wijkt ook af van het gerapporteerde reactievolume en cyclingschema, en de overeenkomst met het uitgezette experiment blijft onopgelost.
Voor validatie via western blot (WB) werden weefselmonsters gehomogeniseerd in ijskoud radioimmunoprecipitatie-assaybuffer aangevuld met protease-remmers. Lysaten werden 30 min op ijs geïncubeerd en 15 min gecentrifugeerd bij 12,000 x g bij 4 °C. De supernatanten werden verzameld en de proteïneconcentraties werden bepaald met een bicinchoninezuur-assay. Gelijke hoeveelheden proteïne (20 µg per lane) werden gescheiden op 4%–20% gradiënt natriumdodecylsulfaat-polyacrylamidegels en overgebracht op 0,22 µm polyvinylideenfluoride-membranen. Membranen werden 1 u bij kamertemperatuur geblokkeerd met 5% vetarme melk in Tris-gebufferde zoutoplossing bevattende 0,1% Tween-20 en overnight bij 4 °C geïncubeerd met een MMP1 polyklonaal antilichaam (1:1,000) en een cofiline polyklonaal antilichaam (1:6,000). Na drie wasbeurten met Tris-gebufferde zoutoplossing bevattende 0,1% Tween-20 werden de membranen 1 u bij kamertemperatuur geïncubeerd met mierikswortelperoxidase-geconjugeerd geiten anti-konijn immunoglobuline G (IgG) (1:5,000). Proteïnebanden werden gevisualiseerd met een enhanced chemiluminescent substraat en gefotografeerd met een chemiluminescentie-beeldvormingssysteem met de bijbehorende besturingssoftware (versie 1.2.0), zoals vastgelegd in de metadata van de afbeelding. Banden werden gekwantificeerd met ImageJ-software. Cofiline werd gebruikt als loading control, en de MMP1-proteïnehoeveelheid werd genormaliseerd ten opzichte van cofiline voor vergelijking tussen de groepen.
Statistische analyse en software
Alle tests waren tweezijdig, tenzij anders vermeld. Een BH-gecorrigeerde p < 0,05 werd gebruikt als de primaire drempelwaarde voor meervoudig testen. De exacte steekproefgroottes varieerden per dataset en, voor de analyse op single-cell steekproefniveau, afhankelijk van de aanwezigheid van een bepaald celtype in elke steekproef. Samenvattingen van continue expressie worden weergegeven als individuele waarnemingen met boxplots die de mediaan en het interkwartielbereik tonen; de whiskers reiken tot 1,5 keer het interkwartielbereik. Voor western blotting werden de zes verkregen MMP1-ten-opzichte-van-cofiline-ratio's geanalyseerd met een tweezijdige gepaarde t-test op drie door de auteurs bevestigde patiëntenparen (df = 2; p = 0,0107). Voor qPCR werden vijf ACTB en vijf MMP1 Cq-waarden afzonderlijk gemiddeld binnen elk monster voordat de ΔCq-berekening plaatsvond. Een tweezijdige gepaarde t-test vergeleek DFU- en gematchte periwound ΔCq-waarden over vier door de auteurs bevestigde patiëntenparen (df = 3; p = 3,04 × 10⁻⁵). De gemiddelde periwound ΔCq werd gebruikt als de gemeenschappelijke calibrator voor de weergave van de relatieve expressie. De geometrische gemiddelde fold-change binnen de patiënt en het bijbehorende 95% BI werden verkregen door de gemiddelde gepaarde ΔCq-diffentie en het op de t-test gebaseerde BI terug te transformeren. Individuele biologische waarnemingen worden weergegeven met lijnen die gematchte weefsels verbinden; technische wells vergroten de biologische steekproefgrootte niet. De p-waarden van de weefselassays zijn nominaal en exploratief. Met drie of vier patiënten kan de normaliteit van gepaarde verschillen niet betrouwbaar worden beoordeeld, en de assays blijven preliminair. Bio-informatische analyses en het genereren van figuren werden uitgevoerd in R 4.5.2 op Windows 11. De versies van de kernpakketten waren DESeq2 1.48.2, WGCNA 1.74, glmnet 5.0, randomForest 4.7-1.2, e1071 1.7-17, pROC 1.19.0.1, clusterProfiler 4.16.0, Seurat 5.5.0, SingleR 2.10.0, rentrez 1.2.4 en ggplot2 4.0.3. Een geconsolideerde inventaris van software, databases en parameters is opgenomen in Supplementary Table 1.
Resultaten
Ontdekkende transcriptomica identificeert een breed expressieprogramma geassocieerd met DFU
GSE199939 diende als de ontdekkingscohort en bevatte 10 DFU- en 11 controlemonsters (Figuur 1A). Principal component-analyse van VST-genormaliseerde expressie toonde een duidelijke groepsscheiding; principal components 1 en 2 verklaarden respectievelijk 34,8% en 15,1% van de totale variantie (Figuur 1B).
Met gebruik van |log2 fold change| > 1 en een BH-gecorrigeerde p < 0,05 identificeerde de analyse van differentiële expressie 3.691 DEGs, waaronder 1.247 genen die upregulated waren in DFU en 2.444 genen die downregulated waren in DFU (Figuur 1C). De top 50 DEGs vormden een sterk groepgestructureerd expressiepatroon (Figuur 1D). Van de zes vervolgens geselecteerde genen vertoonde MMP1 de grootste verandering in de discovery-cohort (log2 fold change = 9,854; gecorrigeerde p = 1,24 × 10⁻²⁹).
Een met DFU geassocieerde co-expressiemodule convergeert met DEGs en DPN-gerelateerde genen
WGCNA werd uitgevoerd op de 5.000 meest variabele VST-getransformeerde genen. Voor het getekende netwerk werd een soft-thresholding power van 18 gekozen, om een balans te vinden tussen de scale-free topologie fit en de connectiviteit (Figuur 2A). Hiërarchische clustering en dynamische moduledetectie identificeerden meerdere co-expressiemodules (Figuur 2B). De blauwe module vertoonde de sterkste positieve associatie met DFU (Pearson r = 0,97, p = 5 × 10-13; Figuur 2C). De bijbehorende samenvattingen van de kwaliteitscontrole voor monsterclustering en modulegrootte zijn opgenomen in Aanvullende Figuur 1A,B.
Binnen de blauwe module voldeden 689 genen aan de hub-criteria |MM| > 0,8 en |GS| > 0,5 (Figuur 2D). De intersectie van de 3.691 DEG's, 689 blue-module hub-genen en 1.062 DPN-gerelateerde genen leverde 77 gedeelde kandidaatgenen op (Figuur 2E). Een gesparseerde weergave van het blue-module hub-netwerk en de hoogst gerangschikte hub-statistieken worden getoond in Aanvullende Figuur 2A,B.
Featureselectie via meerdere methoden prioriteert zes genen, maar vertoont overfitting in de discovery-cohort
De 77 overlappende genen werden geanalyseerd met LASSO, random forest en SVM-RFE. LASSO behield zeven genen bij de geselecteerde penalty: MMP1, MMP13, TRPV2, CCL7, AURKA, MKI67 en CHEK1 (Figuur 3A). Random-forest filtering behield 41 genen met een belangstelling op of boven het gemiddelde, waaronder vijf leden van het uiteindelijke panel tussen de hoogst gerangschikte kenmerken (Figuur 3B). SVM-RFE produceerde een AUC van 1,00 voor elke geëvalueerde geneste subset; volgens de regel van de minimale grootte bij gelijke scores werd CHEK1 geselecteerd als de subset van één gen (Figuur 3C), wat zorgen opriep over overfitting en een optimistische beoordeling in de discovery-cohort. De overeenkomstige expressie, heatmap en ROC-weergaven van de discovery-cohort worden getoond in Aanvullende Figuur 3A–C.
Geen enkel gen werd door alle drie de methoden geselecteerd. Het behouden van genen die door ten minste twee methoden werden ondersteund, leverde CCL7, CHEK1, MKI67, MMP1, MMP13 en TRPV2 op (Figuur 3D). GO-annotatie van deze zes genen benadrukte functies gerelateerd aan de afbraak van de extracellulaire matrix, collageen catabole en metabole processen, gecondenseerde chromosomen en metallo-endopeptidasen (allemaal BH-gecorrigeerd p < 0,05; Figuur 3E). KEGG-analyse identificeerde interleukine-17 (IL-17)-signalering (CCL7/MMP1/MMP13; gecorrigeerd p = 1,81 × 10⁻⁴) en relaxine-signalering (MMP1/MMP13; gecorrigeerd p = 0,0175; Figuur 3F). Deze verrijkingsresultaten werden gebruikt om de biologische functies te karakteriseren die door het panel van zes genen worden vertegenwoordigd.
Beoordeling over verschillende datasets laat heterogene ondersteuning zien voor MMP1
In de samengevoegde GSE68183/GSE80178 matrix (9 DFU en 6 controles) verschilden CCL7, MMP1 en MMP13 tussen de groepen na BH-correctie over de zes genen (gecorrigeerde p = 0,0168, 0,0159 en 0,0431, respectievelijk; Figuur 4A). CHEK1, MKI67 en TRPV2 bereikten de gecorrigeerde significantiedrempel niet (gecorrigeerde p = 0,259, 0,680 en 0,259). ROC-analyse van individuele genen leverde AUC's op van 0,944 voor CCL7 (95% BI, 0,825–1,000), 0,704 voor CHEK1 (0,403–1,000), 0,574 voor MKI67 (0,243–0,905), 0,981 voor MMP1 (0,930–1,000), 0,870 voor MMP13 (0,686–1,000) en 0,722 voor TRPV2 (0,447–0,997; Figuur 4B). Deze ROC-waarden werden als verkennend beschouwd omdat de voorafgaande procedure voor samenvoeging en batch-correctie niet volledig was gedocumenteerd.
In GSE134431 (13 DFU- en 8 niet-geulcereerde DFS-monsters) was de expressie van MMP1 hoger in DFU dan in DFS op basis van de Wilcoxon-toets bij het nominale significantieniveau (p = 0,0225), hoewel deze associatie niet significant bleef na BH-correctie (gecorrigeerde p = 0,135; Figuur 4C). De andere vijf genen vertoonden geen significante verschillen tussen de groepen. MMP1 vertoonde tevens de hoogste beschrijvende AUC, met een AUC van 0,808 (95% BI, 0,589–1,000), terwijl de AUC's van de andere kandidaten varieerden van 0,529 tot 0,635 (Figuur 4D). Over het algemeen vertoonde MMP1 het meest consistente beschrijvende patroon van de zes kandidaten, maar de statistische replicatie was onvolledig.
Single-cell analyse lokaliseert MMP1 voornamelijk in fibroblasten
De single-cell dataset bevatte 69.944 cellen uit 24 monsters (14 DFU en 10 controles) en bestond uit 10 geannoteerde celtypen (Figuur 5A). UMAP-featurevisualisatie lokaliseerde de expressie van MMP1 in beperkte cellulaire regio's in plaats van een uniforme expressie over de atlas te tonen (Figuur 5B). In totaal hadden 3.799 cellen (5,43%) een genormaliseerde MMP1-expressie groter dan nul. Fibroblasten hadden de hoogste gemiddelde genormaliseerde expressie (0,181) en de grootste totale MMP1-positieve fractie (7,88%; Figuur 5C).
Op monsterniveau was de gemiddelde MMP1-expressie in DFU-monsters hoger dan in controlemonsters in keratinocyten, fibroblasten en endotheelcellen. Na BH-correctie over alle geteste celtypen had elk van deze vergelijkingen een aangepaste p van 0,0214 (keratinocyten: 9 controle- en 14 DFU-monsters; fibroblasten: 10 en 14; endotheelcellen: 10 en 14; Figuur 5D). De MMP1-positieve fractie steeg van 5,86% naar 9,29% in fibroblasten, van 0,026% naar 6,68% in keratinocyten en van 0,29% naar 2,67% in endotheelcellen (Figuur 5E).
De correlaties van de module-scores per cel waren bescheiden. De grootste positieve correlatie werd waargenomen voor de module-score van senescentie/senescence-associated secretory phenotype (SASP) (Spearman rho = 0.274), gevolgd door remodellering van de extracellulaire matrix (rho = 0.240), ferroptose (rho = 0.197) en fibroblastactivatie (rho = 0.170; Figuur 5F). Een vergelijking tussen MMP1-hoge en MMP1-lage fibroblasten toonde een verrijking voor termen met betrekking tot organisatie van de extracellulaire matrix, organisatie van extracellulaire structuren, organisatie van collageenfibrillen, glycoproteïneverwerking en eiwitvouwing (Figuur 5G). Deze beschrijvende bevindingen koppelden de MMP1-hoge fibroblasttoestand aan processen gerelateerd aan matrix-remodellering. Aanvullende UMAP op groepniveau, samenvattingen van monsters van alle celtypen en context van de functionele score worden gegeven in Aanvullende Figuur 4A–C. Associaties op individueel celniveau werden niet beschouwd als donor-onafhankelijk bewijs.
Netwerkdekking geeft prioriteit aan MMP1-gerelateerde ingrediënten en kandidaatkruiden
De gefilterde tabel met relaties tussen kruiden, ingrediënten en targets bevatte 561 unieke records die 99 kruiden, 14 ingrediënten en vijf van de zes kandidaat-targets met elkaar verbonden. MMP1 was het meest voorkomende target met 156 records, gevolgd door CHEK1 (120), MMP13 (102), MKI67 (100) en TRPV2 (83; Figuur 6A). Onder de ingrediënten hadden quercetine en luteoline de breedste kruidendekking en waren zij respectievelijk gekoppeld aan 83 en 62 kruiden. Berberine was gekoppeld aan 10 kruiden; deze drie ingrediënten werden gebruikt als kerningrediënten in de prioriteringsregel (Figuur 6B).
De dekkingsscore classificeerde Guanhuangbo, Mahuang en Niuxi gezamenlijk als hoogste (score = 38 elk; Figuur 6C). Elk van deze kruiden besloeg alle vijf de beschikbare targets en bevatte twee MMP1-gerelateerde bestanddelen. De bestanddeel-targetmatrix toonde aan dat quercetine de breedste dekking over het targetpanel bood, terwijl luteoline en berberine aanvullende MMP1-gecentreerde connectiviteit leverden (Figuur 6D). Een gefocust netwerk verbond de leidende kruiden met representatieve bestanddelen en de vijf beschikbare targets (Figuur 6E). Deze resultaten identificeerden kruid-bestanddeel-targetcombinaties met een hoge databasedekking voor verdere evaluatie. Ondersteunende kruid-target- en kernbestanddeel-dekkingsmatrices worden getoond in Supplementary Figure 5A,B.
Voorlopige gepaarde weefselassays tonen een hogere abundantie van MMP1 mRNA en proteïne aan
Western blot-analyse toonde een hogere MMP1-abundantie aan in DFU-monsters dan in de bijbehorende niet-geulcereerde periwound-monsters (Figure 7A,B). De drie gematchte paren hadden een gemiddeld verschil tussen DFU en periwound in de MMP1/cofiline-ratio van 0,3553 (95% BI, 0,1959–0,5147; tweezijdige gepaarde t-toets, t(2) = 9,592, p = 0,0107). De gepaarde metingen van elke patiënt worden weergegeven in Figure 7B. Na het middelen van vijf technische wells per gen per monster, toonde qPCR een hogere genormaliseerde MMP1 mRNA-abundantie aan in elk van de vier DFU-monsters dan in het bijbehorende periwound-monster (Figure 7C). Het gemiddelde intra-patiënt verschil in ΔCq tussen DFU en periwound was −2,6035 (95% BI, −2,8024 tot −2,4046; tweezijdige gepaarde t-toets, t(3) = −41,663, p = 3,04 × 10⁻⁵), wat overeenkomt met een geometrisch gemiddelde toename van 6,08-voud (95% BI, 5,30–6,98). Deze observaties bij een kleine steekproef zijn preliminair en stellen geen functioneel effect vast.
Over de discovery- en externe bulk-datasets heen vertoonde MMP1 het meest consistente beschrijvende patroon van de zes geprioriteerde genen, hoewel de statistische replicatie onvolledig was. Single-cell samenvattingen toonden de hoogste gemiddelde expressie in fibroblasten, en gepaarde WB-metingen van drie patiënten en gepaarde qPCR-metingen van vier patiënten toonden een hogere MMP1-overvloed. Deze waarnemingen ondersteunen MMP1 als een DFU-geassocieerde kandidaat voor verder onderzoek. De algemene workflow van computationele naar weefselbeoordeling is samengevat in Aanvullende Figuur 6.
DATAbeschikbaarheid:
De openbare transcriptomische datasets zijn beschikbaar via de NCBI Gene Expression Omnibus onder de accessienummers GSE199939, GSE68183, GSE80178, GSE134431 en GSE165816. Beschikbare scripts voor analyse en figuurgeneratie, verwerkte expressie- en resultaatentabellen, kwantitatieve brontabellen voor figuren, statistische outputtabellen, het originele qPCR-werkboek en instrumentproject, en de bijgeleverde onbijgesneden western blot-afbeeldingen zijn opgenomen in Supplementary File 1. Het archief bevat daarnaast geëxtraheerde celmetadata en de commandohistorie van het herstelde single-cell object, verificatierapporten van het matrixtype en een bestandsmanifest. Supplementary File 1 behoudt historische bronbestanden en bevat een R2_Updates-map met de herziene brontabellen voor gepaarde assays, statistische outputs, code voor figuurgeneratie en een gecorrigeerde parameterinventaris. De volledig geanalyseerde Seurat RDS wordt geïdentificeerd in de archiefdocumentatie, maar is niet ingebed in dit aanvullende ZIP-bestand. De volledige historie van de bulk-merging, de originele instellingen voor single-cell filtering en annotatie, en de details van de originele blot-achtergrondsubtractie en lane-to-quantification zijn niet volledig beschikbaar; deze beperkingen worden beschreven in het protocol en de discussie. De lokaal herstelde RDS is niet gedeponeerd in een openbare repository.
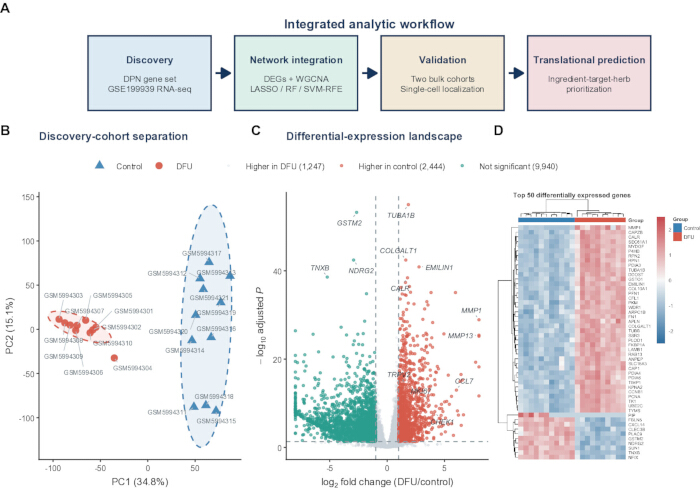
Figuur 1: Discovery transcriptomics identificeert een expressieprogramma geassocieerd met DFU. (A) Overzicht van de computationele workflow, bestaande uit de constructie van de DPN-genenset en de GSE199939-discoveryanalyse, integratie van netwerk en machine learning, bulk- en single-cell-beoordeling, en TCM-ingrediënt-target-kruidvoorspelling. (B) Principale componentenanalyse van variantie-gestabiliseerde GSE199939-expressieprofielen van 10 DFU- en 11 controlemonsters. Ellipsen geven de 90% groepsgebieden aan; percentages duiden de variantie aan die door elke component wordt verklaard. (C) Volcano plot van de DESeq2-resultaten voor differentieel tot expressie gekomen genen voor DFU versus controle. Rode en blauwgroene punten duiden respectievelijk op genen die upgereguleerd zijn in DFU en controle, gebruikmakend van |log2 fold change| > 1 en BH-gecorrigeerde p < 0,05; grijze punten voldeden niet aan beide drempelwaarden. (D) Rijgewijze z-score heatmap van de 50 genen met de kleinste gecorrigeerde p-waarden. Kolommen zijn biologische monsters en de annotatiebalk geeft de groep aan. DEGs, differentieel tot expressie gekomen genen; DFU, diabetische voetulcus; DPN, diabetische perifere neuropathie; VST, variantie-stabiliserende transformatie. De uiteindelijke experimentele beoordeling wordt beschreven in het protocol en Figuur 7. qPCR, kwantitatieve polymerasekettingreactie; TCM, traditionele Chinese geneeskunde; RF, random forest; LASSO, least absolute shrinkage and selection operator; SVM-RFE, support vector machine recursive feature elimination. Klik hier om een grotere versie van deze figuur te bekijken.
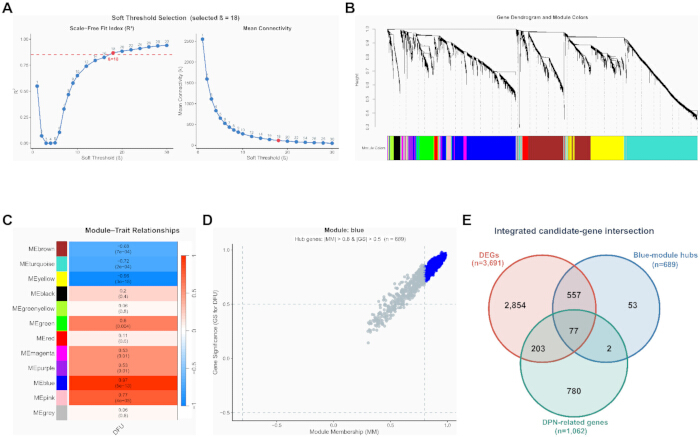
Figuur 2: WGCNA en voorafgaande kennis over DPN convergeren naar 77 kandidaatgenen. (A) Beoordeling van de signed-network soft-threshold voor de 5.000 meest variabele VST-getransformeerde genen. De geselecteerde macht was beta = 18; de stippellijn markeert de doelwaarde voor de scale-free topology fit van 0,85. (B) Average-linkage gendendrogram met dynamische modulekleurtoewijzingen. (C) Pearson-correlaties tussen module-eigengenen en het binaire DFU-kenmerk. Elke cel toont de correlatiecoëfficiënt en de overeenkomstige tweezijdige p-waarde; kleur geeft de richting en grootte aan. (D) Gensignificantie voor DFU versus modulelidmaatschap in de blauwe module. Blauwe punten voldoen aan |modulelidmaatschap| > 0,8 en |gensignificantie| > 0,5; n = 689 hub-genen. (E) Drie-set intersectie van 3.691 DEG's, 689 blauwe-module hub-genen en 1.062 DPN-gerelateerde genen, wat resulteert in 77 gedeelde kandidaten. DFU, diabetisch voetulcus; DPN, diabetische perifere neuropathie; GS, gensignificantie; MM, modulelidmaatschap; WGCNA, weighted gene co-expression network analysis. De ontdekkingscohort bevatte 21 monsters (10 DFU en 11 controles). De annotatie in Figuur 2D gebruikt |MM| > 0,8 en |GS| > 0,5, wat overeenkomt met het absolute-waardecriterium dat is geverifieerd in de oorspronkelijke selectiecode. Klik hier om een grotere versie van deze figuur te bekijken.
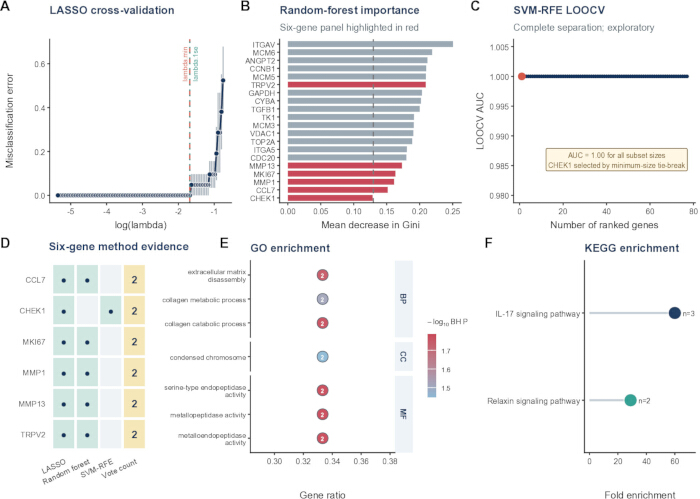
Figuur 3: Prioritering van kenmerken via meerdere methoden levert een panel van zes genen op. (A) Vijfvoudige cross-validatiecurve voor binomiale LASSO-regressie. Verticale stippellijnen geven lambda.min en lambda.1se aan; de geselecteerde niet-nul kenmerken werden bepaald bij lambda.1se, tenzij die penalty geen enkel kenmerk opleverde. (B) Gemiddelde afname in Gini via random-forest voor de 20 hoogst gerangschikte genen uit een model met 1.000 bomen. Rode balken identificeren de leden van het uiteindelijke panel van zes genen; de stippellijn markeert de gemiddelde belangrijkheid die als retentiedrempel werd gebruikt over de volledige set kandidaten. (C) Lineaire SVM-RFE LOOCV AUC over geneste subsets van kenmerken. Alle subsetgroottes produceerden een AUC = 1,00; CHEK1 werd geselecteerd volgens de regel van de kleinste subset bij een gelijkspel, wat wijst op overfitting in de discovery-cohort. (D) Ondersteuningsmatrix van methoden voor CCL7, CHEK1, MKI67, MMP1, MMP13 en TRPV2. Punten geven selectie aan door LASSO, random forest of SVM-RFE; de laatste kolom geeft het aantal ondersteunende methoden weer. (E) Geselecteerde Gene Ontology-termen die verrijkt zijn onder de zes genen. De positie van het punt toont de genratio, de labels van de punten tonen het aantal toegewezen genen, de kleur toont -log10 BH-gecorrigeerde p, en de zijstrip geeft de ontologie aan. (F) KEGG-pathways die verrijkt zijn onder de toegewezen genen. De positie van het punt toont de fold enrichment, de labels van de puntgrootte tonen het aantal toegewezen genen, en de kleur maakt onderscheid tussen pathways. Verrijking vereiste een nominale p < 0,05 en een BH-gecorrigeerde p < 0,05. AUC, area under the receiver operating characteristic curve; BH, Benjamini-Hochberg; BP, biologisch proces; CC, cellulaire component; KEGG, Kyoto Encyclopedia of Genes and Genomes; LOOCV, leave-one-out cross-validation; MF, moleculaire functie; SVM-RFE, support-vector-machine recursive feature elimination. LASSO, least absolute shrinkage and selection operator. Panelen A–D maken gebruik van de 21 discovery-monsters (10 DFU en 11 controles). In paneel A geven de foutenbalken de standaardfout van de cross-validatiefout aan. Klik hier om een grotere versie van deze figuur te bekijken.
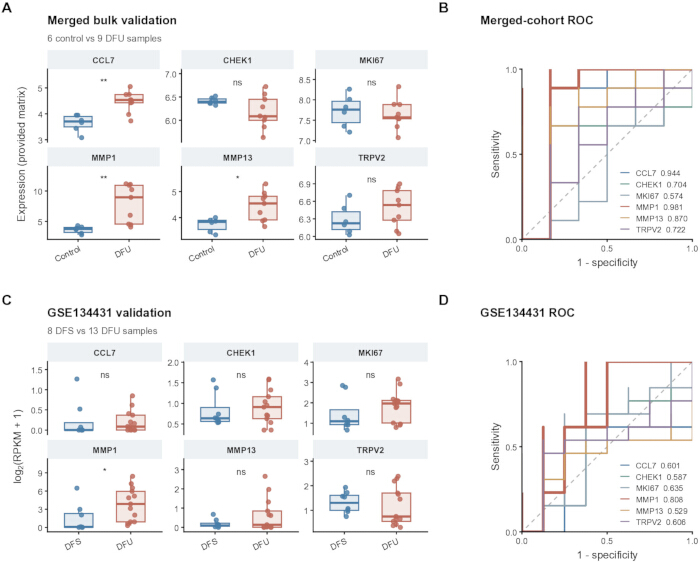
Figuur 4: Cross-dataset bulk-transcriptomische beoordeling van het zes-genenpaneel. (A) Expressie van de zes genen in de samengevoegde GSE68183/GSE80178 matrix (6 controles en 9 DFU-monsters). (B) Bijbehorende ROC-curves voor individuele genen met AUC-waarden; 95% betrouwbaarheidsintervallen zijn opgenomen in de brondata-tabel. Omdat de eerdere samenvoeging en batchcorrectie niet volledig waren gedocumenteerd, werden deze resultaten als verkennend geïnterpreteerd. (C) log2(RPKM + 1) expressie in GSE134431 (8 niet-geulcereerde DFS en 13 DFU-monsters). (D) Bijbehorende ROC-curves voor individuele genen en AUC-waarden. In (A) en (C) tonen de boxen de mediaan en het interkwartielbereik, de whiskers reiken tot 1,5 keer het interkwartielbereik, en de punten representeren biologische monsters. Asterisken geven nominale significantie aan uit tweezijdige Wilcoxon rank-sum tests (*p < 0,05, **p < 0,01); BH-gecorrigeerde p-waarden over de zes genen worden vermeld in de tekst en de brondata-tabel. De ROC-richting werd automatisch geselecteerd door pROC. AUC, area under the receiver operating characteristic curve; DFS, niet-geulcereerde diabetische voetknie; DFU, diabetisch voetulcus; RPKM, reads per kilobase per million mapped reads; ROC, receiver operating characteristic. Klik hier om een grotere versie van deze figuur te bekijken.
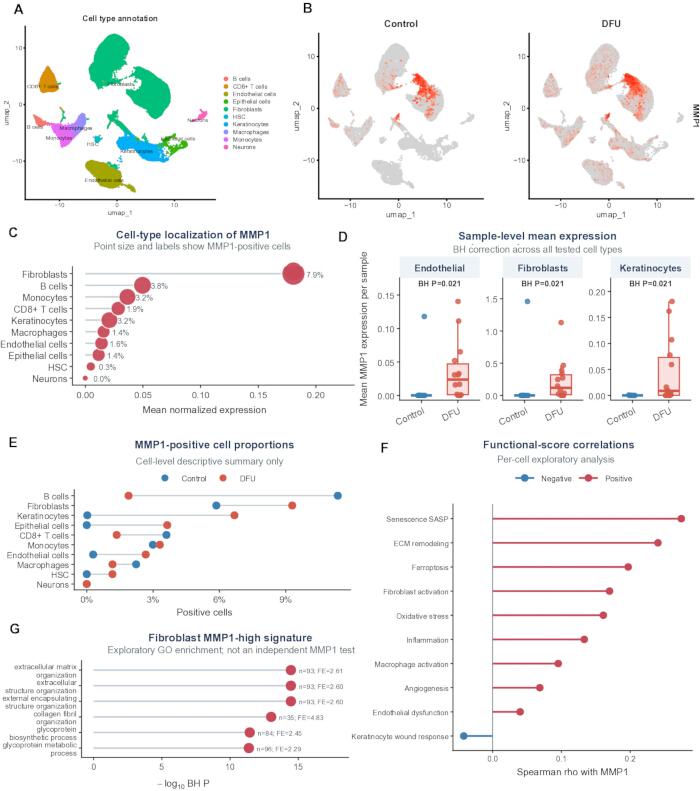
Figuur 5: Single-cell lokalisatie linkt MMP1 aan fibroblast- en matrix-remodeleringssignalen. (A) UMAP van 69.944 cellen uit 24 monsters (10 controles en 14 DFU-monsters), gekleurd op basis van de 10 SingleR-afgeleide celtype-annotaties. (B) UMAP feature plots die de genormaliseerde MMP1-expressie in controle- en DFU-cellen tonen. (C) Samenvatting per celtype van de gemiddelde genormaliseerde MMP1-expressie; puntgrootte en labels geven de totale MMP1-positieve fractie aan, gedefinieerd als genormaliseerde expressie > 0. (D) Gemiddelde MMP1-expressie op monsterniveau in endotheelcellen, fibroblasten en keratinocyten. De boxplots tonen de mediaan en het interkwartielbereik; de punten zijn biologische monsters. Tweezijdige Wilcoxon rank-sum tests werden gevolgd door BH-correctie over alle geteste celtypen. De beschikbare monsteraantallen waren 10 controles en 14 DFU voor endotheelcellen en fibroblasten, en 9 controles en 14 DFU voor keratinocyten. (E) MMP1-positieve cel-fracties per groep en celtype. (F) Per-cel Spearman-correlaties tussen MMP1-expressie en functionele modulescores. (G) GO biological-process enrichment onder genen die upregulated zijn in MMP1-high versus MMP1-low fibroblasten. BH, Benjamini-Hochberg; DFU, diabetisch voetulcera; ECM, extracellulaire matrix; GO, Gene Ontology; HSC, hematopoëtische stamcellen; UMAP, uniform manifold approximation and projection. Per-cel correlaties en expressie-geconditioneerde enrichment in panelen F en G zijn explorerende beschrijvingen, zonder donor-bewuste confirmatieve inferentie. Onafhankelijkheid op monsterniveau vereist verificatie van donor-identificatoren. Klik hier om een grotere versie van deze figuur te bekijken.
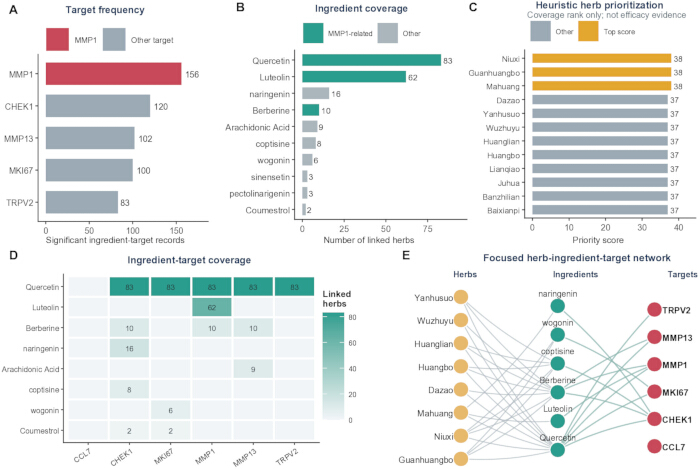
Figuur 6: Op dekking gebaseerde TCM-voorspelling van ingrediënt-target-kruid gecentreerd rond MMP1. (A) Aantal gefilterde databasegegevens van kruid-ingrediënt-target voor elk beschikbaar kandidaat-target. (B) Aantal gekoppelde kruiden voor de meest voorkomende ingrediënten; groenblauw duidt ingrediënten aan die gekoppeld zijn aan MMP1. (C) Belangrijkste kruiden gerangschikt op basis van de dekkingsscore; gouden balken markeren de drie hoogste gedeelde scores. (D) Ingrediënt-target matrix voor representatieve ingrediënten met een hoge dekking. Celwaarden tonen het aantal gekoppelde kruiden; lege cellen geven aan dat er geen record is in de gefilterde relatietabel. (E) Gericht netwerk dat representatieve hooggerangschikte kruiden, ingrediënten en kandidaat-targets verbindt. Node-kleur duidt het entiteitstype aan; grijze kruid-ingrediënt randen duiden op bevatting en groenblauwe ingrediënt-target randen duiden op databaselinks. De gefilterde relatietabel bevatte 561 unieke records, 99 kruiden, 14 ingrediënten en vijf targets met kwalificerende links; CCL7 wordt weergegeven als een geïsoleerde zesde kandidaat-node. TCM, traditionele Chinese geneeskunde. Klik hier om een grotere versie van deze figuur te bekijken.
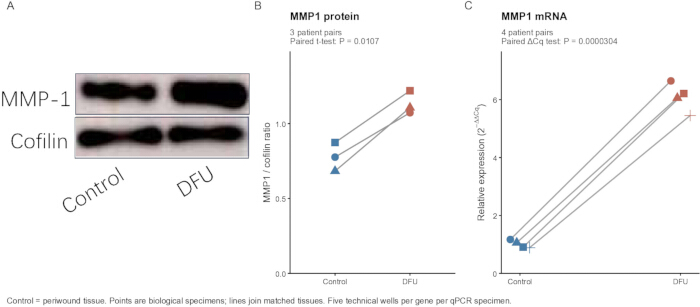
Figuur 7: Voorlopige qPCR- en western blot-beoordeling van MMP1-expressie in DFU in patiëntweefsel. (A) Voorheen verstrekte representatieve western blot die de MMP1-eiwitovervloed in niet-geulcereerd periwound-weefsel en DFU-weefsel laat zien, met cofiline als loading control. (B) MMP1-to-cofiline ratio's hersteld uit het oorspronkelijke plotproject. Symbolen geven individuele biologische metingen van drie patiëntenparen weer; lijnen verbinden overeenkomstige periwound- en DFU-monsters. De tweezijdige gepaarde t-test gaf t(2) = 9.592 en p = 0.0107. (C) Relatieve MMP1 mRNA-overvloed in vier door de auteurs bevestigde overeenkomstige patiëntenparen: NC–DFU, NC1–DFU1, NC2–DFU2 en NC3–DFU3. Vijf technische ACTB-wells en vijf technische MMP1-wells werden afzonderlijk gemiddeld binnen elk monster vóór de ΔCq-berekening. De relatieve expressie werd berekend via de 2−ΔΔCq-methode, waarbij de gemiddelde periwound ΔCq als gemeenschappelijke calibrator werd gebruikt. Elk symbool vertegenwoordigt één biologisch monster; lijnen verbinden overeenkomstige weefsels. De tweezijdige gepaarde t-test gebruikte ΔCq-waarden op monsterniveau (t(3) = −41.663; p = 3.04 × 10⁻⁵), niet de fold changes van technische wells. Er zijn geen significantiesterren gebruikt. Technische wells zijn geen biologische replica's. Control duidt niet-geulcereerd periwound-weefsel aan. Cq, quantification cycle. De p-waarden van de weefselassay zijn nominaal en exploratief. Klik hier om een grotere versie van deze figuur te bekijken.
| Gen | RefSeq-toegangsnummer | Forward primer 5' naar 3' | Reverse primer 5' naar 3' |
| MMP1 | NM_002421 | ATGAAGCAGCCCAGATGTGGAG | TGGTCCACATCTGCTCTTGGCA |
| ACTB | NM_001101.5 | CACCATTGGCAATGAGCGGTTC | AGGTCTTTGCGGATGTCCACGT |
Tabel 1: Primersequenties voor kwantitatieve PCR-validatie van MMP1. Forward en reverse oligonucleotidesequenties (5′–3′) en NCBI RefSeq transcript-toegangsnummers zijn gegeven voor menselijk MMP1 (NM_002421) en ACTB (NM_001101.5). ACTB (β-actine) werd gebruikt als referentiegen voor de relatieve MMP1-expressie.
Aanvullende Figuur 1: Samenvattingen van de WGCNA-kwaliteitscontrole. (A) Hiërarchische clustering met gemiddelde koppeling (average-linkage) van GSE199939-monsters op basis van de 5.000 meest variabele variantie-gestabiliseerde genen. Monsterlabels zijn per groep gekleurd; de gestreepte horizontale lijn is de gids voor de dendrogramhoogte op het 95e percentiel, gebruikt voor de visuele beoordeling van uitschieters. (B) Aantal genen toegewezen aan elke WGCNA-module. Blauwgroene balken duiden de acht niet-grijze modules aan die voldoen aan het DFU-associatiecriterium; grijze balken duiden andere modules aan. DFU, diabetische voetulcus; VST, variantie-stabiliserende transformatie; WGCNA, gewogen gen-co-expressienetwerkanalyse. Klik hier om dit bestand te downloaden.
Aanvullende Figuur 2: Ondersteuning voor co-expressie van de blauwe module. (A) Vereenvoudigd co-expressienetwerk van de 25 hoogst gerangschikte hubgenen van de blauwe module. Onder de paarsgewijze correlaties met |r| > 0,70 bevat het weergegeven netwerk de unie van de twee sterkste verbindingen per gen. De grootte van de knoop geeft de graad binnen dit weergegeven, gesparseerde netwerk aan, en de opvulling van de knoop geeft de gensignificantie voor DFU aan. (B) Gensignificantie en lidmaatschap van de blauwe module voor de 15 hoogst gerangschikte hubs. De subset van randen is geselecteerd voor de leesbaarheid en vertegenwoordigt niet alle kwalificerende correlaties. DFU, diabetische voetulcus; GS, gensignificantie; MM, modulelidmaatschap. Klik hier om dit bestand te downloaden.
Aanvullende Figuur 3: Machine-learning-weergaven van de interne ontdekkingscohort. (A) Geschaalde expressie van CCL7, CHEK1, MKI67, MMP1, MMP13 en TRPV2 in de GSE199939 ontdekkingscohort. De boxen tonen de mediaan en het interkwartielbereik, en de punten representeren biologische monsters. (B) Heatmap van de row-z-score op monsterniveau van dezelfde zes genen. Korte monsterlabels zijn gekoppeld aan GEO-identificatoren in de brongegevenssleutel. (C) ROC-curve van het gefitte multigene model van de ontdekkingscohort. Een AUC van 1,00 werd verkregen door het model te fitten en te beoordelen op dezelfde 21 monsters, wat duidt op overfitting in de ontdekkingscohort. AUC, oppervlak onder de receiver operating characteristic-curve; ROC, receiver operating characteristic. De ontdekkingscohort bestond uit 21 monsters (10 DFU en 11 controles). Klik hier om dit bestand te downloaden.
Aanvullende Figuur 4: Context van expressie op single-cell niveau. (A) UMAP van 69.944 cellen, gekleurd op basis van de controle- en DFU-groep. (B) Gemiddelde expressie van MMP1 op biologisch monsterniveau over alle 10 celtype-annotaties; de punten representeren monsters, en de x-as maakt gebruik van een worteltransformatie voor de weergave. (C) Heatmap van functionele modulescores, samengevat over cellen binnen elk geannoteerd celtype en gestandaardiseerd binnen elke module. DFU, diabetische voetulcera; UMAP, uniform manifold approximation and projection. Klik hier om dit bestand te downloaden.
Aanvullende Figuur 5: Ondersteunende TCM-dekkingmatrices. (A) Aantallen database-records van kruiden-targets voor de 18 hoogst gerangschikte kruiden met MMP1-gerelateerde dekking en de vijf kandidaat-targets weergegeven in de gefilterde relatietabel. (B) Aantallen database-records die dezelfde kruiden koppelen aan de kernbestanddelen quercetine, luteoline en berberine. Celwaarden duiden unieke database-records na deduplicatie. TCM, traditionele Chinese geneeskunde. Klik hier om dit bestand te downloaden.
Aanvullende figuur 6: Workflow voor computationele en weefselbeoordeling. Het schema vat de discovery-input, DEG/WGCNA-intersectie, exploratieve kenmerkselectie, externe bulkbeoordeling, single-cell context, TCM-extensie en matched weefsel-expressiebeoordeling samen. Voor qPCR werden vier gematchte patiëntenparen gebruikt en voor western blotting werden drie gematchte patiëntenparen gebruikt. Aantallen kandidaten en gerapporteerde computationele resultaten zijn behouden uit de oorspronkelijke analyse. TPM-input in de op tellingen gebaseerde discovery-workflow, incomplete oorspronkelijke single-cell preprocessingsgegevens en kleine weefsel-assaycohorten blijven beperkingen. Het schema impliceert niet dat de discovery-analyses opnieuw zijn gevalideerd. Klik hier om dit bestand te downloaden.
Aanvullende Tabel 1: Inventaris van analysesoftware, database, parameters en beperkingen. Dit werkboek documenteert 26 analysestappen, met daarin de analysestap, het hulpmiddel of de database, de gerapporteerde versie, de input, de belangrijkste parameters, de output en ontbrekende informatie of beperkingen. Het omvat discovery transcriptomics, WGCNA, gen-screening en kenmerkselectie, verrijking, externe bulk- en single-cell-analyses, TCM-netwerkanalyse en tissue-assay-rapportage. De tabel legt de beschikbare methodologische informatie vast en stelt op zichzelf geen onafhankelijke reproduceerbaarheid vast. Klik hier om dit bestand te downloaden.
Aanvullend bestand 1: Archief met gegevens, analysecode, bronnen voor figuren en bronnen voor assays. Dit archief bevat beschikbare scripts voor analyse en het genereren van figuren, verwerkte expressie- en resultaatentabellen, kwantitatieve figuren en statistische brondata, het originele qPCR-werkboek en instrumentproject, bijgevoegde onbijgesneden western blot-afbeeldingen, geëxtraheerde single-cell metadata en opdrachtgeschiedenis, verificatierapporten van het matrixtype en een bestandsmanifest. Historische bestanden zijn bewaard gebleven; de map R2_Updates bevat de gecorrigeerde analyse van de gepaarde assay, bijgewerkte bronnen voor figuren en een herziene parameterinventaris. Klik hier om dit bestand te downloaden.
Discussie
Deze integratieve workflow prioriteerde MMP1 op basis van bulk-transcriptomics, WGCNA, DPN-gerelateerde gen-screening en exploratieve kenmerkselectie, waarna de cellulaire context en weefselexpressie werden onderzocht. Zes genen werden ondersteund door ten minste twee selectiemethoden, waarbij MMP1 de grootste verandering in expressie vertoonde in de discovery-cohort. Extern bewijs was heterogeen: MMP1 bleef significant in de samengevoegde GSE68183/GSE80178-matrix, terwijl de associatie in GSE134431 nominaal was (p = 0,0225) en de BH-correctie niet overleefde (gecorrigeerde p = 0,135). De AUC van 0,808 in GSE134431 is beschrijvend, vooral omdat de ROC-richting werd bepaald binnen de beoordelingsdataset. Bijgevolg beschrijft "meest consistent" het waargenomen patroon onder de zes kandidaten en impliceert dit geen volledige statistische replicatie of een gevalideerde diagnostische biomarker.
Het kandidaatpanel werd geannoteerd voor collageenomzetting, ECM-disassemblage, metallo-endopeptidase-activiteit en IL-17- en relaxine-signalering. Deze annotaties zijn compatibel met de biologie van chronische wonden, maar omvatten slechts enkele genen. Eerdere studies bij mensen rapporteerden veranderde MMP- en inhibitorprofielen in diabetische wonden6, terwijl een prospectieve DFU-studie een hogere ratio van MMP1 ten opzichte van weefselinhibitor van metalloproteïnasen 1 (TIMP1) associeerde met genezing7. Verhoogde MMP1-expressie hoeft dus niet noodzakelijkerwijs op een uniform schadelijk effect te duiden; de relevantie ervan kan afhangen van het stadium van herstel, de beschikbaarheid van het substraat en de balans van inhibitoren. Experimentele observaties met betrekking tot MMP13, CCL7 en IL-17 bieden aanvullende context11,12,13,14, maar er kan niet van worden uitgegaan dat hun functies equivalent zijn bij menselijke DFU.
Samenvattingen op single-cell niveau lokaliseerden de hoogste gemiddelde MMP1-expressie in fibroblasten, met een hogere expressie op monsterniveau in DFU-fibroblasten, keratinocyten en endotheelcellen. Dit patroon komt overeen met rapporten over een gewijzigde ECM-organisatie in uit DFU afgeleide fibroblasten4, heterogene fibroblasttoestanden in single-cell- en ruimtelijke studies8, en macrofaag-geassocieerde genezingsprogramma's van fibroblasten15. Echter, monsteridentificatoren vereisen verificatie op donorniveau, en module-scorecorrelaties op celniveau en expressie-geconditioneerde verrijking blijven descriptief omdat afhankelijkheid binnen de donor niet is gemodelleerd. Bijdragen van epitheliale en endotheliale populaties pleiten evenzo tegen een uitsluitend fibroblast-autonoom mechanisme. Ruimtelijke transcriptomics, RNA in situ hybridisatie of immunokleuring zouden complementaire lokalisatie bieden16.
De methodologische waarde ligt in het combineren van differentiële expressie, co-expressie, bestaande genkennis, cel-resolute samenvattingen en onafhankelijke assay-modaliteiten om kandidaten te prioriteren. Deze ligt niet in de voorspellende nauwkeurigheid van de discovery-cohort. Cohort-brede screening ging vooraf aan cross-validatie op algoritmeniveau, en de uniforme SVM-RFE AUC van 1,00 roept zorgen op over leakage, overfitting en een optimistische beoordeling. Het panel dient daarom te worden beschouwd als een resultaat van feature-prioritisering. Voor een voorspellende evaluatie zou volledig geneste preprocessing, selectie en tuning, gevolgd door een afgeschermde onafhankelijke test, noodzakelijk zijn9,10. De discovery-input is geverifieerd als TPM, ondanks het gebruik in een count-based model; de resulterende discovery-statistieken en downstream-selectie blijven daarom ongeverifieerd in afwachting van een passende re-analyse. De samengevoegde bulkmatrix mist de volledige geschiedenis van de preprocessing. Het herstelde Seurat-object bevat instellingen voor normalisatie, selectie van variabele features, PCA, neighbor, clustering en UMAP, hoewel de oorspronkelijke filtering, de volledige Harmony-aanroep en de annotatiereferentie onvolledig gedocumenteerd blijven. Geharmoniseerde herverwerking vanuit brondata, een gedocumenteerde beoordeling van batch-effecten en donor-bewuste pseudobulk- of mixed-model-analyses zijn alternatieve benaderingen voor verdere evaluatie.
Assays op patiëntweefsel leveren preliminaire orthogonale bewijzen voor een hogere MMP1-abundantie. Als comparator werd niet-geulcereerd periwondweefsel van dezelfde patiënten gebruikt, waardoor het contrast lokale verschillen weerspiegelt die geassocieerd zijn met het ulcus binnen diabetisch weefsel, in plaats van een vergelijking met gezonde huid. Herwonnen WB-metingen van drie gematchte patiëntenparen en qPCR-metingen van vier door de auteurs bevestigde gematchte paren werden geanalyseerd met gepaarde toetsen, waarbij individuele biologische waarnemingen zijn weergegeven. Voor qPCR werden technische wells binnen elk monster gemiddeld en werd voor de inferentie ΔCq gebruikt; technische wells hebben de biologische steekproefomvang niet vergroot. De consistente richting van de gepaarde waarnemingen ondersteunt een preliminaire vergelijking van de expressie, maar de kleine cohorten kunnen geen generaliseerbaarheid vaststellen of distributie-aannames betrouwbaar beoordelen. De abundantie in bulkweefsel stelt de cellulaire eiwitlokalisatie, enzymatische activiteit of een causaal effect op de genezing niet vast. Grotere, klinisch gekarakteriseerde cohorten zijn noodzakelijk. Andere beperkingen omvatten onvolledige klinische covariabelen, verschillende comparatorweefsels, een onvolledig gedocumenteerde, uit de literatuur afgeleide DPN-genenset en onvolledige verslagen van de oorspronkelijke achtergrondcorrectie van de blots. Gezond weefsel, studie-gedefinieerd controleweefsel en niet-geulcereerde diabetische voet-huid mogen niet als uitwisselbaar worden beschouwd.
Het TCM-netwerk is een extensie voor het genereren van hypothesen. De aangepaste wegingen vatten de databasedekking samen in plaats van de doelwitinteractie of werkzaamheid, en rangschikkingen kunnen veranderen afhankelijk van de database-inhoud en de gekozen wegingen. Quercetine en berberine vertonen daarnaast een variabele of beperkte systemische blootstelling17,18. Kandidaat-ingrediënten en kruiden vereisen daarom direct onderzoek naar het doelwit, dosis-responscurves, farmacokinetiek, toxiciteit en functionele tests. Toekomstig werk zou goed gedocumenteerde onafhankelijke cohorten moeten combineren met ruimtelijke lokalisatie en MMP1-perturbatie in primaire fibroblasten of multicellular wondmodellen. De huidige bevindingen ondersteunen MMP1 als een DFU-geassocieerde kandidaat in een op fibroblasten gerichte context van matrix-remodellering, zonder causaliteit of klinisch nut vast te stellen.
Openbaarmakingen
De auteurs verklaren dat er geen belangenverstrengeling is.
Dankbetuigingen
Dit onderzoek werd ondersteund door het Wuhan Municipal Medical Scientific Research Project (Guidance Project, Grant No. WX23Z77), beheerd door de Wuhan Municipal Health Commission.
De auteurs danken de deelnemers die weefselmonsters hebben verstrekt voor deze studie en de onderzoekers die de publiek toegankelijke datasets hebben gegenereerd en gedeponeerd in de NCBI Gene Expression Omnibus.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| 8-tube strips van 0,2 mL dunwandige transparante PCR-buisjes | Axygen / Corning | PCR-0208-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Tubes/p/PCR-0208-C |
| 1,000-μL steriele filterpipetpunten | Axygen / Corning | TF-1000-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/SEA/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-1000-R-S |
| 1,5-ml steriele microcentrifugebuisjes, DNase/RNase-vrij | Solarbio Life Sciences | YA0430 | Productnaam: Bovine Serum Albumin (BSA) Productnummer: BS0229 Productomschrijving: BSA is een globulair eiwit dat wordt geproduceerd in het serum van runderen. Het is een veelgebruikt reagens in biologische en biochemische experimenten. Het wordt veel gebruikt als blokkeringsmiddel in assays zoals ELISA en Western blotting om aspecifieke binding van antilichamen te voorkomen. Daarnaast dient het als stabilisator voor eiwitten en enzymen en als substraat voor diverse enzymatische reacties. Producteigenschappen: - Bron: Runderserum - Zuiverheid: ≥ 98% (via SDS-PAGE) - Toepassing: Blokkeringsmiddel, eiwitstabilisator, biochemisch onderzoek Opslagcondities: Bewaar bij 2-8 °C. Toepassingen: - Blokkeren van niet-specifieke binding in ELISA en Western blot. - Stabilisatie van enzymen en andere eiwitten. - Gebruik als standaard voor eiwitkwantificatie. - Toevoeging aan celkweekmedia voor osmotische balans en voedingsstoffen. |
| 10-μL steriele filterpipetpunten | Axygen / Corning | TF-300-L-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Aerosol-Barrier-Tips/p/TF-300-L-R-S |
| 2× SYBR Green PCR Mastermix | Solarbio Life Sciences | SR1110 | Productnaam: Protein A-Agarose Catalogusnummer: PSB0001 Grootte: 5 g Productbeschrijving: Protein A-Agarose is een hoogwaardig affinity-chromatografiemiddel dat wordt gebruikt voor de zuivering van immunoglobulinen (IgG) uit biologische monsters. Protein A is een oppervlakteproteïne van *Staphylococcus aureus* dat een hoge affiniteit heeft voor het Fc-gedeelte van IgG van diverse zoogdieren. Kenmerken: - Hoge bindingscapaciteit: Geoptimaliseerd voor een maximale opbrengst van IgG. - Hoge zuiverheid: Effectieve scheiding van IgG van andere eiwitten in serum, plasma of celculturen. - Stabiel en herbruikbaar: De agarosematrix is robuust en kan na regeneratie meerdere keren worden gebruikt. - Breed toepasbaar: Geschikt voor diverse zuiveringsmethoden, waaronder kolomchromatografie en batch-binding. Toepassingen: - Zuivering van IgG uit serum of plasma. - Isolatie van monoklonale antilichamen uit hybroomculturen. - Verwijdering van IgG voor downstream analyses. Opslagcondities: Bewaar bij 2-8 °C. Niet invriezen. Instructies voor gebruik: 1. Voorbereiding: Evenmeng de suspensie voor gebruik. 2. Binding: Voeg het monster toe aan de Protein A-Agarose en laat dit incuberen onder passende condities (bijv. rotatie bij 4 °C). 3. Wassen: Was de hars herhaaldelijk met een geschikte buffer om niet-gebonden eiwitten te verwijderen. 4. Elutie: Elueer de gebonden IgG met een buffer met een lage pH (bijv. glycine-HCl, pH 2,5-3,0). 5. Regeneratie: De hars kan worden geregenereerd door te wassen met een reeks buffers om resterende eiwitten te verwijderen en de pH te neutraliseren. |
| 20× Tris-gebufferde zoutoplossing | Solarbio Life Sciences | T1080 | Productnaam: Total Protein Assay Kit (BCA-methode) Katalogusnummer: JS-013 Productbeschrijving: De Total Protein Assay Kit (BCA-methode) is ontworpen voor de kwantificering van totale eiwitconcentraties in diverse monsters. De assay is gebaseerd op de Bicinchoninezuur (BCA)-methode, waarbij eiwitten in een alkalische omgeving reageren met $\text{Cu}^{2+}$-ionen om $\text{Cu}^+$-ionen te vormen via de Biuret-reactie. De $\text{Cu}^+$-ionen vormen vervolgens een stabiel, paars complex met BCA, waarvan de absorptie bij 562 nm wordt gemeten. De intensiteit van de kleur is direct proportioneel aan de hoeveelheid eiwit in het monster. Kenmerken: - Hoge gevoeligheid en nauwkeurigheid. - Minimale interferentie van veel veelgebruikte buffercomponenten. - Stabiele resultaten met een breed lineair bereik. - Eenvoudige en snelle procedure. Toepassingen: - Bepaling van de eiwitconcentratie in cellysaten, weefselhomogenaten en serum. - Normalisatie van eiwitconcentraties voor downstream-analyses zoals Western blotting en ELISA. Componenten van de kit: - Eiwitstandaard (BSA) - BCA-reagens A - BCA-reagens B - Werkingsinstructies Opslagcondities: Bewaar de kit bij 4 °C. Toepassingsbereik: Lineair bereik: 20-2000 µg/ml (afhankelijk van de gebruikte methode). |
| 200-μL steriele filterpipetpunten | Axygen / Corning | TF-200-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-200-R-S |
| ACTB qPCR-primerpaar | Solarbio Life Sciences (maatwerk oligonucleotide-synthese) | Aangepast | RefSeq NM_001101.5; V: CACCATTGGCAATGAGCGGTTC; R: AGGTCTTTGCGGATGTCCACGT; URL: https://www.solarbio.com/ |
| Amersham Imager 600 | GE Healthcare Bio-Sciences AB, Uppsala, Zweden | Amersham Imager 600 | Model opgenomen in alle 22 meegeleverde TIFF-bestanden; bedieningssoftware Ver.1.2.0; URL: https://cdn.cytivalifesciences.com/api/public/content/digi-17089-original |
| Bicinchoninezuur-eiwitassaykit | Solarbio Life Sciences | PC0020 | Productnaam: Cytochalasin D Catalogusnummer: C1010 Grootte: 1 mg Beschrijving: Cytochalasin D is een schimmelmetaboliet die actinestructuren verstoort door de polymerisatie van actine te remmen. Het bindt specifiek aan het plus-uiteinde van actinefilamenten, waardoor de toevoeging van nieuwe actine-monomeren wordt voorkomen. Dit resulteert in de disruptie van het actinecytoskelet, wat leidt tot inhibitie van celmigratie, fagocytose en cytokinese. In de celbiologie wordt Cytochalasin D veelvuldig gebruikt voor het bestuderen van de rol van actine bij celbeweging en celdeling, en voor het induceren van multinucleatie in cellen. Kenmerken: - Hoge zuiverheid - Effectieve inhibitie van actinepolymerisatie - Geschikt voor diverse celtypen en weefsels Opslag: Bewaar bij -20 °C. Houd het product droog en beschermd tegen licht. Toepassingen: - Onderzoek naar het actinecytoskelet - Studie van celmigratie en adhesie - Inhibitie van cytokinese - Analyse van fagocytische processen |
| clusterProfiler | Bioconductor | https://bioconductor.org/packages/clusterProfiler/ | Versie 4.16.0 |
| Polyklonaal cofiline-antilichaam (konijn anti-cofiline) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, China) | 10960-1-AP | WB-verdunning gebruikt in deze studie: 1:6.000; URL: https://www.ptgcn.com/; RRID:AB_2291830 |
| Comparative Toxicogenomics Database | CTD | https://ctdbase.org/ | Bron voor ingrediënt-doelwitinteracties |
| DESeq2 | Bioconductor | https://bioconductor.org/packages/DESeq2/ | Versie 1.48.2 |
| DNase/RNase-vrij water | Solarbio Life Sciences | R1600 | Productnaam: Human IL-6 (Interleukine-6) ELISA Kit Catalogusnummer: RBC024 Overzicht De Human IL-6 ELISA Kit is speciaal ontwikkeld voor de kwantitatieve bepaling van IL-6 in menselijk serum, plasma, vloeistof uit hersenvocht en celcultuur-supernatanten. Interleukine-6 (IL-6) is een pleiotroop cytokine dat een cruciale rol speelt bij de regulatie van immuunresponsen, ontsteking en hematopoëse. Het wordt geproduceerd door een breed scala aan cellen, waaronder macrofagen, T-cellen, B-cellen en endotheelcellen. Principe Deze kit maakt gebruik van de sandwich-ELISA-methode. De assay is gebaseerd op de binding van IL-6 aan een specifieke capture-antilichaam dat is geïmmobiliseerd op de microtiterplaat. Na toevoeging van het monster bindt het IL-6 aan het capture-antilichaam. Vervolgens wordt een detectie-antilichaam toegevoegd, dat is geconjugeerd aan horseradish peroxidase (HRP), waardoor een sandwich-complex wordt gevormd. De kleurintensiteit, die wordt bepaald door de toevoeging van een substraat, is direct proportioneel aan de concentratie IL-6 in het monster. Productspecificaties Doelwit: Human IL-6 Detectiemethode: Sandwich ELISA Monstertype: Serum, plasma, vloeistof uit hersenvocht, celcultuur-supernatant Detectiebereik: 15,625 pg/ml - 1000 pg/ml Minimale hoeveelheid monster: 50 µl Gevoeligheid: 7,8 pg/ml Precisie: Intra-assay CV < 10%, Inter-assay CV < 15% Componenten van de kit - Coat coating buffer - Capture-antilichaam - Standaard (lyofiliseerde IL-6) - Detectie-antilichaam-HRP conjugaat - Wash buffer - TMB substraat - Stopoplossing - Microtiterplaat (gecoat met capture-antilichaam) Opslagcondities Bewaar de kit bij 2-8°C. Vermijd herhaaldelijke vries-dooi-cycli. |
| Het is essentieel om de juiste concentratie aan reagentia te gebruiken om de reproduceerbaarheid van de resultaten te waarborgen. De procedure begint met het voorbereiden van de buffers, gevolgd door de isolatie van de doelproteïnen uit het cellysaat. Nadat de monsters zijn gezuiverd, worden ze onderworpen aan een kwantitatieve analyse om de efficiëntie van de extractie te bepalen. De resultaten worden vervolgens statistisch geanalyseerd om significante verschillen tussen de controle- en experimentele groepen vast te stellen. | CRAN / e1071 auteurs | https://cran.r-project.org/package=e1071 | Versie 1.7-17 |
| ECL Plus chemiluminescent substraat | Solarbio Life Sciences | PE0010 | **Productnaam: Protein A/G Magnetic Beads** **Productnummer: PE0010** **Productbeschrijving** Protein A/G Magnetic Beads zijn verkrijgen door de recombinante fusie van Protein A uit *Staphylococcus aureus* en Protein G uit *Streptococcus* soorten op superparamagnetische korrels. De gecombineerde Protein A/G-fusie vertoont een verhoogde bindingscapaciteit en een bredere specificiteit voor IgG van verschillende zoogdiersoorten in vergelijking met Protein A of Protein G afzonderlijk. Deze magnetische korrels zijn ideaal voor de zuivering van IgG uit complexe mengsels, zoals cellysaten of serum, en voor immunoprecipitatie-assays. Dankzij de superparamagnetische eigenschappen kunnen de korrels snel en efficiënt worden gescheiden van de oplossing met behulp van een extern magnetisch veld, waardoor centrifugatie en filtratie overbodig worden. **Producteigenschappen** - Hoge affiniteit en specificiteit voor IgG van diverse soorten. - Snelle scheiding door middel van magnetisme. - Lage aspecifieke binding. - Compatibel met diverse buffersystemen. **Opslag en Stabiliteit** Bewaar bij 4 °C. Niet invriezen. De houdbaarheidsdatum is zoals vermeld op het etiket. **Gebruiksaanwijzing** **1. Voorbereiding** Breng de flacon vóór gebruik kortstondig naar kamertemperatuur. Resuspendeer de korrels door de flacon voorzichtig te schudden of te vortexen. **2. Immunoprecipitatie (IP) Protocol** 1. Meng de gewenste hoeveelheid Protein A/G Magnetic Beads met het monster (bijv. cellysaat of serum) in een geschikte buffer. 2. Voeg, indien nodig, specifieke antilichamen toe aan het monster en laat deze incuberen om de doelproteïnen te binden. 3. Incubeer het mengsel gedurende 2 tot 12 uur bij 4 °C onder constante agitatie (bijv. op een rotatorschudder). 4. Plaats de buis in een magnetische standaard en wacht tot de vloeistof helder is. 5. Verwijder de supernatans voorzichtig met een pipet. 6. Was de korrels 3 tot 5 keer met een passende wasbuffer door de korrels te resuspenderen en opnieuw magnetisch te scheiden. 7. Elueer de gebonden proteïnen met een elutiebuffer (bijv. een lage pH-buffer of een specifieke peptide-elutiebuffer). 8. Verzamel de eluaat voor verdere analyse (bijv. SDS-PAGE of Western Blot). **3. IgG-zuivering Protocol** 1. Voeg Protein A/G Magnetic Beads toe aan de oplossing die IgG bevat. 2. Incubeer het mengsel gedurende 1 tot 2 uur bij kamertemperatuur of 4 °C onder agitatie. 3. Scheid de korrels met een magnetische standaard en verwijder de supernatans. 4. Was de korrels herhaaldelijk met een wasbuffer om ongebonden proteïnen te verwijderen. 5. Elueer het gebonden IgG met een elutiebuffer. **Opmerkingen** - De optimale hoeveelheid korrels hangt af van de concentratie van de doelproteïnen en de gewenste efficiëntie van de zuivering. - Gebruik buffers zonder azidNatrium (NaN3) als de biologische activiteit van het gezuiverde eiwit behouden moet blijven. |
| Gene Expression Omnibus: GSE134431 | National Center for Biotechnology Information | GSE134431 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE134431 |
| Gene Expression Omnibus: GSE165816 | National Center for Biotechnology Information | GSE165816 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE165816 |
| Gene Expression Omnibus: GSE199939 | National Center for Biotechnology Information | GSE199939 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE199939 |
| Gene Expression Omnibus: GSE68183 | National Center for Biotechnology Information | GSE68183 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE68183 |
| Gene Expression Omnibus: GSE80178 | National Center for Biotechnology Information | GSE80178 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE80178 |
| Gene Ontology | Gene Ontology Consortium | https://geneontology.org/ | Houdt u rekening met het feit dat u geen brontekst heeft verstrekt om te vertalen. Voer de Engelse tekst in die u naar het Nederlands vertaald wilt hebben, en ik zal deze volgens uw specifieke richtlijnen voor wetenschappelijke en educatieve content verwerken. |
| ggplot2 | ggplot2-ontwikkelaars | https://ggplot2.tidyverse.org/ | Versie 4.0.3 |
| glmnet | CRAN / glmnet-auteurs | https://cran.r-project.org/package=glmnet | Versie 5.0 |
| Referentietabel voor kruidingrediënten | Bron niet vermeld in het manuscript | Niet gerapporteerd | Niet gedocumenteerd: exacte database-/bestandsnaam, versie/datum en openbare toegangs-URL |
| HRP-geconjugeerde geiten anti-konijn IgG (H+L) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, China) | SA00001-2 | WB-verdunning gebruikt in deze studie: 1:5.000; URL: https://www.ptgcn.com/products/HRP-conjugated-Goat-Anti-Rabbit-IgG-H-L-SA00001-2.htm; RRID:AB_2722564 |
| Tissue-monsters van diabetische voetulcera bij mensen | Vierde Ziekenhuis van Wuhan, Wuhan, China | N/A | Op de patiënt afgestemde DFU-monsters; qPCR n=4 monsters; WB n=3 monsters; goedgekeurd protocol KY2024-161-01 |
| Menselijke monsters van niet-geulcereerd periwondweefsel | Wuhan Fourth Hospital, Wuhan, China | N/A | Op de patiënt afgestemde periwound-comparator; qPCR n=4 monsters; WB n=3 monsters; goedgekeurd protocol KY2024-161-01 |
| ImageJ | National Institutes of Health | https://imagej.net/ij/ | Versie niet gedocumenteerd |
| Kyoto Encyclopedia of Genes and Genomes | KEGG | https://www.genome.jp/kegg/ | Code voor het menselijk organisme hsa |
| Op basis van literatuur gecureerde DPN-genenlijst | Uit literatuur afgeleid component; brontabel op genniveau niet volledig gedocumenteerd | Niet gerapporteerd | Herkomst op genniveau niet volledig gedocumenteerd |
| Microvolume UV-vis spectrophotometer | Fabrikant/model niet vermeld in het manuscript | Niet gerapporteerd | Niet gedocumenteerd: exacte fabrikant, model en product-URL; gemelde toepassing: bepaling van RNA-concentratie en A260/A280-ratio |
| MMP1 polyklonaal antilichaam (konijn anti-MMP1) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, China) | 10371-2-AP | WB-verdunning gebruikt in deze studie: 1:1.000; URL: https://www.ptgcn.com/Products/MMP1-Antibody-10371-2-AP.htm; RRID:AB_2297741 |
| MMP1 qPCR-primerpaar | Solarbio Life Sciences (maatwerk oligonucleotide synthese) | Aangepast | RefSeq NM_002421; F: ATGAAGCAGCCCAGATGTGGAG; R: TGGTCCACATCTGCTCTTGGCA; URL: https://www.solarbio.com/ |
| NCBI Gene | National Center for Biotechnology Information | https://www.ncbi.nlm.nih.gov/gene/ | Menselijke gendatabase |
| Mager melkpoeder, blokkeringsreagens | Solarbio Life Sciences | D8340 | URL: https://www.solarbio.com/goodsInfo?id=1488 |
| org.Hs.eg.db | Bioconductor | https://bioconductor.org/packages/org.Hs.eg.db/ | Versie 3.21.0 |
| Prefabricage SDS-PAGE-gel, 4%–20% gradiënt | Solarbio Life Sciences | PG42010-S | Productnaam: Glucose-oxidase (GOx) Productnummer: GP-10 Beschrijving: Glucose-oxidase (GOx) is een enzym dat glucose katalyseert tot gluconolacton en waterstofperoxide. Het wordt veelvuldig gebruikt in biosensoren voor de detectie van glucose, in de voedingsindustrie en in klinische diagnostiek. Kenmerken: - Hoge specificiteit voor β-D-glucose. - Stabiel bij diverse pH-waarden en temperaturen. - Breed toepasbaar in enzymatische assays en biochemisch onderzoek. Specificaties: - Bron: Aspergillus niger - Activiteit: ≥ 100 U/mg - Zuiverheid: ≥ 98% (via SDS-PAGE) - Toestand: Lyofilisatiepoeder - Opslag: -20 °C Toepassing: Glucose-oxidase wordt gebruikt voor de kwantitatieve bepaling van glucose in serum, urine en andere biologische monsters. Het vormt de basis voor glucosemeters en wordt ingezet in de productie van glucose-vrije media. Opslag en stabiliteit: Bewaar het product bij -20 °C. Na het openen moet het product luchtdicht worden afgesloten om degradatie te voorkomen. |
| pROC | Auteurs van CRAN / pROC | https://cran.r-project.org/package=pROC | Versie 1.19.0.1 |
| Proteaseremmercocktail, 100× | Solarbio Life Sciences | P6730 | URL: https://www.solarbio.com/goodsInfo?id=25748 |
| Proteïne-transfersysteem | Fabrikant/model niet vermeld in het manuscript | Niet gerapporteerd | Niet gedocumenteerd: exacte fabrikant, model en product-URL; gerapporteerd gebruik: Overdracht naar 0,22-μm PVDF-membraan |
| PVDF-membraan, 0.22 μm | Solarbio Life Sciences | YA1690 | Productnaam: Total Protein Assay Kit (BCA-methode) Categorie: Proteine-analyse Productoverzicht: De Total Protein Assay Kit (BCA-methode) is ontworpen voor de kwantitatieve bepaling van de totale eiwitconcentratie in biologische monsters. De kit maakt gebruik van de BCA-methode (bicinchoninezuur), die gebaseerd is op twee onafhankelijke reacties. Eerst reageren eiwitten met $\text{Cu}^{2+}$-ionen in een alkalische omgeving, waarbij $\text{Cu}^{2+}$ wordt gereduceerd tot $\text{Cu}^+$. Vervolgens vormt $\text{Cu}^+$ een stabiel, paarsgekleurd complex met bicinchoninezuur. De intensiteit van de kleur is direct proportioneel met de hoeveelheid eiwit in het monster en kan worden gemeten bij een absorptie van 562 nm. Kenmerken: - Hoge gevoeligheid en nauwkeurigheid. - Breed lineair bereik. - Minimale interferentie van veel veelgebruikte reagentia. - Snel en eenvoudig protocol. - Stabiele resultaten met een hoge reproduceerbaarheid. Toepassingen: - Bepaling van de eiwitconcentratie in cellysaten, weefselextracten en serum. - Normalisatie van eiwitconcentraties voor downstream-applicaties zoals Western blotting en ELISA. - Kwaliteitscontrole van gezuiverde eiwitten. Kitinhoud: - BCA-werkoplossing - BSA-standaard (Bovien Serum Albumine) - Gebruiksaanwijzing Opslagcondities: Bewaar bij 4 °C. Instructies voor gebruik: 1. Bereid een reeks BSA-standaarden voor binnen het gewenste concentratiebereik. 2. Voeg de BCA-werkoplossing toe aan de standaarden en de monsters in de voorgeschreven verhouding. 3. Incubeer de plaat of de buisjes bij 37 °C gedurende 30 minuten (of bij kamertemperatuur voor een langere incubatietijd). 4. Meet de absorbentie bij 562 nm met een microplaatlezer of spectrofotometer. 5. Stel een standaardcurve op op basis van de BSA-standaarden en bereken de eiwitconcentratie van de monsters. |
| R | R Foundation for Statistical Computing | https://www.r-project.org/ | Versie 4.5.2 |
| randomForest | CRAN / randomForest auteurs | https://cran.r-project.org/package=randomForest | Versie 4.7-1.2 |
| Real-time PCR-apparaat | Roche Diagnostics | LightCycler 96 | softwareversie niet bevestigd. Projectvolume/cycli wijken af van het gerapporteerde protocol; de exacte koppeling met het experiment moet nog worden gecontroleerd. |
| Gekoelde microcentrifuge | Fabrikant/model niet vermeld in het manuscript | Niet gerapporteerd | Niet gedocumenteerd: exacte fabrikant, model en product-URL; gerapporteerd gebruik: 12.000 × g gedurende 15 min bij 4 °C |
| ga naar binnen | CRAN / auteurs invoeren | https://cran.r-project.org/package=rentrez | Versie 1.2.4 |
| RIPA-lysebuffer, hoge sterkte | Solarbio Life Sciences | R0010 | Productnaam: Protein A/G Magnetic Beads (Proteïne A/G magnetische kralen) Productnummer: SB001163 Productbeschrijving: Proteïne A/G magnetische kralen zijn geconjugeerd met een recombinant proteïne dat zowel de bindingseigenschappen van proteïne A als proteïne G combineert. Dit zorgt voor een hoge affiniteit voor een breed scala aan IgG-subklassen van verschillende zoogdieren, waaronder mens, muis, rat, geit en konijn. Deze magnetische kralen zijn ideaal voor de zuivering van antilichamen, immunoprecipitatie (IP) en co-immunoprecipitatie (Co-IP), waardoor een snelle en efficiënte isolatie van doeleiwitten uit complexe biologische monsters mogelijk is. Kenmerken: - Hoge affiniteit en specificiteit voor diverse IgG-subklassen. - Snelle scheiding door gebruik van een extern magnetisch veld. - Lage aspecifieke binding. - Geschikt voor een breed scala aan buffercondities. Toepassingen: - Zuivering van antilichamen. - Immunoprecipitatie (IP). - Co-immunoprecipitatie (Co-IP). - Isolatie van immuuncomplexen. Opslagcondities: Bewaar bij 4 °C. Niet invriezen. Specificaties: - Bindingseigenschappen: Gecombineerde proteïne A/G. - Matrix: Magnetische kralen. - Toepasbaarheid: Diverse zoogdier-IgG's. |
| SDS-PAGE-elektroforesesysteem | Fabrikant/model niet vermeld in het manuscript | Niet gerapporteerd | Niet gedocumenteerd: exacte fabrikant, model en product-URL; gerapporteerd gebruik: eiwitscheiding op 4%–gradiëntgels van 20% |
| Seurat | Satija Lab / Seurat-ontwikkelaars | https://satijalab.org/seurat/ | Versie 5.5.0 |
| SingleR | Bioconductor | https://bioconductor.org/packages/SingleR/ | Versie 2.10.0 |
| Weefselhomogenisator | Fabrikant/model niet vermeld in het manuscript | Niet gerapporteerd | Niet gedocumenteerd: exacte fabrikant, model en product-URL; gerapporteerd gebruik: weefselhomogenisatie in ijskoude lysisbuffer |
| TriQuick Reagent total RNA-extractiereagens | Solarbio Life Sciences | R1100 | Productnaam: Total Protein Assay Kit (BCA-methode) Overzicht De Total Protein Assay Kit (BCA-methode) is ontworpen voor de kwantitatieve bepaling van de totale eiwitconcentratie in diverse biologische monsters. Deze kit maakt gebruik van de Bicine-Carbonylaminozuur (BCA) methode, waarbij de reductie van $\text{Cu}^{2+}$ naar $\text{Cu}^{+}$ door eiwitten in een alkalische omgeving wordt gevolgd, waarna $\text{Cu}^{+}$ een complex vormt met BCA, wat resulteert in een paarse kleur die spectrophotometrisch kan worden gemeten. Kenmerken - Hoge gevoeligheid en nauwkeurigheid - Breed lineair bereik - Lage kruisreactiviteit met veel veelvoorkomende interferenten - Eenvoudig protocol met een snelle doorlooptijd - Stabiele reagentia voor reproduceerbare resultaten Toepassingen - Kwantificatie van eiwitten in cellysaten, weefselhomogenaten en serum - Bepaling van eiwitconcentraties in gezuiverde eiwitmonsters - Normalisatie van eiwitgehaltes voor downstream applicaties zoals Western blotting en ELISA Componenten - BCA-reagens A - BCA-reagens B - BSA-standaard (Bovine Serum Albumin) - Gebruiksaanwijzing Opslagcondities Bewaar de kit bij $2\text{--}8\text{ °C}$ voor optimale stabiliteit en houdbaarheid. Protocol (Kort overzicht) 1. Bereid een reeks standaarden met bekende concentraties BSA. 2. Meng reagens A en reagens B in de voorgeschreven verhouding om het werkreagens te vormen. 3. Voeg het werkreagens toe aan de monsters en standaarden. 4. Incubeer de plaat bij de aangegeven temperatuur en tijd. 5. Meet de absorptie bij $562\text{ nm}$ met een microplaatlezer. 6. Bereken de eiwitconcentratie van de onbekende monsters op basis van de standaardcurve. |
| Tween-20 | Solarbio Life Sciences | T8220 | URL: https://www.solarbio.com/goodsInfo?id=102 |
| Ultraduidelijke platte dopjes voor PCR-buisjesstrips van 0,2 ml | Axygen / Corning | PCR-2CP-RT-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Caps/p/PCR-2CP-RT-C |
| Universele RT-PCR-kit (M-MLV) | Solarbio Life Sciences | RP1100 | Productnaam: Lipopolysaccharide (LPS) uit Escherichia coli (O111:B4) Productnummer: LPS100 Specificatie: $\geq$ 95% Zuiverheid: $\geq$ 95% (door HPLC bepaald) Toepassing: Gebruikt voor het stimuleren van macrofagen en andere immuuncellen om cytokinen te produceren, en wordt veel toegepast in studies naar ontstekingsreacties en immuunrespons. Eigenschappen: Lipopolysacchariden (LPS), ook bekend als endotoxinen, zijn belangrijke componenten van de buitenmembraan van Gram-negatieve bacteriën. Ze fungeren als krachtige immuunstimulanten en zijn essentieel voor de structurele integriteit van de bacteriecelwand. In biomedisch onderzoek worden ze veelvuldig gebruikt om in vitro en in vivo ontstekingsmodellen te induceren door de activering van Toll-like receptor 4 (TLR4). Opslag: Bewaar bij -20 °C. Toepassingen: 1. Activering van macrofagen: Gebruikt om de productie van pro-inflammatoire cytokinen zoals TNF-$\alpha$, IL-1$\beta$ en IL-6 te induceren. 2. Immuunresponsstudies: Gebruikt om de respons van immuuncellen op bacteriële endotoxinen te bestuderen. 3. Inflammatiemodellen: Gebruikt voor het opzetten van experimentele modellen voor sepsis en andere ontstekingsziekten. Opmerkingen: Houd rekening met de specifieke concentratie en blootstellingstijd bij het gebruik van LPS om de gewenste biologische respons te verkrijgen en cytotoxiciteit te vermijden. |
| WGCNA | CRAN / WGCNA-auteurs | https://cran.r-project.org/package=WGCNA | Versie 1.74 |
| Windows | Microsoft | https://www.microsoft.com/nl-nl/windows/windows-11 | Windows 11 |
Referenties
- Armstrong DG, Tan TW, Boulton AJM, Bus SA. Diabetic foot ulcers: a review. JAMA. 2023;330(1):62–75.
- Bus SA et al. Guidelines on the prevention of foot ulcers in persons with diabetes (IWGDF 2023 update). Diabetes Metab Res Rev. 2024;40(3):e3651.
- Sloan G, Selvarajah D, Tesfaye S. Pathogenesis, diagnosis and clinical management of diabetic sensorimotor peripheral neuropathy. Nat Rev Endocrinol. 2021;17(7):400–20.
- Maione AG et al. Altered ECM deposition by diabetic foot ulcer-derived fibroblasts implicates fibronectin in chronic wound repair. Wound Repair Regen. 2016;24(4):630–43.
- Caley MP, Martins VLC, O'Toole EA. Metalloproteinases and wound healing. Adv Wound Care (New Rochelle). 2015;4(4):225–34.
- Lobmann R et al. Expression of matrix-metalloproteinases and their inhibitors in the wounds of diabetic and non-diabetic patients. Diabetologia. 2002;45(7):1011–6.
- Muller M et al. Matrix metalloproteinases and diabetic foot ulcers: the ratio of MMP-1 to TIMP-1 is a predictor of wound healing. Diabet Med. 2008;25(4):419–26.
- Theocharidis G et al. Single cell transcriptomic landscape of diabetic foot ulcers. Nat Commun. 2022;13(1):181.
- Vabalas A, Gowen E, Poliakoff E, Casson AJ. Machine learning algorithm validation with a limited sample size. PLoS One. 2019;14(11):e0224365.
- Lewis MJ et al. nestedcv: an R package for fast implementation of nested cross-validation with embedded feature selection designed for transcriptomics and high-dimensional data. Bioinform Adv. 2023;3(1):vbad048.
- Hattori N et al. MMP-13 plays a role in keratinocyte migration, angiogenesis, and contraction in mouse skin wound healing. Am J Pathol. 2009;175(2):533–46.
- Pang J, Maienschein-Cline M, Koh TJ. Monocyte/macrophage heterogeneity during skin wound healing in mice. J Immunol. 2022;209(10):1999–2011.
- Finley PJ et al. Diabetic wounds exhibit decreased Ym1 and arginase expression with increased expression of IL-17 and IL-20. Adv Wound Care (New Rochelle). 2016;5(11):486–94.
- Moon JY et al. IL-17A is increased in diabetic wounds and impairs keratinocyte function via histone demethylase JMJD3. Nat Commun. 2026;17(1):780.
- Xiao Y et al. Macrophages regulate healing-associated fibroblasts in diabetic wound. Mol Biol Rep. 2024;51(1):203.
- Theocharidis G et al. Integrated skin transcriptomics and serum multiplex assays reveal novel mechanisms of wound healing in diabetic foot ulcers. Diabetes. 2020;69(10):2157–69.
- Almeida AF et al. Bioavailability of quercetin in humans with a focus on interindividual variation. Compr Rev Food Sci Food Saf. 2018;17(3):714–31.
- Khoshandam A, Imenshahidi M, Hosseinzadeh H. Pharmacokinetic of berberine, the main constituent of Berberis vulgaris L.: a comprehensive review. Phytother Res. 2022;36(11):4063–79.