Wąskim gardłem dla komórkowej mikroskopii elektronowej 3D jest ekstrakcja cech (segmentacja) w bardzo złożonych mapach gęstości 3D. Opracowaliśmy zestaw kryteriów, które zawierają wskazówki dotyczące tego, które podejście do segmentacji (ręczne, półautomatyczne lub zautomatyzowane) najlepiej nadaje się do różnych typów danych, stanowiąc tym samym punkt wyjścia do skutecznej segmentacji.
Artykuł metodologiczny
Od wokseli do wiedzy: praktyczny przewodnik po segmentacji złożonych danych 3D z mikroskopii elektronowej
W tym artykule
Podsumowanie
Streszczenie
Nowoczesne metody mikroskopii elektronowej 3D pozwoliły ostatnio na bezprecedensowy wgląd w ultrastrukturalną organizację komórek i tkanek w 3D, umożliwiając wizualizację dużych maszyn makromolekularnych, takich jak kompleksy adhezyjne, a także struktur wyższego rzędu, takich jak cytoszkielet i organelle komórkowe w ich odpowiednim kontekście komórkowym i tkankowym. Biorąc pod uwagę nieodłączną złożoność objętości komórkowych, konieczne jest najpierw wyodrębnienie interesujących cech, aby umożliwić wizualizację, kwantyfikację, a tym samym zrozumienie ich organizacji 3D. Każdy zbiór danych jest definiowany przez odrębne cechy, np. stosunek sygnału do szumu, ostrość (ostrość) danych, niejednorodność ich cech, zatłoczenie cech, obecność lub brak charakterystycznych kształtów, które pozwalają na łatwą identyfikację, oraz procent całej objętości, jaki zajmuje określony obszar zainteresowania. Wszystkie te cechy należy wziąć pod uwagę przy podejmowaniu decyzji o tym, jakie podejście przyjąć do segmentacji.
Sześć różnych zestawów danych ultrastrukturalnych 3D zostało uzyskanych za pomocą trzech różnych podejść do obrazowania: tomografii elektronowej z osadzoną żywicą, skoncentrowanej wiązki jonów i skaningowej mikroskopii elektronowej z blokiem szeregowym (FIB-SEM, SBF-SEM) odpowiednio dla próbek lekko i mocno zabarwionych. W przypadku tych zbiorów danych zastosowano cztery różne podejścia do segmentacji: (1) w pełni ręczne budowanie modelu, a następnie wyłącznie wizualizacja modelu, (2) ręczna segmentacja danych ze śledzeniem, a następnie renderowanie powierzchni, (3) podejścia półautomatyczne, po których następuje renderowanie powierzchni lub (4) zautomatyzowane, specjalnie zaprojektowane algorytmy segmentacji, po których następuje renderowanie powierzchni i analiza ilościowa. W zależności od kombinacji cech zbioru danych stwierdzono, że zazwyczaj jedno z tych czterech podejść kategorycznych jest lepsze od pozostałych, ale w zależności od dokładnej sekwencji kryteriów, więcej niż jedno podejście może być skuteczne. Na podstawie tych danych proponujemy schemat klasyfikacji, który kategoryzuje zarówno obiektywne cechy zestawu danych, jak i subiektywne kryteria osobiste do analizy różnych zestawów danych.
Wprowadzenie
Tradycyjnie, pole mikroskopii elektronowej (EM) zostało podzielone na 1) gałąź biologii strukturalnej przy użyciu wysokiej i super wysokiej rozdzielczości TEM, zwykle w połączeniu z niejawnym lub jawnym uśrednianiem danych w celu zbadania trójwymiarowej (3D) struktury kompleksów makromolekularnych o określonym składzie i zazwyczaj stosunkowo małym rozmiarze1-4, oraz 2) gałąź obrazowania komórkowego, w której wizualizowane są całe scenerie komórkowe1,5,6. Podczas gdy gałąź biologii strukturalnej przeszła spektakularny rozwój w ciągu ostatnich czterech dekad, gałąź biologii komórki była w większości ograniczona do dwóch wymiarów, często na mniej niż optymalnie zachowanych próbkach. Dopiero wraz z pojawieniem się tomografii elektronowej w ostatniej dekadzie biologiczne obrazowanie ultrastrukturalne komórek rozszerzyło się na trzeci wymiar5,7, gdzie zazwyczaj nie można przeprowadzić uśredniania, ponieważ scenerie komórkowe, a tym samym interesujące cechy, są zazwyczaj unikalne.
Chociaż wizualizacje scen komórkowych są często oszałamiające dla oka, skuteczne wydobycie interesujących cech i późniejsza analiza ilościowa tak bardzo złożonych objętości komórkowych pozostają w tyle, częściowo dlatego, że dokładny skład białka jest zwykle nieznany, co utrudnia interpretację tych komórkowych objętości 3D. Do dnia dzisiejszego rozległa wiedza biologiczna jest często potrzebna do interpretacji złożonych tomogramów, a nawet do identyfikacji ważnych regionów i istotnych komponentów w objętości 3D. Dodatkową komplikacją jest to, że wizualizacja objętości 3D jest niezwykle prosta. Objętości 3D można traktować i w ten sposób wizualizować jako stosy obrazów 2D. Szczegółowa inspekcja sekwencyjnych obrazów 2D krok po wycinku zmniejsza złożoność, ale także ogranicza wyodrębnianie cech, a tym samym analizę ilościową, do dwóch wymiarów. Jednak w przypadku większości obiektów 3D przedstawianie objętości 3D jako zaledwie stosu następujących po sobie płaszczyzn prowadzi do niekompletnej i zniekształconej perspektywy w stosunku do trójwymiarowej natury danego systemu. Alternatywne tryby kontroli wizualnej wymagają renderowania objętościowego lub powierzchniowego, co — biorąc pod uwagę często gęsty charakter woluminu komórkowego — może łatwo prowadzić do zasłoniętego widoku zagnieżdżonych obiektów lub całkowicie przytłoczyć użytkownika, utrudniając w ten sposób interaktywną segmentację ręczną.
Aby zaradzić tym barierom, opracowano wiele różnych metod automatycznego wyodrębniania cech (segmentacji), które zazwyczaj są oparte na gęstości lub nachyleniu8-10. Jednak metody te mają tendencję do segmentacji całej objętości niezależnie od tego, które obszary lub cechy są interesujące dla eksperta, chociaż niektóre najnowsze metody mogą być ukierunkowane na konkretną cechę zainteresowania, taką jak filamenty aktynowe11. Ponadto programy wykonujące automatyczną segmentację mogą czasami prowadzić do wytworzenia dużej liczby podobjętości (np. w przypadku stosowania segmentacji zanurzeniowej w zlewni), które często muszą być ręcznie scalane z powrotem w całość interesującej nas funkcji lub poddawane dalszej segmentacji. Dotyczy to w szczególności złożonych i zatłoczonych zestawów danych, dlatego większość algorytmów komputerowych renderujących nie jest w stanie wyodrębnić z wiernością tylko interesujących ich cech, a często potrzebne są znaczne wysiłki eksperta, aby uzyskać pożądaną objętość podzieloną na segmenty.
Ponadto, niestandardowe rozwiązania bardzo specyficznego problemu są często publikowane jako dokument z zebrania naukowego, z niewielkim lub żadnym naciskiem na udostępnienie ich szerokim i wszechstronnym narzędziom dla badaczy, którzy nie mają dogłębnej wiedzy z dziedzin matematyki, informatyki i/lub grafiki komputerowej. Konfigurowalne środowisko oprogramowania programistycznego, zawierające szereg bibliotek do analizy obrazów, może być potężnym zestawem narzędzi umożliwiającym użytkownikom efektywne pisanie własnych modułów w celu dokładnej segmentacji. Takie podejście wymaga jednak intensywnego szkolenia i wykształcenia informatycznego, aby móc wykorzystać jego wiele funkcji lub możliwości do analizy obrazu. Można pracować w takim wszechstronnym środowisku oprogramowania dla pewnych zestawów danych, w których cechy są rzadsze, np. wykorzystując potężne podejścia oparte na kształtach, które opierają się na unikalnej geometrii "szablonów" w celu oddzielenia interesujących obiektów od ich otoczenia12,13.
Istnieje spora różnorodność pakietów do wizualizacji grafiki komputerowej do interaktywnej ręcznej segmentacji i budowania modeli. Niektóre pakiety są dostępne na rynku, podczas gdy inne są pochodzenia akademickiego i są dystrybuowane bezpłatnie, takie jak: University of California San Francisco Chimera14, University of Colorado IMOD15 i University of Texas Austin VolumeRover16. Jednak szeroki zakres i złożoność funkcji i możliwości posiadanych przez te programy wydłuża krzywą uczenia się dla każdego z nich. Niektóre programy do wizualizacji udostępniają proste modele geometryczne, takie jak kule i patyki o różnych rozmiarach, które można umieścić na mapach gęstości w celu stworzenia uproszczonego modelu złożonej objętości 3D. Modele te umożliwiają następnie proste pomiary geometryczne i objętościowe, a tym samym wykraczają poza "ładny obrazek". Takie ręczne śledzenie obiektów sprawdza się dobrze w przypadku woluminów, w których trzeba prześledzić i wyodrębnić tylko niewielką liczbę obiektów. Jednak niedawny rozwój obrazowania ultrastrukturalnego 3D o dużej objętości przy użyciu skaningowej mikroskopii elektronowej ze skupioną wiązką jonów (FIB-SEM)17-20 lub skaningowej mikroskopii elektronowej z blokiem szeregowym (SBF-SEM)21 stanowi dodatkową komplikację polegającą na tym, że rozmiar zestawów danych 3D może wahać się od gigabajtów do dziesiątek i setek gigabajtów, a nawet terabajtów. W związku z tym tak duże objętości 3D są praktycznie niedostępne dla ręcznej ekstrakcji cech, a zatem wydajna półautomatyczna ekstrakcja cech prowadzona przez użytkownika będzie jednym z wąskich gardeł dla efektywnej analizy objętości 3D w dającej się przewidzieć przyszłości.
Przedstawione tutaj są cztery różne podejścia do segmentacji, które są rutynowo stosowane w szerokim zakresie typów obrazów biologicznych. Metody te są następnie porównywane pod kątem ich skuteczności dla różnych typów zestawów danych, co pozwala na kompilację w przewodniku, który pomoże biologom zdecydować, jakie może być najlepsze podejście do segmentacji w celu efektywnej ekstrakcji cech własnych danych. Ponieważ dla większości opisanych programów dostępne są szczegółowe instrukcje obsługi, celem nie jest zapoznanie potencjalnych użytkowników z którymkolwiek z tych konkretnych pakietów. Zamiast tego celem jest pokazanie odpowiednich mocnych i słabych stron tych różnych strategii segmentacji poprzez zastosowanie ich do sześciu przykładowych zestawów danych o różnych cechach. Dzięki temu porównaniu opracowano zestaw kryteriów, które są albo oparte na obiektywnych cechach obrazu zestawów danych 3D, takich jak kontrast danych, ostrość, zatłoczenie i złożoność, albo wynikają z subiektywnych rozważań, takich jak pożądany cel segmentacji, morfologie cech, które mają być segmentowane, gęstość zaludnienia cech będących przedmiotem zainteresowania, Oznacza to ułamek objętości zajmowanej przez cechę będącą przedmiotem zainteresowania oraz sposób optymalnego postępowania przy ograniczonych zasobach, takich jak czas i dostępność personelu. Te różne przykładowe zestawy danych ilustrują, w jaki sposób te obiektywne i subiektywne kryteria mogą być stosowane sekwencyjnie w różnych kombinacjach, aby uzyskać parowanie niektórych podejść do ekstrakcji cech z określonymi typami zestawów danych. Mamy nadzieję, że podane zalecenia pomogą nowicjuszom stojącym przed dużą różnorodnością opcji segmentacji wybrać najbardziej efektywne podejście do segmentacji dla własnej objętości 3D.
Chociaż głównym tematem tego artykułu jest ekstrakcja cech, zwrócenie uwagi na gromadzenie danych i wstępne przetwarzanie danych jest kluczowe dla efektywnej segmentacji. Często barwienie próbek może być nierówne, a zatem w procedurze segmentacji należy wziąć pod uwagę potencjalne artefakty barwienia. Jednak barwienie zwykle daje wyższy stosunek sygnału do szumu, a zatem wymaga mniej filtrowania i innego matematycznego traktowania objętości komórkowych, co potencjalnie może również powodować artefakty. Odpowiednie zestawy danych obrazu RAW muszą zostać pozyskane z prawidłowymi ustawieniami kontrastu i pikseli kamery, wyrównane i zrekonstruowane w objętość 3D. W przypadku tomogramów wyrównane obrazy są rekonstruowane zwykle przy użyciu ważonej projekcji wstecznej, a następnie zestaw danych jest zwykle poddawany algorytmom odszumiania, takim jak nieliniowa dyfuzja anizotropowa22, filtrowanie dwustronne23 lub rekurencyjne filtrowanie mediany24. Dane obrazowania FIB-SEM i SBF-SEM są wyrównywane poprzez korelację krzyżową kolejnych warstw w XY przy użyciu programów takich jak ImageJ25. Wzmocnienie kontrastu i filtrowanie można zastosować, aby zwiększyć interesujące Cię funkcje, a tym samym usunąć szumy ze stosu obrazów. Filtrowanie można przeprowadzić na całym woluminie przed zaznaczeniem podwoluminu lub na wybranych podwoluminach, ponieważ metody filtrowania mogą być kosztowne obliczeniowo. Próbkowanie w dół danych (binning), które jest czasami używane do redukcji szumów i/lub zmniejszania rozmiaru pliku, jest zalecane tylko wtedy, gdy dane zostały znacznie nadpróbkowane w porównaniu z przewidywaną rozdzielczością.
Po redukcji szumów, przetworzone obrazy mogą być następnie segmentowane różnymi metodami, a w tym badaniu skupiamy się na następujących czterech: (1) ręcznym generowaniu abstrakcyjnego modelu poprzez tworzenie modelu kulkowego i kijowego, (2) ręcznym śledzeniu interesujących cech, (3) automatycznej analizie opartej na progu, oraz (4) niestandardowej automatycznej segmentacji za pomocą skryptu do segmentacji specyficznej dla projektu. Segmentacja granic8 i immersyjna segmentacja działu wodnego10 są lepszymi alternatywami dla prostego progowania, ale należą do tej samej kategorii i nie zostały wyraźnie uwzględnione w tej dyskusji.
Ręczne śledzenie gęstości wymaga nakreślenia interesujących cech, plasterek po plasterku, co pozwala na zachowanie pierwotnej gęstości odpowiednich obszarów subkomórkowych. Takie podejście pozwala na maksymalną kontrolę procesu segmentacji, ale jest procesem żmudnym i pracochłonnym.
Zautomatyzowane metody segmentacji gęstości oparte na progach (i pokrewne) są półautomatyczne, gdzie algorytm wybiera piksele na podstawie zestawu parametrów zdefiniowanych przez użytkownika. Dostępnych jest kilka akademickich (bezpłatnych) pakietów wizualizacji, takich jak UCSF Chimera, IMOD, Fiji26 i VolumeRover, a także pakiety komercyjne (wymagające płatnych licencji), a oba typy zazwyczaj zawierają jedno lub więcej z tych podejść do segmentacji. Pakiety oprogramowania użyte w tej pracy do zilustrowania tych różnych metod obejmują zarówno programy komercyjne, jak i akademickie programy open source do ręcznego generowania abstrakcyjnego modelu, a także ręcznej i automatycznej segmentacji gęstości. Jednak oprogramowanie typu open source może czasami oferować bardziej zaawansowane opcje dzięki możliwości dostosowania.
Porównanie tych technik przy użyciu różnych typów zestawów danych doprowadziło do następującej prezentacji zasad i wskazówek, jak podejść do segmentacji różnych objętości danych biologicznych 3D, które według naszej wiedzy nie zostały jeszcze opublikowane. Jest to zatem pierwsze systematyczne porównanie różnych podejść i ich przydatności w odniesieniu do zbiorów danych o różnej charakterystyce dla użytkowników o różnych celach.
Protokół
1. Ręczne generowanie abstrakcyjnych modeli
Uwaga: Szczegóły metodologii opisanej poniżej są specyficzne dla Chimery, ale zamiast tego mogą być używane inne pakiety oprogramowania. Stosuj to podejście, gdy jedynym celem jest stworzenie modelu geometrycznego (np. modelu kuli i kija) w celu wykonania pomiarów geometrycznych, a nie wyświetlania kształtu objętości obiektów.
- Zaimportuj wolumin danych do odpowiedniego programu w celu ręcznego generowania abstrakcyjnego modelu.
- Wybierz pozycję Plik > Otwórz mapę, aby wyświetlić okno dialogowe Otwórz plik. Przejdź do lokalizacji pliku żądanej mapy.
- Pociągnij w górę przeglądarkę woluminów (Narzędzia > Dane woluminu > Przeglądarka woluminów) i wybierz opcję Funkcje > Styl wyświetlania, aby wyświetlić dane z różnymi stylami renderowania.
- Dostosuj próg wyświetlania, przeciągając pionowy pasek na histogramie w oknie Podgląd głośności.
- Poruszaj się po objętości 3D (np. plasterek po wycinku), aby wybrać obszar zainteresowania do segmentacji i w razie potrzeby wyciąć mniejszą podobjętość.
- W oknie dialogowym Podgląd woluminu kliknij pozycję Oś, a następnie wybierz opcję X, Y lub Z.
- W oknie dialogowym Podgląd woluminu wybierz opcję Elementy > Płaszczyzny. Kliknij opcję Jedna, aby ustawić głębokość, aby wyświetlić płaszczyznę odpowiadającą liczbie w lewym polu, a następnie kliknij opcję Wszystkie, aby wyświetlić wszystkie płaszczyzny.
- W oknie dialogowym Podgląd woluminu wybierz opcje Funkcje > wybór podregionu.
- Kliknij i przeciągnij, aby utworzyć prostokątny blok wokół obszaru zainteresowania.
- Umieść znaczniki wzdłuż interesującej Cię funkcji i połącz je z konsolidatorami tam, gdzie to konieczne (często jest to wykonywane automatycznie przez program), aż model zostanie ukończony.
- Z paska menu Podgląd woluminu wybierz Narzędzia > Okno dialogowe Śledzenie woluminu, aby otworzyć okno dialogowe Śledzenie woluminu. W oknie dialogowym Volume Tracer (Śledzenie woluminu) wybierz opcję File (Plik) > New Marker Set (Nowy zestaw znaczników).
- W oknie dialogowym Śledzenie głośności zaznacz opcję Mysz > Umieść znaczniki o wysokiej jakości, Umieść znaczniki na płaszczyznach danych, Przenieś i zmień rozmiar znaczników, Połącz nowy znacznik z wybranym znacznikiem i Połącz kolejno wybrane znaczniki.
- Kliknij próbkę Kolor znacznika i wybierz kolor. Powtórz ten krok dla koloru łącza.
- Wprowadź promienie dla elementów znacznika i łączenia modelu.
- W oknie śledzenia woluminu wybierz opcję Umieść znaczniki za pomocą [prawego] przycisku myszy i wstaw promienie dla znaczników i łączy.
- Kliknij prawym przyciskiem myszy dane głośności, aby rozpocząć układanie znaczników. Znaczniki zostaną połączone automatycznie.
- W oknie dialogowym Śledzenie woluminu wybierz Plik > Zapisz bieżący zestaw znaczników, a następnie Plik > Zamknij zestaw znaczników.
- Otwórz nowy zestaw znaczników (krok 1.3.1), aby rozpocząć tworzenie modelu w drugą pożądaną cechę, która Cię interesuje. Wykorzystaj kontrastujące kolory między zestawami znaczników, aby podkreślić różnice w cechach.
2. Ręczne śledzenie interesujących cech
Uwaga: Szczegóły metodologii opisanej poniżej są specyficzne dla Amiry, ale zamiast nich mogą być używane inne pakiety oprogramowania. Stosuj to podejście, gdy gęstość zaludnienia jest stosunkowo niewielka i gdy dokładność wyodrębniania cech ma kluczowe znaczenie, ponieważ ręczne śledzenie jest czasochłonnym podejściem.
- Importuj dane woluminu do programu z opcjami ręcznego śledzenia. Oprogramowanie z tą funkcją zazwyczaj oferuje co najmniej podstawowe narzędzie do malowania.
- W przypadku dużych objętości lub tomogramów (np. 16-bitowych tomogram .rec lub .mrc o wymiarach 2,048 x 2,048 lub większych wygenerowanych w IMOD): Wybierz Otwórz dane > kliknij prawym przyciskiem myszy filename.rec > Formatuj... >Wybierz Raw jako LargeDiskData > Ok> załaduj. Wybierz odpowiednie parametry danych pierwotnych z informacji nagłówka > Ok. Przełącz i zapisz jako nowy plik filename.am do użycia w poniższych krokach.
- W przypadku mniejszych plików stosu obrazów 3D (np. 3D .tif lub .mrc lub .rec): Otwórz > Dane Wybierz filename.tif lub nazwę pliku.mrc. Przełącz i kliknij prawym przyciskiem myszy> Zapisz jako filename.am. Jeśli zostanie wygenerowany błąd lub program nie odpowiada, plik może być zbyt duży i można go otworzyć, wykonując krok 2.1.1.
- Poruszaj się po wycinkach, aby wybrać podwolumin 3D do segmentacji, a następnie przytnij do tego obszaru zainteresowania.
- W oknie Przeglądarka 3D wybierz Orthoslice, aby otworzyć plik obrazu. Użyj suwaka na dole, aby poruszać się po plasterkach.
- Aby przyciąć większe dane otwarte jako LargeDiskData, przełącz nazwę pliku w oknie Pula > kliknij prawym przyciskiem myszy > LatticeAccess. Wprowadź żądany rozmiar pola > Zastosuj. Zapisz nowy plik.
- Utwórz plik segmentacji.
- Przełącz plik w oknie Pula > kliknij prawym przyciskiem myszy > Etykietowanie > LabelField. Nowy plik zostanie utworzony i automatycznie załadowany w zakładce Edytor segmentacji.
- Prześledź obramowanie pierwszej interesującej Cię funkcji, a następnie wypełnij ślad ręcznie lub za pomocą polecenia specyficznego dla używanego oprogramowania. Postępuj zgodnie z interesującą Cię funkcją przez wszystkie wycinki i powtórz ręczną segmentację śledzenia. Podczas korzystania z Amiry użyj następujących poleceń:
- Aby użyć narzędzia Pędzel, zmień rozmiar pędzla zgodnie z potrzebami, a następnie użyj wskaźnika myszy, aby obrysować obramowanie interesującego obiektu.
- Wypełnij obrysowany obszar skrótem "f". Dodaj zaznaczenie, klikając przycisk z symbolem plusa lub skrótem "a". W razie potrzeby naciśnij "u", aby cofnąć i "s", aby odjąć lub usunąć.
- Wygeneruj renderowanie powierzchni w celu wizualizacji i podstawowej analizy jakościowej lub ilościowej zgodnie z instrukcją obsługi oprogramowania.
- Na karcie Pula obiektów przełącz filename-labels.am w oknie Pula > kliknij prawym przyciskiem myszy > SurfaceGen.
- Wybierz żądane właściwości powierzchni > Zastosuj. W puli zostanie utworzony nowy plik filename.surf.
- Aby zwizualizować wolumin podzielony na segmenty, przełącz filename.surf w oknie Pula > kliknij prawym przyciskiem myszy > SurfaceView.
- Użyj narzędzi w oknie 3DViewer, aby przesuwać, obracać i powiększać wolumin 3D.
- Wyodrębnij dokładne gęstości i określ pomiary, takie jak objętość lub powierzchnia. Eksport do innych programów w celu bardziej zaawansowanego wyświetlania, analizy i symulacji.
- W oknie 3DViewer kliknij narzędzie Zmierz > Wybierz odpowiednią opcję (Długość i Kąt 2D dla pomiarów na pojedynczej płaszczyźnie 2D, Długość 3D i Kąt 3D dla pomiarów na objętości 3D).
- Kliknij powierzchnię siatki, aby zmierzyć żądaną długość, odległość i kąty. Wartości zostaną wyświetlone w oknie Właściwości.
3. Automatyczna segmentacja oparta na gęstości
Uwaga: Szczegóły metodologii opisanej poniżej są specyficzne dla Amiry, ale zamiast nich mogą być używane inne pakiety oprogramowania.
- Użyj tego podejścia w przypadku zestawów danych o dowolnej różnorodności kontrastu, wyrazistości lub zatłoczenia, aby wycofać interesujące nas gęstości.
- Importuj dane woluminu do programu wyposażonego w progowanie, magiczną różdżkę lub inne narzędzia oparte na gęstości do automatycznej segmentacji. Postępuj zgodnie z instrukcjami opisanymi w 2.1-2.1.2 we wskazówkach dotyczących ręcznego śledzenia.
- Poruszaj się po wycinkach i wybierz obszar do segmentacji. W razie potrzeby wytnij mniejszą podobjętość 3D w celu segmentacji. Postępuj zgodnie z instrukcjami opisanymi w punktach 2.2-2.2.2 we wskazówkach dotyczących ręcznego śledzenia.
- Wybieranie gęstości interesującego obiektu umożliwia wybór zagęszczenia, zwykle poprzez kliknięcie lub umieszczenie na nim znaku lub punktu kontrolnego. Jeśli jest to dozwolone w oprogramowaniu, wprowadź zakres liczbowy obejmujący intensywność pikseli funkcji i dostosuj tę tolerancję zgodnie z potrzebami. Gęstości należące do obiektu zostaną wybrane zgodnie z intensywnością piksela zakotwiczenia lub wartością tolerancji. Podczas korzystania z Amiry użyj następujących poleceń.
- Narzędzia Różdżka służy do tworzenia obiektów z wyróżniającymi się marginesami.
- Kliknij obszar zainteresowania, a następnie dostosuj suwaki w obszarze Wyświetlanie i maskowanie, aby uchwycić prawidłowy zakres wartości, tak aby funkcja była w pełni podświetlona. Dodaj zaznaczenie za pomocą skrótu "a".
- Narzędzia Próg należy używać w przypadku elementów bez wyraźnie rozróżnialnych marginesów.
- Wybierz ikonę Próg. Dostosuj suwak, aby dostosować gęstość w żądanym zakresie, tak aby maskowane były tylko interesujące obiekty. Kliknij przycisk Wybierz, a następnie dodaj zaznaczenie za pomocą skrótu "a".
- Aby podzielić cały wolumin na segmenty, zaznacz opcję Wszystkie plasterki przed dodaniem zaznaczenia.
- Aby usunąć szum, wybierz Segmentacja > Usuń wyspy i/lub Segmentacja > etykiety Wygładzanie.
- Narzędzia Różdżka służy do tworzenia obiektów z wyróżniającymi się marginesami.
- Wygeneruj powierzchnię do wizualizacji i analizy jakościowej zgodnie z opisem w sekcji 2.6-2.6.2 śledzenia ręcznego. W razie potrzeby można je wyeksportować do innych programów, aby uzyskać odpowiednie wyświetlanie 3D, analizę ilościową i symulacje.
4. Automatyczna segmentacja dostosowana do potrzeb klienta
Uwaga: Użyj tego podejścia do tworzenia niestandardowych skryptów do automatycznej segmentacji, co wymaga podstawowego doświadczenia w informatyce, ale pozwala na stworzenie precyzyjnego modelu gęstości z dużej objętości.
- Narzędzia (konkretny przykład segmentacji nadzorowanej przez kształt w MATLAB27)
- Wstępne przetwarzanie obrazu: Wykonaj usuwanie szumów, usuwanie tła i ulepszanie obrazu przy użyciu następującego potoku:
- Załaduj obraz za pomocą polecenia imread.
- W wierszu polecenia wpisz: >> im = imread($image_path), gdzie $image_path to lokalizacja obrazu, który ma być analizowany.
- W przyborniku Przetwarzanie obrazu wywołaj Filtr Wienera, używając szacowanego lub znanego stosunku szumu do mocy do sygnału (NSR).
- Na poprzednio przetworzonym obrazie wywołaj funkcję otwierania obrazu imopen, aby oszacować warstwę tła, a następnie przydziel wynik jako inną maskę.
- W wierszu poleceń wprowadź: >> background = imopen(im,strel($shape_string,$size)), w tej metodzie $shape_string jest równe 'disk' zmiennej, $size jest podawana przez analizator. tj. >> background = imopen(im,strel('disk',15)).
- Odejmij przefiltrowany obraz od tła.
- W wierszu poleceń wprowadź: >> im2 = im - tło
- W zależności od jakości wyników, wykonaj normalizację obrazu z adaptacyjną metodą28 Otsu lub bez niej, którą można wywołać za pomocą funkcji imadjust z Image Processing Toolbox.
- W wierszu polecenia wpisz: >> im3 = imadjust(im2)
- Przygotuj interesujące Cię obiekty do segmentacji, ograniczając obszary zainteresowania przez przycięcie znormalizowanego obrazu.
- Korzystając z polecenia imtool, zbadaj obszar zainteresowania, który ma zostać przycięty, i podaj współrzędne polecenia: >> im3_crop = imcrop(im3, [x1 y1 x2 y2]), gdzie wektor [x1 y1 x2 y2] odpowiada kwadratowemu regionowi, który ma zostać przycięty.
- Załaduj obraz za pomocą polecenia imread.
- Rozpoznawanie kształtów/nadzorowana klasyfikacja kształtów: Trenuj algorytm, podając konkretne przykłady dla każdej kategorii obiektów (liniowe ślady na obrazie 2D w poprzek interesujących cech).
- Sprawdź, czy interfejs API VLFEAT29 został pomyślnie zainstalowany i odwiedź witrynę internetową VLFEAT, aby uzyskać bardziej szczegółową dokumentację.
- W wierszu poleceń wpisz: >> [TREE,ASGN] = VL_HIKMEANS(im3_crop,$K,$NLEAVES), gdzie $K to liczba klastrów, które mają być użyte, lub liczba klas, do których obserwator chce uporządkować dane, a $NLEAVES to żądana liczba skupisk liści, tj. >> [TREE,ASGN] = VL_HIKMEANS(im3_crop, 4,100)
- Używanie ręcznie podzielonych na segmenty obiektów jako danych wejściowych dla VLFeat.
UWAGA: Ta biblioteka oparta na języku C o otwartym kodzie źródłowym będzie wykonywać łatanie pikseli, grupowanie poprawek i pozycjonowanie środka klastra w zależności od typu metody wybranej do pracy najlepiej dla zestawów danych. Dostępne opcje obejmują zarówno grupowanie k-średnich, jak i podejścia oparte na tekście30, a wynikiem jest tablica numeryczna, która opisuje pożądane cechy na podstawie podanych przykładów.
- Wstępne przetwarzanie obrazu: Wykonaj usuwanie szumów, usuwanie tła i ulepszanie obrazu przy użyciu następującego potoku:
- Segmentacja: Użyj tego w pełni zautomatyzowanego, choć kosztownego obliczeniowo, podejścia do segmentacji wielu klas obiektów jednocześnie, które zostaną zapisane jako osobne mapy do dalszej wizualizacji i analizy.
- Załaduj wcześniej wygenerowaną tablicę liczb (model).
- Wywołaj funkcję maszyny wektorów nośnych (SVM) w VLFeat, używając modelu i obrazu, który ma zostać podzielony na segmenty, jako danych wejściowych.
- W wierszu poleceń wprowadź: >> [w, b] = vl_svmtrain(x, y, 0.1), gdzie x to oryginalny przycięty obraz im2_crop a y to obraz obiektywny, czyli obraz, który został ręcznie podzielony na segmenty. Użyj >> ISEG = VL_IMSEG(I,LABELS), aby pokolorować wyniki zgodnie z etykietami wygenerowanymi przez grupowanie.
UWAGA: Na podstawie charakterystyki modelu, VLFeat sklasyfikuje obraz pod względem liczby klas (interesujących cech) przypisanych od początku. W zależności od pożądanego stopnia dokładności możliwe jest połączenie tej metody z innymi podejściami lub oszacowanie parametrów klastra, takich jak kadłub i środki klastrów. Wynikiem algorytmu SVM jest model probabilistyczny i wiele masek binarnych żądanych klas w nowych zestawach danych.
- W wierszu poleceń wprowadź: >> [w, b] = vl_svmtrain(x, y, 0.1), gdzie x to oryginalny przycięty obraz im2_crop a y to obraz obiektywny, czyli obraz, który został ręcznie podzielony na segmenty. Użyj >> ISEG = VL_IMSEG(I,LABELS), aby pokolorować wyniki zgodnie z etykietami wygenerowanymi przez grupowanie.
- Zapisz wyniki, wpisując polecenie: >> imwrite(im, $format, $filename), gdzie $format to "tiff", a $filename to ścieżka do pliku wyjściowego.
- Aby zwizualizować obrazy, wprowadź polecenie: >> imshow(im).
Wyniki
Rycina 1 przedstawia typowy schemat pracy dla obrazowania komórkowego w 3D za pomocą mikroskopii elektronowej, obejmujący tomografię elektronową, FIB-SEM oraz SBF-SEM. Schemat ten obejmuje zbieranie surowych danych, wyrównanie danych i rekonstrukcję w wolumen 3D, redukcję szumów poprzez filtrowanie, a w razie potrzeby przycinanie do obszaru zainteresowania w celu maksymalizacji efektywności wybranego oprogramowania do segmentacji. Tak wstępnie przetworzone dane są następnie gotowe do ekstrakcji cech/segmentacji.
Rysunek 2 przedstawia schemat pracy opisany na Rysunku 1 na przykładzie czterech różnych zestawów danych (które zostaną omówione poniżej), z których dwa to próbki zatopione w żywicy zarejestrowane za pomocą tomografii elektronowej (Rysunki 2A, 2B), a pozostałe dwa pochodzą odpowiednio z FIB-SEM i SBF-SEM (Rysunki 2C, 2D). Obrazy w kolumnie 1 Rysunku 2 to odpowiednio widoki projekcyjne (Rysunki 2A1, 2B1) oraz obrazy powierzchni bloku (Rysunki 2C1, 2D1), które po wyrównaniu i rekonstrukcji są składane w wolumin 3D. Kolumna 2 przedstawia przekroje przez takie woluminy 3D, które po filtrowaniu (kolumna 3) wykazują znaczne zmniejszenie szumów, dzięki czemu często wydają się wyraźniejsze. Po wybraniu i przycięciu dużego woluminu 3D do obszaru zainteresowania (kolumna 4), można uzyskać renderingi 3D posegmentowanych cech zainteresowania (kolumna 5), które następnie można poddać analizie, kodowaniu kolorystycznemu i analizie ilościowej.
W celu porównania efektywności czterech metod segmentacji wykorzystano łącznie sześć zestawów danych 3D, z których każdy zawiera stos obrazów uzyskanych za pomocą tomografii elektronowej (3 zestawy danych), FIB-SEM (2 zestawy danych) lub SBF-SEM (1 zestaw danych) (Rysunek 3). Zestawy danych pochodzą z różnych projektów badawczych realizowanych w laboratorium, dzięki czemu stanowią one reprezentatywny i zróżnicowany zbiór typowych danych eksperymentalnych. Wszystkie zestawy danych zostały przeanalizowane przez czterech niezależnych badaczy, z których każdy specjalizował się w jednej konkretnej metodzie; ich zadaniem było uzyskanie jak najlepszego wyniku dla każdego z sześciu zestawów danych.
Zestawy danych pochodzą z następujących próbek: 1. Rysunki 3A1-3A5: stereocilia komórek rzęsatych wewnętrznego ucha kurczaka, poddane mrożeniu pod wysokim ciśnieniem, substytucji mrozowej i zatopieniu w żywicy31, 2. Rysunki 3B1-3B5: ścianka komórkowa rośliny, poddana mrożeniu pod wysokim ciśnieniem, substytucji mrozowej i zatopieniu w żywicy (niepublikowane), 3. Rysunki 3C1-3C5: kinocilium komórki rzęsatej wewnętrznego ucha, poddane mrożeniu pod wysokim ciśnieniem, substytucji mrozowej i zatopieniu w żywicy (niepublikowane), 4. Rysunki 3D1-3D5: bloki mitochondriów zlokalizowanych w komórkach nabłonkowych gruczołu piersiowego człowieka HMT-3522 S1 acini, hodowanych w bogatej w lamininę macierzy zewnątrzkomórkowej, poddane mrożeniu pod wysokim ciśnieniem, substytucji mrozowej i zatopieniu w żywicy32,33, 5. Rysunki 3E1-3E5: niezbarwione, opracowane laboratoryjnie, zatopione w żywicy bloki biofilmów bakterii redukujących siarczany (manuskrypt w przygotowaniu) oraz 6. Rysunki 3F1-3F5: granica błony sąsiednich komórek HMT-3522 S1 acini.
Jak widać na Rysunku 3, różne podejścia do segmentacji mogą prowadzić do w większości podobnych wyników dla niektórych typów zestawów danych, ale do całkowicie różnych wyników dla innych typów danych. Na przykład zestaw danych stereocili komórek rzęsek (Rysunek 3A) pozwala na uzyskanie rozsądnych objętości segmentacji przy zastosowaniu wszystkich czterech podejść, przy czym manualny model abstrakcyjny wygenerowany przez eksperta jest najłatwiejszy do interpretacji i pomiaru. W tym przypadku taki model umożliwia szybki pomiar odległości między filamentami, zliczenie liczby połączeń znalezionych między wydłużonymi filamentami, a także określenie brakujących części mapy gęstości odpowiadających miejscom, w których preparat został uszkodzony podczas przygotowania próbki34. Takie informacje są znacznie trudniejsze do uzyskania przy użyciu pozostałych trzech podejść do segmentacji, choć specjalnie dostosowana automatyczna segmentacja daje lepsze wyniki niż progowanie oparte wyłącznie na gęstości.
W przypadku ściany komórkowej rośliny (Rysunek 3B) ręczne generowanie modelu okazało się najskuteczniejsze w oddaniu poczucia uporządkowania w ścianie komórkowej, czego nie osiągnęło żadne z pozostałych podejść. Jednakże model abstrakcyjny nie oddaje zagęszczenia obiektów w zestawie danych. Ręczne obrysowywanie interesujących cech wydaje się dawać lepszy rezultat niż podejścia oparte na gęstości lub nadzorowane kształtem. Z drugiej strony, ręczne obrysowywanie jest bardzo pracochłonne, a identyfikacja granic cech jest w pewnym stopniu subiektywna. W związku z tym podejścia zautomatyzowane mogą być preferowane do segmentacji dużych objętości, przy potencjalnym kompromisie między precyzją a zasobami poświęconymi na segmentację ręczną.
W przypadku zestawu danych dla kinocylium (Rycina 3C), ręczne generowanie modelu abstrakcyjnego daje najczystszy wynik i ujawnia nieoczekiwaną architekturę trzech mikrotubul w centrum kinocylium – szczegół ten jest wyraźnie widoczny w przyciętych danych, lecz ginie we wszystkich pozostałych podejściach, prawdopodobnie z powodu heterogeniczności barwienia. Jednakże w procesie ręcznego tworzenia modelu abstrakcyjnego pomijane są inne potencjalnie kluczowe cechy mapy gęstości. Wynika to z faktu, że subiektywny charakter ręcznego tworzenia modelu prowadzi do idealizacji i abstrakcji faktycznie zaobserwowanej gęstości, a tym samym do subiektywnej interpretacji podczas formowania modelu. Zatem niniejszy przykład dobrze pokazuje, jak ręczne generowanie modelu abstrakcyjnego pozwala skoncentrować się na konkretnym aspekcie objętości 3D. Jednakże selektywna percepcja i uproszczenie nie pozwalają na pełne przedstawienie wszystkich kompleksów białkowych obecnych w zestawie danych. W związku z tym, jeśli celem jest ukazanie złożoności danych, korzystniej jest zastosować którekolwiek z trzech pozostałych podejść.
W przypadku acyn gruczołu piersiowego hodowanych w macierzy 3D (Rysunek 3D), mitochondria o wysokim kontraście są z łatwością segmentowane przez wszystkie cztery podejścia, przy czym ręczne obrysowywanie cech, co nie jest zaskakujące, daje najlepsze wyniki z najmniejszą ilością zanieczyszczeń (Rysunek 3D3). Jednak ręczne obrysowywanie jest bardzo pracochłonne i dlatego ma ograniczone zastosowanie przy dużych objętościach. Zarówno automatyczna segmentacja oparta na progu gęstości, jak i ta nadzorowana kształtem, wyodrębniają mitochondria całkiem dobrze i doprowadziłyby do niemal idealnej segmentacji, gdyby zastosowano dodatkowe metody oczyszczania (np. eliminację wszystkich obiektów poniżej określonego progu gęstości wokseli), dostępne w różnych pakietach. W tym przypadku ręczne budowanie modeli abstrakcyjnych nie przyniosło obiecujących rezultatów, częściowo dlatego, że mitochondria nie mogą być łatwo przybliżone za pomocą modeli kulkowo-prętowych.
W odniesieniu do bakteryjnej społeczności glebowej/biofilmu (Rysunek 3E), trzy z czterech podejść przyniosły zadowalające wyniki, przy czym ręczne generowanie modelu nie wypadło dobrze ze względu na trudność w reprezentowaniu obiektów biologicznych, takich jak bakterie, za pomocą kształtów geometrycznych. Dodatki zewnątrzkomórkowe pochodzące od bakterii można wykryć w podejściach do automatycznej segmentacji, ale nie tak dobrze w przypadku ręcznego śledzenia cech. Automatyczna segmentacja dostosowana do konkretnego przypadku z nadzorem nad kształtem pozwala dodatkowo oddzielić cechy zewnątrzkomórkowe od bakterii mimo ich podobnej gęstości (dane nie pokazano), co umożliwia łatwą kwantyfikację nawet w przypadku niezwykle dużych zbiorów danych. Ponieważ pierwotnie był to bardzo duży zbiór danych, dostosowana automatyczna segmentacja wyraźnie wyprzedziła wszystkie pozostałe podejścia, ale mogło to wynikać z niskiej złożoności i stosunkowo rzadkiego rozkładu interesujących obiektów (małego zagęszczenia).
Podczas badania styku dwóch komórek eukariotycznych w kontekście przypominającym tkankę (Rysunek 3F), tylko ręczne obrysowywanie interesujących cech przyniosło dobre wyniki. Zautomatyzowane podejścia do segmentacji oparte na gęstości całkowicie nie wykrywają granicy błony między sąsiadującymi komórkami, a zawiodły nawet podejścia dostosowane do konkretnego zastosowania, częściowo dlatego, że kształt komórki nie daje się łatwo przybliżyć ani utożsamiać z określonymi kształtami, mimo wyraźnego sukcesu w przypadku bakterii w biofilmie (Rysunek 3E5).
Obserwacja z Rysunku 3, wskazująca, że metody segmentacji sprawdzają się w przypadku niektórych zbiorów danych, ale nie innych, doprowadziła do pytania o to, co charakteryzuje każdy z tych zbiorów oraz czy możliwe jest skategoryzowanie typów cech danych lub indywidualnych celów, które wydają się dobrze współgrać z odpowiednią metodą. Systematyczne badanie tego zagadnienia nie było wcześniej przeprowadzane, dlatego w pierwszym kroku opracowanie empirycznej listy cech obrazów i celów badawczych może pomóc początkującym w próbach znalezienia najlepszej metody ekstrakcji cech dla ich konkretnego zbioru danych.
Osiem zidentyfikowanych jako istotne kryteriów przedstawiono na Rysunku 4; można je podzielić na dwie główne kategorie: (1) cechy immanentne dla zbioru danych oraz (2) osobiste cele badacza i inne, nieco bardziej subiektywne, choć równie ważne rozważania. Przedstawione przykłady pochodzą głównie z sześciu zbiorów danych z Rysunku 3, przy czym wprowadzono trzy dodatkowe zbiory danych: pierwszy (Rysunek 4A1) to kriotomogram krioprzekroju ściany komórkowej rośliny Arabidopsis thaliana, drugi (Rysunki 4A2, 4B1, 4D1) to zbiór danych FIB/SEM stria vascularis ucha wewnętrznego, która jest tkanką wysoce złożoną i zwiniętą, mogącą należeć do kategorii przedstawionej na Rysunkach 3F1-3F5, lecz będącą jeszcze bardziej złożoną, a trzeci (Rysunki 4B2, 4D2) to tomogram przekroju w żywicy stereocili komórek rzęskowych ucha wewnętrznego w widoku poprzecznym, podobny do zawartości próbki pokazanej w widoku podłużnym na Rysunkach 2A1-2A5 oraz 3A1-3A5.
W kategorii obiektywnych kryteriów, takich jak charakterystyka obrazu, zaproponowano cztery cechy właściwe dla zestawów danych, które uznano za istotne:
- Kontrast danych może być (1) niski (Figure 4A1), co jest typowe dla tomogramów cryo-EM, (2) średni (Figure 4A2), na przykład w obrazach komórkowych bez wyraźnych organelli lub innych dominujących struktur, lub (3) wysoki (Figure 4A3), jak w przypadku tomogramu kinocyli lub stereocilii w przekroju poprzecznym, co wynika z wyrównania wyraźnie oddzielonych elementów włóknistych w kierunku osi z.
- Dane mogą być niewyraźne (Figure 4B1), bez widocznych, ostrych granic między dwoma położonymi blisko siebie obiektami, np. komórkami w tkance, lub wyraźne (Figure 4B2), z ostro zdefiniowanymi granicami. Jest to częściowo funkcją rozdzielczości zestawu danych, która w przypadku tomogramów elektronowych jest z natury o ok. 2-4 razy wyższa niż w FIB-SEM. Naturalnie, ostrzejsze granice są pożądane zarówno dla manualnych, jak i zautomatyzowanych metod segmentacji, lecz są one niezbędne w przypadku podejścia automatycznego.
- Mapy gęstości mogą być albo zatłoczone (Figure 4C1), co odzwierciedlają gęsto rozmieszczone komponenty ściany komórkowej roślin, albo rzadko zasiedlone (Figure 4C2), jak w przypadku bakterii w kolonii, co egzemplifikuje separację znacząco ułatwiającą automatyczną segmentację obrazu.
- Mapy gęstości mogą być wysoce złożone z bardzo zróżnicowanymi cechami, często o nieregularnych kształtach, takimi jak tkanka stria vascularis wokół naczynia krwionośnego (Figure 4D1), lub zawierać dobrze zdefiniowane obiekty przypominające organelle o podobnej organizacji, takie jak stereocilia w przekroju poprzecznym (Figure 4D2).
Należy również zwrócić uwagę na znacznie różniące się skale we wszystkich przykładach, co nieco utrudnia porównanie.
Oprócz bardziej obiektywnych kryteriów, takich jak charakterystyka obrazu, zaproponowano również cztery wysoce subiektywne kryteria, które będą kierować wyborem odpowiedniej ścieżki:
- Wyznaczony cel: Celem może być wizualizacja stereocyli wiązki włosków w całej ich złożoności oraz określenie i zbadanie kształtu obiektu (Figure 4E1), lub stworzenie uproszczonego i abstrakcyjnego modelu kulkowo-prętowego wpisanego w mapę gęstości, który pozwala na szybkie przeliczanie i pomiar obiektów geometrycznych (długość filamentów, odległości i liczba połączeń) (Figure 4E2).
- Morfologia cech może być wysoce nieregularna i złożona, podobnie jak w przypadku komórek, np. stref interakcji międzykomórkowych (Figure 4F1), mieć nieco podobny kształt z pewnymi wariacjami, jak w przypadku mitochondriów (Figure 4F2), lub być w większości identyczna, jak w przypadku filamentów aktynowych i wiązań poprzecznych w wiązce włosków w orientacji podłużnej (Figure 4F3).
- Istotna jest proporcja badanej cechy (gęstość populacji), ponieważ celem może być segmentacja wszystkich cech w trójwymiarowym zbiorze danych, co ma miejsce w przypadku ścian komórkowych roślin (Figure 4G1), lub tylko niewielkiej frakcji objętości komórkowej, jak w przypadku mitochondriów w heterogenicznej scenie komórkowej (Figure 4G2). W zależności od rozmiaru zbioru danych i procentowej objętości wymagającej segmentacji, najefektywniejsze może być zastosowanie metod manualnych. W innych przypadkach, np. gdy interesuje nas wiele różnych cech, jedyną alternatywą jest zastosowanie półautomatycznych metod segmentacji.
- Kolejnym kluczowym subiektywnym kryterium jest ilość zasobów, jakie można zainwestować w proces segmentacji, oraz poziom dokładności wymagany do odpowiedzi na pytanie biologiczne. Może istnieć potrzeba ilościowego określenia parametrów objętościowych cechy (takich jak wielkość, objętość, powierzchnia, długość, odległość od innych cech itp.), w takim przypadku konieczna jest większa staranność w celu uzyskania dokładnych informacji ilościowych (Figure 4H1), lub celem może być jedynie wykonanie obrazu jej kształtu 3D (Figure 4H2). W idealnym świecie z nieograniczonymi zasobami z pewnością nie chciano by iść na żadne kompromisy, lecz wybrać najdokładniejszą ścieżkę manualnej ekstrakcji cech wspomaganej przez użytkownika. Choć może to działać dla wielu zbiorów danych, w najbliższej przyszłości objętości 3D będą rzędu 10k na 10k na 10k lub większe, a segmentacja manualna nie będzie już mogła odgrywać głównej roli w segmentowaniu tak ogromnej przestrzeni. W zależności od złożoności danych i innych ich charakterystyk, segmentacja półautomatyczna może stać się koniecznością.
Na Rysunku 5 krótko wymieniono mocne i słabe strony czterech podejść do segmentacji. Przedstawiono również cele osobiste oraz charakterystyki obrazów zidentyfikowane na Rysunku 4, które mogą być dopasowane do każdego z podejść. Na Rysunku 6 cele osobiste i charakterystyki obrazów z sześciu zestawów danych obrazują sposób segregacji danych i wyboru najlepszego podejścia. Zarówno Rysunek 5, jak i Rysunek 6 są szerzej omówione w części dyskusji.

Rycina 1. Przebieg procesu rekonstrukcji i analizy obrazowania biologicznego. Schemat ten przedstawia przegląd poszczególnych etapów zbierania i przetwarzania obrazów uzyskanych za pomocą tomografii, skaningowej mikroskopii elektronowej z wiązką jonową (FIB-SEM) oraz skaningowej mikroskopii elektronowej z seryjnym odsłanianiem powierzchni bloku (SBF-SEM). Gromadzenie surowych danych skutkuje otrzymaniem 2D serii nachyleń lub sekcji seryjnych. Te zestawy obrazów 2D muszą zostać dopasowane i zrekonstruowane w 3D, a następnie przefiltrowane w celu redukcji szumów i poprawy kontrastu interesujących cech. Na koniec dane mogą zostać poddane segmentacji i analizie, co w efekcie prowadzi do stworzenia modelu 3D. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.

Rysunek 2. Przykłady schematu postępowania dla różnych typów danych z tomografii i FIB-SEM. Każdy etap schematu po zebraniu danych przedstawiono na czterech zbiorach danych (rzędy A-D): barwionej tomografii stereocili w przekroju podłużnym zatopionych w żywicy, barwionej tomografii celulozy ścian komórkowych roślin zatopionych w żywicy, FIB-SEM mitochondriów komórek nabłonka piersi oraz SBF-SEM bakterii E. coli. Przekrój 2D przez surowe dane pokazano w kolumnie 1, a obraz z danych po wyrównaniu i rekonstrukcji 3D stanowi kolumna 2. Techniki filtrowania zastosowane w kolumnie 3 to odpowiednio: filtr medianowy (A3), filtr dyfuzji nieanizotropowej (B3), rozmycie Gaussa (C3) oraz filtr imadjust z programu MATLAB (D3). Przykład najlepszej segmentacji dla każdego zbioru danych z wyciętego obszaru zainteresowania (kolumna 4) przedstawiono jako rendering 3D w kolumnie 5. Paski skali: A1-A3 = 200 nm, A4 = 150 nm, A5 = 50 nm, B1-B3 = 200 nm, B4-B5 = 100 nm, C1-C3 = 1 mm, C4-C5 = 500 nm, D1-D3= 2 mm, D4-D5 = 200 nm. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
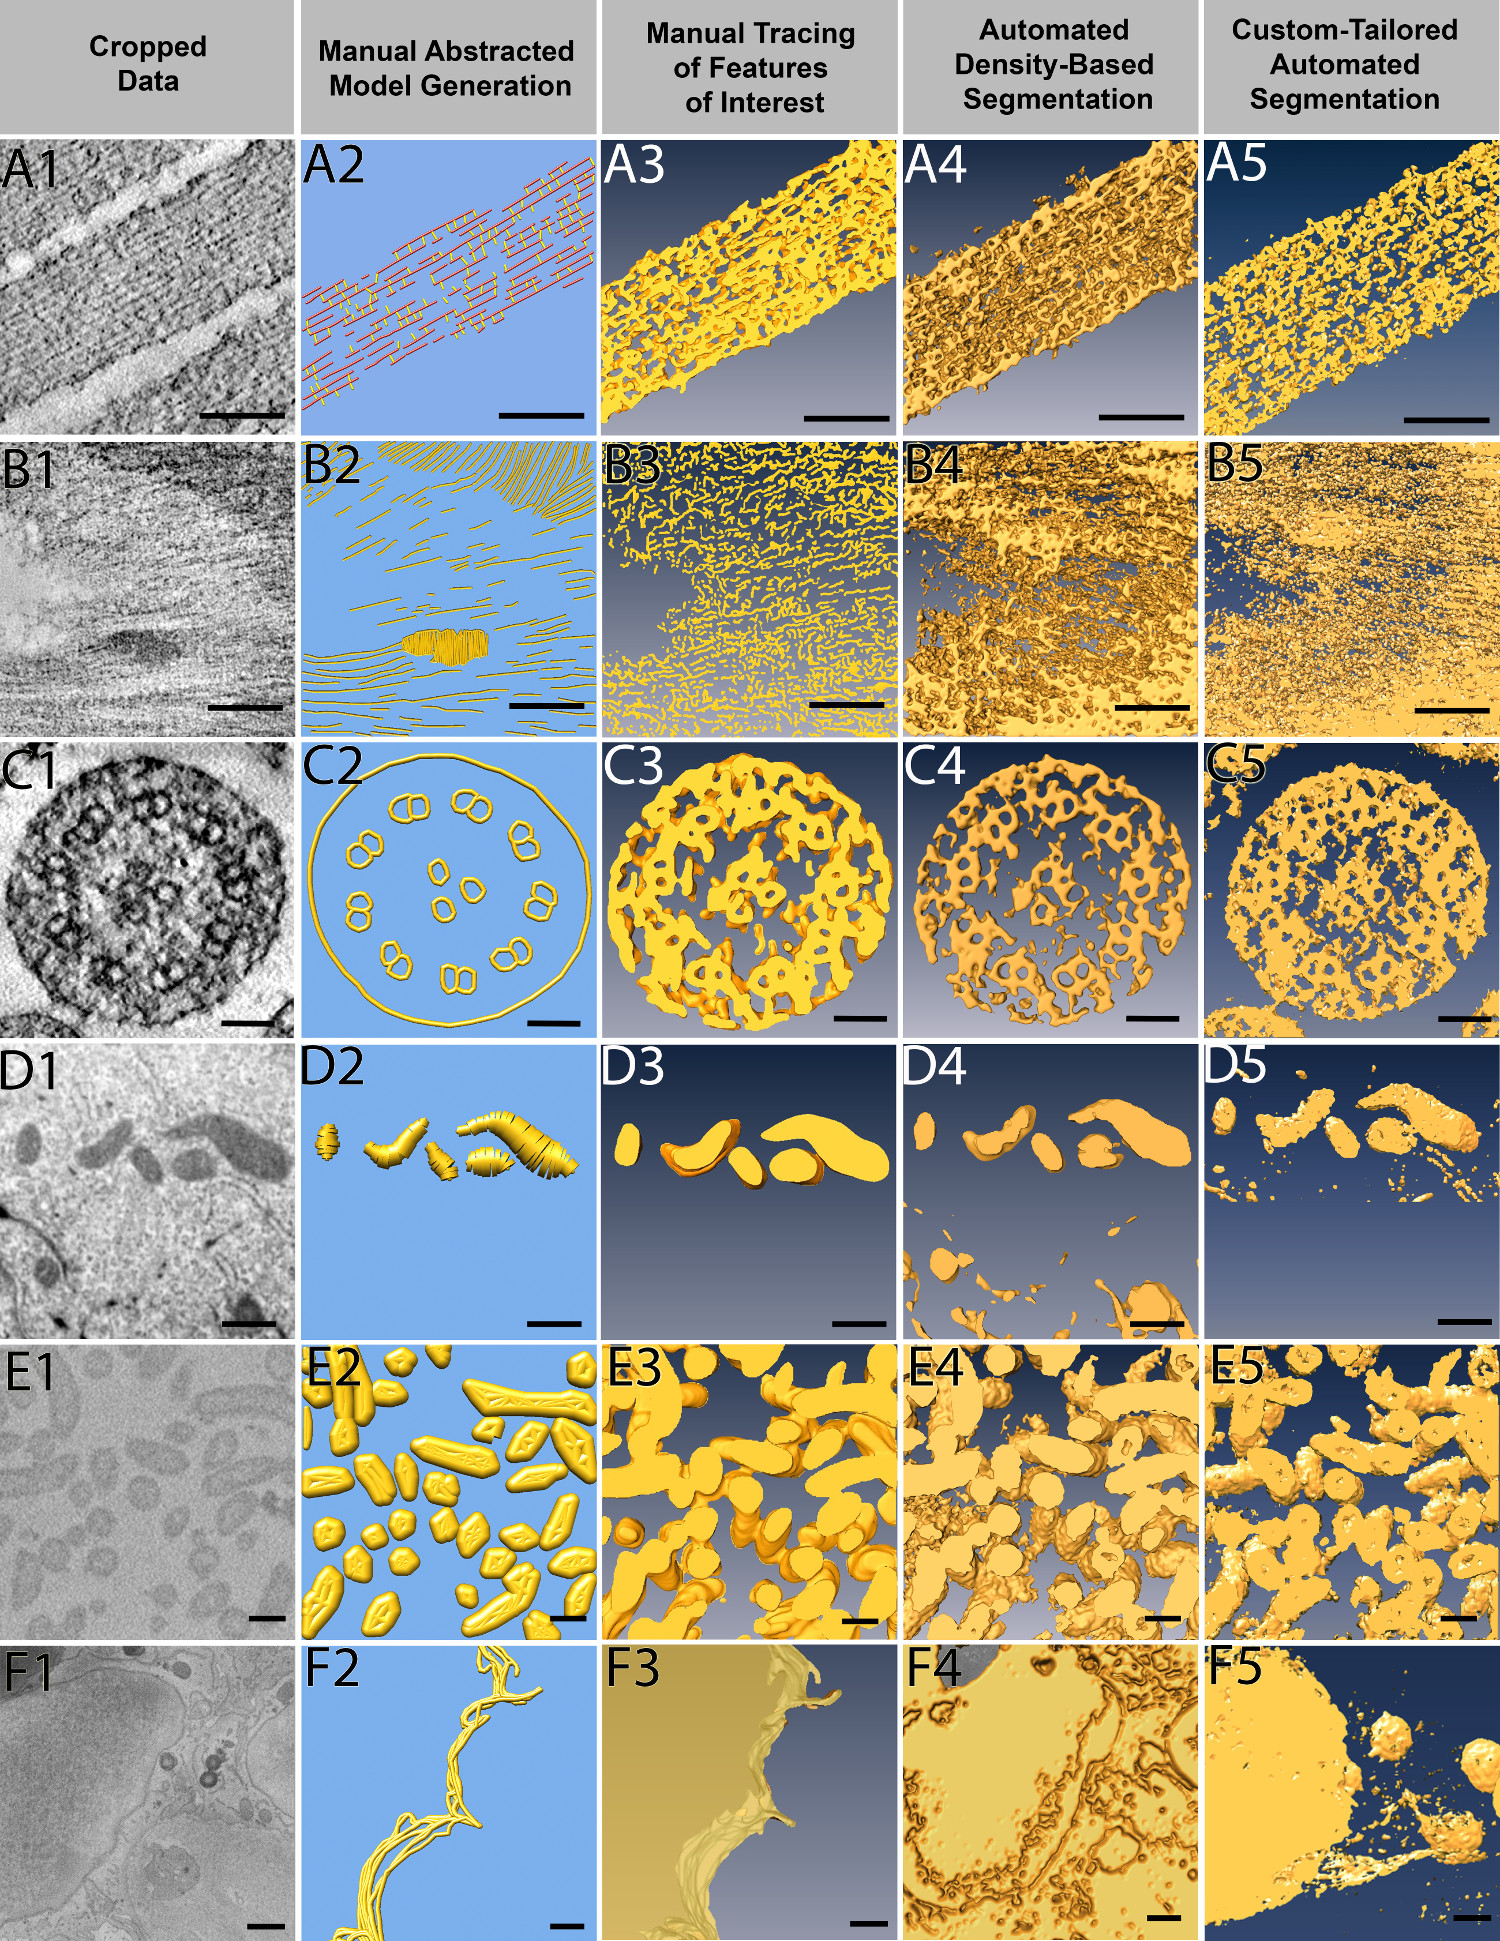
Rycina 3. Zastosowanie czterech podejść do segmentacji w przykładowych zestawach danych. Sześć przykładowych zestawów danych zostało poddanych segmentacji za pomocą wszystkich czterech podejść: ręcznego generowania modelu abstrakcyjnego, ręcznego obrysowywania, zautomatyzowanej segmentacji opartej na gęstości oraz zautomatyzowanej segmentacji dostosowanej indywidualnie. Ręczne generowanie modelu abstrakcyjnego było skuteczne w przypadku barwionej tomografii stereocyli zatopionych w żywicy (A), ponieważ celem było stworzenie modelu do celów ilościowych, a nie wyodrębnianie gęstości. W przypadku barwionej tomografii ściany komórki roślinnej zatopionej w żywicy (B), zautomatyzowana segmentacja oparta na gęstości była najskuteczniejszą metodą szybkiego wyodrębnienia celulozy z wielu przekrojów, podczas gdy metody ręczne wymagały znacznie większego nakładu pracy przy zaledwie kilku przekrojach danych. Ręczne generowanie modelu abstrakcyjnego pozwoliło odtworzyć triplet mikrotubul w barwionej tomografii kinocylium (C), czego nie udało się osiągnąć za pomocą innych metod segmentacji, jednak dwa podejścia zautomatyzowane wyodrębniały gęstości szybciej i dlatego były preferowane. Ze względu na kształt mitochondriów w obrazach FIB-SEM komórek nabłonkowych piersi (D), ręczne obrysowywanie zapewniło najczystszy wynik, a niska gęstość populacji w połączeniu z zastosowaniem metod interpolacji umożliwiła szybką segmentację. Biorąc pod uwagę dużą objętość wymagającą segmentacji, zautomatyzowana segmentacja dostosowana indywidualnie okazała się najefektywniejsza w przypadku danych SBF-SEM bakterii (E), choć oba podejścia automatyczne były porównywalne. Mimo że była czasochłonna, jedyną metodą wyodrębnienia błony komórkowej w obrazach FIB-SEM komórek nabłonkowych piersi (F) było ręczne obrysowywanie. Paski skali: A1-A5 = 100 nm, B1-B5 = 100 nm, C1-C5 = 50 nm, D1-D5 = 500 nm, E1-E5 = 200 nm, F1-F5, paski = 500 nm. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.

Rysunek 4. Obiektywne cechy obrazu i subiektywne cele osobiste w triage'u zestawów danych. Na podstawie przykładów charakterystyk zestawów danych zaproponowano kryteria ułatwiające decyzję o wyborze metody segmentacji. W odniesieniu do cech obiektywnych dane mogą posiadać naturalnie niski, średni lub wysoki kontrast (A1-A3), być rozmyte lub ostre (B1-B2), rzadkie lub zagęszczone (C1-C2) oraz posiadać cechy złożone lub prosto zorganizowane (D1-D2). Subiektywne cele osobiste obejmują pożądany cel nakierowany na model uproszczony lub wyodrębnienie dokładnych gęstości (E1-E2), identyfikację splotowej płaszczyzny, splotowej objętości lub morfologii liniowej jako cechy interesującej (F1-F3), wybór wysokiej lub niskiej gęstości populacji cechy interesującej (G1-G2) oraz decyzję o kompromisie między wysoką wiernością a dużym nakładem zasobów przy malejącym zwrocie z inwestycji, takich jak czas (H1-H2). Paski skali: A1= 50 nm, A2 = 1500 nm, A3 = 100 nm, B1 = 1500 nm, B2 = 200 nm, C1 = 100 nm, C2 = 200 nm, D1 = 10 mm, D2 = 200 nm, E1 = 100 nm, E2 = 50 nm, F1-F2 = 500 nm, F3 = 50 nm, G1 = 100 nm, G2 = 1 mm, H1-H2 = 100 nm. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
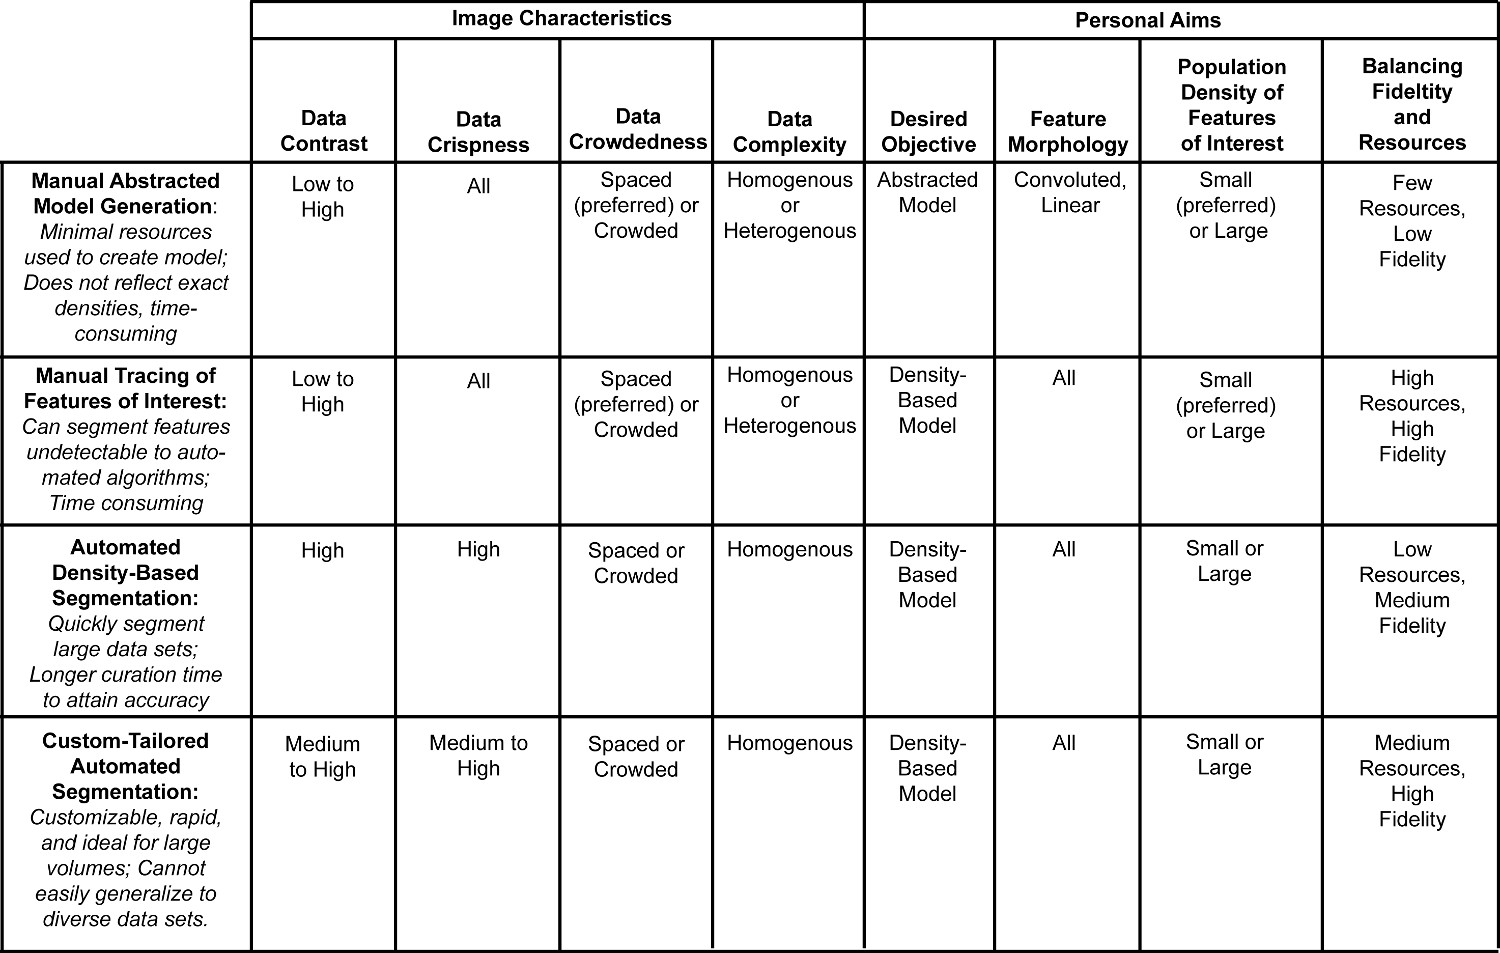
Rysunek 5. Tabela porównawcza charakterystyki danych i celów subiektywnych odpowiednich dla różnych podejść do segmentacji. Tabela ta podsumowuje zalety i ograniczenia każdego podejścia do segmentacji. Kryteria z Rysunku 4 mogą pomóc zidentyfikować, które zbiory danych są odpowiednie dla danej metody segmentacji. Te obiektywne charakterystyki obrazu oraz subiektywne cele osobiste zostały wybrane w celu optymalnego wykorzystania każdego z podejść, jednak różne kombinacje mogą utrudniać lub wspomagać efektywność segmentacji. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.

Rysunek 6. Schemat decyzyjny dla efektywnego doboru metod segmentacji dla zbiorów danych o różnych charakterystykach. Na podstawie cech wyróżnionych na Rysunku 4, schemat ten ilustruje, które cztery kryteria miały największy wpływ na ostateczną decyzję dotyczącą najlepszego podejścia do segmentacji dla każdego zbioru danych z Rysunku 3. Każdy zbiór danych został oznaczony kolorem, aby można było szybko śledzić pogrubione linie reprezentujące główny proces decyzyjny, a także linie przerywane odzwierciedlające alternatywną ścieżkę, która może lub nie prowadzić do tego samego podejścia. Zbiory danych dla kinocyliów, bakterii i ścian komórkowych roślin były najlepiej segmentowane za pomocą dwóch zautomatyzowanych metod. W przeciwieństwie do nich, ścieżki dla błon komórkowych i mitochondriów zawsze prowadzą do ręcznego obrysowywania ze względu na ich trudne charakterystyki. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Dyskusja
Pilnie potrzebne są skuteczne strategie ekstrakcji istotnych cech z woluminów 3D EM, aby nadążyć za tsunami danych, które ostatnio nawiedziło obrazowanie biologiczne. Podczas gdy dane mogą być generowane w ciągu godzin lub dni, dogłębna analiza woluminów 3D zajmuje wiele miesięcy. W związku z tym oczywiste jest, że analiza obrazu stała się wąskim gardłem dla odkryć naukowych; Bez odpowiednich rozwiązań tych problemów, naukowcy zajmujący się obrazowaniem stają się ofiarami własnego sukcesu. Wynika to częściowo z dużej złożoności danych, a także z zatłoczenia makromolekularnego zwykle występującego w komórkach biologicznych, w których białka i kompleksy białkowe graniczą ze sobą i zasadniczo pojawiają się jako ciągły gradient gęstości w skali szarości. Problem komplikują niedoskonałości związane z przygotowaniem próbek i obrazowaniem, a w niektórych przypadkach artefaktami rekonstrukcji obrazu, co prowadzi do mniej niż idealnych danych wolumetrycznych, co może stanowić wyzwanie dla w pełni zautomatyzowanych podejść. Najbardziej znaczący jest jednak fakt, że eksperci w dziedzinie przygotowania próbek, obrazowania i interpretacji biologicznej rzadko są dobrze zorientowani w naukach obliczeniowych, a zatem potrzebują wskazówek, jak skutecznie podejść do ekstrakcji i analizy cech. W związku z tym, korzystając z różnych przykładów, protokół wyjaśnia, jak przygotować dane do segmentacji, a także kroki ręcznego generowania abstrakcyjnego modelu, automatycznej segmentacji opartej na gęstości, ręcznego śledzenia interesujących cech oraz automatycznej segmentacji dostosowanej do potrzeb klienta. Podejścia ręczne i automatyczne przedstawione w procedurze można znaleźć w wielu różnych programach do segmentacji, z których niektóre są tutaj wymienione, ale inne pełnią podobne funkcje i są równie dobrze dopasowane.
Wyniki pokazują, że skuteczność każdego z podejść do segmentacji 3D różni się w zależności od typu zbioru danych. Mimo że różne podejścia dały jakościowo podobne renderingi 3D jako produkt końcowy, ilość czasu i wysiłku poświęconego na każde z nich podczas procesu segmentacji znacznie się różniła. Zalecenia dotyczące odpowiednich cech obrazu i celów osobistych dla każdego podejścia do segmentacji podsumowano na rysunku 5, który został szczegółowo wyjaśniony w kolejnych czterech podsekcjach. Kryteria te zastosowano do sześciu zestawów danych, jak pokazano na schemacie blokowym decyzji na rysunku 6. Chociaż rys. 5 i 6 mają na celu jedynie przedstawienie uzasadnienia dla każdego zestawu danych oraz sposobu ważenia każdego z kryteriów w procesie podejmowania decyzji, nie stanowią one niezawodnych wskazówek, lecz raczej punkt wyjścia. Istnieje po prostu zbyt wiele kryteriów, które wpływają na proces podejmowania decyzji: niektóre z nich są kryteriami obiektywnymi, takimi jak charakterystyka zbioru danych, podczas gdy inne są kryteriami bardziej subiektywnymi, takimi jak pożądany cel. Można śmiało powiedzieć, że zestawy danych, które wykazują wysoki poziom kontrastu z ostrymi, wyraźnymi granicami, mają cechy, które są dobrze oddzielone i stosunkowo jednorodne (niezbyt zróżnicowane) i są przetwarzane w celu wyświetlenia modelu gęstości dla dużej liczby obiektów, podejścia zautomatyzowane byłyby lepsze, gdyby nie fakt, że podejścia ręczne byłyby po prostu zbyt zasobowe (czasowo). Z drugiej strony, jeśli kontrast jest niski, dane są rozmyte, a tym samym wymagają wiedzy eksperta, obiekty są zatłoczone, a cechy wykazują dużą różnorodność, a tym samym są niejednorodne, można nie mieć innego wyboru niż ręczna ekstrakcja/segmentacja cech.
Ręczne generowanie abstrakcyjnego modelu
Ręczne śledzenie abstrakcyjnego modelu jest szczególnie skuteczne w segmentacji elementów liniowych, dostarczając punktów początkowych (kulek), które mogą być automatycznie łączone (pałeczki). Takie kulki i patyki-modele mogą być bardzo skuteczne w mierzeniu długości i orientacji takiego modelu oraz zapewniają odpowiednio abstrakcyjny model zarówno do kontroli jakościowej, jak i analizy ilościowej. Ręczne generowanie abstrakcyjnego modelu jest powszechnie stosowane, gdy minimalizacja zasobów wydanych na analizę jest ważniejsza niż bezwzględna wierność kształtom oryginalnych danych. Najlepiej sprawdza się w przypadku interesujących go cech liniowych i jednorodnych (np. filamenty, rurki). Kontrast danych, ostrość i zatłoczenie nie odgrywają większej roli w określaniu sukcesu tej metody, o ile ludzkie oko jest w stanie rozpoznać obiekt zainteresowania. Czasami takie modele mogą być również wykorzystywane jako szkielet do segmentacji mapy 3D w strefie wokół szkieletu. Chociaż model jest abstrakcyjny, a nie odzwierciedla dokładne gęstości, reprezentuje szkieletową wersję gęstości 3D, a tym samym pozwala na wizualizację bez bałaganu i analizę jakościową. Pomiary ilościowe, takie jak długość, można również określić na podstawie przybliżonego modelu. Przykład oprogramowania z ręcznym generowaniem abstrakcyjnych modeli można znaleźć w szczegółowym podręczniku użytkownika Chimera online pod adresem http://www.cgl.ucsf.edu/chimera/current/docs/UsersGuide/index.html.
Ręczne śledzenie interesujących cech
Ręczne śledzenie pędzlem sprawdza się w przypadku prawie wszystkich cech danych, ale jest to również najbardziej czasochłonna metoda. Czasami jest to jedyna technika wyodrębniania interesującej cechy ze złożonego zestawu obrazów zawierającego dużą różnorodność cech, takich jak cienka i pofałdowana błona komórkowa. Jedno z przydatnych narzędzi dostępnych w niektórych programach pozwala na interpolację między okresowo segmentowanymi wycinkami, gdy interesująca nas funkcja zmienia się płynnie. Ręczne śledzenie może być stosowane najefektywniej, jeśli dane są wyraźne i mają średni lub wysoki kontrast, ale można je również wykorzystać w przypadku bardziej wymagających zestawów danych, o ile użytkownik jest zaznajomiony z obiektem zainteresowania. Złożoność danych może wahać się od dyskretnych obiektów do złożonych i zatłoczonych zestawów danych, w których obiekty są ściśle upakowane. W tym drugim przypadku ręczna segmentacja może być jedynym wyborem, ponieważ podejścia automatyczne często mają trudności z segmentacją żądanej objętości i wyodrębnieniem zbyt dużej lub zbyt małej ilości. Za pomocą tej metody można również wyodrębnić trudne morfologie cech, takie jak zawiłe arkusze lub objętości. Użytkownik powinien jednak pamiętać, że zbiór danych o kilku trudnych cechach może być segmentowany tylko wtedy, gdy gęstość zaludnienia obiektów będących przedmiotem zainteresowania jest niska, ponieważ segmentacja dużych gęstości zaludnienia obiektów będących przedmiotem zainteresowania staje się zbyt czasochłonna. Przykład oprogramowania z ręcznym śledzeniem można znaleźć w szczegółowej instrukcji obsługi Amiry pod adresem http://www.vsg3d.com/sites/default/files/Amira_Users_Guide.pdf.
Zautomatyzowana segmentacja oparta na zagęszczeniu
W przeciwieństwie do technik ręcznych, podejścia zautomatyzowane są na ogół mniej czasochłonne, co jest ważnym czynnikiem, który należy wziąć pod uwagę podczas segmentacji dużego stosu obrazów. Jednak proste progowanie może nie być tak dokładne, a znacznie więcej czasu można poświęcić na udoskonalenie i selekcję automatycznie segmentowanego woluminu. Zautomatyzowana segmentacja oparta na zagęszczeniu działa najlepiej w przypadku zestawów danych, które wyświetlają dużą liczbę podobnych cech, które wymagają segmentacji. Jeśli dane są bardziej złożone, te zautomatyzowane techniki mogą nadal służyć jako pierwszy krok, ale prawdopodobnie będą wymagały pewnej ręcznej interwencji w celu określenia podwoluminu zawierającego interesującą Cię funkcję. Ta strategia zazwyczaj działa dobrze w przypadku morfologii liniowych lub zawiłych objętości, ale rzadko jest skuteczna w przypadku cienkich pofałdowanych arkuszy, takich jak błony komórkowe. Minimalna interwencja użytkownika przy zautomatyzowanych podejściach umożliwia segmentację przez duże lub małe ilości, przy jednoczesnym zużyciu niewielu zasobów użytkownika, takich jak czas, w zamian za wysoką wierność. Przykład oprogramowania z automatyczną segmentacją na podstawie gęstości można znaleźć w szczegółowym podręczniku użytkownika Amiry pod adresem http://www.vsg3d.com/sites/default/files/Amira_Users_Guide.pdf.
Automatyczna segmentacja dostosowana do potrzeb klienta
Automatyczna segmentacja dostosowana do potrzeb klienta umożliwia zaawansowane dostosowywanie algorytmów do określonego zestawu danych, ale często jest specyficzna dla zestawu danych lub typu danych, odpowiednia dla ograniczonej liczby cech funkcji i nie można jej łatwo uogólnić. Przedstawiona tutaj procedura różni się od ogólnych podejść do automatycznej segmentacji, takich jak zanurzenie w zlewni i inne metody ustawiania poziomów, które opierają się na zaprogramowanym określeniu krytycznych punktów zarodkowych, po których następuje szybko maszerująca ekspansja sześcianu z tych punktów początkowych. Wariacją na ten temat jest segmentacja granic, w której informacje o wektorze gradientu informują o granicach obiektów. Z kolei dostosowany skrypt używany w tym miejscu opiera się na etapie trenowania, w którym użytkownik ręcznie śledzi kilka przykładów. Dzięki uczeniu maszynowemu określone algorytmy będą wykrywać, a następnie uczyć się samodzielnie rozpoznawać właściwości i cechy danych, które konsekwentnie znajdują się w śladach. Doświadczony użytkownik może ponownie wytrenować algorytmy i poprawić dokładność segmentacji, dołączając więcej przykładowych śladów, aby zapewnić większy zestaw kryteriów funkcji. Ogólnie rzecz biorąc, progowanie i podejścia pokrewne, a nawet podejścia dostosowane do potrzeb klienta mogą nie być tak przydatne do wyodrębnienia pojedynczej interesującej cechy z obrazu o złożonej różnorodności organelli lub kształtów, ponieważ selekcja może być tak samo pracochłonna jak ręczne śledzenie.
Strategie klasyfikowania danych i wyboru podejścia do segmentacji
Biorąc pod uwagę subiektywne i obiektywne kryteria przedstawione na rysunku 4 oraz podsumowanie odpowiednich zestawów danych na rysunku 5, schemat podejmowania decyzji przedstawiony na rysunku 6 może pomóc w skutecznej ocenie strategii ekstrakcji cech dla wielu różnych zbiorów danych. Zbiory danych są klasyfikowane w czterech kolejnych decyzjach, z których każda może obejmować dowolny z czterech odpowiednich celów, a także cztery subiektywne kryteria przedstawione na rys. 4. Na przykład rysunek 6 przedstawia uzasadnienie klasyfikacji każdego z sześciu zestawów danych pokazanych na rysunku 3. Niewątpliwie dla każdego zbioru danych nie ma jednej unikalnej ścieżki, ale raczej różne ścieżki przez tę matrycę według różnych kryteriów podejmowania decyzji, które mogą prowadzić do takich samych lub różnych zaleceń dotyczących segmentacji danych. Chociaż każdy zestaw danych będzie miał swój własny zestaw właściwości, których nie można przewidzieć, podano sześć przykładów, z których każdy jest połączony z wyjaśnieniem przesłanek stojących za preferowanym podejściem do wyodrębniania/segmentacji cech. Większość z nich zawiera również propozycję alternatywnej ścieżki decyzyjnej, która skutkuje zastosowaniem tego samego lub innego podejścia do segmentacji (rys. 6).
Kinokilium to wyraźny zestaw danych z jasno określonymi granicami, co sprawia, że zautomatyzowane podejścia mają większe szanse na sukces. Wszystkie interesujące cechy są dobrze oddzielone, co ponownie faworyzuje podejście zautomatyzowane. Ponadto interesujące nas cechy są do siebie podobne, co sprawia, że jest to stosunkowo jednorodny zestaw danych, idealny do segmentacji dostosowanej do potrzeb klienta. Wreszcie, celem było wyodrębnienie całej funkcji, faworyzując podejście półautomatyczne. W związku z tym stwierdzono, że zarówno zautomatyzowane progowanie (ciągła zielona linia), jak i niestandardowe podejście (np. segmentacja nadzorowana przez kształt) (przerywana zielona linia) prawdopodobnie dobrze poradzią sobie z tym zbiorem danych.
Podobne kryteria, choć umieszczone w innej kolejności w sieci decyzyjnej, mają zastosowanie w przypadku bakterii. Podejście dostosowane do potrzeb klienta jest zalecane częściowo dlatego, że ten zbiór danych był bardzo duży; W związku z tym ograniczone zasoby uniemożliwiają pracochłonną ręczną interwencję/segmentację. Podczas gdy progowanie przyniosłoby akceptowalne wyniki, niestandardowe podejście było w stanie zrealizować kluczowy cel badania, jakim było oddzielenie okrągłych kształtów bakterii od zewnątrzkomórkowych złogów metali, znajdujących się między bakteriami lub tuż obok bakterii, dlatego preferowano podejście dostosowane do potrzeb klienta.
W przypadku zbiorów danych stereocilia pierwszą kwestią był pożądany cel: celem może być albo pokazanie całej gęstości, albo stworzenie modeli geometrycznych. Przedmiotem zainteresowania był zatłoczony obszar, a celem było podzielenie dużej liczby obiektów na odrębne obiekty, aby następnie przeprowadzić ilościową analizę objętościową, w tym długości, liczby, odległości, orientację itp. Pomocne było to, że obiekty zainteresowania były głównie liniowe, co sprawiło, że model geometryczny śledzący metodę był z wyboru. Jeśli jednak celem byłoby pokazanie całej gęstości, wówczas liniowa morfologia cech, jak również stosunkowo wysoki kontrast z ostro zdefiniowanymi granicami, umożliwiłyby zautomatyzowany protokół progowania.
Przypadki danych dotyczących błon komórkowych i mitochondriów stanowią wyzwanie dla zautomatyzowanych podejść ze względu na ich kategorie morfologii cech: odpowiednio zawiłe arkusze i objętości. Celem jest dokładne prześledzenie zarysu komórki lub mitochondriów, ale istnieją tylko ograniczone zasoby, aby to zrobić. Ponadto interesujące nas cechy są złożone i nie mogą być łatwo automatycznie wykryte lub zakodowane w kształcie, chociaż w przypadku zestawów danych mitochondriów niestandardowe podejście skryptowe przyjęte dla bakterii może być ewentualnie zastosowane z dalszym dostosowaniem. Na szczęście sama błona i mitochondria stanowią tylko niewielki ułamek całej objętości, dlatego ręczne śledzenie jest prostym, choć czasochłonnym podejściem. Ręczne śledzenie jest również metodą z wyboru dla takich zestawów danych, gdy kontrast jest raczej niski, a granice są raczej rozmyte. W rezultacie, nawet jeśli stanowią one znaczną część zbiorów danych, takie zawiłe arkusze muszą być śledzone ręcznie, po prostu z powodu braku lepszej alternatywy.
Zbiór danych o roślinach stanowił własne wyzwanie, ponieważ celem była segmentacja wszystkich obiektów, które są gęsto rozmieszczone i tworzą zatłoczoną scenerię. Wyświetlanie gęstości w niezmienionej postaci umożliwiłoby pomiary kształtu i organizacji obiektów, ale ponieważ ręczna segmentacja każdego obiektu nitkowatego jest zbyt kosztowna, zamiast tego zastosowano automatyczne progowanie.
Przedstawiono tutaj różne kroki i odpowiadające im wyniki tworzenia modelu 3D, ale co ważniejsze, wyjaśniono również charakterystykę danych i kryteria osobiste, które okazały się kluczowe w określeniu najlepszej ścieżki segmentacji. Ważnymi cechami samych danych obrazowych są to, co określa się tutaj jako kontrast, zatłoczenie, ostrość oraz liczbę różnych kształtów lub cech (takich jak organelle, włókna, błony). Subiektywne kryteria, które należy wziąć pod uwagę, obejmują pożądany cel segmentacji (pomiar/liczenie, szkieletowa reprezentacja danych/wyświetlanie objętości w renderingach 3D), cechy morfologiczne interesującej cechy (liniowa, wydłużona, usieciowiona, złożona, splotna), gęstość cech będących przedmiotem zainteresowania w stosunku do całej objętości (część obiektów, które są ważne i muszą zostać wyodrębnione), oraz zrównoważenie kompromisów między wydatkowaniem zasobów a wiernością pierwotnych danych segmentacji i malejącemu zwrotowi z inwestycji, co skutkuje stopniowymi ulepszeniami w celu znacznie większej alokacji zasobów.
Dziedzina segmentacji obrazu znacznie dojrzała w ostatnich latach, ale nie ma srebrnej kuli, algorytmu czy programu, który mógłby to wszystko zrobić. Rozmiary zbiorów danych wzrosły z setek megabajtów do rutynowych dziesiątek gigabajtów, a obecnie zaczynają przekraczać terabajty, co sprawia, że ręczna segmentacja jest prawie niemożliwa. W związku z tym należy zainwestować więcej zasobów w sprytne i efektywne czasowo podejścia do ekstrakcji cech, które naśladują proces podejmowania decyzji przez człowieka. Wysiłki te będą musiały być połączone z (1) hierarchicznymi bazami danych opartymi na semantycznym systemie informacji geograficznej (GIS) (podobnymi do Google Earth), (2) technikami abstrakcji danych (tj. przejściem od woksela do reprezentacji geometrycznej/wolumetrycznej) kompatybilnymi z oprogramowaniem do projektowania wspomaganego komputerowo (CAD) w celu znacznego zmniejszenia ilości danych, a tym samym umożliwienia wyświetlania większych objętości35, (3) techniki symulacyjne, ponieważ są one często stosowane w dyscyplinach inżynieryjnych, a także (4) zaawansowane możliwości w zakresie animacji i tworzenia filmów, w tym animacje z lotu ptaka (podobne do tych, które są opracowywane dla branży gier).
Nie ulega wątpliwości, że efektywna ekstrakcja i segmentacja cech leży u podstaw nadchodzącej rewolucji w obrazowaniu komórkowym w wysokiej rozdzielczości i chociaż zawsze potrzebne będą lepsze podejścia, przedstawione tutaj zasady, a także przykłady tego, jakie podejście zostało przyjęte dla różnych typów danych, dostarczą cennych informacji do podjęcia decyzji o tym, które podejście należy przyjąć.
Oświadczenia
Autorzy deklarują, że nie mają konkurencyjnych interesów finansowych.
Podziękowania
Chcielibyśmy podziękować Tomowi Goddardowi z Uniwersytetu Kalifornijskiego w San Francisco za jego niekończącą się pomoc dla Chimery, Joelowi Mancuso i Chrisowi Boothowi z Gatan, Inc. za ich pomoc w zbieraniu danych SBF-SEM z zestawu danych o bakteriach, Dougowi Wei z Zeiss, Inc. za pomoc w zbieraniu danych FIB-SEM z zestawu danych komórek nabłonkowych, Kent McDonald z Laboratorium Mikroskopii Elektronowej Uniwersytetu Kalifornijskiego w Berkeley za porady dotyczące przygotowania próbek, obrazowania TEM i tomografii, Roseann Csencsits z Lawrence Berkeley National Laboratory za pomoc w wykonaniu obrazu krio-TEM, Elena Bosneaga za kriosekcję zestawu danych roślinnych, Jocelyn Krey z Oregon Health and Science University za sekcję tkanki łagiewki, David Skinner z National Energy Research Scientific Computing Center (NERSC) i Jitendra Malik z University of California Berkeley za porady dotyczące infrastruktury oprogramowania oraz Pablo Arbelaez z Uniwersytetu Kalifornijskiego w Berkeley za jego wkład w kody do niestandardowego skryptu przedstawionego w tym artykule.
Badania były wspierane przez Departament Energii Stanów Zjednoczonych, Biuro Nauki na podstawie umowy nr. DE-AC02-05CH11231 [David Skinner], a także grant Narodowych Instytutów Zdrowia Stanów Zjednoczonych (NIH) nr P01 GM051487 [M.A.] do projektu komórek rzęsatych ucha wewnętrznego i zastosowania w mikroskopii.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Nauk Wizualizacji | Amira | http://www.vsg3d.com/amira/overview | |
| Chimera | UCSF | http://www.cgl.ucsf.edu/chimera/ | |
| Fidżi/ImageJ | Narodowy Instytut Zdrowia | http://fiji.sc/Fiji, http://rsbweb.nih.gov/ij/ | |
| IMOD | Boulder Laboratory for 3D Electron Microscopy of Cells | http://bio3d.colorado.edu/imod/ | |
| Photoshop | Adobe | http://www.adobe.com/products/ photoshopfamily.html | |
| MATLAB | MathWorks | http://www.mathworks.com/ | |
| VLFeat | VLFeat | http://www.vlfeat.org/ |
Bibliografia
- Auer, M. Three-dimensional electron cryo-microscopy as a powerful structural tool in molecular medicine. J Mol Med (Berl). 78 (4), 191-202 (2000).
- Johnson, M. C., Rudolph, F., Dreaden, T. M., Zhao, G., Barry, B. A., Schmidt-Krey, I. Assessing two-dimensional crystallization trials of small membrane proteins for structural biology studies by electron crystallography. Journal of visualized experiments JoVE. (44), e1846(2010).
- Jun, S., Zhao, G., Ning, J., Gibson, G. A., Watkins, S. C., Zhang, P. Correlative microscopy for 3D structural analysis of dynamic interactions. Journal of visualized experiments JoVE. (76), e50386(2013).
- Meng, X., Zhao, G., Zhang, P. Structure of HIV-1 capsid assemblies by cryo-electron microscopy and iterative helical real-space reconstruction. Journal of visualized experiments JoVE. (54), e3041(2011).
- Chen, S., McDowall, A., et al. Electron Cryotomography of Bacterial Cells. Journal of visualized experiments JoVE. (39), e1943(2010).
- Meyerson, J. R., White, T. A., et al. Determination of molecular structures of HIV envelope glycoproteins using cryo-electron tomography and automated sub-tomogram averaging. Journal of visualized experiments JoVE. (58), e2770(2011).
- Lucic, V., Forster, F., Baumeister, W. Structural studies by electron tomography: from cells to molecules. Annu Rev Biochem. 74, 833-865 (2005).
- Bajaj, C., Yu, Z., Auer, M. Volumetric feature extraction and visualization of tomographic molecular imaging. J Struct Biol. 144 (1-2), 132-143 (2003).
- Lin, G., Adiga, U., Olson, K., Guzowski, J. F., Barnes, C. A., Roysam, B. A hybrid 3D watershed algorithm incorporating gradient cues and object models for automatic segmentation of nuclei in confocal image stacks. Cytometry A. 56 (1), 23-36 (2003).
- Volkmann, N. A novel three-dimensional variant of the watershed transform for segmentation of electron density maps. Journal of Structural Biology. 138 (1), 123-129 (2002).
- Rigort, A., Günther, D., et al. Automated segmentation of electron tomograms for a quantitative description of actin filament networks. Journal of structural biology. 177 (1), 135-144 (2012).
- Cremers, D., Rousson, M., Deriche, R. A Review of Statistical Approaches to Level Set Segmentation. Integrating Color, Texture, Motion and Shape. International Journal of Computer Vision. 72 (2), 195-215 (2007).
- Lin, Z., Davis, L. S. Shape-based human detection and segmentation via hierarchical part-template matching. IEEE Trans Pattern Anal Mach Intell. 32 (4), 604-618 (2010).
- Pettersen, E. F., Goddard, T. D., et al. UCSF Chimera--a visualization system for exploratory research and analysis. J Comput Chem. 25 (13), 1605-1612 (2004).
- Kremer, J. R., Mastronarde, D. N., McIntosh, J. R. Computer visualization of three-dimensional image data using IMOD. J Struct Biol. 116 (1), 71-76 (1996).
- Zhang, Q., Bettadapura, R., Bajaj, C. Macromolecular structure modeling from 3D EM using VolRover 2.0. Biopolymers. 97 (9), 709-731 (2012).
- Giannuzzi, L. A., Stevie, F. A. A review of focused ion beam milling techniques for TEM specimen preparation. Micron. 30 (3), 197-204 (1999).
- Heymann, J. A. W., Hayles, M., Gestmann, I., Giannuzzi, L. A., Lich, B., Subramaniam, S. Site-specific 3D imaging of cells and tissues with a dual beam microscope. Journal of structural biology. 155 (1), 63-73 (2006).
- Knott, G., Rosset, S., Cantoni, M. Focussed ion beam milling and scanning electron microscopy of brain tissue. Journal of visualized experiments JoVE. (53), e2588(2011).
- Wirth, R. Focused Ion Beam (FIB) combined with SEM and TEM: Advanced analytical tools for studies of chemical composition, microstructure and crystal structure in geomaterials on a nanometre scale. Chemical Geology. 261 (3-4), 217-229 (2009).
- Denk, W., Horstmann, H. Serial block-face scanning electron microscopy to reconstruct three-dimensional tissue nanostructure. PLoS Biol. 2 (11), e329(2004).
- Frangakis, A. S., Hegerl, R. Noise reduction in electron tomographic reconstructions using nonlinear anisotropic diffusion. Journal of structural biology. 135 (3), 239-250 (2001).
- Jiang, W., Baker, M. L., Wu, Q., Bajaj, C., Chiu, W. Applications of a bilateral denoising filter in biological electron microscopy. Journal of Structural Biology. 144 (1), 114-122 (2003).
- Van der Heide, P., Xu, X. P., Marsh, B. J., Hanein, D., Volkmann, N. Efficient automatic noise reduction of electron tomographic reconstructions based on iterative median filtering. Journal of structural biology. 158 (2), 196-204 (2007).
- Schneider, C. A., Rasband, W. S., Eliceiri, K. W. NIH Image to ImageJ: 25 years of image analysis. Nat Methods. 9 (7), 671-675 (2012).
- Schindelin, J., Arganda-Carreras, I., et al. Fiji: an open-source platform for biological-image analysis. Nat Methods. 9 (7), 676-682 (2012).
- MathWorks. MATLAB. , (2012).
- Otsu, N. A Threshold Selection Method from Gray-Level Histograms. Systems, Man and Cybernetics, IEEE Transactions on. 9, 62-66 (1979).
- Vedaldi, A., Fulkerson, B. VLFeat: An Open and Portable Library of Computer Vision Algorithms. , (2008).
- Zhu, S. C., Guo, C., Wang, Y., Xu, Z. What are Textons? International Journal of Computer Vision. 62 (1-2), 121-143 (2005).
- Gagnon, L. H., Longo-Guess, C. M., et al. The chloride intracellular channel protein CLIC5 is expressed at high levels in hair cell stereocilia and is essential for normal inner ear function. The Journal of neuroscience the official journal of the Society for Neuroscience. 26 (40), 10188-10198 (2006).
- Briand, P., Petersen, O. W., Van Deurs, B. A new diploid nontumorigenic human breast epithelial cell line isolated and propagated in chemically defined medium. In vitro cellular & developmental biology journal of the Tissue Culture Association. 23 (3), 181-188 (1987).
- Petersen, O. W., Rønnov-Jessen, L., Howlett, A. R., Bissell, M. J. Interaction with basement membrane serves to rapidly distinguish growth and differentiation pattern of normal and malignant human breast epithelial cells. Proceedings of the National Academy of Sciences of the United States of America. 89 (19), 9064-9068 (1992).
- Shin, J. B., Krey, J. F., et al. Molecular architecture of the chick vestibular hair bundle. Nature neuroscience. 16 (3), 365-374 (2013).
- Yang, W., Zeng, Z., Max, N., Auer, M., Crivelli, S. Simplified Surface Models of Tubular Bacteria and Cytoskeleta. Journal of Information & Computational Science. 9 (6), 1589-1598 (2012).
Przedruki i uprawnienia
