Ten manuskrypt opisuje protokoły kliniczne dla dwóch paneli sekwencjonowania nowej generacji. Jeden panel bada nowotwory hematologiczne, podczas gdy drugi panel koncentruje się na genach powszechnie zmutowanych w guzach litych. Klasyfikacja molekularna mutacji powodujących nowotwory złośliwe u ludzi dostarcza cennych informacji prognostykujących i predykcyjnych.
Artykuł metodologiczny
Sekwencjonowanie nowej generacji do wykrywania mutacji, które można podjąć w celu działania, w guzach litych i płynnych
W tym artykule
Podsumowanie
Streszczenie
W miarę jak poprawia się nasze zrozumienie mutacji powodujących inicjację i progresję nowotworów, uzyskujemy kluczowe informacje na temat tego, jak określone profile molekularne guza mogą przewidywać reakcję na środki terapeutyczne lub dostarczać wiedzy na temat rokowania. W naszej placówce ustanowiono program genotypowania nowotworów w ramach rutynowej opieki klinicznej, badając zarówno guzy hematologiczne, jak i lite pod kątem szerokiego spektrum mutacji przy użyciu dwóch paneli sekwencjonowania nowej generacji (NGS): niestandardowego, 33-genowego panelu nowotworów hematologicznych do stosowania z krwią obwodową i szpikiem kostnym oraz komercyjnie produkowanego panelu guzów litych do stosowania z tkanką zatopioną w parafinie utrwalonej w formalinie, która jest ukierunkowana na 47 genów powszechnie zmutowanych w raku. Nasz przepływ pracy obejmuje przegląd biopsji przez patologa, aby upewnić się, że jest odpowiednia ilość guza do testu, a następnie przeprowadzana jest dostosowana ekstrakcja DNA na próbce. Kontrola jakości próbki obejmuje etapy dotyczące ilości, jakości i integralności, a dopiero po tym, jak wyekstrahowane DNA przejdzie te wskaźniki, generowana jest i sekwencjonowana biblioteka amplikonów. Uzyskane dane są analizowane za pomocą wewnętrznego systemu bioinformatycznego, a warianty są przeglądane i interpretowane pod kątem patogenności. W tym miejscu przedstawiamy migawkę użyteczności każdego panelu na przykładzie dwóch przypadków klinicznych, aby zapewnić wgląd w to, w jaki sposób dobrze zaprojektowany przepływ pracy NGS może przyczynić się do optymalizacji wyników klinicznych.
Wprowadzenie
Sekwencjonowanie następnej generacji (NGS) próbek onkologicznych stało się w ostatnich latach bardziej dostępne, ponieważ coraz obszerniejsza literatura naukowa wskazuje na znaczenie identyfikacji celowanych zmian genetycznych oraz predykcyjnych i prognostycznych markerów molekularnych. Analizy paneli wielogenowych oraz badania sekwencjonowania całego egzomu w przypadku nowotworów nabłonkowych1,2 i hematologicznych3 ugruntowały koncepcję heterogeniczności guza oraz ewolucji klonalnej w miarę postępu i nawrotów choroby. Ponadto, w przeciwieństwie do konkurencyjnych technologii, takich jak reakcja łańcuchowa polimerazy (PCR) czy sekwencjonowanie metodą Sangera, NGS pozwala na wykrycie większości alteracji genomicznych we wszystkich istotnych klinicznie genach nowotworowych w ramach jednego badania4.
Centrum Diagnostyki Personalizowanej zostało początkowo uruchomione z dwoma klinicznymi panelami NGS: dedykowanym panelem hematologicznym (Heme-NGS Panel) oraz gotowym panelem nowotworowym dla próbek FFPE (Solid-NGS Panel) (patrz Rysunek 1). Panele te obejmują klinicznie istotne lub szczególnie interesujące regiony wybranych genów; nie wszystkie geny lub egzony są pokryte w całości. Amplikony są generowane poprzez hybrydyzację sond, a następnie elongację i ligację. Regiony docelowe są dalej amplifikowane za pomocą PCR z użyciem uniwersalnych starterów z podwójnym indeksem, co pozwala na łączenie do 96 próbek w jednej puli do sekwencjonowania.
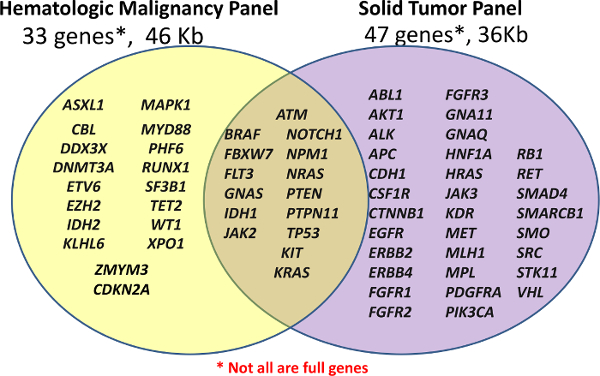
Rysunek 1: Lista genów objętych panelami. Przygotowanie biblioteki przeprowadza się przy użyciu niestandardowego panelu hematologicznego (Heme-NGS Panel) obejmującego 33 geny lub gotowego panelu amplikonowego do nowotworów (Solid-NGS) obejmującego 47 genów. Nie wszystkie geny lub eksony są pokryte w całości, ponieważ niektóre amplikony mogą obejmować jedynie określone regiony hotspot. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Zawartość panelu Heme-NGS została opracowana na podstawie wielu źródeł, jednak koncentruje się ona na 16 genach zmutowanych w ostrej białaczkach szpikowej (AML), które wcześniej opisano jako wykazujące wysoką użyteczność kliniczną5. Panel Solid-NGS jest produkowany komercyjnie, a obszary docelowe oparto na genach często mutujących w nowotworach, zgodnie z informacjami zawartymi w bazie danych Catalogue of Somatic Mutations in Cancer (COSMIC)6.
Cały proces pracy w przypadku klinicznego NGS charakteryzuje się kilkoma kluczowymi etapami. Po zleceniu testu przez lekarza klinicystę, patomorfolog ocenia odpowiedniość materiału, analizując procentową zawartość nowotworu oraz objętość próbki. W naszej instytucji wymagamy co najmniej 10% tkanki nowotworowej ze względu na poziom błędu sekwencjonowania w tle („szum”) danej technologii oraz wydajność podejścia celowanego. Jeśli tkanka jest odpowiednia do badań, ekstrahowane jest genomowe DNA. Następnie DNA to poddawane jest wielokrotnym etapom kontroli jakości (QC). Jeśli DNA przejdzie kontrolę jakości, generowana i sekwencjonowana jest biblioteka amplikonów. Uzyskane dane są analizowane za pomocą wewnętrznego potoku bioinformatycznego. Po analizie bioinformatycznej warianty są ręcznie przeglądane i interpretowane pod kątem patogenności przed włączeniem ich do raportu klinicznego. Poniżej opisujemy dwa przypadki, które przeszły przez ten rygorystyczny proces i w konsekwencji doprowadziły do zmian w postępowaniu klinicznym.
Przypadek 1 – Ostra białaczka szpikowa
Biopsja szpiku kostnego pacjentki A potwierdziła rozpoznanie AML bez dojrzewania. Badania cytogenetyczne przeprowadzone na materiale z szpiku kostnego wykazały prawidłowy kariotyp żeński. Stwierdzono obecność 95% krążących blastów, w związku z czym pobrano próbkę krwi obwodowej do spersonalizowanej diagnostyki z wykorzystaniem panelu Heme-NGS.
Ostra białaczka szpikowa (AML) jest nowotworem hematologicznym linii mieloidalnej białych krwinek. Wykrywanie mutacji genowych w AML stało się coraz ważniejsze dla rokowań i leczenia, a nawracające mutacje genowe uznaje się za istotne w patogenezie i prognozowaniu przebiegu choroby7. Mutacje w genach NPM1 i CEBPA wiążą się z korzystnym ryzykiem prognostycznym, podczas gdy wewnętrzne duplikacje tandemowe (ITD) w genie FLT3 wiążą się z mniej korzystnym wynikiem8. Rosnąca liczba dowodów potwierdza patogenny wpływ tych oraz innych mutacji w AML9.
Przypadek 2 – gruczolak płuca
Biopsja masy nadobojczykowej lewej u pacjenta B wykazała gruczolakoraka płuca. Materiał biopsyjny z utrwalonego w formalinie i zatopionego w parafinie (FFPE) węzła chłonnego został wysłany do badań genomicznych (panel Solid-NGS) w formie zwitek/rolki z zawartością guza powyżej 50%, aby zidentyfikować obecność mutacji umożliwiającej celowaną interwencję terapeutyczną.
Rak płuca jest główną przyczyną śmiertelności z powodu nowotworów w Stanach Zjednoczonych i dzieli się na dwa główne typy: niedrobnokomórkowego raka płuca (NSCLC) oraz drobnokomórkowego raka płuca (SCLC). NSCLC można dalej zdefiniować jako gruczolak lub raka płaskonabłonkowego, w zależności od histologii zmiany. Gruczolak płuca jest najczęstszym podtypem raka płuca, występującym zarówno u palaczy, jak i osób niepalących, i stanowi najczęstszą postać raka płuca u osób niepalących10. Badania molekularne gruczolaków płuca zidentyfikowały mutacje w wielu onkogenach11. Najczęstszymi mutacjami sterującymi zidentyfikowanymi u palaczy są mutacje w KRAS i BRAF. Najczęstszymi mutacjami u osób niepalących są mutacje w EGFR oraz rearanżacje obejmujące geny ALK, RET i ROS1. Opisano guzy płuca z insercją wewnątrzramową w eksonie 20 genu ERBB2 (HER2/neu). Najczęstszą nieprawidłowością w HER2/neu jest amplifikacja tego locus w raku piersi, dla której dostępna jest terapia celowana (trastuzumab: upodobnione przeciwciało monoklonalne przeciwko HER2/neu). Insercja w eksonie 20 HER2/neu, obserwowana w 2 - 4% gruczolaków płuca12, wykazała częściową odpowiedź na terapię skojarzoną inhibitorami HER2/neu i mTOR (odpowiednio neratynibem i temsirolimusem)13.
Protokół
Niniejszy protokół obejmuje kluczowe etapy dwóch zwalidowanych testów opracowanych w laboratorium, służących odpowiednio do profilowania genomicznego guzów ciał stałych oraz biopsji płynnych. Badania przeprowadzane w laboratorium są realizowane zgodnie z wymogami Clinical Laboratory Improvement Amendments (CLIA) z 1988 roku.
1. Izolacja DNA z krwi obwodowej lub szpiku kostnego
- Określ ilość krwi lub szpiku kostnego do pobrania na podstawie Tabeli 1.
| Próbka/WBC | Ilość traktowana jako 1 ml krwi |
| Szpik kostny | 250 μl |
| Liczba leukocytów we krwi 12 000 – 50 000 | 1 ml |
| Liczba białych krwinek (WBC) we krwi: 50 000 – 100 000 | 500 μl |
| Liczba WBC we krwi 100 000 – 200 000 | 200 μl |
| Białe krwinki (WBC) > 200,000 | 100 μl |
| * Dla leukocytów krwi (WBC) < 12 000, pobrać 2 ml krwi | |
Tabela 1: Tabela wyboru objętości krwi/szpiku kostnego. Ponieważ liczba białych krwinek różni się w zależności od próbki, trudno jest określić konkretną objętość krwi do wykorzystania. Dlatego ilość krwi do analizy musi zostać ustalona na podstawie liczby białych krwinek (WBC) przed rozpoczęciem badania. Mimo wykorzystania mniejszej ilości krwi, należy ją traktować tak, jakby była to objętość 1 ml, ponieważ objętość krwi jest zmniejszana w przypadku, gdy liczba obecnych komórek jest wyższa od normy.
- Postępuj zgodnie z protokołem dołączonym do komercyjnego zestawu w celu izolacji DNA genomowego.
2. Ekstrakcja DNA z tkanek utrwalonych w formalinie i zatopionych w parafinie (FFPE)
- Na podstawie obszaru guza zaznaczonego przez patologa na preparacie barwionym H&E, dopasuj niebarwione preparaty do prowadzącego preparatu H&E i wyznacz podobny obszar do ekstrakcji. W przypadku makrodysekcji przetwarzaj tylko jeden zestaw preparatów od jednego pacjenta/próbki jednocześnie.
- Podgrzej preparaty na bloku grzejnym o temperaturze 45 °C, aby lekko roztopić parafinę. Ostrożnie zeskrob tkankę w obrębie wyznaczonych linii na preparacie, używając nowego skalpela dla każdej ekstrahowanej próbki. Wióry woskowe umieść w odpowiednio oznakowanej probówce 1,5 ml. Zachowaj ostrożność, ponieważ zeskrobiony wosk jest silnie elektrostatyczny i może wyskoczyć z probówki.
- Dodaj 320 µl roztworu do deparafinyzacji na każde pięć do sześciu skrawków o grubości 5 µm (łącznie 25 - 30 µm). Na przykład, jeśli przetwarzana jest probówka zawierająca 3 skrawki z rolki/zwój o grubości 10 µm, użyj 320 µl, ale jeśli uzyskano 5 skrawków o tej samej grubości, użyj 640 µl.
- Mieszaj intensywnie na wirówce typu vortex przez co najmniej 10 s, a następnie wykonaj krótkie wirowanie w mikrocentry fudze, aby przenieść tkankę i wosk ze ścianek oraz zakrętki do roztworu. Inkubuj w temperaturze 56 °C przez 3 min, a następnie w temperaturze pokojowej (RT) przez 5 - 10 min.
- Po inkubacji w RT dodaj 180 µl buforu ATL na każde 320 µl dodanego roztworu do deparafinyzacji. Rozdrobnij tkankę dziesięciokrotnie za pomocą sterylnego minipestle, używając nowego pestle dla każdej próbki. Upewnij się, że do pestle nie przywarła tkanka, ponieważ może być ona bardzo lepka. Mieszaj zawiesinę intensywnie na vortexie przez 3 s, a następnie wiruj z maksymalną prędkością przez 1 min.
- Dodaj 10 µl Proteinazy K do dolnej, klarownej fazy. Wymieszaj delikatnie, pipetując w górę i w dół, aby zapewnić ponowną zawieszenie tkanki. NIE używaj vortexu. Inkubuj w temperaturze 56 °C przez noc z wstrząsaniem przy 400 - 500 rpm.
- Następnego dnia sprawdź, czy tkanka została całkowicie rozpuszczona (dzieje się tak, gdy dolny roztwór jest klarowny). Jeśli dolny roztwór nie jest klarowny, wymieszaj intensywnie na vortexie przez 3 s i wiruj z maksymalną prędkością przez 1 min. Dodaj dodatkowe 5 - 10 µl Proteinazy K i inkubuj w temperaturze 56 °C przez kolejne 30 - 60 min.
- Inkubuj w temperaturze 90 °C przez 1 h, aby pomóc w odwróceniu sieciowania formaldehydem. Pozostaw próbki do ostygnięcia do temperatury pokojowej przez 5 - 10 min, a następnie krótko wiruj każdą probówkę, aby zgromadzić ciecz.
- Przenieś dolną klarowną fazę do oznakowanej probówki 1,5 ml. Jeśli z jednej próbki pacjenta pochodzi kilka probówek (np. w przypadku użycia wielu rolek), połącz w tym momencie dolne fazy w jednej probówce. Uwaga: Przeniesienie niewielkich ilości roztworu do deparafinyzacji nie powinno zakłócić procedury oczyszczania, jednak istnieje ryzyko w przypadku przeniesienia dużej ilości.
- Dodaj 2 µl roztworu RNazy A. Mieszaj delikatnie na vortexie lub odwróć probówkę 25 razy i wykonaj krótkie wirowanie w mikrocentry fudze. Inkubuj w temperaturze RT przez 5 min.
- Dodaj 200 µl roztworu do wytrącania białek. W przypadku jednej lub dwóch rolek użyj 200 µl. W przypadku trzech rolek jednocześnie użyj 400 µl. Mieszaj intensywnie na vortexie z wysoką prędkością przez 30 s, aby jednorodnie wymieszać bufory lizy. Inkubuj na lodzie przez 5 min (próbki mogą pozostać na lodzie do 1 h).
- Wiruj przy 5 000 x g przez 5 min. Wytrącone białko powinno utworzyć zwarty, biały osad. Przelej nadsącz do oznakowanej probówki 1,5 ml, a następnie inkubuj próbki na lodzie przez co najmniej 3 min. Wiruj przy 5 000 x g przez 3 min.
- Dodaj 200 µl 2-propanolu (izopropanolu) na każde 180 µl buforu ATL dodanego wcześniej do oznakowanej probówki 1,5 ml (może być konieczne użycie probówki 2 ml). Na przykład, przy trzech rolkach dodaj 600 µl izopropanolu. Dodaj 1 µl glikogenu na każde 180 µl buforu ATL dodanego wcześniej do izopropanolu i kilkakrotnie odwróć probówkę, aby wymieszać.
- Ostrożnie dodaj nadsącz z etapu wytrącania białek do mieszaniny izopropanolu. Wymieszaj zawartość probówki, delikatnie odwracając ją co najmniej 50 razy.
- Wiruj z maksymalną prędkością przez 3 min. DNA będzie widoczne jako mały biały osad na dnie probówki.
- Zlej lub odessaj nadsącz do odpowiedniej probówki z odpadami. Zachowaj oddzielną probówkę 1,5 ml na odpady dla każdej próbki na wypadek oderwania się osadu, aby nie został on utracony ani zmieszany z odpadami z innych próbek. Osusz probówkę na ręczniku papierowym, upewniając się, że większość izopropanolu została usunięta.
- Dodaj 300 µl świeżo przygotowanego 70% etanolu. Delikatnie odwróć probówkę kilka razy, aby wypłukać osad. Staraj się doprowadzić do oderwania się osadu, aby zapewnić dokładniejsze oczyszczenie.
- Wiruj z maksymalną prędkością przez 5 min, a następnie ostrożnie usuń etanol. Osad może być luźny, dlatego zlewaj lub odsysaj powoli, obserwując osad. Usuń nadmiar etanolu ze ścianek probówki, nie dotykając osadu. Pozostaw próbki do wyschnięcia na powietrzu przez 5 - 15 min, uważając, aby nie przesuszyć próbki.
- Dodaj od 25 do 100 µl roztworu do hydratacji DNA do każdej próbki, w zależności od wielkości osadu DNA i początkowej ilości tkanki. Mieszaj probówki intensywnie na vortexie i krótko wiruj w mikrocentry fudze. Inkubuj przez 1 h w temperaturze 65 °C, aby w pełni rehydratować DNA.
3. Kontrola jakości genomowego DNA
Uwaga: Kontrola jakości (QC) DNA składa się z trzech niezależnych etapów. Szczegółowe wyjaśnienie celu każdego etapu QC znajduje się w Tabeli 2.
| Instrument | Wynik | Wskazanie | Zakres optymalny |
| DropSense96 | A260/A230 | Identyfikacja zanieczyszczeń chemicznych (np. etanol) | 1.50 – 2.2 |
| DropSense96 | A260/A280 | Identyfikacja zanieczyszczeń białkowych | 1.60 – 2.2 |
| DropSense96 | Stężenie | Ilościowe oznaczanie DNA | > 1 ng/µProszę podać tekst źródłowy do przetłumaczenia. |
| TapeStation | Rozmaz DNA | Oznaczanie integralności DNA (np., degradacja/fragmentacja wyekstrahowanego DNA) | 50% > 1 000 bp |
| Qubit 2.0 | Stężenie | Bardziej precyzyjna kwantyfikacja DNA | > 1 ng/µl |
Tabela 2: Oczekiwane wyniki kontroli jakości DNA. Wszystkie te wartości są brane pod uwagę przed dopuszczeniem próbki do etapu przygotowania biblioteki.
- Zgodnie z protokołem producenta, analizuj 2 µl wyekstrahowanego DNA za pomocą fluorometru, aby określić stężenie robocze (ng/µl) próbki.
- Analizuj 1 - 2 µl każdej próbki na spektrofotometrze UV/VIS, aby sprawdzić jakość próbki (stosunki A260/A230 oraz A260/A280) zgodnie z instrukcjami producenta.
- W przypadku próbek FFPE: Zgodnie z instrukcjami producenta, analizuj 1 µl każdej próbki w mikrofluidycznym systemie elektroforezy żelowej w celu oceny degradacji/fragmentacji DNA. Przykłady przedstawiono na Rysunku 2.
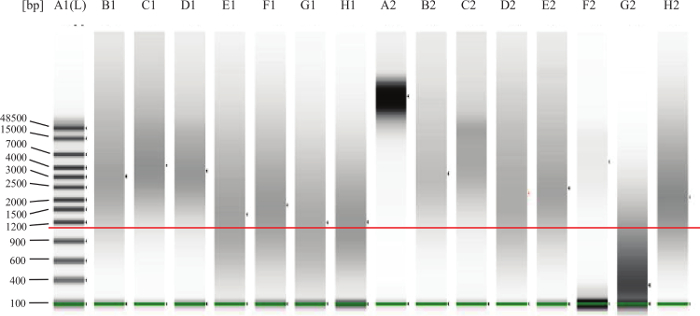
Rysunek 2: Przykład żelu do kontroli jakości genomowego DNA. Zielona linia nad dolnymi prążkami wskazuje dolny marker. Dodana czerwona linia wskazuje przybliżony rozmiar 1 000 bp. Ścieżka A2 przedstawia w pełni nienaruszony DNA, czego można oczekiwać w przypadku świeżej tkanki.pozwać (np., krwi obwodowej lub szpiku kostnego). Ścieżki B1, C1, D1, B2, C2, E2 są przykładami wysokiej jakości, nienaruszonego DNA z materiału FFPE. DNA w ścieżce F2 wydaje się być nienaruszone, lecz jego stężenie jest zbyt niskie. DNA w ścieżce G2 jest zdegradowane lub pofragmentowane i nie będzie nadawać się do analizy. Ścieżki E1, F1, G1, H1, D2, H2 reprezentują DNA znajdujące się w tzw. „szarej strefie”, co oznacza, że analiza może przebiec pomyślnie, ale część DNA może być zbyt uszkodzona lub sieciowana, przez co nie będzie ona dawać dobrych wyników. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej figury.
4. Przygotowanie biblioteki amplikonów
- Hybrydyzacja puli oligonukleotydów oraz elongacja i ligacja związanych oligonukleotydów
- W pomieszczeniu Pre-PCR do każdej odpowiadającej studni w półobramowanej płytce 96-dołkowej, oznaczonej jako płytka do hybrydyzacji (HYB), dodać odpowiednią objętość Low EDTA TE, 5 µl z probówki z oligonukleotydami panelu (np. Panel Solid-NGS lub Panel Heme-NGS) oraz 100 - 250 ng genomicznego DNA.
- Do każdej próbki w płytce HYB dodać 40 µl odczynnika do hybrydyzacji oligonukleotydów do sekwencjonowania 1 (OHS1). Delikatnie pipetować w górę i w dół co najmniej 5 - 6 razy w celu wymieszania. Wymieniać końcówki po każdej kolumnie, aby uniknąć kontaminacji krzyżowej.
- Uszczelnić płytkę HYB aluminiową folią samoprzylepną i odwirować przy 1,000 x g przez 30 sek.
- Inkubować płytkę HYB w wstępnie podgrzanym inkubatorze do hybrydyzacji w temperaturze 95 °C przez 1 min. Ustawić temperaturę inkubatora do hybrydyzacji na 40 °C. Kontynuować inkubację do momentu, aż temperatura w inkubatorze spadnie z 95 °C do 40 °C (~ 90 min). Uwaga: Stopniowe chłodzenie jest kluczowe dla prawidłowej hybrydyzacji.
- Podczas ostatnich 15 - 20 min inkubacji hybrydyzacyjnej przeprowadzić wstępne przemywanie jednostki płytki filtrującej (FPU). Przygotować tylko te studnie, które zostaną użyte w bieżącym badaniu, tj. użyć tylko świeżych/nieużywanych studni z wcześniej otwartej płytki filtrującej; nigdy nie używać ponownie studni, które były już wykorzystane. Uwaga: Powinno to być jednoznaczne na podstawie numeru zestawu na płytce filtrującej, oznaczeń na płytce oraz użytego uszczelnienia całej płytki.
- Za pomocą pipety wielokanałowej dodać 45 µl buforu do rygorystycznego przemywania 1 (SW1) do każdej studni.
OSTROŻNIE: Zawiera formamid. Przykryć i odwirować FPU przy 2,250 x g przez 3 min w temperaturze 20 °C. Sprawdzić każdą studnię pod kątem obecności resztkowej cieczy (> 15 µl/studnię). - Jeśli ciecz resztkowa występuje, obrócić FPU o 180° i powtórzyć etap wirowania przez kolejne 3 min. Jeśli ciecz resztkowa zostanie usunięta podczas drugiego wirowania, przejść do następnego kroku; w przeciwnym razie płytka filtrująca może być wadliwa i wymaga wymiany.
- Za pomocą pipety wielokanałowej dodać 45 µl buforu do rygorystycznego przemywania 1 (SW1) do każdej studni.
- Po ochłodzeniu inkubatora do hybrydyzacji do 40 °C, odwirować płytkę przy 1,000 x g przez co najmniej 30 sek w temperaturze 20 °C w celu zebrania kondensatu. Przenieść całą objętość każdej próbki z płytki HYB na środek odpowiednich, wstępnie przemytych studni FPU. Wymieniać końcówki po każdej kolumnie, aby uniknąć kontaminacji krzyżowej. Przykryć FPU i odwirować przy 2,250 x g przez 3 min w temperaturze 20 °C.
- Dodać 45 µl SW1 i odwirować przy 2,250 x g przez 3 min w temperaturze 20 °C. Powtórzyć czynność łącznie dwa razy. Obrócić FPU o 180° i ponownie odwirować przy 2,250 x g przez 3 min, aby całkowicie usunąć SW1.
- Zdemontować FPU. Cały przesącz (zawierający formamid) wylać do odpowiedniego pojemnika na odpady. Ponownie złożyć FPU, używając innej płytki do zbierania odpadów MIDI Waste Collection Plate. Dodać 45 µl uniwersalnego buforu 1 (UB1) do każdej studni z próbką i odwirować przy 2,250 x g przez 3 min w temperaturze 20 °C. OSTROŻNIE: Zawiera formamid.
- Dodać 45 µl mieszaniny do elongacji i ligacji 3 (ELM3) do każdej studni z próbką na płytce FPU i pipetować w górę i w dół 3 razy w celu wymieszania. Uwaga: Reakcja elongacji i ligacji zachodzi na membranie płytki filtrującej.
- Uszczelnić płytkę FPU aluminiową folią samoprzylepną i inkubować cały zespół FPU w wstępnie podgrzanym inkubatorze w 37 °C przez 45 min.
- Indeksowanie i amplifikacja PCR
- Rozdzielić indeksy do odpowiednich studni w płytce amplifikacji z indeksami (IAP), rozmieszczając primery w uchwycie do płytek indeksowych w następujący sposób: probówki z primerami i5 (białe zakrętki, przezroczysty roztwór) pionowo, wyrównane z rzędami od A do H; probówki z primerami i7 (pomarańczowe zakrętki, żółty roztwór) poziomo, wyrównane z kolumnami od 1 do 12. Za pomocą wielokanałowej pipety p10 dodać 4 µl primerów i7 (żółty roztwór) do każdego rzędu IAP oraz 4 µl primerów i5 (przezroczysty roztwór) do każdej kolumny IAP.
- Na lodzie lub bloku chłodzącym przygotować Master Mix PCR, dodając 0,5 µl polimerazy DNA 1 (TDP1) do 25 µl PCR Master Mix 2 (PMM2) na próbkę. Odwrócić, krótko wymieszać w wirówce (vortex) i krótko odwirować Master Mix PCR w celu wymieszania.
- Dodać 22 µl Master Mix PCR do każdej studni IAP i pipetować w górę i w dół 3 razy w celu wymieszania. Wymieniać końcówki między studniami. Przechowywać IAP w 4 °C.
- Po 45-minutowej reakcji elongacji i ligacji (krok 4.1.10), wyjąć FPU z inkubatora i ostrożnie usunąć aluminiową folię uszczelniającą. Przykryć pokrywką i odwirować przy 2,250 x g przez 3 min w temperaturze 20 °C.
- Dodać 25 µl 50 mM NaOH do każdej studni z próbką w FPU. Pipetować w górę i w dół co najmniej 6 razy; upewnić się, że końcówki pipety stykają się z membraną. Wymieniać końcówki po każdej kolumnie. Inkubować w temperaturze pokojowej przez 5 min.
- Przenieść próbki eluowane z FPU do IAP w następujący sposób:
- Za pomocą wielokanałowej pipety p100 ustawionej na 20 µl pipetować NaOH na płytce FPU w górę i w dół co najmniej 6 razy. Lekko przechylić płytkę FPU, aby zapewnić całkowite odessanie z płytki.
- Przenieść 20 µl z FPU do odpowiedniej kolumny IAP. Delikatnie pipetować w górę i w dół co najmniej 6 razy, aby dokładnie połączyć DNA z Master Mix PCR. Uszczelnić IAP folią samoprzylepną i odwirować przy 1,000 x g przez 1 min w temperaturze 20 °C.
- Przenieść płytkę PCR do pomieszczenia Post-PCR i umieścić ją w termocyklerze. Uruchomić program PCR składający się z etapu denaturacji termicznej w 95 °C przez 3 min, po którym następują 25 cykli: 95 °C przez 30 sek, 62 °C przez 30 sek, 72 °C przez 60 sek, a następnie końcowa elongacja w 72 °C przez 5 min, kończąc podtrzymaniem w 10 °C. Jeśli po zakończeniu PCR nie przechodzi się do następnego etapu, płytkę można pozostawić w termocyklerze przez noc lub przechowywać w temperaturze od 2 do 8 °C przez maksymalnie dwa dni.
- Oczyszczanie PCR i normalizacja oparta na kuleczkach
- Wyjąć magnetyczne kuleczki do oczyszczania, bufor do elucji (EBT) oraz odczynniki do elektroforezy żelowej z lodówki 4 °C i pozostawić w temperaturze pokojowej (RT) co najmniej 20 min przed następnym etapem.
- Po zakończeniu PCR odwirować przy 1,000 x g przez 1 min w temperaturze 20 °C w celu zebrania kondensatu. Przenieść 1 µl każdej reakcji PCR do probówek paskowych/studni płytki zawierających 4 µl wody, aby rozcieńczyć próbki 1/5. Pipetować w górę i w dół w celu wymieszania.
- Dodać 2 µl rozcieńczonych próbek po PCR do 2 µl buforu do żelu mikroprzepływowego. Uszczelnić paski/płytkę. Wstrząsać przy 1,800 rpm przez co najmniej 30 sek i odwirować przy 1,000 x g przez 30 sek. Zgodnie z protokołem producenta, przeprowadzić analizę mieszaniny na żelu mikroprzepływowym, aby ocenić, czy przygotowanie biblioteki pozwoliło uzyskać akceptowalną bibliotekę (patrz Rycina 3).
- Wymieszać kuleczki do oczyszczania magnetycznego w wirówce (vortex), aż będą dobrze zawieszone, a kolor stanie się jednorodny. Dodać 45 µl kuleczek do każdej próbki.
- Uszczelnić płytkę przezroczystą folią samoprzylepną i wstrząsać przy 1,800 rpm przez 2 min. Inkubować w temperaturze pokojowej bez wstrząsania przez 10 min.
- Umieścić płytkę na statywie magnetycznym. Po sklarowaniu nadpłynu ostrożnie usunąć i wylać nadpłyn. Jeśli kuleczki zostaną przypadkowo odessane do końcówek, podać je z powrotem na płytkę, pozostawić płytkę na magnesie przez 2 min i potwierdzić, że nadpłyn jest klarowny.
- Przy płytce znajdującej się na statywie magnetycznym dodać 200 µl świeżo przygotowanego 80% etanolu do każdej studni z próbką. Kilka razy przesuwać płytkę w przód i w tył. Inkubować płytkę na statywie magnetycznym przez 30 sek. Ostrożnie usunąć i wylać nadpłyn. Powtórzyć czynność łącznie dwa razy.
- Usunąć nadmiar etanolu poprzez krótkie odwirowanie płytki przy 1,000 x g, aby sprowadzić etanol ze ścianek probówek, ponowne umieszczenie płytki na statywie magnetycznym i użycie wielokanałowej pipety p10 ustawionej na 10 µl do usunięcia etanolu. Pozostawić kuleczki do wyschnięcia na powietrzu przez 5 - 8 min.
- Za pomocą wielokanałowej pipety p100 dodać 30 µl EBT do każdej studni. Pipetować w górę i w dół kilka razy, aby upewnić się, że kuleczki oddzieliły się od ścianek probówki. Uszczelnić płytkę przezroczystą folią samoprzylepną i wstrząsać przy 1,800 rpm przez 2 min.
- Inkubować w temperaturze pokojowej bez wstrząsania przez 3 min. Jeśli istnieją próbki, w których kuleczki nie zostały całkowicie resuspendowane, delikatnie pipetować w górę i w dół, aby je resuspendować.
- Umieścić płytkę na statywie magnetycznym. Za pomocą wielokanałowej pipety p100 przenieść 20 µl nadpłynu do całkowicie nowej płytki, zwanej Płytką do Normalizacji Biblioteki (LNP). Przenieść pozostałe ~ 10 µl poszczególnych bibliotek sekwencyjnych do oddzielnej płytki zwanej Płytką Pozostałej Oczyszczonej Biblioteki (RCLP). Przechowywać tę płytkę wraz z finalną przygotowaną biblioteką, ponieważ może ona służyć jako rezerwa do drugiego przebiegu sekwencjonowania, jeśli będzie to konieczne. Jeśli nie przechodzi się do następnego etapu, LNP i RCLP można przechowywać w temperaturze od -15 do -25 °C.
- Energicznie wymieszać w wirówce i resuspendować kuleczki do normalizacji biblioteki 1 (LNB1). Krytyczne jest całkowite resuspendowanie osadu kuleczek LNB1 na dnie probówki. Przygotować mieszaninę do normalizacji, mieszając 8 µl LNB1 z 44 µl dodatków do normalizacji biblioteki 1 (LNA1) na próbkę. Energicznie mieszać mieszaninę do normalizacji w wirówce przez 10 - 20 sek.
OSTROŻNIE: LNA1 zawiera formamid. - Przy okresowym odwracaniu i mieszaniu w wirówce mieszaniny do normalizacji, dodać 45 µl do każdej próbki w LNP. Uszczelnić płytkę przezroczystą folią samoprzylepną i wstrząsać przy 1,800 rpm przez 30 min. Ta 30-minutowa inkubacja jest krytyczna dla prawidłowej normalizacji biblioteki, ponieważ inkubacje dłuższe lub krótsze niż 30 min mogą wpłynąć na reprezentację biblioteki i gęstość klastrów.
- Podczas 30-minutowej inkubacji przygotować odczynniki do sekwencjonowania poprzez rozmrożenie kartridża z odczynnikami i buforu do hybrydyzacji (HT1) [OSTROŻNIE: Oba zawierają formamid]. Dodatkowo przygotować lód do późniejszego etapu i upewnić się, że blok grzejny odpowiedni dla probówek wirówkowych 1,5 ml jest ustawiony na 96 °C.
- Po zakończeniu 30-minutowego etapu mieszania umieścić LNP na statywie magnetycznym. Po sklarowaniu nadpłynu użyć pipety wielokanałowej, aby ostrożnie usunąć i wylać nadpłyn do odpowiedniego pojemnika na odpady.
- Zdjąć LNP ze statywu magnetycznego i przemyć kuleczki buforem do przemywania normalizacji biblioteki 1 (LNW1) w następujący sposób:
- Dodać 45 µl LNW1 do każdej studni z próbką.
OSTROŻNIE: Zawiera formamid. Uszczelnić płytkę przezroczystą folią samoprzylepną i wstrząsać przy 1,800 rpm przez 5 min. Powtórzyć czynność łącznie dwa razy. Upewnić się, że cały LNW1 został usunięty po drugim przemywaniu.
- Dodać 45 µl LNW1 do każdej studni z próbką.
- Zdjąć LNP ze statywu magnetycznego i za pomocą pipety wielokanałowej dodać 30 µl 0,1 N NaOH (przygotowanego mniej niż tydzień temu) do każdej studni w celu elucji próbki. Uszczelnić płytkę przezroczystą folią samoprzylepną i wstrząsać przy 1,800 rpm przez 5 min.
- Podczas 5-minutowej elucji dodać 30 µl buforu do przechowywania normalizacji biblioteki 1 (LNS1) do każdej studni w nowej płytce nazwanej Płytką do Przechowywania (SGP).
- Umieścić LNP na statywie magnetycznym. Po sklarowaniu nadpłynu przenieść 30 µl eluatu do LNS1 w SGP. Wymieniać końcówki między próbkami, aby uniknąć kontaminacji krzyżowej.
- Uszczelnić płytkę folią samoprzylepną i odwirować przy 1,000 x g przez co najmniej 30 sek.
- Dodać 5 µl każdej próbki do sekwencjonowania do oznakowanej probówki 1,5 ml z pulą bibliotek amplikonów (PAL). Wymieszać PAL w wirówce i krótko odwirować w mikrowirówce.
- W zależności od użytej chemii sekwencjonowania (V2 lub V3) dodać 4 - 10 µl PAL do 590 - 596 µl HT1. Zazwyczaj dodaje się 5,8 µl PAL do 595 µl HT1 dla chemii V2 oraz 8,5 µl PAL do 592 µl HT1 dla chemii V3. Oznaczyć tę probówkę jako probówkę z rozcieńczoną biblioteką amplikonów (DAL).
- Wymieszać DAL w wirówce i krótko odwirować w mikrowirówce. Inkubować DAL w 96 °C przez 2 min. Odwrócić probówkę DAL 3 razy i umieścić DAL na lodzie przez co najmniej 5 min, przygotowując w tym czasie sekwencjoner do pracy. Po upływie 5 min DAL jest gotowa do załadowania.
- Po zakończeniu pracy z SGP uszczelnić płytkę aluminiową folią samoprzylepną i oznaczyć ją datą oraz identyfikatorem płytki. Przechowywać uszczelnioną SGP i PAL w temperaturze od -15 do -25 °C.
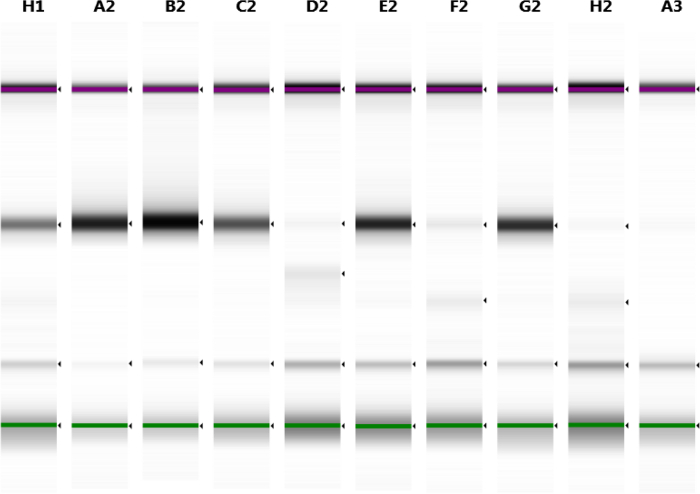
Rysunek 3: Przykład żelu do kontroli jakości przygotowania biblioteki. Zielona linia nad dolnymi prążkami wskazuje marker o niskiej masie cząsteczkowej, a fioletowa linia nad górnymi prążkami wskazuje marker o wysokiej masie cząsteczkowej. Proces przebiegł prawidłowo dla ścieżek H1, A2, B2, C2, E2 i G2. Przygotowanie biblioteki dla ścieżek D2, F2 i H2 nie przebiegło optymalnie, jednak wyniki zostaną uzyskane, choć mogą one nie wykazywać odpowiedniego pokrycia. W przypadku próbki A3 przygotowanie biblioteki ledwo powiodło się i najprawdopodobniej próbka DNA była niewystarczająca do przeprowadzenia analizy. Dolne prążki powyżej dolnego markera to niewykorzystane primery, ponieważ alikwot pobrano bezpośrednio z dołka po reakcji PCR. Próbka NTC powinna zawierać jedynie prążek niewykorzystanego primera i nic więcej. Aby wyświetlić większą wersję tego rysunku, kliknij tutaj.
5. Sekwencjonowanie
- Upewnij się, że dla danego przebiegu utworzono poprawny plik SampleSheet.csv. Przykład znajduje się w uzupełniającej Rysunku 1.
- Przepłucz i osusz komórkę przepływową, a następnie dodaj 600 µl DAL do rozmrożonego wkładu z odczynnikami.
- Przygotuj sekwenator do sekwencjonowania, postępując zgodnie z instrukcjami wyświetlanymi na ekranie.
6. Analiza danych
- Uruchom potok bioinformatyczny. Wykorzystaj wewnętrzny, specjalistyczny potok bioinformatyczny w celu zidentyfikowania mutacji, insercji, delecji oraz amplifikacji18.
- Po zakończeniu pracy potoku sprawdź pliki logów pod kątem błędów i ostrzeżeń, ponieważ wszelkie istotne błędy/ostrzeżenia pomagają w kontroli jakości (QC) przetwarzania w potoku.
- Przeanalizuj statystyki uruchomienia (Tabela 3), aby upewnić się, że zsekwencjonowana biblioteka spełnia określone przez laboratorium kryteria QC (Rycina 4). Ręcznie sprawdź każdy wariant, przeglądając pliki .bam w programie do wizualizacji danych genomicznych (np. Integrative Genomics Viewer16 (IGV)).
UWAGA: Raportowane są jedynie warianty mieszczące się w zwalidowanym zakresie częstości alleli oraz powyżej minimalnej głębokości pokrycia po filtrowaniu jakościowym (zgodnie z nomenklaturą Human Genome Variation Society (HGVS)). W końcowym raporcie każdy wariant eksonowy został sklasyfikowany jako: patogenny, prawdopodobnie związany z chorobą, wariant o nieznanym znaczeniu (VUS), prawdopodobnie łagodny lub łagodny. Zgłoszono wszystkie warianty przekraczające kryterium raportowania w postaci 5% częstości alleli, z wyjątkiem tych uznanych za warianty łagodne oraz zmian synonimicznych.
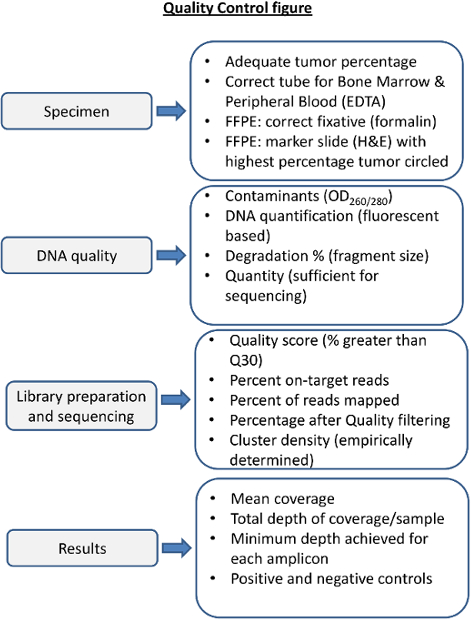
Rycina 4. Przegląd kroków kontroli jakości dla NGS. Kontrola jakości każdego etapu procesu jest niezbędna, aby zapewnić uzyskanie wyników sekwencjonowania uwzględniających parametry przed i po sekwencjonowaniu. Odpowiednia obróbka próbek jest kluczowa dla uzyskania wysokiej jakości DNA. Krew i szpik kostny w niewłaściwych utrwalaczach mogą dostarczyć DNA niskiej jakości. Niewłaściwe utrwalenie próbek guzów litych może doprowadzić do degradacji DNA (np. utrwalenie w B5). Jakość DNA powinna być oceniana za pomocą spektrofotometrii pod kątem zanieczyszczeń białkami i RNA oraz dokładnie oceniana pod kątem ilości i integralności DNA. Parametry sekwencjonowania muszą zostać określone empirycznie w laboratorium sekwencjonowania i monitorowane dla każdej reakcji sekwencjonowania oraz każdej próbki. Przed raportowaniem wyniki sekwencjonowania dla każdej próbki powinny zostać ocenione pod kątem pokrycia, głębokości oraz prawidłowego działania kontroli pozytywnych i negatywnych. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Wyniki
Przypadek 1 – Panel Heme-NGS
DNA wyekstrahowany z leukemicznej krwi obwodowej charakteryzował się wystarczającą jakością i ilością (176 ng/µl) dla panelu Heme-NGS. Całkowita średnia głębokość pokrycia wyniosła 4 933x (powyżej minimalnej średniej głębokości pokrycia wynoszącej 1 000x). Dodatkowe statystyki z sekwencjonowania znajdują się w Tabeli 3. Z 8 regionów o pokryciu poniżej 250x, 3 wynikały z nieprawidłowego przycinania starterów (i.e. sekwencja startera nie została prawidłowo usunięta z powodu błędów sekwencjonowania), 1 był znanym artefaktem testu, a pozostałe 4 stanowiły częściowe regiony eksonów różnych genów bez raportowalnych wariantów. Chociaż nasz protokół kliniczny obejmuje raportowanie wyłącznie wariantów pokrytych co najmniej 250 odczytami, wszystkie dane z co najmniej 100 odczytami są importowane do bazy danych w celu weryfikacji.
Przetwarzanie danych z potoku bioinformatycznego wykazało trzy raportowalne mutacje związane z chorobą: mutację missense w genie FLT3, mutację missense w genie IDH2 oraz mutację przesunięcia ramki odczytu w genie NPM1. Warianty eksonowe wraz z ich częstościami allelicznymi opisano w Table 4. Powszechną mutacją w genie FLT3 jest wewnętrzna duplikacja tandemowa (ITD) FLT3, która nie jest automatycznie wykrywana przez nasz potok i wymaga wizualnej inspekcji eksonu 14. Wizualna inspekcja eksonu 14 genu FLT3 nie wykazała insercji ani duplikacji w przekazanej próbce. Mutacja FLT3 I836del występowała z częstością alleliczną 1% i nie została uwzględniona w końcowym raporcie, ponieważ znajdowała się poniżej zwalidowanej minimalnej częstości allelicznej wynoszącej 5%. Mutacja ta nie znajduje się na tej samej cząsteczce DNA co zmiana FLT3 D835Y (i.e., zaobserwowano ją w tym samym regionie amplikonu, ale nie w układzie „cis” w żadnym z odczytów sekwencyjnych) i została zauważona jedynie podczas ręcznego przeglądu plików .bam podczas weryfikacji zmiany p.D835Y. Niższe częstości alleliczne dwóch mutacji FLT3 sugerują, że mutacje te mogą reprezentować heterogeniczność i/lub ewolucję klonalną; jednak różnica ta może wynikać z wydajności analizy dla tego amplikonu lub z polimorfizmu pojedynczego nukleotydu (SNP) w pobliżu lub nakładającego się na sekwencję startera, co wpłynęło na amplifikację tego allelu.
Wyniki panelu Heme-NGS dla przypadku 1 z AML wykazały mutacje w genach FLT3, IDH2 oraz NPM1, które są trzema powszechnie mutowanymi genami w AML. Mutacje w FLT3 obserwuje się u ~ 25% dorosłych pacjentów z AML (baza danych COSMIC17) i są to albo wewnętrzne duplikacje tandemowe (ITD), albo mutacje typu missense w domenie tyrozynowej kinazy. FLT3-ITD są częstszą mutacją i wiążą się ze słabą odpowiedzią na standardową chemioterapię, podczas gdy znaczenie prognostyczne punktowych mutacji domeny kinazy FLT3, zaobserwowanych u tego pacjenta z AML, ma niejasny wpływ na rokowania14. Dehydrogenaza izocytrynianowa 2 (NADP+), mitochondrialna (IDH2) to gen kodujący modyfikator epigenetyczny, który jest powszechnie mutowany w AML. Mutacje w modyfikatorach epigenetycznych są stosunkowo częste w AML, a mutacje w IDH1 i DNMT3A stanowią inne mutacje w tej klasie genów prowadzące do dysregulacji genów. Mutacje w genie nukleofozminy (NPM1) należą do najczęstszych nabytych mutacji w AML i są zazwyczaj uważane za dobry czynnik prognostyczny (w przypadku braku FLT3-ITD).
Współmutacje w NPM1 oraz IDH2 zostały opisane w literaturze jako korzystny wskaźnik prognostyczny5z 3-letnią całkowitą przeżywalnością na poziomie 89%. Stanowi to istotną korzyść w zakresie przeżywalności w porównaniu z całkowitą 3-letnią przeżywalnością typu dzikiego NPM1 i IDH2 wynoszącej 31%. Na przykład standardowa praktyka opieki obejmuje analizę mutacji w przypadku NPM1 i FLT3-ITD mutacje. W tym scenariuszu wykrycie jedynie jednego NPM1 mutacja nie pozwoliłaby na właściwą stratyfikację ryzyka pacjenta, ponieważ mutacje wtórne mogą być korzystne (np. IDH2) lub niekorzystne (np., TET2), co zmniejsza pewność co do możliwości złagodzenia przebiegu przeszczepu szpiku kostnego.
Przypadek 2 – Panel Solid-NGS
DNA wyekstrahowane z tkanki FFPE charakteryzowało się jakością i ilością wystarczającą dla panelu Solid-NGS, z koncentracją 252 ng/µl i zaledwie 4% DNA poniżej 1 000 par zasad (bp). Po analizie danych średnia głębokość pokrycia wyniosła 9 167 odczytów (znacznie powyżej naszej minimalnej granicy głębokości wynoszącej 1 000 odczytów), przy czym żadne regiony nie znajdowały się poniżej głębokości 250 odczytów. Dodatkowe parametry kontroli jakości przedstawiono w Tabeli 3.
Dane przetworzone za pomocą potoku bioinformatycznego wykazały dwie mutacje związane z chorobą: insercję w ramce odczytu w eksonie 20 genu ERBB2 (Her2/neu) oraz mutację typu missense w genie TP53. Wszystkie warianty eksonowe wraz z ich częstotliwością alleliczną przedstawiono w Tabeli 5. Insercja w ERBB2 w rzeczywistości reprezentuje tandemową duplikację sekwencji (Her2/neu), co odzwierciedla zastosowane nazewnictwo. Identyfikacja i potwierdzenie insercji w ramce odczytu wymagały manualnej analizy odczytów sekwencjonowania za pomocą oprogramowania IGV. Wykrycie częstotliwości mutacji przekraczającej 50%, zaobserwowane zarówno dla mutacji TP53, jak i Her2/neu, sugeruje wystąpienie utraty heterozygotyczności (LOH) (patrz sekcja dyskusja).
Wyniki panelu Solid-NGS dla przypadku 2 z gruczolakorakiem płuca wykazały obecność mutacji w genach ERBB2 (HER2/neu) oraz TP53, czyli dwóch genach rzadko badanych w ramach obecnego standardu opieki nad pacjentami z rakiem płuc. HER2/neu koduje receptor kinazy tyrozynowej podobny do innego często mutującego genu w raku płuc, EGFR. Aktywujące insercje w eksonie 20 HER2/neu obserwuje się u 2 - 4% przypadków gruczolakoraka płuca; stanowią one większość mutacji HER2/neu stwierdzanych w raku płuc i zazwyczaj występują w guzach bez mutacji w innych genach kierujących, takich jak EGFR i ALK 12. Istnieje kilka dowodów wskazujących na potencjał różnych opcji terapeutycznych dla pacjentów z aktywującymi insercjami HER2/neu, w tym na częściową odpowiedź na terapię skojarzoną inhibitorami HER2/neu oraz mTOR13, a także znaczną kontrolę choroby przy zastosowaniu przeciwciała monoklonalnego Trastuzumab w połączeniu z chemioterapią15. Wykrycie zmian w genie TP53 nie jest rzadkie w nowotworach, jednak obecnie nie istnieją dla nich terapie celowane.
| Przypadek 1 | Przypadek 2 | |
| Całkowita liczba odczytów początkowych | 2,215,926 | 2,129,110 |
| Procent odczytów zmapowanych | 98.42% | 98.29% |
| Procent odczytów w obszarze docelowym | 99.01% | 97.29% |
| Procent odczytów w obszarze docelowym po filtrowaniu | 97.60% | 95.45% |
| Procent odczytów użytecznych | 94.87% | 91.79% |
| Procent zasad o pokryciu powyżej 250x | 98.40% | 100% |
| Procent zasad z pokryciem powyżej 1000x | 95.90% | 99.70% |
| Pokrycie poniżej 250x – liczba amplikonów | 8 | 0 |
Tabela 3: Metryki kontroli jakości (QC) cyklu sekwencjonowania. Jest to podsumowanie najważniejszych statystyk cyklu, z wyłączeniem średniego pokrycia, które są wykorzystywane podczas przeglądu danych w celu ustalenia, czy próbka z przygotowanej biblioteki przeszła kontrolę jakości. Cały proces uznaje się za udany, jeśli wszystkie wartości procentowe przekraczają 90%, jednak w przypadku przeniesienia SW1 lub UB1 podczas etapu płukania FPU lub wystąpienia interferencji starterów (primer cross-talk), wartość „Percent on Target” może być niższa i mieścić się w zakresie 80 – 90%. Zbyt niska wartość „Percent Mapped” wskazywałaby na zanieczyszczenie bakteriami lub innym DNA, ponieważ wszystkie próbki powinny mapować do genomu ludzkiego. Jeśli którakolwiek z tych specyfikacji spadnie poniżej 80%, próbka zostaje oznaczona do dalszej analizy, aby pomóc w ustaleniu dalszych kroków i udoskonaleniu procesu.
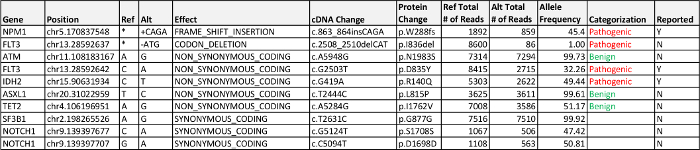
Tabela 4: Wyniki przypadku 1. Wymieniono wykryte patogenne, związane z chorobą, warianty o nieznanym znaczeniu (VUS) oraz prawdopodobnie łagodne warianty eksonowe przekraczające kryteria raportowania częstotliwości alleli na poziomie 5%. Kliknij tutaj, aby pobrać tę tabelę.
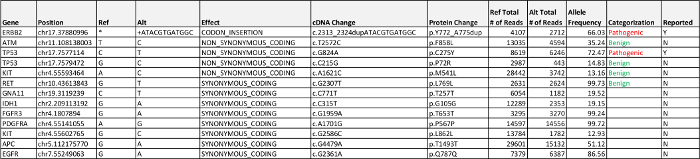
Tabela 5: Wyniki przypadku 2. Wymieniono wykryte warianty eksonowe o charakterze patogennym, związanym z chorobą, warianty o nieznanym znaczeniu (VUS) oraz prawdopodobnie łagodne, których częstość występowania alleli przekracza kryterium raportowania wynoszące 5%. Prosimy kliknąć tutaj, aby pobrać tę tabelę.
Rycina uzupełniająca 1: Przykład pliku SampleSheet.csv dla sekwencjonowania amplikonów. Arkusz ten przekazuje sekwenatorowi informacje o zastosowanej chemii (w tym przypadku Amplicon), przepływie pracy (np. GenerateFastq), zastosowanej aplikacji i badaniu (np. FastqOnly), liczbie zasad (lub odczytów) do sekwencjonowania (w tym przypadku 186 bp x 186 bp), a na koniec o tym, jakie próbki są powiązane z konkretnymi indeksami (w tym przypadku indeksowanie podwójne). Części zaznaczone na żółto mogą zostać zmienione zgodnie z potrzebami eksperymentatora, jednak w tym przypadku laboratorium stosuje te parametry. Kliknij tutaj, aby pobrać tę rycinę.
Dyskusja
Ponieważ dwa testy NGS opisane w tym manuskrypcie są oferowane klinicznie, najważniejszą kwestią praktyczną jest kontrola jakości. W szczególności należy zwrócić szczególną uwagę na jakość i ilość wyekstrahowanego DNA. Jest to szczególnie ważne w przypadku próbek FFPE, które często są silnie zdegradowane ze zmienną wydajnością DNA. Opracowano metodę wytrącania izopropanolu w celu maksymalizacji wydajności DNA z próbek FFPE, ponieważ stwierdzono, że metody oparte na kolumnach czasami prowadzą do ścinania DNA przy ograniczonych objętościach elucji. Dlatego w większości przypadków, gdy próbka ma zbyt niskie stężenie lub jest zbyt zdegradowana do testu, najprawdopodobniej jest to spowodowane rozmiarem, typem lub utrwaleniem tkanki, a nie procesem ekstrakcji. W przypadku próbek krwi/szpiku kostnego, jeśli nie dojdzie do ekstrakcji, jest to zwykle spowodowane hemodylucją próbki (tj. niewystarczającą liczbą białych krwinek lub komórek nowotworowych w tym pobraniu) lub ablacją chemioterapii.
Podczas walidacji należy ustalić wartości graniczne dla akceptowalności jakości i ilości DNA. W teście często stosuje się zalecane wejście 100 - 250 ng; jednak jeśli jakość DNA jest dobra, niższe ilości wejściowe mogą być skuteczne. Ponadto, jeśli jakość DNA jest słaba (tj. ilość amplifikowanego DNA jest mniejsza niż 100 - 250 ng), wówczas wyższe ilości wejściowe mogą poprawić jakość wyników sekwencjonowania (ponieważ ilość amplifikowanego DNA osiągnie zalecany wejście). Wskaźniki jakości i ilości DNA powinny być stosowane do każdej próbki przed przekazaniem DNA do przygotowania biblioteki. Próbki znajdujące się w "szarej strefie" (zob . rysunek 2) powinny być badane według uznania dyrektora laboratorium lub osoby przez niego wyznaczonej. Obecnie najlepszym sposobem przewidywania, czy DNA nie będzie działać dobrze podczas sekwencjonowania, jest wykonanie testu opartego na qPCR, który pozwala na kwantyfikację i ocenę jakości wejściowego DNA. Podejście to dotyczy biodostępności fragmentów o różnych rozmiarach w próbce poprzez amplifikację fragmentów o różnych rozmiarach (np. 100 pz, 150 pz, 200 pz i 300 pz) oraz wydajność porównawczą.
Obecnie przygotowanie biblioteki obejmuje dużą liczbę ręcznych kroków, w których błąd w jednym z kilku momentów może spowodować awarię biblioteki lub jej niską jakość. Analiza żelu mikroprzepływowego jest jedynym krokiem kontroli jakości, który pozwala sprawdzić problem z przygotowaniem biblioteki przed sekwencjonowaniem. W związku z tym istnieje kilka krytycznych kroków, w których dodatkowa uważność może zwiększyć prawdopodobieństwo udanej reakcji. Konieczne jest zagwarantowanie, że dla każdej próbki używana jest właściwa próbka i pula oligonukleotydów. Upewnienie się i prawidłowe zarejestrowanie, że każda próbka zawiera jedną z 96 unikalnych kombinacji podwójnie indeksowanych par starterów PCR, zmniejsza ryzyko pomieszania próbki. Ważne jest również, aby upewnić się, że płyta filtracyjna (FPU) prawidłowo opróżnia; Jeśli nie zostanie odpowiednio opróżniony, może to spowodować, że etap przedłużenia-ligacji przygotowania biblioteki będzie działał nieoptymalnie i doprowadzi do niskiej jakości danych sekwencjonowania. Po kontroli jakości biblioteki ważne jest, aby upewnić się, że kulki LNB1 są w pełni zawieszone i że roztwór LNB1 / LNA1 jest dobrze wymieszany przed dodaniem go do próbek, ponieważ stężenie tej mieszaniny służy do określenia molowości biblioteki. Wreszcie, jeśli etap elucji kulek prowadzi do nieoptymalnej ilości elucji biblioteki z koralików, zmniejszy to gęstość grupowania i prawdopodobnie spowoduje, że biblioteka nie uzyska odpowiedniego średniego pokrycia. I odwrotnie, nadmiar biblioteki doprowadzi do gorszej jakości odczytów. Dlatego ważne jest, aby zachować spójność na etapie normalizacji opartej na koralikach, aby zapewnić optymalne łączenie i grupowanie bibliotek w sekwencerze.
Oprócz przygotowania biblioteki, kluczowe znaczenie ma walidacja potoku bioinformatycznego, który będzie generował dokładne wywołania mutacji z surowych, zdemultipleksowanych plików fastq. Wybór niestandardowego rozwiązania może być czasochłonny, ponieważ istnieje wiele dostępnych nakładek typu open source i komercyjnie, wywoływania wariantów i pakietów oprogramowania NGS, które trzeba by przesiać. Konieczne będzie zaprojektowanie niestandardowych algorytmów, aby wyodrębnić podstawowe statystyki wydajności, zidentyfikować unikalne powtarzające się mutacje, które wymknęły się większości narzędzi open source, oraz określić status liczby kopii dla każdego z loci. Podczas procesu walidacji potoku bioinformatycznego ważne jest, aby określić możliwe do zgłoszenia wartości odcięcia dla wariantów, które spełniają lub przekraczają zarówno minimalną głębokość pokrycia po filtrowaniu jakości (np. co najmniej 250 odczytów), jak i minimalną częstość alleli (np. 4%). Ponieważ jest to multipleksowany test oparty na amplikonie, ważne jest, aby określić minimalną średnią głębokość pokrycia (np. 1,000x), którą biblioteka musi osiągnąć, aby móc uzyskać najniższy wydajność amplikonu do minimalnej głębokości odczytów. Ponadto multipleksowy charakter testu powoduje efekty niedocelowe, a te "artefakty" będą musiały zostać odkryte i w pełni zweryfikowane przed uruchomieniem. Innym ważnym ograniczeniem opisanego testu jest potrzeba, aby próbki zawierały więcej niż 10% guza, aby osiągnąć zwalidowaną minimalną częstość alleli.
Wykrycie insercji FLT3 o niskiej częstotliwości, 1%, jest dowodem na to, że ręczny przegląd jest nadal pożądany w tym procesie. Nawet przy odcięciu częstości alleli wynoszącym 5%, niektóre ważne mutacje mogą zostać pominięte, a zatem ręczny przegląd będzie niezbędny do ustalenia tych wariantów. W przypadku FLT3-ITD kontrola wzrokowa eksonu 14 jest wykonywana u wszystkich pacjentów z AML, aby upewnić się, że niski poziom lub duża insercja/duplikacja nie pozostanie niezauważona. Ponadto insercje eksonu HER2 20, które zwykle znajdują się obok sekwencji startera, wymagają ręcznej interwencji. Pomimo solidnego rurociągu bioinformatycznego, niektóre warianty mogą zostać przeoczone, co jest po prostu naturą twardego odcięcia dla większości wyżej wymienionych statystyk. Aby złagodzić ten problem, potrzebna byłaby lepsza bioinformatyka, a także lepsze przygotowanie bibliotek i/lub metodologie sekwencjonowania, ponieważ korzystniejsze jest posiadanie dobrej jakości danych przy jeszcze niższych wartościach granicznych, które zawierają mniej artefaktów i wyników fałszywie dodatnich.
Wykrywanie i interpretacja częstości alleli może być trudna ze względu na trudności w określeniu procentu guza i odchylenie amplifikacji niektórych regionów genomu. Ponadto można wykryć częstość alleli powyżej 50%, jak zaobserwowano w przypadku 2. Jest to interpretowane jako utrata heterozygotyczności (LOH), albo z powodu utraty normalnego allelu, co prowadzi do pozornego wzrostu odczytów mutantów, przyrostu zmutowanego allelu (np. 2 zmutowane i jedna normalna kopia), albo innych mechanizmów. Mechanizmy te można wyjaśnić, wykorzystując macierzową porównawczą hybrydyzację genomową (aCGH19) i/lub macierz genotypowania SNP. Lokal mieszkalny 20.
Obecne metodologie wzbogacania celu opierają się na całodniowych procedurach albo nieefektywnego wychwytywania hybrydowego, albo technik multipleksowanego PCR, które skutkują potrzebą większego pokrycia sekwencjonowania pojedynczej próbki i większej liczby odczytów sekwencjonowania poza celem. Dodatkowe zastosowania onkologii molekularnej NGS, które spodziewane są w najbliższej przyszłości, będą obejmowały łatwiejsze metody przygotowywania bibliotek, które mogą być w pełni zautomatyzowane i być w stanie przetwarzać próbki z bardzo małą ilością wejściowego DNA (tj. mniej niż 1 ng), a także próbki z wysoce zdegradowanym DNA. Aby sprostać tym wyzwaniom, większość metod będzie prawdopodobnie oparta na PCR, albo będzie to wieloetapowe podejście PCR, albo masowo równoległe podejście singleplex PCR. Ponadto wykazano, że molekularne kodowanie kreskowe poszczególnych amplikonów radykalnie zmniejsza szum sekwencjonowania tła i umożliwi testowanie próbek z niższymi proporcjami komórek nowotworowych w celu osiągnięcia niższych częstości alleli i przejścia do wychwytywania krążących komórek nowotworowych.
Wykrywanie mutacji związanych z chorobą w próbkach nowotworowych jest standardem opieki od dziesięcioleci. Historycznie rzecz biorąc, geny były często testowane sekwencyjnie, po jednym genie/eksonie na raz, z identyfikacją mutacji prowadzącą do końca sekwencji testowej. Pojawienie się NGS pozwoliło na mniej stronnicze podejście do sekwencjonowania wielu genów związanych z wieloma nowotworami równolegle, co doprowadziło do identyfikacji wielu mutacji związanych z nowotworami. Kliniczna przydatność NGS w wykrywaniu mutacji somatycznych w nowotworach jest coraz bardziej widoczna. Rzeczywiście, analiza próbek nowotworów oparta na NGS stanowi nowy paradygmat, który rzuca wyzwanie tradycyjnym testom pojedynczych genów, ale użyteczność kliniczna jest bardzo jasna. Laboratoria kliniczne mają dziś ekscytującą okazję do połączenia starannej walidacji metod i interpretacji testów z zastosowaniem tej potężnej technologii.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Autorzy dziękują Danielowi Wildowi za przeczytanie manuskryptu i pomoc w jego przygotowaniu.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Taśma ScreenTape Genomic DNA | Agilent Technology | 5067-5365 | |
| Odczynniki do genomowego DNA | Agilent Technology | 5067-5366 | |
| Taśma ekranowa D1000 o wysokiej czułości | Agilent Technology | 5067-5584 | |
| Odczynniki D1000 o wysokiej czułości | Agilent Technology | 5067-5585 | |
| TapeStation 2200 | Technologia Agilent | G2965A | |
| TapeStation | Agilent Technology | A.01.04 lub nowszy | |
| 96-dołkowe stojaki do przechowywania probówek | dowolny dostawca | ||
| Stojak na probówki 15/50 ml Dowolny | dostawca | ||
| Stojak na płytki 96-dołkowe | Dowolny dostawca | ||
| Pipeta jednokanałowa, 0,5– 2,5 μ l | Pipeta dowolnego dostawcy | ||
| , jednokanałowa, 1– 10 μ l | Pipeta dowolnego dostawcy | ||
| , jednokanałowa, 2– 20 μ l | Pipeta dowolnego dostawcy | ||
| , jednokanałowa, 10– 100 μ l | Pipeta dowolnego dostawcy | ||
| , jednokanałowa, 20-calowa; 200 μ l | Pipeta dowolnego dostawcy | ||
| , jednokanałowa, 100 – 1,000 μ l | Każdy sprzedawca | ||
| Pipetor serologiczny | Każdy sprzedawca | ||
| Vortexer | Każdy sprzedawca | ||
| Wiadro na lód | Dowolny sprzedawca | ||
| Mikrowirówka (do probówek i probówek paskowych) | Dowolny sprzedawca | ||
| Zamrażarka, -20 & deg; C | Dowolny sprzedawca | ||
| 4 & stopnie; C Lodówka | Dowolny Woda | ||
| lub Kąpiel z koralikami | dla sprzedawców | ||
| (37 & Deg; c) | dowolnego dostawcy | ||
| , 1 ml | dowolnego dostawcy | ||
| , 5 ml | dowolnego dostawcy | ||
| , 10 ml | dowolnego dostawcy | ||
| , 25 ml | Dowolny sprzedawca | ||
| Rękawice | Każdy sprzedawca | ||
| Żyletki/Szpulki | Dowolny sprzedawca | ||
| KimWipes | Dowolny sprzedawca | ||
| Tuba stożkowa 15 ml | Dowolny sprzedawca | ||
| Tuba stożkowa 50 ml | Dowolny sprzedawca | ||
| Ręczniki papierowe | Dowolny sprzedawca | ||
| 200-procentowy etanol | Każdy sprzedawca | Sklep w łatwopalnej szafce | |
| 2-Propanol (izopropanol) | Każdy sprzedawca | Sklep w łatwopalnej szafce | |
| Zbiorniki 25 ml | Każdy sprzedawca | ||
| 10 N NaOH | Dowolny sprzedawca | ||
| Pipeta, 8-kanałowa, 1 – 10 μ l | Pipeta dowolnego dostawcy | ||
| , 8-kanałowa, 10 i ndash; 100 i mu; l | Pipeta dowolnego dostawcy | ||
| , 8-kanałowa, 20 i ndash; 300 i mu; l | Dowolny sprzedawca | ||
| Wiadro na lód | Dowolna | ||
| butelka do spryskiwania wodą | sprzedawcy | ||
| Butelka do spryskiwania alkoholem | Dowolny papier do | ||
| czyszczenia soczewek | Dowolne talerze dostawcy | ||
| , 96-dołkowy PCR, częściowo przyszywkowy | dowolny sprzedawca | ||
| Paski probówek, 8-dołkowe, 0,2 ml | dowolny dostawca | ||
| Koraliki Agencourt AMPure XP | Beckman Coulter | A63881 | |
| BioShake IQ lub 3000-T wiąz | Bulldog Bio/Q.Instruments | 1808-0506/ 1808-0517 | |
| DropPlate96 S - Suwmiarka LabChipDS | 128876 | ||
| DropPlate96 D - Suwmiarka LabChipDS | 132848 | ||
| Suwmiarka DropSense96 | (Trinean) | ||
| DropQuant Software | Caliper (Trinean) | ||
| Płyta uszczelniająca | Denville | B1212-5S | |
| Aluminiowa folia uszczelniająca | Denville | B1212-6S | |
| Wolny od nukleaz, czysty system wodny | Wirówka EMD Millipore | ||
| 5424 | Wirówka Eppendorf | 22621408 | |
| 5804R | Eppendorf | 22623508 | zarówno rotatory do probówek, jak i płytek o pojemności 15 ml, najlepiej wirówkę, która może osiągnąć do 2 500 x g. |
| Probówka Safe-Lock 1,5 ml, naturalna | Eppendorf | 22431021 | |
| 5 ml, probówka DNA LoBind | Eppendorf | 30108310 | |
| 5430R Wirówka | Eppendorf | 022620645 | Będzie działać każda wirówka rotatorowa |
| Hybex Inkubator mikropróbek Fisher | Scientific | 1057-30-0 | |
| Hybex 0,2 ml Blok probówek | Fisher Scientific | 1057-31-0 | |
| TruSeq Amplicon – Panel Raka | Illumina | FC-130-1008 | 96 reakcji |
| TruSeq Custom Amplicon | Illumina | PE-940-1011 | 96 reakcji |
| TruSeq Custom Amplicon Index Kit | Illumina | FC-130-1003 | 96 indeksów, 384 próbki |
| MiSeq Reagent Kit v3, 500 cykli | Illumina | MS-102-3003 | |
| MiSeq Reagent Kit v2, 300 cykli | Illumina | MS-102-2002 | |
| Zestaw odczynników MiSeq v2, 500 cykli | Illumina | MS-102-2003 | |
| Kierownik eksperymentów | Illumina | 1.3 lub nowszy | |
| MiSeq Reporter | Illumina | 2.0 lub nowszy | |
| Przeglądarka analizy sekwencjonowania | Illumina | 1.8 lub nowsza | |
| Zestaw opraw i kołnierzy TruSeq Index Plate | Illumina | FC-130-1007 | |
| MiSeq v2 | Illumina | SY-410-1003 | |
| TruSeq Niestandardowa płyta filtra Amplicon | Illumina | FC-130-1006 | |
| Wymienne nasadki adaptera indeksu | Illumina | 11294657 | |
| Qubit 2.0 | Invitrogen | Q32866 | |
| Qubit 0,5 ml | Probówki | ||
| Qubit dsDNA Zestaw do testów szerokiego zakresu | Stojak magnetyczny Invitrogen | Q32853 | |
| DynaMa6-96, listwy boczne | Invitrogen | 120.27 | |
| GeneAmp PCR System 9700 (blok złoty/srebrny) | Life Technologies | N8050200 | |
| Gentra Puregene Blood Kit | Qiagen | 158489 | |
| roztwór deparufinizacyjny (16 ml) | Qiagen | 19093 | |
| Bufor ATL (4 x 50ml) | Qiagen | 939011 | |
| Roztwór do wytrącania białek (50 ml) | Qiagen | 158910 | |
| Roztwór hydratujący DNA (100 ml) | Qiagen | 158914 | |
| roztwór glikogenu (500 μ l) | Qiagen | 158930 | |
| Qiagen Proteinaza K | Qiagen | 19133 | |
| Rnaza (5 ml) | Qiagen | 158924 | |
| Woda bez nukleaz (10 x 50 ml) | Qiagen | 129114 | |
| Pestles | USA Scientific | 1415-5390 | |
| TipOne RPT 10 µ l Podłużne końcówki pipet filtracyjnych w wysterylizowanych stojakach, 10 stojaków na 96 końcówek (960 końcówek). | Stany Zjednoczone Naukowe | 1180-3810 | |
| TipOne RPT 100 µ l naturalne, skośne końcówki do pipet filtracyjnych w sterylizowanych stojakach, 10 stojaków po 96 końcówek (960 końcówek) | USA Scientific | 1180-1840 | |
| TipOne RPT 200 μ l naturalne, skośne końcówki do pipet filtracyjnych w stojakach, stojaki sterylizowane, 10 stojaków po 96 końcówek (960 końcówek) | USA Scientific | 1180-8810 | |
| TipOne RPT 20 i mu; l naturalne, skośne końcówki do pipet filtracyjnych w stojakach, stojaki sterylizowane, 10 stojaków po 96 końcówek (960 końcówek) | USA Scientific | 1180-1810 | |
| TipOne RPT 1,000 μ l naturalne, wyskalowane końcówki do pipet z filtrem XL w | USA Scientific | 1182-1830 |
Bibliografia
- Gerlinger, M., et al. Intratumor heterogeneity and branched evolution revealed by multiregion sequencing. N Engl J Med. 366 (10), 883-892 (2012).
- Campbell, P. J., et al. The patterns and dynamics of genomic instability in metastatic pancreatic cancer. Nature. 467 (7319), 1109-1113 (2010).
- Ding, L., et al. Clonal evolution in relapsed acute myeloid leukaemia revealed by whole-genome sequencing. Nature. 481 (7382), 506-509 (2012).
- Frampton, G. M., et al. Development and validation of a clinical cancer genomic profiling test based on massively parallel DNA sequencing. Nature Biotechnol. 31 (11), 1023-1031 (2013).
- Patel, J. P., et al. Prognostic relevance of integrated genetic profiling in acute myeloid leukemia. N Engl J Med. 366 (12), 1079-1089 (2012).
- Forbes, S. A., et al. COSMIC (the Catalogue of Somatic Mutations in Cancer ): a resource to investigate acquired mutations in human cancer. Nucleic Acids Res. 38 (Database Issue), 652-657 (2010).
- Shih, A. H., Abdel-wahab, O., Patel, J. P., Levine, R. L. The role of mutations in epigenetic regulators in myeloid malignancies. Nat Rev Cancer. 12 (9), 599-612 (2012).
- Liersch, R., Müller-Tidow, C., Berdel, W. E., Krug, U. Prognostic factors for acute myeloid leukaemia in adults - biological significance and clinical use. Br J Haematol. 165 (1), 17-38 (2014).
- Bacher, U., Schnittger, S., Haferlach, T. Molecular genetics in acute myeloid leukemia. Curr Opin Oncol. 22 (6), 646-655 (2010).
- Subramanian, J., Govindan, R. Lung cancer in "Never-smokers": a unique entity. Oncology (Williston Park). 24 (1), 29-35 (2010).
- Sakashita, S., Sakashita, M., Tsao, M. S. Genes and pathology of non-small cell lung carcinoma. Semin Oncol. 41 (1), 28-39 (2014).
- Arcila, M. E., Chaft, J. E., Nafa, K. Prevalence clinicopathologic associations, and molecular spectrum of ERBB2 (HER2) tyrosine kinase mutations in lung adenocarcinomas. Clin Cancer Res. 18 (18), (2012).
- Gandhi, L., et al. Phase I study of neratinib in combination with temsirolimus in patients with human epidermal growth factor receptor 2-dependent and other solid tumors. J Clin Oncol. 32 (2), 68-75 (2014).
- Sheikhha, M. H., Awan, A., Tobal, K., Liu Yin, J. A. Prognostic significance of FLT3 ITD and D835 mutations in AML patients. Hematol J. 4 (1), 41-46 (2003).
- Mazières, J., et al. Lung cancer that harbors an HER2 mutation epidemiologic characteristics and therapeutic perspectives. J Clin Oncol. 31 (16), 1-8 (2014).
- Robinson, J. T., et al. Integrative Genomics Viewer. Nat Biotechnol. 29 (1), 495-500 (2011).
- Forbes, S. A., et al. COSMIC: exploring the world's knowledge of somatic mutations in human cancer. Nucleic Acids Res. 43 (Database issue), D805-D811 (2014).
- Daber, R., Sukhadia, S., Morrissette, J. J. Understanding the limitations of next generation sequencing informatics, an approach to clinical pipeline validation using artificial data sets. Cancer Genetics. 206 (12), 441-448 (2013).
- Haraksingh, R. R., et al. Genome-Wide Mapping of Copy Number Variation in Humans: Comparative Analysis of High Resolution Array Platforms. PLoS ONE. 6 (11), e27859(2011).
- de Leeuw, N., et al. SNP Array Analysis in Constitutional and Cancer Genome Diagnostics - Copy Number Variants, Genotyping and Quality Control. Cytogenet Genome Res. 135 (3-4), 212-221 (2011).
Przedruki i uprawnienia
