Tutaj prezentowany jest zautomatyzowany przepływ pracy do wykonywania modułowego montażu "urządzenia" DNA przy użyciu modułowej metody klonowania DNA na robotach obsługujących ciecze. Protokół wykorzystuje intuicyjne narzędzie programowe do generowania list wyboru osób zajmujących się cieczami do kombinatorycznego generowania biblioteki urządzeń DNA, które demonstrujemy za pomocą dwóch platform do obsługi cieczy.
Artykuł metodologiczny
Zautomatyzowany zrobotyzowany montaż modułowych urządzeń DNA do obsługi cieczy
W tym artykule
Podsumowanie
Streszczenie
Ostatnie postępy w technikach modułowego składania DNA umożliwiły biologom syntetycznym przetestowanie znacznie większej części dostępnej "przestrzeni projektowej" reprezentowanej przez "urządzenia" stworzone jako kombinacje poszczególnych składników genetycznych. Jednak ręczny montaż tak dużej liczby urządzeń jest czasochłonny, podatny na błędy i kosztowny. Rosnące wyrafinowanie i skala badań nad biologią syntetyczną wymaga wydajnego, powtarzalnego sposobu dostosowania się do wielkoskalowej, złożonej i wysokowydajnej konstrukcji urządzeń.
Tutaj, protokół składania DNA wykorzystujący technikę modularnego klonowania (MoClo) opartej na endonukleazie restrykcyjnej typu IIS jest zautomatyzowany na dwóch platformach robotycznych do obsługi cieczy. Zautomatyzowane roboty do obsługi cieczy wymagają starannej, często żmudnej optymalizacji parametrów pipetowania dla cieczy o różnej lepkości (np. enzymów, DNA, wody,), a także wyraźnego programowania w celu zapewnienia prawidłowego zasysania i dozowania części DNA i odczynników. To sprawia, że ręczne pisanie skryptów dla złożonych zestawów jest tak samo problematyczne, jak ręczne składanie DNA i wymaga narzędzia programowego, które może zautomatyzować generowanie skryptów. W tym celu opracowaliśmy internetowe narzędzie programowe http://mocloassembly.com do generowania bibliotek urządzeń kombinatorycznych DNA z podstawowych części DNA przesłanych jako pliki Genbank. Zapewniamy dostęp do narzędzia i pliku eksportu z naszego oprogramowania do obsługi cieczy, który zawiera zoptymalizowane klasy cieczy, parametry oprogramowania laboratoryjnego i układ pokładu. Wszystkie użyte części DNA są dostępne za pośrednictwem Addgene, a ich cyfrowe mapy można uzyskać za pośrednictwem rejestru BDC ICE Uniwersytetu Bostońskiego. Razem te elementy stanowią podstawę dla innych organizacji do automatyzacji eksperymentów klonowania modułowego i podobnych protokołów.
Przedstawiony tutaj zautomatyzowany proces składania DNA umożliwia powtarzalną, zautomatyzowaną, wysokowydajną produkcję urządzeń DNA i zmniejsza ryzyko błędu ludzkiego wynikającego z powtarzalnego ręcznego pipetowania. Dane sekwencjonowania pokazują, że zautomatyzowane reakcje składania DNA generowane w tym przepływie pracy są w ~95% poprawne i wymagają zaledwie 4% mniej czasu pracy w porównaniu z ręcznym przygotowaniem reakcji.
Wprowadzenie
Najwcześniejsze syntetyczne biologiczne urządzenia genetyczne, takie jak przełącznik Collinsa1 i represylator Elowitz2 pokazały, że systemy biologiczne mogą być projektowane tak, aby miały określone, deterministyczne funkcje. Od tego czasu biolodzy syntetyczni dążą do inżynierii żywych systemów, aby realizowały coraz bardziej złożone funkcje w służbie biomateriałów3, biotherapeutics4,5,6, biofuels7,8, oraz biosensing applications9,10,11. Osiągnięcie tych zastosowań poprzez łączenie modułowych "części" DNA w "urządzenia" o określonej funkcjonalności było jednym z głównych celów biologii syntetycznej. Aby proces ten mógł się skalować, musi istnieć technika, która pozwala na tworzenie złożonych urządzeń z dużych bibliotek części w sposób efektywny czasowo, ekonomicznie, a co najważniejsze, powtarzalny.
Tak rozległy proces montażu jest uzasadniony, ponieważ obecnie w tej dziedzinie brakuje pełnego zrozumienia zasad kierujących udanym projektowaniem i kompozycją systemów biologicznych. Sytuację pogarszają niedostatecznie scharakteryzowane części DNA12, brak kompatybilności i komponowalności parts13 oraz nieoczekiwane, niepożądane interakcje między komponentami genetycznymi w urządzeniach syntetycznych14,15. Wobec braku wiarygodnego modelowania predykcyjnego, funkcjonalne syntetyczne urządzenia genetyczne są uzyskiwane metodą prób i błędów, co wymaga sprawdzenia dziesiątek, a nawet setek wariantów siły sygnału wejścia-wyjścia zamierzonego urządzenia i wybrania "najlepszego" do kompozycji z elementami podrzędnymi16. Podczas gdy nowoczesne ustandaryzowane metody składania DNA, takie jak Golden Gate17 i Modular Cloning18,19,20 ułatwiają ten proces, do wykonania każdego protokołu nadal wymagany jest ekspert eksperymentalny. Wraz ze wzrostem rozmiarów i złożoności urządzeń syntetycznych, całkowita dostępna przestrzeń projektowa stanie się zbyt duża, aby można ją było konstruować i testować ręcznie21, a proces będzie zbyt rzemieślniczy, aby można było dokonać jakiegokolwiek znaczącego postępu, który można powielić w tej dziedzinie.
Do czasu pojawienia się biologii syntetycznej i repozytoriów części biologicznych, takich jak Rejestr Części iGEM (http://partsregistry.org), Inwentarz Elementów Komponowalnych JBEI22, oraz SynBioHub23, części genetyczne nie były przechowywane w żadnym standardowym formacie montażu. Tylko niewielka garstka części musiała zostać sklonowana w jednym projekcie, a co za tym idzie, ilość wykonanych klonowań była niewielka, a realizacja zmontowanego urządzenia była osiągalna i trywialna w porównaniu z rzeczywistymi celami badawczymi. Klonowanie molekularne było często doraźne i przeprowadzane przy użyciu trawień restrykcyjnych opartych na miejscu restrykcji i dostępności endonukleazy, a nie zgodnie z jakimkolwiek standardowym procesem. Brak standaryzacji sprawił, że automatyzacja jakiegokolwiek protokołu klonowania stała się niepraktyczna, ponieważ było mało prawdopodobne, aby następna reakcja klonowania przebiegała zgodnie z identycznym protokołem. Co więcej, automatyzacja składania DNA wymagała znacznych inwestycji pieniężnych w sprzęt (roboty do obsługi cieczy i związane z nimi oprogramowanie oraz infrastruktura sprzętu laboratoryjnego), a także inwestycji czasowych w generowanie instrukcji w celu opracowania dokładnych parametrów obsługi różnych klas przetwarzanych cieczy oraz precyzyjnej serii instrukcji do uruchomienia tych protokołów. Wysiłki związane z klonowaniem na małą skalę nie uzasadniały tych wydatków. Połączenie większych, bardziej złożonych projektów urządzeń genetycznych w połączeniu ze znormalizowanymi protokołami montażu24,25 tworzy środowisko, w którym automatyzacja tych procesów jest bardzo praktyczna. Pojawiają się również tanie robotyki, takie jak Opentrons OT-One26, które umożliwiają dostęp do tej technologii nawet skromnie finansowanym laboratoriom. Ponadto laboratoria "chmurowe"27, w tym Transcriptic and Emerald Cloud Lab, a także akademickie "biofoundries", takie jak Edinburgh Genome Foundry, UIUC iBioFab i MIT-Broad Foundry, wykorzystują robotykę do szybkiego i wielokrotnego tworzenia różnorodnych zestawów projektów dla różnych klientów, jednocześnie utrzymując wspólne repozytorium podstawowych prymitywów DNA i technologii montażu dla przyszłych zamówień.
Jednym z największych wyzwań w automatyzacji procesu składania DNA jest generowanie poleceń pipetowania dla osoby zajmującej się obsługą cieczy. Podczas gdy interfejsy programowe dla tych urządzeń są zazwyczaj łatwe w użyciu, złożone instrukcje pipetowania, takie jak te niezbędne do kombinatorycznego składania DNA, wymagają od naukowca wyraźnego ręcznego określenia każdego polecenia zasysania i dozowania. Tworzy to poważne wąskie gardło w przepływie pracy i sprawia, że proces generowania skryptów jest podatny na te same błędy pipetowania, jak w przypadku ręcznego montażu. Wymaga to narzędzia programowego, które może zautomatyzować wszystkie części tego procesu, od projektowania biblioteki urządzeń, po generowanie instrukcji pipetowania i dostarczanie badaczowi konfiguracji płytki/odczynników wymaganych do ich złożenia. W tej pracy wykorzystujemy nasze narzędzie programowe, aby zautomatyzować projektowanie małej kombinatorycznej biblioteki urządzeń DNA, a także mieszanie odczynników (buforu, wody, enzymów) i części DNA (Rysunek 1b) w 96 jednogarnkowych modułowych reakcjach składania DNA. Korzystanie z narzędzia nie wymaga wcześniejszego doświadczenia w programowaniu, jest skalowalne i ma wysoką przepustowość, a także domyślnie jest kombinatoryczne. Wykazaliśmy, że reakcje klonowania przygotowane na dwóch różnych zautomatyzowanych platformach do obsługi cieczy dają prawidłowe, zweryfikowane sekwencyjnie klony z częstotliwością porównywalną do reakcji przygotowanych ręcznie (95%) i przy znacznie krótszym czasie pracy.
Protokół
1. Określ części do użycia w bibliotece urządzeń DNA i wygeneruj instrukcje użytkownika/obsługi cieczy [15 min]
- Korzystając z dowolnej przeglądarki internetowej, przejdź do mocloassembly.com i prześlij pliki Genbank dla wszystkich części DNA, które zostaną uwzględnione w projekcie kombinatorycznego urządzenia DNA.
- Po przesłaniu wszystkich plików wybierz żądane części DNA i przeciągnij je na puste płótno, umieszczając typy części w zamierzonej ostatecznej kolejności części DNA.
UWAGA: Kolekcje części, a także poszczególne części, można wybierać i umieszczać na płótnie. Uporządkuj również części DNA tak, aby zwisy 5' i 3' dla każdej części pasowały. - Kliknij "Zmontuj" w prawym dolnym rogu strony.
UWAGA: Narzędzie wygeneruje tylko prawidłowe, możliwe do zbudowania zespoły na podstawie czterech zwisów par zasad, które otaczają każdą część po trawieniu enzymem BsaI. Jeśli nie istnieją żadne urządzenia DNA do zbudowania na podstawie części przesłanych przez naukowca, narzędzie wskaże, że nie znaleziono żadnych zestawów. - Przejdź do zakładki "Plany" i pobierz pliki wygenerowane przez narzędzie. Pliki te będą obejmować:
- Czytelne dla człowieka mapy płytkowe dla naukowca do przygotowania próbek DNA, a także odczynników niezbędnych do przeprowadzenia reakcji
- "Lista wyboru" dla osoby zajmującej się cieczami
- W pełni oznaczone adnotacje Pliki Genbank dla wszystkich urządzeń DNA, które mają zostać złożone
UWAGA: Położenie ramienia do obsługi cieczy podczas uzyskiwania dostępu do nowego sprzętu laboratoryjnego musi zostać przetestowane. Zapoznaj się z instrukcją producenta, aby uzyskać szczegółowe instrukcje dotyczące regulacji położenia ramienia pipetującego w osiach X, Y i Z w razie potrzeby.
2. Przygotowanie plazmidowego DNA i odczynników do montażu [3 dni]
- [Dzień 1] Używając sterylnej pętli inokulacyjnej i pracując w pobliżu otwartego ognia lub w okapie z przepływem laminarnym, rozprowadź zapasy bakteryjnego glicerolu na płytkach LB-agar uzupełnionych odpowiednim antybiotykiem. Zrób to dla wszystkich niezbędnych części DNA, upewniając się, że wysterylizowałeś pętlę między każdą próbką. Inkubować płytki w temperaturze 37 °C przez noc.
UWAGA: Zamrożone zapasy glicerolu bakteryjnego należy przechowywać na lodzie tak długo, jak to możliwe. Powtarzające się cykle zamrażania i rozmrażania obniżają żywotność stada i należy ich unikać. - [Dzień 2] Używając sterylnej końcówki pipety, wykałaczki lub pętli do zaszczepiania i pracując w pobliżu otwartego ognia lub w kapturze z przepływem laminarnym, zaszczepić 3 ml bulionu LB (uzupełnionego odpowiednim antybiotykiem) pojedynczą kolonią z płytek LB-agar przygotowanych w 2.1. Inkubować kultury przez noc w temperaturze 37 °C, wytrząsając z prędkością 300 obr./min.
- [Dzień 3] Oczyść DNA plazmidu z kultur bakteryjnych za pomocą dowolnego dostępnego na rynku zestawu do oczyszczania plazmidu mini-prep.
- Korzystając z dostarczonego pliku MoClo_Setup.xlsx, rozcieńczyć każdą próbkę plazmidowego DNA do stężenia 20 fmol/μL w wodzie lub buforze TE.
- Postępując zgodnie z mapą płytek w pliku PDF wygenerowanym przez narzędzie do montażu, umieść wskazaną objętość każdej rozcieńczonej części DNA w odpowiednim dołku na 96-dołkowej płytce PCR z pełną osłoną. Trzymaj tę płytkę SetupPlate na lodzie do momentu, gdy będzie potrzebna, lub uszczelnij folią samoprzylepną i przechowuj w temperaturze -20 °C.
- Na lodzie przygotować mieszankę wzorcową reakcji z następującymi składnikami: na każde 20 μl reakcji dodać 2 μl 10x buforu ligazy DNA T4, 0,5 μl ligazy DNA T4 (HC) i 1 μl enzymu BsaI. W pliku MoClo_Setup.xlsx znajduje się arkusz kalkulatora, który w tym pomaga.
- Rozprowadź mastermix enzymów do odpowiednich dołków nowej 96-dołkowej płytki PCR z pełną osłoną, postępując zgodnie z mapą płytki dla ReagentPlate w wygenerowanym pliku PDF. Przechowuj tę płytkę odczynnika na lodzie lub na 96-dołkowym zimnym bloku.
UWAGA: Płytka odczynnika powinna być przygotowana tylko wtedy, gdy jest gotowa do uruchomienia zespołu na urządzeniu do obsługi cieczy.
- Rozprowadź mastermix enzymów do odpowiednich dołków nowej 96-dołkowej płytki PCR z pełną osłoną, postępując zgodnie z mapą płytki dla ReagentPlate w wygenerowanym pliku PDF. Przechowuj tę płytkę odczynnika na lodzie lub na 96-dołkowym zimnym bloku.
3. Wykonaj skrypt montażowy na urządzeniu do obsługi cieczy [zmienna]
- Umieścić płytkę (płytki) SetupPlate, płytkę (płytki) odczynnika (na 96-dołkowym zimnym bloku) oraz niezbędną liczbę pustych 96-dołkowych płytek PCR z pełną osłoną na pokładzie urządzenia do obsługi cieczy. Puste płytki będą płytkami wyjściowymi, w których są montowane reakcje.
- Przygotuj oprogramowanie sterujące cieczą, tworząc instancje każdej przygotowanej próbki i płytki odczynnika, upewniając się, że nazwałeś je dokładnie tak, jak pojawiają się na mapach płytek wygenerowanych przez mocloassembly.com, w tym koryto czystej, dejonizowanej wody oznaczone jako "Zbiornik".
- Za pomocą polecenia "Lista robocza" w oprogramowaniu sterującym, załaduj plik .gwl wygenerowany przez nasze narzędzie programowe, a następnie kolejne polecenie "Lista robocza", które wykona plik .gwl załadowany w pierwszym poleceniu.
- Wykonaj skrypt za pomocą polecenia "Uruchom" oprogramowania kontrolera.
UWAGA: Zawsze pozwól robotowi zajmującemu się cieczami zakończyć wykonywanie skryptu przed próbą uzyskania dostępu do przestrzeni pokładu. - Usuń wszystkie płytki z pokładu urządzenia do obsługi cieczy. Pozostałe DNA można zachować, uszczelniając płytkę SetupPlate aluminiową folią uszczelniającą i przechowując ją w temperaturze -20 °C. Uszczelnij płytkę OutputPlate folią samoprzylepną, umieść w termocyklerze lub bloku grzewczym i uruchom z następującymi parametrami cyklu:
37 °C przez 2 godziny, 50 °C przez 5 min, 80 °C przez 10 min, utrzymywać w temperaturze 4 °C
UWAGA: Po zakończeniu termocyklingu reakcji, płytki wyjściowe można przechowywać w temperaturze -20 °C, dopóki nie będą gotowe do przekształcenia.
4. Przekształć reakcje [1 dzień]
- Rozmrozić na lodzie wymaganą liczbę potrzebnych właściwych podwielokrotności komórek E. coli (10 μl/reakcję).
UWAGA: Aby zachować sterylność, następujące czynności należy wykonać w pobliżu otwartego ognia lub w okapie z przepływem laminarnym.- Podczas rozmrażania komórek przygotuj płytki z agarem LB (zawierające odpowiedni antybiotyk), pipetując 50 μl 0,1 M IPTG i 50 μl 20 mg/mL X-GAL na powierzchnię. Zrób mieszankę wzorcową, jeśli platerujesz dużą liczbę reakcji. Pokryć płytki równomiernie za pomocą sterylnej szklanej pałeczki lub szklanych kulek i pozostawić płytki w temperaturze 37 °C na co najmniej 15 minut przed posiewem bakterii.
UWAGA: Alternatywnie, dodać IPTG i X-Gal do płynnego agaru przed wylaniem płytek, przy końcowym stężeniu 2 mM IPTG i 40 μg/ml X-Gal. Przechowuj te płytki z dala od bezpośredniego światła, ponieważ X-Gal jest wrażliwy na światło.
- Podczas rozmrażania komórek przygotuj płytki z agarem LB (zawierające odpowiedni antybiotyk), pipetując 50 μl 0,1 M IPTG i 50 μl 20 mg/mL X-GAL na powierzchnię. Zrób mieszankę wzorcową, jeśli platerujesz dużą liczbę reakcji. Pokryć płytki równomiernie za pomocą sterylnej szklanej pałeczki lub szklanych kulek i pozostawić płytki w temperaturze 37 °C na co najmniej 15 minut przed posiewem bakterii.
- Na lodzie podamy 10 μl kompetentnych komórek do każdej reakcji na nową 96-dołkową płytkę PCR. To będzie Płyta Transformacji.
- Dodać 1-3 μl każdej reakcji z płytki wyjściowej (płytek) wyjściowych do odpowiedniego dołka na płytce transformacyjnej i inkubować na lodzie przez 5 minut.
- Uszczelnić płytkę transformacyjną folią samoprzylepną i poddać szokowi cieplnemu w termocyklerze w temperaturze 42 °C przez 30 s. Następnie natychmiast umieść talerz na lodzie na 2 minuty.
- Do tych samych dołków płytki transformacyjnej dodać 150 μl pożywki SOC, uszczelnić aluminiową uszczelką klejącą i inkubować w temperaturze 37 °C, wytrząsając z prędkością 900 obr./min przez 1 godzinę.
- Umieścić pełną zawartość każdej studzienki płytki transformacyjnej na płytkach LB-agarowych przygotowanych w 4.1.1 za pomocą sterylnego pręta szklanego lub szklanych kulek w celu równomiernego pokrycia powierzchni płytki. Inkubować płytki w temperaturze 37 °C przez noc.
5. Weryfikacja klonów [2 dni]
- Przygotuj jeden lub kilka 96-dołkowych bloków hodowli głębokiej z 1,5 ml bulionu LB (zawierającego odpowiedni antybiotyk).
- Podobnie jak w kroku 2.2, zaszczepij blok(i) hodowli głębinowej pojedynczymi białymi koloniami z każdej płytki LB-agar przekształconych reakcji.
- Uszczelnić blok(-i) hodowli uszczelką przepuszczającą gaz i inkubować przez noc w temperaturze 37 °C, wytrząsając z prędkością 900 obr./min.
UWAGA: Technika klonowania modułowego wykorzystuje przesiewanie niebiesko-białe, więc dodatnie CFU będą białe na płytce LB-agar, podczas gdy puste wektory docelowe będą niebieskie.
- Wyizolować plazmidowe DNA z kultur bakteryjnych (jak w 2.3) i przesłać do sekwencjonowania Sangera w celu weryfikacji klonów.
Wyniki
W niniejszej pracy demonstrujemy zautomatyzowany modułowy montaż 96 urządzeń DNA z różnych podstawowych części DNA (Rysunek 1b) przy użyciu dwóch zautomatyzowanych robotycznych platform do obsługi cieczy. Każda jednostka transkrypcyjna stanowi liniowy układ promotora, miejsca wiązania rybosomu, genu i terminatora transkrypcji, sklonowany do specyficznego wektora docelowego. Jednostki transkrypcyjne (TUs) są kluczowym elementem w wielu hierarchicznych projektach obwodów genetycznych28,29,30, a zatem stanowią naturalny dowód koncepcji dla tego podejścia. Klonów z potwierdzoną sekwencją można uzyskać w ciągu ok. 5 dni od początku do końca, a ogólny schemat przedstawionego procesu roboczego ukazano na Rysunku 1a.
Wykorzystując opisane narzędzie i protokół, zebraliśmy kilka parametrów przydatnych do określenia optymalnej platformy montażu przy określonej liczbie reakcji klonowania, które naukowiec musi przeprowadzić. Rysunek 2a przedstawia porównanie czasu montażu reakcji w trzech różnych trybach. Czas wykonania to całkowity czas potrzebny na przeprowadzenie wszystkich etapów pipetowania niezbędnych do przygotowania 96 reakcji, co obejmuje dozowanie wszystkich fragmentów DNA i odczynników. Czas pracy manualnej odnosi się do całkowitego czasu, w którym człowiek brał bezpośredni udział w przygotowaniu reakcji klonowania lub w konfiguracji oprogramowania sterującego automatycznym systemem dozującym. Rysunek 2b porównuje koszty między różnymi metodami. Przedstawione koszty dotyczą pojedynczej reakcji przygotowanej każdą z metod i obejmują cenę enzymów oraz jednorazowych końcówek do pipet, przy założeniu najniższej typowej objętości reakcji (20 µL dla systemu dozującego, 10 µL dla metody manualnej, 250 nL dla dozownika akustycznego). Sekwenowano pojedyncze klony ze wszystkich 96 reakcji dla zestawów przygotowanych manualnie i za pomocą systemu dozującego, natomiast dla reakcji z dozownika akustycznego sekwenowano podzbiór 12 klonów (Rysunek 2c). Prawidłowe sekwencje uzyskano dla 95% z 96 zestawów manualnych i przygotowanych automatycznie. W podzbiorze próbek z dozownika akustycznego 83% było prawidłowych, jednak dwie ostatnie reakcje nie przyniosły żadnych białych kolonii, co prawdopodobnie wynikało z niewystarczającego mieszania kropel po zakończeniu dozowania DNA i odczynników. Rysunek 2d ilustruje wydajność reakcji klonowania, mierzoną stosunkiem białych kolonii do całkowitej liczby kolonii, która jest porównywalna dla reakcji przygotowanych manualnie (94%) i za pomocą systemu dozującego (84%). Co ciekawe, przy zmniejszaniu końcowej objętości reakcji za pomocą dozownika akustycznego, zauważyliśmy wyraźny spadek wydajności reakcji, gdy były one przygotowywane w objętościach mniejszych niż 1 µL (Rysunek dodatkowy 1 & Tabela dodatkowa 2). Jest to prawdopodobnie spowodowane odparowywaniem podczas termocyklingu reakcji, co może prowadzić do zwiększenia stężenia soli w mieszaninie reakcyjnej.
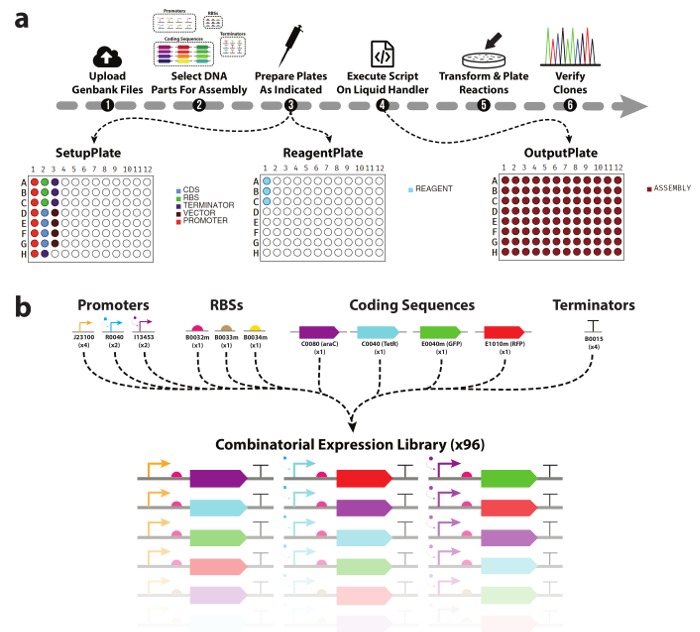
Rysunek 1. Schemat automatycznego procesu składania biblioteki urządzeń DNA.
(a) Przegląd schematu doświadczalnego przedstawionego w niniejszej pracy. (1) W pierwszej kolejności badacze przesyłają pliki Genbank dla wszystkich części DNA & wektory docelowe, których chcą użyć. (2) Następnie wybierane są fragmenty DNA, które mają zostać włączone do konstrukcji. (3) Narzędzie wygeneruje wówczas listę pobrań (picklist) dla automatycznego robota do obsługi cieczy, a także mapy płytek, które pomogą w ręcznym napełnianiu fragmentami DNA i mieszaniną enzymatyczną (mastermix). (4) Wykorzystując DNA & płytki z odczynnikami oraz wygenerowaną listą pobrań (picklist), badacze przeprowadzają montaż reakcji klonowania przy użyciu automatycznego systemu do pipetowania cieczy. (5) Po zakończeniu procesu reakcje są transformowane i wysiewane na płytki w celu przeprowadzenia dalszych analiz. (b) Lista fragmentów DNA wykorzystanych w niniejszej pracy. Do stworzenia kombinatorycznej biblioteki 96 jednostek transkrypcyjnych (TU) wykorzystano łącznie trzy promotory, trzy miejsca wiązania rybosomów, cztery sekwencje kodujące oraz jeden terminator transkrypcji. Kliknij tutaj, aby wyświetlić powiększoną wersję tej figury.
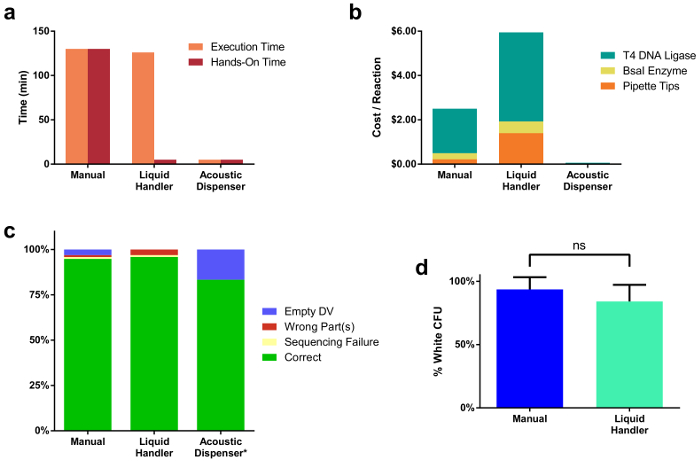
Rycina 2. Porównania trzech różnych modalności przygotowania reakcji.
(a) Czas przygotowania 96 reakcji zmontowanych ręcznie, za pomocą robota do obsługi cieczy oraz za pomocą dyspensera akustycznego. Montaż ręczny zajął 2 h 10 min, z czego cały czas był czasem pracy własnej (hands-on). Robot do obsługi cieczy potrzebował podobnej ilości czasu (2 h 6 min) na wykonanie poleceń pipetowania, jednak tylko ułamek tego czasu (5 min) był czasem pracy własnej. Dyspenser akustyczny potrzebował znacznie mniej czasu na wykonanie transferów cieczy (5 min) i wymagał minimalnego czasu pracy własnej (5 min). (b) Cena za pojedynczą reakcję klonowania dla każdej metody montażu. Cena ta obejmuje koszt użytych enzymów oraz końcówek do pipet. (c) Wyniki sekwencjonowania pojedynczych kolonii wszystkich 96 zmontowanych TUs. Procent poprawnych klonów był porównywalny we wszystkich metodach montażu. Należy zauważyć, że tylko podzbiór (12) z pełnych 96 montaży został poddany transformacji z próbek przygotowanych przez dyspenser akustyczny. Dwie reakcje nie przyniosły żadnych białych kolonii, co prawdopodobnie wynikało z niewystarczającego wymieszania kropli DNA i mastermixu enzymatycznego w OutputPlate. (d) Porównanie wydajności reakcji klonowania między reakcjami przygotowanymi ręcznie a tymi przygotowanymi za pomocą robota do obsługi cieczy. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Rycina dodatkowa 1. Wydajność reakcji spada wraz ze zmniejszaniem objętości reakcji.
Wydajność reakcji wyraźnie spada przy zmniejszaniu objętości reakcji poniżej 1 µL. Tendencja ta jest widoczna przy dwóch różnych końcowych stężeniach DNA; jednak naukowcy mogą zdecydować się na użycie mniejszych objętości w celu obniżenia kosztów odczynników, jeśli dopuszczalna jest niższa wydajność. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 1.
Tabela parametrów klas cieczy DNA i ENZYME dla różnych objętości pipetowania. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 2.
Obliczenia wydajności reakcji. Podano surowe wartości CFU dla 12 z 96 reakcji transformacji przygotowanych ręcznie oraz za pomocą robota do obsługi cieczy. Podano również wartości CFU dla testów mniejszych końcowych objętości reakcji na dyspenserze akustycznym. Kliknij tutaj, aby pobrać ten plik.
Dyskusja
Podsumowując, automatyzacja całego procesu tworzenia urządzenia DNA, od projektowania in-silico po obsługę cieczy, jest realnym celem przy obecnie istniejącej technologii. Oprogramowanie i nowoczesna robotyka umożliwiają tworzenie przepływów pracy, które są opłacalne, efektywne czasowo i skalowalne, a jednocześnie zapewniają bardziej spójne, powtarzalne wyniki niż metody ręczne. Chociaż automatyzacja nie zawsze jest najbardziej opłacalnym wyborem do realizacji protokołu, poprawia odtwarzalność eksperymentów i uwalnia cenny czas badaczy. Jednak w zależności od wykorzystywanego sprzętu, zastosowanie automatyzacji może czasami obniżyć koszty i czas realizacji znacznie poniżej tego, co można osiągnąć za pomocą konwencjonalnych metod ręcznych. Co więcej, automatyzacja przechwytuje protokoły w wyraźny sposób w sformalizowany sposób, zapobiegając eksperymentom opartym na doraźnych, rzemieślniczych i anegdotycznych najlepszych praktykach. Pokazano tu zautomatyzowany montaż modułowych urządzeń DNA, a także dostarczono protokół, pliki elektroniczne i fizyczne zasoby DNA potrzebne czytelnikowi do samodzielnego przeprowadzenia tych i podobnych eksperymentów. Mamy nadzieję, że dostępność naszego narzędzia i publikacja tego protokołu posłużą jako źródło informacji i przesuną tę dziedzinę w kierunku bardziej przejrzystej i wspólnotowej przyszłości w obszarze procesów składania DNA i robotyki do obsługi cieczy.
Użyteczność sprzętu do automatyzacji jest w dużej mierze zależna od konfiguracji i możliwości tego sprzętu. Na przykład nasza maszyna do obsługi cieczy wykorzystuje wypieranie płynów w układzie do uruchamiania poleceń zasysania i dozowania. Tłoki, które napędzają płyn układowy, to stosunkowo duże strzykawki o pojemności 1 ml, które, choć przydatne w przypadku różnych objętości, narzucają dolny limit 2 μl dla dokładnego dozowania odczynników. W związku z tym zwiększyliśmy całkowitą objętość reakcji klonowania ustawionych na urządzeniu do obsługi cieczy do 20 μl, ponieważ każde polecenie dozowania musiało mieć ≥2 μl. To skutecznie podwoiło koszt reakcji w przypadku reakcji przygotowanych do obsługi cieczy, jednak ilość czasu wymaganego do przeprowadzenia tych reakcji została znacznie zmniejszona. Aby rozwiązać ten problem, powtórzyliśmy konfigurację reakcji dla wszystkich 96 reakcji na dozowniku cieczy akustycznej. To urządzenie wykorzystuje energię dźwięku do dozowania płynu bezpośrednio z jednej płytki na drugą i może osiągnąć objętość znacznie poniżej (2,5 nL), co jest możliwe w przypadku standardowych pipet ręcznych opartych na wyporności powietrza. Za pomocą tego urządzenia byliśmy w stanie zmniejszyć całkowitą objętość naszych reakcji do 250 nL, co stanowi 40-krotną redukcję w porównaniu z ręcznie przygotowanymi reakcjami wynoszącymi 10 μL. Ze względu na małe objętości dozowane i brak wymiany końcówek między etapami pipetowania, dozownik akustyczny był w stanie wygenerować te same 96 reakcji w ułamku czasu (<5 min). Mniejsze objętości reakcyjne pozwalają również zaoszczędzić na marnowanych odczynnikach, ponieważ zazwyczaj przekształcamy tylko 1-3 μl reakcji. Biorąc to pod uwagę, zastosowanie sprzętu do automatyzacji, w połączeniu z intuicyjnym oprogramowaniem, może sprawić, że generowanie dużej liczby reakcji składania DNA będzie dostępne dla znacznie szerszego grona odbiorców akademickich.
Tutaj pokazujemy użyteczność naszego narzędzia programowego, jednak istnieje szereg funkcji, które pomogłyby rozszerzyć jego użyteczność. Po pierwsze, za każdym razem, gdy narzędzie jest używane do generowania zespołu kombinatorycznego, muszą zostać wygenerowane nowe płytki części DNA, co wymaga od naukowca ręcznego wypełniania tych płytek dla każdej serii montażu. Zamiast tego byłoby pomocne, gdyby naukowiec mógł określić położenie części na płytce DNA, które mają być użyte w montażu. Pozwoliłoby to na użycie wysokowydajnych zestawów do oczyszczania plazmidowego DNA, ponieważ naukowcy mogliby zaszczepić kultury z zestawu takiego jak biblioteka CIDAR MoClo i oczyścić wszystkie próbki razem, zachowując dobrą lokalizację każdej części określonej w zestawie. Po drugie, narzędzie obsługuje obecnie tylko płytki 96-dołkowe. W przypadku większych projektów, w których konieczne jest zbudowanie kilkuset urządzeń DNA, liczba płytek DNA, odczynników i miejsc docelowych może przekroczyć pojemność pokładu urządzenia do obsługi cieczy. Problem ten mógłby zostać przynajmniej częściowo złagodzony przez wsparcie dla formatów płyt o większej gęstości (384 lub 1536-dołkowe). Wreszcie, narzędzie obsługuje obecnie tylko jeden rodzaj strategii obsługi cieczy i składania DNA. Chociaż stosunkowo łatwo jest przekonwertować instrukcje obsługi cieczy wyprodukowane za pomocą narzędzi na format dozownika akustycznego za pomocą oprogramowania do arkuszy kalkulacyjnych, mamy nadzieję rozszerzyć natywne wsparcie na wiele różnych urządzeń do obsługi cieczy, co znacznie poszerzyłoby jego zastosowanie, podobnie jak kompatybilność z innymi popularnymi technikami składania DNA, takimi jak montaż Gibsona31.
Kluczową częścią tego ekosystemu zautomatyzowanego montażu jest zestaw narzędzi programowych, które przekładają wysokopoziomowe plany montażowe na przyjazne dla automatyzacji protokoły, które są wyraźnie zaplanowane do działania na robotach do obsługi cieczy. Chociaż istnieje wiele narzędzi programowych, które pozwalają naukowcom projektować zespoły in silico, w tym Benchling, MoClo Planner i Raven32, niewiele z nich ma możliwość przekształcenia tych projektów w instrukcje wykonywalne do uruchomienia na urządzeniu do obsługi cieczy. W tym celu rozpoczęły się prace takie jak PR-PR Automation i Puppeteer 33,34,35, które udostępniają te narzędzia. Ponadto podmioty komercyjne działające w tym obszarze poszukują sposobów na wprowadzenie "laboratoriów chmurowych", które świadczą eksperymentalne usługi dla dużych grup użytkowników końcowych za pośrednictwem automatyzacji. Protokół przedstawiony w tym dokumencie może służyć jako element każdego z tych wysiłków, pod warunkiem, że zostanie przedstawiony jako usługa.
Podczas gdy zautomatyzowane składanie urządzeń DNA ma natychmiastową i oczywistą wartość dla biologii syntetycznej, nasz protokół jest również przydatny dla większej społeczności biologów molekularnych. Automatyzacja składania DNA pozwala na równoległe tworzenie dużej liczby znanych, ale podobnych urządzeń genetycznych i może umożliwić szybką syntezę bibliotek ekspresji do celów przesiewowych i testowych w badaniach nad rozwojem leków. Mamy nadzieję, że nasze narzędzie programowe sprawi, że większe wysiłki związane z kombinatorycznym składaniem DNA będą bardziej dostępne i posłużą jako użyteczne źródło informacji zarówno dla biologii syntetycznej, jak i dla szerszej społeczności akademickiej.
Oświadczenia
Densmore jest prezesem i współzałożycielem Lattice Automation, Inc. Timmons i McCarthy są pracownikami Lattice. Lattice tworzy oprogramowanie i usługi do automatyzacji wielu opisanych procesów.
Podziękowania
Dziękujemy Swapnilowi Bhatii, Alejandro Pelaezowi i Johnsonowi Lamowi za pracę nad projektem Lalkarz, a także Swati Carr, Rachael Smith i Thomasowi Costa, za pomoc przy tym rękopisie. Ta praca została sfinansowana przez NSF CAREER Award #1253856. Jest również finansowany przez NSF Expeditions in Computing Award #1522074.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Sprzęt / Oprogramowanie | |||
| Freedom EVO 150 Robot do obsługi cieczy | Tecan | Niestandardowa ładowarka do cieczy wyposażona w 8-kanałowe ramię pipetujące http://lifesciences.tecan.com/products/liquid_handling_and_robotics/freedom_evo | |
| Freedom EVOware Standard (wersja 2.4 Service Pack 2) | Tecan | Oprogramowanie do sterowania płynną ładowarką Freedom EVO 150 http://lifesciences.tecan.com/products/software/freedom_evoware | |
| Echo 550 | Labcyte | Akustyczny dozownik cieczy http://www.labcyte.com/products/liquidhandling/echo-550-liquid-handler | |
| Sorvall Legend RT | Sorvall | Duży stołowy huśtawka z huśtawką | |
| MasterCycler Pro | Eppendorf | 950040015 | Termocykler z 96-dołkowym blokiem grzewczym https://online-shop.eppendorf.us/US-en/PCR-44553/Cyclers-44554/Mastercycler-pro-PF-5193.html |
| ECHOTHERM Sucha kąpiel chłodząco-grzewcza | Torrey Pines Scientific | Blok grzewczy/chłodzący do EVO 150 deck https://www.torreypinesscientific.com/products/chilling-and-heating-dry-baths/echotherm-ric20-series-remote-controlled-chillingheating-dr | |
| Mikrowirówka stołowa 5418 | Eppendorf | 5418000017 | Stardard 18-dołkowa mikrowirówka |
| > https://online-shop.eppendorf.com/OC-en/Centrifugation-44533/Centrifuges-44534/Centrifuges-5418--5418R-PF-9257.htmlNazwa | Firma | Numer katalogowy | Komentarze |
| < strong>Resources | |||
| mocloassembly.com | Lattice Automation | Web-tool do kombinatorycznego montażu DNA mocloassembly.com | |
| CIDAR MoClo Parts Kit | AddGene | 1000000059 | Zestaw bakteryjnych zapasów glicerolu dla wszystkich części DNA użytych w tym badaniu https://www.addgene.org/cloning/moclo/densmore/ |
| CIDAR ICE Registry | CIDAR Lab | Rejestr map plazmidowego DNA https://ice.cidarlab.org/folders/8 https://synbiohub.programmingbiology.org/public/bubdc_ice/bubdc_ice_folder_8/current | |
| Nazwa | Company | Numer katalogowy | Komentarze |
| Labware | |||
| 50 μ L Końcówki przewodzące | Tecan | 30 057 818 | Sterylne 50 μ L Końcówki przewodzące do płynów Tecan http://lifesciences.tecan.com/products/consumables/disposable_tips/liquid_handling_disposable_tips |
| 2 mL Głębokie 96-dołkowe płytki hodowlane | USA Scinetific | 5678-0285 | Płytki do hodowli bakterii używane do hodowli dużej liczby próbek http://www.thermoscientific.com/en/product/nunc-1-3-2-0ml-deepwell-plates-shared-wall-technology.html |
| 1,5 ml Mikrowirówka Probówki | USA Scinetific | 1615-5599 | Jednorazowe probówki do mikrowirówek http://www.usascientific.com/Seal-Rite-1.5-ml-tube-colors.aspx |
| Membrana uszczelniająca Breathe Easier | Sigma-Aldrich | Z763624-100EA | Oddychająca membrana uszczelniająca do płytek do kultur bakteryjnych http://www.sigmaaldrich.com/catalog/product/sigma/z763624?lang=en®ion=US |
| Full-Skirted, Low-Profile, 96-Well Płytki PCR | GeneMate | T-3183-2 | Płytki PCR używane do wszystkich etapów https://www.bioexpress.com/store/catalog/product.jsp?catalog_number=T-3183-R |
| Aluminiowa folia uszczelniająca do płytek PCR | GeneMate | T-2451-1 | Uszczelki aluminiowe do przechowywania płytek PCR https://www.bioexpress.com/store/catalog/product.jsp?catalog_number=T-2451-1 |
| Poliolefinowa folia uszczelniająca do płytek PCR | GeneMate | T-2450-1 | Plastikowe uszczelki do płytek PCR podczas jazdy na rowerze https://www.bioexpress.com/store/catalog/product.jsp?catalog_number=T-2450-1 |
| Chłodnica PCR | Eppendorf | 22510525 | 96-dołkowy blok zimny |
| > https://online-shop.eppendorf.us/US-en/Temperature-Control-and-Mixing-44518/Accessories-44520/PCR-Cooler-PF-55940.htmlNazwa | Company | Numer katalogowy | Komentarze |
| Odczynniki | |||
| GenCatch Plasmid DNA Mini-Prep Kit | Epoch Life Sciences | 2160250 | Zestaw do oczyszczania plazmidowego DNA http://www.epochlifescience.com/Product/PurificationKit/dna_mini.aspx |
| Ligaza DNA T4 (HC) | Promega | M1794 | Ligaza DNA T4 o wysokim stężeniu https://www.promega.com/products/cloning-and-dna-markers/molecular-biology-enzymes-and-reagents/t4-dna-ligase/?catNum=M1794 |
| Enzym restrykcyjny BbsI | New England Biolabs | R0539L | Enzym BbsI w stężeniu 10 000 jednostek/ml https://www.neb.com/products/r0539-bbsi |
| Enzym restrykcyjny BsaI | New England Biolabs | R0535L | Enzym BsaI w ilości 10 000 jednostek/ml https://www.neb.com/products/r3535-bsai-hf |
| Pakiet ligazy DNA T4 | Promega | C1263 | 10x bufor ligazy DNA T4 https://www.promega.com/products/cloning-and-dna-markers/cloning-tools-and-competent-cells/t4-dna-ligase/ |
| Izopropylo-ß-D-tiogalaktopiranozyd (IPTG) | Zymo Research | I1001-25 | 0,5 M roztwór IPTG http://www.zymoresearch.com/buffers-solutions/chemicals/isopropyl-ss-d-thiogalactopyranoside-iptg |
| 5-bromo-4-chloro-3-indolyl ß-D-galaktopyranozyd (X-GAL) | Zymo Research | X1001-25 | 20 mg / ml roztwór X-GAL http://www.zymoresearch.com/buffers-solutions/chemicals/5-bromo-4-chloro-3-indolyl-ss-d-galactopyranoside-x-gal |
| Siarczan kanamycyny | Zymo Research | A1003-25 | 35 mg/ml roztwór kanamycyny http://www.zymoresearch.com/buffers-solutions/antibiotics/kanamycin-sulfate |
| Karbenicylina (sól disodowa) | Fisher | BP26481 | 1 g Karbenicylina (analog ampicyliny) https://www.fishersci.com/shop/products/carbenicillin-disodium-salt-fisher-bioreagents-3/p-25005#?keyword=carbenicillin |
| Soc Bulion Media | Teknova | S0225 | Pożywka proszkowa używana do produkcji bulionu SOC http://www.teknova.com/SOC-BROTH-MEDIA-p/s0225.htm |
| LB Bulion (Lennox) Media | Sigma-Aldrich | L3022-1KG | Pożywka proszkowa używana do produkcji bulionu LB http://www.sigmaaldrich.com/catalog/product/sigma/l3022?lang=en®ion=US |
| Bulion LB z agarem (Lennox) Nośnik | Sigma-Aldrich | L2897-1KG | LB z mieszanką agarową stosowany do wytwarzania płytek z pożywkami stałymi http://www.sigmaaldrich.com/catalog/product/sigma/l2897?lang=en®ion=US |
| Alpha-Select Gold Efficiency Competent Cells | Bioline | BIO-85027 | Wysokowydajne, kompetentne chemicznie komórki E. coli http://www.bioline.com/us/alpha-select-gold-efficiency.html |
| Nazwa | Company | Numer katalogowy< | strong>Komentarze |
| Primers | |||
| Primer VF | 5'-TGCCACCTGACGTCTAAGAA-3' Startery stosowane do sekwencjonowania Sangera i PCR kolonii | ||
| Startery VR | 5'-ATTACCGCCTTTGAGTGAGC-3' Startery używane do sekwencjonowania Sangera i PCR kolonii |
Bibliografia
- Gardner, T. S., Cantor, C. R., Collins, J. J. Construction of a genetic toggle switch in Escherichia coli. Nature. 403 (6767), 339-342 (2000).
- Elowitz, M. B., Leibler, S. A synthetic oscillatory network of transcriptional regulators. Nature. 403 (6767), 335-338 (2000).
- Lutolf, M. P., Hubbell, J. A. Synthetic biomaterials as instructive extracellular microenvironments for morphogenesis in tissue engineering. Nat Biotechnol. 23 (1), 47-55 (2005).
- Anderson, J. C., Clarke, E. J., Arkin, A. P., Voigt, C. A. Environmentally controlled invasion of cancer cells by engineered bacteria. J Mol Biol. 355 (4), 619-627 (2006).
- Xie, Z., Wroblewska, L., Prochazka, L., Weiss, R., Benenson, Y. Multi-input RNAi-based logic circuit for identification of specific cancer cells. Science. 333 (6047), 1307-1311 (2011).
- Ro, D. K., et al. Production of the antimalarial drug precursor artemisinic acid in engineered yeast. Nature. 440 (7086), 940-943 (2006).
- Georgianna, D. R., Mayfield, S. P. Exploiting diversity and synthetic biology for the production of algal biofuels. Nature. 488 (7411), 329-335 (2012).
- Savage, D. F., Way, J., Silver, P. A. Defossiling fuel: how synthetic biology can transform biofuel production. ACS Chem Biol. 3 (1), 13-16 (2008).
- Fussenegger, M., et al. Streptogramin-based gene regulation systems for mammalian cells. Nat Biotechnol. 18 (11), 1203-1208 (2000).
- Boorsma, M., et al. A temperature-regulated replicon-based DNA expression system. Nat Biotechnol. 18 (4), 429-432 (2000).
- Malphettes, L., et al. A novel mammalian expression system derived from components coordinating nicotine degradation in arthrobacter nicotinovorans pAO1. Nucleic Acids Res. 33 (12), e107(2005).
- Brophy, J. A., Voigt, C. A. Principles of genetic circuit design. Nat Methods. 11 (5), 508-520 (2014).
- Lou, C., Stanton, B., Chen, Y. J., Munsky, B., Voigt, C. A. Ribozyme-based insulator parts buffer synthetic circuits from genetic context. Nat Biotechnol. , (2012).
- Cardinale, S., Arkin, A. P. Contextualizing context for synthetic biology--identifying causes of failure of synthetic biological systems. Biotechnol J. 7 (7), 856-866 (2012).
- Carr, S. B., Beal, J., Densmore, D. M. Reducing DNA context dependence in bacterial promoters. PLoS One. 12 (4), e0176013(2017).
- Yeung, E., Ng, A., Kim, J., Sun, Z. Z., Murray, R. M. Decision and Control (CDC), 2014 IEEE 53rd Annual Conference on. , 5405-5412 (2014).
- Engler, C., Gruetzner, R., Kandzia, R., Marillonnet, S. Golden gate shuffling: a one-pot DNA shuffling method based on type IIs restriction enzymes. PLoS One. 4 (5), e5553(2009).
- Weber, E., Engler, C., Gruetzner, R., Werner, S., Marillonnet, S. A modular cloning system for standardized assembly of multigene constructs. PLoS One. 6 (2), e16765(2011).
- Iverson, S. V., Haddock, T. L., Beal, J., Densmore, D. M. CIDAR MoClo: Improved MoClo Assembly Standard and New E. coli Part Library Enable Rapid Combinatorial Design for Synthetic and Traditional Biology. ACS Synth Biol. 5 (1), 99-103 (2016).
- Casini, A., Storch, M., Baldwin, G. S., Ellis, T. Bricks and blueprints: methods and standards for DNA assembly. Nat Rev Mol Cell Biol. 16 (9), 568-576 (2015).
- Bhatia, S. P., Smanski, M., Voigt, C. A., Densmore, D. M. Genetic design via combinatorial constraint specification. ACS Synth Biol. , (2017).
- Ham, T. S., et al. Design, implementation and practice of JBEI-ICE: an open source biological part registry platform and tools. Nucleic Acids Res. 40 (18), e141(2012).
- Madsen, C., et al. The SBOL Stack: A Platform for Storing, Publishing, and Sharing Synthetic Biology Designs. ACS Synth Biol. 5 (6), 487-497 (2016).
- Knight, T. Draft standard for BioBrick biological parts. , (2007).
- Gibson, D. G., et al. Enzymatic assembly of DNA molecules up to several hundred kilobases. Nat Methods. 6 (5), 343-345 (2009).
- Ma, A. C., et al. FusX: A Rapid One-Step Transcription Activator-Like Effector Assembly System for Genome Science. Hum Gene Ther. 27 (6), 451-463 (2016).
- Check Hayden, E. The automated lab. Nature. 516 (7529), 131-132 (2014).
- Nielsen, A. A., et al. Genetic circuit design automation. Science. 352 (6281), aac7341(2016).
- Woodruff, L. B. A., et al. Registry in a tube: multiplexed pools of retrievable parts for genetic design space exploration. Nucleic Acids Res. 45 (3), 1553-1565 (2017).
- Hasty, J., McMillen, D., Collins, J. J. Engineered gene circuits. Nature. 420 (6912), 224-230 (2002).
- Gibson, D. G. Enzymatic assembly of overlapping DNA fragments. Methods Enzymol. 498, 349-361 (2011).
- Appleton, E., Tao, J., Haddock, T., Densmore, D. Interactive assembly algorithms for molecular cloning. Nat Methods. 11 (6), 657-662 (2014).
- Vasilev, V., Liu, C., Haddock, T., Bhatia, S., Adler, A., Yaman, F., Beal, J., Babb, J., Weiss, R., Densmore, D. A Software Stack for Specification and Robotic Execution of Protocols for Synthetic Biological Engineering. SynBERC Fall Retreat, Harvard University. , (2011).
- Beal, J., et al. An end-to-end workflow for engineering of biological networks from high-level specifications. ACS Synth Biol. 1 (8), 317-331 (2012).
- Bhatia, S., Densmore, D. Pigeon: a design visualizer for synthetic biology. ACS Synth Biol. 2 (6), 348-350 (2013).
Przedruki i uprawnienia
