Sekwencjonowanie pojedynczych komórek jest coraz bardziej popularnym i dostępnym narzędziem do rozwiązywania problemów związanych ze zmianami genomowymi w wysokiej rozdzielczości. Udostępniamy protokół, który wykorzystuje sekwencjonowanie pojedynczych komórek do identyfikacji zmian liczby kopii w pojedynczych komórkach.
Artykuł metodologiczny
Wykrywanie zmian numeru kopii za pomocą sekwencjonowania pojedynczych komórek
W tym artykule
Podsumowanie
Streszczenie
Wykrywanie zmian genomowych w rozdzielczości pojedynczej komórki jest ważne dla scharakteryzowania genetycznej heterogeniczności i ewolucji w normalnych tkankach, nowotworach i populacjach mikroorganizmów. Tradycyjne metody oceny heterogeniczności genetycznej były ograniczone przez niską rozdzielczość, niską czułość i/lub niską swoistość. Sekwencjonowanie pojedynczych komórek stało się potężnym narzędziem do wykrywania heterogeniczności genetycznej z wysoką rozdzielczością, wysoką czułością i, po odpowiedniej analizie, wysoką swoistością. Tutaj przedstawiamy protokół izolacji, amplifikacji całego genomu, sekwencjonowania i analizy pojedynczych komórek. Nasze podejście pozwala na wiarygodną identyfikację wariantów liczby kopii w skali megabazowej w pojedynczych komórkach. Jednak aspekty tego protokołu mogą być również stosowane do badania innych rodzajów zmian genetycznych w pojedynczych komórkach.
Wprowadzenie
Zmiany w liczbie kopii DNA mogą wahać się od kilku par zasad (warianty liczby kopii) (CNV) do całych chromosomów (aneuploidia). Zmiany liczby kopii wpływające na duże obszary genomu mogą mieć znaczące konsekwencje fenotypowe poprzez zmianę ekspresji nawet tysięcy genów1,2. CNV, które są obecne we wszystkich komórkach populacji, mogą być wykrywane za pomocą sekwencjonowania zbiorczego lub metod opartych na mikromacierzach3,4. Jednak populacje mogą być również genetycznie heterogeniczne, przy czym CNV istnieją w podzbiorze populacji lub nawet w pojedynczych komórkach. Heterogeniczność genetyczna jest powszechna w nowotworach, napędzając ewolucję guza, a także występuje w normalnych tkankach, z nieznanymi konsekwencjami5,6,7,8,9,10.
Tradycyjnie, heterogeniczność genetyczna była oceniana albo za pomocą metod cytologicznych, albo sekwencjonowania zbiorczego. Podejścia cytologiczne, takie jak fluorescencyjna hybrydyzacja in situ (FISH), rozprzestrzenianie chromosomów i kariotypowanie spektralne (SKY), mają tę zaletę, że identyfikują zmiany obecne w poszczególnych komórkach, ale mają wysokie wskaźniki błędów ze względu na artefakty hybrydyzacji i rozprzestrzeniania się11. Podejścia te są również ograniczone pod względem rozdzielczości - ujawniają tylko zmiany liczby kopii obejmujące kilka megabaz. Sekwencjonowanie lub mikromacierze masowego DNA, choć mają wyższą dokładność i rozdzielczość, są mniej czułe. Aby wykryć heterogeniczność genetyczną za pomocą podejść populacyjnych, warianty muszą być obecne w znacznej części komórek w populacji. Pojawienie się metod amplifikacji genomowego DNA z pojedynczych komórek umożliwiło sekwencjonowanie genomu pojedynczych komórek. Sekwencjonowanie pojedynczych komórek ma zalety wysokiej rozdzielczości, wysokiej czułości i, gdy stosowane są odpowiednie metody kontroli jakości, wysokiej dokładności12.
Tutaj opisujemy metodę wykrywania zmian liczby kopii w skali megabazowej w pojedynczych komórkach. Izolujemy pojedyncze komórki za pomocą mikroaspiracji, amplifikujemy genomowe DNA za pomocą PCR łącznika-adaptera, przygotowujemy biblioteki do sekwencjonowania nowej generacji i wykrywamy warianty liczby kopii zarówno za pomocą ukrytego modelu Markowa, jak i kołowej segmentacji binarnej.
Protokół
1. Izolowanie pojedynczych komórek
- Przygotuj mikroaspirator
- Zdejmij przezroczystą plastikową końcówkę z zespołu rurki aspiratora i włóż wąski koniec do jednego końca rurki PVC o długości 1 stopy i średnicy wewnętrznej 3/16".
- Włóż wylot filtra strzykawkowego 0.2 μm do drugiego końca rurki PVC o długości 1 stopy i średnicy wewnętrznej 3/6".
- Włóż wlot filtra strzykawkowego 0.2 μm do jednego końca rurki PVC o długości 6 cali i średnicy wewnętrznej 5/16".
- Opcjonalnie: Przetnij rurkę PVC o długości 6 cali i średnicy wewnętrznej 5/16" na pół i włóż syfon w linii między dwie połówki.
- Rozbij plastikową pipetę serologiczną o pojemności 5 ml z podziałką 1 ml i włóż złamany koniec do otwartego końca rurki PVC o średnicy wewnętrznej 5/16".
- Włożyć wylot plastikowej pipety serologicznej o pojemności 5 ml do elastycznego końca zespołu probówki aspiratora (w miejscu, z którego usunięto przezroczystą plastikową końcówkę).
- Do przechowywania przykryj czerwony ustnik zespołu rurki aspiratora sterylną plastikową rurką.
- Wyciągnij szklaną rurkę kapilarną do średnicy wewnętrznej 10-30 μm, zbliżając środek rurki do płomienia palnika Bunsena i wywierając napięcie na obu końcach rurki. Przerwij narysowaną rurkę na środku, aby utworzyć dwie potencjalne igły aspiratora. Powtórz ten krok z kilkoma probówkami, ponieważ tylko niektóre rurki będą miały średnicę wewnętrzną, która jest odpowiednia do wybierania pojedynczych komórek.
- Do przechowywania umieść dwa paski plasteliny na 15-centymetrowej szalce Petriego i przymocuj igły aspiratora w poprzek pasków.
- Wskaż komórki
- Przygotować zawiesinę z pojedynczą komórką, odpowiednią dla typu komórki i eksperymentu. Na przykład, aby przygotować przylegające komórki, takie jak ludzkie linie komórkowe fibroblastów, należy zebrać komórki przez trypsynizację i przenieść komórki do stożkowej rurki zawierającej odpowiednią pożywkę.
- Przed, w trakcie lub po przygotowaniu zawiesiny pojedynczej komórki (w zależności od czasu potrzebnego na przygotowanie zawiesiny pojedynczej komórki) ustaw kaptur do amplifikacji całego genomu.
- Spryskaj powierzchnię kaptura, pudełka na końcówki do pipet i końcówki do pipet 10% wybielaczem i wytrzyj ręcznikiem papierowym. Powtórz ten krok z 70% etanolem.
- Dodaj 8 μl wody z zestawu do amplifikacji całego genomu (WGA) do pojedynczych dołków 96-dołkowej płytki PCR, po jednym dołku na każdą komórkę, która ma być sekwencjonowana. Przykryj 96-dołkową płytkę do PCR pokrywką z 96-dołkowej płytki do hodowli tkankowej i umieść na lodzie.
- Dodać 1000 komórek do 10 ml pożywki lub soli fizjologicznej buforowanej fosforanami (PBS) na 15-centymetrowej szalce Petriego i umieścić naczynie na lodzie, aby zapobiec przywieraniu komórek do naczynia.
- Przynieś komórki na szalce Petriego i 96-dołkową płytkę do PCR z pokrywką na lodzie do mikroskopu świetlnego z obiektywem 10X.
- Zwiększ otwór igły aspiratora, delikatnie stukając wyciągniętym końcem igły aspiratora o twardą powierzchnię, tak aby końcówka się oderwała. Włóż szeroki koniec igły aspiratora do przezroczystego końca mikroaspiratora.
- Umieścić szalkę Petriego zawierającą komórki na stoliku mikroskopu. Umieść czerwony ustnik aspiratora w ustach. Jedną ręką przesuwaj igłę aspiratora, a drugą ręką przesuwaj szalkę Petriego zawierającą komórki. Zidentyfikuj pojedyncze komórki, które mają zostać zsekwencjonowane.
- Za pomocą odsysania przez usta wciągnij pojedynczą komórkę do igły aspiratora wraz z ~1-2 μL pożywki lub PBS. Przenieś komórkę do 8 μl wody wewnątrz pojedynczego dołka 96-dołkowej płytki PCR. Unikaj wprowadzania pęcherzyków podczas przenoszenia komórki.
- Powtarzaj krok 1.2.7, aż żądana liczba komórek zostanie odizolowana. Trzymaj płytkę PCR na lodzie i przykryj pokrywką między komórkami do pobrania. Zaznacz studzienki, w których otrzymały się komórki.
- Podczas wybierania pojedynczych komórek rozmrozić 10-krotny bufor do lizy i fragmentacji pojedynczych komórek z całego zestawu do amplifikacji genomu. Po wybraniu żądanej liczby komórek należy natychmiast przystąpić do amplifikacji całego genomu.
2. Amplifikacja całego genomu
- Aby zapobiec zanieczyszczeniu podczas amplifikacji całego genomu, dodaj wszystkie odczynniki do okapu do hodowli tkankowej, użyj końcówek do pipet z filtrami i zmień końcówkę pipety między studzienkami.
- Przygotuj działający roztwór buforowy do lizy i fragmentacji z zestawu do amplifikacji całego genomu (WGA). Dla każdego zestawu do 32 komórek połącz 32 μl 10x buforu do lizy i fragmentacji pojedynczych komórek oraz 2 μl roztworu proteinazy K w probówce do mikrowirówki. Wiruj rurkę, aby wymieszać roztwory.
- Dodać 1 μl roboczego roztworu buforowego do lizy i fragmentacji do każdej studzienki i pipetować w górę iw dół, aby wymieszać.
- Przykryj płytkę i uszczelnij wszystkie studzienki folią z tworzywa sztucznego. Krótko odwirować płytkę w mini wirówce do płytek.
- Następujący cykl termiczny: 50 °C, 1 h i 99 °C, 4 min.
- Ostudzić płytkę na lodzie i krótko odwirować płytkę w mini wirówce do talerzy.
- Przygotuj działający roztwór buforowy do przygotowania biblioteki z całego zestawu do amplifikacji genomu. Dla każdej komórki połącz 2 μl 1x buforu do przygotowania biblioteki pojedynczej komórki i 1 μl roztworu stabilizującego bibliotekę w probówce mikrowirówkowej. Przygotuj roztwór roboczy dla kilku komórek w tej samej probówce do mikrowirówki.
- Usuń folię z tworzywa sztucznego i dodaj 3 μl roztworu buforowego do przygotowania biblioteki roboczej do każdego dołka. Odpipetować zawartość studzienki w górę i w dół, aby wymieszać. Wymień plastikową folię.
UWAGA: Folia z tworzywa sztucznego może być ponownie wykorzystana w całym procesie amplifikacji genomu, dopóki studzienki nie zaczną wiercić otworów w folii. W takim przypadku zmień folię na nową z tworzywa sztucznego. - Krótko odwirować płytkę w mini wirówce do płytek i inkubować w temperaturze 95 °C przez 2 minuty.
- Ostudzić płytkę na lodzie i krótko odwirować płytkę w mini wirówce do talerzy.
- Usuń folię z tworzywa sztucznego, dodaj 1 μl enzymu do przygotowania biblioteki do każdego dołka i pipetuj zawartość studzienki w górę iw dół, aby wymieszać. Na tym etapie należy przechowywać enzym przygotowawczy w bibliotece na lodzie lub w zimnym bloku. Wymień plastikową folię.
- Krótko odwirować płytkę w mini wirówce płytkowej i cyklu termicznym w następujący sposób: 16 °C, 20 min, 24 °C, 20 min, 37 °C, 20 min, 75 °C, 5 min i utrzymywać w temperaturze 4 °C.
- Ostudzić płytkę na lodzie i krótko odwirować płytkę w mini wirówce do talerzy.
- Przygotuj działającą mieszankę amplifikacyjną z całego zestawu do amplifikacji genomu. Dla każdej komórki połącz 48,5 μl wody, 7,5 μl 10-krotnej amplifikacji głównej mieszanki i 5 μl polimerazy DNA WGA w probówce do mikrowirówki. Przygotuj mieszaninę roboczą dla kilku komórek w tej samej probówce do mikrowirówki. Utrzymuj mieszankę roboczą na lodzie.
- Usuń folię z tworzywa sztucznego, dodaj 61 μl roboczej mieszanki amplifikacyjnej do każdego dołka i pipetuj zawartość studzienki w górę iw dół, aby wymieszać. Na tym etapie utrzymuj działającą mieszankę wzmacniającą na lodzie lub w zimnym bloku. Wymień plastikową folię.
- Krótko odwirować płytkę w mini wirówce do płytek i cyklu termicznego w następujący sposób: 95 °C, 3 min, 25 cykli 94 °C, 30 sekund i 65 °C, 5 minut i utrzymywać w temperaturze 4 °C.
- Przenieść 60 μl każdej próbki do oddzielnej probówki do mikrowirówki i przechowywać w temperaturze -20 °C do wykorzystania w kroku 3.
- Dodać barwnik ładujący DNA do pozostałej objętości każdej próbki (tj. 3 μl 6-krotnego barwnika obciążającego DNA na 15 μl próbki) i przeprowadzić 5 μl z każdej reakcji na 1% żelu agarozowym.
UWAGA: Komórki, które pomyślnie uległy amplifikacji, pojawią się jako rozmaz od 250 do 1,000 pz. Jest mało prawdopodobne, aby próbki, które nie wykazały rozmazu lub wykazywały tylko słaby rozmaz, dostarczyły użytecznych danych sekwencjonowania.
3. Sekwencjonowanie
- Oczyść próbki za pomocą kulek paramagnetycznych.
- Rozmrozić próbki DNA na lodzie. Wirować kulki paramagnetyczne, aż roztwór będzie jednorodny i inkubować kulki w temperaturze pokojowej przez co najmniej 30 minut.
- Przenieść 20 μl każdej próbki DNA do czystej probówki do mikrowirówki. Pozostałą część próbki można przechowywać w temperaturze -20 °C.
- Dodaj 30 μl (1,5x) kulek paramagnetycznych do każdej próbki DNA i wymieszaj. Próbki należy inkubować w temperaturze pokojowej przez 10 minut. Pozostawić roztwór podstawowy kulek w temperaturze pokojowej do użycia w kroku 3.4.
- Umieść probówki na magnetycznym pasku probówki na 2 minuty lub do momentu, gdy kulki utworzą osad, a supernatant będzie klarowny.
- Za pomocą pipety P200 usuń jak najwięcej supernatantu, nie naruszając kulek.
- Dodać 180 μl 80% etanolu do mieszaniny DNA-kulki. Obróć rurki kilka razy względem magnesu, aby "przepłukać" kulki przez roztwór etanolu.
- Za pomocą pipety P200 usuń jak najwięcej płynu z etanolu, nie naruszając kulek.
- Powtórzyć czynności 3.1.6 i 3.1.7.
- Suszyć kulki na powietrzu przez około 10 minut lub do momentu, gdy nie będzie już widać etanolu. Przejdź do następnego kroku, gdy koraliki wydają się pęknięte lub spadają ze ścianki rurki.
- Usuń próbki z paska magnetycznego. Dodaj 40 μl 10 mM Tris pH 8,0, aby wymyć DNA z kulek i zwirować próbki, aby ponownie zawiesić kulki. Inkubować przez 2 minuty w temperaturze pokojowej.
- Krótko odwirować próbki, aby zebrać ciecz na dnie probówki i umieścić probówki na pasku probówki magnetycznej na co najmniej dwie minuty. Przenieść eluent do czystych probówek do mikrowirówek, nie naruszając kulek.
- Normalizacja próbki
- Określić ilościowo stężenie każdej próbki za pomocą spektrofotometru. Stężenia powinny wynosić od 10 do 30 ng/μl.
- Rozcieńczyć każdą próbkę do 0,2 ng/μl za pomocą 10 mM Tris pH 8,0. Poniższe kroki będą wymagały minimalnego dopływu 5 μl z tego rozcieńczenia.
- Przygotowanie biblioteki
- Przygotuj biblioteki sekwencjonowania, postępując zgodnie z instrukcjami zestawu do przygotowywania biblioteki13.
- Końcowe sprzątanie
- Oczyść próbki zgodnie z krokiem 3.1. W przypadku długości odczytu 50 pz, 75 pz lub 150 pz należy użyć stosunku ściegu do objętości próbki wynoszącego odpowiednio 1,5x, 1x lub 0,6x. Eluować za pomocą 15 μl 10 mM Tris pH 8,0.
- Uruchom próbki w analizatorze fragmentów, aby sprawdzić rozkład rozmiaru biblioteki14. Rozkład wielkości powinien być równomiernie rozłożony od 150 do 900 pz.
- Oznaczanie ilościowe próbek za pomocą qPCR
- Korzystając z bibliotecznego zestawu do kwantyfikacji, skonfiguruj reakcję qPCR zgodnie z instrukcjami zestawu15. Pozostaw pustą kolumnę, aby dodać wzorce dodatnie (wzorce DNA z zestawu) i normy ujemne (woda lub inny roztwór ślepej próby).
- Cykl termiczny w następujący sposób: 95 °C, 5 min (szybkość narastania 4,8 °C/s) i 35 cykli 95 °C, 30 sekund (szybkość narastania 4,8 °C/s) i 60 °C, 45 sekund (szybkość narastania 2,5 °C/s).
- Buforowanie
- Określ, ile pasów w komorze przepływowej jest potrzebnych i podziel próbki na grupy, po jednej grupie na tor.
- Dla każdej grupy próbek należy wybrać próbkę o najniższym stężeniu na podstawie danych qPCR z kroku 3.5.2 i znormalizować wszystkie próbki w tej grupie do tego stężenia przy użyciu 10 mM Tris pH 8,0.
- Zbierz próbki w każdej grupie.
- Sekwencjonowanie
- Załaduj pule na maszynę sekwencjonującą nowej generacji zgodnie ze standardowymi procedurami16.
4. Analiza danych
UWAGA: Środowisko oparte na Uniksie jest wymagane do uruchamiania programów i skryptów w tej sekcji. Zainstaluj oprogramowanie wymienione w protokole, postępując zgodnie z instrukcjami instalacji. Wszystkie skrypty można znaleźć na stronie https://sourceforge.net/projects/singlecellseqcnv/.
- Przytnij odczyty do 40-nt za pomocą fastx_trimmer z FASTX-Toolkit w wersji 0.0.1317.
fastx_trimmer -Q33 -i przyklad.fastq -l 40 -o przyklad.przytnij.fastq - Dopasuj odczyty do odpowiedniego genomu referencyjnego (mm9 dla myszy, hg19 dla człowieka) przy użyciu BWA w wersji 0.6.1 z opcjami domyślnymi18.
bwa aln mm9.fa example.trim.fastq >example.sai
bwa samse mm9.fa example.sai example.trim.fastq >example.sam - Usuń dopasowania do chrM i losowych chromosomów, a następnie posortuj i zindeksuj wynikowy plik BAM za pomocą SAMTools w wersji 0.1.1919.
grep -v -w chrM przyklad.sam |grep -v losowy >przyklad.filtrowany.sam
samtools view -uSh przyklad.filtrowany.sam | Samtools sort - example.filtered
samtools index example.filtered.bam - Uruchom HMMcopy, aby wykryć CNVs20
- Użyj gcCounter w HMMcopy, aby wygenerować plik referencyjny procentu GC dla genomu. Użyj opcji "-w 500000", aby określić rozmiar okna. Użyj tej samej wersji pliku referencyjnego fasta, która została użyta w kroku 4.2, ale upewnij się, że chrM i losowe chromosomy zostały usunięte z pliku fasta.
gcCounter -w 500000 mm9.fa >mm9_gc.wig - Użyj generateMap.pl w HMMcopy, aby wygenerować plik wiggle w celu mapowania. Użyj opcji "-w 40", aby określić długość odczytu. Użyj tego samego pliku referencyjnego fasta, który został użyty w kroku 4.4.1.
generateMap.pl -b mm9.fa
generateMap.pl -w 40 -i mm9.fa mm9.fa -o mm9.bigwig - Użyj mapCounter w HMMcopy, aby wygenerować plik referencyjny mapokowalności dla genomu. Użyj opcji "-w 500000", aby określić rozmiar okna.
mapCounter -w 500000 mm9.bigwig >mm9_map.wig - Użyj readCounter w HMMcopy, aby wygenerować plik wiggle dla każdego pliku BAM.
readCounter -w 500000 example.filtered.bam >input.wig - Zmodyfikuj ścieżki do plików referencyjnych w skryptach R (run_hmmcopy.mm9.r lub run_hmmcopy.hg19.r), użyj plików wygenerowanych powyżej w 4.4.1 (np. mm9_gc.wig) i 4.4.3 (np. mm9_map.wig) dla zmiennych gfile i mfile, które odnoszą się odpowiednio do pliku referencyjnego GC percentage i pliku referencyjnego mappability. Następnie uruchom dostarczony skrypt języka R "run_hmmcopy.mm9.r" lub "run_hmmcopy.hg19.r".
R CMD WSAD run_hmmcopy.mm9.r
lub
R WSAD CMD run_hmmcopy.hg19.r - W przypadku przetwarzania wsadowego zestawu plików BAM umieść pliki BAM w jednym folderze i uruchom dostarczony skrypt "HMMpipe.pl" w pakiecie, aby wywołać segmenty i obliczyć wyniki zmienności (VS). Postępuj zgodnie z formatem:
perl HMMpipe.pl Folder_to_BAMfiles mm9
- Użyj gcCounter w HMMcopy, aby wygenerować plik referencyjny procentu GC dla genomu. Użyj opcji "-w 500000", aby określić rozmiar okna. Użyj tej samej wersji pliku referencyjnego fasta, która została użyta w kroku 4.2, ale upewnij się, że chrM i losowe chromosomy zostały usunięte z pliku fasta.
- Uruchom DNAcopy, aby wykryć CNVs21.
- Użyj SAMtools w wersji 0.1.19, aby wyodrębnić unikatowo zmapowane odczyty z każdego pliku BAM.
samtools view -h -F 0x0004 przykład.filtrowany.bam | egrep -i "^@|XT:A:U" |samtools view -Shu - >example.mapped.bam - Użyj MarkDuplicates w Picard w wersji 1.94, aby oznaczyć duplikaty PCR w pliku BAM22.
java -jar MarkDuplicates.jar INPUT=example.mapped.bam OUTPUT=example.nondup.bam METRICS_FILE=example.dup REMOVE_DUPLICATES=true - Użyj coveragebed w bedtools w wersji 2.17.0, aby policzyć zmapowane odczyty w każdym z predefiniowanych dynamicznych 500kb mapowalnych okien w dostarczonym pliku BED "mm9.500k.dynamic.win.bed" lub "hg19.500k.dynamic.win.bed"23.
coverageBed -abam example.nondup.bam -b mm9.500k.dynamic.win.bed -counts | sortowanie -k1,1 -k2,2n >przyklad.nondup.counts - Użyj dostarczonego skryptu Perla "normalizeGC.pl", aby znormalizować liczniki odczytów na podstawie dostarczonego pliku referencyjnego zawartości GC "mm9.500k.dynamic.win.fa.gc.txt" lub "hg19.500k.dynamic.win.fa.gc.txt".
Perl normalizeGC.pl mm9.500k.dynamic.win.fa.gc.txt example.nondup.counts >example.bam.norm.counts - Użyj dostarczonego skryptu języka R "dnacopy.r", aby wywołać segments.
R CMD BATCH dnacopy.r
- Użyj SAMtools w wersji 0.1.19, aby wyodrębnić unikatowo zmapowane odczyty z każdego pliku BAM.
- Identyfikowanie CNV
- Wyklucz komórki, dla których VS obliczony w 4.4.6 przekracza 0,26.
- Przefiltruj segmenty wywołane przez HMMcopy w 4.4.6, aby uwzględnić tylko te, dla których mediana współczynnika logarytmu2 jest większa niż 0,4 (przypuszczalny zysk) lub mniejsza niż -0,35 (przypuszczalna strata).
- Przefiltrować segmenty wywołane przez DNAcopy w ppkt 4.5.5 tak, aby obejmowały tylko te, dla których średnia segmentu jest większa niż 1,32 lub mniejsza niż 0,6.
- Nakładaj na siebie segmenty z 4.6.2 i 4.6.3, wywołując CNV tylko w regionach, w których zarówno HMMcopy, jak i DNAcopy identyfikują przypuszczalny zysk lub przypuszczalną stratę.
Wyniki
Zmontowany aspirator powinien wyglądać podobnie do urządzenia przedstawionego na Rysunku 1A. Igłę należy wciągnąć tak, aby była wystarczająco szeroka, by pomieścić jedną komórkę, ale nie tak szeroka, aby wraz z pojedynczą komórką zassać dużą objętość cieczy. Aspiracja pojedynczych komórek jest najłatwiejsza, gdy w polu widzenia 10X znajduje się od jednej do pięciu komórek (Rysunek 1B).
Jeśli amplifikacja całego genomu przebiegła pomyślnie, próbka w postaci smugi będzie widoczna na żelu agarozowym (Rysunek 2, ścieżki 1, 2, 4, 5, 6 i 7). Słaba lub nieobecna smuga wskazuje na nieudaną reakcję amplifikacji i takiej próbki nie należy sekwenować (Rysunek 2, ścieżki 3 i 8).
Po przygotowaniu bibliotek należy ocenić rozkład wielkości fragmentów próbek za pomocą elektroforezy kapilarnej na analizatorze fragmentów. Prawidłowo przygotowane biblioteki będą wykazywać dość równomierny rozkład wielkości fragmentów od 150 do 90 bp (Rysunek 3, A,B). Nieudane przygotowanie biblioteki spowoduje zaburzony rozkład wielkości fragmentów; takich bibliotek nie należy sekwencjonować (Rysunek 3C).
Przetwarzanie danych sekwencjonowania za pomocą ukrytego modelu Markowa (HMMcopy) oraz kolistej segmentacji binarnej (DNAcopy) pozwoli na podział genomu każdej komórki na segmenty o oszacowanej liczbie kopii. Segmenty te można następnie przefiltrować, aby zidentyfikować te, których oszacowana liczba kopii jest zgodna z przyrostem lub utratą w pojedynczej komórce (Tabela 1). Tak przefiltrowane segmenty z HMMcopy oraz DNAcopy powinny zostać następnie nałożone na siebie w celu zidentyfikowania CNV o wysokim stopniu pewności.
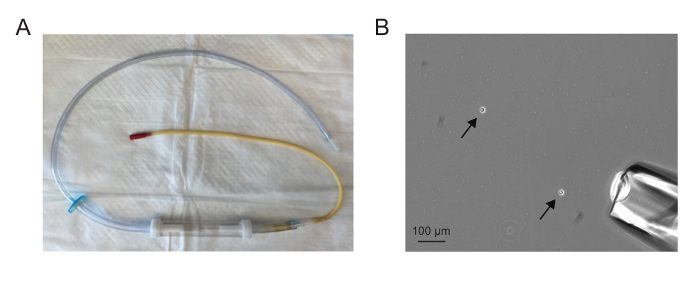
Rysunek 1. Izolacja pojedynczych komórek. (A) Złożony mikroaspirator. (B) Pole widzenia przy powiększeniu 10X ukazujące dysocjowane komórki (strzałki) oraz igłę mikroaspiratora (prawy dolny róg). Aspiracja pojedynczych komórek jest najłatwiejsza, gdy w polu 10X znajduje się od jednej do pięciu komórek. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.

Rysunek 2. Amplifikacja całego genomu. Elektroforeza żelowa w agarozie 5 µl produktów amplifikacji całego genomu. Próbki, w których amplifikacja przebiegła pomyślnie, będą widoczne jako jasne smugi w zakresie od 10 bp do 1 kb (ścieżki 1, 2, 4, 5, 6 i 7) i mogą zostać poddane sekwencjonowaniu. Próbki, w których amplifikacja nie przebiegła pomyślnie, będą dawać słabe smugi lub nie będą dawać żadnej smugi (ścieżki 3 i 8) i nie powinny być sekwencjonowane. Proszę kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
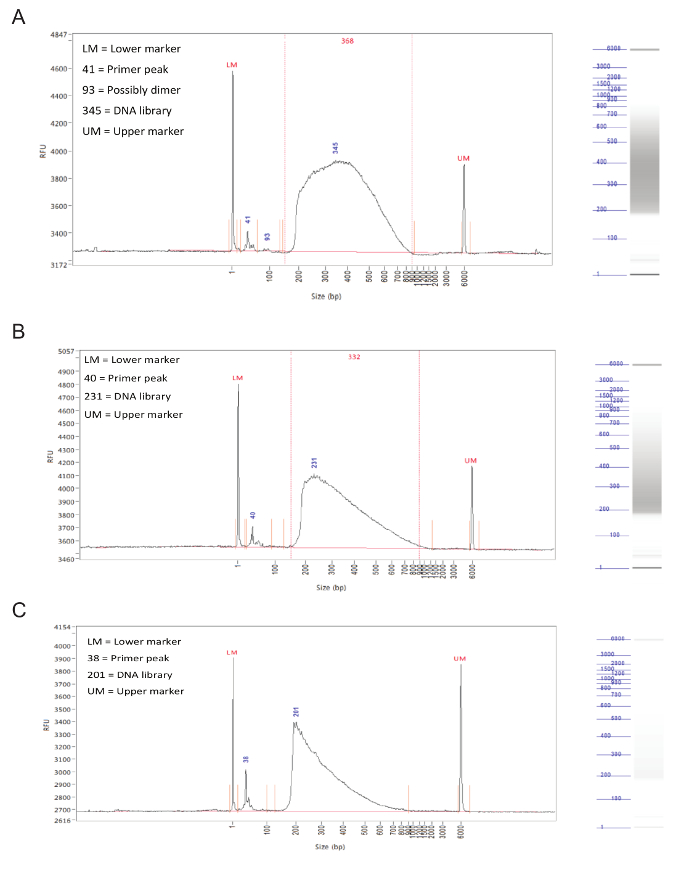
Rysunek 3. Przygotowanie biblioteki. Reprezentatywne wyniki z analizatora fragmentów. Wykresy przedstawiają wielkość fragmentu (w pz) na osi X oraz względne jednostki fluorescencji (RFU) na osi Y. Po prawej stronie każdego wykresu znajduje się symulowana ścieżka żelu.A) Wyniki dla próbki idealnej, z równomiernym rozkładem między 150 a 90 bp, bez ostrych pików lub odchylenia w jedną stronę. Taka próbka nadaje się do sekwencjonowania. (B) Wyniki z próbki poprawnej, z rozkładem wielkości przesuniętym w stronę mniejszych fragmentów. Choć nie jest to wynik optymalny, próbka nadal może zostać poddana sekwencjonowaniu. (C) Wyniki z nieudanej próbki, w której przeważają małe fragmenty. Jest to prawdopodobnie spowodowane zbyt długą inkubacją podczas etapu tagmentacji w procesie przygotowania biblioteki. Próbka ta nie powinna być sekwencjonowana. Kliknij tutaj, aby wyświetlić powiększoną wersję tej figury.
| HMMcopy | |||||||
| Próbka | Segment | Chr | Start | Koniec | Stan | Mediana | |
| D15-498 | 23 | chr8 | 144,500,001 | 146,500,000 | 6 | 0.5008794 | |
| D15-498 | 29 | chr10 | 67,000,001 | 134,500,000 | 6 | 0.4031945 | |
| D15-498 | 52 | chr19 | 1 | 20,000,000 | 6 | 0.4616884 | |
| D15-498 | 57 | chrY | 1 | 59,500,000 | 2 | -1.506532 | |
| Kopia DNA | |||||||
| Próbka | Chrom | Kosz startowy | Koniec pojemnika | Start | Koniec | średnia wartość Seg | Medycyna specjalistyczna |
| D15-498 | chr10 | 88 | 197 | 62,612,945 | 129,971,511 | 1.4688 | 0.157 |
| D15-498 | chr19 | 0 | 31 | 0 | 28,416,392 | 1.4141 | 0.1674 |
| D15-498 | chrX | 77 | 126 | 51,659,160 | 95,343,369 | 1.3548 | 0.1874 |
| D15-498 | chrY | 0 | 14 | 0 | 23,805,358 | -2.7004 | 0.3591 |
Tabela 1. Analiza danych. Przefiltrowane segmenty wygenerowane przez HMMcopy i DNAcopy z pojedynczej komórki. Nałożenie tych dwóch wyników ujawnia przyrost na chromosomie 10 od 67 do 130 Mb oraz przyrost na chromosomie 19 od 0 do 20 Mb. Stwierdziliśmy, że przyrosty w proksymalnej części chromosomu 19 są artefaktem sekwencjonowania pojedynczych komórek 12.
Dyskusja
Tradycyjnie, identyfikacja CNV i aneuploidii na poziomie pojedynczych komórek wymagała metod cytologicznych, takich jak FISH i SKY. Teraz sekwencjonowanie pojedynczych komórek pojawiło się jako alternatywne podejście do takich pytań. Sekwencjonowanie pojedynczych komórek ma przewagę nad FISH i SKY, ponieważ obejmuje zarówno cały genom, jak i ma wysoką rozdzielczość. Ponadto, gdy stosowane są odpowiednie metody kontroli jakości, sekwencjonowanie pojedynczych komórek może zapewnić bardziej wiarygodną ocenę CNV i aneuploidii, ponieważ nie jest podatne na hybrydyzację i rozprzestrzenianie się artefaktów charakterystycznych dla FISH i SKY. Jednak wiele z niedawnych zastosowań sekwencjonowania pojedynczych komórek nie zostało popartych dogłębną oceną czułości i swoistości metod i analiz. Rzeczywiście, niektóre z podejść analitycznych stosowanych w innych badaniach są związane z wysoką częstotliwością (>50%) fałszywie dodatnich połączeń CNV12. Opisywane przez nas podejście zostało rygorystycznie przetestowane przy użyciu komórek o znanym obciążeniu CNV w celu określenia wskaźników prawdziwych i fałszywych wykryć oraz optymalizacji czułości i swoistości wykrywania CNV12. Korzystając z metod kontroli jakości i analiz opisanych w tym protokole, można wykryć około 20% z 5 Mb zysków, 75% z 5 Mb strat i wszystkie CNV przekraczające 10 Mb. Chociaż określenie wskaźnika fałszywych odkryć sekwencjonowania pojedynczych komórek jest trudne, oszacowaliśmy, że wynosi on mniej niż 25%. Protokół ten może być stosowany do komórek z różnych źródeł, skrypty mogą być modyfikowane w celu dostosowania rozdzielczości wykrywania CNV, a protokół może być dostosowany do identyfikacji innych typów zmian genomowych.
Istnieje wiele sposobów dysocjacji świeżych tkanek na pojedyncze komórki, a wiele publikacji opisuje procedury zoptymalizowane dla określonych tkanek, takich jak skóra24 i mózg25. Preferujemy izolację pojedynczych komórek metodą mikroaspiracji, ponieważ pozwala to na wizualną ocenę każdej komórki, która ma być zsekwencjonowana. Możliwe jest jednak również izolowanie pojedynczych komórek za pomocą sortowania komórek aktywowanego fluorescencją (FACS)26 i urządzeń mikroprzepływowych27. Jeśli izolacja pojedynczej komórki i amplifikacja całego genomu jest wykonywana ręcznie, rozsądne jest wyizolowanie i amplifikacja do czterdziestu komórek za jednym razem. Aby uzyskać wysokiej jakości dane dotyczące sekwencjonowania pojedynczych komórek, kluczowe jest, aby amplifikacja genomów pojedynczych komórek była jednolita i kompletna. Stwierdzamy, że jakość izolowanych pojedynczych komórek, a także skuteczność lizy i amplifikacji ma znaczący wpływ na jakość danych sekwencjonowania. W związku z tym komórki powinny zostać pobrane z ich rodzimego środowiska tuż przed izolacją, a amplifikacja całego genomu powinna rozpocząć się natychmiast po wyizolowaniu komórek. Ponadto etap lizy i fragmentacji powinien być postępowany dokładnie tak, jak opisano w krokach 2.3-2.6.
Algorytmy można dostosować w celu zmiany rozdzielczości wykrywania CNV, co ma przeciwstawny wpływ na czułość i swoistość12. Możliwe jest również dostosowanie progów w celu wykrycia aneuploidii całego chromosomu w ustawieniu tetraploidii11. Okazuje się jednak, że nasze podejście ogranicza się do wykrywania CNV większych niż 5 Mb, ponieważ szum wprowadzany podczas amplifikacji całego genomu komplikuje wykrywanie mniejszych wariantów12. Przyszłe ulepszenia w podejściach do amplifikacji całego genomu powinny ostatecznie zwiększyć rozdzielczość wykrywania CNV przy użyciu sekwencjonowania pojedynczych komórek.
Sekwencjonowanie pojedynczych komórek pozwala na badanie nie tylko zmian liczby kopii, ale także wariacji pojedynczych nukleotydów28,29 i zmienności strukturalnej30. Nasz protokół izolacji pojedynczych komórek może być zastosowany, aby odpowiedzieć na te inne pytania. Jednak wybór metody amplifikacji całego genomu zależy od konkretnego zastosowania. Metoda opisana w tym protokole, która opiera się na reakcji łańcuchowej polimerazy, najlepiej nadaje się do wykrywania zmian liczby kopii, ponieważ wiąże się z niższymi poziomami odchylenia amplifikacji32. Uważa się, że do badania innych typów zmian genomowych, takich jak polimorfizmy pojedynczych nukleotydów, bardziej odpowiednie są inne metody amplifikacji całego genomu31,32.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Dziękujemy Stuartowi Levine'owi za komentarze do tego manuskryptu. Praca ta była wspierana przez National Institutes of Health Grant GM056800 oraz Kathy and Curt Marble Cancer Research Fund dla Angeliki Amon, a częściowo przez Koch Institute Support Grant P30-CA14051. Angelika Amon jest również badaczką w Instytucie Medycznym Howarda Hughesa i Fundacji Glenna na rzecz Badań Biomedycznych. K.A.K. jest wspierany przez NIGMS Training Grant T32GM007753.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Zespoły probówek aspiratora do kalibrowanych pipet mikrokapilarnych | Sigma | A5177 | |
| Rurka PVC (ID 3/16", OD 5/16", ~1 stopa) | VWR | 89068-500 | |
| Rurka PVC (ID 5/16", OD 7/16", ~6 cali) | VWR | 89068-508 | |
| Acrodisc Filtr strzykawkowy z membraną HT Tuffryn (średnica 25 mm, wielkość porów 0,2 i mikro; m) | Pipeta | 28144-040 | |
| (5 ml) | BioExpress | P-2837-5 | Każda plastikowa pipeta o pojemności 5 ml powinna wystarczyć |
| Syfon liniowy do tlenu | Amazon.com | 700220210813 | |
| Kapilarne rurki do pomiaru temperatury topnienia (ID 0,8-1,1 mm, długość 100 mm) | VWR | 34502-99 | |
| Plastelina | VWR | 470156-850 | |
| Szalka Petriego (średnica 150 mm) | VWR | 25384-326 | Powierzchnia powinna być nieprzylegająca, aby ułatwić aspirację pojedynczych komórek |
| Twarda skorupa 96-dołkowy półlistwę przypodłogową PCR o pełnej wysokości Płytki | Bio-Rad | HSS9601 | Każda 96-dołkowa płytka do PCR powinna wystarczyć |
| 96-dołkowa płytka do hodowli tkankowej | VWR | 62406-081 | Każda 96-dołkowa płytka do hodowli tkankowej powinna wystarczyć |
| GenomePlex Zestaw do amplifikacji pojedynczej komórki całego genomu | Sigma | WGA4 | |
| Microseal 'A' Film | Bio-Rad | MSA5001 | |
| Mini wirówka do płytek | Thomas Scientific | 1225Z37 | |
| Termocykler | Bio-Rad | 1861096 | Każdy termocykler powinien wystarczyć, o ile może pomieścić 96-dołkową płytkę PCR |
| Koraliki Agencourt Ampure | Beckman Coulter | A63880 | |
| Magnes Dynamag-2 | Thermo Fisher Scientific | 12321D | Każdy podobny pasek rurki magnetycznej powinien wystarczyć |
| Zestaw do przygotowania biblioteki DNA Nextera XT | Illumina | FC-131-1096 | |
| Zestaw indeksowy Nextera XT | Kompletny zestaw Illumina | FC-121-1012 | |
| (zoptymalizowany dla Roche LightCycler 480) | Kapa Biosystems | KK4845 | Ten zestaw jest zoptymalizowany pod kątem maszyny do PCR w czasie rzeczywistym Roche LightCycler 480. Jeśli używasz innej maszyny, zastąp ją zestawem zoptymalizowanym dla Twojej maszyny. |
Bibliografia
- Kahlem, P. Transcript Level Alterations Reflect Gene Dosage Effects Across Multiple Tissues in a Mouse Model of Down Syndrome. Genome Res. 14 (7), 1258-1267 (2004).
- Torres, E. M. Effects of Aneuploidy on Cellular Physiology and Cell Division in Haploid Yeast. Science. 317 (5840), 916-924 (2007).
- Itsara, A. Population Analysis of Large Copy Number Variants and Hotspots of Human Genetic Disease. Am. J. Human Gen. 84 (2), 148-161 (2009).
- Sudmant, P. H. Global diversity, population stratification, and selection of human copy-number variation. Science. 349 (6253), aab3761(2015).
- Navin, N. Inferring tumor progression from genomic heterogeneity. Genome Res. 20 (1), 68-80 (2010).
- Torres, L., Ribeiro, F. R., Pandis, N., Andersen, J. A., Heim, S., Teixeira, M. R. Intratumor genomic heterogeneity in breast cancer with clonal divergence between primary carcinomas and lymph node metastases. Breast cancer res and treat. 102 (2), 143-155 (2007).
- Yates, L. R. Subclonal diversification of primary breast cancer revealed by multiregion sequencing. Nat. Med. 21 (7), 751-759 (2015).
- Forsberg, L. A. Age-related somatic structural changes in the nuclear genome of human blood cells. Am. J. Human Gen. 90 (2), 217-228 (2012).
- Laurie, C. C. Detectable clonal mosaicism from birth to old age and its relationship to cancer. Nat. Gen. 44 (6), 642-650 (2012).
- Jacobs, K. B. Detectable clonal mosaicism and its relationship to aging and cancer. Nat. Gen. 44 (6), 651-658 (2012).
- Knouse, K. A., Wu, J., Whittaker, C. A., Amon, A. Single cell sequencing reveals low levels of aneuploidy across mammalian tissues. Proc. Natl. Acad. Sci. 111 (37), 13409-13414 (2014).
- Knouse, K. A., Wu, J., Amon, A. Assessment of megabase-scale somatic copy number variation using single-cell sequencing. Genome Res. 26 (3), 376-384 (2016).
- Nextera XT DNA Library Preparation Kit. at. , at: http://www.illumina.com/products/nextera_xt_dna_library_prep_kit.html (2016).
- Advanced Analytical Fragment Analyzer. , at: http://aati-us.com/product/fragment-analyzer (2016).
- KAPA Library Quantification Kit. , at: https://www.kapabiosystems.com/product-applications/products/next-generation-sequencing-2/library-quantification/ (2016).
- Illumina HiSeq 2000. , at: http://support.illumina.com/sequencing/sequencing_instruments/hiseq_2000.html (2016).
- FASTX-Toolkit. , at: http://hannonlab.cshl.edu/fastx_toolkit/ (2016).
- Burrows-Wheeler Aligner. , at: http://bio-bwa.sourceforge.net/ (2016).
- SAMTools. , at: http://samtools.sourceforge.net/ (2016).
- HMMcopy. , at: http://compbio.bccrc.ca/software/hmmcopy/ (2016).
- DNAcopy. , at: https://bioconductor.org/packages/release/bioc/html/DNAcopy.html (2016).
- Picard. , at: http://broadinstitute.github.io/picard/ (2016).
- bedtools. , at: http://bedtools.readthedocs.io/en/latest/ (2016).
- Lichti, U., Anders, J., Yuspa, S. H. Isolation and short-term culture of primary keratinocytes, hair follicle populations and dermal cells from newborn mice and keratinocytes from adult mice for in vitro analysis and for grafting to immunodeficient mice. Nat. Protoc. 3 (5), 799-810 (2008).
- Brewer, G. J., Torricelli, J. R. Isolation and culture of adult neurons and neurospheres. Nat. Protoc. 2 (6), 1490-1498 (2007).
- Navin, N. Tumour evolution inferred by single-cell sequencing. Nature. 472 (7341), 90-94 (2011).
- Szulwach, K. E., Chen, P. Single-Cell Genetic Analysis Using Automated Microfluidics to Resolve Somatic Mosaicism. PLoS ONE. 10 (8), e0135007(2015).
- Zong, C., Lu, S., Chapman, A. R., Xie, X. S. Genome-Wide Detection of Single-Nucleotide and Copy-Number Variations of a Single Human Cell. Science. 338 (6114), 1622-1626 (2012).
- Wang, Y. Clonal evolution in breast cancer revealed by single nucleus genome sequencing. Nature. 512 (7513), 155-160 (2014).
- Zhang, C. Z. Chromothripsis from DNA damage in micronuclei. Nature. 522 (7555), 179-184 (2015).
- Macaulay, I. C., Voet, T. Single Cell Genomics: Advances and Future Perspectives. PLoS Genetics. 10 (1), e1004126(2014).
- Gawad, C., Koh, W., Quake, S. R. Single-cell genome sequencing: current state of the science. Nat. Rev. Gen. , 1-14 (2016).
Przedruki i uprawnienia
