Przedstawiono szczegóły dotyczące sposobu wykorzystania mapowania QTL z mapą genetyczną opartą na całej sekwencji genomu do identyfikacji genu oporności na leki w Toxoplasma gondii i jak można to zweryfikować za pomocą systemu CRISPR/Cas9, który skutecznie edytuje cel genomowy, w tym przypadku gen oporności na leki.
Artykuł metodologiczny
Mapowanie QTL i edycja CRISPR/Cas9 w celu identyfikacji genu oporności na leki w Toxoplasma gondii
W tym artykule
Podsumowanie
Streszczenie
Wiedza naukowa jest nierozerwalnie związana z dostępnymi technologiami i metodami. W artykule przedstawione zostaną dwie metody, które pozwoliły na identyfikację i weryfikację genu oporności na leki u pasożyta Apicomplexan Toxoplasma gondii, metoda mapowania Quantitative Trait Locus (QTL) z wykorzystaniem mapy genetycznej opartej na sekwencji całego genomu (WGS) oraz metoda edycji genów opartej na Clustered Regularly Interspaced Short Palindromic Repeats (CRISPR)/Cas9. Podejście do mapowania QTL pozwala sprawdzić, czy istnieje korelacja między regionem genomowym a fenotypem. Do przeprowadzenia skanu QTL wymagane są dwa zestawy danych, mapa genetyczna oparta na potomstwie rekombinowanej krzyżówki i kwantyfikowalnym fenotypie ocenianym u każdego z potomstwa tej krzyżówki. Te zestawy danych są następnie formatowane tak, aby były kompatybilne z oprogramowaniem R/qtl, które generuje skan QTL w celu zidentyfikowania istotnych loci skorelowanych z fenotypem. Chociaż może to znacznie zawęzić okno wyszukiwania potencjalnych kandydatów, QTL obejmują regiony zawierające pewną liczbę genów, na podstawie których należy zidentyfikować gen sprawczy. Posiadanie WGS potomstwa miało kluczowe znaczenie dla zidentyfikowania przyczynowej mutacji oporności na leki na poziomie genu. Po zidentyfikowaniu mutacji kandydackiej można zweryfikować za pomocą manipulacji genetycznej pasożytów wrażliwych na leki. Najłatwiejszą i najskuteczniejszą metodą genetycznej modyfikacji T. gondii jest system CRISPR/Cas9. System ten składa się tylko z 2 składników zakodowanych na pojedynczym plazmidzie, pojedynczego przewodnika RNA (gRNA) zawierającego sekwencję 20 pz komplementarną do celu genomowego oraz endonukleazy Cas9, która generuje dwuniciowe pęknięcie DNA (DSB) w celu, którego naprawa pozwala na insercję lub usunięcie sekwencji wokół miejsca pęknięcia. Ten artykuł zawiera szczegółowe protokoły wykorzystania narzędzi do edycji genomu opartych na CRISPR/Cas9 w celu weryfikacji genu odpowiedzialnego za oporność na sinusyny i konstruowania transgenicznych pasożytów.
Wprowadzenie
Zakres żywicieli określa stopień rozpowszechnienia pasożytów. Niektóre pasożyty mają bardzo specyficzne wymagania dotyczące żywiciela, które ograniczają obszar, z którego się znajdują, inne są generalistami. Jednym z takich generalistów jest Toxoplasma gondii (T. gondii). Pasożyt ten występuje na całym świecie, ponieważ może zarażać wszystkie ssaki i wiele ptaków. Podatni są również ludzie i szacuje się, że około 1/3 światowej populacji została zarażona. Na szczęście silna odpowiedź immunologiczna zwykle kontroluje wzrost pasożyta, ale w sytuacjach, gdy układ odpornościowy jest osłabiony, pasożyt może rozwijać się w niekontrolowany sposób i powodować choroby, często mózgowe. Pasożyt ten może również powodować choroby wrodzone, jeśli wcześniej niezakażone kobiety zostaną zarażone w czasie ciąży, ponieważ brakuje im pamięci immunologicznej, aby szybko ograniczyć rozprzestrzenianie się pasożyta. Dodatkowo istnieje obciążenie toksoplazmozą oczną, która może powodować utratę wzroku 1. Z tych powodów T. gondii stał się przedmiotem badań, a ze względu na wiele metod molekularnych opracowanych do jego badania, modelem pasożytów Apicomplexan. Dwie metody, które zostaną tutaj omówione, to mapowanie locus cech ilościowych (QTL) i edycja genów Clustered Regularly Interspaced Short Palindromic Repeats (CRISPR)/Cas9. Mapowanie QTL i edycja CRISPR/Cas9 są, odpowiednio, podejściami genetycznymi do przodu i do tyłu, które były stosowane w poprzednich badaniach w celu identyfikacji i/lub scharakteryzowania genów wirulencji T. gondii. W tym przypadku metody te są łączone w celu zidentyfikowania i potwierdzenia funkcji genu oporności na sinusynę (SNFr), TgME49_290860, oraz jego ortologów (oznaczonych jako SNR1) 2.
Chociaż T. gondii może infekować szeroką gamę pośrednich gospodarzy, musi przejść przez komórki nabłonka jelitowego kotowatego i je zainfekować, aby zakończyć cykl życia. Koty są ostatecznymi żywicielami pasożyta, w którym wytwarzane są stadia płciowe i zachodzi rekombinacja genetyczna poprzez mejozę. Aby przeprowadzić badanie QTL, należy stworzyć krzyżówkę genetyczną, a w przypadku Toxoplasma oznacza to przejście dwóch różnych szczepów pasożytów, które różnią się cechą fenotypową, plamami rodzicielskimi, przez kota w celu wytworzenia rekombinowanego potomstwa 3. Przed podaniem kotom szczepy rodzicielskie uodparniają się na oddzielne leki, aby umożliwić bardziej efektywną identyfikację rekombinantów poprzez podwójną selekcję leków potomstwa 4. W tym celu u T. gondii zastosowano trzy leki; fluorodeoksyryboza (FUDR), dla której fosforybozylotransferaza uracylu (UPRT) jest genem oporności 5, arabinozyd adenozyny (ARA), dla którego kinaza adenozynowa (AK) jest genem oporności 6, oraz sinusyna (SNF), dla której gen oporności był nieznany 7. Stworzono kilka krzyżówek genetycznych dla T. gondii, ale tylko 24 potomstwo krzyżówki ME49-FUDRr X VAND-SNFr zostało genotypowanych przy użyciu sekwencjonowania całego genomu (WGS) 8. Otworzyło to możliwość mapowania i identyfikacji genu oporności na SNF przy użyciu tej krzyżówki, ponieważ rodzic VAND stał się odporny na sinusynę w wyniku mutagenezy chemicznej wrażliwego na lek szczepu VAND (VAND-SNFs), a genom referencyjny VAND zsekwencjonowano przy użyciu szczepu VAND-SNFs, co pozwoliło na identyfikację wszystkich polimorfizmów między potomstwem WGS a genomemreferencyjnym VAND-SNF. w tym dziedziczna rodzicielska mutacja VAND-SNFr, która sprawiła, że niektóre z potomstwa były odporne na sinusynę.
W celu zidentyfikowania przyczynowego polimorfizmu pojedynczego nukleotydu (SNP) w potomstwie SNFr, można użyć kilku obliczeniowych zasobów open source do analizy danych. Aby stworzyć mapę genetyczną dla krzyżówki ME49-FUDRr X VAND-SNFr, opracowano pakiet oprogramowania REDHORSE 9, który wykorzystuje dopasowania WGS rodziców i potomstwa do dokładnego wykrywania pozycji genomowych krzyżówek genetycznych. Te informacje mapowania można następnie połączyć z danymi fenotypowymi (SNFr u potomstwa) w celu sformatowania zestawu danych zgodnego z pakietem "qtl" 10 w oprogramowaniu do programowania statystycznego R, w którym można uruchomić skanowanie QTL w celu ujawnienia istotnych loci skorelowanych z fenotypem. Aby zidentyfikować przyczynowy SNP zlokalizowany w locus QTL, odczyty WGS potomstwa można indywidualnie dopasować do wrażliwego na sinusynę genomu VAND za pomocą programu dopasowującego Bowtie 2 11, z którego SNP mogą być wywoływane za pomocą programu wywołującego wariant VarScan mpileup2snp 12. Korzystając z tych SNP, locus QTL może być następnie skanowany w poszukiwaniu polimorfizmów, które są obecne w SNFr, ale niew potomstwie SNF. Po zidentyfikowaniu przyczynowego SNP w regionie kodującym gen, można przeprowadzić modyfikację genetyczną kandydującego genuSNF r w szczepie SNF w celu zweryfikowania funkcji oporności na leki.
System edycji genomu CRISPR/Cas9 został niedawno ustanowiony w Toxoplasma13, co dodało ważne narzędzia do eksploracji złożonej biologii tego pasożyta, szczególnie do badań genetycznych na szczepach niezaadaptowanych laboratoryjnie. Ze względu na wysoce aktywną aktywność niehomologicznego łączenia końców (NHEJ) w komórkach WT Toxoplasma, ukierunkowana modyfikacja genomu jest trudna do osiągnięcia, ponieważ egzogennie wprowadzone DNA jest losowo integrowane z genomem z bardzo wysoką częstotliwością 14. Aby zwiększyć wskaźnik powodzenia modyfikacji specyficznej dla locus, zastosowano różne podejścia w celu zwiększenia efektywności rekombinacji homologicznej i/lub zmniejszenia aktywności NHEJ 15,16. Jednym z takich podejść jest system CRISPR/Cas9. W porównaniu z innymi metodami, system CRISPR/Cas9 jest skuteczny we wprowadzaniu modyfikacji specyficznych dla danego miejsca i jest łatwy do zaprojektowania 13,17,18. Ponadto może być stosowany w dowolnym szczepie Toxoplasma bez dodatkowej modyfikacji pasożyta 13,19.
System CRISPR/Cas9 wywodzi się z adaptacyjnego układu odpornościowego Streptococcus pyogenes, który używa go do obrony przed inwazją ruchomych elementów genetycznych, takich jak fagi 20,21,22. System ten wykorzystuje kierowany przez RNA enzym endonukleazy DNA Cas9 do wprowadzenia dwuniciowego pęknięcia DNA (DSB) do celu, który jest następnie naprawiany albo przez podatny na błędy NHEJ w celu inaktywacji docelowych genów poprzez krótkie mutacje indelowe, albo przez rekombinację ukierunkowaną na homologię w celu zmiany docelowego locus dokładnie tak, jak zaprojektowano 23,24. Swoistość docelowa jest określana przez małą cząsteczkę RNA zwaną pojedynczym przewodnikiem RNA (gRNA), która zawiera indywidualnie zaprojektowaną sekwencję 20 nt, która ma 100% homologię do docelowego DNA 22. Cząsteczka gRNA zawiera również sygnatury rozpoznawane przez Cas9, które kierują nukleazę do miejsca docelowego, które zawiera specjalny motyw sąsiadujący z protospacerem (PAM, sekwencja to 'NGG') 25,26. Dlatego cząsteczka gRNA i sekwencja PAM współpracują ze sobą, aby określić miejsce cięcia Cas9 w genomie. Można łatwo zmienić sekwencję gRNA, aby celować w różne miejsca rozszczepienia.
Gdy system CRISPR/Cas9 został po raz pierwszy opracowany w Toxoplasma, pojedynczy plazmid wyrażający nukleazę Cas9 i cząsteczkę gRNA został użyty do wprowadzenia DSB w miejscu docelowym 13,17. Wykazano, że system CRISPR/Cas9 drastycznie zwiększa skuteczność modyfikacji genomu specyficznego dla miejsca, nie tylko poprzez rekombinację homologiczną, ale także niehomologiczną integrację egzogennego DNA 13. Czyni to w odmianach typu dzikiego, które zawierają aktywność NHEJ. Dlatego system ten może być stosowany w zasadzie w każdym szczepie Toxoplasma do wydajnej edycji genomu. W typowym eksperymencie specyficzny dla celu plazmid CRISPR i fragment DNA używany do modyfikacji celu są współtransfekowane w pasożyty. Jeśli fragment DNA użyty do modyfikacji celu zawiera sekwencje homologiczne do locus docelowego, rekombinacja homologiczna może być użyta do naprawy DSB wprowadzonego przez CRISPR/Cas9, aby umożliwić precyzyjną modyfikację celu. Z drugiej strony, jeśli wprowadzony fragment DNA nie zawiera sekwencji homologicznej, nadal może być zintegrowany z miejscem docelowym CRISPR/Cas9. Ten ostatni jest często używany do zakłócania genów poprzez wprowadzanie selektywnych markerów lub do uzupełniania mutantów w loci, które umożliwiają selekcję negatywną 13. W tym przypadku locus SNR1 służy jako przykład pokazujący, w jaki sposób CRISPR/Cas9 może być wykorzystany do rozrywania genów i generowania transgenicznych pasożytów.
Protokół
1. Oceń SNFr w potomstwie krzyżówki ME49-FUDRr x VAND-SNFr
UWAGA: T. gondii jest obligatoryjnym pasożytem wewnątrzkomórkowym, a stadium tachyzoitu łatwo rośnie w hodowli tkankowej.
- Aby wyhodować pasożyta T. gondii, należy go utrzymać w zlewającej się monowarstwowej kulturze ludzkiego fibroblastu napletka (HFF) wysianej do kolb T25 z podłożem Dulbecco's Modified Eagle's Medium (DMEM) uzupełnionym 10% płodową surowicą bydlęcą (FBS) (pożywka D10) w temperaturze 37 °C i 5% CO2,
UWAGA: Patrz uwaga do Protokołu 1.1 w pliku uzupełniającym 1. - Aby przetestować poszczególne klony potomstwa pod kątem odporności na sinusynę, hoduj każdy klon do wysokiej gęstości pasożytów w kolbie hodowlanej T25 HFF przez 2-3 dni, aż większość pasożytów zacznie lizować komórki gospodarza.
- Zeskrob monowarstwę za pomocą skrobaka do komórek i przepuść roztwór pasożyta przez strzykawkę 10 ml / igłę 22 G 2-3 razy, aby zlizować komórki gospodarza uwalniające pasożyty. Roztwór można wciągnąć z powrotem do strzykawki w celu przeprowadzenia wielu przejść igły.
- Przefiltruj roztwór pasożyta do nowej stożkowej rurki przez membranę o wielkości porów 3 μm, aby usunąć komórki HFF i zanieczyszczenia komórkowe.
- Policz pasożyty na hemocytometrze i określ liczbę pasożytów na ml.
- Za pomocą pipetora przepuścić 2,5 x 10⁵ pasożytów do nowej kolby hodowlanej T25 HFF zawierającej pożywkę D10 o stężeniu roboczym 0,3 μM leku sinusynowego.
- Hoduj pasożyty w temperaturze 37 °C i 5% CO2 przez 7-10 dni.
- Oceń potomstwo pod kątem fenotypu wzrostu w leku sinusyny. Obserwuj monowarstwę pod mikroskopem z odwróconym kontrastem fazowym i uzyskaj wynik 0 dla braku wzrostu (wrażliwy na sinusynę), wynik 1 dla wzrostu i lizy monowarstwy (odporny na sinusynę).
UWAGA: Patrz uwaga do Protokołu 1.8 w pliku uzupełniającym 1.
2. Uruchom skanowanie QTL fenotypu SNFr w R/qtl
UWAGA: Zobacz Protokół 2 Uwaga w Pliku Uzupełniającym 1.
- Zainstaluj oprogramowanie języka programowania R na komputerze lokalnym. Zobacz 27.
- Uruchom R i zainstaluj pakiet "qtl". Zrób to z opcji interfejsu GUI języka R "Packages->Install package(s)" lub uruchom następujące polecenie z wiersza poleceń języka R (pierwszy symbol ">" w każdym przykładzie oznacza początek polecenia, którego nie należy kopiować):
>install.packages("qtl")
UWAGA: Po zainstalowaniu R i pakietu 'qtl', istnieją dwa sposoby uruchomienia R/qtl, z wiersza poleceń R lub za pomocą programu graficznego interfejsu użytkownika (GUI) o nazwie J/qtl 28 : zobacz 29, aby pobrać J/qtl. Ten protokół zapewni składnię wiersza poleceń R/qtl z okazjonalnym odwołaniem do równoważnej funkcji w J/qtl. - Załaduj pakiet 'qtl':
> biblioteka(qtl)
UWAGA: Patrz uwaga do Protokołu 2.3 w >pliku uzupełniającym 1, aby zapoznać się z formatem zestawu danych i plikami do pobrania. - Załaduj plik zestawu danych do R/qtl.
- Dla formatu "csv" (patrz: Plik danych 1):
>SNFR <- read.cross(format="csv", file="$PATH/Rqtl-SNFR.csv", genotypes=c("0", "1"), na.strings=c("-"), convertXdata=FALSE) - Lub dla formatu "gary" (patrz: Plik danych 2):
>SNFR <- read.cross(format="gary", dir="$PATH", chridfile="chrid.txt", mnamesfile="mname.txt", mapfile="markerpos.txt", genfile="genotype.txt", phefile="phenos.txt", pnamesfile="phenonames.txt", convertXdata=FALSE)
Gdzie $PATH jest ścieżką katalogu do plików zawierających zestaw danych qtl. Na przykład: /Users/HotDiggityDog/QTLfiles
UWAGA: Pliki można również załadować do J/qtl za pomocą poprzednich poleceń za pomocą opcji "Wstaw komentarz lub polecenie" lub załadować dane za pomocą opcji GUI "Plik->Załaduj dane krzyżowe".
- Dla formatu "csv" (patrz: Plik danych 1):
- Obliczanie prawdopodobieństwa dla mapy:
>SNFR <- calc.genoprob(SNFR, krok=2.0, off.end=0.0, error.prob=1.0E-4, map.function="haldane", stepwidth="naprawiony") - Uruchom pojedyncze skanowanie, używając binarnego rozkładu fenotypu oporności na sinusynę we wszystkich chromosomach:
> SNFR.scan <-scanone(cross=SNFR, chr=c("Ia", "Ib", "II", "III", "IV", "V", "VI", "VI", "VIIa", "VIIb", "VIII", "IX", "X", "XI", "XII"), pheno.col=c(1), model="binarny", method="em")
UWAGA: Jeśli uruchamiasz fenotyp VIR, użyj opcji dystrybucji 'model="normal"'. - Uruchom 1000 permutacji, aby obliczyć progi istotności, a następnie przypisz permutacje do zmiennej SNFR.scan:
> SNFR.scan.permutacje <- scanone(cross=SNFR, chr=c("Ia", "Ib", "II", "III", "IV", "V", "VI", "VI", "VIIa", "VIIb", "VIII", "IX", "X", "XI", "XII"), pheno.col=c(1), model="binarny", method="em", n.perm=1000, perm. Xsp=FAŁSZ, gadatliwy=FAŁSZ)
>attr(SNFR.scan, "pheno.col") <- c(1)
UWAGA: Kroki od 2.5 do 2.7 można uruchomić w J/qtl z opcją "Analysis->Main Scan-> Run One QTL Genome Scan". - Wykreśl wyniki skanowania:
>plot(SNFR.scan, gap=0, bandcol="szary")
UWAGA: Wykres utworzony w J/qtl jest interaktywny. >- Wykreśl wyniki skanowania tylko dla chromosomu IX, chromosomu o najwyższym piku:
>plot(SNFR.scan, chr=c("IX"), gap=0, bandcol="szary", show.marker.names=PRAWDA)
- Wykreśl wyniki skanowania tylko dla chromosomu IX, chromosomu o najwyższym piku:
- Pokaż wszystkie pozycje znaczników i wyniki LOD z pojedynczego skanowania:
>SNFR.scan - Pokaż progowe wyniki testu permutacji:
>podsumowanie(SNFR.scan.permutacje) - Pokaż tylko te znaczniki, które są większe niż wartość progowa alfa=0,05 (pobrana z poprzedniego wyniku):
>SNFR.scan[SNFR.scan$lod >2.68,] - Pokaż markery z najwyższym wynikiem LOD na każdym chromosomie:
> podsumowanie(SNFR.scan) - Pokaż te znaczniki, które mają maksymalną wartość wyniku LOD (pobraną z poprzedniego wyniku):
>SNFR.scan[SNFR.scan$lod >=6.57,]
UWAGA: Patrz uwaga do Protokołu 2.13 w >pliku uzupełniającym 1.
3. Zidentyfikuj przyczynową mutację SNFr za pomocą odczytów WGS od potomstwa
UWAGA: Zobacz Protokół 3 Uwaga w Pliku Uzupełniającym 1.
- Dopasuj odczyty WGS poszczególnych potomstwa do wrażliwego na sinusynę genomu rodzicielskiego VAND (VAND-SNFs).
UWAGA: Pobierz genom referencyjny VAND (SNFs) z NCBI Assembly AEYJ00000000.2, a WGS odczytuje (pliki .) dla 24 potomstwa z NCBI PRJNA258152. Pobierz również następujące programy: Bowtie2 11, NCBI Toolkit, SAMtools 30, VarScan 12 i MUMmer 31.- Utwórz indeks kompatybilny z Bowtie 2 z pliku referencyjnego genomu VAND FASTA za pomocą programu bowtie2-build, tutaj nazywając indeks "VAND":
>muszka2-build GCA_000224845.2_TGVAND_v2_genomic.fna VAND - Konwertuj pliki odczytu WGS w formacie na pliki FASTQ za pomocą fastq-dump z opcją --split-files dla sparowanych odczytów (plik SRR1555372.dla P1_14VB potomstwa zostanie użyty jako przykład):
>fastq-dump --split-files SRR1555372.
UWAGA: Uruchom to i wszystkie poniższe polecenia w Protokole 3.1 dla wszystkich 24 potomstwa. - Dopasuj odczyty WGS do genomu referencyjnego za pomocą bowtie2 z danymi wyjściowymi do pliku SAM (.sam) i opcją --end-to-end:
>muszka2 -x VAND -1 SRR155372_1.fastq -2 SRR1555372_2.fastq -S SRR155372.sam --end-to-end - Przekonwertuj plik .sam na plik BAM (.bam):
>samtools view -bS SRR155372.sam > SRR155372.bam - Sortuj plik .bam:
>samtools sortuj SRR155372.bam SRR155372.sort - Indeksuj posortowany plik .bam:
>samtools index SRR155372.sort.bam
- Utwórz indeks kompatybilny z Bowtie 2 z pliku referencyjnego genomu VAND FASTA za pomocą programu bowtie2-build, tutaj nazywając indeks "VAND":
- Wywołaj SNP dla potomstwa za pomocą VarScan
UWAGA: Patrz uwaga do Protokołu 3.2 w pliku uzupełniającym 1.- Przekonwertuj wszystkie indeksowane pliki BAM (.sort.bam) na jeden plik sformatowany w pileup za pomocą samtools mpileup z plikiem referencyjnym genomu VAN, wszystkimi potomnymi plikami .sort.bam i danymi wyjściowymi do pliku o nazwie AllProgeny-mpileup.txt:
>samtools mpileup -f GCA_000224845.2_TGVAND_v2_genomic.fna SRR1555599.sort.bam SRR1555372.sort.bam SRR1555660.sort.bam SRR1555672.sort.bam SRR1556052.sort.bam SRR1556122.sort.bam SRR1556192.sort.bam SRR1556194.sort.bam SRR1556195.sort.bam SRR1556199.sort.bam SRR1556200.sort.bam SRR1556202.sort.bam SRR1556203.sort.bam SRR1556274.sort.bam SRR1556276.sort.bam SRR1556278.sort.bam SRR1556395.sort.bam SRR1556396.sort.bam SRR1556397.sort.bam SRR1556398.sort.bam SRR1556399.sort.bam SRR1556400.sort.bam SRR1556401.sort.bam SRR1556402.sort.bam > AllProgeny-mpileup.txt - Wywołaj wszystkie SNP za pomocą programu VarScan mpileup2snp przy użyciu pliku AllProgeny-mpileup.txt, minimalnym pokryciu odczytu 5, minimalnej częstotliwości wariantów między odczytami 0,8, wartości p 0,01 i danych wyjściowych do pliku o nazwach AllProgeny-SNPs.txt:
>java -jar VarScan.jar mpileup2snp AllProgeny-mpileup.txt --min-pokrycie 5 --min-var-freq .8 --p-wartość .01 > AllProgeny-SNPs.txt
UWAGA: Plik AllProgeny-SNPs.txt jest plikiem tekstowym rozdzielanym tabulatorami, który będzie używany w protokole 3.4 do zlokalizowania przyczynowego SNP.
- Przekonwertuj wszystkie indeksowane pliki BAM (.sort.bam) na jeden plik sformatowany w pileup za pomocą samtools mpileup z plikiem referencyjnym genomu VAN, wszystkimi potomnymi plikami .sort.bam i danymi wyjściowymi do pliku o nazwie AllProgeny-mpileup.txt:
- Znajdź współrzędne genomu VAN, które odpowiadają współrzędnym locus
QTL opartego na ME49 UWAGA: Patrz uwaga do Protokołu 3.3 w pliku uzupełniającym 1.- Użyj programu MUMmer nucmer, aby wyrównać genom ME49 (dostępny do pobrania ze strony ToxoDB.org 32) i plik genomu referencyjnego VAND (dane wyjściowe trafiają do pliku out.delta):
>nucmer ToxoDB-28_TgondiiME49_Genome.fasta GCA_000224845.2_TGVAND_v2_genomic.fna - Użyj programu MUMmer show-coords, aby uzyskać współrzędne dwóch dopasowań genomu, dane wyjściowe do pliku o nazwie ME49vsVAND-coords.txt:
>show-coords out.delta > ME49vsVAND-coords.txt
UWAGA: Plik ME49vsVAND-coords.txt może być użyty do znalezienia kontigów VAND i pozycji odpowiadających locus QTL; markery MV359 do MV366 zlokalizowane na chromosomie IX ME49 między 3 187 537 a 4 202 258 pz. Istnieją dwa kontigi VAN, które obejmują odpowiednie locus QTL; KN044604.1:657,441-1 pz i KN042501.1:430,910-41,870 pz (oba kontigi ustawiają się odwrotnie do chromosomu ME49).
- Użyj programu MUMmer nucmer, aby wyrównać genom ME49 (dostępny do pobrania ze strony ToxoDB.org 32) i plik genomu referencyjnego VAND (dane wyjściowe trafiają do pliku out.delta):
- Ocena SNP potomstwa zlokalizowanych w locus QTL dla SNP dziedziczonych tylko w SNFr progeny
UWAGA: Patrz uwaga do Protokołu 3.4 w pliku uzupełniającym 1.- Przejrzyj plik danych 3, aby zidentyfikować mutację przyczynową zlokalizowaną w locus QTL. Zeskanuj dane w poszukiwaniu wzorca, w którym potomstwo SNFr ma SNP, aSNF nie (wykonalne, ponieważ SNP potomstwa uzyskano przez porównanie zgenomem referencyjnym VAND-SNF). Powinno to skutkować tylko jedną pozycją z tym wzorcem, pozycją 348130 na VAND contig KN042501.1.
- Patrz wiersz 6604 w pliku danych 3 (rysunek 3).
UWAGA: Patrz uwaga do Protokołu 3.4.2 w pliku uzupełniającym 1.
4. Weryfikacja zidentyfikowanych trafień poprzez inaktywację genów za pośrednictwem CRISPR/Cas9.
UWAGA: Aby potwierdzić przyczynowy SNP zidentyfikowany przez mapowanie QTL i analizę WGS SNP, należy dokonać odpowiednich zmian genetycznychna tle WT SNF i zbadać wynikowy fenotyp. W przypadku oporności na sinusynę, odpowiedzialna mutacja powoduje inaktywację genu SNR1 przez wczesne zakończenie 2. W związku z tym zakłócenie SNR1 może być wykorzystane do potwierdzenia. W tym miejscu przedstawiono szczegółowy protokół wykorzystania mutacji indel indukowanych przez CRISPR/Cas9 w celu zakłócenia SNR1, aby wykazać jego udział w oporności na sinusynę (ryc. 4).
- Budowa plazmidu CRISPR specyficzna dla SNR1
UWAGA: Patrz Uwaga do Protokołu 4.1 w Pliku Uzupełniającym 1 w celu uzyskania plazmidów i map.- Uzyskaj sekwencję genomową dla docelowego genu (SNR1, TGME49_290860) z ToxoDB 32.
- Korzystaj z narzędzi online, takich jak E-CRISP 33, aby zaprojektować docelowe gRNA. Nie włączaj sekwencji PAM (NGG) do gRNA.
UWAGA: Patrz uwaga do Protokołu 4.1.2 w pliku uzupełniającym 1. - Zsyntetyzuj startery, aby skonstruować docelowy plazmid CRISPR.
- Zgodnie z projektem z kroku 4.1.2 zsyntetyzuj dwa startery, aby zmienić gRNA ukierunkowane na UPRT w oryginalnym plazmidzie CRISPR na wybraną sekwencję gRNA poprzez mutagenezę ukierunkowaną na miejsce.
UWAGA: Sekwencje tych dwóch starterów są następujące: gRNA-Fw: NNNNNNNNNNNNNNNNNNNNNNGTTTTAGAGCTAGAAATAGC (N20 to sekwencja gRNA specyficzna dla celu) i gRNA-Rv: AACTTGACATCCCCATTTAC 2.
- Zgodnie z projektem z kroku 4.1.2 zsyntetyzuj dwa startery, aby zmienić gRNA ukierunkowane na UPRT w oryginalnym plazmidzie CRISPR na wybraną sekwencję gRNA poprzez mutagenezę ukierunkowaną na miejsce.
- Wykonaj reakcje mutagenezy ukierunkowanej na miejsce.
- Używając plazmidu CRISPR ukierunkowanego na UPRT (pSAG1::CAS9-U6::sgUPRT) jako matrycy i dwóch starterów wymienionych powyżej, przeprowadź reakcje mutagenezy ukierunkowanej na miejsce zgodnie z instrukcjami producenta.
UWAGA: Do PCR należy stosować następujące warunki cyklu: 98 °C przez 1 min, następnie 25 cykli 98 °C przez 10 s, 55 °C przez 30 s i 72 °C przez 5 minut, a następnie końcowe przedłużenie przez 2 minuty w temperaturze 72 °C.
- Używając plazmidu CRISPR ukierunkowanego na UPRT (pSAG1::CAS9-U6::sgUPRT) jako matrycy i dwóch starterów wymienionych powyżej, przeprowadź reakcje mutagenezy ukierunkowanej na miejsce zgodnie z instrukcjami producenta.
- Przekształcenie produktów mutagenezy zawierających plazmidy CRISPR specyficzne dla rządu Indonezji w komórki kompetentne dla E. coli poprzez przemianę chemiczną zgodnie z protokołem dostawcy (patrz tabele materiałów). Transformanty hodować na płytkach bulionu lizogenicznego (LB) zawierających ampicylinę (100 μg/ml) w temperaturze 37 °C. Następnie wybierz 2-4 klony i hoduj je pojedynczo w pożywce 5 ml LB uzupełnionej 100 μg/ml ampicyliny przez 12-16 godzin.
- Ekstrahuj plazmidy z kultur za pomocą zestawu do izolacji DNA i analizuj je za pomocą elektroforezy żelowej DNA, aby sprawdzić rozmiar plazmidów (oczekiwany rozmiar plazmidu to 9674 pz, użyj oryginalnego plazmidu CRISPR jako kontroli). Użyj startera M13-Rev (5'-CAGGAAACAGCTATGACC) do sekwencjonowania plazmidów, aby potwierdzić docelową sekwencję gRNA.
- Po zidentyfikowaniu dodatnich klonów należy przechowywać zarówno plazmidowe DNA w temperaturze -20 °C, jak i odpowiadającą im kulturę bakteryjną w temperaturze -80 °C do wykorzystania w przyszłości.
UWAGA: Plazmid CRISPR, który ma być używany do transfekcji, należy rozpuścić w wodzie dejonizowanej, a stężenie określić za pomocą spektrofotometrii lub metody alternatywnej.
- Po zidentyfikowaniu dodatnich klonów należy przechowywać zarówno plazmidowe DNA w temperaturze -20 °C, jak i odpowiadającą im kulturę bakteryjną w temperaturze -80 °C do wykorzystania w przyszłości.
- Ekstrahuj plazmidy z kultur za pomocą zestawu do izolacji DNA i analizuj je za pomocą elektroforezy żelowej DNA, aby sprawdzić rozmiar plazmidów (oczekiwany rozmiar plazmidu to 9674 pz, użyj oryginalnego plazmidu CRISPR jako kontroli). Użyj startera M13-Rev (5'-CAGGAAACAGCTATGACC) do sekwencjonowania plazmidów, aby potwierdzić docelową sekwencję gRNA.
- Transfekcja pasożytów.
UWAGA: Ogólne metody hodowli T. gondii w komórkach HFF w pożywce D10 zostały opisane wcześniej 34.- Dwa do trzech dni przed transfekcją dodaj wystarczającą ilość pasożytów do kolby T25 zawierającej zlewającą się monowarstwę komórek HFF (0,5-1 x 10⁶ dla szczepów typu 1, 1-2 x 10⁶ dla innych szczepów), aby osiągnąć 70 - 80% lizy komórek HFF w ciągu 2-3 dni.
- Zbadaj kulturę pod mikroskopem z kontrastem z odwróconymi fazami, gdy monowarstwa HFF jest w 70-80% zlizowana przez pasożyty. Delikatnie usunąć pożywkę pipetą i zmyć komórki z powierzchni kolby za pomocą 5 ml buforu cytomix (120 mM KCl, 0,15 mM CaCl2, 10 mM K2HPO4/KH2PO4 pH = 7,6, 25 mM HEPES, 2 mM EDTA, 5 mM MgCl2, pH = 7,6). Następnie przenieś roztwór pasożyta do stożkowej probówki o pojemności 15 ml.
UWAGA: Patrz uwaga do Protokołu 4.2.2 w pliku uzupełniającym 1. - Przepuść roztwór pasożyta przez strzykawkę 10 ml / igłę 22 G 2-3 razy.
- Przefiltruj roztwór pasożyta do nowej stożkowej rurki przez membranę o wielkości porów 3 μm, aby usunąć komórki HFF i zanieczyszczenia komórkowe.
- Przefiltrowane pasożyty osadzać przez odwirowanie przy 400 x g przez 10 minut.
- Odlać supernatant i ponownie zawiesić granulowane pasożyty za pomocą 10 ml buforu cytomix, pobrać 10 μl podwielokrotności w celu oznaczenia stężenia pasożyta za pomocą hemocytometru, a resztę zagnieździć przez odwirowanie przy 400 × g przez 10 minut.
- Usunąć supernatant i ponownie zawiesić osad w buforze cytomiksu, aby uzyskać gęstość 4 x 10⁷ pasożytów/ml.
- W kuwecie o odstępie 4 mm wymieszaj 250-300 μl roztworu pasożyta (1-1,3 x 10⁷ pasożytów) z 7,5 μg plazmidu CRISPR, 6 μl ATP (100 mM) i 6 μl glutationu (GSH) (250 mM).
- Elektropoturuj pasożyty 35. Uwzględnij oddzielną elektroporację jako kontrolę negatywną, w której plazmid CRISPR jest ukierunkowany na inne miejsce, takie jak UPRT ukierunkowany na plazmid CRIPSR.
UWAGA: Ustawienia elektroporacji zależą od urządzenia. W przypadku elektroporatora wymienionego w Materiałach należy użyć kuwet o odstępie 4 mm. Zalecany jest następujący protokół: 1 700 V, 176 μs długości impulsu, 2 impulsy w odstępie 100 ms.
- Określ częstotliwość oporności na sinusynę po ukierunkowaniu CRISPR.
- Komórki HFF należy zasiać do szkiełek nakrywkowych umieszczonych na płytkach 24-dołkowych 3-4 dni przed elektroporacją, tak aby zlały się do czasu przeprowadzenia transfekcji w ppkt 4.2.
- Trypsynizować komórki HFF z jednej zlewającej się kolby T25, a następnie dodać 12 ml pożywki D10 i dobrze wymieszać.
- Dodać szkiełko nakrywkowe do każdego dołka na płytce 24-dołkowej i podwielokrotność 500 μl roztworu komórek HFF do każdej studzienki. Inkubować płytkę w temperaturze 37 °C przez 3 4 dni, aby pozwolić komórkom rosnąć aż do zlewania się.
UWAGA: Komórki z jednej kolby T25 wystarczą do wysiewu jednej płytki 24-dołkowej. - Dodać 50 μl elektroporowanego roztworu pasożyta z kroku 4.2.9 do jednego dołka na 24-dołkowej płytce zawierającej szkiełko nakrywkowe wysiane zbiegającymi się komórkami HFF. Przenieść resztę elektroporowanego roztworu pasożyta do kolby T25 wysianej zbiegającymi się komórkami HFF.
- Oceń skuteczność transfekcji.
- Hoduj komórki na 24-dołkowej płytce przez 24 godziny, a następnie utrwal komórki (komórki gospodarza i pasożyty) za pomocą 500 μl 4% formaldehydu, aby sprawdzić ekspresję Cas9-GFP za pomocą testu immunofluorescencyjnego (IFA).
- Zbadaj komórki przeciwciałem anty-GFP i przeciwciałem specyficznym dla Toxoplasma (takim jak anty-TgALD), aby oznaczyć wszystkie pasożyty. Zapoznaj się z kartą produktu przeciwciała, aby uzyskać informacje na temat zalecanego rozcieńczenia (zwykle 1:1,000 jest wystarczające dla IFA). Jeśli przeciwciała są niesprzężone, użyj dwóch różnych przeciwciał drugorzędowych sprzężonych z barwnikami fluorescencyjnymi do znakowania przeciwciał pierwszorzędowych.
- Obserwuj znakowane komórki pod mikroskopem fluorescencyjnym z filtrami odpowiednimi dla wtórnych barwników fluorescencyjnych. Wydajność transfekcji można uzyskać, dzieląc liczbę pasożytów dodatnich metodą GFP przez liczbę wszystkich pasożytów.
UWAGA: Dwa przeciwciała stosowane w IFA powinny pochodzić od dwóch różnych gatunków gospodarzy, na przykład przy użyciu kombinacji mysiego anty-GFP i króliczego anty-TgALD.
- Określ częstość występowania oporności na sinusynę u transfekowanych pasożytów.
- W przypadku transfekowanych pasożytów hodowanych w kolbach T25 należy je hodować przez 2-3 dni, aż do naturalnego wyjścia. Następnie zbierz pasożyty, lizę igieł komórek gospodarza w celu uwolnienia pasożytów wewnątrzkomórkowych i oczyść je przez filtrację przez membrany o wielkości porów 3 μm. Policz pasożyty za pomocą hemocytometru, aby oszacować gęstość.
- Dodaj oczyszczone pasożyty do 6-dołkowych płytek wysianych zbiegającymi się komórkami HFF: do pierwszego rzędu (3 dołki) dodaj 200 pasożytów / studzienkę i hoduj je w zwykłym podłożu D10 (2 ml / studzienkę); do drugiego rzędu dodaj 5000 pasożytów / studzienkę i hoduj je w pożywce D10 zawierającej 0,3 μM sinusyny.
- Umieścić płytki w inkubatorze o stężeniu 5% CO2 i hodować pasożyty w temperaturze 37 °C 8-10 d bez zakłóceń, aby umożliwić tworzenie się blaszek miażdżycowych. Utrwalić próbki 70% etanolem (2 ml / studzienkę) i zabarwić monowarstwę 0,1% fioletem krystalicznym (2 ml / studzienkę). Umyj studnie wodą, aby uwidocznić blaszki (przezroczyste strefy) utworzone przez rozwój pasożyta.
UWAGA: Kontrola ujemna powinna być przetwarzana w ten sam sposób obok siebie.
- Oblicz wskaźnik oporności na sinusynę indukowaną przez CRISPR.
- Uzyskaj średnią liczbę (X) blaszek miażdżycowych ze studzienek niezawierających leku i oblicz żywotność pasożyta jako X/200. Uzyskaj średnią liczbę (Y) blaszek z dołków zawierających sinusynę, aby obliczyć szybkość oporności na sinusynę indukowaną przez CRISPR w następujący sposób:
Szybkość odporności indukowanej CRISPR = 200×Y/ (5000 × X × wydajność transfekcji)
UWAGA: Skuteczność transfekcji uzyskuje się z 4.3.2.
- Uzyskaj średnią liczbę (X) blaszek miażdżycowych ze studzienek niezawierających leku i oblicz żywotność pasożyta jako X/200. Uzyskaj średnią liczbę (Y) blaszek z dołków zawierających sinusynę, aby obliczyć szybkość oporności na sinusynę indukowaną przez CRISPR w następujący sposób:
- Komórki HFF należy zasiać do szkiełek nakrywkowych umieszczonych na płytkach 24-dołkowych 3-4 dni przed elektroporacją, tak aby zlały się do czasu przeprowadzenia transfekcji w ppkt 4.2.
- Zbadaj mutacje indel indukowane przez CRISPR/Cas9
- Wyhodować elektroporowane pasożyty z sekcji 4.2.9 w kolbie T25 wysianej komórkami HFF przez 2 dni w temperaturze 37 °C. Następnie zastąp pożywkę 5 ml pożywki D10 zawierającej 0,3 μM sinusyny (pożywka selekcyjna).
- Utrzymuj pasożyty w pożywce selekcyjnej przez co najmniej 3 przejścia, aż pula oporności stanie się stabilna (na co wskazuje brak wzrostu pasożyta w negatywnej grupie kontrolnej, ale silny wzrost pasożyta w grupie eksperymentalnej).
- Subklonuj pulę odporną na sinusynę, aby uzyskać szczepy klonalne.
- Zebrać świeżo usunięte pasożyty, oczyścić je przez filtrację membranową 3 μm i subklonować do 96-dołkowych płytek wysianych zbiegającymi się komórkami HFF w 150 μl pożywki D10. Hodować kultury subklonujące w inkubatorze CO2 w temperaturze 37 °C przez 7 - 10 dni bez naruszania płytek.
UWAGA: Patrz Protokół 4.4.2.1 Uwaga wpliku uzupełniającym S 1.
- Zebrać świeżo usunięte pasożyty, oczyścić je przez filtrację membranową 3 μm i subklonować do 96-dołkowych płytek wysianych zbiegającymi się komórkami HFF w 150 μl pożywki D10. Hodować kultury subklonujące w inkubatorze CO2 w temperaturze 37 °C przez 7 - 10 dni bez naruszania płytek.
- Sprawdź 96-dołkowe płytki pod mikroskopem z odwróconym kontrastem fazowym, aby poszukać studzienek, które zawierają tylko jedną płytkę. Zaznacz takie dołki, a następnie przenieś komórki z każdej studzienki na 24-dołkowe płytki wysiane komórkami HFF za pomocą pipety.
- Gdy 80-90% komórek HFF w studni zostanie poddanych lizie, należy zebrać pasożyty (około 500 μl) i przekazać 50 μl roztworu pasożyta do nowej studzienki, aby utrzymać szczep. Resztę (≈450 μl) należy wykorzystać do ekstrakcji genomowego DNA do amplifikacji PCR.
- W celu izolacji genomowego DNA z klonu SNFr, pasożyty należy osadzać (tolerowane są niewielkie ilości zanieczyszczenia komórek HFF) w ilości 1000 x g przez 10 minut. Przemyć granulowane pasożyty solą fizjologiczną buforowaną fosforanami (PBS) raz i ponownie je otulić. Wyizolować genomowe DNA z komórek granulowanych za pomocą zestawu komercyjnego lub przez gotowanie. Zawiesić pasożyty w 50-100 μL PBS.
UWAGA: Wykonaj PCR, aby uzyskać fragment genu SNR1 do sekwencjonowania. Użyj następujących starterów, aby wzmocnić locus2 SNR1: SNR1-Amp-Fw: 5' CCGACCACAA CAATTTTC i SNR1-Amp-Rv: 5'GACGTGATTCACTTTTTTACAGACACAC. Używaj polimeraz DNA o wysokiej wierności. Wzmocnij locus WT do celów kontrolnych.
- W celu izolacji genomowego DNA z klonu SNFr, pasożyty należy osadzać (tolerowane są niewielkie ilości zanieczyszczenia komórek HFF) w ilości 1000 x g przez 10 minut. Przemyć granulowane pasożyty solą fizjologiczną buforowaną fosforanami (PBS) raz i ponownie je otulić. Wyizolować genomowe DNA z komórek granulowanych za pomocą zestawu komercyjnego lub przez gotowanie. Zawiesić pasożyty w 50-100 μL PBS.
- Wykonać PCR z objętością reakcyjną 20 μl i uruchomić go w następującym programie: 98 °C przez 1 minutę, następnie 30 cykli po 98 °C przez 10 s, 55 °C przez 30 s i 72 °C przez 2,5 min, a następnie końcowe przedłużenie na 2 minuty w temperaturze 72 °C.
UWAGA: Sekwencjonuj produkty PCR za pomocą następujących starterów: SNR1-Seq1: 5' GCC ACA TGC TTT AGC GTG, SNR1-Seq2: 5' TCC TCT CCA TCA CGG GTT GG, SNR1-Seq3: 5' GCA AGA GCC GCG TGA CG, SNR1-Seq4: 5' CTC TCC CGC GGT CGA G, SNR1-Seq5: 5' GCA CCG TCC GCA AGC i SNR1-Seq6: 5' CCG GAA GGT GAA TCG TTC TTC. - Porównaj sekwencje genu SNR1 z mutantów opornych na sinusynę z sekwencjami szczepu WT za pomocą narzędzia do dopasowywania sekwencji.
UWAGA: Patrz Plik Uzupełniający 2 Protokół 5 w celu uzyskania szczegółowych informacji na temat wykorzystania selekcji negatywnej w locus SNR1 do komplementacji genetycznej lub budowy szczepu transgenicznego.
- Wyhodować elektroporowane pasożyty z sekcji 4.2.9 w kolbie T25 wysianej komórkami HFF przez 2 dni w temperaturze 37 °C. Następnie zastąp pożywkę 5 ml pożywki D10 zawierającej 0,3 μM sinusyny (pożywka selekcyjna).
Wyniki
Niniejszy artykuł szczegółowo opisuje kilka metod, które można zastosować sekwencyjnie w celu zidentyfikowania genu odpowiedzialnego za oporność na lek (Rycina 1). 24 potomki krzyżówki ME49-FUDRr X VAND-SNFr oceniono pod kątem oporności na lek sinefungina zgodnie z opisem w Protokole 1. Wykorzystując mapę genetyczną oraz fenotyp SNFr potomstwa, w programie R/qtl przeprowadzono skanowanie QTL – Protokół 2 (Rycina 2). Wynikiem było jedno istotne maksimum na chromosomie IX, obejmujące obszar około 1 Mbp. To właśnie w tym regionie znajduje się mutacja sprawcza.
W celu identyfikacji mutacji przyczynowej, odczyty WGS z potomstwa zostały dopasowane do genomu referencyjnego VAND-SNFs przy użyciu programu Bowtie2 – Protokół 3.1, SNP zostały wywołane przy użyciu VarScan mpileup2snp – Protokół 3.2, a locus QTL w genomie VAND zostało zidentyfikowane za pomocą programu MUMmer – Protokół 3.3. Wyekstrahowano SNP potomstwa w obrębie locus QTL i przeszukano je pod kątem wzorca, w którym potomstwo SNFr posiada SNP, a SNFs go nie ma; było to możliwe, ponieważ SNP potomstwa uzyskano poprzez porównanie z genomem referencyjnym VAND-SNFs (Rysunek 3). Tylko jeden SNP odpowiadał temu wzorcowi, co skutkuje powstaniem przedwczesnego kodonu stop w domniemanym genie transportera aminokwasów nazwanym SNR1.
Potwierdzenie, że SNR1 jest genem oporności na SNFr, przeprowadzono z wykorzystaniem systemu CRISPR/Cas9. Stworzono nowy plazmid CRISPR/Cas9 zaprojektowany do edycji genów T. gondii, zawierający gRNA celujące w gen SNR1 w pobliżu mutacji SNFr zidentyfikowanej w potomstwie – Protokół 4 (Rysunek 4A). Plazmid CRISPR/Cas9 celujący w SNR1 wprowadzono metodą elektroporacji do szczepu pasożyta SNFs WT, a mutanty oporne uzyskano po hodowli w obecności 0,3 µM sinefunginy. Nie uzyskano pasożytów SNFr po elektroporacji plazmidem CRISPR/Cas9 celującym w UPRT. Sklonowano kilka mutantów SNFr CRISPR i zsekwencjonowano region wokół celu gRNA dla SNR1. Każdy mutant posiadał indel, który zakłócał sekwencję kodującą genu SNR1 (Rysunek 4B). Metoda ta może być również wykorzystana do wstawienia konstruktu celującego do locus SNR1 poprzez NHEJ (Rysunek 5) lub HR (Rysunek 6) – Plik uzupełniający 2.
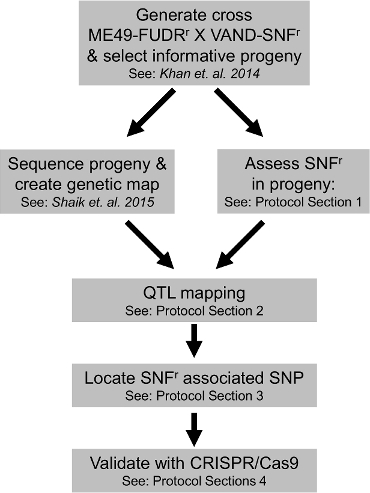
Rycina 1: Schematyczna procedura doświadczeń opisanych w protokołach. Główne etapy identyfikacji i potwierdzenia genu SNFr z wykorzystaniem krzyżówki ME49-FUDRr X VAND-SNFr zostały przedstawione z odniesieniem do odpowiednich protokołów opisanych w niniejszym artykule. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
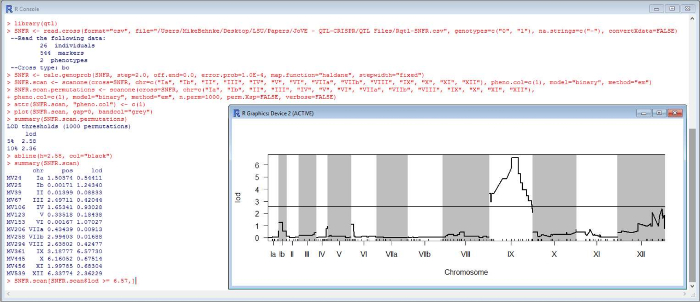
Rysunek 2: Polecenia R/qtl do przeprowadzenia skanowania QTL dla fenotypu SNFr. Polecenia opisane w Protokole 2 zostały wykonane w programie R z wykorzystaniem pakietu qtl. Przedstawiono reprezentatywne polecenia i wykres. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
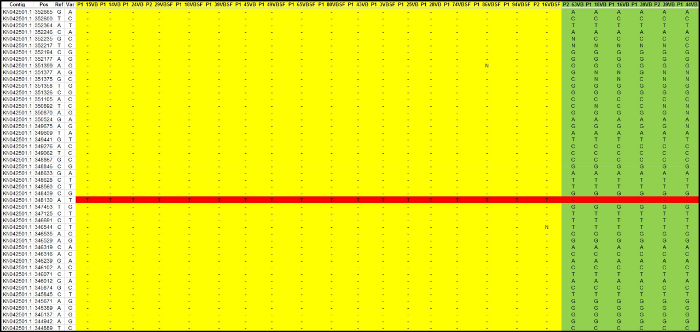
Rysunek 3: Lokalizacja przyczynowego SNP. Odczyty WGS potomstwa dopasowano do genomu referencyjnego VAND-SNFs za pomocą Bowtie 2, SNP wyznaczono programem VarScan, a odpowiadający im locus QTL VAND zidentyfikowano przy użyciu MUMmer. SNP zlokalizowane w obrębie locus QTL zaimportowano do arkusza kalkulacyjnego, w celu zidentyfikowania przyczynowego SNP. Potomstwo SNFr (żółte), potomstwo SNFs (zielone), SNP SNFr (czerwone) (patrz Plik danych 3). Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
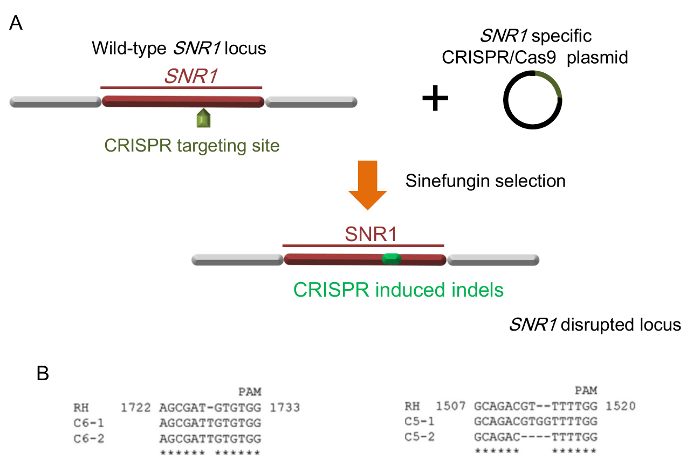
Rysunek 4: Potwierdzanie SNR1 jako SNFProszę podać tekst źródłowy do przetłumaczenia. Edycja genów za pomocą CRISPR/Cas9. (A) mutacje typu indel wywołane przez system CRISPR/Cas9 (kolor zielony) w SNR1 locus. (B) Reprezentatywne indele w SNR1 spowodowane przez dwa różne SNR1 konkretne plazmidy CRISPR (odpowiednio C5 i C6). RH jest szczepem typu dzikiego (WT), a C5 i C6 są SNFProszę podać tekst do tłumaczenia. mutanty. (B zaczerpnięto z referencji 2). Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
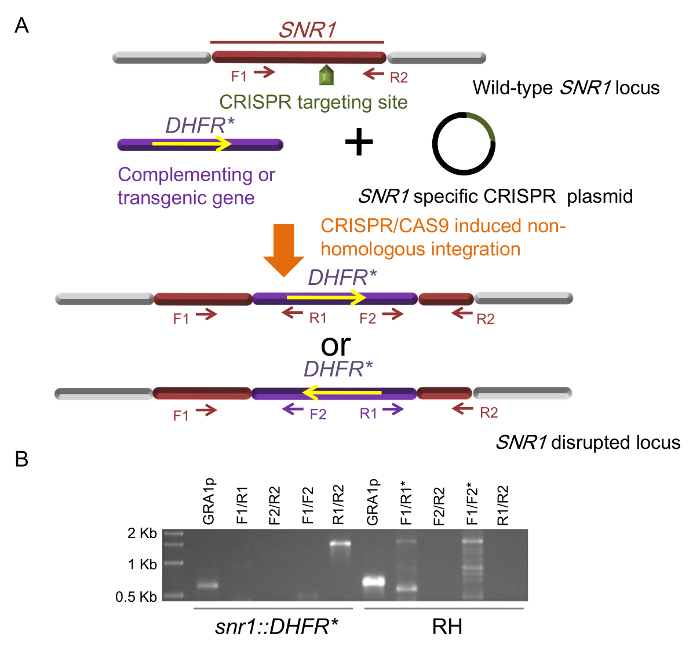
Rysunek 5. Mutageneza insercyjna z użyciem CRISPR/Cas9. (A) Insercja genów komplementujących lub transgenicznych do locus SNR1 poprzez specyficzną dla miejsca integrację pośredniczoną przez CRISPR/Cas9. Dwie możliwe orientacje wstawionego minigenu DHFR* oraz startery użyte do identyfikacji; F1/2 i R1/2 reprezentują miejsca wiązania oligonukleotydów użytych w diagnostycznych reakcjach PCR. (B) Diagnostyczne reakcje PCR jednego klonu snr1::DHFR* ; RH służy jako kontrola WT. PCR dla GRA1p został uwzględniony jako kontrola jakości DNA genomowego użytego jako matryca. Gwiazdki oznaczają ścieżki z niespecyficznymi prążkami (Rysunek 5B pochodzi z referencji 2). Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
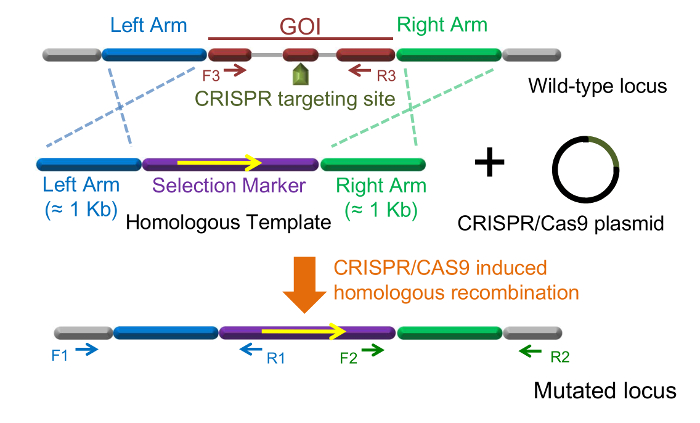
Rysunek 6: Wyłączenie genu (knockout) za pomocą CRISPR/Cas9. Klasyczny projekt zapośredniczonej przez CRISPR/Cas9 homologicznej wymiany genu u T. gondii. Orientacja wstawionego transgenu jest w tym przypadku stała. F1/R1, F2/R2 i F3/R3 reprezentują miejsca przyłączania starterów oligos używanych w diagnostycznych reakcjach PCR. Aby wyświetlić większą wersję tego rysunku, kliknij tutaj.
Plik z danymi 1: Plik krzyżowania ME49-FUDRr X VAND-SNFr do użytku w R/qtl, format „csv”. Jeden plik .csv, który można wczytać do programu R/qtl za pomocą opcji format="csv". Kliknij tutaj, aby pobrać ten plik.
Plik danych 2: (chrid.txt, genotype.txt, markerpos.txt, mname.txt, phenonames.txt oraz phenos.txt). ME49-FUDRProszę o podanie tekstu źródłowego do przetłumaczenia. X VAND-SNFr Pliki krzyżówek do użytku w programie R/qtl, format „gary”. Sześć plików .txt, które można wczytać do programu R/qtl za pomocą opcji format="gary". Prosimy kliknąć tutaj, aby pobrać ten plik.
Plik danych 3. Arkusz kalkulacyjny z SNP potomstwa w obrębie locus QTL SNFr. Zawiera jeden arkusz z SNP potomstwa oraz drugi arkusz z danymi fenotypowymi rodziców i potomstwa krzyżówki. Kliknij tutaj, aby pobrać ten plik.
Plik uzupełniający 1: Dodatkowe szczegóły protokołu. Kliknij tutaj, aby pobrać ten plik.
Plik uzupełniający 2: Protokół 5 – Wykorzystanie selekcji negatywnej w SNR1 Locus dla komplementacji genetycznej lub konstrukcji szczepów transgenicznych. Prosimy kliknąć tutaj, aby pobrać ten plik.
Dyskusja
Protokoły te przedstawiają kilka metod, które w połączeniu pozwalają na identyfikację genu oporności na leki u T. gondii. Dwie z nich były integralną częścią projektu: stosunkowo doświadczona metoda mapowania QTL oraz niedawno opracowana metoda edycji genów CRISPR/Cas9. Lander i Botstein opublikowali swoją wpływową pracę w 1989 roku, demonstrując mapowanie QTL, które koreluje loci genetyczne z fenotypami 36. Niedawno, w 2012 roku, Dounda i Charpentier opisali system edycji CRISPR/Cas9 u Streptococcus pyogenes 22, który został szybko zaadaptowany jako narzędzie genetyczne w wielu różnych modelach, w tym T. gondii13,17. Obie metody okazały się przydatne w tym przypadku, gdzie mapowanie QTL zdefiniowało locus zawierające mutację oporności na leki, która została ostatecznie zidentyfikowana za pomocą wykrywania SNP opartego na WGS, a edycja CRISPR/Cas9 zapewniła środki do potwierdzenia, że SNR1 jest genem oporności na leki sinusynowe.
Krzyżówka ME49-FUDRr X VAND-SNFr 8 została pierwotnie opracowana do badania fenotypu wirulencji 19, ale okazało się, że szczepy rodzicielskie mają również dodatkową różnicę fenotypową, dla której gen przyczynowy nie był znany, oporność na sinusynę u rodzica VAN. Podkreśla to jedną z zalet krzyżówek, ponieważ można je ponownie wykorzystać, gdy zaobserwuje się dodatkowe różnice fenotypowe u rodziców. Tak było w przypadku innej krzyżówki Toxoplasma, typu 2 x typu 3, w której znaleziono kilka genów zaangażowanych w wirulencję poprzez mapowanie wielu fenotypów 37,38,39,40. Do tej pory opisano cztery różne krzyżówki T. gondii i wykorzystano je do mapowania genów odpowiedzialnych za fenotypy 8,37,41,42, z których wszystkie mają potencjał do ponownego wykorzystania do mapowania nowych fenotypów, dla których podstawa genetyczna jest nieznana. W związku z tym zsekwencjonowano genomy 62 szczepów T. gondii reprezentujących znaną globalną różnorodność genetyczną 43. Z tej puli można by tworzyć nowe krzyżówki dla szczepów różniących się interesującymi fenotypami. Wychwalając zalety mapowania QTL, trzeba powiedzieć, że wygenerowanie krzyża nie jest drobnym przedsięwzięciem. Istnieją inne metody, które można wykorzystać do identyfikacji genów przyczynowych. Jedna z potężnych technik wykorzystuje mutagenezę chemiczną do tworzenia mutantów, które można badać pod kątem fenotypów. Aby znaleźć gen przyczynowy, mutanty można albo uzupełnić bibliotekami kosmidowymi 44, albo zastosować metody sekwencjonowania genomu w celu znalezienia mutacji przyczynowej 45. Więcej informacji na ten temat można znaleźć w dwóch artykułach JoVE autorstwa Colemana i wsp. oraz Walwyn i wsp., które przedstawiają te podejścia 46,47.
Wiele etapów prowadzących do zidentyfikowania przyczynowej mutacji SNFr (protokoły 2 i 3) opiera się na metodach obliczeniowych przeprowadzonych przy użyciu oprogramowania, które jest swobodnie dostępne do użytku akademickiego. Szczegółowe polecenia dla każdego kroku są dostępne, a po uruchomieniu z odpowiednimi plikami pozwolą użytkownikowi na odtworzenie zestawów danych niezbędnych do znalezienia przyczynowego SNFr SNP. Należy pamiętać, że część składni poleceń odwołuje się do nazw plików lub struktury katalogów ($PATH), które można modyfikować zgodnie z preferencjami użytkownika. Chociaż podane tutaj polecenia z pewnością nie wyczerpują sposobów analizy krzyżówki z analizą QTL i identyfikacją SNP opartą na WGS, są one wystarczająco wyczerpujące, aby powtórzyć eksperyment opisany w tym artykule i powinny pozwolić użytkownikowi lepiej zapoznać się z tym, jak te podejścia są wykorzystywane krok po kroku.
Chociaż mapowanie QTL i wykrywanie SNP w oparciu o sekwencję WGS były wystarczające do zidentyfikowania potencjalnego genu SNFr, potrzebne są dodatkowe eksperymenty, aby potwierdzić jego rolę w oporności na leki. Można to przekonująco wykazać za pomocą technik rozrywania lub nokautu genów, które można osiągnąć za pomocą edycji genów CRISPR/Cas9. Podano szczegółowe metody wykorzystania CRISPR/Cas9 do generowania mutacji indel lub wstawiania konstruktów transgenicznych do genu docelowego u T. gondii. Specyficzność ukierunkowania, którą zapewnia CRISPR/Cas9, zwiększa efektywność edycji genów w porównaniu z tradycyjnymi metodami. Ponadto, wzrost ten umożliwił wykorzystanie szczepów nieprzystosowanych laboratoryjnie do badań genetycznych, które wcześniej były trudne do modyfikacji 13. Mimo że w powijakach, CRISPR/Cas9 był już używany do zakłócania genów 2,13,17,18,48,49, oznaczania genów 17 i nokautowania genów 16,19,50,51,52,53,54 u T. gondii , który ma być użytecznym narzędziem w wielu innych badaniach w przyszłości.
Odkrycie, że inaktywacja SNR1 prowadzi do oporności na sinusynę, sprawia, że locus SNR1 jest obiecującym miejscem do insercji transgenu lub komplementacji genetycznej. Aby zmaksymalizować sukces wykorzystania celowania genów za pośrednictwem CRISPR/Cas9 w celu kierowania integracją transgenu z locus SNR1 , podczas projektowania eksperymentalnego należy wziąć pod uwagę następujące aspekty. Po pierwsze, zaleca się włączenie markera selekcyjnego do konstruktu transgenicznego w celu zwiększenia efektywności budowy szczepu. Jeśli uwzględniony jest marker selekcyjny, można zastosować zarówno selekcję pozytywną, jak i negatywną, w wyniku czego prawie 100% podwójnie wyselekcjonowanych pasożytów jest transgenicznych z GOI zintegrowanym w locus SNR1 . W przeciwieństwie do tego, jeśli konstrukt transgeniczny nie zawiera dodatkowych cech możliwych do selekcji i opiera się na selekcji negatywnej w locus SNR1 , skuteczność udanej transgenezy w dużej mierze zależy od wydajności kotransfekcji plazmidu CRISPR i konstruktu transgenicznego.
Po drugie, chociaż integracja specyficzna dla miejsca za pośrednictwem CRISPR/Cas9 niehomologicznego fragmentu DNA jest często stosowana do komplementacji i transgenezy, należy zauważyć, że w takich przypadkach nie można zagwarantować orientacji insercji, ponieważ możliwy jest dowolny kierunek. Może to powodować problemy z niektórymi aplikacjami. Na przykład, aby uzupełnić mutanta różnymi allelami genów, trudno jest zapewnić, że wszystkie allele są wstawione w tej samej orientacji, a rozbieżności w orientacji mogą powodować różnice w ekspresji. Do tego typu zastosowań zalecane są konstrukty DNA z sekwencjami homologicznymi do locus SNR1 , które będą napędzać właściwą orientację integracji (ryc. 6).
Po trzecie, podczas transfekcji stosunek między plazmidem CRISPR a transgeniczną cząsteczką DNA ma kluczowe znaczenie dla udanej budowy szczepu transgenicznego. Stosunek ten należy dostosować do strategii selekcji. Zalecane są następujące wytyczne: 1) Jeśli konstrukt transgeniczny zawiera marker lekooporności, a odpowiadający mu lek jest jedyną selekcją używaną do generowania pasożytów transgenicznych, tj. nie stosuje się sinusyny, sugerowany stosunek molowy między konstruktem transgenicznym a plazmidem CRISPR wynosi 1:5. Użycie większej ilości plazmidu CRISPR w tym przypadku zwiększa prawdopodobieństwo, że pasożyty otrzymujące konstrukt transgeniczny otrzymają również plazmid CRISPR, dlatego pasożyty oporne na leki są bardziej skłonne do umieszczenia markera w miejscu docelowym CRISPR. Jeśli stosunek zostanie odwrócony, większość pasożytów, które otrzymają konstrukt transgeniczny, nie otrzyma plazmidu CRISPR. W konsekwencji zdecydowana większość pasożytów opornych na leki uzyskuje konstrukt transgeniczny poprzez losową integrację, która nie jest związana z insercją specyficzną dla miejsca za pośrednictwem CRISPR/CAS9. 2) Jeśli konstrukt transgeniczny zawiera marker oporności na lek i odpowiedni lek jest stosowany wraz z sinusyną do selekcji pasożytów transgenicznych, sugerowany stosunek molowy między konstruktem transgenicznym a plazmidem CRISPR wynosi 1:1. Strategia ta zapewnia najwyższą efektywność budowy szczepów transgenicznych. 3) Jeśli konstrukt transgeniczny nie zawiera selekcjonowanego twórcy, polegającego na selekcji negatywnej za pomocą samej sinusyny w celu uzyskania pasożytów transgenicznych, sugerowany stosunek molowy między konstruktem transgenicznym a plazmidem CRISPR wynosi 5:1. Uzasadnienie tego projektu jest takie samo, jak w pierwszej wytycznej powyżej. Ponieważ zarówno pirymetamina, jak i sinusyna zostały użyte do selekcji w Protokole 5, stosunek między mini genem DHFR* a plazmidem CRISPR ukierunkowanym na SNR1 ustalono na 1:1.
Podsumowując, przedstawione tutaj metody mają poziom szczegółowości, który nie był możliwy do przekazania w oryginalnej publikacji, która zidentyfikowała SNR1 2. Protokoły te; w szczególności składnia wiersza poleceń, sekwencyjny układ używanych programów oraz użycie CRISPR/Cas9 powinny pomóc w przyszłych wysiłkach na rzecz identyfikacji nowych genów odpowiedzialnych za fenotypy.
Oświadczenia
Autorzy oświadczają, że nie mają konkurencyjnych interesów finansowych.
Podziękowania
Chcielibyśmy podziękować L. Davidowi Sibleyowi i Asis Khanowi za ich wkład w oryginalną publikację, na której opierają się te protokoły. Praca ta została sfinansowana z grantu National Institutes of Health AI108721.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Kolby T25 | Corning | 430639 | |
| Ludzkie fibroblasty napletka (HFF) | ATCC | SCRC-1041 | |
| T. gondii Szczep ME49 | ATCC | 50840< | |
| em>T. gondiiVAND szczep | ATCC | PRA-344 | |
| DMEM (bez wodorowęglanu sodu) | Nauki biologiczne | 12800017 | |
| Wodorowęglan sodu | Sigma Aldrich | S5761 | |
| HEPES | Sigma Aldrich | H3375 | |
| Płodowa surowica bydlęca (FBS) Premium Grade | VWR International | 97068-085 | |
| L-glutamina 200 mM | Sigma Aldrich | G7513 | |
| Gentamycyna (10 mg/ml) | Life Technologies | do komórek 15710064 | |
| do kolb | VWR International | 10062-904 | |
| Strzykawka 10 ml | BD | 309604 | |
| igły 22 G x 1" | BRICO Products | BN2210 | |
| Filtr nukleporowy 3.0 i mikro; m, 25 mm | Uchwyt | 110612 | |
| Swin-Lok 25 mm | GE Healthcare | 420200 | |
| Hemacytometr | Propper MFG | 90001 | |
| Sinefungin | Enzo Life Sciences | 380-070-M001 | |
| R | Fundacja R | https://www.r-project.org/ | |
| J/qtl | Grupa Churchill | http://churchill.jax.org/software/jqtl.shtml | |
| Bowtie2 | Uniwersytet Johna Hopkinsa | http://bowtie-bio.sourceforge.net/bowtie2/index.shtml | |
| Zestaw narzędzi NCBI NCBI | http://www.ncbi.nlm.nih.gov/Traces//?view=toolkit_doc | ||
| SAMtools | Wellcome Trust Sanger Institute | http://www.htslib.org/ | |
| VarScan | Washington University, St Louis | http://varscan.sourceforge.net/ | |
| MUMmer | JCVI & Univ Hamburg | http://mummer.sourceforge.net/ | |
| pSAG1::CAS9-U6::sgUPRT | Addgene Plasmid #54467 | T. gondii Plazmid CRISPR do cięcia genu UPRT | |
| pSAG1::CAS9-U6::sg290860-6 | Addgene | Plasmid #59855 | T. gondii Plazmid CRISPR do cięcia genu TG*_290860 SNR1 |
| pUPRT::D HFR-D | Addgene Plazmid | #58528 | Szablon zestawu do DHFR* mini gene |
| Q5 Site-Directed Mutageneza Kit | New England Biolabs | E0552S | |
| QIAprep Spin Miniprep Kit | QIAGEN | 27106 | |
| NanoDrop 2000 | Thermo Scientific | ND-2000 | |
| LB Bulion | Fisher Scientific | DF0446-07-5 | |
| Chlorek potasu | Sigma Aldrich | P9541 | |
| Chlorek wapnia | Sigma Aldrich | 746495 | |
| Fosforan potasu jednozasadowy | Sigma Aldrich | P9791 | |
| Fosforan potasu dwuzasadowy | Sigma | Aldrich P5504 | |
| EDTA | Sigma Aldrich | E5134 | |
| Chlorek magnezu | Sigma Aldrich | M1028 | |
| Adenozyna triposhpate (ATP) | Sigma | Aldrich A6419 | |
| L-glutation (GSH) | Sigma System | G4251 | |
| ECM 830 | BTX | 45-0002 | |
| Kuweta do elektroporacji 4 mm | Aparat Harvard | 45-0126 | |
| Crytal Violet | Alfa Aesar | B21932-14 | |
| 6-dołkowa płytka TC | Corning | 353046 | |
| 24-dołkowa płytka TC | Corning | 353935 | |
| Szklana osłona 12 mm okrągła | VWR International | 89015-724 | |
| 96-dołkowa płytka TC | Corning | 353075 | |
| Gibson Assembly Cloning Kit (wielofragmentowy) | New England Biolabs | E5510S | |
| Q5 Polimeraza wysokiej wierności | New England Biolabs | M0491S | |
| Pirymetamina | TCI AMERICA | P2037-1G | Stosowanie w przypadku stosowania pasożytów odpornych na pirymetaminę - patrz Protokół |
Bibliografia
- Dubey, J. P. The history of Toxoplasma gondii--the first 100 years. J Eukaryot Microbiol. 55 (6), 467-475 (2008).
- Behnke, M. S., Khan, A., Sibley, L. D. Genetic Mapping Reveals that Sinefungin Resistance in Toxoplasma gondii Is Controlled by a Putative Amino Acid Transporter Locus That Can Be Used as a Negative Selectable Marker. Eukaryot Cell. 14 (2), 140-148 (2015).
- Dubey, J. P. History of the discovery of the life cycle of Toxoplasma gondii. Int J Parasitol. 39 (8), 877-882 (2009).
- Pfefferkorn, L. C., Pfefferkorn, E. R. Toxoplasma gondii: genetic recombination between drug resistant mutants. Exp Parasitol. 50 (3), 305-316 (1980).
- Donald, R. G., Roos, D. S. Insertional mutagenesis and marker rescue in a protozoan parasite: cloning of the uracil phosphoribosyltransferase locus from Toxoplasma gondii. Proc Natl Acad Sci U S A. 92 (12), 5749-5753 (1995).
- Sullivan, W. J. Jr Insertional tagging of at least two loci associated with resistance to adenine arabinoside in Toxoplasma gondii, and cloning of the adenosine kinase locus. Mol Biochem Parasitol. 103 (1), 1-14 (1999).
- Khan, A. Composite genome map and recombination parameters derived from three archetypal lineages of Toxoplasma gondii. Nucleic Acids Res. 33 (9), 2980-2992 (2005).
- Khan, A. NextGen sequencing reveals short double crossovers contribute disproportionately to genetic diversity in Toxoplasma gondii. BMC Genomics. 15 (1), 1168(2014).
- Shaik, J. S., Khan, A., Beverley, S. M., Sibley, L. REDHORSE-REcombination and Double crossover detection in Haploid Organisms using next-geneRation SEquencing data. BMC Genomics. 16 (1), 133(2015).
- Arends, D., Prins, P., Jansen, R. C., Broman, K. W. R/qtl: high-throughput multiple QTL mapping. Bioinformatics. 26 (23), 2990-2992 (2010).
- Langmead, B., Salzberg, S. L. Fast gapped-read alignment with Bowtie 2. Nat Methods. 9 (4), 357-359 (2012).
- Koboldt, D. C. VarScan 2: somatic mutation and copy number alteration discovery in cancer by exome sequencing. Genome Res. 22 (3), 568-576 (2012).
- Shen, B., Brown, K. M., Lee, T. D., Sibley, L. D. Efficient gene disruption in diverse strains of Toxoplasma gondii using CRISPR/CAS9. MBio. 5 (3), e01114(2014).
- Fox, B. A., Ristuccia, J. G., Gigley, J. P., Bzik, D. J. Efficient gene replacements in Toxoplasma gondii strains deficient for nonhomologous end joining. Eukaryot Cell. 8 (4), 520-529 (2009).
- Huynh, M. H., Carruthers, V. B. Tagging of endogenous genes in a Toxoplasma gondii strain lacking Ku80. Eukaryot Cell. 8 (4), 530-539 (2009).
- Wang, J. L. The Past, Present, and Future of Genetic Manipulation in Toxoplasma gondii. Trends Parasitol. , (2016).
- Sidik, S. M., Hackett, C. G., Tran, F., Westwood, N. J., Lourido, S. Efficient genome engineering of Toxoplasma gondii using CRISPR/Cas9. PLoS One. 9 (6), e100450(2014).
- Sugi, T., Kato, K., Weiss, L. M. An improved method for introducing site-directed point mutation into the Toxoplasma gondii genome using CRISPR/Cas9. Parasitol Int. , (2016).
- Behnke, M. S. Rhoptry Proteins ROP5 and ROP18 Are Major Murine Virulence Factors in Genetically Divergent South American Strains of Toxoplasma gondii. PLoS Genet. 11 (8), e1005434(2015).
- Barrangou, R. CRISPR provides acquired resistance against viruses in prokaryotes. Science. 315 (5819), 1709-1712 (2007).
- Garneau, J. E. The CRISPR/Cas bacterial immune system cleaves bacteriophage and plasmid DNA. Nature. 468, 67-71 (2010).
- Jinek, M. A programmable dual-RNA-guided DNA endonuclease in adaptive bacterial immunity. Science. 337 (6096), 816-821 (2012).
- Cong, L. Multiplex genome engineering using CRISPR/Cas systems. Science. 339 (6121), 819-823 (2013).
- Mali, P. RNA-guided human genome engineering via Cas9. Science. 339 (6121), 823-826 (2013).
- Jiang, F., Zhou, K., Ma, L., Gressel, S., Doudna, J. A. STRUCTURAL BIOLOGY. A Cas9-guide RNA complex preorganized for target DNA recognition. Science. 348 (6242), 1477-1481 (2015).
- Nishimasu, H. Crystal Structure of Staphylococcus aureus Cas9. Cell. 162 (5), 1113-1126 (2015).
- The R Project for Statistical Computing. , Available from: https://www.r-project.org (2016).
- Smith, R., Sheppard, K., DiPetrillo, K., Churchill, G. Quantitative trait locus analysis using J/qtl. Methods Mol Biol. 573, 175-188 (2009).
- The Churchill Group. , J/qtl. http://churchill.jax.org/software/jqtl.shtml (2013).
- Li, H. The Sequence Alignment/Map format and SAMtools. Bioinformatics. 25 (16), 2078-2079 (2009).
- Kurtz, S. Versatile and open software for comparing large genomes. Genome Biol. 5 (2), (2004).
- Gajria, B. ToxoDB: an integrated Toxoplasma gondii database resource. Nucleic Acids Res. 36 (Database issue), D553-D556 (2008).
- Heigwer, F., Kerr, G., Boutros, M. E-CRISP: fast CRISPR target site identification. Nat Methods. 11 (2), 122-123 (2014).
- Roos, D. S. Molecular genetic tools for the identification and analysis of drug targets in Toxoplasma gondii. Curr Top Microbiol Immunol. 219, 247-259 (1996).
- Soldati, D., Boothroyd, J. C. Transient transfection and expression in the obligate intracellular parasite Toxoplasma gondii. Science. 260 (5106), 349-352 (1993).
- Lander, E. S., Botstein, D. Mapping mendelian factors underlying quantitative traits using RFLP linkage maps. Genetics. 121 (1), 185-199 (1989).
- Saeij, J. P. Polymorphic secreted kinases are key virulence factors in toxoplasmosis. Science. 314 (5806), 1780-1783 (2006).
- Saeij, J. P. Toxoplasma co-opts host gene expression by injection of a polymorphic kinase homologue. Nature. 445 (7125), 324-327 (2007).
- Rosowski, E. E. Strain-specific activation of the NF-kappaB pathway by GRA15, a novel Toxoplasma gondii dense granule protein. J Exp Med. 208 (1), 195-212 (2011).
- Reese, M. L., Zeiner, G. M., Saeij, J. P., Boothroyd, J. C., Boyle, J. P. Polymorphic family of injected pseudokinases is paramount in Toxoplasma virulence. Proc Natl Acad Sci U S A. 108 (23), 9625-9630 (2011).
- Taylor, S. A secreted serine-threonine kinase determines virulence in the eukaryotic pathogen Toxoplasma gondii. Science. 314 (5806), 1776-1780 (2006).
- Behnke, M. S. Virulence differences in Toxoplasma mediated by amplification of a family of polymorphic pseudokinases. Proc Natl Acad Sci U S A. 108 (23), 9631-9636 (2011).
- Lorenzi, H. Local admixture of amplified and diversified secreted pathogenesis determinants shapes mosaic Toxoplasma gondii genomes. Nat Commun. 7, 10147(2016).
- Gubbels, M. J. Forward genetic analysis of the apicomplexan cell division cycle in Toxoplasma gondii. PLoS Pathog. 4 (2), e36(2008).
- Farrell, A. A DOC2 protein identified by mutational profiling is essential for apicomplexan parasite exocytosis. Science. 335 (6065), 218-221 (2012).
- Coleman, B. I., Gubbels, M. J. A genetic screen to isolate Toxoplasma gondii host-cell egress mutants. J Vis Exp. (60), (2012).
- Walwyn, O. Forward genetics screens using macrophages to identify Toxoplasma gondii genes important for resistance to IFN-gamma-dependent cell autonomous immunity. J Vis Exp. (97), (2015).
- Rugarabamu, G., Marq, J. B., Guerin, A., Lebrun, M., Soldati-Favre, D. Distinct contribution of Toxoplasma gondii rhomboid proteases 4 and 5 to micronemal protein protease 1 activity during invasion. Mol Microbiol. 97 (2), 244-262 (2015).
- Varberg, J. M., Padgett, L. R., Arrizabalaga, G., Sullivan, W. J. Jr TgATAT-Mediated alpha-Tubulin Acetylation Is Required for Division of the Protozoan Parasite Toxoplasma gondii. mSphere. 1 (1), (2016).
- Zheng, J., Jia, H., Zheng, Y. Knockout of leucine aminopeptidase in Toxoplasma gondii using CRISPR/Cas9. Int J Parasitol. 45 (2-3), 141-148 (2015).
- Long, S., Wang, Q., Sibley, L. D. Analysis of Noncanonical Calcium-Dependent Protein Kinases in Toxoplasma gondii by Targeted Gene Deletion Using CRISPR/Cas9. Infect Immun. 84 (5), 1262-1273 (2016).
- Wang, K. Identification of Novel O-Linked Glycosylated Toxoplasma Proteins by Vicia villosa Lectin Chromatography. PLoS One. 11 (3), e0150561(2016).
- Yang, M., Zheng, J., Jia, H., Song, M. Functional characterization of X-prolyl aminopeptidase from Toxoplasma gondii. Parasitology. , 1-7 (2016).
- Zhang, W. Analysis of the virulence determination mechanisms in a local Toxoplasma strain (T.gHB1) isolated from central China. Parasitol Res. , (2016).
Przedruki i uprawnienia
