Ten manuskrypt opisuje, jak przeprowadzić analizę interakcji psychofizjologicznej, aby ujawnić zależne od zadania zmiany funkcjonalnej łączności między wybranym regionem nasiennym a wokselami w innych regionach mózgu. Analiza interakcji psychofizjologicznych jest popularną metodą badania wpływu zadań na łączność mózgową, w odróżnieniu od tradycyjnych efektów aktywacji jednowymiarowej.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Analiza uogólnionej interakcji psychofizjologicznej (PPI) łączności związanej z pamięcią u osób z genetycznym ryzykiem choroby Alzheimera
W tym artykule
Podsumowanie
Streszczenie
W neuroobrazowaniu, funkcjonalny rezonans magnetyczny (fMRI) mierzy sygnał zależny od poziomu natlenienia krwi (BOLD) w mózgu. Stopień korelacji sygnału BOLD w przestrzennie niezależnych obszarach mózgu określa funkcjonalną łączność tych regionów. Podczas zadania poznawczego fMRI analiza interakcji psychofizjologicznej (PPI) może być wykorzystana do zbadania zmian w łączności funkcjonalnej w określonych kontekstach zdefiniowanych przez zadanie poznawcze. Przykładem takiego zadania jest takie, które angażuje system pamięci, prosząc uczestników o nauczenie się par niepowiązanych ze sobą słów (kodowanie) i przypomnienie sobie drugiego słowa w parze, gdy przedstawiono mu pierwsze słowo (odzyskiwanie). W niniejszym badaniu wykorzystaliśmy ten rodzaj zadania pamięci asocjacyjnej i uogólnioną analizę PPI (gPPI), aby porównać zmiany w połączeniach hipokampa u osób starszych, które są nosicielami genetycznego czynnika ryzyka choroby Alzheimera (AD) apolipoproteiny-E epsilon-4 (APOEε4). W szczególności pokazujemy, że funkcjonalna łączność podregionów hipokampa zmienia się podczas kodowania i odzyskiwania, dwóch aktywnych faz zadania pamięci asocjacyjnej. Zależne od kontekstu zmiany w funkcjonalnej łączności hipokampa różniły się istotnie u nosicieli APOEε4 w porównaniu z osobami niebędącymi nosicielami. Analizy PPI umożliwiają zbadanie zmian w łączności funkcjonalnej, odrębnych od jednowymiarowych efektów głównych, oraz porównanie tych zmian między grupami. W związku z tym analiza PPI może ujawnić złożone efekty zadań w określonych kohortach, których tradycyjne metody jednowymiarowe nie uwzględniają. Analizy PPI nie są jednak w stanie określić kierunkowości ani przyczynowości między funkcjonalnie połączonymi regionami. Niemniej jednak analizy PPI dostarczają potężnych środków do generowania konkretnych hipotez dotyczących zależności funkcjonalnych, które można testować za pomocą modeli przyczynowych. Ponieważ mózg jest coraz częściej opisywany w kategoriach połączeń i sieci, PPI jest ważną metodą analizy danych z zadań fMRI, która jest zgodna z obecną koncepcją ludzkiego mózgu.
Wprowadzenie
Termin "konektom" został ukuty w 2005 roku, co oznacza zmianę paradygmatu w neurobiologii, która trwa do dziś1. Mózg jest coraz częściej opisywany w kategoriach sieci funkcjonalnych, połączeń i interakcji między regionami na dużą skalę. Niemniej jednak nakreślenie regionalnej specjalizacji funkcjonalnej i powiązania między aktywnością mierzoną za pomocą fMRI a wymaganiami zadaniowymi są nadal ważnymi i użytecznymi podejściami. W świetle rosnącego zainteresowania konektomomiką, coraz większą popularnością zyskują podejścia oparte na łączności funkcjonalnej do analizy fMRI. Jednym z podejść do pomiaru zmian łączności funkcjonalnej w zależności od wymagań zadania wykorzystuje się koncepcję PPI. PPI to interakcja aktywnej fazy zadania lub szczególnego zapotrzebowania na zadanie ("psycho") z funkcjonalną łącznością ("fizjo") obszaru zainteresowania lub "ziarna" w mózgu. PPI różni się od dwuwymiarowej, opartej na korelacji analizy łączności funkcjonalnej, która generalnie mierzy stopień korelacji między aktywnością w dwóch regionach bez żadnych ograniczeń związanych z zapotrzebowaniem na zadania.
Koncepcja i struktura analizy PPI została pierwotnie opisana przez Fristona i współpracowników w 1997 roku2. Autorzy stwierdzili, że ich podejście jest ważne, ponieważ pozwoli badaniom nad łącznością być bardziej funkcjonalnymi i pozwoli na wnioskowanie, że aktywność w dystalnym ziarnie może modulować aktywność wynikającą z zapotrzebowania na zadanie. W 2012 roku McLaren i jego koledzy dodali do tego oryginalnego schematu i opisali podejście gPPI, w którym wszystkie fazy zadań i ich interakcje są zawarte w jednym modelu3. Takie podejście prowadzi do wyników, które są bardziej wrażliwe i specyficzne dla badanej fazy zadania i interakcji. To właśnie zaktualizowane podejście do gPPI stosujemy w niniejszym badaniu (patrz krok 6.2.2 w Protokole). Podejście gPPI jest obecnie cytowane w ponad 200 badaniach. Dla jasności, w dalszej części artykułu używamy terminu "PPI" do opisania wspólnych cech zarówno wersji standardowej, jak i uogólnionej. "gPPI" będzie używany do omówienia konkretnych postępów związanych z nowszymi ramami.
Ogólnym celem analizy PPI jest zrozumienie, w jaki sposób wymagania zadania poznawczego wpływają lub modulują funkcjonalną łączność regionu zalążkowego. Analiza PPI wymaga silnej hipotezy a priori. Aktywność w regionie zalążkowym musi być modulowana przez zadanie, aby podejście PPI działało skutecznie4. Na przykład w niniejszym badaniu oparliśmy naszą selekcję nasion na mocnych dowodach na to, że aktywność hipokampa jest modulowana przez wymagania poznawcze zadania pamięciowego. Za pomocą PPI można zidentyfikować regiony, które są znacznie mniej lub bardziej funkcjonalnie połączone z hipokampem podczas określonych faz zadań. Krótko mówiąc, zadajemy pytanie: "w których regionach aktywność jest bardziej skorelowana z zalążkiem w kontekście A w porównaniu z linią bazową?" Możemy również zapytać o logiczne przeciwieństwo (ponieważ ważne jest, aby zrozumieć różnicę): "w których regionach aktywność jest mniej skorelowana z zalążkiem w kontekście A w porównaniu z wartością wyjściową?" Interpretując różnice grupowe w efektach PPI, Ważne jest, aby zbadać dane i sprawdzić, czy pozytywna lub negatywna zmiana w łączności funkcjonalnej, czy też jedno i drugie, napędza różnice grupowe.
Podejście PPI zostało wykorzystane do badania dynamicznych centrów kontroli zadań u zdrowych osób z grupy kontrolnej, jak modulacja funkcjonalnej łączności jest związana z wydajnością poznawczą w chorobie Alzheimera (AD), inteligencją u osób z autyzmem, łącznością sieci motorycznej u osób z chorobą Parkinsona, przetwarzaniem twarzy u osób z dysmorfofobią ciała i anoreksją, Regulacja emocji, pamięć i wiele innych szczegółowych pytań związanych z łącznością5,6,7,8,9,10,11. W niniejszym badaniu porównujemy zmiany w funkcjonalnej łączności podregionów hipokampa podczas kodowania i odzyskiwania pamięci między grupą osób o zwiększonym ryzyku genetycznym AD z grupą bez czynnika ryzyka12. Poniżej opisano protokół, który zastosowaliśmy, stosując podejście gPPI, aby umożliwić nam sprawdzenie, czy wywołane przez zadanie zmiany w łączności funkcjonalnej różnią się w związku z obecnością APOEε4, genetycznego czynnika ryzyka AD.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Niniejsze badanie zostało przeprowadzone zgodnie z protokołami Instytucjonalnej Rady Przeglądowej (IRB) UCLA i zatwierdzone przez Komitet Ochrony Podmiotów Ludzkich UCLA. Wszyscy uczestnicy wyrazili pisemną świadomą zgodę na udział w tym badaniu.
1. Wybór uczestników
- Uzyskać zgodę IRB na przeprowadzenie badania.
- Przeprowadzić przesiewowy badanie osób w wieku 55 lat i starszych pod kątem zaburzeń poznawczych, wykorzystując zestandaryzowany zestaw testów neuropsychologicznych. Należy uwzględnić testy inteligencji ogólnej (podtesty WAIS-III)13, płynności mowy (owoce i warzywa)14, uwagi (cyfry w przód i w tył)13, języka (Boston Naming Test)15, pamięci werbalnej (Buschke-Fuld Selective Reminding Task)16, pamięci logicznej WMS-III oraz uczenia się par skojarzonych werbalnie13 oraz pamięci wizualnej (test figury Rey-Osterrietha)17.
- Poprosić uczestników o wypełnienie kwestionariuszy nastroju, takich jak skale depresji i lęku Hamiltona18,19, a także Mini Mental State Exam (MMSE)20.
- Zakwalifikować uczestników, którzy uzyskali wynik 26 lub więcej w MMSE oraz których wyniki w testach poznawczych nie są niższe niż dwa odchylenia standardowe poniżej normy dla ich grupy wiekowej. Wykluczyć uczestników z klinicznym lękiem, depresją lub jakąkolwiek inną chorobą neuropsychiatryczną lub neurologiczną. Wykluczyć uczestników, którzy nie spełniają kryteriów bezpieczeństwa MRI lub nie wyrażają zgody na pobranie krwi.
UWAGA: W niniejszym badaniu kryteria te spełniło 93 uczestników (średni wiek = 67,4 lat, 31M/49F).
2. Genotypowanie
- Pobrać krew od każdego uczestnika za pomocą wykwalifikowanego flebotomisty lub innego pracownika medycznego.
- Wyizolować 200 µg DNA genomicznego z 10 mL próbki zgodnie z opisem21.
- Przeprowadzić genotypowanie polimorfizmu pojedynczego nukleotydu (SNP) za pomocą real-time PCR w dwóch locus, rs429358 i rs7412, aby rozróżnić allele APOE22.
- Wprowadzić barwniki raportujące dla rs429358 i rs7412 do testu genotypowania SNP. Po zakończeniu każdego cyklu amplifikacji PCR nanieść sygnały fluorescencyjne na wykres przedstawiający rozkład barwników raportujących i wygaszaczy. Eksperyment wykonać w duplikacie w celu potwierdzenia wyników.
- Przeanalizować dane z genotypowania SNP przy użyciu pakietu oprogramowania opracowanego dla wyników procedury real-time PCR23.
UWAGA: Program użyty w niniejszym badaniu oblicza powinowactwo próbki do jednego z dwóch barwników raportujących, co z kolei reprezentuje jeden SNP APOE względem drugiego. W niniejszym badaniu do udziału zakwalifikowano 34 nosicieli allelu ryzyka AD, APOEε4 (heterozygoty ε3/ε4) oraz 46 osób niebędących nosicielami (homozygoty ε3/ε3), co dało łącznie 80 uczestników badania. Wykluczyć nosicieli allelu APOEε2, ponieważ istnieją dowody, że allel ten może mieć działanie ochronne w odniesieniu do AD.
3. Gromadzenie danych obrazowania funkcjonalnego i strukturalnego
- Do pozyskania danych obrazowych całego mózgu należy użyć systemu MRI 3 Tesla (3T).
- W przypadku obrazowania funkcjonalnego należy zebrać przekroje osiowe przy użyciu sekwencji obrazowania echo planarnego (EPI). Aby ułatwić rejestrację obrazów funkcjonalnych, należy pozyskać osiowe przekroje strukturalne T2-zależne, koplanarne. Do obrazowania strukturalnego o wysokiej rozdzielczości należy zebrać przekroje osiowe przy użyciu sekwencji 3D T1-zależnej.
UWAGA: W niniejszym badaniu zastosowano magnes 3T z 12-kanałową cewką głowową. Poniższe parametry zostały opracowane dla konkretnego skanera i cewki. Więcej informacji znajduje się w Tabeli materiałów.- Dane obrazowania funkcjonalnego należy pozyskać przy użyciu następujących parametrów sekwencji: czas repetycji (TR) = 2,500 ms, czas echa (TE) = 21 ms, pole widzenia (FOV) = 200 mm x 200 mm, kąt odchylenia = 75°, macierz = 64 x 64, 33 przekroje, grubość przekroju = 3 mm, przerwa między przekrojami = 0.75 mm, rozmiar woksela = 3.125 x 3.125 x 3.75 mm.
- Zadanie pamięci asocjacyjnej z niezwiązanymi słowami należy uruchomić wraz z trzecim wolumenem sekwencji obrazowania funkcjonalnego. Aby uwzględnić stan równowagi stanu ustalonego, z analiz należy wykluczyć dwa pierwsze wolumeny każdego skanowania funkcjonalnego.
UWAGA: Zadanie pamięci asocjacyjnej z niezwiązanymi słowami zostało opisane w innym opracowaniu12,24. W skrócie jest to funkcjonalne zadanie o projekcie blokowym z blokami kodowania i odzyskiwania informacji. Uczestnicy otrzymują instrukcję nauki par niezwiązanych ze sobą słów. - Dane obrazowania strukturalnego T2-zależnego, koplanarnego, należy pozyskać przy użyciu następujących parametrów sekwencji: TR = 5,000 ms, TE = 34 ms, FOV = 200 mm x 200 mm, kąt odchylenia = 90°, macierz = 128 x 128, 28 przekrojów, grubość przekroju = 3 mm, przerwa między przekrojami = 1 mm oraz rozmiar woksela = 1.56 x 1.56 x 4 mm.
- Obrazowanie strukturalne (anatomiczne) o wysokiej rozdzielczości należy pozyskać przy użyciu następujących parametrów sekwencji MPRAGE (Magnetization Prepared Rapid Gradient Echo): TR = 1,900 ms, TE = 2.26 ms, TI = 900 ms, FOV = 250 mm x 218 mm, kąt odchylenia = 9°, macierz = 256 x 215, 176 przekrojów, grubość przekroju = 1 mm, z uzupełnieniem zerami do macierzy 256 x 224, co daje rozmiar woksela = 1 x 0.976 x 0.976 mm.
- W przypadku obrazowania funkcjonalnego należy zebrać przekroje osiowe przy użyciu sekwencji obrazowania echo planarnego (EPI). Aby ułatwić rejestrację obrazów funkcjonalnych, należy pozyskać osiowe przekroje strukturalne T2-zależne, koplanarne. Do obrazowania strukturalnego o wysokiej rozdzielczości należy zebrać przekroje osiowe przy użyciu sekwencji 3D T1-zależnej.
4. Przetwarzanie wstępne danych fMRI BOLD
- Przeprowadź wstępne przetwarzanie danych funkcjonalnych przy użyciu biblioteki oprogramowania Functional MRI of the Brain (FMRIB) Software Library (FSL) w wersji 6.0 (http://fsl.fmrib.ox.ac.ul) w następujący sposób:
- Dla zbioru danych każdego uczestnika usuń artefakty ruchu głowy z danych, korzystając z narzędzia Motion Correction FMRIB's Linear Image Registration Tool (MCFLIRT)25.
- Usuń tkanki poza mózgowe z obrazów za pomocą narzędzia brain extraction tool (BET) z opcjonalną flagą -F26.
- Użyj narzędzia FSL Motion Outliers, aby zidentyfikować w danych funkcjonalnych wolumeny z nadmiernym ruchem na podstawie przesunięcia klatek pomiędzy wolumenami. Oznacz wolumeny, w których ruch został określony jako wartość odstająca (powyżej 75th percentyla + 1,5 raza zakres międzykwartylowy) w porównaniu z resztą skanu i wykorzystaj wynik tego programu do zmniejszenia wagi tych wolumenów w analizach.
UWAGA: Przed przeprowadzeniem porównań grupowych sprawdź, czy średni ruch, mierzony za pomocą FSL Motion Outliers, nie różni się między dwiema grupami. Pomoże to zapewnić, że wyniki nie wynikają z różnic w ruchu związanych z grupami.
- Skonfiguruj wstępne przetwarzanie i ogólny liniowy model (GLM) pierwszego poziomu, korzystając z graficznego interfejsu użytkownika (GUI) dla FSL fMRI Expert Analysis Tool (FEAT) dla pierwszego uczestnika.
UWAGA: Powtórz ten krok dla każdego uczestnika badania. Aby zaoszczędzić czas, po skonfigurowaniu jednego uruchomienia dla jednego uczestnika, napisz skrypt do przeprowadzenia wstępnego przetwarzania danych pozostałych uczestników badania poprzez zmodyfikowanie pliku „design.fsf” (wynik FSL FEAT) dla każdego uczestnika tak, aby odwoływał się do specyficznych danych tego uczestnika.- W zakładce danych kliknij „add 4D data” i przejdź do pliku po korekcji ruchu i ekstrakcji mózgu. Ustaw TR na 2.5 s (odpowiadające TR sekwencji funkcjonalnej). Użyj domyślnego filtra górnoprzepustowego (ustawionego na 100 s).
UWAGA: Filtrowanie górnoprzepustowe usunie sygnały o niskiej częstotliwości, które nie są przedmiotem zainteresowania. - W zakładce pre-stats kliknij „none” w sekcji „motion correction” (ponieważ zostało to już wykonane w kroku 4.1). Odznacz „BET brain extraction” (ponieważ zostało to już wykonane w kroku 4.1). Wpisz „5” w polu, aby ustawić jądro Gaussa o szerokości połówkowej pełnej szerokości (FWHM) wynoszącej 5 mm dla wygładzania przestrzennego.
UWAGA: FWHM dla jądra wygładzania powinno być zazwyczaj ustawione na około dwukrotność rozmiaru woksela skanu funkcjonalnego. - Użyj wyniku (6 kolumn, liczba wierszy = liczba TR w skanie) z MCFLIRT do utworzenia 6 jednokolumnowych plików tekstowych opisujących korekcję ruchu wykonaną dla każdego wolumenu w zbiorze danych. Zostaną one dodane do modelu jako regresory w następnym kroku.
- W zakładce stats w sekcji „full model setup” dodaj 6 parametrów ruchu oraz ich pochodne czasowe jako regresory lub zmienne objaśniające (EVs) w GLM. Dla każdego EV ruchu wybierz „custom” (1 wpis na wolumen) dla kształtu podstawowego, „none” dla splotu i zaznacz „apply temporal filtering”.
NOTE: Parametry ruchu nie muszą być splotowane z żadną funkcją, ponieważ odnoszą się do wyrównania wykonanego dla każdego wolumenu funkcjonalnego podczas korekcji ruchu, a zatem nie wymagają korekty.
- W zakładce stats w sekcji „full model setup” dodaj 6 parametrów ruchu oraz ich pochodne czasowe jako regresory lub zmienne objaśniające (EVs) w GLM. Dla każdego EV ruchu wybierz „custom” (1 wpis na wolumen) dla kształtu podstawowego, „none” dla splotu i zaznacz „apply temporal filtering”.
- W zakładce stats wybierz wynik z FSL Motion Outliers z kroku 4.1 w sekcji „add additional confound EVs”.
UWAGA: Wynik ten jest macierzą wskazującą każdy wolumen oznaczony jako nadmierny ruch; poprzez dodanie pliku zakłócającego (confound file), waga tych wolumenów w GLM zostanie zmniejszona. - W zakładce stats kliknij „full model set-up”. Utwórz pliki tekstowe z czasem trwania zadania, określające początek i koniec różnych faz zadania, i dodaj je jako EVs w GLM, wybierając format 1 kolumny i wskazując odpowiedni plik tekstowy (dołącz jeden dla fazy kodowania zadania i jeden dla fazy wydobywania). Dla „convolution” wybierz opcję „double-gamma HRF” z listy rozwijanej dla obu plików. Nie modeluj w GLM linii bazowej ani nieaktywnych części zadania.
UWAGA: HRF oznacza funkcję odpowiedzi hemodynamicznej. Splotowanie EV zadania z HRF przesuwa czas trwania EV zadania tak, aby był on bardziej zgodny z oczekiwanymi zmianami sygnału BOLD indukowanymi zadaniem w mózgu. - W zakładce registration zaznacz „expanded functional image” oraz „main structural image” dla rejestracji dwuetapowej.
- W pierwszym kroku, w którym dane funkcjonalne są rejestrowane do koplanarnych danych strukturalnych, wybierz koplanarny skan strukturalny ważony T2 uczestnika. Wybierz 6 stopni swobody (DOF) dla tego kroku, klikając drugie pole rozwijane pod tym krokiem i wybierając „6 DOF”.
- W następnym kroku, w którym obraz ważony T2 jest rejestrowany do obrazu MPRAGE ważonego T1 o wysokiej rozdzielczości, wybierz rejestrację opartą na granicach (BBR) z pola rozwijanego27.
UWAGA: BBR wykorzystuje różnice w intensywności między istotą białą a szarą do rejestracji skanów strukturalnych i funkcjonalnych i wykazano, że działa lepiej niż FLIRT i inne alternatywne metody. - W ostatnim kroku, w którym strukturalne dane o wysokiej rozdzielczości są rejestrowane do standardowego szablonu MNI152, wybierz 12 stopni swobody i transformację liniową, wybierając „12 DOF”.
UWAGA: Po zakończeniu wszystkich kroków w sekcji 4 dane funkcjonalne są wstępnie przetworzone i gotowe do dalszej analizy.
- W zakładce danych kliknij „add 4D data” i przejdź do pliku po korekcji ruchu i ekstrakcji mózgu. Ustaw TR na 2.5 s (odpowiadające TR sekwencji funkcjonalnej). Użyj domyślnego filtra górnoprzepustowego (ustawionego na 100 s).
5. Ziarna hipokampa
- Wygeneruj maskę lewego hipokampa w przestrzeni strukturalnej o wysokiej rozdzielczości dla każdego uczestnika, korzystając z algorytmu segmentacji FMRIB Integrated Registration and Segmentation Tool (FIRST) pakietu FSL28.
UWAGA: Inne regiony, w tym prawy hipokamp, stanowiłyby interesujące i poprawne ziarna (seeds) do dalszych analiz. - Używając platformy oprogramowania statystycznego, napisz kod do obliczenia długości przedniej i tylnej jednej trzeciej struktury29. W szczególności wykorzystaj długość wolumetrycznej maski hipokampa w płaszczyźnie przednio-tylnej, aby wyznaczyć współrzędne wyznaczające przednią i tylną jedną trzecią tej płaszczyzny.
UWAGA: Niedawno opublikowana metoda segmentacji hipokampa wzdłuż osi podłużnej może stanowić alternatywne podejście do tworzenia ziaren30. - Na podstawie tych współrzędnych utwórz obrazy maski przedniej i tylnej części hipokampa. Zarejestruj maski przedniej i tylnej części hipokampa w natywnej przestrzeni funkcjonalnej, używając macierzy "example_func2highres" z katalogu rejestracji wyników FEAT.
UWAGA: Wykorzystanie przedniej i tylnej jednej trzeciej zapobiegło rozmyciu sygnału między dwoma ziarnami hipokampa po rejestracji w przestrzeni funkcjonalnej. Istnieją dowody na specjalizację funkcjonalną wzdłuż osi podłużnej hipokampa31,32,33,34. Regiony przednie są obszarami wejściowymi i wiążą się z kodowaniem, podczas gdy tylna część hipokampa jest obszarem wyjściowym związanym z wydobywaniem i konsolidacją pamięci35,36,37. W związku z tym wykorzystanie tych regionów pozwala na ocenę zaangażowania funkcjonalnego przedniej i tylnej części hipokampa w fazach kodowania i wydobywania w zadaniu pamięciowym. - Użyj narzędzia FSL mean timeseries (fslmeants), aby wyekstrahować odszumione średnie szeregi czasowe z przedniego i tylnego ziarna hipokampa (Rycina 1). Postępuj zgodnie z instrukcjami programu i użyj przedniego lub tylnego ziarna hipokampa jako maski oraz odszumionych, wstępnie przetworzonych danych funkcjonalnych jako obrazu głównego.
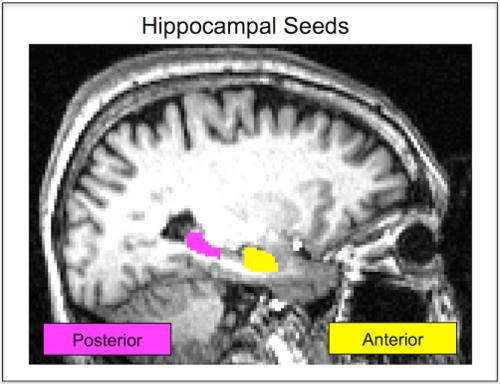
Rysunek 1: Obszary nasienne hipokampa. W przestrzeni natywnej żółtym kolorem zaznaczono obszar nasienny przedniej części hipokampa jednego uczestnika. Różowym kolorem zaznaczono obszar nasienny tylnej części hipokampa tego samego uczestnika. Obszary nasienne są definiowane na indywidualnym obrazie strukturalnym każdego uczestnika, a następnie rejestrowane do jego skanu funkcjonalnego. Obszary nasienne nigdy nie znajdują się w przestrzeni standaryzowanej, co zwiększa dokładność segmentacji hipokampa. Rysunek przedrukowano za zgodą12. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
6. Model PPI
- Użyj interfejsu GUI dla FSL FEAT, aby załadować wstępnie przetworzone dane funkcjonalne.
- W karcie data wybierz odszumiony obraz "filtered_func_data" (wynik kroków wykonanych w sekcji 4) jako plik wejściowy. W karcie pre-stats ustaw korekcję ruchu (motion correction) oraz ekstrakcję mózgu (brain extraction) na "none." Odznacz pola dotyczące filtrowania czasowego (temporal filtering) i wygładzania przestrzennego (spatial smoothing).
- Konfiguracja modelu PPI (Tabela 1).
- W karcie stats wybierz "full model set-up". W karcie EVs dodaj wszystkie zmienne objaśniające (EVs) z modelu pierwszego poziomu: 6 EVs korekcji ruchu, macierz EV zakłócających z FSL Motion Outliers oraz EVs czasu trwania zadań. Kliknij strzałkę w górę, aby dodać EVs. Do modelu dołącz, klikając strzałkę w górę, EV dla przebiegu fizjologicznego z obszaru seed (plik tekstowy będący wynikiem fslmeants w kroku 5.4) jako kowariancję nieistotną.
- Utwórz człony PPI.
- W menu basic shape wybierz "interaction" i zaznacz EV przebiegu czasowego seed oraz jedno EV zadania. Dla opcji "make zero" wybierz "mean" dla EV przebiegu czasowego seed oraz "centre" dla EV zadania. Powtórz tę procedurę dla pozostałych faz zadania. Uruchom osobny model dla każdego obszaru seed.
UWAGA: Te nowe EVs są członami PPI dla wybranej fazy zadania (psycho) i obszaru seed (physio). W niniejszym badaniu w każdym modelu PPI uwzględniono człon PPI dla fazy kodowania oraz drugi człon PPI dla fazy przypominania. Opcja "centre" zapewnia, że fazy "on" i "off" w zadaniu o projekcie blokowym są traktowane równorzędnie. Opcję "mean" stosuje się zawsze do przebiegu czasowego seed, co skutkuje odjęciem średniej od tego regresora.
- W menu basic shape wybierz "interaction" i zaznacz EV przebiegu czasowego seed oraz jedno EV zadania. Dla opcji "make zero" wybierz "mean" dla EV przebiegu czasowego seed oraz "centre" dla EV zadania. Powtórz tę procedurę dla pozostałych faz zadania. Uruchom osobny model dla każdego obszaru seed.
- W karcie contrasts and F-tests zmodeluj następujące specyficzne efekty, wpisując "1" w odpowiedniej komórce EV: psych_enc (faza kodowania zadania), psych_ret (faza przypominania zadania), phys (przebieg czasowy seed), PPI_enc (PPI seed i kodowania), PPI_ret (PPI seed i przypominania). Na koniec wpisz "-1", aby zmodelować negatywne PPI dla każdej fazy zadania.
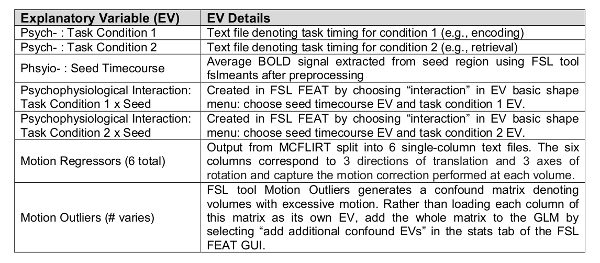
Tabela 1: Konfiguracja modelu gPPI.
7. Porównania grup
- W programie FSL FEAT wybierz opcję "higher-level analysis", aby uruchomić prosty model grupowy porównujący nosicieli APOEε4 z osobami niebędącymi nosicielami dla każdej kombinacji zadania i ziarna (seed).
UWAGA: Porównania te są przeprowadzane w celu wygenerowania odpowiednich grupowych 4D obrazów rezyduów ("res4d"), które są niezbędne do oszacowania wygładzenia (smoothness) zbioru danych. Statystycznie istotne wyniki z tego porównania grupowego są poprawne, jednak w poniższych krokach opisano inną metodę ustalania progów z wykorzystaniem AFNI i SPM8 w celu wyznaczenia minimalnej wielkości istotnego klastra na podstawie symulacji Monte Carlo. - Użyj programu Analysis of Functional Neuroimaging (AFNI)
- Użyj narzędzia 3dFWHMx programu AFNI (dowolna wersja po grudniu 2015 r.) w wierszu poleceń, aby oszacować wygładzenie grupowych 4D obrazów rezyduów wygenerowanych za pomocą FSL.
UWAGA: W narzędziu 3dClustSim programu AFNI wykryto błąd, który został naprawiony w maju 2015 r. W grudniu 2015 r. zaktualizowano narzędzie 3dFWHMx programu AFNI, aby dokładniej modelować autokorelacje. W związku z tym należy używać wersji tych narzędzi wydanych w grudniu 2015 r. lub później. - Użyj narzędzia 3dClustSim programu AFNI (dowolna wersja po grudniu 2015 r.), aby określić minimalny rozmiar klastra osiągający istotność przy różnych progach na poziomie woksela. W wywołaniu 3dClustSim w wierszu poleceń uwzględnij oszacowania wygładzenia z poprzedniego kroku. Z tabeli wygenerowanej przez 3dClustSim, w oparciu o hipotezy badania dotyczące oczekiwanej wysokości i rozległości efektów, wybierz próg na poziomie woksela oraz odpowiadający mu minimalny rozmiar klastra.
UWAGA: Generalnie większe klastry minimalizują liczbę wyników fałszywie dodatnich.
- Użyj narzędzia 3dFWHMx programu AFNI (dowolna wersja po grudniu 2015 r.) w wierszu poleceń, aby oszacować wygładzenie grupowych 4D obrazów rezyduów wygenerowanych za pomocą FSL.
- Użyj programu Statistical Parametric Mapping (SPM8)
- W interfejsie graficznym SPM8 wybierz "specify 2nd-level". Otworzy się edytor wsadowy (batch editor). W sekcji design wybierz "two sample t-test". Przejdź do katalogu z obrazami oszacowań parametrów dla grupy 1 (nosiciele APOEε4) i zaznacz je, klikając na nie. Następnie dodaj obrazy dla grupy 2 (osoby niebędące nosicielami APOEε4). Uruchom to porównanie, klikając zielony przycisk odtwarzania.
- Wróć do interfejsu SPM, wybierz "estimate" i przejdź do pliku SPM.mat utworzonego w poprzednim kroku, aby uruchomić proces estymacji modelu.
- Wybierz "results" i przeprowadź kontrasty porównania grupowego: nosiciele APOEε4 > osoby niebędące nosicielami APOEε4 oraz osoby niebędące nosicielami APOEε4 > nosiciele APOEε4.
- Kliknij "define a new contrast", w polu "type" wybierz "T-contrast" i wprowadź "1 -1" w polu "contrast" dla porównania nosiciele APOEε4 > osoby niebędące nosicielami APOEε4. Kliknij "done". W opcji Apply Masking wybierz "none" i ręcznie ustaw próg na poziomie woksela oraz minimalny rozmiar klastra zgodnie z ustaleniami z kroku 7.2.2. Wprowadź "-1 1" dla porównania osoby niebędące nosicielami APOEε4 > nosiciele APOEε4.
Uwaga: W niniejszym badaniu zastosowano próg wokselowy p <0.005, a klastry ograniczono progiem alpha <0.05.
- Kliknij "define a new contrast", w polu "type" wybierz "T-contrast" i wprowadź "1 -1" w polu "contrast" dla porównania nosiciele APOEε4 > osoby niebędące nosicielami APOEε4. Kliknij "done". W opcji Apply Masking wybierz "none" i ręcznie ustaw próg na poziomie woksela oraz minimalny rozmiar klastra zgodnie z ustaleniami z kroku 7.2.2. Wprowadź "-1 1" dla porównania osoby niebędące nosicielami APOEε4 > nosiciele APOEε4.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Przy dwóch różnych aktywnych fazach zadania (kodowanie i wydobywanie) oraz dwóch regionach ziarnowych (przednia i tylna część hipokampa) istnieją cztery warunki, dla których należy zaraportować wyniki dla każdej grupy. Mapy aktywacji zadania w obrębie grup (nie przedstawiono ich tutaj, patrz Harrison et al., 201612) wykazują, że płat potyliczny, kora słuchowa, rozległe obszary płata ciemieniowego, czołowe ośrodki językowe, górny zakręt skroniowy oraz jądro...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Wczesne badania fMRI oparte na zadaniach miały na celu odkrycie statystycznych zależności między określonymi procesami poznawczymi lub wymaganiami a zmianami sygnału BOLD w stosunku do pomiaru podstawowego. To tradycyjne podejście jest przydatne do identyfikacji określonych regionów mózgu, w których aktywność jest modulowana przez zadanie eksperymentalne. W przeciwieństwie do tego, analiza PPI dotyczy głównie modulacji funkcjonalnej łączności lub synchronizacji aktywności, która wynika z procesu poznawczego wywołanego za...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
DGM jest pracownikiem firmy Biospective, Inc. Biospective, Inc. nie przetwarzała żadnych z prezentowanych danych.
Podziękowania
Ta praca była wspierana przez National Institute of Aging (grant numer R01AG013308 dla SYB, F31AG047041 dla TMH). Autorzy korzystali z usług obliczeniowych i pamięci masowej związanych z klastrem Hoffman2 Shared Cluster dostarczanym przez UCLA Institute for Digital Research and Education's Research Technology Group.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Skaner rezonansu monetycznego 3T | Siemens Medical Solutions | MAGNETOM Trio, A Tim System | Skaner MRI 3T |
| FSL (biblioteka oprogramowania FMRIB) | Uniwersytet Oksfordzki | w wersji 6.0 | Oprogramowanie do funkcjonalnego przetwarzania obrazowania |
| AFNI (Analiza funkcjonalnego neuroobrazowania) | National Institute of Mental Health, National Institutes of Health | Dowolna wersja po maju 2015 | r.Oprogramowanie do funkcjonalnego przetwarzania obrazowania |
| SPM8 (statystyczne mapowanie parametryczne) | University College of London | SPM8 | Oprogramowanie do funkcjonalnego przetwarzania obrazowania Oprogramowanie |
| Matlab | Mathworks, Inc | Wersja R2012a | Oprogramowanie komputerowe |
| Oprogramowanie SDS | Applied Biosystems, Inc | 7900HT Szybki system PCR | czasie rzeczywistym PCR w czasie rzeczywistym |
| Testy Taqmana | ThermoFisher Naukowe | specyficzne dla | SNP Genotypowanie SNP |
Bibliografia
- Sporns, O., Tononi, G., Kötter, R. The Human Connectome: A Structural Description of the Human Brain. PLoS Comput Biol. 1 (4), 42(2005).
- Friston, K. J., Buechel, C., Fink, G. R., Morris, J., Rolls, E., Dolan, R. J. Psychophysiological and modulatory interactions in neuroimaging. NeuroImage. 6 (3), 218-229 (1997).
- McLaren, D. G., Ries, M. L., Xu, G., Johnson, S. C. A generalized form of context-dependent psychophysiological interactions (gPPI): a comparison to standard approaches. NeuroImage. 61 (4), 1277-1286 (2012).
- O'Reilly, J. X., Woolrich, M. W., Behrens, T. E. J., Smith, S. M., Johansen-Berg, H. Tools of the trade: psychophysiological interactions and functional connectivity. Soc Cogn Affect Neurosci. 7 (5), 604-609 (2012).
- Moody, T. D., Sasaki, M. A., et al. Functional connectivity for face processing in individuals with body dysmorphic disorder and anorexia nervosa. Psychol Med. 45 (16), 3491-3503 (2015).
- Simard, I., Luck, D., Mottron, L., Zeffiro, T. A., Soulières, I. Autistic fluid intelligence: Increased reliance on visual functional connectivity with diminished modulation of coupling by task difficulty. NeuroImage Clin. 9, 467-478 (2015).
- Yan, L. -R., Wu, Y. -B., Zeng, X. -H., Gao, L. -C. Dysfunctional putamen modulation during bimanual finger-to-thumb movement in patients with Parkinson's disease. Front Hum Neurosci. 9, 516(2015).
- Cole, M. W., Reynolds, J. R., Power, J. D., Repovs, G., Anticevic, A., Braver, T. S. Multi-task connectivity reveals flexible hubs for adaptive task control. Nat Neurosci. 16 (9), 1348-1355 (2013).
- McLaren, D. G., Sperling, R. A., Atri, A. Flexible modulation of network connectivity related to cognition in Alzheimer's disease. NeuroImage. 100, 544-557 (2014).
- Morawetz, C., Bode, S., Baudewig, J., Heekeren, H. R. Effective amygdala-prefrontal connectivity predicts individual differences in successful emotion regulation. Soc Cogn Affect Neurosci. , 169(2016).
- Takashima, A., Bakker, I., van Hell, J. G., Janzen, G., McQueen, J. M. Richness of information about novel words influences how episodic and semantic memory networks interact during lexicalization. NeuroImage. 84, 265-278 (2014).
- Harrison, T. M., Burggren, A. C., Small, G. W., Bookheimer, S. Y. Altered memory-related functional connectivity of the anterior and posterior hippocampus in older adults at increased genetic risk for Alzheimer's disease. Hum Brain Mapp. 37 (1), 366-380 (2016).
- Wechsler, D. Wecshler Adult Intelligence Scale, 3rd Edition. , Harcourt Assessement. San Antonio, TX. (1997).
- Cauthen, N. R. Verbal fluency: normative data. J Clin Psychol. 34 (1), 126-129 (1978).
- Goodglass, H. P., Kaplan, E. P. Boston Naming Test, 3rd Edition. , (2001).
- Buschke, H., Fuld, P. A. Evaluating storage, retention, and retrieval in disordered memory and learning. Neurol. 24 (11), 1019-1025 (1974).
- Osterrieth, P. A. Le test de copie d'une figure complex: Contribution à l'étude de la perception et de la memoir. Archives de Psychologie. 30, 286-356 (1944).
- Hamilton, M. The assessment of anxiey states by rating. Br J Med Psychol. 32, (August) 50-55 (1959).
- Hamilton, M. A rating scale for depression. J Neurol Neurosurg Psychiatry. 23, 56-62 (1960).
- Folstein, M. F., Robins, L. N., Helzer, J. E. The Mini-Mental State Examination. Arch Gen Psychiatry. 40 (7), 812(1983).
- O'Brien, D., Campbell, K. A., Morken, N. W., Bair, R. J., Heath, E. M. Automated Nucleic Acid Purification for Large Samples. J Lab Autom. 6 (2), 67-70 (2001).
- Lehmann, M., Ghosh, P. M., et al. Greater medial temporal hypometabolism and lower cortical amyloid burden in ApoE4-positive AD patients. J Neurol Neurosurg Psychiatry. 85 (3), 266-273 (2014).
- TaqMan® SNP Genotyping Assays User Guide. , Thermo Fisher Scientific. Available from: https://tools.thermofisher.com/content/sfs/manuals/TaqMan_SNP_Genotyping_Assays_man.pdf (2014).
- Bookheimer, S. Y., Strojwas, M. H., et al. Patterns of brain activation in people at risk for Alzheimer's disease. N Engl J Med. 343 (7), 450-456 (2000).
- Jenkinson, M., Bannister, P., Brady, M., Smith, S. Improved optimization for the robust and accurate linear registration and motion correction of brain images. NeuroImage. 17 (2), 825-841 (2002).
- Smith, S. M. Fast robust automated brain extraction. Hum Brain Mapp. 17 (3), 143-155 (2002).
- Greve, D. N., Fischl, B. Accurate and robust brain image alignment using boundary-based registration. NeuroImage. 48 (1), 63-72 (2009).
- Patenaude, B., Smith, S. M., Kennedy, D. N., Jenkinson, M. A Bayesian model of shape and appearance for subcortical brain segmentation. NeuroImage. 56 (3), 907-922 (2011).
- Learn MATLAB Basics. , Available from: https://www.mathworks.com/support/learn-with-matlab-tutorials.html?s_tid=hp_ff_I_tutorials (2017).
- Lerma-Usabiaga, G., Iglesias, J. E., Insausti, R., Greve, D. N., Paz-Alonso, P. M. Automated segmentation of the human hippocampus along its longitudinal axis. Hum Brain Mapp. 37 (9), 3353-3367 (2016).
- Salami, A., Eriksson, J., Nyberg, L. Opposing effects of aging on large-scale brain systems for memory encoding and cognitive control. J Neurosci. 32 (31), 10749-10757 (2012).
- Schacter, D. L., Wagner, A. D. Medial temporal lobe activations in fMRI and PET studies of episodic encoding and retrieval. Hippocampus. 9 (1), 7-24 (1999).
- Strange, B., Dolan, R. Functional segregation within the human hippocampus. Mol Psychiatry. 4 (6), 508-511 (1999).
- Strange, B. A., Fletcher, P. C., Henson, R. N., Friston, K. J., Dolan, R. J. Segregating the functions of human hippocampus. Proc Natl Acad Sci U S A. 96 (7), 4034-4039 (1999).
- Eldridge, L. L., Engel, S. A., Zeineh, M. M., Bookheimer, S. Y., Knowlton, B. J. A dissociation of encoding and retrieval processes in the human hippocampus. J Neurosci. 25 (13), 3280-3286 (2005).
- Strange, B. A., Witter, M. P., Lein, E. S., Moser, E. I. Functional organization of the hippocampal longitudinal axis. Nat Rev Neurosci. 15 (10), 655-669 (2014).
- Zeineh, M. M., Engel, S. A., Thompson, P. M., Bookheimer, S. Y. Dynamics of the hippocampus during encoding and retrieval of face-name pairs. Science. 299 (5606), 577-580 (2003).
- Nieuwenhuis, S., Forstmann, B. U., Wagenmakers, E. -J. Erroneous analyses of interactions in neuroscience: a problem of significance. Nat Neurosci. 14 (9), 1105-1107 (2011).
- Cisler, J. M., Bush, K., Steele, J. S. A comparison of statistical methods for detecting context-modulated functional connectivity in fMRI. NeuroImage. 84, 1042-1052 (2014).
- Friston, K. J., Harrison, L., Penny, W. Dynamic causal modelling. NeuroImage. 19 (4), 1273-1302 (2003).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
