Neuronalne korelaty słuchania interwałów spółgłoskowych i dysonansowych były szeroko badane, ale mechanizmy neuronalne związane z wytwarzaniem interwałów spółgłoskowych i dysonansowych są mniej znane. W tym artykule testy behawioralne i fMRI są połączone z zadaniami identyfikacji interwałowej i śpiewania, aby opisać te mechanizmy.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Mapowanie fMRI aktywności mózgu związanej z wytwarzaniem wokalnym interwałów spółgłoskowych i dysonansowych
W tym artykule
Podsumowanie
Streszczenie
Neuronalne korelaty współbrzmienia i percepcji dysonansu były szeroko badane, ale nie neuronalne korelaty współbrzmienia i produkcji dysonansów. Najprostszym sposobem produkcji muzycznej jest śpiewanie, ale z perspektywy obrazowania nadal stanowi więcej wyzwań niż słuchanie, ponieważ wiąże się z aktywnością motoryczną. Dokładne śpiewanie interwałów muzycznych wymaga integracji przetwarzania słuchowego sprzężenia zwrotnego i kontroli motorycznej głosu w celu prawidłowego wydobycia każdej nuty. Protokół ten przedstawia metodę, która pozwala na monitorowanie aktywacji neuronalnych związanych z wokalną produkcją interwałów spółgłoskowych i dysonansowych. Cztery interwały muzyczne, dwa spółgłoskowe i dwa dysonansowe, są używane jako bodźce, zarówno do testu dyskryminacji słuchowej, jak i zadania, które polega najpierw na słuchaniu, a następnie odtwarzaniu danych interwałów. Uczestniczki, wszystkie studentki śpiewu na poziomie konserwatorium, były badane za pomocą funkcjonalnego rezonansu magnetycznego (fMRI) podczas wykonywania zadania śpiewania, przy czym zadanie słuchania służyło jako warunek kontrolny. W ten sposób obserwowano aktywność zarówno układu motorycznego, jak i słuchowego, a także uzyskano miarę dokładności głosu podczas zadania śpiewania. W ten sposób protokół może być również używany do śledzenia aktywacji związanych ze śpiewaniem różnych rodzajów interwałów lub z dokładniejszym śpiewaniem wymaganych nut. Wyniki wskazują, że śpiewanie interwałów dysonansowych wymaga większego udziału mechanizmów neuronalnych odpowiedzialnych za integrację zewnętrznych informacji zwrotnych z układu słuchowego i sensomotorycznego niż śpiewanie interwałów spółgłoskowych.
Wprowadzenie
Pewne kombinacje dźwięków muzycznych są ogólnie uznawane za spółgłoskowe i zazwyczaj kojarzą się z przyjemnym uczuciem. Inne kombinacje są ogólnie określane jako dysonansowe i kojarzą się z nieprzyjemnym lub nierozwiązanym uczuciem1. Chociaż wydaje się rozsądne założenie, że enkulturacja i trening odgrywają pewną rolę w postrzeganiu współbrzmienia2, ostatnio wykazano, że różnice w postrzeganiu interwałów i akordów spółgłoskowych i dysonansowych prawdopodobnie zależą od kultury muzycznej w mniejszym stopniu, niż wcześniej sądzono3 i mogą nawet wywodzić się z prostych podstaw biologicznych4, 5,6. Aby zapobiec niejednoznacznemu rozumieniu terminu współbrzmienie, Terhardt7 wprowadził pojęcie współbrzmienia sensorycznego, w przeciwieństwie do współbrzmienia w kontekście muzycznym, gdzie harmonia, na przykład, może wpływać na reakcję na dany akord lub interwał. W obecnym protokole tylko izolowane, dwunutowe interwały zostały użyte właśnie do wyodrębnienia aktywacji związanych wyłącznie ze współbrzmieniem sensorycznym, bez zakłóceń ze strony przetwarzania zależnego od kontekstu8.
Próby scharakteryzowania współbrzmienia za pomocą czysto fizycznych środków rozpoczęły się od Helmholtz9, który przypisał postrzeganą chropowatość związaną z dysonansowymi akordami dudnieniu między sąsiednimi składnikami częstotliwości. Ostatnio jednak wykazano, że współbrzmienie sensoryczne wiąże się nie tylko z brakiem szorstkości, ale także z harmonijnością, czyli wyrównaniem części danego tonu lub akordu z częściami niesłyszanego tonu o niższej częstotliwości10,11. Badania behawioralne potwierdzają, że na subiektywne współbrzmienie rzeczywiście wpływają parametry czysto fizyczne, takie jak odległość częstotliwości12,13, ale szerszy zakres badań jednoznacznie wykazał, że zjawiska fizyczne nie mogą wyłącznie wyjaśniać różnic między postrzeganą współbrzmieniem a dysonansem14,15,16,17. Wszystkie te badania wykazują jednak te różnice podczas słuchania różnych interwałów lub akordów. Różnorodne badania z wykorzystaniem pozytonowej tomografii emisyjnej (PET) i funkcjonalnego rezonansu magnetycznego (fMRI) wykazały znaczące różnice w obszarach kory mózgowej, które stają się aktywne podczas słuchania interwałów i akordów spółgłoskowych lub dysonansowych8,18,19,20. Celem niniejszego badania jest zbadanie różnic w aktywności mózgu podczas wytwarzania, a nie słuchania, interwałów spółgłoskowych i dysonansowych.
Badanie kontroli sensoryczno-motorycznej podczas produkcji muzycznej zazwyczaj obejmuje użycie instrumentów muzycznych, a bardzo często wymaga produkcji instrumentów zmodyfikowanych specjalnie do ich użytku podczas neuroobrazowania21. Wydaje się jednak, że śpiew od początku dostarcza odpowiedniego mechanizmu do analizy procesów sensomotorycznych podczas produkcji muzycznej, ponieważ instrumentem jest sam ludzki głos, a aparat głosowy nie wymaga żadnej modyfikacji, aby był odpowiedni podczas obrazowania22. Chociaż mechanizmy neuronalne związane z aspektami śpiewania, takie jak kontrola wysokości dźwięku23, naśladownictwo głosu24, zmiany adaptacyjne wywołane treningiem25 oraz integracja zewnętrznego sprzężenia zwrotnego25,26,27,28,29, były przedmiotem wielu badań w ciągu ostatnich dwóch dekad, neuronalne korelaty śpiewania spółgłosek i dysonansów zostały opisane dopiero niedawno30. W tym celu w niniejszym artykule opisano test behawioralny mający na celu ustalenie odpowiedniego rozpoznawania interwałów spółgłoskowych i dysonansowych przez uczestników. Następnie przeprowadza się badanie fMRI uczestników śpiewających różne interwały spółgłoskowe i dysonansowe. Protokół fMRI jest stosunkowo prosty, ale, podobnie jak w przypadku wszystkich badań MRI, należy zachować dużą ostrożność, aby prawidłowo skonfigurować eksperymenty. W tym przypadku szczególnie ważne jest zminimalizowanie ruchów głowy, ust i warg podczas wykonywania zadań związanych ze śpiewaniem, dzięki czemu identyfikacja efektów niezwiązanych bezpośrednio z fizycznym aktem śpiewania jest łatwiejsza. Metodologia ta może być wykorzystana do zbadania mechanizmów neuronalnych związanych z różnorodnymi czynnościami związanymi z produkcją muzyczną poprzez śpiew.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Protokół ten został zatwierdzony przez Komitet ds. Badań, Etyki i Bezpieczeństwa szpitala Hospital Infantil de México "Federico Gómez".
1. Behawioralny test wstępny
- Przeprowadź standardowe audiometryczne badanie czystym tonem, aby potwierdzić, że wszyscy potencjalni uczestnicy mają prawidłowy słuch (próg słyszenia 20 dB HL dla częstotliwości oktawowych od 8 00 Hz). Wykorzystaj Kwestionariusz Lateralizacji Edinburgh Handedness Inventory31, aby upewnić się, że wszyscy uczestnicy są praworęczni.
- Generowanie sekwencji interwałów.
- Wygeneruj czyste tony obejmujące dwie oktawy, G4-G6, korzystając z programu do edycji dźwięku.
UWAGA: W tym przypadku opisano darmowe oprogramowanie open-source do edycji dźwięku Audacity. Do tego celu można użyć innych pakietów.- Dla każdego tonu otwórz nowy projekt w oprogramowaniu do edycji dźwięku.
- W menu „Generate” wybierz „Tone”. W wyświetlanym oknie wybierz przebieg sinusoidalny, amplitudę 0,8 oraz czas trwania 1 s. Wprowadź wartość częstotliwości odpowiadającą żądanemu dźwiękowi (np. 40 Hz dla A4). Kliknij przycisk „OK”.
- W menu „File” wybierz „Export Audio”. W otwartym oknie wpisz żądaną nazwę pliku audio i wybierz WAV jako żądany typ pliku. Kliknij „Save”.
- Wybierz dwa interwały konsonansowe i dwa dysonansowe zgodnie z Tabelą 1, w taki sposób, aby każdy interwał konsonansowy znajdował się blisko interwału dysonansowego.
UWAGA: Jako przykład rozważ interwały konsonansowe takie jak kwinta czysta i oktawa oraz interwały dysonansowe takie jak kwarta zwiększona (tryton) i septyma wielka. Są to interwały wybrane do badania przeprowadzonego przez autorów. - Wygeneruj wszystkie możliwe kombinacje dźwięków odpowiadających tym czterem interwałom w zakresie od G4 do G6.
- Dla każdego interwału otwórz nowy projekt w oprogramowaniu do edycji dźwięku i użyj funkcji „Import Audio” w menu „File”, aby zaimportować dwa pliki WAV, które zostaną ze sobą połączone.
- Ustaw kursor w dowolnym punkcie nad drugim tonem i kliknij, aby go zaznaczyć. Kliknij „Select All” w menu „Edit”. W tym samym menu kliknij „Copy”.
- Ustaw kursor w dowolnym punkcie nad pierwszym tonem i kliknij. W menu „Edit” kliknij „Move Cursor to Track End”, a następnie kliknij „Paste” w tym samym menu. Eksportuj dźwięk zgodnie z opisem w kroku 1.2.1.3.
- Użyj generatora sekwencji losowych do stworzenia sekwencji składających się ze 100 interwałów wygenerowanych pseudolosowo w taki sposób, aby każdy z czterech różnych interwałów wystąpił dokładnie 25 razy30. W tym celu użyj funkcji losowej permutacji w oprogramowaniu do analizy statystycznej (patrz Tabela Materiałów). Wprowadź cztery interwały jako argumenty i stwórz pętlę, która powtórzy ten proces 25 razy.
- Użyj oprogramowania do badań behawioralnych, aby wygenerować dwa oddzielne przebiegi. Załaduj sekwencję 100 interwałów w formacie WAV dla każdego przebiegu i przypisz identyfikację każdego interwału do pojedynczej próby30.
UWAGA: W tym przypadku użyte zostało oprogramowanie do badań behawioralnych E-Prime. Można użyć innego równoważnego oprogramowania do badań behawioralnych.
- Wygeneruj czyste tony obejmujące dwie oktawy, G4-G6, korzystając z programu do edycji dźwięku.
- Wyjaśnij uczestnikom, że wysłuchają dwóch sekwencji po 10 interwałów każda, gdzie każda sekwencja jest powiązana z innym zadaniem i własnym zestawem instrukcji. Poinformuj uczestników, że w obu przebiegach kolejny interwał zostanie odtworzony dopiero po naciśnięciu odpowiedniego klawisza.
UWAGA: Po rozpoczęciu sekwencji rozpoznawania interwałów nie należy jej przerywać, aby przebieg działań był dla wszystkich uczestników jak najjaśniejszy.- Poproś uczestników, aby usiedli przed laptopem i założyli dostarczone słuchawki. Użyj wysokiej jakości słuchawek wokółusznych. Dostosuj poziom głośności do poziomu komfortowego dla każdego badanego.
- W przypadku korzystania z opisanego tutaj oprogramowania do badań behawioralnych, otwórz zadania utworzone w kroku 1.2.5 za pomocą E-Run. W wyświetlanym oknie wprowadź numer sesji i uczestnika, a następnie kliknij „OK”. Użyj numeru sesji, aby odróżnić przebiegi dla każdego uczestnika.
UWAGA: Instrukcje do aktualnego zadania pojawią się na ekranie, a następnie rozpocznie się samo zadanie.- Najpierw, w zadaniu z wymuszonym wyborem z dwóch alternatyw (2-AFC), poproś uczestników o zidentyfikowanie, czy słyszane interwały są konsonansowe czy dysonansowe. Uczestnik powinien nacisnąć klawisz „C” na klawiaturze komputera dla interwałów konsonansowych i „D” dla dysonansowych.
UWAGA: Ponieważ od wszystkich uczestników oczekuje się wykształcenia muzycznego na poziomie konserwatorium, wszyscy powinni być w stanie odróżnić ewidentnie konsonansowe od ewidentnie dysonansowych interwałów. Pierwsze zadanie służy w pewnym sensie jako potwierdzenie, że rzeczywiście tak jest. - Następnie, w zadaniu z wymuszonym wyborem z czterech alternatyw (4-AFC), poproś uczestników o zidentyfikowanie samych interwałów. Uczestnicy powinni naciskać cyfry „4”, „5”, „7” i „8” na klawiaturze komputera, aby zidentyfikować odpowiednio interwały: kwartę zwiększoną, kwintę czystą, septymę wielką i oktawę.
- Najpierw, w zadaniu z wymuszonym wyborem z dwóch alternatyw (2-AFC), poproś uczestników o zidentyfikowanie, czy słyszane interwały są konsonansowe czy dysonansowe. Uczestnik powinien nacisnąć klawisz „C” na klawiaturze komputera dla interwałów konsonansowych i „D” dla dysonansowych.
- Na koniec każdego zadania naciśnij „OK”, aby automatycznie zapisać wyniki dla każdego uczestnika w oddzielnym pliku E-DataAid 2.0 z oznaczeniem numeru uczestnika i sesji oraz rozszerzeniem .edat2.
- Użyj oprogramowania do analizy statystycznej (np. Matlab, SPSS Statistics lub alternatywy open-source), aby obliczyć wskaźniki sukcesu dla każdego zadania (tzn. procent poprawnych odpowiedzi przy identyfikacji, czy interwały były konsonansowe czy dysonansowe, a także przy identyfikacji samych interwałów), zarówno indywidualnie, jak i dla całej grupy32.
2. Eksperyment fMRI
- Przygotowanie do sesji fMRI.
- Wygeneruj sekwencje o tych samych interwałach, co w kroku 1.2.3, ponownie składające się z dwóch następujących po sobie czystych tonów o czasie trwania 1 s każdy.
UWAGA: Należy teraz uwzględnić zakres głosowy uczestników; wszystkie nuty muszą mieścić się w komforcie zakresu śpiewanego każdego z uczestników.- Użyj generatora sekwencji losowych, aby stworzyć zrandomizowaną sekwencję 30 interwałów dla prób polegających wyłącznie na słuchaniu30. Dla prób śpiewanych utwórz pseudozrandomizowaną sekwencję 120 interwałów, aby uczestnicy mogli wysłuchać określonego interwału, a następnie dopasować ten interwał docelowy swoim głosem śpiewanym. W przypadku sekwencji pseudozrandomizowanej zastosuj tę samą metodę, która została opisana w kroku 1.2.4, ponownie używając 4 interwałów jako argumentów, ale powtarzając ten proces 30 razy.
- Postępując zgodnie z procedurą opisaną w kroku 1.2.5, użyj oprogramowania do badań behawioralnych, aby wygenerować trzy odrębne serie (runy), z których każda składa się początkowo z 10 prób bazowych w ciszy, następnie z 10 następujących po sobie prób polegających wyłącznie na słuchaniu, a na koniec z 40 następujących po sobie prób śpiewanych.
UWAGA: Podczas prób bazowych cztery interwały pojawiają się w kolejności losowej, natomiast podczas prób śpiewanych cztery interwały pojawiają się w kolejności pseudozrandomizowanej w taki sposób, że każdy interwał zostanie zaprezentowany dokładnie 10 razy. Czas trwania każdej próby wynosi 10 s, zatem jedna pełna seria trwa 10 min. Ponieważ każdy badany przechodzi przez 3 serie eksperymentalne, całkowity czas trwania eksperymentu wynosi 30 min. Jednakże, uwzględniając czas wejścia i wyjścia uczestników ze skanera, czas na konfigurację i przetestowanie mikrofonu, czas na wykonanie skanu anatomicznego oraz przerwy między seriami funkcjonalnymi, na każdego uczestnika należy przeznaczyć około 1 h czasu pracy skanera.
- Wyjaśnij uczestnikom sekwencje prezentowanych prób, zgodnie z opisem w kroku 2.1.1.2, i odpowiedz na wszelkie wątpliwości. Poinstruuj uczestników, aby podczas prób śpiewanych mruczeli nuty bez otwierania ust, utrzymując wargi w bezruchu i wydając dźwięk „m”.
- Podłącz niemagnetyczne słuchawki kompatybilne z MR do laptopa. Dostosuj poziom głośności do komfortowego poziomu dla każdego badanego.
- Podłącz mały mikrofon kondensatorowy do interfejsu audio, który z kolei jest połączony z laptopem za pomocą ekranowanego kabla w skrętkach.
UWAGA: Zasilacz mikrofonu, interfejs audio i laptop powinny znajdować się poza pomieszczeniem, w którym znajduje się skaner. - Sprawdź charakterystykę częstotliwościową mikrofonu.
UWAGA: Celem tego testu jest potwierdzenie, że mikrofon działa zgodnie z oczekiwaniami wewnątrz skanera.- Uruchom nowy projekt w oprogramowaniu do edycji dźwięku i wybierz mikrofon kondensatorowy jako urządzenie wejściowe.
- Wygeneruj ton testowy o częstotliwości 40 Hz i czasie trwania 10 s, zgodnie z opisem w sekcji 1.2.1, z odpowiednimi wartościami częstotliwości i czasu trwania.
- Używając domyślnego oprogramowania do odtwarzania dźwięku na laptopie, naciśnij „Play”, aby przesłać ton testowy przez słuchawki w lokalizacjach wewnątrz (na zagłówku) i na zewnątrz (w pokoju sterowniczym) skanera, przy czym w każdym przypadku mikrofon powinien znajdować się pomiędzy stronami słuchawek.
- Naciśnij „Record” w oprogramowaniu do edycji dźwięku, aby nagrać około 1 s tonu testowego w każdej lokalizacji.
- Wybierz „Plot Spectrum” z menu „Analyze” dla każdego przypadku i porównaj odpowiedź mikrofonu na ton testowy, zarówno wewnątrz, jak i na zewnątrz skanera, sprawdzając, czy częstotliwość podstawowa sygnału odebranego w każdej lokalizacji wynosi 40 Hz.
- Przyklej mikrofon kondensatorowy do szyi uczestnika, tuż poniżej krtani.
- Poproś uczestnika o założenie słuchawek. Umieść uczestnika w skanerze rezonansu magnetycznego (MR).
- Wygeneruj sekwencje o tych samych interwałach, co w kroku 1.2.3, ponownie składające się z dwóch następujących po sobie czystych tonów o czasie trwania 1 s każdy.
- Sesja fMRI.
- Na początku sesji uruchom pakiet oprogramowania interfejsu użytkownika rezonansu magnetycznego (MRUI). Użyj MRUI do zaprogramowania paradygmatu akwizycji.
UWAGA: Należy spodziewać się pewnych różnic w interfejsie pomiędzy różnymi modelami.- Wybierz opcję „Patient” z menu ekranowego. Wprowadź imię, wiek i wagę uczestnika.
- Kliknij przycisk „Exam”. Najpierw wybierz „Head”, a następnie „Brain” z dostępnych opcji.
- Wybierz „3D», a następnie „T1 isometric”, z następującymi wartościami dla odpowiednich parametrów: czas repetycji (TR) = 10.2 ms, czas echa (TE) = 4.2 ms, kąt odchylenia (Flip Angle) = 90° oraz rozmiar voxela = 1 x 1 x 1 mm3.
UWAGA: Dla każdego uczestnika zostanie wykonany anatomiczny obraz wolumetryczny ważony T1 przy użyciu sekwencji impulsów echo gradientowego do celów odniesienia anatomicznego. - Kliknij „Program” i wybierz EchoPlanaImage_diff_perf_bold (T2*), z następującymi wartościami odpowiednich parametrów: TE = 40 ms, TR = 10 s, czas akwizycji (TA) = 3 s, opóźnienie w TR = 7 s, Flip Angle = 90°, pole widzenia (FOV) = 256 mm2 oraz wymiary macierzy = 64 x 64. Użyj opcji „Dummy”, aby pozyskać 5 wolumenów, wprowadzając wartość „5” dla całkowitej liczby wolumenów.
UWAGA: Wartości te umożliwiają akwizycję funkcjonalnych skanów całej głowy ważonych T2* zgodnie z paradygmatem rzadkiego próbkowania przedstawionym na Ryc. 1, gdzie skan „dummy” obrazowania echo-planarnego (EPI) jest pozyskiwany i odrzucany, aby zniwelować efekty nasycenia T1. Należy zauważyć, że w niektórych interfejsach MRUI wartość TR powinna wynosić 3 s, ponieważ jest ona traktowana jako całkowity czas, w którym odbywa się akwizycja. - Kliknij „Copy”, aby utworzyć kopię tej sekwencji. Ustaw kursor na dole listy sekwencji, a następnie kliknij „Paste” dwa razy, aby skonfigurować trzy następujące po sobie sekwencje rzadkiego próbkowania.
- Kliknij „Start”, aby rozpocząć akwizycję anatomicznego wolumenu ważonego T1.
- Zaprezentuj uczestnikowi trzy serie, zgodnie z opisem w kroku 2.1.1.2. Zsynchronizuj start serii z akwizycją skanera za pomocą modułu wyzwalającego (trigger-box) skanera.
- Postępuj zgodnie z procedurą opisaną w sekcji 1.3.2, aby rozpocząć każdą z trzech serii, odróżniając je numerem sesji. Zapisz wyniki trzech pełnych serii, stosując tę samą procedurę opisaną w kroku 1.3.3.
UWAGA: Czas prezentacji prób jest systematycznie modyfikowany (jitter) o ±50 ms.
- Postępuj zgodnie z procedurą opisaną w sekcji 1.3.2, aby rozpocząć każdą z trzech serii, odróżniając je numerem sesji. Zapisz wyniki trzech pełnych serii, stosując tę samą procedurę opisaną w kroku 1.3.3.
- Na początku sesji uruchom pakiet oprogramowania interfejsu użytkownika rezonansu magnetycznego (MRUI). Użyj MRUI do zaprogramowania paradygmatu akwizycji.
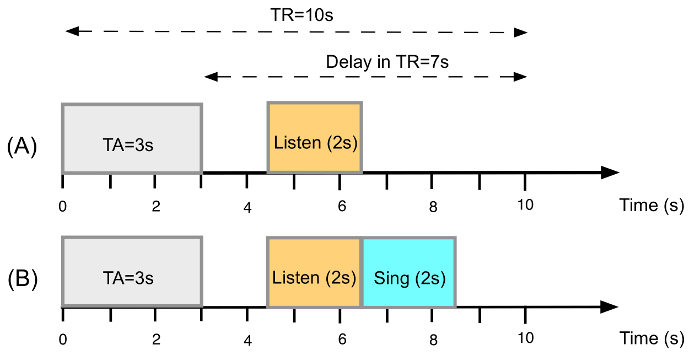
Rysunek 1: Projekt rzadkiego próbkowania. (A) Oś czasu zdarzeń w próbie obejmującej wyłącznie słuchanie interwału dwutonowego (2 s), bez następującej po nim jawnej reprodukcji. (B) Oś czasu zdarzeń w ramach badania obejmującego zadania słuchania i śpiewania. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ilustracji.
3. Analiza danych
- Wstępnie przetworzyć dane funkcjonalne przy użyciu oprogramowania przeznaczonego do analizy sekwencji obrazowania mózgu zgodnie ze standardowymi procedurami3.
UWAGA: Cały proces przetwarzania danych odbywa się w ramach tego samego oprogramowania.- Użyć dostępnej opcji menu, aby wyrównać obrazy do pierwszego wolumenu, a następnie przeprowadzić resampling i normalizację przestrzenną (ostateczna wielkość woksela: 2 x 2 x 2 mm3) do standardowej przestrzeni stereotaktycznej Montreal Neurological Institute (MNI)34.
- Użyć dostępnej opcji menu, aby wygładzić obraz za pomocą izotropowego jądra Gaussa o szerokości połówkowej (FWHM) wynoszącej 8 mm.
- W celu zamodelowania odpowiedzi BOLD, wybrać funkcję odpowiedzi impulsowej skończonej (FIR) z pojedynczym koszykiem jako funkcję bazową (rząd 1) lub funkcję prostokątną (boxcar), obejmującą czas akwizycji wolumenu (3 s)28.
UWAGA: Protokoły rzadkiego próbkowania (sparse-sampling), takie jak ten, zazwyczaj nie wymagają splotu FIR z funkcją odpowiedzi hemodynamicznej, co jest powszechnie stosowane w fMRI zależnym od zdarzeń. - Zastosować filtr górnoprzepustowy do odpowiedzi BOLD dla każdego zdarzenia (1 0 s dla „sieci śpiewania” i 360 s w pozostałych przypadkach).
UWAGA: Modelowanie wszystkich zadań śpiewania razem stworzy blok o długości 40 s35.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Wszystkich 1 uczestników naszego eksperymentu stanowiły studentki śpiewu na poziomie konserwatoryjnym, które uzyskały wystarczająco dobre wyniki w zadaniach rozpoznawania interwałów, aby zostać zakwalifikowane do badania obrazowego. Odsetek sukcesów w zadaniu identyfikacji interwałów wyniósł 65,72 ±21,67%, co, zgodnie z oczekiwaniami, jest wartością niższą niż odsetek sukcesów przy identyfikacji interwałów dysonansowych i konsonansowych, który wyniósł 74,82 ±14,15%.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Praca ta opisuje protokół, w którym śpiew jest używany jako środek badania aktywności mózgu podczas tworzenia interwałów spółgłoskowych i dysonansowych. Mimo że śpiew jest prawdopodobnie najprostszą metodą tworzenia interwałów muzycznych22, nie pozwala na wytwarzanie akordów. Jednakże, chociaż większość fizycznych charakterystyk pojęcia współbrzmienia opiera się, do pewnego stopnia, na nakładaniu się jednoczesnych nut, wiele badań wykazało, że interwały zbudowane z nut odpowiadających akordom spół...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy deklarują brak konfliktu interesów.
Podziękowania
Autorzy dziękują za wsparcie finansowe dla tych badań od Secretaría de Salud de México (HIM/2011/058 SSA. 1009), CONACYT (SALUD-2012-01-182160) i DGAPA UNAM (PAPIIT IN109214).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Skaner rezonansu magnetycznego Achieva 1.5-T | Philips | Release 6.4 | |
| Audacity | Open source | 2.0.5 | |
| Interfejs audio | Tascam | US-144MKII | |
| Audiometr | Brü el & Kjaer | Type 1800 | |
| E-Prime Profesjonalne | narzędzia programowe do psychologii, Inc. | 2.0.0.74 | |
| Matlab | Mathworks | R2014A Kompatybilne | |
| z MRI Wkładki douszne | Sensimetrics | S14 | |
| Praat | Open source | 5.4.12 | |
| Mikrofon pojemnościowy Pro-audio | Shure | SM93 | |
| SPSS Statystyki | IBM | 20 | |
| Statystyczne mapowanie | parametryczneWellcome Trust Centre for Neuroimaging (Centrum Zaufania Wellcome ds. Neuroobrazowania | 8 |
Bibliografia
- Burns, E. Intervals, scales, and tuning. The psychology of music. Deutsch, D. , Academic Press. London. 215-264 (1999).
- Lundin, R. W. Toward a cultural theory of consonance. J. Psychol. 23, 45-49 (1947).
- Fritz, T., Jentschke, S., et al. Universal recognition of three basic emotions in music. Curr. Biol. 19, 573-576 (2009).
- Schellenberg, E. G., Trehub, S. E. Frequency ratios and the discrimination of pure tone sequences. Percept. Psychophys. 56, 472-478 (1994).
- Trainor, L. J., Heinmiller, B. M. The development of evaluative responses to music. Infant Behav. Dev. 21 (1), 77-88 (1998).
- Zentner, M. R., Kagan, J. Infants' perception of consonance and dissonance in music. Infant Behav. Dev. 21 (1), 483-492 (1998).
- Terhardt, E. Pitch, consonance, and harmony. J. Acoust. Soc. America. 55, 1061(1974).
- Minati, L., et al. Functional MRI/event-related potential study of sensory consonance and dissonance in musicians and nonmusicians. Neuroreport. 20, 87-92 (2009).
- Helmholtz, H. L. F. On the sensations of tone. , New York: Dover. (1954).
- McDermott, J. H., Lehr, A. J., Oxenham, A. J. Individual differences reveal the basis of consonance. Curr. Biol. 20, 1035-1041 (2010).
- Cousineau, M., McDermott, J. H., Peretz, I. The basis of musical consonance as revealed by congenital amusia. Proc. Natl. Acad. Sci. USA. 109, 19858-19863 (2012).
- Plomp, R., Levelt, W. J. M. Tonal Consonance and Critical Bandwidth. J. Acoust. Soc. Am. 38, 548-560 (1965).
- Kameoka, A., Kuriyagawa, M. Consonance theory part I: Consonance of dyads. J. Acoust. Soc. Am. 45, 1451-1459 (1969).
- Tramo, M. J., Bharucha, J. J., Musiek, F. E. Music perception and cognition following bilateral lesions of auditory cortex. J. Cogn. Neurosci. 2, 195-212 (1990).
- Schellenberg, E. G., Trehub, S. E. Children's discrimination of melodic intervals. Dev. Psychol. 32 (6), 1039-1050 (1996).
- Peretz, I., Blood, A. J., Penhune, V., Zatorre, R. J. Cortical deafness to dissonance. Brain. 124, 928-940 (2001).
- Mcdermott, J. H., Schultz, A. F., Undurraga, E. A., Godoy, R. A. Indifference to dissonance in native Amazonians reveals cultural variation in music perception. Nature. 535, 547-550 (2016).
- Blood, A. J., Zatorre, R. J., Bermudez, P., Evans, A. C. Emotional responses to pleasant and unpleasant music correlate with activity in paralimbic brain regions. Nat. Neurosci. 2, 382-387 (1999).
- Pallesen, K. J., et al. Emotion processing of major, minor, and dissonant chords: A functional magnetic resonance imaging study. Ann. N. Y. Acad. Sci. 1060, 450-453 (2005).
- Foss, A. H., Altschuler, E. L., James, K. H. Neural correlates of the Pythagorean ratio rules. Neuroreport. 18, 1521-1525 (2007).
- Limb, C. J., Braun, A. R. Neural substrates of spontaneous musical performance: An fMRI study of jazz improvisation. PLoS ONE. 3, (2008).
- Zarate, J. M. The neural control of singing. Front. Hum. Neurosci. 7, 237(2013).
- Larson, C. R., Altman, K. W., Liu, H., Hain, T. C. Interactions between auditory and somatosensory feedback for voice F0 control. Exp. Brain Res. 187, 613-621 (2008).
- Belyk, M., Pfordresher, P. Q., Liotti, M., Brown, S. The neural basis of vocal pitch imitation in humans. J. Cogn. Neurosci. 28, 621-635 (2016).
- Kleber, B., Veit, R., Birbaumer, N., Gruzelier, J., Lotze, M. The brain of opera singers: Experience-dependent changes in functional activation. Cereb. Cortex. 20, 1144-1152 (2010).
- Jürgens, U. Neural pathways underlying vocal control. Neurosci. Biobehav. Rev. 26, 235-258 (2002).
- Kleber, B., Birbaumer, N., Veit, R., Trevorrow, T., Lotze, M. Overt and imagined singing of an Italian aria. Neuroimage. 36, 889-900 (2007).
- Kleber, B., Zeitouni, A. G., Friberg, A., Zatorre, R. J. Experience-dependent modulation of feedback integration during singing: role of the right anterior insula. J. Neurosci. 33, 6070-6080 (2013).
- Zarate, J. M., Zatorre, R. J. Experience-dependent neural substrates involved in vocal pitch regulation during singing. Neuroimage. 40, 1871-1887 (2008).
- González-García, N., González, M. A., Rendón, P. L. Neural activity related to discrimination and vocal production of consonant and dissonant musical intervals. Brain Res. 1643, 59-69 (2016).
- Oldfield, R. C. The assessment and analysis of handedness: The Edinburgh inventory. Neuropsychologia. 9, 97-113 (1971).
- Samuels, M. L., Witmer, J. A., Schaffner, A. Statistics for the Life Sciences. , Pearson. Harlow. (2015).
- Eickhoff, S. B., et al. A new SPM toolbox for combining probabilistic cytoarchitectonic maps and functional imaging data. NeuroImage. 25, 1325-1335 (2005).
- Evans, A. C., Kamber, M., Collins, D. L., MacDonald, D. An MRI-based probabilistic atlas of neuroanatomy. Magnetic Resonance Scanning and Epilepsy. Shorvon, S. D., Fish, D. R., Andermann, F., Bydder, G. M., Stefan, H. 264, 263-274 (1994).
- Ashburner, J., et al. SPM8 Manual. , Wellcome Trust Centre for Neuroimaging. London. (2013).
- Özdemir, E., Norton, A., Schlaug, G. Shared and distinct neural correlates of singing and speaking. Neuroimage. 33, 628-635 (2006).
- Brown, S., Ngan, E., Liotti, M. A larynx area in the human motor cortex. Cereb. Cortex. 18, 837-845 (2008).
- Worsley, K. J. Statistical analysis of activation images. Functional MRI: An introduction to methods. , Oxford University Press. Oxford. 251-270 (2001).
- FSL Atlases. , Available from: https://fsl.fmrib.ox.ac.uk/fsl/fslwiki/Atlases (2015).
- Bidelman, G. M., Krishnan, A. Neural correlates of consonance, dissonance, and the hierarchy of musical pitch in the human brainstem. J. Neurosci. 29, 13165-13171 (2009).
- McLachlan, N., Marco, D., Light, M., Wilson, S. Consonance and pitch. J. Exp. Psychol. – Gen. 142, 1142-1158 (2013).
- Thompson, W. F. Intervals and scales. The psychology of music. Deutsch, D. , Academic Press. London. 107-140 (1999).
- Hurwitz, R., Lane, S. R., Bell, R. A., Brant-Zawadzki, M. N. Acoustic analysis of gradient-coil noise in MR imaging. Radiology. 173, 545-548 (1989).
- Ravicz, M. E., Melcher, J. R., Kiang, N. Y. -S. Acoustic noise during functional magnetic resonance imaging. J Acoust. Soc. Am. 108, 1683-1696 (2000).
- Cho, Z. H., et al. Analysis of acoustic noise in MRI. Magn. Reson. Imaging. 15, 815-822 (1997).
- Belin, P., Zatorre, R. J., Hoge, R., Evans, A. C., Pike, B. Event-related fMRI of the auditory cortex. Neuroimage. 429, 417-429 (1999).
- Hall, D. A., et al. "Sparse" temporal sampling in auditory fMRI. Hum. Brain Mapp. 7, 213-223 (1999).
- Ternström, S., Sundberg, J. Acoustical factors related to pitch precision in choir singing. Speech Music Hear. Q. Prog. Status Rep. 23, 76-90 (1982).
- Ternström, S., Sundberg, J. Intonation precision of choir singers. J. Acoust. Soc. Am. 84, 59-69 (1988).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
Tagi
aktywność mózgu w fMRIinterwały produkcji wokalnejinterwały konsonansowe i dysonansoweintegracja sprzężenia zwrotnego słuchowegosystemy sensoryczno-motorycznefunkcjonalny rezonans magnetycznyprotokół zadania śpiewawczegopomiar dokładności wokalnejmonitorowanie aktywacji mózgusystemy motoryczno-słuchowe
