Ten protokół opisuje test uczenia się i zapamiętywania u Drosophila zwany warunkowaniem zalotów. Ten klasyczny test opiera się na zmniejszeniu zachowań związanych z zalotami samców po odrzuceniu seksualnym przez niepodatną samicę z premfetem. Ta naturalna forma plastyczności behawioralnej może być wykorzystana do testowania uczenia się, pamięci krótkotrwałej i pamięci długotrwałej.
Artykuł metodologiczny
Drosophila Warunkowanie zalotów jako miara uczenia się i pamięci
W tym artykule
Podsumowanie
Streszczenie
Wiele wglądów w mechanizmy molekularne leżące u podstaw uczenia się i pamięci zostało wyjaśnionych dzięki użyciu prostych testów behawioralnych w organizmach modelowych, takich jak muszka owocowa, Drosophila melanogaster. Drosophila jest przydatna do zrozumienia podstawowej neurobiologii leżącej u podstaw deficytów poznawczych wynikających z mutacji w genach związanych z zaburzeniami poznawczymi człowieka, takimi jak niepełnosprawność intelektualna (ID) i autyzm. Niniejsza praca opisuje metodologię testowania uczenia się i pamięci przy użyciu klasycznego paradygmatu u Drosophila, znanego jako warunkowanie zalotów. Samce much zalecają się do samic, używając wyraźnego wzorca łatwo rozpoznawalnych zachowań. Samice w preparacji nie są otwarte na krycie i odrzucają próby kopulacji samca. W odpowiedzi na to odrzucenie samce much zmniejszają swoje zachowania godowe. To wyuczone zmniejszenie zachowań związanych z zalotami jest mierzone w czasie, służąc jako wskaźnik uczenia się i pamięci. Podstawowym wynikiem liczbowym tego testu jest wskaźnik zalotów (CI), który jest definiowany jako procent czasu, jaki samiec spędza na zalotach w ciągu 10-minutowego interwału. Wskaźnik uczenia się (LI) to względne zmniejszenie CI u much, które były narażone na kontakt z samicą w preparacie, w porównaniu z muchami naiwnymi, które nie miały wcześniejszych kontaktów społecznych. Do statystycznego porównania LI między genotypami stosuje się test randomizacji z bootstrappingiem. Aby zilustrować, w jaki sposób test może być wykorzystany do określenia roli genu związanego z uczeniem się i pamięcią, scharakteryzowano panneuronalny knockdown acylotransferazy fosforanu dihydroksyacetonu (Dhap-at). Ludzki ortolog Dhap-at, O-acylotransferaza fosforanu gliceronu (GNPT), bierze udział w chondrodysplazji punktowej typu 2 kłączowej, zespole autosomalno-recesywnym charakteryzującym się ciężką ID. Korzystając z testu warunkowania zalotów, ustalono, że Dhap-at jest wymagany do pamięci długotrwałej, ale nie do pamięci krótkotrwałej. Wynik ten służy jako podstawa do dalszych badań nad mechanizmami molekularnymi leżącymi u jego podstaw.
Wprowadzenie
Mechanizmy molekularne leżące u podstaw uczenia się i pamięci są zachowane u wielu gatunków. Pionierskie badania przesiewowe linii mutantów Drosophila melanogaster pod kątem defektów w uczeniu się węchu i pamięci dostarczyły kluczowych informacji molekularnych na temat procesów leżących u podstaw uczenia się i pamięci1. Badania te zidentyfikowały niektóre z pierwszych genów zaangażowanych w uczenie się i pamięć, takie jak rutabaga2, amnesiac3 i dunce4, ujawniając kluczową rolę cyklicznego sygnalizacji monofosforanu adenozyny (cAMP)5.
Wczesne badania genetyczne mutantów pamięci były głównie przeprowadzane przy użyciu warunkowania węchowego. Jednak z biegiem czasu pojawiło się kilka metod pomiaru innych form uczenia się i pamięci. Jeden z najczęściej używanych paradygmatów uczenia się i pamięci, a także opisany tutaj test, jest znany jako warunkowanie zalotów, który został po raz pierwszy opisany przez Siegela i Halla6, a następnie został udoskonalony przez kilka innych grup badawczych7,8,9. Kondycjonowanie zalotów jest zależne od obecności specyficznego feromonu, octanu cis-vaccenylu (cVA), na brzuchu samicy, który jest odkładany przez samca podczas kopulacji. Wyczuwanie cVA na brzuchu samicy w naturalny sposób zmniejsza zachowania związane z zalotami, a w połączeniu z aktem odrzucenia przez samicę, wpływ cVA na redukcję zalotów samca jest znacznie zwiększony. Reakcję samców much w tym teście można łatwo określić ilościowo, obserwując ich wyraźne zachowanie godowe, które charakteryzuje się orientacją w kierunku samicy i podążaniem za nią, stukaniem, wysuwaniem i wibrowaniem skrzydła, lizaniem i próbą kopulacji10 (Rysunek 1A). Samce much uczą się odróżniać receptywne dziewicze od niereceptywnych krytych samic11, a po odrzuceniu seksualnym wykazują zmniejszone zachowania godowe w stosunku do niereceptywnych samic przez okres do 9 dni8. To naturalne zachowanie może być wykorzystane do wyjaśnienia mechanizmów leżących u podstaw uczenia się, pamięci krótkotrwałej (STM) i pamięci długotrwałej (LTM)8,9,12. Uczenie się definiuje się jako natychmiastowe zmniejszenie zachowań związanych z zalotami, które występuje w okresie treningu i jest często określane jako natychmiastowa pamięć przywoławcza, mierzona 0 - 30 minut po ekspozycji na pokrytą samicę 6,8. STM mierzy się od 30 min do 1 h po treningu, natomiast LTM najczęściej mierzy się 24 h po treningu8 (Rysunek 1B). STM można indukować za pomocą 1-godzinnego okresu treningowego, ale trwa on tylko przez 2-3 godziny6,8. W większości paradygmatów uczenia się, LTM może być wywołany tylko przez rozłożone w czasie powtarzające się treningi. Mcbride i wsp. (1999)8 pokazał, że trzy rozłożone w czasie, 1-godzinne sesje treningowe były wystarczające do wywołania wspomnienia zalotów trwającego do 9 dni, w przeciwieństwie do 2-3 godzin wywołanych przez pojedynczą 1-godzinną sesję treningową. McBride i wsp. 8 wykazał również, że pojedyncza 5-godzinna sesja treningowa dawała podobną odpowiedź LTM przez okres do 9 dni. Muchy nie zalecają się stale podczas tego 5-godzinnego okresu, w efekcie wytwarzając własny trening w odstępach czasu, aby wywołać LTM w jednej sesji treningowej. Jest to bardzo ważne z praktycznego punktu widzenia, ponieważ znacznie zwiększa łatwość, z jaką można wykorzystać ten test do badania LTM. Obecne protokoły używają głównie pojedynczej sesji treningowej trwającej 7 godzin dla LTM11,12. W kilku badaniach analizowano różne zmutowane stany, które mają określone defekty w różnych aspektach uczenia się zalotów. Na przykład, ablacja ciała grzyba wpływa na STM i LTM, ale nie na learning8. Mutacje w genie amnezji, który po raz pierwszy został zdefiniowany jako specyficzny regulator pamięci za pomocą warunkowania węchowego3, wpływają na STM, ale nie na uczenie się6. Zakłócenie regulatora translacji orb2 (podrodzina CPEB2 wiążącego RNA oo18 (orb) CPEB2) i sygnalizacji ekdyzonu wpływają wyłącznie na LTM9,13. Tak więc warunkowanie zalotów jest użytecznym paradygmatem do analizy mechanizmów leżących u podstaw różnych etapów uczenia się i pamięci.
Ta praca demonstruje zoptymalizowaną konfigurację eksperymentalną, która pozwala na stosunkowo wysoką przepustowość testowania warunkowania zalotów. Ponadto opisano w nim skrypt analizy statystycznej i omówiono krytyczne czynniki testu. Pokazano tutaj, że gen Drosophila Acylotransferaza fosforanu dihydroksyacetonu (Dhap-at) jest wymagana w neuronach dla LTM, ale nie dla STM. Ludzki ortolog tego genu, O-acylotransferaza fosforanu gliceronu (GNPAT), jest zmutowany w chondrodysplazji kłączowej typu 214, zaburzeniu autosomalno-recesywnym charakteryzującym się ciężką niepełnosprawnością intelektualną, drgawkami i kilkoma innymi cechami klinicznymi15. W tym kontekście, warunkowanie zalotów może być wykorzystane do funkcjonalnej walidacji roli genów chorób ludzkich w uczeniu się i pamięci, stanowiąc podstawę do badań mechanistycznych.
Protokół
UWAGA: W opisanym poniżej protokole opisana jest jedna replika zbierania, trenowania i testowania. W celu zbadania odtwarzalności wyników, kroki te należy powtarzać równolegle, przez wiele dni i z oddzielnymi grupami much (tabela 1). Protokół opiera się na 10-dniowym cyklu życia od jaja do dorosłego osobnika, co jest normalne, gdy muchy są hodowane w stałych warunkach 25 °C, wilgotności 70% i 12-godzinnym cyklu światła/ciemności. Wszystkie aspekty tego protokołu zakładają, że warunki są utrzymywane na stałym poziomie przez cały czas trwania testu. Godziny są wskazywane jako godziny przed włączeniem świateł (BLO) lub po włączeniu świateł (ALO) w inkubatorze, ponieważ można je wygodnie ustawić w zależności od preferowanej pory dnia przez badacza. Gaz CO2 należy stosować tylko do początkowego zbierania naiwnych samców much oraz do zbierania wstępnie pokrytych samic. Ten protokół warunkowania zalotów składa się z następujących kroków:
- Ustanowienie premowanych żeńskich kultur kolekcjonerskich
- Tworzenie kultur do zbierania samców badanych
- Przygotowanie bloków mieszkalnych
- Ustalanie fiolek do krycia do produkcji standaryzowanych wstępnie pokrytych samic
- Zbiór męskich obiektów testowych
- szkolenie
- testowanie
- Analiza danych wideo i statystyki
1. Ustanowienie hodowli premowanych żeńskich
kolekcji- Przygotuj powerfood16. Gotować 0,8% (m/v) agar, 8% (w/v) drożdży, 2% (w/v) ekstraktu drożdżowego, 2% (w/v) peptonu, 3% (w/v) sacharozy, 6% (w/v) glukozy, 0,05% (w/v)MgSO4 i 0,05% (w/v) CaCl2 w wodzie przez 15 min. Pozostawić roztwór do ostygnięcia do temperatury 70 °C przed dodaniem 0,05% (m/v) metyloparenu (UWAGA: toksyczny) i 0,5% (v/v) kwasu propionowego (UWAGA: toksyczny). Dobrze wymieszać, mieszając, schładzając do temperatury 50 °C, aby uzyskać jednorodny roztwór.
- Zanim żywność stwardnieje w temperaturze pokojowej, dodaj ~50 ml powerfood do każdej plastikowej fiolki o pojemności 175 ml. Pozwól żywności jeszcze bardziej ostygnąć. Zamknąć fiolkę zatyczką.
UWAGA: Powerfood to specjalistyczna mieszanka pokarmowa opracowana specjalnie do produkcji dużej liczby much, prawdopodobnie poprzez indukowanie składania jaj. Powerfood nie jest używany do produkcji samców much, które zostaną wykorzystane do analizy zachowania (krok 2), ponieważ nietypowa dieta i potencjalne zatłoczenie mogą wpływać na rozwój. - W dniu -11 (Tabela 1) rozpocznij 5-20 kultur typu dzikiego z około 60-100 muchami (mieszanką samców i samic) w fiolkach Powerfood; zostaną one użyte w kroku 4 do wyprodukowania standaryzowanych wstępnie pokrytych samic17. Dodać bibułę filtracyjną do każdej fiolki, aby zwiększyć obszar, na którym larwy mogą się przepoczwarzać; Zwiększy to liczbę much, które mogą się zamknąć.
- Okresowo powtarzaj kroki 1.1-1.3 przez cały czas trwania eksperymentu, aby uzyskać wystarczającą liczbę nowo zamkniętych much jako dane wejściowe do "ustanowienia fiolek krytych do produkcji standaryzowanych samic przed kryciem" (krok 4).
2. Ustanawianie kultur do zbierania męskich obiektów testowych
- Przygotuj normalne jedzenie16, wykonane z 0,5% (w/v) agaru, 2,75% (w/v) drożdży, 5,2% (w/v) mąki kukurydzianej, 11% (w/v) cukru, 0,05% (w/v) metyloparabenu, i 0,5% (v/v) kwasu propionowego w wodzie, jak opisano w krokach 1.1 i 1.2. Zamknąć plastikowe fiolki o pojemności 175 ml zatyczką na muchę.
- W dniu -10 (Tabela 1) umieścić około 10-20 samców z około 30-75 dziewiczymi samicami (Tabela materiałów/sprzętu) w każdej fiolce o pojemności 175 ml zawierającej normalny pokarm. Dodaj bibułę filtracyjną, aby zwiększyć powierzchnię do przepoczwarzania i zmaksymalizować produktywność.
- Ustalić od trzech do sześciu fiolek po 175 ml na genotyp, aby uzyskać wymaganą liczbę badanych samców.
UWAGA: Może być potrzebnych więcej fiolek, w zależności od produktywności pożądanego genotypu.
3. Przygotowanie bloków mieszkalnych (Rysunek 2A)
- Rozpuść około 50 ml powerfood na blok mieszkalny w kuchence mikrofalowej lub przygotuj go na świeżo.
- Dodaj 500 μl powerfood do każdego dołka 96-dołkowego bloku z płaskim dnem za pomocą pipety z wieloma dozownikami.
- Pozwól żywności zestalić się w temperaturze pokojowej.
- Przykryj bloki folią samoprzylepną PCR i użyj igły, aby zrobić co najmniej 4 otwory na studzienkę, aby zapewnić muchom świeże powietrze.
- Aby móc otworzyć każdą studzienkę, użyj żyletki, aby przeciąć folię samoprzylepną wzdłuż między każdym rzędem. Pozostaw folię nienaruszoną na jednym końcu bloku.
- Bloki można przechowywać w temperaturze 4 °C do 2 dni.
UWAGA: Przed użyciem pozwól blokom ponownie zrównoważyć się do temperatury pokojowej.
4. Ustanowienie fiolek godowych do produkcji standaryzowanych samic premowanych
- W dniu -1 należy usunąć i wyrzucić wszystkie dorosłe muchy typu dzikiego z premowanych kultur żeńskich kolekcji po 2-5 godzinach BLO.
- Zbieraj muchy za pomocą aspiratora (Rysunek 2B) z tych fiolek w odstępach od 2 do 3 godzin (np. po 30 minutach, 2,5 godzinach i 5 godzinach ALO) i umieść je w nowej fiolce powerfood uzupełnionej niewielką ilością pasty drożdżowej i bibuły filtracyjnej.
- Aby uniknąć zatłoczenia i zapewnić optymalną atmosferę godową, nie należy przenosić więcej niż 150-200 much do każdej nowej fiolki. Zapewnij krycie wszystkich samic, zapewniając co najmniej 25% samców. Upewnij się, że w fiolkach do krycia znajduje się wystarczająca ilość samic, aby dostosować się do wielkości eksperymentu.
UWAGA: Ponieważ jest to kluczowy krok w protokole, upewnij się, że do nowej fiolki godowej przenoszone są tylko świeżo zamknięte muchy i żadne stare muchy, larwy ani poczwarki. - Inkubuj te "fiolki godowe" przez cztery dni, aby zapewnić wszystkim samicom wystarczająco dużo czasu na krycie.
5. Zbiór męskich obiektów testowych
- W dniu 1 (Tabela 1) po 2-3 godzinach BŁO użyj CO2 do usunięcia wszystkich dorosłych much z fiolek do pobierania samców (krok 2), ale pozwól, aby więcej much zamknęło się w ciągu następnych kilku godzin.
- Przez następne 5-6 godzin usuwaj nowo zamknięte muchy co 20-30 minut za pomocą CO2 i umieść każdego samca w indywidualnym dołku bloku mieszkalnego (krok 3) za pomocą aspiratora (Rysunek 2B).
- Ponownie uszczelnij studzienkę samoprzylepną folią PCR.
UWAGA: Jest to kluczowy krok w protokole. Samce powinny być często zbierane. Zebrane samce należy odizolować w bloku mieszkalnym w pobliżu momentu ekleksji, kiedy wykazują bladą pigmentację i obecność smółki w półprzezroczystym brzuchu.
UWAGA: Delikatne użycie aspiratora umożliwia przenoszenie much; jednak niewłaściwe użycie będzie stresować muchy, powodując różnice w teście (patrz Dyskusja). - Staraj się zebrać do 48 samców na genotyp. Zapewnia to niewielki nadmiar w stosunku do maksymalnej liczby samców potrzebnych do analizy zarówno warunków naiwnych, jak i wytrenowanych, co pozwala na pewną stratę podczas późniejszych etapów transferu.
6. Szkolenie
- Usunąć muchy z fiolki do krycia (krok 4.2) za pomocą CO2 i oddzielić wstępnie pokryte samice od samców.
- Za pomocą aspiratora dodaj pojedynczą znieczuloną, wstępnie pokrytą samicę do każdej studzienki w jednym rzędzie nowego bloku mieszkalnego.
- Za pomocą aspiratora i bez znieczulenia przenieś indywidualnego naiwnego samca z bloku mieszkalnego ustawionego w kroku 5.2 do studni, w której znajduje się wstępnie pokryta samica. Po umieszczeniu samca w studni należy natychmiast ponownie uszczelnić folią samoprzylepną; Nie pozwól samcowi uciec.
UWAGA: Przenieś samce much z aspiratora do bloku mieszkalnego, wykorzystując ich naturalne zachowanie "negatywnej geotaksji" (patrz Dyskusja). - Powtarzaj kroki 6.2-6.3, aż utworzy się wystarczająca liczba par samiec-samica. Najlepiej ustalić 24 pary, dwa pełne rzędy bloku mieszkalnego, na genotyp. Pozostaw pozostałych naiwnych samców w oryginalnym bloku mieszkalnym ustawionym w kroku 5.2.
- Pozostaw pary męsko-żeńskie w spokoju podczas okresu treningu (Tabela 2, Rysunek 1B).
UWAGA: W tym czasie samiec będzie zalecał się i zostanie odrzucony przez samicę z premfetu. Dla nauki i STM okres szkolenia wynosi 1 h, a dla LTM okres szkolenia wynosi 7-9 godzin. - Zakończ trening (Tabela 2, Rysunek 1B) za pomocą aspiratora, aby delikatnie oddzielić samca od samicy w parze; nie stosuj znieczulenia. Umieść oddzielonego samca w nowym bloku mieszkalnym.
- Za pomocą aspiratora delikatnie i bez znieczulenia przenieś wszystkich naiwnych samców z bloku mieszkalnego ustawionego w kroku 5.2 do nowego bloku mieszkaniowego.
UWAGA: Ten krok jest opcjonalny dla STM i nauki, ale jest bardzo ważny dla LTM, ponieważ muchy są trzymane przez dodatkowe 24 godziny w celu przetestowania LTM. - W przypadku STM i LTM pozwól samcom odpocząć odpowiednio przez 1 godzinę i ~24 godziny (Tabela 2, Rysunek 1B) przed badaniem (krok 7).
- Aby się nauczyć, natychmiast przetestuj wyszkolonych i naiwnych mężczyzn (krok 7).
7. Testowanie
- Zebrać muchy z fiolek kryjących (krok 4.2) za pomocą CO2 i oddzielić wstępnie kryte samice od samców.
- Pozwól samicom dojść do siebie po znieczuleniu przez co najmniej 1 godzinę w fiolce zawierającej normalny pokarm.
- Zamontuj magnetowidy z wyprzedzeniem (Rysunek 2C), aby mieć gotowy cały sprzęt przed rozpoczęciem testów.
- Rozpocznij testowanie zgodnie z różnymi harmonogramami uczenia się, STM i LTM (Tabela 2, Rysunek 1B). Testy wykonuj bezpośrednio po treningu do nauki, 1 godzinę po treningu na STM i 24 godziny po treningu na LTM.
- Za pomocą aspiratora delikatnie przenieś pojedynczego samca z bloku mieszkalnego w stanie spoczynku lub z bloku mieszkalnego treningowego, jeśli uczenie się jest testowane (krok 6.7, wyszkolony; krok 6.8, naiwny) na połowę areny zalotów z zamkniętą przegrodą (Rysunek 2D; zobacz plik S1, aby zapoznać się z planem budynku).
UWAGA: Użycie naturalnego zachowania "negatywnej geotaksji" powinno wystarczyć do przeniesienia samców much z aspiratora na arenę zalotów (Dyskusja). - Szybko, ale delikatnie przesuń otwór wejściowy na następną arenę i powtarzaj krok 7.5, aż na wszystkich 18 arenach pojawi się jeden samiec.
- Używając aspiratora i bez CO2 dodaj jedną wstępnie pokrytą samicę (zebraną w kroku 7.2) do drugiej połowy wszystkich 18 aren.
- Ostrożnie umieść komorę zalotów pod kamerą, tak aby otwory studni były skierowane w dół (Rysunek 2C).
- Usuń przegrodę aren, aby umożliwić bezpośrednią interakcję między samcami a samicami.
- Natychmiast rozpocznij nagrywanie zachowania przez co najmniej 10 minut.
UWAGA: W przypadku korzystania z konfiguracji z dwiema kamerami, równoległe nagrywanie dwóch płyt zalotów może być wykonywane w nakładających się na siebie ramach czasowych, aby zmaksymalizować wydajność. - Opróżnij areny zalotów za pomocą ręcznego odkurzacza i pozwól komnacie zalotów przewietrzyć się przed ponownym użyciem.
- Powtarzaj kroki 7.4-7.11 aż do zakończenia testowania wszystkich genotypów i warunków (tj. naiwnych i wyszkolonych).
8. Analiza i statystyki danych wideo
- Oblicz wskaźnik zalotów (CI), zdefiniowany jako procent czasu, w którym samiec zabiega w ciągu pierwszych 10 minut okresu testowego, dla każdego pojedynczego samca muchy.
UWAGA: Można to zrobić ręcznie, obserwując stereotypowe zachowania związane z zalotami (Rysunek 1A) lub używając oprogramowania komputerowego do automatycznego ilościowego określania zachowań związanych z zalotami (Dyskusja).
UWAGA: Zaleca się analizę 40-60 mężczyzn na stan w ciągu trzech dni w celu uzyskania wystarczającej mocy statystycznej i oceny spójności danych CI. - Oblicz wskaźnik uczenia się (LI), zdefiniowany jako procentowe zmniejszenie średniego CI wyszkolonych mężczyzn w porównaniu z mężczyznami naiwnymi (LI = (CI naiwny –CI wyszkolony) / CInaiwny). Oceń LI dla każdego dnia badania i porównaj go ze skumulowanym LI obliczonym na podstawie wszystkich dni testowych łącznie.
- Utwórz osobny dwukolumnowy plik danych z zakładkami "Genotype" i "CI" jako nagłówkami.
UWAGA: W tych nagłówkach rozróżniana jest wielkość liter. Nazwa genotypu dla każdego CI musi składać się z opisu genotypu, po którym następuje podkreślenie i warunek wytrenowania (np. genotype_N i genotype_LTM itd., gdzie N = naiwny, a LTM = pamięć długotrwała; patrz plik uzupełniający S2 dla przykładu). Ta adnotacja jest niezbędna, ponieważ funkcja analearn zidentyfikuje wyszkolone i naiwne muchy na podstawie znaków obecnych po pierwszym podkreśleniu w kolumnie "Genotyp". - Użyj skryptu analearn R (plik uzupełniający S3), aby wykonać test randomizacji w celu oceny istotności statystycznej różnic między wartościami LI z różnych genotypów.
- Utwórz źródło skryptu (plik uzupełniający S3) w R18, który definiuje funkcję o nazwie "analearn."
UWAGA: Definicja funkcji jest następująca: analearn <- function(nboot = 10 000, naivelevel = 'N', refmutation = NA, datname = NA, header = TRUE, seed = NA, writeoutput = TRUE). - Uruchom funkcję, wpisując "analearn()" w wierszu poleceń języka R i wybierając plik danych do analizy (utworzony w kroku 8.3) za pomocą wyskakującego okienka.
- Wybierz mutację referencyjną, którą jest genotyp kontrolny, wpisując odpowiedni numer i naciskając enter.
UWAGA: Po wybraniu genotypu referencyjnego skrypt potrzebuje kilku sekund, aby wykonać 10 000 replikacji bootstrap .
- Przestrzegać tabeli wyników (Tabela 3), która zawiera genotyp, warunek uczenia się (tj. uczenie się, STM lub LTM), średnią CI niezałożoną, średnią CI wytrenowaną, LI, różnicę między LI kontroli w porównaniu z warunkami doświadczalnymi (LI dif), dolną granicę (LL) i górną granicę (UL) 95% przedziału ufności LI dif, oraz wartość p wskazująca prawdopodobieństwo, że nie ma istotnej różnicy.
UWAGA: analearn zapisze wyjściowy plik tekstowy w katalogu, w którym znajduje się plik danych. Jednak tabela wyjściowa pojawia się również w konsoli R-Studio. Nazwa domyślna jest tworzona na podstawie nazwy podanego pliku danych. - W funkcji analearn znajduje się kilka argumentów, których można użyć do zmiany domyślnych ustawień funkcji w celu dostosowania parametrów bootstrapping.
UWAGA: "nboot" określa liczbę replik bootstrap i domyślnie jest ustawione na 10 000. Tę wartość można zmienić na dowolną liczbę całkowitą większą od zera. W tabeli 5 wymieniono kilka argumentów, których można użyć do zmiany domyślnych ustawień funkcji. Nie zaleca się jednak używania danych utworzonych przy użyciu małej liczby replik bootstrap.
- Utwórz źródło skryptu (plik uzupełniający S3) w R18, który definiuje funkcję o nazwie "analearn."
Wyniki
Test warunkowania zalotowego może być wykorzystany do pomiaru uczenia się i pamięci u Muszka owocówkaAby to zademonstrować, przedstawione tutaj wyniki analizują pamięć krótkotrwałą (STM) i pamięć długotrwałą (LTM) u much kontrolnych w porównaniu z muchami z neuronowym wyciszeniem genu Dhap-at. Samce kontrolne wykazują ekspresję sekwencji spinki RNA interferencyjnego nakierowanej na Caenorhabditis elegans-konkretny gen, domniemane białko z motywem palca cynkowego C02F5.1219Ten szczep kontrolny zapewnia taką samą liczbę elementów sekwencji aktywującej (UAS) w grupie knockdown i grupie kontrolnej w tym samym tle genetycznym, a kontrolna spinka RNAi uwzględnia wszelkie niespecyficzne efekty systemu RNAi. Samce kontrolne (genotyp: UAS-dcr2/+; P{KK108109}VIE-260B/+; elav-Gal4/+) wykazują znaczną redukcję wskaźnika CI u osobników trenowanych w porównaniu z naiwnymi w obu grupach STM (Rysunek 3A, p = 1,2 x 10⁻⁴, test U Manna-Whitneya) oraz LTM (Rysunek 3B, p = 1,2 x 10⁻⁴, test U Manna-Whitneya). Wynik ten odzwierciedla prawidłową zdolność uczenia się i zapamiętywania u tych much. Dhap-at muchy z wyciszeniem genu (genotyp: UAS-dcr2/+; P{KK101437}VIE-260B/+; elav-Gal4/+) wykazują również istotną redukcję CI w przypadku muszek wytrenowanych w porównaniu do naiwnych w teście STM (Rycina 3A, p = 1,2 x 10⁻⁴, test U Manna-Whitneya). Nie wykazują one jednak istotnego zmniejszenia CI po treningu LTM (Rysunek 3B, p = 0,33, test U Manna-Whitneya). Do porównania średnich wartości CI much naiwnych i przeszkolonych zastosowano test U Manna-Whitneya ze względu na nieparametryczny rozkład danych CI dla niektórych warunków (Rysunek 3A i 3B). Różnice zaobserwowane podczas analizy wskaźników CI odzwierciedla wskaźnik LI dla każdego genotypu, który mierzy procentową redukcję CI w grupie much naiwnych w porównaniu do wyszkolonych (Rysunek 3C). Nie ma istotnej różnicy w LI pomiędzy grupą kontrolną a muchami z wyciszeniem genu Dhap-at w przypadku STM (p = 0,115, 10 000 powtórzeń bootstrapowych, Rycina 3C, Tabela 3), podczas gdy wskaźnik LI dla LTM jest znacznie niższy w Dhap-at muchy z wyciszeniem ekspresji genów (p = 0,0034, 10 000 replikacji bootstrapowych, Rycina 3C, Tabela 3). W celu porównania LI między genotypami zastosowano test randomizacyjny20 zaadaptowano z metody po raz pierwszy zalecanej przez Kamysheva i wsp.7 zostało wykorzystane. Ponieważ LI jest pojedynczą wartością pochodną danych populacyjnych (t. j. średnia dla grupy CI-naïve oraz średnia dla grupy CI-trained), standardowe metody statystyczne opierające się na rozkładach wyprowadzonych eksperymentalnie nie mają zastosowania. Test randomizacyjny jest wolny od założeń dotyczących rozkładu i wykorzystuje bootstrapping (tj. losowe próbkowanie ze zwróceniem) w celu wygenerowania hipotetycznych zestawów danych pochodnych z danych rzeczywistych. Skrypt analearn (Plik S3) generuje zestaw hipotetycznych LIs dla każdego genotypu i oblicza różnicę między genotypem kontrolnym a badanym (LIdiff). Proces ten jest powtarzany 10 000 razy, a otrzymane wartości służą do wyznaczenia 95% przedziału ufności dla LIdiff (Tabela 3). Dane te są wykorzystywane do wygenerowania pwartość wskazująca prawdopodobieństwo, że wskaźnik LI dla dwóch genotypów jest różny. Przedstawione tutaj wyniki wykazują, że Dhap-at jest wymagany w neuronach dla LTM, ale nie dla STM.
W celu skontrolowania zmienności między dniami, porównano CI i LI z powtórzeń przeprowadzonych w różne dni (Tabela 4). Chociaż z dnia na dzień obserwuje się pewne wahania LI, wyniki są ogólnie powtarzalne. Należy zauważyć, że dane CI mogą znacznie różnić się w zależności od użytego szczepu kontrolnego oraz warunków środowiskowych testów. Przedstawione tutaj dane CI są typowe dla tego genotypu kontrolnego, jednak inne genotypy mogą wykazywać wyższą lub niższą średnią wartość CI oraz inny rozkład.
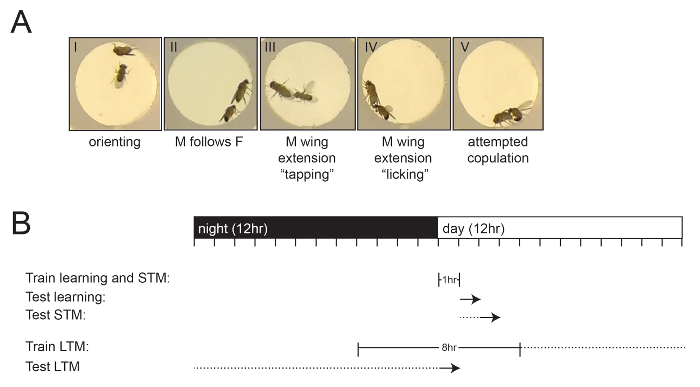
Rycina 1: Wyznaczanie indeksu zalotów i przegląd eksperymentu. (A) Zdjęcia przedstawiające stereotypowe zachowania godowe samca wobec samicy muchy. Pokazano różne etapy zachowań zalotnych: orientację (I), podążanie (II), wibracje skrzydeł (rozłożenie) i uderzanie (III), lizanie (IV) oraz próbę kopulacji (V). (B) Schematyczny przegląd czasu treningu i testów w odniesieniu do cyklu świetlnego inkubatora, oznaczonego w godzinach. Czas treningu zaznaczono paskami, okresy odpoczynku dla STM i LTM zaznaczono linią przerywaną, a punkt rozpoczęcia testów zaznaczono strzałką. Należy zauważyć, że czas testowania dla LTM przypada na dzień po treningu. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
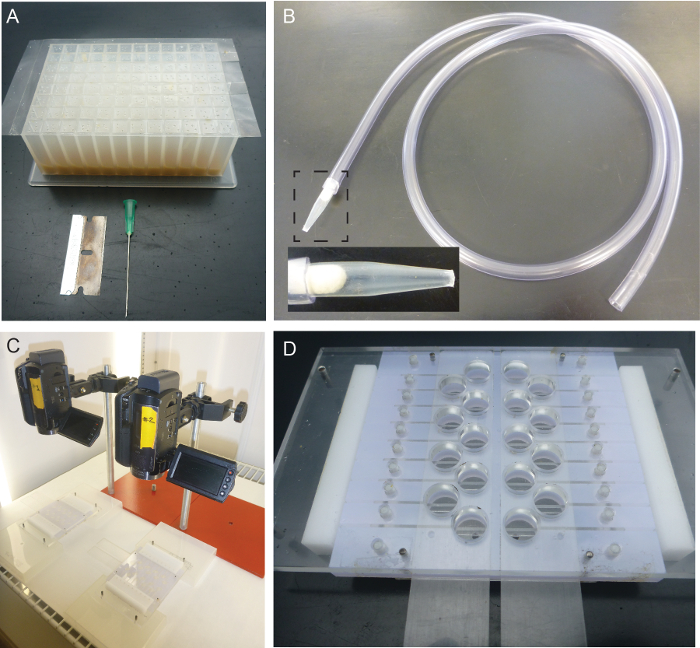
Rysunek 2: Sprzęt używany w teście warunkowania courtship u Drosophila. (A) Blok mieszkalny to płaski blok z dnem, zawierający 500 µL powerfood na każdą studzienkę. Jest on uszczelniony folią klejącą do qPCR z co najmniej 4 otworami na studzienkę, wykonanymi za pomocą igły strzykawki o średnicy 0.8 mm. Pojedyncze rzędy są przecięte wzdłuż na paski za pomocą żyletki, aby umożliwić ich otwieranie i zamykanie. (B) Aspirator jest niezbędny do delikatnego przenoszenia much samców i samic bez użycia anestezji. Wstawka pokazuje końcówkę aspiratora, zamkniętą kawałkiem waty, aby zatrzymać muchy wewnątrz końcówki. (C) Konfiguracja systemu dwóch kamer do jednoczesnego nagrywania dwóch komór courtship. (D) Komora courtship z 18 arenami. Przesuwne otwory wejściowe służą do umieszczania much w arenach. Białe przegrody można otworzyć jednocześnie, aby zainicjować interakcję między samcami a samicami. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
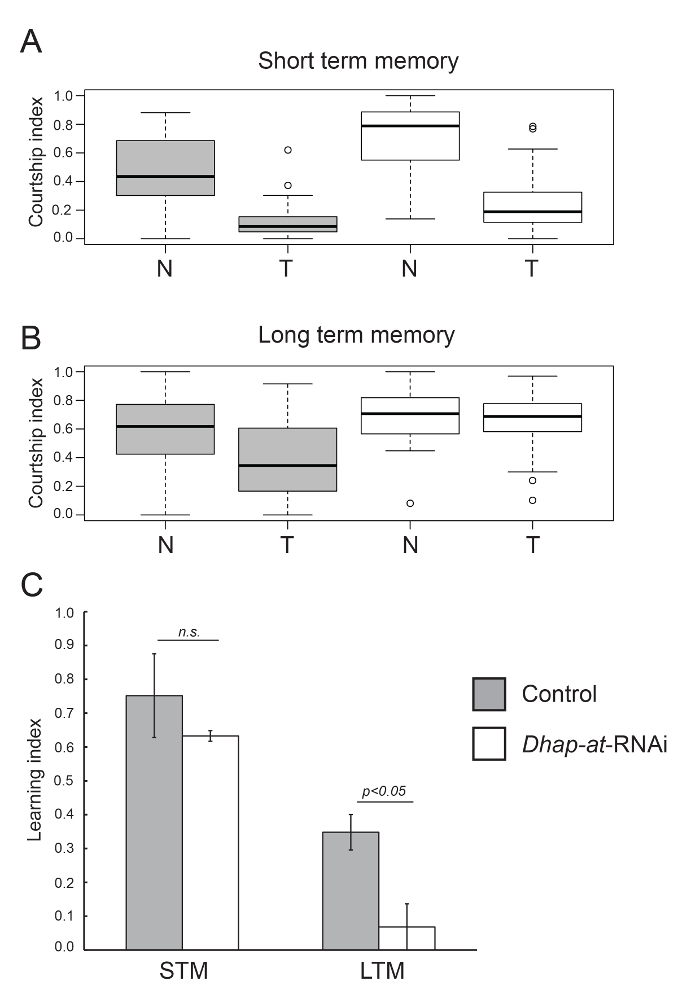
Rycina 3: Analiza pamięci krótkotrwałej (STM) i długotrwałej (LTM) u much kontrolnych oraz z wyciszeniem genu Dhap-at. (A-B) Wykresy pudełkowe przedstawiające rozkład wartości CI dla much naiwnych (N) i wytrenowanych (T) w grupie kontrolnej (szary) oraz Dhap-at badane genotypy z knockdownem (białe) w testach STM (A) i LTM (B). (C) Odpowiadające im wartości LI dla grupy kontrolnej i Dhap-at Muchy z wyciszeniem ekspresji genów (knockdown) poddano badaniu pod kątem STM i LTM. Różnice w LI pomiędzy genotypami kontrolnymi a genotypami z wyciszeniem ekspresji porównano za pomocą testu randomizacyjnego (10 000 powtórzeń bootstrap). Słupki błędów wskazują standardowy błąd średniej obliczony na podstawie wartości LI wyznaczonych w różnych dniach testów. Genotypy to: w+, UAS-dcr2/+; P{KK108109}VIE-260B/+; i elav-Gal4/+ (Kontrola) i w+, UAS-dcr2/+;P{KK101437}VIE-260B/+; oraz elav-Gal4/+ (Dhap-at-RNAi). Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
| Ogólne | Zbiór | Trening | Test | |
| dzień -11 | Rozpoczęcie hodowli w celu zbioru samic przed kopulacją (krok 1.3) | |||
| dzień -10 | Rozpoczęcie hodowli w celu zbioru samców do testów (krok 2.2) | |||
| dzień 1 | powt. 1 | |||
| dzień 2 | powt. 2 | |||
| dzień 3 | powt. 3 | |||
| dzień 4 | powt. 4 | powt. 1 | ||
| dzień 5 | powt. 2 | powt. 1 | ||
| dzień 6 | powt. 3 | powt. 2 | ||
| dzień 7 | powt. 4 | powt. 3 | ||
| dzień 8 | powt. 4 | |||
| dzień 9 | Analiza danych wideo i statystyka (krok 8) | |||
| powt. = powtórzenie | ||||
Tabela 1: Przykładowy harmonogram badania LTM w trzech powtórzeniach w osobne dni.
| Nauka | STM | LTM | |
| Czas szkolenia | 1 h. | 1 h | 8 h. |
| Czas odpoczynku | 0 h. | 1 h | ~ 24 h. |
| rozpocząć szkolenie | 0 h. ALO | 0 h. ALO | 4 h. BLO |
| zatrzymaj trening | 1 h ALO | 1 h ALO | 4 h. ALO |
| rozpocznij test | 1 h ALO | 2 h. ALO | 0 h. ALO (następnego dnia) |
| ALO = po zapaleniu świateł, BLO = przed zapaleniem świateł, STM = pamięć krótkotrwała, LTM = pamięć długotrwała | |||
Tabela 2: Czas trwania treningu, liczba powtórzeń treningowych i czasy testowania dla uczenia się, pamięci krótkotrwałej (STM) oraz pamięci długotrwałej (LTM).
| Genotyp | Nauka warunek | CI naiwny | CI przeszkolony | LI | LI różnica | Dolna granica (95% przedział ufności) | Górna granica (95% przedział ufności) | wartość p |
| Kontrola | STM | 0.467 | 0.116 | 0.752 | Brak danych | NA | ND | ND |
| Dhap-at-RNAi | STM (skaningowa mikroskopia tunelowa) | 0.699 | 0.257 | 0.633 | 0.119 | -0.030 | 0.265 | 0.116 |
| Kontrola | LTM | 0.590 | 0.384 | 0.348 | ND | NA | ND | ND |
| Dhap-at-RNAi | LTM | 0.697 | 0.650 | 0.068 | 0.280 | 0.103 | 0.446 | 0.003 |
Tabela 3: Dane statystyczne wygenerowane przez skrypt Analearn.
Dane statystyczne wygenerowane przez skrypt analearn. Plik wynikowy skryptu R do bootstrapowania zawierający genotyp, warunek uczenia (t.j. uczenie, STM lub LTM), średni CI dla grupy naiwnej, średni CI dla grupy przeszkolonej, LI, różnicę między LI grupy kontrolnej a warunkiem eksperymentalnym (LI dif), dolną granicę (LL) i górną granicę (UL) 95% przedziału ufności dla LI dif oraz wartość p wskazującą prawdopodobieństwo braku istotnej różnicy.
| Kontrola | Dhap-at-RNAi | ||||||
| Śr. CI naiwne | Śr. CI wytrenowane | LI | Śr. CI naiwne | Śr. CI wytrenowane | LI | ||
| STM | Dzień 1 | 0.300 | 0.125 | 0.584 | 0.679 | 0.239 | 0.648 |
| Dzień 2 | 0.634 | 0.107 | 0.831 | 0.720 | 0.276 | 0.617 | |
| Wszystkie dni | 0.467 | 0.116 | 0.752 | 0.699 | 0.257 | 0.633 | |
| LTM | Dzień 1 | 0.590 | 0.441 | 0.252 | 0.630 | 0.646 | -0.027 |
| Dzień 2 | 0.640 | 0.363 | 0.432 | 0.709 | 0.710 | -0.002 | |
| Dzień 3 | 0.547 | 0.349 | 0.363 | 0.738 | 0.598 | 0.190 | |
| Wszystkie dni | 0.590 | 0.384 | 0.348 | 0.697 | 0.650 | 0.068 |
Tabela 4: Wartości CI i LI uzyskane w osobnych dniach badań.
| „naivelevel” określa tekst, który będzie identyfikował wartości naiwne dla każdego genotypu. Domyślną wartością jest „N”, ale można ją zmienić na dowolny inny tekst alfanumeryczny. |
| Parametr „refmutation” ma domyślnie ustawioną wartość „NA” (nie dotyczy), ale można go zmienić na nazwę kontroli lub genotypu w celu przeprowadzenia porównań statystycznych. Dzięki temu skrypt automatycznie wybierze genotyp kontrolny. |
| "„datname” odnosi się do nazwy pliku danych i może zostać określone w tym argumencie zamiast domyślnego wyboru pliku. |
| "Parametr „header” może służyć do określenia, czy plik danych zawiera nagłówki kolumn. Wartość domyślna to „TRUE”, jednak w przypadku zmiany tego argumentu na „FALSE” można użyć pliku bez nagłówków. |
| "„seed” inicjuje generator liczb pseudolosowych. Domyślnie parametr ten jest ustawiony na „NA”, co zapewnia uzyskanie losowej liczby przy każdym uruchomieniu skryptu. Z założenia analiza bootstrapowa daje nieco inne wyniki przy każdym uruchomieniu, nawet w przypadku korzystania z tego samego pliku danych. Gdy ziarno (seed) zostanie określone jako dowolna liczba całkowita większa od zera, otrzymuje się ten sam zestaw losowych próbek bootstrapowych. |
| "Wartość „writeoutput” można ustawić na „TRUE” lub „FALSE”, aby określić, czy plik wyjściowy zostanie wygenerowany. Wartością domyślną jest „TRUE”. |
Tabela 5: Argumenty używane w funkcji Analearn, które mogą zmienić domyślne ustawienia funkcji w celu dostosowania parametrów bootstrapowania
Plik uzupełniający S1: Plan konstrukcyjny komory do kojarzenia. Plik można otworzyć w dowolnej aplikacji obsługującej rozszerzenia .stp (pliki CAD). Kliknij tutaj, aby pobrać ten plik.
Plik uzupełniający S2: Przykład pliku wejściowego dla skryptu Analearn. Aby pobrać ten plik, kliknij tutaj.
Plik uzupełniający S3: Skrypt Analearn.R. Plik można otworzyć za pomocą programu R-studio18. Kliknij tutaj, aby pobrać ten plik.
Dyskusja
Test warunkowania zalotów jest klasycznym paradygmatem analizy uczenia się i pamięci u Drosophila. Przedstawiony tutaj protokół jest zgodny z ogólną metodologią opisaną wcześniej 6,7,8,9, ale zawiera unikalne aspekty, takie jak praktyczne wytyczne, specjalistyczny sprzęt i skrypt analizy danych 9,12 dla testów randomizacyjnych. Korzystając z tego protokołu, możliwe jest równoległe analizowanie dużej liczby much przy użyciu 96-dołkowych bloków płaskodennych (ryc. 2A) w celu zbierania i trenowania samców. Bloki są uszczelnione folią samoprzylepną PCR, dzięki czemu muchy są łatwo dostępne w razie potrzeby. Dodatkowo, opisane tutaj unikalne komory zalotowe pozwalają na jednoczesne parowanie 18 par męsko-żeńskich w niemal dwuwymiarowej przestrzeni, która jest optymalna do analizy wideo. Specjalnie zaprojektowane komnaty zalotowe są łatwe w użyciu, a plan budynku jest dostarczany (plik S1, rysunek 2D). Protokół ten, od ustalenia kultur używanych do zbierania badanych do uzyskania danych wideo, trwa około 20 dni (Tabela 1). Na analizę danych wideo potrzebny jest dodatkowy czas. Z naszego doświadczenia wynika, że test STM jest niezwykle solidny. Test LTM jest również dość solidny, ale jest bardziej wrażliwy na zakłócające zmienne środowiskowe i dlatego może być trudniejszy do opanowania.
Zachowanie zwierząt może być dość zmienne. Dlatego krytyczne kroki w protokole muszą być wykonywane z ostrożnością, aby zmniejszyć tę wariancję. Po pierwsze, delikatne użycie aspiratora (Rysunek 2B) zmniejszy naprężenia, które mogą być spowodowane nieostrożnym obchodzeniem się lub zbyt silnym wydmuchiwaniem. Sugerowaną metodą przenoszenia pojedynczych much z aspiratora jest użycie geotaksji ujemnej. Ponieważ muchy mają tendencję do chodzenia w górę, można po prostu skierować końcówkę aspiratora do góry; Tuż przed tym, jak mucha dotrze do czubka, wystarczy delikatne uderzenie, aby mucha wypuściła muchę. Dodatkowo, aby wpuścić samce do komnat godowych przed testem, cios często nie jest konieczny.
Kolejnym ważnym krokiem jest zebranie i wygenerowanie męskich obiektów testowych. Wszystkie samce muszą być zbierane, gdy są bardzo młode i społecznie naiwne. Można to osiągnąć poprzez częste zbieranie w szczytowych okresach ekklonizacji (krok 5.2). Jeśli samce nie zostaną zebrane w tych napiętych ramach czasowych, mogą mieć wczesne interakcje społeczne, co może skutkować słabym uczeniem się lub dużą zmiennością implantu ślimakowego. Innym czynnikiem u mężczyzn biorących udział w testach, który powinien zostać oceniony, jest pochodzenie genetyczne. Różne tła genetyczne będą wykazywać różne poziomy naiwnych zalotów, a także mogą różnić się ogólną aktywnością lub zdolnościami lokomotorycznymi. Porównując wiele genotypów, należy zwrócić uwagę na tło genetyczne, aby uniknąć tych czynników zakłócających, które mogą wpływać na wyniki LI. Ponadto należy dokładnie ocenić rozkład danych CI. Dane CI mogą być zarówno parametryczne, jak i nieparametryczne, w zależności od genotypu lub innych czynników środowiskowych. W niektórych przypadkach, jeśli rozkład CI jest dramatycznie odchylony od rozkładu normalnego, lepszym rozwiązaniem może być użycie mediany CI zamiast średniej do obliczenia LI. Jednak z naszego doświadczenia wynika, że zastosowanie mediany lub średniej CI nie ma wpływu na statystyczną interpretację danych, a stosowanie średniej CI jest powszechną praktyką w literaturze.
Dla udanego warunkowania zalotów kluczowe znaczenie w okresie treningu ma aktywne odrzucanie prób zalotów samców przez samice preparowane. Ważne jest, aby upewnić się, że wstępnie pokryte samice użyte w tym teście zostały skutecznie kryte i w związku z tym nie pozwalają na kopulację. To krycie ustala się w fiolkach do krycia przygotowanych w kroku 4, w których samce i samice much są trzymane razem przez 4 dni (tabela 1). Następnie krycie może być monitorowane poprzez regularne oglądanie filmów testowych oraz obserwację par samiec i samica podczas treningu. Jeśli dojdzie do krycia, istnieje kilka środków, które można podjąć podczas przygotowywania samic przed kryciem. Po pierwsze, samice prekryte powinny być hodowane w optymalnych warunkach hodowlanych. Fiolki można uzupełnić pastą drożdżową i składaną bibułą filtracyjną, aby zwiększyć potencjalne powierzchnie współpracujące. Inkubacja much w opisanych tutaj warunkach doprowadziła w przeszłości do wytworzenia wytrzymałych, premfetowanych samic, ale może się to różnić w różnych laboratoriach i przy użyciu różnych szczepów genetycznych. Dlatego może być konieczne zoptymalizowanie pokolenia samic premowanych poprzez zmianę czasu i warunków inkubacji.
Kwantyfikacja zachowań związanych z zalotami jest kolejnym krytycznym krokiem w tym protokole. Można to zrobić ręcznie lub automatycznie za pomocą specjalistycznych programów9. Zautomatyzowana kwantyfikacja jest szybka i w zasadzie bezstronna. Opublikowano kilka programów 21,22,23; Nie są one jednak proste w użyciu, często wymagają specjalistycznych formatów wideo i zaawansowanych umiejętności obliczeniowych. Ręczna kwantyfikacja jest łatwa i dokładna, ale jest bardzo pracochłonna i podlega indywidualnej zmienności i odchyleniom. Należy podkreślić, że protokół ten nie spełnia wymagań dotyczących formatowania wideo, które są potencjalnie wymagane do automatycznej kwantyfikacji CI. Do ręcznej kwantyfikacji użyj dowolnego prostego urządzenia do nagrywania wideo, które ma potencjał do wytworzenia filmu o jakości wystarczającej do dokładnej obserwacji zachowania zalotów. W przypadku automatycznej kwantyfikacji prawdopodobnie będą obowiązywały różne wymagania w zależności od używanego oprogramowania, a użytkownicy powinni to dokładnie zbadać, jeśli pożądana jest automatyczna kwantyfikacja.
W połączeniu z obszernymi narzędziami, które są dostępne do genetycznej manipulacji muchami, test warunkowania zalotów zapewnia solidny odczyt, który można wykorzystać do analizy mechanizmów molekularnych i sieci neuronalnych zaangażowanych w uczenie się i pamięć.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Dziękujemy Wiedeńskiemu Centrum Zasobów Drosophila za dostarczenie szczepów Drosophila. Dodatkowo w tym badaniu wykorzystano zapasy uzyskane z Bloomington Drosophila Stock Center (NIH P40OD018537). Badania te były częściowo wspierane przez zintegrowaną sieć Gencodys do K.K., H.v.B. i A.S. w ramach 7PR Unii Europejskiej oraz przez granty NSERC Discovery i CIHR dla J.M.K.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| P{KK101437}VIE-260B | VDRC | 101437 | Dhat-at-RNAi w tle 60100 |
| P{KK108109}VIE-260B | - | - | Control-RNAi w tle 60100 (prezent od K. Kelemana) |
| w+, UAS-dcr2/yhh;; elav-Gal4 (III) < / em> | - | panneuronalna linia sterująca | |
| Pojemniki do hodowli tkanek roślinnych | VWR | 960177 | 175 ml fiolki plastikowe |
| Filtry składane | Whatman | 10311643 | Bibuła filtracyjna do powiększania powierzchni, na której muchy mogą się przepoczwarzać |
| Bloki z płaskim dnem (96 dołków) | Qiagen | 19579 | Używany do bloków mieszkalnych |
| MicroAmp Clear Adhesive Film | Applied Biosystems | 4306311 | Folia samoprzylepna PCR jako pokrywka na blokach o płaskim dnie |
| Żyletka | - | każdy ostry się nada | |
| Igła | - | średnicy 0,8 mm | |
| - | Wytnij nożyczkami końcówkę pipety o pojemności 1 ml, aby uzyskać dwie części. Wąska końcówka pipettip jest umieszczona jako wejście muchy w elastycznym wężu o długości ~80 cm. Aby zapobiec przedostawaniu się muchy do węża, między końcówką a wężem umieszcza się zwykły kawałek bawełny lub małej siatki. Druga połowa pipettip może być używana jako ustnik na końcu węża. | ||
| Komnaty zalotowe | - | plik S1 można otworzyć za pomocą wskazanego oprogramowania CAD | |
| Specyfikacja kamery | Sony | : >4 mln pikseli, Full HD. W przypadku ręcznej kwantyfikacji każde proste urządzenie do nagrywania wideo może potencjalnie wytworzyć film o jakości wystarczającej do dokładnej obserwacji zachowań związanych z zalotami. W przypadku automatycznej kwantyfikacji prawdopodobnie będą obowiązywały różne wymagania w zależności od używanego oprogramowania, a użytkownicy powinni to dokładnie zbadać, jeśli pożądana jest automatyczna kwantyfikacja. | |
| Nazwa | Firma | Numer katalogowy | Komentarze |
| power food | |||
| Agar | Sigma | A7002 | |
| Drożdże | Bruggeman-Ekstrakt | ||
| MP biomedyczny | 0210330391 | ||
| Pepton | Sigma | P6838 | |
| Sacharoza | Sigma | S9378 | |
| Glukoza | Sigma | G7021 | |
| MgSO4 | Sigma | M2643 | |
| CaCl2 | Merck | 1023780500 | |
| Methylparabene (UWAGA) | Sigma | H5501 | |
| Kwas propionowy (UWAGA) | Sigma | P1386 | |
| Demineralizowana mieszanina wody | |||
| pasty | ziaren drożdży w stosunku 1:1 | ||
| Nazwa | Firma | Numer katalogowy | Komentarze |
| normalna żywność | |||
| Agar | MP biomedyczne | 215017890 | |
| Drożdże | bruggeman-Mąka | ||
| kukurydziana | de Molen-Cukier | ||
| de | |||
| (UWAGA) | Sigma | H5501 | |
| Kwas propionowy (UWAGA) | Sigma | P1386 | |
| Woda demineralizowana | - |
Bibliografia
- Quinn, W. G., Harris, W. A., Benzer, S. Conditioned behavior in Drosophila melanogaster. Proc. Natl. Acad. Sci. USA. 71, 708-712 (1974).
- Livingstone, M. S., Sziber, P. P., Quinn, W. G. Loss of calcium/calmodulin responsiveness in adenylate cyclase of rutabaga, a Drosophila learning mutant. Cell. 37, 205-215 (1984).
- Quinn, W. G., Sziber, P. P., Booker, R. The Drosophila memory mutant amnesiac. Nature. 277, 212-214 (1979).
- Dudai, Y., Jan, Y. N., Byers, D., Quinn, W. G., Benzer, S. dunce, a mutant of Drosophila deficient in learning. Proc. Natl. Acad. Sci. USA. 73, 1684-1688 (1976).
- Dubnau, J., Tully, T. Gene discovery in Drosophila: new insights for learning and memory. Annu. Rev. Neurosci. 21, 407-444 (1998).
- Siegel, R. W., Hall, J. C. Conditioned responses in courtship behavior of normal and mutant Drosophila. Proc. Natl. Acad. Sci. USA. 76, 3430-3434 (1979).
- Kamyshev, N. G., Iliadi, K. G., Bragina, J. V. Drosophila conditioned courtship: two ways of testing memory. Learning & memory. 6, 1-20 (1999).
- McBride, S. M., et al. Mushroom body ablation impairs short-term memory and long-term memory of courtship conditioning in Drosophila melanogaster. Neuron. 24, 967-977 (1999).
- Keleman, K., Kruttner, S., Alenius, M., Dickson, B. J. Function of the Drosophila CPEB protein Orb2 in long-term courtship memory. Nature Neurosci. 10, 1587-1593 (2007).
- Hall, J. C. The mating of a fly. Science. 264, 1702-1714 (1994).
- Keleman, K., et al. Dopamine neurons modulate pheromone responses in Drosophila courtship learning. Nature. 489, 145-149 (2012).
- Kramer, J. M., et al. Epigenetic regulation of learning and memory by Drosophila EHMT/G9a. PLoS Biol. 9. 9, e1000569(2011).
- Ishimoto, H., Sakai, T., Kitamoto, T. Ecdysone signaling regulates the formation of long-term courtship memory in adult Drosophila melanogaster. Proc. Natl. Acad. Sci. USA. 106, 6381-6386 (2009).
- Kochinke, K., et al. Systematic Phenomics Analysis Deconvolutes Genes Mutated in Intellectual Disability into Biologically Coherent Modules. Am. J. Hum. Genet. 98, 149-164 (2016).
- Buchert, R., et al. A peroxisomal disorder of severe intellectual disability, epilepsy, and cataracts due to fatty acyl-CoA reductase 1 deficiency. Am. J. Hum. Genet. 95, 602-610 (2014).
- JoVE Science Education Database. Essentials of Biology 1: yeast, Drosophila and C. elegans. Drosophila Maintenance. JoVE. , Cambridge, MA. (2017).
- JoVE Science Education Database. Essentials of Biology 1: yeast, Drosophila and C. elegans. An Introduction to Drosophila melanogaster. JoVE. , Cambridge, MA. (2017).
- R Core Team. R: A Language and Environment for Statistical Computing. R Foundation for Statistical Computing. , Vienna (Austria). (2016).
- Stepien, B. K., et al. RNA-binding profiles of Drosophila CPEB proteins Orb and Orb2). Proc. Natl. Acad. Sci. USA. 113, E7030-E7038 (2016).
- Basu, D. Randomization Analysis of Experimental Data: The Fisher Randomization Test. J Am Stat Assoc. 75, 575-582 (1980).
- Dankert, H., Wang, L., Hoopfer, E. D., Anderson, D. J., Perona, P. Automated monitoring and analysis of social behavior in Drosophila. Nat Methods. 6, 297-303 (2009).
- Reza, M. A., et al. Automated analysis of courtship suppression learning and memory in Drosophila melanogaster. Fly. 7, 105-111 (2013).
- Schneider, J., Levine, J. D. Automated identification of social interaction criteria in Drosophila melanogaster. Biol. Lett. 10, 20140749(2014).
Przedruki i uprawnienia
