W przeciwieństwie do danych o sekwencjach DNA, dane epigenomiczne nie są łatwo poddawane wyszukiwaniom tekstowym. Poniżej przedstawiono procedury korzystania z ulepszonej wersji GeNemo, internetowego narzędzia bioinformatycznego, do przeprowadzania opartych na wzorcach poszukiwań podobieństw w danych epigenomicznych, porównując dostępne internetowe bazy danych, w tym Encyklopedię Elementów DNA, z danymi użytkownika.
Artykuł metodologiczny
Wyszukiwanie danych epigenomicznych w oparciu o wzorce za pomocą GeNemo
* These authors contributed equally
W tym artykule
Podsumowanie
Streszczenie
W porównaniu z solidnymi narzędziami do wyszukiwania danych genomicznych lub sekwencjonowania RNA, obecne metodologie wyszukiwania danych epigenomicznych i innych funkcjonalnych danych genomowych na podstawie wzorców są bardzo ograniczone. GeNemo to pierwsza wyszukiwarka internetowa, która osiąga ten cel. Użytkownicy wprowadzają swoje funkcjonalne dane genomiczne w formatach Browser Extensible Data (BED), Peaks i bigWig i mogą wyszukiwać dane w dowolnym z trzech formatów. Użytkownicy mogą określić, które typy zbiorów danych mają być przeszukiwane, wybierając spośród różnych zestawów danych online, przy czym Encyklopedia Elementów DNA (ENCODE) reprezentuje różne znaczniki epigenomiczne, miejsca wiązania czynników transkrypcyjnych oraz nadwrażliwość lub dostępność chromatyny w określonych typach komórek oraz etapach rozwoju lub gatunkach (myszy lub ludzi). GeNemo zwraca listę regionów genomu z wzorcami pasującymi do danych wejściowych, które można wyświetlić w przeglądarce, a także pobrać w formacie pliku BED. Zmodernizowany GeNemo ma ulepszony wyświetlacz graficzny, bardziej niezawodny interfejs i nie jest już podatny na błędy z powodu zmian w przeglądarce genomu Uniwersytetu Kalifornijskiego w Santa Cruz (UCSC). Omówiono kroki rozwiązywania typowych problemów. Ponieważ ilość funkcjonalnych danych genomicznych rośnie wykładniczo, istnieje pilna potrzeba opracowania i udoskonalenia nowych narzędzi bioinformatycznych, takich jak GeNemo, do analizy i interpretacji danych.
Wprowadzenie
Ostatnie osiągnięcia technologiczne pozwoliły na szybką ekspansję epigenomicznych lub funkcjonalnych depozytów danych genomowych, które wyprzedziły rozwój odpowiednich narzędzi analitycznych do wydobywania biologicznych spostrzeżeń. Jednym z ważnych sposobów analizy danych epigenomicznych jest przeszukiwanie danych generowanych przez użytkowników w depozytariuszach danych, a zwłaszcza tych z projektów Encyklopedii Elementów DNA (ENCODE)1 w celu dopasowania wzorców, które mogą prowadzić do nowej wiedzy. Na przykład zidentyfikowanie podobieństw we wzorcach dwóch różnych znaczników epigenomicznych w zdefiniowanych loci w całym genomie może wskazywać na skoordynowane działanie różnych graczy molekularnych na konformację chromatyny i regulację transkrypcji2,3,4.
Konwencjonalne wyszukiwarki tekstowe są nieskuteczne pod tym względem, ponieważ, w przeciwieństwie do sekwencji DNA, dane epigenomiczne istnieją głównie w formacie intensywności lub funkcjonalnych regionów genomu. GeNemo, skrót od Gene Nemo (jak od Finding Nemo), został opracowany, aby zaspokoić tę niezaspokojoną potrzebę za pomocą wyszukiwania opartego na wzorcach5. Jego algorytm wykorzystuje proces maksymalizacji Monte Carlo łańcucha Markowa5. Użytkownicy pobierają własne dane lub zestaw danych pobrany z depozytariuszy i przeszukują szereg danych epigenomicznych online, aby zidentyfikować podobieństwa we wzorcach.
Obecna wersja GeNemo ma zaktualizowany wyświetlacz, solidniej współpracuje z przeglądarką genomu Uniwersytetu Kalifornijskiego w Santa Cruz (UCSC)6, i jest mniej podatna na problemy spowodowane zmianami w tej ostatniej. W szczególności, podczas gdy strona wyników GeNemo była kiedyś oparta na interfejsie przeglądarki genomu UCSC, obecna wersja GeNemo obsługuje własną stronę wyników i w związku z tym zmiany strukturalne w przeglądarce genomu UCSC nie mają już negatywnego wpływu. GeNemo może wykorzystać dowolny sygnał genomowy, w tym wiązanie białek, modyfikację histonów, dostępność chromatyny, domeny topologiczne i tak dalej, jako zapytanie w celu znalezienia kolokalizowanych/podobnych segmentów wśród znanych zestawów danych z dużych konsorcjów. Dlatego jest to ważne narzędzie do badania związku między różnymi danymi epigenomicznymi będącymi przedmiotem zainteresowania a znanymi danymi generowanymi w ramach projektów genomicznych na dużą skalę.
Protokół
UWAGA: Protokół można w dowolnym momencie przerwać.
1. Podstawowa konfiguracja
- Pobierz plik w formacie BED, Peaks lub BigWig7 zawierający dane, które zostaną wprowadzone do Genome. Plik powinien posiadać odpowiednio rozszerzenie „bed”, „broadpeaks”, „narrowpeaks” lub „bigWig”.
UWAGA: Pliki tego typu w wersjach skompresowanych (ZIP) również będą działać. - Użyj przeglądarki internetowej, aby przejść na stronę genemo.org. Z GeNemo powinien być mógł korzystać każdy system operacyjny zdolny do uruchomienia najpopularniejszych przeglądarek internetowych.
- Wybierz gatunek, w odniesieniu do którego ma być przeprowadzone wyszukiwanie, korzystając z menu rozwijanego. Obecnie dostępne gatunki to człowiek i mysz.
- Prześlij plik użytkownika za pomocą adresu URL lub poprzez bezpośredni upload. Pliki BigWig działają wyłącznie przy metodzie przesyłania przez URL. Pliki w formacie BED i Peaks działają w obu metodach (pliki wiggle nie mogą być obecnie przesyłane jako główne dane).
2. Opcjonalna konfiguracja
- Podaj adres e-mail w odpowiednim polu, aby otrzymać wyniki wyszukiwania pocztą elektroniczną po zakończeniu operacji.
UWAGA: Przy przeszukiwaniu dużego fragmentu genomu i/lub dużej liczby ścieżek (tracków) (patrz poniżej), zaleca się podanie adresu e-mail, ponieważ wyszukiwanie może potrwać długo. Na przykład przeszukiwanie obszaru o wielkości 10 megabase zajmuje około 15 s. Link do wyników wyszukiwania zostanie wysłany na podany adres e-mail po zakończeniu procesu. Link wygaśnie po 7 dniach od zakończenia wyszukiwania. - Podaj plik bigwig lub plik wyświetlania wiggle (może pochodzić z adresu URL). Plik wyświetlania nie wpłynie na wyniki; zostanie on jedynie pokazany obok wyników.
- Określ zakres wyszukiwania (w tym chromosom oraz pozycje par zasad) w odpowiednim polu.
- Wymień chromosom, początkową i końcową parę zasad.
- W formacie chromosomu użyj 'chrN', gdzie 'N' oznacza numer/literę chromosomu (1, 2, … X lub Y). W przypadku par zasad wpisz po prostu liczby.
- Wprowadź spacje między wszystkimi trzema wpisami lub użyj dwukropka (:) pomiędzy numerem chromosomu a pierwszą parą zasad i/lub myślnika pomiędzy dwiema parami zasad. Na przykład: chr1:100-200, chr1 100 200, chr1 10-20, chr1:100 200.
UWAGA: Kroki 2.1 - 2.3 są opcjonalne.
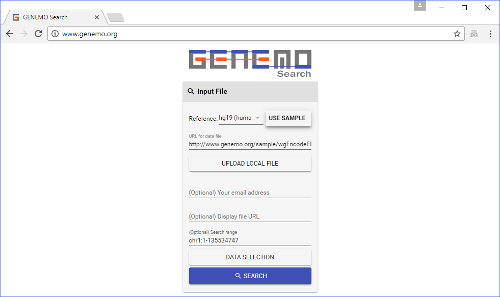
Rysunek 1Strona główna GeNemo z wypełnionymi niezbędnymi polami. Użytkownik musi wprowadzić gatunek, plik wyszukiwania i zakres wyszukiwania oraz wybrać ścieżki, w których chce przeprowadzić wyszukiwanie. Adres e-mail oraz plik wyświetlania są opcjonalne. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
3. Wybór danych
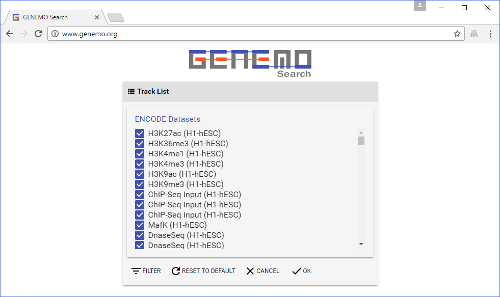
Rysunek 2Okno wyboru ścieżki. Okno to pojawia się po kliknięciu przycisku „DATA SELECTION” na stronie głównej. W tym miejscu użytkownicy wybierają ścieżki, z którymi ma zostać porównany plik wejściowy. Niektóre ścieżki są zaznaczone domyślnie. Proszę kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
- Po kliknięciu przycisku wyboru danych wybierz, przeciwko jakim typom ścieżek (tracks) ma zostać przeprowadzone wyszukiwanie (t.j. które dodać do zapytania). Kolekcja ścieżek obejmuje wiele różnych zestawów danych z laboratoriów z całego świata.
- Ponieważ lista ścieżek jest dość długa, użytkownicy mogą chcieć skorzystać z przycisku filtra (na górze), aby ułatwić wybór ścieżek. Ścieżki można filtrować według Eksperymentu, Tkanki, Linii komórkowej i/lub Laboratorium.
- Na dole znajduje się pięć przycisków pomagających w wyborze ścieżek: Zaznacz wszystko (Select All), Odznacz wszystko (Select None), Dodaj (Add), Filtruj (Filter), Wyklucz (Exclude).
- Funkcje „Zaznacz wszystko” oraz „Odznacz wszystko” są oczywiste.
- Przycisk „Dodaj” dodaje aktualnie zaznaczone ścieżki do zapytania. Pełni on funkcję bramki logicznej „LUB”. Należy pamiętać, że wybranie filtrów powyżej (np. konkretnych Eksperymentów, Tkankek, Linii komórkowych lub Laboratoriów) nie dodaje automatycznie odpowiadających im ścieżek do zapytania wyszukiwania. Użytkownicy muszą najpierw zaznaczyć ścieżki (np. mózg, wątroba w sekcji tkanek), a następnie kliknąć przycisk „Dodaj”, aby dodać je do zapytania. Podczas wyboru ścieżek należy zwrócić uwagę, że do zapytania wyszukiwania zostaną zastosowane tylko filtry określone w otwartej karcie okna filtrów. Wybory w innych kartach zostaną zapisane w oknie filtrów, ale nie zostaną zastosowane do zapytania wyszukiwania.
- Przycisk „Filtruj” pozostawia w zapytaniu tylko te typy ścieżek, które są aktualnie zaznaczone w oknie filtrów, i usuwa wszystkie pozostałe typy ścieżek. Pełni on funkcję bramki logicznej „I”. W zasadzie funkcja „Filtruj” pozwala na wybór interakcji między dwiema kategoriami ścieżek (np. konkretnymi tkankami i konkretnymi Laboratoriami). Należy pamiętać, że funkcja „Filtruj” nie dodaje wybranych typów ścieżek do zapytania, jeśli nie znajdują się one już w zapytaniu.
- Przycisk „Wyklucz” usuwa z zapytania wszystkie typy ścieżek, które są aktualnie zaznaczone w oknie filtrów. Pełni on funkcję bramki logicznej „NIE”, przeciwnie do funkcji „Filtruj”. Podobnie funkcja „Wyklucz” nie dodaje do zapytania żadnych ścieżek, które nie są aktualnie zaznaczone w oknie filtrów.
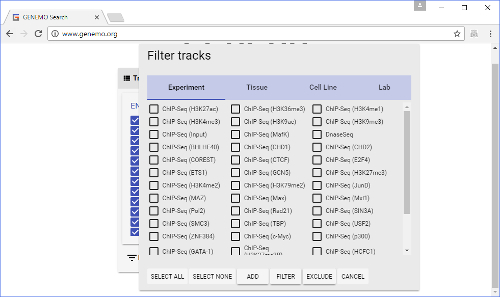
Rycina 3Okno filtrowaniaOpcję tę wywołuje się, klikając przycisk „FILTER” w oknie wyboru ścieżek (Track selection). Użytkownicy mogą tutaj z łatwością wybrać wiele ścieżek jednocześnie. Aby wyświetlić powiększoną wersję tej ryciny, kliknij tutaj.
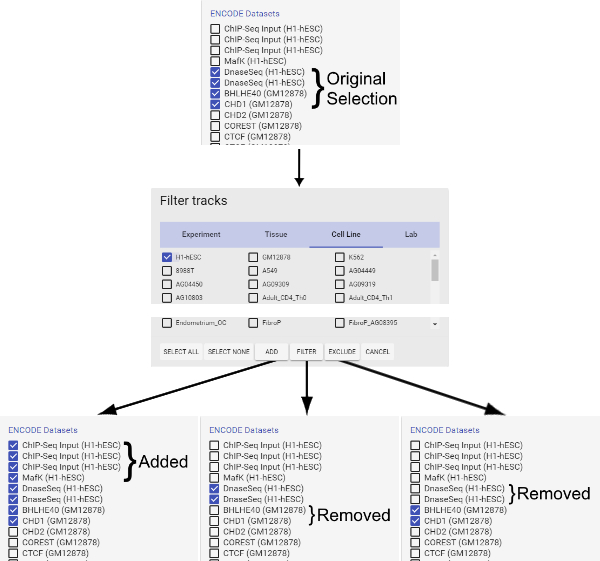
Rycina 4Jak korzystać z funkcji filtrowania. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
- Po dodaniu wybranych ścieżek do zapytania, kliknij przycisk „Update” w prawym dolnym rogu. Jest to konieczne, aby umożliwić dwie metody wyboru danych: wybór poszczególnych ścieżek danych lub filtrowanie/wykluczanie. Przycisk „Reset View” przywraca zapytanie do domyślnych ścieżek związanych z regulacją ekspresji genów w ludzkich i mysich embrionalnych komórkach macierzystych.
UWAGA: Wybór ścieżek do przeszukiwania za pomocą funkcji „Data selection” jest opcjonalny, ale zalecany, ponieważ domyślne ścieżki wyszukiwania prawdopodobnie nie będą odpowiadać potrzebom użytkownika.
4. Wyszukiwanie i wyniki
- Po wybraniu danych kliknij przycisk „Search”. Wyszukiwanie może zająć chwilę.
- Po zakończeniu wyszukiwania na stronie wyników (Results page) pojawią się różne ramki. Każda ramka reprezentuje sekcję genomu, w której plik danych użytkownika wykazuje wzorzec ściśle pasujący do jednej lub więcej ścieżek (tracks), które zostały wyszukane.
- Jeśli żadne ramki nie są widoczne, spróbuj wyszukać więcej typów ścieżek lub zwiększyć zakres wyszukiwania przy użyciu tego samego pliku wejściowego. Prostym sposobem na zrobienie tego bez powtarzania całej procedury jest kliknięcie przycisku „☰” obok logo. Otworzy to pasek boczny, który umożliwia modyfikację wyszukiwania.
- Wyniki można wyeksportować jako plik BED, klikając przycisk „DOWNLOAD BED FILE” na dole strony wyników.
- Aby zwizualizować wyniki, kliknij przycisk Visualize w prawym górnym rogu każdej ramki.
- W panelu wizualizacji po prawej stronie wyświetlane są różne elementy, w tym dane, które obejmują plik wejściowy użytkownika, plik wyświetlania (jeśli został podany), pasujące ścieżki oraz niektóre ścieżki domyślne. Na podstawie wyników użytkownik może porównać znane zestawy danych ENCODE z dostarczonym zbiorem danych w celu dalszej analizy. Użytkownik może również odwołać się do genów UCSC, aby zobaczyć kontekst wyników zapytania. Jeśli wybrano ścieżki z wielu linii komórkowych lub tkanek, użytkownik może wykorzystać takie wyniki do uzyskania informacji na temat specyficzności tkankowej podobieństw między podanym zestawem danych a zbiorami danych ENCODE.
- Na stronie wyników użytkownik może przeciągać dowolne ścieżki, aby przesuwać się w górę lub w dół strumienia genomu; gdy kursor myszy znajduje się nad współrzędnymi, użytkownik może korzystać z kółka myszy i/lub funkcji przybliżania i oddalania.
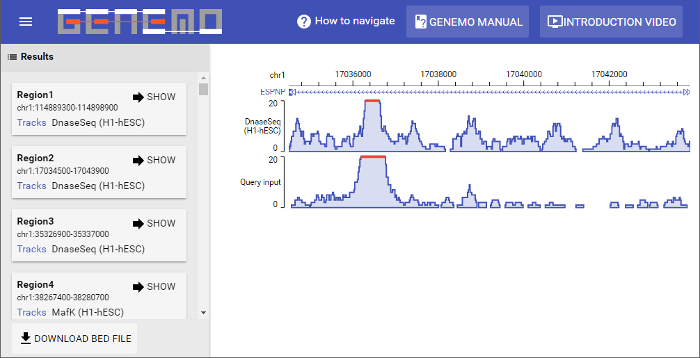
Rycina 5Strona z wynikamiTo konkretne wyszukiwanie zwróciło 363 pasujących regionów. Wyświetlenie pierwszego pasującego regionu można zrealizować, klikając przycisk „SHOW” w lewym dolnym rogu każdego pola z wynikiem. W lewej części okna wyświetlania widać, że dwa pliki danych (wejściowy i wybrany ścieżką) wykazują podobny wzorzec natężenia sygnału. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Wyniki
Pokazane tutaj w Rysunek 5 to symulowane wyszukiwanie. Wybrano gatunek ludzki, a odpowiadający mu plik próbki użyto jako pliku danych wejściowych. Ponadto wybrano domyślne ścieżki, jak widać w Rysunek 3. W sumie były 363 pasujące regiony, a pierwszy region jest wyświetlany na stronie wyświetlania. Można zauważyć, że wzorzec intensywności od podstawy 17036000 do 17038000 na chromosomie 1 dla pliku wejściowego i jednej z wybranych ścieżek jest bardzo podobny.
Dyskusja
Dogłębne zrozumienie epigenomu jest konieczne, aby osiągnąć pełny potencjał sekwencjonowania ludzkiego genomu w dostarczaniu nowych informacji biologicznych8. Obecnie istnieją tylko sposoby przeszukiwania internetowych zbiorów danych epigenomicznych według ich opisu danych i tytułu (tj. metadanych)1. To poważnie ogranicza rodzaje poszukiwań, które można przeprowadzić z danymi epigenomicznymi. Oparte na wzorcach narzędzia wyszukiwania danych epigenomicznych są niezbędne do badania relacji między różnymi znacznikami epigenomicznymi, co może prowadzić do nowych spostrzeżeń biologicznych. GeNemo, który wyszukuje według zawartości danych, a nie metadanych, jest pierwszą tego rodzaju usługą porównującą wzorce w danych epigenomicznych z opublikowanych depozytariuszy, takich jak baza danych ENCODE, z wygenerowanym przez użytkownika lub pobranym zbiorem danych5. Oznacza to początek dostępności narzędzia do wyszukiwania epigenomicznego, które jest szeroko dostępne dla naukowców na całym świecie, podobnie jak narzędzie do wyszukiwania sekwencji oparte na tekście stało się powszechnie dostępne w latach 90. Obecnie nie ma alternatywy dla opartych na wzorcach narzędzi wyszukiwania danych epigenomicznych online innych niż GeNemo.
Jednym z potencjalnych przykładów wykorzystania GeNemo jest wyszukiwanie współpojawiających się modyfikacji histonów i innych znaczników epigenetycznych z czynnikiem transkrypcyjnym E2F6 w ludzkich embrionalnych komórkach macierzystych (przykładowy plik sygnału wiązania E2F6 jest dostępny na portalu danych ENCODE lub pod adresem https://sysbio.ucsd.edu/public/xcao3/ENCODESample/ENCFF001UBC.bed). Używając tego pliku jako zapytania do wyszukiwania wszystkich zestawów danych ENCODE w H1-hESC, GeNemo pokaże, że sygnał wiązania E2F6 jest silnie wzbogacony o H3K4me1, H3K4me2, H3K4me3 i H3K27me3, co zgadza się z istniejącymi badaniami pokazującymi, że E2F6 reguluje niektóre geny poprzez metylację H3K279. Z drugiej strony wydaje się, że istnieje kolokalizacja miejsc wiązania E2F6 i CtBP2, o których wiadomo, że wchodzą w interakcje z czynnikiem z tej samej rodziny, E2F710. Te wyniki dla całego genomu w odniesieniu do dużej liczby znaczników epigenetycznych, sygnałów wiązania czynników transkrypcyjnych i innych sygnałów zawartych w ENCODE można dość łatwo uzyskać za pomocą GeNemo, który może dostarczyć wszystkich potencjalnych celów do dalszej analizy.
Od czasu pierwszej publikacji5 GeNemo jako internetowego narzędzia do wyszukiwania danych epigenomicznych, sekcja Wyniki GeNemo została zaktualizowana tak, aby wyglądała podobnie jak strona główna GeNemo. Stara sekcja wyników ściśle odzwierciedlała sekcję wyników przeglądarki genomu UCSC i była w dużej mierze zależna od zdalnego serwera UCSC do wyświetlania. Dzięki nowemu interfejsowi GeNemo jest bardziej przyjazny dla użytkownika i nie jest już zależny od serwera genomu UCSC (mimo że dane są nadal pobierane zdalnie). To sprawia, że GeNemo jest bardziej niezawodne i mniej podatne na problemy spowodowane zmianami w kodzie na serwerze UCSC. Co więcej, nowy, szybszy polimerowy interfejs GeNemo daje użytkownikowi więcej narzędzi do wizualizacji i analizy wzorców w danych.
Krytyczne kroki obejmują dostarczenie odpowiedniego pliku wejściowego i wybranie ścieżek danych do wyszukiwania. Zdecydowanie zachęca się użytkowników do eksperymentowania z różnymi funkcjami wyboru ścieżek, aby zapoznać się z procesem wyboru i tym, jak można łączyć różne polecenia, aby osiągnąć zamierzony wynik. W szczególności należy pamiętać, że funkcja "Dodaj" jest wymagana do dodania żądanych ścieżek wybranych do zapytania, podczas gdy "Filtruj" lub "Wyklucz" mogą być używane jako polecenia bramki logicznej odpowiednio "AND" i "OR". Funkcja "Aktualizuj" jest wymagana, aby wpłynąć na wszystkie wybory przed wdrożeniem wyszukiwania. Gdy nie zostaną zwrócone żadne wyniki, użytkownik może sprawdzić plik danych wejściowych, wyszukać więcej ścieżek lub zwiększyć zakres wyszukiwania. Za każdym razem, gdy wystąpi błąd, pojawi się okno definiujące, na czym dokładnie polega błąd. Jest jednak kilka niejednoznacznych błędów. Na przykład, gdy w oknie pojawia się komunikat "nie przesłano żadnego pliku", oznacza to, że albo żaden plik nie został przesłany, albo przesłany plik nie miał akceptowalnego formatu, a w konsekwencji program nie był w stanie poprawnie go odczytać. Dopuszczalne formaty plików do przesyłania plików to format BED i Peaks file dla obu metod przesyłania oraz bigWig tylko dla przesyłania linków online. Dopuszczalne są również spakowane wersje tych formatów plików.
Obecne ograniczenia tego podejścia obejmują jeszcze niezoptymalizowane algorytmy i funkcje stosowane w GeNemo. GeNemo nie może jeszcze udzielić żadnych wskazówek dotyczących interpretacji jakichkolwiek zwróconych zestawów danych. Zadanie to leży w gestii użytkowników, co wymaga znacznej wiedzy i doświadczenia w zakresie biologii genomu i epigenomu. Ponadto kolejnym obecnym ograniczeniem jest to, że użytkownicy nie mogą zmieniać czułości i poziomu szumów wyszukiwania. Oczekujemy, że w przyszłości będziemy nadal ulepszać i rozszerzać GeNemo w zakresie możliwości wyszukiwania wzorców i zbierania zestawów danych.
Oświadczenia
Autorzy nie mają żadnych konkurencyjnych interesów finansowych do ujawnienia.
Podziękowania
Ta praca była wspierana przez granty NIH, w tym DP1HD087990 z NICHD, R01HG008135 z NHGRI. Dziękujemy członkom laboratorium Zhong za cenne opinie.
Wkład autora:
X.C. i A.T.Z. zaktualizowali GeNemo, kodując nowy interfejs i funkcje; A.T.Z. wyprodukowało próbkę wideo we własnym zakresie; A.T.Z., X.C i S.Z. napisali artykuł.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| GENEMO | https://www.genemo.org | Przeglądarka Epigenomu Porównawczego |
Bibliografia
- The ENCODE Project Consortium. An integrated encyclopedia of DNA elements in the human genome. Nature. 489, 57-74 (2012).
- Barski, A., et al. High-Resolution Profiling of Histone Methylations in the Human Genome. Cell. 129 (4), 823-837 (2007).
- Meaney, M. J., Ferguson-Smith, A. C. Epigenetic regulation of the neural transcriptome: the meaning of the marks. Nature Neuroscience. 13, 1313-1318 (2010).
- Roh, T. -Y., Cuddapah, S., Cui, K., Zhao, K. The genomic landscape of histone modifications in human T cells. PNAS. 103 (43), 15782-15787 (2006).
- Zhang, Y., Cao, X., Zhong, S. GeNemo: a search engine for web-based functional genomic data. Nucleic Acids Res. 44, W122-W127 (2016).
- Fujita, P. A., Rhead, B., Zweig, A. S., Hinrichs, A. S., Karolchik, D., Cline, M. S., Goldman, M., Barber, G. P., Clawson, H., Coelho, A., et al. The UCSC Genome Browser database: update 2011. Nucleic Acids Res. 39, 876-882 (2011).
- Neph, S., Vierstra, J., Stergachis, A. B., Reynolds, A. P., Haugen, E., Vernot, B., Thurman, R. E., John, S., Sandstrom, R., Johnson, A. K., et al. An expansive human regulatory lexicon encoded in transcription factor footprints. Nature. 489, 83-90 (2012).
- Sarda, S., Hannenhalli, S. Next-generation sequencing and epigenomics research: a hammer in search of nails. Genomics Inform. 12 (1), 2-11 (2014).
- Storre, J., et al. Silencing of the Meiotic Genes SMC1β and STAG3 in Somatic Cells by E2F6. J Biol Chem. 280, 41380-41386 (2005).
- Liu, B., Shats, I., Angus, S. P., Gatza, M. L., Nevins, J. R. Interaction of E2F7 Transcription Factor with E2F1 and C-terminal-binding Protein (CtBP) Provides a Mechanism for E2F7-dependent Transcription Repression. J Biol Chem. 288, 24581-24589 (2013).
Przedruki i uprawnienia
