Ten protokół przedstawia podejście do analizy całego transkryptomu z zarodków danio pręgowanego, larw lub posortowanych komórek. Obejmuje izolację RNA, analizę szlaku danych RNASeq oraz walidację zmian ekspresji genów opartą na qRT-PCR.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Przygotowanie próbki i analiza danych dotyczących ekspresji genów opartych na RNASeq od danio pręgowanego
* These authors contributed equally
W tym artykule
Podsumowanie
Streszczenie
Analiza globalnych zmian ekspresji genów jest cennym narzędziem do identyfikacji nowych szlaków leżących u podstaw obserwowanych fenotypów. Danio pręgowany jest doskonałym modelem do szybkiej oceny całego transkryptomu z całych zwierząt lub pojedynczych populacji komórek ze względu na łatwość izolacji RNA od dużej liczby zwierząt. W artykule przedstawiono protokół globalnej analizy ekspresji genów w zarodkach danio pręgowanego z wykorzystaniem sekwencjonowania RNA (RNASeq). Opisujemy otrzymywanie RNA z całych zarodków lub z populacji komórek uzyskanych za pomocą sortowania komórek u zwierząt transgenicznych. Opisujemy również podejście do analizy danych RNASeq w celu identyfikacji wzbogaconych szlaków i terminów ontologii genów (GO) w globalnych zestawach danych dotyczących ekspresji genów. Na koniec udostępniamy protokół walidacji zmian ekspresji genów za pomocą ilościowej reakcji PCR z odwrotną transkryptazą (qRT-PCR). Protokoły te mogą być wykorzystywane do analizy porównawczej zestawów kontrolnych i eksperymentalnych danio pręgowanego w celu identyfikacji nowych zmian ekspresji genów i zapewnienia molekularnego wglądu w fenotypy będące przedmiotem zainteresowania.
Wprowadzenie
Analiza porównawcza globalnej ekspresji genów jest cennym narzędziem do identyfikacji nowych genów przyczyniających się do obserwowanych fenotypów. Takie analizy zazwyczaj opierają się na ilościowej ocenie obfitości transkryptów w porównaniu między próbkami eksperymentalnymi i kontrolnymi. Podejścia celowane, takie jak qRT-PCR, są stosunkowo szybkie i dokładne w badaniu zmian ekspresji pojedynczych genów. Sekwencjonowanie RNA (RNASeq) oferuje szerokie, wolne od hipotez podejście do identyfikacji istotnych zmian w ekspresji genów między próbkami, co czyni je obecnie standardem dla takich badań w systemach eksperymentalnych.
Danio pręgowany stał się ważnym modelem w wielu obszarach chorobowych. Pierwotnie opracowane ze względu na ich użyteczność w badaniach biologii rozwoju, ze względu na ich wysoką płodność i stosunkowo niskie koszty utrzymania, eksperymentalne zastosowanie danio pręgowanego ewoluowało, obejmując szeroki zakres fenotypów od stadium embrionalnego do dorosłego, a także szeroki wachlarz testów molekularnych1,2,3. Rzeczywiście, te zalety sprawiają, że badania mechanistyczne molekularne są szybkie i opłacalne ze względu na łatwość pozyskiwania dużych ilości materiału w połączeniu z łatwością manipulacji zarówno genetycznej, jak i środowiskowej na wszystkich etapach życia. Co więcej, przezroczysta natura zarodków i larw danio pręgowanego sprawia, że idealnie nadaje się do generowania specyficznych dla komórek i tkanek transgenicznych linii reporterowych, umożliwiając wizualizację in vivo dyskretnych populacji komórek4. Wykorzystanie takich linii pozwala na globalną analizę ekspresji genów w określonych izolowanych typach komórek w oparciu o ekspresję genu reporterowego.
Tutaj prezentujemy kompleksowy protokół globalnej analizy ekspresji genów za pomocą RNASeq po hodowli zarodków danio pręgowanego. Eksperymentalne manipulacje genetyczne, w tym przejściowe knockdown genu oparte na morfolinie (MO) lub edycja genomu za pośrednictwem CRISPR, zostały przedstawione w innym miejscu5,6,7. Dlatego skupiamy się na szczegółowym protokole izolacji RNA z całych zarodków lub posortowanych transgenicznych komórek wykazujących ekspresję reportera, a następnie na prostej analizie obliczeniowej wyników RNASeq przy użyciu narzędzi szlaku i terminów ontologii genów (GO). Na koniec dołączyliśmy strategię walidacji zmian ekspresji genów za pomocą ilościowej PCR z odwrotną transkryptazą (qRT-PCR). Protokoły te mają zastosowanie do zarodków danio pręgowanego poddanych szerokiemu zakresowi warunków eksperymentalnych, w tym porównaniu mutantów genetycznych lub warunków środowiskowych.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Wszystkie opisane poniżej protokoły dotyczące zwierząt są zgodne z wytycznymi i zostały zatwierdzone przez Instytucjonalny Komitet ds. Opieki i Wykorzystania Zwierząt (IACUC) Uniwersytetu Maryland.
1. Przygotowanie embrionów
- Pozyskiwanie embrionów poprzez naturalne rozmnażanie
- Hodować embriony do 3 miesiąca życia, do osiągnięcia dojrzałości rozrodczej5,8.
- Wieczorem przed zbiorem embrionów odseparować dorosłe ryby płci męskiej i żeńskiej z pożądanego szczepu do podzielonych zbiorników rozrodczych, umieszczając w każdym zbiorniku 2 samce i 3 samice.
UWAGA: Zastosowanie transgenicznego szczepu z fluorescencyjnym reporterem insulin2a:mCherry umożliwiło analizę komórek β trzustki. - Przenieść ryby do zbiornika rozrodczego ze świeżą wodą systemową i usunąć przegrodę natychmiast po zapaleniu świateł następnego ranka.
- Pozostawić ryby do naturalnego rozrodu, aż w dolnym zbiorniku pojawią się embriony. Zbierać embriony w odstępach 30 min, aż do uzyskania pożądanej ilości. Przechowywać każdą partię zebraną w danym czasie w osobnych szalkach Petri z medium dla embrionów w temperaturze 28.5 °C.
- W razie potrzeby przeprowadzić mikroiniekcję materiału genetycznego lub umieścić embriony w eksperymentalnym medium hodowlanym6, a następnie hodować embriony w świeżym medium Hank's dla embrionów8 w 10-cm szalkach Petri w temperaturze 28.5 °C.
UWAGA: W przypadku analizy ekspresji genów u zwierząt z wstrzykniętym morfolino (MO) lub mutantów należy pamiętać, że każda manipulacja może mieć przypadkowy wpływ na ekspresję genów. Mutanty mogą wykazywać kompensację genetyczną na poziomie transkrypcji, której nie obserwuje się przy celowaniu w geny za pomocą MO9.
- Oznaczanie stadiów rozwojowych embrionów
- Hodować embriony w grupach po 50–75 embrionów na 10-cm szalkę Petri, aby zapewnić jednolity czas rozwoju wszystkich embrionów.
- Monitorować morfologię rozwojową za pomocą mikroskopu stereoskopowego w stadiach blastomerów, epiboli i somitów, aby upewnić się co do postępu rozwoju10.
UWAGA: Usuwać wszelkie obumierające lub zdeformowane embriony, aby zapobiec opóźnieniu rozwoju w szalce. - Rozdzielić embriony na podstawie wieku rozwojowego. Określać wiek embrionu na podstawie liczby somitów po segmentacji (po gastrulacji, od 10.33 h po zapłodnieniu (hpf)) aż do około 24 hpf. Oznaczać stadia embrionów i larw na podstawie całkowitej długości ciała po 24 hpf.
UWAGA: Somity to mesodermalna tkanka w kształcie grotu strzały, znajdująca się w części grzbietowej embrionu. - Umieścić posortowane embriony w inkubatorze w temperaturze 28.5 °C i pozwolić na rozwój do pożądanego wieku.
2. Dysocjacja pojedynczych komórek: cały zarodek i posortowane populacje komórek
- Dysocjacja całych embrionów
- Uśmierć embriony zebrafish na pożądanym etapie rozwoju, umieszczając szalkę Petriego na lodzie na 5-15 min, aż do całkowitego ustania ruchu.
- Przenieś grupę 20 embrionów do oznakowanej probówki mikrocentryfugowej o pojemności 1,5 mL. Usuń nadmiar pożywki do embrionów z probówki.
- Dodaj 200 µL odczynnika lizującego (patrz Tabela materiałów) do probówki z embrionami. Homogenizuj embriony w odczynniku lizującym mechanicznie za pomocą tłuczka. Dodaj 800 µL odczynnika lizującego, aby uzyskać całkowitą objętość 1 mL. Przechowuj w temperaturze -80 °C do czasu ekstrakcji RNA.
- Izolacja komórek metodą sortowania przepływowego11
- Przenieś embriony z szalki Petriego do probówki mikrocentryfugowej o pojemności 1,5 mL i usuń jak największą ilość pożywki do embrionów.
UWAGA: W zależności od wieku embrionów na tym etapie może być wymagana dysocjacja mechaniczna. W przypadku embrionów > 48 hpf zaleca się użycie tłuczka w celu naruszenia integralności embrionów przed przejściem do kolejnych kroków. - Inkubuj embriony z 1 mL buforu do dysocjacji 1 (patrz Tabela materiałów) w probówce mikrocentryfugowej 1,5 mL. Inkubuj przez 15-30 min w temperaturze pokojowej. Trituruj roztwór, delikatnie pipetując go w górę i w dół za pomocą końcówki P1000, mieszając co 3-4 min podczas etapu inkubacji. NIE UŻYWAĆ MIKSERA WIRUJĄCEGO (VORTEX).
- Zbierz embriony poprzez wirowanie przez 3 min przy 300 x g i usuń nadsącz. Ponownie zawieś embriony w 1 mL buforu do dysocjacji 2 (patrz Tabela materiałów). Inkubuj przez 15-30 min w temperaturze pokojowej, regularnie triturując pipetą.
- Oceń stopień trawienia, rozcieńczając 1-2 µL zawiesiny w buforze do sortowania komórek metodą FACS (fluorescence-activated cell sorting) i obserwując pod mikroskopem.
UWAGA: Pełne trawienie następuje, gdy badana alikwota wykazuje obecność pojedynczych komórek przy minimalnej liczbie skupisk komórkowych i fragmentów tkanki embrionalnej. - Zbierz komórki poprzez wirowanie przy 300 x g przez 5 min. Usuń nadsącz. Ponownie zawieś komórki w 1 mL buforu FACS i przefiltruj grawitacyjnie przez sitko komórkowe 40 µm, aby usunąć z próbki nietrawioną tkankę.
- Policz komórki za pomocą hemocytometru i rozcieńcz buforem FACS do stężenia około 1x 10⁶ komórek/mL w probówce do FACS.
UWAGA: Dla typów komórek występujących w relatywnie niewielkiej liczbie w jednym embrionie (mniej niż 5% całości), takich jak komórki β trzustki, należy użyć minimum 1000 embrionów na tym samym etapie rozwoju. - Przekaż do laboratorium sortowania FACS probówki zawierające 1 mL próbek zawiesiny komórkowej, a także probówkę FACS zawierającą tylko odczynnik lizujący lub bufor FACS. Ustaw bramkowanie (gate) sortownika FACS tak, aby zbierać tylko pojedyncze komórki wykazujące ekspresję fluorescencyjnego reportera.
- Przeprowadź sortowanie przepływowe FACS do momentu zebrania pożądanej liczby komórek.
UWAGA: Do przeprowadzenia RNASeq wymagana jest minimalna ilość całkowitego RNA. Ustalono, że 3000-5000 komórek jest wystarczające do izolacji wysokiej jakości RNA o wysokim stężeniu. - Przechowuj zebrane komórki na lodzie i niezwłocznie przystąp do przygotowania RNA.
- Przenieś embriony z szalki Petriego do probówki mikrocentryfugowej o pojemności 1,5 mL i usuń jak największą ilość pożywki do embrionów.
3. Przygotowanie RNA
- Izolacja RNA
- Inkubować zebraną próbkę (z kroku 2) z odczynnikiem lizującym przez 5 min w temperaturze pokojowej.
- Dodać 0,2 mL chloroformu na każdy 1,0 mL użytego odczynnika lizującego i odwrócić probówki ręcznie przez 15 s. Inkubować przez 2-3 min w temperaturze pokojowej. Wirować próbki przy 12,000 x g przez 15 min w temperaturze 4 °C.
- Przenieść oddzieloną fazę wodną do nowej probówki i dodać 0,5 mL izopropanolu na każdy 1,0 mL użytego odczynnika lizującego. Inkubować przez 10 min w temperaturze pokojowej. Wirować próbki przy 12,000 x g przez 10 min w temperaturze 4 °C.
- Przemyć 75% etanolem i wirować próbki przy 7,500 x g przez 5 min w temperaturze 4 °C. Całkowicie usunąć nadsącz i pozostawić do wyschnięcia w temperaturze pokojowej. Ponownie zawiesić RNA w 15-30 µL wody traktowanej diethylopyrokarbonianem (DEPC).
- Oczyszczanie wysokiej jakości RNA
- Połączyć zawiesinę RNA z 1/10 objętości 3M octanu sodu (pH 5,5) oraz 1 objętością izopropanolu. Inkubować przez 20 min w temperaturze pokojowej i wirować próbki przy 12,500 x g przez 10 min w temperaturze 4 °C.
- Przemyć osad lodowatym 70% etanolem w wodzie traktowanej DEPC i wirować próbki przy 10,000 x g przez 5 min w temperaturze 4 °C. Powtórzyć etap przemywania raz.
- Usunąć nadsącz i pozostawić do wyschnięcia w temperaturze pokojowej. Ponownie zawiesić w wodzie traktowanej DEPC.
- Oznaczyć stężenie (ng/µL) i czystość (stosunek 260/230) wyizolowanego RNA za pomocą spektrometru absorpcyjnego. Przed przystąpieniem do RNASeq upewnić się, że wartość 260/230 wynosi ok. 2,0. Przechowywać w temperaturze -80 °C do momentu użycia (do 6 miesięcy).
- Przekazać próbki RNA do dostawcy usług lub centrum sekwencjonowania w celu przeprowadzenia RNASeq i analizy zmian ekspresji genów na podstawie kwantyfikacji odczytów sekwencyjnych. Wyniki otrzymane od dostawcy są zazwyczaj przedstawiane jako lista genów wykazujących istotną zmianę krotności (fold-change) w odczytach transkryptów pomiędzy próbkami.
UWAGA: W przypadku uzyskania RNA słabej jakości powyższą metodą można zastosować chromatografię kolumnową. Ilość, stężenie i wskaźnik integralności RNA (RIN) dla próbek RNA powinny zostać potwierdzone z dostawcą lub centrum sekwencjonowania. Dostawca lub centrum zazwyczaj ocenia również RIN.
4. Analiza szlaków i terminów GO
UWAGA: Przedstawiony na Rysunku 1 jest reprezentatywny wynik analizy ekspresji genów po sekwencjonowaniu RNASeq wykonanym przez jednostkę wsparcia badawczego lub dostawcę.
- Sortowanie genów różnicowo wyrażonych
- Porównanie pojedynczego warunku eksperymentalnego z kontrolą
- Otwórz dane (wyniki) w oprogramowaniu do zarządzania arkuszami kalkulacyjnymi (patrz Tabela materiałów).
- W arkuszu zawierającym geny różnicowo wyrażone w warunku eksperymentalnym w porównaniu z kontrolą kliknij strzałkę rozwijaną obok przycisku „Sortuj” i wybierz opcję „Sortowanie niestandardowe”.
- W oknie, które się pojawi, zaznacz pole pod nagłówkiem „Kolumna” i wybierz sortowanie według kolumny „LFC”. Upewnij się, że w kolumnie „Sortuj według” wybrana jest opcja „Wartości”. W kolumnie „Kolejność” wybierz sortowanie „Od największych do najmniejszych” i kliknij „OK”.
UWAGA: Spowoduje to posortowanie genów różnicowo wyrażonych w taki sposób, że te o zwiększonej ekspresji (dodatnie LFC) pojawią się na górze listy, natomiast te o zmniejszonej ekspresji (ujemne LFC) pojawią się na dole listy.
- Porównaj wiele warunków eksperymentalnych z jedną kontrolą w następujący sposób:
- W arkuszu „Experimental 1 versus Control” zaznacz pierwszą komórkę w pustej kolumnie, aby określić geny różnicowo wyrażone występujące w dwóch warunkach eksperymentalnych. Wpisz w komórce następujące równanie:
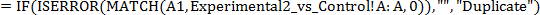
UWAGA: Równanie to jest kombinacją funkcji IF, ISERROR i MATCH. (i) Funkcja MATCH, MATCH(A1,Experimental2_vs_Control!A:A,0), wyszuka wartość w komórce A1 (identyfikator ENSEMBL) w kolumnie A (A:A) arkusza o nazwie Experimental2_vs_Control (Experimental2_vs_Control!). „0” oznacza szukanie dokładnego dopasowania; jeśli zostanie znalezione dokładne dopasowanie, funkcja zwróci wartość „1”, a jeśli nie zostanie znalezione żadne dopasowanie, funkcja zwróci błąd „N/A”. (ii) Wynik funkcji MATCH jest następnie wprowadzany do funkcji ISERROR, ISERROR(MATCH(A1,Experimental2_vs_Control!A:A,0)), w której, jeśli dane wejściowe to „1” (oznaczające znalezienie dopasowania), zwrócona zostanie wartość „FALSE”, a jeśli dane wejściowe to „N/A” (oznaczające brak dopasowania), zwrócona zostanie wartość „TRUE”. (iii) Wynik „TRUE” lub „FALSE” jest następnie wprowadzany do funkcji IF, IF(ISERROR(MATCH(A1,Experimental2_vs_Control!A:A,0)),"","Duplicate"), gdzie jeśli dane wejściowe to „TRUE” (oznaczające brak dopasowania), funkcja zwróci wartość znajdującą się między pierwszym zestawem cudzysłowów (""), która jest pusta, zatem komórka pozostanie pusta. Jeśli dane wejściowe to „FALSE” (oznaczające znalezienie dopasowania), funkcja zwróci wartość znajdującą się między drugim zestawem cudzysłowów („Duplicate”), a w komórce pojawi się napis „Duplicate”. - Naciśnij „Enter” lub „Return”, aby uruchomić równanie. Zaznacz komórkę zawierającą równanie i kliknij pole w prawym dolnym rogu komórki. Przytrzymaj przycisk myszy i przeciągnij zaznaczony obszar w dół kolumny aż do ostatniego „Feature ID”, aby skopiować równanie do każdej komórki w kolumnie.
- Ponownie wybierz „Sortowanie niestandardowe” i dodaj drugi poziom sortowania, klikając ikonę „+” w lewym dolnym rogu. Na pierwszym poziomie, „Sortuj według”, w polu Kolumna wybierz „Duplicate”, w polu Sortuj według wybierz „Wartości”, a w polu Kolejność wybierz „Od Z do A”. Na drugim poziomie, „Następnie według”, w polu Kolumna wybierz „LFC”, w polu Sortuj według wybierz „Wartości”, a w polu Kolejność wybierz „Od największych do najmniejszych”, a następnie kliknij „OK”.
UWAGA: Spowoduje to posortowanie listy genów na 4 grupy w zależności od kierunku zmiany ekspresji. Ważne jest sprawdzenie genów znalezionych w obu warunkach eksperymentalnych, aby upewnić się, że zmiana ekspresji następuje w tym samym lub w przeciwnych kierunkach. - Przed kontynuacją usuń wszystkie nawiasy z kolumny z symbolami genów, w przeciwnym razie wyniki nie zostaną znalezione w bazach danych. Zaznacz całą kolumnę zawierającą symbole genów. W rozwijanym menu „Plik” wybierz „Edycja”, a następnie „Zamień”. W polu „Znajdź:” w oknie Zamień wpisz „(*)”, a pole „Zamień na:” pozostaw puste. Wybierz „Zamień wszystko”, aby usunąć wszystkie wystąpienia nawiasów.
UWAGA: Znak * reprezentuje dowolną liczbę znaków; umieszczenie tego znaku między dwoma nawiasami powoduje, że program wyszukuje każde wystąpienie w zaznaczonych komórkach, a każdy przypadek wystąpienia nawiasów zostaje zastąpiony pustką, co prowadzi do ich usunięcia.
- W arkuszu „Experimental 1 versus Control” zaznacz pierwszą komórkę w pustej kolumnie, aby określić geny różnicowo wyrażone występujące w dwóch warunkach eksperymentalnych. Wpisz w komórce następujące równanie:
- Porównanie pojedynczego warunku eksperymentalnego z kontrolą
- Określanie wzbogaconych szlaków
- Skopiuj do schowka symbole genów z zestawu, dla którego chcesz określić wzbogacone szlaki. Przejdź do ConsensusPathDB12. Na lewym pasku bocznym strony internetowej wybierz „Gene set analysis”, a następnie „Over-representation analysis”.
- Wklej listę genów w polu „Paste a list of gene/protein identifiers”. W polu „Gene/protein identifier type” wybierz „gene symbol” i kliknij „Proceed”. W sekcji zbiorów opartych na szlakach zaznacz pole obok „Pathways as defined by pathway databases”.
UWAGA: Pojawi się szereg opcji analizy, w tym lista dostępnych baz danych do przeszukania. Zalecamy odznaczenie wszystkich baz danych z wyjątkiem Kegg i Reactome, ponieważ są one najbardziej uznane i kompleksowe. Ustawienia minimalnego pokrycia z listą wejściową oraz odcięcia wartości p mogą być dostosowane do potrzeb. Zalecamy pozostawienie tych ustawień domyślnych: minimalne pokrycie 2 genów i odcięcie wartości p na poziomie 0,01. - Wybierz „Find enriched sets”, aby uzyskać listę szlaków zawierających geny z listy wejściowej.
UWAGA: Wynik zostanie przedstawiony w formie tabeli zawierającej nazwę każdego szlaku, a następnie „Set size” (liczba wszystkich genów w szlaku), „Candidates contained” (liczba genów z listy wejściowej znajdujących się w tym szlaku), a także wartość p oraz wartość q (FDR) oraz bazę danych, w której zidentyfikowano szlak.
- Generowanie sieci szlaków
- Określ wzbogacone szlaki zgodnie z powyższym opisem.
- Zaznacz wszystkie wzbogacone szlaki do wizualizacji w sieci szlaków, zaznaczając poszczególne pola obok nazw szlaków lub klikając „All” w sekcji „Select” w nagłówku kolumny nad polami wyboru, a następnie wybierz „Visualize selected sets”.
UWAGA: Zalecamy wizualizację wszystkich szlaków, jeśli jest ich mniej niż 30; jeśli szlaków jest więcej niż 30, zalecamy wybranie 30 najbardziej wzbogaconych szlaków (tych zawierających największą liczbę genów z listy wejściowej). - Dostosuj filtry „relative overlap” (pokrycie względne) i „shared candidates” (wspólni kandydaci), wybierając odpowiednie pole w górnej środkowej części strony i wpisując żądany procent pokrycia względnego lub liczbę wspólnych kandydatów, aby zwiększyć rygorystyczność i sprawić, by bardziej istotne pokrycia w sieciach szlaków były wyraźniejsze, a następnie wybierz „apply”.
UWAGA: Zalecamy minimalne pokrycie względne 0,2 (co oznacza 20% pokrycia genów między 2 szlakami w celu ich połączenia) oraz minimum 2 wspólnych kandydatów. Legendę wykresu można wyświetlić, klikając legendę w górnej lewej części strony.
- Określanie wzbogaconych terminów GO
- Skopiuj do schowka symbole genów z grupy, dla której chcesz określić wzbogacone ontologie genów. Przejdź do narzędzia „GO Enrichment Analysis tool” w Gene Ontology Consortium13. Wklej listę symboli genów w polu po lewej stronie strony pod napisem „Your gene IDs here…”.
- Wybierz zestaw terminów GO do użycia z listy pod polem identyfikatorów genów: proces biologiczny (biological process), funkcja molekularna (molecular function) lub komponent komórkowy (cellular component). Wybierz (zalecane) „biological process”. Pod polem terminów GO wybierz „Danio rerio” i kliknij „Submit”.
UWAGA: Zalecamy stosowanie domyślnego odcięcia wartości p na poziomie 0,05.
5. Weryfikacja metodą qRT-PCR
UWAGA: Poszczególne geny, u których stwierdzono istotne zmiany ekspresji w analizie RNASeq, powinny zostać zweryfikowane za pomocą ukierunkowanego qRT-PCR w eksperymentach powtórzonych.
- Synteza cDNA
- Wyizolować RNA z embrionów metodą opisaną w sekcji 3.1. Izolacja RNA.
- Przekształcić 1 µg RNA w cDNA przy użyciu zestawu do konwersji cDNA (patrz Tabela materiałów). Połączyć RNA, dNTP oraz enzym odwrotnej transkryptazy. Przeprowadzić reakcję w termocyklerze zgodnie ze specyfikacją producenta.
- Rozcieńczyć cDNA w stosunku 1:3 w wodzie traktowanej DEPC. Przechowywać w temperaturze 4 °C do 1-2 miesięcy.
- Weryfikacja qRT-PCR
- Wybrać geny do weryfikacji metodą qRT-PCR na podstawie wyników sekwencjonowania RNA. Zidentyfikować geny o wysokiej krotności zmian (fold change) w ekspresji. Określić, które z tych genów posiadają również wysoką liczbę odczytów, co wskazuje na obfitą ekspresję.
- Wybrać 10-12 celów z listy genów o wysokiej krotności zmian i wysokiej liczbie odczytów. Zaprojektować startery do amplifikacji genów docelowych, które obejmują co najmniej jedną granicę intron-ekson.
- Wprowadzić gen lub docelowy region genu do strony do projektowania starterów qPCR14. Wybrać opcję „design 2 qPCR primers” i zlecić stronie utworzenie zestawu starterów.
UWAGA: Należy pamiętać o uwzględnieniu starterów do kontroli wewnętrznej, takich jak β-actin, w celu normalizacji porównań między próbkami. Startery dla β-actin to F: 5'-TCGAGCTGTCTTCCCATCCA-3' oraz R: 5'-TCACCAACGTAGCTGTCTTTCTG-3'. - Połączyć cDNA, starter forward, starter reverse oraz polimerazę. Przeprowadzić amplifikację qRT-PCR w celu określenia względnej ekspresji genów15.
- Przeanalizować względną ekspresję mRNA interesujących genów za pomocą metody kwantyfikacji względnej15.
- Porównać wyniki qRT-PCR z wynikami RNASeq, aby upewnić się, że kierunkowość różnicowej ekspresji jest spójna.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Sortowanie genów o różnej ekspresji:
Aby zidentyfikować geny o zróżnicowanej ekspresji w stadium larwalnym modeli zespołu Alströma i zespołu Bardeta-Biedla (BBS) u danio pręgowanego, zastosowano celowanie w transkrypty alms1 lub bbs1 poprzez wstrzyknięcie uprzednio zwalidowanych MO blokujących splicing do embrionów danio pręgowanego typu dzikiego16,17. W ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Podejście opisane w tym protokole oferuje stosunkowo szybką i opłacalną strategię analizy na poziomie transkryptomu całych zwierząt lub określonych posortowanych populacji komórek. Danio pręgowany stanowi korzystny model dla tego typu badań ze względu na łatwość i szybkość generowania dużych ilości materiału wyjściowego, łatwość wdrożenia genetycznych lub środowiskowych warunków eksperymentalnych oraz dostępność szerokiego spektrum transgenicznych linii reporterowych pozwalających na izolację populacji specyficznych dla ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Ta praca była wspierana przez R01DK102001 (N.A.Z.), P30DK072488 (N.A.Z.) i T32DK098107 (T.L.H. i J.E.N.).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Commercial Reagents | |||
| TriZol | Thermo Scientific | 15596026 | odczynnik |
| TrypLE | Gibco | 12604013 | bufor dysocjacyjny 1 |
| FACSMax | Genlantis | T200100 | bufor dysocjacyjny 2 |
| Woda uzdatniona przez DEPC | Sigma | 95284 | |
| Konwersja cDNA FirstNici | konwersji cDNA | Thermo Scientific | K1621 |
| 2X SYBR Green Master Mix | Roche | 4707516001 | qRT-PCR Master Mix |
| bufor FACS | Fisher Scientific | 50-105-9042 | |
| chloroform | Sigma Aldrich | 288306 | |
| octan sodu | Sigma Aldrich | S2889 | |
| Nazwa | Firma | Numer katalogowy | Uwagi |
| Odmiany danio pręgowanego | |||
| Tuebingen | ZIRC | ZL57 | |
| ins2a:mCherry | ZIRC | ZL1483 | |
| Nazwa | < strong>Firma< | strong>Numer katalogowy | Uwagi |
| Equipment | |||
| 40 mikronowy sitko | komórkowe Sigma | CLS431750 | |
| rurka FACS | BD Falcon | 352063 | |
| hemocytometr | Sigma | Z359629 | |
| Mikroskop preparacyjny | Zeiss Zeiss | ||
| Nanodrop | Thermo Scientific | ||
| Illumina HiSeq | Illumina | ||
| LightCycler 480 | Roche | ||
| Zbiorniki kryjące 1,0 l Zestaw zbiorników krzyżowych | Aquaneering | ZHCT100 | |
| probówka FACS 5 ml rurka polipropylenowa | BD Falcon | 352063 | |
| Nazwa | Firma | Numer katalogowy | Komentarze |
| Software | |||
| Excel | Microsoft | ||
| Consensus Path DB | |||
| GO | http://geneontology.org/page/go-enrichment-analysis |
Bibliografia
- Nusslein-Volhard, C., Dahm, R. Zebrafish. , Oxford University Press. (2002).
- Detrich, H. W., Zon, L., Westerfield, M. The Zebrafish: Disease Models and Chemical Screens. , 4th ed, Academic Press. (2017).
- Detrich, H. W., Zon, L. I., Westerfield, M. The Zebrafish: Genetics, Genomics, and Transcriptomics. , 4th ed, Academic Press. (2016).
- Detrich, H. W. The Zebrafish: Genetics, Genomics and Informatics. , 3rd ed, Academic Press. (2011).
- Avdesh, A., et al. Regular care and maintenance of a zebrafish (Danio rerio) laboratory: an introduction. J Vis Exp. (69), e4196(2012).
- Rosen, J. N., Sweeney, M. F., Mably, J. D. Microinjection of zebrafish embryos to analyze gene function. J Vis Exp. (25), (2009).
- Hwang, W. Y., et al. Efficient genome editing in zebrafish using a CRISPR-Cas system. Nat Biotechnol. 31 (3), 227-229 (2013).
- Westerfield, M. The zebrafish book. A guide for the laboratory use of zebrafish (Danio rerio). , 4th ed, Univ. of Oregon Press. Eugene. (2000).
- Rossi, A., et al. Genetic compensation induced by deleterious mutations but not gene knockdowns. Nature. 524 (7564), 230-233 (2015).
- Kimmel, C. B., Ballard, W. W., Kimmel, S. R., Ullmann, B., Schilling, T. F. Stages of embryonic development of the zebrafish. Dev Dyn. 203 (3), 253-310 (1995).
- Samsa, L. A., Fleming, N., Magness, S., Qian, L., Liu, J. Isolation and Characterization of Single Cells from Zebrafish Embryos. J Vis Exp. (109), (2016).
- MPIMG. ConsenusPathDB. , Available from: http://cpdb.molgen.mpg.de/ (2017).
- Consortium, G. O. Enrichment analysis Tool. , Available from: http://www.geneontology.org/ (2017).
- IDT. IDT Primerquest Tool. , Available from: https://www.idtdna.com/Primerquest/Home/Index (2017).
- Heid, C. A., Stevens, J., Livak, K. J., Williams, P. M. Real time quantitative PCR. Genome Res. 6 (10), 986-994 (1996).
- Leitch, C. C., Lodh, S., Prieto-Echague, V., Badano, J. L., Zaghloul, N. A. Basal body proteins regulate Notch signaling through endosomal trafficking. J Cell Sci. 127 (Pt 11), 2407-2419 (2014).
- Lodh, S., Hostelley, T. L., Leitch, C. C., O'Hare, E. A., Zaghloul, N. A. Differential effects on beta-cell mass by disruption of Bardet-Biedl syndrome or Alstrom syndrome genes. Hum Mol Genet. 25 (1), 57-68 (2016).
- Hostelley, T. L., Lodh, S., Zaghloul, N. A. Whole organism transcriptome analysis of zebrafish models of Bardet-Biedl Syndrome and Alstrom Syndrome provides mechanistic insight into shared and divergent phenotypes. BMC Genomics. 17, 318(2016).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
