Tutaj prezentujemy nowe podejście do identyfikacji wirusów roślinnych za pomocą dwuniciowych genomów DNA. Stosujemy standardowe metody ekstrakcji DNA i RNA z zakażonych liści oraz przeprowadzamy sekwencjonowanie nowej generacji. Narzędzia bioinformatyczne łączą sekwencje w kontigi, identyfikują kontigi reprezentujące genomy wirusów i przypisują genomy do grup taksonomicznych.
Artykuł metodologiczny
Połączenie analizy DNA w surowej ekstrakcji wirionu z analizą RNA z zakażonych liści w celu odkrycia nowych genomów wirusów
W tym artykule
Podsumowanie
Streszczenie
To podejście metagenomowe służy do identyfikacji wirusów roślinnych z kolistymi genomami DNA i ich transkryptami. Często wirusy DNA roślin, które występują w niskich mianach u swojego gospodarza lub nie mogą być mechanicznie inokulowane intonacji innemu gospodarzowi, są trudne do rozmnażania w celu uzyskania większego miana materiału zakaźnego. Zainfekowane liście są mielone w łagodnym buforze o optymalnym pH i składzie jonowym, zalecanym do oczyszczania większości retrowirusów Para prątkowatych. Mocznik służy do rozbijania ciał inkluzyjnych, które zatrzymują wiriony i rozpuszczania składników komórkowych. Wirowanie różnicowe zapewnia dalszą separację wirionów od zanieczyszczeń roślinnych. Następnie leczenie proteinazą K usuwa kapsydy. Następnie DNA wirusa jest zagęszczane i wykorzystywane do sekwencjonowania nowej generacji (NGS). Dane NGS są wykorzystywane do łączenia kontigów, które są przesyłane do NCBI-BLASTn w celu zidentyfikowania podzbioru sekwencji wirusów w wygenerowanym zbiorze danych. W równoległym rurociągu RNA jest izolowane z zainfekowanych liści przy użyciu standardowej metody ekstrakcji RNA opartej na kolumnach. Następnie przeprowadza się zubożenie rybosomów w celu wzbogacenia o podzbiór transkryptów mRNA i wirusa. Złożone sekwencje pochodzące z sekwencjonowania RNA (sekwencjonowanie RNA) przesłano do NCBI-BLASTn w celu zidentyfikowania podzbioru sekwencji wirusa w tym zestawie danych. W naszym badaniu zidentyfikowaliśmy dwa powiązane genomy badnawirusa o pełnej długości w dwóch zestawach danych. Metoda ta jest preferowana w stosunku do innego powszechnego podejścia, które polega na ekstrakcji zagregowanej populacji małych sekwencji RNA w celu odtworzenia sekwencji genomowych wirusów roślinnych. Ten ostatni potok metagenomiczny odzyskuje sekwencje związane z wirusem, które są elementami retrotranskrypcji wprowadzonymi do genomu rośliny. Jest to sprzężone z testami biochemicznymi lub molekularnymi w celu dalszego rozpoznania aktywnie zakaźnych czynników. Podejście udokumentowane w tym badaniu pozwala na odzyskanie sekwencji reprezentatywnych dla replikujących się wirusów, które prawdopodobnie wskazują na aktywną infekcję wirusową.
Wprowadzenie
Pojawiające się choroby roślin skłaniają badaczy do opracowania nowych narzędzi do identyfikacji właściwego czynnika sprawczego. Wstępne doniesienia o nowych lub nawracających chorobach wirusowych opierają się na powszechnie występujących objawach, takich jak mozaika i wady rozwojowe liści, oczyszczanie żył, karłowatość, więdnięcie, zmiany chorobowe, martwica lub inne objawy. Standardem zgłaszania nowego wirusa jako czynnika wywołującego chorobę jest oddzielenie go od innych zanieczyszczających patogenów, rozmnażanie go w odpowiednim żywicielu i rozmnażanie choroby poprzez zaszczepienie zdrowych roślin pierwotnego gatunku gospodarza. Ograniczeniem w tym podejściu jest to, że wiele rodzajów wirusów roślinnych zależy od owada lub innych wektorów w celu przeniesienia się na odpowiedniego gospodarza lub z powrotem na pierwotny gatunek żywiciela. W takim przypadku poszukiwania odpowiedniego wektora mogą się przedłużyć, mogą wystąpić trudności z założeniem laboratoryjnych kolonii wektora i konieczne są dalsze wysiłki w celu opracowania protokołu eksperymentalnej transmisji. Jeśli nie można osiągnąć warunków do udanych badań laboratoryjnych dotyczących transmisji wirusowej, oznacza to, że praca nie spełnia standardu zgłaszania nowej choroby wirusowej. W przypadku wirusów, które występują w swoich naturalnych gospodarzach przy bardzo niskich mianach, naukowcy muszą zidentyfikować alternatywnych gospodarzy do rozmnażania, aby utrzymać wystarczające zasoby zakaźne do prowadzenia badań. Dla gatunków wirusów, które infekują tylko kilka roślin, może to również stanowić przeszkodę w uprawie kultur podstawowych1.
W ostatnich latach naukowcy coraz częściej stosują wysokoprzepustowe NGS i podejścia metagenomiczne do odkrywania sekwencji wirusów obecnych w środowisku, które mogą istnieć niezwiązane ze znaną chorobą, ale mogą być przypisane do gatunków i rodzajów taksonomicznych2,3,4. Takie podejścia do odkrywania i kategoryzacji materiałów genetycznych w odrębnym środowisku umożliwiają opisanie różnorodności wirusów w przyrodzie lub ich obecności w określonym ekosystemie, ale niekoniecznie potwierdzają ramy definiowania czynników przyczynowych dla widocznej choroby.
Rodzaj Badnavirus należy do rodziny Caulimoviridae pararetrowirusów. Wirusy te mają kształt pałeczek z okrągłymi dwuniciowymi genomami DNA o wielkości około 7 do 9 kb. Wszystkie pararetrowirusy replikują się przez produkt pośredni RNA. Pararetrowirusy występują jako episomy i replikują się niezależnie od DNA chromosomalnego rośliny5,6. Badania terenowe populacji wirusów wskazują, że te populacje wirusów są genetycznie złożone. Ponadto informacje uzyskane w różnych genomach roślinnych za pomocą sekwencjonowania o wysokiej przepustowości ujawniły liczne przykłady fragmentów genomu badnawirusa wprowadzonych w wyniku nielegalnych zdarzeń integracji do genomów roślinnych. Te endogenne sekwencje badnawirusa niekoniecznie są związane z infekcją7,8,9,10,11. Następnie, zastosowanie NGS do identyfikacji nowych badnawirusów jako czynnika wywołującego chorobę jest skomplikowane ze względu na różnorodność subpopulacji genomów epizodycznych, a także występowanie sekwencji endogennych12,13.
Chociaż nie ma jednego optymalnego sposobu na odkrycie nowych genomów pararetrowirusów, istnieją dwa powszechne podejścia do identyfikacji tych wirusów jako czynników wywołujących choroby. Jedną z metod jest wzbogacenie o małe sekwencje RNA z zakażonych liści, a następnie złożenie tych sekwencji w celu odtworzenia genomu (genomów)14,15,16,17. Innym podejściem jest amplifikacja toczącego się koła (RCA) w celu amplifikacji kolistych genomów wirusów DNA18. Powodzenie RCA zależy od wieku liścia i miana wirusa w wybranej tkance. Produkty RCA są poddawane trawieniu restrykcyjnemu i klonowane do plazmidów w celu bezpośredniego sekwencjonowania19,20,21.
Wirus Canna yellow mottle virus (CaYMV) jest badnawirusem i jest opisany jako etiologiczna przyczyna choroby żółtej pstrości w Canna, chociaż tylko 565 pz fragment genomu został wcześniej wyizolowany z zakażonych Cannas22. Współczesne badanie zidentyfikowało CaYMV w Alpinia purpurata (kwitnący imbir; CaYMV-Ap)23. Celem tego badania było odzyskanie kompletnych sekwencji genomu badnawirusa z zakażonych lilii konopnych. Opisujemy protokół oczyszczania wirusa z zanieczyszczeń roślinnych, a następnie izolowania wirusowego DNA z tego preparatu oraz przygotowania biblioteki DNA do zastosowania w NGS. Takie podejście eliminuje potrzebę pośrednich etapów amplifikacji molekularnej. Izolujemy również mRNA z zakażonych roślin pod kątem sekwencjonowania RNA. NGS, który obejmuje sekwencję RNA, przeprowadzono przy użyciu każdego preparatu kwasu nukleinowego. Stwierdzono, że złożone kontigi odnoszą się do taksonu Badnavirus w obu zestawach danych przy użyciu podstawowego narzędzia do wyszukiwania lokalnych dopasowań kwasów nukleinowych (BLASTn) przez Narodowe Centrum Biotechnologii i Informacji (NCBI). Zidentyfikowaliśmy genomy dwóch gatunków badnawirusów24.
Protokół
1. Ogólne oczyszczanie wirusa przez wirowanie różnicowe przy użyciu standardowej metody Covey et al. 25
- Najpierw odetnij 80-100 g liści chorych roślin i zmiel w blenderze w temperaturze 4 °C przy użyciu 200 ml buforu do mielenia (0,5 M NaH2PO4, 0,5 M Na2HPO4 (pH 7,2) i 0,5% (w/v) Na2SO3). Nosić fartuch laboratoryjny i rękawice na wszystkich etapach tej procedury.
- Następnie przenieść homogenat (300 ml) do zlewki o pojemności 1,0 l. Dodać 18 g mocznika i 25 ml 10% niejonowego detergentu (t-Oct-C 6H4-(OCH2CH2)9OH) do homogenatu wewnątrz okapu chemicznego.
UWAGA: Na tym etapie najlepiej jest nosić okulary ochronne i prostą maskę oddechową do ochrony osobistej. - Krótko wymieszać mieszadłem magnetycznym w pokrywie i przykryć zlewkę folią. Następnie przenieść pokrytą folią zlewkę do chłodni i mieszać mieszadłem magnetycznym przez noc w temperaturze 4 °C.
- Przenieść homogenat do butelek wirnika wirowego (pojemniki o pojemności 250 ml) i odwirować w wirniku o stałym kącie nachylenia 4 000 x g przez 10 minut w temperaturze 4 °C. W dygestoriach chemicznych odzyskaj supernatant i przefiltruj przez 4 warstwy gazy.
- Podzielić homogenat na 38,5 ml polipropylenowych probówek wirówkowych i wirować przez 2,5 godziny przy 40 000 x g w temperaturze 4 °C. Zazwyczaj należy sprawdzić, czy na dnie probówki znajduje się zielony osad, a na całej długości probówki biały osad. Odlewać supernatant i zachować obie granulki; Umieść próbki na lodzie.
UWAGA: Zielony granulat zawiera chloroplasty, skrobię i inne organelle. - Pracując w kapturze chemicznym, użyj gumowego policjanta do oddzielenia granulek. Zawiesić białe osady w każdej butelce z rotorem w 1 ml ddH2O w ciągu 1-2 godzin, utrzymując zawiesiny przez noc w temperaturze 4 °C, aby materiały całkowicie rozpuszczone w roztworze. Odwirować zawiesinę w temperaturze 6 000 x g i w temperaturze 4 °C przez 10 minut w celu usunięcia pozostałych zanieczyszczeń.
- Odwirować zagęszczoną zawiesinę o stężeniu 136 000 x g przez 2 godziny w temperaturze 4 °C w celu osadzenia wirionów. Zawiesić granulki w 1 ml buforu (50 mM Tris-HCl, pH 7,5, 5 mM MgCl2).
UWAGA: Opcjonalnym krokiem jest traktowanie wirionów DNAzą I (10 μg/ml) przez 10 minut w temperaturze 37 °C w celu usunięcia niekapsułkowanego DNA, tj. zanieczyszczającego chloroplast i mitochondrialne DNA. Następnie dezaktywuj DNAzę I, dodając EDTA do 1 mM. - Rozbić wiriony za pomocą 40 μl 2 μg/μl proteinazy K w temperaturze 37 °C przez 15 minut.
- Pracuj w kapturze chemicznym, aby odzyskać DNA wirionu przez ekstrakcję organiczną. Podczas ekstrakcji należy nosić osłonę twarzy, rękawice i fartuch laboratoryjny w celu ochrony przed potencjalnymi ostrymi skutkami zdrowotnymi. Dodać 1 objętość alkoholu fenolowo-chloroformowo-izoamylowego (49:50:1) do próbki i wstrząsać ręcznie przez 20 s. Wirować w temperaturze pokojowej przez 5 minut przy 16 000 x g. Usunąć górną fazę wodną i przenieść do nowej probówki. Powtórz tę ekstrakcję dwa lub więcej razy. Pozbądź się fazy organicznej, umieszczając ją w szklanej butelce na odpady w celu prawidłowej instytucjonalnej utylizacji chemicznej26.
- Zagęścić DNA za pomocą wytrącania etanolu. Użyć 0,3 M końcowego stężenia octanu sodu (pH 5,2) i 2,5 objętości 95% etanolu. Umieść próbki w temperaturze -20 °C na 30-60 minut i odwiruj przy 13 000 x g przez 10-20 minut, aby osadzać DNA26.
- Pracując na stole laboratoryjnym, ponownie zawieś osad DNA w 1 ml 0,1 mM buforu TE (pH 8,0). Przepuścić zawiesinę przez komercyjną żelową kolumnę filtracyjną (zwykle używaną do oczyszczania za pomocą reakcji łańcuchowej polimerazy (PCR)) w celu wyeliminowania soli i materiałów o niskiej masie cząsteczkowej, które mogą utrudniać NGS.
- Analizować próbki za pomocą 1% elektroforezy w żelu agarozowym przy użyciu barwienia bromkiem etydyny, aby zobaczyć jakość preparatów. Oceń jakość DNA za pomocą spektrofotometru nanokropli.
UWAGA: Stosunek absorbancji próbki przy 260 λ i 280 λ między 1,85 a 2,0 zazwyczaj wskazuje, że preparat jest "czysty" od zanieczyszczeń i ma pożądaną jakość. - Analizuj jakość DNA (użyj od 5 pg do 10 ng) za pomocą przyrządu do elektroforezy kapilarnej na bazie chipa.
UWAGA: Jakość wyjściowa pokazuje czyste piki, reprezentujące fragmenty DNA rozmieszczone według wielkości wzdłuż osi X. Wysokość piku wskazuje na obfitość fragmentu. Postrzępione piki wskazują na częściowo zdegradowane fragmenty lub zanieczyszczenia chemiczne. Okrągłe krzywe reprezentują rozmaz DNA wskazujący na słabą jakość
2. Przygotowanie biblioteki za pomocą amplifikacji klonalnej opartej na DNA i emulsji (emPCR Amplifikacja)
Uwaga: Biblioteka jest zazwyczaj przygotowywana przez placówkę NGS, która wykonuje prace zorientowane na klienta.
- Ścinać roztwór DNA (> 200 ng) za pomocą nebulizatora, który przekształca DNA we fragmenty. Zaktualizuj komercyjne adaptery zgodnie z instrukcjami instrukcji27.
- Przeprowadzić amplifikację emPCR próbki DNA zgodnie z instrukcjami producenta28,29,30. Powtórz etap mycia trzy razy, a po każdym praniu granuluj kulki w miniwirówce przez 10 sekund. Wyrzucić supernatant po każdym praniu.
UWAGA: Procedura rozpoczyna się od przygotowania kulek wychwytujących poprzez umycie w komercyjnym buforze do płukania dostarczonym z zestawem. emPCR jest powszechnie stosowany do amplifikacji matrycy dla NGS. - Podgrzać denaturację DNA lub RNA w temperaturze 95 °C przez 2 minuty, a następnie w temperaturze 4 °C, aż będzie gotowa do użycia. Użyj 200 milionów cząsteczek DNA/RNA do 5 milionów kulek wychwytujących w końcowej objętości 30 μl. Przygotuj próbkę próbną wraz z próbką DNA/RNA i wykonaj następujące kroki z próbką kwasu nukleinowego, a także próbką próbną.
- Przeprowadzić emulgację, wirując rurkę z olejem emulsyjnym przez 10 s z maksymalną prędkością, a następnie wlać całą zawartość (4 ml) do plastikowej rurki mieszającej, która jest kompatybilna z homogenizatorem platformowym. Umieść rurkę mieszającą na platformie, aby mieszać emulsję z prędkością 2 000 obr./min przez 5 minut.
- Dozować 100 μl porcji emulsji do probówek z 8-paskową nakrętką lub do płytki 96-dołkowej. Zakryj probówki lub uszczelnij płytkę i przeprowadź emPCR przy użyciu zalecanego przez producenta programu28.
UWAGA: Po zakończeniu PCR sprawdź dołki, aby zobaczyć, czy emulsja jest nienaruszona, a następnie kontynuuj. Wyrzuć całą studzienkę, jeśli emulsja jest rozbita. - Załóż fartuch laboratoryjny i pracuj w kapturze chemicznym, aby zebrać amplifikowane kulki DNA (ADB). Odessać próżniowo emulsję ze studzienek i zebrać kulki do probówki o pojemności 50 ml. Przepłukać studzienki dwukrotnie 100 μl izopropanolu i odessać płukanie do tej samej probówki o pojemności 50 ml.
- Zebrać zebrane emulsje należy zmieszać i ponownie zawiesić ADB z izopropanolem do końcowej objętości 35 ml. Granulować ADB przy 930 x g przez 5 minut. Usunąć supernatant i dodać 10 ml buforu wzmacniającego. Odwirować ADB, a następnie przemyć, dodając izopropanol do 40 ml końcowej objętości Odwirować i wyrzucić supernatant po każdym przemyciu i powtórzyć etap płukania dwukrotnie.
- Przeprowadzić końcowe płukanie przy użyciu etanolu zamiast izopropanolu. Dodaj bufor wzmacniający do 35 ml końcowej objętości, zmieszaj i otul kulki w 930 x g przez 5 minut. Usunąć supernatant, ale pozostawić 2 ml buforu wzmacniającego.
- Przenieść zawiesinę do probówki mikrowirówkowej i krótko odwirować w celu osadzenia ADB. Po odrzuceniu supernatantu przepłukać dwukrotnie osad ADB 1 ml buforu wzmacniającego. Odwirować i wyrzucić supernatant po każdym przemyciu.
- Aby przygotować się do wzbogacenia kulek w bibliotece DNA, dodaj 1 ml 1 N NaOH do kulek. Zwirować ADB, a następnie inkubować przez 2 minuty w temperaturze pokojowej. Odwirować i wyrzucić supernatant. Powtórz ten krok prania raz.
- Dodać 1 ml buforu do wyżarzania, następnie zwirować ADB i inkubować przez 2 minuty w temperaturze pokojowej. Krótko odwirować i wyrzucić supernatant. Powtórz ten krok ponownie, używając 100 μl buforu do wyżarzania.
- Do starterów sekwencjonowania wyżarzanego do DNA dodaj 15 μl Seq Primer A i 15 μl Seq Primer B dostarczonych w zestawie. Krótko wymieszać przez wirowanie i umieścić probówkę mikrowirówki w bloku grzewczym w temperaturze 65 °C na 5 minut. Przełóż na lód na 2 minuty.
- Przemyć trzykrotnie 1,0 ml buforu do wyżarzania. Wirować przez 5 s i za każdym razem odrzucać supernatant.
- Przed sekwencjonowaniem zmierz liczbę koralików za pomocą komercyjnego licznika koralików. Powinno być co najmniej 500 000 wzbogaconych koralików.
UWAGA: Licznik kulek to specjalne urządzenie, które mierzy kulki w dołączonej probówce do mikrowirówki.
3. Ogólna izolacja mRNA i synteza dsDNA rozpoczynająca się od zakażonych liści konopi, które testuje się za pomocą RT-PCR na obecność CaYMV przy użyciu zgłoszonych starterów diagnostycznych
- We wszystkich kolejnych krokach należy nosić fartuch laboratoryjny i rękawice lateksowe do ochrony osobistej. Pracując na stole laboratoryjnym, zbierz 12 próbek z liści i zanurz je w ciekłym azocie. Do homogenizacji użyj młynka perełkowego. Użyj komercyjnego zestawu, który zapewnia standardową metodę opartą na kolumnach do całkowitej izolacji RNA rośliny. Dodać bufor do lizy guanidyny i izotiocyjanianu dostarczony przez zestaw do zmielonej próbki i wstrząsać przez 20 sekund.
- Dodaj etanol i dokładnie wymieszaj, zgodnie z instrukcją zestawu. Dodaj każdy homogenat do kolumny wirowej, która wiąże RNA z błoną. Przemyć trzy razy i wymyć RNA do probówki regeneracyjnej24.
- Określić ilościowo RNA za pomocą spektrofotometru w celu zmierzenia stosunku absorbancji przy 260 λ i 280 λ. Sprawdź integralność RNA za pomocą 1% elektroforezy w żelu agarozowym barwionej bromkiem etydyny.
UWAGA: Współczynnik absorbancji między 1,85 a 2,0 wskazuje, że preparat jest pożądanej jakości. Potraktuj RNA DNazą I (10 μg/ml) przez 10 minut w temperaturze 37 °C. Użyj komercyjnej kolumny wirowej, aby skoncentrować RNA w wodzie wolnej od RNaz class31. Zbierz próbki RNA przed kontynuowaniem. - Użyj zestawu do usuwania rRNA, aby usunąć roślinne rybosomalne RNA. Porcję kulek magnetycznych przemyć do probówki mikrowirówki i dwukrotnie przemyć wodą wolną od RNaz. Odwiruj probówkę w celu ponownego zawieszenia, umieść probówkę na stojaku magnetycznym i poczekaj, aż płyn się zklaruje. Odrzucić supernatant i zastąpić go roztworem do ponownego zawieszania kulek magnetycznych. Zmieszać w celu ponownego zawieszenia i dodać 1 μl inhibitora RNazy.
UWAGA: Takie zestawy wykorzystują oligo-dT związane z kulkami magnetycznymi, które hybrydyzują z mRNA. Metoda wykorzystuje standardową technologię separacji kulek magnetycznych do odzyskiwania transkryptów24. - Połącz od 500 ng do 1,25 μg RNA, wody wolnej od RNaz i reakcyjnych dostarczonych przez zestaw. Umieść mieszaninę na 10 minut w temperaturze 50 °C. Zdejmij z ognia i dodaj umyte kulki magnetyczne do wody wolnej od RNAzy. Krótko wirować i ustawić w temperaturze pokojowej na 5 minut.
- Umieść na stojaku magnetycznym i poczekaj, aż płyn się usunie. Przenieść supernatant do świeżej probówki do mikrowirówki. Osadzony na lodzie.
- Użyj metody wychwytywania opartej na roztworze do wzbogacenia egzosomów i 200 ng RNA, aby przygotować bibliotekę cDNA.
UWAGA: Biblioteka dwuniciowych cDNA jest zwykle przygotowywana przez zakład NGS, który wykonuje prace zorientowane na klienta. - Fragmentuj RNA za pomocą komercyjnego roztworu do fragmentacji RNA (0,136 g ZnCl2 i 100 mM Tris-HCl pH 7,0). Dodać 2 μl roztworu do 18 μl RNA (łącznie 200 ng). Krótko odwirować probówki w mikrowirówce, umieścić próbki w temperaturze 70 °C na 30 s i przenieść do lodu. Zatrzymaj reakcję za pomocą 2 μl 0,5 M EDTA pH 8,0 i 28 μl 10 mM Tris-HCl pH 7,5.
- Zwiąż RNA z kulkami magnetycznymi, mieszając w temperaturze pokojowej przez 10 minut. Użyj koncentratora magnetycznego, aby zebrać kulki i wyrzucić supernatant. Umyj koraliki trzykrotnie 200 μl 70% etanolu. Wyrzuć każde pranie, a następnie wysusz granulowane kulki na powietrzu w temperaturze pokojowej przez 3 minuty. Zawiesić w 19 μl 10 mM Tris-HCl pH 7,5.
- Wyżarzać losowe startery do rozdrobnionego RNA przez ogrzewanie do 70 °C przez 10 minut, a następnie umieścić probówkę na lodzie na 2 minuty. Przygotować pierwszą i drugą nić cDNA przy użyciu standardowego komercyjnego zestawu do syntezy cDNA.
- Oczyść dwuniciowe cDNA za pomocą koncentratora kulek magnetycznych. Umyć trzykrotnie 800 μl 70% etanolu. Wyrzuć każde pranie i wysusz granulki na powietrzu w temperaturze pokojowej przez 3 minuty. Zawiesić w 16 μl 10 mM Tris-HCl pH 7,5. Użyj koncentratora kulek magnetycznych, aby oddzielić kulki od dwuniciowego cDNA, który jest teraz w roztworze. Usuń cDNA, pipetując do nowej probówki PCR o pojemności 200 μl.
- Przeprowadzić naprawę końca fragmentu za pomocą polimerazy Taq i mieszaniny deoksyrybonukleotydów dostarczonych przez komercyjny zestaw do przygotowywania biblioteki. Zestaw komercyjny zawiera wstępnie rozcieńczone adaptery do dodania do każdego końca dwuniciowego cDNA za pomocą komercyjnej ligazy w temperaturze 25 °C przez 10 minut.
4. NGS biblioteki DNA przygotowanej z prymitywnego preparatu wirusowego i biblioteki dsDNA przygotowanej z mRNA
- Użyj standardowego urządzenia do pirosekwencjonowania o wysokiej przepustowości i postępuj zgodnie ze wszystkimi zalecanymi protokołami producentów, aby wygenerować bezpośrednie odczyty sekwencji DNA. Używaj komercyjnych odczynników do sekwencjonowania, w tym znakowanych fluorescencyjnie nukleotydów.
UWAGA: Szczegółowe informacje można znaleźć w instrukcjach producenta dołączonych do przyrządu. - Przeprowadź analizę po sekwencjonowaniu za pomocą oprogramowania do składania genomu, które automatycznie składa odczyty w celu wytworzenia pierwszego zestawu kontigów o średniej długości < 700 pz. Użyj oprogramowania FastQC na stronie internetowej iPlant/CyVerse, które przeprowadza kontrolę jakości surowych danych sekwencji32. Wybierz sekwencje z wynikami Phred ≥ 30, aby kontynuować rekonstrukcję dłuższych sekwencji z mniejszych sekwencji reads24 za pomocą oprogramowania do mapowania i amplikonu.
UWAGA: Szczegółowe informacje można znaleźć w instrukcji producenta. - Prześlij te zmontowane kontigi do analizy NCBI-BLASTn za pomocą domyślnego modułu MEGABLAST, a także Viridplantae (TaxID: 33090) i Viruses (TaxID: 10239) jako ograniczających nazw organizmów33. Zbierz subpopulację kontigów, które wykazują duże podobieństwo do zgłoszonych genomów Badnavirus w raporcie.
- Sprawdź, czy połączone rusztowania, które reprezentują co najmniej jeden kandydat na pełnowymiarowy genom wirusa, poprawnie tworzą sekwencje w ramce, które mają tę samą organizację, co standardowy genom badnawirusa. Aby to zrobić, wprowadź kandydat na pełnej długości genomu wirusa do oprogramowania do rysowania plazmidu. Następnie potwierdź, że pierwsze 15 nukleotydów składa się zmet tRNA (TGGTATCAGAGCGAG), który jest wysoce konserwatywny wśród badnawirusów. Zlokalizuj potencjalny sygnał poliadenylacji w pobliżu końca 3' genomu. Opisz cały genom, aby zidentyfikować obecność dwóch małych ORF i jednego dużego ORF kodujących poliproteinę. Następnie użyj narzędzia do tłumaczenia portalu ExPASy, aby zidentyfikować produkty tłumaczeniowe badnavirus ORF1, ORF2 i ORF334.
UWAGA: To oprogramowanie naukowe jest bezpłatne i generuje koliste DNA, identyfikuje wszystkie otwarte ramki odczytu i zapewnia natychmiastowe dane wyjściowe w celu sprawdzenia, czy sekwencja reprezentuje pełną długość kolistego genomu DNA. - Użyj narzędzi do porównywania wielu sekwencji o otwartym kodzie źródłowym, MUSCLE i CLUSTALW, aby porównać genomy wirusów uzyskane z analiz DNA i RNA<: sup class="xref">35,36.
- Przeszukaj bazę danych nukleotydów NCBI, aby uzyskać pełne sekwencje genomu 30 gatunków badnawirusów i wyeksportować je jako dokument w formacie .fasta. Prześlij sekwencje do oprogramowania, które przeprowadza ewolucyjną analizę genetyczną sekwencji wraz z sekwencjami genomu wirusa uzyskanymi przez NGS. Generuj wiele wyrównań sekwencji i drzew maksymalnego prawdopodobieństwa za pomocą MUSCLE37.
5. Ocena jakości sekwencjonowania de novo za pomocą amplifikacji PCR genomów wirusów z zakażonych roślin
- Wprowadź nowo zidentyfikowane sekwencje genomu badnawirusa o pełnej długości (format .fasta) do bezpłatnego narzędzia online Primer3, aby uzyskać startery PCR38. Zidentyfikuj zestawy starterów, które będą wytwarzać rozłożone w czasie produkty o stężeniu 1000-1500 pz na całej długości genomu (genomów) wirusa. Wyślij sekwencje do placówki serwisowej, która zsyntetyzuje i dostarczy startery PCR.
UWAGA: Dane wyjściowe identyfikują dopuszczalne pary starterów o typowych i akceptowalnych temperaturach topnienia oraz dokładne lokalizacje starterów wzdłuż wprowadzonych sekwencji. - Pracując na stole laboratoryjnym, ubrany w fartuch laboratoryjny i rękawice, wyizoluj 5 μg DNA z zakażonych wirusem i zdrowych liści kontrolnych przy użyciu zautomatyzowanej metody, która wykorzystuje standardowe paramagnetyczne cząstki celulozy do wyizolowania DNA z materiału roślinnego39 . Zamrozić materiał liściowy (20-40 mg) w ciekłym azocie w probówce mikrowirówkowej i zmielić za pomocą młynka perełkowego. Połączyć próbkę z buforem do lizy w probówce mikrowirówki i dodać RNazę A do każdej próbki. Wirować próbkę przez 10-20 s i krótko obracać próbkę, aby usunąć cząstki stałe.
UWAGA: Paramagnetyczne cząstki celulozy mają wysoką zdolność wiązania DNA i izolują wysoką wydajność czystego DNA. Standardowe komercyjne metody izolacji DNA z kolumną krzemionkową nie pozwalają skutecznie ekstrahować DNA z wielu różnych gatunków roślin. W związku z tym istnieją dziesiątki metod, które są modyfikacjami tych procedur w celu poprawy wydajności dla poszczególnych gatunków roślin. Zautomatyzowana metoda paramagnetycznych cząstek celulozy została wybrana, ponieważ pozwala uzyskać więcej i wyższej jakości DNA z ponad 25 gatunków okrytozalążkowych roślin zielnych40. - Używaj dostępnych w handlu wkładów z odczynnikami do automatycznej paramagnetycznej izolacji DNA. Dodaj 300 μl wody wolnej od nukleaz do każdego dostępnego w handlu wkładu z odczynnikiem i przenieś lizat roślinny do tego samego wkładu. Umieścić wkład w stojaku na wkłady, umieścić tłok w studzience najbliżej probówki elucyjnej i umieścić bufor elucyjny w probówce elucyjnej. Załaduj kartridże do automatycznej maszyny do izolacji kwasów nukleinowych i uruchom protokół izolacji DNA roślinnego41,42.
- Przeprowadź PCR, aby uzyskać zestaw nakładających się produktów PCR. Użyj 5 μM każdego startera do przodu i do tyłu z 35 cyklami amplifikacji PCR. Stosować następujące warunki cyklu: denaturacja w temperaturze 95 °C przez 60 s, wyżarzanie w temperaturze 50 °C przez 45 s i rozciąganie w temperaturze 72 °C przez 1-2 minuty z końcowym przedłużeniem w temperaturze 72 °C przez 7-10 minut. Użyj wstępnie zapakowanej żelowej kolumny filtracyjnej, aby wyeliminować sole i materiał o niskiej masie cząsteczkowej, jak w kroku 1.231.
- Oblicz stosunek molowy produktu PCR do wektora 3:1, aby określić ilość produktu PCR do ligacji do 50 ng zlinearyzowanego plazmidu pGEM43. Użyj kontrolnej wkładki DNA, aby określić, czy ligacje działają wydajnie. Przeprowadzić ligację przez noc przy użyciu ligazy DNA T4 (3 U/μL) w temperaturze 4 °C. Następnie przekształć komercyjnie przygotowane kompetentne komórki Escherichia coli JM109. Użyj kontroli 100 pg nieoszlifowanego plazmidowego DNA jako kontroli pozytywnej dla efektywnej transformacji. Umieść 100 μl przekształconych komórek na płytkach LB-agar z antybiotykiem i selekcją niebiesko-białą w celu odzyskania zligowanych plazmidów26. Inkubować płytki przez 16-24 h w temperaturze 37 °C.
UWAGA: Wektor pGEM ma gen lacZ, który koduje β-galaktozydazę. Przekształcone bakterie wyhodowane na płytce zawierającej 100 μg/ml ampicyliny, 0,5 mM IPTG, 80 μg/ml 5-bromo-4-chloro-3-indoilo-β-D-galaktopiranozydazy (X-gal) zmienią kolor na niebieski z powodu aktywności β-galaktozydazy. Plazmid pGEM jest linearyzowany w sposób, który zaburza gen lacZ. Kolonie, które zawierają insercje produktu PCR, zaburzają gen lacZ i nie metabolizują X-gal. Te kolonie są białe. W ten sposób kolonie z insertem można odróżnić od tych bez insertu na podstawie koloru kolonii (biały kontra niebieski)26. - Wyizoluj DNA z trzech kolonii za pomocą standardowego zestawu do izolacji plazmidu opartego na kolumnie39. Sekwencjonuj trzy plazmidy produktu przemiany. Porównaj każdą sekwencję DNA z genomami wirusa złożonymi de novo wyprodukowanymi przez NGS. Użyj CLUSTALW, aby wyrównać sekwencje i upewnić się, że są one odpowiednio uporządkowane.
Wyniki
Ta zmodyfikowana metoda oczyszczania wirusów zapewniła wzbogacenie kwasów nukleinowych wirusów, co było przydatne do identyfikacji dwóch gatunków wirusów za pomocą NGS i bioinformatyki. Po odwirowaniu homogenatu przy 40,000 x g przez 2,5 h, na dnie probówki pojawił się zielony osad, a wzdłuż jej ścianek osad biały. Zielony osad zawieszono ponownie w jednej probówce do mikrocentryfugi, a osad biały w dwóch probówkach do mikrocentryfugi. Reakcję PCR przeprowadzono z użyciem standardowych diagnostycznych starterów PCR dla CaYMV; produkty wykryto w rozpuszczonym osadzie białym, a nie w zielonym (Rycina 1A). Próbkę preparatu surowego zbadano za pomocą transmisyjnej mikroskopii elektronowej, w której zaobserwowano cząstki pałeczkowate o długości 124-133 nm (Rycina 1B). Mieści się to w przewidywanej modalnej długości większości badnawirusów. DNA wyekstrahowano z osadów białego i zielonego, a następnie zawieszono osobno. Na Rycynie 1C naniesiono 5 µL DNA wyekstrahowanego z próbek osadu zielonego i białego (1,6 µg DNA dla frakcji zielonej i 3,1 µg DNA dla frakcji białej) na żel agarozowy 0,8% do elektroforezy, a następnie przeanalizowano DNA po barwieniu bromkiem etydyny. Frakcja zielona zawierała DNA o niskiej masie cząsteczkowej, podczas gdy frakcja biała utworzyła dwa prążki DNA o wyższej masie cząsteczkowej, a także DNA o niższej masie cząsteczkowej (Rycina 1C). Żel przedstawiony na Rycynie 1C był poddawany elektroforezie przez 40 min przy 100 V; rozmycie w ścieżce 3 sugeruje, że napięcie żelu powinno zostać obniżone w celu uzyskania wyraźniejszych prążków. Dane te sugerują, że osad biały był wzbogacony w wiriony. Stężenie DNA (0,6 µg/mL) wyekstrahowanego z próbki białej było niskie, lecz wystarczające do NGS, który wymaga minimum 10 ng DNA do przeprowadzenia analizy. Fragmentowane DNA zostały wykorzystane do przygotowania biblioteki do NGS.
Równolegle, z zakażonych roślin kanny wyekstrahowano RNA (Rysunek 1D) do wysokoprzepustowego sekwencjonowania RNA-seq. Przeprowadzono standardowy proces przygotowania bibliotek, NGS, tworzenia kontigów oraz identyfikacji sekwencji genomu wirusa (Rysunek 1E). Porównano wyniki uzyskane przy zastosowaniu DNA i RNA jako materiałów wyjściowych.
Za pomocą NGS uzyskaliśmy 188 626 surowych odczytów DNA z DNA wyizolowanego z surowego preparatu wirusowego. Odczyty zmontowano w 13 269 kontigów, a następnie wykorzystano BLASTn do przeszukania zbioru sekwencji nukleotydowych NCBI (przy ograniczonym zakresie organizmów do Viridplantae TaxID: 33090 oraz Virus TaxID: 10239) (Rycina 1E). Wyniki NCBI-BLASTn wykazały, że 93% kontigów zmontowanych de novo stanowiły sekwencje komórkowe, 22% było nieznanych, a 0,3% stanowiły kontigi wirusowe (Rycina 2A). Większość kontigów sklasyfikowanych jako sekwencje komórkowe zidentyfikowano jako DNA mitochondrialne lub chloroplastowe. W zbiorze kontigów wirusowych 32% kontigów było powiązanych z członkami rodziny Caulimoviridae (które nie były sekwencjami Badnavirus), a 58% z nich było powiązanych z Badnavirus. Spośród kontigów wirusowych 29% wykazało wysoką 유사ność (e < 1 x 10-30) z genem ORF3 izolatu V17 CaYMV (EF189148.1), pełnym genomem izolatu Batavia D Sugarcane bacilliform virus (FJ439817.1) oraz pełnym genomem Banana streak CA virus (KJ013511). W tej populacji znajdowały się długie kontigi przypominające dwa pełnowymiarowe genomy.
Wysokoprzepustowe sekwencjonowanie RNA (RNA-seq) pozwoliło uzyskać 153 488 oczyszczonych pojedynczych odczytów sekwencji o średniej długości odczytu < 500 bp. Asemblacja kontigów zredukowała tę liczbę do 8 243 kontigów. Zostały one poddane analizie w bazie NCBI-BLASTn (przy zastosowaniu Viridplantae TaxID: 33090 oraz Virus TaxID: 10239 jako organizmów ograniczających), a wyniki wykazały, że 76% kontigów należało do kategorii komórkowych sekwencji roślinnych, 23% pozostało nieznanych, a 0,1% sklasyfikowano jako kontigi wirusowe (Rysunek 2B). Szczegółowa analiza populacji tych 0,1% kontigów wirusowych wykazała, że 68% z nich przypisano do rodziny Caulimoviridae (Rysunek 2B). Trzy duże kontigi w tej populacji zidentyfikowano jako wykazujące wysoką podobieństwo (e < 1 X 10-30) do genu ORF3 izolatu V17 CaYMV (EF189148.1), pełnego genomu izolatu Batavia D Sugarcane bacilliform virus (FJ439817.1) oraz pełnego genomu Banana streak CA virus (KJ013511). Po przeanalizowaniu trzech kontigów, ręcznie połączono dwa z nich w celu uzyskania pełnej długości genomu wirusa.
Porównano kontigi długości genomu wirusa uzyskane z sekwencjonowania DNA i RNA jako wzajemne rusztowanie, aby potwierdzić obecność dwóch pełnych genomów wirusowych. Jeden pełny genom wirusa o długości 6 966 bp został wstępnie nazwany Canna yellow mottle associated virus 1 (CaYMAV-1) (Rysunek 3A). Drugi genom miał długość 7 385 bp i był wariantem CaYMV infekującym Alpinia purpurata (CaYMV-Ap01) (Rysunek 3A).
Na koniec, startery PCR zaprojektowane do klonowania fragmentu o długości ~1,000 bp każdego z wirusów zostały wykorzystane do różnicowego wykrywania obu genomów w populacji 227 roślin kanny reprezentujących dziewięć odmian komercyjnych. W wielu przypadkach poszczególne rośliny były zainfekowane obydwoma wirusami. Przedstawiamy przykład detekcji RT-PCR CaYMAV-1 oraz CaYMV-Ap01 w 12 roślinach. Trzy z nich były pozytywne tylko w kierunku CaYMV-Ap01, a dziewięć było pozytywnych w kierunku obu wirusów (Rysunek 3B).
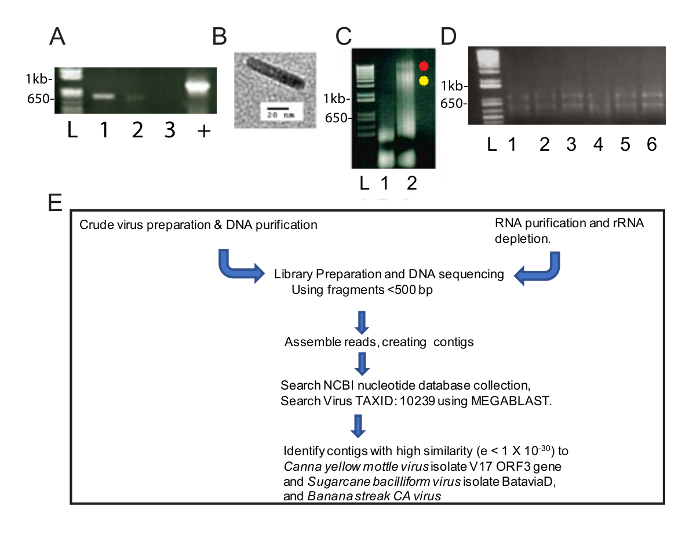
Rycina 1: Preparaty kwasów nukleinowych wirusa i schemat pracy NGS. (A) Elektroforeza w żelu agarozy (1,0%) fragmentów PCR o długości 565 bp genomów CaYMV. Dwa produkty PCR wykryto w próbkach przygotowanych z białego osadu (ścieżki 1, 2), ale nie w próbce z zielonego osadu (ścieżka 3). Kontrola pozytywna (+) przedstawia produkt PCR namnożony z DNA z zainfekowanej rośliny, które zostało wyizolowane za pomocą zautomatyzowanej metody z wykorzystaniem standardowych paramagnetycznych cząsteczek celulozy. Ścieżka L zawiera drabinę DNA użytą jako standard do pomiaru wielkości liniowych prążków DNA w ścieżkach z próbkami. (B) Przykład cząsteczki wirusa obrazowanej za pomocą transmisyjnej mikroskopii elektronowej w białym osadzie uzyskanym poprzez wstępne frakcjonowanie zainfekowanych liści kanny. (C) Elektroforeza w żelu agarozy (0,8%) DNA odzyskanego z zielonego (ścieżka 1) i białego (ścieżka 2) osadu, które dały wynik pozytywny w badaniu PCR w panelu A. Czerwona i żółta kropka obok ścieżki 2 wskazują dwa prążki DNA o wysokiej masie cząsteczkowej występujące w frakcji białej. (D) Elektroforeza w żelu agarozy (1%) całkowitego RNA odzyskanego za pomocą kolumnowej puryfikacji RNA. Ścieżka L zawiera drabinę DNA użytą jako standard do pomiaru wielkości liniowych prążków w ścieżkach z próbkami. Ścieżki 1-6 zawierają RNA wyizolowane z zainfekowanych liści kanny, które zostały połączone w jedną próbkę w celu przeprowadzenia ribo-depletion i RNA-seq. (E) Schematyczny przebieg izolacji kwasów nukleinowych, przygotowania bibliotek, sekwencjonowania, składania kontigów i identyfikacji genomu wirusa. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
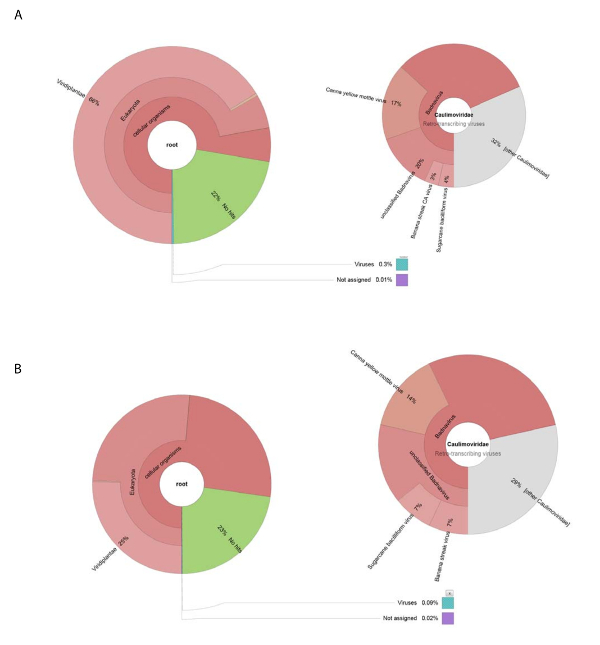
Rycina 2: Wykresy Krona wizualizujące kategorie taksonomiczne kontigów. (A) Wykres po lewej stronie przedstawia liczebność i rozkład taksonomiczny kontigów zmontowanych z surowego preparatu wirusowego. Wykres po prawej przedstawia proporcje kontigów wirusowych powiązanych z rodziną Caulimoviridae, rodzajem Badnavirus oraz trzema blisko spokrewnionymi gatunkami. (B) Panel po lewej stronie pokazuje liczebność kontigów pochodzących z RNA-seq w zależności od ich rozkładu taksonomicznego. Po prawej stronie znajduje się wykres przedstawiający liczebność kontigów w populacji kontigów wirusowych powiązanych z rodziną Caulimoviridae, rodzajem Badnavirus oraz trzema blisko spokrewnionymi gatunkami. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
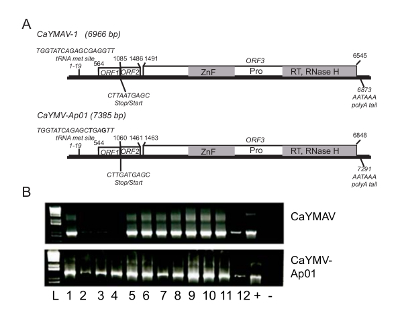
Rycina 3. Charakterystyka genomów CaYMAV-1 i CaYMV-Ap01. (A) Schematyczne przedstawienie genomów Canna yellow mottle associate virus 1 (CaYMAV) oraz wirusa podobnego do Canna yellow mottle virus, wyizolowanego z Alpinia purpurata (CaYMV-Ap01). Pozycje nukleotydowe 1-10 zidentyfikowano jako początek genomu; zawierają one miejsce antykodonu tRNAmet typowe dla większości genomów badnavirusów. Pozycje stop i start dla translacji otwartych ramek odczytu (ORF) 1 i 2 są sąsiadujące. Funkcje tych białek są nieznane. ORF3 to poliproteina zawierająca domeny palca cynkowego (ZnF), proteazy (Pro), odwrotnej transkryptazy (RT) oraz RNazy H. Sekwencja sygnału poly(A) na końcu 3' jest zachowana w obu genomach wirusowych. (B) Analizę RT-PCR przeprowadzono z wykorzystaniem RNA wyizolowanego z liści zainfekowanych wirusem oraz starterów wykrywających CaYMAV i CaYMV-Ap01. W tej samej populacji 12 roślin trzy były zainfekowane wyłącznie CaYMV-Ap01, natomiast pozostałe były zainfekowane zarówno CaYMAV, jak i CaYMV-Ap01. (+) oznacza kontrolę pozytywną, a (-) kontrolę negatywną. Rycina została powielona/zmodyfikowana z pracy Wijayasekara et al.24 za zgodą autorów. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
Dyskusja
W ostatnich latach do badania różnorodności biologicznej wirusów roślinnych w środowisku naturalnym zastosowano różne metody, które obejmują wzbogacanie o cząsteczki wirusopodobne (VLP) lub RNA lub DNA specyficzne dla wirusa 2,3,44,45,46 . Po tych metodach stosuje się NGS i analizę bioinformatyczną. Celem tego badania było znalezienie czynnika wywołującego powszechną chorobę w uprawianej roślinie. Doniesiono, że choroba jest wynikiem nieznanego wirusa, który ma bezotoczkowe cząsteczki pałeczek i dla którego sklonowano tylko fragment o długości 565 pz47. Informacje te były wystarczające dla wcześniejszych badaczy, aby hipotetycznie przypisać wirusa do rodzaju Badnavirus w rodzinie Caulimoviridae. Podczas gdy wcześniejsze doniesienia stawiały hipotezę, że choroba plamistości konopi w liliach kanciastych była wynikiem pojedynczego badnawirusa, stosując podejście metagenomiczne przedstawione w tym badaniu, ustaliliśmy, że choroba była spowodowana przez dwa wstępnie zidentyfikowane gatunki badnawirusa24. Tak więc mocną stroną stosowania podejścia metagenomowego do odkrycia czynnika przyczynowego choroby jest to, że możemy teraz zidentyfikować sytuacje, w których może istnieć więcej niż jedna przyczyna.
Nasze podejście łączące dane sekwencjonowania DNA i RNA jest dokładne i pokazuje również, że wyniki przy użyciu dwóch podejść przyniosły spójne wyniki i potwierdziły obecność dwóch pokrewnych wirusów. Zastosowaliśmy zmodyfikowaną procedurę izolacji kalalimowirusów i wyprodukowaliśmy próbkę, która została wzbogacona o kwasy nukleinowe związane z wirusem i które były chronione w kapsydzie wirusa. Do przeprowadzenia sekwencjonowania DNA zlecono laboratorium serwisowemu. Podstawową koncepcją sekwencjonowania de novo jest to, że polimeraza DNA włącza znakowane fluorescencyjnie nukleotydy do nici matrycowej DNA podczas sekwencyjnych cykli syntezy DNA. Złożone kontigi, a następnie NGS zostały poddane bioinformatycznemu procesowi pracy, w wyniku którego powstało kilka kontigów, które zostały zidentyfikowane jako kontigi wirusów. Dalsze potwierdzenie dwóch genomów wirusa 10,24,48,49,50 uzyskano poprzez analizę bioinformatyczną danych sekwencyjnych RNA uzyskanych z preparatów RNA zubożonych w rybo. Jednym z interesujących wyników było dowiedzenie się, że populacje sekwencji odzyskanych przez sekwencjonowanie DNA i RNA zapewniają podobne rozkłady niewirusowych i wirusowych kwasów nukleinowych. W przypadku sekwencjonowania DNA i RNA < 0,5% sekwencji było pochodzenia wirusowego. W populacji sekwencji wirusa 78-82% należało do rodziny Caulimoviridae. Porównując złożone kontigi wirusa z sekwencjonowania DNA i RNA, potwierdziliśmy, że dwa złożone genomy wystąpiły w obu zestawach danych.
Problem związany z używaniem tylko sekwencjonowania DNA do identyfikacji nowych genomów wirusa polega na tym, że genom badnawirusa jest otwartym okrągłym DNA. Przypuszczaliśmy, że sekwencje nakładające się na nieciągłości w genomie mogą stanowić przeszkodę w składaniu genomu z kontigów. Wstępne badanie wyników sekwencjonowania DNA ujawniło dwa podobne genomy wirusa. Postawiliśmy hipotezę, że genomy te albo reprezentują różnorodność genetyczną gatunku, który nie był badany, albo reprezentują dwa gatunki jednocześnie infekujące tę samą roślinę24. W związku z tym zbiorowa analiza bioinformatyczna zbiorów danych uzyskanych za pomocą sekwencjonowania DNA i RNA NGS, umożliwiła potwierdzenie obecności dwóch genomów o pełnej długości.
W innym raporcie opracowano alternatywną metodę ekstrakcji VLP i kwasów nukleinowych z homogenatów roślinnych do badań metagenomicznych, opartą na procedurach odzyskiwania DNA z wirusa mozaiki kalafiora (CaMV; kalafiowirusa)3. W ramach tego podejścia zidentyfikowano nowe sekwencje wirusów RNA i DNA w roślinach nieuprawianych. Etapy wyprowadzone z procedury izolacji kalafimowirusa zastosowanej w tym badaniu w celu wykrycia czynnika wywołującego chorobę roślin uprawnych różnią się od etapów wyznaczonych do ekstrakcji VLP z naturalnie zakażonych roślin24. Sukces obu zmodyfikowanych metod sugeruje, że ramowa procedura izolacji kaulimowirusa może być cennym punktem wyjścia dla badań metagenomicznych wirusów roślinnych w ogóle.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Badania zostały sfinansowane przez Oklahoma Center for Advancement of Science and Technology Applied Research Program Phase II AR 132-053-2; oraz przez Oklahoma Department of Agriculture Specialty Crops Research Grant Program. Dziękujemy dr HongJin Hwang i OSU Bioinformatics Core Facility, który był wspierany przez granty z NSF (EOS-0132534) i NIH (2P20RR016478-04, 1P20RR16478-02 i 5P20RR15564-03).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| NaH2PO4 | Sigma-Aldrich St. Louis MO | S5976 | Bufor mielący do oczyszczania wirusów |
| Na2HPO4 | Sigma-Aldrich | S0751 | Bufor mielący do oczyszczania wirusów |
| Na2SO3 | Thermo-Fisher Waltham, MA | 28790 | Bufor mielący do oczyszczania |
| wirusów mocznik | Thermo-Fisher | PB169-212 | Ekstrakcja homogenatu |
| Triton X-100 | Sigma-Aldrich | Ekstrakcja homogenatu | X-100 |
| Gaza | VWR Radnor, PA | 21910-107 | Homogenat filtracyjny |
| Tris | Thermo-Fisher | BP152-5 | Zawieszenie peletów i do resuspension DNA |
| MgCl2 | Spectrum, Gardena, CA | M1035 | Bufor do resuspension w postaci granulek |
| EDTA | Spectrum | E1045 | Zatrzymuje reakcje enzymatyczne |
| Proteinaza K | Thermo-Fisher | 25530 | Bufor do resuspension DNA |
| fenol:chloroform:alkohol izoamylowy | Sigma-Aldrich | P2069 | Rozpuszczanie białek wirionu |
| DNAza I | Promega | M6101 | Degradacja DNA komórkowego z ekstraktów |
| 95% etanolu | Wirus Sigma-Aldrich | 6B-100 | Wytrącanie DNA Blender |
| laboratoryjny | VWR | 58984-030 | Mielenie próbek liści |
| Model podłogowy ultrawirówka & Wirnik Ti70 | Beckman Coulter, Irving TX | A94471 | Separacja ekstraktów komórkowych |
| Wirówka podłogowa i wirnik JA-14 | Beckman Coulter | 369001 | Separacja ekstraktów komórkowych |
| Mieszadło magnetyczne | VWR | 75876-022 | Mieszanie mocznika z próbkami przez noc |
| Gumowy policjant | VWR | 470104-462 | Rozpuść granulkę wirusa |
| Bioanalizator 2100 Instrument | Agilent Genomics, Santa Clare, CA | G2939BA | Czułe wykrywanie jakości i ilości DNA i RNA |
| 2100 Bioanalyzer RNA-Picochip | 5067-1513 | Chip mikroprzepływowy służący do przenoszenia, barwienia i pomiaru jakości RNA w 2100 Bioanalyzer | |
| 2100 Bioanalyzer Chip | 5067-4626 | Chip mikrofluidyczny używany do przenoszenia, barwienia i pomiaru jakości DNA w bioanalizatorze 2100 | |
| Spektrofotometr | Nanodrop Thermo-Fisher | ND-2000 | Analiza jakości DNA/RNA na pośrednich etapach procedur |
| Zestaw do izolacji całkowitego RNA roślin | Sigma-Aldrich | STRN50-1KT | Izolat RNA do sekwencji |
| RNaz bez wody | VWR | 10128-514 | Ponowne zawieszenie DNA i RNA do |
| kolumny wirowej koncentratora RNA | Zymo Research, Irvine, CA | R1013 | Przygotowanie RNA do |
| zestawu do usuwania rRNA | sekwencyjnego Illumina, San Diego, CA | MRZPL116 | Przygotowanie RNA do sekwencji RNA |
| Magnes DynaMag-2 | ThermoFisher | 12321D | Przygotowanie RNA do sekwencjonowania RNA |
| RNA system wzbogacania | Roche | 7277300001 | Przygotowanie RNA dla sekwencji RNA |
| Agarozy | Thermo-Fisher | 16500100 | Żel analiza jakości DNA/RNA na pośrednich etapach zabiegów |
| Bromek etydyny | Thermo-Fisher | 15585011 | Barwienie żelem agarozowym |
| kompetentne komórki pGEM-T + JM109 Promega | , Madison, WI | A3610 | Klonowane fragmenty genomu |
| polimeraza pFU Taq | Promega | M7741 | PCR amplifikacja genomu wirusa |
| dNTPs | Promega | U1511 | PCR amplifikacja genomu wirusa |
| Oligonukleotydy | PCR IDT, Coralvill, IA | Niestandardowe zamówienie | PCR amplifikacja genomu wirusa |
| Zestaw do oczyszczania DNA Miniprep | Promega | A1330 | Oczyszczanie plazmidowego DNA przed sekwencjonowaniem |
| Zestaw do czyszczenia PCR | Promega | A9281 | Przygotuj produkty PCR do klonowania |
| oprogramowania pDRAW32 | ACAClone | Komputerowa analiza kolistego DNA i motywów | |
| MEGA6.0 oprogramowanie | MEGA | Analiza genetyki ewolucyjnej molekularnej | |
| Elementarz 3.0 | Simgene.com | ||
| Quant-iT™ RiboGreen&handel; Zestaw do oznaczania RNA | Thermo-Fisher | R11490 | Fluorometryczne oznaczanie ilości RNA |
| GS Junior&trade System pirosekwencjonowania | Platforma sekwencjonowania Roche | 5526337001 | Zestaw do sekwencjonowania |
| GS Junior Titanium EmPCR (Lib-A) | 5996520001Odczynniki | emulsji PCR | |
| GS Jr EmPCR Odczynniki do odzyskiwania kulek | Roche | 5996490001 | Odczynniki do emulsji PCR |
| Odczynniki GS Junior EmPCR (Lib-A) | Odczynniki 5996538001 Roche | do emulsji PCR | |
| GS Jr EmPCR Oil & Zestaw do łamania | Odczynniki do | emulsji PCR | |
| 5996511001 Zestaw do sekwenikowania tytanu GS Jr | Roche | 5996554001 | Zawiera odczynniki do sekwencjonowania, enzymy, i kulki do pakowania |
| GS Jr. Zestaw tytanowych płytek pikotytowych Roche | 5996619001 | Płytka sekwencyjna z powiązanymi odczynnikami i uszczelkami | |
| Mieszalnik | 3646000 | Specjalny mieszalnik używany z Turrax Probówki | |
| IKA Turrax Tube (specjalistyczny mieszalnik) | 20003213 | Specjalistyczne rurki mieszające z wewnętrznym wirnikiem do tworzenia emulsji | |
| GS Nebulizatory Kit | Roche | 5160570001 | Frakcjonator wielkości kwasu nukleinowego do stosowania podczas przygotowań bibliotecznych |
| GS Junior emPCR Bead Counter | Roche | 05 996 635 001 | Biblioteczny licznik koralików |
| GS Junior Urządzenie do osadzania koralików | Roche | 05 996 473 001 | Uchwyt na płytkę Pikotitera podczas wirowania |
| Przeciwwaga i Adapter do urządzeń do osadzania kulek | Roche | 05 889 103 001 | Służy do równoważenia urządzenia do osadzania z wirowaniem płytkowym pikotitera |
| Oprogramowanie GS Junior | Roche | 05 996 643 001 | Pakiet oprogramowania do sterowania instrumentem, zbierania i analizowania danych |
| GS Junior Sequencer Control v. 3.0 | Roche | (zawarty w pozycji 05 996 643 001 powyżej) | |
| GS Run Processor v. 3.0 | Roche | (Zawarte w pozycji 05 996 643 001 powyżej) | |
| GS De Novo Assembler v. 3.0 | Roche | (Zawarte w pozycji 05 996 643 001 powyżej) | |
| GS Reference Mapper v. 3.0 | Roche | (Zawarte w pozycji 05 996 643 001 powyżej) | |
| GS Amplicon Variant Analyzer v. 3.0 | Roche | (Zawarte w pozycji 05 996 643 001 powyżej) |
Bibliografia
- Dijkstra, J., Jager, C. P. Practical Plant Virology : Protocols and Exercises. , Springer-Verlag. Berlin Heidelberg. 1 edn (1998).
- Roossinck, M. J. Plant virus metagenomics: biodiversity and ecology. Annu Rev Genet. 46, 359-369 (2012).
- Melcher, U., et al. Evidence for novel viruses by analysis of nucleic acids in virus-like particle fractions from Ambrosia psilostachya. J Virol Methods. 152 (1-2), 49-55 (2008).
- Stobbe, A. H., Schneider, W. L., Hoyt, P. R., Melcher, U. Screening metagenomic data for viruses using the e-probe diagnostic nucleic Acid assay. Phytopathology. 104 (10), 1125-1129 (2014).
- Borah, B. K., et al. Bacilliform DNA-containing plant viruses in the tropics: commonalities within a genetically diverse group. Mol Plant Pathol. 14 (8), 759-771 (2013).
- Bousalem, M., Douzery, E. J., Seal, S. E. Taxonomy, molecular phylogeny and evolution of plant reverse transcribing viruses (family Caulimoviridae) inferred from full-length genome and reverse transcriptase sequences. Arch Virol. 153 (6), 1085-1102 (2008).
- Geering, A. D., et al. Banana contains a diverse array of endogenous badnaviruses. J Gen Virol. 86, Pt 2 511-520 (2005).
- Kunii, M., et al. Reconstruction of putative DNA virus from endogenous rice tungro bacilliform virus-like sequences in the rice genome: implications for integration and evolution. BMC Genomics. 5, 80(2004).
- Laney, A. G., Hassan, M., Tzanetakis, I. E. An integrated badnavirus is prevalent in Figure germplasm. Phytopathology. 102 (12), 1182-1189 (2012).
- Gambley, C. F., Geering, A. D., Steele, V., Thomas, J. E. Identification of viral and non-viral reverse transcribing elements in pineapple (Ananas comosus), including members of two new badnavirus species. Arch Virol. 153 (8), 1599-1604 (2008).
- Gayral, P., et al. A single Banana streak virus integration event in the banana genome as the origin of infectious endogenous pararetrovirus. J Virol. 82 (13), 6697-6710 (2008).
- Lyttle, D. J., Orlovich, D. A., Guy, P. L. Detection and analysis of endogenous badnaviruses in the New Zealand flora. AoB Plants. 2011, 008(2011).
- Le Provost, G., Iskra-Caruana, M. L., Acina, I., Teycheney, P. Y. Improved detection of episomal Banana streak viruses by multiplex immunocapture PCR. J Virol Methods. 137 (1), 7-13 (2006).
- Singh, K., Talla, A., Qiu, W. Small RNA profiling of virus-infected grapevines: evidences for virus infection-associated and variety-specific miRNAs. Funct Integr Genomics. 12 (4), 659-669 (2012).
- Alfson, K. J., Beadles, M. W., Griffiths, A. A new approach to determining whole viral genomic sequences including termini using a single deep sequencing run. J Virol Methods. 208, 1-5 (2014).
- Kreuze, J. F., et al. Complete viral genome sequence and discovery of novel viruses by deep sequencing of small RNAs: a generic method for diagnosis, discovery and sequencing of viruses. Virology. 388 (1), 1-7 (2009).
- Zheng, Y., et al. VirusDetect: An automated pipeline for efficient virus discovery using deep sequencing of small RNAs. Virology. 500, 130-138 (2017).
- James, A. P., Geijskes, R. J., Dale, J. L., Harding, R. M. Molecular characterisation of six badnavirus species associated with leaf streak disease of banana in East Africa. Annals of Applied Biology. 158 (3), 346-353 (2011).
- Baranwal, V. K., Sharma, S. K., Khurana, D., Verma, R. Sequence analysis of shorter than genome length episomal Banana streak OL virus like sequences isolated from banana in India. Virus Genes. 48 (1), 120-127 (2014).
- Sukal, A., Kidanemariam, D., Dale, J., James, A., Harding, R. Characterization of badnaviruses infecting Dioscorea spp. in the Pacific reveals two putative novel species and the first report of dioscorea bacilliform RT virus 2. Virus Res. 238, 29-34 (2017).
- BÖmer, M., Turaki, A. A., Silva, G., Kumar, P. L., Seal, S. E. A sequence-independent strategy for amplification and characterisation of episomal badnavirus sequences reveals three previously uncharacterised yam badnaviruses. Viruses. 8 (7), (2016).
- Momol, M. T., Lockhart, B. E. L., Dankers, H., Adkins, S. Canna yellow mottle virus detected in Canna in Florida. Plant Health Progress. , August 2-4 (2004).
- Zhang, J., et al. Characterization of Canna yellow mottle virus in a new host, Alpinia purpurata, in Hawaii. Phytopathology. 107 (6), 791-799 (2017).
- Wijayasekara, D., et al. Molecular characterization of two badnavirus genomes associated with Canna yellow mottle disease. Virus Res. 243, 19-24 (2018).
- Covey, S. N., Noad, R. J., al-Kaff, N. S., Turner, D. S. Caulimovirus isolation and DNA extraction. Methods Mol Biol. 81, 53-63 (1998).
- Sambrook, J., Fritsch, E. F., Maniatis, T. Molecular cloning: A laboratory manual. 2nd edn. , Cold Spring Harbor Press. (1989).
- Radford, A. D., et al. Application of next-generation sequencing technologies in virology. J Gen Virol. 93, Pt 9 1853-1868 (2012).
- Kanagal-Shamanna, R. Emulsion PCR: Techniques and Applications. Methods Mol Biol. 1392, 33-42 (2016).
- Getts, D. R., et al. Targeted blockade in lethal West Nile virus encephalitis indicates a crucial role for very late antigen (VLA)-4-dependent recruitment of nitric oxide-producing macrophages. J Neuroinflammation. 9, 246(2012).
- van Dijk, E. L., Jaszczyszyn, Y., Thermes, C. Library preparation methods for next-generation sequencing: tone down the bias. Exp Cell Res. 322 (1), 12-20 (2014).
- Gel filtration principles and methods. GE Healthcare. , (2010).
- Goff, S., et al. The iPlant Collaborative: Cyberinfrastructure for Plant Biology. Frontiers in Plant Science. 2, (2011).
- Lin, Z., et al. Next-generation sequencing and bioinformatic approaches to detect and analyze influenza virus in ferrets. J Infect Dev Ctries. 8 (4), 498-509 (2014).
- Artimo, P., et al. ExPASy: SIB bioinformatics resource portal. Nucleic Acids Res. 40, Web Server issue 597-603 (2012).
- Edgar, R. C. MUSCLE: a multiple sequence alignment method with reduced time and space complexity. BMC Bioinformatics. 5, 113(2004).
- Hung, J. H., Weng, Z. Sequence Alignment and Homology Search with BLAST and ClustalW. Cold Spring Harb Protoc. 2016 (11), (2016).
- Sohpal, V. K., Dey, A., Singh, A. MEGA biocentric software for sequence and phylogenetic analysis: a review. Int J Bioinform Res Appl. 6 (3), 230-240 (2010).
- Untergasser, A., et al. Primer3--new capabilities and interfaces. Nucleic Acids Res. 40 (15), 115(2012).
- Dhaliwa, A. DNA extraction and purification. Mater Methods. 3, 191(2013).
- Moeller, J. R., Moehn, N. R., Waller, D. M., Givnish, T. J. Paramagnetic cellulose DNA isolation improves DNA yield and quality among diverse plant taxa. Appl. Plant Sci. 2 (10), (2014).
- Moeller, J. R., et al. Paramagnetic cellulose DNA isolation improves DNA yield and quality among diverse plant taxa. Appl. Plant Sci. 2 (10), (2014).
- Grooms, K. Review: Improved DNA Yield and Quality from Diverse Plant Taxa. , (2015).
- Nishimori, A., et al. In vitro and in vivo antivirus activity of an anti-programmed death-ligand 1 (PD-L1) rat-bovine chimeric antibody against bovine leukemia virus infection. PLoS One. 12 (4), 0174916(2017).
- Rojas, M. R., Gilbertson, R. L. Plant Virus Evolution. Roossinck, M. J. 1, Springer-Verlag. 27-51 (2008).
- Roossinck, M. J. The big unknown: plant virus biodiversity. Curr Opin Virol. 1 (1), 63-67 (2011).
- Roossinck, M. J., Martin, D. P., Roumagnac, P. Plant Virus Metagenomics: Advances in Virus Discovery. Phytopathology. 105 (6), 716-727 (2015).
- Momol, M. T., Lockhart, B. E. L., Dankers, H., Adkins, S. Plant Health Progress. , Online (2004).
- Eni, A., Hughes, J. D., Asiedu, R., Rey, M. Sequence diversity among badnavirus isolates infecting yam (Dioscorea spp.). Archives of Virology. 153 (12), Ghana, Togo, Benin and Nigeria. 2263-2272 (2008).
- Harper, G., et al. The diversity of Banana streak virus isolates in Uganda. Arch Virol. 150 (12), 2407-2420 (2005).
- Muller, E., Sackey, S. Molecular variability analysis of five new complete cacao swollen shoot virus genomic sequences. Arch Virol. 150 (1), 53-66 (2005).
Przedruki i uprawnienia
