Indywidualne sekwencjonowanie prowirusowe o pełnej długości (FLIPS) zapewnia efektywną i wysokoprzepustową metodę amplifikacji i sekwencjonowania pojedynczych, prawie pełnej długości (nienaruszonych i wadliwych) prowirusów HIV-1 i pozwala na określenie ich potencjalnej zdolności replikacyjnej. Projekt FLIPS pozwala przezwyciężyć ograniczenia poprzednich testów zaprojektowanych do sekwencjonowania utajonego rezerwuaru HIV-1.
Artykuł metodologiczny
Amplifikacja prowirusów HIV-1 o niemal pełnej długości do sekwencjonowania nowej generacji
W tym artykule
Podsumowanie
Streszczenie
Test Full-Length Individual Proviral Sequencing (FLIPS) jest efektywną i wysokoprzepustową metodą przeznaczoną do amplifikacji i sekwencjonowania pojedynczych, prawie pełnej długości (nienaruszonych i uszkodzonych) prowirusów HIV-1. FLIPS umożliwia określenie składu genetycznego zintegrowanego wirusa HIV-1 w populacji komórek. Poprzez identyfikację defektów w sekwencjach prowirusa HIV-1, które powstają podczas odwrotnej transkrypcji, takich jak duże delecje wewnętrzne, szkodliwe kodony stop/hipermutacje, mutacje przesunięcia ramki odczytu oraz mutacje/delecje w elementach cispłciowych wymaganych do dojrzewania wirionu, FLIPS może zidentyfikować zintegrowane prowirusy niezdolne do replikacji. Test FLIPS może być wykorzystany do identyfikacji prowirusów HIV-1, które nie mają tych defektów, a zatem są potencjalnie zdolne do replikacji. Protokół FLIPS obejmuje: lizę komórek zakażonych wirusem HIV-1, zagnieżdżony PCR prowirusów HIV-1 o niemal pełnej długości (przy użyciu starterów ukierunkowanych na LTR HIV-1 5' i 3'), oczyszczanie i kwantyfikację DNA, przygotowanie biblioteki do sekwencjonowania nowej generacji (NGS), NGS, składanie de novo kontigów prowirusowych oraz prosty proces eliminacji w celu identyfikacji prowirusów kompetentnych do replikacji. FLIPS zapewnia przewagę nad tradycyjnymi metodami zaprojektowanymi do sekwencjonowania zintegrowanych prowirusów HIV-1, takimi jak sekwencjonowanie pojedynczego wirusa. FLIPS amplifikuje i sekwencjonuje prawie pełnowymiarowe prowirusy, umożliwiając określenie kompetencji replikacyjnych, a także wykorzystuje mniej starterów amplifikacyjnych, zapobiegając konsekwencjom niedopasowania starterów. FLIPS jest użytecznym narzędziem do zrozumienia genetycznego krajobrazu zintegrowanych prowirusów HIV-1, zwłaszcza w obrębie utajonego rezerwuaru, jednak jego wykorzystanie może rozszerzyć się na każde zastosowanie, w którym wymagany jest skład genetyczny zintegrowanego HIV-1.
Wprowadzenie
Charakterystyka genetyczna latentnego rezerwuaru HIV-1, który utrzymuje się u osób przyjmujących długotrwałą terapię antyretrowirusową (ART), miała kluczowe znaczenie dla zrozumienia, że większość zintegrowanych prowirusów jest wadliwych i niezdolnych do replikacji1,2. Podczas procesu odwrotnej transkrypcji do zintegrowanej sekwencji prowiralnej wprowadzane są błędy. Mechanizmy generujące wadliwe sekwencje prowiralne obejmują m.in. podatną na błędy odwrotną transkryptazę HIV-13, przeskakiwanie matrycy4 oraz/lub hipermutację indukowaną przez APOBEC5,6. Dwa niedawne badania wykazały, że około 5% prowirusów HIV-1 wyizolowanych od osób na długotrwałej ART jest genetycznie nienaruszonych i potencjalnie zdolnych do replikacji, co może przyczyniać się do szybkiego wzrostu poziomu HIV-1 w osoczu po zaprzestaniu ART1,2,7. Wcześniejsze badania wykazały, że zdolne do replikacji prowirusy HIV-1 utrzymują się w naiwnych oraz spoczywających podzbiorach komórek T pamięci CD4+ (w tym w komórkach T pamięci centralnej, przejściowej i efektorowej), co wskazuje na znaczenie celowania w te komórki w przyszłych strategiach eradykacji2,8,9.
Wczesne informacje na temat rozmieszczenia, dynamiki i utrzymywania się latentnego rezerwuaru HIV-1 uzyskano dzięki zastosowaniu metod sekwencjonowania pojedynczych prowirusów (SPS), które genetycznie charakteryzują regiony subgenomowe genomu HIV-110,11,12,13. SPS jest wszechstronnym narzędziem, umożliwiającym sekwencjonowanie pojedynczego prowirusa HIV-1 z jednej zainfekowanej komórki. Jednakże SPS nie pozwala na określenie zdolności prowirusów do replikacji, ponieważ sekwencjonuje jedynie regiony subgenomowe i pomija prowirusy zawierające duże delecje w miejscach wiązania starterów. Wcześniejsze badanie wykazało, że SPS zawyża wielkość rezerwuaru zdolnego do replikacji od 13 do 17 razy poprzez selektywne sekwencjonowanie nienaruszonych regionów subgenomowych2.
Aby rozwiązać ograniczenia metody SPS, Ho et al.4 oraz Bruner et al.1 opracowali testy służące do sekwencjonowania niemal pełnej długości prowirusów HIV-1. Pozwoliło to na określenie częstości występowania genetycznie nienaruszonych i potencjalnie zdolnych do replikacji prowirusów HIV-1 u osób przyjmujących długoterminową terapię ART. W testach tych amplifikowano i sekwencjonowano (metodą Sangera) regiony subgenomowe, które następnie składano w celu uzyskania sekwencji (nienaruszonego lub wadliwego) prowirusa HIV-1. Trzema ograniczeniami tego podejścia są: 1) stosowanie wielu starterów do sekwencjonowania zwiększa ryzyko niezamierzonego wprowadzenia defektów do sekwencji prowiralnej, 2) niedopasowania starterów mogą uniemożliwić amplifikację konkretnych prowirusów, a 3) często nie można zrekonstruować całej sekwencji prowiralnej ze względu na kwestie techniczne tych metod.
Aby przezwyciężyć ograniczenia istniejących testów sekwencjonowania pełnych prowirusów HIV-1, opracowaliśmy test Full-Length Individual Proviral Sequencing (FLIPS). FLIPS jest testem opartym na sekwencjonowaniu następnej generacji (NGS), który w sposób wydajny i wysokoprzepustowy amplifikuje i sekwencjonuje niemal pełne (nienaruszone lub wadliwe) prowirusy HIV-1. FLIPS oferuje zalety w porównaniu z poprzednimi testami, ponieważ ogranicza liczbę wykorzystywanych starterów; w związku z tym zmniejsza ryzyko niedopasowania starterów, co mogłoby ograniczyć populację wychwyconych prowirusów lub nieumyślnie wprowadzić defekty do sekwencji wirusowej. FLIPS jest również mniej wymagający technicznie niż poprzednie metody i obejmuje 6 głównych etapów: 1) lizę komórek zainfekowanych HIV-1, 2) amplifikację pojedynczych prowirusów HIV-1 za pomocą zagnieżdżonej PCR przeprowadzonej przy ograniczonym rozcieńczeniu z użyciem starterów specyficznych dla wysoce konserwowanego regionu 5' i 3' U5 LTR HIV-1 (Ryc. 1A), 3) oczyszczanie i ilościowe oznaczenie produktów amplifikacji, 4) przygotowanie biblioteki amplifikowanych prowirusów do NGS, 5) NGS oraz 6) montaż de novo zsekwencjonowanych prowirusów w celu uzyskania kontigów każdego pojedynczego prowirusa.
Sekwencje wygenerowane przez metodę FLIPS mogą zostać poddane rygorystycznemu procesowi eliminacji w celu zidentyfikowania tych, które są nienaruszone genetycznie i potencjalnie zdolne do replikacji (Rycina 1C)2. Genetycznie nienaruszone prowirusy są pozbawione wszystkich znanych defektów, które prowadzą do powstania prowirusa niezdolnego do replikacji. Defekty te obejmują: sekwencje inwersyjne, duże delecje wewnętrzne, hipermutacje/szkodliwe kodony stop, przesunięcia ramki odczytu lub mutacje w sygnale pakowania 5' bądź w głównym miejscu donora splicingu (MSD).
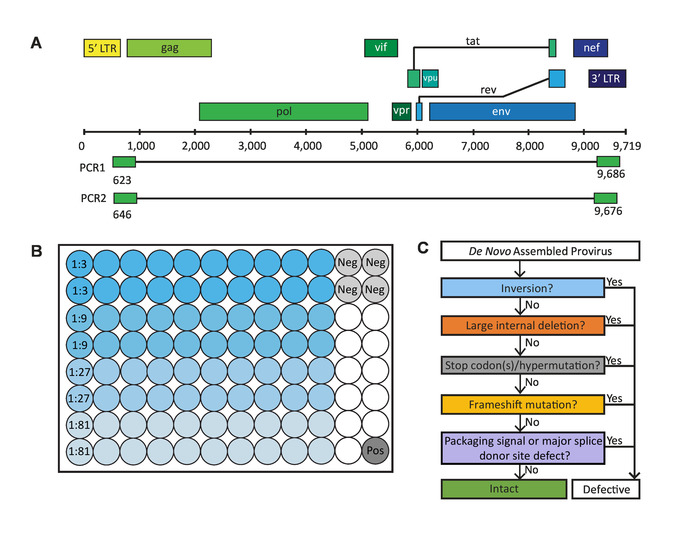
Rycina 1: Kluczowe etapy testu sekwencjonowania pełnej długości pojedynczych prowirusów (FLIPS). (A) Genom DNA HIV-1 z miejsc wiązania starterów w regionach 5' i 3' U5 LTR wykorzystywanych w metodzie FLIPS do amplifikacji prawie pełnych (defektywnych i nienaruszonych) prowirusów HIV-1 za pomocą nested PCR. (B) Układ 96-dołkowej płytki PCR zawierającej 80 dołków z próbkami (20 dołków dla każdego rozcieńczenia), 4 dołki kontroli negatywnej i 1 dołek kontroli pozytywnej. (C) Proces eliminacji stosowany w celu identyfikacji genetycznie nienaruszonych i potencjalnie zdolnych do replikacji prowirusów HIV-1. Rycina została zmodyfikowana na podstawie pracy Hiener et al.2. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
Protokół
Wszystkie opisane tutaj metody zostały zatwierdzone przez instytucjonalne komisje rewizyjne na Uniwersytecie Kalifornijskim w San Francisco i Zachodnim Dystrykcie Zdrowia Sydney, w skład którego wchodzi Instytut Badań Medycznych Westmead.
1. Liza komórek zakażonych wirusem HIV-1
UWAGA: Komórki mogą być izolowane z krwi obwodowej, próbek leukaferezy, biopsji szpiku kostnego lub biopsji tkanek. Populacje komórek można sortować za pomocą sortowania komórek aktywowanego fluorescencją (FACS).
- Przygotuj bufor do lizy zawierający 10 mM Tris-HCl, 0,5% Nonidet P-40, 0,5% Tween-20 i 0,3 mg/ml proteinazy K. Do osadu komórkowego dodać 100 μl buforu do lizy na 1 x 10⁶ komórek. Pipetować w górę i w dół, aby wymieszać. Inkubować w temperaturze 55 °C przez 1 godzinę, a następnie w temperaturze 85 °C przez 15 minut w celu lizy komórek i uwolnienia genomowego DNA do amplifikacji PCR.
UWAGA: Liza komórek jest wystarczająca do uzyskania genomowego DNA do amplifikacji. Nie jest wymagana izolacja ani oczyszczanie DNA. W tym momencie protokół może zostać wstrzymany, a genomowe DNA może być przechowywane w temperaturze -20 °C przez czas nieokreślony.
2. Amplifikacja pojedynczych prowirusów DNA HIV-1 za pomocą zagnieżdżonego PCR
- Wymieszać odczynniki do pierwszej rundy PCR (PCR1) wymienione w Tabeli 1 (patrz Tabela Materiałów). Dodaj 38 μl mieszanki głównej do 85 dołków (80 próbek, 4 kontrole ujemne, 1 kontrola pozytywna) 96-dołkowej płytki PCR (postępuj zgodnie z układem w Rysunek 1B). Oznaczyć tę płytkę jako "PCR1".
| Odczynnik | Stężenie końcowe | Objętość na płytkę PCR1 (μL) | Objętość dla płytki PCR2 (μL) |
| Podkład do przodu | 1 μM | Nr 32,3 | Rozdział 23,8 |
| Podkład odwrotny | 1 μM | Nr 32,3 | Rozdział 23,8 |
| Bufor (10x) | 1x | 323 | 238 |
| MgSO4 (50 mM) | 2 mM | 129,2 | Nr 95,2 |
| dNTP (10 mM) | 0,2 mM | 64,6 | 47,6 |
| Polimeraza DNA (5 U/μL) | 0,025 U/μL | Rozdział 16,2 | Pytanie 11,9 |
| Ultraczysty H2O | 2632.5 | Rok 1939.7 |
Tabela 1: Odczynniki i objętości do głównych mieszanek PCR.
UWAGA: Startery używane do PCR1 to:
BLOuterF: 5'-AAATCTCTAGCAGTGGCGCCCGAACAG-3' (pozycja HXB2 623-649)
BLOuterR: 5'-TGAGGGATCTCTAGTTACCAGAGTC-3' (pozycja HXB2 9662-9686)
- Po przygotowaniu mieszanki wzorcowej przenieść płytkę PCR1 do czystego miejsca przeznaczonego do dodania genomowego DNA.
- Seryjnie rozcieńczyć genomowe DNA od 1:3 do 1:81 za pomocą Tris-HCl (5 mM, pH 8), przygotowując 45 μl na każde rozcieńczenie (wystarcza na 20 dołków na każde rozcieńczenie). Dodaj 2 μl rozcieńczonego genomowego DNA do każdej studzienki próbki i 2 μl Tris-HCl (5 mM, pH 8) do każdej studzienki kontroli ujemnej (postępuj zgodnie z układem w Rysunek 1B). Uszczelnić wszystkie studzienki płytki PCR1, z wyjątkiem studzienki kontroli dodatniej, za pomocą przezroczystej uszczelki samoprzylepnej (patrz Tabela materiałów).
Uwaga: Powyższe zalecane rozcieńczenia służą jedynie jako początkowa wskazówka do określenia rozcieńczenia punktu końcowego. Rozcieńczenia będą zależeć od stężenia zintegrowanego DNA HIV-1 w próbkach.
- Seryjnie rozcieńczyć genomowe DNA od 1:3 do 1:81 za pomocą Tris-HCl (5 mM, pH 8), przygotowując 45 μl na każde rozcieńczenie (wystarcza na 20 dołków na każde rozcieńczenie). Dodaj 2 μl rozcieńczonego genomowego DNA do każdej studzienki próbki i 2 μl Tris-HCl (5 mM, pH 8) do każdej studzienki kontroli ujemnej (postępuj zgodnie z układem w Rysunek 1B). Uszczelnić wszystkie studzienki płytki PCR1, z wyjątkiem studzienki kontroli dodatniej, za pomocą przezroczystej uszczelki samoprzylepnej (patrz Tabela materiałów).
- Przenieść się do obszaru przeznaczonego do dodania kontroli dodatniej. Dodać 2 μl kontroli dodatniej (pNL4-3 rozcieńczonej do 105 kopii/μl) do studzienki kontroli dodatniej płytki PCR1 i uszczelnić płytkę. Krótko obrócić płytkę PCR1 w wirówce lub wirówce do PCR (400 x g przez 10 s w temperaturze pokojowej), aby ściągnąć resztki zawartości z boków studzienek.
- Uruchomić płytkę PCR1 w termocyklerze: 94 °C przez 2 min; następnie 94 °C przez 30 s, 64 °C przez 30 s, 68 °C przez 10 min przez 3 cykle; 94 °C przez 30 s, 61 °C przez 30 s, 68 °C przez 10 min przez 3 cykle; 94 °C przez 30 s, 58 °C przez 30 s, 68 °C przez 10 min przez 3 cykle; 94 °C przez 30 s, 55 °C przez 30 s, 68 °C przez 10 min przez 21 cykli; następnie 68 °C przez 10 minut (łącznie 30 cykli). Utrzymywać w temperaturze 4 °C.
UWAGA: W tym miejscu można wstrzymać działanie protokołu, a płytkę PCR1 przechowywać w temperaturze 4 °C przez okres do 2 dni. - Wymieszać odczynniki do drugiej rundy PCR (PCR2) wymienione w Tabeli 1. Dodaj 28 μl do 85 dołków (80 próbek, 4 kontrole ujemne, 1 kontrola pozytywna) nowej 96-dołkowej płytki PCR (postępuj zgodnie z układem w Rysunek 1B). Oznaczyć tę płytkę jako "PCR2".
UWAGA: Startery używane do PCR2 to:
275F: 5'-ACAGGGACCTGAAAGCGAAAG-3' (pozycja HXB2 646-666)
280R: 5'-CTAGTTACCAGAGTCACACAACAGACG-3' (pozycja HXB2 9650-9676)
- Krótko obrócić płytkę PCR1 w wirówce lub wirówce do PCR (400 x g przez 10 s w temperaturze pokojowej), aby ściągnąć resztki zawartości z boków studzienek. Dodać 80 μl Tris-HCl (5 mM, pH 8) do każdego dołka płytki PCR1.
- Przenieś 2 μl płytki PCR1 na płytkę PCR2 za pomocą pipety wielokanałowej. Upewnij się, że próbki są dobrze przeniesione do studzienki (tj. 2 μl z dołka A1 płytki PCR1 przenosi się do dołka A1 płytki PCR2). Uszczelnij płytkę PCR2 za pomocą przezroczystej uszczelki samoprzylepnej (patrz Tabela materiałów).
- Krótko obrócić płytkę PCR2 w wirówce lub wirówce do PCR (400 x g przez 10 s w temperaturze pokojowej), aby wyciągnąć resztki zawartości z boków studzienek. Uszczelnić płytkę PCR1 folią termozgrzewalną do długotrwałego przechowywania w temperaturze -20 °C (patrz Tabela materiałów).
- Uruchomić płytkę PCR2 w termocyklerze: 94 °C przez 2 min; następnie 94 °C przez 30 s, 64 °C przez 30 s, 68 °C przez 10 min przez 3 cykle; 94 °C przez 30 s, 61 °C przez 30 s, 68 °C przez 10 min przez 3 cykle; 94 °C przez 30 s, 58 °C przez 30 s, 68 °C przez 10 min przez 3 cykle; 94 °C przez 30 s, 55 °C przez 30 s, 68 °C przez 10 min przez 31 cykli; następnie 68 °C przez 10 minut (łącznie 40 cykli). Utrzymywać w temperaturze 4 °C.
UWAGA: W tym miejscu można wstrzymać działanie protokołu, a płytkę PCR2 przechowywać w temperaturze 4 °C przez okres do 2 dni. - Krótko obrócić płytkę PCR2 w wirówce lub wirówce do płytek PCR, aby ściągnąć resztki zawartości z boków studzienek. Dodaj 60 μl Tris-HCl (5 mM, pH 8) do każdego dołka za pomocą pipety wielokanałowej.
- Uruchomić 15 μl każdej studzienki na 2 x 48-dołkowych prefabrykowanych 1% żelach agarozowych zawierających bromek etydyny (0,1\u20120,3 μg/ml, patrz tabela materiałów). Użyj drabiny o zasięgu do 10 kb (patrz Tabela materiałów). Wizualizacja w celu zidentyfikowania studzienek zawierających amplifikowany produkt i ich przybliżonych rozmiarów. Zapisz obraz żelu.
UWAGA: Upewnij się, że studzienka kontroli pozytywnej zawiera amplifikowany produkt. Jeśli studzienki kontroli ujemnej zawierają amplifikowany produkt, należy rozważyć zanieczyszczenie i zignorować płytkę.
- Uruchomić 15 μl każdej studzienki na 2 x 48-dołkowych prefabrykowanych 1% żelach agarozowych zawierających bromek etydyny (0,1\u20120,3 μg/ml, patrz tabela materiałów). Użyj drabiny o zasięgu do 10 kb (patrz Tabela materiałów). Wizualizacja w celu zidentyfikowania studzienek zawierających amplifikowany produkt i ich przybliżonych rozmiarów. Zapisz obraz żelu.
- Określić rozcieńczenie, w którym nie więcej niż 30% studzienek jest dodatnich dla amplifikowanego produktu.
UWAGA: Jest to rozcieńczenie w punkcie końcowym, w którym większość (80%) studzienek zawiera amplifikowany produkt z pojedynczej matrycy. Rozcieńczenie to należy przygotować i wykorzystać w kolejnych testach PCR w celu uzyskania dalszych amplikonów prowirusowych. Zapisz przybliżony rozmiar każdego wzmocnionego produktu.
3. Oczyszczanie i kwantyfikacja DNA
- Krótko obrócić płytkę PCR2 w wirówce lub wirówce do płytek PCR, aby ściągnąć resztki zawartości z boków studzienek. Przenieść 40 μl z dołków zawierających amplifikowany produkt (w lub poniżej rozcieńczenia punktu końcowego) do nowej 96-dołkowej płytki midi (o objętości studzienki 0,8 ml, patrz tabela materiałów).
UWAGA: Zapisz oryginalną i nową pozycję dołka każdego wzmocnionego produktu w arkuszu kalkulacyjnym jako zapis każdego wzmocnionego produktu, który ma być sekwencjonowany. - Oczyść produkty amplifikowanego DNA za pomocą zestawu do oczyszczania PCR na bazie kulek magnetycznych (patrz tabela materiałów) w celu usunięcia starterów, nukleotydów, enzymów, olejów i soli. Przed rozpoczęciem doprowadź kulki magnetyczne do temperatury pokojowej i przygotuj świeży 80% etanol. W razie potrzeby należy używać nowych końcówek do pipet, aby uniknąć zanieczyszczenia krzyżowego próbek DNA.
- Wiruj kulki magnetyczne, aby upewnić się, że są dokładnie zawieszone. Za pomocą pipety wielokanałowej dodaj 40 μl kulek do 40 μl amplifikowanego produktu w 0,8 ml 96-dołkowej płytki midi. Delikatnie pipetować w górę i w dół 10 razy, aby wymieszać. Alternatywnie, wymieszać roztwór, zamykając płytkę, a następnie wytrząsając na wytrząsarce do mikropłytek z prędkością 1 800 obr./min przez 2 minuty. Inkubować w temperaturze pokojowej przez 5 minut.
- Umieść płytkę na stojaku magnetycznym (patrz tabela materiałów) na 2 minuty. Usuń i wyrzuć supernatant.
- Umyj koraliki, dodając 200 μl 80% etanolu do każdej studzienki za pomocą płytki na stojaku. Inkubować w temperaturze pokojowej przez 30 s. Usunąć i wyrzucić sklarowany osad. Powtórz raz. Za pomocą pipety wielokanałowej z cienkimi końcówkami usuń nadmiar etanolu po drugim praniu. Trzymając talerz na stojaku, pozostaw koraliki do wyschnięcia na powietrzu przez 15 minut.
- Zdejmij płytkę ze stojaka. Dodać 30 μl buforu elucyjnego (patrz tabela materiałów) do każdej studzienki. Delikatnie pipetować w górę i w dół 10 razy, aby wymieszać. Alternatywnie, wymieszać roztwór, zamykając płytkę, a następnie wytrząsając na wytrząsarce do mikropłytek z prędkością 1 800 obr./min przez 2 minuty. Inkubować w temperaturze pokojowej przez 2 minuty.
- Umieść płytkę na stojaku magnetycznym na 2 minuty. Za pomocą pipety wielokanałowej przenieś 25 μl supernatantu (oczyszczonego DNA) na nową 96-dołkową płytkę PCR. Upewnij się, że próbki są przenoszone z dołka do dołka (tj. supernatant basenika A1 w płytce o pojemności 0,8 ml przenosi się do dołka A1 nowej płytki 96-dołkowej).
UWAGA: Pozostawia się 5 μl eluowanej próbki, aby zapewnić brak przenoszenia resztek kulek oczyszczających.
- Oznaczyć i zapisać przybliżone stężenie każdego amplifikowanego produktu DNA po oczyszczeniu za pomocą spektrofotometru (absorbancja przy długości fali 260 nm).
UWAGA: Na tym etapie konieczne jest zmierzenie przybliżonego stężenia każdego amplifikowanego produktu, aby upewnić się, że żadne próbki nie zostaną utracone podczas etapów oczyszczania i że przybliżone stężenie mieści się w zakresie krzywej wzorcowej stosowanej w następnym etapie (0,001–1 ng/μL DNA w 100 μl objętości). W tym miejscu można wstrzymać działanie protokołu, a oczyszczone próbki można przechowywać w temperaturze -20 °C przez okres do 6 miesięcy. - Określić ilościowo stężenie DNA w każdym oczyszczonym produkcie za pomocą zestawu do oznaczania ilościowego dsDNA (patrz tabela materiałów).
UWAGA: Polega to na użyciu krzywej standardowej do określenia stężenia dsDNA w próbce. Zestaw zawiera bufor (10 mM Tris-HCl, 1 mM EDTA, pH 7,5), wzorzec lamda dsDNA oraz barwnik fluorescencyjny. Trzymaj wszystkie odczynniki na lodzie. Przykryj probówkę zawierającą barwnik folią, aby uniknąć ekspozycji na światło. Zmierzyć stężenie każdego amplifikowanego produktu w trzech egzemplarzach.- Rozcieńczyć bufor do 1x w sterylnymH2O, wolnym od DNaz. Dodać 99 μl buforu do odpowiedniej liczby pustych studzienek (3-krotność liczby amplifikowanych produktów do zmierzenia, patrz tabela 2 dla przykładowego układu) płaskiej płytki do hodowli tkankowej. Dodać 100 μl buforu do 3 ślepych studzienek.
- Dla każdego amplifikowanego produktu, który ma być mierzony, dodać 1 μl oczyszczonego DNA (z kroku 3.2.5) w trzech egzemplarzach do każdego basenika zawierającego bufor (patrz tabela 2 w celu zapoznania się z przykładowym układem).
- Aby przygotować wzorce, należy rozcieńczyć lamda dsDNA 10-krotnie od 2 ng/μL do 0,002 ng/μL. Dodać 100 μL każdego wzorca dsDNA do 3 studzienek.
UWAGA: Po kroku 3.4.4 końcowe stężenie wzorców będzie wynosić od 1 do 0,001 ng/μL - Rozcieńczyć barwnik fluorescencyjny w stosunku 1:200 z buforem. Szybko dodaj 100 μl do każdej studzienki zawierającej próbkę, ślepe próby i wzorce. Mieszaj w górę i w dół za pomocą pipety. Przykryj płytkę folią, aby uniknąć kontaktu ze światłem.
- Odczyt emisji fluorescencji na czytniku mikropłytek (wzbudzenie przy 480 nm, emisja przy 520 nm). Rejestruj wyniki w arkuszu kalkulacyjnym.
- Określić stężenie dsDNA w każdej próbce, korzystając z zarejestrowanych pomiarów fluorescencji. Odejmij fluorescencję zmierzoną w studzienkach ślepej próby od próbki i wzorców. Oznaczyć średnią fluorescencję dla każdej próbki i wzorca z trzech egzemplarzy. Narysuj krzywą wzorcową na podstawie pomiarów fluorescencji wzorców. Określić stężenie próbek w stosunku do wzorców.
| 1 | cyfra arabska | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | |
| A | Standardowy (1 ng/ml) | Standardowy (0,1 ng/ml) | Standardowy (0,01 ng/ml) | Standardowy (0,001 ng/ml) | pusty | |||||||
| 100 ml | 100 ml | 100 ml | 100 ml | 100 ml buforu | ||||||||
| B | Standardowy (1 ng/ml) | Standardowy (0,1 ng/ml) | Standardowy (0,01 ng/ml) | Standardowy (0,001 ng/ml) | pusty | |||||||
| 100 ml | 100 ml | 100 ml | 100 ml | 100 ml buforu | ||||||||
| C | Standardowy (1 ng/ml) | Standardowy (0,1 ng/ml) | Standardowy (0,01 ng/ml) | Standardowy (0,001 ng/ml) | pusty | |||||||
| 100 ml | 100 ml | 100 ml | 100 ml | 100 ml buforu | ||||||||
| D | Przykład 1: | Przykład 2: | Przykład 3: | Przykład 4: | Przykład 5: | Przykład 6: | Przykład 7: | Przykład 8: | Przykład 9: | Przykład 10: | Przykład 11: | Przykład 12: |
| 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | |
| E | Przykład 1: | Przykład 2: | Przykład 3: | Przykład 4: | Przykład 5: | Przykład 6: | Przykład 7: | Przykład 8: | Przykład 9: | Przykład 10: | Przykład 11: | Przykład 12: |
| 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | |
| F | Przykład 1: | Przykład 2: | Przykład 3: | Przykład 4: | Przykład 5: | Przykład 6: | Przykład 7: | Przykład 8: | Przykład 9: | Przykład 10: | Przykład 11: | Przykład 12: |
| 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | 1 ml DNA + 99 ml buforu | |
| Z | ||||||||||||
| H |
Tabela 2: Przykładowy układ płytki 96-dołkowej do ilościowego oznaczania dsDNA.
- Rozcieńczyć każdy oczyszczony produkt (otrzymany w kroku 3.2.5) stężeniemH2Odo 0,2 ng/μl.
4. Przygotowanie biblioteki sekwencjonowania
- Przygotować amplifikowane i oczyszczone prowirusowe DNA dla NGS za pomocą zestawu do przygotowania biblioteki DNA NGS (patrz tabela materiałów). Postępuj zgodnie z instrukcjami producenta dla wszystkich etapów znakowania, amplifikacji PCR i czyszczenia [z wyjątkiem objętości reakcji, w tym wejściowego DNA (od kroku 3.5), można zmniejszyć o połowę, aby przedłużyć stosowanie odczynników do przygotowania biblioteki].
- Znormalizuj biblioteki ręcznie za pomocą zestawu do kwantyfikacji biblioteki NGS opartego na qPCR (patrz tabela materiałów), aby określić indywidualne stężenie prowirusa. Połączyć poszczególne biblioteki prowirusów w ilościach równomolowych do końcowego stężenia 4 nM lub zgodnie ze specyfikacją dostawcy usług sekwencjonowania.
UWAGA: W tym miejscu można wstrzymać protokół, a biblioteka w puli jest przechowywana w temperaturze -20 °C. - Określ ilościowo końcową bibliotekę puli przy użyciu tego samego zestawu do kwantyfikacji dsDNA, który został użyty w kroku 3.4. Postępuj zgodnie z instrukcjami producenta. Określić średnią długość fragmentów, uruchamiając 1 μl zbiorczej biblioteki na automatycznym systemie elektroforezy przy użyciu odpowiedniego zestawu (patrz Tabela materiałów). Użyj stężenia i średniej długości fragmentów, aby określić molowość biblioteki połączonej.
- Połącz 5 μl wspólnej biblioteki z 5 μl 0,2 N NaOH, aby zdenaturować bibliotekę. Dodaj 5 μl 200 mM Tris-HCl w celu zneutralizowania. Rozcieńczyć końcową bibliotekę do 12,5 pM schłodzonym buforem hybrydyzacyjnym (dostępnym z zestawem do przygotowania biblioteki DNA) bezpośrednio przed sekwencjonowaniem.
- Wykonaj sekwencjonowanie 2 x 150 nukleotydów (nt) sparowanych końców na odpowiedniej platformie NGS (patrz tabela materiałów).
UWAGA: Gdy 96 bibliotek prowirusowych jest indeksowanych na przebieg, daje to około 20 milionów odczytów sparowanych końców na przebieg lub 200 000 odczytów na pojedynczą bibliotekę prowirusów do analizy po demultipleksowaniu. Kroki 4.4 i 4.5 są zwykle wykonywane przez urządzenie do sekwencjonowania.
5. De novo Montaż zsekwencjonowanych prowirusów HIV-1
UWAGA: Aby uzyskać sekwencję genetyczną każdego amplifikowanego prowirusa, kontigi są składane de novo z odczytów sparowanych końców. Wiele platform (np. CLC Genomics Workbench14) umożliwia projektowanie niestandardowych przepływów pracy dla montażu de novo. Inne programy open source, takie jak FastQC15, Trimmomatic16, Cutadapt17 i FLASH18 mogą być również wykorzystywane do przetwarzania odczytów, a także narzędzia takie jak Bowtie219 i SPAdes20 do mapowania odczytu i montażu de novo. Kroki montażu de novo kontigów HIV-1 przy użyciu określonej platformy komercyjnej (patrz tabela materiałów) są opisane poniżej (Rysunek 2). Dostosowany plik przepływu pracy jest dostępny na żądanie.
- Importuj sekwencje i sprawdzaj jakość: Zaimportuj sparowane odczyty sekwencji (w formacie fastq.gz) do oprogramowania, które następnie zostaną połączone jako pojedynczy zestaw sparowanych odczytów. Wygeneruj sekwencyjny raport kontroli jakości i zbadaj jakość swoich danych.
- Kontrola jakości
- Wykonaj przycinanie odczytu zgodnie z raportem kontroli jakości. Usuń wszelkie sekwencje adaptera i niejednoznaczne nukleotydy. Przytnij piętnaście 5' i dwa 3' końcowe nukleotydy. Odrzut odczytuje mniej niż 50 nukleotydów długości. Użyj rygorystycznego limitu jakości wynoszącego 0,001, co odpowiada wynikowi QC phred wynoszącemu 30.
- Scalanie nakładających się par
- Twórz pojedyncze rozszerzone odczyty, scalając sparowane odczyty do przodu i do tyłu z nakładającymi się regionami.
- De novo assembly
- Użyj natywnego asemblera genomiki de novo CLC o rozmiarze słowa (lub k-mer) 30 nt i maksymalnym rozmiarze pęcherzyka 65 nt, aby zebrać losową podpróbkę 10 000 nienakładających się sparowanych odczytów. Oczekiwane pokrycie dla kontigu zmontowanego de novo wynosi ~200x dla sekwencji ~9 kb.
UWAGA: To podpróbkowanie może zmniejszyć obciążenie obliczeniowe tak, że większość standardowych komputerów stacjonarnych może poradzić sobie z montażem i analizą, a biorąc pod uwagę klonalność każdego prowirusa (jedna biblioteka to jeden prowirus), nie ogranicza to różnorodności.
- Użyj natywnego asemblera genomiki de novo CLC o rozmiarze słowa (lub k-mer) 30 nt i maksymalnym rozmiarze pęcherzyka 65 nt, aby zebrać losową podpróbkę 10 000 nienakładających się sparowanych odczytów. Oczekiwane pokrycie dla kontigu zmontowanego de novo wynosi ~200x dla sekwencji ~9 kb.
- Ponowne mapowanie wszystkich odczytów na kontigi
- Aby uzyskać ostateczną sekwencję konsensusu większościowego każdego wirusa, zmapuj pełny zestaw odczytów na kontig zmontowany de novo. Akceptuj tylko kontigi o minimalnym średnim pokryciu 1,000x i upewnij się, że końcowa długość kontigu odpowiada rozmiarowi opaski na oryginalnym żelu agarozowym (krok 2.8.1). Zapisz końcową sekwencję konsensusu większości jako plik .fasta.
UWAGA: Większość kontigów można zmontować, wykonując powyższe kroki. Jednak w niektórych przypadkach dla jednego wirusa montowanych jest wiele kontigów o podobnym zasięgu. W takich okolicznościach kontigi są wyrównywane do prawie pełnej długości (~9 kb) sekwencji konsensusu od tego samego uczestnika i ręcznie montowane w jeden kontig. Wszystkie odczyty są następnie mapowane do ręcznie zmontowanego kontigu, a ostateczny konsensus jest akceptowany, jeśli pokrycie odczytu jest równomierne w całym zespole i nie występują polimorfizmy pojedynczych nukleotydów (SNP) > 40%.
- Aby uzyskać ostateczną sekwencję konsensusu większościowego każdego wirusa, zmapuj pełny zestaw odczytów na kontig zmontowany de novo. Akceptuj tylko kontigi o minimalnym średnim pokryciu 1,000x i upewnij się, że końcowa długość kontigu odpowiada rozmiarowi opaski na oryginalnym żelu agarozowym (krok 2.8.1). Zapisz końcową sekwencję konsensusu większości jako plik .fasta.
- Dalsza kontrola jakości
- Aby upewnić się, że każdy kontig reprezentuje pojedynczy prowirus i nie jest spowodowany amplifikacją wielu prowirusów w jednym dołku, pokrycie odczytem ekranu i wywołanie wariantu końcowego kontigu.
- Wiele matryc prowirusowych obecnych podczas PCR jest często identyfikowanych na podstawie bardzo nierównomiernego pokrycia odczytem (ze względu na koamplifikację prowirusów o różnych rozmiarach) podczas mapowania do pełnego konsensusu od tego samego uczestnika lub na podstawie obecności SNP z częstością >40% (patrz reprezentatywne wyniki, Rysunek 4). Pomiń populacje mieszane w kolejnych analizach.
- wyrównanie
- Zaimportuj ostateczny konsensus każdej sekwencji prowirusowej do oprogramowania do przeglądania sekwencji, takiego jak Molecular Evolutionary Genetics Analysis (MEGA) 721. Dopasuj każdą sekwencję ręcznie do sekwencji referencyjnej HXB2. Przytnij końce 5' i 3' do pozycji 666-9650 HXB2, aby usunąć sekwencje starterów.
- Wyeksportuj listę sekwencji w formacie fasta, a następnie wyrównaj za pomocą MAFFT w wersji 722, z ręczną edycją w razie potrzeby, aby uzyskać ostateczne wyrównanie.
UWAGA: Jeśli jakiekolwiek sekwencje nie są wyrównane, najpierw odwróć uzupełnienie sekwencji. Jeśli sekwencja nadal nie jest wyrównana, przeprowadź wyszukiwanie BLAST, aby upewnić się, że sekwencja to HIV-1. Możliwe jest amplifikowanie matryc innych niż HIV-1 i można je zidentyfikować na tym etapie. Jeśli sekwencje są HIV-1, ale nie są wyrównane, należy wziąć pod uwagę obecność inwersji (patrz krok 6.1).
6. Określanie potencjalnej kompetencji replikacyjnych sekwencji prowirusowych HIV-1
UWAGA: Aby zidentyfikować sekwencje genetycznie nienaruszonych i potencjalnie zdolnych do replikacji prowirusów HIV-1, stosuje się rygorystyczny proces eliminacji (Rysunek 1C). Sekwencje prowirusowe pozbawione inwersji, dużych wewnętrznych delecji, szkodliwych kodonów stop / hipermutacji, mutacji przesunięcia ramki odczytu i/lub defektów w miejscu MSD lub sygnale pakowania są uważane za genetycznie nienaruszone i potencjalnie kompetentne do replikacji.
- Inwersji
- Na etapie wyrównywania zidentyfikuj inwersje. Inwersje to obszary, w których sekwencja nie jest wyrównana do odniesienia HXB2, chyba że region jest odwrotnie uzupełniony.
UWAGA: W zależności od zastosowania danych, może być konieczne pominięcie sekwencji zawierających inwersje w dalszej analizie.
- Na etapie wyrównywania zidentyfikuj inwersje. Inwersje to obszary, w których sekwencja nie jest wyrównana do odniesienia HXB2, chyba że region jest odwrotnie uzupełniony.
- Duże usunięcia wewnętrzne
- Zidentyfikuj kontigi z dużymi wewnętrznymi usunięciami (>600 pz) na etapie wyrównywania. O ile usunięcie nie znajduje się w nef, sekwencja może być zdefiniowana jako wadliwa.
UWAGA: Wszelkie sekwencje z wewnętrznymi delecjami <600 pz zostaną zidentyfikowane przez Gene Cutter (krok 6.3.1) jako posiadające niekompletne sekwencje genów.
- Zidentyfikuj kontigi z dużymi wewnętrznymi usunięciami (>600 pz) na etapie wyrównywania. O ile usunięcie nie znajduje się w nef, sekwencja może być zdefiniowana jako wadliwa.
- Szkodliwe kodony stop, mutacje z przesunięciem ramki odczytu i delecje
- Sprawdź wszystkie kontigi nukleotydów o długości >8400 pod kątem obecności szkodliwych kodonów stop, przesunięć ramki i niekompletnych sekwencji genów, korzystając z narzędzia Los Alamos National Laboratory HIV Sequence Database Gene Cutter tool23.
UWAGA: Narzędzie Gene Cutter dzieli sekwencję prowirusową na geny >gag, pol, vif, vpr, tat, rev, vpu, env i nef i tłumaczy je na aminokwasy. Następnie Gene Cutter przeprowadza badania przesiewowe pod kątem obecności kodonów stop i mutacji przesunięcia ramki odczytu (z powodu insercji lub delecji). Kontigi zawierające kodony stop lub przesunięcia ramki w dowolnym genie, z wyjątkiem nef24, są klasyfikowane jako wadliwe. Gene Cutter identyfikuje również niekompletne sekwencje genów, a wszelkie prowirusy z delecją <600 pz w genie innym niż nef mogą zostać przeklasyfikowane jako wadliwe z powodu dużej delecji wewnętrznej.
- Sprawdź wszystkie kontigi nukleotydów o długości >8400 pod kątem obecności szkodliwych kodonów stop, przesunięć ramki i niekompletnych sekwencji genów, korzystając z narzędzia Los Alamos National Laboratory HIV Sequence Database Gene Cutter tool23.
- Hipermutacja
- Wygeneruj konsensus pozostałych pełnowymiarowych sekwencji prowirusowych za pomocą narzędzia Los Alamos National Laboratory HIV Sequence Database Consensus Maker (simple consensus maker)25. Dodaj sekwencję konsensusu na górze wyrównania zawierającego tylko pozostałe sekwencje prowirusowe o pełnej długości. Korzystając z tego dopasowania i narzędzia Hypermut Los Alamos National Laboratory HIV Sequence Database26 w celu zidentyfikowania hipermutacji G-A indukowanej przez APOBEC w pozostałych pełnowymiarowych sekwencjach prowirusowych.
- Usterki w sygnale MSD i opakowaniu
- Sprawdź każdy z pozostałych kontigów pod kątem defektów w MSD i sygnale opakowania (region HXB2 670-810), które powodują, że sekwencja prowirusowa jest uszkodzona4. Poszukaj mutacji punktowej w miejscu MSD (sekwencja GT, HXB2 744-745) lub jakiejkolwiek delecji w czterech pętlach macierzystych sygnału pakowania (SL1 (HXB2 691-734), SL2 (HXB2 736-754), SL3 (HXB2 766-779) i SL4 (HXB2 790-810)).
Wyniki
Test FLIPS służy do amplifikacji i sekwencjonowania pojedynczych, niemal pełnowymiarowych prowirusów HIV-1. Protokół obejmuje 6 etapów pozwalających na uzyskanie niemal pełnowymiarowych sekwencji prowirusowych. Etapy te obejmują: lizę zakażonych komórek, zagnieżdżoną PCR pełnowymiarowych (nienaruszonych i wadliwych) prowirusów HIV-1, oczyszczanie i kwantyfikację DNA, przygotowanie biblioteki do sekwencjonowania, NGS oraz składanie de novo zsekwencjonowanych prowirusów. Zakończenie każdego etapu można uznać za punkt kontrolny, w którym można ocenić jakość produktu (np. amplifikowanego DNA, oczyszczonego DNA, biblioteki sekwencjonowania lub sekwencji) przed przejściem do kolejnego kroku. Poniżej przedstawiono przegląd oceny przeprowadzanej na koniec każdego etapu oraz oczekiwane wyniki.
Po przeprowadzeniu zagnieżdżonej reakcji PCR, produkty amplifikacji są rozdzielane w 1% żelu agarozowym (Rysunek 3). Początkową jakość PCR można określić poprzez analizę kontroli negatywnych i pozytywnych. Obecność produktu amplifikacji w dołkach kontroli negatywnej wskazuje na kontaminację, natomiast brak produktu w dołkach kontroli pozytywnej świadczy o niewystarczającej amplifikacji. Następnie do sekwencjonowania wybierane są dołki zawierające produkt amplifikacji. Aby uniknąć dołków zawierających mieszaniny wielu amplifikowanych prowirusów, do sekwencjonowania bierze się pod uwagę wyłącznie dołki z produktem amplifikacji uzyskanym przy rozcieńczeniu końcowym. Zgodnie z rozkładem Poissona, rozcieńczenie końcowe zostaje osiągnięte, gdy 30% dołków daje wynik pozytywny pod kątem produktu amplifikacji. Przy takim rozcieńczeniu istnieje 80% prawdopodobieństwa, że dołki te zawierają pojedynczy amplifikowany prowirus. Ponadto na tym etapie można zidentyfikować dołki zawierające wiele amplifikowanych prowirusów o różnych długościach, gdyż w żelu pojawią się wówczas wielokrotne prążki. Takich dołków nie należy wybierać do sekwencjonowania (Rysunek 3).
Po oczyszczaniu amplifikowanych prowirusów wybranych do sekwencjonowania przeprowadza się kwantyfikację, aby upewnić się, że podczas etapu oczyszczania nie utracono prowiralnego DNA. Jeśli stężenie DNA w amplifikowanym prowirusie wynosi <0.2 ng/µL, można oczyścić pozostałą próbkę z płytki PCR2. Podobny punkt kontrolny występuje po przygotowaniu biblioteki, podczas którego kwantyfikowana jest każda poszczególna biblioteka. Gwarantuje to, że poszczególne prowirusy zostały odpowiednio pofragmentowane, otagowane i amplifikowane przed sekwencjonowaniem. Poszczególne biblioteki prowiralne są łączone w ilościach ekimolarnych do końcowego stężenia biblioteki 4 nM (lub zgodnie ze specyfikacją dostawcy usługi sekwencjonowania). Jeśli stężenie pojedynczej biblioteki prowiralnej jest zbyt niskie, można ją wykluczyć z puli bibliotek do sekwencjonowania lub ponownie przygotować daną bibliotekę. Przed sekwencjonowaniem przeprowadza się końcową kontrolę stężenia połączonej biblioteki oraz potwierdzenie średniej długości fragmentów.
Kroki kontroli jakości przed etapem składania de novo zapewniają wysoką jakość odczytów wykorzystywanych do zmontowania końcowego kontigu prowirusowego. Kroki te obejmują: usunięcie sekwencji adapterów, przycinanie nukleotydów z końców 5' i 3', zastosowanie rygorystycznego limitu jakości oraz odrzucenie krótkich odczytów. Program CLC Genomics Workbench umożliwia generowanie raportów kontroli jakości, które mogą służyć najpierw do oceny początkowej jakości odczytów i doboru ustawień przycinania, a następnie do ustalenia, czy przycinanie było wystarczające do usunięcia regionów o niskiej jakości. Ponadto, w przypadku składania de novo, jakość zmontowanych kontigów można ocenić pod kątem wystarczającej głębokości (>1000X) i równomierności pokrycia (Rycina 4A). Na tym etapie można również zidentyfikować populacje mieszane. Mieszaniny wielu pełnowymiarowych (~9 kb) prowirusów rozpoznaje się po obecności wielu SNP o częstotliwości powyżej 40%, natomiast mieszaniny prowirusów krótkich (zawierających dużą delecję wewnętrzną) i pełnowymiarowych można zidentyfikować poprzez nierównomierne pokrycie odczytami po mapowaniu do pełnowymiarowej sekwencji referencyjnej od tego samego uczestnika (Rycina 4B).
W zależności od zastosowania, końcowe dopasowanie można zwizualizować przy użyciu narzędzi takich jak ggtree, dostępnego jako pakiet w "R: A language and environment for statistical computing"27. W niedawnym badaniu metoda FLIPS została wykorzystana do sekwencjonowania prowirusów HIV-1 z naiwnych, centralnych, przejściowych i efektorowych limfocytów T CD4+ pamięci, wyizolowanych od osób przyjmujących długotrwale ART, w celu ustalenia, czy konkretne subpopulacje komórek wykazują wyższe proporcje genetycznie nienaruszonych i potencjalnie zdolnych do replikacji HIV-12. Tutaj przedstawiono wizualną reprezentację sekwencji wyizolowanych od jednego uczestnika tego badania (uczestnik 2026) (Rysunek 5). U tego uczestnika większość (97%) sekwencji była wadliwa, a sekwencje nienaruszone znaleziono w efektorowych i przejściowych limfocytach T CD4+ pamięci. To narzędzie wizualizacji jest przydatne do pokazania liczby sekwencji z dużymi delecjami wewnętrznymi oraz ich pozycji w genomie. Można je dodatkowo adnotować, aby wskazać sekwencje z szkodliwymi kodonami stop, mutacjami przesunięcia ramki odczytu oraz delecjami/mutacjami w miejscu MSD i/lub sygnale pakowania.
Jednym z zastosowań testu FLIPS jest identyfikacja genetycznie nienaruszonych i potencjalnie zdolnych do replikacji prowirusów HIV-1. W niedawnym badaniu 531 sekwencji wyizolowanych z limfocytów T CD4+ od 6 uczestników przyjmujących długoterminową terapię ART zidentyfikowano 26 (5%) genetycznie nienaruszonych prowirusów HIV-12. Pozostałe wadliwe prowirusy obejmowały te z sekwencjami inwersyjnymi (6%), dużymi delecjami wewnętrznymi (68%), szkodliwymi kodonami stop/hipermutacją (9%), mutacjami przesunięcia ramki odczytu (1%) oraz defektami w sygnale pakowania i/lub mutacjami w miejscu MSD (11%).
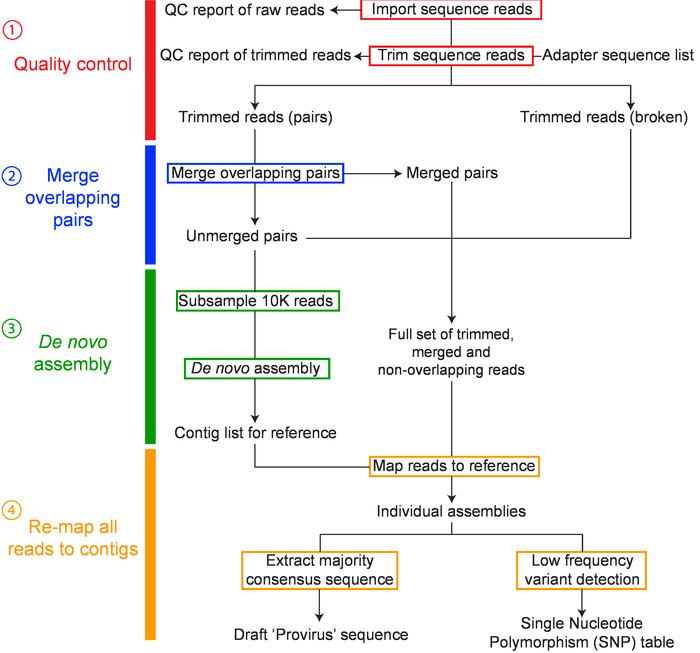
Rysunek 2: Przegląd schematu postępowania dla składania de novo prowirusów HIV-1. Główne etapy schematu obejmują: 1) kontrolę jakości odczytów sekwencyjnych, 2) łączenie par nakładających się, 3) składanie de novo oraz 4) ponowne mapowanie i budowanie konsensusu, które zostały odpowiednio oznaczone kolorami czerwonym, niebieskim, zielonym i pomarańczowym. Rysunek został zmodyfikowany na podstawie pracy Hiener et al.2. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
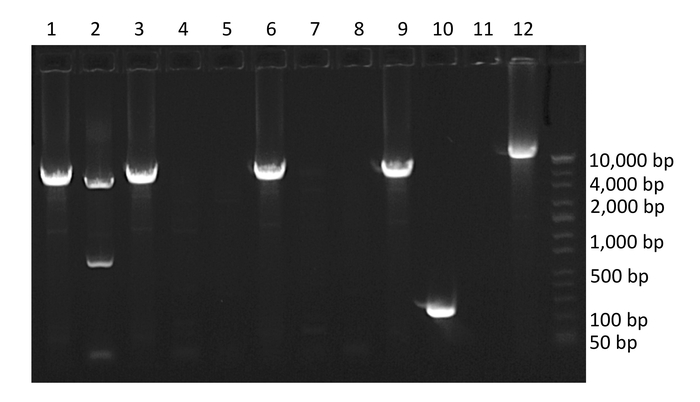
Rycina 3: Przykład żelu agarozowego z amplifikowanymi metodą PCR prowirusami HIV-1. Do studni 1, 2, 3, 6, 9 i 10 naniesiono amplifikowane prowirusy HIV-1. Studnia 10 zawiera prowirus z dużą delecją wewnętrzną, studnia 2 zawiera koamplifikację dwóch prowirusów HIV-1 o różnych długościach (mieszanina), a studnia 12 zawiera kontrolę dodatnią. Należy zauważyć, że odsetek studni zawierających amplifikowany produkt wynosi 60%, co przekracza wartość wymaganą do izolacji pojedynczych matryc. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
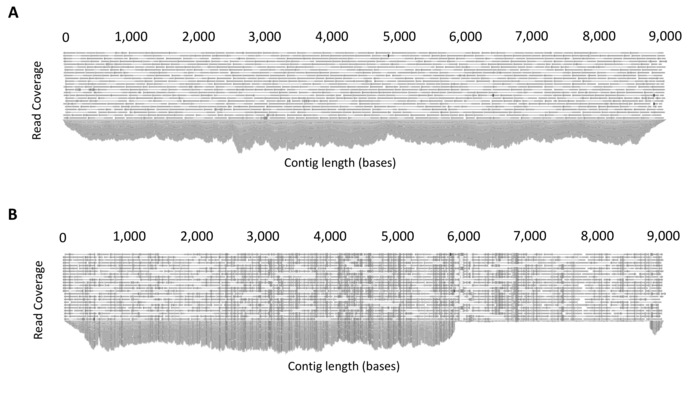
Rycina 4: Przykładowy wynik mapowania odczytów. (A) Przykład wykazujący równomierne pokrycie wynikające z amplifikacji pojedynczego, pełnowymiarowego prowirusa HIV-1. Po asemblacji de novo wszystkie odczyty są mapowane do zmontowanego kontigu w celu uzyskania sekwencji konsensusowej. Platforma programistyczna umożliwia sprawdzenie zmapowanych odczytów pod kątem wystarczającego i równomiernego pokrycia. (B) Przykład wykazujący koamplifikację dwóch prowirusów HIV-1 o różnych długościach (mieszanina). W celu wykrycia mieszanin odczyty mapuje się do pełnowymiarowej (~9 kb) sekwencji referencyjnej od tego samego uczestnika, a następnie analizuje mapowanie odczytów. Obecność nierównomiernego pokrycia wskazuje na mieszaninę. Rycina ta została powielona za zgodą firmy Qiagen14. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
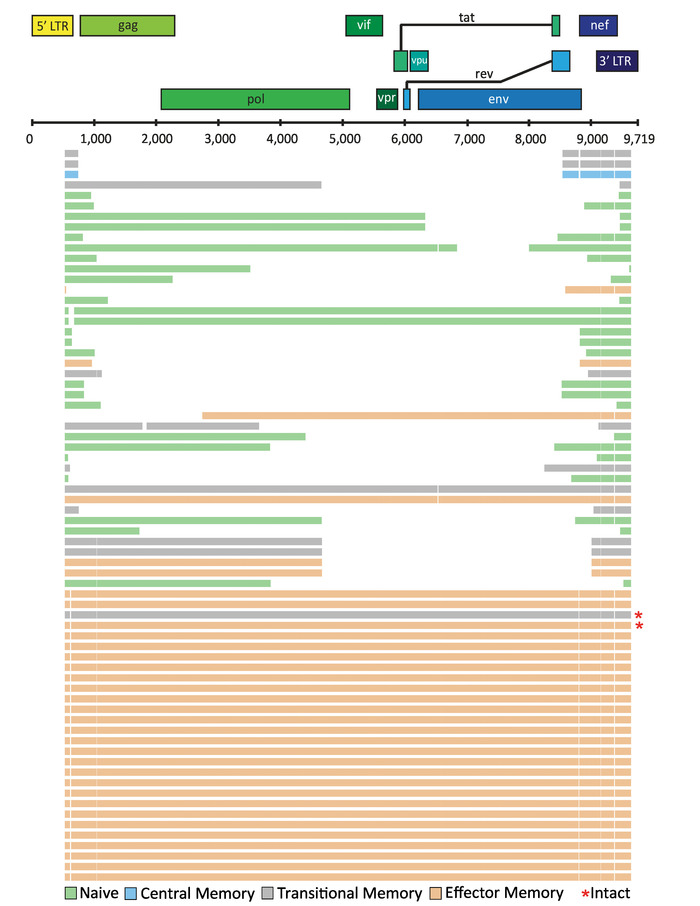
Rycina 5: Przykładowa wizualizacja sekwencji prowirusowych HIV-1 wyizolowanych z subpopulacji limfocytów T CD4+ u osoby w długotrwałej terapii ART. Pojedyncze sekwencje prowirusowe HIV-1 przedstawiono w formie linii poziomych. Rycina została zmodyfikowana na podstawie pracy Hiener et al.2. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Dyskusja
Test FLIPS jest wydajną i wysokoprzepustową metodą amplifikacji i sekwencjonowania pojedynczych, prawie pełnowymiarowych prowirusów HIV-1. Zidentyfikowano wiele czynników i krytycznych etapów w protokole, które wpływają na liczbę i jakość uzyskanych sekwencji. Po pierwsze, liczba komórek i częstotliwość zakażeń HIV-1 w populacji komórek wpływają na liczbę amplifikowanych prowirusów. Na przykład w poprzedniej publikacji uzyskano o około połowę mniej sekwencji z tej samej liczby naiwnych limfocytów T CD4 + w porównaniu z limfocytami T CD4 + pamięci efektorowej. Dzieje się tak, ponieważ komórki naiwne mają zazwyczaj niższą częstotliwość infekcji niż komórki pamięci efektorowej2. Po drugie, liza komórek jest lepsza niż metody ekstrakcji oparte na kolumnach w celu uzyskania genomowego DNA, ponieważ nie ma ryzyka utraty DNA w procesie ekstrakcji. Wreszcie, podobnie jak w przypadku każdego testu opartego na PCR, zapobieganie zanieczyszczeniu ma kluczowe znaczenie. Wydzielone obszary czyste powinny być wyznaczone do przygotowania mieszanek wzorcowych, obchodzenia się z genomowym DNA, dodawania kontroli pozytywnych, oczyszczania i kwantyfikacji DNA oraz przygotowania biblioteki. Jest to szczególnie ważne w przypadku testów jednokopiowych, takich jak ten przedstawiony tutaj.
Wdrożenie testu FLIPS powinno najpierw obejmować przeprowadzenie kontroli pozytywnej, takiej jak plazmidy pNL4-3, a nie próbki uczestników. Pozwoli to na rozwiązywanie wszelkich problemów przed użyciem komórek HIV-1 dodatnich, ponieważ uzyskane sekwencje można porównać z dostępnymi sekwencjami referencyjnymi dla tych plazmidów. Podczas korzystania z komórek HIV-1 dodatnich ważne jest, aby wziąć pod uwagę podtyp HIV-1 (startery przeznaczone dla FLIPS są specyficzne dla podtypu B) oraz częstotliwość infekcji w populacji komórek, jeśli amplifikowane są niewielkie lub żadne prowirusy. Sekwencje podkładowe mogą być modyfikowane/przeprojektowywane, aby pasowały do innych podtypów. Dodatkowo, studzienka zawierająca kontrolę dodatnią powinna być dołączona do każdego wykonanego PCR.
Projekt FLIPS przezwyciężył ograniczenia poprzednich testów sekwencjonowania, w tym SPS. Poprzez amplifikację i sekwencjonowanie prowirusów HIV-1 o niemal pełnej długości, projekt FLIPS może określić potencjalną zdolność replikacyjną prowirusów HIV-1. Nie było to możliwe przy użyciu SPS, który sekwencjonował tylko regiony subgenomowe, a zatem wybierał sekwencje z nienaruszonymi miejscami wiązania starterów. Co więcej, FLIPS pokonuje ograniczenia związane z wykorzystaniem wielu starterów amplifikacji i sekwencjonowania, jak to miało miejsce w poprzednich testach sekwencjonowania o pełnej długości 1,4. Dzięki dwóm rundom PCR ukierunkowanym na regiony LTR HIV-1 w połączeniu z NGS, FLIPS zmniejsza liczbę i złożoność wymaganych starterów. FLIPS jest zatem mniej podatny na konsekwencje niedopasowania starterów, a mianowicie błędną identyfikację wadliwych prowirusów i niezdolność do amplifikacji niektórych prowirusów w populacji. Protokół FLIPS jest również bardziej wydajny i pozwala na większą przepustowość sekwencjonowania niż poprzednie metody.
Ewidentnie FLIPS zapewnia przewagę nad istniejącymi metodami, które określają skład genetyczny prowirusów HIV-1. Jednak ważne jest, aby pamiętać o ograniczeniach FLIPS. Po pierwsze, test FLIPS nie został opracowany jako narzędzie do pomiaru wielkości utajonego rezerwuaru HIV-1, ponieważ nie zakończono analiz mających na celu określenie, czy FLIPS amplifikuje każdy prowirus HIV-1 obecny w populacji komórek. FLIPS jest natomiast przydatny do dokonywania względnych porównań składu rezerwuaru między różnymi populacjami komórek2. Po drugie, kompetencja replikacyjna nienaruszonych prowirusów HIV-1 nie może być określona z całą pewnością bez analiz in vivo , takich jak te przeprowadzone przez Ho i wsp.4. Po trzecie, FLIPS nie jest przeznaczony do określania miejsca integracji prowirusów HIV-1.
Drobne zmiany w protokole FLIPS mogą zwiększyć jego zastosowanie. Na przykład zmiany w sekwencjach starterów mogą pozwolić na amplifikację i sekwencjonowanie różnych i wielu podtypów HIV-1. Sekwencjonowanie wirionów HIV-1 w osoczu jest możliwe dzięki dodaniu syntezy cDNA przed zagnieżdżonym PCR. Przyszłe wykorzystanie metod sekwencjonowania pojedynczych cząsteczek wyeliminuje potrzebę składania de novo .
Sekwencjonowanie genetyczne zintegrowanych prowirusów HIV-1 poszerzyło naszą wiedzę na temat utajonego rezerwuaru HIV-1. FLIPS jest ważnym narzędziem dla przyszłych badań wyjaśniających skład i rozmieszczenie utajonego zbiornika. Jednak zastosowanie FLIPS może wykraczać poza zbiornik. Przyszłe badania mogą wykorzystywać FLIPS do określenia konkretnych celów dla technologii CRISPR-Cas lub pomóc w identyfikacji regionów kodujących i niekodujących, które sprawiają, że wirus jest bardziej wrażliwy na czynniki odwracające latencję. Rekombinację wirusową można lepiej zrozumieć, przyglądając się miejscom połączeń dużych delecji wewnętrznych.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Ta praca była wspierana przez Delaney AIDS Research Enterprise (DARE) w celu znalezienia lekarstwa (1U19AI096109 i 1UM1AI126611-01); grant na wspólne badania amfAR Research Consortium on HIV Eradication (ARCHE) od Fundacji Badań nad AIDS (amfAR 108074-50-RGRL); Australijskie Centrum Badań nad Wirusologią HIV i Wirusowym Zapaleniem Wątroby (ACH2); UCSF-GIVI Centrum Badań nad AIDS (P30 AI027763); oraz Australijska Narodowa Rada ds. Zdrowia i Badań Medycznych (AAP1061681). Chcielibyśmy podziękować dr Joeyowi Lai, kierownikowi zakładu genomiki w Instytucie Badań Medycznych Westmead za szkolenie w zakresie przygotowania biblioteki i korzystania z jego obiektu, a także Centrum Genomiki Ramaciotti (Uniwersytet Nowej Południowej Walii, Sydney, Australia) za przeprowadzenie sekwencjonowania. Z wdzięcznością dziękujemy uczestnikom, którzy przekazali próbki do tego badania.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| UltraPure 1 M Tris-HCI, pH 8,0 | Invitrogen | 15568025 | Rozcieńczony do 5 mM do zagnieżdżonego PCR |
| Nonidet P 40 Roztwór zastępczy | Sigma | 98379 | |
| Tween-20 | Sigma | P9416 | |
| Roztwór proteinazy K (20 mg / ml) | Termocykler | ||
| 96 dołków | Można użyć dowolnego termocyklera 96-dołkowego | ||
| Platinum Taq DNA Polymerase High Fidelity | Invitrogen | 11304011 | |
| 10x bufor wysokiej wierności [600 mM Tris-SO4 (pH 8,9), 180 mM (NH4)2SO4] | Invitrogen | 11304011 | |
| 50 mM MgSO4 | Invitrogen | 11304011 | |
| Mieszanka nukleotydów PCR, 10 mM | Promega | C1141 | |
| Ultrapure H2O | Invitrogen | 10977023 | |
| startery | odsolone. Rozcieńczyć do (100 &mikro; M) Z płytką H2O | ||
| PCR 96 dołków, półspódnica, narożnik z pojedynczym nacięciem, przezroczysta | Axygen | PCR-96M2-HS-C | |
| Microseal 'B' Uszczelki samoprzylepne | BioRad | MSB1001 | Wymagane do uszczelnienia 96-dołkowych płytek PCR |
| HIV-1 NL4-3 Zakaźny klon molekularny (pNL4-3) | Następujący odczynnik został uzyskany za pośrednictwem NIH AIDS Reagent Program, Division of AIDS, NIAID, NIH: HIV-1 NL4-3 Infectious Molecular Clone (pNL4-3) od dr Malcolma Martina (Cat# 114). | Rozcieńczony do 105 kopii/ml i stosowany jako | |
| wirówka płytkowa do PCR | |||
| 48 1% Agaroza | Invitrogen | G800801 | Prefabrykowane 1% żele agarozowe (dwa żele używane na płytkę 96-dołkową). Można zastąpić dowolny 1% żel agarozowy. Zawiera bromek etydyny. |
| Marker DNA DirectLoad Wide Range | Sigma | D7058 | Można zastąpić dowolną drabiną o zasięgu do 10 kb |
| Urządzenie Mother E-Base | Invitrogen | EBM03 | Wymagane do uruchamiania prefabrykowanych 48-dołkowych żeli agarozowych 1% |
| Żel Doc EZ System Dokumentacji Żelu | BioRad | 1708270 | Można zastosować dowolny system wizualizacji żeli agarozowych zawierających bromek etydyny |
| Zgrzewanie | termiczne PlateMaxAxygen | HS-200 | Folia termozgrzewalna do długotrwałego przechowywania |
| 96 Well 0,8 mL Płyta do przechowywania | ThermoFisher Scientific | AB0765 | 0,8 mL 96-dołkowa płytka wymagana do oczyszczania PCR na bazie kulek magnetycznych |
| Agencourt AMPure XP (zestaw do oczyszczania PCR) | Beckman Coulter | A63880 | Zestaw do oczyszczania PCR na bazie kulek magnetycznych. Tutaj można zastąpić inne zestawy do oczyszczania PCR (np. Zestaw do oczyszczania QIAquick PCR (Qiagen Cat#28106) |
| Alkohol etylowy, czysty. 200 proof, dla biologii molekularnej | Sigma | E7023 | |
| Magnetic Stand-96 | Invitrogen | AM10027 | |
| Wytrząsarka | Opcjonalny | ||
| bufor EB | Qiagen | 19086 | Bufor elucyjny |
| Quant-iT PicoGreen dsDNA Zestaw testowy | Invitrogen | P11496 | Barwnik fluorescencyjny do pomiaru stężenia dsDNA |
| Czytnik mikropłytek Zestaw | |||
| do przygotowania biblioteki DNA Nextera XT | Illumina | FC-131-1096 | |
| Zestaw indeksów Nextera XT | Illumina | FC-131-2001 | |
| 96-dołkowe płytki PCR z twardą skorupą | Biorad | HSP9601 | Wymagane dla zestawu do przygotowania biblioteki DNA Nextera XT |
| Zestaw do kwantyfikacji biblioteki - Illumina/Universal | Kapa Biosystems | KK4824 | Inne zestawy do kwantyfikacji biblioteki mogą być podstawione (np. Zestaw do kwantyfikacji biblioteki DNA JetSeq Lo-Rox (Bioline Cat#BIO-68029) |
| 2100 Bioanalizator | Agilent Technology | Zautomatyzowany system elektroforezy . Używaj w połączeniu z zestawem DNA o wysokiej czułości | |
| Zestaw DNA o wysokiej czułości | Agilent Technology | 5067-4626 | |
| Platforma Illumina MiSeq | Illumina |
Bibliografia
- Bruner, K. M., et al. Defective proviruses rapidly accumulate during acute HIV-1 infection. Nature Medicine. 22 (9), 1043-1049 (2016).
- Hiener, B., et al. Identification of Genetically Intact HIV-1 Proviruses in Specific CD4(+) T Cells from Effectively Treated Participants. Cell Reports. 21 (3), 813-822 (2017).
- Abram, M. E., Ferris, A. L., Shao, W., Alvord, W. G., Hughes, S. H. Nature, position, and frequency of mutations made in a single cycle of HIV-1 replication. Journal of Virology. 84 (19), 9864-9878 (2010).
- Ho, Y. C., et al. Replication-competent noninduced proviruses in the latent reservoir increase barrier to HIV-1 cure. Cell. 155 (3), 540-551 (2013).
- Harris, R. S., et al. DNA deamination mediates innate immunity to retroviral infection. Cell. 113 (6), 803-809 (2003).
- Lecossier, D., Bouchonnet, F., Clavel, F., Hance, A. J. Hypermutation of HIV-1 DNA in the absence of the Vif protein. Science. 300 (5622), 1112(2003).
- Chun, T. W., et al. Rebound of plasma viremia following cessation of antiretroviral therapy despite profoundly low levels of HIV reservoir: implications for eradication. AIDS. 24 (18), 2803-2808 (2010).
- Chomont, N., et al. HIV reservoir size and persistence are driven by T cell survival and homeostatic proliferation. Nature Medicine. 15 (8), 893-900 (2009).
- Soriano-Sarabia, N., et al. Quantitation of replication-competent HIV-1 in populations of resting CD4+ T cells. Journal of Virology. 88 (24), 14070-14077 (2014).
- Josefsson, L., et al. The HIV-1 reservoir in eight patients on long-term suppressive antiretroviral therapy is stable with few genetic changes over time. Proceedings of the National Academy of Sciences USA. 110 (51), E4987-E4996 (2013).
- Evering, T. H., et al. Absence of HIV-1 evolution in the gut-associated lymphoid tissue from patients on combination antiviral therapy initiated during primary infection. Public Library of Science Pathogens. 8 (2), e1002506(2012).
- von Stockenstrom, S., et al. Longitudinal Genetic Characterization Reveals That Cell Proliferation Maintains a Persistent HIV Type 1 DNA Pool During Effective HIV Therapy. Journal of Infectious Diseases. 212 (4), 596-607 (2015).
- Palmer, S., et al. Multiple, linked human immunodeficiency virus type 1 drug resistance mutations in treatment-experienced patients are missed by standard genotype analysis. Journal of Clinical Microbiology. 43 (1), 406-413 (2005).
- Qiagen. CLC Genomics Version 10. , Available from: https://www.qiagenbioinformatics.com/products/clc-genomics-workbench (2018).
- Andrews, S. FastQC: a quality control tool for high throughput sequence data. , Available from: https://www.bioinformatics.babraham.ac.uk/projects/fastqc/ (2010).
- Bolger, A. M., Lohse, M., Usadel, B. Trimmomatic: a flexible trimmer for Illumina sequence data. Bioinformatics. 30 (15), 2114-2120 (2014).
- Martin, M. Cutadapt removes adapter sequences from high-throughput sequencing reads. EMBnet.journal. 17 (1), (2011).
- Magoc, T., Salzberg, S. L. FLASH: fast length adjustment of short reads to improve genome assemblies. Bioinformatics. 27 (21), 2957-2963 (2011).
- Langmead, B., Salzberg, S. L. Fast gapped-read alignment with Bowtie 2. Nature Methods. 9 (4), 357-359 (2012).
- Bankevich, A., et al. SPAdes: a new genome assembly algorithm and its applications to single-cell sequencing. Journal of Computational Biology. 19 (5), 455-477 (2012).
- Kumar, S., Stecher, G., Tamura, K. MEGA7: Molecular Evolutionary Genetics Analysis Version 7.0 for Bigger Datasets. Molecular Biology and Evolution. 33 (7), 1870-1874 (2016).
- Katoh, K., Standley, D. M. MAFFT multiple sequence alignment software version 7: improvements in performance and usability. Molecular Biology and Evolution. 30 (4), 772-780 (2013).
- Laboratory, L. A. N. HIV Sequence Database - Gene Cutter tool. , Available from: https://www.hiv.lanl.gov/content/sequence/GENE_CUTTER/cutter.html (2018).
- Foster, J. L., Garcia, J. V. Role of Nef in HIV-1 replication and pathogenesis. Advances in Pharmacology. 55, 389-409 (2007).
- Laboratory, L. A. N. HIV Sequence Database - Consensus Maker tool. , Available from: https://www.hiv.lanl.gov/content/sequence/CONSENSUS/consensus.html (2018).
- Laboratory, L. A. N. HIV Sequence Database - Hypermut tool. , Available from: https://www.hiv.lanl.gov/content/sequence/HYPERMUT/hypermut.html (2018).
- Yu, G., Smith, D. K., Zhu, H., Guan, Y., Lam, T. T. Y. ggtree: an r package for visualization and annotation of phylogenetic trees with their covariates and other associated data. Methods in Ecology and Evolution. , (2016).
Przedruki i uprawnienia
