Protokół opisuje metodę przewidywania stężenia o-krezolu podczas produkcji eteru polifenylenowego za pomocą spektroskopii bliskiej podczerwieni i częściowej regresji metodą najmniejszych kwadratów. Aby jaśniej i pełniej opisać ten proces, w celu wyjaśnienia etapów posłużono się przykładem przewidywania stężenia o-krezolu podczas produkcji polifenylenu.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Pomiar stężenia O-krezolu online w oparciu o spektroskopię bliskiej podczerwieni za pomocą częściowej regresji metodą najmniejszych kwadratów
W tym artykule
Podsumowanie
Streszczenie
W przeciwieństwie do makroskopowych zmiennych procesowych, spektroskopia bliskiej podczerwieni dostarcza informacji o procesie na poziomie molekularnym i może znacznie poprawić przewidywanie składników w procesach przemysłowych. Możliwość rejestrowania widm dla próbek stałych i ciekłych bez żadnej obróbki wstępnej jest korzystna, a metoda ta jest szeroko stosowana. Jednak wady analizy wielowymiarowych danych spektralnych w bliskiej podczerwieni obejmują nadmiarowość informacji i wieloliniowość danych spektralnych. W związku z tym proponujemy użycie metody częściowej regresji metodą najmniejszych kwadratów, która jest tradycyjnie stosowana w celu zmniejszenia wymiarowości danych i wyeliminowania współliniowości między oryginalnymi cechami. Wdrażamy metodę przewidywania stężenia o-krezolu podczas produkcji eteru polifenylenowego. Proponowane podejście oferuje następujące zalety w porównaniu z metodami przewidywania regresji składowej: 1) częściowa regresja metodą najmniejszych kwadratów rozwiązuje problem wieloliniowości zmiennych niezależnych i skutecznie zapobiega nadmiernemu dopasowaniu, które występuje w analizie regresji ze względu na wysoką korelację między zmiennymi niezależnymi; 2) Wykorzystanie widm bliskiej podczerwieni skutkuje wysoką dokładnością, ponieważ jest to nieniszcząca i niezanieczyszczająca metoda uzyskiwania informacji w skali mikroskopowej i molekularnej.
Wprowadzenie
Spektroskopia w bliskiej podczerwieni (NIR) zyskała powszechną akceptację jako szybka, wydajna, nieniszcząca i bezemisyjna nowoczesna technologia analityczna; metoda ta była stosowana w ciągu ostatnich kilku lat do wykrywania i analizy jakości produktów oraz pomiaru składników chemicznych w procesach przemysłowych. Najistotniejszą cechą tej metody jest zdolność do rejestrowania widm próbek stałych i ciekłych bez żadnego przygotowania wstępnego, co sprawia, że NIRS jest szczególnie odpowiednia do bezpośredniego i szybkiego wykrywania oraz analizy produktów naturalnych i syntetycznych1,2. W przeciwieństwie do tradycyjnych czujników, które mierzą zmienne procesowe (np. temperaturę, ciśnienie, poziom cieczy itp.) w skali makroskopowej i nieuchronnie ulegają zakłóceniom zewnętrznym i tłu, NIRS wykrywa informacje strukturalne o składzie chemicznym w skali mikroskopowej i molekularnej. Dzięki temu kluczowe informacje mogą być mierzone dokładniej i skuteczniej niż za pomocą innych metod3,4.
Eter polifenylu, jako jeden z tworzyw inżynieryjnych, jest szeroko stosowany ze względu na swoją odporność termiczną, właściwości trudnopalne, izolacyjność, właściwości elektryczne, stabilność wymiarową, odporność na udary, odporność na pełzanie, wytrzymałość mechaniczną i inne właściwości5. Co ważniejsze, jest on nietoksyczny i nieszkodliwy w porównaniu z innymi tworzywami inżynieryjnymi. Obecnie 2,6-ksylenol jest jednym z podstawowych surowców do syntezy eteru polifenylenu, a zazwyczaj jest otrzymywany metodą katalitycznego alkilowania fenolu metanolem6. Głównymi produktami tej metody otrzymywania są o-krezol i 2,6-ksylenol. Po serii etapów separacji i ekstrakcji 2,6-ksylenol jest wykorzystywany do produkcji eteru polifenylenu. Jednak w 2,6-ksylenolu pozostają śladowe ilości o-krezolu. O-krezol nie bierze udziału w syntezie eteru polifenylenu i pozostaje w produkcie końcowym, co prowadzi do obniżenia jakości produktu lub nawet do niespełnienia norm jakościowych. Obecnie większość firm nadal analizuje skład złożonych mieszanin organicznych, takich jak produkty eteru polifenylu w fazie ciekłej zawierające zanieczyszczenia (np. o-krezol), za pomocą fizycznej lub chemicznej analizy separacyjnej, takiej jak chromatografia7,8. Zasadą separacji w chromatografii jest wykorzystanie niewielkich różnic w rozpuszczalności, analizie, adsorpcji, desorpcji lub innym powinowactwie składników mieszaniny względem fazy stacjonarnej i fazy ruchomej. Gdy obie fazy poruszają się względem siebie, składniki są wielokrotnie rozdzielane w obu fazach poprzez opisane procesy. W zależności od badanego obiektu, operacja separacji złożonego materiału trwa zazwyczaj od kilku do kilkudziesięciu minut. Można zatem zauważyć, że wydajność pomiaru jest niska.
Obecnie pomiar jakości produktu oraz zaawansowana technologia sterowania oparta na tej analizie dla nowoczesnego przemysłu chemicznego materiałów precyzyjnych stanowią kluczowy kierunek dalszej poprawy jakości produktów. W przemyśle procesowym produkcji polieterów polifenylowych pomiar w czasie rzeczywistym zawartości o-krezolu w produkcie polieteru polifenylenu ma ogromne znaczenie rozwojowe. Analiza chromatograficzna ewidentnie nie spełnia wymagań zaawansowanej technologii sterowania w zakresie pomiaru substancji i sprzężenia zwrotnego sygnału w czasie rzeczywistym. Dlatego proponujemy metodę regresji cząstkowych najmniejszych kwadratów (PLSR) w celu ustanowienia modelu liniowego między danymi NIRS a stężeniem o-krezolu, co pozwala na pomiar online zawartości o-krezolu w ciekłym produkcie polieteru polifenylenu na wylocie.
Wstępne przetwarzanie danych w spektroskopii NIRS odgrywa kluczową rolę przed zastosowaniem wielowymiarowego modelowania statystycznego. Liczby falowe NIRS w widmie bliskiej podczerwieni oraz rozmiary cząsteczek próbek biologicznych są porównywalne, co prowadzi do występowania nieoczekiwanych efektów rozproszenia wpływających na zarejestrowane widma próbek. Dzięki zastosowaniu odpowiednich metod wstępnego przetwarzania efekty te można w znacznym stopniu wyeliminować9. Najczęściej stosowane techniki wstępnego przetwarzania w NIRS klasyfikuje się jako metody korekcji rozproszenia oraz metody pochodnych widmowych. Pierwsza grupa metod obejmuje multiplikatywną korekcję rozproszenia (MSC), detrending, transformację standard normal variate (SNV) oraz normalizację. Metody pochodnych widmowych obejmują zastosowanie pierwszej i drugiej pochodnej.
Przed opracowaniem ilościowego modelu regresji ważne jest usunięcie niesystematycznych wariacji rozproszonych z danych NIRS, ponieważ mają one istotny wpływ na dokładność modelu predykcyjnego, jego złożoność oraz oszczędność. Wybór odpowiedniej metody wstępnego przetwarzania powinien zawsze zależeć od kolejnego etapu modelowania. W tym przypadku, jeśli zbiór danych widmowych NIR nie spełnia prawa Lamberta-Beera, inne czynniki mają tendencję do kompensowania nieidealnego zachowania predykcji dla przewidywanych komponentów. Wadą istnienia takich zbędnych czynników jest zwiększenie złożoności modelu, a najprawdopodobniej również zmniejszenie jego odporności. Zatem zastosowanie pochodnych widma oraz konwencjonalnej normalizacji danych widmowych stanowi niezbędną część tej metody.
Po wstępnym przetwarzaniu widm uzyskuje się dane NIRS o wysokim stosunku sygnału do szumu i niskich zakłóceniach tła. Nowoczesna analiza NIRS umożliwia szybką akwizycję dużych ilości danych o absorbancji w odpowiednim zakresie widmowym. Skład chemiczny próbki jest następnie przewidywany poprzez wyodrębnienie istotnych zmiennych z informacji zawartych w krzywej widmowej. Zazwyczaj NIRS łączy się z technikami analizy wielowymiarowej w celu przeprowadzenia analiz jakościowych lub ilościowych10. Wielowymiarowa regresja liniowa (MLR) jest powszechnie stosowana do opracowywania i badania zależności matematycznych między danymi a składnikami w procesach przemysłowych i znajduje szerokie zastosowanie w analizie NIRS.
Istnieją jednak dwa fundamentalne problemy podczas wdrażania regresji wieloliniowej (MLR) dla wstępnie przetworzonych danych NIRS. Pierwszym problemem jest redundancja zmiennych. Wysoka wymiarowość danych NIRS często sprawia, że prognozowanie zmiennej zależnej staje się niewiarygodne, ponieważ do modelu włączane są zmienne, które nie wykazują korelacji z komponentami. Te nadmiarowe zmienne obniżają efektywność informacyjną danych widmowych i wpływają na dokładność modelu. Aby wyeliminować redundancję zmiennych, niezbędne jest opracowanie i zmaksymalizowanie korelacji między danymi NIRS a prognozowanymi komponentami.
Kolejnym problemem jest kwestia współliniowości w danych NIRS. Jednym z ważnych założeń modeli regresji liniowej wielorakiej jest brak liniowej zależności między zmiennymi objaśniającymi modelu regresji. Jeśli taka zależność liniowa występuje, oznacza to obecność współliniowości w modelu regresji liniowej i naruszenie tego założenia. W regresjach liniowych wielorakich, takich jak regresja metodą najmniejszych kwadratów (OLSR), wielokrotne korelacje między zmiennymi wpływają na szacowanie parametrów, zwiększają błąd modelu oraz wpływają na jego stabilność. Aby wyeliminować korelację wieloliniową pomiędzy danymi widmowymi NIR, stosujemy metody selekcji zmiennych, które maksymalizują inherentną zmienność próbek.
W niniejszej pracy proponujemy zastosowanie metody PLSR, która stanowi uogólnienie wielokrotnej regresji liniowej i jest szeroko wykorzystywana w dziedzinie NIRS11,12. Metoda PLSR integruje podstawowe funkcje MLR, analizy korelacji kanonicznej (CCA) oraz analizy głównych składowych (PCA), łącząc analizę prognostyczną z analizą konotacyjną danych bezmodelowych. PLSR można podzielić na dwie części. W pierwszej części, za pomocą analizy częściowych najmniejszych kwadratów (PLS), wybierane są składowe zmiennych charakterystycznych oraz składowe przewidywane. PLS maksymalizuje wewnętrzną zmienność głównych składowych poprzez dążenie do uzyskania jak największej kowariancji między głównymi składowymi a składowymi przewidywanymi podczas ekstrakcji głównych składowych. Następnie dla wybranych głównych składowych tworzony jest model OLSR dla stężenia o-kresolu. PLSR nadaje się do analizy danych zaszumionych z licznymi zmiennymi niezależnymi, które wykazują silną kolinearność i wysoką korelację, a także do jednoczesnego modelowania kilku zmiennych odpowiedzi. Ponadto PLSR pozwala na ekstrakcję istotnych informacji ze widm próbek, rozwiązuje problem współliniowości oraz charakteryzuje się wysoką stabilnością i dużą dokładnością przewidywań13,14.
Poniższy protokół opisuje proces wykorzystania modelu PLSR do pomiaru stężenia o-krezolu z wykorzystaniem danych spektralnych NIR. Niezawodność i dokładność modelu są oceniane ilościowo przy użyciu współczynnika determinacji ( ), współczynnika korelacji predykcji (
 ) oraz średnio kwadratowego błędu predykcji walidacji krzyżowej (MSPECV). Ponadto, aby intuicyjnie przedstawić zalety metody PLSR, wskaźniki oceny zostały zwizualizowane na kilku wykresach w ramach analizy jakościowej. Na koniec, wskaźniki oceny eksperymentu zostają przedstawione w formie tabeli, aby ilościowo zilustrować niezawodność i precyzję modelu PLSR.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
1. Pozyskiwanie danych widmowych NIR za pomocą spektrometru procesowego FT-NIR
- Zainstaluj sondę światłowodową do pomiarów w fazie ciekłej spektrometru bliskiej podczerwieni przy wylocie produktu z polifenylenoeteru. Następnie otwórz OPUS oprogramowanie na komputerze nadrzędnym połączonym z urządzeniem i rozpocznij konfigurację pomiaru.
- Podłączenie do spektrometru
- Na Pomiar menu, wybierz Konfiguracja i serwis optyki wprowadź polecenie lub kliknij ikonę na pasku narzędzi.
- W otwierającym się oknie dialogowym kliknij przycisk Ława optyczna zakładka.
- Sprawdzić, czy ustawienia spektrometru są prawidłowe. W przypadku potwierdzenia zamknąć okno dialogowe. W przeciwnym razie przejść do kroku 4.
- Z Konfiguracja z listy rozwijanej wybierz odpowiedni typ spektrometru.
- Wprowadź adres IP spektrometru do Adres URL ławy optycznej pole wprowadzania
- Kliknij w Połącz przycisk
- Konfiguracja parametrów pomiarowych
- Na Pomiar menu, wybierz Pomiar wprowadź polecenie lub kliknij ikonę na pasku narzędzi.
- W wyświetlonym oknie dialogowym zdefiniuj parametry pomiarowe na poszczególnych kartach.
UWAGA: Szczegółowe informacje na temat poszczególnych parametrów pomiarowych opisano w podręczniku użytkownika OPUS (OPUS Reference Manual). - Kliknij Akceptuj & Wyjście przycisk
- Przechowywanie pliku eksperymentu
- Na Pomiar menu, wybierz opcję Zaawansowany pomiar polecenie. Następnie kliknij przycisk Zaawansowany tab.
- W otwieranym oknie dialogowym zdefiniuj rozdzielczość jako 4 cm-1.
- Zdefiniuj liczbę skanów jako 16 skany w Czas skanowania próbki/tła pola wprowadzania danych
- Zdefiniuj ścieżkę do automatycznego zapisywania danych pomiarowych z 4 000 cm-1-12 500 cm-1.
- Określ typ danych dla widma wynikowego jako Absorbancja.
- Kliknij w Zapisz przycisk
- W otwierającym się oknie dialogowym określ nazwę pliku eksperymentu i zapisz tę nazwę.
- Pomiar widma tła
- Na Pomiar menu, wybierz Zaawansowane pomiary polecenie
- Kliknij Optyczny tab.
- W wyświetlonym oknie dialogowym kliknij przycisk Ustawienie przysłony z listy rozwijanej i wybierz tę samą wartość, której użyto do pozyskania widma wzorcowego.
- Kliknij Podstawowe tab.
- W otwartym oknie dialogowym kliknij przycisk Tło jednokanałowe przycisk
- Pomiar widma próbki
- Umieść próbkę na drodze optycznej spektrometru. Sposób wykonania tej czynności zależy od konfiguracji spektrometru.
- Na Pomiar menu, wybierz z Zaawansowane pomiary polecenie
- Kliknij Podstawowe tab.
- W otwierającym się oknie dialogowym należy zdefiniować opis próbki oraz formę próbki w odpowiednim polu wprowadzania. Informacje te są zapisywane wraz ze widmem.
- Kliknij przycisk Próbka jednokanałowa przycisk do rozpoczęcia pomiaru online. Następnie należy zapisać widmo NIR każdego skanu jako plik OPUS.
- Pobierać próbki polifenylenu co 6 h i oznaczać stężenie o-krezolu metodą chromatografii cieczowej w laboratorium przemysłowym w celu uzyskania chemicznej wartości odniesienia.
UWAGA: Pracownicy laboratoryjni z sektora przemysłowego pobrali każdą próbkę eteru polifenylu z wylotu eteru polifenylu w fazie ciekłej. Zawartość o-krezolu w każdej próbce zmierzono trzykrotnie przy użyciu chromatografii cieczowej. Następnie, w celu zminimalizowania błędów przypadkowych, wartość średnią z wyników tych trzech analiz przyjęto jako wartość referencyjną zawartości o-krezolu. - Należy uzyskać 600 laboratoryjnych wartości referencyjnych dla stężenia o-krezolu. Zakres kalibracji stężenia o-krezolu wynosi od 42,1063 mg/1 g produktu polifenyloeterowego do 51,6763 mg/1 g produktu polifenyloeterowego.
- Połącz widma NIR uzyskane w określonych czasach testu z chemicznymi wartościami referencyjnymi stężenia o-krezolu.
- Użyj oprogramowania OPUS, aby odczytać oryginalny zestaw widm, jak pokazano w Rycina 1.
- Na Plik menu, kliknij Wczytaj plik polecenie
- W otwartym oknie dialogowym wybierz odpowiedni plik widma.
- Kliknij Otwórz przycisk. Widmo jest wyświetlane w oknie widma.
2. Przetwarzanie wstępne danych spektroskopii NIR
- Korzystając z funkcji wstępnego przetwarzania widm, uzyskaj zestaw danych widmowych przetworzonych za pomocą pochodnej pierwszego rzędu.
- Otwórz The Unscrambler który jest oprogramowaniem do wielowymiarowej analizy danych i planowania eksperymentów, wybierz* Import polecenie pod PlikZaimportuj plik OPUS jako oryginalny zestaw danych spektralnych NIR.
- Wybierz Przekształć polecenie pod Zmodyfikuj. I wybierz Pochodne Savitzky'ego-Golaya pod Pochodne.
- Zdefiniuj Próbki i Zmienne jako Wszystkie Próbki i Wszystkie Zmienne w Zakresie. Następnie zdefiniuj liczbę Wygładzanie punktów jako 13 oraz Pochodna jako 1Proszę podać tekst źródłowy do tłumaczenia. pochodna w Parametrach.
- Kliknij Proszę podać tekst źródłowy do tłumaczenia. aby rozpocząć otrzymywanie pochodnej.
UWAGA: Zwiększenie stopnia wygładzania może zredukować gwałtowne wahania krzywej oraz zmniejszyć wpływ szumu, ale może również osłabić charakterystykę krzywej i doprowadzić do jej zniekształcenia. Należy zatem dobrać odpowiedni stopień wygładzania na podstawie obserwacji rzeczywistej intensywności wahań krzywej oraz efektu po przetworzeniu danych.
- Przeprowadź normalizację wektorową widm próbek, aby znormalizować wartości absorbancji.
- Wybierz Normalizacja polecenie poniżej Zmodyfikuj.
- Zdefiniuj Próbki i zmienne jako Wszystkie próbki i Wszystkie zmienne w Zakres.
- Wybierz Normalizacja wektora w Typ.
- Kliknij Proszę przesłać tekst źródłowy do tłumaczenia. w celu przeprowadzenia normalizacji wektorów.
3. Tworzenie modelu PLSR
- Tworzenie zestawu danych spektralnych NIR
- Uruchom program Uncrambler.exe, wybierz opcję Export w menu File, wybierając pliki Matlab, aby wyeksportować wstępnie przetworzony zestaw danych spektralnych do pliku .mat i automatycznie uzyskać zestaw danych spektralnych X zawierający 2203 zmienne.
- Uzyskaj kompletny zestaw danych spektralnych NIR X (macierz 600 wierszy i 2203 kolumn) oraz odpowiadające im chemiczne wartości referencyjne Y (wektor 600 wierszy) w formie pliku .mat do późniejszej analizy i modelowania.
- Wybór odpowiedniej liczby głównych składowych
- Otwórz program Matlab i zaimportuj do obszaru roboczego plik .mat zawierający wstępnie przetworzone dane spektralne w bliskiej podczerwieni, przeciągając plik .mat do obszaru roboczego.
UWAGA: Plik .mat przechowuje dane spektralne w bliskiej podczerwieni X jako zmienną niezależną oraz zawartość o-krezolu w produkcie jako zmienną zależną w formie dwóch macierzy. - Otwórz zaprogramowany plik .m w Edytorze. Kliknij Open w opcjach Editor, wybierz skompilowany plik .m w katalogu plików, a następnie kliknij Confirm.
- Wyodrębnij 15 głównych składowych zgodnie z celem optymalizacji określonym w Równaniu 1 oraz modelem OLSR pomiędzy wyodrębnionymi głównymi składowymi a przewidywanymi wartościami stężenia o-krezolu, korzystając z programu zawierającego polecenie plsregress() w programie Matlab.
[XL, YL, XS, YS, BETA, PCTVAR, MSE] = plsregress(X,Y,ncomp,’CV’,k);
Zapoznaj się z dokumentacją pomocy MATLAB, aby uzyskać szczegółowe informacje na temat użytkowania i wartości zwracanych.
UWAGA: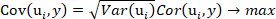 Równanie 1

 oraz
 to ita główna składowa danych spektralnych NIR;
 to rzut itej głównej składowej danych spektralnych NIR;
 to współczynnik korelacji Pearsona dla itej głównej składowej i stężenia o-krezolu.
- Oblicz wartość dla danych spektralnych NIR i wartości przewidywanych dla różnych głównych składowych, korzystając z Równania 2.
UWAGA: Równanie 2
 to suma kwadratów błędów, zdefiniowana jako
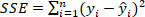 ;
 to całkowita suma kwadratów, zdefiniowana jako
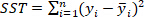 ;
 to wartość referencyjna stężenia o-krezolu w zbiorze testowym;
 to wartość przewidywana stężenia o-krezolu w zbiorze testowym;
 to średnia wartość referencyjna stężenia o-krezolu w zbiorze testowym;
 to liczba próbek w zbiorze testowym.
- Wyznacz wartości i tendencję wraz ze wzrostem liczby głównych składowych, jak pokazano na Rysunku 2. Wybierz 10 jako odpowiednią liczbę głównych składowych dla wartości wynoszącej 0,9917.
UWAGA: Wartość to proporcja wariancji zmiennej zależnej, która jest przewidywalna na podstawie zmiennych niezależnych. Im wyższa wartość , tym lepsza jest jakość dopasowania i na odwrót.
- Otwórz program Matlab i zaimportuj do obszaru roboczego plik .mat zawierający wstępnie przetworzone dane spektralne w bliskiej podczerwieni, przeciągając plik .mat do obszaru roboczego.
- Walidacja jakości dopasowania i dokładności modelu PLSR z 10 głównymi składowymi przy użyciu polecenia plsregress().
- Powtórz proces modelowania dla 10 głównych składowych, zgodnie z krokami 3.2.1-3.2.5.
- Oceń model na podstawie 10-krotnej walidacji krzyżowej, wykorzystując wykresy procentowej wariancji wyjaśnionej w danych spektralnych NIR, rezyduów oraz MSPECV.
- Przedstaw procentową wariancję wyjaśnioną w danych spektralnych NIR, rezydua oraz MSPECV jako Rysunki 3, 4 i 5.
- Zestaw w tabeli wskaźniki oceny , oraz MSPE z 10-krotnej walidacji krzyżowej dla modelu PLSR do analizy ilościowej, jak pokazano w Tabeli 1.
UWAGA: Równania dla i MSPE są przedstawione jako Równanie 3 i Równanie 4.
 Równanie 3
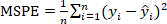 Równanie 4
 to kowariancja wartości referencyjnej i wartości przewidywanej stężenia o-krezolu;
 to odchylenie standardowe wartości referencyjnej stężenia o-krezolu;
 to odchylenie standardowe wartości przewidywanej stężenia o-krezolu.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Przewidywana wartość zanieczyszczenia o-krezolem w produktach polifenyloeterowych jest uzyskiwana za pomocą spektroskopii bliskiej podczerwieni opartej na PLSR. Rycina 2 oraz Rycina 3 przedstawiają odpowiednio wiarygodność metody na etapie wyboru cech, na podstawie krzywej współczynnika determinacji oraz procentowej interpretacji błędu rosnącej wraz z liczbą głównych składowych.
W szczególności ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Protokół ten opisuje proces wykonywania PLSR na pomiarze stężenia o-krezolu pozostałego w ciekłym produkcie eteru polifenylenowego z NIRS.
Dwa kluczowe etapy tego procesu to wstępne przetwarzanie oryginalnych danych spektralnych NIR oraz wybór zmiennych wysokowymiarowych danych spektralnych NIR.
Ogólnie rzecz biorąc, niesystematyczna interferencja tła prowadzi do niesystematycznego odchylenia rozpraszania lub dryfu linii bazowej widma NIR. Właściwa metoda wstępnego ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Ta praca była wspierana przez Narodową Fundację Nauk Przyrodniczych Chin (Granty nr 61722306 i 61473137) oraz National First-class Discipline Program of Light Industry Technology and Engineering (LITE2018-025).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Wielofunkcyjny analizator FT-NIR MPA II Sondy | Bruker | 1 | |
| (faza ciekła) | Analizator | 1 | |
| / | 1 | ||
| Sprzęt i materiały laboratoryjne (np. probówka itp.) | / | ||
| MATLAB | MathWork | 1 | |
| OPUS | Bruker | 1 | |
| Główny komputer | DELL | 1 | |
| Unscrambler | CAMO | 1 |
Bibliografia
- Nicolai, B. M., et al. Nondestructive measurement of fruit and vegetable quality by means of NIR spectroscopy: A review. Postharvest Biology and Technology. 46 (2), 99-118 (2007).
- Chang, C. W., Laird, D. A., Mausbach, M. J., Hurburgh, C. R. Near-infrared reflectance spectroscopy-principal components regression analyses of soil properties. Soil Science Society of America Journal. 65 (2), 480-490 (2001).
- Chen, Y., et al. Near-infrared spectroscopy for rapid evaluation of different processing products of Sophora japonica. L. Spectroscopy Letters. 51 (1), 37-44 (2018).
- Cayuela, J. A., Garcia, J. F. Nondestructive measurement of squalene in olive oil by near infrared spectroscopy. LWT-FOOD SCIENCE AND TECHNOLOGY. 88, 103-108 (2018).
- Joaquim, M. Polyphenyl Ether Lubricants. Synthetic Lubricants and High-performance Functional. Rudnick, R. L., Shubkin, R. L. , Marcel Dekker, Inc. NY. 239(1999).
- Grabowska, H., Kaczmarczyk, W., Wrzyszcz, J. Synthesis of 2,6-Xylenol by Alkylation of Phenol with Methanol. Applied Catalysis. 47 (2), 351-355 (1989).
- Jeon, D. B., et al. Determination of volatile organic compounds, catechins, caffeine and theanine in Jukro tea at three growth stages by chromatographic and spectrometric methods. FOOD CHEMISTRY. 219, 443-452 (2016).
- Davidyuk, E. I., Demchenko, V. F., Klisenko, M. A. Rapid group separation and identification of chlorinated organic compounds by high performance liquid chromatography. JOURNAL OF ANALYTICAL CHEMISTRY. 52 (11), 1058-1065 (1997).
- Rinnan, A., Berg, F., Engelsen, S. B. Review of the most common pre-processing techniques for near-infrared spectra. TrAC Trends in Analytical Chemistry. 28 (10), 1201-1222 (2009).
- Zou, X. B., Zhao, J. W., Povey, M. J. W., Holmes, M., Mao, H. P. Variables selection methods in near-infrared spectroscopy. Analytica Chimica Acta. (1-2), 14-32 (2010).
- Dunn, B. W., Beecher, H. G., Batten, G. D., Ciavarella, S. The potential of near-infrared reflectance spectroscopy for soil analysis - a case study from the Riverine Plain of south-eastern Australia. Australian Journal of Experimental Agriculture. 42 (5), 607-614 (2002).
- Wang, C. K., Zhang, T. L., Pan, X. Z. Potential of visible and near-infrared reflectance spectroscopy for the determination of rare earth elements in soil. Geoderma. 306, 120-126 (2017).
- Gatius, F., Miralbes, C., David, C., Puy, J. Comparison of CCA and PLS to explore and model NIR data. Chemometrics and Intelligent Laboratory Systems. , 76-82 (2017).
- Wold, S., Sjostrom, M., Eriksson, L. PLS-regression: a basic tool of chemometrics. Chemometrics & Intelligent Laboratory. 58 (2), 109-130 (2001).
- Douglas, R. K., Nawar, S., Alamar, M. C., Mouazen, A. M., Coulon, F. Rapid prediction of total petroleum hydrocarbons concentration in contaminated soil using vis-NIR spectroscopy and regression techniques. SCIENCE OF THE TOTAL ENVIRONMENT. 616, 147-155 (2017).
- Grassi, S., Alamprese, C. Advances in NIR spectroscopy applied to process analytical technology in food industries. CURRENT OPINION IN FOOD SCIENCE. 22 (SI), 17-21 (2018).
- Trung, T., Downes, G., Meder, R., Allison, B. Pulp mill and chemical recovery control with advanced analysers - from trees to final product. APPITA. 68 (1), 39-46 (2015).
- Vann, L., Sheppard, J. Use of near-infrared spectroscopy (NIRs) in the biopharmaceutical industry for real-time determination of critical process parameters and integration of advanced feedback control strategies using MIDUS control. Journal of Industrial Microbiology& Biotechnology. 44 (12), 1589-1603 (2017).
- Modrono, S., Soldado, A., Martinez-Fernandez, A., de la Roza-Delgado, B. Handheld NIRS sensors for routine compound feed quality control: Real time analysis and field monitoring. TALANTA. 162, 597-603 (2017).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
