Prezentujemy prosty protokół ekranu tłumiącego w drożdżach rozszczepienia. Metoda ta jest skuteczna, wolna od mutagenów i selektywna w przypadku mutacji, które często występują w pojedynczym locus genomu. Protokół jest odpowiedni do izolowania supresorów, które łagodzą defekty wzrostu w płynnej kulturze, które są spowodowane mutacją lub lekiem.
Artykuł metodologiczny
Wspomagane głębokim sekwencjonowaniem, spontaniczne badanie supresorowe w drożdżach rozszczepienia Schizosaccharomyces pombe
W tym artykule
Podsumowanie
Streszczenie
Genetyczne badanie przesiewowe pod kątem zmutowanych alleli, które tłumią defekty fenotypowe spowodowane mutacją, jest skutecznym podejściem do identyfikacji genów, które należą do blisko powiązanych szlaków biochemicznych. Wcześniejsze metody, takie jak analiza syntetycznej macierzy genetycznej (SGA) i techniki mutagenezy losowej z wykorzystaniem ultrafioletu (UV) lub chemikaliów, takich jak metanosulfonian etylu (EMS) lub N-etylo-N-nitrozomocznik (ENU), były szeroko stosowane, ale często są kosztowne i pracochłonne. Ponadto te metody badań przesiewowych oparte na mutagenach są często związane z poważnymi skutkami ubocznymi dla organizmu, wywołując wiele mutacji, które zwiększają złożoność izolowania supresorów. W tym miejscu przedstawiamy prosty i skuteczny protokół identyfikacji mutacji supresorowych u mutantów, które powodują defekt wzrostu w Schizosaccharomyces pombe. Sprawność komórek z niedoborem wzrostu w standardowych bogatych pożywkach płynnych lub syntetycznych pożywkach płynnych może być monitorowana w celu odzyskania za pomocą automatycznego 96-dołkowego czytnika płytek przez dłuższy czas. Gdy komórka nabywa mutację supresorową w kulturze, jej potomkowie konkurują z komórkami rodzicielskimi. Odzyskane komórki, które mają konkurencyjną przewagę wzrostu nad komórkami rodzicielskimi, można następnie wyizolować i krzyżować wstecznie z komórkami rodzicielskimi. Mutacje supresorowe są następnie identyfikowane za pomocą sekwencjonowania całego genomu. Stosując to podejście, udało nam się wyizolować wiele supresorów, które łagodzą poważne defekty wzrostu spowodowane utratą Elf1, ATPazy z rodziny AAA +, która jest ważna w transporcie jądrowym mRNA i utrzymaniu stabilności genomu. Obecnie w S. pombe znajduje się ponad 400 genów z mutantami nadającymi wadę wzrostu. Ponieważ wiele z tych genów jest niescharakteryzowanych, sugerujemy, że nasza metoda przyspieszy identyfikację nowych interakcji funkcjonalnych dzięki temu przyjaznemu dla użytkownika, wysokowydajnemu podejściu.
Wprowadzenie
Podstawą zrozumienia funkcjonalnych powiązań między genami jest umiejętność identyfikacji molekularnych mechanizmów, dzięki którym złożone cechy genetyczne rozchodzą się, tworząc różne fenotypy1. U drożdży rozszczepialnych, Schizosaccharomyces pombe (S. pombe), większość genów kodujących białka jest zbędna dla żywotności2. Wynik ten nie świadczy o nieistotności tych genów, ale raczej o skomplikowanych mechanizmach kompensacyjnych leżących u podstaw szlaków biochemicznych, do których te geny należą. Analiza tych mechanizmów kompensacyjnych pozwoliła na stworzenie map epistazy, które ujawniły kompleksowe interakcje genetyczne i poszerzyły naszą wiedzę na temat funkcjonalnych szlaków biochemicznych3,4.
Metody o wysokiej przepustowości (np. analiza syntetycznej macierzy genetycznej lub SGA) zostały opracowane w celu identyfikacji interakcji genetycznych całego genomu u pączkujących drożdży i zostały rozszerzone do użytku w drożdżach rozszczepialnych5,6. Takie podejścia często opierają się na bibliotece szczepów zawierających wszystkie zdolne do życia delecje genów kodujących pojedyncze białka (około 3300 haploidalnych mutantów delecji pokrywających ponad 92% genomu drożdży rozszczepialnych) i wymagają ramienia robotycznego do wykonania krzyżówek genetycznych między szczepem będącym przedmiotem zainteresowania a wszystkimi możliwymi szczepami w bibliotece6. Co więcej, techniki SGA zależą od zdolności szczepów bibliotecznych do prawidłowego i wydajnego kojarzenia, fenotypu, który jest nieprawidłowy dla 444 obecnie scharakteryzowanych genów w S. pombe2.
Pomimo złożoności interakcji genetycznych, porównanie fenotypu szczepu przenoszącego mutacje w dwóch genach do fenotypu dwóch szczepów niosących indywidualne mutacje każdego genu może przynieść jeden z dwóch godnych uwagi wyników: 1) Fenotyp podwójnej mutacji jest gorszy niż oczekiwany multiplikatywny fenotyp rodzicielski w postaci choroby lub, w najbardziej ekstremalnym przypadku, Śmiertelność. Jest to określane jako negatywna interakcja genetyczna i jest ogólnie znakiem, że te dwa geny działają w równoległych szlakach biologicznych. 2) Fenotyp podwójnie zmutowany jest lepszy niż oczekiwana kombinacja fenotypów rodzicielskich, znana również jako pozytywna interakcja genetyczna. Pozytywna interakcja genetyczna jest szczególnie interesująca, ponieważ wskazuje, że geny te funkcjonują w tym samym procesie. Dwa pozytywnie oddziałujące geny mają trzy potencjalne relacje: zmutowany gen może regulować ekspresję drugiego genu w górę w równoległym szlaku, dwa geny mogą działać zgodnie w ramach tego samego szlaku za sobą lub dwa geny kodują białka, które oddziałują bezpośrednio ze sobą. W związku z tym pozytywne interakcje genetyczne mogą być wykorzystywane do mapowania węzłów regulacyjnych genów i klasyfikowania niescharakteryzowanych genów w szlakach biochemicznych7,8.
Supresor to mutacja, która może złagodzić fenotyp choroby mutacji innego genu, zazwyczaj reprezentując pozytywną interakcję genetyczną między dwoma genami9,10. Mutacje supresorowe w innym locus niż mutacja, którą tłumią, są znane jako supresory ekstragenowe. Są one szczególnie cenne w badaniu nieżywotnych mutacji genetycznych poprzez syntetyczne ratowanie śmiertelnego fenotypu (znanego również jako efekt Lazarusa)11. Mają również potencjalne zastosowania terapeutyczne w leczeniu chorób dziedzicznych12,13.
Z tych wszystkich powodów, identyfikacja mutacji supresorowych w różnych organizmach modelowych jest szeroko wykorzystywana, aby ułatwić nam zrozumienie różnych szlaków biochemicznych14,15,16. Badania przesiewowe w kierunku supresorów są zwykle oparte na fenotypie danej mutacji i wymagają przeprowadzenia mutagenezy losowej w celu wyizolowania mutacji, które złagodziłyby fenotyp. Prawie wszystkie organizmy modelowe mają ustalone metody mutagenezy losowej. Na przykład N-etylo-N-nitrozomocznik (ENU) i metanosulfonian etylu (EMS), dwa mutageny, które są zdolne do indukowania mutacji punktowych w DNA, są szeroko stosowane w różnych modelach, od bakterii po myszy17,18,19. Ponadto chlorek manganu jest od dawna stosowany w drożdżach ze względu na zdolność kationu manganu do hamowania szlaków naprawy DNA20. Innym powszechnym podejściem jest mutageneza indukowana promieniowaniem UV, która generuje mutagenne dimery pirymidynowe obejmujące cały genom21,22.
Chociaż wykorzystanie mutagenezy chemicznej do identyfikacji mutacji supresorowych było popularne, metoda ta ma wiele wad, w tym użycie niebezpiecznych substancji chemicznych, bardzo zróżnicowane wskaźniki sukcesu i wprowadzenie dodatkowych zmiennych zakłócających, które są spowodowane negatywnymi skutkami ubocznymi mutagenu na wiele procesów komórkowych23,24. Ponadto mutageneza chemiczna często indukuje wiele mutacji w genomie, co zwiększa złożoność stosowania technik genetycznych i sekwencjonowania w celu zidentyfikowania dokładnej mutacji, która nadała fenotyp supresorowy w organizmie25.
Aby rozwiązać problemy obecnych metod mutagenezy, przedstawiamy metodę badania spontanicznych mutacji supresorowych u drożdży rozszczepialnych, która nie opiera się na żadnych mutagenach ani bibliotece delecji. Metoda izoluje supresory za pomocą pozytywnego testu selekcji. Zasada tej metody opiera się na przewadze wzrostu zmutowanej subpopulacji supresorów w kulturze płynnej, która może być monitorowana przez automatyczny czytnik płytek. Krycie i mejoza są stosowane tylko wtedy, gdy ktoś chciałby oczyścić tło genetyczne lub potwierdzić obecność monogenowych alleli supresorów przed sekwencjonowaniem całego genomu. Jeśli fenotyp supresji jest spowodowany pojedynczą mutacją, fenotyp supresorowy będzie segregowany w stosunku 2:2 po krzyżowaniu wstecznym ze szczepami rodzicielskimi. Mutacje supresorowe można następnie zidentyfikować za pomocą sekwencjonowania całego genomu. Proponujemy, aby ta metoda miała zastosowanie do badań przesiewowych supresorów we wszystkich mikroorganizmach, które mogą urosnąć do dużej populacji w kulturze płynnej.
Protokół
1. Konstrukcja i przygotowanie szczepów
- Wprowadź mutację lub delecję genu (yfm, wybrana przez badacza mutacja) przy użyciu standardowej mutogenezy kierowanej (SDM), zgodnie z wcześniejszym opisem26.
- Przed rozpoczęciem przesiewu (optymalnie) przeprowadź krzyżowanie wsteczne szczepów mutantów ze szczepem typu dzikiego w celu oczyszczenia tła genetycznego i wygenerowania świeżo powstałych komórek mutantów jako szczepów rodzicielskich. Wysiej szczep rodzicielski do pojedynczych kolonii na standardowych płytkach z pożywką bogatą. Losowo wybierz od ośmiu do szesnastu niezależnych kolonii (replikatów biologicznych) z pożądanymi mutacjami do analizy w czytniku płytek (patrz 3.1).
UWAGA: Niniejszy protokół jest skuteczny tylko wtedy, gdy szczepy rodzicielskie wykazują defekt wzrostu w pożywkach płynnych (minimalnych lub bogatych, z lekiem lub bez, lub przy zmianach temperatury wywołujących defekt wzrostu). Wszystkie szczepy rodzicielskie powinny być haploidalne, a zatem zdolne do krzyżowania genetycznego z innymi szczepami haploidalnymi o komplementarnym typie strzępkowania.
2. Analiza z użyciem czytnika płytek
- Za pomocą sterylnego aplikatora pobierz niewielką ilość każdej z kolonii przygotowanych w kroku 1.1 (dokładna ilość niezbędna do zaszczepienia kultury startowej nie jest wymagana) i przenieś je do polistyrenowej mikropłytki 96-dołkowej. Zawieś każdą z kolonii w 200 µL odpowiedniej pożywki płynnej (bogatej lub minimalnej, z lekiem lub bez). W każdym rzędzie płytki uwzględnij kontrolny dołek zawierający 200 µL tej samej pożywki (bez komórek).
- Uruchom poniższy protokół w oprogramowaniu detekcyjnym czytnika płytek podłączonym do zautomatyzowanego czytnika mikropłytek: ustaw program kinetyczny na 24 h i temperaturę na 30 °C, z ciągłym szybkim wstrząsaniem orbitalnym (425 cpm, amplituda 3 mm). Ustaw odczyty optyczne na pomiar rozproszenia światła przy długości fali 600nm dla gęstości optycznej oraz ustaw odczyt światła od dołu płytki z częstotliwością 2 min (łącznie 721 odczytów w ciągu 24 h na dołek).
- Po 24 h zarejestruj końcowe odczyty gęstości optycznej po odjęciu tła (blanked OD600) i użyj poniższego wzoru, aby określić objętość potrzebną do rozcieńczenia każdej z próbek do O.D. = 0.1:

UWAGA: Eksportuj dane z oprogramowania czytnika płytek i użyj programu do arkuszy kalkulacyjnych, aby wprowadzić powyższy wzór jako funkcję do masowego obliczania objętości rozcieńczenia dla każdego dołka eksperymentalnego. - Co 24 h rozcieńczaj każdą z próbek, używając tej samej pożywki co w dniu 0, do O.D. = 0.1 (około 1.5 x 10⁶ komórek/mL), stosując wzór wskazany w kroku 2.3. Zapisuj wszystkie krzywe wzrostu generowane codziennie i odnotowuj każdą pojedynczą kolonię, która wykazuje zwiększone tempo wzrostu, oceniane na podstawie końcowej wartości O.D. istotnie wyższej niż w przypadku reszty kohorty o tym samym tle genetycznym lub na podstawie krzywej wzrostu podobnej do krzywych kolonii typu dzikiego.
UWAGA: Analiza ta trwa zazwyczaj od 7 do 14 dni. Wszystkie kroki należy wykonywać w warunkach sterylnych.
3. Selekcja kolonii supresorowych i potwierdzenie fenotypu.
- W ostatnim dniu testu z użyciem czytnika płytek (krok 2.4) należy zachować kultury płynne, które wykazują wyraźnie poprawioną szybkość wzrostu, co prawdopodobnie wynika z nabycia mutacji supresorowej łagodzącej fenotyp mutacji rodzicielskiej. Przenieść i wymieszać 250 µL kultury płynnej w probówce kriogenicznej zawierającej 250 µL 50% glicerolu. Komórki należy zamrozić gwałtownie w ciekłym azocie i przechowywać szczepy w temperaturze -80oC bezterminowo.
- Aby potwierdzić, że mutacja supresorowa jest elementem dziedzicznym genetycznie, należy zastosować standardowe metody krzyżowania genetycznego w celu skrzyżowania yfm P (szczep rodzicielski użyty na początku testu z czytnikiem płytek) z yfm S (szczep supresorowy zachowany na końcu testu z czytnikiem płytek). Jeśli mutacja supresorowa jest rzeczywiście elementem dziedzicznym genetycznie, krzyżówka yfm P × yfm S powinna dać tetrady, w których dwie kolonie wykazują fenotyp osłabienia szczepu rodzicielskiego, a dwie kolonie wykazują przywróconą szybkość wzrostu szczepu supresorowego.
- Z krzyżówki z kroku 3.2 należy wybrać trzy kolonie o fenotypie supresorowym (szczep S) oraz trzy kolonie o fenotypie rodzicielskim (szczep P) z tej samej krzyżówki genetycznej (3 powtórzenia biologiczne dla każdego), a następnie przejść do poniższych etapów ekstrakcji genomicznego DNA i sekwencjonowania.
UWAGA: Kroki 3.2 i 3.3 są wysoce zalecane, ale nieobowiązkowe. Alternatywnie można wysiać odzyskaną kulturę płynną zebraną w kroku 3.1 na podłożu bogatym w celu uzyskania pojedynczych kolonii, a następnie losowo wybrać trzy kolonie jako powtórzenia biologiczne do sekwencjonowania całego genomu bez dalszego potwierdzenia genetycznego. W takim przypadku do porównawczego sekwencjonowania genomicznego należy użyć trzech powtórzeń biologicznych szczepu rodzicielskiego.
4. Ekstrakcja genomowego DNA, przygotowanie bibliotek i sekwencjonowanie.
- W celu ekstrakcji DNA, przygotowania biblioteki i sekwencjonowania, należy losowo wybrać trzy powtórzenia biologiczne dla każdego szczepu yfm P oraz trzy powtórzenia biologiczne dla każdego indywidualnie powstałego szczepu yfm S z krzyżówek genetycznych (krok 3.2) lub z płytek, na których wyizolowano pojedyncze kolonie szczepu S (uwaga do kroku 3.3).
- Szczepy należy hodować w kulturach 10 mL w pożywce bogatej do środkowej fazy logarytmicznej (O.D. = 0,5–0,8, około 0,75–1,2 x 10⁷ komórek/mL), wykorzystując inkubator wytrząsowy w temperaturze 30 °C przy ciągłym wytrząsaniu z prędkością 250 rpm. Komórki należy zebrać poprzez wirowanie w temperaturze 4 °C przez 5 min przy 1000 x g.
- Osad komórkowy należy zawiesić w 400 µL buforu do ekstrakcji DNA (2% Triton X-100, 1% SDS, 100 mM NaCl, 10 mM Tris-Cl (pH 8,0), 1mM Na2-EDTA), a następnie dodać 400 µL kulek szklanych oraz 400 µL mieszaniny fenol:chloroform:alkohol izoamylikowy w proporcji 25:24:1. Próbki należy energicznie mieszać na wortexie przez 2 min w temperaturze 4 °C.
- Należy dodać kolejne 200 µL buforu do ekstrakcji DNA i wymieszać, kilkakrotnie odwracając probówkę. Wirować przez 5 min w temperaturze 4 °C przy 20 000 x g.
- Fazę wodną należy przenieść do czystej probówki, dodać 20 µg mieszaniny RNazy A/T1 i inkubować w temperaturze 37 °C przez 15 min.
- Należy dodać równą objętość mieszaniny fenol:chloroform:alkohol izoamylikowy 25:24:1, wirować przez 5 min w temperaturze 4 °C przy 20 000 x g, a następnie przenieść fazę wodną do czystej probówki.
- Należy dodać równą objętość chloroformu, wymieszać, kilkakrotnie odwracając probówkę, a następnie wirować przez 5 min w temperaturze 4 °C przy 20 000 x g i przenieść fazę wodną do czystej probówki.
- DNA należy wytrącić dwiema objętościami 100% etanolu oraz 10% objętością 3 M NaOAC (pH 4,3) w temperaturze -20 °C przez co najmniej 2 h, a następnie wirować przez 5 min w temperaturze 4 °C przy 20 000 x g i zebrać osad.
- Osad (wytrącone DNA) należy dwukrotnie przemyć schłodzonym 70% etanolem (wirowanie przy 20 000 x g, 5 min, 4 °C) i zawiesić osad w 50 µL 10 mM buforu Tris (pH 7,4).
- Do przygotowania biblioteki do sekwencjonowania całego genomu należy użyć zestawu do przygotowania bibliotek (patrz Tabela materiałów) zgodnie z zaleceniami producenta.
UWAGA: Zalecamy zestaw wymieniony w Tabeli materiałów, ponieważ umożliwia on konstrukcję biblioteki genomowej bez amplifikacji PCR, co minimalizuje mutacje błędne generowane podczas tego procesu. Ponadto podczas przygotowania biblioteki genomowej nie należy dopuścić do całkowitego wyschnięcia kulek, skracając czas ich suszenia do 1–2 min. - W przypadku parametrów fragmentacji podczas przygotowania biblioteki należy użyć sonikatora skupionego (patrz Tabela materiałów), ustawiając współczynnik wypełnienia (duty factor) na 20%, moc szczytową na 175 W, 200 cykli na impuls oraz tryb sweep częstotliwości od 5,5oC do 6 °C przez 45 s. Alternatywnie można użyć systemu do fragmentacji DNA i chromatyny (patrz Tabela materiałów) z następującymi ustawieniami: amplituda 50% w temperaturze 4 °C w trybie impulsowym, 15 s włączenia i 15 s wyłączenia przez 10 min, przy całkowitym czasie przetwarzania wynoszącym 20 min.
- Niezbędne jest zachowanie ostrożności podczas pracy z materiałami niebezpiecznymi używanymi w tym kroku. W celu bezpiecznego obchodzenia się z NaOAC, etanolem, mieszaniną fenol:chloroform:alkohol izoamylikowy 25:24:1 oraz chloroformem należy zapoznać się z odpowiednimi Kartami Charakterystyki Substancji oraz skonsultować się z biurem ds. BHP i ochrony środowiska w danej instytucji.
- Następnie należy zsekwencjonować otrzymane biblioteki genomowe. Całkowite odczyty z sekwencjonowania powinny pokryć cały genom co najmniej trzykrotnie z rozdzielczością na poziomie pojedynczego nukleotydu. Zaleca się sekwencjonowanie par końców (paired-end) lub zastosowanie najnowszych technologii.
5. Analiza bioinformatyczna w celu identyfikacji mutacji supresorowych
- Przeprowadź analizę bioinformatyczną, aby skupić się na zmianach genomicznych, które są konsekwentnie identyfikowane pomiędzy szczepami rodzicielskimi a szczepami yfm z supresją we wszystkich powtórzeniach biologicznych.
UWAGA: Pełny proces potoku (pipeline) opisano poniżej, ale dodatkowo dołączono dwa pliki skryptów BASH w formacie tekstowym, fastq_to_vcf.sh oraz vcfprocess.sh, jako materiały uzupełniające, aby pokazać przykłady przepływu pracy odpowiednio od przetwarzania odczytów do plików wariantów VCF oraz przetwarzania i przecięcia plików VCF. - Przytnij krótkie odczyty za pomocą SHEAR (https://github.com/jbpease/shear), stosując następujące linie komend (pozostałe opcje pozostawiono domyślne):
shear.py --fq1 $FASTQ1 --fq2 $FASTQ2 --out1 $OUTFQ1 --out2 $OUTFQ2 \
--barcodes1 $BARCODE --platform TruSeq --trimqual 20:20 \
--trimpolyat 0 --trimambig --filterlength 50 --filterunpaired - Zmapuj odczyty do genomu referencyjnego S. pombe v2.30 pobranego z PomBase (ftp://ftp.ebi.ac.uk/pub/databases/pombase/pombe/Chromosome_Dumps/fasta/) przy użyciu BWA v0.7.1527. Użyj następującej linii komend (pozostałe opcje pozostawiono domyślne):
bwa mem -t 8 $GENOME $OUTFQ1 $OUTFQ2 > $SAM1 - Przetwórz pliki dopasowań SAM przez potok dobrych praktyk GATK28 w celu wywoływania wariantów (variant calling), używając GATK v3.629, PicardTools v2.5.0 (http://broadinstitute.github.io/picard) oraz SAMtools v1.3.130. Użyj następujących linii komend i parametrów (pozostałe opcje pozostawiono domyślne):
java -Xmx30g -jar picard.jar AddOrReplaceReadGroups INPUT=$SAM1 \
OUTPUT=$BAMMARKED RGID=1 RGLB=lib01 RGPL=illumina \
RGPU=$BARCODE RGSM=$SAMPLENUMBER
samtools fixmate -O bam $BAMMARKED $BAMFIXED
samtools sort -O bam -o $BAMSORTED -T /home/peasejb/tmp $BAMFIXED
samtools index $BAMSORTED
java -Xmx30g -jar GenomeAnalysisTK.jar -T HaplotypeCaller \
-R $GENOME -I $BAMSORTED --genotyping_mode DISCOVERY \
-stand_emit_conf 10 -stand_call_conf 30 -o $VCFRAW - Skompresuj i zaindeksuj pliki VCF za pomocą tabix:
bgzip $VCFRAW.vcf
tabix $VCFRAW.vcf.gz - Porównaj pliki VCF pomiędzy powtórzeniami sekwencjonowania szczepów rodzicielskich i supresorowych przy użyciu BCFtools v1.3.127. Użyj następujących linii komend i parametrów (pozostałe opcje pozostawiono domyślne):
bcftools isec -n+1 $VCFPARENTAL1.gz $VCFPARENTAL2.gz $VCFPARENTAL3.gz \
$VCFMUTANT1.gz $VCFMUTANT2.gz $VCFMUTANT3.gz > common_variants.list
UWAGA: Komenda ta wygenerowała plik zakodowany wzorami binarnymi, w którym warianty sekwencji występujące tylko w pierwszym mutancie były zakodowane binarnie jako "000100", w drugim tylko jako "000010", we wszystkich trzech mutantach jako "000111," itd. Pliki te zostały wygenerowane dla każdego zestawu plików VCF powtórzeń rodzicielskich i mutantów. - Skompiluj listy przecięć wariantów razem z nazwą pliku dopisaną do każdej linii, używając komendy grep w systemie UNIX:
grep "." *.list > all.list - Przeprowadź analizę porównawczą pełnej listy wariantów z aktualnym plikiem adnotacji GFF3 (ftp://ftp.ebi.ac.uk/pub/databases/pombase/pombe/Chromosome_Dumps/gff3/schizosacchar omyces_pombe.chr.gff3) za pomocą niestandardowego skryptu Python (variant_characterize.py), aby zidentyfikować spójne miejsca SNP w regionach kodujących białka (synonimiczne i niesynonimiczne), w 5′ i 3′ UTR oraz w ncRNA.
python3 variant_characterize.py --list common_variants.list \
--gff schizosaccharomyces_pombe.chr.gff3 \
--fasta Schizosaccharomyces_pombe.ASM294v2.30.dna.genome.fa \
--pattern 000100 --out all.list.filter.000100
Powtórz działanie tego skryptu, modyfikując parametr --pattern oraz rozszerzenie pliku wyjściowego (--out), używając wzorów binarnych:
000010, 000001, 000110, 000011, 000101 oraz 000111 - Połącz wyniki ze wszystkich uruchomień skryptu w pliku rozdzielonym tabulatorami, który można wyświetlić jako arkusz kalkulacyjny. Adnotowana tabela wariantów obejmuje te, które występują w jednym lub obu szczepach mutantów w stosunku do tła. Pole flagi binarnej oznacza występowanie w pojedynczym szczepie mutanta (000100, 000010, 000001), dwóch szczepach mutantów (000011, 000101, 000110) lub we wszystkich trzech szczepach mutantów (000111).
- Przeanalizuj wyjściowe adnotowane listy wariantów, których nie znaleziono w próbkach rodzicielskich, ale które występują w jednej, dwóch lub wszystkich trzech próbkach mutantów. Adnotacja wskazuje zarówno lokalizację genomiczną, jak i klasę wariantu (synonimiczny/niesynonimiczny w regionie kodującym, 3'/5' UTR, niekodujący itd.). Z tej listy potencjalnych mutacji przykładem silnie istotnego kandydata może być niesynonimiczny wariant kodujący, występujący konsekwentnie we wszystkich trzech szczepach. Innym typem silnego kandydata byłoby nagromadzenie różnych mutacji niesynonimicznych lub domniemanych mutacji regulacyjnych w szczepach mutantów, występujących blisko siebie lub w obrębie tego samego genu.
Wyniki
Mutanty wolno rosnące wykazują regenerację fenotypową w hodowli ciekłej
Wybrano trzy mutanty zaangażowane w różne szlaki biologiczne o fenotypie osłabionym i wolno rosnącym: ATPase z rodziny AAA Elf1, deacetylazę histonową Clr6 oraz komponent kompleksu złącza eksonowego Fal1. Szczep typu dzikiego oraz szczepy z mutacjami w tych trzech genach, które zostały skrzyżowane wstecznie ze szczepami typu dzikiego, wysiano w celu uzyskania pojedynczych kolonii, a następnie losowo wybrano 16 pojedynczych kolonii do hodowli w bogatym medium ciekłym z wykorzystaniem płytki 96-dołkowej, zgodnie z powyższym opisem. Krzywe wzrostu poszczególnych kolonii rejestrowano w punkcie początkowym (dzień 0) oraz przez 6 dni przy ciągłym monitorowaniu za pomocą czytnika płytek. Zgodnie z oczekiwaniami, kolonie typu dzikiego nie wykazują zauważalnych zmian w krzywych wzrostu w trakcie całego eksperymentu31 (Rysunek 1). Co istotne, cztery kolonie z tłem elf1∆ i jedna kolonia fal1∆ wykazują gwałtowną zmianę wzrostu z wolno rosnącego na różne poziomy wzrostu zbliżone lub podobne do wzrostu kolonii typu dzikiego. Co uderzające, wszystkie mutanty clr6-1 wykazują spójną regenerację fenotypową, rosnąc w szybszym tempie pod koniec analizy31 (Rysunek 1). Aby scharakteryzować różne fenotypy, oryginalne szczepy wolno rosnące określono jako „szczepy P” (lub szczepy rodzicielskie), a szczepy wykazujące regenerację fenotypową jako „szczepy S” (lub szczepy stłumione). Należy pamiętać, że Rysunek 1 jest przykładem jednej rundy eksperymentu przesiewowego i nie reprezentuje całkowitej liczby zidentyfikowanych i zsekwencjonowanych niekomplementarnych supresorów przedstawionych w poniższych reprezentatywnych wynikach.
Przywrócenie fenotypu przypisuje się cechom dziedzicznym
S. pombe może rosnąć jako haploidalny organizm w pożywkach bogatych, jednak dwa szczepy haploidalne o komplementarnych typach kojarzenia łączą się podczas głodzenia azotowego. Mejoza u drożdży rozszczepialnych obejmuje jedną rundę duplikacji, po której następują dwie rundy podziału komórkowego. Cykl płciowy prowadzi do powstania czterech haploidalnych zarodników niosących materiał genetyczny szczepu rodzicielskiego z segregacją cech genetycznych w stosunku 2:2, zgodnie z zasadami klasycznej genetyki mendlowskiej (Rycina 2A). Hodując je na tej samej płytce przez ten sam czas, potwierdziliśmy segregację 2:2 poprzez krzyżowanie zwrotne wszystkich szczepów supresorowych (szczepy S) z ich szczepami rodzicielskimi (szczepy P), co zaowocowało powstaniem 2 małych kolonii (defekt wzrostu) i 2 dużych kolonii (fenotyp supresorowy). Pojedyncze przykłady dla supresorowych komórek elf1∆, clr6-1 oraz fal1∆ przedstawiono na Rycynie 2B. Potwierdziliśmy, że wszystkie wyizolowane szczepy S posiadają monogeniczny element genetyczny, który supresuje fenotyp wolnego wzrostu ich szczepów P (dane niepokazane).
Sekwencjonowanie całego genomu skutecznie identyfikuje mutacje supresorowe
Przykładowo, wykorzystaliśmy sekwencjonowanie całego genomu z odczytami parowanymi (paired-end), aby zidentyfikować elementy genetyczne odpowiedzialne za powrót fenotypowy w szczepach elf1∆ S. Bardziej szczegółowy opis analizy danych jest dostępny online31. W skrócie, zastosowaliśmy triplikaty biologiczne dwóch niezależnie wygenerowanych szczepów elf1∆ P oraz duplikaty biologiczne pięciu niekomplementarnych grup szczepów elf1∆ S, z których każdy zawierał różne supresory. Po uzyskaniu listy adnotowanych wariantów z analizy bioinformatycznej (6.1-10), nadaliśmy priorytet określonym klasom wariantów istotnym dla naszej analizy. Skupiliśmy się na identyfikacji spójnych zmian genomowych, które były identyczne we wszystkich replikach biologicznych poszczególnych szczepów elf1∆ S w porównaniu z ich szczepami rodzicielskimi elf1∆ P (Rycina 3 i Tabele uzupełniające 1-4). Zidentyfikowaliśmy pięć zmian niesynonimicznych w regionach CDS we wszystkich pięciu różnych szczepach elf1∆ S, w tym rli1+, SPBPJ4664.02, cue2+ oraz rpl2702+. Zarówno S-A1, jak i S-A2 zawierają zmutowany gen SPBPJ4664.02, choć mutacje występują w różnych aminokwasach. Ponieważ SPBPJ4664.02 jest długim genem (11 916 nukleotydów) z setkami powtórzeń, nie udało się potwierdzić mutacji za pomocą PCR i następującego po nim sekwencjonowania. S-A3 zawiera mutant z delecją w genie rli1, która jest spójna w obu duplikatach biologicznych. Jednak mutant ten nie współsegregował z fenotypem S w tle elf1∆. Zidentyfikowaliśmy mutant cue2 (cue2-1) w S-B1 z brakiem aminokwasów 396-400. S-B2 zawiera mutant rpl2702 (rpl2702-1), w którym aminokwas w pozycji 45 zmienia się z glicyny na asparaginian31. Zarówno cue2-1, jak i rpl2702-1 zostały potwierdzone jako supresory elf1∆, co przedstawiono poniżej.
Genetyczne potwierdzenie zidentyfikowanych mutacji supresorowych weryfikuje dziedziczność fenotypu regeneracji
Dwie zidentyfikowane zmiany niesynonimiczne, cue2-1 oraz rpl2702-1, zostały zrekonstruowane w laboratorium zgodnie ze standardowymi protokołami mutagenezy celowanej. Podwójne szczepy mutantów cue2-1 elf1∆ P oraz rpl2702-1 elf1∆ P skrzyżowano z komplementarnym szczepem elf1∆ P31 (Rysunek 4). Jeśli mutacje niesynonimiczne zidentyfikowane w tym przesiewie były wystarczające do supresji elf1∆ P, to powstałe tetrady wykazywałyby stosunek 2:2 małych do dużych kolonii pochodzących z 4 zarodników w każdej tetradzie. Rzeczywiście, krzyżowanie genetyczne wykazało, że zidentyfikowane mutacje supresorowe skutecznie supresują fenotyp powolnego wzrostu elf1∆ P i są dziedziczne.
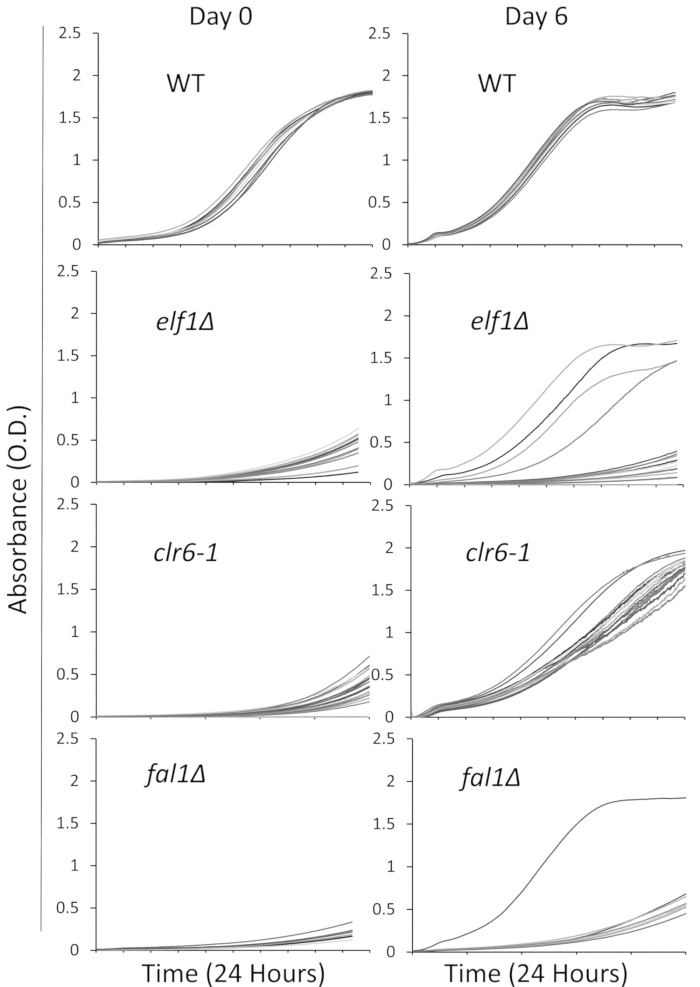
Rysunek 1: Przywrócenie fenotypu można monitorować poprzez rejestrację krzywych wzrostu w czytniku płytek. Szesnaście pojedynczych kolonii typu dzikiego (WT), elf1∆, clr6-1 oraz fal1∆ umieszczono na płytce 96-dołkowej. Krzywe wzrostu rejestrowano w okresie 24 h, a kolonie codziennie rozcieńczano w pożywce bogatej. Defekt wzrostu jest widoczny poprzez niską absorbancję (O.D.) pod koniec 24-godzinnego okresu w dniu 0. Szczepy z przywróconym fenotypem to te, które w dniu 6 wykazują krzywą wzrostu podobną lub zbliżoną do typu dzikiego w okresie 24 h. Cztery kolonie elf1∆, jedna kolonia fal1∆ oraz wszystkie kolonie clr6-1 wykazały różny stopień przywrócenia fenotypu po 6 dniach. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
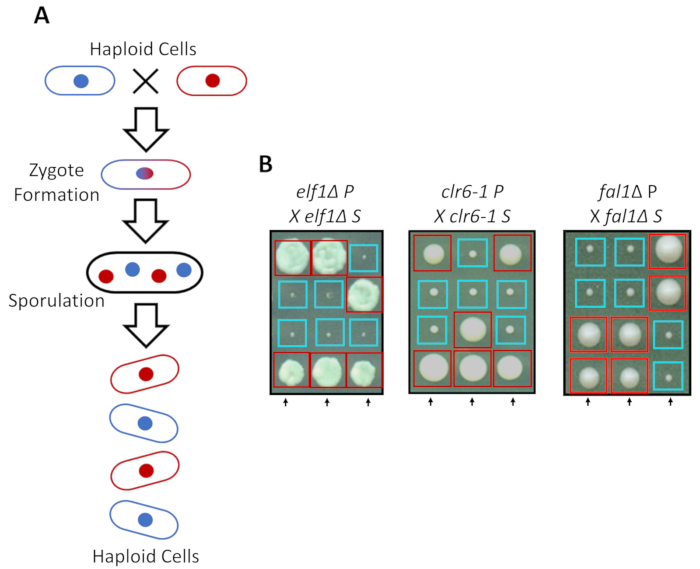
Rycina 2: Krzyżowanie genetyczne może potwierdzić, że powrót fenotypowy jest przypisany do pojedynczego dziedzicznego allelu. (A) Gdy komórki drożdży szczelinowych są poddane głodzeniu azotowemu, dwie komórki haploidalne o komplementarnych typach kojarzenia mogą utworzyć zygotę, która przechodzi sporulację, tworząc tetradę 4 spor. Materiały genetyczne rodzicielskie ulegną segregacji podczas mejozy zgodnie z zasadami genetyki mendlowskiej. (B) Kolonie z powrotem uzyskanym fenotypem (oznaczone jako S, od angielskiego suppressed) o wskazanych genotypach rodzicielskich zostały skrzyżowane wstecznie z komplementarną kolonią rodzicielską (która nie wykazuje powrotu fenotypowego, oznaczona jako P, od angielskiego parental). Krzyżówki genetyczne wykazujące stosunek 2:2 kolonii małych (słaba kondycja) do dużych (odzyskana kondycja) dowodzą, że powrót fenotypowy jest dziedziczny i może być przypisany do pojedynczego elementu genetycznego. Czerwone ramki oznaczają kolonie niosące allel supresora, a niebieskie ramki kolonie niosące allel rodzicielski. Rycina została zmodyfikowana na podstawie pracy Marayati et al., 201831. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
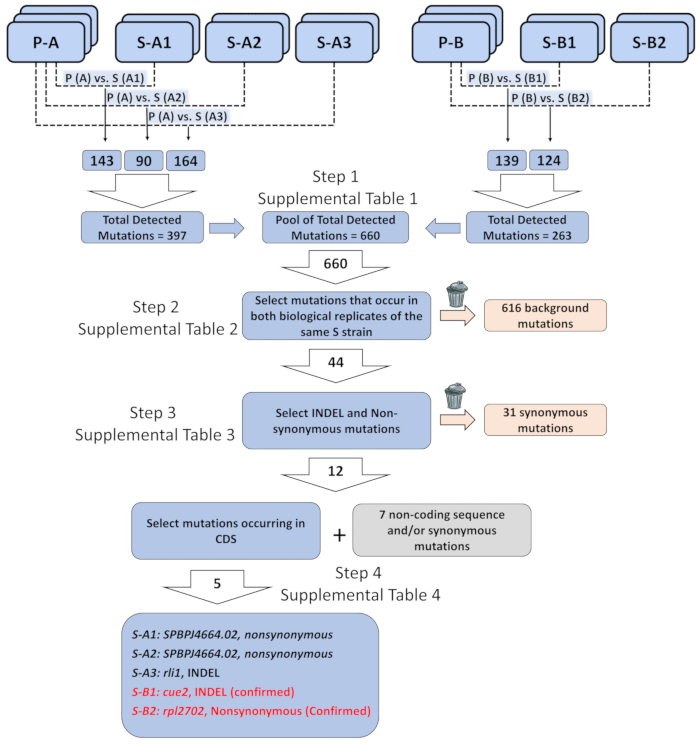
Rysunek 3: Analiza danych z sekwencjonowania całego genomu w celu identyfikacji elementów genetycznych odpowiedzialnych za powrót fenotypowy. Przeprowadzono sekwencjonowanie trzech powtórzeń biologicznych dwóch szczepów rodzicielskich „P” (P-A i P-B) oraz dwóch powtórzeń biologicznych pięciu szczepów przełączonych „S” z powrotem fenotypowym (S-A1, S-A2 i S-A3 pochodzące z P-A; S-B1 i S-B2 z P-B), a następnie zestawiono mutacje w formie listy każdej mutacji w szczepie z powrotem fenotypowym w porównaniu z genomem szczepu rodzicielskiego, z którego pochodził (np. P-A vs. S-A1 itd.). Całkowita liczba wykrytych mutacji w całym genomie we wszystkich takich porównaniach parowych wyniosła 660. Zidentyfikowano łącznie 44 mutacje po wybraniu tylko tych, które wystąpiły w obu powtórzeniach biologicznych tego samego szczepu „S”. Spośród 44 mutacji, 12 stanowiły insercje/delecje (INDEL) lub mutacje niesynonimiczne. Z 12 mutacji INDEL lub niesynonimicznych, pięć wystąpiło w sekwencji kodującej białko. Pięć mutacji potencjalnie koreluje z pojedynczym elementem genetycznym odpowiedzialnym za szczepy z powrotem fenotypowym: mutacja niesynonimiczna w SPBPJ4664.02 znaleziona w S-A1 i S-A2, INDEL w rli1 znaleziona w S-A3, INDEL w cue2 znaleziona w S-B1 oraz mutacje niesynonimiczne w rpl2702 znalezione w S-B2. Szczegółowe informacje o sekwencjach mutacji i przefiltrowanym tle znajdują się w Tabelach uzupełniających 1-4. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
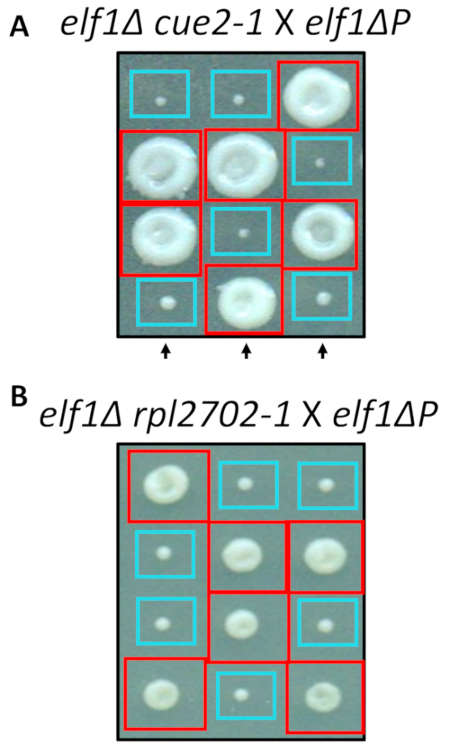
Rycina 4: Potwierdzenie supresorów zidentyfikowanych za pomocą sekwencjonowania całego genomu. Wyniki sekwencjonowania całego genomu potwierdzono poprzez niezależne wywołanie mutacji i przeprowadzenie krzyżówek genetycznych w celu potwierdzenia powrotu fenotypu, krzyżując szczep elf1∆ cue2-1 ze szczepem elf1∆ P oraz szczep elf1∆ rpl2702-1 ze szczepem elf1∆ P. Przedstawiono trzy reprezentatywne tetrady pionowe. Czerwone ramki oznaczają kolonie podwójnych mutantów (elf1 cue2-1 lub elf1 rpl2702-1); niebieskie ramki oznaczają kolonie elf1∆. Rycina została zmodyfikowana na podstawie pracy Marayati et al., 201831. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Tabela uzupełniająca 1. Kliknij tutaj, aby pobrać tę tabelę.
Tabela uzupełniająca 2. Kliknij tutaj, aby pobrać tę tabelę.
Tabela uzupełniająca 3. Kliknij tutaj, aby pobrać tę tabelę.
Tabela uzupełniająca 4. Kliknij tutaj, aby pobrać tę tabelę.
Dodatkowe pliki z kodem. Kliknij tutaj, aby pobrać pliki.
Dyskusja
Opisany tutaj protokół stanowi nowatorskie i proste badanie przesiewowe spontanicznych mutacji supresorowych wykrywalnych poprzez fenotypowe odzyskiwanie mutacji powodujących powolny wzrost drożdży rozszczepialnych, fenotypu charakterystycznego dla ponad 400 genów u S. pombe, z których funkcja wielu pozostaje nieznana 2,32. Poprzednie metody obejmowały inne podejścia do badań przesiewowych w kierunku mutacji supresorowych w mikroorganizmach, w tym wykorzystanie mutagenów21 lub zastosowanie zmiany temperatury w zmutowanych tłach wrażliwych na temperaturę33. W przeciwieństwie do tego, protokół ten pokazuje, że odzysk fenotypowy zachodzi bez dodatkowej ingerencji środowiskowej/chemicznej i podkreśla przewagę dopasowania wynikającą z wzrostu mutacji supresyjnych, które ostatecznie przejmują zasoby dostępne w kulturze płynnej. To badanie przesiewowe umożliwia izolację zarówno supresorów obejściowych, jak i supresorów interakcji, ponieważ jest skuteczne zarówno w przypadku mutacji powodujących utratę funkcji∆ takich jak elf1 lub fal1∆ jak i mutacji punktowych, takich jak clr6-1, o ile mutanty wykazują defekty dopasowania w płynnej hodowli.
Do tej pory wszystkie odzyskane szczepy S, które badaliśmy, wykazywały różne stopnie odzysku fenotypowego. Jak wykryto w wyniku krzyżowania genetycznego, odzyskany fenotyp można przypisać pojedynczemu elementowi genetycznemu i jest dziedziczny (przykłady pokazane na rycinie 2). Jest to jedna z najważniejszych zalet tej metody w porównaniu z ekranami supresorowymi opartymi na chemikaliach lub promieniowaniu UV, które często są ukierunkowane na wiele loci genomowych. Często obserwuje się, że jedna lub dwie kolonie są odzyskiwane z 16 kolonii/szczepu (około 10%) w ciągu tygodnia. Zauważyliśmy jednak, że niektóre mutanty, takie jak utrata funkcji Rrp6, podjednostki egzosomów specyficznej dla jądra, nigdy nie powróciły do prawie dzikiego tempa wzrostu obserwowanego w elf1Δ komórki31. Jest prawdopodobne, że funkcja Rrp6 może być tylko częściowo skompensowana przez supresory, w przeciwieństwie do funkcji innych badanych mutantów, w tym fal1∆, który, jak wykazano, powoduje poważny defekt mejotyczny poprzez swoją ważną funkcję w splicingu regulatorowym34. Uważamy, że alternatywne metody badań przesiewowych supresorów byłyby narażone na ten sam problem, gdy yfg ma unikalne, niezastępowalne role we wzroście komórek.
Przed wykonaniem sekwencjonowania genomu optymalne jest krzyżowanie wsteczne fenotypowo odzyskanych kolonii, zidentyfikowanych na podstawie czytnika płytek, ze szczepami rodzicielskimi w celu oczyszczenia tła genetycznego i uzyskania replik biologicznych. Ponadto głębokie sekwencjonowanie całego genomu identyfikuje setki zmian pojedynczych nukleotydów, z których większość nie jest identyczna między powtórzeniami biologicznymi, które są mało interesujące dla badań przesiewowych. Na przykład znaleźliśmy w sumie 660 zmian genomowych we wszystkich trzech chromosomach między dwoma elf1Δ P i pięcioma różnymi szczepami S (Figura 3). Nie zaobserwowaliśmy często identycznych mutacji między zsekwencjonowanymi replikami biologicznymi każdego szczepu, co sugeruje, że albo nowe mutacje mogą powstać podczas hodowli elf1Δ komórek przed budową biblioteki genomowej, albo mogą zostać wprowadzone losowe błędy podczas budowy biblioteki i sekwencjonowania. W związku z tym izolowanie mutacji, które są spójne we wszystkich replikach biologicznych, jest ważnym aspektem skutecznej identyfikacji supresorów za pomocą sekwencjonowania całego genomu.
Zidentyfikowaliśmy i potwierdziliśmy dwa supresory w regionach CDS w pięciu sekwencjonowanych szczepach S. Chociaż mutacje w SPBPJ4664.02 wykryto zarówno w szczepach S-A1, jak i S-A2, jest mało prawdopodobne, że SPBPJ4664.02 jest ważnym supresorem, ponieważ S-A1 i S-A2 nie zawierają supresora na tym samym genie, ponieważ nie są ze sobą komplementarne (dane nie pokazane). Nie potwierdziliśmy również rli1 w S-A3, który nie uległ kosegregacji z fenotypem S po krzyżowaniu wstecznym z elf1Δ. Alternatywnie, znaleźliśmy specyficzne mutacje w regionach niekodujących w S-A1, S-A2 i S-A3. Możliwe, że te zmienione niekodujące regiony genomowe łagodzą fenotyp elf1Δ , który zostanie uwzględniony w naszych przyszłych badaniach. W porównaniu z tradycyjnymi metodami, takimi jak test sprzężeń, który może zająć lata, aby zmapować mutację genetyczną, zidentyfikowaliśmy dwa supresory w ciągu dwóch miesięcy po potwierdzeniu, że element monogenowy spowodował fenotyp S. Biorąc pod uwagę szybki rozwój technologii sekwencjonowania całego genomu, jesteśmy optymistami, że metoda ta będzie bardziej skuteczna w identyfikacji spójnych mutacji genetycznych w dającej się przewidzieć przyszłości.
Podsumowując, protokół ten zawiera wskazówki krok po kroku, jak skutecznie zidentyfikować mutacje supresorowe dla dowolnego genu będącego przedmiotem zainteresowania z wolno rosnącym defektem w płynnej kulturze. Prostota tego testu pozwala na badania przesiewowe na dużą skalę wielu interesujących środowisk genetycznych przy niewielkim przeszkoleniu praktycznym. Istnieje możliwość dalszej automatyzacji procesu poprzez wykorzystanie robota do obsługi cieczy do wykonywania codziennych rozcieńczeń. Ponieważ laboratoryjna manipulacja mikroorganizmami nieuchronnie wymaga wzrostu w płynnej kulturze, procesu, który jest z natury selektywny pod względem przydatności, proponujemy, aby protokół ten mógł być szeroko stosowany do innych organizmów modelowych o dużej populacji, takich jak bakterie i inne gatunki drożdży.
Oświadczenia
Autorzy deklarują brak poparcia ze strony producentów instrumentów stosowanych w tej metodzie, ani też brak konkurencyjnych interesów finansowych.
Podziękowania
Ta praca była wspierana przez National Institute of General Medical Sciences, przyznaje K.Z. 1R15GM119105-01. Dziękujemy wszystkim recenzentom za wnikliwe komentarze. Dziękujemy również Jamesowi Tuckerowi, Alicii Anderson, Elizabeth Black i Glenowi Marrsowi za dyskusję i komentarze na temat tego manuskryptu.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Adenina, Proszek | Acros Organics | 147441000 | Stosować w dawce 75 mg/L do wytwarzania płynnych i stałych pożywek bogatych (YEA) |
| Bakteriologia Petri | Dish Corning, Falcon | C351029 | 100 i razy; 15 mm, służy do hodowli szczepów do pojedynczych kolonii na stałych pożywkach bogatych D-glukoza |
| bezwodna, proszek | Fisher Chemical | D16-1 | Stosować w ilości 30 g/l do wytwarzania płynnych i stałych pożywek bogatych (YEA) |
| Difco Agar, Granuated | Becton, Dickinson and Co. | 214530 | Stosować w stężeniu 20 g/L do wytwarzania stałego buforu |
| do ekstrakcji DNA | 2% Triton X-100, 1% SDS, 100 mM NaCl, 10 mM Tris-Cl (pH 8,0), 1mM Na2-EDTA | ||
| Skoncentrowany ultrasonograf | Covaris Inc. | S220 | Alternatywnie, użyj QSonica Q800R sonicator/system ścinania DNA i chromatyny |
| Gen5 Oprogramowanie do zbierania i analizy danych | Biotek, Inc. | GEN5SECURE | Lub równoważny, musi być kompatybilny z czytnikiem mikropłytek, służy do eksportowania odczytów danych z czytnika mikropłytek |
| Kwas solny 1N, płyn | Fisher Chemical | SA48-4 | Służy do regulacji pH do 5,5 w płynnych i stałych podłożach bogatych |
| Płynne podłoża bogate (płynny YEA) | 30 g/L D-glukoza, 5 g/L ekstrakt drożdżowy, 75 mg/L Adenina, pH dostosowane do 5,5 za pomocą czytnika mikropłytek HCl 1 M | ||
| , hybrydowego czytnika wielomodowego Synergy H1 | Biotek, Inc. | BTH1MG | Lub równoważny, musi odczytywać światło widzialne w zakresie długości fal 600 nm |
| Płytki agarowe Rich Media (płytki YEA) | 30 g / L D-glukoza, 5 g / L ekstrakt drożdżowy, 75 mg / L adenina, 20 g / L agar, pH dostosowane do 5,5 z 1 M HCl. | ||
| Mieszanka RNazy A/T1 | Thermo Fisher Scientific | EN0551 | Stosować zgodnie z zaleceniami producenta |
| Sterylna pętla do zaszczepiania polistyrenu | Corning, Inc. | OS101 | Lub odpowiednik, służy do przenoszenia kolonii z płytek agarowych na płytkę 96-dołkową |
| Sterylna przestrzeń robocza i palniki | |||
| Płytka do hodowli tkankowych, 96-dołkowa optyczna płaska denna z pokrywką o niskiej parowaniu | Rdzeniowanie, Falcon | C353072 | Lub odpowiednik, musi mieć optyczny płaski dno do przygotowania mikropłytki |
| Zestaw do przygotowania biblioteki TruSeq DNA PCR-Free LT / HT | Illumina, Inc. | 20015962 | Służy do przygotowania biblioteki sekwencjonowania całego genomu |
| Ekstrakt drożdżowy, proszek | Fisher Chemical | BP1422-500 | Stosować w stężeniu 5 g/l do wytwarzania płynnych i stałych pożywek bogatych (YEA) |
Bibliografia
- McKay, J. K., Latta, R. G. Adaptive population divergence: Markers, QTL and traits. Trends in Ecology and Evolution. 17 (6), 285-291 (2002).
- Wood, V., Harris, M. A., et al. PomBase: A comprehensive online resource for fission yeast. Nucleic Acids Research. 40 (D1), (2012).
- de Visser, J. A. G. M., Cooper, T. F., Elena, S. F. The causes of epistasis. Proceedings of the Royal Society B: Biological Sciences. 278 (1725), 3617-3624 (2011).
- Sailer, Z. R., Harms, M. J. Detecting high-order epistasis in nonlinear genotype-phenotype maps. Genetics. 205 (3), 107911088(2017).
- Kuzmin, E., Costanzo, M., Andrews, B., Boone, C. Synthetic genetic arrays: Automation of yeast genetics. Cold Spring Harbor Protocols. 2016 (4), 326-332 (2016).
- Tong, A. H. Y., Boone, C. Synthetic genetic array analysis in Saccharomyces cerevisiae. Methods in Molecular Biology. 313 (1), 171-192 (2006).
- Dixon, S. J., Costanzo, M., Baryshnikova, A., Andrews, B., Boone, C. Systematic Mapping of Genetic Interaction Networks. Annual Review of Genetics. 43 (1), 601-625 (2009).
- Boone, C., Bussey, H., Andrews, B. J. Exploring genetic interactions and networks with yeast. Nature Reviews Genetics. 8 (6), 437-449 (2007).
- Bai, X., Yang, Z., Jiang, H., Lin, S., Zon, L. I. Genetic suppressor screens in haploids. Methods in Cell Biology. , 129-136 (2011).
- Manson, M. D. Allele-specific suppression as a tool to study protein-protein interactions in bacteria. Methods. 20 (1), 18-34 (2000).
- Motter, A. E., Gulbahce, N., Almaas, E., Barabási, A. L. Predicting synthetic rescues in metabolic networks. Molecular Systems Biology. 4, 168(2008).
- Peterson, R. T., Shaw, S. Y., et al. Chemical suppression of a genetic mutation in a zebrafish model of aortic coarctation. Nature Biotechnology. 22 (5), 595-599 (2004).
- Giorgini, F., Guidetti, P., Nguyen, Q., Bennett, S. C., Muchowski, P. J. A genomic screen in yeast implicates kynurenine 3-monooxygenase as a therapeutic target for Huntington disease. Nature Genetics. 37 (5), 526-531 (2005).
- Forsburg, S. L., Patton, E., et al. The art and design of genetic screens. Nature reviews. Genetics. 2 (9), 659-668 (2001).
- Johnston, D. S. The art and design of genetic screens. Genetics. 3 (March), 176-188 (2002).
- Jorgensen, E. M., Mango, S. E. The art and design of genetic screens: Caenorhabditis elegans. Nature Reviews Genetics. 3 (5), 356-369 (2002).
- Gocke, E., Müller, L. In vivo studies in the mouse to define a threshold for the genotoxicity of EMS and ENU. Mutation Research - Genetic Toxicology and Environmental Mutagenesis. 678 (2), 101-107 (2009).
- Suzuki, T., Hayashi, M., et al. A comparison of the genotoxicity of ethylnitrosourea and ethyl methanesulfonate in lacZ transgenic mice (Muta(TM)Mouse). Mutation Research - Genetic Toxicology and Environmental Mutagenesis. 395 (1), 75-82 (1997).
- Uttam, J., Alberico, C., De Stasio, E. ENU Mutagenesis. International C. elegans Meeting. , (1995).
- Putrament, A., Baranowska, H., Ejchart, A., Prazmo, W. Manganese Mutagenesis in Yeast. Methods in Cell Biology. 20, 25-34 (1978).
- Bose, J. L. Chemical and UV mutagenesis. Methods in Molecular Biology. 1373, 111-115 (2016).
- Ikehata, H., Ono, T. The Mechanisms of UV Mutagenesis. Journal of Radiation Research. 52 (2), 115-125 (2011).
- Shrivastav, N., Li, D., Essigmann, J. M. Chemical biology of mutagenesis and DNA repair: cellular responses to DNA alkylation. Carcinogenesis. 31 (1), 59-70 (2010).
- De Stasio, E. A., Dorman, S. Optimization of ENU mutagenesis of Caenorhabditis elegans. Mutation Research - Genetic Toxicology and Environmental Mutagenesis. 495 (1-2), 81-88 (2001).
- Probst, F. J., Justice, M. J. Mouse mutagenesis with the chemical supermutagen ENU. Methods in Enzymology. 477 (C), 297-312 (2010).
- Bähler, J., Wu, J. Q., et al. Heterologous modules for efficient and versatile PCR-based gene targeting in Schizosaccharomyces pombe. Yeast. 14 (10), 943-951 (1998).
- Li, H., Durbin, R. Fast and accurate short read alignment with Burrows – Wheeler transform. Bioinformatics. 25 (14), 1754-1760 (2009).
- Van der Auwera, G. A., Carneiro, M. O., et al. From fastQ data to high-confidence variant calls: The genome analysis toolkit best practices pipeline. Current Protocols in Bioinformatics. 43, 11.10.1-11.10.33 (2013).
- Mckenna, A., Hanna, M., et al. The Genome Analysis Toolkit: A MapReduce framework for analyzing next-generation DNA sequencing data. Genome Research. 20, 1297-1303 (2010).
- Li, H., Handsaker, B., et al. The Sequence Alignment/Map format and SAMtools. Bioinformatics. 25 (16), 2078-2079 (2009).
- Marayati, B. F., Drayton, A. L., et al. Loss of Elongation-Like Factor 1 Spontaneously Induces Diverse, RNase H-Related Suppressor Mutations in Schizosaccharomyces pombe. Genetics. 209 (4), 967-981 (2018).
- Harris, M. A., Lock, A., Bähler, J., Oliver, S. G., Wood, V. FYPO: The fission yeast phenotype ontology. Bioinformatics. 29 (13), 1671-1678 (2013).
- Xu, X., Wang, L., Yanagida, M. Whole-Genome Sequencing of Suppressor DNA Mixtures Identifies Pathways That Compensate for Chromosome Segregation Defects in Schizosaccharomyces pombe. G3: Genes|Genomes|Genetics. 8 (3), 1031-1038 (2018).
- Marayati, B. F., Hoskins, V., et al. The fission yeast MTREC and EJC orthologs ensure the maturation of meiotic transcripts during meiosis. RNA. 22 (9), 1349-1359 (2016).
Przedruki i uprawnienia
