Sekwencjonowanie nanoporowe to nowatorska technologia, która pozwala na efektywne kosztowo sekwencjonowanie w odległych lokalizacjach i miejscach o ograniczonych zasobach. W tym miejscu przedstawiamy protokół sekwencjonowania mRNA z krwi pełnej, który jest zgodny z takimi warunkami.
Artykuł metodologiczny
Sekwencjonowanie mRNA z krwi pełnej za pomocą sekwencjonowania nanoporowego
W tym artykule
Podsumowanie
Streszczenie
Sekwencjonowanie w odległych lokalizacjach i miejscach o ograniczonych zasobach stanowi wyjątkowe wyzwanie. Sekwencjonowanie nanoporowe może być z powodzeniem stosowane w takich warunkach i zostało wdrożone w Afryce Zachodniej podczas niedawnej epidemii wirusa Ebola, co podkreśla tę możliwość. Oprócz zalet praktycznych (niski koszt, łatwość transportu i użytkowania sprzętu), technologia ta zapewnia również fundamentalne zalety w porównaniu z podejściami do sekwencjonowania drugiej generacji, w szczególności bardzo długą długość odczytu, możliwość bezpośredniego sekwencjonowania RNA i dostępność danych w czasie rzeczywistym. Dokładność odczytu surowego jest niższa niż w przypadku innych platform sekwencjonowania, co stanowi główne ograniczenie tej technologii; Można to jednak częściowo złagodzić dzięki generowanej dużej głębokości odczytu. W tym miejscu przedstawiamy kompatybilny z polem protokół sekwencjonowania mRNA kodujących Niemann-Pick C1, który jest receptorem komórkowym dla wirusów Ebola. Protokół ten obejmuje ekstrakcję RNA z próbek krwi zwierzęcej, a następnie RT-PCR w celu wzbogacenia celu, kodowania kreskowego, przygotowania biblioteki i samego sekwencjonowania, i może być łatwo dostosowany do użycia z innymi celami DNA lub RNA.
Wprowadzenie
Sekwencjonowanie jest potężnym i ważnym narzędziem w badaniach biologicznych i biomedycznych. Umożliwia analizę genomów, wariacji genetycznych i profili ekspresji RNA, a tym samym odgrywa ważną rolę w badaniu chorób zarówno ludzi, jak i zwierząt1,2. Sekwencjonowanie Sangera, jedna z najstarszych dostępnych metod sekwencjonowania DNA, jest nadal rutynowo stosowana do dziś i stanowi kamień węgielny biologii molekularnej. W ciągu ostatnich 50 lat technologia ta została ulepszona, aby osiągnąć długość odczytu ponad 1000 nt i dokładność tak wysoką jak 99,999%1. Jednak sekwencjonowanie Sangera ma również ograniczenia. Sekwencjonowanie większego zestawu próbek lub analiza całych genomów za pomocą tej metody jest czasochłonne i kosztowne1,3. Metody sekwencjonowania DNA drugiej generacji (nowej generacji), takie jak pirosekwencjonowanie 454 i technologia Illumina, pozwoliły nam znacznie obniżyć koszty i nakład pracy wymagany do sekwencjonowania w ciągu ostatniej dekady i doprowadziły do ogromnego wzrostu ilości dostępnych informacji o sekwencjach biologicznych4. Niemniej jednak indywidualne sekwencjonowanie przy użyciu tych technologii drugiej generacji jest drogie, a sekwencjonowanie w warunkach terenowych jest trudne, ponieważ niezbędny sprzęt jest nieporęczny i delikatny (podobnie jak urządzenia do sekwencjonowania Sangera) i często musi być kalibrowany i serwisowany przez specjalnie przeszkolony personel. Ponadto w przypadku wielu technologii drugiej generacji długość odczytu jest raczej ograniczona, co często sprawia, że dalsza analiza bioinformatyczna tych danych jest wyzwaniem.
Sekwencjonowanie trzeciej generacji za pomocą kieszonkowych urządzeń do sekwencjonowania nanoporowego (zobacz Tabelę materiałów) może służyć jako alternatywa dla tych uznanych platform sekwencjonowania. W tych urządzeniach jednoniciowa cząsteczka DNA lub RNA przechodzi przez nanopory jednocześnie z prądem jonowym, który jest następnie mierzony przez czujnik (Rysunek 1). Gdy nić przechodzi przez nanopory, wykrywana jest modulacja prądu przez nukleotydy obecne w porze w danym momencie i obliczeniowo przekształcana wstecznie w sekwencję nukleotydów5. Ze względu na tę zasadę działania, sekwencjonowanie nanoporowe umożliwia zarówno generowanie bardzo długich odczytów (blisko 1 x 10⁶ nukleotydów6), jak i analizę danych sekwencjonowania w czasie rzeczywistym. Kodowanie kreskowe jest możliwe poprzez dołączenie zdefiniowanych sekwencji nukleotydów do kwasów nukleinowych w próbce, co umożliwia analizę wielu próbek w jednym cyklu sekwencjonowania, zwiększając w ten sposób przepustowość próbki i obniżając koszty na próbkę. Ze względu na ich wysoką przenośność i łatwość użycia, urządzenia do sekwencjonowania nanoporowego były z powodzeniem stosowane w terenie podczas niedawnej epidemii wirusa Ebola w Afryce Zachodniej, co podkreśla ich przydatność do szybkiego wdrożenia w odległych regionach7,8.
Tutaj opisujemy szczegółowy, kompatybilny z polem protokół sekwencjonowania kodowania mRNA dla białka Niemann-Pick C1 (NPC1), które jest obowiązkowym receptorem wejściowym dla filowirusów, takich jak wirusy ebola, i wykazano, że ogranicza podatność gatunków na te wirusy9,10. Protokół obejmuje ekstrakcję całego RNA z próbek krwi, swoistą amplifikację mRNA NPC1 za pomocą RT-PCR, kodowanie kreskowe próbek, przygotowanie biblioteki i sekwencjonowanie za pomocą urządzenia do sekwencjonowania nanoporowego. Analiza danych nie może być omawiana ze względu na ograniczenia przestrzenne, chociaż w reprezentatywnych wynikach podano kilka podstawowych wskazówek; Zainteresowanego czytelnika odsyłamy jednak do poprzedniej publikacji11 w celu uzyskania bardziej szczegółowego opisu zastosowanego przez nas przepływu pracy, a także do publikacji innych12,13,14 w celu uzyskania szczegółowych informacji na temat narzędzi analitycznych używanych w tym procesie pracy.
Protokół
Próbki zostały pobrane zgodnie z nr. protokołu Njala University Institutional Review Board (NUIRB). IRB00008861/FWA00018924.
1. Ekstrakcja RNA z próbek krwi
- Zebrać 3 ml krwi pełnej od gatunku, który ma być analizowany, do probówki do pobierania krwi wypełnionej 6 ml odczynnika stabilizującego DNA/RNA (patrz Tabela materiałów) i wymieszać przez odwrócenie 5 razy. Próbkę krwi należy przechowywać przez okres do jednego miesiąca w temperaturze 4 °C.
- Przenieść zawartość probówki do probówki do probówki o pojemności 50 ml, dodać 120 μl proteinazy K i mieszać przez wirowanie przez 5 s. Inkubować próbkę przez 30 minut w temperaturze pokojowej.
- Dodaj 9 ml izopropanolu do mieszaniny i wiruj przez 5 s.
- Umieść zbiornik na wirowej kolumnie oczyszczającej RNA (patrz Tabela materiałów) i umieść zespół na kolektorze próżniowym (patrz Tabela materiałów). Dodać mieszaninę próbek do zbiornika. Zastosuj próżnię, aż cała ciecz przejdzie przez kolumnę.
- Alternatywnie, jeśli nie jest dostępny kolektor próżniowy, krew może być przepuszczona przez kolumnę w porcjach o objętości 700 μl przez wielokrotne wirowanie przez 30 s przy 12 000 x g, przy czym przepływ jest odrzucany między etapami wirowania. Będzie to jednak wymagało około 26 etapów wirowania.
- Umieścić kolumnę wirową do oczyszczania RNA w probówce zbiorczej i dodać 400 μl buforu przygotowawczego DNA/RNA (patrz Tabela materiałów). Wirować przy 12 000 x g przez 30 s i odrzucić przepływ.
- Dodać 400 μl buforu do przemywania DNA/RNA (patrz tabela materiałów) do kolumny, odwirować przy 12 000 x g przez 30 s i odrzucić przepływ.
- Zmieszać 5 μl DNazy I (1 U/μL) (patrz Tabela Materiałów) z 75 μL buforu do wytrawiania DNA (patrz Tabela Materiałów) i dodać mieszaninę do kolumny. Inkubować przez 15 minut w temperaturze pokojowej.
- Dodać 400 μl buforu przygotowawczego DNA/RNA do kolumny i odwirować przy 12 000 x g przez 30 s. Wyrzucić przepływ.
- Przemyć kolumnę 700 μl buforu płuczącego DNA/RNA i odwirować przy 12 000 x g przez 30 s. Odrzucić przepływ.
- Powtórzyć krok 1.9 z 400 μl buforu do płukania DNA/RNA i odwirować przy 12 000 x g przez 2 minuty w celu usunięcia wszystkich pozostałości buforu do przemywania i wysuszenia kolumny. Podczas wyjmowania kolumny z probówki zbiorczej należy uważać, aby nie zwilżyć spodu kolumny buforem w probówce zbiorczej.
- Umieść kolumnę w nowej probówce do mikrowirówek o pojemności 1,5 ml i dodaj 70 μl wody wolnej od nukleaz. Inkubować przez 1 minutę w temperaturze pokojowej i wirować przez 30 s przy 12 000 x g. Przechowywać RNA w temperaturze -80 °C do czasu dalszego użycia (lub zużyć natychmiast).
- OPCJONALNIE: W celu ilościowego określenia RNA należy pobrać podwielokrotność i oznaczyć stężenie za pomocą spektrofotometru UV (patrz Tabela materiałów).
2. Odwrotna transkrypcja mRNA NPC1 do cDNA
- Do probówki reakcyjnej o pojemności 0,2 ml dodać 8 μl matrycy RNA (1 pg do 2,5 μg RNA) i po 1 μl 10-krotnego buforu DNazy i enzymu DNazy (patrz tabela materiałów). Inkubować w temperaturze 37 °C przez 2 minuty. Następnie krótko odwirować reakcję i umieścić ją na lodzie.
- Dodać 4 μl głównej mieszaniny odwrotnej transkryptazy (patrz tabela materiałów) i 6 μl wody wolnej od nukleaz do probówki reakcyjnej i delikatnie wymieszać. Inkubować reakcję w termocyklerze przez 10 minut w temperaturze 25 °C (w przypadku wyżarzania startera), a następnie przez 10 minut w temperaturze 50 °C (w celu odwrotnej transkrypcji RNA). W celu inaktywacji enzymu inkubować przez 5 minut w temperaturze 85 °C.
- Przenieść cDNA do nowej probówki mikrowirówkowej o pojemności 1,5 ml i przechowywać w temperaturze -80 °C do dalszego użycia (lub użyć natychmiast).
3. Wzmocnienie otwartej ramki odczytu NPC1
- Początkowy etap wzmocnienia
- Skonfiguruj PCR15,16, aby amplifikować cDNA NPC1 za pomocą zestawu starterów 1 (patrz Tabela 1), używając polimerazy DNA o wysokiej wierności na gorąco (patrz tabela materiałów) z odpowiednim buforem reakcyjnym w objętości reakcyjnej 50 μl z 1 μl matrycy. Jeśli to możliwe, przeprowadzić reakcję na lodzie lub w chłodnym bloku o temperaturze 4 °C.
- Inkubować reakcję w termocyklerze z początkowym etapem denaturacji wynoszącym 30 s w temperaturze 98 °C, następnie 10 cyklami z denaturacją w temperaturze 98 °C przez 10 s, wyżarzaniem startera przez 20 s w temperaturze 65 °C, obniżając temperaturę o 0,5 °C na cykl i wydłużaniem przez 1 minutę w temperaturze 72 °C. Następnie uruchom dodatkowe 20 cykli po 10 s w temperaturze 98 °C, 20 s w 60 °C i 1 minutę w temperaturze 72 °C, a następnie końcowy etap wydłużania trwający 5 minut w temperaturze 72 °C.
- Oczyszczanie PCR za pomocą kulek magnetycznych
- Przenieść 50 μl produktu PCR do 1,5 ml probówki reakcyjnej o niskim poziomie wiązania DNA (patrz tabela materiałów). Dokładnie zawiesić kulki magnetyczne (patrz Tabela materiałów) przez wirowanie i dodać 50 μl kulek do reakcji PCR. Dobrze wymieszaj. Inkubować próbkę w mieszalniku obrotowym (patrz tabela materiałów) przez 5 minut w temperaturze pokojowej (przy 15 obr./min).
- Na krótko odwiruj próbkę i umieść probówkę do mikrowirówki o pojemności 1,5 ml na stojaku magnetycznym (patrz Tabela materiałów), aby otulić kulki magnetyczne. Poczekaj, aż supernatant zostanie całkowicie oczyszczony, zanim przejdziesz do następnego kroku.
- Odessać supernatant bez naruszania granulki perełki i wyrzucić.
- Odpipetować 200 μl 70% etanolu do probówki reakcyjnej i inkubować przez 30 s. Odessać etanol bez naruszania osadu i wyrzucić. Powtórz w sumie dwa prania. Upewnij się, że nie pozostał etanol. Może być konieczne najpierw zassanie większą pipetą (np. 1000 μl), a następnie usunięcie pozostałych kropelek etanolu mniejszą pipetą (np. 10 μl).
- Suszyć granulat na powietrzu przez 1 minutę w temperaturze pokojowej.
- Wyjmij probówkę reakcyjną ze stojaka magnetycznego, ponownie zawieś osad w 30 μl wody wolnej od nukleaz i inkubuj przez 2 minuty w temperaturze pokojowej.
- Umieść probówkę reakcyjną z powrotem na stojaku magnetycznym i poczekaj, aż kulki zostaną całkowicie granulowane.
- Usunąć supernatant bez naruszania osadu i przenieść go do nowej probówki reakcyjnej o pojemności 1,5 ml.
- Dodawanie adapterów kodów kreskowych przez zagnieżdżony PCR
- Skonfiguruj 50 μl PCR przyziemienia z polimerazą DNA High-Fidelity na gorąco z 5-krotnym buforem reakcyjnym i zestawem starterów 2 (patrz Tabela 1). Startery w tym zestawie składają się z regionu specyficznego dla sekwencji docelowej, który umożliwia wiązanie produktów PCR wygenerowanych w kroku 3.2 (wewnątrz sekwencji zestawu starterów 1), a także sekwencji adaptera, która jest używana jako cel w późniejszej reakcji PCR z kodowaniem kreskowym (por. sekcja 4). Jeśli to możliwe, przeprowadzić reakcję na lodzie lub w chłodnym bloku o temperaturze 4 °C. Jako matrycę należy użyć 1 μl oczyszczonego produktu PCR przygotowanego w sekcji 3.2.
- Inkubować mieszaninę reakcyjną w termocyklerze, stosując początkowy etap denaturacji trwający 30 s w temperaturze 98 °C, a następnie 10 cykli z denaturacją w temperaturze 98 °C przez 10 s, wyżarzanie startera przez 20 s w temperaturze 65 °C, obniżając temperaturę o 0,5 °C na cykl i wydłużenie przez 1 minutę w temperaturze 72 °C. Następnie inkubować reakcję przez kolejne 30 cykli przez 10 s w temperaturze 98 °C, 20 s w temperaturze 71 °C i 1 minutę w temperaturze 72 °C, po czym następuje końcowy etap wydłużania trwający 5 minut w temperaturze 72 °C.
- Oczyścić produkt PCR za pomocą kulek magnetycznych, jak opisano w sekcji 3.2.
4. Kody kreskowe amplikonów NPC1
- Dla każdego produktu PCR wytworzonego w sekcji 3 należy przeprowadzić reakcję PCR z kodowaniem kreskowym w probówce reakcyjnej o pojemności 0,2 ml przy użyciu 50 μl polimerazy DNA Taq 2x mieszaniny wzorcowej (patrz tabela materiałów), 2 μl jednego ze starterów kodów kreskowych z zestawu do kodowania kreskowego PCR (patrz tabela materiałów i tabela 2), i 1 μl oczyszczonego produktu PCR z kroku 3.3.2 jako matrycy. Dodać 47 μl wody wolnej od nukleaz, aby uzyskać końcową objętość 100 μl.
- Inkubować reakcję w termocyklerze w temperaturze 95 °C przez 3 minuty jako początkową denaturację. Następnie uruchom 15 cykli przez 15 s w temperaturze 95 °C, 15 s w temperaturze 62 °C i 1,5 minuty w temperaturze 65 °C. Jako końcowe wydłużenie inkubować reakcję w temperaturze 65 °C przez 5 minut.
- Oczyścić produkt PCR zgodnie z opisem w ppkt 3.2, ale użyć 100 μl kulek magnetycznych i eluować w 30 μl wody wolnej od nukleaz.
- Jeśli to możliwe, należy określić ilościowo próbkę za pomocą spektrofotometru UV.
5. Przygotowanie biblioteki
- Połączyć równą ilość DNA oznaczonego kodem kreskowym z każdej próbki, aby uzyskać łącznie 1 μg DNA w objętości 45 μl (w razie potrzeby dodać wodę wolną od nukleaz) w probówce reakcyjnej o pojemności 0,2 ml. Jeżeli spektrofotometr UV nie jest dostępny, należy użyć równych objętości każdej próbki. W przypadku dA-tailingu dodać 7 μl buforu reakcyjnego End-prep (patrz Tabela materiałów), 3 μL mieszanki enzymów End-prep (patrz Tabela materiałów) i 5 μl wody wolnej od nukleaz. Delikatnie wymieszaj, przesuwając tubkę.
- Inkubować reakcję przez 5 minut w temperaturze 20 °C, a następnie 5 minut w temperaturze 65 °C w termocyklerze.
- Oczyścić produkt reakcji zgodnie z opisem w sekcji 3.2, ale użyć 60 μl kulek magnetycznych i wymyć w 25 μl wody wolnej od nukleaz.
- FAKULTATYWNIE: Pobrać 1 μl, aby określić ilościowo stężenie próbki za pomocą spektrofotometru UV. Całkowita ilość powinna przekraczać 700 ng.
- Połącz 22,5 μl oczyszczonego DNA z kroku 5.3 z 2,5 μl adaptera 1D2 (patrz Tabela materiałów) i 25 μl głównej mieszanki ligazy / TA (patrz Tabela materiałów) w nowej probówce reakcyjnej o pojemności 1,5 ml o niskim poziomie wiązania DNA, delikatnie wymieszaj przez trzepanie i krótko odwiruj. Inkubować przez 10 minut w temperaturze pokojowej.
- Oczyścić produkt reakcji zgodnie z opisem w sekcji 3.2, ale użyć 20 μl kulek magnetycznych, wydłużyć czas inkubacji do wiązania DNA do 10 minut, wykonać dwa etapy przemywania po 1 ml etanolu każdy i wymyć w 46 μl wody wolnej od nukleaz.
- Połączyć 45 μl produktu reakcji z kroku 5.6 z 5 μl mieszanki adaptera kodów kreskowych (patrz tabela materiałów) i 50 μl mieszaniny głównej ligazy / TA w probówce reakcyjnej o niskim poziomie wiązania DNA. Delikatnie wymieszać i inkubować przez 10 minut w temperaturze pokojowej.
- Oczyścić produkt reakcji zgodnie z opisem w sekcji 3.2, ale użyć 40 μl kulek magnetycznych, wykonać dwa etapy płukania 140 μl buforu ABB (patrz tabela materiałów) zamiast etanolu, ponownie zawiesić kulki przez strzepnięcie i osadzać na stojaku magnetycznym. Eluować w 15 μl buforu elucyjnego (patrz tabela materiałów). Wydłużyć czas inkubacji dla początkowego wiązania DNA z kulkami, jak również dla etapu elucji do 10 minut. Otrzymany produkt należy przechowywać na lodzie lub w temperaturze 4 °C do czasu użycia.
6. Kontrola jakości komory przepływowej
- Przed użyciem należy przeprowadzić kontrolę jakości komory przepływowej. W tym celu podłącz urządzenie sekwencjonujące do komputera hosta i otwórz oprogramowanie.
- Włóż komórkę przepływową (patrz Tabela materiałów) do urządzenia sekwencjonującego i wybierz typ komory przepływowej z pola wyboru i potwierdź, klikając Dostępne.
- Kliknij opcję Sprawdź komórkę przepływu u dołu ekranu i wybierz odpowiedni typ komórki przepływu.
- Kliknij przycisk Rozpocznij test, aby rozpocząć sprawdzanie jakości. Aby komora przepływowa nadawała się do użytku, potrzeba łącznie co najmniej 800 aktywnych nanoporów.
7. Wczytywanie komórki przepływu i rozpoczynanie sekwencjonowania
- Otwórz pokrywę portu zasysającego, przesuwając ją w kierunku zgodnym z ruchem wskazówek zegara. Ustaw pipetę P1000 na 200 μl i włóż końcówkę do portu zasysania. Ustaw pipetę na 230 μl, trzymając końcówkę w porcie zasysającym, aby pobrać bufor 20-30 μl i usunąć wszelkie pęcherzyki powietrza.
- W nowej probówce reakcyjnej o pojemności 1,5 ml o niskim poziomie wiązania DNA przygotuj mieszankę gruntującą, łącząc 576 μl buforu RBF (patrz tabela materiałów) z 624 μl wody wolnej od nukleaz.
- Ostrożnie odpipetować 800 μl przygotowanej mieszanki gruntującej do portu zasysającego i odczekać 5 minut. Podnieść pokrywę portu próbki i odpipetować dodatkowe 200 μl przygotowanej mieszanki gruntującej do portu zasysającego.
- Odpipetować 35 μl buforu RBF do nowej, czystej probówki reakcyjnej o niskim poziomie wiązania DNA o pojemności 1,5 ml. Dokładnie wymieszać kulki LLB (patrz Tabela Materiałów) przez pipetowanie i dodać 25,5 μl kulek do bufora RBF. Dodać 2,5 μl wody wolnej od nukleaz i 12 μl biblioteki DNA z kroku 5.8 i wymieszać pipetując.
- Powoli dodawać 75 μl mieszaniny próbek do celi przepływowej przez port próbki.
- Załóż pokrywę portu próbki, zamknij port zalewowy i zamknij pokrywę urządzenia sekwencjonującego.
- W oprogramowaniu upewnij się, że komórka przepływowa jest nadal dostępna, otwórz nowy eksperyment i ustaw parametry uruchamiania, wybierając używany zestaw. Wybierz połączenie z bazą na żywo. Rozpocznij sekwencjonowanie, klikając przycisk Rozpocznij eksperyment. Kontynuuj sekwencjonowanie, dopóki nie zostanie zebrana wystarczająca ilość danych eksperymentalnych.
Wyniki
W reprezentatywnym eksperymencie służącym do przetestowania przedstawionego protokołu wyizolowano RNA z 10 różnych próbek krwi pięciu gatunków zwierząt (tj. 2 osobniki na gatunek (koza, owca, świnia, pies, bydło)) (Tabela 3). Wydajność i jakość RNA po ekstrakcji mogą się znacznie różnić, w szczególności ze względu na różnice w obchodzeniu się z próbkami i ich przechowywaniu. W naszym reprezentatywnym eksperymencie zaobserwowaliśmy stężenia RNA od 43 ng do 543 ng na µL (Tabela 3). Ponadto, po amplifikacji metodą RT-PCR, analiza żelowa produktów PCR NPC-1 wykazała zróżnicowane wyniki (Rycina 2), z wyraźnie słabszymi prążkami dla próbek BC01 i BC02 (obie od kozy). Różnice te były najprawdopodobniej spowodowane różnicami w jakości próbek, choć nie można wykluczyć różnic w efektywności PCR wynikających z różnic w wiązaniu starterów do genu NPC1 różnych gatunków. Jednakże te różnice w wydajności i/lub efektywności amplifikacji nie wpłynęły znacząco na ogólny wynik sekwencjonowania. Ponadto, w próbce BC10 (bydło) pojawił się dodatkowy nieswoisty produkt PCR. W przeciwieństwie do sekwencjonowania metodą Sangera, takie nieswoiste produkty nie wpływają negatywnie na wyniki sekwencjonowania nanoporowego, ponieważ odczyty te są odrzucane podczas mapowania uzyskanych odczytów do sekwencji referencyjnej w ramach analizy danych.
Przed każdym uruchomieniem sekwencjonowania zdecydowanie zaleca się przeprowadzenie kontroli jakości użytej celi przepływowej, przyjmując minimalne wymaganie 800 porów łącznie. W naszym reprezentatywnym eksperymencie kontrola jakości ta wykazała dostępność 1 102 porów do sekwencjonowania. Ponieważ dane są dostarczane w czasie rzeczywistym i mogą być natychmiast analizowane, czas trwania sekwencjonowania można dostosować do konkretnego zastosowania (tzn. do momentu wygenerowania wystarczającej ilości danych sekwencjonowania dla pożądanej analizy). W naszych eksperymentach sekwencjonowanie jest zazwyczaj przeprowadzane przez noc, a w przypadku naszego reprezentatywnego eksperymentu uzyskaliśmy około 1,4 miliona odczytów podczas takiego 14 h cyklu.
W zależności od rodzaju planowanej analizy danych, wskazane może być przetworzenie jedynie podzbioru uzyskanych odczytów. W przypadku naszego reprezentacyjnego eksperymentu do dalszej analizy wybrano podzbiór 10 000 odczytów. W tym celu pliki fastq wygenerowane podczas sekwencjonowania zostały następnie przetworzone w środowisku Ubuntu 18.04 LTS i zdemultipleksowane przy użyciu programu flexbar v3.0.3 z parametrami zoptymalizowanymi dla demultipleksowania danych z sekwencjonowania nanoporowego (barcode-tail-length 300, barcode-error-rate 0.2, barcode-gap-penalty -1)12. Po demultipleksowaniu mapowanie odczytów i generowanie konsensusu można przeprowadzić za pomocą szeregu różnych narzędzi, jednak szczegółowa dyskusja nad aspektem bioinformatycznym sekwencjonowania nanoporowego wykracza poza zakres niniejszego opracowania. Niemniej jednak, w przypadku naszych reprezentacyjnych wyników, mapowanie odczytów do sekwencji referencyjnej wykonano za pomocą programu Geneious 10.2.3. Spośród 10 000 analizowanych odczytów 5 457 miało długość od 1 750 do 2 000 nukleotydów, co odpowiada oczekiwanym rozmiarom fragmentów PCR amplifikowanych w ramach naszego protokołu (1 769 nt, Rysunek 3). Dodatkowy pik w rozkładzie długości odczytów zaobserwowano pomiędzy 250 a 500 nukleotydami, co można przypisać niespecyficznym produktom PCR. Demultipleksowanie odczytów pozwoliło na przypisanie 87,6% odczytów do jednego z 10 analizowanych kodów kreskowych/próbek (Rysunek 4). Udział zdemultipleksowanych odczytów dla każdego kodu kreskowego wahał się od 3,4% dla kodu 1 do 16,9% dla kodu 10; jednak ze względu na ogólną dużą liczbę odczytów pozwoliło to na rzetelne wyznaczenie konsensusu z wysoką głębokością pokrycia nawet dla zbiorów danych z kodami kreskowymi o niższej liczebności. Rzeczywiście, mapowanie posortowanych odczytów do sekwencji referencyjnej NPC1 zaowocowało mapowaniem do referencji od 31,7% (kod 2) do 100% (kod 7 i 8) odczytów, co dało głębokość pokrycia wynoszącą ponad 90 odczytów w każdej pozycji dla każdej próbki. Jest to wartość w pełni wystarczająca, aby umożliwić pewne wyznaczenie konsensusu zasad z pomijalnie niskim wskaźnikiem błędów.

Rycina 1: Schematyczne przedstawienie sekwencjonowania DNA z wykorzystaniem technologii nanoporowej. Jednoniciowa cząsteczka DNA przechodzi przez nanopor osadzony w membranie rezystywnej, przy czym helikaza reguluje prędkość przejścia. Przez por przepływa jednocześnie prąd jonowy, który jest stale mierzony. Modulacje prądu wywołane przez nukleotydy znajdujące się w porze są wykrywane i obliczeniowo przekształcane z powrotem w sekwencję nukleotydową nici DNA. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
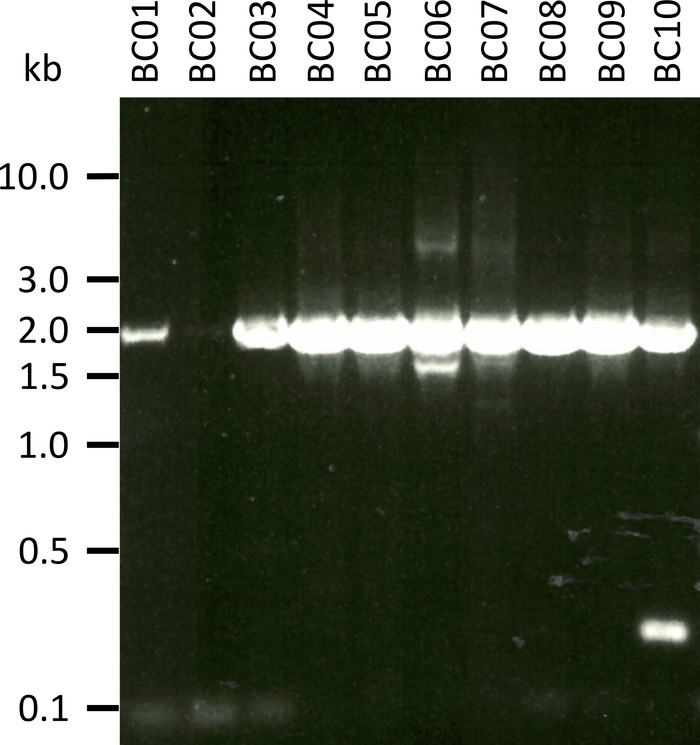
Rysunek 2: Amplifikacja produktów PCR Niemann-Pick C1 z mRNA. mRNA wyizolowano od kóz (BC01 i 02), owiec (BC03 i 04), świń (BC05 i 06), psów (BC07 i 08) oraz bydła (BC09 i 10). Produkty nested PCR rozdzielono w 0,8% żelu agarozowym w buforze 1x TAE (przygotowanym z buforu 50x TAE: 242,28 g bazy Tris, 57,1 mL octu lodowatego, 100 mL 0,5 M EDTA, uzupełniono dH2O do 1 L, pH skorygowano do 8,0) przez 45 min przy 100 V i zabarwiono barwnikiem Sybr Safe. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
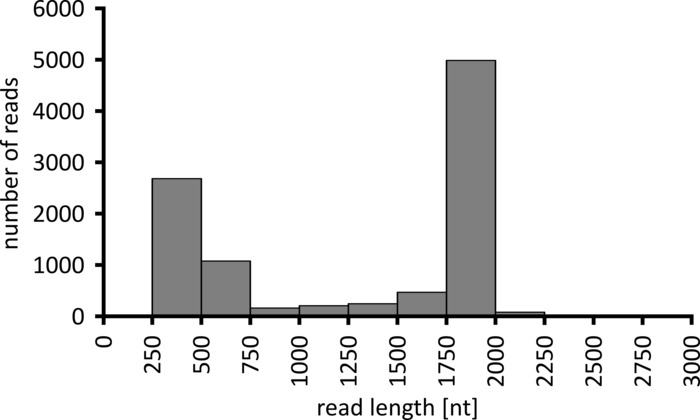
Rycina 3: Rozkład długości 10 000 odczytów z reprezentatywnego eksperymentu. Wskazano liczbę uzyskanych odczytów w danym przedziale długości odczytu. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
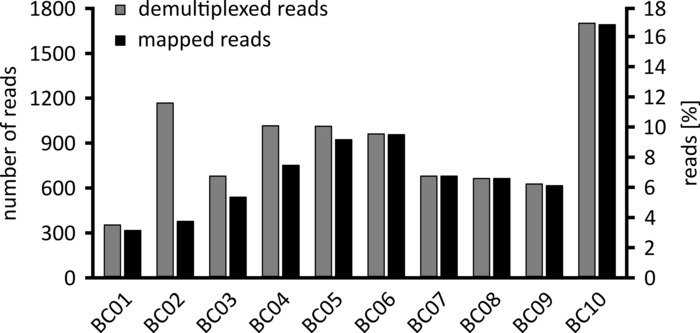
Rycina 4: Rozkład odczytów po demultipleksowaniu. Przedstawiono liczbę oraz procent odczytów po demultipleksowaniu (szare) i odczytów zmapowanych (czarne) dla każdego kodu kreskowego. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Tabela 1: Przegląd zastosowanych zestawów starterów. Pierwsza amplifikacja sekwencji docelowych została przeprowadzona z użyciem Zestawu Starterów 1. Następnie do amplifikacji zagnieżdżonej i dodania adapterów wykorzystano Zestaw Starterów 2. Adaptery zaznaczono kolorem czerwonym. Kliknij tutaj, aby pobrać ten plik.
Tabela 2: Przegląd sekwencji kodów kreskowych. Poszczególne kody kreskowe zostały wykorzystane do identyfikacji każdej sekwencjonowanej próbki. Kliknij tutaj, aby pobrać ten plik.
Tabela 3: Stężenia RNA uzyskane po ekstrakcji z próbek krwi sekwencjonowanych w eksperymencie reprezentatywnym. Przedstawiono stężenia RNA dwóch osobników z każdego z pięciu gatunków oraz wskazano stosunki gęstości optycznych przy 260/280 nm i 260/230 nm. Kliknij tutaj, aby pobrać ten plik.
Dyskusja
W ciągu ostatnich dwóch dekad sekwencjonowanie próbek biologicznych stało się coraz ważniejszym aspektem badań w szerokim zakresie dziedzin. Opracowanie systemów sekwencjonowania drugiej generacji opartych na sekwencjonowaniu gęstej matrycy cech DNA przy użyciu iteracyjnych cykli manipulacji enzymatyczneji pozyskiwania danych na podstawie obrazu1 znacznie zwiększyło przepustowość w porównaniu z tradycyjną techniką sekwencjonowania Sangera i umożliwia równoległą analizę wielu próbek, a także różnych gatunków kwasów nukleinowych w danej próbce4. Jednak w przypadku większości powszechnie używanych systemów drugiej generacji generowane są tylko krótkie odczyty, a wszystkie platformy opierają się na czułym, nieporęcznym i drogim sprzęcie 3,4.
W przeciwieństwie do platform sekwencjonowania drugiej generacji, urządzenie sekwencjonujące stosowane w tym protokole oparte jest na technologii nanoporowej. Tutaj jednoniciowa cząsteczka kwasu nukleinowego przechodzi przez nanopory, co powoduje modulację prądu jonowego, który również przepływa przez ten sam nanopor i który można zmierzyć i przetłumaczyć wstecznie w celu wywnioskowania sekwencji cząsteczki kwasu nukleinowego. To podejście oparte na sekwencjonowaniu trzeciej generacji ma wiele zalet w porównaniu z innymi podejściami. Główne zalety, które są bezpośrednio związane z unikalną zasadą działania tej technologii, to niezwykle długa długość odczytu (długość odczytu do 8,8 x 10⁵ nukleotydów została zgłoszona6), zdolność do bezpośredniego sekwencjonowania nie tylko DNA, ale także RNA, co niedawno wykazano w przypadku pełnego genomu wirusa grypy17oraz możliwość analizowania danych w czasie rzeczywistym w trakcie ich generowania, co umożliwia szybkie wykrywanie patogenów w metagenomice w ciągu kilku minut18. Dodatkowymi zaletami praktycznymi są niezwykle mały rozmiar urządzenia do sekwencjonowania nanoporowego, pozwalający na jego zastosowanie w dowolnym laboratorium lub na misjach terenowych w odległych lokalizacjach19,20 oraz niska cena w porównaniu z innymi platformami sekwencjonowania. Jeśli chodzi o koszty eksploatacji, obecnie do każdego cyklu sekwencjonowania wymagana jest nowa komórka przepływowa, co skutkuje kosztami około 1,100 USD za przebieg odczynników do przygotowania komory przepływowej i biblioteki. Koszty te można w niektórych przypadkach obniżyć poprzez mycie i ponowne użycie celi przepływowej lub poprzez kodowanie kreskowe i sekwencjonowanie wielu próbek w jednym przebiegu. Ponadto nowy typ komory przepływowej jest obecnie testowany w wersji beta przez niewielką liczbę laboratoriów, co będzie wymagało użycia adaptera komory przepływowej (zwanej "flongle") i powinno znacznie obniżyć cenę komory przepływowej, a tym samym koszty eksploatacji.
Główną wadą sekwencjonowania nanoporowego pozostaje jego dokładność, przy czym dokładność pojedynczego odczytu w zakresie od 83 do 86% wynosi 6,21,22, a większość niedokładności jest spowodowana insercją/delecją (indels)5,21. Jednak duża głębokość odczytu może zrekompensować te niedokładności, a niedawne badanie zasugerowało na podstawie rozważań teoretycznych, że głębokość odczytu >10 może zwiększyć ogólną dokładność do >99,8%21. Niemniej jednak konieczna będzie dalsza poprawa dokładności, zwłaszcza jeśli analiza ma być przeprowadzana na poziomie pojedynczej cząsteczki, a nie na poziomie sekwencji zgodnej. Zastosowanie technologii 1D2 opisanej w niniejszym protokole, która opiera się na dodaniu adapterów 1D2 i kodów kreskowych (por. sekcja 5.5), w wyniku których obie nici pojedynczej cząsteczki DNA są sekwencjonowane przez ten sam nanopor, zwiększa dokładność odczytu, ponieważ informacje z obu nici DNA mogą być wykorzystane do określenia sekwencji. Co więcej, strategią obejścia, którą można zastosować w celu połączenia zalet sekwencjonowania nanoporowego (szczególnie długiego odczytu) z wyższą dokładnością innych technologii sekwencjonowania, jest wykorzystanie informacji o sekwencjonowaniu nanoporowym jako rusztowania, które jest następnie polerowane przy użyciu danych sekwencjonowania z innych platform6.
Najważniejszym czynnikiem decydującym o powodzeniu przedstawionego tutaj protokołu jest jakość próbki, a w szczególności ilość i jakość wyekstrahowanego RNA. Właściwe przechowywanie i szybka ekstrakcja RNA pomagają w osiągnięciu odpowiedniej wydajności RNA. Stosowanie odpowiednich probówek do pobierania krwi pozwala na przechowywanie próbek krwi przez okres do jednego miesiąca, ale krzepnięcie krwi może stanowić problem, szczególnie gdy próbki są przechowywane w podwyższonych temperaturach, co może mieć miejsce w warunkach polowych. Drugim krytycznym etapem jest amplifikacja sekwencji docelowych, a szczególnie w warunkach polowych reakcje PCR często przebiegają gorzej niż w standardowych warunkach laboratoryjnych7. W tym celu staranne zaprojektowanie i optymalizacja podkładu ma kluczowe znaczenie dla uzyskania solidnego wzmocnienia. Dodatkowo, zagnieżdżone podejścia PCR i touchdown PCR, stosowane w tym protokole, mogą zwiększyć zarówno specyficzność, jak i czułość docelowej amplifikacji genu 4,7. Rzeczywiście, z naszego doświadczenia w Liberii i Gwinei z tą technologią wynika, że zagnieżdżone protokoły były wymagane w warunkach terenowych z próbkami terenowymi, nawet w przypadku zestawów starterów, które pozwalały na amplifikację celów z próbek laboratoryjnych i w warunkach laboratoryjnych z pojedynczą rundą PCR (7 i niepublikowane wyniki).
W przeciwieństwie do tych bardziej krytycznych kroków, przygotowanie biblioteki i sam przebieg sekwencjonowania są raczej solidnymi procedurami. Jednak w warunkach polowych problematyczne mogą być kwestie praktyczne, takie jak dostępność niektórych elementów wyposażenia. Na przykład spektrofotometr UV jest potrzebny do określenia stężeń DNA przed przygotowaniem biblioteki próbek z kodami kreskowymi. Jeśli jednak takie urządzenie nie jest dostępne w warunkach polowych, równą objętość każdej próbki można po prostu połączyć, aby uzyskać 45 μl wymagane do przygotowania biblioteki, przy czym różnice w materiale wejściowym próbki są zwykle łagodzone przez dużą liczbę odczytów. Podobnie, potrzeba połączenia z Internetem do przebiegu sekwencjonowania może stanowić problem, nawet jeśli wywołanie bazy nie musi już odbywać się online, ale może być wykonane lokalnie; Jednak w pewnych okolicznościach wymóg ten może zostać usunięty przez producenta, jeśli jest to wymagane.
Podsumowując, prezentowany protokół pozwala na relatywnie niskokosztowe sekwencjonowanie w lokalizacjach bez dostępu do tradycyjnego sprzętu do sekwencjonowania, w tym w odległych lokalizacjach. Można go łatwo dostosować do dowolnego docelowego RNA lub DNA, co pozwala naukowcom odpowiedzieć na wiele pytań biologicznych.
Oświadczenia
W latach 2014-2015 TH uczestniczył w programie wczesnego dostępu MinION firmy Oxford Nanopore Technologies (ONT) i otrzymał urządzenia MinION i komórki przepływowe do poprzedniego badania 7 przeprowadzonego przez National Institutes of Health w USA, bezpłatnie lub po obniżonych kosztach. Został zaproszony przez ONT do zaprezentowania części tej pracy na spotkaniu London Calling 2015 w Londynie w Wielkiej Brytanii, a ONT zapłacił za transport i zakwaterowanie. Za pracę przedstawioną w tym manuskrypcie nie uzyskano żadnych korzyści (np. sprzętu lub odczynników po obniżonych kosztach, zwrotu kosztów podróży itp.) od ONT. AM, KF i RS nie mają nic do ujawnienia.
Podziękowania
Autorzy dziękują Allison Groseth za krytyczne przeczytanie manuskryptu. Prace te były wspierane finansowo przez niemieckie Federalne Ministerstwo Żywności i Rolnictwa (BMEL) na podstawie decyzji Parlamentu Republiki Federalnej Niemiec za pośrednictwem Federalnego Urzędu ds. Rolnictwa i Żywności (BLE).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Adapter 1D2, adapter kodów kreskowych mix, bufor ABB, bufor elucyjny, bufor RBF, kulki LBB | Oxford Nanopore Technologies | SQK-LSK308 | 1D² Zestaw do sekwencjonowania |
| Probówka do pobierania krwi z odczynnikiem stabilizującym DNA/RNA | Zymo Research | R1150 | DNA/RNA Shield - Probówka do pobierania krwi |
| Blunt/TA ligase master mix | New England Biolabs | M0367S | Blunt/TA Ligase Master Mix |
| Probówka reakcyjna o niskim poziomie wiązania DNA | Eppendorf | 30108051 | DNA LoBind Probówka |
| Bufor DNazy i DNaza | ThermoFisher Scientific | 11766050 | Indeks górny&handel; IV VILO&handel; Master Mix z ezDNase™ Enzymatyczna |
| komórka przepływowa | Oxford Nanopore Technologies | FLO-MIN105.24 | Komórka przepływowa R9.4 |
| Polimeraza DNA o wysokiej wierności na gorąco | New England Biolabs | M0493L | Q5 Hot Start Polimeraza DNA o wysokiej wierności (500 U) |
| Koraliki magnetyczne | Beckman Coulter | A63881 | Koraliki Agencourt AMPure XP |
| Stojak magnetyczny | ThermoFisher Scientific | 12321D | DynaMag-2 Magnes |
| Nanopore urządzenie do sekwencjonowania | Oxford Nanopore | Technologies-MinION | Mk 1B |
| Zestaw kodów kreskowych PCR | Oxford Nanopore Technologies | EXP-PBC001 | Zestaw kodów kreskowych PCR I (R9) |
| Główna mieszanka odwrotnej transkryptazy | ThermoFisher Scientific | 11766050 | SuperScript™ IV VILO&handel; Master Mix z ezDNase™ Kolumna |
| wirowa do oczyszczania enzymatycznego RNA, bufor do przygotowania DNA/RNA, bufor do płukania DNA/RNA, DNaza I, bufor do trawienia DNA | Zymo Research | R1151 | Zestaw probówek do krwi Quick-DNA/RNA |
| Mieszalnik obrotowy | ThermoFisher Scientific | 15920D | HulaMixer Sample Mixer |
| Polimeraza DNA Taq | Nowa Anglia Biolabs | M0287S | LongAmp Taq 2x Master Mix |
| Ultra II Zestaw do przygotowania końcówek | Nowa Anglia Biolabs | E7546S | NEBNext Ultra II Spektrofotometr UV z modułem naprawy końcowej/dA-tailingu |
| Implen-NanoPhotometer | |||
| Kolektor próżniowy Kolektor próżniowy | Zymo Research | S7000 | EZ-Vac |
Bibliografia
- Shendure, J., Ji, H. Next-generation DNA sequencing. Nature Biotechnology. 26 (10), 1135-1145 (2008).
- Shendure, J., Lieberman Aiden, E. The expanding scope of DNA sequencing. Nature Biotechnology. 30 (11), 1084-1094 (2012).
- Liu, L., et al. Comparison of next-generation sequencing systems. Journal of Biomedicine and Biotechnology. 2012, 251364(2012).
- Levy, S. E., Myers, R. M. Advancements in Next-Generation Sequencing. Annual Review of Genomics and Human Genetics. 17, 95-115 (2016).
- Lu, H., Giordano, F., Ning, Z. Oxford Nanopore MinION Sequencing and Genome Assembly. Genomics, Proteomics & Bioinformatics. 14 (5), 265-279 (2016).
- Jain, M., et al. Nanopore sequencing and assembly of a human genome with ultra-long reads. Nature Biotechnology. 36 (4), 338-345 (2018).
- Hoenen, T., et al. Nanopore Sequencing as a Rapidly Deployable Ebola Outbreak Tool. Emerging Infectious Diseases. 22 (2), 331-334 (2016).
- Quick, J., et al. Real-time, portable genome sequencing for Ebola surveillance. Nature. 530 (7589), 228-232 (2016).
- Carette, J. E., et al. Ebola virus entry requires the cholesterol transporter Niemann-Pick C1. Nature. 477 (7364), 340-343 (2011).
- Ndungo, E., et al. A Single Residue in Ebola Virus Receptor NPC1 Influences Cellular Host Range in Reptiles. mSphere. 1 (2), (2016).
- Martin, S., et al. A genome-wide siRNA screen identifies a druggable host pathway essential for the Ebola virus life cycle. Genome Medicine. 10 (1), 58(2018).
- Roehr, J. T., Dieterich, C., Reinert, K. Flexbar 3.0 - SIMD and multicore parallelization. Bioinformatics. 33 (18), 2941-2942 (2017).
- Li, H., et al. The Sequence Alignment/Map format and SAMtools. Bioinformatics. 25 (16), 2078-2079 (2009).
- Kielbasa, S. M., Wan, R., Sato, K., Horton, P., Frith, M. C. Adaptive seeds tame genomic sequence comparison. Genome Research. 21 (3), 487-493 (2011).
- Don, R. H., Cox, P. T., Wainwright, B. J., Baker, K., Mattick, J. S. Touchdown' PCR to circumvent spurious priming during gene amplification. Nucleic Acids Research. 19 (14), 4008(1991).
- Korbie, D. J., Mattick, J. S. Touchdown PCR for increased specificity and sensitivity in PCR amplification. Nature Protocols. 3 (9), 1452-1456 (2008).
- Keller, M. W., et al. Direct RNA Sequencing of the Coding Complete Influenza A Virus Genome. Scientific Reports. 8 (1), 14408(2018).
- Greninger, A. L., et al. Rapid metagenomic identification of viral pathogens in clinical samples by real-time nanopore sequencing analysis. Genome Medicine. 7, 99(2015).
- Castro-Wallace, S. L., et al. Nanopore DNA Sequencing and Genome Assembly on the International Space Station. Scientific Reports. 7 (1), 18022(2017).
- Goordial, J., et al. In Situ Field Sequencing and Life Detection in Remote (79 degrees 26'N) Canadian High Arctic Permafrost Ice Wedge Microbial Communities. Frontiers in Microbiology. 8, 2594(2017).
- Runtuwene, L. R., et al. Nanopore sequencing of drug-resistance-associated genes in malaria parasites, Plasmodium falciparum. Scientific Reports. 8 (1), 8286(2018).
- Rang, F. J., Kloosterman, W. P., de Ridder, J. From squiggle to basepair: computational approaches for improving nanopore sequencing read accuracy. Genome Biology. 19 (1), 90(2018).
Przedruki i uprawnienia
