OpenProt to swobodnie dostępna baza danych, która wymusza policistroniczny model genomów eukariotycznych. W tym miejscu przedstawiamy protokół korzystania z baz danych OpenProt podczas przeszukiwania zestawów danych spektrometrii mas. Wykorzystanie bazy danych OpenProt do analizy eksperymentów proteomicznych pozwala na odkrycie nowych i wcześniej niewykrywalnych białek.
Artykuł metodologiczny
Analizy proteomiczne oparte na spektrometrii mas z wykorzystaniem bazy danych OpenProt w celu odkrycia nowych białek przetłumaczonych z niekanonicznych otwartych ramek odczytu
W tym artykule
Podsumowanie
Streszczenie
Adnotacja genomu jest kluczowa dla dzisiejszych badań proteomicznych, ponieważ rysuje zarysy krajobrazu proteomicznego. Tradycyjne modele adnotacji z otwartą ramką do czytania (ORF) narzucają dwa arbitralne kryteria: minimalną długość 100 kodonów i jeden ORF na transkrypcję. Jednak coraz więcej badań donosi o ekspresji białek z regionów rzekomo niekodujących, co podważa dokładność obecnych adnotacji genomu. Odkryto, że te nowe białka są kodowane albo w niekodujących RNA, 5' lub 3' nieulegających translacji regionach (UTR) mRNA, albo nakładających się na znaną sekwencję kodującą (CDS) w alternatywnym ORF. OpenProt to pierwsza baza danych, która wymusza policistroniczny model genomów eukariotycznych, umożliwiając adnotację wielu ORF na transkrypt. OpenProt jest swobodnie dostępny i oferuje niestandardowe pobieranie sekwencji białek dla 10 gatunków. Wykorzystanie bazy danych OpenProt do eksperymentów proteomicznych umożliwia odkrywanie nowych białek i podkreśla policistroniczną naturę genów eukariotycznych. Wielkość bazy danych OpenProt (wszystkie przewidywane białka) jest znaczna i należy ją uwzględnić w analizie. Jednak dzięki odpowiednim ustawieniom współczynnika fałszywych wykryć (FDR) lub użyciu ograniczonej bazy danych OpenProt użytkownicy uzyskają bardziej realistyczny obraz krajobrazu proteomicznego. Ogólnie rzecz biorąc, OpenProt jest ogólnodostępnym narzędziem, które będzie sprzyjać odkryciom proteomicznym.
Wprowadzenie
W ciągu ostatnich dziesięcioleci, proteomika oparta na spektrometrii mas (MS-) stała się złotą techniką do rozszyfrowywania proteomów komórek eukariotycznych1,2,3,4,5. Ta metoda opiera się na aktualnych adnotacjach genomu w celu wygenerowania referencyjnej bazy danych sekwencji białek, która nakreśla zakres możliwości6,7,8. Jednak adnotacje genomu zawierają arbitralne kryteria adnotacji ORF, takie jak minimalna długość 100 kodonów i jeden ORF na transkrypt9,10. Coraz więcej badań kwestionuje obecny model adnotacji i donosi o odkryciach nieopisanych funkcjonalnych ORF w genomach eukariotycznych8,11,12,13,14. Te nowe białka znajdują się zakodowane w rzekomo niekodujących RNA, w nieulegających translacji regionach 5' lub 3' mRNA lub nakładających się na kanoniczną sekwencję kodującą (cCDS) w alternatywnej ramce. Chociaż większość z tych odkryć była przypadkowa, pokazują one zastrzeżenia obecnych adnotacji genomu i policistroniczną naturę genów eukariotycznych8.
Tutaj podkreślamy użycie baz danych OpenProt do proteomiki opartej na MS. OpenProt jest pierwszą bazą danych, która zawiera polistroniczny model adnotacji dla transkryptomów eukariotycznych. Jest on dostępny bezpłatnie pod adresem www.openprot.org15. Część tych przewidywanych ORF-ów byłaby losowa i niefunkcjonalna, dlatego OpenProt kumuluje dowody eksperymentalne i funkcjonalne, aby zwiększyć pewność. Dowody eksperymentalne obejmują ekspresję białek (przez stwardnienie rozsiane) i dowody translacji (przez profilowanie rybosomów)15. Dowody funkcjonalne obejmują ortologię białek (z podejściem podobnym do In-Paranoid) i przewidywanie domeny funkcjonalnej15.
OpenProt oferuje możliwość pobrania kilku baz danych, od zawierających tylko dobrze obsługiwane białka do baz danych tworzonych na zamówienie. W tym miejscu przedstawimy potok wykorzystania baz danych OpenProt i zaoferujemy wgląd w to, którą bazę danych wybrać, biorąc pod uwagę cel eksperymentalny. Przedstawiony tutaj potok analizy proteomicznej jest obsługiwany przez framework Galaxy, ponieważ jest otwarty i łatwy w użyciu, ale bazy danych mogą współpracować z dowolnym przepływem pracy16,17,18. Przedstawimy również, w jaki sposób wykorzystać stronę internetową OpenProt do gromadzenia dalszych informacji na temat nowych białek wykrywanych przez SM. Korzystanie z baz danych OpenProt zapewni bardziej wyczerpujący obraz krajobrazu proteomicznego i będzie sprzyjać odkryciom proteomiki i biomarkerów w bardziej systematyczny sposób niż obecne metody.
Ten protokół podkreśla użycie baz danych OpenProt 15 podczas przeszukiwania zbiorów danych MS; nie będzie sprawdzać projektu samego eksperymentu, który został dokładnie sprawdzony gdzie indziej20,21,22. Aby pozostać w pełni otwartym, protokół jest swobodnie dostępny (Materiały uzupełniające S1-S4). Dla łatwiejszego odczytania, wszystkie terminy używane w OpenProt i tym samym w całym tym protokole są zdefiniowane w Tabeli 1.
Protokół
1. Pobieranie bazy danych OpenProt
UWAGA: Na przykład można również uzyskać niestandardowe bazy danych oparte na danych sekwencyjnych RNA, a procedura jest szczegółowo opisana w drugiej sekcji tego protokołu. Jeśli potrzebna jest niestandardowa baza danych, przejdź do następnej sekcji.
- Przejdź do witryny OpenProt : www.openprot.org i otwórz stronę Pobrane, korzystając z linku z menu górnej strony.
- Kliknij na interesujący Cię gatunek na podstawie przeanalizowanych danych eksperymentalnych.
- Kliknij żądany typ białka.
UWAGA: OpenProt oferuje trzy klasyfikacje: RefProt, Isoforms i AltProt. Jak pokazano w Rysunek 1, ten parametr będzie się różnił w zależności od celu badawczego.- Kliknij na sam RefProc, aby wygenerować pliki zawierające tylko znane białka.
- Kliknij AltProt i Isoforms, aby wygenerować pliki zawierające tylko nowe białka - albo nowe izoformy znanych białek (Isoforms), albo zakodowane przez alternatywny ORF (AltProts). Należy pamiętać, że OpenProt wymusza minimalną długość ORF wynoszącą 30 kodonów15.
- Kliknij AltProts, Isoforms i RefProts, aby wygenerować pliki zawierające wszystkie typy białek obecne w bazie danych OpenProt - znane i nowe białka.
- Jeśli to możliwe, kliknij adnotację, z której rysowane są sekwencje białek.
UWAGA: OpenProt oferuje bardziej wyczerpujący krajobraz proteomiczny poprzez połączenie wielu adnotacji. Adnotacje transkryptomu w minimalnym stopniu się pokrywają; W związku z tym wybrana adnotacja może znacząco wpłynąć na zwizualizowany profil proteomiczny15,23. - Kliknij na poziom dowodów potwierdzających niezbędnych do rozważenia białka. Jak pokazano w Rysunek 1, ten parametr będzie się różnił w zależności od celu badawczego.
- Kliknij na co najmniej dwa wykryte unikalne peptydy, aby wygenerować pliki zawierające tylko najbardziej pewne białka.
UWAGA: Kryterium dwóch unikalnych peptydów jest obecnie uważane za złoty standard w proteomice ekspresji białek. Jeśli celem eksperymentu jest wykrycie znanych i dobrze potwierdzonych białek, zaleca się stosowanie tego parametru. - Kliknij co najmniej jeden wykryty unikalny peptyd, aby wygenerować pliki zawierające białka, które zostały już zaobserwowane co najmniej raz w eksperymentach spektrometrii mas ponownie przeanalizowanych przez OpenProt.
UWAGA: Pozwala to na uwzględnienie krótszej długości AltProts i prawdopodobieństwa, że niektóre z nich mogą zawierać tylko jeden unikalny peptyd tryptyczny8,11. - Kliknij wszystkie przewidywane, aby wygenerować pliki zawierające wszystkie przewidywania OpenProt .
UWAGA: To ustawienie jest zalecane tylko wtedy, gdy celem eksperymentu jest odkrycie nowych białek (Rysunek 1). Późniejszy znaczny wzrost przestrzeni wyszukiwania wymaga dostosowanego potoku analizy, jak omówiono poniżej7,15.
- Kliknij na co najmniej dwa wykryte unikalne peptydy, aby wygenerować pliki zawierające tylko najbardziej pewne białka.
- Kliknij żądany format pliku, aby pobrać. Do analiz proteomicznych należy wybrać plik Fasta (białkowy). Plik readme zawiera wszystkie niezbędne informacje na temat formatu pliku.
2. Pobieranie niestandardowej bazy danych OpenProt
UWAGA: Ta sekcja szczegółowo opisuje, jak uzyskać niestandardową bazę danych. Jeśli niestandardowa baza danych nie jest potrzebna, przejdź do następnej sekcji.
- Przejdź do witryny OpenProt (www.openprot.org) i otwórz stronę Szukaj, korzystając z linku z menu górnej strony.
- Kliknij interesujący Cię gatunek na podstawie analizowanych danych eksperymentalnych.
- Wprowadź listę interesujących genów lub transkryptów.
- W przypadku korzystania z listy genów wprowadź ją w polu Zapytanie genowe.
- W przypadku korzystania z listy transkrypcji wprowadź ją w polu Zapytanie transkrypcji.
- Zaznacz dowolne pole, które ma zastosowanie do żądanej bazy danych.
- Nie klikaj na żadne pole, aby uzyskać tabelę zawierającą wszystkie rodzaje białek obsługiwanych przez OpenProt: RefProt, Isoforms i AltProts.
- Kliknij Pokaż tylko białka z dowodami eksperymentalnymi, aby uzyskać tabelę zawierającą wszystkie typy białek (RefProts, Isoforms i AltProts), które zostały wykryte co najmniej raz przez MS i/lub dla których zebrano dowody translacji na podstawie danych profilowania rybosomów.
- Podobnie, kliknij Pokaż tylko białka wykryte przez SM lub Pokaż tylko białka wykryte przez profilowanie rybosomów, aby uzyskać tabelę zawierającą wszystkie typy białek, które zostały wykryte co najmniej raz odpowiednio przez SM lub przez profilowanie rybosomów.
- Kliknij Pokaż tylko AltProts lub Pokaż tylko izoformy, aby uzyskać tabelę zawierającą odpowiednio tylko AltProts lub tylko izoformy.
- Kliknij zarówno Pokaż tylko AltProts, jak i Pokaż tylko izoformy, aby uzyskać tabelę zawierającą oba typy białek.
UWAGA: Możliwe są wszystkie kombinacje filtrów.
- Po ustawieniu wszystkich żądanych parametrów kliknij Szukaj. Dane wyjściowe tabeli pojawią się poniżej pól zapytania wyszukiwania.
- Kliknij przycisk Pobierz Fasta w prawym górnym rogu tabeli wyjściowej. Spowoduje to wygenerowanie pliku Fasta zawierającego wszystkie białka wynikające z poszukiwanej listy genów lub transkryptów.
- Należy pamiętać, że ze względów obliczeniowych OpenProt przechowuje maksymalnie 2 000 elementów do odpytywania (genów lub transkryptów) jednocześnie. W przypadku listy powyżej tego limitu można wygenerować kilka fasta, a następnie połączyć je (jak opisano poniżej); lub po prostu pobierz całą bazę danych OpenProt i przefiltruj uzyskany plik zgodnie z potrzebami.
- Umieść całą listę genów lub transkryptów na podlistach zawierających 2,000 wpisów lub mniej. Dla każdej podlisty pobierz plik Fasta zgodnie z powyższym opisem (kroki od 3.3 do 3.6).
- Zaloguj się do europejskiej instancji Galaxy (lub dowolnej innej, w której dostępne są narzędzia proteomiczne) https://usegalaxy.eu/.
- Utwórz nową historię i zaimportuj wszystkie pobrane bazy danych OpenProt (po jednej na podlistę genów lub transkryptów), klikając logo przesyłania w lewym górnym rogu ekranu.
- Skorzystaj z narzędzia Fasta Merge Files and Filter Unique Sequences opracowanego przez programistów GalaxyP (https://github.com/galaxyproteomics/). Wybierz opcję Scal wszystkie Fasta i wprowadź wszystkie zaimportowane bazy danych OpenProt .
UWAGA: Każde narzędzie można przeszukiwać za pomocą pola zapytania po lewej stronie ekranu - Wybierz opcję tylko dostęp, aby ocenić jednolitość sekwencji i skopiuj regułę parsowania identyfikatora OpenProt (>(.*)\|), a następnie kliknij przycisk Wykonaj.
- Zwróć uwagę, że wszystkie pliki zostały połączone w unikalny plik Fasta bez nadmiarowości, który teraz pojawia się w panelu historii po prawej stronie ekranu. Stanowi to roboczą bazę danych.
3. Obsługa bazy danych
UWAGA: Od teraz platforma Galaxy będzie używana, ale te same zasady można zastosować do innych programów proteomicznych.
- Zaloguj się do europejskiej instancji Galaxy (lub dowolnej innej, w której dostępne są narzędzia proteomiczne) https://usegalaxy.eu/.
- Utwórz nową historię i zaimportuj pobraną bazę danych OpenProt, klikając logo przesyłania w lewym górnym rogu ekranu.
- Przejdź do strony przepływu pracy i zaimportuj przepływ pracy Obsługa bazy danych (materiał uzupełniający S1), klikając logo przesyłania w lewym górnym rogu środkowego panelu.
- Kliknij Uruchom przepływ pracy i wybierz zaimportowaną bazę danych OpenProt jako input.
UWAGA: Ten przepływ pracy dołączy repozytorium CRAPome do OpenProt fasta i wygeneruje sekwencje wabiące (sekwencje odwrotne)24. Jeśli pożądana jest lista zwodzików losowych, można to zrobić, zmieniając ten parametr w narzędziu DecoyDatabase. - Zmień nazwę uzyskanego pliku Fasta na coś znaczącego. Baza danych jest gotowa do wykorzystania do analiz proteomicznych.
4. Przygotowanie pliku spektrometrii mas
UWAGA: Większość narzędzi proteomicznych dostępnych na instancjach Galaxy używa formatu mzML, a wyszukiwarki peptydów preferują dane w trybie centroidowym.
- Otwórz bezpłatne narzędzie MSConvert z pakietu ProteoWizard i prześlij plik danych do analizy25.
- Wybierz katalog dla danych wyjściowych i żądany format pliku do mzML.
- Ustaw filtr wybierania wartości szczytowych za pomocą algorytmu falkowego (CWT) na poziomach MS1 i MS2 i rozpocznij konwersję26.
5. Identyfikacja/kwantyfikacja peptydów i białek
UWAGA: Ta część potoku korzysta z narzędzi z pakietu OpenMS, wszechstronnego i łatwego w użyciu frameworka18.
- Zaloguj się do europejskiej instancji Galaxy (lub dowolnej innej, w której dostępne są narzędzia proteomiczne) https://usegalaxy.eu/.
- Utwórz nową historię i przenieś poprzednio utworzoną bazę danych (krok 3.5) do tej nowej historii za pomocą przeciągania i upuszczania.
- Zaimportuj przekształcony plik danych mzML (krok 4.3), klikając logo Prześlij w lewym górnym rogu ekranu.
- Przejdź do strony przepływu pracy i zaimportuj żądany przepływ pracy, klikając logo przesyłania w lewym górnym rogu środkowego panelu.
UWAGA: Eksperymenty MS są różnie projektowane w zależności od pożądanego wyniku końcowego. Przepływy pracy są dostępne dla dwóch częstych projektów: identyfikacji białek i kwantyfikacji białek w oparciu o znakowanie stabilnych izotopów (SIL). Jednak instancja Galaxy zawiera wiele innych narzędzi, które będą obsługiwać inne typy analiz proteomicznych27,28.- W celu zaprojektowania identyfikacji białka należy zaimportować przepływ pracy podany w Materiałach uzupełniających S2. Podczas korzystania z tego przepływu pracy nie należy używać kompresji zlip podczas konwersji plików (krok 4.2)
- W celu ilościowego określenia białka w oparciu o projekt znakowania stabilnych izotopów, należy zaimportować przepływ pracy podany w Materiałach uzupełniających S3.
- Wybierz pozycję Uruchom przepływ pracy i przejrzyj różne parametry.
- Wybierz zaimportowany plik danych mzML jako dane wejściowe, a wcześniej utworzoną bazę danych (krok 3.5) jako plik Fasta bazy danych.
- Ponieważ przepływ pracy korzysta z wyszukiwarki X!Tandem, zaimportuj domyślny plik konfiguracyjny X!Tandem (dostarczony w Materiałach uzupełniających S4)29, klikając logo przesyłania w lewym górnym rogu ekranu.
- Przepływ pracy wykorzystuje wiele wyszukiwarek (MS-GF+ i X!Tandem). Dołącz inne wyszukiwarki lub wybierz jedną, po prostu dodając lub usuwając narzędzia z przepływu pracy30,31.
UWAGA: Zaleca się korzystanie z wielu wyszukiwarek, ponieważ zwiększa to czułość i czułość analizy32. - Aby uwzględnić znaczny wzrost rozmiaru podczas korzystania z całej bazy danych OpenProt, należy użyć rygorystycznego FDR15. Domyślnie podany przepływ pracy jest ustawiony na 0,001% FDR, odpowiedni do użycia całej bazy danych OpenProt. W przypadku innych baz danych można to edytować do dowolnej żądanej wartości.
UWAGA: Należy pamiętać o dostosowaniu parametrów różnych narzędzi w zależności od użytego spektrometru mas i protokołu eksperymentalnego (błąd jonów i fragmentów prekursorowych, modyfikacje stałe i zmienne, zastosowany enzym itp.).
- Opcjonalnie pobierz dane wyjściowe dla każdego kroku przepływu pracy do analizy magazynowania lub kontroli jakości, klikając wybrany krok w panelu historii, a następnie klikając logo Zapisz, które pojawi się pod spodem.
6. Kontrola jakości
UWAGA: Ponieważ proteomika oparta na MS jest wynikiem złożonego procesu, w którym każdy krok musi być zoptymalizowany, aby uzyskać powtarzalne wyniki, kontrola jakości jest konieczną procedurą w przepływie pracy33.
- Wspólnym wskaźnikiem wydajności jest kilka wskaźników, takich jak liczba dopasowań spektrum peptydów (PSM), liczba zidentyfikowanych peptydów i białek. Uruchom narzędzie File Info na danych wyjściowych IDFilter (oznaczonych na zielono w Rysunek 2), aby podać takie metryki.
- Chociaż nie ma to zastosowania do każdej identyfikacji, zwłaszcza w przypadku dużych zbiorów danych, raporty dotyczące nowych białek powinny być zawsze starannie oceniane. Kontrola wyniku białka, pokrycia sekwencji i widm potwierdzających odkrycie ma kluczowe znaczenie. Aby to zrobić, użyj narzędzia TOPPview z frameworka OpenMS; Jest on powszechnie dostępny i dobrze udokumentowany18,34,35.
7. Eksploracja bazy danych OpenProt
UWAGA: Po pewnym zidentyfikowaniu nowego białka przewidzianego przez OpenProt (numery dostępu zaczynające się od IP_ dla AltProts i II_ dla nowych izoform), można uzyskać więcej informacji biologicznych ze strony internetowej OpenProt 15.
- Przejdź do witryny OpenProt : www.openprot.org i otwórz stronę Szukaj, korzystając z linku w górnym menu strony.
- Kliknij interesujący nas gatunek (taki sam jak ten, w którym zidentyfikowano białko) i wprowadź numer dostępu do białka w polu zapytania Białko.
- Kliknij na szukaj, a pojawi się tabela zawierająca podstawowe informacje na temat poszukiwanego białka. Tabela zawiera: długość białka (w aminokwasie), jego masę cząsteczkową (kDa) i punkt izoelektryczny, dowody eksperymentalne za pomocą MS lub profilowania rybosomów (Translation Evidence, TE) oraz przewidywania funkcjonalne, takie jak przewidywane domeny i ortologia białek (dla 10 gatunków obsługiwanych przez OpenProt, v1.3). Tabela zawiera również informacje o powiązanym genie i transkryptacie oraz lokalizacji białka w transkryptie.
- Kliknij link Szczegóły, aby uzyskać więcej informacji. Nowo otwarta strona zawiera przeglądarkę genomu, która jest wyśrodkowana na pytanym białku oraz informacje, takie jak współrzędne genomowe i transkryptomiczne oraz obecność motywu Kozaka lub miejsca inicjacji translacji o wysokiej wydajności (TIS)36,37.
- Kliknij linki Białko lub DNA na karcie informacyjnej, aby uzyskać odpowiednio sekwencje białka lub DNA.
- Przeglądaj szczegółowe informacje na temat dowodów na stwardnienie rozsiane, profilowanie rybosomów, wykrywanie, ochronę i zidentyfikowane domeny białkowe, klikając na górne zakładki15.
Wyniki
Opisany powyżej schemat postępowania zastosowano do zbioru danych MS dostępnego w repozytorium PRIDE38,39. W pierwotnym badaniu opracowano metodę (iMixPro), wykorzystującą znakowanie stabilnymi izotopami aminokwasów w hodowli komórkowej (SILAC), aby wyeliminować wyniki fałszywie dodatnie w eksperymentach MS z oczyszczaniem powinowactwem (AP-MS)38. W skrócie, eksperyment AP-MS polega na wykorzystaniu przeciwciał związanych z koralikami do wyizolowania białka zainteresowania (przynęty) oraz jego interaktorów (ofiar). Zebrane białka są następnie trawione i przygotowywane do analizy MS. Metoda przygotowania próbek oraz ustawienia instrumentu zostały opisane w pierwotnym badaniu oraz w repozytorium PRIDE (PXD004246). Wyzwaniem w tego typu eksperymentach jest duża liczba wyników fałszywie dodatnich, w szczególności białek wiążących się z koralikami, a nie z przynętą. W tym przypadku wykorzystano metodę SILAC do wygenerowania różnych stosunków izotopowych między prawdziwymi ofiarami a wynikami fałszywie dodatnimi: 3 próbki kontrolne (bez przynęty) hodowane w medium lekkim, 1 próbka wykazująca ekspresję przynęty hodowana w medium lekkim oraz 1 próbka wykazująca ekspresję przynęty hodowana w medium ciężkim są poddawane obróbce z użyciem koralików i dalszej analizie spektrometrią mas. Przy takim projekcie białka nieswoiste wiążące się z koralikami będą miały stosunek ciężki do lekkiego wynoszący 1:4, podczas gdy prawdziwe ofiary będą miały stosunek 1:138.
Dokonaliśmy ponownej analizy ich danych AP-MS z wykorzystaniem bazy danych OpenProt; jako białka-przynęty (baits) zastosowano trzy białka endogenne (PTPN14, JIP3 i IQGAP1) oraz dwa białka nadeksponowane (RAF1 i RNF41). Ponieważ w eksperymentach wykorzystano metodę SILAC, zastosowano przepływ pracy (workflow) Galaxy do kwantyfikacji białek (Materiał uzupełniający S3, Rycina 2). Workflow uruchomiono z wykorzystaniem pełnej bazy danych OpenProt (OpenProt_all) lub ograniczonej bazy danych OpenProt (OpenProt_2pep, obejmującej wyłącznie białka wykryte wcześniej przy użyciu minimum dwóch unikalnych peptydów).
Identyfikacja i kwantyfikacja białek były prawidłowe i powtarzalne we wszystkich zastosowanych bazach danych. Jak pokazano na Rysunku 3, większość białek zidentyfikowanych w oryginalnej pracy została również zidentyfikowana przy użyciu bazy OpenProt_2pep lub OpenProt_all (szczegółowa lista znajduje się w Materiałach uzupełniających S5). Wynik ten dowodzi, że opisany tutaj proces oraz bazy danych OpenProt pozwalają na identyfikację i kwantyfikację białek porównywalną z aktualnymi procedurami opartymi na bazach UniProtKB40. Jednakże zastosowanie baz OpenProt daje unikalną korzyść w postaci możliwości wykrywania nowych i wcześniej niewykrywalnych białek, co wykazano w niniejszym studium przypadku.
W ramach wszystkich zbiorów danych, z wykorzystaniem pewnych peptydów i bazy danych OpenProt_2pep, zidentyfikowano 11 dobrze udokumentowanych białek (1 izoformę i 10 AltProt), które obecnie nie są adnotowane w bazach danych (wszystkie numery dostępowe białek wraz z liczbą peptydów potwierdzających są dostępne w Materiałach uzupełniających S5). Baza ta pozwala na zastosowanie tradycyjnego poziomu FDR wynoszącego 1%, ponieważ wzrost przestrzeni przeszukiwań pozostaje umiarkowany. Te 11 białek nie zostało zidentyfikowanych w oryginalnym badaniu, ponieważ nie było ich w bazie danych.
W wszystkich zestawach danych, przy zastosowaniu pewnych peptydów oraz bazy danych OpenProt_all, odkryto 29 nowych białek (16 izoform i 13 AltProts; wszystkie numery dostępu białek wraz z liczbą peptydów potwierdzających są dostępne w Materialach Suplementarnych S6). Jak pokazano na Rysunku 3, zalecany rygorystyczny poziom FDR nie wpłynął na najbardziej wiarygodne identyfikacje białek, choć zmniejszył całkowitą liczbę zidentyfikowanych białek. W porównaniu z bazą danych OpenProt_2pep, można z większą pewnością zidentyfikować większą liczbę nowych białek. Wszystkie te nowe białka nie występują w bazie OpenProt_2pep. Podkreśla to kluczową rolę wyboru bazy danych w proteomice opartej na MS.
Odkryto jedno nowe białko będące interaktorem białka RAF1 (IP_637643). Korzystając ze strony OpenProt, można zauważyć, że białko to nie zostało dotąd wykryte za pomocą MS ani profilowania rybosomów (OpenProt v1.3). Białko składa się z 46 aminokwasów i podczas trawienia trypsyną może dostarczyć tylko dwa unikalne peptydy. Peptyd wykryty w zbiorze danych RAF1 AP-MS (frakcja 18) posiadał widmo dobrej jakości, co pokazano na Rysunku 4, i wykazywał stosunek ciężkiego do lekkiego izotopu na poziomie 1,09. Białko jest kodowane przez gen NANOGNBP1, który jest pseudogenem NANOGNB. Transkrypty (ENST00000448444), obecnie adnotowane jako niekodujące, zostały wykryte w kilku tkankach zgodnie z portalem GTEx40. Białko zawiera przewidywaną funkcjonalną domenę związaną z wiązaniem DNA (Gene Ontology GO:0003677)41.

Rysunek 1: Schemat wyboru bazy danych dla analiz proteomicznych. Analizy danych MS, a w szczególności wybór bazy danych, zależą od celów badawczych. Trzy powszechne cele przedstawiono w kolorze niebieskim (klasyczny potok proteomiczny), zielonym (wyczerpujące przeszukiwanie proteomiczne) i pomarańczowym (odkrywanie proteomiczne). Każdy cel wymaga zastosowania odpowiedniej bazy danych i potoku analizy. Do wyczerpującego i klasycznego potoku proteomicznego można użyć jednego narzędzia do identyfikacji. W przypadku potoku odkrywania proteomicznego zdecydowanie zalecamy stosowanie wielu silników identyfikacyjnych. Zalecane wartości FDR zaznaczono na czerwono, a wielkości baz danych białek wskazano w szarych polach. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.

Rycina 2: Graficzna reprezentacja wykorzystanego przepływu pracy w Galaxy.Krok po kroku przedstawiono schemat analizy proteomicznej zastosowany do ponownej analizy danych Eyckermana i wsp.38. Pliki wejściowe, wyszukiwanie peptydów i kwantyfikacja białek są oznaczone pomarańczowymi polami. Niebieskie pola odpowiadają wykorzystanym narzędziom, a szare pola odpowiadają wygenerowanym plikom wyjściowym. Różne wyszukiwarki (MS-GF+ i X!Tandem) są oznaczone różnymi kolorami (odpowiednio czerwonym i fioletowym), a strzałki wskazują ich niezbędne dane wejściowe i wyjściowe. Zielone pole wyróżnia narzędzie generujące listę identyfikacji białek. W przypadku wygenerowania wielu plików wyjściowych, ten wykorzystany w kolejnych krokach jest zaznaczony jako najbliższy strzałce. Ten przepływ pracy jest dostępny bezpłatnie w Materialach Uzupełniających S2. Plik konfiguracyjny z domyślnymi parametrami X!Tandem jest dostępny w Materialach Uzupełniających S4. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
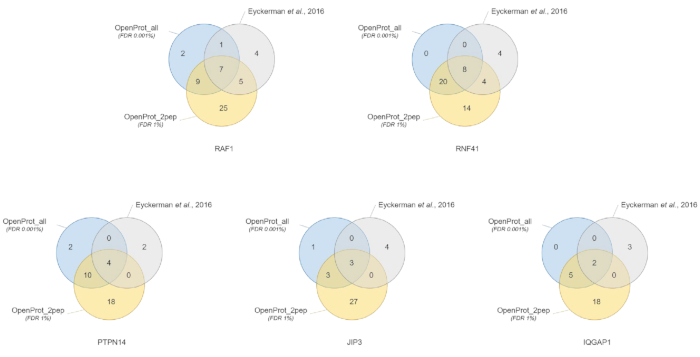
Rysunek 3: Porównanie identyfikacji interaktorów dla poszczególnych białek przynęty przy użyciu różnych baz danych. Diagramy Venna identyfikacji białek z wykorzystaniem najbardziej wiarygodnej bazy OpenProt (na pomarańczowo, dowody potwierdzające w postaci minimum 2 unikalnych peptydów, OpenProt_2pep) z FDR 1%, całej bazy OpenProt (na niebiesko, OpenProt_all) z FDR 0,001% lub zgodnie z raportem w oryginalnej pracy38 (na szaro). Każdy diagram odpowiada zidentyfikowanym interaktorom dla wymienionych białek przynęty: RAF1, RNF41, PTPN14, JIP3 oraz IQGAP1. Kliknij tutaj, aby zobaczyć powiększoną wersję tego rysunku.

Rycina 4: Widmo MS/MS zidentyfikowanego peptydu MDNLWAK(13C6) z nowego białka IP_637643. Intensywność jest względna (od 0 do 100%). Wybrane piki zaznaczono na czerwono, adnotacje jonów y są w kolorze ciemnoczerwonym, a adnotacje jonów b w kolorze zielonym. Wygenerowano w oprogramowaniu TOPPview34. Błąd prekursora = 2,70 ppm, wynik PEP = 0,12. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
| Termin | Definicja | Literatura |
| Alternatywna ramka odczytu (AltORF) | niekanoniczna ramka odczytu (ORF), która obecnie nie jest opisana w adnotacjach genomu, ale została opisana w OpenProt. | 15 |
| Referencyjna otwarta ramka odczytu (RefORF) | kanoniczna ORF adnotowana w adnotacjach genomowych oraz w OpenProt. | 15 |
| Alternatywne białka (AltProt) | nowe białko kodowane przez AltORF, bez istotnego podobieństwa do RefProt. Przedrostek numeru dostępu: IP_. | 15 |
| Białko referencyjne (RefProt) | białko obecnie adnotowane w bazach danych sekwencji białkowych, takich jak UniProtKB, Ensembl lub NCBI RefSeq, a także w OpenProt. | 15 |
| Nowa izoforma | nowe białko kodowane przez AltORF, wykazujące istotne podobieństwo do RefProt. Przedrostek numeru dostępu: II_. | 15 |
| Baza danych OpenProt_2pep | zawiera sekwencje wszystkich białek referencyjnych (RefProts) oraz nowych białek przewidzianych przez OpenProt, które zostały już wykryte przy użyciu minimum 2 unikalnych peptydów. | 15 |
| baza danych OpenProt_1pep | zawiera sekwencje wszystkich RefProtów oraz nowych białek przewidzianych przez OpenProt, które zostały już wykryte przy użyciu minimum 1 unikalnego peptydu. | 15 |
| Baza danych OpenProt_all | zawiera sekwencje wszystkich białek referencyjnych (RefProts) oraz nowych białek przewidzianych przez OpenProt. | 15 |
Tabela 1: Definicje terminów używanych w OpenProt oraz w całym protokole
Materiał uzupełniający S1: Przepływ pracy w programie Galaxy do obsługi bazy danych. Operacja ta dołączy sekwencje CRAPome oraz sekwencje decoy (odwrócone) do bazy wejściowej. Wynikiem jest plik Fasta. Kliknij tutaj, aby pobrać.
Materiał uzupełniający S2: Przepływ pracy w systemie Galaxy do identyfikacji białek. Służy on do identyfikacji białek z pliku danych spektrometrii mas przy użyciu dwóch wyszukiwarek (MS-GF+ oraz X!Tandem). Każdy parametr można dostosować według uznania przed uruchomieniem przepływu pracy. Kliknij tutaj, aby pobrać.
Materiał uzupełniający S3: Przepływ pracy Galaxy dla kwantyfikacji białek z wykorzystaniem znakowania stabilnymi izotopami (SIL). Narzędzie to służy do identyfikacji i kwantyfikacji białek z pliku danych spektrometrii mas przy użyciu dwóch silników wyszukiwania (MS-GF+ oraz X!Tandem). Każdy parametr można dostosować według uznania przed uruchomieniem przepływu pracy. Kliknij tutaj, aby pobrać.
Materiał uzupełniający S4: Plik konfiguracyjny parametrów domyślnych X!Tandem.Ten plik XML jest niezbędny do uruchomienia narzędzia X!TandemAdapter na platformie Galaxy. Prosimy kliknąć tutaj, aby pobrać.
Materiał uzupełniający S5: Ilościowe oznaczenia białek z zestawów danych iMixPro.Pliki danych z pracy Eyckerman i wsp. 201638 zostały przetworzone przy użyciu baz danych OpenProt i wyliczono ilość białek dla każdego wariantu. Jako przynęty (baits) zastosowano PTPN14, JIP3, IQGAP1, RAF1 oraz RNF41. Nazwy genów zaznaczone na zielono odpowiadają białkom zidentyfikowanym również w oryginalnej publikacji38. Nazwy genów zaznaczone na pomarańczowo odpowiadają znanym interaktorom według bazy BioGrid, które nie zostały opisane w oryginalnej publikacji. Nazwy genów zaznaczone na jasnoniebiesko odpowiadają nowym białkom zidentyfikowanym jako interaktory (odpowiedni numer dostępowy białka podano w nawiasach). Nazwy genów zaznaczone na jasnoszaro i pisane kursywą odpowiadają prawdopodobnym zanieczyszczeniom (białka keratyny). Kliknij tutaj, aby pobrać.
Materiał uzupełniający S6: Nowe białka zidentyfikowane w zbiorach danych iMixPro.Pliki danych z publikacji Eyckerman i wsp. 201638 zostały przetworzone przy użyciu baz danych OpenProt, a nowo zidentyfikowane białka są wymienione dla każdego warunku. Przynętami są PTPN14, JIP3, IQGAP1, RAF1 oraz RNF41. Wymieniono numery akcesyjne białek, zaczynające się od II_ dla nowych izoform znanego białka oraz od IP_ dla nowych białek z alternatywnej otwartej ramki odczytu (AltProt). Liczba peptydów potwierdzających jest podana w nawiasach. Kliknij tutaj, aby pobrać.
Dyskusja
Podczas analizy danych ze spektrometrów masowych jakość identyfikacji białek zależy częściowo od dokładności wykorzystanej bazy danych 6,20. Obecne podejścia tradycyjnie wykorzystują bazy danych UniProtKB, jednak wspierają one model adnotacji genomu pojedynczego ORF na transkrypt i minimalnej długości 100 kodonów (z wyjątkiem wcześniej zademonstrowanych przykładów)40. Liczne badania łączą niedociągnięcia takich baz danych z odkryciem funkcjonalnych ORF z rzekomo niekodujących regionów 8,11,12,13. Teraz OpenProt pozwala na bardziej wyczerpującą identyfikację białek, ponieważ pobiera sekwencje białek z wielu adnotacji transkryptomu. OpenProt pobiera transkryptomy NCBI RefSeq (GRCh38.p7) i Ensembl (GRCh38.83) oraz adnotacje UniProtKB (UniProtKB-SwissProt, 2017-09-27)40,42,43. Ponieważ obecne adnotacje w niewielkim stopniu się pokrywają, OpenProt wyświetla bardziej wyczerpujący obraz potencjalnego krajobrazu proteomicznego niż w przypadku ograniczenia do jednej adnotacji15.
Ponadto, ponieważ OpenProt wymusza model policistroniczny, pozwala na wiele adnotacji białek na transkrypt. Ze względów statystycznych i obliczeniowych OpenProt nadal utrzymuje minimalny próg długości wynoszący 30 kodonów15. Przewiduje jednak tysiące nowych sekwencji białek, poszerzając tym samym zakres możliwości identyfikacji białek. Dzięki takiemu podejściu OpenProt wspiera odkrycia proteomiczne w bardziej systematyczny sposób.
Na jakość identyfikacji białek mogą mieć również wpływ stosowane parametry. Analizy proteomiczne oparte na stwardnieniu rozsianym zazwyczaj zawierają 1% białka FDR. Jednak cała baza danych OpenProt zawiera około 6 razy więcej wpisów (rysunek 1). Aby uwzględnić ten znaczny wzrost przestrzeni wyszukiwania, zalecamy użycie bardziej rygorystycznego FDR wynoszącego 0,001%. Parametr ten został zoptymalizowany przy użyciu badań porównawczych i ręcznej oceny losowo wybranych widm15. Fałszywie dodatnie wyniki są jednak nadal możliwe, dlatego zachęcamy do dokładnej kontroli i walidacji dowodów potwierdzających istnienie nowego białka. Zalecanym standardem może być identyfikacja białka z dwóch różnych serii stwardnienia rozsianego, ponieważ dane podstawowe i wyniki fałszywie dodatnie różnią się w zależności od zestawu danych15.
Dostarczony tutaj rurociąg i wykorzystany w studium przypadku może być dowolnie modyfikowany, aby dopasować go do projektu i parametrów eksperymentu. Zalecamy korzystanie z wielu wyszukiwarek, ponieważ zwiększa to czułość i czułość identyfikacji peptydów32. Ponadto zachęcamy do korzystania z bazy danych najlepiej odpowiadającej celowi eksperymentu (rysunek 1). Ponieważ korzystanie z całej bazy danych OpenProt jest zgodne z rygorystycznym FDR, prawdziwa identyfikacja może zostać utracona. W związku z tym cała baza danych powinna być przeznaczona do odkrywania nowych białek, podczas gdy klasyczne profilowanie proteomiczne powinno wykorzystywać mniejsze bazy danych OpenProt (takie jak OpenProt_2pep użyte w powyższym studium przypadku).
OpenProt obecnie przewiduje sekwencje rozpoczynające się od kodonu ATG, podczas gdy kilka badań podkreśliło inicjację translacji w innych kodonach44,45. Gdy nowe białko jest identyfikowane przez jeden lub kilka unikalnych peptydów, możliwe jest, że prawdziwym kodonem inicjacyjnym nie jest przypuszczalny ATG. Użytkownicy mogą szukać dowodów tłumaczenia na stronie internetowej OpenProt. Obecnie OpenProt raportuje zdarzenia translacji tylko wtedy, gdy dotyczą one całej przewidywanej sekwencji białek (100% pokrywania się)15. Tak więc brak dowodów translacji nie oznaczałby, że białko nie ulega translacji, ale że kodon start może nie być domniemanym ATG.
Pomimo obecnych ograniczeń, OpenProt oferuje bardziej wyczerpujące spojrzenie na potencjał kodowania genomów eukariotycznych. Bazy danych OpenProt sprzyjają odkryciom proteomicznym oraz zrozumieniu funkcji i interakcji proteomicznych. Przyszły rozwój bazy danych OpenProt będzie obejmował adnotację innych gatunków, dowody translacji z kodonu startowego innego niż ATG oraz opracowanie linii produkcyjnej w celu włączenia nowych białek do badań sekwencjonowania całego genomu i egzomu.
Oświadczenia
Autorzy deklarują brak konfliktu interesów.
Podziękowania
Dziękujemy Vivian Delcourt za pomoc, dyskusje i rady dotyczące tej pracy. X.R. jest członkiem wspieranego przez Fonds de Recherche du Québec Santé (FRQS) Centre de Recherche du Centre Hospitalier Universitaire de Sherbrooke. Badania te były wspierane przez Kanadyjską Katedrę Badań nad Proteomiką Funkcjonalną i Odkrywaniem Nowych Białek w ramach grantu X.R. i CIHR MOP-137056. Dziękujemy zespołowi Calcul Québec i Compute Canada za wsparcie w zakresie wykorzystania superkomputera mp2 firmy Université de Sherbrooke. Eksploatacja superkomputera mp2 jest finansowana przez Canada Foundation of Innovation (CFI), le ministère de l'Économie, de la science et de l'innovation du Québec (MESI) oraz les Fonds de Recherche du Québec - Nature et technologies (FRQ-NT). Serwer Galaxy, który został wykorzystany do niektórych obliczeń proteomicznych, jest częściowo finansowany przez Collaborative Research Centre 992 Medical Epigenetics (grant DFG SFB 992/1 2012) i niemieckie Federalne Ministerstwo Edukacji i Badań (BMBF granty 031 A538A/A538C RBC, 031L0101B/031L0101C de. NBI-epi, 031L0106 de. STAIR (de. NBI)).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Witryna internetowa OpenProt | open source | n/a | www.openprot.org |
| Galaxy Server | open source | nie dotyczy | https://usegalaxy.eu/ |
| TOPPwyświetl oprogramowanie | open source | nie dotyczy | www.openms.de |
Bibliografia
- Kim, M. S., et al. A draft map of the human proteome. Nature. 509 (7502), 575-581 (2014).
- Wilhelm, M., et al. Mass-spectrometry-based draft of the human proteome. Nature. 509 (7502), 582-587 (2014).
- Hein, M. Y., et al. A human interactome in three quantitative dimensions organized by stoichiometries and abundances. Cell. 163 (3), 712-723 (2015).
- Huttlin, E. L., et al. The BioPlex Network: A Systematic Exploration of the Human Interactome. Cell. 162 (2), 425-440 (2015).
- Huttlin, E. L., et al. Architecture of the human interactome defines protein communities and disease networks. Nature. 545 (7655), 505-509 (2017).
- Kumar, D., Yadav, A. K., Dash, D. Choosing an Optimal Database for Protein Identification from Tandem Mass Spectrometry Data. Proteome Bioinformatics. , 17-29 (2017).
- Jeong, K., Kim, S., Bandeira, N. False discovery rates in spectral identification. BMC Bioinformatics. 13 (Suppl 16), (2012).
- Brunet, M. A., Levesque, S. A., Hunting, D. J., Cohen, A. A., Roucou, X. Recognition of the polycistronic nature of human genes is critical to understanding the genotype-phenotype relationship. Genome Research. , (2018).
- Brent, M. R. Genome annotation past, present, and future: how to define an ORF at each locus. Genome Research. 15 (12), 1777-1786 (2005).
- Harrow, J., et al. GENCODE: The reference human genome annotation for The ENCODE Project. Genome Research. 22 (9), 1760-1774 (2012).
- Samandi, S., et al. Deep transcriptome annotation enables the discovery and functional characterization of cryptic small proteins. eLife. 6, e27860 (2017).
- Saghatelian, A., Couso, J. P. Discovery and characterization of smORF-encoded bioactive polypeptides. Nature Chemical Biology. 11 (12), 909-916 (2015).
- Delcourt, V., Staskevicius, A., Salzet, M., Fournier, I., Roucou, X. Small Proteins Encoded by Unannotated ORFs are Rising Stars of the Proteome, Confirming Shortcomings in Genome Annotations and Current Vision of an mRNA. Proteomics. , (2017).
- Plaza, S., Menschaert, G., Payre, F. In Search of Lost Small Peptides. Annual Review of Cell and Developmental Biology. 33 (1), (2017).
- Brunet, M. A., et al. OpenProt: a more comprehensive guide to explore eukaryotic coding potential and proteomes. Nucleic Acids Research. , (2018).
- Afgan, E., et al. The Galaxy platform for accessible, reproducible and collaborative biomedical analyses: 2016 update. Nucleic Acids Research. 44 (W1), W3-W10 (2016).
- Afgan, E., et al. The Galaxy platform for accessible, reproducible and collaborative biomedical analyses: 2018 update. Nucleic Acids Research. 46, W537-W544 (2018).
- Sturm, M., et al. OpenMS – An open-source software framework for mass spectrometry. BMC Bioinformatics. 9 (1), 163(2008).
- Carithers, L. J., et al. A Novel Approach to High-Quality Postmortem Tissue Procurement: The GTEx Project. Biopreservation and Biobanking. 13 (5), 311-319 (2015).
- Aebersold, R., Mann, M. Mass spectrometry-based proteomics. Nature. 422 (6928), 6928(2003).
- Domon, B., Aebersold, R. Mass Spectrometry and Protein Analysis. Science. 312 (5771), 212-217 (2006).
- Hu, J., Coombes, K. R., Morris, J. S., Baggerly, K. A. The importance of experimental design in proteomic mass spectrometry experiments: Some cautionary tales. Briefings in Functional Genomics. 3 (4), 322-331 (2005).
- Wu, P. Y., Phan, J. H., Wang, M. D. Assessing the impact of human genome annotation choice on RNA-seq expression estimates. BMC Bioinformatics. 14 (11), S8(2013).
- Mellacheruvu, D., et al. The CRAPome: a contaminant repository for affinity purification-mass spectrometry data. Nature Methods. 10 (8), 730-736 (2013).
- Adusumilli, R., Mallick, P. Data Conversion with ProteoWizard msConvert. Proteomics: Methods and Protocols. , 339-368 (2017).
- French, W. R., et al. Wavelet-Based Peak Detection and a New Charge Inference Procedure for MS/MS Implemented in ProteoWizard’s msConvert. Journal of Proteome Research. 14 (2), 1299-1307 (2015).
- Kuenzi, B. M., et al. APOSTL: An Interactive Galaxy Pipeline for Reproducible Analysis of Affinity Proteomics Data. Journal of Proteome Research. 15 (12), 4747-4754 (2016).
- Hoekman, B., Breitling, R., Suits, F., Bischoff, R., Horvatovich, P. msCompare: a framework for quantitative analysis of label-free LC-MS data for comparative candidate biomarker studies. Molecular & Cellular Proteomics: MCP. 11 (6), (2012).
- Bjornson, R. D., et al. X!!Tandem, an improved method for running X!tandem in parallel on collections of commodity computers. Journal of Proteome Research. 7 (1), 293-299 (2008).
- Kim, S., Pevzner, P. A. MS-GF+ makes progress towards a universal database search tool for proteomics. Nature Communications. 5, 5277(2014).
- Vaudel, M., Barsnes, H., Berven, F. S., Sickmann, A., Martens, L. SearchGUI: An open-source graphical user interface for simultaneous OMSSA and X!Tandem searches. Proteomics. 11 (5), 996-999 (2011).
- Shteynberg, D., Nesvizhskii, A. I., Moritz, R. L., Deutsch, E. W. Combining results of multiple search engines in proteomics. Molecular & Cellular Proteomics: MCP. 12 (9), 2383-2393 (2013).
- Bittremieux, W., et al. Quality control in mass spectrometry-based proteomics. Mass Spectrometry Reviews. 37 (5), 697-711 (2018).
- Bertsch, A., Gröpl, C., Reinert, K., Kohlbacher, O. OpenMS and TOPP: Open Source Software for LC-MS Data Analysis. Data Mining in Proteomics: From Standards to Applications. , 353-367 (2011).
- Pfeuffer, J., et al. OpenMS – A platform for reproducible analysis of mass spectrometry data. Journal of Biotechnology. 261, 142-148 (2017).
- Kozak, M. Pushing the limits of the scanning mechanism for initiation of translation. Gene. 299 (1-2), 1-34 (2002).
- Noderer, W. L., et al. Quantitative analysis of mammalian translation initiation sites by FACS-seq. Molecular Systems Biology. 10, 748(2014).
- Eyckerman, S., et al. Intelligent Mixing of Proteomes for Elimination of False Positives in Affinity Purification-Mass Spectrometry. Journal of Proteome Research. 15 (10), 3929-3937 (2016).
- Vizcaíno, J. A., et al. 2016 update of the PRIDE database and its related tools. Nucleic Acids Research. 44 (D1), D447-D456 (2016).
- Bateman, A., et al. UniProt: the universal protein knowledgebase. Nucleic Acids Research. 45 (D1), D158-D169 (2017).
- The Gene Ontology Consortium Expansion of the Gene Ontology knowledgebase and resources. Expansion of the Gene Ontology knowledgebase and resources. Nucleic Acids Research. 45 (D1), D331-D338 (2017).
- O’Leary, N. A., et al. Reference sequence (RefSeq) database at NCBI: current status, taxonomic expansion, and functional annotation. Nucleic Acids Research. 44, D733-D745 (2016).
- Zerbino, D. R., et al. Ensembl 2018. Nucleic Acids Research. 46 (D1), D754-D761 (2018).
- Andreev, D. E., et al. Translation of 5’ leaders is pervasive in genes resistant to eIF2 repression. eLife. 4, e03971(2015).
- Jackson, R., et al. The translation of non-canonical open reading frames controls mucosal immunity. Nature. 564, 434-438 (2018).
Przedruki i uprawnienia
