Przedstawiamy portal internetowy CorExplorer, zasób do eksploracji czynników sekwencjonowania RNA nowotworów znalezionych przez algorytm uczenia maszynowego CorEx (Correlation Explanation) i pokazujemy, jak można analizować czynniki związane z przeżyciem, adnotacjami w bazie danych, interakcjami białko-białko i sobą nawzajem, aby uzyskać wgląd w biologię nowotworu i interwencje terapeutyczne.
Artykuł metodologiczny
Analiza czynników ekspresji genów nowotworowych za pomocą portalu internetowego CorExplorer
W tym artykule
Podsumowanie
Streszczenie
Różnicowa analiza ekspresji genów jest ważną techniką dla zrozumienia stanów chorobowych. Algorytm uczenia maszynowego CorEx okazał się przydatny w analizie różnicowej ekspresji grup genów w sekwencyjnym RNA guza w sposób, który może być pomocny w rozwoju onkologii precyzyjnej. Jednak CorEx wytwarza wiele czynników, które mogą być trudne do przeanalizowania i połączenia z istniejącym zrozumieniem. Aby ułatwić takie połączenia, zbudowaliśmy stronę internetową CorExplorer, która umożliwia użytkownikom interaktywną eksplorację danych i odpowiadanie na często zadawane pytania związane z ich analizą. Przeszkoliliśmy CorEx na danych dotyczących ekspresji genów sekwencyjnych RNA dla czterech typów nowotworów: jajnika, płuc, czerniaka i jelita grubego. Następnie włączyliśmy do strony internetowej odpowiednie przeżycia, interakcje białko-białko, wzbogacenie szlaków Gene Ontology (GO) i Kyoto Encyclopedia of Genes and Genomes (KEGG) oraz mapy cieplne w celu powiązania z wizualizacją wykresu czynnikowego. W tym miejscu wykorzystujemy przykładowe protokoły, aby zilustrować wykorzystanie bazy danych do zrozumienia znaczenia poznanych czynników nowotworowych w kontekście tych danych zewnętrznych.
Wprowadzenie
Od czasu wprowadzenia nieco ponad dekadę temu, sekwencja RNA stała się wszechobecnym narzędziem do pomiaru ekspresji genów1. Dzieje się tak dlatego, że umożliwia szybkie i tanie profilowanie de novo całego transkryptomu próbki. Jednak dane dotyczące guza z sekwencją RNA odzwierciedlają podstawową biologię, która jest wewnętrznie złożona i często niedostatecznie próbkowana, podczas gdy same dane są wielowymiarowe i zaszumione. Stanowi to poważne wyzwanie dla ekstrakcji wiarygodnych sygnałów. Algorytm CorEx wykorzystuje wielowymiarowe informacje wzajemne, aby znaleźć subtelne wzorce w takich sytuacjach2,3 . Technika ta została wcześniej zaadaptowana do analizy próbek RNA guza jajnika z Atlasu Genomu Raka (TCGA) i w tym kontekście wydaje się, że ma znaczące zalety w porównaniu z częściej stosowanymi metodami analizy4.
Chociaż użycie sekwencjonowania RNA jest niezwykle rozpowszechnione w zastosowaniach badawczych, w tym w onkologii, wysiłki te nie doprowadziły do szerokiego zastosowania dla celów interwencji klinicznych5. Jednym z powodów takiego stanu rzeczy jest brak przyjaznych dla użytkownika algorytmów i oprogramowania ukierunkowanego na te konkretne problemy. Aby wypełnić tę lukę, zaprojektowaliśmy portal internetowy CorExplorer, aby umożliwić naukowcom z różnych środowisk badanie czynników ekspresji genów w próbkach sekwencyjnych RNA guza, znalezionych przez algorytm uczenia maszynowego CorEx. Portal CorExplorer obsługuje interaktywną wizualizację i odpytywanie czynników z kilku różnych typów nowotworów, w tym płuc, okrężnicy, czerniaka i jajnika6,7,8,9,10, z zamiarem pomocy badaczom w przesiewaniu korelacji danych i identyfikowaniu potencjalnych ścieżek stratyfikacji pacjentów do celów terapeutycznych.
Spodziewamy się, że portal CorExplorer może być przydatny dla kilku typów użytkowników. Portal został zaprojektowany z myślą o użytkownikach, którzy chcą zrozumieć szerokie czynniki wpływające na różnice w ekspresji genów nowotworowych w publicznych bazach danych, a być może także umieścić indywidualne profile ekspresji genów w kontekście nowotworów o podobnej charakterystyce. Oprócz przedstawionych tutaj reprezentatywnych protokołów, badania CorExplorer mogą służyć jako punkt wyjścia do sugerowania hipotez do dalszych testów, porównywania i kontrastowania wyników CorEx na zestawach danych poza CorExplorer oraz do łączenia patologicznych sygnatur ekspresji jednego lub kilku genów w pojedynczym guzie z większymi grupami, które mogą być skoordynowanie dotknięte. Wreszcie, może służyć jako przyjazne dla użytkownika wprowadzenie do zastosowania uczenia maszynowego do sekwencjonowania RNA dla osób rozpoczynających pracę w tej dziedzinie.
Protokół
1. Badanie czynników zawierających interesujący nas gen
- Otwórz przeglądarkę internetową i przejdź do http://corex.isi.edu, strony głównej CorExplorer.
- Po prawej stronie, w sekcji Szybkie linki, kliknij przycisk + rozwiń obok pozycji Jajnik (TCGA-OV), aby wyświetlić podsumowanie wykresu czynnika CorEx, który został wytrenowany na danych dotyczących raka jajnika TCGA (pokazanych w Rysunek 1). Opcjonalnie kliknij inne, aby porównać.
- Po zakończeniu sprawdzania wykresów czynników kliknij Płuca (TCGA-LUAD), aby uzyskać dostęp do strony CorExplorer dla sekwencji RNA raka płuc.
- Zapoznaj się z wykresem czynnika CorEx dla interesującego genu za pomocą okna "Wykres czynnika" CorExplorer.
- Najedź kursorem myszy na okno wyświetlania wykresu czynnikowego. Powiększ wykres czynników za pomocą kółka przewijania myszy lub gładzika, aby zobaczyć szczegóły wykresu, takie jak najważniejsze geny w każdym czynniku i połączenia między węzłami na różnych warstwach. Możesz też kliknąć i przeciągnąć, aby przesunąć obszar obserwacji lub dowolny węzeł.
- Aby znaleźć gen docelowy (tutaj użyjemy BRCA1), kliknij menu rozwijane Gen w górnej części okna wykresu czynnikowego. Wpisz "BRCA1", aby wybrać go z listy rozwijanej i naciśnij Return, aby powiększyć widok do czynnika 26, współczynnika, z którym BRCA1 jest najsilniej skorelowany.
- Umieść kursor myszy na ekranie wykresu i przewiń, aby pomniejszyć, aby wyświetlić węzeł poziomu 2, L2_8 i skojarzone z nim czynniki, które są sąsiadami czynnika 26. Należy pamiętać, że wyświetlane są tylko geny o wadze większej niż próg wskazany na suwaku Min link weight.
- Aby zobaczyć wszystkie geny powiązane z tym czynnikiem, kliknij węzeł L1_26 i wybierz opcję Załaduj dodatkowe geny w wyskakującym okienku. Gdy pojawi się słowo "Gotowe", zamknij wyskakujące okienko.
- Teraz wróć do sekcji nagłówka nad oknem wykresu czynnikowego i chwyć i przeciągnij modyfikator Min. Teraz, gdy suwak wagi ogniwa zostanie przesunięty w dół do 0,05, inne geny czynnika L1_26, w tym BRCA2, pojawią się w kolejności wagowej. Opcjonalnie zmień położenie węzłów, chwytając i przeciągając, aby poprawić układ.
- Określ, w jaki sposób stratyfikacja pacjentów w odniesieniu do czynnika wpływa na przeżycie, pytając w oknie przeżycia.
- W oknie przeżycia odznacz opcję Sortuj według p-wartość, a następnie wybierz czynnik 26 z menu rozwijanego Pojedynczy czynnik, aby wyświetlić krzywe przeżycia dla czynnika 26.
- Przewiń w dół wykres przeżycia, aby pokazać liczbę zagrożonych pacjentów wzdłuż osi x.
- Znajdź powiązania z funkcją biologiczną, wysyłając zapytanie w oknie Adnotacja.
- W oknie adnotacji, aby posortować menu rozwijane Czynnik według numeru czynnika, a nie wskaźnika fałszywych wykryć (FDR), usuń zaznaczenie opcji Sortowanie FDR.
- Przewiń i kliknij, aby wybrać czynnik 26 z listy rozwijanej okna adnotacji, aby wyświetlić adnotacje wzbogacenia dla współczynnika.
- Przewiń listę adnotacji w dół, aż widoczna będzie naprawa DNA, a następnie kliknij ją, aby natychmiast zobaczyć powiązane geny podświetlone na żółto na ekranie wykresu. Zobacz środkowy panel Rysunek 2.
- Należy zauważyć, że czynniki znikają lub pojawiają się w miarę wybierania różnych terminów GO, w zależności od tego, czy są one wzbogacone o geny z wybraną adnotacją, np. "wewnętrzny apoptotyczny szlak sygnałowy w odpowiedzi na uszkodzenie DNA".
- Zapoznaj się z tymi czynnikami, dodając okna o różnych funkcjach.
- Na górnym pasku menu dodaj okno sieci interakcji białko-białko (PPI), wybierając PPI z listy rozwijanej Dodaj okno, a następnie kliknij przycisk Dodaj, aby dodać okno wykresu PPI do obszaru wyświetlania. W oknie wykresu PPI wybierz współczynnik "Warstwa1: 26", aby pokazać interakcje białko-białko. Zwróć uwagę na gęstość połączeń.
- Na górnym pasku menu, zamiast PPI, wybierz Mapa ciepła z listy rozwijanej Dodaj okno, a następnie kliknij przycisk Dodaj, aby dodać okno mapy ciepła do obszaru wyświetlania. W oknie mapy cieplnej wybierz współczynnik "Warstwa1: 26", aby wyświetlić wzorce ekspresji genów.
- Chwyć i zmień położenie okna mapy cieplnej tak, aby okno przetrwania było również widoczne. Wzdłuż górnej części mapy cieplnej obserwuj, jak pomarańczowy/niebieski/szary pasek odpowiada warstwom ryzyka pacjenta na wykresie przeżycia. Wyniki są pokazane na dole Rysunek 2.
- Zapoznaj się z wykresem czynnika CorEx dla interesującego genu za pomocą okna "Wykres czynnika" CorExplorer.
2. Filtrowanie i interpretacja czynników CorEx na podstawie danych o wadze genów, przeżyciu i adnotacjach
- Filtrowanie pod kątem czynników zainteresowania przy użyciu przeżycia i jakości klastra.
- Z menu rozwijanego Dataset (Zestaw danych) u góry wybierz TCGA_OVCA, aby przejść do strony CorExplorer dla sekwencji RNA raka jajnika TCGA.
- Po załadowaniu strony należy zauważyć w oknie przeżycia, że współczynnik o największej różnicy przeżycia dla różnych warstw wynosi 114.
- W górnej części okna wykresu czynników wybierz "Warstwa1: 114" z listy rozwijanej Czynnik.
- Chwyć suwak wagi linku za pomocą myszy i przesuń go w górę do 0.5. Należy zauważyć, że duża liczba genów w czynniku 114 (1609), z których żaden nie ma masy >0,35, wskazuje na stosunkowo słabe grupowanie.
- Następnie należy rozwinąć listę czynników w oknie przeżycia i wybrać następny najlepszy czynnik z listy rozwijanej okna przeżycia, czynnik 39, aby wyświetlić powiązane z nim krzywe przeżycia.
- Wybierz czynnik 39 w oknie adnotacji, klikając na niego. Pokazane są znaczące adnotacje GO i KEGG.
- Aby lepiej zrozumieć biologiczną rolę genów w czynniku 39, zinterpretuj czynniki za pomocą informacji o adnotacjach sąsiedztwa w następujący sposób.
- W górnej części okna wykresu czynnika wybierz czynnik "Warstwa1: 39" z listy rozwijanej współczynnika. Następnie najedź myszką na okno wykresu czynnikowego i pomniejsz je, aby odsłonić cały klaster L2_14 z 6 czynnikami: 14, 32, 39, 42, 52 i 82 (pokazanymi w Rysunek 3).
- Aby zrozumieć względne znaczenie czynników związanych z węzłem L2_14, zacznij od wyświetlenia różnic w przeżywalności dla każdego z L2_14 czynników. Usuń zaznaczenie opcji Sortuj według p-val w oknie przetrwania, a następnie kliknij kolejno na każdą z liczb czynników. Robiąc to, zwróć uwagę, że tylko czynniki 14, 32 i 39 wykazują związek z przeżyciem.
- Teraz z górnego paska menu ponownie wybierz PPI z listy rozwijanej Dodaj okno. Naciśnij przycisk Dodaj, aby dodać okno wykresu PPI do obszaru wyświetlania. W oknie wykresu PPI wybierz współczynnik "Warstwa1: 52", aby pokazać interakcje białko-białko, które są istotne. Przykładowy układ okien w tym miejscu pokazany jest w Rysunek 3.
- Kliknij łącze View at StringDB (Wyświetl w bazie danych StringDB) u dołu okna PPI, aby połączyć się z internetową bazą danych StringDB. Kliknij przycisk Kontynuuj na pierwszym ekranie, a następnie wybierz kartę Analiza poniżej wykresu sieci, tak jak poprzednio, aby uzyskać analizę GO online dla genów sieci PPI. Najważniejszym składnikiem komórkowym jest "kompleks białkowy MHC klasy II".
- Wróć do zakładki CorExplorer i okna PPI i wybierz współczynnik 32, tym razem z listy rozwijanej współczynnika. Kliknij łącze Wyświetl w bazie danych StringDB do analizy bazy danych StringDB. Najważniejszym składnikiem komórkowym jest "kompleks białkowy MHC klasy I", w przeciwieństwie do klasy II dla czynnika 52 w poprzednim kroku!
- Na koniec wróć do okna PPI i wybierz "Warstwa 1: 39" z menu rozwijanego czynnika u góry. Kliknij łącze Wyświetl w bazie danych StringDB, aby utworzyć łącze do analizy bazy danych StringDB.
- Kliknij przycisk Kontynuuj na pierwszym ekranie, a następnie wybierz kartę Analiza poniżej wykresu sieci, aby uzyskać analizę GO online dla genów sieci PPI. Zauważ, że główną funkcją molekularną jest "wiązanie receptora chemokiny CXCR3".
3. Korzystanie z adnotacji o przeżyciu i bazie danych w celu poszukiwania obiecujących kombinacji terapeutycznych
- Przełącz się na CorExplorer czerniaka TCGA, wybierając TCGA_SKCM z menu rozwijanego Dataset (Zestaw danych).
- Należy zauważyć, że czynnikiem o największej różnicy przeżycia jest czynnik 171. Zbadaj adnotacje czynnika 171, przewijając i zauważ, że "odpowiedź immunologiczna" i "szlak sygnałowy za pośrednictwem cytokin" znajdują się na górze (tak jak w przypadku najwyższego czynnika jajnika).
- Aby znaleźć czynnik komplementarny, należy zapoznać się z najważniejszymi czynnikami związanymi z przeżyciem wraz z ich najważniejszymi terminami adnotacji. Aby to zrobić, kliknij link Przegląd zbioru danych na górnym pasku menu, aby otworzyć osobną zakładkę zawierającą tabelę ze szczegółami przetwarzania zbioru danych, a także podsumowanie najważniejszych czynników według wartości p różnicy przeżycia. Należy pamiętać, że pierwszym czynnikiem nieimmunologicznym jest 88.
- Wróć do karty przeglądarki TCGA_SKCM.
- Wybierz współczynnik 88 w oknach przeżycia, adnotacji i wykresu. Kilka najpopularniejszych terminów GO jest związanych z "przetwarzaniem rRNA" i "organizacją mitochondrium", co potwierdza, że różni się od czynników związanych z odpornością.
- W oknie przeżycia, na liście rozwijanej sparowanych czynników, wybierz "88_171", aby zobaczyć, jak poprawia się przeżycie pacjentów z warstwy środkowej dla połączonych czynników ekspresji 171 i 88. Adnotacje i porównania przeżycia są zilustrowane na Rysunek 4.
4. Znajdowanie podobieństw i różnic w zmienności ekspresji genów w różnych typach nowotworów za pomocą strony Szukaj
- Kliknij nagłówek CorExplorer, aby powrócić do strony głównej.
- Kliknij Szukaj na górnym pasku menu, aby przejść do strony umożliwiającej przeszukiwanie wszystkich zestawów danych w witrynie CorExplorer.
- W polu wyszukiwania genów wpisz "FLT1" (VEGFR1) i naciśnij Return lub naciśnij Szukaj. FLT1 występuje ze stosunkowo dużą masą w następujących czynnikach: OVCA - 76, LUAD - 162, SKCM - 195 i SKCM - 184, a także COAD - 112 i COAD - 74.
- Możesz też wyszukać powiązany termin języka GO we wszystkich zestawach danych. Spróbuj tego w polu "GO Search", wpisując "angiogeneza" i naciskając Return lub naciskając Szukaj. Wszystkie czynniki FLT1, z wyjątkiem SKCM-195, są wymienione jako statystycznie wzbogacone dla genów "angiogenezy" – czynnik 195 w rzeczywistości ma adnotację, ale poniżej domyślnego progu 10-8. Wyniki wyszukiwania dla tego i poprzedniego kroku są pokazane w Rysunek 5.
- Jako dalsze przykłady, w polu wyszukiwania GO najpierw wpisz "receptor naskórkowego czynnika wzrostu". Tylko LUAD jest wzbogacony o ten termin, dobrze znany czynnik stratyfikacji raka płuc. Następnie wpisz "mezenchymalny" w polu wyszukiwania. Termin ten jest wzbogacony w grupy ekspresji genów dla OVCA, gdzie jest dobrze zbadanym czynnikiem stratyfikacji.
Wyniki
Wyszukiwanie genu „BRCA1” w zbiorze danych dotyczącym raka płuca wykazuje, że jest on najsilniej powiązany z czynnikiem CorEx 26 (Rysunek 2). Wzbogacenie terminów GO dla tego czynnika jest niezwykle wysokie, przy czym naprawa DNA wykazuje FDR na poziomie zaledwie 1 x 10-19. Wybór ten zwraca również uwagę na klaster drugiego poziomu L2_8, który posiada sześć blisko powiązanych czynników jako elementy potomne. Wybranie terminu „DNA repair” w adnotacjach GO lub w rozwijanym menu wzbogacenia GO na grafie czynników podświetla powiązane geny w każdym z czynników, przy czym czynnik 26 posiada ich zdecydowanie najwięcej, zgodnie z oczekiwaniami11. Sieć oddziaływań białko-białko jest silnie połączona, co dodatkowo potwierdza ściśle powiązaną funkcjonalność genów w czynniku 26. Powiązany wykres przeżycia sugeruje możliwą korelację z przeżywalnością pacjentów, jednak wymagałoby to potwierdzenia w większym zbiorze danych.
Rozpoczęcie analizy od przeżywalności pozwala na badanie przyczyn poprawy przeżywalności związanej z konkretnymi grupami ekspresji genów. Na przykład głównym czynnikiem wpływającym na przeżywalność w raku jajnika jest czynnik nr 39, który wykazuje silne wzbogacenie w genach związanych z układem odpornościowym (Rysunek 3). Pięć innych czynników powiązanych z tym samym węzłem poziomu 2 również jest wskazanych jako związane z odpornością, jednak wpływ na przeżywalność wydaje się być wśród nich bardzo zróżnicowany, przy czym czynnik 39 ma najwyższy, a czynnik 52 najniższy wpływ. Dodanie okna interakcji białko-białko dla danego czynnika pokazuje bezpośrednią sieć interakcji i umożliwia przejście do strony StringDB12 w celu sprawdzenia różnych wzbogaceń dla genów w sieci PPI. Przeprowadzając taką analizę dla każdego z czynników L2_14 po kolei, można stwierdzić, że wzbogacenia StringDB dla genów sieci PPI sugerują następujące możliwe wyjaśnienie powiązań z przeżywalnością. Czynnik 32 zawiera geny tworzące kompleks białkowy głównego układu zgodności tkankowej (MHC) klasy I, który jest rozpoznawany przez cytotoksyczne limfocyty T. Czynnik 39 odpowiada sygnalizacji cytokin i wiązaniu receptora CXCR3, co jest związane z limfocytami T CD8+. Oba te czynniki wydają się zapewniać znaczną przewagę w przeżywalności pacjentom wykazującym stosunkowo wysoką ekspresję odpowiadających im genów. Cytotoksyczne limfocyty T CD8+ są główno odpowiedzialne za odporność przeciwnowotworową. Z kolei czynnik 52 składa się z genów kodujących białka kompleksu MHC klasy II, które są rozpoznawane głównie przez pomocnicze limfocyty T CD4+, a nie bezpośrednio przez cytotoksyczne limfocyty T. Pozostałe czynniki L2_14 odzwierciedlają ogólną aktywację układu odpornościowego, która nie różnicuje tych dwóch populacji limfocytów. Powiązanie przeżywalności specyficzne dla rozpoznawania komórkowych antygenów MHC klasy I przez cytotoksyczne limfocyty T jest zgodne z naszą wiedzą o odporności przeciwnowotworowej w ujęciu ogólnym oraz z obserwacjami w innych nowotworach, takich jak czerniak13,14.
Portal internetowy wspiera odkrywanie par czynników o komplementarnych funkcjach, co może sugerować skuteczne, specyficzne dla guza terapie skojarzone. Przegląd zbioru danych pozwala na wyszukiwanie czynników, które korelują z przeżywalnością, a jednocześnie wykazują odmienne wzbogacenia GO. W przypadku czerniaka (TCGA_SKCM; Rycina 4) widać, że najważniejszy czynnik przeżywalności 171 jest związany z odpornością, podczas gdy czynnik 88, znajdujący się niżej na liście, wykazuje wzbogacenie w geny związane z organizacją mitochondriów. Rzeczywiście, zostało to zasugerowane jako cel terapeutyczny w czerniaku15. Dodanie okien przeżywalności na stronie CorExplorer umożliwia porównanie stratyfikacji z użyciem pary czynników do stratyfikacji dla każdego czynnika z osobna, co pokazuje, że korzystne wzorce ekspresji genów z obu grup wykazują trend przeżywalności lepszy niż w przypadku każdego z czynników osobno. Najwyższa warstwa nie wydaje się jednak ulec poprawie, co sugeruje, że sama immunoterapia może być najlepszą opcją dla niektórych pacjentów.
Podobieństwa i różnice między nowotworami można zaobserwować, przeszukując zestawy danych pod kątem genów lub terminów GO (Rysunek 5). Jako przykład, FLT1 (znany również jako VEGFR1) jest dobrze przebadanym markerem proangiogennym16,17. Po wpisaniu go w pasek wyszukiwania okazuje się, że wszystkie nowotwory posiadają czynniki, w których FLT1 odgrywa istotną rolę. Odwrotnie, po wprowadzeniu terminu GO „angiogenesis” na stronie wyszukiwania, 5 z 6 grup FLT1 pojawia się z tym wzbogaceniem. Wszystkie czynniki FLT1, z wyjątkiem SKCM-195, są wymienione jako statystycznie wzbogacone o geny związane z „angiogenesis”. Szósty czynnik faktycznie posiada tę adnotację, ale znajduje się on poniżej domyślnego progu 10-8. Gdy w alternatywnym kalkulatorze wzbogaceń, np. Gene Set Enrichment Analysis (GSEA)18, zostanie wykorzystane ważenie wewnątrz listy czynników, stwierdza się, że szósty czynnik jest również znacząco wzbogacony o geny „angiogenesis”.
Ważne jest sprawdzenie map ciepła, aby upewnić się, że wzorzec ekspresji genów jest odpowiedniej jakości, by wspierać interpretacje biologiczne. Mapy ciepła wykazujące wyraźną, silną zmienność mogą przedstawiać albo skoordynowaną ekspresję genów czynnikowych w zakresie od niskiej do wysokiej, albo bardziej złożone wzorce, w których niska ekspresja niektórych genów jest skorelowana z wysoką ekspresją innych (Rycina 6). Kluczowym wskaźnikiem wysokiej jakości grupy jest obecność kilku genów o płynnej zmienności ekspresji w funkcji wyniku czynnika. Mapy ciepła czynników przedstawiają próbki uporządkowane zgodnie z wynikiem czynnika, zatem powinien występować płynny gradient przesuwający się od lewej do prawej strony. Może to jednak nie nastąpić na co najmniej dwa różne sposoby. Najczęściej korelacje mogą być niezwykle zaszumione (Rycina 5C), co poddaje w wątpliwość wiarygodność i użyteczność wszelkich wniosków dotyczących przeżywalności i/lub funkcji biologicznej. Ponadto wzorce występujące tylko w niewielkiej mniejszości próbek mogą nie być zgodne z modelem trzech stanów ekspresji założonym przez algorytm CorEx, co prowadzi do błędnej klasyfikacji próbek (prawa strona Ryciny 5D).
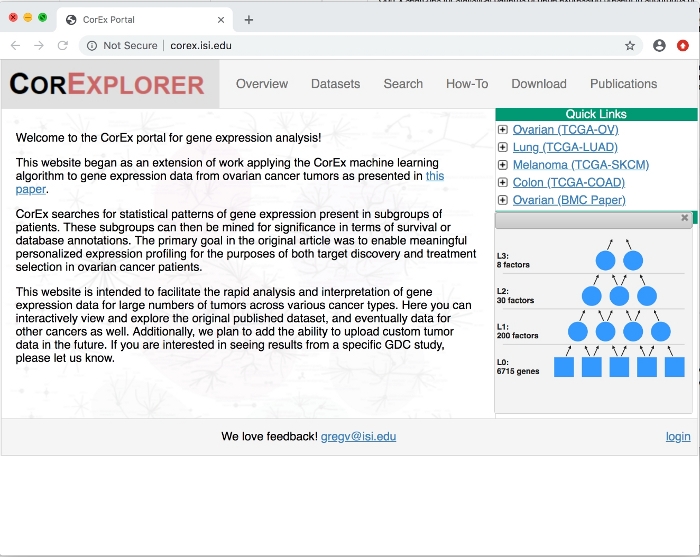
Rycina 1: Strona główna CorExplorer. Po kliknięciu znaku + obok Ovarian Cancer w sekcji Quick Links wyświetlane są szczegóły grafu czynnikowego. Hierarchiczny model CorEx składa się ze zmiennych wejściowych (w tym przypadku ekspresji genów) w dolnej warstwie oraz wywnioskowanych czynników utajonych w warstwach wyższych. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
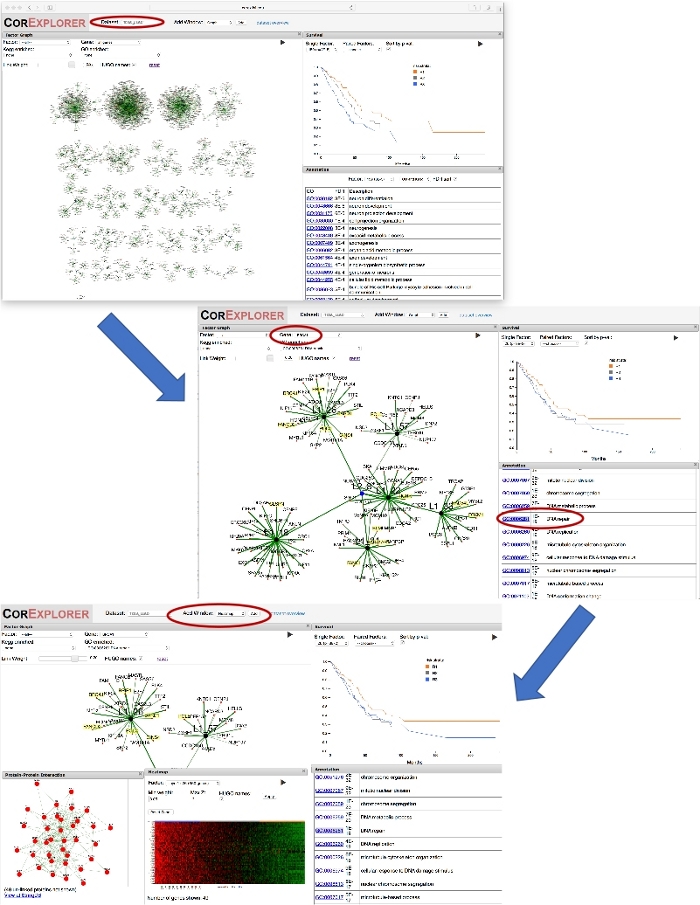
Rycina 2: Wykorzystanie nazwy genu do prowadzenia eksploracji. Rycina przedstawia serię zrzutów ekranu ilustrujących eksplorację czynników raka płuca w CorEx silnie powiązanych z BRCA1. Po pierwsze, wybranie „BRCA1” w rozwijanym menu Gene dla grafu czynników powoduje przybliżenie widoku grafu do czynnika, dla którego BRCA1 ma największą wagę. Lekkie oddalenie kadru ukazuje węzeł drugiej warstwy L2_8 łączący ten czynnik z innymi powiązanymi czynnikami. Można porównać przeżywalność i adnotacje: kliknięcie terminu GO DNA repair wyróżnia adnotowane geny. Dodano okno PPI, aby pokazać interakcje sieciowe dla genów w danym czynniku. Użycie przycisku Add Window w celu dodania mapy ciepła pokazuje powiązanie wzorców ekspresji z przeżywalnością, co sugeruje, że zwiększona ekspresja genów naprawy DNA może być powiązana ze zmniejszoną przeżywalnością. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
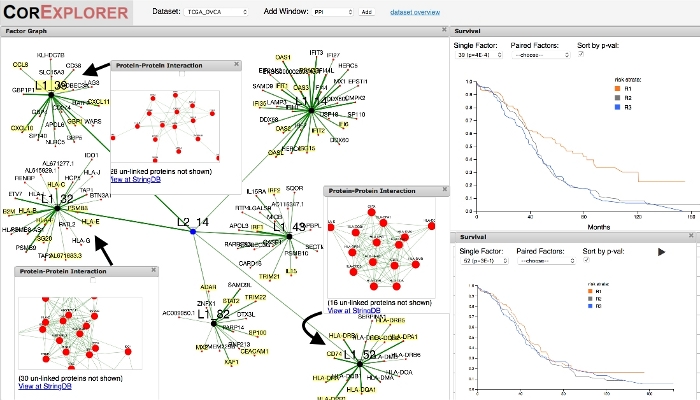
Rysunek 3: Wykorzystanie danych klinicznych (przeżywalności) do ukierunkowanej eksploracji. Analiza głównego czynnika powiązanego z przeżywalnością (39) w raku jajnika ujawnia interesujące relacje między sąsiednimi czynnikami. Po wybraniu czynnika 39 na grafie czynników i niewielkim oddaleniu widać, że czynnik drugiej warstwy powiązany z czynnikiem 39 ma pięć innych powiązanych czynników. Dodatkowe okno przeżywalności umożliwia bezpośrednie porównanie powiązanych różnic w przeżywalności. Czynniki 39 i 32 wykazują pozytywną korelację z przeżywalnością, w przeciwieństwie do czynnika 52, który jej nie wykazuje. Sieci oddziaływań białko-białko są dobrze zdefiniowane. Odnośniki do StringDB pozwalają na porównanie adnotacji GO (nie pokazano): czynnik 39 jest powiązany z siecią sygnalizacji cytokin związanych z aktywacją cytotoksycznych limfocytów T CD8+, a w czynniku 32 dominują białka prezentujące antygen MHC klasy I, które wyzwalają rozpoznanie przez takie limfocyty; sąsiednie czynniki są jednak zdominowane przez inne komponenty układu odpornościowego, takie jak pomocnicze limfocyty T CD4+, i nie wykazują korelacji z przeżywalnością. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
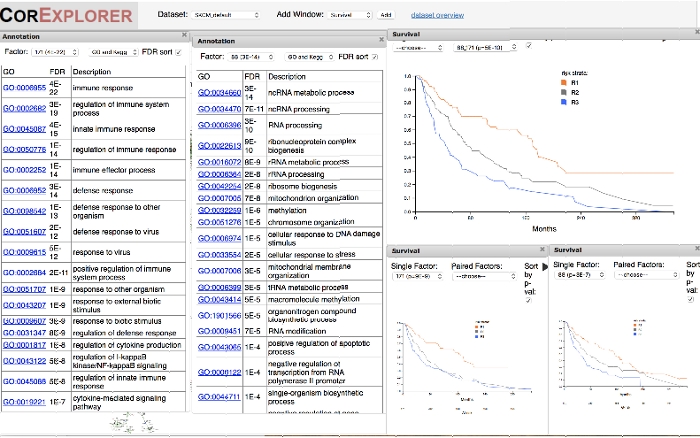
Rycina 4: Analiza głównych czynników przeżycia sugeruje potencjalne kombinacje terapeutyczne. Link „Datasets” na pasku menu strony głównej prowadzi do zwięzłej tabeli czynników przeżycia uporządkowanych według wartości p, wraz z główną adnotacją GO (niewidoczną na rysunku). Wykorzystując te informacje dla czerniaka, kombinacja czynnika 171 dla funkcji odpornościowej z czynnikiem 88 dla organizacji mitochondriów wydaje się komplementarna. Na rysunku przedstawiono okna adnotacji dla każdego z czynników obok siebie w celu ich zestawienia. Krzywe przeżycia dla pacjentów stratyfikowanych według dwóch czynników osobno lub razem wskazują, że kombinacja ta zwiększa różnicę w przeżywalności w porównaniu do każdego z czynników stosowanego pojedynczo. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
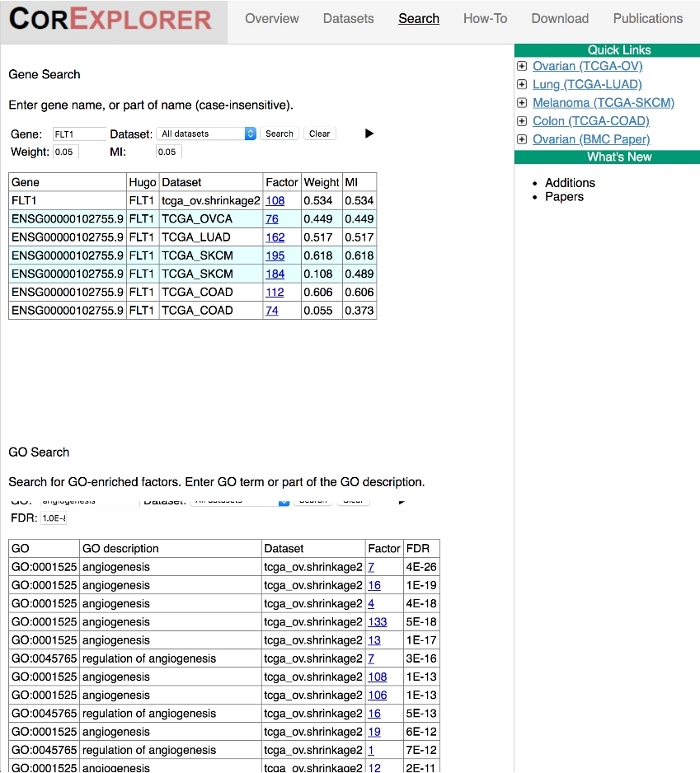
Rysunek 5: Strona wyszukiwania umożliwia analizę panrakową. Geny lub terminy procesów biologicznych GO można wyszukiwać we wszystkich zbiorach danych, korzystając z łącza Search na stronie głównej. Rysunek przedstawia wyniki wyszukiwania dla genu FLT1 i terminu GO „angiogenesis”. Wyniki wskazują obecność FLT1 w czynnikach opisanych terminem „angiogenesis” w różnych nowotworach. Prosimy kliknąć tutaj, aby wyświetlić większą wersję tego rysunku.
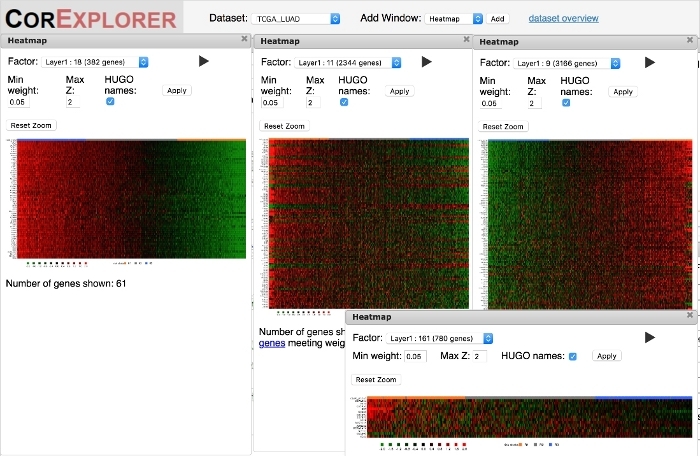
Rysunek 6: Mapy ciepła mogą być wykorzystywane do jakościowej oceny korelacji między genami a próbkami w zależności od wyniku czynnika. Relacje wysokiej jakości w ekspresji genów są widoczne jako płynne przejścia, gdy pacjenci w mapach ciepła są uporządkowani według wyniku czynnika. Przykładem jest najbardziej lewa mapa ciepła dla czynnika 18. Wzorce mogą obejmować również złożone sygnatury nadekspresji i niedoekspresji, jak w środkowej dużej mapie ciepła dla czynnika 11. Wzorce niższej jakości czasami wykazują gwałtowne zmiany ekspresji dla podgrupy pacjentów, jak w mapie ciepła dla czynnika 9 po prawej stronie, lub proste, bardzo szumiące korelacje, jak w mapie ciepła dla czynnika 161 w prawym dolnym rogu. Aby zobaczyć powiększoną wersję tego rysunku, kliknij tutaj.
Dyskusja
Zaprezentowaliśmy stronę CorExplorer, publicznie dostępny serwer WWW do interaktywnej eksploracji maksymalnie skorelowanych czynników ekspresji genów poznanych z sekwencji RNA guza za pomocą algorytmu CorEx. Pokazaliśmy, w jaki sposób strona internetowa może być wykorzystywana do stratyfikacji pacjentów według ekspresji genów nowotworowych oraz jak taka stratyfikacja odpowiada funkcji biologicznej i przeżyciu.
Zbudowano inne serwery sieciowe do analizy sekwencyjnej RNA. Analiza różnicowa i koekspresja nowotworów może być badana i integrowana z innymi typami danych w cbioPortal 19,20. Serwery GenePattern21, Mev22 i Morpheus23 zawierają sprawdzone techniki grupowania, takie jak analiza głównych składowych (PCA), kmeans lub samoorganizujące się mapy (SOM). Bardziej innowacyjne działania obejmują CamurWeb24, oparty na automatycznym klasyfikatorze generującym reguły, oraz TACCO25, który implementuje losowe klasyfikatory lasu i lasso. Zastosowany tutaj algorytm CorEx optymalizuje informacje wielowymiarowe w celu znalezienia hierarchii czynników, które wyjaśniają wzorce w danych. Wydaje się, że nieliniowe i hierarchiczne uczenie się czynników zapewnia lepszą interpretowalność w stosunku do liniowych czynników globalnych znalezionych za pomocą PCA4. Dodatkowo, precyzyjna analiza sygnałów próbek w ramach tej techniki umożliwia precyzyjne porównania guzów z częściej stosowanymi szerokimi podtypami. To połączenie nakładającej się i hierarchicznej analizy czynnikowej odróżnia CorExplorer od większości innych podejść i wymaga nowych narzędzi do wizualizacji i podsumowania.
Kluczową częścią analizy czynnikowej CorExplorer jest możliwość zbadania nie tylko kilku, ale ponad 100 czynników z informacyjnymi wzorcami genów, które są umieszczone w nakładającej się hierarchii. CorExplorer ułatwia eksplorację tych niezliczonych czynników w celu uzyskania powiązań biologicznych i klinicznych oraz pozwala na wyjątkowo szczegółową charakterystykę poszczególnych nowotworów. Nienadzorowane uczenie się tak dużej liczby czynników oznacza, że nie wszystkie będą miały znaczenie dla biologii choroby. W takim przypadku konieczne jest użycie adnotacji lub znanych genów w celu wyodrębnienia interesujących czynników lub wyszukania czynników związanych z danymi klinicznymi, takimi jak przeżycie. W ten sposób CorExplorer pozwala użytkownikom zaimplementować ten bardzo ważny krok filtrowania. Obecność wzorców genów czynnikowych w guzie może nawet sugerować podejście do spersonalizowanego leczenia onkologicznego. Co więcej, mnogość wyników czynników dla każdego nowotworu, która pozwala na odkrycie potencjalnie użytecznych kombinacji terapeutycznych.
Czasami zdarza się, że nie pojawiają się żadne znaczące adnotacje GO dla czynników silnie skorelowanych z przeżyciem. Chociaż może się to zdarzyć z powodu zaszumionych lub niedostatecznie pobranych próbek, istnieją inne możliwe przyczyny, takie jak rozmiar klastra, który jest zbyt mały, aby zarejestrować znaczące wyniki wzbogacenia lub grupa będąca "koszykiem" pojedynczych genów z różnych szlaków bez spójnego związku biologicznego. Ponadto odpowiednia może być kategoria adnotacji inna niż w procesie biologicznym KEGG i GO, np. kompartment komórkowy. Dostęp do nich można uzyskać, łącząc się z bazą danych StringDB, jak pokazano w protokole. Analiza wzbogacania ontologii genów na stronie CorExplorer obecnie nie uwzględnia wagi genów w czynniku, chociaż prawdopodobnie zostanie to naprawione w najbliższej przyszłości. Zwróć uwagę, że w oknie "Dodaj dostępną jest opcja listy genów", która umożliwia pobranie pełnej listy genów czynnika w celu dalszej analizy za pomocą narzędzi zewnętrznych.
Na potrzeby strony internetowej CorEx został uruchomiony na każdym ze zbiorów danych pięć razy, a przebieg, który doprowadził do największej ogólnej korelacji, został zachowany. Posiadanie statystycznej reprezentacji wyników wielu serii może być bardziej pouczające i stanowi cel przyszłych prac. Ponadto zestaw typów nowotworów dostępnych na serwerze jest raczej niewielki, ale spodziewamy się, że z czasem będzie się rozszerzał w zależności od zainteresowania użytkowników.
Jak opisano powyżej, CorExplorer wizualizuje relacje między czynnikami sekwencyjnymi RNA CorEx wraz z informacjami klinicznymi i informacjami z bazy danych, umożliwiając w ten sposób wiele różnych trybów zapytania. Mamy nadzieję, że to narzędzie doprowadzi do dalszych prac nad wykorzystaniem mocy analizy sekwencyjnej RNA do odkryć i zastosowań klinicznych w onkologii.
Oświadczenia
Autorzy oświadczają, że nie mają konkurencyjnych interesów finansowych.
Podziękowania
GV był wspierany przez DARPA award W911NF-16-0575.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Serwer publiczny dla strony CorExplorer USC | http://corex.isi.edu | Intel Xeon E5-2690 4-rdzeniowy 2,6 GHz, 8GB RAM. Architektura backendowa to LAMP: Linux, Apache, MySQL, PHP. | |
| Przeglądarka internetowa | : Google/Apple | Chrome/Safari | Zweryfikowane przeglądarki internetowe. |
Bibliografia
- Petryszak, R., et al. The RNASeq-er API-a gateway to systematically updated analysis of public RNA-seq data. Bioinformatics. 33, 2218-2220 (2017).
- Steeg, G. V., Galstyan, A. Maximally Informative Hierarchical Representations of High-Dimensional Data. Proceedings of the Eighteenth International Conference on Artificial Intelligence and Statistics (AISTATS). , San Diego, CA. (2015).
- Ver Steeg, G., Galstyan, A. Discovering structure in high-dimensional data through correlation explanation. Advances in Neural Information Processing Systems. , Montreal, Canada. (2014).
- Pepke, S., Ver Steeg, G. Comprehensive discovery of subsample gene expression components by information explanation: therapeutic implications in cancer. BMC medical Genomics. 10, 12(2017).
- Byron, S. A., Van Keuren-Jensen, K. R., Engelthaler, D. M., Carpten, J. D., Craig, D. W. Translating RNA sequencing into clinical diagnostics: opportunities and challenges. Nature Reviews Genetics. 17, 257(2016).
- Cancer Genome Atlas Research Network. Comprehensive molecular profiling of lung adenocarcinoma. Nature. 511, 543(2014).
- Cancer Genome Atlas Network. Comprehensive molecular characterization of human colon and rectal cancer. Nature. 487, 330(2012).
- Akbani, R., et al. Genomic classification of cutaneous melanoma. Cell. 161, 1681-1696 (2015).
- Cancer Genome Atlas Research Network. Integrated genomic analyses of ovarian carcinoma. Nature. 474, 609(2011).
- Grossman, R. L., et al. Toward a shared vision for cancer genomic data. New England Journal of Medicine. 375, 1109-1112 (2016).
- Moynahan, M. E., Chiu, J. W., Koller, B. H., Jasin, M. Brca1 controls homology-directed DNA repair. Molecular Cell. 4, 511-518 (1999).
- Szklarczyk, D., et al. STRING v11: protein–protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Research. 47, 607-613 (2018).
- Durgeau, A., Virk, Y., Corgnac, S., Mami-Chouaib, F. Recent advances in targeting CD8 T-cell immunity for more effective cancer immunotherapy. Frontiers in Immunology. 9, 14(2018).
- Sato, E., et al. Intraepithelial CD8+ tumor-infiltrating lymphocytes and a high CD8+/regulatory T cell ratio are associated with favorable prognosis in ovarian cancer. Proceedings of the National Academy of Sciences of the United States of America. 102, 18538-18543 (2005).
- De Moura, M. B., et al. Mitochondrial respiration-an important therapeutic target in melanoma. PLoS One. 7, 40690(2012).
- Folkman, J., Merler, E., Abernathy, C., Williams, G. Isolation of a tumor factor responsible for angiogenesis. Journal of Experimental Medicine. 133, 275-288 (1971).
- Takahashi, S. Vascular endothelial growth factor (VEGF), VEGF receptors and their inhibitors for antiangiogenic tumor therapy. Biological and Pharmaceutical Bulletin. 34, 1785-1788 (2011).
- Subramanian, A., et al. Gene set enrichment analysis: a knowledge-based approach for interpreting genome-wide expression profiles. Proceedings of the National Academy of Sciences of the United States of America. 102, 15545-15550 (2005).
- Cerami, E., et al. The cBio Cancer Genomics Portal: An Open Platform for Exploring Multidimensional Cancer Genomics Data. Cancer Discovery. 2, 401-404 (2012).
- Gao, J., et al. Integrative Analysis of Complex Cancer Genomics and Clinical Profiles Using the cBioPortal. Science Signalling. 6, 1(2013).
- Reich, M., et al. GenePattern 2.0. Nature Genetics. 38, 500(2006).
- Wang, Y. E., Kutnetsov, L., Partensky, A., Farid, J., Quackenbush, J. WebMeV: A Cloud Platform for Analyzing and Visualizing Cancer Genomic Data. Cancer Research. 77, 11-14 (2017).
- Morpheus. , Available from: https://software.broadinstitute.org/morpheus (2019).
- Weitschek, E., Lauro, S. D., Cappelli, E., Bertolazzi, P., Felici, G. CamurWeb: a classification software and a large knowledge base for gene expression data of cancer. BMC Bioinformatics. 19, 354(2018).
- Chou, P. -H., et al. tACCo, a Database Connecting transcriptome Alterations, pathway Alterations and Clinical outcomes in Cancers. Scientific Reports. 9, 3877(2019).
Przedruki i uprawnienia
