Protokół eksploracji genomu sterowany spektrometrią mas jest ustanowiony i opisany tutaj. Opiera się na informacjach o sekwencjach genomu i analizie LC-MS/MS i ma na celu ułatwienie identyfikacji cząsteczek ze złożonych ekstraktów mikrobiologicznych i roślinnych.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Eksploracja genomu pod kontrolą spektrometrii mas jako narzędzie do odkrywania nowych produktów naturalnych
W tym artykule
Podsumowanie
Streszczenie
Przestrzeń chemiczna pokryta naturalnymi produktami jest ogromna i powszechnie nierozpoznana. W związku z tym pożądane są wygodne metodologie do przeprowadzania szeroko zakrojonej oceny ich funkcji w przyrodzie i potencjalnych korzyści dla człowieka (np. w przypadku zastosowań związanych z odkrywaniem leków). Protokół ten opisuje połączenie eksploracji genomu (GM) i sieci molekularnej (MN), dwóch współczesnych podejść, które dopasowują adnotacje kodowane przez klastry genów w sekwencjonowaniu całego genomu do sygnatur struktury chemicznej z surowych ekstraktów metabolicznych. Jest to pierwszy krok w kierunku odkrycia nowych organizmów naturalnych. Pojęcia te, zastosowane razem, są tutaj zdefiniowane jako eksploracja genomu kierowana przez MS. W tej metodzie główne składniki są wcześniej oznaczane (przy użyciu MN), a strukturalnie spokrewnieni nowi kandydaci są powiązani z adnotacjami sekwencji genomu (przy użyciu GM). Połączenie GMO i MN jest opłacalną strategią ukierunkowaną na nowe szkielety molekuł lub zbieranie profili metabolicznych w celu identyfikacji analogów z już znanych związków.
Wprowadzenie
Badania nad metabolizmem wtórnym często polegają na przesiewaniu surowych ekstraktów pod kątem specyficznych aktywności biologicznych, a następnie na oczyszczaniu, identyfikacji i charakterystyce składników należących do aktywnych frakcji. Proces ten okazał się efektywny, umożliwiając izolację wielu związków chemicznych. Obecnie uznaje się go jednak za nieefektywny, głównie ze względu na wysoki odsetek ponownych odkryć tych samych substancji. Ponieważ przemysł farmaceutyczny rozwijał się bez pełnej wiedzy na temat ról i funkcji wyspecjalizowanych metabolitów, ich identyfikacja była przeprowadzana w warunkach laboratoryjnych, które nie odzwierciedlały wiernie natury1. Obecnie istnieje lepsze zrozumienie naturalnych wpływów sygnałowych, wydzielania oraz obecności większości celów w niewykrywalnie niskich stężeniach. Ponadto regulacja tego procesu pomoże środowisku akademickiemu i przemysłowi farmaceutycznemu w wykorzystaniu tej wiedzy. Przyniesie to również korzyści badaniom obejmującym bezpośrednią izolację metabolitów związanych z milczącymi klastrami genów biosyntezy (BGCs)2.
W tym kontekście postępy w sekwencjonowaniu genomicznym odnowiły zainteresowanie badaniami przesiewowymi metabolitów mikroorganizmów. Wynika to z faktu, że analiza informacji genomicznych odkrytych klastrów biosyntetycznych może ujawnić geny kodujące nowe związki, których nie zaobserwowano lub których nie wytworzono w warunkach laboratoryjnych. Obecnie dostępnych jest wiele projektów lub szkiców pełnych genomów drobnoustrojów, a ich liczba rośnie z każdym rokiem, co stwarza ogromne perspektywy odkrywania nowych cząsteczek biologicznie czynnych poprzez eksplorację genomów (genome mining)3,4.
Atlas Biosyntetycznych Klastrów Genów (Atlas of Biosynthetic Gene Clusters) jest obecnie największym zbiorem automatycznie zidentyfikowanych klastrów genów, stanowiącym element Zintegrowanej Platformy Genomów Mikrobialnych (Integrated Microbial Genomes Platform) Joint Genome Institute (JGI IMG-ABC)2. Niedawno inicjatywa standaryzacyjna Minimum Information for Biosynthetic Gene Clusters (MIBiG) promowała ręczną reanotację BGC, dostarczając wysoko wykuratorowany zestaw danych referencyjnych5. Obecnie dostępnych jest wiele narzędzi umożliwiających obliczeniowe przeszukiwanie danych genetycznych i powiązanie ich ze znanymi metabolitami wtórnymi. Opracowano również różne strategie pozyskiwania nowych bioaktywnych produktów naturalnych (np. ekspresję heterologiczną, delecję genów docelowych, rekonstrukcję in vitro, analizę sekwencji genomowej, screening z wykorzystaniem izotopów [podejście genomizotopowe], manipulację regulatorami lokalnymi i globalnymi, przeszukiwanie oparte na celach oporności, przeszukiwanie niezależne od hodowli, a ostatnio podejścia sterowane spektrometrią mas lub kodem2,6,7,8,9,10,1,12,13,14,15).
Przeszukiwanie genomu (genome mining) jako strategia pojedyncza wymaga wysiłków w celu adnotacji jednej lub małej grupy cząsteczek; w związku z tym w procesie tym wciąż istnieją luki w zakresie ustalania priorytetów dla nowych związków do izolacji i wyznaczania struktury. W teorii podejścia te celują w tylko jedną ścieżkę biosyntetyczną na eksperyment, co skutkuje powolnym tempem odkryć. W tym sensie stosowanie GM wraz z podejściem sieci molekularnych stanowi istotny postęp w badaniach nad produktami naturalnymi14,15.
Wszechstronność, dokładność i wysoka czułość chromatografii cieczowej sprzężonej ze spektrometrią mas (LC-MS) sprawiają, że jest to doskonała metoda do identyfikacji związków. Obecnie wiele platform udostępnia algorytmy i pakiety oprogramowania do niezorientowanej metabolomiki16,17,18,19,20. Rdzeniem tych programów jest detekcja cech (wykrywanie pików)21 oraz wyrównywanie pików, co umożliwia dopasowanie identycznych cech w serii próbek oraz poszukiwanie wzorców. Algorytmy oparte na wzorcach MS2,23 porównują charakterystyczne wzorce fragmentacji i dopasowują podobieństwa MS2, generując rodziny molekularne o wspólnych cechach strukturalnych. Cechy te mogą być następnie wyróżnione i pogrupowane, co pozwala na szybkie odkrywanie znanych i nieznanych cząsteczek w złożonym ekstrakcie biologicznym za pomocą tandemowej spektrometrii mas MS2,24,25. Zatem tandemowa spektrometria mas jest wszechstronną metodą pozyskiwania informacji strukturalnych o wielu chemotypach zawartych w dużym zbiorze danych jednocześnie.
Algorytm Global Natural Products Social Molecular Networking (GNPS)26 wykorzystuje znormalizowaną intensywność jonów fragmentowych do konstruowania wektorów wielowymiarowych, w których podobieństwa są porównywane przy użyciu funkcji cosinusowej. Relacje między różnymi jonami prekursorowymi są przedstawione na schemacie, w którym każda fragmentacja jest wizualizowana jako węzeł (okręgi), a stopień powiązania poszczególnych węzłów jest definiowany przez krawędź (linie). Globalna wizualizacja cząsteczek pochodzących z jednego źródła jest definiowana jako sieć molekularna. Cząsteczki rozbieżne strukturalnie, które ulegają unikalnej fragmentacji, tworzą własne, specyficzne klastry lub konstelacje, podczas gdy cząsteczki spokrewnione grupują się razem. Klastrowanie chemotypów umożliwia hipotetyczne powiązanie podobnych cech strukturalnych z ich pochodzeniem biosyntetycznym.
Łączenie podejść chemotyp-genotyp oraz genotyp-chemotyp jest niezwykle skuteczne podczas tworzenia powiązań bioinformatycznych między BGC a ich małocząsteczkowymi produktami27. W związku z tym poszukiwanie genomowe sterowane przez MS jest szybką metodą i strategią wymagającą niewielkiej ilości materiału, co pomaga powiązać jony rodzime ze szlakami biosyntezy ujawnionymi przez WGS jednego lub wielu szczepów w różnych warunkach metabolicznych i środowiskowych.
Przebieg tego protokołu (Rycina 1) polega na wprowadzeniu danych WGS do platformy adnotacji biosyntetycznych klastrów genów, takiej jak antiSMASH28,29,30. Pomaga to oszacować różnorodność i klasę związków zakodowanych w genomie. Należy przyjąć strategię nakierowaną na biosyntetyczny klaster genów kodujący interesującą jednostkę chemiczną, a następnie przeanalizować ekstrakty hodowlane szczepu dzikiego i/lub szczepu heterologicznego zawierającego BGC, aby wygenerować klastry jonów na podstawie podobieństw przy użyciu GNPS26,31. W konsekwencji możliwe jest zidentyfikowanie nowych cząsteczek powiązanych z docelowym BGC, których nie ma w bazie danych (głównie nieznane analogi, czasami produkowane w niskich mianach). Warto zauważyć, że użytkownicy mogą współtworzyć te platformy, a dostępność danych bioinformatycznych i MS/MS szybko rośnie, co prowadzi do ciągłego rozwoju i aktualizacji skutecznych narzędzi obliczeniowych oraz algorytmów umożliwiających efektywne łączenie złożonych ekstraktów z cząsteczkami.
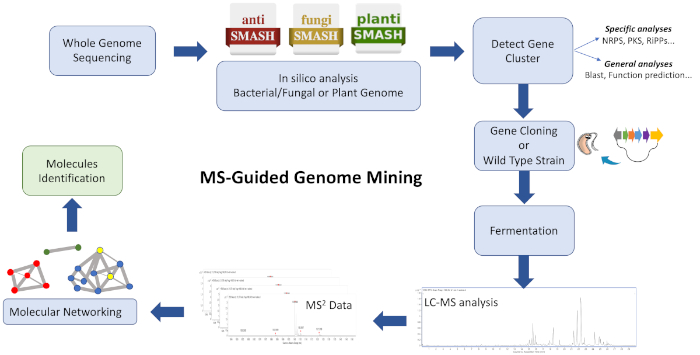
Rysunek 1: Przegląd całego schematu postępowania. Przedstawiono ilustrację etapów bioinformatycznych, klonowania oraz sieciowania molekularnego, które wchodzą w skład opisanego podejścia do przeszukiwania genomu z wykorzystaniem spektrometrii mas (MS) w celu identyfikacji nowych metabolitów. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Niniejszy protokół opisuje szybki i efektywny schemat pracy łączący analizę genomu (genome mining) z sieciowaniem molekularnym (molecular networking) jako punkt wyjścia dla procesu odkrywania produktów naturalnych. Choć wiele aplikacji pozwala na wizualizację składu i pokrewieństwa cząsteczek wykrywanych metodą MS w ramach jednej sieci, w niniejszej pracy zastosowano kilka z nich w celu wizualizacji strukturalnie podobnych, zgrupowanych cząsteczek. Dzięki zastosowaniu tej strategii pomyślnie zidentyfikowano nowe cyklodepsypeptydy zaobserwowane w ekstraktach metabolicznych Streptomyces sp. CBMAI 2042. Na podstawie analizy genomu rozpoznano cały biosyntetyczny klaster genowy (BGC) kodujący walinomycyny i sklonowano go do szczepu produkcyjnego Streptomyces coelicolor M146. Ostatecznie, po przeprowadzeniu sieciowania molekularnego opartego na wzorcach MS, cząsteczki wykryte metodą MS skorelowano z BGC odpowiedzialnymi za ich biogenezę32.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
1. Przeszukiwanie genomu w poszukiwaniu biosyntetycznych klastrów genów
- W pierwszym kroku wyboru biosyntetycznego klastra genów (BCG) do poszukiwania w genomie kierowanego spektrometrią mas (MS-guided genome mining) przeprowadź sekwencjonowanie całego genomu (WGS). Wstępny projekt całego genomu interesującego szczepu (bakterii) można uzyskać za pomocą technologii Illumina MiSeq, wykorzystując wysokiej jakości genomowe DNA oraz następujące metody: przygotowanie bibliotek shotgun TruSeq PCR-Free oraz Nextera Mate Pair Library Preparation Kit3.
UWAGA: Po sekwencjonowaniu bibliotekę Illumina shotgun oraz bibliotekę Illumina mate pair można złożyć za pomocą programu asemblera Newbler v3.0 (Roche, 454) (dostępnego pod adresem ) i adnotować przy użyciu potoku opartego na FgeneSB (dostępnego pod adresem ), zgodnie z wcześniejszym opisem33. Microbiology Resource Announcements (MRA) jest czasopismem w pełnym dostępie otwartym, publikującym artykuły o dostępności wszelkich zasobów mikrobiologicznych zdeponowanych w dostępnych repozytoriach (dostępne pod adresem ). Potencjalne geny kodujące białka są identyfikowane przy użyciu adnotacji serwera RAST34, a projekt Whole Genome Shotgun (WGS) jest deponowany w bazach danych sekwencji DDBJ/ENA/GenBank (dostępnych pod adresem ) oraz Gold (dostępnych pod adresem ). - Aby uzyskać informacje in silico na temat adnotacji klastrów genów metabolizmu wtórnego z kompletnego zsekwencjonowanego genomu, prześlij plik sekwencji (w formacie GenBank/EMBL lub FASTA) do platformy antiSMASH (dostępnej pod adresem ).
- Wybierz interesujący klaster genów z danych wyjściowych (Rycina 2) na podstawie najbardziej podobnego znanego klastra.
UWAGA: Po pierwsze, rutynowo przeprowadza się analizę gen po genie oraz poszczególne wyszukiwania (blastp), aby ocenić, jakie funkcje są powiązane z pożądanymi grupami genów biosyntetycznych. Procedura ta może również pomóc w określeniu, który BGC prawdopodobnie wiąże się z produkcją pożądanego związku, nawet jeśli procent podobieństwa jest niski. Przewidywanie w antiSMASH bierze pod uwagę wszystkie geny w obrębie klastra w celu obliczenia procentowego pokrycia, co może skutkować globalnie niskim procentem podobieństwa dla analizowanego BGC. Jednakże analizując gen po genie, możliwe jest uzyskanie dokładniejszych informacji przy użyciu najbardziej podobnego znanego klastra. Po drugie, antiSMASH oferuje dwie opcje doprecyzowania wyszukiwania: 1) ścisłość detekcji (detection strictness): stopień rygorystyczności, z jaką klaster genów biosyntetycznych musi zostać zidentyfikowany, aby został uznany za trafienie. W przypadku tej opcji użytkownik powinien zastosować następujące parametry: a) strict (ścisły): wykrywa wyłącznie dobrze zdefiniowane klastry zawierające wszystkie wymagane regiony, odporny na błędy w informacjach genetycznych; b) relaxed (rozluźniony): wykrywa klastry częściowe, w których brakuje jednego lub więcej regionów funkcjonalnych, co działa również w przypadku wykrywania cech typu strict; lub c) loose (swobodny): wykrywa słabo zdefiniowane klastry oraz klastry, które prawdopodobnie odpowiadają metabolitom pierwotnym, co może prowadzić do pojawienia się wyników fałszywie dodatnich lub słabo zdefiniowanych BGC. Drugą opcją są 2) dodatkowe funkcje (extra features): typ informacji, których platforma ma szukać i wyświetlać w wynikach. Ogólnie te dwie opcje mogą zaoszczędzić czas po przeprowadzeniu przewidywania. Należy jednak pamiętać, że proces w antiSMASH wymaga dłuższego czasu oczekiwania.
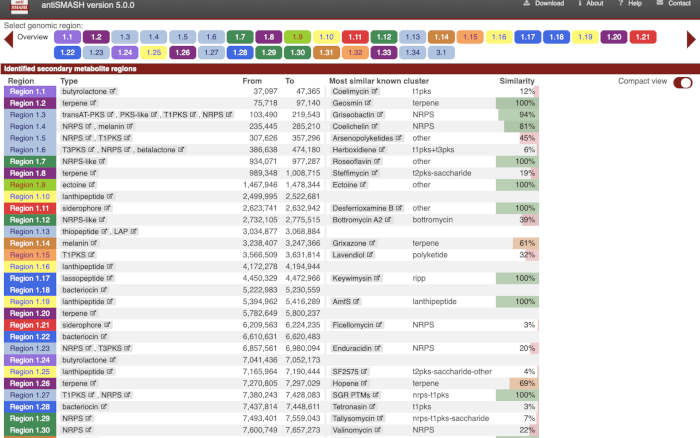
Rysunek 2: Wynik z platformy antiSMASH. Analiza in silico metabolizmu wtórnego na podstawie adnotacji pełnej sekwencji genomu. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
- Na podstawie informacji o sekwencji DNA BGC zaprojektuj primery (20–25 nt) flankujące klaster genów do przesiewania biblioteki ESAC (E. coli/Streptomyces Artificial Chromosome).
UWAGA: Do przechwycenia całego biosyntetycznego klastra genów z DNA można zastosować różne metody35,36. W tym przypadku zastosowano metodę konstrukcji reprezentatywnej biblioteki ESAC37,38 z Streptomyces sp. CBMAI 2042, zawierającej klony z fragmentami o średniej wielkości ~95 kb.
2. Heterologiczna ekspresja całego biosyntetycznego klastra genów z biblioteki ESAC
- Przenieś wektor ESAC z E. coli DH10B do E. coli ET12567 za pomocą koniugacji triparentalnej32.
- Zaszczep E. coli ET12567 (CamR), TOPO10/pR9604 (CarbR), DH10B/ESAC4H (AprR) w 5 mL pożywki Luria-Bertani (LB) zawierającej chloramfenikol (25 µg/mL), karbenycylinę (10 µg/mL) i apramycynę (50 µg/mL).
- Inkubuj kulturę przez noc w temperaturze 37 °C przy 250 rpm.
- Zaszczep 50 µL kultury nocnej w 10 mL pożywki LB zawierającej połowę stężenia antybiotyków.
- Inkubuj kulturę w temperaturze 37 °C przy 250 rpm aż do osiągnięcia A60 na poziomie 0,4–0,6.
- Zbierz komórki poprzez wirowanie przy 2 20 x g przez 5 min.
- Przemyj komórki dwukrotnie 20 mL pożywki LB.
- Resuspenduj komórki w 50 µL pożywki LB.
- Wymieszaj 20 μL każdego szczepu w probówce do mikrocentryfugi i nanieś kroplami na płytkę agarową z pożywką LB bez antybiotyków.
- Inkubuj płytki przez noc w temperaturze 37 °C.
- Wysewaj wyhodowane komórki na świeżą płytkę z agarem LB zawierającym antybiotyki i inkubuj przez noc w temperaturze 37 °C.
3. Konjugacja Streptomyces/E. coli
- Aby uzyskać rekombinowany organizm heterologiczny, przeprowadź konjugację32 pomiędzy szczepem E. coli ET12567 zawierającym wektor ESAC, plazmid pomocniczy pR9604 a Streptomyces coelicolor M146 lub innym wybranym szczepem gospodarza39.
- Dzień 1: Zaszczep izolowane kolonie S. coelicolor M146 w 25 mL pożywki TSBY w kolbie Erlenmeyera o pojemności 250 mL wyposażonej w sprężynę ze stali nierdzewnej, w temperaturze 30 °C przy 20 rpm przez 48 h.
- Dzień 2/3: Zaszczep szczep ET12567/ESAC/pR9604 w 5 mL pożywki LB zawierającej chloramfenikol (25 µg/mL), karbenicylinę (10 µg/mL) i apramycynę (50 µg/mL) przez noc w temperaturze 37 °C przy 250 rpm.
- Dzień 3/4: Przenieś 50 µL kultury nocnej do 10 mL pożywki 2TY (w probówce stożkowej 50 mL) zawierającej połowę roboczych stężeń antybiotyków. Inkubuj w temperaturze 37 °C przy 250 rpm aż do osiągnięcia A60 na poziomie 0,4–0,6.
- Odwirowuj kultury (ET12567/ESAC/pR9604 oraz M146) przy 200 x g przez 10 min.
- Przemyj osady 2x w 20 mL pożywki 2TY i resuspenduj w 500 µL pożywki 2TY.
- Odlej 200 µL zawiesiny S. coelicolor M146 i rozcieńcz w 50 µL pożywki 2TY (zawiesina A).
- Odlej 20 µL zawiesiny A i rozcieńcz w 500 µL pożywki 2TY (zawiesina B).
- Odlej 20 µL zawiesiny B i rozcieńcz w 50 µL pożywki 2TY (zawiesina C).
- Odlej 20 µL zawiesiny ET12567/ESAC/pR9604 i zmieszaj z 20 µL zawiesiny C.
- Wysiej 150 µL mieszaniny koniugacyjnej na płytkę z agarem SFM bez antybiotyków.
- Inkubuj w temperaturze 30 °C przez 16 h.
- Pokryj płytki 1 mL roztworu antybiotyku (zależnie od oporności plazmidu). Po wyschnięciu inkubuj w temperaturze 30 °C przez 4–7 dni.
UWAGA: W tym przypadku przygotowano roztwór zawierający 1,0 mg/mL tiostreptonu i 0,5 mg/mL kwasu nalidyksowego. - Przesiej domniemane ekskonjuganty na płytki z agarem SFM zawierającym tiostrepton (50 mg/mL) i kwas nalidyksowy (25 mg/mL). Inkubuj w temperaturze 30 °C.
- Przesiej ekskonjuganty na agar SFM zawierający tylko kwas nalidyksowy.
- Przeprowadź analizę PCR izolowanych kolonii, aby potwierdzić, że cały klaster genów został przeniesiony do gospodarza S. coelicolor M146.
4. Hodowla szczepów
- W celu uzyskania profilu metabolicznego, zaszczepić 1/10 prekultury szczepu w odpowiedniej pożywce fermentacyjnej i w odpowiednich warunkach hodowli.
- Odwirować kultury przy 20 x g przez 10 min.
- Przeprowadzić ekstrakcję zgodnie z klasą związku, który jest przedmiotem analizy40.
5. Pozyskiwanie widm mas i przygotowanie do analizy w GNPS
- Aby uzyskać dane MS/MS, zaprogramuj odpowiednie metody HPLC i spektrometrii mas za pomocą oprogramowania sterującego. Analizie może zostać poddany zarówno wysokorozdzielczy, jak i niskorozdzielczy tryb spektrometrii mas zależnej od danych (DDA).
UWAGA: Zazwyczaj idealnym rozwiązaniem jest roztwór próbek złożonych ekstraktów surowych o stężeniu 1 mg/mL. W przypadku mniej złożonych ekstraktów konieczne są rozcieńczenia. Należy zauważyć, że sieciowanie MS/MS stanowi wykrywalną sieć molekularną w danych warunkach spektrometrii mas. - Konwertuj widma mas na format .mzXML, używając programu MSConvert z pakietu Proteowizard (dostępnego pod adresem ). Parametry wejściowe dla konwersji przedstawiono na Rysunku 3. Dane z oprogramowania niemal wszystkich producentów są kompatybilne.
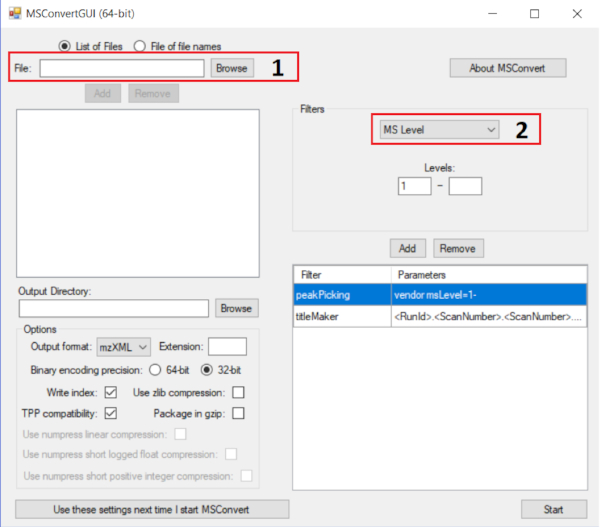
Rysunek 3: Wykorzystanie programu MsConvert do konwersji plików MS do rozszerzenia mzXML. Wyświetlono poprawny parametr dla analizy GNPS. Instrukcje są następujące: należy dodać wszystkie pliki MS w polu 1 i dodać filtr. Wybór pików w polu 2; w przypadku tego filtra należy wybrać dostawcę algorytmu; naciśnij Proszę podać tekst źródłowy do tłumaczenia. a następnie nastąpią procesy konwersji. Kliknij tutaj, aby wyświetlić powiększoną wersję tej figury.
- Prześlij przekonwertowane pliki LC-MS/MS do bazy danych GNPS. Dostępne są dwie opcje: za pomocą protokołu transferu plików (FTP) lub bezpośrednio w przeglądarce poprzez platformę internetową.
UWAGA: Szczegółowe informacje na temat instalacji i przesyłania danych do GNPS są dostępne pod adresem .
6. Analiza GNPS
- Po utworzeniu konta w serwisie GNPS (dostępnym pod adresem ), zaloguj się na utworzone konto i wybierz opcję Create Molecular Network. Dodaj tytuł zadania.
- Opcje podstawowe: wybierz pliki mzXML, na podstawie których zostanie zbudowana sieć molekularna. Można je zorganizować w maksymalnie sześć grup. Wybierz biblioteki dla procedury dereplikacji (Rysunek 4).
UWAGA: Grupy te nie wpływają na konstrukcję sieci molekularnej. Informacje te zostaną wykorzystane wyłącznie do reprezentacji graficznej.
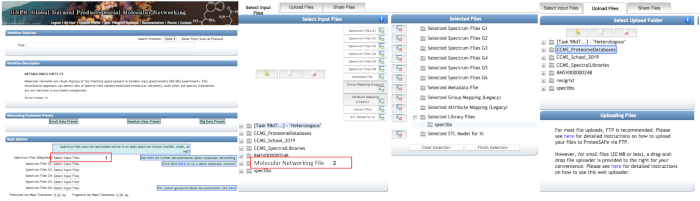
Rysunek 4: Wykorzystanie platformy online GNPS do przeprowadzenia analizy sieci molekularnych. Wybór plików mzXML odbywa się poprzez kliknięcie w polu 1. W otwartym oknie dialogowym można wybrać pliki z folderu osobistego (pole 2) lub przesłać je w drugiej zakładce, korzystając z funkcji przeciągania i upuszczania (pliki o rozmiarze mniejszym niż 20 MB). Pliki można podzielić na maksymalnie sześć grup. Kliknij tutaj, aby wyświetlić powiększoną wersję tej figury.
- Wybierz tolerancję masy jonu prekursorowego wynoszącą 0,02 Da oraz tolerancję masy jonu fragmentacyjnego wynoszącą 0,05 Da.
UWAGA: GNPS oferuje różne poziomy rygorystyczności w zależności od 1) dokładności danych MS/MS oraz 2) wymaganej dokładności asocjacji. Podstawowe opcje: w tym folderze można ustawić Tolerancja masy jonu prekursorowego i Tolerancja masy jonów fragmentowychParametry te służą jako wytyczne do określenia wymaganej precyzji jonu prekursorowego i jonu fragmentacyjnego. Wybrane tolerancje masy zależą od rozdzielczości i dokładności stosowanego spektrometru mas. - Zaawansowane opcje sieciowe: wybierz parametry zgodnie z Rycina 5Parametry te bezpośrednio wpływają na rozmiar i kształt klastrów sieci. Pozostałe parametry znajdujące się w pozostałych kartach są przeznaczone dla zaawansowanych użytkowników; należy zatem pozostawić ich wartości domyślne.
UWAGA: Zaawansowane parametry można znaleźć w dokumentacji GNPS (dostępnej pod adresem ).
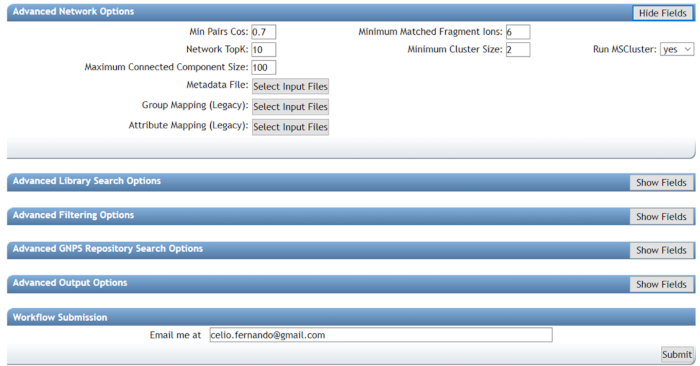
Rycina 5: Wykorzystanie GNPS do przeprowadzania analizy sieci molekularnych (opcje zaawansowane). Parametr Min Pair Cos będzie mieć bezpośredni wpływ na wielkość klastrów, ponieważ wysokie wartości doprowadzą do połączenia związków blisko spokrewnionych, a niskie wartości do połączenia związków spokrewnionych w stopniu niewielkim. Należy unikać stosowania zbyt niskich wartości. Minimum matched fragment ions określa liczbę wspólnych fragmentów między dwoma widmami fragmentacji, które mają zostać połączone w sieci. Oba te parametry wspólnie określają strukturę sieci; niższe wartości spowodują zgrupowanie związków bardziej odległych i na odwrót. Zastosowanie odpowiednich wartości w znacznym stopniu ułatwi identyfikację związków. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
- Wybierz adres e-mail, na który zostanie wysłane powiadomienie po zakończeniu pracy, a następnie zatwierdź zlecenie.
7. Analiza wyników GNPS
- Zaloguj się do GNPS. Wybierz Jobs > Published job > Done, aby otworzyć zadanie. Otworzy się strona internetowa przedstawiona na Rysunku 6. Wyświetlone zostaną wszystkie wyniki uzyskane z sieci molekularnych.
- Wybierz View Spectral Families (In Browser Network Visualizer, aby zobaczyć wszystkie klastry sieciowe (czerwona ramka, Rysunek 6).
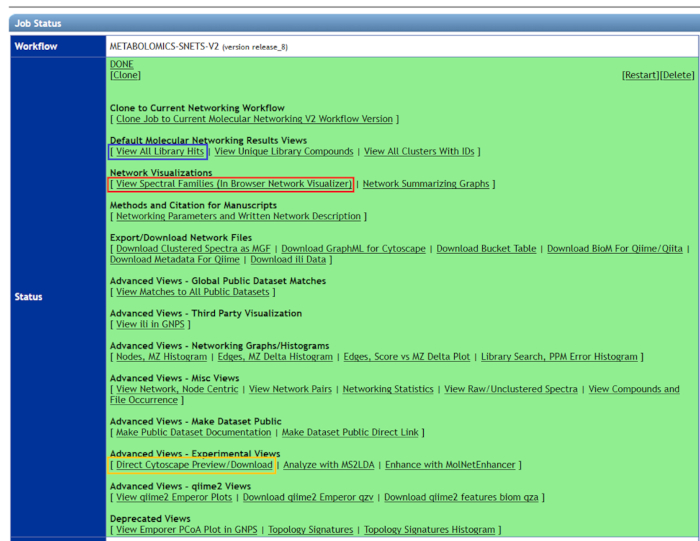
Rysunek 6: Wykorzystanie GNPS do wizualizacji wyników sieci molekularnych. Wszystkie powiązane klastry związków można wyświetlić w sekcji view spectral families (czerwona ramka). Aby zwizualizować wyłącznie dopasowania z biblioteki, należy wybrać opcję „view all library hits” (niebieska ramka). Dla lepszej reprezentacji graficznej wyników sieci molekularnej należy pobrać narzędzie „Direct Cytoscape Preview” (żółta ramka) i korzystać z najnowszej wersji programu Cytoscape. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
- Wyświetlona zostanie lista wszystkich wygenerowanych klastrów sieci molekularnych. Jeśli w celu uzyskania wyników wybrano przeszukiwanie biblioteki, wstępna identyfikacja cząsteczek zostanie wyświetlona w AllIDs. Wybierz Show, aby je zwizualizować.
UWAGA: Analizy danych mogą być ukierunkowane na inne wyniki (np. mining genomu, testy biologiczne, dereplikację cząsteczek z bibliotek itp.). - Aby przeanalizować klaster sieci molekularnej, wybierz Visualize Network.
UWAGA: Każdy klaster składa się z węzłów (kół) i krawędzi, które reprezentują odpowiednio cząsteczki oraz podobieństwo molekularne. Zdereplikowane cząsteczki będą wyróżnione jako niebieskie węzły w internetowym wizualizatorze sieci. - W polu etykiet węzłów wybierz parent mass (czerwona ramka, Rysunek 7).
- W polu etykiet krawędzi wybierz Cosine lub DeltaMZ, aby zaobserwować odpowiednio podobieństwo węzłów lub różnicę mas między węzłami (żółta ramka, Rysunek 7).
- W przypadku analiz wielogrupowych kliknij Draw pies w polu kolorowania węzłów, aby zaobserwować częstotliwość występowania każdego węzła w każdej grupie (niebieska ramka, Rysunek 7).
UWAGA: Możliwe są inne wybory, ale powyższe sugestie są optymalne dla adnotacji węzłów klastra i analizy ich struktur.
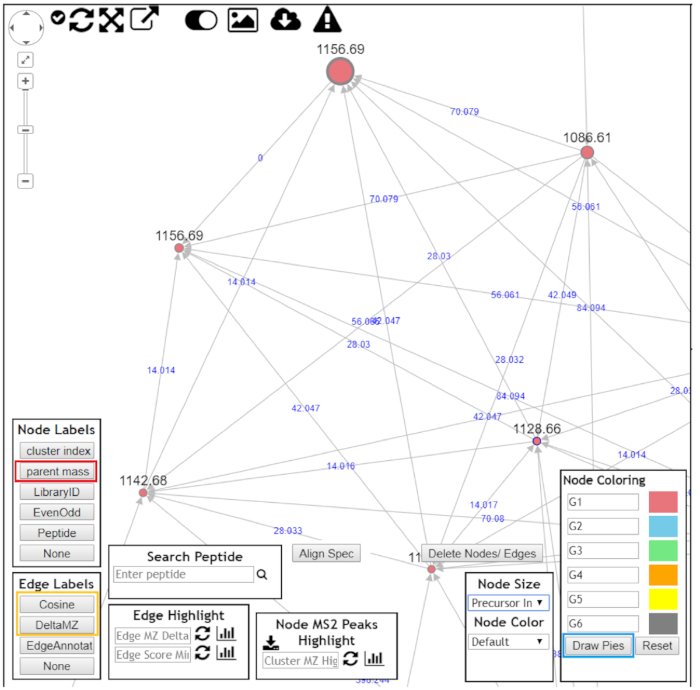
Rycina 7: Wykorzystanie GNPS do wizualizacji wyników klastrowania molekularnego. Po otwarciu klastrów molekularnych w celu lepszej wizualizacji danych, należy wybrać następujące opcje: „Parent mass” jako etykiety węzłów (czerwona ramka), „DeltaMZ” jako etykiety krawędzi (żółta ramka) oraz „Draw pies” jako kolorowanie węzłów (niebieska ramka). Przejdź przez klaster molekularny i spróbuj zaanotować wszystkie węzły. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
- Aby wyświetlić wszystkie trafienia z biblioteki, wybierz View all library hits (niebieska ramka, Rysunek 7).
UWAGA: Sieć MNW można również pobrać w sekcji „Direct Cytoscape Preview/Download” (żółta ramka, Rysunek 7), a plik można otworzyć w platformie Cytoscape (dostępnej pod adresem ), aby uzyskać więcej opcji wizualizacji struktury graficznej. - Wymagana jest ręczna weryfikacja zdereduplikowanych związków oraz wyjaśnienie struktury związków pokrewnych. Otwórz widma fragmentacji bezpośrednio w platformie GNPS lub w oryginalnych plikach surowych.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Protokół został pomyślnie zademonstrowany z wykorzystaniem kombinacji eksploracji genomu (genome mining), ekspresji heterologicznej oraz podejść sterowanych spektrometrią mas (MS) i kodem, w celu uzyskania nowych cząsteczek będących wyspecjalizowanymi analogami walinomycyny. Przepływ pracy od genomu do cząsteczki dla celu, jakim jest walinomycyna (VLM), przedstawiono w Rysunek 8. Streptomyces Analizowano in silico projekt genomu szczepu CBMAI 2042, w wyniku czego zidentyfikowano kla...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Największą zaletą tego protokołu jest jego zdolność do szybkiej dereplikacji profili metabolicznych i łączenia informacji genomicznej z danymi MS w celu wyjaśnienia struktur nowych cząsteczek, zwłaszcza analogów strukturalnych2. Na podstawie informacji genomicznych można badać różne chemotypy produktów naturalnych, takie jak poliketydy (PK), peptydy nierybosomalne (NRP) i glikozylowane produkty naturalne (GNP), a także tajemnicze BGC. Badania przesiewowe metabolomiczne dostarczają dowodów na aktyw...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Wsparcie finansowe dla tego badania zostało zapewnione przez São Paulo Research Foundation - FAPESP (2019/10564-5, 2014/12727-5 i 2014/50249-8 dla L.G.O; 2013/12598-8 i 2015/01013-4 dla R.S.; oraz 2019/08853-9 dla C.F.F.A.). B.S.P, C.F.F.A. i L.G.O. otrzymali stypendia Narodowej Rady Rozwoju Naukowego i Technologicznego - CNPq (205729/2018-5, 162191/2015-4 i 313492/2017-4). L.G.O. jest również wdzięczna za wsparcie grantowe udzielone przez program For Women in Science (2008, edycja brazylijska). Wszyscy autorzy wyrażają uznanie dla CAPES (Koordynacja na rzecz Doskonalenia Kadr Szkolnictwa Wyższego) za wspieranie programów podyplomowych w Brazylii.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Acetonitryl | Tedia | AA1120-048 | Klasa HPLC |
| Agar | Oxoid | LP0011 | NA |
| Apramycyna | Sigma Aldrich | A2024 | NA |
| Karbenicylina | Sigma Aldrich | C9231 | NA |
| Wirówka | Eppendorf | NA | 5804 |
| Chloramfenikol | Sigma Aldrich | C3175 | NA |
| Kolumna C18 | Agilent Technologies | NA | ZORBAX RRHD Extend-C18, 80Å, 2.1 x 50 mm, 1.8 µ m, 1200 bar limit ciśnienia P/N 757700-902 |
| Kanamycin | Sigma Aldrich | K1377 | NA |
| Manitol P.A.- A.C.S. | Synth | NA | NA |
| Mikrowirówka | Eppendorf | NA | 5418 |
| Kwas nalidyksowy | Sigma Aldrich | N4382 | NA |
| Phusion Flash High-Fidelity PCR Master Mix | ThermoFisher Scientific | F548S | NA |
| Q-TOF | Agilent technologies | NA | 6550 iFunnel Q-TOF LC/MS |
| Sacarose P.A.- A.C.S. | Synth | NA | |
| NA Shaker/Inkubator | Marconi | MA420 | NA |
| Chlorek sodu | Synth | NA | P. A. - ACS |
| Ekstrakt sojowy | NA | NA | |
| NA | Sacharoza | Synth NA | P. A. - ACS |
| Thermal Cycles | Eppendorf | NA | Mastercycler Nexus Gradient |
| Thiostrepton | Sigma Aldrich | T8902 | NA |
| Trypton | Oxoid | LP0042 | NA |
| Tryptonowy bulion sojowy | Oxoid | CM0129 | NA |
| UPLC | Agilent Technologies | NA | 1290 Infinity LC System |
| Ekstrakt drożdżowy | Oxoid | LP0021 | NA |
Bibliografia
- Davies, J. Specialized microbial metabolites: functions and origins. The Journal of Antibiotics. 66 (7), Tokyo. 361-364 (2013).
- Ziemert, N., Alanjary, M., Weber, T. The evolution of genome mining in microbes - a review. Natural Product Reports. 33 (8), 988-1005 (2016).
- Zerikly, M., Challis, G. L. Strategies for the Discovery of New Natural Products by Genome Mining. ChemBioChem. 10 (4), 625-633 (2009).
- Gomez-Escribano, J. P., Bibb, M. J. Heterologous expression of natural product biosynthetic gene clusters in Streptomyces coelicolor: from genome mining to manipulation of biosynthetic pathways. Journal of Industrial Microbiology & Biotechnology. 41 (2), 425-431 (2014).
- Medema, M. H., et al. Minimum Information about a Biosynthetic Gene cluster. Nature Chemical Biology. 11 (9), 625-631 (2015).
- Lautru, S., Deeth, R. J., Bailey, L. M., Challis, G. L. Discovery of a new peptide natural product by Streptomyces coelicolor genome mining. Nature Chemical Biology. 1 (5), 265-269 (2005).
- Chiang, Y. -M., et al. Molecular Genetic Mining of the Aspergillus Secondary Metabolome: Discovery of the Emericellamide Biosynthetic Pathway. Chemistry & Biology. 15 (6), 527-532 (2008).
- Huang, T., et al. Identification and Characterization of the Pyridomycin Biosynthetic Gene Cluster of Streptomyces pyridomyceticus NRRL B-2517. Journal of Biological Chemistry. 286 (23), 20648-20657 (2011).
- Udwary, D. W., et al. Genome sequencing reveals complex secondary metabolome in the marine actinomycete Salinispora tropica. Proceedings of the National Academy of Sciences. 104 (25), 10376-10381 (2007).
- Gross, H., et al. The Genomisotopic Approach: A Systematic Method to Isolate Products of Orphan Biosynthetic Gene Clusters. Chemistry & Biology. 14 (1), 53-63 (2007).
- Spohn, M., Wohlleben, W., Stegmann, E. Elucidation of the zinc-dependent regulation in Amycolatopsis japonicum enabled the identification of the ethylenediamine-disuccinate ([S,S ]-EDDS) genes. Environmental Microbiology. 18 (4), 1249-1263 (2016).
- Thaker, M. N., Waglechner, N., Wright, G. D. Antibiotic resistance-mediated isolation of scaffold-specific natural product producers. Nature Protocols. 9 (6), 1469-1479 (2014).
- Katz, M., Hover, B. M., Brady, S. F. Culture-independent discovery of natural products from soil metagenomes. Journal of Industrial Microbiology & Biotechnology. 43, 129-141 (2016).
- Quinn, R. A., et al. Molecular Networking as a Drug Discovery, Drug Metabolism, and Precision Medicine Strategy. Trends in Pharmacological Sciences. 38 (2), 143-154 (2017).
- Yang, J. Y., et al. Molecular Networking as a Dereplication Strategy. Journal of Natural Products. 76 (9), 1686-1699 (2013).
- Lommen, A. MetAlign: Interface-Driven, Versatile Metabolomics Tool for Hyphenated Full-Scan Mass Spectrometry Data Preprocessing. Analytical Chemistry. 81 (8), 3079-3086 (2009).
- Katajamaa, M., Miettinen, J., Oresic, M. MZmine: toolbox for processing and visualization of mass spectrometry based molecular profile data. Bioinformatics. 22 (5), 634-636 (2006).
- Pluskal, T., Castillo, S., Villar-Briones, A., Orešič, M. MZmine 2: Modular framework for processing, visualizing, and analyzing mass spectrometry-based molecular profile data. BMC Bioinformatics. 11 (1), 395(2010).
- Tautenhahn, R., Patti, G. J., Rinehart, D., Siuzdak, G. XCMS Online: A Web-Based Platform to Process Untargeted Metabolomic Data. Analytical Chemistry. 84 (11), 5035-5039 (2012).
- Kuhl, C., Tautenhahn, R., Böttcher, C., Larson, T. R., Neumann, S. CAMERA: An Integrated Strategy for Compound Spectra Extraction and Annotation of Liquid Chromatography/Mass Spectrometry Data Sets. Analytical Chemistry. 84 (1), 283-289 (2012).
- Katajamaa, M., Orešič, M. Data processing for mass spectrometry-based metabolomics. Journal of Chromatography A. 1158, 318-328 (2007).
- Liu, W. -T., et al. Interpretation of Tandem Mass Spectra Obtained from Cyclic Nonribosomal Peptides. Analytical Chemistry. 81 (11), 4200-4209 (2009).
- Ng, J., et al. Dereplication and de novo sequencing of nonribosomal peptides. Nature Methods. 6 (8), 596-599 (2009).
- Liaw, C., et al. Vitroprocines, new antibiotics against Acinetobacter baumannii, discovered from marine Vibrio sp. QWI-06 using mass-spectrometry-based metabolomics approach. Scientific Reports. 5 (1), 1-11 (2015).
- Kang, K. B., et al. Targeted Isolation of Neuroprotective Dicoumaroyl Neolignans and Lignans from Sageretia theezans Using in Silico Molecular Network Annotation Propagation-Based Dereplication. Journal of Natural Products. 81 (8), 1819-1828 (2018).
- Wang, M., et al. Sharing and community curation of mass spectrometry data with Global Natural Products Social Molecular Networking. Nature Biotechnology. 34 (8), 828-837 (2016).
- Doroghazi, J. R., et al. A roadmap for natural product discovery based on large-scale genomics and metabolomics. Nature Chemical Biology. 10 (11), 963-968 (2014).
- Medema, M. H., et al. antiSMASH: rapid identification, annotation and analysis of secondary metabolite biosynthesis gene clusters in bacterial and fungal genome sequences. Nucleic Acids Research. 39, 339-346 (2011).
- Weber, T., et al. antiSMASH 3.0-a comprehensive resource for the genome mining of biosynthetic gene clusters. Nucleic Acids Research. 43, 237-243 (2015).
- Blin, K., et al. antiSMASH 5.0: updates to the secondary metabolite genome mining pipeline. Nucleic Acids Research. 47, 81-87 (2019).
- Watrous, J., et al. Mass spectral molecular networking of living microbial colonies. Proceedings of the National Academy of Sciences. 109 (26), 1743-1752 (2012).
- Paulo, B. S., Sigrist, R., Angolini, C. F. F., De Oliveira, L. G. New Cyclodepsipeptide Derivatives Revealed by Genome Mining and Molecular Networking. ChemistrySelect. 4 (27), 7785-7790 (2019).
- Gonzaga de Oliveira, L., Sigrist, R., Sachetto Paulo, B., Samborskyy, M. Whole-Genome Sequence of the Endophytic Streptomyces sp. Strain CBMAI 2042, Isolated from Citrus sinensis. Microbiology Resource Announcements. 8 (2), 1-2 (2019).
- Aziz, R. K., et al. The RAST Server: Rapid Annotations using Subsystems Technology. BMC Genomics. 9 (1), 75(2008).
- Nah, H. -J., Pyeon, H. -R., Kang, S. -H., Choi, S. -S., Kim, E. -S. Cloning and Heterologous Expression of a Large-sized Natural Product Biosynthetic Gene Cluster in Streptomyces Species. Frontiers in Microbiology. 8, 1-10 (2017).
- Zhang, J. J., Tang, X., Moore, B. S. Genetic platforms for heterologous expression of microbial natural products. Natural Product Reports. 36 (9), 1313-1332 (2019).
- Alduina, R., et al. Artificial chromosome libraries of Streptomyces coelicolor A3(2) and Planobispora rosea. FEMS Microbiology Letters. 218 (1), 181-186 (2003).
- Jones, A. C., et al. Phage P1-Derived Artificial Chromosomes Facilitate Heterologous Expression of the FK506 Gene Cluster. PLoS One. 8 (7), 69319(2013).
- Gomez-Escribano, J. P., Bibb, M. J. Engineering Streptomyces coelicolor for heterologous expression of secondary metabolite gene clusters. Microbial Biotechnology. 4 (2), 207-215 (2011).
- Cannell, R. J. P. Natural Products Isolation. , Humana Press. Totowa, NJ. (1998).
- Kersten, R. D., et al. A mass spectrometry-guided genome mining approach for natural product peptidogenomics. Nature Chemical Biology. 7 (11), 794-802 (2011).
- Kersten, R. D., et al. Glycogenomics as a mass spectrometry-guided genome-mining method for microbial glycosylated molecules. Proceedings of the National Academy of Sciences. 110 (47), 4407-4416 (2013).
- Liu, W., et al. MS/MS-based networking and peptidogenomics guided genome mining revealed the stenothricin gene cluster in Streptomyces roseosporus. The Journal of Antibiotics. 67 (1), Tokyo. 99-104 (2014).
- Duncan, K. R., et al. Molecular Networking and Pattern-Based Genome Mining Improves Discovery of Biosynthetic Gene Clusters and their Products from Salinispora Species. Chemistry & Biology. 22 (4), 460-471 (2015).
- Cao, L., et al. MetaMiner: A Scalable Peptidogenomics Approach for Discovery of Ribosomal Peptide Natural Products with Blind Modifications from Microbial Communities. Cell Systems. , (2019).
- Chen, L. -Y., Cui, H. -T., Su, C., Bai, F. -W., Zhao, X. -Q. Analysis of the complete genome sequence of a marine-derived strain Streptomyces sp. S063 CGMCC 14582 reveals its biosynthetic potential to produce novel anti-complement agents and peptides. PeerJ. 7 (1), 6122(2019).
- Kim Tiam, S., et al. Insights into the Diversity of Secondary Metabolites of Planktothrix Using a Biphasic Approach Combining Global Genomics and Metabolomics. Toxins. 11 (9), 498(2019).
- Özakin, S., Ince, E. Genome and metabolome mining of marine obligate Salinispora strains to discover new natural products. Turkish Journal of Biology. 43 (1), 28-36 (2019).
- Trivella, D. B. B., de Felicio, R. The Tripod for Bacterial Natural Product Discovery: Genome Mining, Silent Pathway Induction, and Mass Spectrometry-Based Molecular Networking. mSystems. 3 (2), 00160(2018).
- Maansson, M., et al. An Integrated Metabolomic and Genomic Mining Workflow To Uncover the Biosynthetic Potential of Bacteria. mSystems. 1 (3), 1-14 (2016).
- Blin, K., Kim, H. U., Medema, M. H., Weber, T. Recent development of antiSMASH and other computational approaches to mine secondary metabolite biosynthetic gene clusters. Briefings in Bioinformatics. 20 (4), 1103-1113 (2019).
- Fisch, K. M. Biosynthesis of natural products by microbial iterative hybrid PKS-NRPS. RSC Advances. 3 (40), 18228-18247 (2013).
- Tatsuno, S., Arakawa, K., Kinashi, H. Analysis of Modular-iterative Mixed Biosynthesis of Lankacidin by Heterologous Expression and Gene Fusion. The Journal of Antibiotics. 60 (11), Tokyo. 700-708 (2007).
- Helfrich, E. J. N., Piel, J. Biosynthesis of polyketides by trans-AT polyketide synthases. Natural Product Reports. 33 (2), 231-316 (2016).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
