Celem tego protokołu jest ujawnienie strukturalnej dynamiki jednowymiarowej dyfuzji białka wzdłuż DNA, przy użyciu białka domeny roślinnego czynnika transkrypcyjnego WRKY jako przykładowego systemu. W tym celu wdrożono zarówno atomistyczne, jak i gruboziarniste symulacje dynamiki molekularnej, a także obszerne próbkowanie obliczeniowe.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Symulacja oparta na strukturze i pobieranie próbek ruchów białek czynnika transkrypcyjnego wzdłuż DNA od stopniowania w skali atomowej do dyfuzji gruboziarnistej
* These authors contributed equally
W tym artykule
Podsumowanie
Streszczenie
Jednowymiarowe (1-D) przesuwanie białka czynnika transkrypcyjnego (TF) wzdłuż DNA jest niezbędne do ułatwienia dyfuzji TF w celu zlokalizowania docelowego miejsca DNA dla regulacji genetycznej. Wykrycie rozdzielczości par zasad (bp) TF przesuwającego się lub nadepnięcia na DNA jest nadal eksperymentalnie trudne. Niedawno przeprowadziliśmy symulacje dynamiki molekularnej wszystkich atomów (MD), rejestrując spontaniczne krokowanie 1-pz małego białka TF domeny WRKY wzdłuż DNA. Opierając się na ścieżce krokowej 10 μs WRKY uzyskanej z takich symulacji, protokół tutaj pokazuje, jak przeprowadzić bardziej rozległe próbki konformacyjne systemów TF-DNA, konstruując model stanu Markowa (MSM) dla krokowania białka 1-bp, z różną liczbą mikro- i makrostanów testowanych pod kątem budowy MSM. W celu zbadania procesowego dyfuzyjnego wyszukiwania 1D białka TF wzdłuż DNA o podstawie strukturalnej, protokół pokazuje ponadto, jak przeprowadzać symulacje gruboziarniste (CG) MD w celu próbkowania dynamiki systemu w skali długoterminowej. Takie modelowanie i symulacje CG są szczególnie przydatne do ujawnienia elektrostatycznego wpływu białka-DNA na procesywne ruchy dyfuzyjne białka TF powyżej kilkudziesięciu mikrosekund, w porównaniu z submikrosekundowymi do mikrosekundowymi ruchami krokowymi białek ujawnionymi w symulacjach wszystkich atomów.
Wprowadzenie
Czynniki transkrypcyjne (TF) poszukują docelowego DNA, aby związać i regulować transkrypcję genów oraz związane z tym działania1. Oprócz trójwymiarowej (3D) dyfuzji, zasugerowano, że ułatwiona dyfuzja TF jest niezbędna do poszukiwania docelowego DNA, w którym białka mogą również ślizgać się lub przeskakiwać wzdłuż jednowymiarowego (1D) DNA lub skakać z transferem międzysegmentowym na DNA2,3,4,5,6,7.
W niedawnym badaniu przeprowadziliśmy symulacje dynamiki molekularnej równowagi wszystkich atomów (MD) w ciągu kilkudziesięciu mikrosekund (μs) na roślinnym TF - białku domeny WRKY na DNA8. Udało się uchwycić pełną krokowość WRKY o 1 pz na DNA poli-A w ciągu mikrosekund. Zaobserwowano ruchy białka wzdłuż rowka DNA i dynamiki łamania-reformowania wiązań wodorowych (HBs). Chociaż taka trajektoria reprezentuje jedną próbkowaną ścieżkę, nadal brakuje ogólnego krajobrazu etapowania białek. W tym miejscu pokazujemy, jak rozszerzyć próbkowanie obliczeniowe wokół początkowo przechwyconej ścieżki krokowej białka za pomocą skonstruowanego modelu stanu Markowa (MSM), który został szeroko zaimplementowany do symulacji różnych systemów biomolekularnych obejmujących istotne zmiany konformacyjne i separację w skali czasowej9,10,11,12,13,14,15,16,17,18,19. Celem jest ujawnienie zespołu konformacyjnego i metastabilnych stanów dyfuzji białka TF wzdłuż DNA w jednym cyklicznym kroku.
Podczas gdy powyższa symulacja MD ujawnia atomową rozdzielczość ruchów białka dla 1 pz na DNA, dynamika strukturalna długotrwałej procesowej dyfuzji TF wzdłuż DNA w tej samej wysokiej rozdzielczości jest prawie niedostępna. Przeprowadzanie gruboziarnistych (CG) symulacji MD na poziomie pozostałości jest jednak technicznie dostępne. Skala czasowa symulacji CG może być skutecznie wydłużona do dziesiątek lub setek razy dłużej niż symulacje atomowe20,21,22,23,24,25,26,27,28,29. Tutaj pokazujemy symulacje CG przeprowadzone za pomocą oprogramowania CafeMol opracowanego przez Takada lab30.
W obecnym protokole, najpierw prezentujemy symulacje atomowe białka domeny WRKY wzdłuż DNA poli-A i konstrukcji MSM, które skupiają się na próbkowaniu ruchów krokowych białka tylko przez 1 pz wzdłuż DNA. Następnie przedstawiamy modelowanie CG i symulacje tego samego układu białko-DNA, które rozszerzają próbkowanie obliczeniowe na procesową dyfuzję białek przez dziesiątki bps wzdłuż DNA.
Tutaj używamy GROMACS31,32,33 do przeprowadzania symulacji MD oraz MSMbuilder34 do konstruowania MSM dla próbkowanych migawek konformacyjnych, a także do wizualizacji biomolekuł VMD35. Protokół wymaga, aby użytkownik był w stanie zainstalować i wdrożyć powyższe oprogramowanie. Instalacja i implementacja oprogramowania CafeMol30 jest następnie niezbędna do przeprowadzenia symulacji CG MD. Dalsze analizy trajektorii i wizualizacje są również prowadzone w VMD.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
1. Konstrukcja modelu stanów Markowa (MSM) na podstawie atomowych symulacji MD
- Ścieżka spontanicznego przesuwania się białek i gromadzenie struktur początkowych
- Użyj wcześniej otrzymanego 10-µs wszystkoatomowa MD trajektoria8 aby równomiernie wyodrębnić 10 000 klatek z "do przodu" ścieżka krokowa 1-ps (tj. jedna klatka na każdą nanosekundę). Całkowita liczba klatek musi być wystarczająco duża, aby objąć wszystkie reprezentatywne konformacje.
- Przygotuj ścieżkę przejścia z 10 000 klatkami w programie VMD, klikając Plik > Zapisz współrzędnewpisz białko (protein) lub kwas nukleinowy (nucleic) w polu wybranych atomów (selected atoms) i wybierz klatki w polu klatek (Frames), a następnie kliknij Zapisz aby uzyskać niezbędne klatki.
UWAGA: Wcześniej otrzymany 10 µs trajektoria symulacji MD w pełnym modelu atomowym (nazwana "trajektoria kroku naprzód" tutaj) dla białka WRKY przemieszczającego się w krokach o długości 1 bp wzdłuż 34-bp homogenicznego DNA poli-A8 została wykorzystana jako ścieżka początkowa do przeprowadzenia dalszego próbkowania konformacyjnego. Należy jednak zauważyć, że w większości przypadków ścieżka początkowa jest konstruowana poprzez przeprowadzanie symulacji MD sterowanych (steered MD) lub celowanych (targeted MD) bądź poprzez wdrażanie ogólnych metod generowania ścieżek itp.36,37,38,39. - Ustaw oś długą referencyjnego DNA (pochodzącego ze struktury krystalicznej) wzdłuż osi x, a początkowy środek masy (COM) pełnego DNA o długości 34 bp w początku układu współrzędnych, aby ułatwić dalszą analizę danych. Aby to zrobić, kliknij Rozszerzenia > Konsola Tk w programie VMD, a następnie w oknie konsoli poleceń Tk wpisz:
źródło rotate.tcl
Skrypt tcl znajduje się w Plik uzupełniający 3. - Następnie należy obliczyć średni kwadratowy odchylenie (RMSD) szkieletu białkowego, dopasowując centralne 10 bp DNA (A 14–23 oraz T 14'–23') do fragmentu z struktury krystalicznej.40, a wartość RMSD reprezentują miary geometryczne układów (patrz Rycina 1A). Zrób to, klikając VMD > Rozszerzenia > Analiza > Narzędzie do analizy trajektorii RMSD wpisz nucleic oraz residue 14 to 23 and 46 to 55 w polu wyboru atomów (atom selection box), a następnie kliknij Wyrównaj a następnie RMSD pole do obliczenia wartości RMSD.
- Obliczanie stopnia obrotu białka wokół DNA Θ(t) na płaszczyźnie y-z w programie MATLAB, wpisując polecenie
rad2deg(atan(z/y))
przy założeniu, że początkowe ustawienie kątowe zdefiniowano jako Θ(0)=0, zgodnie z wcześniej przeprowadzoną procedurą8. - Wpisz poniższą komendę w programie MATLAB41 do zastosowania metod K-średnich42,43,44 or zaklasyfikować 10 000 struktur do 25 klastrów, wpisując:
[idx, C]=kmeans( X, 25)
Proszę podać tekst źródłowy do tłumaczenia. X jest to macierz 2D przedstawiająca RMSD oraz kąt rotacji białka WRKY na DNA. Należy zebrać struktury tych 25 centrów klastrów do dalszych symulacji MD.
UWAGA: Ponieważ wartość RMSD białka obliczona względem DNA obejmuje zakres około 25 Åwybieramy 25 klastrów, aby uzyskać jeden klaster na angstrom.
- Przeprowadzanie 1Proszę o podanie tekstu źródłowego do tłumaczenia. seria symulacji MD oraz parametry symulacji
- Zbuduj systemy atomistyczne dla 25 struktur, korzystając z oprogramowania GROMACS 5.1.232 przy użyciu pola siłowego parmbsc145 or za pomocą pliku buildsystem.sh z Plik uzupełniający 2 w powłoce
- Przeprowadź 60-ns symulacje MD dla tych 25 układów w ansamblu NPT z krokiem czasowym 2 fs, wpisując w powłoce następujące polecenie:
gmx_mpi grompp -f md.mdp -c npt.gro -p topol.top -o md.tpr
gmx_mpi mdrun -deffnm md
- Klastrowanie 1Proszę podać tekst źródłowy do tłumaczenia. trajektorie MD z zaokrągleniem
- Usuń pierwsze 10 ns z każdej trajektorii symulacji, wpisując w powłoce:
gmx_mpi trjcat -f md.xtc -b 10000 -e 600000 -o newtraj.xtc
oraz zebrać konformacje z 25 × trajektorie o długości 50 ns do klasteryzacji w celu przygotowania struktur wejściowych do późniejszych, bardziej obszernych próbkowania (2nd symulacje MD).
UWAGA: Aby zmniejszyć wpływ początkowej ścieżki i umożliwić lokalną ekwilibrację, z symulacji usunięto pierwsze 10 ns okresu początkowego. - Wybierz pary odległości między białkiem a DNA jako parametry wejściowe dla analizy niezależnych komponentów zależnych od czasu (tICA)46,47,48 projekcja. Użyj make_ndx polecenie w programie GROMACS, aby to zrobić:
gmx_mpi make_ndx -f input.pdb -o index.ndx
UWAGA: W tym przypadku wybrano atomy CA białka oraz ciężkie atomy (NH1, NH2, OH, NZ, NE2, ND2) pozostałości Y119, K122, K125, R131, Y133, Q146, K144, R135, W116, R117, Y134, K118, Q121, które mogą tworzyć wiązania wodorowe (HBs) z nukleotydem DNA i parują się z atomami O1P, O2P oraz N6 nukleotydu DNA (A14-20, T19-23). Wybrane aminokwasy mogą tworzyć z DNA albo trwałe wiązania wodorowe, albo mostki solne. - Skopiuj powyższy wybrany indeks atomów z pliku index.ndx do nowego pliku tekstowego (index.dat). Uzyskaj informacje o parach między tymi atomami za pomocą skryptu python z Plik uzupełniający 1 generate_atom_indices.py oraz typ:
python2.6 generate_atom_indices.py index.dat > IndeksyAtomow.txt
Pozwala to na wygenerowanie 415 par odległości pomiędzy białkiem a DNA. - Oblicz 415 par odległości dla każdej trajektorii, wpisując następującą komendę w oknie poleceń MSMbuilder:
msmb AtomPairsFeaturizer -out pair_features --pair_indices AtomIndices.txt --top references.pdb --trjs "trajectories/*.xtc" --przekształcone cechy_par --krok 5 - Przeprowadź analizę tICA, aby zredukować wymiarowość danych do pierwszych dwóch komponentów (tIC) lub wektorów niezależnych od czasu, wpisując:
msmb tICA -i ../tica_rc_a/tmp/ -o tica_results --n_components 2 --lag_time 10 --gamma 0.05 -t tica_results.h5
UWAGA: tICA to metoda redukcji wymiarowości, która oblicza wartości własne macierzy korelacji z przesunięciem czasowym aby wyznaczyć najwolniej relaksujące stopnie swobody systemu symulacyjnego za pomocą równania:

gdzie Xi(t) jest wartością i-tej współrzędnej reakcji w czasie t, i Xj(t+Δt) jest wartością j-tej współrzędnej reakcji w czasie t+Δt. czy wartość oczekiwana iloczynu Xi(t) oraz Xj(t + Δt) ogólne trajektorie symulacji. Kierunki wzdłuż najwolniej relaksujących stopni swobody odpowiadają największym wartościom własnym powyższej macierzy korelacji z przesunięciem czasowym W tym przypadku 2 tIC wydają się stanowić minimalny zestaw pozwalający na rozróżnienie trzech makrostanów podczas konstrukcji naszej MSM (omówionej później). Można również obliczyć wynik uogólnionej macierzy ilorazu Rayleigha (GMRQ).49, na przykład w celu zbadania optymalnego zestawu komponentów do wykorzystania.
- Użyj polecenia w programie MSMbuilder, aby pogrupować rzutowane zestawy danych w 100 klastrów metodą K-center43,44 metoda (patrz Rysunek 1B):
msmb KCenters -i ./tica_results.h5 -o kcenters_output -t kcenters_output --n_clusters 100.
Wybierz strukturę centralną każdego klastra jako strukturę początkową dla 2nd seria symulacji MD. Zachowaj informacje z symulacji dla 100 symulowanych struktur, w tym pozycje, temperatury, ciśnienia itp., z wyjątkiem prędkości.
UWAGA: Po pierwszej serii 25 symulacji pamięć o ścieżce początkowej uległa zmniejszeniu, dlatego w drugiej serii generujemy więcej klastrów, np. 100 klastrów, aby znacząco rozszerzyć próbkowanie konformacyjne.
- Usuń pierwsze 10 ns z każdej trajektorii symulacji, wpisując w powłoce:
- Przeprowadzanie 2nd seria obszernych symulacji dynamiki molekularnej (MD)
- Przeprowadź 60-ns symulacje MD, rozpoczynając od tych 100 struktur początkowych, po nadaniu wszystkim atomom losowych prędkości początkowych. Nadaj losowe prędkości początkowe, włączając generowanie prędkości w pliku mdp, tzn. zmieniając w pliku md.mdp parametr gen_vel = no na gen_vel = yes.
- Usuń pierwsze 10 ns każdej symulacji, zgodnie z opisem w kroku 1.3.1, i pobierz 2 500 000 migawek z 100 × trajektorie o długości 50 ns w równych odstępach w celu zbudowania modelu MSM.
UWAGA: Należy zauważyć, że w późniejszej konstrukcji makrostanów niewielka liczba stanów pozaszlakowych o szczególnie niskiej populacji (~0,2%, na dole osi X-Θ płaszczyznę), stwierdzono obecność stanów pobocznych. Stany te są klasyfikowane jako jeden makrostan, gdy całkowita liczba makrostanów zostaje ustawiona w zakresie od 3 do 6 (Rysunek 2B). Ponieważ tak nisko zaludniony makrostan obejmuje tylko 3 trajektorie, które zostały ostatecznie usunięte, wyniki przedstawione w niniejszym protokole zostały rzeczywiście otrzymane z 97 × trajektorie o długości 50 ns, obejmujące łącznie 2 425 000 klatek lub migawek.
- Klastrowanie 2nd zaokrąglij trajektorie MD
- Przeprowadź analizę tICA dla 2nd okrągłe trajektorie, tak jak zrobiono to wcześniej. Wprowadź w MSMbuilder:
msmb tICA -i ../tica_rc_a/tmp/ -o tica_results --n_components 2 --lag_time 10 --gamma 0.05 -t tica_results.h5 - Oblicz implikowaną skalę czasową w celu walidacji parametrów dla czasu opóźnienia korelacji Δt oraz liczba mikrostanów (patrz Rysunek 1C),
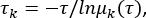
gdzie τ oznacza czas opóźnienia (lag-time) wykorzystany do budowy macierzy prawdopodobieństwa przejścia (TPM); μk(τ) reprezentuje k-tą wartość własną macierzy przejść (TPM) dla czasu opóźnienia wynoszącego τUżyj skryptu Python z Plik uzupełniający 1 dla tego skryptu python BuildMSMsAsVaryLagTime.py -d ../ -f ../trajlist_num -i 50 -m 1000 -t 10 -n 20 -s 500. - Zmieniaj czas opóźnienia τ or liczbę mikrostanów poprzez zmianę parametrów użytych powyżej:
python BuildMSMsAsVaryLagTime.py -d ../ -f ../trajlist_num -i 50 -m 1000 -t 5 10 20 30 40 -n 20 -s 20 200 400 500 800 2000
UWAGA: System uznaje się za markowowski, gdy krzywe implikowanej skali czasowej zaczynają się wypłaszczać wraz z separacją skal czasowych. Następnie należy wybrać Dt jako czas opóźnienia korelacji oraz τ czas opóźnienia, w którym domniemana skala czasowa zaczyna się stabilizować do przygotowania MSM. - W związku z tym należy wybrać stosunkowo dużą (ale nie zbyt dużą) liczbę stanów, N = 500, oraz stosunkowo krótki czas opóźnienia korelacji Δt = 10 ns. Stwierdzono, że czas opóźnienia wynosił τ =10 ns na zbudowanie MSM.
- Zaklasyfikuj konformacje do 500 klastrów (patrz Rycina 1D) za pomocą polecenia:
msmb KCenters -i ./tica_results.h5 -o kcenters_output -t kcenters_output --n_clusters 500
- Przeprowadź analizę tICA dla 2nd okrągłe trajektorie, tak jak zrobiono to wcześniej. Wprowadź w MSMbuilder:
- Konstrukcja MSM
- Pogrupuj 500 mikrostanów w 3–6 makrostany, aby ustalić liczbę makrostanów najlepiej dopasowaną zgodnie z algorytmem PCCA+.50 w programie MSMbuilder, korzystając ze skryptu Pythona w Plik uzupełniający 1 python msm_lumping_usingPCCAplus.py. Identyfikacja zredukowanej sieci kinetycznej modeli dla najważniejszych zmian konformacyjnych biomolekuł poprzez konstrukcję niewielkiej liczby makrostanów, tj. na podstawie poprzez kinetyczne grupowanie setek mikrostanów zgodnie z opisem poniżej17,51.
- Zmapuj wysokowymiarowe konformacje na oś X (ruch białka wzdłuż długiej osi DNA) oraz kąt obrotu białka wzdłuż DNA dla każdego makrostanu, zgodnie z opisem w krokach 1.1.3 i 1.1.4 (np. pomijając stany o zbyt niskiej populacji). < 1%; patrz Rycina 2C). Następnie należy wyznaczyć 3 makrostany, które najlepiej reprezentują system (Rycina 1E) . Patrz Rycina 2D dla ujęć ruchu białka wzdłuż DNA oraz kąta obrotu białka wokół DNA.
UWAGA: W poprzednich pracach podczas generowania 10 μs ścieżkę spontanicznego kroku naprzód białka, przeprowadziliśmy dodatkowo 5 x 4 μs symulacje MD w stanie równowagi w celu umiarkowanego rozszerzenia próbowania. Przedstawiliśmy mapowanie pierwotnej ścieżki w przód (patrz Rycina 2A lewej) i kolejne 4-μs próbkowanie trajektorii na ścieżce w przód przeprowadzone wcześniej (patrz Rysunek 2A prawo)8Mapowanie pierwotnych 100 × 50 ns (patrz Rysunek 2B lewa)8 oraz 97 × przedstawiono trajektorie o długości 50 ns wykorzystane w niniejszej pracy (patrz Rycina 2B prawym).
- Obliczanie średnich czasów pierwszego przejścia (MFPT)
- Przeprowadzić pięć trajektorii Monte Carlo (MC) o długości 10 ms w oparciu o macierz przejść (TPM) modelu MSM składającego się z 500 mikrostanów, przyjmując czas opóźnienia (lag time) wynoszący 10 ns jako krok czasowy MC. Obliczyć średni czas pierwszego przejścia (MFPT).52 między każdą parą makrostanów (Rysunek 3) przez skrypt w języku Python w Plik uzupełniający 1 python python mfpt_msm3.py.
- Oblicz średnią i błąd standardowy MFPT, korzystając z pliku bash w Plik uzupełniający 2, typ:
sh mfpt_analysis.bash
2. Przeprowadzanie symulacji gruboziarnistej (CG) w celu próbkowania dynamiki długoterminowej
- Przeprowadzenie symulacji CG przy użyciu oprogramowania CafeMol 3.030Należy zapoznać się z ustawieniami symulacji CG określonymi w pliku konfiguracyjnym wejściowym z rozszerzeniem .inp, obejmującymi m.in. struktury wejściowe, parametry symulacji oraz pliki wyjściowe. Aby uruchomić symulację CG, należy wpisać w terminalu następującą komendę:
cafemol XXX.inp - Określ następujące bloki w pliku wejściowym, przy czym każdy blok powinien zaczynać się od etykiety <<<< i kończąc na >>>>.
- Skonfiguruj blok nazw plików (wymagane), aby określić katalogi robocze oraz ścieżkę przechowywania plików wejściowych i wyjściowych. W bloku nazw plików dla tych symulacji wpisz następujące dane:
<<<< nazwy plików
ścieżka = XXXXX (ścieżka robocza)
nazwa pliku = wrky (nazwy plików wyjściowych)
WYJŚCIE psf pdb movie dcd rst
path_pdb = XXXXX (ścieżka do wejściowej struktury natywnej)
path_ini = XXXXX (ścieżka do wejściowej struktury początkowej)
path_natinfo = XXXXX (ścieżka do pliku z informacjami natywnymi)
path_para = XXXXX (ścieżka do plików parametrów)
>>>>
UWAGA: Jako model Go53 jest wykorzystywany w modelowaniu CG, co oznacza, że białko będzie dążyć do konformacji natywnej, dlatego należy ustawić modelowaną strukturę jako konformację natywną. W niniejszym przypadku jako konformację natywną ustawiono wejściową strukturę krystaliczną. - Ustaw blok sterowania zadaniem (wymagane), aby zdefiniować tryb uruchomienia symulacji. Wpisz następującą komendę:
<<<< sterowanie zadaniem
i_run_mode = 2 (= 2 symulacja w stałej temperaturze)
i_simulate_type = 1 (=1 dynamika Langevina)
i_initial_state = 2 (=2 oznacza, że konfiguracją początkową jest konfiguracja natywna)
>>>>
Wybierz symulacje dynamiki Langevina w stałej temperaturze. - Ustaw blok jednostek i stanu (wymagane), aby zdefiniować informacje dla struktur wejściowych. Wpisz następującą komendę:
<<<< jednostka i stan
i_seq_read_style = 1 (=1 oznacza odczytywanie sekwencji z pliku PDB)
i_go_native_read_style = 1 (=1 oznacza, że struktura natywna pochodzi z pliku PDB)
1 białko protein.pdb (jednostka&stan typ_cząsteczki struktura_natywna)
2-3 DNA DNA.pdb (jednostka&stan molecular_type native_structure)
>>>>
UWAGA: Wymagane są początkowe pliki struktur wejściowych (tutaj protein.pdb i DNA.pdb). Struktury zapisane są w formacie pdb. Potrzebne są dwa pliki pdb: jeden to plik struktury białka zawierający współrzędne ciężkich atomów WRKY (jednostka 1), a drugi to współrzędne dwuniciowego (ds) DNA o długości 200 pz (jednostki 2-3). Białko zostaje początkowo umieszczone w odległości 15 Å od DNA. - Ustaw wymagany blok funkcji energii zdefiniowany w sekcji energy_function. Wpisz następującą komendę:
<<<< funkcja energii
LOKALNIE(1) L_GO
LOCAL(2-3) L_DNA2
NLOCAL(1/1) GO EXV ELE
NLOCAL(2-3/2-3) ELE DNA
NLOCAL(1/2-3) EXV ELE
i_use_atom_protein = 0
i_use_atom_dna = 0
i_para_from_ninfo = 1
i_triple_angle_term = 2
>>>>
UWAGA: W symulacjach CG białko jest reprezentowane w modelu gruboziarnistym (coarse-grained) zgodnie z modelem Go.53 gdzie każdy aminokwas jest reprezentowany przez cząsteczkę CG umieszczoną w jego węźle Cα położenie. Konformacja białka będzie wówczas przesunięta w stronę struktury natywnej lub struktury krystalicznej tutaj, przy zastosowaniu potencjału Go (Rycina 4A lewej). DNA jest opisane za pomocą modelu 3SPN.254, w której każdy nukleotyd jest reprezentowany przez 3 cząstki CG: S, P i N, odpowiadające odpowiednio cukrowi, fosforanowi i zasadzie azotowej (Rysunek 4A prawie). Oddziaływania elektrostatyczne oraz siły van der Waalsa są uwzględniane pomiędzy różnymi łańcuchami. Oddziaływania elektrostatyczne między białkiem a DNA w symulacji CG są przybliżone za pomocą potencjału Debye’a-Hückla55Energia odpychania vdW przyjmuje taką samą formę, jak w modelu Go. - Ustaw wymagalny blok md_information w celu zdefiniowania informacji o symulacji. Wpisz następującą komendę:
<<<< informacje_md
n_step_sim = 1
n_tstep(1) = 500000000
tstep_size = 0,1
n_step_save = 1000
n_sąsiadów_kroku = 100
i_com_zeroing = 0
i_no_trans_rot = 0
tempk = 300,0
n_seed = -1
>>>>
Wartość n_tstep określa krok symulacji. Parametr tstep_size należy ustawić jako długość czasu każdego kroku MD; każdy krok czasowy CG Cafemol wynosi około 200 fs.30zatem każdy krok MD wynosi tutaj 200 × 0,1 fs w zasadzie. Aktualizować listę sąsiadów co 100 kroków MD (n_step_neighbor = 100). Ustaw temperaturę symulacji na 300 K. Kontroluj temperaturę, stosując algorytm Verleta typu velocity do aktualizacji struktury białka z termostatem Berendsena56.
UWAGA: n_step_sim to numer basenu potencjału modelu Go lub numer lokalnego minimum krzywej energii. Potencjał wielobasenowy pozwala na skłonność konformacji białka do przyjmowania różnych struktur, dzięki czemu konformacja białka może zmieniać się z jednego lokalnego minimum w drugie. W tym przypadku zastosowano jedynie jednobasenowy model Go, co oznacza, że w symulacjach białko przyjmuje tylko jedną określoną konformację (strukturę krystaliczną). Jednocześnie, ze względu na brak oddziaływań poprzez wiązania wodorowe między białkiem a DNA itd. w kontekście modelowania w gruboziarnistym ujęciu (CG), ruchy molekularne mogą być próbkowane jeszcze szybciej, tj. > 10 razy więcej niż w symulacjach atomowych. - Ustaw blok elektrostatyczny (wymagane tylko w przypadku zastosowania oddziaływań elektrostatycznych) ponieważ oddziaływanie elektrostatyczne jest uwzględniane pomiędzy różnymi łańcuchami, należy użyć tego bloku do zdefiniowania parametrów oddziaływania elektrostatycznego, wpisując:
<<<< elektrostatyczny
cutoff_ele = 10,0
siła_jonowa = 0,15
>>>>
Ustaw długość Debye’a w oddziaływaniu elektrostatycznym na 10 Åodpowiadający warunkom roztworu. Ustawić siłę jonową na 0,15 M, zgodnie z warunkami fizjologicznymi.
- Skonfiguruj blok nazw plików (wymagane), aby określić katalogi robocze oraz ścieżkę przechowywania plików wejściowych i wyjściowych. W bloku nazw plików dla tych symulacji wpisz następujące dane:
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Poślizg sprzężony z rotacją lub przesunięcie o 1 bp białka WRKY na podstawie konstrukcji MSM
Wszystkie konformacje białka na DNA są odwzorowane na ruch podłużny X oraz kąt rotacji środka masy (COM) białka wzdłuż DNA (patrz Rycina 3A). Liniowe sprzężenie tych dwóch stopni swobody wskazuje na przesunięcia domeny białka WRKY na DNA sprzężone z rotacją. Konformacje te można dalej pogrupować w 3 makrostany (S1, S2 i S3) w modelu MSM. Przesunięcie białka WRKY do przodu ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Praca ta dotyczy sposobu przeprowadzania symulacji obliczeniowych opartych na strukturze i pobierania próbek w celu ujawnienia czynnika transkrypcyjnego lub białka TF poruszającego się wzdłuż DNA, nie tylko w atomowych szczegółach krokowania, ale także w dyfuzji procesowej, która jest niezbędna do ułatwionej dyfuzji TF w poszukiwaniu celu DNA. Aby tego dokonać, najpierw skonstruowano model stanu Markowa lub MSM małego białka WRKY w domenie TF krokowego dla 1-bp wzdłuż jednorodnego DNA poli-A, dzięki czemu można ujawnić z...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy nie pozostają w konflikcie interesów.
Podziękowania
Ta praca została wsparta przez Grant NSFC #11775016 i #11635002. JY jest wspierany przez CMCF UCI za pośrednictwem NSF DMS 1763272 oraz grantu #594598 Fundacji Simonsa i funduszu startowego z UCI. LTD jest wspierana przez Fundację Nauk Przyrodniczych w Szanghaju #20ZR1425400 i #21JC1403100. Dziękujemy również za wsparcie obliczeniowe ze strony Pekińskiego Centrum Badań Obliczeniowych (CSRC).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| CafeMol | w Kioto | Symulacje gruboziarniste (CG) | |
| GROMACS | Uniwersytet w Groningen Królewski Instytut Technologii Uniwersytet | Oprogramowanie do symulacji dynamiki molekularnej | |
| Matlab | MathWorks | Oprogramowanie do obliczeń numerycznych | |
| MSMbuilder | Uniwersytet | zbuduj MSM | |
| VMD | Program | wizualizacji molekularnej |
Bibliografia
- Latchman, D. S. Transcription factors: an overview. The International Journal of Biochemistry & Cell Biology. 29 (12), 1305-1312 (1997).
- Berg, O. G., von Hippel, P. H. Selection of DNA binding sites by regulatory proteins. Statistical-mechanical theory and application to operators and promoters. Journal of Molecular Biology. 193 (4), 723-750 (1987).
- von Hippel, P. H., Berg, O. G. Facilitated target location in biological systems. The Journal of Biological Chemistry. 264 (2), 675-678 (1989).
- Halford, S. E., Marko, J. F. How do site-specific DNA-binding proteins find their targets. Nucleic Acids Research. 32 (10), 3040-3052 (2004).
- Slusky, M., Mirny, L. A. Kinetics of protein-DNA interaction: facilitated target location in sequence-dependent potential. Biophysical Journal. 87 (6), 4021-4035 (2004).
- Bauer, M., Metzler, R. Generalized facilitated diffusion model for DNA-binding proteins with search and recognition states. Biophysical Journal. 102 (10), 2321-2330 (2012).
- Shvets, A. A., Kochugaeva, M. P., Kolomeisky, A. B. Mechanisms of Protein Search for Targets on DNA: Theoretical Insights. Molecules. 23 (9), Basel, Switzerland. 2106(2018).
- Dai, L., Xu, Y., Du, Z., Su, X. D., Yu, J. Revealing atomic-scale molecular diffusion of a plant-transcription factor WRKY domain protein along DNA. Proceedings of the National Academy of Sciences of the United States of America. 118 (23), 2102621118(2021).
- Chodera, J. D., Singhal, N., Pande, V. S., Dill, K. A., Swope, W. C. Automatic discovery of metastable states for the construction of Markov models of macromolecular conformational dynamics. The Journal of Chemical Physics. 126 (15), 155101(2007).
- Pan, A. C., Roux, B. Building Markov state models along pathways to determine free energies and rates of transitions. The Journal of Chemical Physics. 129 (6), 064107(2008).
- Bowman, G. R., Huang, X., Pande, V. S. Using generalized ensemble simulations and Markov state models to identify conformational states. Methods. 49 (2), San Diego, California. 197-201 (2009).
- Prinz, J. H., et al. Markov models of molecular kinetics: Generation and validation. The Journal of chemical physics. 134 (17), 174105(2011).
- Chodera, J. D., Noé, F. Markov state models of biomolecular conformational dynamics. Current Opinion in Structural Biology. 25, 135-144 (2014).
- Malmstrom, R. D., Lee, C. T., Van Wart, A. T., Amaro, R. E. On the Application of Molecular-Dynamics Based Markov State Models to Functional Proteins. Journal of Chemical Theory and Computation. 10 (7), 2648-2657 (2014).
- Husic, B. E., Pande, V. S. Markov State Models: From an Art to a Science. Journal of the American Chemical Society. 140 (7), 2386-2396 (2018).
- Sittel, F., Stock, G. Perspective: Identification of collective variables and metastable states of protein dynamics. The Journal of chemical physics. 149 (15), 150901(2018).
- Wang, W., Cao, S., Zhu, L., Huang, X. Constructing Markov State Models to elucidate the functional conformational changes of complex biomolecules. WIREs Computational Molecular Science. 8, 1343(2018).
- Peng, S., et al. Target search and recognition mechanisms of glycosylase AlkD revealed by scanning FRET-FCS and Markov state models. Proceedings of the National Academy of Sciences of the United States of America. 117 (36), 21889-21895 (2020).
- Tian, J., Wang, L., Da, L. T. Atomic resolution of short-range sliding dynamics of thymine DNA glycosylase along DNA minor-groove for lesion recognition. Nucleic Acids Research. 49 (3), 1278-1293 (2021).
- Chu, J. -W., Izveko, S., Voth, G. The multiscale challenge for biomolecular systems: coarse-grained modeling. Molecular Simulation. 32 (3-4), 211-218 (2006).
- Marrink, S. J., Risselada, H. J., Yefimov, S., Tieleman, D. P., De Vries, A. H. The MARTINI force field: coarse grained model for biomolecular simulations. The Journal of Physical Chemistry B. 111 (27), 7812-7824 (2007).
- Givaty, O., Levy, Y. Protein sliding along DNA: dynamics and structural characterization. Journal of Molecular Biology. 385 (4), 1087-1097 (2009).
- Khazanov, N., Levy, Y. Sliding of p53 along DNA can be modulated by its oligomeric state and by cross-talks between its constituent domains. Journal of Molecular Biology. 408 (2), 335-355 (2011).
- Riniker, S., Allison, J. R., van Gunsteren, W. F. On developing coarse-grained models for biomolecular simulation: a review. Physical Chemistry Chemical Physics : PCCP. 14 (36), 12423-12430 (2012).
- Kmiecik, S., et al. Coarse-Grained Protein Models and Their Applications. Chemical Reviews. 116 (14), 7898-7936 (2006).
- Bhattacherjee, A., Krepel, D., Levy, Y. Coarse-grained models for studying protein diffusion along DNA. WIREs Computational Molecular Science. 6, 515-531 (2016).
- Wang, J., et al. Machine Learning of Coarse-Grained Molecular Dynamics Force Fields. ACS Central Science. 5 (5), 755-767 (2019).
- Joshi, S. Y., Deshmukh, S. A. A review of advancements in coarse-grained molecular dynamics simulations. Molecular Simulation. 47 (10-11), 786-803 (2021).
- Bigman, L. S., Greenblatt, H. M., Levy, Y. What Are the Molecular Requirements for Protein Sliding along DNA. The Journal of Physical Chemistry B. 125 (12), 3119-3131 (2021).
- Kenzaki, H., et al. CafeMol: A Coarse-Grained Biomolecular Simulator for Simulating Proteins at Work. Journal of Chemical Theory and Computation. 7 (6), 1979-1989 (2011).
- Berendsen, H. J. C., vander Spoel, D., van Drunen, R. GROMACS: a message-passing parallel molecular dynamics implementation. Computer Physics Communications. 91 (1-3), 43-56 (1995).
- vander Spoel, D., et al. GROMACS: fast, flexible, and free. Journal of Computational Chemistry. 26 (16), 1701-1718 (2005).
- Abraham, M. J., et al. GROMACS: High performance molecular simulations through multi-level parallelism from laptops to supercomputers. SoftwareX. 1-2, 19-25 (2015).
- Harrigan, M. P., et al. MSMBuilder: Statistical Models for Biomolecular Dynamics. Biophysical journal. 112 (1), 10-15 (2017).
- Humphrey, W., Dalke, A., Schulten, K. VMD: visual molecular dynamics. Journal of Molecular Graphics. 14 (1), 33-38 (1996).
- Izrailev, S., et al. Steered Molecular Dynamics. Computational Molecular Dynamics: Challenges, Methods, Ideas. 4, Springer. Berlin, Heidelberg. 39-65 (1999).
- Schlitter, J., Engels, M., Krüger, P. Targeted molecular dynamics: a new approach for searching pathways of conformational transitions. Journal of Molecular Graphics. 12 (2), 84-89 (1994).
- Maragliano, L., Fischer, A., Vanden-Eijnden, E., Ciccotti, G. String method in collective variables: minimum free energy paths and isocommittor surfaces. The Journal of Chemical Physics. 125 (2), 24106(2006).
- Weiss, D. R., Levitt, M. Can morphing methods predict intermediate structures. Journal of Molecular Biology. 385 (2), 665-674 (2009).
- Xu, Y. P., Xu, H., Wang, B., Su, X. D. Crystal structures of N-terminal WRKY transcription factors and DNA complexes. Protein. 11 (3), 208-213 (2020).
- Higham, D. J., Higham, N. J. MATLAB guide. Society for Industrial and Applied Mathematics. , (2016).
- Hartigan, J. A., Wong, M. A. Algorithm AS 136: A K-Means Clustering Algorithm. Journal of the Royal Statistical Society. Series C (Applied Statistics). 28 (1), 100-108 (1979).
- Gonzalez, T. F. Clustering to minimize the maximum intercluster distance. Theoretical Computer Science. 38, 293-306 (1985).
- Zhao, Y., Sheong, F. K., Sun, J., Sander, P., Huang, X. A fast parallel clustering algorithm for molecular simulation trajectories. Journal of Computational Chemistry. 34 (2), 95-104 (2013).
- Ivani, I., et al. Parmbsc1: a refined force field for DNA simulations. Nature Methods. 13 (1), 55-58 (2016).
- Naritomi, Y., Fuchigami, S. Slow dynamics of a protein backbone in molecular dynamics simulation revealed by time-structure based independent component analysis. The Journal of Chemical Physics. 139 (21), 215102(2013).
- Naritomi, Y., Fuchigami, S. Slow dynamics in protein fluctuations revealed by time-structure based independent component analysis: the case of domain motions. The Journal of Chemical Physics. 134 (6), 065101(2011).
- Pérez-Hernández, G., Paul, F., Giorgino, T., De Fabritiis, G., Noé, F. Identification of slow molecular order parameters for Markov model construction. The Journal of Chemical Physics. 139 (1), 015102(2013).
- McGibbon, R. T., Pande, V. S. Variational cross-validation of slow dynamical modes in molecular kinetics. The Journal of Chemical Physics. 142 (12), 124105(2015).
- Deuflhard, P., Weber, M. Robust Perron cluster analysis in conformation dynamics. Linear Algebra and its Applications. 398, 161-184 (2005).
- Silva, D. A., et al. Millisecond dynamics of RNA polymerase II translocation at atomic resolution. Proceedings of the National Academy of Sciences of the United States of America. 111 (21), 7665-7670 (2014).
- Swope, W. C., Pitera, J. W., Suits, F. Describing Protein Folding Kinetics by Molecular Dynamics Simulations. 1. Theory. The Journal of Physical Chemistry B. 108 (21), 6571-6581 (2004).
- Clementi, C., Nymeyer, H., Onuchic, J. N. Topological and energetic factors: what determines the structural details of the transition state ensemble and "en-route" intermediates for protein folding? An investigation for small globular proteins. Journal of molecular biology. 298 (5), 937-953 (2000).
- Hinckley, D. M., Freeman, G. S., Whitmer, J. K., De Pablo, J. J. An experimentally-informed coarse-grained 3-Site-Per-Nucleotide model of DNA: structure, thermodynamics, and dynamics of hybridization. The Journal of chemical physics. 139 (14), 144903(2013).
- Debye, P., Huckel, E. The theory of the electrolyte II-The border law for electrical conductivity. Physikalische Zeitschrift. 24, 305-325 (1923).
- Berendsen, H. J., Postma, J. V., van Gunsteren, W. F., DiNola, A., Haak, J. R. Molecular dynamics with coupling to an external bath. The Journal of Chemical Physics. 81, 3684-3690 (1984).
- Bowman, G. R. Improved coarse-graining of Markov state models via explicit consideration of statistical uncertainty. The Journal of Chemical Physics. 137 (13), 134111(2012).
- Jain, A., Stock, G. Identifying metastable states of folding proteins. Journal of Chemical Theory and Computation. 8 (10), 3810-3819 (2012).
- Röblitz, S., Weber, M. Fuzzy spectral clustering by PCCA+: application to Markov state models and data classification. Advances in Data Analysis and Classification. 7, 147-179 (2013).
- Mardt, A., Pasquali, L., Wu, H., Noé, F. VAMPnets for deep learning of molecular kinetics. Nature Communications. 9 (1), 5(2018).
- Wang, W., Liang, T., Sheong, F. K., Fan, X., Huang, X. An efficient Bayesian kinetic lumping algorithm to identify metastable conformational states via Gibbs sampling. The Journal of Chemical Physics. 149 (7), 072337(2018).
- Chen, W., Sidky, H., Ferguson, A. L. Nonlinear discovery of slow molecular modes using state-free reversible VAMPnets. The Journal of Chemical Physics. 150 (21), 214114(2019).
- Gu, H., et al. RPnet: a reverse-projection-based neural network for coarse-graining metastable conformational states for protein dynamics. Physical Chemistry Chemical Physics :PCCP. 24 (3), 1462-1474 (2022).
- Lane, T. J., Bowman, G. R., Beauchamp, K., Voelz, V. A., Pande, V. S. Markov state model reveals folding and functional dynamics in ultra-long MD trajectories. Journal of the American Chemical Society. 133 (45), 18413-18419 (2011).
- Konovalov, K. A., Unarta, I. C., Cao, S., Goonetilleke, E. C., Huang, X. Markov State Models to Study the Functional Dynamics of Proteins in the Wake of Machine Learning. JACS Au. 1 (9), 1330-1341 (2021).
- Cao, S., Montoya-Castillo, A., Wang, W., Markland, T. E., Huang, X. On the advantages of exploiting memory in Markov state models for biomolecular dynamics. The Journal of Chemical Physics. 153 (1), 014105(2020).
- Brandani, G. B., Takada, S. Chromatin remodelers couple inchworm motion with twist-defect formation to slide nucleosomal DNA. PLoS Computational Biology. 14 (11), 1006512(2018).
- Tan, C., Terakawa, T., Takada, S. Dynamic Coupling among Protein Binding, Sliding, and DNA Bending Revealed by Molecular Dynamics. Journal of the American Chemical Society. 138 (27), 8512-8522 (2016).
- Terakawa, T., Takada, S. p53 dynamics upon response element recognition explored by molecular simulations. Scientific reports. 5, 17107(2015).
- Brandani, G. B., Niina, T., Tan, C., Takada, S. DNA sliding in nucleosomes via twist defect propagation revealed by molecular simulations. Nucleic Acids Research. 46 (6), 2788-2801 (2018).
- Knotts, T. A., Rathore, N., Schwartz, D. C., de Pablo, J. J. A coarse grain model for DNA. The Journal of Chemical Physics. 126 (8), 084901(2007).
- Freeman, G. S., Hinckley, D. M., Lequieu, J. P., Whitmer, J. K., de Pablo, J. J. Coarse-grained modeling of DNA curvature. The Journal of Chemical Physics. 141 (16), 165103(2014).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
