Hi-C 3.0 to ulepszony protokół Hi-C, który łączy sieciujące formaldehyd i glutaran disuccinimidylu z koktajlem enzymów restrykcyjnych DpnII i DdeI, aby zwiększyć stosunek sygnału do szumu i rozdzielczość wykrywania interakcji chromatyny.
Artykuł metodologiczny
Rejestrowanie konformacji chromosomów w różnych skalach długości
W tym artykule
Podsumowanie
Streszczenie
Przechwytywanie konformacji chromosomów (3C) służy do wykrywania trójwymiarowych oddziaływań chromatyny. Zazwyczaj chemiczne sieciowanie formaldehydem (FA) stosuje się do utrwalania oddziaływań chromatyny. Następnie trawienie chromatyny enzymem restrykcyjnym i późniejsza religacja końców fragmentów przekształca trójwymiarową (3D) bliskość w unikalne produkty ligacji. Wreszcie, po odwróceniu wiązań krzyżowych, usunięciu białka i izolacji DNA, DNA jest ścinane i przygotowywane do sekwencjonowania o wysokiej przepustowości. Częstość ligacji zbliżeniowej par loci jest miarą częstości ich kolokalizacji w przestrzeni trójwymiarowej w populacji komórek.
Sekwencjonowana biblioteka Hi-C dostarcza informacji o częstości interakcji między wszystkimi parami loci dla całego genomu. Rozdzielczość i precyzja Hi-C opiera się na wydajnym sieciowaniu, które utrzymuje kontakty chromatyny oraz częstą i równomierną fragmentację chromatyny. W artykule opisano ulepszony protokół Hi-C in situ, Hi-C 3.0, który zwiększa efektywność sieciowania poprzez połączenie dwóch środków sieciujących (formaldehydu [FA] i glutaranu disuccinimidylu [DSG]), a następnie dokładniejsze trawienie przy użyciu dwóch enzymów restrykcyjnych (DpnII i DdeI). Hi-C 3.0 to pojedynczy protokół do dokładnej kwantyfikacji cech fałdowania genomu w mniejszych skalach, takich jak pętle i domeny kojarzenia topologicznego (TAD), a także cech w większych skalach obejmujących jądro, takich jak przedziały.
Wprowadzenie
Metoda uchwytywania konformacji chromosomów (Chromosome conformation capture) jest stosowana od 2002 roku1. Fundamentalnie każdy wariant uchwytywania konformacji opiera się na utrwaleniu oddziaływań DNA-białko oraz białko-białko w celu zachowania trójwymiarowej organizacji chromatyny. Następnie przeprowadza się fragmentację DNA, zazwyczaj poprzez trawienie restrykcyjne, a na koniec religację bliskich końców DNA, aby przekształcić loci bliskie przestrzennie w unikalne kowalencyjne sekwencje DNA. W początkowych protokołach 3C wykorzystywano PCR do badania specyficznych oddziaływań typu „jeden-do-jednego”. Kolejne testy 4C umożliwiły wykrywanie oddziaływań typu „jeden-do-wszystkich”2, natomiast 5C wykrywało oddziaływania typu „wiele-do-wielu”3. Metoda uchwytywania konformacji chromosomów w pełni rozwinęła się po wprowadzeniu wysokoprzepustowego sekwencjonowania nowej generacji (NGS), co pozwoliło na wykrywanie genomowych oddziaływań typu „wszystkie-do-wszystkich” przy użyciu ogennomowej metody Hi-C4 oraz technik porównywalnych, takich jak 3C-seq5, TCC6 i Micro-C7,8 (zob. również przegląd Denkera i De Laata9).
W metodzie Hi-C do znakowania nawisów 5′ po trawieniu i przed ligacją stosuje się nukleotydy biotynilowane (Rycina 1). Pozwala to na wyselekcjonowanie prawidłowo strawionych i religowanych fragmentów za pomocą kulek pokrytych streptawidyną, co odróżnia tę metodę od GCC10. Istotną aktualizację protokołu Hi-C wprowadzili Rao i wsp.11, którzy przeprowadzili trawienie i religację w nienaruszonych jądrach komórkowych (tzn. in situ), aby zredukować liczbę fałszywych produktów ligacji. Ponadto zastąpienie trawienia enzymem HindIII trawieniem MboI (lub DpnII) zmniejszyło rozmiar fragmentów i zwiększyło potencjalną rozdzielczość Hi-C. Wzrost ten umożliwił wykrywanie struktur o stosunkowo niewielkiej skali oraz bardziej precyzyjną lokalizację genomową punktów kontaktu, takich jak pętle DNA między małymi elementami cis, np. pętle między miejscami wiązania CTCF powstające w wyniku ekstruzji pętli11,12. Ten potencjał wiąże się jednak z pewnymi kosztami. Po pierwsze, dwukrotny wzrost rozdzielczości wymaga czterokrotnego (22) zwiększenia liczby odczytów sekwencjonowania13. Po drugie, niewielkie rozmiary fragmentów zwiększają prawdopodobieństwo pomylenia niestrawionych fragmentów sąsiednich z fragmentami strawionymi i religowanymi14. Jak wspomniano, w Hi-C fragmenty strawione i religowane różnią się od fragmentów niestrawionych obecnością biotyny w miejscu ligacji. Niemniej jednak, wymagane jest prawidłowe usunięcie biotyny z nieligowanych końców, aby zapewnić wyizolowanie wyłącznie miejsc ligacji14,15.
Wraz ze spadkiem kosztów NGS, możliwe staje się badanie fałdowania chromosomów w większych szczegółach. Aby zmniejszyć rozmiar fragmentów DNA, a tym samym zwiększyć rozdzielczość, protokół Hi-C można dostosować poprzez zastosowanie częściej tnących enzymów restrykcyjnych16 lub kombinacji enzymów restrykcyjnych17,18,19. Alternatywnie, w metodach Micro-C można miareczkować MNase7,8, a w DNase Hi-C miareczkować DNase20, aby uzyskać optymalny stopień trawienia.
Niedawna systematyczna ocena podstaw metod 3C wykazała, że detekcja cech fałdowania chromosomów we wszystkich skalach długości uległa znacznej poprawie dzięki sekwencyjnemu sieciowaniu 1% FA, a następnie 3 mM DSG17. Ponadto Hi-C z trawieniem za pomocą HindIII okazało się najlepszą opcją do wykrywania wielkoskalowych cech fałdowania, takich jak przedziały (compartments), natomiast Micro-C było skuteczniejsze w wykrywaniu małkoskalowych cech fałdowania, takich jak pętle DNA. Wyniki te doprowadziły do opracowania jednolitej strategii o wysokiej rozdzielczości „Hi-C 3.0”, która wykorzystuje kombinację sieciujących czynników FA i DSG, a następnie podwójne trawienie endonukleazami DpnII i DdeI21. Hi-C 3.0 stanowi skuteczną strategię do ogólnego zastosowania, ponieważ precyzyjnie wykrywa cechy fałdowania we wszystkich skalach długości17. Poniżej szczegółowo opisano część eksperymentalną protokołu Hi-C 3.0 oraz przedstawiono typowe wyniki, jakich można się spodziewać po sekwencjonowaniu.
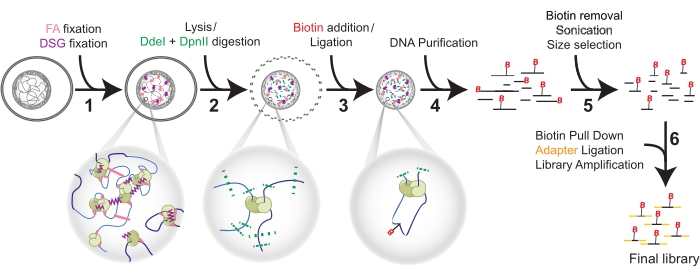
Rysunek 1: Procedura Hi-C w sześciu krokach. Komórki są najpierw fiksowane za pomocą FA, a następnie DSG (1). Następnie po lizie następuje podwójne trawienie enzymami DdeI i DpnII (2). Biotyna jest wprowadzana poprzez wypełnianie nawisów, a proksymalne, stępione końce są ligowane (3) przed oczyszczaniem DNA (4). Biotyna jest usuwana z nieligowanych końców przed sonikacją i selekcją rozmiaru (5). Na koniec pull-down biotyny umożliwia ligację adapterów i amplifikację biblioteki metodą PCR (6). Skróty: FA = formaldehyd; DSG = glutaronian disukcynimidylu; B = biotyna. Kliknij tutaj, aby zobaczyć powiększoną wersję tego rysunku.
Protokół
1. Fiksacja poprzez sieciowanie
- Fiksacja formaldehydem: rozpoczynając od komórek w monowarstwie
- Wysiać komórki w odpowiednim medium, aby uzyskać 5 × 10⁶ komórek na płytkę 150 mm.
UWAGA: Użytkownicy mogą wybrać dowolny preferowany pojemnik zapewniający optymalny wzrost dowolnej linii komórkowej ssaków. Dodatkowo komórki można wyizolować z tkanki. - Odssać medium z płytki 150 mm za pomocą pipety Pasteura połączonej z pułapką próżniową, przemyć 2x ok. 10 mL HBSS.
- Bezpośrednio przed sieciowaniem przygotować w probówce 50 mL roztwór sieciujący 1% FA, łącząc 22,5 mL HBSS i 625 µL 37% FA do stężenia końcowego 1%. Mieszać delikatnie przez kołysanie.
OSTROŻNIE: Należy pracować pod wyciągiem; formaldehyd jest toksyczny. - Aby usieciować komórki, nalać 23,125 mL 1% roztworu FA na każdą płytkę 15 cm.
- Inkubować w temperaturze pokojowej przez 10 min, delikatnie kołysząc płytkami ręcznie co 2 min.
- Dodać 1,25 mL 2,5 M glicyny (stężenie końcowe 128 mM) i delikatnie zamieszać płytkę, aby zatrzymać reakcję sieciowania.
- Inkubować w temperaturze pokojowej przez 5 min, a następnie kontynuować inkubację na lodzie przez co najmniej 15 min, aby całkowicie zatrzymać sieciowanie.
- Zeskrobać komórki z płytek za pomocą skrobaka do komórek lub gumowego policemana.
- Przenieść zawiesinę komórkową do stożkowej probówki 50 mL za pomocą pipety. Centryfugować przy 1,000 × g przez 10 min w temperaturze pokojowej i odessać nadsącz.
- Przemyć osad komórkowy raz 10 mL soli fizjologicznej z buforem fosforanowym Dulbecco (DPBS), resuspendując za pomocą pipety. Następnie centryfugować przy 1,000 × g przez 10 min w temperaturze pokojowej. Bezzwłocznie przejść do sieciowania DSG.
UWAGA: Należy zachować ostrożność podczas przemywania osadu komórkowego, ponieważ może on być luźny, co może prowadzić do utraty komórek.
- Wysiać komórki w odpowiednim medium, aby uzyskać 5 × 10⁶ komórek na płytkę 150 mm.
- Fiksacja formaldehydem: rozpoczynając od komórek w zawiesinie
- Wysiać komórki w odpowiednim medium, aby uzyskać 5 × 10⁶ komórek na naczynie.
UWAGA: Użytkownicy mogą wybrać dowolny preferowany pojemnik zapewniający optymalny wzrost dowolnej linii komórkowej ssaków. - Bezpośrednio przed zbiorem policzyć komórki i przenieść 5 × 10⁶ komórek do stożkowej probówki 50 mL.
- Delikatnie osadzić komórki poprzez centryfugowanie przy 300 × g przez 10 min w temperaturze pokojowej.
- Przygotować 1% roztwór sieciujący FA, dodając 1,25 mL 37% FA do 45 mL HBSS i mieszając poprzez kilkukrotne odwrócenie probówki.
UWAGA: Dodać całe 1,25 mL FA bez dzielenia tej ilości.
OSTROŻNIE: Formaldehyd jest silnie toksyczny. - Resuspendować osad komórkowy w 46,25 mL 1% roztworu sieciującego FA przygotowanego w poprzednim kroku, pipetując w górę i w dół.
- Inkubować w temperaturze pokojowej przez dokładnie 10 min na rotatorze, kołysarce lub poprzez delikatne ręczne odwracanie probówki co 1-2 min.
- Zatrzymać reakcję sieciowania, dodając 2,5 mL 2,5 M glicyny (stężenie końcowe 128 mM) i dobrze wymieszać poprzez odwrócenie probówki.
- Inkubować przez 5 min w temperaturze pokojowej, a następnie na lodzie przez co najmniej 15 min, aby całkowicie zatrzymać sieciowanie.
- Centryfugować w temperaturze pokojowej przy 1,000 × g przez 10 min w celu osadzenia usieciowanych komórek i odessać nadsącz.
- Przemyć komórki raz 10 mL DPBS, a następnie centryfugować przy 1,000 × g przez 10 min w temperaturze pokojowej. Całkowicie usunąć nadsącz za pomocą pipety i bezzwłocznie przejść do sieciowania DSG.
UWAGA: Należy zachować ostrożność podczas przemywania osadu komórkowego, ponieważ może on być luźny, co może prowadzić do utraty komórek.
- Wysiać komórki w odpowiednim medium, aby uzyskać 5 × 10⁶ komórek na naczynie.
- Sieciowanie za pomocą glutaranu disukcynimidylowego
- Resuspendować osadzone komórki w 9,9 mL DPBS przed dodaniem 100 µL 300 mM DSG (stężenie końcowe 3 mM). Wymieszać przez odwracanie.
UWAGA: DSG jest wrażliwy na wilgoć. Ważne jest, aby przygotować świeży roztwór zapasowy 300 mM DSG w DMSO w dniu sieciowania.
OSTROŻNIE: DSG w DMSO jest silnie toksyczny. - Sieciować komórki w temperaturze pokojowej przez 40 min na rotatorze.
- Dodać 1,925 mL 2,5 M glicyny (stężenie końcowe 400 mM), odwrócić w celu wymieszania i inkubować w temperaturze pokojowej przez 5 min.
- Centryfugować komórki przy 2,000 × g przez 15 min w temperaturze pokojowej.
UWAGA: Należy zachować ostrożność podczas usuwania nadsączu z luźnych osadów komórkowych. - Resuspendować osad w 1 mL 0,05% albuminy surowicy bydlęcej (BSA)-DPBS i przenieść do probówki 1,7 mL.
UWAGA: Dodatek BSA może pomóc w zmniejszeniu agregacji komórek. - Centryfugować komórki przy 2,000 × g przez 15 min w 4 °C i usunąć nadsącz za pomocą pipety.
UWAGA: Aby uniknąć utraty osadu, należy szybko i całkowicie usunąć nadsącz. - Szybko zamrozić osad w ciekłym azocie i przechowywać w -80 °C lub bezzwłocznie przejść do następnego etapu.
- Resuspendować osadzone komórki w 9,9 mL DPBS przed dodaniem 100 µL 300 mM DSG (stężenie końcowe 3 mM). Wymieszać przez odwracanie.
2. Przechwytywanie konformacji chromosomów
- Lizą komórek i trawienie chromatyny
- Resuspendować (pipetować) alikwoty sieciowanych komórek (~5 × 10⁶ komórek) w 1 mL lodowatego buforu do lizy (przepis w Tabela uzupełniająca S1) zawierający 10 µL koktajlu inhibitorów proteaz i przeniesienie do homogenizatora Dounce w celu inkubacji przez 15 min w lodzie.
UWAGA: Inhibitory proteaz należy dodać do buforu lizującego bezpośrednio przed użyciem. - Powoli przesuwaj tłuczek A w górę i w dół 30 razy, aby zhomogenizować komórki w lodzie, a następnie inkubuj w lodzie przez 1 min, aby komórki ostygły, przed wykonaniem kolejnych 30 ruchów.
- Przenieś lizat do probówki do mikrowirówki o pojemności 1,7 ml.
UWAGA: Należy stale mieszać zawiesinę, ponieważ komórki mogą osadzać się w końcówce pipety. - Odwiruj lizowaną zawiesinę z prędkością 2500 × g przez 5 min w temperaturze pokojowej.
- Odrzuć nadsącz i przetrzep lub wymieszaj w wirówce wierzchołkowej mokry osad, aby go resuspenderować. Usuń jak najwięcej nadsączu, aby uzyskać substancję o konsystencji jogurtu z minimalną ilością grudek.
- Resuspenduj osad w 500 µL lodowatego 1x buforu restrykcyjnego (z 10x; patrz przepis w Tabela uzupełniająca S1) i wiruj przez 5 min przy 2 500 × gPowtórz ten krok, aby przeprowadzić drugie przemycie.
UWAGA: Osad w 1x buforze restrykcyjnym jest bardziej ziarnisty niż poprzedni osad w buforze do lizy. - Resuspenduj komórki w końcowej objętości 360 µL buforu restrykcyjnego 1x, pipetując po dodaniu około340 µL do objętości pozostałości w osadzie, która zależy od wielkości komórek.
- Odstawić na bok 18 µL każdego lizatu w celu przetestowania integralności chromatyny (CI). Próbki CI należy przechowywać w 4 °C.
- Dodaj 38 µL 1% dodecylosiarczanu sodu (SDS) do każdej probówki Hi-C (całkowita objętość 380 µL) i dokładnie wymieszać poprzez pipetowanie, unikając powstawania pęcherzyków powietrza.
UWAGA: SDS jest toksyczny. - Inkubować próbki w temperaturze 65 °C bez wstrząsania przez dokładnie 10 min w celu rozluźnienia chromatyny.
- Należy niezwłocznie umieścić probówki w lodzie i przygotować mieszaninę do trawienia z Tritonem X-100 w celu zneutralizowania SDS, zgodnie z opisem w Tabela 1.
- Dodaj 107 µL mieszaniny trawiennej do probówki do Hi-C (487 µL (łącznie) w celu strawienia chromatyny przez noc (~16 h) w temperaturze 37 °C w termomikserze z wytrząsaniem interwałowym (np. 900 obr./min, 30 s pracy, 4 min przerwy).
UWAGA: Dodanie Tritonu do stężenia końcowego 1% służy do neutralizacji SDS.
- Resuspendować (pipetować) alikwoty sieciowanych komórek (~5 × 10⁶ komórek) w 1 mL lodowatego buforu do lizy (przepis w Tabela uzupełniająca S1) zawierający 10 µL koktajlu inhibitorów proteaz i przeniesienie do homogenizatora Dounce w celu inkubacji przez 15 min w lodzie.
- Biotynylacja końców DNA
- Po całonocnym trawieniu przenieść próbki do 65 °C przez 20 min w celu dezaktywacji pozostałej aktywności endonukleazy.
- Podczas inkubacji przygotować master mix do uzupełniania, zgodnie z przedstawioną w Tabela 2.
- Po inkubacji należy niezwłocznie umieścić próbki w lodzie.
- Odstawić 10 µL Kontrola trawienia (DC) dla każdej próbki i przechowywanie w 4 °C.
- Usuń kondensat z pokrywki za pomocą pipety lub poprzez wirowanie. Do każdej próbki dodaj 58 µL mieszaniny do uzupełniania biotyną (całkowita objętość próbki 535 µL) i pipetować ostrożnie, aby nie tworzyć pęcherzyków powietrza.
- Inkubować próbki w temperaturze 23 °C przez 4 h w termomikserze (np. 900 obr./min, 30 s pracy, 4 min przerwy).
- Ligacja proksymalnych fragmentów DNA
- Przygotować mieszaninę do ligacji zgodnie z instrukcją w Tabela 3 podczas inkubacji procesu uzupełniania biotyną.
- Dodaj 665 µL mieszaniny do ligacji do każdej próbki (całkowita objętość próbki 1,200 µL). Wymieszać delikatnie, pipetując.
- Inkubować próbki w temperaturze 16 °C przez 4 h w termomikserze z wytrząsaniem przerywanym (np. 900 obr./min, 30 s pracy, 4 min przerwy). Próbki zawierające kowalencyjnie powiązaną chromatynę należy przechowywać w 4 °C przez kilka dni.
- Odwrócenie sieciowania
- Dopełnić objętość próbek CI i DC do 50 µL z użyciem 1x Tris Low EDTA (TLE; przepis znajduje się w Tabela uzupełniająca S1).
- Dodaj 10 µL 10 mg/mL Proteinazy K do próbek CI i DC.
- Inkubować w temperaturze 65 °C przez noc z wytrząsaniem interwałowym (np. 900 obr./min, 30 s włączone, 4 min wyłączone). Alternatywnie, w przypadku tych kontroli, przeprowadzić 30-minutowe odwrócenie sieciowania podczas oczyszczania DNA z próbek Hi-C.
- Do każdej próbki Hi-C dodać 50 µL 10 mg/mL proteinazy K i inkubować w 65 °C przez co najmniej 2 h z przerywanym wstrząsaniem (np. 900 obr./min, 30 s włączone, 4 min wyłączone).
- Dodaj kolejny 50 µL 10 mg/mL Proteinazy K do każdej probówki Hi-C (całkowita objętość próbki 1,300 µL) i kontynuować inkubację w 65 °C przez noc. Przechowywać w 4 °C do momentu oczyszczania DNA.
UWAGA: Podział inkubacji z proteinazą K zapewnia całkowitą proteolizę białek.
- Oczyszczanie DNA
- Pozostawić probówki do ochłodzenia z 65 °C do temperatury pokojowej.
- Przenieś każdą próbkę do stożkowej probówki o pojemności 15 ml i dodaj do każdej z nich 2,6 ml (dwukrotność objętości) mieszaniny fenol:chloroform:alkohol izoamylowy.
OSTROŻNIE: Fenol:chloroform:alkohol izoamylowy jest bardzo toksyczną substancją drażniącą i potencjalnie rakotwórczą. - Mieszaj każdą probówkę na wirówce typu vortex przez 1 min, a następnie przelej jej zawartość do 15 ml probówki do separacji faz (phase-lock).
- Wirować próbki przez 5 min z maksymalną prędkością (1 500–3 500 × g) w wirówce laboratoryjnej.
- Ostrożnie przelej fazę wodną do probówki do ultrawirówki o pojemności 35 ml i dodaj wodę ultrapure do uzyskania objętości końcowej wynoszącej 1,250 µL.
UWAGA: Należy użyć probówek dopasowanych do dostępnej ultrawirówki lub podzielić materiał na kilka probówek do mikrowirówki. - Dodaj 1/10th objętość (~125 µL) 3 M octanu sodu i wymieszać dokładnie poprzez odwracanie probówki.
- Do każdej próbki należy dodać 2,5-krotność objętości (~3,4 mL) lodowatego, 100% etanolu, wyrównać masę probówek do ultrawirowania, dolewając lodowatego, 100% etanolu, a następnie dokładnie wymieszać przez odwracanie.
- Inkubować probówki na suchym lodzie przez ok. 15 min (unikając zestalenia).
- Wiruj probówki z prędkością 18 000 × g przez 30 min w temperaturze 4 °C.
UWAGA: W przypadku wirówek z rotorem kątowym należy zaznaczyć na probówkach miejsce, w którym uformuje się osad. - Za pomocą pipety całkowicie usuń i odrzuć nadsącz ze strony przeciwnej do osadu.
UWAGA: Na tym etapie osad powinien stać się widoczny i można go zaznaczyć na probówce, ponieważ po wysuszeniu w następnym kroku może nie być wyraźnie widoczny. - Suszyć próbki na powietrzu przez około 10 min lub do momentu, aż będą widocznie suche.
- Rozpuścić każdy osad w 450 µL do 1x TLE poprzez pipetowanie lub mieszanie wirowe, a następnie przenieść do jednostki filtra odwirującego (CFU) o objętości 0,5 ml z granicą odcięcia masy cząsteczkowej 3 kDa.
- Odwiruj CFU z maksymalną prędkością przez 10 min i odlej nadsącz. Przemyj każdą probówkę do ultrawirówki dodatkową 450 µL w 1x TLE, a następnie przenieść do wirówki w celu ponownego przemycia.
UWAGA: Płukanie CFU w ten sposób ogranicza utratę DNA, jednocześnie zmniejszając stężenie soli. - Wirować CFU z maksymalną prędkością przez 10 min, a następnie odlać nadsącz.
- Dodaj 80 µL dodać 1x TLE do kolumny, a następnie odwrócić kolumnę do nowej probówki do zbierania i wirować przez 2 min przy maksymalnej prędkości, aby uzyskać objętość końcową wynoszącą ok.100 µL.
- Dodaj 1 µL RNazy A (1 mg/ml; rozcieńczenie 10-krotne z roztworu stokowego o stężeniu 10 mg/ml) do każdej próbki i inkubować w 37 °C na bloku grzewczym, w kąpieli wodnej lub w termomikserze przez co najmniej 30 min.
- Po traktowaniu RNazą należy wyjąć próbki z 37 °C i przechowywać w temperaturze 4 °C do etapu kontroli jakości.
- Kontrola jakości chromatyny, trawienie enzymatyczne i ligacja próbek
- Schłodzić próbki CI i DC do temperatury pokojowej po odwróceniu wiązań krzyżowych w kroku 2.4.5. Następnie przenieść je do wcześniej zakręconej probówki phase-lock o pojemności 2 ml.
UWAGA: Należy upewnić się, że zawartość phase lock została odwirowana do postaci osadu (prędkość maksymalna przez 2 min). - Dodaj 200 µL fenolu:chloroformu:alkoholu izoamylowego, a następnie wymieszać próbki w vorteksie przez 1 min.
- Wirować probówki przez 5 min z maksymalną prędkością.
- Przenieś fazę wodną z każdej próbki (~50 µL) do nowej probówki do wirówki o pojemności 1,7 ml.
- Dodaj 1 µL RNazy A (z roztworu 1 mg/ml) i inkubować w 37 °C przez co najmniej 30 min.
- Nanieś próbki na żel agarozy 0,8% zgodnie z zaleceniami w Tabela 4.
UWAGA: Wyniki oczekiwane z kontroli jakości przedstawiono w Rycina 2. - Oznacz ilość DNA metodą densytometryczną z żelu lub przy użyciu urządzenia Qubit lub Nanodrop.
UWAGA: Precyzyjna kwantyfikacja zapewnia wprowadzenie prawidłowej objętości materiału w kolejnej części protokołu. W celu sporządzenia krzywej wzorcowej należy użyć kilku standardów o znanym stężeniu.
- Schłodzić próbki CI i DC do temperatury pokojowej po odwróceniu wiązań krzyżowych w kroku 2.4.5. Następnie przenieść je do wcześniej zakręconej probówki phase-lock o pojemności 2 ml.
Tabela 1: Odczynniki do trawienia. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 2: Odczynniki do uzupełniania biotyny. *Należy pamiętać, że zmiana enzymów może wymagać zastosowania innych buforów i biotynylowanych dNTP. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 3: Odczynniki do mieszaniny ligacyjnej. Skróty: BSA = albuminy surowicy bydlęcej. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 4: Parametry nakładania na żel do oceny jakości i selekcji rozmiaru. Kliknij tutaj, aby pobrać tę tabelę.
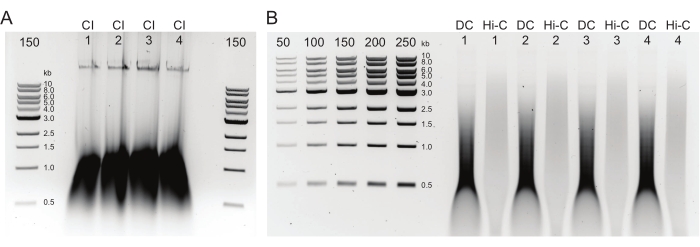
Rycina 2: Żel agarozowy przedstawiający typowe wyniki kontroli jakości po oczyszczaniu DNA. (A) Kontrola CI powinna wykazać prążek DNA o wysokiej masie cząsteczkowej. (B) Próbki DC i Hi-C wykazują zakres wielkości DNA. Próbka Hi-C, w której fragmenty zostały połączone w większe jednostki, powinna mieć wyższą masę cząsteczkową niż DC. Zakres stężeń markerów umożliwia wyznaczenie krzywej wzorcowej. Należy zauważyć, że w tym przykładzie CI naniesiono na osobny żel, jednak zaleca się naniesienie i prowadzenie wszystkich próbek oraz kontroli jednocześnie. Skróty: CI = integralność chromatyny (chromatin integrity); DC = kontrola trawienia (digestion control); Hi-C = ligacja bliskościowa (proximity-ligated). Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
3. Przygotowanie biblioteki do sekwencjonowania Hi-C
- Usuwanie biotyny z niepodlegających ligacji końców
- Przygotować reakcje usuwania biotyny zgodnie z przedstawionym w Tabela 5.
UWAGA: Zazwyczaj 10 µg DNA jest wystarczająca, lecz do 30 µg można zastosować. - Rozdziel 2 x 65 µL alikwoty z każdego 130 µL reakcję do dwóch probówek PCR.
- Przenieść do termocyklera lub urządzenia do PCR i inkubować zgodnie z opisem w Tabela 5.
UWAGA: Próbki można przechowywać w temperaturze 4 °C (od kilku dni do kilku tygodni), -20 °C (długoterminowo) lub niezwłocznie przekazane do sonikacji.
- Przygotować reakcje usuwania biotyny zgodnie z przedstawionym w Tabela 5.
- Sonikacja
- Połącz powtórzenia próbek z etapu usuwania biotyny (130 µL całkowita objętość próbki) do 130 µL probówka do sonikacji do procesu sonikacji.
- Poddaj próbki sonikacji, stosując parametry podane w Tabela 6 aby uzyskać wąski, zwarty rozkład poniżej 500 bp.
UWAGA: Można stosować różne typy sonikatorów, jednak w celu uzyskania wąskiego rozkładu fragmentów (100–500 bp) ustawienia sonikatora mogą wymagać optymalizacji.
- Selekcja wielkości za pomocą kulek magnetycznych
- Przenieś DNA poddanym sonikacji z probówki (lub probówek) sonikatora do probówki o pojemności 1,7 ml typu low binding za pomocą pipety.
- Dopełnić każdą próbkę do całkowitej objętości 500 µL z 1x TLE. Należy dążyć do uzyskania objętości jak najbliższej 500 µLponieważ stosunek próbki do mieszaniny kulek magnetycznych jest kluczowy dla selekcji wielkości.
- Dodaj 400 µL mieszaniny kulek magnetycznych do każdej probówki, aby uzyskać stosunek objętości mieszaniny kulek magnetycznych do objętości próbki równy 0,8.
UWAGA: W tych warunkach kuleczki wiążą fragmenty DNA >300 bp, które będą stanowić frakcję górną. Nadpływ będzie zawierać fragmenty <300 bp, co stanowić będzie frakcję dolną. - Wymieszaj zawartość probówek za pomocą wstrząsarki typu vortex i inkubuj przez 10 min w temperaturze pokojowej na rotatorze. W przypadku tego oraz innych stosunków selekcji wielkości należy upewnić się, że cała objętość próbki została dobrze wymieszana. Warto skorzystać z tzw. „trybu nieregularnego” (erratic mode), który jest dostępny w niektórych rotatorach i sprawdza się w przypadku mniejszych objętości.
- Inkubować przez 5 min w temperaturze pokojowej przy użyciu separatora cząstek magnetycznych (MPS).
- Podczas inkubacji dodać 500 µL mieszaniny kulek magnetycznych do nowej 1.7 µL probówka o niskim wiązaniu dla każdej próbki.
UWAGA: Probówki te zostaną wykorzystane do następnego etapu selekcji rozmiaru frakcji dolnej poprzez przygotowanie mieszaniny kulek magnetycznych i próbki w stosunku 1,1:1. - Pozostaw probówki w urządzeniu MPS na 5 min.
- Usunąć nadsącz z kulek i resuspendować w 150 µL mieszaniny kulek magnetycznych.
UWAGA: Ten krok pozwala uniknąć nasycenia kulek DNA poprzez zwiększenie ich liczby bez zwiększania objętości. - Przenieś nadsącz z kroku 3.3.5 do opisanej probówki przygotowanej do wyboru frakcji dolnej (Lower Fraction) (krok 3.3.8).
UWAGA: 150 µL mieszaniny kulek magnetycznych + 400 µL mieszaniny kulek magnetycznych 0,8x (550 µL (całkowita) podzielona przez 500 µL próbki początkowej = stosunek mieszaniny kulek magnetycznych do próbki wynoszący 1,1x. - Wymieszaj probówki z dolną frakcją (Lower Fraction) za pomocą wirówka typu vortex i inkubuj przez 10 min w temperaturze pokojowej na rotatorze.
UWAGA: Kuleczki będą wiązać fragmenty DNA >100 bp, co skutkuje końcową frakcją związaną z kuleczkami o wielkości 100–300 bp. - Umieść probówki z dolną frakcją na MPS na 5 min (temperatura pokojowa).
- Usunąć nadsącz i krótko odwirować probówki, aby w maksymalnym stopniu usunąć pozostałości nadsączu.
- Przemyć dwa razy kuleczki z obu frakcji za pomocą 200 µL w 70% etanolu, a następnie odzyskuj kuleczki przez 5 min na MPS przy każdym powtórzeniu.
- Po krótkim wirowaniu w wirówce całkowicie usunąć etanol, a następnie dodatkowo osuszyć kuleczki na MPS.
UWAGA: Suszyć do całkowitego odparowania alkoholu. Osad powinien przypominać ciemną czekoladę i nie powinien być spękany (może to zająć ok. 10 min). - Resuspenduj obie frakcje w 50 µL buforu TLE 1x. Inkubować w temperaturze pokojowej przez 10 min, stukując lub potrząsając probówkami co drugą minutę, aby usprawnić mieszanie i elucję.
- Oddziel kuleczki od nadsączu na MPS przez 5 min dla obu frakcji.
- Zachować nadsącz z każdej próbki. Przenieść nadsącz pipetą do probówki 1,7 ml o niskim wiązaniu (low binding).
UWAGA: Próbki można przechowywać w 4 °C przez kilka dni lub w temperaturze -20 °C do długotrwałego przechowywania. - Przeprowadź elektroforezę w 2% żelu agarozowym zgodnie z opisem w Tabela 4 w celu określenia jakości i ilości próbki. Patrz Rycina 3 przykładowy obraz takiego żelu.
UWAGA: Jeśli doświadczenie wskazuje, że sonikacja jest wysoce powtarzalna, można pominąć ten etap elektroforezy w żelu i przejść bezpośrednio do naprawy końców. Zaleca się, aby użytkownicy zachowali frakcje górne (Upper Fractions) do czasu przeprowadzenia PCR miareczkowego. W przypadku uzyskania suboptimalnej ilości DNA, która wymagałaby intensywnej amplifikacji PCR, materiał ten można odzyskać z frakcji górnych. - Ilość DNA z żelu należy określić bezpośrednio po sporządzeniu krzywej wzorcowej na podstawie znanych wartości markera DNA lub przy użyciu urządzenia Qubit lub Nanodrop.
- Naprawa końców
- Przygotować mieszaninę do naprawy końców zgodnie z instrukcją w Tabela 7 (podano ilość na jedną reakcję).
- Przenieść pozostałą część 46 µL elowanego DNA z dolnej frakcji do probówek PCR i dodać 24 µL przygotowanej mieszaniny do naprawy końców. Inkubować w termocyklerze, zgodnie z propozycją w Tabela 7.
- Po zakończeniu programu przechowywać próbki w 4 °C do momentu przeprowadzenia pull-downu.
- Wyciąganie (pull-down) biotynilowanych produktów ligacji za pomocą kulek pokrytych streptawidyną
- Określ ilość kulek powlekanych streptawidyną dla każdej biblioteki na podstawie ilościowego pomiaru po selekcji wielkości (krok 3.3.19).
UWAGA: Te kulki pokryte streptawidyną (roztwór 10 mg/ml) mogą wiązać 20 µg dwuniciowego DNA na mg kuleczek (= 20 µg / 100 µL beads). Użyć 2 µL dla każdego 1 µg DNA Hi-C, lecz nie mniej niż 10 µL. - Wymieszać kuleczki pokryte streptawidyną i pipetować objętość kuleczek wymaganą dla każdej biblioteki (obliczoną w poprzednim kroku) do oddzielnych probówek 1,7 ml o niskim wiązaniu.
- Resuspenduj kuleczki w 400 µL buforu płuczącego z Tweenem (TWB; patrz receptura w Tabela uzupełniająca S1) i inkubować przez ok. 3 min w temperaturze pokojowej na rotatorze (patrz instrukcje w kroku 3.3.4).
- Oddziel koraliki od supernatantu na MPS przez 1 min i usuń supernatant.
- Wypłucz kuleczki, pipetując kolejną 400 µL TWB.
- Oddziel kuleczki od nadsączu w systemie MPS przez 1 min i usuń nadsącz.
- Dodaj 400 µL buforu wiążącego (BB) 2x (przepis w Tabela uzupełniająca S1) do kulek i resuspenduj. Dodatkowo dodaj 330 µL 1x TLE oraz roztworu z etapu naprawy końców (z kroku 3.4.3).
- Próbki inkubować przez 15 min w temperaturze pokojowej, mieszając na rotatorze.
- Oddziel kuleczki od supernatantu na MPS przez 1 min i usuń supernatat.
- Dodaj 400 µL dodaj 1x BB do kulek i resuspenduj.
- Oddziel kuleczki od nadsączu na MPS przez 1 min i usuń nadsącz.
- Dodaj 100 µL 1x TLE do przemycia kulek.
- Oddziel kulki od nadsączu na MPS przez 1 min i usuń nadsącz.
- Na koniec dodać 41 µL 1x TLE w celu resuspensji kulek.
- Określ ilość kulek powlekanych streptawidyną dla każdej biblioteki na podstawie ilościowego pomiaru po selekcji wielkości (krok 3.3.19).
- A-tailing
- Przygotować mieszaninę do A-tailingu zgodnie z opisem w Tabela 8.
- Przenieś mieszaniny reakcyjne pipetą do probówek PCR i inkubuj zgodnie z opisem w Tabela 8.
- Bezpośrednio po wyjęciu z termocyklera należy umieścić probówki do PCR w lodzie, a następnie przenieść ich zawartość do probówek o niskim wiązaniu o pojemności 1,7 ml.
- Oddziel kuleczki od supernatantu na MPS przez 1 min i odrzuć supernatant.
- Dodaj 400 µL 1x buforu do ligacji, rozcieńczonego z 5x buforu do ligazy T4 DNA za pomocą wody ultrapure.
- Oddziel kuleczki od nadsączu w systemie MPS przez 1 min, a następnie odlej nadsącz.
- Dodać bufor do ligacji 1x do objętości końcowej wynoszącej 40 µL.
- Wyżarzanie oligonukleotydów adapterowych
- Przygotuj zapasy oligonukleotydów adapterowych z 100 µM (Tabela 9).
UWAGA: Należy zamówić 250 nmoli oligosów oczyszczonych metodą HPLC. - Przeprowadź hybrydyzację adapterów w probówkach do PCR zgodnie z opisem w Tabela 9.
- Użyj termocyklera PCR, aby stopniowo zwiększać temperaturę do 0.5 °C/s do 97.5 °CUtrzymać w 97.5 °C przez 2,5 min.
- Użyj termocyklera PCR, aby stopniowo zwiększać temperaturę do 0.1 °C/s przez 775 cykli (osiągając 20 °C). Utrzymać temperaturę na poziomie 4 °C do czasu dalszego użycia.
- Dodaj 83 µL 1x buforu do wyżarzania (przepis w Tabela uzupełniająca S1) w celu rozcieńczenia adapterów do 15 µMPrzechowywać adaptery w temperaturze -20 °C.
- Przygotuj zapasy oligonukleotydów adapterowych z 100 µM (Tabela 9).
- Ligacja adapterów sekwencjonujących
- Przygotować mieszaninę do ligacji adapterów w probówce o pojemności 1,7 ml typu low binding (Tabela 10).
- Przeprowadzić ligację przez 2 h w temperaturze pokojowej.
- Oddziel kuleczki od nadsączu w systemie MPS przez 1 min i odrzuć nadsącz.
- Dodaj 400 µL z TWB, a następnie ostrożnie pipetuj kuleczki w górę i w dół przed inkubacją na rotatorze przez 5 min w temperaturze pokojowej. Oddziel kuleczki od supernatantu na MPS i powtórz ten krok jeszcze raz.
- Oddziel kuleczki od nadsączu na MPS (~1 min), odrzuć nadsącz i dodaj 200 µL 1x BB.
- Oddziel kuleczki od nadsączu na MPS (~1 min) i odrzuć nadsącz.
- Dodaj 200 µL 1x buforu przed-PCR (z roztworu 10x; przepis w Tabela uzupełniająca S1) i przenieść do nowej probówki o pojemności 1,7 ml o niskiej wiązalności (low binding).
- Oddziel kuleczki od nadsączu na MPS (~1 min) i odrzuć nadsącz.
- Dodaj 20 µL 1x buforu przed-PCR i wymieszać poprzez pipetowanie.
- Przechowywać probówki w lodzie podczas użytkowania lub przechowywać w temperaturze 4 °C.
- Optymalizacja liczby cykli PCR metodą miareczkowania
- Przygotowanie aparatury 30 µL reakcji z mieszaniną master mix na próbkę, jak w Tabela 11 (podano ilość na jedną reakcję).
- Przeprowadź najmniejszą liczbę cykli i pobierz 5 µL podzielić na alikwoty. Przed pobraniem kolejnej porcji przeprowadzić dodatkowe 2–3 cykle pozostałej reakcji. 5 µL pobrać aلیکwot. Powtórzyć czynność, aby zebrać cztery alikwoty.
- Należy zastosować parametry PCR z Tabela 11 dla każdej alikwoty.
- Dodaj 5 µL wody i 2 µL po 6x barwnika do każdej 5 µL próbkę. Rozdzielić w żelu agarozowym 2% w buforze TBE (przepis w Tabela uzupełniająca S1) z 25–150 ng drabinki markerów o niskiej masie cząsteczkowej. Patrz Rycina 4 dla oczekiwanych wyników.
UWAGA: Optymalna liczba cykli dla końcowej amplifikacji PCR biblioteki [krok 3.10] to najniższa liczba cykli pozwalająca na uzyskanie widocznego produktu w żelu, pomniejszona o jeden cykl.
- Końcowa amplifikacja PCR biblioteki
- Przygotuj 12 x 30 µL reakcje w celu amplifikacji każdej końcowej biblioteki do sekwencjonowania, zgodnie z Tabela 11.
- Przeprowadzić cykle reakcji PCR zgodnie z Tabela 11 po określeniu liczby cykli na podstawie miareczkowania PCR (krok 3.9.3).
- Po zakończeniu reakcji PCR połącz próbki powtórzone w probówce do wirówki o pojemności 1,7 ml typu low binding.
- Umieść probówki na wirówce MPS i przenieś nadsącz do nowej probówki do mikrowirówki o pojemności 1,7 ml typu low binding.
- Resuspend pozostałe kuleczki pokryte streptawidyną w 20 µL 1x buforu przed-PCR (pre-PCR Buffer).
UWAGA: Niniejszy szablon może być ponownie wykorzystany, jeśli zostanie przechowywany w 4 °C od kilku dni do kilku tygodni lub długoterminowo w temperaturze -20 °C.
- Usuwanie starterów za pomocą mieszaniny kulek magnetycznych
- Użyć 1x buforu TLE (przepis w Tabela uzupełniająca S1) aby skorygować objętość z kroku 3.10.4 do dokładnie 360 µL.
- Do każdej próbki należy dodać 360 µL mieszaniny kulek magnetycznych, a następnie pipetować w górę i w dół w celu wymieszania.
- Mieszaj próbki na rotatorze przez 10 min w temperaturze pokojowej.
- Oddziel kuleczki od supernatantu na MPS w temperaturze pokojowej (3–5 min).
- Przemyj kuleczki dwukrotnie, używając 200 µL w 70% etanolu i odzyskuj koraliki za pomocą MPS przez 5 min przy każdym powtórzeniu.
- Krótko wiruj w wirówce i całkowicie odpipetuj etanol. Osusz koraliki na powietrzu na MPS, aby całkowicie odparować etanol.
UWAGA: Osad powinien mieć kolor ciemnej czekolady i nie powinien być popękany (proces ten może trwać ok. 10 min). - Dodaj 30 µL wodą ultrapure i inkubować w celu elucji DNA przez 10 min w temperaturze pokojowej. Co 2 min delikatnie potrząsać probówkami, aby wspomóc mieszanie.
- Oddziel kuleczki od supernatantu za pomocą MPS przez 5 min.
- Zebrać nadsącz z każdej próbki do nowej probówki o pojemności 1,7 ml.
- Uruchom 1 µL biblioteki w 2% żelu agarozowym TBE (przepis w Tabela uzupełniająca S1) żel w celu uzyskania rozkładu wielkości fragmentów i ilościowego oznaczenia końcowej biblioteki (Rysunek 5).
UWAGA: Trawienie enzymem ClaI może zachodzić wyłącznie w obrębie złączy DpnII-DpnII i służy jako pozytywna kontrola ligacji, która powinna skutkować mniejszym rozkładem rozmiarów fragmentów dla końcowej biblioteki. Końcowe biblioteki można przechowywać przez kilka dni w 4 °C, długoterminowo w temperaturze -20 °Club natychmiast rozcieńczone i przekazane do sekwencjonowania.
Tabela 5: Odczynniki i temperatury do usuwania biotyny Kliknij tutaj, aby pobrać tę tabelę.
Tabela 6: Parametry sonikacji. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 7: Odczynniki i temperatury do naprawy końców. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 8: Odczynniki i temperatury procesu A-tailingu. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 9: Startery PCR i oligosy adapterów typu paired-end wraz z odczynnikami do hybrydyzacji. Skrót: 5PHOS = fosforan 5'. Gwiazdki oznaczają fosforotioatowe zasady DNA. #Połącz indeksowany oligo z oligo uniwersalnym, aby uzyskać hybrydę w postaci indeksowanego adaptera. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 10: Odczynniki do ligacji adapterów. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 11: Odczynniki do PCR i parametry cyklu. Kliknij tutaj, aby pobrać tę tabelę.

Rycina 3: Żel agarozowy pokazujący typowe wyniki po selekcji wielkości fragmentów. Przedstawiono frakcje górną (Upper Fraction) i dolną (Lower Fraction) dla czterech próbek (ponumerowanych 1-4) Hi-C DpnII-DdeI. Pierwsza ścieżka dla każdej próbki zawiera frakcję górną, otrzymaną z mieszaniny kulek magnetycznych 0,8x, a druga i trzecia ścieżka zawierają rozcieńczenie frakcji dolnej otrzymanej z mieszaniny kulek magnetycznych 1,1x. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
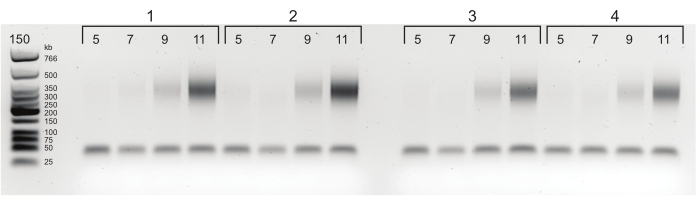
Rysunek 4: Żel agarozowy z wynikami miareczkowania PCR. Począwszy od 5 cykli PCR, próbki pobierano co 2 cykle (5, 7, 9 i 11 cykli) dla każdej z czterech bibliotek. Na podstawie tego rysunku wybrano 6 cykli jako optymalną liczbę cykli dla każdej próbki. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
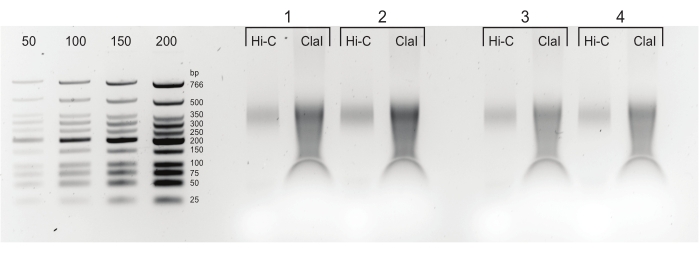
Rycina 5: Końcowe produkty PCR. Po oczyszczaniu i selekcji wielkości, produkty PCR (Hi-C) nałożono obok frakcji tej samej biblioteki trawionej enzymem ClaI (ClaI). Fragmenty trawione ClaI wskazują na obecność poszukiwanych ligacji DpnII-DpnII. Należy zauważyć, że ClaI nie trawi złączy DpnII-DdeI, w związku z czym nie wszystkie ligacje przyczynią się do zmniejszenia wielkości fragmentów w wyniku tej restrykcji. Kliknij tutaj, aby zobaczyć powiększoną wersję tej ryciny.
Wyniki
Ryciny w niniejszym manuskrypcie zostały wygenerowane z osobnego, powtórzonego eksperymentu, innego niż ten opublikowany wcześniej przez Lafontaine i współpracowników21. Po uzyskaniu danych z sekwencjonowania wysokoprzepustowego, do przetworzenia danych Hi-C wykorzystano Open Chromatin Collective (Open2C: https://github.com/open2c). Podobny rurociąg przetwarzania można znaleźć w portalu danych projektu 4D Nucleome (https://data.4dnucleome.org/resources/data-analysis/hi_c-processing-pipeline). W skrócie, zaimplementowano rurociąg Nextflow distiller (https://github.com/open2c/distiller-nf), aby (1) dopasować sekwencje cząsteczek Hi-C do genomu referencyjnego, (2) sparsować pliki dopasowań .sam i utworzyć pliki z parami Hi-C, (3) odfiltrować duplikaty PCR oraz (4) zagregować pary w macierzach binowych interakcji Hi-C. Macierze te w formacie HDF5, nazywane coolerami, mogą być następnie (1) przeglądane na serwerze HiGlass (https://higlass.io/) oraz (2) analizowane przy użyciu szerokiego zestawu otwartych narzędzi obliczeniowych zawartych w kolekcji „cooltools” utrzymywanej przez Open Chromatin Collective (https://github.com/open2c/cooltools), w celu wyodrębnienia i ilościowego określenia cech fałdowania, takich jak przedziały (compartments), TADs i pętle.
Niektóre wskaźniki jakości bibliotek Hi-C3.0 można ocenić bezpośrednio po zmapowaniu par odczytów do genomu referencyjnego, korzystając z kilku prostych metryk/wskaźników. Po pierwsze, w przypadku komórek ludzkich zazwyczaj ok. 50% zsekwencjonowanych par odczytów można zmapować jednoznacznie. Ze względu na polimerową naturę chromosomów, większość tych zmapowanych odczytów (~60%-90%) reprezentuje oddziaływania w obrębie jednego chromosomu (cis), przy czym częstotliwość oddziaływań gwałtownie spada wraz ze wzrostem odległości genomicznej (spadek zależny od odległości). Spadek zależny od odległości najlepiej zobrazować na „wykresie skalowania” (scaling plot), który przedstawia prawdopodobieństwo kontaktu (na ramię chromosomu) jako funkcję odległości genomicznej. Stwierdzono, że zastosowanie różnych czynników sieciujących i enzymów może zmienić charakter spadku zależnego od odległości w zakresach długich i krótkich dystansów17. Dodanie sieciowania DSG zwiększa wykrywalność oddziaływań na krótkich dystansach w połączeniu z takimi enzymami jak Mnase oraz kombinacjami DpnII-DdeI, które generują mniejsze fragmenty (Rycina 6A).
Zależny od odległości spadek sygnału można również zaobserwować bezpośrednio na dwuwymiarowych macierzach oddziaływań: oddziaływania stają się rzadsze wraz ze zwiększaniem odległości od głównej przekątnej (Rysunek 6B). Ponadto cechy fałdowania genomu, takie jak przedziały (compartments), domeny TAD oraz pętle, można zidentyfikować na macierzach Hi-C i wykresach skalowania jako odchylenia od ogólnego średniego dla całego genomu spadku zależnego od odległości. Co istotne, sieciowanie za pomocą DSG w połączeniu z FA zmniejsza liczbę ligacji losowych, które ze względu na polimerową naturę chromosomów są nieograniczone i tym samym częściej występują między chromosomami (in trans) (Rysunek 6C). Ograniczenie ligacji losowych prowadzi do zwiększenia stosunku sygnału do szumu, szczególnie w przypadku oddziaływań międzychromosomalnych oraz bardzo długozasięgowych (>10-50 Mb) w obrębie jednego chromosomu.

Rysunek 6: Reprezentatywne wyniki zmapowanych i przefiltrowanych bibliotek Hi-C. (A) Wykresy skalowania z prawdopodobieństwem kontaktu i jego pochodną dla różnych enzymów, uporządkowane według długości fragmentu (góra) oraz sieciowania za pomocą FA lub FA + DSG (dół). Trawienie przy użyciu MNAse (microC) lub DpnII-DdeI (Hi-C 3.0) znacząco zwiększa liczbę kontaktów krótkozasięgowych (góra), podobnie jak dodanie DSG do FA (dół). (B) Kolumny przedstawiają mapy ciepła Hi-C dla trawienia DpnII po samym sieciowaniu FA oraz trawienia DpnII lub DdeI po sieciowaniu FA+DSG. Białe strzałki wskazują zwiększającą się intensywność „punktów” po sieciowaniu DSG i trawieniu DdeI, co sugeruje lepszą detekcję pętli DNA. Wiersze przedstawiają różne fragmenty chromosomu 3 przy zwiększającej się rozdzielczości, zgodnie z panelem C: górny wiersz: cały chromosom 3 (0-198 295 559 Mb); środkowy wiersz: 186-196 Mb; dolny wiersz: 191,0-191,5 Mb. (C) Wykresy pokrycia dla regionów przedstawionych w części A. Czarne strzałki wskazują niższe pokrycie (% odczytów cis) dla sieciowania samym FA. Skróty: FA = formaldehyd; DSG = glutarate disuccinimidyl; chr = chromosom. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Nie wszystkie zmapowane odczyty są użyteczne. Drugim wskaźnikiem jakości jest liczba duplikatów PCR. Jest wysoce nieprawdopodobne, aby identyczne odczyty wystąpiły przypadkowo po ligacji i sonikacji. Zatem takie odczyty prawdopodobnie są wynikiem amplifikacji PCR i muszą zostać odfiltrowane. Duplikaty często powstają, gdy do amplifikacji bibliotek o niskiej złożoności wymagana jest zbyt duża liczba cykli PCR. Zazwyczaj w przypadku Hi-C większość bibliotek wymaga jedynie 5-8 cykli końcowej amplifikacji PCR, co określa się poprzez PCR miareczkowy (patrz krok 3.9; Rycina 4). Niemniej jednak biblioteki o wystarczającej złożoności można uzyskać nawet po 14 cyklach amplifikacji PCR.
Kolejna kategoria duplikatów odczytów, tzw. duplikaty optyczne, może wynikać z procesu amplifikacji na platformach sekwencjonowania Illumina wykorzystujących wzorcowane ogniwa przepływowe (takich jak HiSeq4000). Duplikaty optyczne powstają albo w wyniku przeładowania ogniwa przepływowego, co powoduje, że (duże) klastry są rozpoznawane jako dwa oddzielne klastry, albo w wyniku lokalnej reklasteryzacji oryginalnej cząsteczki typu paired-end po pierwszej rundzie PCR. Ponieważ oba typy duplikatyw optycznych mają charakter lokalny, można je zidentyfikować i odróżnić od duplikatów PCR na podstawie ich położenia w ogniwie przepływowym. Podczas gdy biblioteki z zawartością >15% duplikatów PCR wymagałyby regeneracji, biblioteki z duplikatami optycznymi mogą zostać ponownie załadowane po zoptymalizowaniu procesu ładowania.
Tabela uzupełniająca S1: Bufory i roztwory. Proszę kliknąć tutaj, aby pobrać tę tabelę.
Dyskusja
Krytyczne etapy obsługi komórek
Chociaż możliwe jest użycie mniejszej liczby komórek wejściowych, protokół ten został zoptymalizowany dla ~5 × 10⁶ komórek na linię sekwencjonowania (~400 mln odczytów), aby zapewnić odpowiednią złożoność po głębokim sekwencjonowaniu. Komórki najlepiej liczyć przed utrwaleniem. W przypadku generowania bibliotek ultragłębokich zazwyczaj mnożymy liczbę linii (i komórek), aż do osiągnięcia żądanej głębokości odczytu. W celu optymalnego utrwalenia, pożywkę zawierającą surowicę należy zastąpić PBS przed utrwaleniem FA, a roztwory utrwalające należy dodać natychmiast i bez gradientów stężeń15,22. W przypadku zbierania komórek skrobanie jest preferowane zamiast trypsynizacji, ponieważ przejście od bardziej płaskiego do kulistego kształtu po trypsynizacji może wpływać na konformację jądrową. Po dodaniu DSG luźne i grudkowate granulki komórkowe łatwo się gubią. Na tym etapie należy zachować ostrożność podczas obchodzenia się z komórkami i dodać do 0,05% BSA, aby zmniejszyć zbrylanie.
Modyfikacje metody
Protokół ten został opracowany przy użyciu komórek ludzkich17. Jednak w oparciu o doświadczenie w wychwytywaniu konformacji chromosomów, protokół ten powinien działać w przypadku większości komórek eukariotycznych. W przypadku znacznie niższego wkładu (~1 × 10⁶ komórek) zalecamy użycie połowy objętości do procedur wychwytywania lizy i konformacji [kroki 2.1-2.4]. Pozwoliłoby to również na przeprowadzenie izolacji DNA [krok 2.5] w wirówce stołowej z probówkami o pojemności 1,7 ml, co mogłoby poprawić granulowanie przy niskich stężeniach DNA. Kwantyfikacja DNA (krok 2.6.6) wskaże, jak należy postępować. W przypadku małych ilości wyizolowanego DNA (1-5 μg) sugerujemy pominięcie wyboru rozmiaru (krok 3.3) i przystąpienie do usuwania biotyny po zmniejszeniu objętości ze 130 μL do ~45 μL za pomocą CFU.
Protokół ten został opracowany specjalnie w celu zapewnienia wysokiej jakości danych po późniejszym sieciowaniu z FA i DSG oraz trawieniu z DpnII i DdeI. Jednak alternatywne strategie sieciowania, takie jak FA, a następnie EGS (bursztynian glikolu etylenowego)), który jest również stosowany w ChIP-seq23 i ChIA-PET24, mogą działać równie dobrze17. Podobnie do trawienia można stosować różne kombinacje enzymów, takie jak DpnII i HinfI18 lub MboI, MseI i NlaIII19 . Dostosowując kombinacje enzymów, należy pamiętać o stosowaniu biotynylowanych nukleotydów, które mogą wypełnić określone 5' zwisy i używać najbardziej optymalnych dla każdego koktajlu. DpnII jest dostarczany z własnym buforem, a producent enzymu zaleca określony bufor do trawienia DdeI. Jednak w przypadku podwójnego trawienia z DpnII i DdeI w tym protokole zalecany jest bufor restrykcyjny, ponieważ jest on oceniany na 100% aktywność dla obu enzymów.
Rozwiązywanie problemów z przechwytywaniem konformacji
Trzy kluczowe etapy wychwytywania konformacji chromosomów: sieciowanie, trawienie i religacja zostały wykonane, zanim wyniki będzie można zwizualizować na żelu. Aby określić jakość każdego z tych trzech etapów i określić, gdzie mogły wystąpić problemy, pobiera się podwielokrotności przed (CI) i po trawieniu (DC) i umieszcza je w żelu wraz z ligowaną próbką Hi-C (ryc. 2). Żel ten służy do określenia jakości próbki Hi-C i tego, czy warto będzie kontynuować protokół. Bez CI i DC trudno jest wskazać potencjalne nieoptymalne kroki. Warto zauważyć, że nieoptymalne podwiązanie może być spowodowane problemem w samym podwiązaniu, wypełnieniu lub problemem z sieciowaniem. Aby rozwiązać problemy z sieciowaniem, pamiętaj, aby nie używać więcej niż 1 × 10⁷ komórek na bibliotekę i zacznij od świeżych odczynników do sieciowania i czystych komórek (tj. przepłukanych PBS). W przypadku podwiązania upewnij się, że komórki i mieszanina ligacji są trzymane na lodzie. Dodać ligazę DNA T4 tuż przed 4 godzinną inkubacją w temperaturze 16 °C i dobrze wymieszać.
Rozwiązywanie problemów z przygotowywaniem biblioteki
Jeśli potrzebnych jest więcej niż 10 cykli PCR lub po miareczkowaniu PCR na żelu nie widać produktu PCR (ryc. 4), istnieje kilka opcji zapisania próbki Hi-C. Wracając do miareczkowania PCR, pierwszą opcją jest ponowna próba PCR. Jeśli nadal nie ma wystarczającej ilości produktu, można spróbować kolejnej rundy ogona A i podwiązania adaptera (krok 3.6) po dwukrotnym umyciu kulek buforem 1x TLE. Po tym dodatkowym ogonie A i podwiązaniu adapterem można przejść do miareczkowania PCR jak poprzednio. Jeśli nadal nie ma produktu, ostatnią opcją jest ponowne rozpoznanie ułamka 0,8x z kroku 3.3 i kontynuowanie od tego miejsca.
Ograniczenia i zalety Hi-C3.0
Ważne jest, aby zdać sobie sprawę, że Hi-C jest metodą opartą na populacji, która rejestruje średnią częstotliwość interakcji między parami loci w populacji komórek. Niektóre analizy obliczeniowe mają na celu rozwikłanie kombinacji konformacji z populacji25, ale w zasadzie Hi-C jest ślepy na różnice między komórkami. Chociaż możliwe jest wykonanie pojedynczej komórki Hi-C26,27 i można dokonać wnioskowania obliczeniowego28, jednokomórkowa Hi-C nie nadaje się do uzyskiwania informacji 3C o ultrawysokiej rozdzielczości. Dodatkowym ograniczeniem Hi-C jest to, że wykrywa on tylko oddziaływania parami. Do wykrywania oddziaływań wielokontaktowych można użyć częstych obcinaczy w połączeniu z sekwencjonowaniem krótkiego odczytu (Illumina)16 lub wykonać wielokontaktowe 3C29 lub 4C30, używając sekwencjonowania długiego odczytu z platform PacBio lub Oxford Nanopore. Opracowano również pochodne Hi-C do specyficznego wykrywania kontaktów między chromatydami siostrzanymi i wzdłuż nich31,32.
Chociaż Hi-C19 i Micro-C33 mogą być używane do generowania map kontaktowych w rozdzielczościach subkilobazowych, oba wymagają dużej ilości odczytów sekwencjonowania, co może stać się kosztownym przedsięwzięciem. Aby uzyskać podobną, a nawet wyższą rozdzielczość bez ponoszenia kosztów, można zastosować wzbogacanie o określone regiony genomu (capture-C34) lub specyficzne interakcje białkowe (ChiA-PET35, PLAC-seq36, Hi-ChIP37). Zaletą i wadą tych aplikacji wzbogacających jest to, że próbkowana jest tylko ograniczona liczba interakcji. Przy takich wzbogaceniach zatraca się globalny aspekt Hi-C (i możliwość globalnej normalizacji).
Znaczenie i potencjalne zastosowania Hi-C3.0
Protokół ten został zaprojektowany, aby umożliwić uzyskanie wysokiej rozdzielczości, ultragłębokiego 3C, przy jednoczesnym wykrywaniu elementów składania na dużą skalę, takich jak TAD i komory17 (ilustracja 6). Protokół ten zaczyna się od 5 × 10⁶ komórek na probówkę dla każdej biblioteki Hi-C, co powinno wystarczyć do sekwencjonowania jednej lub dwóch linii w komórce przepływowej, aby uzyskać do 1 miliarda odczytów sparowanych końców. Do ultragłębokiego sekwencjonowania należy przygotować wiele probówek po 5 × 10⁶ komórek, w zależności od liczby zmapowanych odczytów i duplikatów PCR. Przy najwyższej rozdzielczości (<1 kb) interakcje pętlowe występują głównie między miejscami CTCF, ale można również wykryć interakcje promotor-wzmacniacz. Czytelnicy mogą zapoznać się z Akgol Oksuz et al.17 w celu uzyskania szczegółowego opisu analizy danych.
Oświadczenia
Autorzy nie mają do ujawnienia żadnych konfliktów interesów.
Podziękowania
Chcielibyśmy podziękować Denisowi Lafontaine'owi za opracowanie protokołu i Sergeyowi Venevowi za pomoc bioinformatyczną. Praca ta została wsparta grantem z National Institutes of Health Common Fund 4D Nucleome Program dla J.D. (U54-DK107980, UM1-HG011536). J.D. jest badaczem w Instytucie Medycznym Howarda Hughesa.
Ten artykuł podlega polityce HHMI dotyczącej otwartego dostępu do publikacji. Szefowie laboratoriów HHMI wcześniej udzielali niewyłącznej licencji CC BY 4.0 dla publiczności i licencji podlegającej sublicencjonowaniu dla HHMI w swoich artykułach badawczych. Zgodnie z tymi licencjami, zaakceptowany przez autora manuskrypt tego artykułu może być bezpłatnie udostępniony na licencji CC BY 4.0 natychmiast po publikacji.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| 1 kb Drabina | New England Biolabs | N3232L | |
| Agarose | Invitrogen | 16500100 | |
| Koraliki magnetyczne Agencourt AMPure XP, 60 ml | Beckman Coulter | A63881 | |
| Filtr odśrodkowy Amicon Ultra-0,5 (CFU) | EMD Milipore | UFC500396 | |
| bufor do wyżarzania (5x) | Zobacz przepis w materiałach | ||
| ATP 10 mM | ThermoFisher | R0441 | |
| Avanti J-25i Ultrawirówka z chłodzeniem o dużej prędkości Beckman | Coulter | ||
| Probówka ultrawirówkowa Beckman Coulter 35 ml | Beckman Coulter | 357002 | |
| Bufor wiążący (2x) | Zobacz przepis w materiałach | ||
| biotyna-14-dATP 0,4 mM | Invitrogen | 19524-016 | |
| BSA 10 mg/ml | New England Biolabs | B9000S | rozcieńczony od 20 mg/ml |
| Skrobak do komórek | Falcon | 353089 | |
| Skrobak do komórek | Corning | 3008 | |
| Stożkowe probówki polipropylenowe 50 ml | Denville | C1062-P | |
| Rurka stożkowa 15 ml | Denville | C1017-P | |
| Mikrorurka Covaris AFA z włóknem AFA Zatrzask 130 &MICRO; L | Covaris | 520045/520077 | |
| Covaris Sonicator | Covaris | E220/E220evolution/M220 | |
| Kolba hodowlana 175 cm2 | Falcon | 353112 | |
| Płytki hodowlane 150 mm x 25 mm | Corning | 430599 | |
| dATP 1 | mM Invitrogen | 56172 | |
| dCTP 10 mM | Invitrogen | 56173 | |
| DdeI | New England Biolabs | R0175L | |
| dGTP 10 mM | Invitrogen | 56174 | |
| DMSO | Sigma | D2650-5x10ML | |
| dNTP mix 25 mM | Homogenizator Invitrogen | 10297117 | |
| Dounce | DWK Life Sciences | 8853010002/8853030002 | |
| DPBS | Gibco | 14190-144 | |
| DPNII | New England Biolabs | R0543M | |
| DSG | ThermoScientific | 20593 | |
| dTTP 10 mM | Invitrogen | 56175 | |
| Etanol 70% | Fisher | A409-4 | Rozcieńczony ze 100% |
| bromku etydyny | Fisher | BP1302-10 | |
| Formaldehyd (37%) | Fisher | BP531-500 | |
| Barwnik ładujący w żelu (6x) | New England Biolabs | B7024S | |
| Glicyna w ultraczystej wodzie 2,5 M | Sigma | G8898-1KG | |
| HBSS | Gibco | 14025-092 | |
| Detergent Igepal CA-630 | MP Biomedicals | 198596 | |
| Klenow Polimeraza DNA 5 U/&mikro; L | New England Biolabs | M0210L | |
| Fragment Klenowa 3-->5' egzo-, 5 U/&mikro; L | New England Biolabs | M0212L | |
| (10x) | New England Biolabs | B7203S | |
| Probówka wirówkowa LoBind | |||
| Drabinka DNA o niskiej masie cząsteczkowej | England Biolabs | N3233L | |
| materiały | |||
| Magnetyczny separator cząstek | ThermoFisher | 12321D | |
| Probówki do mikrofuge 1,7 ml | Axygen | MCT-175-C | |
| MyOne Streptawidyna C1 kulki | Invitrogen | 65001 | |
| NEBuffer 2.1 (10x) | New England Biolabs | B7002S | |
| NEBuffer 3.1 (10x) | New England Biolabs | B7203S | |
| PBS | Gibco | 70013-032 | |
| Probówki do PCR (paskowe) Biorad | TBS0201/ TCS0803 | ||
| Termocykler do PCR | Biorad | T100 | |
| Pfu Ultra II Bufor (10x) | Agilent | W zestawie z | |
| polimerazą DNA Pfu Ultra PfuUltra II Fusion HS | Agilent | 600674 | |
| Rurka z blokadą fazową 15 ml | Qiagen | 129065 | |
| Rurki z blokadą fazową 2 ml | Qiagen | 129056 | |
| Fenol: chloroform: alkohol izoamylowy | Invitrogen | 15593-049 | |
| Koktajl inhibitorów proteazy | ThermoFisher | 78440 | |
| Proteinaza K w wodzie ultraczystej 10 mg/ml | Invitrogen | 25530-031 | |
| Wirówka z chłodzeniem | Eppendorf | 5810R | |
| RNaza A, bez DNaz i proteaz 10 mg/ml | Thermo Scientific | EN0531 | |
| Rotator | Argos technologies | EW-04397-40 lub platforma | |
| SDS 1% | Fisher | BP13111 | |
| Octan sodu pH = 5,2, 3 M | Sigma | ||
| Sub-Cell GT System Elektroforezy Poziomej | Biorad | 1704401 | |
| Ligaza DNA T4 1 U/&mikro; L | Invitrogen | 100004817 | |
| Polimeraza DNA | T4 New England Biolabs | M0203L | |
| Polimeraza DNA T4 | New England Biolabs | M0203L | |
| Polimeraza DNA T4 3 U/&mikro; L | Bufor ligacyjny New England Biolabs | M0203L | |
| T4 (5x) | Invitrogen | Y90001 | |
| Kinaza polinukleotydowa T4 10 U/&mikro; L | New England Biolabs | M0201L | |
| Wirówka stołowa | Eppendorf | 5425 | |
| Bufor TBE | Zobacz przepis w materiałach | ||
| Tris Low EDTA Buffer (TLE) | Zobacz przepis w materiałach | ||
| Triton X-100 (10%) | Sigma | 93443 | |
| Adapter Truseq oligos | Zintegrowane DNA Technologie (IDT) | )https://www.idtdna.com/site/order/oligoentry | 250 nmol i oczyszczony HPLC |
| detergent Tween 20 | Fisher | 9005-64-5 | |
| Bufor do płukania Tween | Zobacz przepis w materiałach | ||
| Vortex | Scientific Industries | (G560) SI-0236 |
Bibliografia
- Dekker, J., Rippe, K., Dekker, M., Kleckner, N. Capturing chromosome conformation. Science. 295 (5558), 1306-1311 (2002).
- Simonis, M., et al. Nuclear organization of active and inactive chromatin domains uncovered by chromosome conformation capture-on-chip (4C). Nature Genetics. 38 (11), 1348-1354 (2006).
- Dostie, J., et al. Chromosome Conformation Capture Carbon Copy (5C): a massively parallel solution for mapping interactions between genomic elements. Genome Research. 16 (10), 1299-1309 (2006).
- Lieberman-Aiden, E., et al. Comprehensive mapping of long-range interactions reveals folding principles of the human genome. Science. 326 (5950), 289-293 (2009).
- Stadhouders, R., et al. Multiplexed chromosome conformation capture sequencing for rapid genome-scale high-resolution detection of long-range chromatin interactions. Nature Protocols. 8 (3), 509-524 (2013).
- Kalhor, R., Tjong, H., Jayathilaka, N., Alber, F., Chen, L. Genome architectures revealed by tethered chromosome conformation capture and population-based modeling. Nature Biotechnology. 30 (1), 90-98 (2012).
- Hsieh, T. H., et al. Mapping nucleosome resolution chromosome folding in yeast by micro-C. Cell. 162 (1), 108-119 (2015).
- Hsieh, T. -H. S., Fudenberg, G., Goloborodko, A., Rando, O. J. Micro-C XL: assaying chromosome conformation from the nucleosome to the entire genome. Nature Methods. 13 (12), 1009-1011 (2016).
- Denker, A., de Laat, W. The second decade of 3C technologies: detailed insights into nuclear organization. Genes & Development. 30 (12), 1357-1382 (2016).
- Rodley, C. D., Bertels, F., Jones, B., O’Sullivan, J. M. Global identification of yeast chromosome interactions using Genome conformation capture. Fungal Genetics and Biology. 46 (11), 879-886 (2009).
- Rao, S. S., et al. A 3D map of the human genome at kilobase resolution reveals principles of chromatin looping. Cell. 159 (7), 1665-1680 (2014).
- Alipour, E., Marko, J. F. Self-organization of domain structures by DNA-loop-extruding enzymes. Nucleic Acids Research. 40 (22), 11202-11212 (2012).
- Lajoie, B. R., Dekker, J., Kaplan, N. The Hitchhiker’s guide to Hi-C analysis: Practical guidelines. Methods. 72, 65-75 (2015).
- Belaghzal, H., Dekker, J., Gibcus, J. H. Hi-C 2.0: An optimized Hi-C procedure for high-resolution genome-wide mapping of chromosome conformation. Methods. 123, 56-65 (2017).
- Golloshi, R., Sanders, J. T., McCord, R. P. Iteratively improving Hi-C experiments one step at a time. Methods. 142, 47-58 (2018).
- Darrow, E. M., et al. Deletion of DXZ4 on the human inactive X chromosome alters higher-order genome architecture. Proceedings of the National Academy of Sciences of the United States of America. 113 (31), 4504-4512 (2016).
- Akgol Oksuz, B., et al. Systematic evaluation of chromosome conformation capture assays. Nature Methods. 18 (9), 1046-1055 (2021).
- Ghuryeid, J., et al. Integrating Hi-C links with assembly graphs for chromosome-scale assembly. PLoS Computational Biology. 15 (8), 1007273(2019).
- Gu, H., et al. Fine-mapping of nuclear compartments using ultra-deep Hi-C shows that active promoter and enhancer elements localize in the active A compartment even when adjacent sequences do not. bioRxiv. , (2021).
- Ramani, V., et al. Mapping 3D genome architecture through in situ DNase Hi-C. Nature Protocols. 11 (11), 2104-2121 (2016).
- Lafontaine, D. L., Yang, L., Dekker, J., Gibcus, J. H. Hi-C 3.0: Improved Protocol for Genome-Wide Chromosome Conformation Capture. Current Protocols. 1 (7), 198(2021).
- Belton, J. -M. M., et al. Hi-C: A comprehensive technique to capture the conformation of genomes. Methods. 58 (3), 268-276 (2012).
- Truch, J., Telenius, J., Higgs, D. R., Gibbons, R. J. How to tackle challenging ChIP-Seq, with long-range cross-linking, Using ATRX as an example. Methods in Molecular Biology. 1832, Clifton, N.J. 105-130 (2018).
- Wang, P., et al. In situ chromatin interaction analysis using paired-end tag sequencing. Current Protocols. 1 (8), 174(2021).
- Tjong, H., et al. Population-based 3D genome structure analysis reveals driving forces in spatial genome organization. Proceedings of the National Academy of Sciences of the United States of America. 113 (12), 1663-1672 (2016).
- Nagano, T., et al. Cell-cycle dynamics of chromosomal organization at single-cell resolution. Nature. 547 (7661), 61-67 (2017).
- Ramani, V., et al. Massively multiplex single-cell Hi-C. Nature Methods. 14 (3), 263-266 (2017).
- Meng, L., Wang, C., Shi, Y., Luo, Q. Si-C is a method for inferring super-resolution intact genome structure from single-cell Hi-C data. Nature Communications. 12 (1), 4369(2021).
- Tavares-Cadete, F., Norouzi, D., Dekker, B., Liu, Y., Dekker, J. Multi-contact 3C reveals that the human genome during interphase is largely not entangled. Nature Structural & Molecular Biology. 27 (12), 1105-1114 (2020).
- Vermeulen, C., et al. Multi-contact 4C: long-molecule sequencing of complex proximity ligation products to uncover local cooperative and competitive chromatin topologies. Nature Protocols. 15 (2), 364-397 (2020).
- Oomen, M. E., Hedger, A. K., Watts, J. K., Dekker, J. Detecting chromatin interactions between and along sister chromatids with SisterC. Nature Methods. 17 (10), 1002-1009 (2020).
- Mitter, M., et al. Conformation of sister chromatids in the replicated human genome. Nature. 586 (7827), 139-144 (2020).
- Krietenstein, N., et al. Ultrastructural Details of Mammalian Chromosome Architecture. Molecular Cell. 78 (3), 554-565 (2020).
- Hughes, J. R., et al. Analysis of hundreds of cis-regulatory landscapes at high resolution in a single, high-throughput experiment. Nature Genetics. 46 (2), 205-212 (2014).
- Fullwood, M. J., et al. An oestrogen-receptor-alpha-bound human chromatin interactome. Nature. 462 (7269), 58-64 (2009).
- Fang, R., et al. Mapping of long-range chromatin interactions by proximity ligation-assisted ChIP-seq. Cell Research. 26 (12), 1345-1348 (2016).
- Mumbach, M. R., et al. HiChIP: efficient and sensitive analysis of protein-directed genome architecture. Nature Methods. 13 (11), 919-922 (2016).
Przedruki i uprawnienia
