Test mikrojądrowy (MN) jest sprawdzonym testem do ilościowego określania uszkodzeń DNA. Jednak ocena testu przy użyciu konwencjonalnych technik, takich jak mikroskopia ręczna lub analiza obrazu oparta na cechach, jest pracochłonna i wymagająca. W artykule opisano metodologię opracowania modelu sztucznej inteligencji do oceny testu MN przy użyciu danych z obrazowej cytometrii przepływowej.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Automatyzacja testu mikrojądrowego z wykorzystaniem obrazowania, cytometrii przepływowej i sztucznej inteligencji
W tym artykule
Podsumowanie
Streszczenie
Test mikrojądrowy (MN) jest używany na całym świecie przez organy regulacyjne do oceny chemikaliów pod kątem toksyczności genetycznej. Test można przeprowadzić na dwa sposoby: poprzez ocenę MN w raz podzielonych, zablokowanych przez cytokinezę komórkach dwujądrowych lub w pełni podzielonych komórkach jednojądrowych. Historycznie rzecz biorąc, mikroskopia świetlna była złotym standardem metody oceny testu, ale jest pracochłonna i subiektywna. Cytometria przepływowa była stosowana w ostatnich latach do oceny testu, ale jest ograniczona przez niemożność wizualnego potwierdzenia kluczowych aspektów obrazowania komórkowego. Obrazowa cytometria przepływowa (IFC) łączy w sobie wysokoprzepustowe przechwytywanie obrazu i zautomatyzowaną analizę obrazu i jest z powodzeniem stosowana do szybkiego pozyskiwania obrazów i oceny wszystkich kluczowych zdarzeń w teście MN. Ostatnio wykazano, że metody sztucznej inteligencji (AI) oparte na konwolucyjnych sieciach neuronowych mogą być wykorzystywane do oceny danych testowych MN pozyskanych przez IFC. W tym dokumencie opisano wszystkie kroki korzystania z oprogramowania sztucznej inteligencji do tworzenia modelu uczenia głębokiego w celu oceny wszystkich kluczowych zdarzeń i zastosowania tego modelu do automatycznego oceniania dodatkowych danych. Wyniki z modelu głębokiego uczenia się AI wypadają dobrze w porównaniu z mikroskopią ręczną, umożliwiając w ten sposób w pełni zautomatyzowaną ocenę testu MN poprzez połączenie IFC i AI.
Wprowadzenie
Test mikrojądrowy (MN) ma fundamentalne znaczenie w toksykologii genetycznej do oceny uszkodzeń DNA podczas opracowywania kosmetyków, farmaceutyków i substancji chemicznych stosowanych u ludzi1,2,3,4. Mikrojądra powstają z całych chromosomów lub fragmentów chromosomów, które nie włączają się do jądra po podziale i kondensują się w małe, koliste ciała oddzielone od jądra. W związku z tym MN może być używany jako punkt końcowy do ilościowego określania uszkodzeń DNA w testach genotoksyczności1.
Preferowaną metodą do ilościowego oznaczania MN jest blokowanie podziału za pomocą Cytochalasin-B (Cyt-B). W tej wersji testu cytotoksyczność jest również oceniana poprzez ocenę komórek jednojądrowych (MONO) i wielojądrowych (POLY). Test można również przeprowadzić, oceniając MN w niezablokowanych komórkach MONO, co jest szybsze i łatwiejsze do oceny, przy czym cytotoksyczność ocenia się za pomocą liczby komórek przed i po ekspozycji w celu oceny proliferacji5,6.
Historycznie fizyczna ocena testu była przeprowadzana za pomocą ręcznej mikroskopii, ponieważ pozwala to na wizualne potwierdzenie wszystkich kluczowych zdarzeń. Jednak mikroskopia manualna jest trudna i subiektywna1. W ten sposób opracowano zautomatyzowane techniki, w tym skanowanie szkiełek mikroskopowych i cytometrię przepływową, z których każda ma swoje zalety i ograniczenia. Podczas gdy metody skanowania slajdów umożliwiają wizualizację kluczowych wydarzeń, slajdy muszą być tworzone w optymalnej gęstości komórek, co może być trudne do osiągnięcia. Ponadto w tej technice często brakuje wizualizacji cytoplazmatycznej, co może zagrozić punktacji komórek MONO i POLY7,8. Podczas gdy cytometria przepływowa zapewnia wysokoprzepustowe przechwytywanie danych, komórki muszą być poddawane lizie, co nie pozwala na użycie formy Cyt-B testu. Dodatkowo, jako technika nieobrazowa, konwencjonalna cytometria przepływowa nie zapewnia wizualnej walidacji kluczowych zdarzeń9,10.
Dlatego też badano obrazową cytometrię przepływową (IFC) w celu przeprowadzenia testu MN. ImageStreamX Mk II łączy w sobie szybkość i niezawodność statystyczną konwencjonalnej cytometrii przepływowej z możliwościami obrazowania mikroskopowego w wysokiej rozdzielczości w jednym systemie11. Wykazano, że korzystając z IFC, obrazy wszystkich kluczowych zdarzeń w wysokiej rozdzielczości mogą być rejestrowane i automatycznie oceniane za pomocą feature-based12,13 lub technik sztucznej inteligencji (AI)14,15. Dzięki zastosowaniu IFC do przeprowadzenia testu MN możliwe jest uzyskanie automatycznej oceny znacznie większej liczby komórek w porównaniu z mikroskopią w krótszym czasie.
Ta praca odbiega od wcześniej opisanego przepływu pracy analizy obrazu16 i omawia wszystkie kroki wymagane do opracowania i wytrenowania modelu Random Forest (RF) i/lub konwolucyjnej sieci neuronowej (CNN) przy użyciu oprogramowania Amnis AI (zwanego dalej "oprogramowaniem AI"). Opisano wszystkie niezbędne kroki, w tym wypełnianie danych o prawdzie gruntowej za pomocą narzędzi do tagowania wspomaganych przez sztuczną inteligencję, interpretację wyników trenowania modelu oraz zastosowanie modelu do klasyfikacji dodatkowych danych, co pozwala na obliczenie genotoksyczności i cytotoksyczności15.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
1. Pozyskiwanie danych za pomocą cytometrii przepływowej z obrazowaniem
UWAGA: Należy odnieść się do pracy Rodrigues i wsp.16 z następującymi modyfikacjami, przy czym należy pamiętać, że obszary akwizycji przy użyciu IFC mogą wymagać modyfikacji w celu optymalnego zarejestrowania obrazu:
- W przypadku metody non-Cyt-B należy przeprowadzić liczenie komórek przy użyciu dostępnego w sprzedaży licznika komórek zgodnie z instrukcjami producenta (patrz Tabela materiałów) na każdej hodowli bezpośrednio przed hodowlą oraz bezpośrednio po okresie rekonwalescencji.
- Jeśli próbki są analizowane na przepływowym cytometrze obrazującym z jedną kamerą, należy umieścić Jasne pole (BF) w Kanał 4Zastąp M01 z M04, i M07 z M01.
UWAGA: „M” odnosi się do kanału kamery w IFC. - Podczas akwizycji należy użyć powiększenia 40x.
- Na wykresie zależności powierzchni BF od współczynnika kształtu BF (BF aspect ratio) podczas akwizycji, należy użyć następujących współrzędnych obszaru:
Współrzędne X: 100 i 900; Współrzędne Y: 0,7 i 1 (metoda Cyt-B)
Współrzędne X: 100 i 600; współrzędne Y: 0,7 i 1 - Na wykresie intensywności barwienia Hoechst należy zastosować następujące współrzędne obszaru:
Współrzędne X: 55 i 75; współrzędne Y: 9,5 i 15 (metoda Cyt-B)
Współrzędne X: 55 i 75; współrzędne Y: 13 i 21 (metoda bez użycia Cyt-B) - Aby usunąć z danych obrazy obiektów apoptotycznych i nekrotycznych, należy uruchomić pakiet oprogramowania IDEAS 6.3 (dalej nazywany „oprogramowaniem do analizy obrazu”; patrz Tabela materiałów).
UWAGA: Oprogramowanie AI zostało zaprojektowane do pracy z plikami .daf przetworzonymi przy użyciu najnowszej wersji oprogramowania do analizy obrazu. Należy upewnić się, że oprogramowanie do analizy obrazu jest aktualne. - Zapisz tę pracę jako plik szablonu (.ast).
2. Tworzenie plików .daf dla wszystkich plików .rif
- Oprogramowanie AI umożliwia import wyłącznie plików .daf. Przetwórz wszystkie pliki .rif z eksperymentu w pliki .daf za pomocą przetwarzania wsadowego.
- W menu Tools kliknij Batch Data Files , a następnie Add Batch.
- W nowym oknie wybierz Add Files i zaznacz pliki .rif, które mają zostać dodane do serii. W opcji Select a Template or Data Analysis File (.ast, .daf) wybierz plik .ast utworzony wcześniej.
- W razie potrzeby przypisz nazwę serii i kliknij OK , aby utworzyć pliki .daf dla wszystkich wczytanych plików .rif.
3. Tworzenie eksperymentu w oprogramowaniu AI
- Należy zapoznać się ze schematem blokowym na Rysunku 1, który opisuje proces tworzenia modelu głębokiego uczenia przy użyciu oprogramowania AI.
- Uruchom oprogramowanie AI i upewnij się, że zainstalowana jest najnowsza wersja, klikając About w lewym dolnym rogu okna. Jeśli najnowsza wersja nie jest zainstalowana, skontaktuj się z support@luminexcorp.com w celu jej uzyskania.
- Ekranem domyślnym w oprogramowaniu jest ekran New Experiment . Użyj ikony Folder , aby wybrać miejsce zapisu eksperymentu, a następnie wpisz nazwę eksperymentu (np. „MN model”).
- W sekcji Experiment Type kliknij przycisk radiowy obok opcji Train , aby rozpocząć eksperyment treningowy w celu budowy modelu CNN. Kliknij Next.
- Opcjonalnie: jeśli wcześniej wytrenowano już model, można go użyć jako szablonu dla nowego modelu AI, wybierając go na ekranie Select Template Model. Jeśli nie istnieje model szablonowy, pomiń ten krok, klikając Next.
- Następnym ekranem jest ekran Define New Model . W polu Model automatycznie pojawi się nazwa nadana modelowi w kroku 3.3.
- W sekcji Description wpisz opis modelu (opcjonalnie) i pozostaw maksymalny rozmiar obrazu na poziomie 150 pikseli.
- W sekcji Channels kliknij Add BF, aby dodać do listy kanał jasnego pola (brightfield). W kolumnie Name kliknij dwukrotnie Brightfield i zmień nazwę tego kanału na BF. Kliknij Add FL, aby dodać do listy kanał fluorescencyjny. W kolumnie Name kliknij dwukrotnie Fluorescent i zmień nazwę tego kanału na DNA.
- W sekcji Class Names kliknij Add. W oknie pop-up wpisz Mononucleated i kliknij OK. Dzięki temu klasa jednojądrowa zostanie dodana do listy nazw klas. Powtórz ten proces, aby upewnić się, że na liście zdefiniowano następujące sześć klas:
Mononucleated
Mononucleated with MN
Binucleated
Binucleated with MN
Polynucleated
Irregular morphology
Kliknij Next.
UWAGA: Te sześć klas modelu prawdy obiektywnej (ground truth) będzie reprezentować kluczowe zdarzenia podlegające ocenie, a także obrazy o morfologii odbiegającej od przyjętych kryteriów oceny5.- Opcjonalnie: jeśli jest to pożądane, można dołączyć szablon analizy z punktu 1.7, aby wykorzystać funkcje z oprogramowania do analizy obrazu. Jeśli chcesz uwzględnić te funkcje w modelu AI, wyszukaj plik .ast, a następnie z rozwijanych list specyficznych dla kanałów wybierz podzbiory cech, które chcesz dołączyć.
- W sekcji Select Files kliknij Add Files i wyszukaj pliki, które mają zostać dodane do oprogramowania AI w celu budowy danych prawdy obiektywnej. Kliknij Next.
UWAGA: Ważne jest dodanie wielu plików danych (np. danych kontroli pozytywnej i negatywnej), które zawierają wystarczającą liczbę wszystkich kluczowych zdarzeń.
- Następnie, na ekranie Select Base Populations , zlokalizuj populację Non-Apoptotic w hierarchii populacji. Kliknij prawym przyciskiem myszy na populację Non-Apoptotic i wybierz Select All Matching Populations. Kliknij Next.
UWAGA: Ważne jest wykluczenie wszelkich populacji, które nie powinny być klasyfikowane (np. kulek, debris, dubletów itp.) - Ten ekran to ekran Select Truth Populations .
- Jeśli w oprogramowaniu do analizy obrazu nie utworzono otagowanych populacji prawdy obiektywnej dla kluczowych zdarzeń, kliknij Next.
- Jeśli otagowane populacje prawdy obiektywnej zostały utworzone w oprogramowaniu do analizy obrazu, przypisz je do odpowiedniej klasy modelu.
- Aby przypisać otagowaną populację prawdy obiektywnej dla komórek MONO z MN, kliknij klasę Mononucleated with MN w sekcji Model Classes po lewej stronie. Następnie kliknij po prawej stronie odpowiednią otagowaną populację prawdy obiektywnej, która zawiera te zdarzenia.
- Jeśli otagowane populacje prawdy obiektywnej zostały utworzone w więcej niż jednym pliku danych, kliknij prawym przyciskiem myszy jedną z populacji prawdy obiektywnej i wybierz Select All Matching Populations, aby dodać otagowane populacje z wielu plików do odpowiedniej klasy.
- Po przypisaniu wszystkich odpowiednich populacji prawdy obiektywnej kliknij Next.
- Na ekranie Select Channels wybierz odpowiednie kanały dla eksperymentu. Tutaj ustaw BF na kanał 1 oraz Hoechst na kanał 7. Kliknij prawym przyciskiem myszy na kanale i wybierz Apply to All. Kliknij Next.
- Na koniec, na ekranie Confirmation, kliknij Create Experiment.
- Oprogramowanie AI ładuje obrazy z plików danych i tworzy klasy modelu zdefiniowane w kroku 3.5.3 z obrazami prawdy obiektywnej przypisanymi w kroku 3.7. Kliknij Finish.
- Po utworzeniu eksperymentu prezentowanych jest pięć opcji:
Experiment: dostarcza szczegółów eksperymentu, w tym załadowanych plików danych, wybranych kanałów i zdefiniowanych klas modelu prawdy obiektywnej.
Tagging: uruchamia narzędzie do tagowania, za pomocą którego użytkownicy mogą uzupełniać dane prawdy obiektywnej.
Training: trenuje model na podstawie danych prawdy obiektywnej.
Classify: wykorzystuje wytrenowane modele do klasyfikacji danych.
Results: dostarcza wyników zarówno z eksperymentu treningowego, jak i eksperymentu klasyfikacyjnego.
4. Uzupełnianie danych prawdy obiektywnej (ground truth) przy użyciu narzędzi do tagowania wspomaganych przez AI
- Kliknij Tagging, aby uruchomić interfejs narzędzia do tagowania.
- Kliknij narzędzia powiększania (ikony lupy), aby przyciąć obrazy w celu łatwiejszego przeglądania.
- Kliknij pasek suwaka, aby dostosować rozmiar obrazów i zmienić liczbę obrazów wyświetlanych w galerii.
- Kliknij opcję Display Setting i wybierz Min-Max, co zapewni obraz o najlepszym kontraście do identyfikacji wszystkich kluczowych zdarzeń.
- Kliknij Setup Gallery Display, aby zmienić kolor obrazu DNA na żółty lub biały, co poprawi wizualizację małych obiektów (np. MN).
- Kliknij Cluster, aby uruchomić algorytm grupujący obiekty o podobnej morfologii. Po zakończeniu klastrowania poszczególne klastry wraz z liczbą obiektów w każdym klastrze zostaną wyświetlone na liście pod nagłówkiem Unknown Populations. Wybierz poszczególne klastry, aby przejrzeć obiekty w nich zawarte i przypisać te obiekty do odpowiednich klas modelowych.
- Po przypisaniu minimum 25 obiektów do każdej klasy modelowej dostępny zostanie algorytm Predict. Kliknij Predict.
UWAGA: Obiekty, które nie pasują do żadnej populacji, pozostają zaklasyfikowane jako Unknown. W miarę dodawania kolejnych obiektów do populacji wzorcowych (truth populations) dokładność predykcji wzrasta. - Kontynuuj uzupełnianie klas modelowych ground truth odpowiednimi obrazami, aż do osiągnięcia wystarczającej liczby obiektów w każdej klasie.
- Po przypisaniu minimum 100 obiektów do każdej klasy modelowej kliknij kartę Training u góry ekranu. Kliknij przycisk Train, aby utworzyć model przy użyciu algorytmów Random Forest i CNN.
UWAGA: Oprogramowanie AI tworzy modele z wykorzystaniem obu algorytmów, Random Forest oraz CNN; pola wyboru umożliwiają tworzenie modeli przy użyciu wyłącznie algorytmu Random Forest lub wyłącznie CNN.
5. Ocena dokładności modelu
- Po zakończeniu trenowania modelu kliknij View Results.
- Użyj ekranu wyników, aby ocenić dokładność modelu. Skorzystaj z menu rozwijanego, aby przełączyć się między Random Forest a CNN.
UWAGA: Populacje referencyjne mogą zostać zaktualizowane, a model może zostać ponownie wytrenowany lub wykorzystany w obecnej formie do klasyfikacji dodatkowych danych.- Aby zaktualizować populacje referencyjne, kliknij Tagging na górze i postępuj zgodnie z sekcją 4.
6. Klasyfikacja danych przy użyciu modelu
- Uruchom oprogramowanie AI. Ekranem domyślnym jest ekran New Experiment. Użyj ikony Folder, aby wybrać miejsce zapisu eksperymentu, a następnie wpisz nazwę eksperymentu.
- W sekcji Experiment Type kliknij przycisk radiowy obok opcji Classify, aby rozpocząć eksperyment klasyfikacji. Kliknij Next.
- Kliknij model, który ma zostać użyty do klasyfikacji, a następnie kliknij Next.
- Na ekranie Select Files kliknij Add Files i wyszukaj pliki, które mają zostać sklasyfikowane przez model CNN. Kliknij Next.
- Następnie, na ekranie Select Base Populations, zaznacz pole wyboru obok populacji Non-Apoptotic w jednym z wczytanych plików. Kliknij prawym przyciskiem myszy na populację Non-Apoptotic i wybierz Select All Matching Populations, aby wybrać tę populację ze wszystkich wczytanych plików. Kliknij Next.
- Opcjonalnie: jeśli dane do klasyfikacji zawierają populacje prawdy (truth populations), można je przypisać do odpowiednich klas modelu na ekranie Select Truth Populations. W przeciwnym razie kliknij Next, aby pominąć ten krok.
- Na ekranie Select Channels wybierz Channel 1 dla jasnego pola (brightfield) oraz Channel 7 dla barwienia DNA. Kliknij prawym przyciskiem myszy na kanał i wybierz Apply to All. Następnie kliknij Next.
- Na koniec, na ekranie Confirmation, kliknij Create Experiment. Oprogramowanie AI wczyta wybrany model oraz wszystkie obrazy z wybranych plików danych. Kliknij Finish.
- Kliknij Classify, aby otworzyć ekran klasyfikacji. Kliknij przycisk Classify. Rozpocznie to proces wykorzystania modeli RF i CNN do klasyfikacji dodatkowych danych i identyfikacji wszystkich obiektów należących do określonych klas modelu.
UWAGA: Pola wyboru mogą służyć do wyboru modelu RF i/lub modelu CNN. - Po zakończeniu klasyfikacji kliknij View Results.
- Kliknij przycisk Update DAFs, aby wyświetlić okno Update DAFs with Classification Results. Kliknij OK, aby zaktualizować pliki .daf.
7. Generowanie raportu z wyników klasyfikacji
- Na ekranie Results kliknij Generate Report. Zaznacz pole wyboru obok Create Report for Each Input DAF, jeśli wymagany jest oddzielny raport dla każdego wejściowego pliku DAF. Kliknij OK.
- Po zakończeniu procesu otwórz folder, w którym zapisano pliki raportów. W folderze znajduje się raport z eksperymentu w formacie .pdf oraz folder Resources.
- Otwórz plik .pdf, aby wyświetlić raport. Raport zawiera informacje o modelu i eksperymencie, listę wejściowych plików .daf, liczbę i procentowy udział klas w formie tabelarycznej i histogramów oraz macierz pomyłek podsumowującą medianę prawdopodobieństwa predykcji dla wszystkich wejściowych plików .daf.
- Otwórz folder Resources, a następnie folder CNN. W tym folderze znajdują się pliki .png z wykresami słupkowymi liczby i procentowego udziału klas, a także macierz pomyłek. Dodatkowo dostępne są pliki .csv zawierające liczbę i procentowy udział klas dla każdego pliku wejściowego.
8. Określanie częstotliwości występowania MN oraz cytotoksyczności
- Obliczanie częstości MN
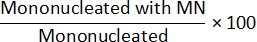
- Metoda Non Cyt-B: Aby wyznaczyć częstość MN, otwórz plik class_count.csv z kroku 7.4. Dla każdego pliku wejściowego podziel liczbę komórek w populacji „Mononucleated with MN” przez liczbę komórek w populacji „Mononucleated” i pomnóż wynik przez 100:
- Metoda Cyt-B: Aby wyznaczyć częstość MN, otwórz plik class_count.csv z kroku 7.4. Dla każdego plika wejściowego podziel liczbę komórek w populacji „Binucleated with MN” przez liczbę komórek w populacji „Binucleated” i pomnóż wynik przez 100:
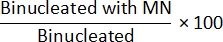
- Metoda Non Cyt-B: Aby wyznaczyć częstość MN, otwórz plik class_count.csv z kroku 7.4. Dla każdego pliku wejściowego podziel liczbę komórek w populacji „Mononucleated with MN” przez liczbę komórek w populacji „Mononucleated” i pomnóż wynik przez 100:
- Obliczanie cytotoksyczności
- Metoda Non Cyt-B:
- Wykorzystując początkową liczbę komórek oraz liczbę komórek po zakończeniu inkubacji, oblicz najpierw liczbę podwojeń populacji (PD) dla każdej próbki2:
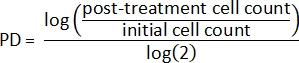
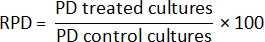
- Następnie oblicz względną liczbę podwojeń populacji2:
- Na koniec oblicz cytotoksyczność2 dla każdej próbki:
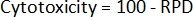
- Wykorzystując początkową liczbę komórek oraz liczbę komórek po zakończeniu inkubacji, oblicz najpierw liczbę podwojeń populacji (PD) dla każdej próbki2:
- Metoda Cyt-B:
- Aby obliczyć indeks proliferacji z blokadą cytokinezy (CBPI)2, wykorzystaj liczby komórek w klasach mononuklearnych, binuklearnych i polinuklearnych dla każdej próbki z pliku class_count.csv:
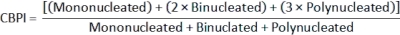
- Aby obliczyć cytotoksyczność2, wykorzystaj CBPI z kultur kontrolnych (C) i kultur eksponowanych (T):
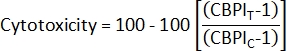
- Aby obliczyć indeks proliferacji z blokadą cytokinezy (CBPI)2, wykorzystaj liczby komórek w klasach mononuklearnych, binuklearnych i polinuklearnych dla każdej próbki z pliku class_count.csv:
- Metoda Non Cyt-B:
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Rysunek 1 przedstawia schemat pracy z wykorzystaniem oprogramowania AI w celu stworzenia modelu dla analizy MN. Użytkownik ładuje wybrane pliki .daf do oprogramowania AI, a następnie przypisuje obiekty do klas modelu prawdy terenowej (ground truth), korzystając z algorytmów tagowania: klastrowania wspomaganego przez AI (Rysunek 2) oraz predykcji (Rysunek 3>). Po uzupełnieniu wszystkich klas modelu prawdy terenowej odpowiednią liczbą...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Prezentowana praca opisuje wykorzystanie algorytmów głębokiego uczenia się do automatyzacji punktacji testu MN. Kilka ostatnich publikacji wykazało, że intuicyjne, interaktywne narzędzia pozwalają na tworzenie modeli głębokiego uczenia się w celu analizy danych obrazowych bez konieczności posiadania dogłębnej wiedzy obliczeniowej18,19. Protokół opisany w tej pracy, wykorzystujący pakiet oprogramowania oparty na interfejsie użytkownika, został zaprojektowany tak, ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy są zatrudnieni przez Luminex Corporation, firmę należącą do DiaSorin, producenta cytometru przepływowego do obrazowania ImageStream oraz oprogramowania Amnis AI wykorzystanego w tej pracy.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Probówka wirówkowa 15 ml | Falcon | 352096 | |
| Cleanser - Coulter Clenz | Beckman Coulter | 8546931 | Pojemnik do napełniania 200 ml środka czyszczącego. https://www.beckmancoulter.com/wsrportal/page/itemDetails?itemNumber=8546931#2/10//0/25/ 1/0/asc/2/8546931///0/1//0/ |
| Colchicine | MilliporeSigma | 64-86-8 | |
| Corning butelkowy filtr próżniowy | MilliporeSigma | CLS430769 | 0,22 i mikro; m filtr, butelka 500 ml |
| Cytochalazyna B | MiliporeSigma | 14930-96-2 | Butelka 5 mg |
| Debubbler - 70% Isopropanol | MilliporeSigma | 1.3704 | Napełnij pojemnik 200 ml Debubbler. http://www.emdmillipore.com/US/en/product/2-Propanol-70%25-%28V%2FV%29-0.1-%C2%B5m-filtred,MDA_CHEM-137040?ReferrerURL=https%3A%2F%2Fwww.google.com%2F |
| Dimetylosulfotlenek (DMSO) | MilliporeSigma | 67-68-5 | |
| Sól fizjologiczna buforowana fosforanem Dulbecco 1X | EMD Milipore | BSS-1006-B | PBS Ca++MG++ Bezpłatny |
| Hyklon płodowej surowicy bydlęcej | SH30071.03 | ||
| Formaldehyd, 10%, bez metanolu, Ultra Pure | Polysciences, Inc. | 04018 | To jest to, co jest używane do 4% i 1% formaliny. UWAGA: Formalina/formaldehyd toksyczny przez drogi oddechowe i po połknięciu. Działa drażniąco na oczy, drogi oddechowe i skórę. Może powodować uczulenie przez drogi oddechowe lub kontakt ze skórą. Ryzyko poważnego uszkodzenia oczu. Potencjalne zagrożenie rakiem. http://www.polysciences.com/default/catalog-products/life-sciences/histology-microscopy/fixatives/formaldehydes/formaldehyde-10-methanol-free-pure/ |
| Analizator komórek Guava Muse | Luminex | 0500-3115 | Zastosowano analizator komórek Guava Muse o standardowej konfiguracji. |
| Hoechst 33342 | Thermo Fisher | H3570 | 10 mg/ml roztwór |
| Miliporów mannitoluSigma | 69-65-8 | ||
| MEM Aminokwasy endogenne 100X | Hyklon | SH30238.01 | |
| MIFC - ImageStreamX Mark II | Luminex, firma DiaSorin | 100220 | A 2 ImageStreamX Mark II wyposażoną w lasery 405 nm, 488 nm i 642 nm. |
| Oprogramowanie do analizy MIFC - IDEAS | Luminex, firma należąca do DiaSorin | 100220 | "Oprogramowanie do analizy obrazu" Oprogramowanie towarzyszące MIFC (ImageStreamX MKII) |
| Oprogramowanie MIFC - INSPIRE | Luminex, firma należąca do DiaSorin | 100220 | "Oprogramowanie do akwizycji obrazu" Jest to oprogramowanie, które uruchamia oprogramowanie MIFC (ImageStreamX MKII) |
| Oprogramowanie Amnis AI | Luminex, firma | DiaSorin100221 | "Oprogramowanie AI" Jest to oprogramowanie, które pozwala na tworzenie modeli sztucznej inteligencji do analizy danych |
| Mitomycyna C | MiliporeSigma | 50-07-7 | |
| Mieszanina NEAA 100x | Lonza BioWhittaker | 13-114E | |
| Penicllin/Streptomycyna/Glutamina roztwór 100X | Gibco | 15070063 | |
| Chlorek potasu (KCl) | MilliporeSigma | P9541 | |
| Płukanie - Woda ultraczysta lub woda dejonizowana | NA | NA | Użyj dowolnej wody ultraczystej lub wody dejonizowanej. Napełnij pojemnik 900 ml płukania. |
| RNase | MilliporeSigma | 9001-99-4 | |
| RPMI-1640 Medium 1x | HyClone | SH30027.01 | |
| Osłona - PBS | MilliporeSigma | BSS-1006-B | To jest to samo, co sól fizjologiczna buforowana fosforanem Dulbecco 1x Ca++MG++ za darmo. Napełnij pojemnik 900 ml pochwy. |
| Sterylizator | HyClone | SH30529.01 | |
| 0.4%– 0,7% podchlorynu | VWR | JT9416-1 | Jest to zdecydowanie 10% wybielacza Clorox, który można uzyskać, rozcieńczając wybielacz Clorox wodą. Napełnij pojemnik 200 ml sterylizatora. |
| Kolba T25 | Falcon | 353109 | |
| Kolba T75 | Falcon | 353136 | |
| Ogniwa TK6 | MilliporeSigma | 95111735 |
Bibliografia
- Fenech, M., et al. HUMN project initiative and review of validation, quality control and prospects for further development of automated micronucleus assays using image cytometry systems. International Journal of Hygiene and Environmental Health. 216 (5), 541-552 (2013).
- OECD. Test No. 487: In Vitro Mammalian Cell Micronucleus Test. Section 4. OECD Guidelines for the Testing of Chemicals. , OECD Publishing. Paris. (2016).
- Fenech, M. The in vitro micronucleus technique. Mutation Research/Fundamental and Molecular Mechanisms of Mutagenesis. 455 (1), 81-95 (2000).
- Bonassi, S., et al. An increased micronucleus frequency in peripheral blood lymphocytes predicts the risk of cancer in humans. Carcinogenesis. 28 (3), 625-631 (2007).
- Fenech, M. Cytokinesis-block micronucleus cytome assay. Nature Protocols. 2 (5), 1084-1104 (2007).
- Fenech, M. Commentary on the SFTG international collaborative study on the in vitro micronucleus test: To Cyt-B or not to Cyt-B. Mutation Research/Fundamental and Molecular Mechanisms of Mutagenesis. 607 (1), 9-12 (2006).
- Seager, A. L., et al. Recommendations, evaluation and validation of a semi-automated, fluorescent-based scoring protocol for micronucleus testing in human cells. Mutagenesis. 29 (3), 155-164 (2014).
- Rossnerova, A., Spatova, M., Schunck, C., Sram, R. J. Automated scoring of lymphocyte micronuclei by the MetaSystems Metafer image cytometry system and its application in studies of human mutagen sensitivity and biodosimetry of genotoxin exposure. Mutagenesis. 26 (1), 169-175 (2011).
- Bryce, S. M., Bemis, J. C., Avlasevich, S. L., Dertinger, S. D. In vitro micronucleus assay scored by flow cytometry provides a comprehensive evaluation of cytogenetic damage and cytotoxicity. Mutation Research/Genetic Toxicology and Environmental Mutagenesis. 630 (1), 78-91 (2007).
- Avlasevich, S. L., Bryce, S. M., Cairns, S. E., Dertinger, S. D. In vitro micronucleus scoring by flow cytometry: Differential staining of micronuclei versus apoptotic and necrotic chromatin enhances assay reliability. Environmental and Molecular Mutagenesis. 47 (1), 56-66 (2006).
- Basiji, D. A. Principles of Amnis imaging flow cytometry. Methods in Molecular Biology. 1389, 13-21 (2016).
- Rodrigues, M. A. Automation of the in vitro micronucleus assay using the Imagestream® imaging flow cytometer. Cytometry Part A. 93 (7), 706-726 (2018).
- Verma, J. R., et al. Investigating FlowSight® imaging flow cytometry as a platform to assess chemically induced micronuclei using human lymphoblastoid cells in vitro. Mutagenesis. 33 (4), 283-289 (2018).
- Wills, J. W., et al. Inter-laboratory automation of the in vitro micronucleus assay using imaging flow cytometry and deep learning. Archives of Toxicology. 95 (9), 3101-3115 (2021).
- Rodrigues, M. A., et al. The in vitro micronucleus assay using imaging flow cytometry and deep learning. Npj Systems Biology and Applications. 7 (1), 20(2021).
- Rodrigues, M. A. An automated method to perform the in vitro micronucleus assay using multispectral imaging flow cytometry. Journal of Visualized Experiments. (147), e59324(2019).
- Lovell, D. P., et al. Analysis of negative historical control group data from the in vitro micronucleus assay using TK6 cells. Mutation Research/Genetic Toxicology and Environmental Mutagenesis. 825, 40-50 (2018).
- Berg, S., et al. ilastik: interactive machine learning for (bio)image analysis. Nature Methods. 16 (12), 1226-1232 (2019).
- Hennig, H., et al. An open-source solution for advanced imaging flow cytometry data analysis using machine learning. Methods. 112, 201-210 (2017).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
