To badanie dostarcza metody wykorzystania procesora kwantowego do obliczania tras dla różnych dynamik ruchu, które działają skuteczniej niż klasyczne metody w literaturze, aby zmaksymalizować żywotność sieci.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Wielkoskalowy, energooszczędny routing sieci czujników przy użyciu procesora kwantowego
W tym artykule
Podsumowanie
Streszczenie
Metoda oszczędzania energii w sieci czujników, która jest hybrydą klasycznego komputera i procesora kwantowego, okazała się działać lepiej niż algorytm heurystyczny wykorzystujący klasyczny komputer. W niniejszej pracy przedstawiono i uzasadniono kontekst techniczny znaczenia metody. Następnie etapy eksperymentalne są demonstrowane w sekwencji operacyjnej z ilustracjami, jeśli zajdzie taka potrzeba. Metoda została zwalidowana pozytywnymi wynikami w losowo wygenerowanym zestawie topologii sieci. Udane wyniki eksperymentalne tej metody zapewniły lepsze podejście do problemów związanych z maksymalizacją żywotności sieci czujników i wykazały, że obecny stan techniki procesor kwantowy jest w stanie rozwiązać duże praktyczne problemy inżynieryjne z zaletami, które zastępują obecne metody w literaturze. Innymi słowy, przewaga kwantowa może być wykorzystana w najlepszy możliwy sposób. Wyszedł poza etap dowodu koncepcji do dowodu wykonalności.
Wprowadzenie
Oszczędność energii w sieciach czujników była bardzo krytyczną kwestią w projektowaniu1. Klasyczne metody zwykle rozwiązują problem za pomocą podejścia ad hoc2,3,4,5,6. To powiedziawszy, metody te emulują węzły czujników jako indywidualnie zarządzane inteligentne zasoby, które mogą również współpracować, aby służyć zarówno interesom jednostki, jak i społeczności. Ze względu na zmienne środowisko, w którym działają czujniki, w niektórych pracach wprowadza się algorytmy losowe w celu wychwycenia niepewności środowiskowych, podczas gdy w innych biointeligencja jest zapożyczana do opracowania algorytmów heurystycznych, które mogłyby osiągnąć akceptowalne dla zdrowego rozsądku wyniki7. Aby zilustrować to dalej, w przypadku tych algorytmów losowych, z jednej strony, niepewności środowiskowe mogą nie być tak losowe, jak sekwencja losowa generowana przez klasyczny procesor, z drugiej strony, nawet jeśli niepewności środowiskowe są absolutnie losowe, nie można ich uchwycić za pomocą symulatora procesów losowych generowanego przez klasyczny procesor; W przypadku tych algorytmów biointeligencji, po pierwsze, nie przeprowadzono rygorystycznej analizy matematycznej, aby dowód koncepcyjny był skuteczny, po drugie, zbieżność do prawdy lub granica tolerancji błędu mogą być skonfigurowane tylko przy podstawie świadomej prawdy podstawowej - chociaż znaczna liczba prac w literaturze wykazała w pewnym stopniu działanie tych algorytmów heurystycznych. Po pierwsze, algorytmy te są analizowane (a nie symulowane) pod kątem dobrze zdefiniowanych scenariuszy przypadków użycia, zatrzymują się na pewnych kryteriach, które nadal są warte rozważenia w dalszych badaniach, po drugie, jak wspomniano wcześniej, większość algorytmów nie została zweryfikowana pod kątem symulacji oprogramowania, które można łatwiej wdrożyć w mikroprocesorach, które sprawiają, że czujnik staje się jego bytem8.
Nie bierzemy tutaj pod uwagę uczenia maszynowego (ML), ponieważ wymaga ono analizy danych, która wymaga stosunkowo dużej mocy obliczeniowej, która nie jest przenośna w urządzeniach sensorowych9.
Aby rozwiązać wyżej wymienione problemy, udostępniamy hybrydowy algorytm kwantowy. Algorytm jest hybrydowy w tym, że mechanizm wyboru głowicy klastra jest implementowany przy użyciu klasycznego algorytmu losowego podczas obliczeń routingu przeprowadzanych przy użyciu procesora kwantowego po skonfigurowaniu topologii sieci. Metodę uzasadnia się w następujący sposób: (1) Jak omówiono w pierwszym akapicie dotyczącym niepewności środowiskowej, nie chcemy dalej próbować zastosować generatora sekwencji kwantowych do uchwycenia dynamiki środowiska, ponieważ może on być historycznie identyfikowalny. Dynamika środowiskowa, którą można historycznie prześledzić, została uzasadniona przez różne prace badawcze w zakresie uczenia maszynowego w dziedzinie nauk o sieciach. Na obecnym etapie pozostajemy przy klasycznym podejściu. (2) Dokładna metoda, która bazuje na abstrakcyjnej analizie matematycznej, gwarantuje dojście do podstawowej prawdy. Kwantowa fizyka doświadczalna była do tej pory w wyrafinowany sposób wspierana przez matematykę fizyczną. Co więcej, istnieją aplikacje algorytmiczne, takie jak Shor algorithm10, aby udowodnić tę zaokrągloną teorię.
Poniżej znajduje się odpowiednia ilość ankiety literatury dla porównania. Protokół HEESR zaproponowany przez 11 ma wyraźne zalety w wynikach, ale autorzy dobrze określili parametry konfiguracji symulacji, na przykład dokładną funkcję rozkładu losowego pozycji węzła, prawidłowe uzasadnienie procentu głowy klastra p (0,2%) oraz parametr skalowania dla rozkładu poziomu energii (1-2 dżule) między węzłami a_i. Zabronił on autorowi dalszego powielania eksperymentów i przeprowadzania porównania. Mechanizm routingu mocy12 wykorzystuje metodę dopasowania krzywej do przybliżania zbieżnych funkcji ciągłych z dyskretnych zestawów danych uzyskanych z nieokreślonej przestrzeni próbkowania dla determinantów, które wpływają na proces decyzyjny optymalnego routingu sieci. Metoda dopasowania krzywej13 wymaga uprzednich informacji na temat topologii sieci. Rzeczywista sytuacja może nie sprawiać, że wcześniejsze informacje są łatwo dostępne. Nawet jeśli istnieją wcześniejsze informacje, topologia sieci może nie być wystarczająco regularna, aby można ją było odwzorować na krzywe dopasowania, które są w stanie ułatwić obliczenia możliwe do wyprowadzenia. Kierując się tą samą logiką, DORAF protocol14 nie uzasadnił, jak i dlaczego zapożyczyć funkcję Boltzmanna i funkcję logistyczną do przybliżenia determinantów sieciowych. Ismail i in.15 dostarczyli solidnego punktu odniesienia dla przyszłych przedsięwzięć badawczych nad energooszczędnym projektowaniem protokołów routingu w sieci podwodnej.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
1. Konfiguracja środowiska Dwave Ocean
- Pobierz i zainstaluj narzędzia ocean z linku: https://docs.ocean.dwavesys.com/en/stable/overview/install.html
- W terminalu wpisz python -m venv ocean.
- W terminalu wpisz . ocean/bin/activate, jak pokazano na Ryc. 1.
- W terminalu wpisz git clone https://github.com/dwavesystems/dwave-ocean-sdk.git
Następnie wpisz cd dwave-ocean-sdk, jak pokazano na Ryc. 2.
Potem wpisz python setup.py install

Rysunek 1: Aktywacja wirtualnego środowiska Ocean. Pakiet Ocean, zintegrowany z API D-wave, zapewnia użytkownikowi dostęp do maszyny D-wave w chmurze za pośrednictwem jego własnego komputera. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tego rysunku.

Rycina 2: Instalacja Ocean SDK. Pakiet Ocean dostarcza niezbędne zestawy narzędzi dla programistów, w tym praktyczną instalację Cplex. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
2. Instalacja interfejsu Cplex Python API
- Pobrać i zainstalować Cplex: https://pypi.org/project/cplex/
- W terminalu wpisać pip install cplex.
3. Parametry konfiguracji eksperymentu
- Ustaw parametry konfiguracji eksperymentu wymienione w Tabeli 1, korzystając z notacji programistycznej języka Python w skrypcie, jak pokazano na Ryc. uzupełniającej 1. Po uruchomieniu i wykonaniu skryptu, język programowania przetworzy i zapisze zmienne w pamięci RAM. Załączono zrzut ekranu z kodami Python, w których poszczególnym parametrom przypisano wartości (Ryc. uzupełniająca 1).
| d0 | 87,7085 m |
| E | 50 * 1 x 10-09 dżule |
| epson_fs | 1 * 10-12* 10 dżuli |
| epson_mp | 0.0013 * 1 * 10-12 dżule |
| wielkość pakietu | 4000 bitów |
Tabela 1: Parametry modelu energetycznego i ustawienia rozmiaru pakietu.
Rycina uzupełniająca 1: Script1. Skrypt do konfiguracji parametrów eksperymentu. Kliknij tutaj, aby pobrać ten plik.
4. Skrypty Pythona
- Przygotuj skrypty w języku Python w celu wygenerowania 2D pozycji 198 węzłów czujnikowych, rozmieszczonych równomiernie w sześciu sektorach dzielących obszar kołowy o promieniu 50 m.
UWAGA: Wykres kołowy jest podzielony na 6 sektorów. W każdym sektorze pozycja każdego węzła jest opisana dwiema odpowiadającymi mu zmiennymi: kątem oraz promieniem. Przypisz wartości do kąta i promienia, korzystając z generatora jednostajnego rozkładu prawdopodobieństwa. Szczegółowa procedura przedstawiona jest na Rysunku uzupełniającym 2 oraz Rysunku uzupełniającym 3. - W obrębie każdego sektora upewnij się, że 33 węzły czujnikowe są rozmieszczone losowo zgodnie z rozkładem normalnym. Zapisz pozycje 2D w plikach tekstowych dla każdego sektora, stosując regułę nazewnictwa 'posdata'+sector_no+'.txt' (Rysunek 3 oraz Rysunek 4).
- Podziel obszar kołowy o promieniu 50 m na sześć sektorów. Początkowe wartości kątowe dla tych sześciu sektorów tworzą wektor A= [60,120,180,240,300,360].
- Przyjmując, że indeks sektora to i, ustaw długość promienia dla jtego węzła czujnikowego jako l_{i,j}=50*random.random()
- Przyjmując, że indeks sektora to i, ustaw wartość kątową dla jtego węzła czujnikowego jako ang_{i,j}=(60*random.random() + A_i - 60) * 2 * pi / 360
- Wyznacz współrzędne kartezjańskie jtego węzła czujnikowego w itym sektorze jako
x_{i,j}=l_{i,j}*cos(ang_{i,j})
y_{i,j}=l_{i,j}*sin(ang_{i,j})
- Podziel obszar kołowy o promieniu 50 m na sześć sektorów. Początkowe wartości kątowe dla tych sześciu sektorów tworzą wektor A= [60,120,180,240,300,360].
Rycina uzupełniająca 2: Script2. Skrypt do konfiguracji dwuwymiarowych lokalizacji pozycji dla każdego węzła według sektora. Kliknij tutaj, aby pobrać ten plik.
Rycina uzupełniająca 3: Skrypt 3. Skrypt służący do konfigurowania wartości pozycji każdego węzła w obrębie jednego sektora. Kliknij tutaj, aby pobrać ten plik.

Rysunek 3: Pozycje węzłów wygenerowane i zapisane osobno w 6 plikach, z których każdy odpowiada jednemu sektorowi. Dwuwymiarowe lokalizacje pozycji są zapisane w 6 plikach posdata+'idx'. Każdy z nich przedstawia jeden sektor. Aby wyświetlić powiększoną wersję tego rysunku, kliknij tutaj.

Rysunek 4: Pozycje węzłów zapisane w sektorze 0. Pozycje są dwuwymiarowe i zostały wygenerowane przy użyciu jednorodnego generatora liczb losowych. Pierwsza kolumna przedstawia współrzędne poziome, a druga kolumna współrzędne pionowe. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
5. Przygotowanie początkowych poziomów energii
- Przygotuj początkowe poziomy energii dla wszystkich 198 węzłów czujników. Połowie z nich przypisz energię początkową 0,5 J, a pozostałej połowie 1 J. Utwórz tablicę do przechowywania poziomu energii każdego węzła i użyj pętli, aby przypisać komórkom o indeksach parzystych wartość 1, a komórkom o indeksach nieparzystych wartość 0,5. Rycina uzupełniająca 4 przedstawia kody w języku Python, a wynik pokazano w Rycina 5.
Rycina uzupełniająca 4: Skrypt 4. Skrypt przypisujący połowie węzłów energię 1 joule, a pozostałym 0,5 joule. Kliknij tutaj, aby pobrać ten plik.

Rysunek 5: Początkowe przypisanie Energy_buffer. Połowie węzłów przypisano energię 1 joule, podczas gdy pozostałej połowie przypisano 0,5 joules. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
6. Przygotowanie skryptu algorytmu Advanced_Leach (Rysunek 6 i Rycina 7)
- Przygotuj funkcjonalny skrypt, w którym wybierana jest głowica klastra (cluster head) i tworzony jest klaster.
UWAGA: Klaster jest wybierany za pomocą pętli pod warunkiem, że liczba wybranych głowic klastrów jest mniejsza niż całkowita liczba węzłów podzielona przez 6. Warunek ten ma zapewnić, aby w każdym klastrze liczba węzłów źródłowych była równa lub mniejsza niż 6. Wewnątrz pętli każdemu węzłowi przypisywana jest liczba losowa z przedziału [0,1]. Węzły, dla których liczba ta jest mniejsza od określonej wartości kryterialnej, stają się głowicami klastra, natomiast pozostałe stają się węzłami źródłowymi. Szczegółowa procedura została przedstawiona na Ryc. uzupełniającej 5. Następnie, przy ustalonym zbiorze głowic klastrów, pozostałe węzły źródłowe wybierają najbliższą im głowicę klastra, pod warunkiem, że dana głowica nie obsługuje jeszcze więcej niż 6 węzłów źródłowych. Szczegółowa procedura została przedstawiona na Ryc. uzupełniającej 6.- Ustaw T_n=P/(1-P*(count%(1/P))), gdzie P = 0,2 (proporcjonalna liczba głowic klastrów do całkowitej wielkości sieci), a count to liczba rund transmisji do chwili obecnej.
- Dla każdego węzła czujnika wygeneruj liczbę losową z przedziału [0,1] threshold_rm = random.random()
- Jeśli threshold_rm jest mniejsza niż T_n, wybierz ten węzeł czujnika jako głowicę klastra.
- Dla każdego węzła, który nie jest głowicą klastra, wybierz najbliższy mu węzeł czujnika będący głowicą klastra jako jego głowicę. Przy ustalonym zbiorze głowic klastrów, pozostałe węzły źródłowe wybierają najbliższą głowicę klastra, pod warunkiem, że dana głowica nie obsługuje jeszcze więcej niż 6 węzłów źródłowych. Szczegółowa procedura została przedstawiona na Ryc. uzupełniającej 6.
- Przygotuj linie komend do obliczenia procesu wyczerpywania energii w całej sieci w danej rundzie. Dla każdego uruchomienia algorytmu, które kończy jedną partię dostarczania pakietów z węzłów źródłowych do węzła odbiorczego (sink), przygotowana tablica zapasów energii zostanie zaktualizowana, a jej wartości zostaną zmniejszone w poszczególnych komórkach. Zużycie energii wzdłuż ścieżki będzie sumą zużycia energii na każdym odcinku między węzłami, obliczaną zgodnie z modelem energetycznym1. Szczegółowa procedura została przedstawiona na Ryc. uzupełniającej 7.
- Oblicz wymagane wskaźniki rundy transmisji.
UWAGA: Przy każdym uruchomieniu algorytmu w celu zakończenia jednej partii dostarczania pakietów aktualizowana jest tablica energii oraz zliczany jest numer uruchomienia i liczba węzłów całkowicie rozładowanych. Jeśli wartość ta jest większa lub równa 1, to FND (first node die – śmierć pierwszego węzła) jest równa aktualnemu numerowi uruchomienia. Jeśli wartość jest większa lub równa połowie liczby węzłów, to HND (half node die – śmierć połowy węzłów) jest równa aktualnemu numerowi uruchomienia. Jeśli wartość jest równa całkowitej liczbie węzłów, to AND (all node die – śmierć wszystkich węzłów) jest równa aktualnemu numerowi uruchomienia. Szczegółowa procedura została przedstawiona na Ryc. uzupełniającej 8.

Rysunek 6: Tablica głównych węzłów klastra. Numery sekwencyjne węzłów, które zostały wybrane na główne węzły klastra. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.

Rysunek 7: Tablica indeksów głów klastrów. Ponieważ istnieje sześć sektorów, z których każdy zawiera 33 węzły czujników, w tablicy indeksów głów klastrów liczba wskazuje numer kolejny głowy klastra, do której należy odpowiadający jej węzeł czujnika. Indeks pozycji w tablicy odpowiada numerowi kolejnemu każdego węzła czujnika. W przypadku węzła czujnika wybranego jako głowa klastra, liczba przypisana do jego slotu w tablicy jest jego własnym numerem kolejnym. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Rycina uzupełniająca 5: Skrypt 5. Skrypt do wyboru głowy klastra. Kliknij tutaj, aby pobrać ten plik.
Rycina uzupełniająca 6: Skrypt 6. Skrypt do przypisywania węzłów źródłowych do klastrów. Kliknij tutaj, aby pobrać ten plik.
Rycina uzupełniająca 7: Skrypt 7. Skrypt do aktualizacji bufora energii dla wszystkich węzłów źródłowych poprzez redukcję ilości energii zużytej podczas transmisji. Kliknij tutaj, aby pobrać ten plik.
Rycina uzupełniająca 8: Skrypt 8. Skrypt służący do obliczenia liczby rund do momentu obumarcia pierwszego węzła oraz połowy wszystkich węzłów. Kliknij tutaj, aby pobrać ten plik.
7. Przygotowanie skryptu hybrydowego algorytmu kwantowego
- Przygotuj działający skrypt, w którym wybierana jest głowica klastra i tworzony jest klaster.
- Ponieważ maksymalny rozmiar klastra w tym eksperymencie wynosi 61, upewnij się, że liczba głowic klastrów nie jest mniejsza niż current_valid_node_amount/6; procedura wyboru będzie uruchamiana w pętli do momentu spełnienia tego kryterium.
UWAGA: Jeśli current_valid_node_amount nie przekracza 6, wówczas te poprawne węzły tworzą jeden i jedyny klaster. - Dla każdego z węzłów niebędących głowicami klastrów (non-cluster_head_valid), oblicz odległość do każdej z wybranych głowic i przypisz go do tej głowicy, której rozmiar klastra nie przekroczył 6, a wartość odległości jest najmniejsza.
UWAGA: Na Rysunku 8 obliczono odległości wszystkich węzłów non-cluster_head_valid od wybranej głowicy 24, a wszystkie wybrane głowice klastrów przedstawiono na Rysunku 9. Rysunek 10 pokazuje przypisanie wszystkich węzłów do odpowiadających im głowic klastrów, a Rysunek 11 przedstawia grupowanie węzłów członkowskich każdego klastra w tablicy wektorowej.
- Ponieważ maksymalny rozmiar klastra w tym eksperymencie wynosi 61, upewnij się, że liczba głowic klastrów nie jest mniejsza niż current_valid_node_amount/6; procedura wyboru będzie uruchamiana w pętli do momentu spełnienia tego kryterium.
- Przygotuj skrypt podfunkcji, w której sformułowany zostaje problem optymalizacji routingu dla każdego klastra i przesłany do API D-wave (Rysunek 12). Ścieżki routingu obliczane są klaster po klastrze.
- Za pomocą skryptu Python oblicz proces wyczerpywania energii w całej sieci, aby ilościowo ocenić algorytm pod kątem czasu życia sieci w przeliczeniu na liczbę rund transmisji.
UWAGA: Dla każdego uruchomienia algorytmu, które kończy jedną partię dostaw pakietów z węzłów źródłowych do węzła odbiorczego (sink), przygotowana tablica zapasów energii zostanie zaktualizowana poprzez zmniejszenie wartości w poszczególnych komórkach. Zużycie energii wzdłuż ścieżki będzie sumą zużycia energii dla każdej trasy węzeł-węzeł, obliczoną zgodnie z modelem energetycznym1. Szczegółowa procedura przedstawiona jest na Rysunku Uzupełniającym 7. - Za pomocą skryptu Python zarejestruj moment, w którym rozładuje się pierwszy węzeł oraz moment, w którym rozładuje się połowa węzłów. Szczegółowa procedura przedstawiona jest na Rysunku Uzupełniającym 8.

Rysunek 8: Tablica toClusterHeadDistance dla węzła niebędącego głową klastra o indeksie 24. Pierwsza kolumna to odległość, a druga kolumna to numer indeksu głowy klastra Proszę kliknąć tutaj, aby wyświetlić powiększoną wersję tego rysunku.

Rycina 9: Tablica CHID_buff. Numery sekwencyjne węzłów czujnikowych wybranych jako głowy klastra. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.

Rysunek 10 tablica CHIdx_buff. Przypisanie numeru sekwencyjnego węzła głowy klastra do każdego odpowiadającego mu węzła czujnika. Aby wyświetlić powiększoną wersję tej figury, kliknij tutaj.
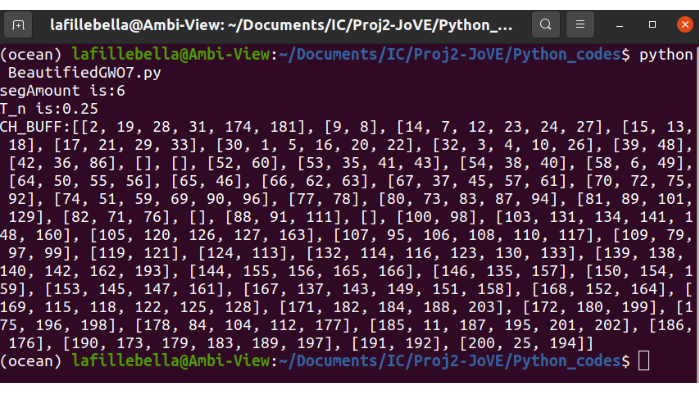
Rysunek 11: Tablica CH_BUFF. Grupa klastraB dla węzłów czujników będących głowami klastrów, odpowiadająca tablicy CHID_buff. Każda grupa klastra składa się z 0 lub więcej węzłów czujników. Każda tablica grupy klastra wyświetla numery sekwencyjne węzłów czujników, które się w niej znajdują. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.

Rycina 12: Obliczanie ścieżek routingu dla każdego sektora. Dla każdego sektora oblicza się ścieżki routingu dla wszystkich węzłów źródłowych. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Wyniki z jednej próbki z serii pomiarowej przedstawiono w Tabeli 2, Tabeli 3 i Tabeli 4. Szczegółowe zestawy danych dla trzech partii danych znajdują się w folderze Supplementary Data 1.
| Zbiór danych 1 | ||
| 198 węzłów w obszarze kołowym o promieniu 50 m | Hybrydowy algorytm kwan... | |
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Obecny najnowocześniejszy komercyjny procesor kwantowy może być używany w problemach obliczeniowych dowolnej topologii sieci1. Aplikacja procesora kwantowego nie jest ograniczona przez liczbę fizycznych qbitów, które którykolwiek z procesorów kwantowych był w stanie zaimplementować.
Wyniki projektu przedłużenia żywotności sieci czujników wskazują na postęp w metodzie osiągania jeszcze dłuższej żywotności sieci przy użyciu procesora kwantowego. Wyniki sugerują, że przew...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Podziękowania
Praca jest wspierana przez Brytyjską Radę ds. Badań Inżynieryjnych i Fizycznych (EPSRC) Grant numer EP/W032643/1.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Laptopy Dell | Nie dotyczy | ||
| Ubuntu 18.04.6 LTS | Canonical Ltd | 18.04.6 LTS | |
| Python3.8 | Python Software Foundation | 3.8.0 | |
| Dwave QPU | Dwave | https://docs.ocean.dwavesys.com/en/stable/overview/install.html |
Bibliografia
- Chen, J., Date, P., Chancellor, N., Atiquazzaman, M., Cormac, S. Controller-based energy-aware wireless sensor network routing using quantum algorithms. IEEE Transactions on Quantum Engineering. 3, 1-12 (2022).
- Lin, H., Uster, H. Exact and heuristic algorithms for data-gathering cluster-based wireless sensor network design problem. IEEE/ACM Transactions on Networking. 22 (3), 903-916 (2014).
- Zhou, Y., Wang, N., Xiang, W. Clustering hierarchy protocol in wireless sensor networks using an improved PSO algorithm. IEEE Access. 5, 2241-2253 (2017).
- How long is the lifetime of a wireless sensor network. Seah, W. K. G., Mak, N. H. 2009 International Conference on Advanced Information Networking and Applications, Bradford, UK, , 763-770 (2009).
- Salahud din, M., Rehman, M. A. U., Ullah, R., Park, C., Kim, B. S. Towards network lifetime enhancement of resource constrained IoT devices in heterogeneous wireless sensor networks Sensors. 20, 4156(2020).
- Wu, W., Xiong, N., Wu, C. Improved clustering algorithm based on energy consumption in wireless sensor networks. IET Network. 6 (3), 7-53 (2017).
- Kumar, N., Kumar, V., Ali, T., Ayaz, M. Prolong network lifetime in the wireless sensor networks: An improved approach. Arabian Journal for Science and Engineering. 46, 3631-3651 (2021).
- Faris, H., Aljarah, I., Al-Betar, M. A., Mirjalili, S. Grey wolf optimizer: A review of recent variants and applications. Neural Computing and Applications. 30, 413-435 (2018).
- Kaur, J., Arifkhan, M., Iftikhar, M., Imran, M., Haq, A. Machine learning techniques for 5G and beyond. IEEEAccess. 9, 23472-23488 (2021).
- Shor, P. Polynomial-time algorithms for prime factorization and discrete logarithms on a quantum computer. SIAMJournalonComputing. 26 (5), 1484-1509 (1997).
- Qabouche, H., Sahel, A., Badri, A. Hybrid energy efficient static routing protocol for homogeneous and heterogeneous large scale WSN. Wireless Networks. 27, 575-587 (2021).
- Farooq, M., et al. POWER: probabilistic weight-based energy-efficient cluster routing for large-scale wireless sensor networks. The Journal of Supercomputing. 78, 12765-12791 (2022).
- Maddams, W. F. The scope and limitations of curve fitting. Applied Spectroscopy. 34 (3), 245-267 (1980).
- Wang, X., et al. A dynamic opportunistic routing protocol for asynchronous duty-cycled WSNs. IEEE Transactions on Sustainable Computing. , (2023).
- Ismail, A. S., Wang, X., Hawbani, A., Alsamhi, S., Aziz, S. Routing protocols classification for underwater wireless sensor networks based on localization and mobility. Wireless Networks. 28, 797-826 (2022).
- Garcia-Martin, E., Rodrigues, C. F., Riley, G., Grahn, H. Estimation of energy consumption in machine learning. Journal of Parallel Distributed Computing. 134, 75-88 (2019).
- Egger, D. J., et al. Quantum computing for finance: State-of-the-art and future prospects. IEEE Transactions on Quantum Engineering. 1, 1-24 (2020).
- Rasool, R. U., Ahmad, H. F., Rafique, W., Qayyum, A., Qadir, J. Quantum computing for healthcare : A review. TechRxiv. , (2021).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
