Ten artykuł przedstawia metodę szacowania dokładności interfejsu mózg-komputer (BCI) dla pisowni P300 tego samego dnia przy użyciu małego zestawu danych testowych.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Szacowanie wydajności pisowni interfejsu mózg-komputer oparte na P300 z szacowaniem opóźnień na podstawie klasyfikatora
W tym artykule
Podsumowanie
Streszczenie
Szacowanie wydajności jest niezbędnym krokiem w rozwoju i walidacji systemów interfejsu mózg-komputer (BCI). Niestety, nawet nowoczesne systemy BCI działają powoli, co sprawia, że gromadzenie wystarczającej ilości danych do walidacji jest czasochłonnym zadaniem zarówno dla użytkowników końcowych, jak i eksperymentatorów. Jednak bez wystarczających danych losowa zmienność wydajności może prowadzić do fałszywych wniosków na temat tego, jak dobrze BCI działa dla konkretnego użytkownika. Na przykład pisownia P300 zwykle operuje około 1-5 znaków na minutę. Oszacowanie dokładności z rozdzielczością 5% wymaga 20 znaków (4-20 min). Pomimo tej inwestycji czasu, granice ufności dla dokładności od 20 znaków mogą wynosić nawet ±23% w zależności od obserwowanej dokładności. Wykazano, że wcześniej opublikowana metoda, Classifier-Based Latency Estimation (CBLE), jest silnie skorelowana z dokładnością BCI. W tej pracy przedstawiono protokół wykorzystania CBLE do przewidywania dokładności pisowni P300 użytkownika na podstawie stosunkowo niewielu znaków (~3-8) danych pisania. Wynikające z tego granice ufności są węższe niż te uzyskiwane tradycyjnymi metodami. Metoda ta może być zatem wykorzystana do szybszego i/lub dokładniejszego oszacowania wydajności BCI.
Wprowadzenie
Interfejsy mózg-komputer (BCI) to nieinwazyjna technologia, która pozwala osobom na komunikację bezpośrednio za pomocą maszyn, bez względu na ograniczenia fizyczne narzucone przez organizm. BCI może być wykorzystywane jako urządzenie wspomagające sterowane bezpośrednio przez mózg. BCI wykorzystuje aktywność mózgu użytkownika do określenia, czy zamierza on wybrać określony klawisz (literę, cyfrę lub symbol) wyświetlony na ekranie1. W typowym systemie komputerowym użytkownik fizycznie naciska zamierzony klawisz na klawiaturze. Jednak w systemie BCI z wyświetlaczem wizualnym użytkownik musi skupić się na pożądanym klawiszu. Następnie BCI wybierze zamierzony klawisz poprzez analizę zmierzonych sygnałów mózgowych1. Aktywność mózgu można mierzyć za pomocą różnych technik. Choć istnieją konkurencyjne technologie BCI, elektroencefalografia (EEG) jest uważana za wiodącą technikę ze względu na swój nieinwazyjny charakter, wysoką rozdzielczość czasową, niezawodność i stosunkowo niski koszt2.
Zastosowania BCI obejmują komunikację, sterowanie urządzeniami, a także rozrywkę3,4,5,6. Jednym z najaktywniejszych obszarów zastosowań BCI jest pisarka P300, wprowadzona przez Farwella i Donchina7. P300 to potencjał wywołany (ERP) powstający w odpowiedzi na rozpoznanie rzadkiego, lecz istotnego bodźca8. Gdy osoba rozpoznaje swój bodziec docelowy, automatycznie generuje P300. P300 jest skutecznym sygnałem dla BCI, ponieważ przekazuje informację o rozpoznaniu zdarzenia docelowego przez uczestnika bez konieczności wywołania zewnętrznej reakcji9.
BCI oparte na potencjale P300 przyciągnęło badaczy z zakresu informatyki, inżynierii elektrycznej, psychologii, ergonomii oraz wielu innych dyscyplin. Postępy poczyniono w przetwarzaniu sygnałów, algorytmach klasyfikacji, interfejsach użytkownika, schematach stymulacji i wielu innych obszarach10,11,12,13,14,15. Jednak niezależnie od obszaru badawczego, wspólnym mianownikiem wszystkich tych prac jest konieczność pomiaru wydajności systemu BCI. Zadanie to zazwyczaj wymaga wygenerowania zestawu danych testowych. Konieczność ta nie ogranicza się tylko do badań; przyszłe zastosowania kliniczne jako technologii wspomagającej prawdopodobnie będą wymagały indywidualnych zestawów walidacyjnych dla każdego użytkownika końcowego, aby zapewnić systemowi możliwość generowania niezawodnej komunikacji.
Mimo znacznych badań nad BCI opartym na potencjale P300, systemy te są nadal dość powolne. Chociaż większość osób jest w stanie korzystać z BCI P30016, większość systemów P300 Speller generuje tekst w tempie od 1 do 5 znaków na minutę. Niestety, tak niska prędkość sprawia, że generowanie zestawów danych testowych wymaga znacznego czasu i wysiłku ze strony uczestników, eksperymentatorów i przyszłych użytkowników końcowych. Pomiar dokładności systemu BCI jest problemem szacowania parametru dwumianowego, a do uzyskania rzetelnego szacunku niezbędna jest duża ilość danych znakowych.
Aby ocenić obecność lub brak ERP P300, większość klasyfikatorów wykorzystuje binarny model klasyfikacji, który polega na przypisaniu etykiety binarnej (np. „obecność” lub „brak”) do każdej próby lub epoki danych EEG. Ogólne równanie stosowane przez większość klasyfikatorów można zapisać jako:
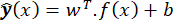
gdzie  nazywa się wynikiem klasyfikatora, który reprezentuje prawdopodobieństwo wystąpienia odpowiedzi P300, x jest wektorem cech wyekstrahowanym z sygnału EEG, a b jest członem biasu17. Funkcja f jest funkcją decyzyjną, która mapuje dane wejściowe na etykietę wyjściową i jest uczenia z zestawu etykietowanych danych treningowych przy użyciu algorytmu uczenia nadzorowanego17. Podczas treningu klasyfikator jest uczony na etykietowanym zbiorze danych sygnałów EEG, gdzie każdy sygnał jest oznaczony jako posiadający lub nieposiadający odpowiedzi P300. Wektor wag oraz człon biasu są optymalizowane w celu zminimalizowania błędu między przewidywanym wynikiem klasyfikatora a rzeczywistą etykietą sygnału EEG. Po wytrenowaniu klasyfikator może zostać użyty do przewidywania obecności odpowiedzi P300 w nowych sygnałach EEG.
Różne klasyfikatory mogą wykorzystywać różne funkcje decyzyjne, takie jak liniowa analiza dyskryminacyjna (LDA), krokowa liniowa analiza dyskryminacyjna (SWLDA), metoda najmniejszych kwadratów (LS), regresja logistyczna, maszyny wektorów nośnych (SVM) lub sieci neuronowe (NNs). Klasyfikator najmniejszych kwadratów jest klasyfikatorem liniowym, który minimalizuje sumę kwadratów błędów między przewidywanymi a rzeczywistymi etykietami klas. Klasyfikator ten przewiduje etykietę klasy nowej próbki testowej za pomocą następującego równania:
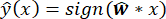 (1)
gdzie funkcja znaku zwraca +1, jeśli iloczyn jest dodatni, i -1, jeśli jest ujemny, a wektor wag  jest wyznaczany z zestawu cech danych treningowych (x) i etykiet klas (y) przy użyciu poniższego równania:
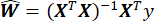 (2)
W poprzednich badaniach wykazaliśmy, że szacowanie opóźnienia oparte na klasyfikatorze (Classifier-Based Latency Estimation, CBLE) może być wykorzystywane do szacowania dokładności BCI17,18,19. CBLE jest strategią oceny zmienności opóźnienia poprzez wykorzystanie czułości czasowej klasyfikatora18. Podczas gdy konwencjonalne podejście do klasyfikacji P300 polega na użyciu pojedynczego okna czasowego zsynchronizowanego z każdą prezentacją bodźca, metoda CBLE polega na tworzeniu wielu przesuniętych w czasie kopii epok popodbodźcowych. Następnie wykrywa ona przesunięcie czasowe, które skutkuje maksymalnym wynikiem, w celu oszacowania opóźnienia odpowiedzi P30017,18. W niniejszej pracy przedstawiono protokół, który szacuje wydajność BCI na podstawie małego zbioru danych z wykorzystaniem CBLE. W ramach analizy reprezentatywnej zmieniano liczbę znaków, aby dokonać prognoz ogólnej wydajności danej osoby. Dla obu przykładowych zbiorów danych obliczono błąd średniokwadratowy (RMSE) dla vCBLE oraz rzeczywistą dokładność BCI. Wyniki wskazują, że RMSE z prognoz vCBLE, przy użyciu dopasowanych danych, był konsekwentnie niższy niż dokładność uzyskana z 1 do 7 przetestowanych znaków.
Opracowaliśmy graficzny interfejs użytkownika (GUI) o nazwie „CBLE Performance Estimation” do implementacji proponowanej metodologii. Udostępniono również przykładowy kod (Supplementary Coding File 1), który działa na platformie MATLAB. Przykładowy kod wykonuje wszystkie kroki zastosowane w GUI, a poszczególne etapy zostały przedstawione, aby pomóc czytelnikowi w adaptacji do nowego zbioru danych. Kod ten wykorzystuje publicznie dostępny zbiór danych „Brain Invaders calibration-less P300-based BCI using dry EEG electrodes Dataset (bi2014a)” w celu oceny proponowanej metody20. Uczestnicy rozegrali do trzech sesji gry Brain Invaders, przy czym każda sesja składała się z 9 poziomów gry. Gromadzenie danych trwało do momentu ukończenia wszystkich poziomów lub utraty przez uczestnika pełnej kontroli nad systemem BCI. Interfejs Brain Invaders zawierał 36 symboli, które migały w 12 grupach po sześć kosmitów. Zgodnie z paradygmatem P300 w Brain Invaders, jedna repetycja składała się z 12 błysków, po jednym dla każdej grupy. Z tych 12 błysków dwa zawierały symbol docelowy (tzw. błyski Target), natomiast pozostałe 10 błysków nie zawierało symbolu docelowego (tzw. błyski non-Target). Więcej informacji na temat tego paradygmatu można znaleźć w oryginalnej publikacji20.
Podejście CBLE zaimplementowano również na zbiorze danych z Michigan, który zawierał dane od 40 uczestników18,19. W tym przypadku dane ośmiu uczestników musiały zostać odrzucone z powodu niepełnego wykonania zadań. Całe badanie wymagało trzech wizyt każdego uczestnika. Pierwszego dnia każdy uczestnik wpisywał treningowe zdanie składające się z 19 znaków, a następnie trzy testowe zdania po 23 znaki w dniach 1, 2 i 3. W tym przykładzie klawiatura zawierała 36 znaków pogrupowanych w sześć rzędów i sześć kolumn. Każdy rząd lub kolumna błyskały przez 31.25 milliseconds z odstępem 125 milliseconds między błyskami. Pomiędzy znakami stosowano przerwę trwającą 3.5 s.
Rycina 1 przedstawia schemat blokowy proponowanej metody. Szczegółowa procedura została opisana w sekcji protokołu.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Graficzny interfejs użytkownika "Oszacowanie wydajności CBLE" został zastosowany do dwóch zestawów danych: zestawu danych "BrainInvaders" i zestawu danych Michigan. W przypadku zestawu danych "BrainInvaders" zbieranie danych zostało zatwierdzone przez Komisję Etyczną Uniwersytetu Grenoble Alpes20. Dane z Michigan zostały zebrane za zgodą University of Michigan Institutional Review Board19. Dane zostały przeanalizowane zgodnie z protokołem 7516 zwolnionym z obowiązku Kalifornijskiego Uniwersytetu Stanowego Kansas. W przypadku zbierania nowych danych należy postępować zgodnie z zatwierdzonym przez IRB procesem zbierania świadomej zgody. W tym przypadku proponowany protokół jest oceniany przy użyciu analizy offline wcześniej zarejestrowanych, zanonimizowanych danych, a zatem nie wymagał dodatkowej świadomej zgody.
Graficzny interfejs użytkownika (GUI) zawarty w tym artykule jest biegły w zarządzaniu dwoma różnymi formatami zestawów danych. Pierwszy format jest powiązany z oprogramowaniem BCI2000, podczas gdy drugi format jest określany jako zestaw danych "BrainInvaders". Aby korzystać z formatu "Brain Invaders", dane muszą zostać wstępnie przetworzone zgodnie z opisem w kroku 1 sekcji protokołu. Jednak w przypadku formatu zbioru danych "BCI2000" krok 1 można pominąć.
1. Przygotowanie danych
- Tylko BrainInvaders: Wygeneruj plik danych wejściowych w formacie pliku ".mat", który może być używany z graficznym interfejsem użytkownika (GUI) "CBLE Performance Estimation". Aby zapoznać się z przykładowym skryptem, zapoznaj się z dodatkowym plikiem kodowania 2.
UWAGA: Każdy plik danych składa się z dwuwymiarowej macierzy składającej się z wierszy, które reprezentują obserwacje zarejestrowane w różnych próbkach czasowych. Kolumny matrycowe ponumerowane od 2 do 17 to zapisy pochodzące z 16 elektrod EEG. Pierwsza kolumna macierzy oznacza znacznik czasu każdej obserwacji, podczas gdy kolumna 18 zawiera informacje związane ze zdarzeniami eksperymentalnymi. W kolumnie 19 znajdują się głównie zera, ale gdy rozpoczyna się błysk niebędący celem (lub celem), liczby zmieniają się na jeden (lub dwa) w tym konkretnym czasie. Szczegółowy opis można znaleźć w pliku reference20.
2. Pobieranie i instalowanie pakietu GUI
- Pobierz i zainstaluj graficzny interfejs użytkownika "CBLE Performance Estimation".
3. Przechowywanie zestawu danych w podfolderze lokalizacji GUI
- Upewnij się, że folder zestawu danych pozostaje w tym samym katalogu co graficzny interfejs użytkownika.
- Na przykład utwórz nowy folder i umieść w nim graficzny interfejs użytkownika "CBLE Performance Estimation". Przechowuj wszystkie zestawy danych w podfolderze w "CBLE GUI" o nazwie "Dataset".
4. Otwieranie zainstalowanego graficznego interfejsu użytkownika
- Otwórz MATLAB (patrz Spis materiałów), zmień bieżący katalog na folder, w którym znajduje się GUI, kliknij kartę APLIKACJE i wybierz MOJE APLIKACJE.
- W zakładce "MOJE APLIKACJE" wybierz opcję CBLE Performance Estimation.
5. Wybór formatu zestawu danych
- Wybierz format zestawu danych z listy rozwijanej Wybierz format zestawu danych.
6. Wczytywanie pliku z danymi EEG
- Kliknij przycisk Wybierz folder wejściowy, aby wybrać katalog, w którym znajduje się zestaw danych.
- Obserwuj liczbę plików danych znajdujących się w wybranym folderze.
UWAGA: W formacie "Brain Invaders" każdy uczestnik jest reprezentowany przez pojedynczy plik danych. W związku z tym łączna liczba plików danych wskazuje liczbę uczestników badania. Nie dotyczy to jednak formatu "BCI2000", ponieważ każdy uczestnik może mieć wiele plików treningowych i testowych.
7. Ustawianie parametrów
- W polu tekstowym "Liczba uczestników" wpisz liczbę uczestników, których użytkownik zamierza użyć w procesie szacowania.
- Tylko BrainInvaders: określ częstotliwość próbkowania zestawu danych.
UWAGA: BCI2000 pliki zawierają częstotliwość próbkowania. - Wybierz wartość dziesiątkowania, aby zmniejszyć próbkowanie zestawu danych do około 20 Hz w celu poprawy wydajności klasyfikacji21. Na przykład, jeśli częstotliwość próbkowania wynosi 256 Hz, wybierz wartość decymacyjną 13.
- Określ przedział czasu dla klasyfikacji w milisekundach.
UWAGA: Określony jest zalecany początkowy rozmiar okna, przy czym punkt początkowy może wynosić od 0 do 100 ms, a punkt końcowy od 700 do 800 ms. Jednak ważne jest, aby unikać zbyt dużego rozmiaru okna, aby zapobiec nakładaniu się na inne zdarzenie P300. - Zdefiniuj okno przesunięcia dla CBLE w milisekundach.
UWAGA: "Okno przesunięcia" odnosi się do rozszerzonego zakresu czasu, który metoda CBLE przeszukuje w celu znalezienia odpowiedzi P3. Klasyfikator zostanie zastosowany do epoki, zaczynając od pierwszego elementu okna przesunięcia. Klasyfikator jest następnie sekwencyjnie stosowany do epok rozpoczynających się o jedną próbkę później, aż epoka wyjdzie poza okno przesunięcia. W ten sposób, okno przesunięcia musi być większe niż okno oryginalne; Empirycznie wartości mniejsze niż 100 ms z każdej strony są dobre. W każdym przypadku marża powinna być utrzymywana na poziomie niższym niż połowa ISI. - Tylko BC2000: Wprowadź długość identyfikatora podmiotu wskazaną w plikach zestawu danych w polu "Długość identyfikatora".
UWAGA: Graficzny interfejs użytkownika oczekuje, że pierwsze sub_len znaki nazw plików zakodują identyfikator tematu. - BCI2000 tylko: W polu "Identyfikator kanału" wskaż łączną liczbę kanałów lub określ konkretne numery kanałów, które mają być używane do analizy.
- Kliknij przycisk Ustaw parametry, aby ustawić wszystkie parametry wymagane do analizy.
8. Tylko BrainInvaders: Podział zbioru danych na zestaw treningowy i testowy
- Wybierz liczbę obiektów docelowych reprezentującą rozmiar zestawu treningowego. Pozostała część zestawu danych zostanie uznana za testowy zestaw danych.
UWAGA: Aby zapewnić prawidłowe trenowanie modelu, niezbędne jest posiadanie wystarczająco dużej próby treningowej. Zalecany minimalny rozmiar próby szkoleniowej to 20, choć może się to różnić w zależności od ogólnego rozmiaru zestawu danych. Jeśli podczas sesji treningowych wystąpią błędy regresji, zaleca się zwiększenie wielkości próby treningowej. - Naciśnij przycisk "Podziel zestaw danych", aby podzielić zestaw danych na zestawy treningowe i testowe.
UWAGA: Każdy uczestnik będzie miał równą ilość danych treningowych. Jednak liczba danych testowych może nie być równa dla wszystkich uczestników ze względu na możliwość wielokrotnych prób podczas zadania. W związku z tym całkowita liczba prezentowanych celów lub błysków może się różnić w zależności od osoby.
9. Trenowanie modelu za pomocą zestawu danych treningowych
UWAGA: Krok 9.1 dotyczy formatu "Brain Invaders", a krok 9.2 dotyczy formatu "BCI2000".
- Tylko BrainInvaders: kliknij przycisk Trenuj model, aby zastosować regresję liniową w zestawie danych trenowania przy użyciu równania 2 do trenowania modelu klasyfikatora.
- Tylko BCI2000: Wskaż nazwy plików trenowania i testowania wraz z ich formatem danych (.dat), aby odróżnić pliki treningowe i testowe od wszystkich plików. Następnie kliknij przycisk Trenuj model, aby zastosować regresję liniową w zestawie danych treningowych.
10. Przewidywanie dokładności zestawu testowego
- Kliknij pozycję Przewiduj dokładność, aby zastosować wytrenowany model klasyfikatora do zestawu funkcji testowych i przewidzieć dokładność przy użyciu równania 1.
11. Uzyskiwanie dokładności X-target
- Wybierz maksymalną liczbę docelową, X, która ma być brana pod uwagę w zestawie testowym.
- BCI2000 tylko: Wybierz numer pliku testowego, jeśli użytkownik ma wiele plików testowych.
- Naciśnij przycisk Znajdź dokładność celu X.
12. Obliczanie vCBLE
- Kliknij przycisk Znajdź vCBLE, aby uzyskać vCBLE dla wszystkich celów.
13. Obliczanie błędu średniokwadratowego (RMSE) dokładności BCI i vCBLE
- Kliknij przycisk Oblicz RMSE, aby obliczyć RMSE między oboma przewidywaniami na podstawie vCBLE z dokładnością BCI i dokładności X-target z dokładnością BCI.
14. Wizualizacja wyników analizy
- Kliknij przycisk Dokładność a vCBLE, aby obserwować zależność między całkowitą dokładnością a całkowitą vCBLE dla wszystkich uczestników.
- Naciśnij przycisk RMSE BCI i vCBLE, aby wyświetlić krzywą RMSE dokładności BCI i vCBLE.
15. Przewidywanie wyników poszczególnych uczestników
- Aby przewidzieć dokładność pojedynczego uczestnika, umieść identyfikator podmiotu w polu Sub ID.
UWAGA: W tym przypadku zestaw danych wszystkich uczestników, z wyłączeniem uczestnika testu, zostanie wykorzystany do wytrenowania modelu regresji liniowej. Wyniki vCBLE wszystkich pozostałych uczestników i odpowiadające im dokładności testów zostaną wykorzystane odpowiednio jako predyktory i etykiety dla klasyfikatora. - Wybierz numer docelowy, rzeczownik. Przewidywanie zostanie wykonane na podstawie dokładności n znaków testowych.
- Kliknij przycisk Przewiduj, aby uzyskać przewidywaną dokładność uczestnika testu.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Zaproponowany protokół został przetestowany na dwóch różnych zbiorach danych: „BrainInvaders” oraz zbiorze danych Michigan. Zbiory te zostały już krótko przedstawione w sekcji Wstęp. Parametry zastosowane dla tych dwóch zbiorów danych są wymienione w Tabeli 1. Ryciny 2-4 przedstawiają wyniki uzyskane przy użyciu zbioru danych „BrainInvaders”, natomiast Ryciny 5-7 obrazują wyniki...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
W tym artykule przedstawiono metodę szacowania dokładności BCI przy użyciu małego zestawu danych P300. W tym przypadku obecny protokół został opracowany w oparciu o zestaw danych "bi2014a", chociaż skuteczność protokołu została potwierdzona na dwóch różnych zestawach danych. Aby pomyślnie zaimplementować tę technikę, konieczne jest ustalenie pewnych zmiennych, takich jak okno epoki dla oryginalnych danych, okno przesunięcia w czasie, współczynnik próbkowania w dół oraz rozmiar zestawów danych zarówno treningowych, jak i ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Wszyscy autorzy deklarują, że nie mają żadnych konfliktów interesów.
Podziękowania
Dane użyte do reprezentatywnych wyników zostały zebrane z pracy wspieranej przez National Institute of Child Health and Human Development (NICHD), National Institutes of Health (NIH) w ramach Grant R21HD054697, oraz National Institute on Disability and Rehabilitation Research (NIDRR) w Departamencie Edukacji w ramach Grantu H133G090005 i Nagrody Numer H133P090008. Reszta prac została częściowo sfinansowana przez National Science Foundation (NSF) w ramach nagrody #1910526. Ustalenia i opinie zawarte w tej pracy niekoniecznie odzwierciedlają stanowisko NICHD, NIH, NIDRR lub NSF.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| MATLAB 2021 | Matlab | N/A | Można użyć dowolnej najnowszej wersji MATLAB. |
Bibliografia
- Rezeika, A., Benda, M., Stawicki, P., Gembler, F., Saboor, A., Volosyak, I. Brain-Computer Interface spellers: A review. Brain Science. 8 (4), 57(2018).
- Gannouni, S., Aledaily, A., Belwafi, K., Aboalsamh, H. Emotion detection using electroencephalography signals and a zero-time windowing-based epoch estimation and relevant electrode identification. Scientific Reports. 11 (1), 7071(2021).
- Daly, J. J., Wolpaw, J. R. Brain-computer interfaces in neurological rehabilitation. Lancet Neurology. 7 (11), 1032-1043 (2008).
- Birbaumer, N. Breaking the silence: brain-computer interfaces (BCI) for communication and motor control. Psychophysiology. 43 (6), 517-532 (2006).
- Riccio, A., Simione, L., Schettini, F., Pizzimenti, A., Inghilleri, M., Belardinelli, M. O. Attention and P300-based BCI performance in people with amyotrophic lateral sclerosis. Frontiers in Human Neuroscience. 7, 732(2013).
- Finke, A., Lenhardt, A., Ritter, H. The MindGame: a P300-based brain-computer interface game. Neural Network. 22 (9), 1329-1333 (2009).
- Farwell, L. A., Donchin, E. Talking off the top of your head: toward a mental prosthesis utilizing event-related brain potentials. Electroencephalogr. Clinical Neurophysiology. 70 (6), 510-523 (1988).
- Li, Q., Lu, Z., Gao, N., Yang, J. Optimizing the performance of the visual P300-speller through active mental tasks based on color distinction and modulation of task difficulty. Frontiers in Human Neuroscience. 13, 130(2019).
- McFarland, D. J., Sarnacki, W. A., Townsend, G., Vaughan, T., Wolpaw, J. R. The P300-based brain-computer interface (BCI): effects of stimulus rate. Clinical Neurophysiology. 122 (4), 731-737 (2011).
- Krusienski, D. J., Sellers, E. W., Cabestaing, F., Bayoudh, S., McFarland, D. J., Vaughan, T. M. A comparison of classification techniques for the P300 Speller. Journal of Neural Engineering. 3 (4), 299-305 (2006).
- Sellers, E. W., Donchin, E. A P300-based brain-computer interface: initial tests by ALS patients. Clinical Neurophysiology. 117 (3), 538-548 (2006).
- Donchin, E., Spencer, K. M., Wijesinghe, R. The mental prosthesis: assessing the speed of a P300-based brain-computer interface. IEEE Transactions on Rehabilitation Engineering. 8 (2), 174-179 (2000).
- Höhne, J., Schreuder, M., Blankertz, B., Tangermann, M. A novel 9-class auditory ERP paradigm driving a predictive text entry system. Frontiers in Neuroscience. 5, 99(2011).
- Acqualagna, L., Treder, M. S., Blankertz, B. Chroma Speller: Isotropic visual stimuli for truly gaze-independent spelling. 2013 6th International IEEE/EMBS Conference on Neural Engineering (NER), , (2013).
- Townsend, G., LaPallo, B. K., Boulay, C. B., Krusienski, D. J., Frye, G. E., Hauser, C. K. A novel P300-based brain-computer interface stimulus presentation paradigm: moving beyond rows and columns. Clinical Neurophysiology. 121 (7), 1109-1120 (2010).
- Guger, C., Daban, S., Sellers, E., Holzner, C., Krausz, G., Carabalona, R. How many people are able to control a P300-based brain-computer interface (BCI). Neuroscience Letters. 462 (1), 94-98 (2009).
- Mowla, M. R., Gonzalez-Morales, J. D., Rico-Martinez, J., Ulichnie, D. A., Thompson, D. E. A comparison of classification techniques to predict Brain-computer interfaces accuracy using classifier-based latency estimation. Brain Science. 10 (10), 734(2020).
- Thompson, D. E., Warschausky, S., Huggins, J. E. Classifier-based latency estimation: a novel way to estimate and predict BCI accuracy. Journal of Neural Engineering. 10 (1), 016006(2012).
- Thompson, D. E., Gruis, K. L., Huggins, J. E. A plug-and-play brain-computer interface to operate commercial assistive technology. Disability and Rehabilitation: Assistive Technology. 9 (2), 144-150 (2014).
- Korczowski, L., Ostaschenko, E., Andreev, A., Cattan, G., Coelho Rodrigues, P. L., Gautheret, V., Congedo, M. Brain Invaders calibration-less P300-based BCI using dry EEG electrodes Dataset (bi2014a) [Data set]. Zenodo. , (2019).
- Krusienski, D. J., Sellers, E. W., Cabestaing, F., Bayoudh, S., McFarland, D. J., Vaughan, T. M., Wolpaw, J. R. A comparison of classification techniques for the P300 Speller. Journal of Neural Engineering. 3 (4), 299-305 (2006).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
