Ten protokół opisuje proces od hodowli komórkowych ex vivo lub in vitro do wstępnego przetwarzania danych transkryptomicznych w celu opłacalnego badania przesiewowego leków opartego na transkryptomie.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Ekonomiczne badania przesiewowe leków oparte na transkryptomii
W tym artykule
Podsumowanie
Streszczenie
Transkryptomika pozwala uzyskać kompleksowy wgląd w programy komórkowe i ich reakcje na zakłócenia. Pomimo znacznego spadku kosztów produkcji bibliotecznej i sekwencjonowania w ostatniej dekadzie, zastosowanie tych technologii na skalę niezbędną do badań przesiewowych narkotyków pozostaje zbyt drogie, co utrudnia wykorzystanie ogromnego potencjału tych metod. W naszym badaniu przedstawiono efektywny kosztowo system do badań przesiewowych leków na podstawie transkryptomu, łączący zminiaturyzowane kultury perturbacyjne z transkryptomiką mini-masową. Zoptymalizowany protokół mini-bulk dostarcza informacyjnych sygnałów biologicznych przy opłacalnej głębokości sekwencjonowania, umożliwiając szeroko zakrojone badania przesiewowe znanych leków i nowych cząsteczek. W zależności od wybranego leczenia i czasu inkubacji, protokół ten spowoduje sekwencjonowanie bibliotek w ciągu około 2 dni. Ze względu na kilka punktów zatrzymania w tym protokole, przygotowanie biblioteki, jak również sekwencjonowanie, mogą być wykonywane niezależnie od czasu. Możliwe jest jednoczesne przetwarzanie dużej liczby próbek; Pomiar do 384 próbek został przetestowany bez utraty jakości danych. Nie są również znane żadne ograniczenia co do liczby schorzeń i/lub leków, pomimo uwzględnienia zmienności optymalnego czasu inkubacji leków.
Wprowadzenie
Rozwój nowych leków to złożony i czasochłonny proces, który obejmuje identyfikację potencjalnych leków i ich celów, optymalizację i syntezę kandydatów na leki oraz testowanie ich skuteczności i bezpieczeństwa w badaniach przedklinicznych i klinicznych1. Tradycyjne metody badań przesiewowych leków, tj. systematyczna ocena bibliotek związków kandydujących do celów terapeutycznych, obejmują wykorzystanie modeli zwierzęcych lub testów komórkowych w celu przetestowania wpływu na określone cele lub szlaki. Chociaż metody te okazały się skuteczne w identyfikacji kandydatów na leki, często nie dostarczały wystarczających informacji na temat złożonych mechanizmów molekularnych leżących u podstaw skuteczności leków, a także toksyczności i mechanizmów potencjalnych skutków ubocznych.
Ocena stanów transkrypcyjnych całego genomu stanowi skuteczne podejście do przezwyciężenia obecnych ograniczeń w badaniach przesiewowych leków, ponieważ umożliwia kompleksową ocenę ekspresji genów w odpowiedzi na leczenie farmakologiczne2. Mierząc transkrypty RNA w sposób obejmujący cały genom wyrażony w danym czasie, transkryptomika ma na celu zapewnienie holistycznego spojrzenia na zmiany transkrypcyjne, które zachodzą w odpowiedzi na leki, w tym zmiany we wzorcach ekspresji genów, alternatywny splicing i niekodującą ekspresję RNA3. Informacje te mogą być wykorzystane do określenia celów leków, przewidywania ich skuteczności i toksyczności oraz optymalizacji dawkowania i schematów leczenia.
Jedną z kluczowych korzyści płynących z połączenia transkryptomiki z bezstronnym badaniem przesiewowym leków jest możliwość identyfikacji nowych celów leków, które wcześniej nie były brane pod uwagę. Konwencjonalne metody badań przesiewowych leków często koncentrują się na ustalonych cząsteczkach docelowych lub szlakach, co utrudnia identyfikację nowych celów i potencjalnie prowadzi do powstania leków o nieprzewidzianych skutkach ubocznych i ograniczonej skuteczności. Transkryptomika może przezwyciężyć te ograniczenia, dostarczając wglądu w zmiany molekularne, które zachodzą w odpowiedzi na leczenie farmakologiczne, odkrywając potencjalne cele lub szlaki, które mogły nie być wcześniej brane pod uwagę2.
Oprócz identyfikacji nowych celów leków, transkryptomika może być również używana do przewidywania skuteczności i toksyczności leków. Analizując wzorce ekspresji genów związanych z reakcjami na leki, można opracować biomarkery, które można wykorzystać do przewidywania odpowiedzi pacjenta na określony lek lub schemat leczenia. Może to również pomóc w optymalizacji dawkowania leków i zmniejszeniu ryzyka wystąpienia niepożądanych skutków ubocznych4.
Pomimo potencjalnych korzyści, koszt transkryptomiki pozostaje istotną przeszkodą dla jej szerokiego zastosowania w badaniach przesiewowych leków. Analiza transkryptomiczna wymaga specjalistycznego sprzętu, wiedzy technicznej i analizy danych, co może stanowić wyzwanie dla mniejszych zespołów badawczych lub organizacji o ograniczonych funduszach w wykorzystaniu transkryptomiki w badaniach przesiewowych leków. Jednak koszt transkryptomiki stale spada, co czyni ją bardziej dostępną dla społeczności naukowych. Ponadto postęp w technologii i metodach analizy danych sprawił, że transkryptomika stała się bardziej wydajna i opłacalna, co jeszcze bardziej zwiększyło jej dostępność2.
W tym protokole opisujemy wielowymiarowy i eksploracyjny system do badań przesiewowych leków opartych na transkryptomie, łączący zminiaturyzowane kultury perturbacji z analizą transkryptomiczną mini-masową5,6. Dzięki temu protokołowi możliwe jest obniżenie kosztu na próbkę do 1/6 obecnego kosztu komercyjnych rozwiązań do sekwencjonowania mRNA o pełnej długości. Protokół wymaga jedynie standardowego sprzętu laboratoryjnego, a jedynym wyjątkiem jest stosowanie technologii sekwencjonowania z krótkim odczytem, które można zlecić na zewnątrz, jeśli przyrządy do sekwencjonowania nie są dostępne we własnym zakresie. Zoptymalizowany protokół mini-bulk dostarcza bogatych w informacje sygnałów biologicznych przy opłacalnej głębokości sekwencjonowania, umożliwiając szeroko zakrojone badania przesiewowe znanych leków i nowych cząsteczek.
Celem eksperymentu jest sprawdzenie aktywności leków na PBMC w różnych kontekstach biologicznych. Protokół ten może być zastosowany do każdego zagadnienia biologicznego, w którym kilka leków powinno być testowanych z odczytem transkryptomicznym, dając szeroki transkryptom wglądu w komórkowy efekt leczenia.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Niniejszy protokół jest zgodny z wytycznymi lokalnych komisji etycznych Uniwersytetu w Bonn.
1. Przygotowanie buforów, roztworów i sprzętu
- Przygotować roztwory i zgromadzić materiały opisane w Tabeli materiałów.
- Rozgrzać łaźnię wodną do 37 °C i ogrzać pełną pożywkę wzrostową (RPMI-1640 + 10% płodowej surowicy cielęcej (FCS) + 1% penicyliny/streptomycyny).
- Do zbioru komórek należy użyć lodowatego roztworu soli fizjologicznej buforowanej fosforanem (PBS).
UWAGA: Podczas pracy z komórkami należy zachować czystość otoczenia w celu utrzymania sterylności.
2. Obsługa komórek
UWAGA: Szczegółowy protokół kriozachowywania mononuklearnych komórek krwi obwodowej (PBMC) z krwi ludzkiej znajduje się w 7.
- Rozmrażanie i liczenie komórek
- Wyjmij kriotubule z ciekłego azotu i rozmrażaj je w łaźni wodnej w temperaturze 37 °C przez 2 - 3 min, delikatnie odwracając probówki.
- Przenieś rozmrożone komórki do probówki stożkowej o pojemności 50 mL.
- Przepłucz kriotubulę 1 mL ciepłej, pełnej pożywki wzrostowej i dodaj ten roztwór kroplami do komórek w probówce (1st etap rozcieńczania).
- Powtarzaj rozcieńczanie 1:1, aż do osiągnięcia objętości 32 mL (łącznie 5 rozcieńczeń z odpowiednio 1, 2, 4, 8 i 16 mL ciepłej, pełnej pożywki wzrostowej). Dodawaj pożywkę kroplami, aby zminimalizować wytrząsanie komórek, lekko agitując probówkę stożkową.
- Odwiruj zawiesinę komórkową przez 5 min (300 x g, 20 °C) i usuń supernatant, delikatnie przechylając probówkę stożkową jednym płynnym ruchem.
- Resuspenduj komórki w 3 mL ciepłej, pełnej pożywki wzrostowej i przystąp do liczenia komórek.
- W celu liczenia zmieszaj 10 µL zawiesiny komórkowej z Trypan Blue (rozcieńczenie od 1:2 do 1:10 w zależności od gęstości zawiesiny komórkowej), aby odróżnić komórki żywe od martwych podczas liczenia. Komórki martwe lub uszkodzone będą miały kolor niebieski ze względu na pobranie barwnika, natomiast komórki żywe nie zostaną zabarwione.
UWAGA: Trypan Blue jest lekko cytotoksyczny, zabarwione komórki nie powinny być przechowywane dłużej niż przez 5 min. - Policz komórki za pomocą automatycznego licznika komórek lub komory liczbowej, wykorzystując 10 µL zabarwionego roztworu komórek.
- Przy użyciu ulepszonej komory Neubauera policz wszystkie komórki w czterech dużych kwadratach znajdujących się w narożnikach i zastosuj poniższe równanie, aby obliczyć stężenie zawiesiny komórkowej.
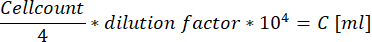
- Przy użyciu ulepszonej komory Neubauera policz wszystkie komórki w czterech dużych kwadratach znajdujących się w narożnikach i zastosuj poniższe równanie, aby obliczyć stężenie zawiesiny komórkowej.
- Rozcieńcz komórki do końcowego stężenia 1 x 10⁶ komórek/mL za pomocą ciepłej, pełnej pożywki wzrostowej. Odwiruj tylko wtedy, gdy wymagana objętość jest mniejsza niż 3 mL, a następnie resuspenduj osad komórkowy do odpowiedniej objętości.
- Wysiew i traktowanie komórek
- Wysiej 100 µL zawiesiny komórkowej na dołek w 96-dołkowej płytce do hodowli komórek (1 x 10⁵ komórek / dołek).
UWAGA: Liczba komórek do wysiewu została zoptymalizowana dla kultur PBMC. Podczas gdy niskie stężenia komórek nie dostarczą wystarczającej ilości RNA do sekwencjonowania, nadmierna liczba komórek zwiększy ryzyko suboptimalnej lizy komórek i inhibicji reakcji odwrotnej transkrypcji. - Przygotuj rozcieńczenia leku o stężeniu dwukrotnie większym niż stężenie stosowane podczas traktowania (2x). Wybierz rozpuszczalnik zgodnie z rozpuszczalnością związku, najlepiej pełną pożywkę wzrostową.
UWAGA: Można stosować PBS lub dimetylosulfotlenek (DMSO), jeśli w inny sposób nie uda się osiągnąć wystarczającej rozpuszczalności. Maksymalne stężenie DMSO w końcowej objętości inkubacji nie powinno przekraczać 0,5 %, aby zapobiec cytotoksyczności indukowanej przez rozpuszczalnik. - Dodaj 100 µL 2-krotnego rozcieńczenia leku (stężenie końcowe w dołku 1X) i inkubuj w 37 °C przez określony czas.
UWAGA: Należy przeprowadzić badania uzupełniające w celu ustalenia optymalnego czasu inkubacji leku i wykluczenia potencjalnych mechanizmów cytotoksyczności.
- Wysiej 100 µL zawiesiny komórkowej na dołek w 96-dołkowej płytce do hodowli komórek (1 x 10⁵ komórek / dołek).
- Zbiór i liza komórek
- Odwiruj płytkę do hodowli komórek przez 10 min (300 x g, 20 °C). Delikatnie usuń supernatant za pomocą pompy próżniowej, trzymając płytkę pod kątem (30°-45°) i kierując końcówkę w stronę dolnego narożnika dołka, aby usunąć jak najmniej komórek.
- Przemyj komórki, dodając 200 µL lodowatego PBS do każdego dołka i odwiruj płytkę przez 5 min (300 x g, 4 °C). Usuń supernatant za pomocą pompy próżniowej, ponownie trzymając płytkę pod dużym kątem, aby usunąć jak najwięcej PBS.
- Przygotuj bufor do lizy zgodnie z opisem w Tabeli 1 dla wymaganej liczby reakcji (rxn), dodając 10% zapasu.
- Dodaj 15 µL buforu do lizy do każdego dołka i szczelnie zamknij płytkę folią uszczelniającą, aby chronić próbki przed kontaminacją. Wymieszaj płytkę w wortexie przed odwirowaniem przez 1 min (1000 x g, 4 °C) i inkubuj przez 5 min na lodzie.
- Zabierz 6 µL roztworu lizowanych komórek do płytki PCR i krótko zamroź lizat komórkowy w -80 °C, aby zapewnić optymalną lizę komórek. Pamiętaj, aby unikać wielokrotnych cykli zamrażania płytek.
UWAGA: PUNKT ZATRZYMANIA: Jeśli produkcja cDNA nie jest przeprowadzana bezpośrednio po tym etapie, lizat komórkowy można przechowywać w -80 °C przez kilka miesięcy bez znacznego spadku jakości RNA.
3. Przygotowanie biblioteki do sekwencjonowania
- Reakcja odwrotnej transkrypcji (RT)
UWAGA: Podczas pracy z RNA wszystkie próbki należy trzymać na lodzie i używać sprzętu wolnego od nukleaz (sterylnych, jednorazowych wyrobów plastikowych) oraz wody wolnej od nukleaz.- Przygotować mieszaninę do reakcji RT zgodnie z Tabelą 2 dla wymaganej liczby reakcji, doliczając 10% nadmiaru. Krótko wymieszać mieszaninę wirówkami (vortex) i krótko odwirCować. Mieszaninę przechowywać na lodzie do momentu użycia.
- Rozmrozić lizat komórkowy w temperaturze pokojowej (RT) i krótko odwirować, aby zebrać cały lizat na dnie płytki.
- Przeprowadzić denaturację mRNA w termocyklerze zgodnie z Tabelą 3.
- Wyjąć płytkę z termocyklera i krótko odwirować, aby zebrać potencjalny kondensat. Do każdej studni dodać 6 µL mieszaniny do reakcji RT, tak aby uzyskać końcową objętość 12 µL. Zamknąć płytkę, aby ją zabezpieczyć i uniknąć parowania, wymieszać wirówką i odwirować.
- Umieścić płytkę w termocyklerze i uruchomić program reakcji RT zgodnie z Tabelą 3.
- Preamplifikacja
- Rozmrozić polimerazę DNA o wysokiej wierności oraz starter do PCR in-situ (ISPCR) w temperaturze pokojowej.
- Przygotować mieszaninę do preamplifikacji zgodnie z Tabelą 4 dla wymaganej liczby reakcji, doliczając 10% nadmiaru. Krótko wymieszać mieszaninę wirówkami i odwirować.
UWAGA: Mieszanina enzymatyczna jest stabilna w temperaturze pokojowej przez kilka godzin. - Odwirować płytkę PCR, dodać 15 µL mieszaniny do preamplifikacji do każdej studni i zamknąć płytkę.
- Umieścić ją w termocyklerze i uruchomić reakcję preamplifikacji zgodnie z Tabelą 5.
- Dostosować liczbę cykli do zawartości RNA. Zacząć od mniejszej liczby i zwiększać ją, jeśli wydajność cDNA jest niewystarczająca.
UWAGA: Z naszego doświadczenia wynika, że optymalną liczbę cykli należy ustalić dla każdego typu komórek; warunki eksperymentalne i traktowanie nie wpływają na optymalną liczbę cykli. Dlatego zalecamy eksperymentalne ustalenie optymalnej liczby cykli przy wdrażaniu tego protokołu dla nowego typu komórek. Generalnie komórki pierwotne wymagają większej liczby cykli w porównaniu do linii komórkowych. PUNKT ZATRZYMANIA: Produkt preamplifikacji można przechowywać w temperaturze - 20 °C.
- Dostosować liczbę cykli do zawartości RNA. Zacząć od mniejszej liczby i zwiększać ją, jeśli wydajność cDNA jest niewystarczająca.
- Oczyszczanie cDNA i kontrola jakości (QC)
UWAGA: Oczyszczanie próbek można przeprowadzać sekwencyjnie dla każdej płytki, ponieważ próbki są na tym etapie dość stabilne. Zwiększenie liczby próbek wydłuży czas trwania protokołu, ale nie ograniczy liczby próbek, które można przetwarzać jednocześnie.- Przed rozpoczęciem doprowadzić magnetyczne kulki do oczyszczania do temperatury pokojowej i mieszać w wirówce z wysoką prędkością przez 1 min, aby w pełni resuspendować kulki.
- Dodać 0,8x v/v (20 µL) magnetycznych kulek do oczyszczania do każdej studni i inkubować w temperaturze pokojowej przez 5 min.
- Umieścić płytkę PCR na statywie magnetycznym na 5 min, aż kulki zostaną całkowicie oddzielone. Ostrożnie usunąć supernatant.
- Trzymając płytkę na statywie magnetycznym, delikatnie dodać 100 µL świeżo przygotowanego 80% etanolu w celu przemycia kulek i inkubować przez 30 s. Użyć pipety o małej objętości do usunięcia supernatantu. Powtórzyć krok dla dodatkowego etapu płukania. Należy upewnić się, że usunięto jak najwięcej etanolu.
- Suszyć kulki na powietrzu na statywie magnetycznym w temperaturze pokojowej do 5 min, aż etanol całkowicie odparuje, a kulki przestaną być błyszczące.
- Zdjąć płytkę ze statywu magnetycznego, resuspendować kulki w 20 µL wody wolnej od nukleaz i inkubować przez 2 min.
- Ponownie umieścić płytkę na statywie magnetycznym, aż kulki się oddzielą.
- Przenieść eluat do nowej płytki PCR w celu kontroli jakości cDNA i tagmentacji.
- Przeprowadzić analizę za pomocą TapeStation lub FragmentAnalyser, aby ocenić rozkład wielkości i stężenie biblioteki cDNA (Zalecany test: TapeStation D5000). Szczegóły znajdują się w instrukcjach producenta. Przewidywana typowa wydajność to 20 ng.
- Tagmentacja z użyciem zestawu
UWAGA: Jeśli istnieją już opracowane inne protokoły tagmentacji, można ich użyć.- Rozcieńczyć cDNA do końcowego stężenia 150 - 300 pg/µL, używając wody wolnej od nukleaz.
- Zaprogramować termocykler zgodnie z Tabelą 6, aby zapewnić natychmiastowy start reakcji tagmentacji po dodaniu cDNA do mieszaniny enzymatycznej.
- Przygotować mieszaninę do tagmentacji zgodnie z Tabelą 7 dla wymaganej liczby reakcji, doliczając 10% nadmiaru.
- Napiować 3 µL mieszaniny do tagmentacji na jedną reakcję do nowej płytki PCR i dodać 1 µL cDNA do każdej reakcji.
- Uruchomić reakcję tagmentacji natychmiast po dodaniu cDNA.
- Dezaktywować reakcję, dodając 1 µL buforu neutralizującego tagment (NT; alternatywnie można użyć 0,2% dodecylu siarczanu sodu (SDS)).
- PCR wzbogacający
- Przygotować mieszaninę do PCR wzbogacającego zgodnie z Tabelą 7 dla odpowiedniej liczby reakcji, doliczając 10% nadmiaru. (Zalecany: zestaw Nextera UDI w celu zapobiegania zjawisku index hopping na przepływach wzorowanych (np. Illumina NovaSeq 6000)).
- Dodać 9 µL mieszaniny do PCR wzbogacającego do każdej reakcji, aby uzyskać całkowitą objętość 14 µL.
- Uruchomić program PCR wzbogacający zgodnie z Tabelą 8.
UWAGA: Standardowo w przypadku PCR wzbogacającego stosuje się 16 cykli. Jeśli jakość cDNA jest słaba, można dodać dodatkowe cykle.
- Oczyszczanie i kontrola jakości (QC)
- Przed rozpoczęciem doprowadzić magnetyczne kulki do oczyszczania do temperatury pokojowej i mieszać w wirówce z wysoką prędkością przez 1 min, aby w pełni resuspendować kulki.
- Dodać 1,0x v/v (14 µL) magnetycznych kulek do oczyszczania i inkubować w temperaturze pokojowej przez 5 min.
- Umieścić płytkę na statywie magnetycznym i odczekać 5 min, aż kulki zostaną całkowicie oddzielone. Ostrożnie usunąć supernatant.
- Trzymając płytkę na statywie magnetycznym, delikatnie dodać 100 µL świeżo przygotowanego 80% etanolu w celu przemycia kulek i inkubować przez 30 s. Użyć pipety o małej objętości do usunięcia supernatantu. Powtórzyć krok dla dodatkowego etapu płukania. Należy upewnić się, że usunięto jak najwięcej etanolu.
- Suszyć kulki na powietrzu w temperaturze pokojowej przez 3 min lub do momentu, gdy przestaną być błyszczące.
- Zdjąć płytkę ze statywu magnetycznego, resuspendować kulki w 20 µL wody wolnej od nukleaz i inkubować przez 2 min.
- Ponownie umieścić płytkę na statywie magnetycznym, aż kulki się oddzielą, i przenieść eluat do nowej płytki PCR w celu kontroli jakości biblioteki.
- Przeprowadzić analizę za pomocą TapeStation lub Fragment Analyzer, aby ocenić rozkład wielkości i stężenie biblioteki cDNA (Zalecany test: TapeStation D1000 high-sensitivity). Szczegóły znajdują się w instrukcjach producenta. Średnio spodziewana wydajność wynosi 10 ng.
UWAGA: PUNKT ZATRZYMANIA: Produkt PCR można przechowywać w temperaturze - 20 °C.
4. Sekwencjonowanie i wstępne przetwarzanie danych
- Sekwencjonowanie
UWAGA: Poniższe wytyczne mają zastosowanie do wszystkich instrumentów Illumina do sekwencjonowania krótkich odczytów. W przypadku braku dostępności aparatury, sekwencjonowanie można zlecić zewnętrznemu ośrodkowi sekwencjonowania. Można również zastosować inne podejścia do sekwencjonowania. Dla uproszczenia zdecydowano się opisać wyłącznie najszerzej stosowaną technologię sekwencjonowania.
UWAGA: Poniższe kroki dotyczące obsługi oprogramowania opisują procedurę na sekwenatorze Illumina NovaSeq 6000.- Połącz biblioteki z unikalnymi indeksami w stosunku ekimolarnym, zgodnie z wynikami uzyskanymi w kroku 3.6.8.
- Zmierz stężenie końcowej puli za pomocą wysokoczułego testu, aby obliczyć molarność próbki w następujący sposób:
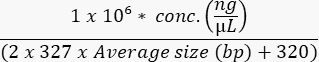
- Należy załadować komórkę przepływową zgodnie ze specyfikacją urządzenia oraz optymalizacją eksperymentalną. Przykłady stężeń ładowania dla powszechnie stosowanych urządzeń przedstawiono w Tabela 9.
- Dotknij ekranu, aby wybrać Sekwencja w celu rozpoczęcia konfiguracji przebiegu.
- Postępuj zgodnie z instrukcjami wyświetlanymi na ekranie i umieść w urządzeniu ogniwo przepływowe, kartridż do sekwencjonowania przez syntezę, kartridż do klastrowania oraz kartridż z buforem, a następnie upewnij się, że pojemniki na odpady są puste.
- Po rozpoznaniu przez instrument wszystkich odczynników należy kliknąć Konfiguracja uruchomieniaZdefiniuj tutaj nazwę uruchomienia oraz folder wyjściowy do przechowywania danych.
- Zdefiniuj szczegóły sekwencjonowania jako sekwencjonowanie par końców (paired-end), w którym oba odczyty mają długość 51 bp. Sekwencjonowane są również dwa odczyty indeksów, każdy o długości 8 bp.
- Naciśnij Przegląd a po sprawdzeniu poprawności wszystkich szczegółów sekwencjonowania należy nacisnąć Rozpocznij przebieg.
UWAGA: Zalecana głębokość sekwencjonowania wynosi 5 x 10⁶ odczytów/próbkę, z minimum 1 x 10⁶ odczyty/próbka.
- Wstępne przetwarzanie danych
- Przekształć surowe dane z sekwencjonowania do formatu FASTQ i przeprowadź demultipleksację zgodnie z indeksami próbek przy użyciu narzędzia Bcl2Fastq2. Przeprowadź demultipleksację przy użyciu ustawień domyślnych. Szczegółowe instrukcje dotyczące Bcl2Fastq2 znajdują się w podręczniku referencyjnym.
UWAGA: Konwersja do formatu FASTQ oraz demultipleksowanie są zazwyczaj wykonywane przez ośrodek sekwencjonowania, jeśli sekwencjonowanie nie jest przeprowadzane wewnątrz jednostki. Ośrodki sekwencjonowania zazwyczaj dostarczają zdemultipleksowane pliki FASTQ do dalszej analizy. - Dostępnych jest kilka opcji dopasowania danych i kwantyfikacji obfitości odczytów sekwencjonowania (zalecany: rurociąg nf-core RNA-seq (https://nf-co.re/rnaseq)). Rurociąg ten oferuje kilka opcji; należy zastosować ustawienia domyślne z programem STAR.8 zgodnie z dopasowaniem i Salmon9 w celu ilościowego oznaczenia poziomu transkrypcji.
- UWAGA: Do dalszych analiz bioinformatycznych dostępnych jest kilka metod. Poza zakresem niniejszego protokołu znajduje się opisanie wszystkich z nich (zalecany: potok DEseq2)10). Standardowy skrypt oparty na opracowanym przez nas przepływie pracy DEseq2 znajduje się w serwisie GitHub (https://github.com/jsschrepping/RNA-DESeq2).
- Przekształć surowe dane z sekwencjonowania do formatu FASTQ i przeprowadź demultipleksację zgodnie z indeksami próbek przy użyciu narzędzia Bcl2Fastq2. Przeprowadź demultipleksację przy użyciu ustawień domyślnych. Szczegółowe instrukcje dotyczące Bcl2Fastq2 znajdują się w podręczniku referencyjnym.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Zgodnie z opisanym protokołem, ludzkie PBMC wysiano, poddano działaniu różnych leków immunomodulujących, a po różnych czasach inkubacji zebrano do analizy transkryptomicznej typu bulk, stosując protokół sekwencjonowania (Rycina 1).
Optymalne stężenia leków i czasy inkubacji dla testowanych związków powinny zostać określone przed rozpoczęciem niniejszego protokołu przy użyciu uzupełniających strategii eksperymentalnych i w oparciu o konkretne pytanie badawcze. W wi...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Odkrywanie i opracowywanie leków może przynieść ogromne korzyści z holistycznego spojrzenia na procesy komórkowe, które może zapewnić transkryptomika masowa. Niemniej jednak podejście to jest często ograniczone przez wysokie koszty eksperymentu ze standardowym protokołem masowego sekwencjonowania RNA, co uniemożliwia jego zastosowanie w środowisku akademickim, a także jego potencjał skalowalności przemysłowej.
Najbardziej krytycznymi etapami protokołu są rozmrażanie komórek i początkowe etapy ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy deklarują brak sprzecznych interesów.
Podziękowania
J.L.S. jest wspierany przez Niemiecką Fundację Badawczą (DFG) w ramach Niemieckiej Strategii Doskonałości (EXC2151-390873048), a także w ramach SCHU 950/8-1; GRK 2168, TP11; CRC SFB 1454 Metaflammacja, IRTG GRK 2168, WGGC INST 216/981-1, CCU INST 217/988-1, finansowany przez BMBF projekt doskonałości Dieta-Ciało-Mózg (DietBB); oraz projekt unijny SYSCID w ramach grantu nr 733100. M.B. jest obsługiwany przez DFG (IRTG2168-272482170, SFB1454-432325352). L.B. jest wspierany przez DFG (ImmuDiet BO 6228/2-1 - Numer projektu 513977171) oraz niemiecką strategię doskonałości (EXC2151-390873048). Obrazy utworzone za pomocą BioRender.com.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Rurka stożkowa 50 ml | Fisher Scientific | 10203001 | |
| Samoprzylepne uszczelki płytkowe do PCR | Thermo Fisher Scientific | AB0558 | |
| Amplicon Tagment Mix (ATM) | Illumina | FC-131-1096 | Nextera XT Zestaw do przygotowania biblioteki DNA (96 próbek) |
| Koraliki AMPure XP | Beckman Coulter | A 63881 | |
| Betaina | Sigma-Aldrich | 61962 | |
| Płytki 96-dołkowe do hodowli komórkowych | Thermo Fisher Scientific | 260860 | |
| Pompa próżniowa do hodowli komórkowych (VACUSAFE) | Integra Bioscience | 158300 | |
| Trifosforany deoksynukleotydów (dNTP) mieszają się po 10 mM każdy | Fermentas | R0192 | |
| DMSO | Sigma-Aldrich | 276855 | |
| DTT (100 mM) | Invitrogen | 18064-014 | |
| EDTA | Sigma-Aldrich | 798681 | do komórek adherentnych |
| Etanol | Sigma-Aldrich | 51976 | |
| Surowica bydlęca | płodu Thermo Fisher Scientific | 26140079 | |
| Końcówki filtrujące (10 &mikro; L) | Gilson | ||
| Końcówki filtrujące (100 &mikro; L) | Gilson | ||
| Końcówki filtrujące (20 &mikro; L) | Gilson | ||
| Końcówki filtrujące (200 &mikro; L) | Gilson | ||
| Chlorowodorek guanidyny | Sigma-Aldrich | G3272 | |
| Starter ISPCR (10 &mikro; M) | Biomers.net GmbH | SP10006 | 5′-AAGCAGTGGTATCAACGCAGAG T-3′ |
| KAPA HiFi HotStart ReadyMix (2X) | KAPA Biosystems | KK2601 | |
| Chlorek magnezu (MgCl2) | Sigma-Aldrich | M8266 | |
| Podstawka magnetyczna 96 | Ambion | AM10027 | |
| Neutralize Tagment (NT) Buffer | Illumina | FC-131-1096 | Zestaw do przygotowania biblioteki DNA Nextera XT (96 próbek), alternatywnie 0,2 % SDS |
| Starter indeksujący kompatybilny z Nextera | Illumina | ||
| Woda wolna od nukleaz | Invitrogen | 10977049 | |
| PBS | Thermo Fisher Scientific | AM9624 | |
| PCR 96-dołkowe płytki | Thermo Fisher Scientific | AB0600 | |
| Zgrzewarka do płytek PCR | Thermo Fisher Scientific | HSF0031 | |
| Penicylina / Streptomycyna | Termo Fisher Scientific | 15070063 | |
| Fluorometr Qubit 4 | Invitrogen | 15723679 | |
| Rekombinowany inhibitor RNazy (40 U/ul) | Pożywka do hodowli komórkowych TAKARA | 2313A | |
| RPMI-1640 | Gibco | 61870036 | Jeśli nie działa z PBMC, dostosuj do typu komórki |
| Starter SMART dT30VN | Sigma-Aldrich | 5' Bio-AAGCAGTGGTATCAACGCAGAG TACT30VN-3 | |
| Standardowe wyposażenie laboratoryjne | różne | np | . wirówka, maszyna do lodu, wiadro na lód, woda destylowana, łaźnia wodna |
| SuperScript II Odwrotna transkryptaza (SSRT II) | Thermo Fisher Scientific | 18064-014 | |
| SuperScript II Bufor odwrotnej transkryptazy (SSRT II) (5x) | Thermo Fisher Scientific | 18064-014 | |
| Tagment DNA Buffer (TD) | Illumina | FC-131-1096 | Nextera XT Zestaw do przygotowania biblioteki DNA (96 próbek) |
| System TapeStation 4200 | Agilent | G2991BA | |
| Thermocycler (S1000) | Bio-Rad | 1852148 | |
| TSO-LNA (100 uM) | Eurogentec | 5' Biotyna AAGCAGTGGTATCAACGCAGAG TACAT(G)(G){G | |
| Vortex-Genie 2 Mixer | Sigma-Aldrich | Z258415 |
Bibliografia
- Hughes, J. P., Rees, S., Kalindjian, S. B., Philpott, K. L. Principles of early drug discovery. Br J Pharmacol. 162 (6), 1239-1249 (2011).
- Yang, X., et al. High-throughput transcriptome profiling in drug and biomarker discovery. Front Genet. 11, 19(2020).
- Bonaguro, L., et al. A guide to systems-level immunomics. Nat Immunol. 23 (10), 1412-1423 (2022).
- Carraro, C., et al. Decoding mechanism of action and sensitivity to drug candidates from integrated transcriptome and chromatin state. ELife. 11, 78012(2022).
- Picelli, S., et al. Smart-seq2 for sensitive full-length transcriptome profiling in single cells. Nat Methods. 10 (11), 1096-1098 (2013).
- Picelli, S., et al. Full-length RNA-seq from single cells using Smart-seq2. Nat Protoc. 9 (1), 171-181 (2014).
- De Domenico, E., et al. Optimized workflow for single-cell transcriptomics on infectious diseases including COVID-19. STAR Protoc. 1 (3), 100233(2020).
- Dobin, A., et al. ultrafast universal RNA-seq aligner. Bioinformatics. 29 (1), 15-21 (2013).
- Patro, R., et al. Salmon provides fast and bias-aware quantification of transcript expression. Nat Methods. 14 (4), 417-419 (2017).
- Love, M. I., Huber, W., Anders, S. Moderated estimation of fold change and dispersion for RNA-seq data with DESeq2. Genome Biol. 15 (12), 550(2014).
- Frankish, A., et al. GENCODE reference annotation for the human and mouse genomes. Nucleic Acids Res. 47, D766-D773 (2019).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
Przeglądaj więcej artykułów
Transkryptomiczne przesiewanie lekówminiaturyzowana transkryptomika (mini-bulk)kosztowo efektywne sekwencjonowanieprzesiewanie leków na PBMCpłytka do hodowli komórkowejodwrotna transkrypcjaoczyszczanie za pomocą kulek magnetycznychreakcja tagmentacjiPCR wzbogacającyprzygotowanie biblioteki do sekwencjonowania
