To badanie miało na celu porównanie L1-L2-angielskiego i L1-L2 portugalskiego, aby sprawdzić, jak bardzo wpływ obcego akcentu wpływa zarówno na metryki, jak i parametry prozodowo-akustyczne, a także na wybór docelowego głosu w zestawie głosowym.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Obcy akcent i kryminalistyczna identyfikacja mówcy w składach głosowych: wpływ cech akustycznych na podstawie prozodii
W tym artykule
Podsumowanie
Streszczenie
To badanie ma na celu zbadanie zarówno cech prozodyczno-akustycznych, jak i percepcyjnych korelatów angielskiego z obcym akcentem i brazylijskiego portugalskiego z obcym akcentem oraz sprawdzenie, jak produkcja obcych i rodzimych akcentów przez mówców jest skorelowana z percepcją słuchaczy. W ramach Metodyki przeprowadziliśmy procedurę produkcji mowy z grupą Amerykanów posługujących się L2 (brazylijski portugalski) oraz grupą Brazylijczyków (L2 English), a także procedurę percepcji mowy, w której wykonaliśmy składy głosowe dla obu języków. Na potrzeby analizy statystycznej produkcji mowy przeprowadziliśmy uogólnione modele addytywne, aby ocenić wpływ grup językowych na każdą klasę (metryczną lub prozodyczno-akustyczną) cech kontrolowanych pod kątem efektu wygładzania współzmiennych przeciwnej klasy. Na potrzeby analizy statystycznej percepcji mowy przeprowadziliśmy test Kruskala-Wallisa oraz test Dunna post hoc, aby ocenić wpływ głosów składów na wyniki oceniane przez słuchaczy. Przeprowadziliśmy jednak testy podobieństwa akustycznego (głosowego) w oparciu o odległości cosinusowe i euklidesowe. Wyniki wykazały istotne różnice akustyczne między grupami językowymi pod względem zmienności f0, czasu trwania i jakości głosu. W przypadku składów wyniki wykazały, że cechy prozodyczne f0, intensywności i jakości głosu korelowały z postrzeganymi ocenami słuchaczy.
Wprowadzenie
Akcent jest istotnym i dynamicznym aspektem komunikacji i płynności, zarówno w języku ojczystym (L1), jak i w języku obcym (L2)1. Akcent obcy reprezentuje cechy fonetyczne L2 języka docelowego i może się zmieniać (w czasie) w odpowiedzi na doświadczenie mówcy w L2, styl mówienia, jakość danych wejściowych, ekspozycję i inne zmienne. Akcent obcy można określić ilościowo jako (skalarny) stopień różnicy między mową L2 wytwarzaną przez obcokrajowca a akcentem lokalnym lub referencyjnym języka docelowego2,3,4,5.
To badanie ma na celu zbadanie zarówno cech prozodyczno-akustycznych, jak i percepcyjnych korelatów angielskiego z obcym akcentem i brazylijskiego portugalskiego (BP), a także sprawdzenie, w jakim stopniu produkcja obcych i rodzimych akcentów przez użytkowników jest skorelowana z percepcją słuchaczy. Wcześniejsze badania w dziedzinie kryminalistyki wykazały, że samogłoski i spółgłoski w identyfikacji obcego akcentu są albo stabilne w długoterminowej analizie danej osoby (The Lo Case6) lub odnoszą się do wysokiej dokładności ID osoby mówiącej (The Lindbergh Case7). Jednak eksploracja cech prozodowo-akustycznych w oparciu o czas trwania, częstotliwość podstawową (f0, tj. akustyczny korelat wysokości dźwięku), intensywność i jakość głosu (VQ) zyskuje coraz większą uwagę8,9. W związku z tym wybór cech prozodowo-akustycznych w tym badaniu stanowi obiecującą drogę w dziedzinie fonetyki sądowej8,10,11,12,13.
Obecne badania są wspierane przez badania poświęcone obcym akcentom jako formie maskowania głosu w sprawach kryminalistycznych14,15, a także w przygotowaniu składów głosowych do rozpoznawania mówcy16,17. Na przykład szybkość mowy odegrała ważną rolę w identyfikacji niemieckich, włoskich, japońskich i brazylijskich użytkowników języka angielskiego18,19,20,21,22. Oprócz szybkości mowy, długoterminowe funkcje spektralne i f0 stanowią wyzwanie dla biegłych użytkowników L2 w zakresie znajomości języka docelowego, ponieważ mózg i podstawy poznawcze cierpią na deficyt pamięci, uwagi i emocji, co odbija się na wydajności fonetycznej mówcy podczas długich zwrotów mowy23. Pogląd na temat obcych akcentów w dziedzinie kryminalistyki jest taki, że definicja tego, co naprawdę brzmi jak obcy akcent, zależy w dużej mierze od nieznajomości słuchacza, a nie od zerowego do skrajnego stopnia mowy z obcym akcentem24.
W dziedzinie percepcyjnej, powszechnym narzędziem kryminalistycznym używanym od połowy lat 90. do rozpoznawania przestępców jest Voice Lineup (rozpoznawanie słuchowe), które jest analogiczne do rozpoznawania wizualnego używanego do identyfikacji sprawcy na miejscu zbrodni16,25. W zestawieniu głosowym głos podejrzanego jest prezentowany wraz z kontrastami – głosami podobnymi w aspektach socjolingwistycznych, takich jak wiek, płeć, położenie geograficzne, dialekt i status kulturowy – w celu identyfikacji przez naocznego świadka. Powodzenie lub niepowodzenie składu głosowego będzie zależało od liczby próbek głosu i czasu trwania próbki25,26. Ponadto w przypadku próbek ze świata rzeczywistego uważa się, że jakość dźwięku konsekwentnie wpływa na dokładność rozpoznawania głosu. Niska jakość dźwięku może zniekształcić unikalne cechy głosu27. W przypadku podobieństwa głosu, drobne szczegóły fonetyczne oparte na f0 mogą zmylić słuchacza podczas rozpoznawania głosu28,29. Takie cechy akustyczne wykraczają poza f0 i obejmują elementy czasu trwania oraz cechy spektralne intensywności i VQ30. To spojrzenie na wiele cech prozodycznych ma kluczowe znaczenie w kontekście porównywania głosu w kryminalistyce, aby zapewnić dokładną identyfikację mówcy9,14,15,29,31.
Podsumowując, badania nad fonetyką kryminalistyczną wykazały pewne różnice w zakresie identyfikacji obcego akcentu w ciągu ostatnich dziesięcioleci. Z jednej strony, obcy akcent nie wydaje się wpływać na proces identyfikacji mówcy32,33 (zwłaszcza jeśli mówca nie jest zaznajomiony z docelowym obcym akcentem34). Z drugiej strony istnieją wyniki w przeciwnym kierunku12,34,35.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Praca ta uzyskała zatwierdzenie komisji etyki badań z udziałem ludzi. Ponadto od wszystkich uczestników zaangażowanych w niniejsze badanie uzyskano świadomą zgodę na wykorzystanie i publikację ich danych.
1. Produkcja mowy
UWAGA: Zebraliśmy mowę z zadania czytania zarówno dla „L1 English-L2 BP” wygenerowanej przez Grupę 1: Amerykańskich mówców języka angielskiego (z USA) (AmE-S), jak i dla „L1 BP-L2 English” wygenerowanej przez Grupę 2: Brazylijskich mówców (Bra-S). Schemat blokowy produkcji mowy przedstawiono na Rysunku 1.

Rysunek 1Schematyczny blokowy przebieg procesu produkcji mowy. Proszę kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
- Uczestnicy
- Wyznacz liczbę uczestników, język (L1 angielski, L2 BP; L1 BP, L2 angielski), płeć (żeńska lub męska), wiek (średnia, odchylenie standardowe), charakterystykę grupy (specjaliści lub studenci studiów licencjackich) oraz poziom biegłości w języku L2 (zaawansowany lub bardzo zaawansowany) dla każdej grupy.
UWAGA: W niniejszym badaniu zarówno grupę AmE-S, jak i Bra-S uznano za biegłe w L2 (obie grupy zakwalifikowano na poziomach B2-C136). Osoby z grupy AmE-S mieszkały w Brazylii przez dwa lata w momencie przeprowadzania procedur. Osoby z grupy Bra-S mieszkały w USA ponad dwa lata w momencie przeprowadzania procedur. Podczas pobytu za granicą obie grupy posługiwały się językiem L2 w celach edukacyjnych i zawodowych co najmniej 6 dni w tygodniu przez ok. 4-5 h dziennie. - Zakwateruj uczestników w wygodnym i cichym pomieszczeniu i przedstaw materiał do czytania dla każdej grupy.
- Wyznacz liczbę uczestników, język (L1 angielski, L2 BP; L1 BP, L2 angielski), płeć (żeńska lub męska), wiek (średnia, odchylenie standardowe), charakterystykę grupy (specjaliści lub studenci studiów licencjackich) oraz poziom biegłości w języku L2 (zaawansowany lub bardzo zaawansowany) dla każdej grupy.
- Gromadzenie danych
UWAGA: Dane mowy muszą zostać zebrane podczas zadania czytania w następujących językach: L1-angielski i L2-BP oraz L1-BP i L2-angielski. W razie potrzeby pozwól uczestnikom zapoznać się z tekstami wcześniej.- Procedury nagrywania
- Nagraj dane mowy w cichym miejscu o odpowiednich warunkach akustycznych.
- Użyj cyfrowego rejestratora dźwięku (patrz Tabela materiałów)37 oraz jednokierunkowego, izolowanego elektromagnetycznie mikrofonu kardioidalnego (patrz Tabela materiałów)38.
- Nagraj dane audio w formacie '.wav'.
- Ustaw częstotliwość próbkowania na 48 kHz oraz rozdzielczość kwantyzacji na 16 bitów.
UWAGA: Format audio oraz konfiguracja częstotliwości próbkowania i kwantyzacji opisane w krokach 1.2.1.3 i 1.2.1.4 są stosowane w celu zapewnienia wysokiej jakości i redukcji szumów, aby zachować cechy spektralne wykorzystywane w późniejszej analizie akustycznej.
- Procedury nagrywania
- Analiza akustyczna
UWAGA: Podziel procedury analizy akustycznej na trzy etapy: wymuszone wyrównanie (forced-alignment), ponowne wyrównanie (realignment) oraz ekstrakcję cech akustycznych.- Przygotuj transkrypcję lingwistyczną (w pliku '.txt') dla każdego pliku audio.
- Oznacz pary plików '.txt'/'.wav' taką samą nazwą (np. 'my_file.wav'/ 'my_file.txt').
UWAGA: Aby usprawnić działanie procedury opisanej w sekcji 1.3.7, wysoce zaleca się, aby pierwsze trzy znaki nazw plików '.txt/.wav' reprezentowały język, dialekt lub akcent, a czwarty do szóstego znaku oznaczały płeć (np. EL1FEM dla English L1 Female). Od siódmego znaku użytkownik powinien wskazać numer mówcy (np. 01 dla pierwszego mówcy). W związku z tym pierwsza para '.txt/.wav' to EL1FEM01. - Utwórz folder dla każdej pary języków L1-L2.
UWAGA: Folder dla L1-L2 angielski i folder dla L1-L2 BP. - Upewnij się, że wszystkie pary plików w tym samym języku znajdują się w tym samym folderze.
- Przeprowadź wymuszone wyrównanie (forced alignment).
- Wejdź w interfejs sieciowy narzędzia do wymuszonego wyrównania Munich Automatic Segmentation (MAUS) (webMAUS)39 pod adresem https://clarin.phonetik.uni-muenchen.de/BASWebServices/interface/Pipeline.
- Przeciągnij i upuść każdą parę plików .wav / .txt z folderu do przerywanego prostokąta w sekcji Files (lub kliknij wewnątrz prostokąta, Rysunek 2A).
- Kliknij przycisk Upload , aby przesłać pliki do wyrównywacza (patrz czerwona strzałka na Rysunku 2A).
- Wybierz następujące opcje w menu Service options (Rysunek 2B): G2P-MAUS-PHO2SYL dla Pipeline name; English (US) (dla Language) w przypadku danych L1-L2 angielskich; Italian (IT) (dla Language) w przypadku danych L1-L2 BP.
UWAGA: Wybraliśmy język włoski ('Italian') dla danych BP, ponieważ webMAUS nie oferuje wstępnie wytrenowanych modeli akustycznych dla wymuszonego wyrównania języka BP. Literatura fonetyczna wskazuje, że fonologia włoska posiada nieco porównywalny, symetryczny zestaw siedmiu samogłosek, podobnie jak BP40, a także podobieństwa akustyczne spółgłosek41,42. - Zachowaj domyślne opcje dla 'Output format' oraz 'Keep everything'.
- Zaznacz pole Run , aby zaakceptować warunki użytkowania (patrz zielona strzałka na Rysunku 2C).
- Kliknij przycisk Run Web Service, aby przetworzyć przesłane pliki w wyrównywaczu.
UWAGA: Dla każdego pliku audio wyrównywacz MAUS zwraca obiekt Praat TextGrid (plik '.txt' sformatowany dla programu Praat, zawierający adnotacje słów, sylab fonologicznych i fonemów na podstawie transkrypcji lingwistycznej wyekstrahowanej z pliku '.txt' opisanego w kroku 1.3.1). - Kliknij przycisk Download as ZIP-File, aby pobrać pliki TextGrid jako plik skompresowany (Rysunek 2C).
UWAGA: Upewnij się, że skompresowane pliki TextGrid zostały pobrane do tego samego folderu, w którym znajdują się pliki audio. - Wypakuj pliki TextGrid do późniejszego ponownego wyrównania w oprogramowaniu do analizy fonetycznej43.
- Przeprowadź ponowne wyrównanie (realignment).
- Znajdź i pobierz skrypt dla Praat VVUnitAligner4 ze strony https://github.com/leonidasjr/VVunitAlignerCode_webMAUS/blob/main/VVunitAligner.praat.
- Upewnij się, że wszystkie pary plików w tym samym języku oraz skrypt VVUnitAligner znajdują się w tym samym folderze.
UWAGA: Folder dla plików L1-L2 angielskich i VVunitAligner oraz folder dla plików L1-L2 BP i VVunitAligner. - Otwórz oprogramowanie do analizy fonetycznej.
- Kliknij Praat | Open Praat script…, aby wywołać skrypt z okna obiektów.
- Kliknij raz przycisk Run .
UWAGA: Na ekranie pojawi się formularz o nazwie Phonetic syllable alignment zawierający ustawienia do korzystania ze skryptu (Rysunek 3A). - Kliknij przycisk Language , aby wybrać język z listy: 'English (US),' 'Portuguese (BR),' 'French (FR)' lub 'Spanish (ES)'.
- Kliknij przycisk Chunk segmentation , aby wybrać procedurę segmentacji: 'Automatic,' 'Forced (manual)' lub 'None'.
- Zaznacz opcję Save TextGrid files , aby automatycznie zapisać nowe pliki TextGrid.
- Kliknij przyciski Ok | Run, aby przeprowadzić ponowne wyrównanie jednostek fonetycznych z kroku 1.3.5.7 .
UWAGA: Dla każdego pliku audio VVUnitAligner wygeneruje nowy plik TextGrid dla sekcji 1.3.7 (Rysunek 3B).
- Przeprowadź automatyczną ekstrakcję cech akustycznych.
- Znajdź i pobierz skrypt SpeechRhythmExtractor45 ze strony https://github.com/leonidasjr/SpeechRhythmCode/blob/main/SpeechRhythmExtractor.praat w celu automatycznej ekstrakcji cech prozodyczno-akustycznych.
- Utwórz nowy folder i umieść w nim skrypt SpeechRhythmExtractor wraz ze wszystkimi parami plików audio/TextGrid we wszystkich językach.
- Otwórz oprogramowanie do analizy fonetycznej.
- Kliknij Praat | Open Praat script…, aby wywołać skrypt z okna obiektów.
- Kliknij przycisk Run tylko raz.
UWAGA: Na ekranie pojawi się formularz z ustawieniami skryptu. W polach nazw wyjściowych plików '.txt' zmień nazwy plików w odpowiedni sposób lub pozostaw nazwy domyślne. - Zaznacz opcję voice quality parameters, aby zapisać Output file VQ dla jakości głosu (Rysunek 3C).
UWAGA: Ten drugi plik wyjściowy (Output file VQ) zawiera parametry różnicy między 1.szym a 2.gim harmonicznymi (H1-H2) oraz szczytową prominencję cepstralną (CPP)9. - Zaznacz opcję Linguistic target , aby wybrać etykietę 'Language,' 'Dialect' lub 'Accent' (Rysunek 3C).
- Zaznacz opcję Unit , aby wybrać cechy f0 w Hz lub w półtonach (Rysunek 3C).
- Wprowadź wartości dla F0 threshold, określając minimalny i maksymalny próg f0 (Rysunek 3C).
UWAGA: Jeśli badanie nie ma specyficznych celów lub wcześniej określonych cech audio, zdecydowanie zaleca się pozostawienie parametrów z kroku 1.3.7.9 z wartościami domyślnymi. - Kliknij Ok | Run, aby przeprowadzić automatyczną ekstrakcję cech akustycznych.
UWAGA: Skrypt SpeechRhythmExtractor zwraca plik '.txt' z rozdzielaczem tabulacyjnym (Output file/ Output file VQ) zawierający cechy akustyczne wyekstrahowane od mówców.
- Analiza statystyczna
- Wgraj arkusz zawierający cechy akustyczne do środowiska R46 (lub dowolnego wybranego oprogramowania/środowiska statystycznego).
- Przeprowadź nieparametryczną analizę statystyczną za pomocą uogólnionych modeli addytywnych (GAMs).
- Wykonaj GAMs w programie R.
- Wpisz następujące polecenia i naciśnij Enter.
library(mgcv)
model = gam(the metric/prosodic-acoustic feature in analysis ~ the Language + s(the chosen metric feature, by = the Language) + other metric/prosodic-acoustic features, data = the data frame)
UWAGA: Zdecydowaliśmy się przeprowadzić testy statystyczne protokołu w języku programowania R ze względu na jego rosnącą popularność wśród fonetyków (i lingwistów) w środowisku akademickim. R jest szeroko stosowany w badaniach terenowych z zakresu fonetyki47. Należy pamiętać, że krok 1.4.2.2 zawiera pseudokod. Napisz kod zgodnie ze zmiennymi badawczymi.

Rysunek 2Zrzut ekranu z dopasowania fonetycznego przy użyciu narzędzia do wymuszonego wyrównywania MAUS. (A) Przerywany prostokąt służy do przeciągania i upuszczania pliku 'my_file.wav'/' mój_plikProszę o dostarczenie tekstu źródłowego do tłumaczenia.pliki lub kliknięcie wewnątrz obszaru w celu wyszukania takich plików w folderze; przycisk przesyłania jest wskazany czerwoną strzałką. (B) Przesłane pliki z panelu A (patrz niebieska strzałka), potok do zastosowania, język dla par plików, format pliku do zwrócenia oraz przycisk „prawda/fałsz” w celu zachowania wszystkich plików. (C) pole wyboru Warunków użytkowania (patrz zielona strzałka), Uruchamianie usług sieciowych przycisk oraz wyniki (do pobrania pliki TextGrid). Aby wyświetlić powiększoną wersję tego rysunku, kliknij tutaj.
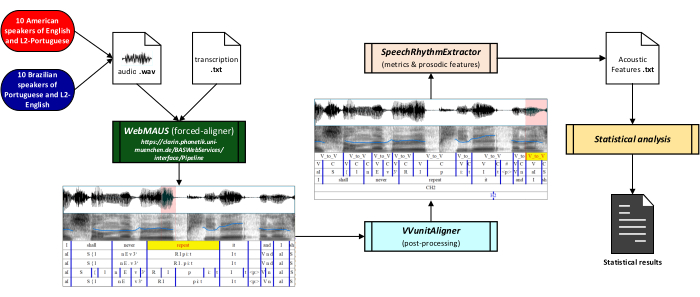
Rysunek 3Zrzut ekranu procedury ponownego wyrównania. (A) Formularz ustawień wejściowych dla procedury ponownego dopasowania. (B) Częściowy przebieg fali, spektrogram szerokopasmowy z konturem f0 (kolor niebieski) oraz sześć poziomów podzielonych na segmenty (i opisanych) jako poziom 1jednostki od początku samogłoski do początku kolejnej samogłoski (V_to_V); początek samogłoski (V_to_V); poziom 2jednostki samogłosek (V), spółgłosek (C) i pauz (#); poziom 3reprezentacje fonetyczne V_do_V; poziom 4kilka słów z tekstu; poziom 5: niektóre fragmenty (CH) mowy z tekstu; warstwa 6: warstwa tonalna zawierająca najwyższy (H) i najniższy (L) ton każdego fragmentu mowy wyprodukowanego przez kobietę posługującą się amerykańską odmianą języka angielskiego (AmE-S).C) Ustawienia wejściowe dla automatycznej ekstrakcji cech akustycznych. Kliknij tutaj, aby wyświetlić powiększoną wersję tej figury.
2. Percepcja mowy
UWAGA: Przeprowadziliśmy cztery próby rozpoznawania głosu w języku angielskim z udziałem słuchaczy z USA oraz cztery próby w BP z udziałem słuchaczy z Brazylii. Schemat blokowy percepcji mowy przedstawiono na Rysunku 4.
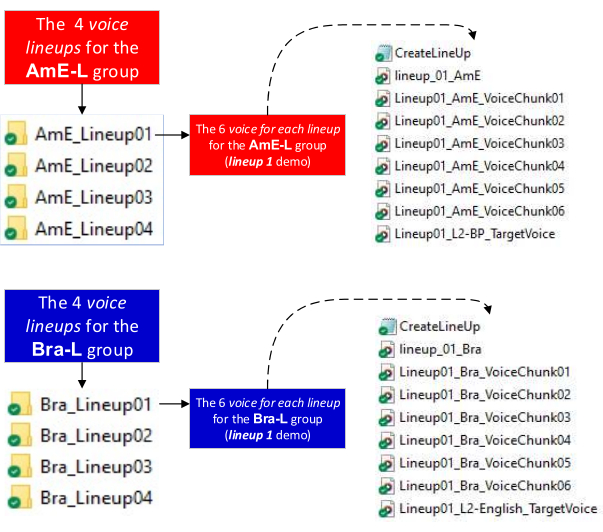
Rysunek 4Schematyczny przebieg procesu percepcji mowy. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
- Uczestnicy
- Dla każdej grupy należy wybrać innych uczestników niż ci, którzy brali udział w protokole produkcji mowy.
UWAGA: Do tej części protokołu wybrano dwie grupy uczestników: Grupa 1The Amamerykański Eangielski (z USA) Lsłuchaczy (AmE-L) oraz Grupa 2Wprowadzenie Brazilian Lsłuchaczy (Bra-L). W niniejszym badaniu zarówno osoby z grupy AmE-L, jak i Bra-L uznano za biegłe w języku L2 (obie grupy zakwalifikowano na poziomie B2-C1)36 Grupa AmE-L mieszkała w Brazylii przez dwa lata w momencie przeprowadzania procedur. Grupa Bra-L mieszkała w USA przez ponad dwa lata w momencie przeprowadzania procedur. Podczas pobytu za granicą obie grupy posługiwały się swoim językiem L2 w celach naukowych i zawodowych (przynajmniej sześć dni w tygodniu przez około 4 do 5 godzin dziennie). - Wyznaczyć liczba uczestników, the język (L1 angielski, L2 BP; L1 BP, L2 angielski), the płeć (żeński lub męski), the wiek (średnia, odchylenie standardowe), the charakterystyka grup (specjaliści lub studenci studiów licencjackich) oraz Poziom biegłości w drugim języku (L2) dla każdej grupy.
- Dla każdej grupy należy wybrać innych uczestników niż ci, którzy brali udział w protokole produkcji mowy.
- Ścieżki dźwiękowe
UWAGA: Podziel procedury dotyczące zestawów głosowych na dwa oddzielne etapy: przygotowanie i przeprowadzenie zestawów głosowych.- Przygotuj cztery zestawy próbek głosowych dla języka angielskiego i cztery dla BP.
- Pobierz pliki audio od prelegentów z sekcji 1: Produkcja mowy.
- Upewnij się, że pliki audio dla każdego czynnika językowego znajdują się w osobnych folderach.
- Wybierz losowo sześć fragmentów głosowych w języku angielskim (L1) lub w języku brazylijskim portugalskim (L1 BP).
UWAGA: Sześć głosów w zestawieniu reprezentuje jeden głos docelowy i pięć folii. - Wybierz fragment głosowy w języku angielskim jako drugim języku (L2 English) lub w brazylijskim portugalskim jako drugim języku (L2 BP) jednego z mówców uwzględnionych w kroku 2.2.1.3.
UWAGA: Fragment dźwiękowy w kroku 2.2.1.4 to głos referencyjny8. Fragmenty powinny trwać około 20 s. - Pobierz skrypt Praat CreateLineup48 z https://github.com/pabarbosa/prosody-scripts-CreateLineUp
- Przed uruchomieniem skryptu CreateLineup należy upewnić się, że głos referencyjny L2, folie L1 oraz głos docelowy L1 znajdują się w tym samym folderze (Rycina 5).
- Uruchom oprogramowanie do analizy fonetycznej.
- Z okno obiektu, kliknij Praat | Otwieranie skryptu Praat… aby wywołać skrypt.
- Kliknij Uruchom | Uruchom.
UWAGA: Skrypt zwraca plik w następującej kolejności: (głos referencyjny L2) + (głos docelowy L1 oraz losowo rozmieszczone dystraktory)Rysunek 5).
- Przeprowadzanie konfrontacji głosowych
- Utwórz przestrzeń online do hostowania zestawień na dowolnej wybranej platformie (np. SurveyMonkey. Zobacz Tabela materiałów) do zdalnego przeprowadzania okazów głosowych.
- Przejdź do łącza w przestrzeni online.
- Prześlij pliki zwrócone przez skrypt CreateLineup na platformę.
- Przeprowadź procedurę w obecności uczestników, aby przetestować każdy etap.
UWAGA: Zaleca się wcześniejsze przejście pod wskazany link i uruchomienie sekwencji w celu sprawdzenia, czy wszystko działa prawidłowo.
- Przygotuj cztery zestawy próbek głosowych dla języka angielskiego i cztery dla BP.
- Analiza statystyczna
- Wgraj arkusz kalkulacyjny zawierający wyniki ocen słuchaczy do środowiska R (lub dowolnego innego wybranego oprogramowania/środowiska statystycznego).
- Przeprowadź test Kruskala-Wallisa w programie R.
- Wpisz następujące polecenia i naciśnij Wprowadź.
model = kruskal.test(oceny każdy przebieg przesłuchania głosowego, dane = the ramka danych)
- Wykonaj test post-hoc Dunna.
- Przeprowadź test Dunna w programie R.
- Wpisz następujące polecenia i naciśnij Wprowadź.
library(FSA)
model = dunnTest(oceny każdy identyfikacja głosowa, dane = data, metoda = "Bonferroni")
UWAGA: Kody w krokach 2.3.1.2 i 2.3.2.2 są pseudokodami (patrz UWAGA 1.4.2.2).
- Wgraj arkusz kalkulacyjny zawierający wyniki ocen słuchaczy do środowiska R (lub dowolnego innego wybranego oprogramowania/środowiska statystycznego).
- Analiza podobieństwa akustycznego
- Wybierz serie (por. UWAGA w kroku 2.2.1.3), w których nie stwierdzono istotnych różnic między bodźcem docelowym a którymkolwiek z dystraktorów.
- Powtórzyć procedury z kroków od 1.3.1 do 1.3.7.5 oraz kroków od 1.3.7.8 do 1.3.7.10.
- Pobierz i uruchom skrypt dla języka Python49, PodobieństwoAkustyczne_cosinusowe_euklidesowe50 z https://github.com/leonidasjr/AcousticSimilarity/blob/main/AcousticSmilarity_cosine_euclidean.py.
UWAGA: Skrypt zwraca trzy macierze (w formatach „.txt” i „.csv”): jedną dla podobieństwa cosinusowego51,52, jedna dla odległości euklidesowej52,53oraz jeden dla wartości przekształconej odległości euklidesowej, a także porównanie parowe głosu docelowego z każdym z głosów dystrakcyjnych. - Upewnij się, że skrypt został pobrany do tego samego folderu, w którym znajduje się zbiór danych lineup.
- Kliknij w Otwórz plik… przycisk do uruchomienia skryptu.
- Kliknij Uruchom | Uruchom bez debugowania przyciski
UWAGA: Drugi Uruchomienie przycisk może być otagowany jako Uruchom lub uruchom bez debugowania lub Uruchom skrypt. Wszystkie one wykonują te same polecenia. Zależy to po prostu od użytego środowiska Python. - Przeprowadzenie testów podobieństwa głosu w oparciu o cechy akustyczne.
UWAGA: Podobieństwo cosinusowe (lub dystans cosinusowy) to technika stosowana w sztucznej inteligencji (AI), w szczególności w uczeniu maszynowym w systemach automatycznego rozpoznawania mowy (ASR). Jest to miara podobieństwa przyjmująca wartości od zera do jedynki. Podobieństwo cosinusowe bliskie jedynce oznacza, że dwa głosy są z dużym prawdopodobieństwem podobne. Podobieństwo cosinusowe bliskie zeru oznacza, że głosy są z dużym prawdopodobieństwem niepodobne.52Odległość euklidesowa, często określana jako podobieństwo euklidesowe, jest również szeroko stosowana w sztucznej inteligencji, uczeniu maszynowym oraz ASR. Reprezentuje ona odległość w linii prostej między dwoma punktami w przestrzeni euklidesowej.53tj. im bliżej siebie znajdują się punkty (krótsze wartości odległości), tym bardziej podobne są głosy. Aby zapewnić lepsze zrozumienie wyników obu technik, dokonano transformacji surowych wyników odległości euklidesowej na wartości z zakresu od zera (mniejsze podobieństwo głosów) do jeden (większe podobieństwo głosów).54.

Rysunek 5Konfiguracja katalogów dla percepcji mowy. Ustaw foldery w linii. Każdy folder zawiera sześć głosów L1, głos docelowy L2, the "Tworzenie zestawu" skrypt oraz plik audio z zestawieniem głosów (wygenerowany po uruchomieniu skryptu). Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej figury.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Wyniki produkcji mowy
W tej sekcji opisano wyniki statystycznie istotnych prozodyczno-akustycznych cech oraz miar rytmicznych. Cechy prozodyczne obejmowały tempo mowy, tempo artykulacji oraz częstotliwość pauz, które wiążą się z czasem trwania, a także shimmer, który wiąże się z jakością głosu. Miary rytmiczne obejmowały odchylenie standardowe (SD) czasu trwania sylaby, SD spółgłoski, SD czasu trwania samogłosek lub spółgłosek oraz współczynnik zmienności czasu trwania sylaby (patrz Tabela ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Obecny protokół stanowi nowość w dziedzinie fonetyki (sądowej). Dzieli się na dwie fazy: jedną opartą na produkcji (analiza akustyczna) i drugą opartą na percepcji (analiza osądu). Faza analizy produkcji obejmuje przygotowanie danych i wymuszone wyrównanie, ponowne wyrównanie i automatyczną ekstrakcję cech prozodowo-akustycznych oprócz statystyk. Protokół ten łączy etap zbierania danych z analizą danych w szybszy i bardziej efektywny sposób niż tradycyjne protokoły oparte na głównie ręcznej segmentacji.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy nie mają do zadeklarowania konfliktu interesów.
Podziękowania
To badanie było wspierane przez Narodową Radę Rozwoju Naukowego i Technologicznego - CNPq, grant nr 307010/2022-8 dla pierwszego autora i grant nr 302194/2019-3 dla drugiego autora. Autorzy pragną wyrazić szczerą wdzięczność uczestnikom tych badań za ich hojną współpracę i nieoceniony wkład.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| CreateLineup | Personal collection | # | Skrypt do przygotowania składów głosowych |
| Dell I3 (z dyskiem SSD - SSD) | Dell | # | Laptop |
| Praat | Paul Boersma & David Weenink | # | Oprogramowanie do analizy fonetycznej |
| Python 3 | Python Software Foundation | # | Interpretowany, wysokopoziomowy język programowania ogólnego przeznaczenia |
| R | The R Project for Statistical Computing | # | Język programowania do obliczeń statystycznych |
| Shure Beta SM7B | Shure | # | Microphone |
| SpeechRhythmExtractor | Personal collection | # | Script for praat for automatic extract of acoustic features |
| SurveyMonkey Inc. | # | Zbierz bezpłatne, konfigurowalne ankiety, a także zestaw programów zaplecza, które obejmują analizę danych, wybór próby, usuwanie uprzedzeń i reprezentację danych. | |
| Tascam DR-100 MKII | Tascam | # | Dyktafon cyfrowy |
| Monachijski automatyczny system segmentacji MAUS | Uniwersytet w Monachium | # | Wymuszone wyrównywanie plików audio (.wav) i informacji językowych (.txt) |
| VVUnitAligner | Kolekcja osobista | # | Skrypt do automatycznego wyrównywania i przetwarzania końcowego jednostek fonetycznych |
Bibliografia
- Moyer, A. Foreign Accent: The Phenomenon of Non-native Speech. , Cambridge University Press. (2013).
- Munro, M., Derwing, T. Foreign accent, comprehensibility and intelligibility, redux. J Second Lang Pronunciation. 6 (3), 283-309 (2020).
- Levis, J. Intelligibility, Oral Communication, and the Teaching of Pronunciation. , Cambridge University Press. (2018).
- Munro, M. Applying Phonetics: Speech Science in Everyday Life. , Wiley-Blackwell. (2022).
- Gut, U. Speaker Classification. Muller, C. , Springer-Verlag. 75-87 (2007).
- Rogers, H. Foreign accent in voice discrimination: a case study. Forensic Linguistics. 5 (2), 203-208 (1998).
- Solan, L., Tiersma, P. Hearing Voices: Speaker Identification in Court. Hastings Law Journal. 54, 373-436 (2003).
- Alcaraz, J. The long-term average spectrum in forensic phonetics: From collation to discrimination of speakers. Estudios de Fonética Experimental / Journal o Experimental Phonetics. 32, 87-110 (2023).
- Silva, L. Jr, Barbosa, P. A. Voice disguise and foreign accent: Prosodic aspects of English produced by Brazilian Portuguese speakers. Estudios de Fonética Experimental / Journal o Experimental Phonetics. 32, 195-226 (2023).
- Munro, M., Derwing, T. Modeling perceptions of the accentedness and comprehensibility of L2 speech. Studies in Second Language Acquisition. 23 (4), 451-468 (2001).
- Keating, P., Esposito, C. Linguistic Voice Quality. Working Papers in Phonetics. , 85-91 (2007).
- Niebuhr, O., Skarnitzl, R., Tylečková, L. The acoustic fingerprint of a charismatic voice -Initial evidence from correlations between long-term spectral features and listener ratings. Proceedings of Speech Prosody. , 359-363 (2018).
- Segundo San, E. International survey on voice quality: Forensic practitioners versus voice therapists. Estudios de Fonética Experimental. 29, 8-34 (2021).
- Farrús, M. Fusing prosodic and acoustic information for speaker recognition. International Journal of Speech, Language and the Law. 16 (1), 169(2009).
- Farrús, M. Voice disguise in automatic speaker recognition. ACM Computing Surveys. 51 (4), 1-2 (2018).
- Nolan, F. A recent voice parade. The International Journal of Speech, Language and the Law. 10 (2), 277-291 (2003).
- McDougall, K. Ear-catching versus eye-catching? Some developments and current challenges in earwitness identification evidence. Speaker Individuality in Phonetics and Speech Sciences. Bernardasci, C., Dipino, D., Garassino, D., Negrinelli, S., Pellegrino, E., Schmid, S. , Officinaventuno. 33-56 (2021).
- Gut, U. Rhythm in L2 speech. Speech and Language Technology. 14 (15), 83-94 (2012).
- Urbani, M. Pitch Range in L1/L2 English. An Analysis of F0 using LTD and Linguistic Measures. Coop. , Libraria Editrice Università di Padova. (2012).
- Gonzales, A., Ishihara, S., Tsurutani, C. Perception modeling of native and foreign-accented Japanese speech based on prosodic features of pitch accent. J Acoust Soc Am. 133 (5), 3572(2013).
- Silva, L. Jr, Barbosa, P. A. Speech rhythm of English as L2: an investigation of prosodic variables on the production of Brazilian Portuguese speakers. J Speech Sci. 8 (2), 37-57 (2019).
- Foreign accent and L2 speech rhythm of English a pilot study based on metric and prosodic parameters. Silva, L. Jr, Barbosa, P. A. Proceedings of the II Brazilian Conference on Prosody (Anais II Congresso Brasileiro de Prosódia), 1, 41-50 (2023).
- Costa, A. El cerebro bilingüe: La neurociencia del lenguaje. , Penguin Randon House. (2017).
- Eriksson, A. Tutorial on forensic speech science: Part I. Forensic Phonetics. , (2005).
- Harvey, M., Giroux, M., Price, H. Lineup size influences voice identification accuracy. Applied Cognitive Psychology. 37 (5), 42-89 (2023).
- Pautz, N., et al. Identifying unfamiliar voices: Examining the system variables of sample duration and parade size. Q J Exp Psychol (Hove). 76 (12), 2804-2822 (2023).
- McDougall, K., Nolan, F., Hudson, T. Telephone transmission and earwitnesses: Performance on voice parades controlled for voice similarity. Phonetica. 72 (4), 257-272 (2015).
- Nolan, F., McDougall, K., Hudson, T. Some acoustic correlates of perceived (dis) similarity between same-accent voices. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2011). , 1506-1509 (2011).
- Sheoran, S., Mahna, D. Voice identification and speech recognition: an arena of voice acoustics. Eur Chem Bull. 12 (5), 50-60 (2023).
- Hudson, T., McDougall, K., Hughes, V. Forensic phonetics. The Cambridge Handbook of Phonetics. Knight, R. -A., Setter, J. , Cambridge University Press. 631-656 (2021).
- Eriksson, A. The disguised voice: Imitating accents or speech styles and impersonating individuals. Language and identities. Llamas, C., Watt, D. , Edinburgh University Press. 86-96 (2010).
- Köster, O., Schiller, N. Different influences of the native language of a listener on speaker recognition. Forensic Linguistics. 4 (1), 18-27 (1997).
- The influence of native-language background on speaker recognition. Köster, O., Schiller, N., Künzel, H. Proceedings of the International Congress of Phonetic Sciences (ICPhS 1995), , 306-309 (1995).
- Thompson, C. P. A language effect in voice identification. Applied Cognitive Psychology. 1, 121-131 (1987).
- San Segundo, E., Univaso, P., Gurlekian, J. Sistema multiparamétrico para la comparación forense de hablantes. Estudios de Fonética Experimental. 28, 13-45 (2019).
- Council of Europe. Common European Framework of Reference for Languages: Learning, Teaching, Assessment. , Press Syndicate of the University of Cambridge. (2001).
- How to use Tascam DR-100 MKII: Getting started. , https://www.youtube.com/watch?v=O2E72uV9fWc (2018).
- Getting the most from your Shure SM58 microphone. , https://www.youtube.com/watch?v=wweNufW7EXA (2020).
- Kisler, T., Reichel, U. D., Schiel, F. Multilingual processing of speech via web services. Computer Speech & Language. 45, https://clarin.phonetik.uni-muenchen.de/BASWebServices/interface/WebMAUSBasic 326-347 (2017).
- Escudero, P., Boersma, P., Rauber, A., Bion, R. A cross-dialect acoustic description of vowels: Brazilian and European Portuguese. J Acoust Soc Am. 126 (3), 1379-1393 (2009).
- Post-aspiration in standard Italian: some first cross-regional acoustic evidence. Stevens, M., Hajek, J. Proceedings 11th Conference of the International Speech Communication Association (INTERSPEECH 2010), , 1557-1560 (2011).
- Barbosa, P., Madureira, S. Manual de Fonética Acústica Experimental: aplicações a dados do português. , Cortez. (2015).
- Boersma, P., Weenink, D. Praat: Doing phonetics by computer. (Version 6.1.38) [Computer program]. , https://www.praat.org/ (1992-2021).
- Silva, L. Jr VVUnitAligner. [Computer program]. , https://github.com/leonidasjr/VVunitAlignerCode_webMAUS (2022).
- Silva, L. Jr, Barbosa, P. A. SpeechRhythmExtractor [Computer program]. , https://github.com/leonidasjr/VowelCode (2019-2023).
- R Core Team. A language and environment for statistical computing. R Foundation for Statistical Computing. , https://www.R-project.org/ (2023).
- Pigoli, D., Hadjipantelis, P. Z., Coleman, J. Z., Aston, J. The statistical analysis of acoustic phonetic data. Journal of the Royal Statistical Society. 67 (5), 1103-1145 (2018).
- Barbosa, P. A. CreateLineup [Computer program]. , https://github.com/pabarbosa/prosody-scripts-CreateLineUp (2021).
- Van Rossum, G., Drake, F. L. Python 3 Reference Manual. , CreateSpace. (2009).
- Silva, L. Jr AcousticSimilarity_cosine_euclidean. [Computer program]. , https://github.com/leonidasjr/AcousticSimilarity/blob/main/AcousticSmilarity_cosine_euclidean.py (2024).
- Automatic assessment of voice similarity within and across speaker groups with different accents. Gerlach, L., McDougall, K., Kelly, F., Alexander, A. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023), , 3785-3789 (2023).
- Gahman, N., Elangovan, V. A comparison of document similarity algorithms. International Journal of Artificial Intelligence and Applications. 14 (2), 41-50 (2023).
- San Segundo, E., Tsanas, A., Gómez-Vilda, P. Euclidean distances as measures of speaker similarity including identical twin pairs: A forensic investigation using source and Filter voice characteristics. Forensic Science International. 270, 25-38 (2017).
- Speaker's voice characteristics and similarity measurement using Euclidean distances. Singh, M. K., Singh, N., Singh, A. K. Proceedings of the International Conference on Signal Processing and Communication (ICSC 2019), , 317-322 (2019).
- Darling-White, M., Banks, W. Speech rate varies with sentence length in typically developing children. J Speech Lang Hear Res. 64 (6), 2385-2391 (2021).
- Barbosa, P. A. Incursões em torno do ritmo da Fala. , Pontes Editores. (2006).
- Golestani, N., Pallier, C. Anatomical correlates of foreign speech sound production. Cereb Cortex. 17 (4), 929-934 (2007).
- Trouvain, J., Fauth, C., Möbius, B. Breath and non-breath pauses in fluent and disfluent phases of German and French L1 and L2 read speech. Proceedings of Speech Prosody. , 31-35 (2016).
- Waaning, J. The Lombard effect: the effects of noise exposure and being instructed to speak clearly on speech acoustic parameters. [Master's thesis]. , Radboud University. (2021).
- Villegas, J., Perkins, J., Wilson, I. Effects of task and language nativeness on the Lombard effect and on its onset and offset timing. J Acoust Soc Am. 149 (3), 1855(2021).
- Differences between native and non-native Lombard speech in terms of pitch range. Proceedings of the 23rd International Congress on Acoustics(ICA 2019). Marcoux, K., Ernestus, M. , 5713-5720 (2019).
- Marcoux, K., Ernestus, M. Pitch in native and non-native Lombard speech. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2019). , 2605-2609 (2019).
- Marcoux, K., Ernestus, M. Acoustic characteristics of non-native Lombard speech in the DELNN corpus. Journal of Phonetics. 102, 1-25 (2024).
- Gil, J., San Segundo, E. La cualidad de voz en fonética judicial [Voice quality in judicial phonetics]. Lingüística Forense: la Lingüística en el ámbito legal y policial. Garayzábal, M., Jiménez, M., Reigosa, M. , Euphonía Ediciones. 154-199 (2014).
- Gil, J., San Segundo, E. El disimulo de la cualidad de voz en fonética judicial: Estudio perceptivo de la hiponasalidad [Voice quality disguise in judicial phonetics: A perceptual study of hyponasality. Panorama de la fonética española actual. Penas-báñez, M. A. , Arco Libros. 321-366 (2013).
- Passeti, R., Madureira, S., Barbosa, P. What can voice line-ups tell us about voice similarity. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023). , 3765-3769 (2023).
- Nolan, F. The DyViS database: Style-controlled recordings of 100 homogeneous speakers for forensic phonetic research. International Journal of Speech Language and the Law. 16 (1), 31-57 (2009).
- Caroll, D. Psychology of Language. , Wadsworth. (1994).
- Ortega-Llebaria, M., Silva, L. Jr, Nagao, J. Macro- and micro-rhythm in L2 English: Exploration and Refinement of Measures. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023). , 1582-1586 (2023).
- Fernández-Trinidad, M. Hacia la aplicabilidad de la cualidad de la voz en fonética judicial. Loquens. 9 (1-2), 1-11 (2022).
- Brouwer, S. The role of foreign accent and short-term exposure in speech-in-speech recognition. Atten Percep Psychophys. 81, 2053-2062 (2019).
- Love, R., Wright, D. Specifying challenges in transcribing covert recordings: Implications for forensic transcription. Front Commun. 6, 1-14 (2021).
- Meer, P. Automatic alignment for New Englishes: Applying state-of-the-art aligners to Trinidadian English. J Acoust Soc Am. 147 (4), 2283-2294 (2020).
- Montreal Forced Aligner: trainable text-speech alignment using Kaldi. McAuliffe, M., Socolof, M., Mihuc, S., Wagner, M., Sonderegger, M. Proceedings 18th Conference of the International Speech Communication Association (INTERSPEECH 2017), , 498-502 (2017).
- Chodroff, E. Montreal Forced Aligner: MFA Tutorial. , https://zenodo.org/records/7591607 (2023).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
