Niniejszy protokół opisuje wydajną metodę segmentacji wielonarządowej o nazwie Swin-PSAxialNet, która osiągnęła doskonałą dokładność w porównaniu z poprzednimi metodami segmentacji. Kluczowe kroki tej procedury obejmują zbieranie zestawów danych, konfigurację środowiska, wstępne przetwarzanie danych, trenowanie i porównywanie modeli oraz eksperymenty ablacyjne.
Artykuł metodologiczny
Swin-PSAxialNet: skuteczna technika segmentacji wielonarządowej
W tym artykule
Podsumowanie
Streszczenie
Segmentacja wielonarządowa jamy brzusznej jest jednym z najważniejszych tematów w dziedzinie analizy obrazów medycznych i odgrywa ważną rolę we wspieraniu klinicznych przepływów pracy, takich jak diagnozowanie chorób i planowanie leczenia. W niniejszej pracy zaproponowano wydajną metodę segmentacji wielonarządowej o nazwie Swin-PSAxialNet opartą na architekturze nnU-Net. Został zaprojektowany specjalnie do precyzyjnej segmentacji 11 narządów jamy brzusznej na obrazach TK. Proponowana sieć wprowadziła następujące ulepszenia w porównaniu z nnU-Net. Po pierwsze, wprowadzono moduły SPD (Space-to-depth) i bloki ekstrakcji cech PSAA (Sharement-shared axial attention), zwiększając możliwości ekstrakcji cech obrazu 3D. Po drugie, zastosowano wieloskalowe podejście do fuzji obrazów w celu uchwycenia szczegółowych informacji i cech przestrzennych, poprawiając możliwości wyodrębniania subtelnych cech i cech krawędziowych. Na koniec wprowadzono metodę współdzielenia parametrów w celu zmniejszenia kosztów obliczeniowych modelu i szybkości trenowania. Proponowana sieć osiąga średni współczynnik Dice'a wynoszący 0,93342 dla zadania segmentacji obejmującego 11 narządów. Wyniki eksperymentalne wskazują na znaczną wyższość Swin-PSAxialNet nad poprzednimi metodami segmentacji głównego nurtu. Metoda wykazuje doskonałą dokładność i niskie koszty obliczeniowe w segmentacji głównych narządów jamy brzusznej.
Wprowadzenie
Współczesna interwencja kliniczna, obejmująca diagnostykę chorób, opracowywanie planów leczenia oraz monitorowanie wyników terapii, opiera się na dokładnej segmentacji obrazów medycznych1. Jednak złożone zależności strukturalne między narządami jamy brzusznej2 sprawiają, że precyzyjna segmentacja wielu organów brzusznych jest zadaniem trudnym3. W ciągu ostatnich kilku dekad dynamiczny rozwój obrazowania medycznego i wizji komputerowej przyniósł zarówno nowe możliwości, jak i wyzwania w dziedzinie wielonarządowej segmentacji jamy brzusznej. Zaawansowana technologia obrazowania metodą rezonansu magnetycznego (MRI)4 oraz tomografii komputerowej (CT)5 umożliwia pozyskiwanie obrazów jamy brzusznej o wysokiej rozdzielczości. Precyzyjna segmentacja wielu narządów z obrazów CT ma istotną wartość kliniczną w ocenie i leczeniu kluczowych organów, takich jak wątroba, nerki, śledziona, trzustka itp.6,7,8,9,10 Jednak ręczna adnotacja tych struktur anatomicznych, zwłaszcza tych wymagających udziału radiologów lub radioterapeutów, jest czasochłonna i podatna na wpływ subiektywny1. W związku z tym istnieje pilna potrzeba opracowania zautomatyzowanych i dokładnych metod wielonarządowej segmentacji jamy brzusznej.
Poprzednie badania nad segmentacją obrazu opierały się głównie na konwolucyjnych sieciach neuronowych (CNN), które zwiększają wydajność segmentacji poprzez nakładanie warstw oraz wprowadzenie architektury ResNet12. W 2020 roku zespół badawczy Google wprowadził model Vision Transformer (VIT)13, co stanowiło pionierski przykład zastosowania architektury Transformer w tradycyjnej domenie wizualnej dla szeregu zadań związanych z obrazowaniem14. Podczas gdy operacje konwolucyjne mogą uwzględniać jedynie lokalne informacje o cechach, mechanizm uwagi w Transformerach umożliwia kompleksowe uwzględnienie globalnych informacji o cechach.
Biorąc pod uwagę przewagę architektur opartych na Transformerach nad tradycyjnymi sieciami splotowymi15, wiele zespołów badawczych podjęło szeroko zakrojone próby optymalizacji synergii między mocnymi stronami Transformerów a sieciami splotowymi16,17,18,19. Chen i wsp. wprowadzili model TransUNet do zadań segmentacji obrazów medycznych16, który wykorzystuje Transformery do wyodrębniania globalnych cech z obrazów. Ze względu na wysoki koszt trenowania sieci oraz brak wykorzystania koncepcji hierarchii ekstrakcji cech, zalety Transformerów nie zostały w pełni zrealizowane.
Aby rozwiązać te problemy, wielu badaczy zaczęło eksperymentować z wykorzystaniem Transformerów jako szkieletu do trenowania sieci segmentacyjnych. Liu i wsp.17 wprowadzili Swin Transformer, który wykorzystywał hierarchiczną metodę konstrukcji do warstwowej ekstrakcji cech. Zaproponowano koncepcję Windows Multi-Head Self-Attention (W-MSA), która znacząco zredukowała koszt obliczeniowy, szczególnie w przypadku większych map cech na niskim poziomie. Choć podejście to zmniejszyło wymagania obliczeniowe, doprowadziło jednocześnie do izolacji transmisji informacji między różnymi oknami. Aby rozwiązać ten problem, autorzy wprowadzili dodatkowo koncepcję Shifted Windows Multi-Head Self-Attention (SW-MSA), umożliwiającą propagację informacji pomiędzy sąsiednimi oknami. Opierając się na tej metodologii, Cao i wsp. opracowali Swin-UNet18, zastępując sploty 2D w U-Net modułami Swin oraz włączając W-MSA i SW-MSA do procesów kodowania i dekodowania, co pozwoliło osiągnąć satysfakcjonujące wyniki segmentacji.
Z kolei Zhou i wsp. podkreślili, że podczas przetwarzania obrazów o wysokiej rozdzielczości nie można zignorować zalet operacji splotu (conv)19. Zaproponowany przez nich model nnFormer wykorzystuje metodę obliczeń mechanizmu self-attention opartą na lokalnych trójwymiarowych blokach obrazu, tworząc model Transformer o strukturze w kształcie krzyża. Zastosowanie uwagi opartej na lokalnych blokach trójwymiarowych znacząco zredukowało obciążenie sieci podczas procesu trenowania.
Biorąc pod uwagę problemy związane z powyższą analizą, zaproponowano wydajną hybrydową strukturę hierarchiczną do segmentacji trójwymiarowych obrazów medycznych, nazwaną Swin-PSAxialNet. Metoda ta zawiera blok downsamplingu, blok Space-to-depth (SPD)20, który jest zdolny do ekstrakcji informacji globalnych21. Ponadto dodano moduł współdzielonej parametrami uwagi osiowej (PSAA), który redukuje liczbę parametrów uczenia z kwadratowej do liniowej, co pozytywnie wpływa na dokładność trenowania sieci oraz złożoność modeli treningowych2.
Sieć Swin-PSAxialNet
Ogólna architektura sieci przyjmuje strukturę w kształcie litery U charakterystyczną dla nnU-Net23, składającą się ze struktur koder i dekoder. Struktury te służą do lokalnej ekstrakcji cech oraz konkatenacji cech z obrazów w dużej i małej skali, co przedstawiono na Rysunku 1.
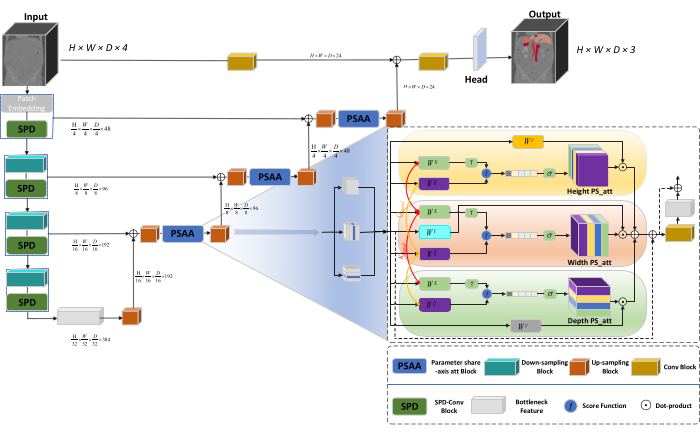
Rycina 1Schemat architektury sieci Swin-PSAxialNet. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
W strukturze koderach tradycyjny blok Conv został połączony z blokiem SPD20 w celu utworzenia objętości podpróbkowanej. Pierwsza warstwa kodera zawiera Patch Embedding – moduł, który dzieli dane 3D na fragmenty (patche) 3D 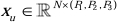 , (P1, P2, P3) reprezentuje w tym kontekście niezachodzące na siebie fragmenty,
 oznacza długość sekwencji fragmentów 3D (patchy). Po warstwie osadzania (embedding layer) kolejnym krokiem jest jednostka zmniejszająca próbkowanie splotowe bez nakładania się, składająca się z bloku splotowego oraz bloku SPD. W tej konfiguracji blok splotowy ma ustawiony krok (stride) równy 1, a blok SPD służy do skalowania obrazu, co prowadzi do czterokrotnej redukcji rozdzielczości i dwukrotnego zwiększenia liczby kanałów.
W strukturze dekodera każdy blok upsamplingu po warstwie Bottleneck Feature składa się z kombinacji bloku upsamplingu i bloku PSAA. Rozdzielczość mapy cech jest dwukrotnie zwiększana, a liczba kanałów zmniejszana o połowę pomiędzy każdą parą etapów dekodera. W celu przywrócenia informacji przestrzennych i poprawy reprezentacji cech, pomiędzy blokami upsamplingu przeprowadza się fuzję cech obrazów o dużej i małej skali. Ostatecznie wyniki upsamplingu są przekazywane do warstwy Head w celu przywrócenia oryginalnego rozmiaru obrazu, z rozmiarem wyjściowym (H × W × D × C, C = 3).
Architektura bloku SPD
W tradycyjnych metodach sekcja downsamplingu wykorzystuje pojedynczy krok o rozmiarze 2. Wiąże się to z pulowaniem splotowym w lokalnych pozycjach obrazu, co ogranicza pole recepcyjne i zmusza model do ekstrakcji cech z niewielkich fragmentów obrazu. Metoda ta wykorzystuje blok SPD, który precyzyjnie dzieli oryginalny obraz na trzy wymiary. Oryginalny obraz 3D jest równomiernie segmentowany wzdłuż osi x, y i z, co skutkuje powstaniem czterech podobjętości (Rysunek 2). Następnie cztery objętości są łączone za pomocą operacji „cat”, a otrzymany obraz poddawany jest splotowi 1 × 1 × 1 w celu uzyskania obrazu po downsamplingu20.

Rysunek 2Schemat blokowy SPD. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Architektura bloku PSAA
W przeciwieństwie do tradycyjnych sieci CNN, proponowany blok PSAA jest bardziej efektywny w koncentrowaniu informacji globalnych oraz wydajniejszy w procesie uczenia i trenowania sieci. Pozwala to na przechwycenie bogatszych cech obrazów i cech przestrzennych. Blok PSAA obejmuje uczenie uwagi osiowej (axial attention) oparte na współdzieleniu parametrów w trzech wymiarach: wysokości, szerokości i głębokości. W porównaniu do konwencjonalnego mechanizmu uwagi, który przeprowadza uczenie uwagi dla każdego piksela obrazu, metoda ta niezależnie realizuje uczenie uwagi dla każdego z trzech wymiarów, co redukuje złożoność samo-uwagi (self-attention) z kwadratowej do liniowej. Ponadto zastosowano mechanizm współdzielenia parametrów kluczy-zapytań (keys-queries) z możliwością uczenia, co pozwala sieci na równoległe wykonywanie operacji mechanizmu uwagi w trzech wymiarach, prowadząc do szybszej, lepszej i bardziej efektywnej reprezentacji cech.
Protokół
Niniejszy protokół został zatwierdzony przez Komisję Etyczną Uniwersytetu Nantong. Obejmuje on inteligentną ocenę i badanie pozyskanych nieinwazyjnych lub małoinwazyjnych danych multimodalnych, w tym obrazów medycznych człowieka, ruchów kończyn oraz obrazowania naczyniowego, z wykorzystaniem technologii sztucznej inteligencji. Rysunek 3 przedstawia ogólny schemat blokowy segmentacji wielonarządowej. Wszystkie niezbędne linki internetowe znajdują się w Tabeli materiałów.

Rysunek 3Ogólny schemat blokowy segmentacji wielu organów. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
1. Gromadzenie zbioru danych
- Pobierz zestaw danych AMOS20224 (patrz Tabela materiałów).
- Wybierz 160 obrazów jako zbiór treningowy i 40 obrazów jako zbiór testowy.
- Wykonaj końcowo mkdir ~/PaddleSeg/contrib/MedicalSeg/data/raw_data.
- Otwórz ścieżkę do raw_data.
- Umieść zestaw danych w dane surowe katalogu i upewnij się, że odpowiadają one nazwom plików wewnątrz niego "obrazyTr" i "etykietyTr" katalogi
- Utwórz zbiór_danych.json Plik.
- Dodaj informacje o zbiorze danych, takie jak liczbaTreningów, numTest, i nazwy etykiet do "zbiordanych.json" Proszę o dostarczenie tekstu źródłowego do tłumaczenia.
UWAGA: Zestaw danych dla niniejszego badania składa się z 20 wysokiej jakości zestawów danych CT, wybranych z oficjalnego zbioru 50 CT AMOS202 do celów treningowych i testowych. Zestaw danych obejmuje 1 organów, w tym śledzionę, prawą nerkę, lewą nerkę, pęcherzyk żółciowy, przełyk, wątrobę, żołądek, aortę, żyłę główną dolną, trzustkę oraz pęcherz moczowy.
2. Konfiguracja środowiska
- Zainstaluj środowisko Paddlepaddle (patrz Tabela materiałów) oraz odpowiednią wersję CUDA25.
UWAGA: Zaleca się korzystanie z wersji 2.5.0 Paddlepaddle oraz wersji 1.7 CUDA. - Sklonuj repozytorium PaddleSeg za pomocą Git25.
- Wykonaj w terminalu polecenie cd ~/PaddleSeg/contrib/MedicalSeg/.
- Wykonaj polecenie pip install -r requirements.txt.
- Wykonaj polecenie pip install medpy.
3. Przetwarzanie wstępne danych
- Zmodyfikuj plik „yml”, uwzględniając parametry takie jak data_root, batch_size, model, train_dataset, val_dataset, optimizer, lr_scheduler, oraz loss.
- Określ wymagane parametry do uruchomienia, w tym „-config, --log_iters, --precision, --nnunet, --save_dir, --save_interval, itp.
UWAGA: Oryginalne „raw_data” są przekształcane w trzy rodzaje plików danych: „Cropped”, „Decathlon” oraz „Preprocessed”, co pozwala na dostosowanie do różnych wymagań dotyczących uczenia i oceny w celu zwiększenia wydajności modelu i efektywności procesu uczenia.
4. Trenowanie i porównywanie modeli
UWAGA: Jako powszechnie stosowany punkt odniesienia w dziedzinie segmentacji obrazów, nnU-Net23 służy jako model bazowy w niniejszym badaniu. Szczegółowy proces porównania modeli przedstawia się następująco.
- Trenowanie nnU-Net
- Skonfiguruj wielkość partii (batch size) na 2 i 80 00 iteracji, rejestruj logi co 20 iteracji oraz wykorzystaj precyzję fp16.
- Ustaw save_dir jako folder „output” w katalogu roboczym, z interwałem zapisu ustawionym na 1 00 iteracji.
- Dodaj parametr --use_vdl w celu wizualizacji parametrów w VisualDL.
- Uruchom plik train.py.
- Utwórz cztery pliki yml, określ foldy 1-4 i wytrenuj model z wykorzystaniem pięciokrotnej walidacji krzyżowej.
- Trenowanie Swin-UNet
- Zachowaj spójność z wcześniej ustalonymi warunkami eksperymentalnymi.
- Usuń parametr --nnunet i użyj --swinunet.
- Uruchom plik train.py.
- Wytrenuj foldy 1-4 indywidualnie, a następnie poddaj je przetwarzaniu zespołowemu (ensemble processing).
- Trenowanie TransUNet
- Postępuj zgodnie z procedurami opisanymi w kroku 4.1.
- Otwórz plik yml.
- Zmień type: nnunet na type: transunet.
- Zmień parametr --nnunet na --transunet.
- Uruchom plik train.py.
- Wytrenuj foldy 1-4 indywidualnie i przeprowadź przetwarzanie zespołowe.
- Trenowanie UNETR
- Zachowaj spójność zmiennych eksperymentalnych.
- Powtórz procedury opisane wcześniej dla Swin-UNet i TransUNet (krok 4.2 i krok 4.3).
- Uruchom plik train.py.
- Wytrenuj foldy 1-4 indywidualnie i przeprowadź przetwarzanie zespołowe.
- Trenowanie nnFormer
- Zmodyfikuj parametry analogicznie jak dla Swin-UNet i TransUNet.
- Uruchom plik train.py dla pojedynczego folda.
- Uruchom przetwarzanie zespołowe.
5. Eksperyment ablacyjny
- Blok PSAA dla całej sieci
- Zachowaj zmienne spójne z krokiem 4.1.
- Ustaw volume_shape = (64,192,192) oraz Axial_attention = True.
- Uruchom single fold train.py.
- Przeprowadź przetwarzanie ansamblowe dla pięciu foldów.
- Blok SPD dla całej sieci
- Zachowaj zmienne spójne z krokiem 4.1.
- Ustaw SPD_enable = True oraz Axial_attention = False.
- Uruchom single fold train.py.
- Przeprowadź przetwarzanie ansamblowe dla pięciu foldów.
- Blok PSAA do upsamplingu
UWAGA: Nie używaj bloku SPD do downsamplingu.- Użyj bloku PSAA do upsamplingu.
- Zachowaj zmienne spójne z krokiem 4.1.
- Ustaw Axial_attention = False w części downsamplingu oraz SPD_enable = False.
- Uruchom single fold train.py.
- Przeprowadź przetwarzanie ansamblowe dla pięciu foldów.
- Blok PSAA do upsamplingu
UWAGA: Użyj bloku SPD do downsamplingu.- Użyj bloku SPD do downsamplingu oraz bloku PSAA do upsamplingu.
- Zachowaj zmienne spójne z krokiem 4.1.
- Ustaw Axial_attention = False w części downsamplingu oraz SPD_enable = True.
- Uruchom single fold train.py.
- Przeprowadź przetwarzanie ansamblowe dla pięciu foldów.
- Ustaw liczbę iteracji na 2,0,00 ze względu na lepsze wyniki.
Wyniki
W niniejszym protokole zastosowano dwie metryki do oceny modelu: współczynnik podobieństwa Dice'a (DSC) oraz 95% odległość Hausdorffa (HD95). DSC mierzy stopień pokrycia między przewidywaną segmentacją wokseli a prawdą obiektywną (ground truth), natomiast HD95 ocenia pokrycie granic między przewidywaną segmentacją wokseli a prawdą obiektywną, odfiltrowując 5% wartości odstających. Definicja DSC26 przedstawia się następująco:
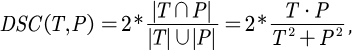 (1)
Gdzie T i P reprezentują odpowiednio wartości rzeczywiste (ground truth) oraz wartości przewidywane dla wszystkich wokseli. Definicja 95% HD26 przedstawia się następująco:
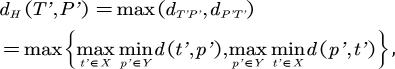 (2)
Gdzie dT,P, jest odległością 95. percentyla maksymalnego HD95 między rzeczywistymi a przewidywanymi wokselami, a dT,P, reprezentuje odległość 95. percentyla maksymalnego HD95 między przewidywanymi wokselami a prawdą obiektywną.
Swin-PSAxialNet został porównany z różnymi głównymi algorytmami segmentacji wieloorganowej w Tabeli 1. Wyniki wykazują poprawę wydajności segmentacji organów jamy brzusznej w proponowanym algorytmie. Dokładność Dice metody segmentacji przewyższa średnią wartość Dice innych metod o 2-3 punkty procentowe i przewyższa nawet nnFormer o 1 punkt procentowy. Swin-PSAxialNet wykazuje również wysoką dokładność w segmentacji granic, ze średnim współczynnikiem HD95 wynoszącym 5,63, co jest najniższym wynikiem spośród wszystkich porównanych algorytmów.
| Metody | Lkn | Spl | Liv | Patelnia | Aro | Bla | Zatrzymaj | Gbd | Pozytywne | Eso | Rkn | Śr. | ||
| DSC (skrót od różnicowej kalorymetrii skaningowej) | HD95 | |||||||||||||
| nnU-Net | 96.3 | 96.8 | 97.21 | 85.2 | 95.22 | 86.57 | 91.47 | 84.7 | 91.79 | 82.5 | 95.44 | 91.2 | 7.13 | |
| Swin-Unet | 96.03 | 96.68 | 97.22 | 85.74 | 95.3 | 87.82 | 91.77 | 84.64 | 91.67 | 83.26 | 96.14 | 91.48 | 9.68 | |
| TransUNet | 96.42 | 96.74 | 97.05 | 85.09 | 94.86 | 85.2 | 91.81 | 83.33 | 91.52 | 82.22 | 96.12 | 90.94 | 13.77 | |
| UNETR | 95.94 | 96.48 | 96.85 | 84.14 | 94.62 | 85.01 | 90.18 | 81.16 | 90.79 | 80.34 | 95.15 | 90.06 | 12.92 | |
| nnFormer | 96.59 | 97.22 | 97.33 | 86.79 | 95.31 | 89.74 | 92.82 | 84.88 | 92.43 | 84.24 | 96.32 | 92.15 | 6.59 | |
| Swin-PSAxialNet | 96.85 | 97.67 | 97.64 | 88.39 | 95.97 | 92.03 | 94.4 | 87.78 | 93.15 | 86.24 | 96.59 | 93.34 | 5.63 | |
Tabela 1: Porównanie głównych algorytmów segmentacji. Skróty oznaczają następujące organy: Lkn dla lewej nerki, Spl dla śledziony, Liv dla wątroby, Pan dla trzustki, Aro dla aorty, Bla dla pęcherza moczowego, Sto dla żołądka, Gbd dla pęcherzyka żółciowego, Pos dla żyły głównej dolnej, Eso dla przełyku, Rkn dla prawej nerki, a DSC dla średniego współczynnika Dice, HD95 dla średniej 95% odległości Hausdorffa.
Ponadto wprowadzenie mechanizmu współdzielenia parametrów oraz ulepszenia struktury transformera zapewniają istotne korzyści zarówno w zakresie złożoności modelu, jak i szybkości wnioskowania (Tabela 2, Rysunek 4 oraz Rysunek 5).
| Modele | Parametry (M) | FLOPs (G) | Czas wnioskowania (s) |
| nn-Unet | 17.96 | 398.54 | 9.07 |
| UNETR | 89.58 | 39.67 | 12.51 |
| nnFormer | 134.78 | 152.43 | 11.24 |
| Swin-PSAxialNet | 37.64 | 43.15 | 10.31 |
Tabela 2: Tabela porównawcza wskaźników modelu sieciowego.
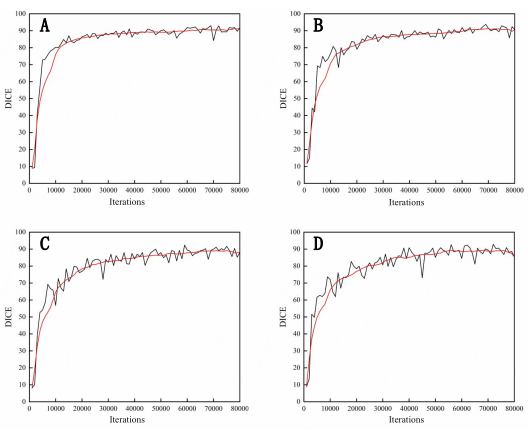
Rycina 4Krzywa zmienności współczynnika Dice podczas trenowania sieci modelu. (A) Obecna sieć. (B) nnFormer. (C) nnU-Net. (D) UNETR. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.

Rycina 5Porównanie wyników trenowania modelu. Rysunek przedstawia wyniki bieżącej sieci, wyniki nnFormer, wyniki nnU-Net oraz wyniki UNETR. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
W niniejszym badaniu przeprowadzono kompleksowe eksperymenty ablacyjne sieci algorytmicznej, przyjmując blok PSAA oraz blok SPD jako zmienne i porównując trening jednokrotny z treningiem pięciokrotnym. Współczynniki Dice uzyskane w wynikach eksperymentalnych przedstawiono w Tabeli 3. Wyniki te wykazują, że zastosowanie bloku SPD do downsamplingu oraz bloku PSAA do upsamplingu skutecznie poprawia wydajność segmentacji w porównaniu z niemodyfikowaną siecią nnU-Net (Rysunek 6).
| Modele | Blok PSAA dla całej sieci | Blok SPD dla całej sieci | Blok PSAA wyłącznie do upsamplingu | Blok PSAA do nadpróbkowania, zastosuj SPD |
| Trening z pojedynczym podziałem | 92.17 | 90.51 | 92.24 | 92.39 |
| Pięciokrotne trenowanie | 92.82 | 91.26 | 92.79 | 93.34 |
Tabela 3: Wyniki eksperymentu ablacyjnego Swin-PSAxialNet. Przedstawiono wyniki eksperymentu ablacyjnego modelu Swin PSAxialNet. W eksperymentzie ablacyjnym porównano zastosowanie bloków PSAA oraz SPD, a wyniki treningu dla wskaźnika DSC przedstawiono w tabeli.
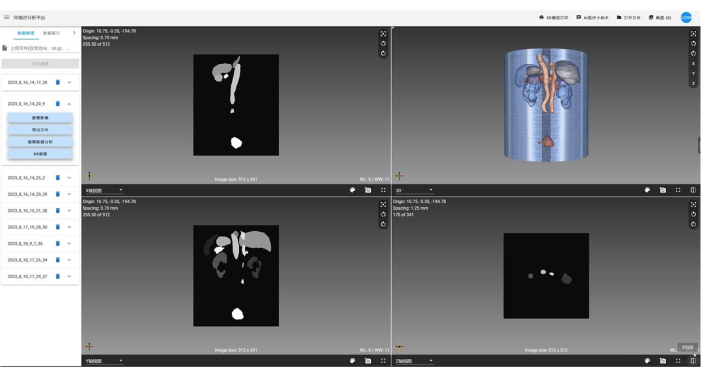
Rycina 6Wyniki segmentacji. Prosimy o kliknięcie tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Dyskusja
Segmentacja narządów jamy brzusznej to skomplikowana praca. W porównaniu z innymi wewnętrznymi strukturami ludzkiego ciała, takimi jak mózg czy serce, segmentacja narządów jamy brzusznej wydaje się trudniejsza ze względu na niski kontrast i duże zmiany kształtu w obrazach TK27,28. W celu rozwiązania tego trudnego problemu zaproponowano tutaj Swin-PSAxialNet.
Na etapie zbierania danych w ramach tego badania pobrano 200 obrazów z oficjalnej strony internetowej AMOS202224. Na etapie konfiguracji środowiska konfiguracja eksperymentalna obejmowała środowisko Paddlepaddle wraz z odpowiadającą mu wersją CUDA. Na etapie wstępnego przetwarzania danych zastosowano losowe przycinanie i losowe przerzucanie w celu zwiększenia niezawodności danych. W krokach trenowania i porównywania modelu, w oparciu o model bazowy nnU-Net, w eksperymencie dodano blok SPD do próbkowania w dół i blok ekstrakcji cech PSAA do próbkowania w górę, osiągając doskonałe wyniki segmentacji. Swin-PSAxialNet porównano z różnymi popularnymi modelami segmentacji i uzyskano obiecujące wyniki na publicznym zbiorze danych AMOS2022. Osiągnięto wyższą dokładność segmentacji niż inne metody segmentacji wymienione w tym badaniu 16,17,18,19. W części dotyczącej eksperymentu ablacyjnego użycie bloku PSAA i bloku SPD zostało zróżnicowane w celu znalezienia optymalnej sieci segmentacji. Wyniki eksperymentu ablacyjnego wskazały, że użycie modułu PSAA tylko do upsamplingu pozwala osiągnąć o jeden punkt procentowy więcej niż użycie go dla całej sieci.
Innowacje tego badania są następujące: Po pierwsze, moduł SPD jest włączony do sieci, aby stanowić jednostkę próbkowania w dół obok bloku Conv, zwiększając w ten sposób możliwości ekstrakcji cech sieci. Po drugie, wprowadzenie bloku ekstrakcji cech PSAA skutecznie zmniejsza złożoność sieci, jednocześnie poprawiając dokładność trenowania. Wreszcie, wprowadzenie mechanizmu współdzielenia parametrów znacznie zmniejsza złożoność modelu treningowego.
To badanie ma ograniczenia w następujących aspektach: Zostało ono zastosowane tylko do AMOS2022 zbioru danych, a wyniki nie zostały zweryfikowane na innych zestawach danych. Ponownie, chociaż nnU-Net osiągnął wysoką wydajność w zadaniach segmentacji narządów jamy brzusznej po serii optymalizacji jako zautomatyzowana struktura segmentacji, niektóre parametry nadal mają pewien stopień subiektywizmu, takie jak początkowa szybkość uczenia się, liczba iteracji, architektura sieci itp. Przyszłe badania będą dotyczyły metod automatycznego obliczania tych parametrów29.
W ramach projektu Swin-PSAxialNet osiągnięto doskonałe wyniki segmentacji w zadaniach związanych z segmentacją narządów jamy brzusznej, wykazując duże możliwości uogólniania i stabilność. W przyszłych badaniach zostaną wykorzystane dodatkowe zestawy danych w celu dalszego zbadania możliwości uogólnienia algorytmu i wprowadzenia poprawek do modelu. Co więcej, struktura algorytmu może być poddawana dalszej optymalizacji w celu zwiększenia ogólnej dokładności i solidności sieci. Celem jest zintegrowanie sieci z możliwościami multimodalnymi w celu przekształcenia jej w medyczny model multimodalny.
Oświadczenia
Autorzy deklarują brak konfliktu interesów.
Podziękowania
Badanie to było wspierane przez Projekt Inżynieryjny "333" prowincji Jiangsu ([2022]21-003), Program Ogólny Komisji Zdrowia Wuxi (M202205) oraz Fundusz Rozwoju Nauki i Technologii Wuxi (Y20212002-1), których wkład był nieoceniony dla sukcesu tej pracy". Autorzy dziękują wszystkim asystentom naukowym i uczestnikom badania za ich wsparcie.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| AMOS2022 zestaw danych | Żaden | Żaden | Zestawy danych do trenowania i testowania sieci. Link do strony internetowej: https://pan.baidu.com/s/1x2ZW5FiZtVap0er55Wk4VQ?pwd=xhpb |
| Komputer mainframe ASUS | ASUS (Międzynarodowa Sieć AS | https://www.asusparts.eu/en/asus-13020-01910200 | |
| CUDA w wersji 11.7 | Technologia NVIDIA | https://developer.nvidia.com/cuda-11-7-0-download-archive | |
| NVIDIA GeForce RTX 3090 | Technologia NVIDIA | https://www.nvidia.com/en-in/geforce/graphics-cards/30-series/rtx-3090-3090ti/ | |
| Środowisko wiosła | Baidu (Język baidu | Żaden | Przygotowanie środowiskowe do szkolenia sieciowego. Link do strony internetowej: https://www.paddlepaddle.org.cn/ |
| Wiosło Seg | Baidu (Język baidu | Żaden | Linia bazowa, której używamy: https://github.com/PaddlePaddle/PaddleSeg |
Bibliografia
- Liu, X., Song, L., Liu, S., Zhang, Y. A review of deep-learning-based medical image segmentation methods. Sustain. 13 (3), 1224(2021).
- Popilock, R., Sandrasagaren, K., Harris, L., Kaser, K. A. CT artifact recognition for the nuclear technologist. J Nucl Med Technol. 36 (2), 79-81 (2008).
- Rehman, A., Khan, F. G. A deep learning based review on abdominal images. Multimed Tools Appl. 80, 30321-30352 (2021).
- Schenck, J. F. The role of magnetic susceptibility in magnetic resonance imaging: Mri magnetic compatibility of the first and second kinds. Med Phys. 23 (6), 815-850 (1996).
- Palmisano, A., et al. Myocardial late contrast enhancement ct in troponin-positive acute chest pain syndrome. Radiol. 302 (3), 545-553 (2022).
- Chen, E. -L., Chung, P. -C., Chen, C. -L., Tsai, H. -M., Chang, C. -I. An automatic diagnostic system for CT liver image classification. IEEE Trans Biomed Eng. 45 (6), 783-794 (1998).
- Sagel, S. S., Stanley, R. J., Levitt, R. G., Geisse, G. J. R. Computed tomography of the kidney. Radiol. 124 (2), 359-370 (1977).
- Freeman, J. L., Jafri, S., Roberts, J. L., Mezwa, D. G., Shirkhoda, A. CT of congenital and acquired abnormalities of the spleen. Radiographics. 13 (3), 597-610 (1993).
- Almeida, R. R., et al. Advances in pancreatic CT imaging. AJR Am J Roentgenol. 211 (1), 52-66 (2018).
- Eisen, G. M., et al. Guidelines for credentialing and granting privileges for endoscopic ultrasound. Gastrointest Endosc. 54 (6), 811-814 (2001).
- Sykes, J. Reflections on the current status of commercial automated segmentation systems in clinical practice. J Med Radiat Sci. 61 (3), 131-134 (2014).
- He, K., Zhang, X., Ren, S., Sun, J. Deep residual learning for image recognition. 2016 IEEE Conference on Computer Vision and Pattern Recognition (CVPR). , Vegas, NV, USA. 770-778 (2016).
- Dosovitskiy, A., et al. An image is worth 16x16 words: Transformers for image recognition at scale. arXiv. arXiv. , 11929(2020).
- Ramachandran, P., et al. Stand-alone self-attention in vision models. Adv Neural Inf Process Syst. 32, NIPS2019 (2019).
- Vaswani, A., et al. Attention is all you need. Adv Neural Inf Process Syst. 30, NIPS2019 (2017).
- Chen, J., et al. TransUNET: Transformers make strong encoders for medical image segmentation. arXiv. , arXiv:2102 04396(2021).
- Liu, Z., et al. Swin transformer: Hierarchical vision transformer using shifted windows. Proc IEEE Int Conf Comput Vis. , 10012-10022 (2021).
- Cao, H., et al. Swin-UNET: Unet-like pure transformer for medical image segmentation. Comput Vis ECCV. , 205-218 (2022).
- Zhou, H. -Y., et al. nnformer: Interleaved transformer for volumetric segmentation. arXiv. arXiv. , arXiv:2109 03201(2021).
- Sunkara, R., Luo, T. No more strided convolutions or pooling: A new CNN building block for low-resolution images and small objects. Mach Learn Knowl Discov Databases. , 443-459 (2023).
- Çiçek, Ö, Abdulkadir, A., Lienkamp, S. S., Brox, T., Ronneberger, O. 3D U-Net: learning dense volumetric segmentation from sparse annotation. Med Comput Vis Bayesian Graph Models Biomed Imaging. 2016, 424-432 (2016).
- Kim, H., et al. Abdominal multi-organ auto-segmentation using 3D-patch-based deep convolutional neural network. Scientific reports. 10 (1), 6204(2020).
- Isensee, F., et al. nnu-net: Self-adapting framework for u-net-based medical image segmentation. arXiv. , arXiv:1809 10486(2018).
- Ji, Y., et al. A large-scale abdominal multi-organ benchmark for versatile medical image segmentation. Adv Neural Inf Process Syst. 35, 36722-36732 (2022).
- Liu, Y., et al. Paddleseg: A high-efficient development toolkit for image segmentation. arXiv. , arXiv:2101 06175(2021).
- Hatamizadeh, A., et al. UNETR: Transformers for 3D medical image segmentation. Proc IEEE Int Conf Comput Vis. , https://api.semanticscholar.org/CorpusID:232290634 574-584 (2022).
- Zhou, H., Zeng, D., Bian, Z., Ma, J. A semi-supervised network-based tissue-aware contrast enhancement method for ct images. Nan Fang Yi Ke Da Xue Xue Bao. 43 (6), 985-993 (2023).
- Ma, J., et al. Abdomenct-1k: Is abdominal organ segmentation a solved problem. IEEE Trans Pattern Anal Mach Intell. 44 (10), 6695-6714 (2021).
- Galván, E., Mooney, P. Neuroevolution in deep neural networks: Current trends and future challenges. IEEE Trans Artif Intell. 2 (6), 476-493 (2021).
Przedruki i uprawnienia
