Ta praca szczegółowo opisuje metody integracji danych multiomicznych (konkatenacja, transformacja i oparte na modelach). Łącząc dane z genomiki, epigenomiki, transkryptomiki, proteomiki, metabolomiki, metagenomiki, lipidomiki i glikomiki, uzyskuje się kompleksowe zrozumienie systemów biologicznych. Manuskrypt zawiera wskazówki krok po kroku, podkreślając ograniczenia, zalety i narzędzia do wizualizacji integracji multi-omicznej.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Kompleksowy protokół i przewodnik krok po kroku dotyczący integracji multi-omiki w badaniach biologicznych
W tym artykule
Podsumowanie
Streszczenie
Ten manuskrypt zawiera obszerny przewodnik krok po kroku dotyczący integracji danych multiomicznych w badaniach biologicznych.
Integracja danych multiomicznych odnosi się do procesu łączenia i analizowania danych mierzonych na tym samym zestawie próbek biologicznych za pomocą różnych technologii omicznych, takich jak genomika, epigenomika, transkryptomika, proteomika, metabolomika, mikrobiomy, lipidomika i glikomika. Mimo że podejścia multiomiczne mają podobne cele jak analizy jednoblokowe lub jednotomiczne (na przykład opis, dyskryminacja, klasyfikacja lub przewidywanie), są one w stanie uchwycić szersze spektrum informacji molekularnych, zapewniając w ten sposób głębsze zrozumienie systemów biologicznych i ich złożonych interakcji. Rzeczywiście, połączenie zbiorów danych multi-omicznych umożliwia poprawę dokładności prognozowania i daje bardziej wiarygodne wyniki, zwłaszcza w przypadkach, gdy liczba dostępnych próbek jest ograniczona. Co więcej, również dzięki najnowszym osiągnięciom technik uczenia maszynowego, analizy multiomiczne są obecnie odpowiednie do odkrywania ukrytych wzorców i złożonych zjawisk powstających wśród różnych związków biologicznych.
Głównym celem tej pracy jest przedstawienie pełnego protokołu, który jest powszechnie stosowany w badaniach multiomicznych, od wstępnego sformułowania problemu do narzędzi przydatnych do biologicznej interpretacji wyników. W artykule szczegółowo opisano różne metody integracji danych multiomicznych, w tym podejścia oparte na konkatenacji (niskopoziomowe), transformacyjne (mid-level) i modelowe (high-level), a także podkreślono ich ograniczenia i zalety, a także przedstawiono ogólne narzędzia wizualizacyjne i diagnostyczne.
Wprowadzenie
Dziedzina badań biologicznych odnotowała znaczący postęp w ostatnich latach, szczególnie w dziedzinie technologii omicznych. Technologie te dostarczają cennych informacji na temat złożonej natury systemów biologicznych. Jednak każda technologia omiczna oferuje unikalną perspektywę na komponenty biologiczne, co wymaga integracji danych multiomicznych w celu uzyskania kompleksowego zrozumienia.
Multiomika obejmuje różne klasy biomolekuł, które mogą być ilościowo zdefiniowane dzięki pojawieniu się nowych i potężnych technik sekwencjonowania o wysokiej przepustowości. Wśród różnych rodzajów technologii omicznych znajdują się genomika, epigenomika, transkryptomika, proteomika, metabolomika, metagenomika, lipidomika i glikomika. Genomika obejmuje badanie genomów organizmu, podczas gdy epigenomika koncentruje się na strukturze nośnej genomu, w tym na spoiwach białkowych i RNA, alternatywnych strukturach DNA i modyfikacjach chemicznych DNA. Transkryptomika obejmuje badanie wszystkich cząsteczek RNA, w tym mRNA, rRNA, tRNA i innych niekodujących RNA. Proteomika obejmuje badanie białek, w tym modyfikacje dokonywane w określonych grupach białek. Metabolomika koncentruje się na zespole małych cząsteczek (metabolitów) w matrycy biologicznej. Metagenomika polega na badaniu zbiorowisk drobnoustrojów w dobrze zdefiniowanych siedliskach o określonych właściwościach fizykochemicznych. Lipidomika obejmuje badanie całego zestawu lipidów komórkowych, podczas gdy glikomika koncentruje się na badaniu glikomu, w tym węglowodanów i cukrów1.
Integracja danych multiomicznych zyskuje coraz większe zainteresowanie w społeczności naukowej ze względu na jej potencjał do odkrywania złożonych zjawisk biologicznych. Łącząc dane z wielu technologii omicznych, naukowcy mogą przezwyciężyć ograniczenia poszczególnych zestawów danych i uzyskać bardziej holistyczne spojrzenie na systemy biologiczne. To zintegrowane podejście umożliwia identyfikację nowych biomarkerów, odkrycie mechanizmów chorobowych i wyjaśnienie skomplikowanych szlaków biologicznych.
Liczba cytowań terminów "Multiomics" i "Multi-omics" w PubMed znacznie wzrosła na przestrzeni lat, z 307 w 2018 r. do 1414 w 2021 r. do 3933 w 2023 r. Integracja różnych typów zmiennych omicznych staje się coraz bardziej powszechna, ponieważ pozwala na głębsze badanie mechanizmów leżących u podstaw chorób i dysfunkcji organizmów. Podejścia jednoomiczne zapewniają ograniczony, częściowy wgląd w ukrytą biologię, ponieważ koncentrują się na jednej perspektywie. Jednak integrując dane multiomiczne, możemy rzucić światło na wzajemne oddziaływanie różnych biomolekuł, zrozumieć relacje w wielu warstwach i wypełnić lukę między genotypem a fenotypem. Ogólnie rzecz biorąc, podejścia multiomiczne mogą pomóc w znalezieniu odpowiedzi na ważne pytania, takie jak klasyfikacja różnych podgrup chorób, przewidywanie podstawowych biomarkerów związanych z chorobą oraz lepsze zrozumienie szlaków i mechanizmów biologicznych. W poniższych sekcjach różne zestawy danych omicznych mogą być również nazywane "widokami" danych lub "blokami" danych.
Techniki integracji multi-omicznej można podzielić na trzy główne podgrupy, jak opisali Reel et al. (2021)2 i Ritchie et al. (2015)3 (Rysunek 1).
Niskopoziomowa, wczesna integracja lub konkatenacja: To podejście polega na łączeniu zmiennych z każdego pojedynczego zestawu danych w jedną macierz. Jednak wczesna integracja nie uwzględnia unikalnego rozkładu każdego typu danych omicznych i może przypisywać większą wagę niektórym typom danych omicznych o większych wymiarach. Stwarza to również wyzwania, takie jak zwiększone ryzyko klątwy wymiarowości, dodatkowy szum, wysoce skorelowane zmienne i problemy ze skalowalnością obliczeniową. Pomimo tych ograniczeń, wczesna integracja pozwala na identyfikację skoordynowanych zmian w wielu warstwach omicznych i poprawia interpretację biologiczną.
Średni, średni poziom integracji lub oparty na transformacji: W tym podejściu, matematyczne modele integracji są stosowane do wielu warstw danych omicznych. Integracja środkowa koncentruje się na fuzji podzbiorów lub reprezentacji wyodrębnionych ze źródeł. Dwa podejścia cząstkowe w ramach integracji środkowej to podejście środkowe i podejście środkowe. Podejście środkowe polega na konkatenacji wyników uzyskanych w wyniku redukcji wymiarowości w każdym bloku, dzięki czemu nadaje się do obsługi danych heterogenicznych. Może jednak brakować możliwości interpretacji. Podejście środkowe obejmuje wybór zmiennych lokalnych i późniejszą analizę połączonych podzbiorów zmiennych, co pozwala na łatwiejszą interpretację modeli. Środkowa integracja oferuje takie korzyści, jak lepszy stosunek sygnału do szumu, zmniejszona wymiarowość i lepsza moc statystyczna.
Wysokopoziomowe, późna integracja lub oparte na modelu: To podejście polega na przeprowadzaniu analiz na każdym poziomie omicznym i łączeniu wyników w sposób ad-hoc. Obejmuje on fuzję wyników z pojedynczych modeli blokowych w celu identyfikacji biomarkerów z każdego źródła i zapewnienia wspólnej interpretacji wyników. Późna integracja nie zwiększa wymiarowości przestrzeni wejściowej i działa z unikalną dystrybucją poszczególnych danych omicznych. Jest to szczególnie odpowiednie, gdy jedna warstwa omiczna jest bardziej predykcyjna niż inne. Jednak późna integracja może przeoczyć relacje krzyżowe i stanąć przed wyzwaniami związanymi z brakiem zrozumienia powiązań między początkowymi blokami danych i potencjalną utratą informacji biologicznej w wyniku indywidualnego modelowania.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
1. Definicja pytania (pytań) badawczych
- Jasno sformułuj konkretne pytania badawcze, na które zostanie udzielona odpowiedź poprzez integrację multiomiki. Na przykład, pytanie badawcze 1: Jakie zmiany w ekspresji białek i profilach metabolitów korelują z odpowiedzią na leczenie? Pytanie badawcze 2: W jaki sposób warianty genetyczne wpływają na wzorce ekspresji genów u pacjentów z daną chorobą? Pytanie badawcze 3: W jaki sposób integracja określonych warstw omicznych pozwala na kompleksowe zrozumienie konkretnego procesu biologicznego lub mechanizmu choroby?
- Rozważ zastosowanie wielu technologii omicznych w celu poszukiwania biomarkerów lub uzyskania wglądu w mechanizmy złożonych chorób. Należy pamiętać, że w celu stratyfikacji pacjentów może być konieczne zwiększenie liczebności próby.
2. Wybór omik
- Zidentyfikuj technologie omiczne najbardziej odpowiednie dla postawionego pytania (pytań) badawczych oraz badanego systemu biologicznego. Na przykład, w przypadku pytania 1 właściwymi technologiami omicznymi są proteomika i metabolomika; dla pytania badawczego 2 genomika i transkryptomika; a dla pytania badawczego 3 kilka różnych technologii omicznych.
- Przy wyborze optymalnych warstw omicznych weź pod uwagę cel badania oraz dostępne zasoby. Przykłady obejmują metabolomikę w badaniach nad żywieniem, genomikę i transkryptomikę w biologii nowotworów oraz proteomikę w badaniach nad różnymi chorobami.
3. Zapewnienie jakości danych
UWAGA: Należy zapewnić wiarygodność danych oraz powtarzalność danych omicznych generowanych zgodnie z poniższymi krokami.
- Starannie zaplanuj eksperyment i zachowaj spójne warunki doświadczalne oraz metody pobierania próbek we wszystkich warstwach omicznych, aby zminimalizować efekty seryjne.
- Postępuj zgodnie z uznanymi protokołami i wdróż środki kontroli jakości podczas generowania danych dla każdego zestawu danych omicznych.
- W odpowiednich przypadkach stosuj standardy wewnętrzne lub zewnętrzne.
- Wykonuj kontrole jakości w poszczególnych zestawach danych omicznych.
- W przypadku danych genomowych oceniaj takie parametry jak wyniki jakości odczytów, skład zasad i głębokość sekwencjonowania, aby zapewnić wysoką jakość danych sekwencyjnych, a także jakość dopasowania i mapowania oraz jakość wywoływania wariantów, w tym częstotliwość alleli, głębokość odczytu i adnotację wariantów.
- W przypadku danych transkrypcyjnych oceniaj takie parametry jak rozkład długości odczytów, skład zasad i wyniki jakości Phred podczas oceny jakości odczytów oraz liczbę transkryptyów na milion (TPM) lub liczbę fragmentów na kilobaza transkrypcyjna na milion zmapowanych odczytów (FPKM) podczas oceny jakości kwantyfikacji transkryptyvów.
- W przypadku danych proteomicznych, oceniając jakość danych z spektrometrii mas, uwzględnij odpowiednie parametry, takie jak rozkład intensywności piku, stosunek sygnału do szumu i dokładność masy, a podczas oceny jakości identyfikacji i kwantyfikacji białek analizuj pokrycie sekwencji peptydów, wynik identyfikacji białka, wskaźnik fałszywych odkryć (FDR) oraz powtarzalność pomiarów zawartości białek.
- W przypadku danych metabolomicznych, oceniając jakość danych z spektrometrii mas, analizuj odpowiednie parametry, takie jak rozkład intensywności piku, stosunek sygnału do szumu i dokładność masy, a podczas oceny jakości identyfikacji metabolitów dopasowuj widma mas do baz referencyjnych lub wykorzystuj wzorce fragmentacji do wyjaśniania struktury.
4. Przetwarzanie wstępne danych
- Próbki pokrywające się
- Uwzględnij tylko te próbki, które występują we wszystkich analizowanych zestawach danych omicznych.
- Wyklucz bloki z niewystarczającą liczbą wspólnych próbek w porównaniu do innych bloków.
- Imputacja brakujących wartości
- Przetwarzaj brakujące wartości, stosując metody statystyczne lub uczenia maszynowego.
- Wykorzystaj techniki takie jak metoda najmniejszych kwadratów adaptacyjnych (LSA) do imputacji brakujących wartości.
- Unikaj usuwania wierszy z brakującymi danymi, szczególnie w przypadku ograniczonej liczby próbek.
- Wyklucz zmienne z wysokim odsetkiem brakujących wartości (np. 25% lub 30% brakujących wartości w próbach).
- Standaryzacja
- Przeprowadź manipulację danymi, aby zapewnić spójne skalowanie cech.
- Zapobiegaj dominacji cech o większym wpływie nad cechami o mniejszym wpływie.
- Zastosuj powszechne przekształcenia, takie jak transformacja logarytmiczna, centrowanie i skalowanie.
UWAGA: Przekształcenia powinny być starannie dobrane, aby zachować interpretowalność oryginalnych danych.
- Identyfikacja wartości odstających
- Wykrywaj wartości odstające i ekstremalne, korzystając z takich narzędzi jak wykresy pudełkowe lub analiza odległości od mediany wartości.
- Postępuj z wartościami odstającymi za pomocą odpowiednich metod, takich jak transformacja danych lub ich usunięcie.
5. Redukcja wymiarowości
UWAGA: Istnieją dwa podejścia do redukcji wymiarowości: usuwanie zmiennych szumowych i nadmiarowych (wybór cech) lub łączenie cech w celu stworzenia bardziej znaczących zmiennych (ekstrakcja cech).
- Określ, czy celem badania jest predykcja (np. budowa modelu zdolnego do przewidzenia, czy badany jest zdrowy, czy chory), czy analiza (np. które zmienne są biomarkerami danej choroby).
UWAGA: Jeśli celem badania jest analiza, bardziej odpowiednia jest selekcja cech, ponieważ ekstrakcja cech może prowadzić do utraty interpretowalności. - W przypadku danych o wysokiej wymiarowości ważne jest wybranie zmiennych istotnych dla badanego zjawiska, aby ułatwić analizę i interpretację, zmniejszyć zapotrzebowanie na zasoby obliczeniowe oraz usunąć szum i redundantne informacje, które mogłyby zaburzyć wyniki.
- Selekcja cech
- Zidentyfikuj podzbiór cech informacyjnych dla badanego zjawiska.
- Zastosuj metody selekcji cech sklasyfikowane w kategoriach takich jak metody filtrujące (filter), opakowujące (wrapper), wbudowane (embedded) i hybrydowe. W przypadku multiomiki można zastosować również metody selekcji biomarkerów.
UWAGA: Przy wyborze odpowiedniej metody należy wziąć pod uwagę charakterystykę zbioru danych. Metody opakowujące zapewniają najdokładniejsze modele predykcyjne, ale wymagają znacznie dłuższego czasu obliczeń niż metody filtrujące lub wbudowane. Tabela podsumowująca zalety i wady różnych metod selekcji i ekstrakcji cech znajduje się w Tabeli 1. - Zrównoważ wydajność końcowego modelu z nakładem pracy obliczeniowej wymaganej do selekcji cech.
- Zoptymalizuj liczbę wybranych cech, aby uniknąć niedopasowania (underfitting) lub przeuczenia (overfitting).
UWAGA: Przykłady ryzyka przeuczenia omówiono w poprzednio opublikowanej pracy. - Oceń wydajność modelu za pomocą takich metryk jak dokładność (accuracy), pole pod krzywą (AUC) lub zrównoważony wskaźnik błędu (BER).
- Ekstrakcja cech
- Przekształć surowe dane w zredukowany zestaw znaczących cech:
- Zastosuj techniki takie jak analiza głównych składowych (PCA), aby zidentyfikować ważne wzorce i zależności poprzez rzutowanie danych na przestrzeń o niższej wymiarowości.
- Wykorzystaj t-SNE do wizualizacji danych wysokowymiarowych przy zachowaniu lokalnych podobieństw.
- Rozważ liniową analizę dyskryminacyjną (LDA) w celu maksymalizacji separacji klas.
- Wykorzystaj autoenkodery do nauki skompresowanych reprezentacji danych za pomocą sieci neuronowych.
UWAGA: Ekstrakcja cech może prowadzić do powstania reprezentacji, które są trudniejsze do zinterpretowania. Tabela 1 zawiera wybrane przykłady metod selekcji i ekstrakcji cech5.
- Przekształć surowe dane w zredukowany zestaw znaczących cech:
6. Wybór metody integracji
- Zidentyfikuj najodpowiedniejszą metodę lub metody integracji do zastosowania w analizie danych.
- Jeśli próbki są dopasowane i dostępna jest wystarczająca liczba kompletnych podmiotów, należy zastosować metodę wczesnej integracji.
- Jeśli należy uwzględnić interakcje międzywarstwowe, nie należy stosować metody późnej integracji.
- Jeśli sygnały mogą być subtelne, ale spójne we wszystkich warstwach, metoda wczesnej integracji może być bardziej odpowiednia niż metoda późnej integracji.
- Jeśli istotne jest wykorzystanie wzajemnych powiązań danych między różnymi warstwami omicznymi, należy wybrać metodę średniej integracji.
- Integracja niskopoziomowa poprzez konkatenację
- Jeśli jeden (lub więcej) z bloków omicznych pozostaje znacznie większy pod względem liczby cech (zmiennych) niż pozostałe, należy zredukować jego (ich) wymiarowość zgodnie z krokami opisanymi w sekcji 5.
- Skonkatenuj zmienne z każdego pojedynczego zbioru danych omicznych w jedną szeroką macierz.
- Przekształć skonkatenowane zmienne tak, aby miały podobne zakresy i rozkłady.
- Użyj skonkatenowanej macierzy danych do dalszych analiz, takich jak zastosowanie algorytmów uczenia maszynowego lub strategii redukcji wymiarowości.
UWAGA: Najczęstszym sposobem przeprowadzania integracji niskopoziomowej jest konkatenacja. Jednak metody te mogą prowadzić do utraty relacji między blokami lub utraty specyficznych dla danych bloków informacji.
- Integracja średniopoziomowa
- Wybierz jedną z sześciu głównych kategorii integracji średniopoziomowej w zależności od celu analizy.
- Oparta na podobieństwie: Stosuj to podejście do oceny podobieństwa między różnymi próbkami lub cechami w celu zidentyfikowania wzorców lub podtypów chorób, w eksploracyjnej analizie danych, gdzie relacje nie są znane a priori. Przykład: SNF6.
- Oparta na korelacji: Stosuj tę metodę do identyfikacji i kwantyfikacji powiązań między różnymi zmiennymi, w szczególności do oceny, jak jedna zmienna zmienia się wraz ze zmianami drugiej. Przykład: CNAMet7.
- Oparta na sieciach: Stosuj metody oparte na sieciach do reprezentowania złożonych relacji między cechami. Jest to szczególnie przydatne do wykrywania klastrów w strukturze danych i przewidywania biomarkerów. Przykłady: NetICS8, PARADIGM9, scMoMtF10.
- Oparta na modelu bayesowskim: Stosuj to podejście, aby włączyć wiedzę a priori do analizy lub w przypadku występowania niepewności w danych. Jest to szczególnie przydatne do wnioskowania o podtypach chorób i przewidywania biomarkerów na podstawie modeli probabilistycznych. Przykłady: MOFA11, iClusterPlus12.
- Wielowymiarowa: Stosuj tę metodę do jednoczesnej analizy wielu zmiennych, zwłaszcza gdy interakcje między nimi są kluczowe dla zrozumienia systemu biologicznego. Jest ona przydatna zarówno do klasteryzacji, jak i odkrywania biomarkerów. Przykłady: mixOmics13, JIVE14,15.
- Oparta na fuzji: Stosuj tę metodę, aby połączyć dane z różnych warstw omicznych w jedne ramy analityczne, wykorzystując zalety każdego typu danych. Jest ona szczególnie przydatna w kompleksowych analizach wymagających integracji różnorodnych zbiorów danych. Przykłady: PFA16, PSDF17.
UWAGA: Dzięki silnemu przetwarzaniu statystycznemu lub modelowaniu technikami uczenia maszynowego, metoda ta może ograniczyć problemy występujące w przypadku integracji niskopoziomowej lub wysokopoziomowej.
- Zastosuj wybraną metodę do wieloomicznego zbioru danych.
- Wybierz jedną z sześciu głównych kategorii integracji średniopoziomowej w zależności od celu analizy.
- Integracja wysokopoziomowa
- Przeprowadź pełną analizę danych dla każdego pojedynczego bloku omicznego niezależnie.
- Wspólnie zinterpretuj wyniki uzyskane w poprzednim kroku.
7. Analiza statystyczna
- Analiza ekspresji różnicowej (DE)
- Przygotuj dane, upewniając się, że są one odpowiednio sformatowane i znormalizowane.
UWAGA: W zależności od użytych pakietów format i struktura danych mogą się różnić. Do analizy DE zaleca się stosowanie pakietów R, takich jak limma18, edgeR19 lub DESeq220. - Konstruuj macierz projektu, która zawiera oddzielne współczynniki dla każdej grupy eksperymentalnej, określając warunki eksperymentalne i przypisania do grup.
- Zaimplementuj model liniowy i zastosuj go do każdej cechy, włączając macierz projektu.
- Oblicz umiarkowane statystyki t oraz statystyki F, aby ocenić ekspresję różnicową.
- Użyj moderacji błędów standardowych metodą empirycznego Bayesa w celu oszacowania logarytmu szans (log-odds) ekspresji różnicowej.
- Określ progi istotności
- Przyjmij wartość p-value poniżej 0,05 w celu określenia istotności statystycznej.
- Ustaw progi logarytmicznej zmiany krotności (log-fold change) w zależności od rodzaju cechy:
- Dla metabolitów i białek zastosuj log-fold change na poziomie log2(1,1).
- Dla transkryptów zastosuj log-fold change na poziomie log2(1,5).
- Przygotuj dane, upewniając się, że są one odpowiednio sformatowane i znormalizowane.
- Klastrowanie
- Wybierz metodę/algorytm klastrowania do zastosowania.
UWAGA: Istnieją algorytmy klastrowania zaprojektowane specjalnie dla danych multiomicznych, takie jak NEMO21, iCluster22 oraz JIVE23. - Określ liczbę klastrów, jeśli metoda tego wymaga. Alternatywami do oszacowania optymalnej liczby klastrów są metoda łokciowa, wynik sylwetkowy (silhouette score) lub statystyka gap.
- Uruchom wybrany algorytm klastrowania na oczyszczonych danych.
- Zoptymalizuj parametry specyficzne dla algorytmu w razie potrzeby.
- Oceń jakość wyników klastrowania za pomocą wewnętrznych lub zewnętrznych miar walidacji, takich jak wynik sylwetkowy lub skorygowany indeks Rand (adjusted Rand index).
- Jeśli jest to odpowiednie i możliwe, zwaliduj przypisanie do klastrów przy użyciu niezależnych danych lub zestawu testowego, który został wcześniej wykluczony z analizy klastrowej.
- Wybierz metodę/algorytm klastrowania do zastosowania.
- Modelowanie predykcyjne
- Oceń potrzebę przeprowadzenia modelowania predykcyjnego w badaniu multiomicznym.
UWAGA: Modele predykcyjne można zastosować po integracji danych multiomicznych, aby porównać, jak zmienia się dokładność predykcji w klasyfikacji wyników w zależności od cech wybranych różnymi metodami. - Jeśli decyzja podjęta w kroku 7.3.1 jest pozytywna, przejdź do następnych kroków; w przeciwnym razie przejdź do kroku 8.
- Wybierz odpowiedni model predykcyjny do zastosowania.
UWAGA: Przykładem modelu do wykorzystania jest Random Forest (RF), algorytm uczenia maszynowego, który integruje wiele drzew decyzyjnych w celu uzyskania wyniku końcowego. - Dostrój parametry modelu (np. używając pakietu R caret).
- Podziel zestaw danych na zbiór treningowy i testowy (60-40% lub 80-20%) w sposób zrównoważony, aby zachować taką samą proporcję próbek z różnych grup.
- Uruchom model na zbiorze treningowym.
- Oblicz dokładność (accuracy) oraz wskaźnik F1 w zbiorze testowym, aby ocenić wydajność modelu.
- Powtórz kroki od 2 do 4 wielokrotnie (np. 1000 razy), aby zwiększyć losowość.
- Oblicz średnią z wyników kroku 5.
- Zaraportuj uśrednioną dokładność (Accuracy) i wskaźnik F1. Jeśli wyniki nie są satysfakcjonujące, wróć do kroku 1, aby poprawić dobór parametrów.
- Określ istotność cech, korzystając z przeciętnego spadku dokładności (DMA) oraz przeciętnego spadku nieczystości (MDI).
- Oceń potrzebę przeprowadzenia modelowania predykcyjnego w badaniu multiomicznym.
8. Interpretacja biologiczna:
- Wybierz narzędzie do analizy wzbogacenia szlaków (często stosowanymi narzędziami PEA są DAVID, GSEA, Enrichr oraz Metascape).
- Wprowadź listę genów lub białek do wybranego narzędzia do analizy wzbogacenia szlaków.
- Wybierz odpowiednią bazę danych szlaków, taką jak KEGG, Reactome lub GO, aby przeprowadzić analizę.
UWAGA: Narzędziem zaprojektowanym specjalnie dla danych multiomicznych jest Paintomics, który wykorzystuje bazy danych (KEGG, Reactome lub Mapman) do dostarczania informacji o funkcjonalnych zależnościach między tymi biomarkerami, a także o ich udziale w konkretnych procesach biologicznych25. - Uruchom analizę wzbogacenia szlaków za pomocą wybranego narzędzia i bazy danych.
- W razie potrzeby dostosuj parametry, takie jak próg istotności, listę genów tła lub metodę korekty.
- Zwizualizuj i oceń końcowe wyniki (m.in. wzbogacone szlaki, FDR, diagramy szlaków, mapy ciepła).
9. Eksperymenty walidacyjne i uzupełniające
- Walidacja techniczna
- Zweryfikuj, czy zastosowanie różnych technik analitycznych w odniesieniu do tych samych próbek pozwala na uzyskanie równoważnych wyników.
UWAGA: Na przykład wyniki uzyskane za pomocą proteomiki opartej na spektrometrii mas (MS) mogą zostać później zwalidowane przy użyciu testu immunologicznego, takiego jak enzymatyczny test immunosorpcyjny (ELISA).
- Zweryfikuj, czy zastosowanie różnych technik analitycznych w odniesieniu do tych samych próbek pozwala na uzyskanie równoważnych wyników.
- Zidentyfikuj eksperymenty uzupełniające w celu walidacji uzyskanych wyników.
- Jeśli to możliwe, powtórz odkrycie, analizując dane omiczne z niezależnej kohorty.
- W przypadku zastosowań klinicznych przeprowadź randomizowane badania kliniczne, aby wykazać ważność kliniczną otrzymanych wyników.
- Zaprojektuj i przeprowadź kontrolowane badanie z odpowiednią wielkością próby i randomizacją, aby ocenić skuteczność i bezpieczeństwo zidentyfikowanych biomarkerów lub punktów uchwytu.
- Zbierz istotne punkty końcowe badania klinicznego i zmierz wpływ zidentyfikowanych czynników na wyniki pacjentów.
10. Narzędzia do wizualizacji i diagnostyki
UWAGA: Do ilustracji wyników analizy danych można wykorzystać różne rodzaje wykresów, zapewniając wizualną reprezentację kluczowych ustaleń. Powszechnie stosowane wykresy to wykresy wulkaniczne (Volcano plots), mapy ciepła (heatmaps), wykresy Circos oraz wykresy Manhattan.
- Wykresy wulkaniczne (Volcano plots):
- Stosuj wykresy wulkaniczne do podsumowania wyników analizy ekspresji różnicowej (DEA).
- Przedstaw zależność między istotnością statystyczną a skalą zmian pomiędzy badanymi grupami.
- Identyfikuj kluczowe cechy do dalszej analizy na podstawie ich pozycji na wykresie.
- Mapy ciepła (Heatmaps):
- Wykorzystuj mapy ciepła do wizualizacji wartości zmiennej w różnych kategoriach.
- Używaj kolorów do wskazania intensywności zmiennej, co ułatwia identyfikację wzorców i klastrów w zestawach danych.
- Wykresy Manhattan (Manhattan plots):
- Stosuj wykresy Manhattan do efektywnego podsumowania wyników DEA i wizualizacji licznych punktów danych na jednym wykresie.
- Są one powszechnie stosowane w badaniach asocjacyjnych całego genomu (GWAS), ale znajdują zastosowanie również w badaniach multiomicznych.
- Wykresy Circos (Circos plots):
- Używaj wykresów Circos, czyli wizualizacji kolistych, do badania interakcji i korelacji pomiędzy różnymi cechami molekularnymi.
- Przedstawiaj zależności i powiązania między różnymi elementami w sposób kompleksowy i przejrzysty wizualnie.
UWAGA: Niniejsze badanie dostarcza przykładów reprezentatywnych wyników dla każdego z powyższych typów wykresów z wykorzystaniem testowego zestawu danych dotyczących nowotworów.
- Narzędzia diagnostyczne:
UWAGA: Narzędzia wizualizacyjne, wraz z metrykami wydajności, są bardzo istotne w celach diagnostycznych.- Wykorzystuj krzywe charakterystyki operacyjnej odbiornika (ROC) do oceny wydajności modeli klasyfikacji.
- Stosuj wykresy ładunków (loading plots) oraz wykresy analizy głównych składowych (PCA) do wizualizacji relacji i wzorców w danych.
UWAGA: Przykłady reprezentatywnych wyników dla każdego z tych wykresów z wykorzystaniem testowego zestawu danych dotyczących nowotworów znajdują się w sekcji Wyniki Reprezentatywne.
- Metryki wydajności dla klasyfikacji binarnej
UWAGA: Wszystkie poniższe metryki mogą zostać dostosowane do klasyfikacji wieloklasowej, jak w przedstawionym przykładzie, poprzez analizę każdej klasy w stosunku do pozostałych (one-vs-rest) dla każdej klasy.- Macierz pomyłek: Używaj macierzy pomyłek (Tabela 2), aby wskazać prawdziwie dodatnie i prawdziwie ujemne wyniki na przekątnej, prawdziwie ujemne w prawych dolnych blokach, fałszywie dodatnie w prawych górnych blokach oraz fałszywie ujemne w lewych dolnych blokach.
- Precyzja (Precision): Jest to proporcja poprawnie zidentyfikowanych przypadków dodatnich do wszystkich zidentyfikowanych jako dodatnie. Oblicz precyzję korzystając ze wzoru: TP/(TP + FP). Model o precyzji równej 1 nie generuje fałszywie dodatnich wyników. Jeśli model ma precyzję 0,5, oznacza to, że jest poprawny w połowie przypadków.
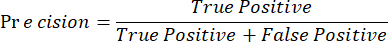
- Czułość (Recall lub sensitivity): Znana również jako współczynnik prawdziwie dodatnich lub wskaźnik trafień; jest to proporcja rzeczywistych przypadków dodatnich, które zostały poprawnie zidentyfikowane. Oblicz czułość korzystając ze wzoru: TP/(TP + FN) lub TP/pos, gdzie pos = TP + FN jest całkowitą liczbą przykładów dodatnich.
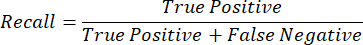
- Swoistość (Specificity): Jest to proporcja rzeczywistych przypadków ujemnych, które zostały poprawnie zidentyfikowane. Oblicz ją korzystając ze wzoru: TN/neg, gdzie neg = TN + FP jest całkowitą liczbą przykładów ujemnych.
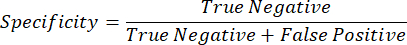
- Dokładność (Accuracy): Proporcja poprawnych przewidywań (zarówno dodatnich, jak i ujemnych). Oblicz dokładność korzystając ze wzoru:
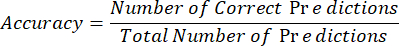
- Wskaźnik F (F-Score): Wskaźnik F to średnia harmoniczna czułości i precyzji. Oblicz go korzystając ze wzoru:
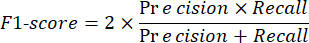
- Zrównoważona dokładność (Balanced accuracy): Zrównoważona dokładność (BAC) to średnia z czułości i swoistości. Oblicz ją korzystając ze wzoru:
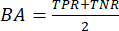
gdzie TPR oznacza współczynnik prawdziwie dodatnich (True Positive Rate) i odpowiada czułości, a TNR oznacza współczynnik prawdziwie ujemnych (True Negative Rate) i odpowiada swoistości. - Zrównoważony wskaźnik błędów (Balanced error rate): Zrównoważony wskaźnik błędów (BER) to średnia błędów dla każdej klasy. Oblicz go korzystając ze wzoru:
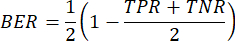
UWAGA: BER ma tę zaletę, że uwzględnia różnicę w wydajności między klasami poprzez tworzenie zrównoważonej miary wskaźnika błędów, ograniczając tym samym wpływ niezrównoważonego zestawu danych. Wskaźnik błędów wynoszący 0,5 oznacza wydajność zbliżoną do losowego zgadywania. W przypadku DIABLO, BER jest ważonym wskaźnikiem błędu klasyfikacji z każdego bloku, w zależności od korelacji między komponentami a badanym stanem. BER jest dopełnieniem BA do 1, tj. BER = (1 - BAC). - Pole pod krzywą: Oblicz pole pod krzywą (AUC) jako powierzchnię pod krzywą ROC (opisaną w następnej sekcji), uzyskaną poprzez wykreślenie czułości względem swoistości.
UWAGA: To, która z tych metryk jest najlepiej dostosowana do zadania, zależy od znaczenia wyników fałszywie ujemnych oraz równowagi lub braku równowagi między klasami. Precyzja koncentruje się na minimalizacji wyników fałszywie dodatnich, natomiast czułość na minimalizacji wyników fałszywie ujemnych. Jeśli proporcja przypadków dodatnich jest niska, sama precyzja może nie być najlepszym wskaźnikiem do oceny wydajności modelu. Kod Code.R jest dostarczony jako Plik Uzupełniający 1.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Podobnie jak w analizie pojedynczego typu danych omicznych (single-omics), wizualizacja ma kluczowe znaczenie dla eksploracji danych, ich integracji, rozpoznawania wzorców, formułowania hipotez oraz komunikowania wyników. W szczególności właściwa wizualizacja dużych zbiorów danych jest bardzo istotna podczas etapów wstępnego przetwarzania, pomagając w weryfikacji normalizacji, identyfikacji wartości odstających i wielu innych aspektach. W podejściu multiomikowym wizualizacja jest jeszcze bardziej kluczowa, ponieważ może ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Zidentyfikowanie najistotniejszego zestawu danych omicznych jest jednym z pierwszych kroków w badaniu integracji multi-omicznej. W badaniach żywieniowych metabolomika stanowi jedną z pierwszych warstw omiki, której należy się przyjrzeć, ponieważ może uwypuklić szlaki metaboliczne i procesy biochemiczne leżące u podstaw interwencji dietetycznej lub odpowiedzi metabolicznej na spożycie pokarmu. Z drugiej strony, na przykład w biologii nowotworów, genomika i transkryptomika, które dostarczają informacji o DNA, wariantach ge...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
E. A., R. R i O. C są pracownikami Société des Produits Nestlé SA.
Podziękowania
Autorzy dziękują za wsparcie dr Michaela Affoltera, dr Loïca Dayona, dr Jeana Philippe'a Godina, dr Francesca Giuffrida, dr Eugenii Migliavacca, prof. Anne-Florence Bitbol i prof. Zoltana Kutalika.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Apple M2 Pro macOS | Apple | 14.3 (23D56) | Przetwarzanie komputera |
| ggplot2 Pakiet R | r-project.org | 3.4.4 | Utwórz wizualizacje danych |
| ggpubr Pakiet R | r-project.org | 0.6.0 | Utwórz wykresy gotowe do publikacji |
| pakiet ggrepel R | r-project.org | 0.9.5 | Automatycznie umieszczaj nienakładające się etykiety tekstowe za pomocą ggplot2 |
| pakiet kratowy R | r-project.org | 0.22-5 | Grafika Tellis dla R |
| limma Pakiet R | r-project.org | 3.58.1 | Modele liniowe dla mixPakiet danych mikromacierzowych |
| Omics R | r-project.org | 6.25.1 | Projekt integracji danych omic |
| Pakiet NEMO R | r-project.org | 0.1.0 | Klastrowanie multiomiczne oparte na sąsiedztwie |
| R | r-project.org | 4.3.2 (2023-10-31) | Język programowania do obliczeń statystycznych i grafiki |
| R Studio | RStudio | 2023.12.1+402 (2023.12.1+402) | Zintegrowane środowisko programistyczne dla |
| R Pakiet SNFtool R | r-project.org | 2.3.1 | Pakiet Similarity network |
| fusion tidyr | r-project.org | 1.3.1 | Uporządkowany, niechlujny |
| miernik danych R pakiet | r-project.org | 1.3.0 | Uporządkowane charakterystyki wydajności modelu |
Bibliografia
- Hasin, Y., Seldin, M., Lusis, A. Multi-omics approaches to disease. Genome Biol. 18 (1), 83(2017).
- Reel, P. S., Reel, S., Pearson, E., Trucco, E., Jefferson, E. Using machine learning approaches for multi-omics data analysis: a review. Biotechnol Adv. 49, (2021).
- Ritchie, M. D., Holzinger, E. R., Li, R., Pendergrass, S. A., Kim, D. Methods of integrating data to uncover genotype-phenotype interactions. Nat Rev Genet. 16 (2), 85-97 (2015).
- Lan, W., He, G., Liu, M., Chen, Q., Cao, J., Peng, W. Transformer-Based Single-Cell Language Model: a survey. Big Data Min Analyt. 7 (4), 1169-1186 (2024).
- Li, Y., Mansmann, U., Du, S., Hornung, R. Benchmark study of feature selection strategies for multi-omics data. BMC Bioinformatics. 23 (1), (2022).
- Li, L., et al. Multi-omics data integration for subtype identification of Chinese lower-grade gliomas: a joint similarity network fusion approach. Comput Struct Biotechnol J. 20, 3482-3492 (2022).
- Louhimo, R., Hautaniemi, S. CNAmet: an R package for integrating copy number, methylation and expression data. Bioinformatics. 27 (6), 887-888 (2011).
- Dimitrakopoulos, C., et al. Network-based integration of multi-omics data for prioritizing cancer genes. Bioinformatics. 34 (14), 2441-2448 (2018).
- McLendon, R. Comprehensive genomic characterization defines human glioblastoma genes and core pathways. Nature. 455 (7216), 1061(2008).
- Lan, W., Ling, T., Chen, Q., Zheng, R., Li, M., Pan, Y. scMoMtF: an interpretable multitask learning framework for single-cell multi-omics data analysis. PLoS Comput Biol. 20 (12), e1012679(2024).
- Argelaguet, R., et al. MOFA+: a statistical framework for comprehensive integration of multi-modal single-cell data. Genome Biol. 21 (1), (2020).
- Mo, Q., et al. Pattern discovery and cancer gene identification in integrated cancer genomic data. Proc Natl Acad Sci USA. 110 (11), 4245-4250 (2013).
- Rohart, F., Gautier, B., Singh, A., Lê Cao, K. A. mixOmics: an R package for 'omics feature selection and multiple data integration. PLoS Comput Biol. 13 (11), (2017).
- O'Connell, M. J., Lock, E. F. R.JIVE for exploration of multi-source molecular data. Bioinformatics. 32 (18), 2877-2879 (2016).
- Lock, E. F., Hoadley, K. A., Marron, J. S., Nobel, A. B. Joint and individual variation explained (JIVE) for integrated analysis of multiple data types. Ann Appl Stat. 7 (1), 523-542 (2013).
- Shi, Q. Pattern fusion analysis by adaptive alignment of multiple heterogeneous omics data. Bioinformatics. 33 (17), 2706-2714 (2017).
- Yuan, Y., Savage, R. S., Markowetz, F. Patient-Specific Data Fusion defines prognostic cancer subtypes. PLoS Comput Biol. 7 (10), e1002227(2011).
- Smyth, G. K. Linear models and empirical bayes methods for assessing differential expression in microarray experiments. Stat Appl Genet Mol Biol. 3 (1), (2004).
- Robinson, M. D., McCarthy, D. J., Smyth, G. K. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. Bioinformatics. 26 (1), 139(2010).
- Love, M. I., Huber, W., Anders, S. Moderated estimation of fold change and dispersion for RNA-seq data with DESeq2. Genome Biol. 15 (12), (2014).
- Rappoport, N., Shamir, R. NEMO: cancer subtyping by integration of partial multi-omic data. Bioinformatics. 35 (18), 3348-3356 (2019).
- Shen, R., Olshen, A. B., Ladanyi, M. Integrative clustering of multiple genomic data types using a joint latent variable model with application to breast and lung cancer subtype analysis. Bioinformatics. 25 (22), 2906-2912 (2009).
- Biau, G., Scornet, E. A random forest guided tour. Test. 25 (2), 197-227 (2016).
- Rigatti, S. J. Random Forest. J Insur Med. 47 (1), 31-39 (2017).
- Hernández-De-Diego, R., et al. PaintOmics 3: a web resource for the pathway analysis and visualization of multi-omics data. Nucleic Acids Res. 46 (W1), W503-W509 (2018).
- Singh, A., et al. DIABLO - an integrative, multi-omics, multivariate method for multi-group classification. BioRxiv. , (2016).
- Koboldt, D. C., et al. Comprehensive molecular portraits of human breast tumours. Nature. 490 (7418), 61-70 (2012).
- Welham, Z., Déjean, S., LêCao, K. A. Multivariate analysis with the R package mixOmics. Methods Mol Biol. 2426, 333-359 (2023).
- Sharifi-Noghabi, H., Zolotareva, O., Collins, C. C., Ester, M. MOLI: multi-omics late integration with deep neural networks for drug response prediction. Bioinformatics. 35 (14), i501-i509 (2019).
- Chicco, D., Cumbo, F., Angione, C. Ten quick tips for avoiding pitfalls in multi-omics data integration analyses. PLoS Comput Biol. 19 (7), e1011224(2023).
- Lan, W., Liao, H., Chen, Q., Zhu, L., Pan, Y., Chen, Y. P. P. DeepKEGG: a multi-omics data integration framework with biological insights for cancer recurrence prediction and biomarker discovery. Brief Bioinform. 25 (3), 185(2024).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.