Bateria multimedialna do oceny ogólnych i szczegółowych umiejętności czytania jest niezawodną i ważną baterią multimedialną przeznaczoną do oceny poznawczych i podstawowych umiejętności czytania. Umożliwia wygenerowanie kompleksowego profilu sprawności poznawczej i czytania, co jest szczególnie korzystne dla dzieci z dysleksją.
Artykuł metodologiczny
Postęp w ocenie dysleksji u dzieci poprzez testy komputerowe
W tym artykule
Podsumowanie
Streszczenie
Nabywanie umiejętności czytania to skomplikowany proces, który wymaga kultywowania różnych umiejętności ogólnych i specyficznych dla danej dziedziny. W związku z tym nie jest zaskakujące, że wiele dzieci zmaga się z utrzymaniem biegłości na poziomie klasy, szczególnie w obliczu wyzwań obejmujących wiele umiejętności w obu dziedzinach, co obserwuje się u osób z trudnościami w czytaniu. Uderzające jest to, że pomimo tego, że trudności w czytaniu są jednymi z najczęstszych zaburzeń neurorozwojowych dotykających dzieci w wieku szkolnym, większość dostępnych narzędzi diagnostycznych nie ma kompleksowych ram do oceny pełnego spektrum umiejętności poznawczych związanych z dysleksją, przy minimalnych opcjach komputerowych. Warto zauważyć, że obecnie dostępne są ograniczone narzędzia z tymi funkcjami dla dzieci hiszpańskojęzycznych. Celem pracy było opracowanie protokołu diagnozowania trudności w czytaniu u dzieci hiszpańskojęzycznych z wykorzystaniem baterii multimedialnej Sicole-R. To narzędzie dla klas podstawowych koncentruje się na ocenie umiejętności poznawczych związanych z dysleksją, zgodnie z zaleceniami literatury naukowej. W szczególności koncentruje się na ocenie szeregu zdolności poznawczych, które, jak wykazały badania, są związane z dysleksją. Skupienie się na tym opiera się na obserwacji, że osoby z dysleksją zazwyczaj wykazują deficyty w kilku obszarach poznawczych ocenianych przez to narzędzie cyfrowe. Wykazano solidną spójność wewnętrzną i wielowymiarową strukturę wewnętrzną akumulatora. Ta multimedialna bateria okazała się odpowiednim narzędziem do diagnozowania dzieci z trudnościami w czytaniu w szkole podstawowej, oferując kompleksowy profil poznawczy, który jest cenny nie tylko do celów diagnostycznych, ale także do dostosowywania zindywidualizowanych planów nauczania.
Wprowadzenie
Dysleksja to zaburzenie neurorozwojowe charakteryzujące się trudnościami w dokładnym i/lub płynnym rozpoznawaniu słów oraz słabymi zdolnościami ortograficznymi i dekodacyjnymi, a także charakteryzuje się nieoczekiwanymi i uporczywymi trudnościami w nabywaniu umiejętności skutecznego czytania pomimo konwencjonalnego nauczania, odpowiedniej inteligencji i możliwości społeczno-kulturowych1. To zaburzenie neurobiologiczne często objawia się trudnościami w czytaniu, pisowni i pisaniu, głównie z powodu deficytów fonologicznych2,3. "Nie można przecenić znaczenia wczesnej identyfikacji dysleksji, ponieważ pozwala ona na szybką interwencję i wsparcie4,5. Kiedy uczeń nie wykracza poza poziom 3 w modelu odpowiedzi na interwencję, konieczne staje się przeprowadzenie bardziej kompleksowej oceny zarówno ogólnych, jak i specyficznych dla danej dziedziny zdolności związanych z dysleksją, jak podkreślono w literaturze naukowej. Rozwój przedstawionej tu techniki opiera się na konieczności przeprowadzenia dokładnych ocen w celu zapewnienia odpowiednich interwencji i wsparcia. Ponadto wcześniejsze badania podkreślają użyteczność narzędzi przesiewowych opartych na technologii, takich jak aplikacje internetowe i gry komputerowe, w ułatwianiu skutecznych procesów przesiewowych6, 7. Badania te łącznie podkreślają wieloaspektowy charakter dysleksji, podkreślając potrzebę kompleksowej oceny i strategii interwencyjnych w celu uwzględnienia różnorodnych profili poznawczych osób z dysleksją. Pomimo rozpowszechnienia dysleksji wśród dzieci w wieku szkolnym, większości dostępnych narzędzi diagnostycznych brakuje ram, które kompleksowo oceniałyby zarówno umiejętności ogólne, jak i specyficzne dla danej dziedziny. Co więcej, istnieje minimalna liczba opcji skomputeryzowanych, szczególnie dla populacji hiszpańskojęzycznych. Ta multimedialna bateria wypełnia te luki, wykorzystując technologię w celu ułatwienia szczegółowej oceny umiejętności poznawczych związanych z dysleksją.
Perspektywy teoretyczne i deficyty poznawcze w dysleksji
Różne modele teoretyczne, w tym teorie fonologiczne, szybkie przetwarzanie słuchowe, wizualne, wielkokomórkowe i móżdżkowe, mają na celu wyjaśnienie przyczyn dysleksji i informowanie o interwencjach (zobacz przegląd)8. Teoria fonologiczna przypisuje dysleksję trudnościom w przetwarzaniu dźwięków językowych 9, podczas gdy teoria szybkiego przetwarzania słuchowego łączy dysleksję z deficytami w postrzeganiu szybko zmieniających się dźwięków10. Teoria wizualna podkreśla wizualne aspekty trudności w czytaniu, a teoria magnokomórkowa wskazuje na upośledzenie szlaków przetwarzania wzrokowego i słuchowego11. Teoria móżdżku sugeruje, że dysleksja wynika z upośledzenia móżdżku wpływającego na kontrolę motoryczną i funkcje poznawcze12. Ramy opóźnionego zaangażowania neuronalnego (DNC) Nicolsona i Fawcetta zakładają, że wolniejsze nabywanie umiejętności i opóźniony rozwój sieci neuronowych mają kluczowe znaczenie dla dysleksji. Najnowsze modele, takie jak model deficytu wielorakiego, sugerują, że dysleksja jest złożonym zaburzeniem, na które wpływają czynniki genetyczne, poznawcze i środowiskowe13,14,15. Na przykład Ring i Black14 wspierają model deficytu wielorakiego, pokazując, że zarówno deficyty przetwarzania fonologicznego, jak i poznawczego przyczyniają się do heterogeniczności dysleksji. Soriano-Ferrer i wsp.15 przeprowadzili badanie z hiszpańskojęzycznymi dziećmi z dysleksją rozwojową (DD) i stwierdzili znaczne upośledzenie szybkości nazywania, werbalnej pamięci roboczej i świadomości fonologicznej (PA). Podobnie Zygouris i wsp.16 oraz Rauschenberger i wsp.6 podkreślają znaczenie narzędzi do badań przesiewowych w identyfikowaniu tych deficytów, przy czym osoby z dysleksją konsekwentnie osiągają niższe wyniki niż zazwyczaj osiągający wyniki.
Badanie podejść technologicznych w badaniach przesiewowych dysleksji: Spostrzeżenia z badań naukowych
Badania nad badaniami przesiewowymi w kierunku dysleksji ewoluowały w oparciu o trzy główne podejścia: strategie wczesnego wykrywania, wieloaspektowe metody badań przesiewowych łączące różne oceny oraz integrujące technologię w celu zwiększenia skuteczności17. Niedawny przegląd systematyczny Politi-Georgousi's18 podkreśla zmianę w kierunku większej liczby zastosowań do interweniowania w objawach dysleksji, a nie procesów przesiewowych, dostosowując się do integracji technologii w celu poprawy umiejętności czytania u uczniów z dysleksją. Istnieją różne narzędzia, takie jak Test Wczesnego Badania Przesiewowego Dysleksji (DEST) autorstwa Fawcetta i Nicolsona, który ocenia szybkość, umiejętności fonologiczne, zdolności motoryczne, funkcję móżdżku i wiedzę19. "Narzędzia komputerowe rozwinęły się, w tym aplikacja internetowa oceniająca umiejętności czytania i poznawcze u greckich dzieci20 oraz narzędzia Hautala et al.21 i Rauschenberg et al.6, które wykorzystują gry i uczenie maszynowe do wczesnej identyfikacji dysleksji. Ahmad i in. zintegrowali gry z sieciami neuronowymi, osiągając 95% dokładności w wykrywaniu22. Badania nad różnymi ortografiami podkreślają znaczenie świadomości fonologicznej i szybkiego, zautomatyzowanego nazywania w identyfikacji dysleksji23,24.
Wgląd w dysleksję wśród hiszpańskojęzycznych dzieci
Badania nad dysleksją u dzieci hiszpańskojęzycznych zostały znacznie zaawansowane dzięki zastosowaniu technologii Sicole-R. Jiménez i wsp. wykazali jego skuteczność w ocenie dysleksji w różnych grupach wiekowych, szczególnie w rozróżnianiu między dysleksją a typowymi czytelnikami na podstawie przetwarzania fonologicznego i składniowego we wczesnych latach szkoły podstawowej25. Guzmán i in. badali deficyty szybkości nazywania u dzieci z dysleksją z wyzwaniami fonologicznymi, podkreślając interakcje między dysleksją a szybkością nazywania mierzoną za pomocą zadań takich jak letter-RAN i number-RAN26. Dalsze badania Jiméneza i in. dotyczyły deficytów świadomości fonologicznej w różnych strukturach sylab27, podczas gdy Ortiz i in. badali deficyty percepcji mowy wśród hiszpańskich dzieci z dysleksją, ujawniając upośledzenia w rozwoju percepcji mowy niezależnie od kontrastu fonetycznego lub jednostki językowej28,29. Jiménez i in. zbadali hipotezę podwójnego deficytu dysleksji30, a następnie przeprowadzili analizy procesów poznawczych i różnic związanych z płcią w rozpowszechnieniu dysleksji31,32. Rodrigo i in. badali dostęp leksykalny wśród hiszpańskich dzieci z dysleksją33, a Jiménez i in. przyjrzeli się deficytom przetwarzania składniowego34. Wreszcie, Jiménez i in. badali procesy fonologiczne i ortograficzne w podtypach dysleksji, podkreślając różnice w wydajności trasy ortograficznej35. Badania te łącznie poszerzają naszą wiedzę na temat poznawczych i językowych wyzwań związanych z dysleksją w populacjach hiszpańskojęzycznych.
Przeprowadzone badania mają kilka wspólnych cech pod względem wieku i pochodzenia uczestniczących dzieci. Dzieci włączone do tych badań były w wieku od 7 do 14 lat. Większość badań koncentrowała się na dzieciach ze szkół podstawowych w wieku od 7 do 12 lat, z wyjątkiem tych, które obejmowały dzieci w wieku do 14 lat, zapewniając próbkę obejmującą okres od wczesnych lat szkolnych do okresu dojrzewania31,32. Uczestniczące w projekcie dzieci pochodziły głównie z Wysp Kanaryjskich w Hiszpanii. Ponadto niektóre badania obejmowały próbki z innych regionów Hiszpanii i Gwatemali31,32. Uczestnicy rekrutowali się zarówno ze szkół publicznych, jak i prywatnych, które pochodziły z obszarów miejskich i podmiejskich. Poziomy społeczno-ekonomiczne reprezentowane w tych badaniach wahają się od niskiego średniego do klasy robotniczej i średniej.
Razem, te pytania znacznie poszerzają nasze zrozumienie złożoności dysleksji, przyczyniając się do rozwoju badań nad dysleksją. Przystosowane do użytku w wielu krajach iberoamerykańskich, w tym w Hiszpanii, Gwatemali, Chile i Meksyku, narzędzie ułatwia ocenę dokładności i precyzji diagnostycznej w zróżnicowanej próbie hiszpańskojęzycznej na potrzeby tego badania.
To badanie miało na celu opracowanie protokołu diagnozowania hiszpańskojęzycznych dzieci z trudnościami w czytaniu przy użyciu specjalistycznej baterii multimedialnej. Głównym celem jest zapewnienie kompleksowego narzędzia oceny, które ocenia zarówno ogólne, jak i specyficzne dla danej dziedziny umiejętności związane z dysleksją.
Przegląd konfiguracji eksperymentalnej
SICOLE-R został zaprogramowany w Java 2 Platform Standard Edition (J2SE). Silnik bazy danych HSQL jest używany jako baza danych. Oprogramowanie zawiera 6 głównych modułów do oceny: 1) przetwarzanie percepcyjne, które obejmuje zadania związane z dźwięcznością, umieszczeniem i sposobem artykulacji; 2) przetwarzanie fonologiczne, które obejmuje izolację fonemów, usuwanie fonemów, segmentację fonemów i mieszanie fonemów; 3) szybkość nazywania, która obejmuje zadania szybkości nazywania cyfr, liter, kolorów i obrazów; 4) przetwarzanie ortograficzne, które obejmuje zadania morfologicznego rozumienia leksemów i sufiksów oraz rozumienia homofonowego; 5) przetwarzanie składniowe, w tym zadania związane z rodzajem, liczbą, słowami funkcyjnymi i strukturą gramatyczną; oraz 6) przetwarzanie semantyczne, które wpływa na zadania czytania ze zrozumieniem poprzez tekst informacyjny i narracyjny. Instrukcje dotyczące każdego zadania, którym towarzyszy jedna lub dwie próby (w zależności od zadania) i demonstracja, są dostarczane przez agenta pedagogicznego przed rozpoczęciem fazy testowania. Protokół aplikacji dla każdego zadania jest zilustrowany tutaj.
Przed podaniem baterii multimedialnej próbie badawczej, dokonano adaptacji modalności języka hiszpańskiego dla każdego kraju (tj. Meksyku, Gwatemali, Ekwadoru i Chile), w tym dostosowano słownictwo, obrazy i inne istotne treści. Warunki administracyjne były takie same we wszystkich krajach Ameryki Łacińskiej. Środowisko administracyjne w szkole musiało być ciche i wolne od hałasu, zakłóceń i zakłóceń. Czas podawania baterii multimedialnej wynosił od 3 do 4 sesji po 30 minut każda, w zależności od umiejętności i wieku ucznia. Ze względu na kompatybilność bazy danych z większością arkuszy kalkulacyjnych i systemów przetwarzania danych statystycznych, ewaluator może analizować wyniki każdego dziecka i każdego zadania. Jeśli chodzi o zbieranie danych, zastosowano dwa różne typy zadań: 1) zadania, w których egzaminator rejestruje ustne wypowiedzi uczniów, odnotowując sukcesy i błędy za pomocą zewnętrznej myszy, oraz 2) zadania wymagające od studentów samodzielnego wyboru opcji poprzez kliknięcie na nie.
Protokół
Ten protokół został przeprowadzony zgodnie z wytycznymi dostarczonymi przez Comité de Ética de la Investigación y Bienestar Animal (Komitet ds. Etyki Badań i Dobrostanu Zwierząt, CEIBA) na Universidad de La Laguna (ULL). Dane zostały zebrane w różnym czasie, zgodnie z programem nauczania każdego kraju, zbierając informacje wyłącznie od uczniów, których administracja edukacyjna, szkoły i rodzice wyrazili na to zgodę. Bateria testowa wykorzystana w tym badaniu jest zarejestrowana jako własność intelektualna i można uzyskać do niej dostęp na podstawie umowy o przeniesieniu z ULL. Aby uzyskać więcej informacji na temat tego, jak uzyskać baterię testową, zainteresowane strony mogą skontaktować się z Biurem Transferu Wiedzy (OTRI) pod adresem ULL.
1. Instalacja i przygotowanie SICOLE-R
- Użyj następującego kryterium włączenia, aby zastosować to narzędzie: uczniowie od drugiej do szóstej klasy. Stosuj następujące kryterium wykluczenia: nie uwzględniaj uczniów ze specjalnymi potrzebami edukacyjnymi, odnosząc się do tych, którzy potrzebowali wsparcia i ukierunkowanej uwagi edukacyjnej z powodu m.in. upośledzenia sensorycznego lub nabytych problemów neurologicznych.
UWAGA: Ocena jest przeprowadzana indywidualnie ze studentami w cichym pomieszczeniu z dostępem do komputera i dobrym oświetleniem. Słuchawki z dostosowanym mikrofonem będą niezbędne, aby ułatwić odbiór instrukcji dotyczących zadań i zwiększyć wydajność uczniów. - Aby zainstalować oprogramowanie na komputerze, uruchom plik jako administrator i kliknij ikonę, aby otworzyć narzędzie. Po otwarciu aplikacji pojawia się początkowy interfejs, wyświetlający różne opcje operacyjne.
- Uzupełnij informacje o uczniach, którzy będą wykonywać zadania przed rozpoczęciem oceny. Po wprowadzeniu ich danych zapisz ich na liście uczniów, a ich informacje można później zmodyfikować.
- Za każdym razem, gdy dodawany jest nowy uczeń, przed rozpoczęciem zadań pojawi się ekran testowy. Na tym ekranie poproś ucznia, aby stuknął w but, który pojawi się na ekranie.
UWAGA: Celem tej mini-gry jest ustalenie punktu odniesienia do oceny kontroli motorycznej uczniów. Pozwala na monitorowanie indywidualnych różnic w prędkości silnika, ponieważ oprogramowanie rejestruje odpowiedzi poprzez naciskanie na klawiaturze. Ta mini gra pojawia się tylko raz. - Przed rozpoczęciem oceny poproś egzaminatora o udzielenie następujących instrukcji: Teraz wejdziesz do środowiska wirtualnego cyrku z różnymi bramkami. Każda brama prowadzi do zabawnych zajęć, w których będziesz uczestniczyć. Klaun przeprowadzi Cię przez te bramki i wyjaśni, co robić w każdej czynności. Proszę usiąść obok egzaminatora i uważnie słuchać instrukcji. Upewnij się, że dajesz z siebie wszystko w każdym zadaniu. Ciesz się odkrywaniem i wykonywaniem tych zajęć!
- Rozpocznij zadania, wybierając ucznia, którego zaplanowano do oceny i klikając sekcję Rozpocznij. W menu głównym znajduje się 5 kolorowych drzwi, z których każde odpowiada jednemu z modułów do oceny.
- Każde zadanie zaczyna się od instrukcji wprowadzającej, poproś uczniów, aby zwrócili na to uwagę. Uczniowie są informowani o naturze gry i instruowani, jak w nią grać, co ułatwia im agent pedagogiczny. Upewnij się, że agent dostarcza ustne instrukcje do każdego zadania, ilustrując procedurę za pomocą modelu i przedstawiając przykłady do naśladowania przez uczniów.
- Po zakończeniu przykładów upewnij się, że agent pedagogiczny udzieli odpowiedniej informacji zwrotnej, umożliwiając uczniom ponowne wykonanie przykładu, jeśli został wykonany niepoprawnie, i rozpocznie się ocena.
UWAGA: Agent pedagogiczny to wirtualna postać, której zadaniem jest prowadzenie ucznia przez zadania. Ta rola wymaga, aby agent miał jasną i zrozumiałą mowę oraz potrafił udzielać wskazówek instruktażowych, modelować zadania i przekazywać informacje zwrotne na podstawie odpowiedzi uczniów. Agent pedagogiczny musi być zaprogramowany tak, aby reagował konsekwentnie i dokładnie, zgodnie z danymi wejściowymi ucznia podczas zadań.
2. Zadania SICOLE-R
- Yellow Door: Moduł przetwarzania percepcyjnego wykorzystujący zadanie percepcji mowy
- Otwórz program na komputerze. Przejdź do żółtych drzwi w interfejsie programu. Kliknij na jedno z dostępnych podzadań, aby rozpocząć zadanie: (1) udźwiękowienie, (2) sposób artykulacji i (3) umieszczenie.
- Pozwól agentowi pedagogicznemu udzielić uczniowi wskazówek instruktażowych i modelowania zadań. Agent powinien powiedzieć: Teraz usłyszymy pary sylab. Jeśli sylaby są identyczne, naciśnij niebieski przycisk; Jeśli są różne, naciśnij czerwony przycisk. Zobacz, jak to robię. Teraz twoja kolej z tymi przykładami.
- Przedstaw uczniowi dwa przykłady przedmiotów: /ba/-/pa/;/ja/-/ka/. Ponownie poinstruuj uczniów, aby wybrali niebieskie kółko, jeśli pary są identyczne, i czerwony przycisk, jeśli są różne.
- Po wykonaniu zadania upewnij się, że agent pedagogiczny udziela informacji zwrotnej na podstawie odpowiedzi ucznia w przykładach. Gdy przykłady są gotowe, pozwól agentowi poinstruować ucznia, aby zainicjował zadanie.
- Procedura wybierania kółek (niebieskich lub czerwonych) pozostanie spójna przez cały czas trwania zadania, rejestrując trafienia i chybienia. Jeśli uczeń musi ponownie usłyszeć parę sylab, kliknij ikonę głośnika, aby odtworzyć ją jeszcze raz. Należy pamiętać, że dozwolone jest tylko jedno dodatkowe odtworzenie każdego elementu.
- Różowe drzwi: Moduł świadomości fonologicznej
- Zadanie segmentacji fonemów
- Otwórz program na komputerze. Przejdź do różowych drzwi w interfejsie programu. Wybierz opcję Segmentacja fonemów, aby wybrać zadanie.
- Pozwól agentowi pedagogicznemu udzielić uczniowi wskazówek instruktażowych. Agent powinien powiedzieć: Teraz skupimy się na segmentacji fonemów. Zobacz, jak to demonstruję. Następnie zobaczysz dwa przykładowe elementy.
- Przedstaw uczniowi dwa przykładowe zadania. Poproś ucznia, aby odpowiedział na głos dla każdego słowa.
- Użyj zewnętrznej myszy, aby kliknąć niebieski przycisk, aby uzyskać poprawne odpowiedzi, i czerwony przycisk, aby uzyskać nieprawidłowe odpowiedzi. Upewnij się, że agent pedagogiczny oferuje informacje zwrotne w oparciu o odpowiedzi ucznia na przykłady.
- Po przykładach upewnij się, że agent pedagogiczny poinstruuje ucznia, aby rozpoczął zadanie.
- Zadanie mieszania fonemów
- Wejdź do programu na komputerze. Przejdź do różowych drzwi w interfejsie programu. Wybierz opcję Mieszanie fonemów, aby wybrać zadanie.
- Pozwól agentowi pedagogicznemu udzielić uczniowi wskazówek instruktażowych. Agent mówi: Teraz skupimy się na syntezie fonemów. Zobacz, jak to demonstruję. Następnie zobaczysz dwa przykładowe elementy.
- Przedstaw uczniowi dwa przykładowe zadania. Poproś ucznia, aby wyartykułował na głos swoje odpowiedzi dla każdego słowa.
- Użyj zewnętrznej myszy, aby kliknąć niebieski przycisk, aby uzyskać dokładne odpowiedzi, i czerwony przycisk, aby uzyskać niedokładne odpowiedzi. Upewnij się, że agent pedagogiczny udziela informacji zwrotnej na podstawie odpowiedzi ucznia na przykłady.
- Po przykładach pozwól agentowi pedagogicznemu skierować ucznia do zainicjowania zadania. Procedura pozostaje spójna przez cały czas wykonywania zadania, rejestrując zarówno dokładne, jak i niedokładne odpowiedzi.
- Jeśli uczeń musi ponownie wysłuchać słowa, kliknij ikonę papugi, aby wyświetlić powtórkę. Pamiętaj, że dozwolona jest tylko jedna powtórka dla każdego przedmiotu.
- Zadanie izolacji fonemów
- Otwórz program na komputerze. Przejdź do różowych drzwi w interfejsie programu. Kliknij Izolacja fonemów, aby wybrać zadanie.
- Pozwól agentowi pedagogicznemu udzielić uczniowi wskazówek instruktażowych i modelowania zadań. Agent powinien powiedzieć: Teraz skupimy się na izolowaniu fonemów. Zobacz, jak to demonstruję. Następnie zobaczysz dwa przykładowe elementy. Twoim zadaniem jest kliknięcie na obrazy, których nazwa zaczyna się tym samym dźwiękiem, co słowo docelowe.
- Przedstaw uczniowi dwa przykładowe zadania. Obserwuj, czy uczeń klika na obrazy, które zaczynają się od tego samego dźwięku, co słowo docelowe.
- Upewnij się, że agent pedagogiczny oferuje informacje zwrotne w oparciu o odpowiedzi ucznia na przykłady. Po zapoznaniu się z przykładami upewnij się, że agent prowadzi ucznia do rozpoczęcia zadania.
- Procedura pozostaje jednolita przez cały czas trwania zadania, dokumentując zarówno trafienia, jak i chybienia. Jeśli uczeń wymaga dodatkowego słuchania słowa, kliknij ikonę mówcy, aby je odtworzyć. Pamiętaj, że dozwolona jest tylko jedna powtórka dla każdego przedmiotu.
- Zadanie usuwania fonemów
- Otwórz program na komputerze. Przejdź do różowych drzwi w interfejsie programu. Wybierz opcję Usuwanie fonemów, aby wybrać zadanie.
- Pozwól agentowi pedagogicznemu udzielić wskazówek instruktażowych i zademonstrować zadanie uczniowi. Agent powinien powiedzieć: Teraz skupimy się na usuwaniu fonemów. Zobacz, jak to demonstruję. Następnie zobaczysz dwa przykładowe elementy.
- Przedstaw uczniowi dwa przykładowe zadania. Poproś ucznia, aby wypowiedział na głos swoją odpowiedź dla każdego słowa.
- Kliknij zewnętrzną myszą na niebieski przycisk, aby uzyskać poprawne odpowiedzi, i na czerwony przycisk, aby uzyskać nieprawidłowe odpowiedzi. Upewnij się, że agent pedagogiczny udziela informacji zwrotnej na podstawie odpowiedzi ucznia na przykłady.
- Po przykładach upewnij się, że agent pedagogiczny poinstruuje ucznia, aby zainicjował zadanie. Procedura pozostaje spójna przez cały czas wykonywania zadania, rejestrując zarówno poprawne, jak i niepoprawne odpowiedzi.
- Jeśli uczeń musi ponownie wysłuchać słowa, kliknij ikonę głośnika, aby wyświetlić powtórkę. Pamiętaj, że dozwolona jest tylko jedna powtórka dla każdego przedmiotu.
- Zadanie segmentacji fonemów
- Pomarańczowe drzwi: Szybkość nazewnictwa i moduły ortograficzne
- Zadanie szybkiego automatycznego nazewnictwa (RAN)
- Uzyskaj dostęp do programu na komputerze. Przejdź do pomarańczowych drzwi w interfejsie programu. Wybierz opcję Szybkość nazewnictwa, aby wybrać zadanie.
- Pozwól agentowi pedagogicznemu udzielić wskazówek instruktażowych i zademonstrować zadanie. Przedstaw przykład podzadania literowego RAN modułu szybkości nazewnictwa.
- Poproś uczniów, aby wyartykułowali swoje odpowiedzi na głos. Jeśli odpowiedź w przykładzie jest dokładna, wybierz niebieski przycisk na ekranie. Jeśli nie jest to poprawne, kliknij czerwony przycisk.
- Upewnij się, że agent pedagogiczny przekazuje informację zwrotną na podstawie odpowiedzi ucznia. Po przykładzie upewnij się, że agent pedagogiczny inicjuje zadanie.
- Rozpocznij zadanie, klikając lewym przyciskiem myszy, aby rozpocząć odmierzanie czasu. W trakcie zadania na ekranie pojawi się matryca elementów, w zależności od podzadania.
- Poproś ucznia, aby wymienił na głos i po kolei elementy matrycy. Jednocześnie udokumentuj wszelkie błędy popełnione przez ucznia.
- Dla każdego błędu użyj prawego przycisku myszy zewnętrznej, aby zarejestrować liczbę błędów. Gdy uczeń skończy nazywać elementy, ponownie naciśnij lewy przycisk, aby zakończyć czas i zakończyć zadanie dla tego podzadania. Po zakończeniu pierwszego podzadania (litera RAN) automatycznie pojawia się następne podzadanie (numer RAN), zgodnie z tą samą procedurą. Ten proces jest kontynuowany dla pozostałych podzadań (kolor RAN i obiektowa RAN).
- Zadanie Leksem i sufiksy
- Uzyskaj dostęp do programu na komputerze. Przejdź do pomarańczowych drzwi w interfejsie platformy i kliknij Leksymy i Sufiksy, aby wybrać zadanie.
- Pozwól agentowi pedagogicznemu zaoferować uczniowi wskazówki instruktażowe i modelowanie zadań, w tym przykładowy element, w którym uczeń używa zewnętrznej myszy, aby wybrać obraz odpowiadający słowu docelowemu.
- Upewnij się, że agent pedagogiczny przekazuje informację zwrotną na podstawie odpowiedzi ucznia na przykład, a następnie instruuje ucznia, aby rozpoczął zadanie.
- Utrzymuj spójność proceduralną przez cały czas wykonywania zadania, zachęcając ucznia do wybrania obrazu odpowiadającego słowu docelowemu dla każdego prezentowanego elementu i rejestrując zarówno poprawne trafienia, jak i nieudane odpowiedzi.
- Zadanie rozumienia homofonu
- Uzyskaj dostęp do programu na komputerze. Przejdź do pomarańczowych drzwi w interfejsie platformy. Kliknij Homophone Comprehension, aby wybrać zadanie.
- Pozwól agentowi pedagogicznemu zaoferować uczniowi wskazówki instruktażowe i modelowanie zadań. Przedstaw przykładowy element, prosząc ucznia o użycie zewnętrznej myszy w celu wybrania obrazu odpowiadającego słowu docelowemu.
- Upewnij się, że agent pedagogiczny przekazuje informację zwrotną na podstawie odpowiedzi ucznia na przykład i poinstruuj ucznia, aby rozpoczął zadanie zgodnie z przykładową prezentacją.
- Zachowaj spójność kroków proceduralnych przez cały czas wykonywania zadania. Zachęć ucznia, aby wybrał obrazek odpowiadający słowu docelowemu dla każdego prezentowanego elementu.
- Rejestruj zarówno poprawne trafienia, jak i nieodebrane odpowiedzi podczas wykonywania zadania.
- Zadanie szybkiego automatycznego nazewnictwa (RAN)
- Green Door: Moduł przetwarzania składniowego
- Zadanie związane z płcią
- Otwórz program na komputerze. Przejdź do zielonych drzwi w interfejsie programu. Kliknij Płeć, aby wybrać zadanie.
- Pozwól agentowi pedagogicznemu na dostarczenie uczniowi instrukcji i modelowania zadań. Przedstaw uczniowi dwa przykłady do wykonania, prosząc go o kliknięcie odpowiednich słów w każdym zdaniu zgodnie z umową dotyczącą płci za pomocą zewnętrznej myszy.
- Upewnij się, że agent pedagogiczny udziela informacji zwrotnej na podstawie odpowiedzi ucznia na przykłady. Postępując zgodnie z przykładową prezentacją, upewnij się, że agent pedagogiczny prowadzi ucznia do rozpoczęcia zadania.
- Przez cały czas wykonywania zadania zachowuj spójność procedury. Zachęć ucznia do kliknięcia odpowiednich słów w każdym zdaniu zgodnie z jego umową dotyczącą płci.
- Zbieraj zarówno poprawne, jak i niepoprawne odpowiedzi podczas wykonywania zadania.
UWAGA: W przeciwieństwie do języka hiszpańskiego, język angielski nie rozróżnia płci w swojej gramatyce.
- Zadanie numeryczne
- Otwórz program na komputerze. Przejdź do zielonych drzwi w interfejsie programu. Kliknij Numer, aby wybrać zadanie.
- Pozwól agentowi pedagogicznemu na dostarczenie uczniowi instrukcji i modelowania zadań. Przedstaw uczniowi dwa przykłady do wykonania, prosząc go o kliknięcie odpowiednich słów w każdym zdaniu zgodnie z ich zgodnością liczbową za pomocą zewnętrznej myszy.
- Upewnij się, że agent pedagogiczny udziela informacji zwrotnej na podstawie odpowiedzi ucznia na przykłady. Postępując zgodnie z przykładową prezentacją, upewnij się, że agent pedagogiczny prowadzi ucznia do rozpoczęcia zadania.
- Przez cały czas wykonywania zadania zachowuj spójność procedury. Zachęć ucznia, aby kliknął odpowiednie słowa w każdym zdaniu zgodnie z ich zgodnością liczbową.
- Zbieraj zarówno trafienia, jak i chybienia podczas wykonywania zadania.
UWAGA: W przeciwieństwie do hiszpańskiego, język angielski nie rozróżnia liczb w swojej gramatyce.
- Zadanie ze słowami funkcjonalnymi
- Otwórz program na komputerze. Przejdź do zielonych drzwi w interfejsie programu. Kliknij Funkcjonalne słowa, aby wybrać zadanie.
- Pozwól agentowi pedagogicznemu na dostarczenie uczniowi instrukcji i modelowania zadań. Przedstaw uczniowi dwa przykłady do wykonania, prosząc go o kliknięcie odpowiednich słów funkcyjnych w każdym zdaniu zgodnie z kontekstem zdania za pomocą zewnętrznej myszy.
- Upewnij się, że agent pedagogiczny udziela informacji zwrotnej na podstawie odpowiedzi ucznia na przykłady. Postępując zgodnie z przykładową prezentacją, upewnij się, że agent pedagogiczny prowadzi ucznia do rozpoczęcia zadania.
- Przez cały czas wykonywania zadania zachowuj spójność procedury. Zachęć ucznia do kliknięcia odpowiednich słów funkcyjnych w każdym zdaniu zgodnie z kontekstem zdania.
- Zbieraj zarówno poprawne, jak i niepoprawne odpowiedzi podczas wykonywania zadania.
- Zadanie struktury gramatycznej
- Otwórz program na komputerze. Przejdź do zielonych drzwi w interfejsie programu. Wybierz opcję Struktura gramatyczna, aby wybrać zadanie.
- Pozwól agentowi pedagogicznemu udzielić uczniowi instrukcji i demonstracji zadań. Przedstaw uczniowi dwa przykłady do wykonania, prosząc go o kliknięcie odpowiedniego zdania przy każdym obrazie za pomocą zewnętrznej myszy.
- Upewnij się, że agent pedagogiczny udziela informacji zwrotnej na podstawie odpowiedzi ucznia na przykłady. Postępując zgodnie z przykładową prezentacją, upewnij się, że agent pedagogiczny prowadzi ucznia do rozpoczęcia zadania.
- Przez cały czas wykonywania zadania zachowuj spójność procedury. Zachęć ucznia, aby za pomocą zewnętrznej myszy kliknął odpowiednie zdanie dla każdego obrazka.
- Przechwytuj zarówno poprawne, jak i niepoprawne odpowiedzi podczas wykonywania zadania.
- Zadanie związane z płcią
- Blue Door: Moduł przetwarzania semantycznego wykorzystujący zadanie czytania ze zrozumieniem
- Otwórz program na komputerze. Przejdź do niebieskich drzwi w interfejsie programu. Wybierz Owoce dla tekstu informacyjnego lub Tino's Getaway dla tekstu narracyjnego.
- Pozwól agentowi pedagogicznemu przekazać uczniowi instrukcje dotyczące zadań. Po wybraniu typu tekstu wyświetl go na ekranie.
- Uczeń musi przeczytać tekst i zapamiętać najistotniejsze informacje. Po zakończeniu czytania poproś ucznia, aby za pomocą zewnętrznej myszy kliknął strzałkę na ekranie, aby wskazać zakończenie czytania i przejść do następnej sekcji.
- Pozwól agentowi pedagogicznemu poinstruować ucznia, aby przeczytał pytania i wybrał poprawną odpowiedź za pomocą zewnętrznej myszy. Uczeń czyta pytania i odpowiednio dobiera poprawną odpowiedź.
3. Analiza danych
- Aby ocenić trafność konstrukcji i dokładność diagnostyczną baterii multimedialnej w populacji hiszpańskojęzycznej, należy użyć konfirmacyjnej analizy czynnikowej (CFA) i analizy krzywej charakterystyki pracy odbiornika (ROC).
- Wykonaj CFA, aby sprawdzić podstawową strukturę czynnikową baterii multimedialnej. Analiza ta pozwala na przetestowanie hipotezy, że dane pasują do predefiniowanej struktury w oparciu o oczekiwania teoretyczne.
- Oceń dopasowanie modelu za pomocą kilku wskaźników dopasowania, w tym porównawczego wskaźnika dopasowania (CFI), indeksu Tuckera-Lewisa (TLI), błędu aproksymacji średniej kwadratowej (RMSEA) i standaryzowanej średniej kwadratowej reszty (SRMR). Dobre dopasowanie modelu jest wskazywane przez wartości CFI i TLI większe niż 0,90, wartości RMSEA mniejsze niż 0,08 i wartości SRMR mniejsze niż 0,08.
- Aby określić dokładność diagnostyczną baterii multimedialnej, należy przeprowadzić analizę krzywej ROC. Metoda ta pozwala ocenić zdolność testu do prawidłowej klasyfikacji osób z trudnościami w czytaniu i bez nich. Obszar pod krzywą ROC (AUC) stanowi miarę ogólnej dokładności testu. AUC 0,5 oznacza brak zdolności diagnostycznej, podczas gdy AUC 1,0 oznacza doskonałą zdolność diagnostyczną.
- Zidentyfikuj optymalne punkty odcięcia dla akumulatora, analizując czułość i swoistość na różnych poziomach progowych.
- Wykorzystując zarówno analizę krzywej CFA, jak i ROC, należy przeprowadzić kompleksową ocenę baterii multimedialnej, potwierdzając jej trafność konstrukcyjną i dokładność diagnostyczną w populacji hiszpańskojęzycznej.
Wyniki
Badanie próbne
Próba obejmowała 881 uczestników z Hiszpanii (N = 325), Meksyku (N = 169), Gwatemali (N = 227) i Chile (N = 160), z których wszyscy byli rodzimymi użytkownikami języka hiszpańskiego. Próbę podzielono na dwie grupy: 451 osób w grupie z dysleksją (RD) oraz 430 osób w grupie czytelników o typowych osiągnięciach (NAR). Dzieci ze specjalnymi potrzebami edukacyjnymi – wymagające wsparcia i specyficznej uwagi edukacyjnej ze względu na dysfunkcje sensoryczne, problemy neurologiczne lub inne schorzenia – zostały wykluczone, ponieważ czynniki te są zazwyczaj stosowane jako kryteria wykluczające w przypadku trudności w nauce lub ciężkich zaburzeń behawioralnych, albo tymczasowo, albo na cały okres edukacji. Uczestnicy grupy RD zostali wybrani na podstawie kryteriów takich jak: IQ równe lub większe niż 80, centyl czasu czytania słów powyżej 75. centyla, centyl czasu czytania pseudosłów powyżej 75. centyla lub centyl poprawności czytania pseudosłów poniżej 25. centyla. Podobnie grupę NAR wybrano na podstawie porównywalnych kryteriów, z dodatkiem centyla zadania rozumienia tekstu PROLEC36 powyżej 25. centyla. Wszystkie centyle określono zgodnie z poziomem klasy uczestników. Klasyfikacja uczestników do tych grup opierała się na zadaniach czytania słów i czytania pseudosłów, z których każde składało się z oddzielnych bloków. W obu blokach uczestnicy otrzymali instrukcję, aby czytać na głos prezentowane bodźce werbalne tak szybko, jak to możliwe. Blok czytania słów obejmował 32 bodźce, natomiast blok czytania pseudosłów zawierał 48 bodźców. Znajomość słów kontrolowano zgodnie z kryteriami opisanymi przez Guzmana i Jimeneza37. Rejestrowano liczbę poprawnych odpowiedzi, błędów oraz czasy latencji, przy czym czasy latencji mierzono od pojawienia się każdego elementu do momentu rozpoczęcia odpowiedzi wokalnej ucznia. Blok czytania słów wykazał wysoką spójność wewnętrzną (α = .89), natomiast blok czytania pseudosłów wykazał jeszcze większą spójność wewnętrzną (α = .91). Rozkład uczniów z RD i NAR w poszczególnych klasach przedstawiał się następująco: w drugiej klasie było 30 uczniów NAR i 27 RD. W trzeciej klasie odnotowano 100 uczniów NAR oraz 88 RD. Czwarta klasa obejmowała 100 uczniów NAR i 116 RD. W piątej klasie było 100 uczniów NAR i 116 RD, natomiast w szóstej klasie 100 uczniów NAR i 104 RD. Aby ocenić różnice wiekowe w całej próbie oraz w obrębie każdego poziomu klasy, przeprowadzono jednoczynnikowe testy ANOVA. Wyniki nie wykazały istotnych różnic, a wszystkie wartości p przekroczały 0,05. Podobnie zbadano rozkład zmiennej płci za pomocą testu chi-kwadrat, gdzie wszystkie wartości p również przekroczyły 0,05.
Statystyka opisowa
Tabela 1 przedstawia statystyki opisowe (średnią i odchylenie standardowe) dla wieku oraz miar oceny. Dane zostały podzielone według płci, z rozróżnieniem między czytelnikami osiągającymi wyniki w normie a osobami z dysleksją w różnych krajach. Wyniki wykazały pozytywne i istotne statystycznie korelacje pomiędzy dużą liczbą miar oceny (patrz Tabela 2). Tabela przedstawia korelacje między miarami, obejmujące zakres od słabych do silnych. Korelacje poniżej 0,3 uznano za słabe, natomiast te powyżej 0,5 sklasyfikowano jako silne. Konkretne wartości korelacji podano wraz z ich odpowiednią klasyfikacją siły. Na przykład słabe korelacje (r < 0,3) obejmowały korelacje między blendowaniem a segmentacją (r = 0,354) oraz między usuwaniem a rozumieniem homofonów (r = 0,270). Umiarkowane korelacje (0,3 ≤ r < 0,5) zaobserwowano między strukturą gramatyczną a liczbą (r = 0,463) oraz słowami funkcyjnymi a strukturą gramatyczną (r = 0,512). Silne korelacje (r ≥ 0,5) są widoczne dla liczby i rodzaju (r = 0,642) oraz RAN obrazkowego i RAN kolorów (r = 0,442).
Tabela 1: Statystyki opisowe pomiarów. Tabela ta przedstawia średnią, odchylenie standardowe oraz inne statystyki opisowe dla poszczególnych pomiarów zawartych w narzędziu cyfrowym. AGE: wiek; NAR: czytelnicy osiągający standardowe wyniki (Normally Achieving Readers); RD: dysleksja/zaburzenia czytania; SEG: segmentacja; BLN: blendowanie; ISO: izolacja fonemów; DEL: usuwanie fonemów; HOM: rozumienie homofonów; R&S: rdzenie i przyrostki; GEN: rodzaj; NUM: liczba; FW: słowa funkcyjne; GRS: struktura gramatyczna; EXT: tekst ekspozycyjny; NAT: tekst narracyjny; VOC: dźwięczność artykulacji; MOA: sposób artykulacji; POA= miejsce artykulacji; DIG: RAN cyfr; LET: RAN liter; COL: RAN kolorów; PIC: RAN obrazków Prosimy kliknąć tutaj, aby pobrać tę tabelę.
Tabela 2: Współczynniki korelacji pomiarów.Tabela ta przedstawia współczynniki korelacji między różnymi pomiarami narzędzia cyfrowego, wskazując siłę i kierunek zależności między tymi pomiarami. SEG: Segmentacja; BLN: Blendowanie; ISO: Izolacja fonemów; DEL: Usuwanie fonemów; HOM: Rozumienie homofonów; R&S: Rdzenie i przyrostki; GEN: Rodzaj; NUM: Liczba; GRS: Struktura gramatyczna; FW: Słowa funkcyjne; EXT: Tekst ekspozycyjny; NAT: Tekst narracyjny; VOC: Głosowość artykulacji; MOA: Sposób artykulacji; POA= Miejsce artykulacji; DIG: RAN cyfr; LET: RAN liter; COL: RAN kolorów; PIC: RAN obrazków. Kliknij tutaj, aby pobrać tę tabelę.
Weryfikująca analiza czynnikowa
Przeprowadzono weryfikującą analizę czynnikową (CFA), aby ocenić proponowaną strukturę czynnikową baterii multimedialnej. Model obejmuje jeden czynnik drugiego rzędu oraz sześć zmiennych latentnych, z których każda reprezentuje odrębne moduły baterii multimedialnej. Konstrukty te obejmują świadomość fonologiczną (w tym zadania z segmentacji fonemicznej, izolacji, blendowania i usuwania), moduł morfo-ortograficzny (obejmujący zadania z rozumienia rdzeni, afiksów i homofonów), składnię (składającą się z zadań dotyczących rodzaju, liczby, struktury gramatycznej i słów funkcyjnych), percepcję mowy (obejmującą zadania dotyczące dźwięczności, sposobu artykulacji i miejsca artykulacji), rozumienie tekstu (obejmujące zadania z rozumienia tekstu ekspozycyjnego i narracyjnego) oraz szybkie automatyczne nazywanie (zadania z literami, kolorami, cyframi i obrazkami w ramach testu RAN). Aby zapewnić spójność wszystkich zadań w baterii multimedialnej (w zakresie od 0 do 1), zastosowano estymację z wykorzystaniem skalowania proporcji maksimum (POMS). Wyniki POMS obliczono dla zadań pomiarowych czasu (rdzenie i afiksy)38.
Analizy statystyczne i prezentacje graficzne wykonano przy użyciu oprogramowania R wersja 4.3.139, wykorzystując pakiety lavaan40, semTools41 oraz ggplot242. Dopasowanie modelu oceniono za pomocą różnych wskaźników dobroci dopasowania. Choć test chi-kwadrat dla dobroci dopasowania był istotny, χ2(df) = 632.01, p < .001, co sugeruje rozbieżność między modelem hipotetycznym a obserwowanymi danymi, należy zaznaczyć, że test chi-kwadrat jest wrażliwy na wielkość próby43. W związku z tym rozważono dodatkowe wskaźniki dopasowania.
Wskaźnik dopasowania porównawczego (CFI) wyniósł .961, co przekracza powszechnie przyjęty próg .95 i wskazuje na dobre dopasowanie do danych. Średniokwadratowy błąd aproksymacji (RMSEA) wyniósł .038, co wskazuje na ścisłe dopasowanie modelu do danych. Standaryzowana pierwiastkowa średnia kwadratowa reszt (SRMR) wyniosła .034, co znajduje się poniżej zalecanej wartości .05, sugerując idealne dopasowanie. Ładunki czynnikowe dla pozycji wynosiły od .36 do .81, co wskazuje na istotne ładunki dla ich odpowiednich czynników. Całkowita średnia wariancja wyekstrahowana (AVE) przekroczyła .50, co sugeruje odpowiednią trafność zbieżną, a całkowita niezawodność kompozytowa (CR) była powyżej .80, co wskazuje na dobrą niezawodność spójności wewnętrznej.
Podsumowując, wyniki CFA potwierdziły proponowaną strukturę czynnikową, wykazując dobry dopasowanie modelu, trafność zbieżną oraz rzetelność. Przedstawienie graficzne modelu znajduje się na Rysunku 1.
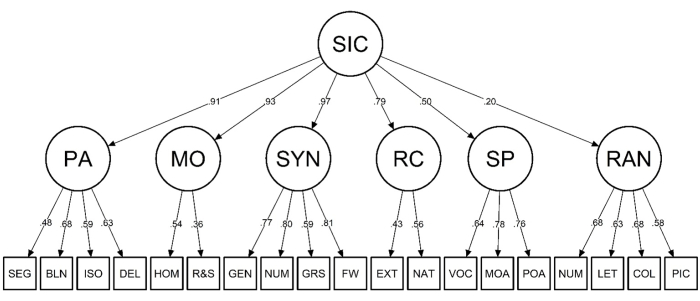
Rysunek 1: Analiza czynnikowa potwierdzająca. Na rysunku przedstawiono wyniki analizy czynnikowej potwierdzającej przeprowadzonej dla narzędzia cyfrowego, z zaznaczeniem ładunków czynnikowych oraz relacji między różnymi miarami przetwarzania poznawczego. Skróty: SIC= Sicole-R; PA= świadomość fonologiczna; SEG= segmentacja; BLN= blendowanie; ISO= izolacja; DEL= usuwanie; MO= przetwarzanie morfologiczne; HOM= rozumienie homofonów; R&S= rdzenie i afiksy; SYN= przetwarzanie syntaktyczne; GEN= rodzaj; NUM= liczba; GRS= struktura gramatyczna; FW= słowa funkcyjne; RC= rozumienie tekstu; EXT= tekst ekspozycyjny; NAT= tekst narracyjny; SP= percepcja mowy; VOC= dźwięczność artykulacji; MOA= sposób artykulacji; POA= miejsce artykulacji; RAN= szybkie nazywanie zautomatyzowane; NUM= RAN liczb; LET= RAN liter; COL= RAN kolorów; PIC= RAN obrazków. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Analizy niezmienniczości pomiarowej wykorzystano do sprawdzenia, czy struktura czynnikowa baterii multimedialnej była stabilna w zależności od płci. Testowanie niezmienniczości pomiarowej polega na serii porównań modeli, które definiują coraz bardziej rygorystyczne ograniczenia równości44. Przeprowadzono analizy statystyczne, stosując te same kryteria dopasowania modelu, co w poprzedniej analizie CFA. Stopniowo nakładano ograniczenia na parametry reprezentujące struktury: konfiguracyjną, metryczną (ładunki), skalarną (przechwyty) oraz ścisłą (residua)45. Słabe dopasowanie w którymkolwiek z tych modeli sugeruje, że aspekt poddany ograniczeniu nie funkcjonuje spójnie w różnych grupach. Stopień niezmienniczości określano łącznie, gdy χ2D wynosiło >0,05, a ΔCFI było <0,01. Podsumowanie wyników wskaźników modeli oraz różnic między nimi przedstawiono w Tabeli 3.
Tabela 3: Wskaźniki dopasowania modelu niezmienniczego.Tabela ta przedstawia wskaźniki dopasowania służące do testowania niezmienniczości modelu ze względu na płeć, oceniając, w jakim stopniu narzędzie cyfrowe zachowuje spójność swojej struktury i właściwości pomiarowych w grupach mężczyzn i kobiet. Wskaźniki te zapewniają niezawodność i trafność narzędzia, potwierdzając jego zdolność do spójnego pomiaru procesów poznawczych w różnych grupach płciowych. Kliknij tutaj, aby pobrać tę tabelę.
Model konfiguracyjny, w którym ograniczono jedynie konfigurację względną zmiennych w modelu, aby była taka sama w obu grupach, wykazał adekwatne dopasowanie do danych: χ2(292) = 745.970, p<.001, CFI = .964, SRMR = 0.034, RMSEA = .036, 90% CI (.033, .038). Model niezmienniczości metrycznej ograniczał konfigurację zmiennych oraz wszystkie ładunki czynnikowe, aby były stałe w poszczególnych grupach. Wskaźniki dopasowania były porównywalne z tymi z modelu konfiguracyjnego: χ2(310) = 768.56, p<.001, CFI = .963, SRMR = .037, RMSEA = .036, 90% CI (.033, .038). Niezmienniczość ładunków czynnikowych została potwierdzona przez nieistotne testy różnic oceniające podobieństwo modeli: χ2D (18) = 26.30, p =.09; ΔCFI = .001. W modelu niezmienniczości skalarnej konfiguracja, ładunki czynnikowe oraz średnie/punkty przecięcia wskaźników zostały ograniczone tak, aby były takie same dla każdej grupy. Wskaźniki dopasowania były mniej niż idealne: χ2(322) = 787,50, p<.001, CFI = .963, SRMS = .038, RMSEA = .035 (90% CI = .032, .038). Testy różnic oceniające podobieństwo modeli sugerowały występowanie niezmienniczości factorialnej: χ2D(12)=13.00, p = .369; ΔCFI = .001. Wreszcie, w modelu niezmienniczości ścisłej konfiguracja, ładunki czynnikowe, średnie/punkty przecięcia wskaźników oraz reszty zostały ograniczone tak, aby były takie same dla każdej grupy. Wskaźniki dopasowania były mniej niż idealne: χ2(341) =798.20, p<.001, CFI = .961, SRMS = .039, RMSEA = .0035 (90% CI = .032, .038). Niezmienniczość ścisła została potwierdzona przez nieistotne testy różnic oceniające podobieństwo modeli: χ2D(11) = 25.81, p<.001; ΔCFI =.002
Dokładność diagnostyczna
Aby ocenić dokładność i zdolność dyskryminacyjną baterii multimedialnej, przeprowadzono analizy krzywej charakterystyki operacyjnej odbiornika (ROC). Analiza ROC pomaga w wyznaczeniu optymalnego progu (wartości odcięcia) dla testu oceniającego w skali ciągłej, zapewniając równowagę między czułością (zdolnością do poprawnej identyfikacji wyników prawdziwie dodatnich) a swoistością (zdolnością do poprawnej identyfikacji wyników prawdziwie ujemnych). Dodatkowo analizę ROC wykorzystano do oceny zdolności testu do rozróżniania grup RD i NAR. W celu przeprowadzenia analizy obliczono wyniki Z dla każdego stopnia w każdym zadaniu baterii multimedialnej. Wynik całkowity stanowił suma wyników zeta. Analizy statystyczne i prezentacje graficzne wykonano przy użyciu programu R w wersji 4.3.1.41Pakiet pROC46 oraz ggplot242 wykorzystano pakiety. Pod względem dokładności diagnostycznej bateria multimedialna wykazała pole pod krzywą (AUC) wynoszące 94,39% [95% CI: 93,31%–96,24% (metoda DeLonga)] oraz czułość na poziomie 91,0 (Rycina 2Krzywe ROC w podziale na stopień zaawansowania wykazały następujące wskaźniki: stopień 2°, AUC = 96,195% [CI: 91,54%–100% (DeLong)], Se = 0,96, Sp = 0,90; stopień 3°, AUC = 95,3 [95% CI: 92,43%–98,18% (DeLong)], Se = 75,70, Sp = 72,34; 4° stopień, AUC=93,4 [95% CI: 90,2%–96,66% (DeLong)], Se=0,92, Sp=0,84; 5° stopień, AUC=95,9 [// 95% CI: 93,11%–98,75% (DeLong)], Se=0,90, Sp=0,95; 6° stopień, AUC=94,4 [95% CI: 91,11%–97,69% (DeLong)], Se=0,92, Sp=0,91.

Rycina 2: Analiza krzywej ROC. Na rysunku przedstawiono analizę krzywej ROC, która obrazuje dokładność diagnostyczną narzędzia cyfrowego poprzez zestawienie odsetka wyników prawdziwie dodatnich z odsetkiem wyników fałszywie dodatnich dla różnych wartości progowych. Jednostką na osi x krzywej ROC jest swoistość, a na osi y — czułość. Skróty: ROC = charakterystyka operacyjna odbiornika; AUC = pole pod krzywą. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Dyskusja
W tym badaniu zastosowano konfirmacyjną analizę czynnikową (CFA) do oceny struktury czynnikowej baterii Sicole-R, składającej się z jednego czynnika drugiego rzędu i sześciu zmiennych utajonych reprezentujących różne moduły. Wyniki wykazały dobre dopasowanie modelu, zbieżną trafność i niezawodność, potwierdzając skuteczność baterii w ocenie kompleksowego zestawu umiejętności poznawczych i czytania, które są krytyczne dla osób z dysleksją. Co ważne, konsekwentna wydajność narzędzia cyfrowego w różnych grupach demograficznych w Hiszpanii, Meksyku, Gwatemali i Chile sugeruje jego potencjalną użyteczność w placówkach edukacyjnych i klinicznych w różnych regionach hiszpańskojęzycznych.
Badanie to wnosi wkład do literatury, pokazując, w jaki sposób baterie multimedialne mogą być wykorzystywane do skutecznej identyfikacji określonych deficytów poznawczych związanych z dysleksją. Zdolność baterii do wskazywania określonych obszarów trudności, takich jak świadomość fonologiczna, percepcja mowy, szybkość nazywania, przetwarzanie ortograficzne, przetwarzanie składniowe i czytanie ze zrozumieniem, umożliwia dostosowane interwencje w celu skutecznego zaspokojenia indywidualnych potrzeb uczniów. Co więcej, wykazana spójność baterii we wszystkich płciach podkreśla jej przydatność w promowaniu sprawiedliwych praktyk oceny, wspierając w ten sposób inicjatywy w zakresie edukacji włączającej mające na celu zapewnienie równych szans wszystkim uczniom.
Chociaż poprzednie narzędzia o podobnych cechach zostały zaprojektowane do użytku w języku angielskim, takie jak Test Wczesnego Badania Przesiewowego Dysleksji (DEST) zaproponowany przez Fawcetta i Nicolsona17, który ocenia wiele dziedzin, badanie to wykazało możliwość zastosowania i skuteczność baterii multimedialnej w innym kontekście językowym. W trakcie analizy podjęto kilka krytycznych kroków w ramach protokołu, aby zapewnić dokładność i wiarygodność wyników. Kroki te obejmowały wstępne przetwarzanie danych, specyfikację modelu i oszacowanie parametrów, zgodnie z badaniami takimi jak Hautala i wsp.19, które wykazały niezawodność narzędzi komputerowych w identyfikowaniu uczniów z trudnościami w czytaniu. Ponadto inne badania, takie jak te przeprowadzone przez Protopapas i wsp.20 oraz Pennington i wsp.12, badały wdrożenie komputerowych narzędzi przesiewowych do identyfikacji dysleksji, podkreślając znaczenie wykorzystania technologii w celu ulepszenia strategii oceny. Co więcej, obecne badanie jest zgodne z najnowszymi postępami w badaniach nad dysleksją i oceną psychometryczną, podkreślając znaczenie baterii we współczesnych kontekstach. Badania przeprowadzone przez Jiméneza i wsp.23 oraz Guzmána i wsp.24 podkreśliły krytyczną potrzebę solidnych narzędzi oceny dostosowanych do różnych środowisk językowych, podkreślając skuteczność Sicole-R w wypełnianiu tej luki w populacjach hiszpańskojęzycznych. Co więcej, integracja technologii cyfrowych w ocenie dysleksji, omówiona przez Rauschenberga i wsp.6, wzmacnia rygor metodologiczny wykazany w podejściu do analizy czynnikowej i walidacji w tym badaniu.
Pomimo rygoru metodologicznego zastosowanego w tym badaniu, ważne jest, aby uznać pewne ograniczenia związane z analizą. Jedno z ograniczeń dotyczy możliwości uogólnienia wyników, ponieważ próba składała się z określonej grupy demograficznej, co potencjalnie ogranicza możliwość zastosowania wyników do szerszych populacji. Ponadto, chociaż podjęto wysiłki w celu zapewnienia niezmienności pomiaru między płciami, inne czynniki demograficzne, takie jak wiek lub status społeczno-ekonomiczny, nie zostały wyraźnie uwzględnione w analizie, co mogło mieć wpływ na wyniki.
Przyszłe kierunki badań mogą dotyczyć jego adaptacji do różnych dialektów hiszpańskich i integracji z szerszymi ramami edukacyjnymi w celu ulepszenia strategii identyfikacji. Idąc dalej, przyszłe badania powinny mieć na celu zajęcie się ograniczeniami zidentyfikowanymi w tym badaniu, takimi jak zbadanie użyteczności baterii multimedialnej w różnych populacjach oraz zbadanie jej trafności podłużnej i trafności predykcyjnej w przewidywaniu długoterminowych wyników edukacyjnych. Dodatkowo, obiecująca przyszła linia badań została podkreślona w niedawnym przeglądzie Jin et al.47, sugerując włączenie technologii neurobiologicznej. Przeprowadzili kompleksowy przegląd naukowych baz danych, wybierając badania opublikowane w latach 2018-2023. Ich odkrycia sugerują, że ocena technologii neurobiologicznej staje się obiecującym trendem w postępie w diagnozowaniu dysleksji.
Podsumowując, wyniki tego badania podkreślają, że bateria multimedialna jest cennym narzędziem dla nauczycieli, ostatecznie ułatwiającym skuteczniejsze wsparcie i poprawiające wyniki uczniów z dysleksją. Uwzględniając te współczesne spostrzeżenia, odkrycia przyczyniają się do rozwijającego się dyskursu na temat oceny dysleksji, oferując praktykom i badaczom zaktualizowane perspektywy na skuteczne ramy strategii diagnostycznych. Według naszej wiedzy, badanie to jest jednym z pierwszych, które zweryfikowały kompleksową baterię multimedialną dostosowaną specjalnie dla populacji hiszpańskojęzycznych, wypełniając krytyczną lukę w obecnych narzędziach diagnostycznych dostępnych dla dysleksji.
Oświadczenia
Wyżej wymienieni autorzy zaświadczają, że w związku z niniejszym badaniem nie istnieją żadne interesy finansowe ani inne konflikty interesów.
Podziękowania
Z wdzięcznością dziękujemy za wsparcie udzielone przez Programa de la Agencia Española de Cooperación con Iberoamérica (AECI), umożliwiające dostosowanie narzędzia technologicznego Sicole-R-Primaria do hiszpańskiego wariantu językowego różnych krajów w przestrzeni iberoamerykańskiej poprzez projekty Evaluación de procesos cognitivos en la lectura mediante ayuda asistida a través de ordenador en población escolar de educación primaria (Ocena procesów poznawczych w czytaniu za pomocą wspomaganej komputerowo pomocy w populacji uczniów szkół podstawowych) w Gwatemali (nr ref.: A/3877/05), Ekwadorze (nr ref.: C/030692/10), Meksyku (nr ref.: A/013941/07) i Chile (nr ref.: A/7548/07). Dodatkowo chcielibyśmy wyrazić naszą szczerą wdzięczność Międzyamerykańskiemu Bankowi Rozwoju (IDB) za wsparcie finansowe dla Ministerstwa Edukacji (MEDUCA) Panamy, którego pośrednikiem jest Organizacja Iberoamerykańskich Państw na rzecz Edukacji, Nauki i Kultury (OEI). Fundusze te umożliwiły dostosowanie Sicole-R do użytku zarówno na komputerach, jak i tabletach. Jesteśmy również wdzięczni za wsparcie udzielone w ramach Programu PN-L1143; 4357/OC-PN, w szczególności Wsparcie Techniczne w zakresie Szkolenia Facylitatorów i Przeglądu Zasobów Edukacyjnych. Ponadto wyrażamy nasze uznanie dla Umowy o Świadczenie Zewnętrznych Produktów i Usług (PEC), która ma na celu oferowanie specjalistycznych szkoleń ułatwiających wykrywanie, identyfikację i wczesną interwencję panamskich uczniów, którzy mogą być narażeni na trudności w czytaniu, pisaniu i matematyce. We wszystkich wyżej wymienionych projektach pierwszym z autorów był kierownik projektu.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Sicole-R | Universidad de La Laguna | TF-263-07 |
Bibliografia
- World Federation of Neurology. Report of research group on Dyslexia and world illiteracy. , Dallas. (1968).
- Diamanti, V., Goulandris, N., Campbell, R., Protopapas, A. Dyslexia profiles across orthographies differing in transparency: An evaluation of theoretical predictions contrasting English and Greek. Sci Stud Reading. 22 (1), 55-69 (2018).
- Shaywitz, S. Overcoming dyslexia: A new and complete science-based program for reading problems at any level. , Alfred A. Knopf. (2003).
- Heikki Lyytinen, H., Ronimus, H., Alanko, A., Poikkeus, N. M., Taanila, M. Early identification of dyslexia and the use of computer game-based practice to support reading acquisition. Nordic Psychol. 59 (2), 109-126 (2007).
- Tobia, V., Marzocchi, G. M. Cognitive profiles of Italian children with developmental dyslexia. Reading Res Quart. 49 (4), 437-452 (2014).
- Rauschenberger, M., Baeza-Yates, R., Rello, L. A universal screening tool for dyslexia by a web-game and machine learning. Front Comput Sci. 3, 628634(2022).
- Ekhsan, H. M., Ahmad, S. Z., Halim, S. A., Hamid, J. N., Mansor, N. H. The implementation of interactive multimedia in early screening of dyslexia. Int Conf Innov Mgmt Tech Res. , 566-569 (2012).
- Jiménez, J. E. Dyslexia in Spanish. Prevalence and cognitive, cultural, family and biological indicators. , Ediciones Pirámide. Madrid. (2012).
- Hatcher, J., Snowling, M. J. The phonological representations hypothesis of dyslexia: From theory to practice. Dyslexia and Literacy, Theory and Practice. , Chichester, John Wiley & Sons. (2002).
- Goswami, U. A temporal sampling framework for developmental dyslexia. Trends Cogn Sci. 15 (1), 3-10 (2011).
- Stein, J. F. The magnocellular theory of developmental dyslexia. Dyslexia. 7 (1), 12-36 (2001).
- Nicolson, R. I., Fawcett, A. J. Development of Dyslexia: The delayed neural commitment framework. Front Behav Neurosci. 21 (13), 112(2001).
- Pennington, B. F., et al. Individual prediction of dyslexia by single versus multiple deficit models. J Abnorm Psychol. 121 (1), 212-224 (2012).
- Ring, J., Black, J. L. The multiple deficit model of dyslexia: what does it mean for identification and intervention. Ann Dyslexia. 68 (2), 104-125 (2018).
- Soriano-Ferrer, M., Nievas-Cazorla, F., Sánchez-López, P., Félix-Mateo, V., González-Torre, J. A. Reading-related cognitive deficits in Spanish developmental Dyslexia. Procedia - Social Behav Sci. 132, 3-9 (2014).
- The implementation of a web application for screening children with Dyslexia. Zygouris, N. C., et al. International Conference on Interactive Collaborative Learning, , (2016).
- Snowling, M. J., Hulme, C. The Science of Reading: A Handbook. , Wiley-Blackwell. (2021).
- Politi-Georgousi, S., Drigas, A. Mobile applications, an emerging powerful tool for Dyslexia screening and intervention: A systematic literature review. Int J Interact Mobile Technol. 14 (18), 4-17 (2020).
- Fawcett, A. J., Nicolson, R. I. The Dyslexia early screening test. Irish J Psychol. 16 (3), 248-259 (1995).
- Zygouris, N. C., et al. The implementation of a web application for screening children with dyslexia Interactive Collaborative Learning. , Advances in Intelligent Systems and Computing. Cham. (2017).
- Hautala, J., et al. Identification of reading difficulties by a digital game-based assessment technology. J Edu Comput Res. 58 (5), 1003-1028 (2020).
- Ahmad, N., Rehman, M. B., El Hassan, H. M., Ahmad, I., Rashid, M. An efficient machine learning-based feature optimization model for the detection of dyslexia. Comput Intell Neurosci. 9, 8491753(2022).
- Rello, L., Baeza-Yates, R., Ali, A., Bigham, J. P., Serra, M. Predicting risk of dyslexia with an online gamified test. PLoS One. 15 (12), e0241687(2020).
- Dębska, A., et al. The cognitive basis of dyslexia in school-aged children: A multiple case study in a transparent orthography. Dev Sci. 25 (2), e13173(2022).
- Jiménez, J. E., et al. Discriminant validity of the Sicole-R-Primaria Multimedia Battery for the evaluation of cognitive processes associated with dyslexia. Revista de Investigación Educativa. 27 (1), 49-71 (2009).
- Guzmán, R., et al. Assessment of naming speed in reading learning difficulties. Psicothema. 16 (3), 442-447 (2004).
- Jiménez, J. E., et al. Is the deficit in phonological awareness better explained in terms of task differences or effects of syllable structure. Appl Psycholinguist. 26 (2), 267-283 (2005).
- Ortiz, R., et al. Locus and nature of perceptual phonological deficit in Spanish children with reading disabilities. J Learn Disabil. 40 (1), 80-92 (2007).
- Ortiz, R., et al. Development of speech perception in children with dyslexia. Psicothema. 20 (4), 678-683 (2008).
- Jiménez, J. E., et al. The Double-deficit hypothesis in Spanish developmental dyslexia. Topics Lang Disorders. 28 (1), 46-60 (2008).
- Jiménez, J. E., García de la Cadena, C. Learning disabilities in Guatemala and Spain: A cross-national study of the prevalence and cognitive processes associated with reading and spelling disabilities. Learning Disabilities Res Pract. 22, 161-169 (2007).
- Jiménez, J. E., de la Cadena, C. G., Siegel, L. S., O'Shanahan, I., García, E. Gender ratio and cognitive profiles in dyslexia: a cross-national study. Read Writ. 24, 729-747 (2011).
- Rodrigo, M., et al. Assessment of orthographic processing in Spanish children with dyslexia: the role of lexical and sublexical units. Revista Electrónica de Investigación Psicoeducativa y Psicopedagógica. 2 (2), 105-126 (2004).
- Jiménez, J. E., et al. Evaluation of syntactic-semantic processing in developmental dyslexia. Elect J Res Edu Psychol. 2 (2), 127-142 (2004).
- Jiménez, J. E., Rodríguez, C., Ramírez, G. Spanish developmental dyslexia: prevalence, cognitive profile, and home literacy experiences. J Exp Child Psychol. 103 (2), 167-185 (2009).
- PROLEC-R. Primary Reading Processes Assessment Battery - Revised. Cuetos, F., Rodríguez, B., Ruano, R., Arribas, A. D. , TEA Ediciones. (2005).
- Guzmán, R., Jiménez, J. E. Normative study on psycholinguistic parameters in children aged 6 to 8 years: Subjective familiarity. Cognitiva. 2, 153-191 (2001).
- Cohen, P., Cohen, J., Aiken, L., West, S. G. The problem of units and the circumstance for POMP. Multivariate Behav Res. 34, 315-346 (1999).
- R Core Team. R: A Language and Environment for Statistical Computing_. R Foundation for Statistical Computing. , Vienna, Austria. (2023).
- Rosseel, Y. lavaan: An R package for structural equation modeling. J Stat Software. 48 (2), 1-36 (2012).
- Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., Rosseel, Y. semTools: Useful tools for structural equation modeling. , R package version 0.5-6. (2022).
- Wickham, H. ggplot2: Elegant graphics for data analysis. , Springer-Verlag. New York. (2016).
- Byrne, B. M. Structural equation modeling with AMOS: Basic concepts, applications, and programming. , Third Edition, Taylor & Francis Group. (2016).
- Vandenberg, R. J., Lance, C. E. A review and synthesis of the measurement invariance literature: Suggestions, practices, and recommendations for organizational research. Org Res Methods. 3 (1), 4-70 (2000).
- Hirschfeld, G., von Brachel, R. Multiple-Group confirmatory factor analysis in R - A tutorial in measurement invariance with continuous and ordinal indicators. Pract Assess Res Eval. 19 (7), 1-12 (2014).
- Sachs, M. C. plotROC: A Tool for Plotting ROC Curves. J Stat Softw. 79, 2(2017).
- Jing, W., Yu, E. L. X., Motevalli, S. A comparison between cognitive assessment and neurobiology technology assessment of dyslexia: A literature review. Int J Acad Res Busi Soc Sci. 13 (4), 976-986 (2023).
Przedruki i uprawnienia
