Ten artykuł opisuje RUGGED (Retrieval Under Graph-Guided Explainable disease Distinction), który integruje wnioskowanie Large Language Model (LLM) z Retrieval-Augmented Generation (RAG). Opiera się na dowodach z opracowanych przez ekspertów baz wiedzy biomedycznej i recenzowanych publikacji biomedycznych, aby zsyntetyzować nową wiedzę z aktualnych informacji, zidentyfikować wytłumaczalne i możliwe do zastosowania prognozy oraz wskazać obiecujące kierunki badań opartych na hipotezach.
Artykuł metodologiczny
Synteza wiedzy opartej na dowodach i walidacja hipotez: poruszanie się po bazach wiedzy biomedycznej za pomocą wytłumaczalnej sztucznej inteligencji i systemów agentowych
W tym artykule
Podsumowanie
Streszczenie
Skala wiedzy biomedycznej, obejmująca literaturę naukową i wyselekcjonowane bazy wiedzy, stanowi poważne wyzwanie dla badaczy w efektywnym przetwarzaniu, ocenie i interpretacji wyników. Duże modele językowe (LLM) stały się potężnymi narzędziami do poruszania się po tym złożonym krajobrazie wiedzy, ale mogą powodować reakcje halucynacyjne. Funkcja Retrieval-Augmented Generation (RAG) jest niezbędna do identyfikacji istotnych informacji w celu zwiększenia dokładności i wiarygodności. Protokół ten wprowadza RUGGED (Retrieval Under Graph-Guided Explainable disease Distinction), kompleksowy przepływ pracy zaprojektowany w celu wspierania integracji wiedzy, łagodzenia uprzedzeń oraz badania i walidacji nowych kierunków badań. Informacje biomedyczne z publikacji i baz wiedzy są syntetyzowane i analizowane za pomocą analizy skojarzeń eksploracji tekstu i wytłumaczalnych modeli predykcyjnych grafów w celu odkrycia potencjalnych zależności między lekami a chorobami. Odkrycia te, wraz z korpusem tekstu źródłowego i bazami wiedzy, są włączane do ram, które wykorzystują LLM wzmocnione przez RAG, aby umożliwić użytkownikom badanie hipotez i badanie podstawowych mechanizmów. Przypadek użycia klinicznego demonstruje zdolność RUGGED do oceny i zalecania terapii kardiomiopatii arytmogennej (ACM) i kardiomiopatii rozstrzeniowej (DCM), analizowania przepisanych leków pod kątem interakcji molekularnych i potencjalnych nowych zastosowań. Platforma zmniejsza halucynacje LLM, podkreśla praktyczne spostrzeżenia i usprawnia badania nad nowymi terapiami.
Wprowadzenie
Proces badania hipotez w przedsiębiorstwie biomedycznym jest niezbędny do odkrycia nowych współzależności molekuła-lek-choroba leżących u podstaw patogenezy i odblokowania potencjału terapeutycznego1,2. Proces ten opiera się na dowodach z istniejącej wiedzy biomedycznej, syntetyzując nowe odkrycia w oparciu o logiczne tropy osadzone w recenzowanej literaturze (np. >36 raportów z PubMed) oraz integrując wyselekcjonowane dowody o wysokim poziomie zaufania, zakorzenione w bazach wiedzy biomedycznej. Najnowsze osiągnięcia zmniejszają pracochłonny wysiłek ręczny poprzez zastosowanie eksploracji tekstu w literaturze corpra3,4,5, a także stosowanie analiz opartych na wykresach6,7,8,9 w celu syntezy istotnych informacji i odkrycia nowych dróg dochodzenia. Pomimo tych wysiłków obecne podejścia często nie wspierają głębokiego zrozumienia kontekstowego ze względu na fragmentaryczne dane. Ponadto brakuje im zdolności do wyciągania wniosków opartych na dowodach i interaktywnego badania nowych hipotez.
Ostatnie osiągnięcia w dużych modelach językowych (LLM) rzucają nowe światło na te wyzwania, demonstrując zrozumienie kontekstowe na wysokim poziomie poprzez szkolenie na ogromnych ilościach informacji w wielu dyscyplinach10,11,12. W dziedzinie biomedycznej LLM wykazały obiecującą rolę w wydobywaniu informacji o pacjencie13 i ogólnych odpowiedziach na pytania kliniczne14,15, podczas gdy aplikacje w odpowiadaniu na pytania specyficzne dla danej dziedziny16 i narzędzia w podstawowej opiece klinicznej17 pozostają do zbadania. Modele te wykazują zdolność do wnioskowania i wyciągania wniosków ze złożonych zestawów danych, dzięki czemu potencjalnie nadają się do prowadzenia eksploracji hipotez i syntezy wiedzy. Co więcej, niektóre modele oferują interakcję podobną do czatu, aby angażować użytkowników i umożliwiać dynamiczną eksplorację tematów, przekraczając konwencjonalne granice wyszukiwarek opartych na zapytaniach i baz wiedzy18,19.
Oprócz tych potencjałów, LLM stoją przed poważnymi wyzwaniami, takimi jak możliwe halucynacje informacji, wykazywanie nieuzasadnionej pewności co do potencjalnie niedokładnych wyjaśnień, brak możliwości interpretacji oraz podatność na stronnicze lub nieodpowiednie treści20,21,22,23,24. Odpowiedzi i prognozy oparte na LLM, stosowane bezpośrednio do kierowania procesem podejmowania decyzji klinicznych, mają wysoką stawkę; Wszelkie błędy mogą potencjalnie skutkować kosztownymi eksperymentami laboratoryjnymi lub negatywnie wpłynąć na trajektorie zdrowia pacjenta25,26. Dlatego najważniejsze są rzetelne i godne zaufania odpowiedzi LLM, ponieważ ich porady muszą być mocno zakorzenione w dowodach. W tych scenariuszach interpretowalność nie jest luksusem, ale koniecznością, aby zrozumieć, dlaczego te modele dokonują takich przewidywań.
W tym celu, Retrieval-Augmented Generation (RAG) jest systemem zaprojektowanym w celu zminimalizowania halucynacji LLM, uziemiając odpowiedzi LLM w dowodach, aby zwiększyć ich dokładność i niezawodność27,28. Takie podejście zazwyczaj polega na pobieraniu odpowiednich fragmentów tekstu, takich jak integracja LLM (np. ChatGPT) z PubMed, co pozwala na identyfikację odpowiednich cytatów z zapytań użytkowników29,30. Nie ograniczając się do tekstu, wyszukiwanie na Grafach Wiedzy (KG) jest obiecujące w zastosowaniu do LLM do zadań takich jak sprawdzanie faktów31,32,33, transparent reasoning34,35,36, kodowanie wiedzy37, poprawa odpowiadania na pytania38 i uzupełnianie wiedzy graphs39. Kodując faktyczne informacje ze zweryfikowanych źródeł, KG zwiększają dokładność, przejrzystość i wiarygodność odpowiedzi LLM. Techniki przewidywania powiązań w tych wykresach wykorzystują głębokie uczenie do identyfikowania wcześniej ukrytych relacji między cząsteczkami, lekami i chorobami5,40,41. Ostatnie postępy w zakresie wytłumaczalnych prognoz AI jeszcze bardziej zwiększają przejrzystość i interpretowalność tych zadań przewidywania linków, zapewniając potencjalne wsparcie w interpretacji hipotez biomedycznych jako realnej drogi do badań42,43,44. Postępy te zapewniają, że odpowiedzi generowane przez LLM są zrównoważone i oparte na dowodach, co znacznie zwiększa ich zastosowanie w przedsiębiorstwach biomedycznych.
Ten protokół przedstawia RUGGED (Retrieval Under Graph-Guided Explainable disease Distinction) jako dostępny i efektywny przepływ pracy do eksploracji i walidacji klinicznych spostrzeżeń terapeutycznych (Rysunek 1). Ten protokół przepływu pracy wykorzystuje ogromne zasoby literatury biomedycznej i baz wiedzy do ekstrakcji i walidacji odpowiednich informacji, umożliwiając procesy wyszukiwania dostosowane do zapytań (Rysunek 2). Wytłumaczalny model predykcyjny oparty na sztucznej inteligencji jest wykorzystywany do odkrywania możliwych do zinterpretowania i praktycznych spostrzeżeń na podstawie istniejącej wiedzy biomedycznej, zwiększając w ten sposób przejrzystość i użyteczność modeli predykcyjnych. Ukończony przepływ pracy usprawnia eksplorację wykresów wiedzy i prognoz modeli za pośrednictwem LLM z obsługą RAG, ułatwiając intuicyjne i świadome interakcje badaczom, klinicystom i profesjonalistom klinicznym.
Ta sekcja kładzie podwaliny pod protokół, z krokami do wdrożenia tego podejścia opisanymi w następnej sekcji. Następnie przedstawiono translacyjny przypadek użycia klinicznego, aby zademonstrować to podejście, stosowane do oceny leków pod kątem interakcji molekularnych, a także strategii terapeutycznych w medycynie sercowo-naczyniowej. Na koniec omówiono implikacje i dyskusję na temat tego protokołu.
Protokół
Ten protokół został opracowany w Pythonie 3.10 i zaimplementowany jako kontener Docker w systemie Windows. Podane polecenia są oparte na środowisku Unix w kontenerze platformy Docker. Oprogramowanie jest dostępne pod adresem https://github.com/pinglab-utils/RUGGED. Tabela 1 przedstawia szacunkowy czas obliczeniowy dla wszystkich kroków w protokole.
1. Instalacja oprogramowania
- Zainstaluj wymagane oprogramowanie, postępując zgodnie z instrukcjami w Tabeli materiałów.
UWAGA: Ten protokół wymaga kontroli wersji, konteneryzacji, grafowej bazy danych i usług dużego modelu językowego (LLM). Kontrola wersji i konteneryzacja są opcjonalne, ale mogą uprościć proces konfiguracji; grafowa baza danych i usługi LLM mogą być zastąpione podobnymi narzędziami, jeśli użytkownik jest biegły technicznie.- Konfigurowanie sieci między kontenerami. Skonfiguruj kontenery platformy Docker tak, aby były połączone z innymi usługami na urządzeniu (np. innymi kontenerami platformy Docker). Wpisz następujące polecenie w terminalu: docker network create rugged_network
- Konfigurowanie usług dużych modeli językowych (LLM). Wybierz odpowiednią usługę LLM dla danego przypadku użycia, spośród komercyjnych usług LLM lub usług z modelu lokalnego działającego na urządzeniu użytkownika. Upewnij się, że określono co najmniej jedną usługę LLM, chociaż agenci mogą być mieszani i dopasowywani w celu wykorzystania różnych modeli.
- Uruchom lokalną usługę LLM. Jeśli używasz Ollamy za pomocą graficznego interfejsu użytkownika (GUI), uruchom plik wykonywalny GUI (np. ollama.exe). Jeśli używasz platformy Docker, uruchom: 'docker run -name ollama --net rugged_network d -v ollama:/root/.ollama -p 11434:11434 ollama/ollama'. Jeśli używasz Dockera z akceleracją GPU, upewnij się, że sterownik GPU jest zainstalowany i uruchom: 'docker run -name ollama --net rugged_network -d --gpus=all -v ollama:/root/.ollama -p 11434:11434 ollama/ollama'.
- Zainicjuj lokalny model LLM. Określ, który model ma być używany spośród obsługiwanych modeli (np. Zalecane: llama3, mistral, mixtral. Jeśli używasz platformy Docker, wpisz "docker exec run ollama run " w wierszu polecenia; jeśli używasz graficznego interfejsu użytkownika Ollama, wpisz "ollama run ", zastępując nazwą modelu dla każdego z nich.
- Uruchom usługę Graph Database. Wybierz usługę grafowej bazy danych spośród kontenera platformy Docker, aplikacji klasycznej lub usługi internetowej online. Postępuj zgodnie z instrukcjami instalacji w materiałach uzupełniających, aby zakończyć konfigurację.
- Skonfiguruj środowisko RUGGED. Sprawdź pobrane obrazy platformy Docker, wpisując obrazy platformy Docker. Upewnij się, że na liście znajdują się wszystkie obrazy platformy Docker z poprzedniego kroku. Uruchom te polecenia w terminalu, aby pobrać obraz RUGGED Docker i kod:
docker pull pinglabutils/rugged:latest
UWAGA: git clone https://github.com/pinglab-utils/RUGGED- Skonfiguruj komercyjną usługę LLM. Jeśli korzystasz z komercyjnych usług LLM, upewnij się, że konto i powiązany klucz API mają wystarczające środki. Zmodyfikuj pliki konfiguracyjne RUGGED, edytując plik konfiguracyjny pod adresem "RUGGED/config/openai_key.txt" i dodając klucz API do pliku.
- Konfigurowanie agentów handlowych. Określ, którzy agenci LLM w systemie RUGGED będą korzystać z tej usługi. Zmodyfikuj plik konfiguracyjny pod adresem "RUGGED/config/llm_agents.json" i zaktualizuj pola agenta, aby określić wersję modelu. Zalecane modele: gpt-3.5-turbo, gpt-4o.
- Skonfiguruj lokalną usługę LLM. Jeśli używasz innego punktu końcowego usługi niż domyślny punkt końcowy dla Ollama pod adresem "http://localhost:11434", zmodyfikuj i zaktualizuj pole "OLLAMA_URI" w plikach konfiguracyjnych pod adresem "RUGGED/config/ollama_config.json".
- Konfigurowanie lokalnych agentów LLM. Określ, którzy agenci LLM w systemie RUGGED będą korzystać z tej usługi. Zmodyfikuj plik konfiguracyjny pod adresem "RUGGED/config/llm_agents.json" i zaktualizuj pola agenta, aby określić "ollama" jako wybrany model.
- Skonfiguruj punkt końcowy bazy danych programu Graph. Jeśli zmodyfikowano domyślne hasło i nazwę użytkownika dla Neo4j, edytuj plik konfiguracyjny "RUGGED/config/neo4j_config.json", aby zaktualizować pola "uri", "nazwa użytkownika" i "hasło".
- Uruchom usługę RUGGED, uruchamiając polecenie:
docker run --name rugged -it --net rugged_network --gpus=all -v \RUGGED\:/data ping-lab-
narzędzia:RUGGED /bin/bash
UWAGA: Aby sprawdzić, czy usługi działają zgodnie z oczekiwaniami, przejdź do katalogu RUGGED i wykonaj kroki 1.4.1. w kroku 1.4.4. w tym oknie terminala.- Sprawdź funkcjonalność usługi LLM. Przejdź do folderu testowego w katalogu RUGGED i wykonaj następujące polecenia, aby sprawdzić, czy usługi OpenAI i/lub Ollama działają:
python test_openai.py
python test_ollama.py - Sprawdź funkcjonalność usługi rozpoznawania jednostek nazwanych. Wykonaj polecenie "test_ner.py", aby sprawdzić, czy kod rozpoznawania nazwanych jednostek zapytań użytkowników działa poprawnie.
- Sprawdź funkcjonalność usługi Neo4j. Wykonaj skrypty testowe, aby sprawdzić, czy usługa Neo4j działa zgodnie z oczekiwaniami, wpisując "python test_neo4j.py"
- (Opcjonalnie) Sprawdź dostęp HTTP do bazy danych programu Graph. Otwórz przeglądarkę internetową i odwiedź interfejs użytkownika Neo4j.
UWAGA: W przypadku Neo4j w Dockerze lub Desktopie domyślny adres URL to "http://localhost:7474". W przypadku Neo4j AuraDB użyj linku podanego podczas instalacji.
- Sprawdź funkcjonalność usługi LLM. Przejdź do folderu testowego w katalogu RUGGED i wykonaj następujące polecenia, aby sprawdzić, czy usługi OpenAI i/lub Ollama działają:
- (Opcjonalnie) Rozwiązywanie problemów. Upewnij się, że usługi obsługujące RUGGED są weryfikowane podczas konfiguracji oprogramowania, aby przewidzieć problemy. Rozwiąż problemy z nieudanymi testami od kroku 1.4. Jeśli takowe istnieją, postępuj zgodnie z komunikatami o błędach zgłaszanymi przez skrypty testowe opisujące problemy.
- Sprawdź kontenery platformy Docker. Upewnij się, że wszystkie kontenery platformy Docker są uruchomione przy użyciu polecenia "docker ps" w terminalu, w tym kontenera platformy docker RUGGED, kontenera platformy Docker Neo4j (opcjonalnie) i kontenera platformy Docker Ollama (opcjonalnie).
- Sprawdź porty sieciowe. W przypadku usług Docker upewnij się, że otwarte są odpowiednie porty i sprawdź dzienniki za pomocą polecenia "docker logs neo4j" lub "docker logs ollama".
UWAGA: Domyślnie Neo4j używa portów 7474 dla http i 7687 dla interfejsu bolt; Ollama używa portu 11434. - Weryfikuj aplikacje serwisowe. W przypadku aplikacji zainstalowanych bezpośrednio na urządzeniu (np. Ollama i Neo4j Desktop) otwórz aplikacje, aby potwierdzić, że są uruchomione.
- Sprawdź usługi internetowe. W przypadku Neo4j AuraDB zaloguj się do witryny i sprawdź, czy usługa jest uruchomiona.
- Sprawdź reguły zapory. Zmodyfikuj reguły zapory urządzenia, aby upewnić się, że zapora nie blokuje żadnych usług zewnętrznych.
- Uruchom ponownie urządzenie. Jeśli problemy nie zostaną rozwiązane, uruchom ponownie urządzenie i spróbuj ponownie od kroku 1.5.1.
- Otwórz zgłoszenie. Jeśli problemy będą się powtarzać, otwórz problem w serwisie GitHub RUGGED (https://github.com/pinglab-utils/RUGGED).
2. Dostęp do wiedzy biomedycznej i informacji o ekstrakcji
UWAGA: Te kroki opisują dwa potoki ekstrakcji wiedzy jako podstawowe informacje składające się na system Retrieval Augmented Generation (RAG) RUGGED: (1) potok eksploracji tekstu biomedycznego CaseOLAP LIFT5 i (2) przepływ pracy budowy grafu wiedzy Know2BIO9. Aby użyć RUGGED z danymi niestandardowymi, przejdź do kroku 4.
- Wyciąg z literatury biomedycznej. Zidentyfikuj odpowiednie dokumenty i wysokopoziomowe relacje białko-choroba za pomocą CaseOLAP LIFT, protokołu obliczeniowego zaprojektowanego do badania białek subkomórkowych i ich powiązań z chorobą poprzez eksplorację tekstów w literaturze biomedycznej. Wykonaj ten krok, aby przygotować informacje niezbędne do informowania przepływu pracy RAG o ukierunkowane wnioski z tych raportów.
- Uruchom analizę eksploracji tekstu CaseOLAP LIFT. Zapoznaj się z protokołem CaseOLAP LIFT JoVE (kroki 4-5 nie są konieczne do tej analizy).
- Przenoszenie przetworzonych dokumentów tekstowych. Upewnij się, że przeanalizowane dokumenty biomedyczne (pubmed.json) i ich pełny tekst (pmid2full_text_sections.json) z kroku 3 znajdują się w folderze danych CaseOLAP LIFT. Przenieś te pliki do folderu danych RUGGED za pomocą poniższych poleceń:
mv /caseolap_lift/caseolap_lift_shared_folder/data/pubmed.json /RUGGED/data/text_corpus
mv /caseolap_lift/caseolap_lift_shared_folder/data/ pmid2full_text_sections.json /RUGGED/data/text_corpus - Przenoszenie wyników wyszukiwania tekstu. Sprawdź, czy plik grafu wiedzy (merged_edge_list.tsv) ze skojarzeniami białko-choroba został wygenerowany w folderze wynik/kg. Sprawdź, czy liczba powiązań jest zgodna z oczekiwaniami, w zależności od ustawień wybranych w krokach 1-3 (patrz na przykład Tabela 2). Przenieś ten plik do folderu danych RUGGED:
mv /caseolap_lift/caseolap_lift_shared_folder/wynik/graph_data/ merged_edge_list.tsv /RUGGED/data/knowledge_graph
- Wyodrębnij wiedzę biomedyczną. Złóż graf wiedzy biomedycznej za pomocą oprogramowania Know2BIO, które integruje dane z 30 baz wiedzy biomedycznej. Wykonaj ten krok, aby upewnić się, że informacje dotyczące tych relacji biomedycznych i danych multimodalnych są przetwarzane w celu wsparcia dalszego przepływu pracy RAG.
- Sklonuj repozytorium Know2BIO. Sklonuj repozytorium, wpisując w wierszu poleceń, używając poniższego polecenia. Przejdź do repozytorium Know2BIO.
git klon https://github.com/Yijia-Xiao/Know2BIO.git. - Przygotowanie danych i licencji. Przejdź do folderu zestawu danych i postępuj zgodnie z instrukcjami w pliku "README.md". Zakończ niezbędne tworzenie kont użytkowników, aby uzyskać dostęp do różnych zasobów online (np. tezaurusa UMLS, banku leków).
- Pobierz zasoby bazy wiedzy. Wykonaj skrypt "python create_edge_files.py" i monitoruj postęp potoku ekstrakcji grafu wiedzy. Upewnij się, że został wygenerowany plik .csv w folderze "Know2BIO/dataset/output" reprezentujący relacje biomedyczne.
- Konstruowanie grafu wiedzy. Wykonaj skrypt "python prepare_kgs.py", aby zintegrować informacje wyodrębnione w poprzednim kroku, aby automatycznie połączyć wyodrębnione relacje w ujednolicony graf wiedzy, formatując wykres według źródła danych i domeny.
- Sprawdź dane wyjściowe. Sprawdź, czy ukończone pliki znajdują się w pliku "whole_kg.txt" w katalogu "Know2BIO/dataset/know2bio_dataset". Upewnij się, że liczba krawędzi w pliku jest zgodna z oczekiwaniami; patrz Tabela 3, co dało ponad 6 milionów krawędzi. Przejdź do następnego kroku, ponieważ pozostałe kroki w pliku Know2BIO README nie są wymagane do tej analizy.
UWAGA: Relacje z Know2BIO w Tabeli 3 były źródłami z 31 źródeł, w tym ATC (Światowa Organizacja Zdrowia), Bgee45, CTD46, ClinGen47, ClinVar48, DOID49, DisGeNET50, DrugBank51, GRNdb52, Gene Ontology53, HGNC54, Hetionet3, Inxight Drugs55, KEGG56, MeSH57, Mondo58, MyChem.info59, MyDisease.info<‟sup class="xref">59, MyGene.info59, OMIM60, PathFX61, PharmGKB62, PubMed, Reactome63, SIDER64, SMPDB65, STRING66, TTD67, UMLS68, Uberon69 oraz UniProt70. - Przenoszenie wyników grafu wiedzy. Przenieś plik do katalogu '/data/knowledge_graph/' w katalogu RUGGED.
mv /Know2BIO/dataset/know2bio/whole_kg.txt /RUGGED/data/knowledge_graph
- Sklonuj repozytorium Know2BIO. Sklonuj repozytorium, wpisując w wierszu poleceń, używając poniższego polecenia. Przejdź do repozytorium Know2BIO.
- Skonstruuj połączony graf wiedzy. Zintegruj wykres z poprzedniego kroku z wysokopoziomowymi relacjami białko-choroba z eksploracji tekstu z kroku 2.1 w jeden ujednolicony graf wiedzy.
- Sprawdź wyniki w katalogu RUGGED. Sprawdź, czy plik wyników budowy grafu wiedzy (whole_kg.txt) i wyniki relacji wyszukiwania tekstu (merged_edge_list.tsv) znajdują się w katalogu knowledge_graph w folderze danych.
- Zintegruj wyniki. Wykonaj skrypt "combine_kg_results.py", aby scalić wyodrębnione relacje i jednostki z analizy eksploracji tekstu i konstrukcji grafu wiedzy w jeden spójny graf wiedzy. Postępuj zgodnie z poniższym przykładowym poleceniem:
python rugged/knowledge_graph/combine_kg_results.py ./data/knowledge_graph/merged_edge_list.tsv ./data/knowledge_graph/whole_kg.txt --output_dir ./data/rugged_knowledge_graph
- Filtruj wykres wiedzy. (Opcjonalnie) Próbkowanie podzbioru grafu wiedzy, który zostanie użyty do analizy predykcyjnej. Ten krok zachowuje tylko ściśle powiązane relacje i zmniejsza zasoby obliczeniowe niezbędne do wykonywania przewidywań uczenia głębokiego.
- Zidentyfikuj odpowiednie węzły. Określ jednostki biomedyczne będące przedmiotem zainteresowania dla analizy predykcyjnej w kroku 3, przeglądając wykres wiedzy i wskazując odpowiednie węzły.
UWAGA: Protokół ten koncentruje się na węzłach chorobowych kardiomiopatii arytmogennej (ACM) i kardiomiopatii rozstrzeniowej (DCM), odpowiednio MeSH_Disease: D019571 i MeSH_Disease: D002311. Węzły docelowe muszą być dostosowane do zamierzonego przypadku użycia. - Próbka z grafu wiedzy. Użyj skryptu "filter.py", aby wyodrębnić podgraf grafu wiedzy dostępny w k-hop z wybranych węzłów zainteresowania. Postępuj zgodnie z poniższym przykładowym poleceniem, które filtruje wykres osiągalny w promieniu 2 węzłów od wybranych węzłów choroby:
python ./rugged/knowledge_graph/kg_filter.py --k 2 --disease "MeSH_Disease:D019571,MeSH_Disease:D002311" --input_file ./data/rugged_knowledge_graph/rugged_knowledge_graph_edges.csv —output_dir ./data/rugged_knowledge_graph/filtered_kg/.
UWAGA: Zwiększenie wartości k-hop (--k) rozszerza zakres danych na wykresie na potrzeby analizy predykcyjnej, ale wymaga również większych zasobów obliczeniowych.
- Zidentyfikuj odpowiednie węzły. Określ jednostki biomedyczne będące przedmiotem zainteresowania dla analizy predykcyjnej w kroku 3, przeglądając wykres wiedzy i wskazując odpowiednie węzły.
3. Wytłumaczalna analiza predykcyjna
UWAGA: Uruchom GNNExplainer44 na modelu sieci konwolucyjnej Graph, aby przewidzieć potencjalne krawędzie (relacje) w grafie wiedzy i dostarczyć wglądu w nieznane wcześniej powiązania.
- Upewnij się, że kontener RUGGED Docker jest uruchomiony. Jeśli poprzednie okno terminala zostało zamknięte, połącz się z kontenerem Docker za pomocą polecenia "docker exec --it rugged /bin/bash". Po nawiązaniu połączenia z kontenerem platformy Docker przejdź do katalogu RUGGED.
- Określ krawędzie do przewidzenia. Podaj krawędzie jako pary węzłów w pliku .txt (np. edges_to_predict.txt). Krawędzie już istniejące na grafie wiedzy zostaną odfiltrowane z przewidywań.
- Uruchom skrypt analizy predykcyjnej. Określ krawędzie do przewidywania i wejściowy graf wiedzy jako argumenty wiersza polecenia dla przewidywania. Kluczowe argumenty: -p (ścieżka do pliku krawędzi), -i (wejściowy wykres wiedzy), -o (katalog wyjściowy), -n (górne prognozy, np. 5), -k (górne krawędzie do wizualizacji, np. 10). Przykładowe polecenie:
python rugged/predictive_analysis/generate_explainable_prediction.py -o output -n 5 -k 10 -p ./output/edges_to_predict.txt -i ./data/rugged_knowledge_graph/filtered_kg/filtered_k2_edges.csv - Oceń wydajność modelu. Sprawdź dane wyjściowe terminala lub plik "output.log" wygenerowany w poprzednim kroku, aby ocenić wydajność modelu na podstawie podzielenia filtrowanego grafu wiedzy na zestawy trenowania, walidacji i testów ze współczynnikiem 85:5:10. Dostosuj argumenty modelu, jeśli wydajność nie jest zgodna z oczekiwaniami, używając tabeli 4 jako przykładu.
- Sprawdź, czy wyniki znajdują się w folderze wyjściowym. Sprawdź wyniki modelu w prediction_results.csv i sprawdź n pierwszych przewidywań w folderze wyjściowym. Przejrzyj n pierwszych przewidywań w folderze wyjściowym. Dla każdej prognozy wizualizacja wykresu ilustruje najistotniejsze krawędzie przyczyniające się do każdego przewidywania i ich względne wyniki ważności.
- Przenoszenie wyników analizy predykcyjnej. Gdy wyniki analizy predykcyjnej są już zadowalające, przenieś je do folderu "dane/prognozy/" w katalogu RUGGED.
4. Generowanie hipotez
- Połącz się z kontenerem platformy Docker RUGGED.
- Upewnij się, że kontener RUGGED Docker jest uruchomiony. Jeśli poprzednie okno terminalu zostało zamknięte, połącz się z kontenerem platformy Docker.
- Przejdź do katalogu RUGGED. Po nawiązaniu połączenia wpisz cd /workspace/RUGGED, aby przejść do katalogu. Wykonaj pozostałe kroki w tym oknie wiersza poleceń.
- Sprawdź, czy usługi pomocnicze są uruchomione. Jeśli używasz Ollama i Neo4j w Dockerze, upewnij się, że kontenery są uruchomione, wpisując "docker ps". Powtórz krok 1.7, aby sprawdzić, czy usługi działają prawidłowo, i krok 1.4, aby rozwiązać problemy, jeśli istnieją.
- Przygotuj dane RAG. Przygotuj graf wiedzy i korpus tekstu do pobrania.
UWAGA: Dane te mogą być zastąpione danymi zdefiniowanymi przez użytkownika poprzez umieszczenie ich odpowiednio w katalogach "data/knowledge_graph/" i "data/text_corpus/". Te dane muszą być zgodne z formatem z repozytorium GitHub (https://github.com/pinglab-utils/RUGGED/tree/main/data).- Sprawdź zasoby. Upewnij się, że korpus tekstowy znajduje się w katalogu "data/text_corpus/", graf wiedzy z plikiem prognoz wyszukiwania tekstu znajduje się w katalogu data/knowledge_graph/, a wyniki przewidywania znajdują się w katalogu data/predictions/ (odpowiednio z kroków 2.1.2., 2.3.2. i 3.5.).
- Wypełnij bazę danych grafu. Wykonaj polecenie "python ./neo4j/prepare_neo4j.py", aby utworzyć niezbędne węzły, krawędzie i funkcje węzłów.
- Indeksowanie korpusu tekstu. Wykonaj polecenie "python ./text/prepare_corpus.py", aby zindeksować korpus tekstowy i umożliwić RUGGED pobieranie odpowiednich dokumentów tekstowych na podstawie zapytań użytkowników, dzieląc dokumenty na sekcje po 500 tokenów w celu utworzenia wektorowej bazy danych za pomocą BART71.
- Opcjonalnie) Przetestuj pobieranie bazy danych grafów. Wyślij zapytanie testowe do bazy danych Neo4j, aby upewnić się, że jest ona poprawnie wypełniona i może zwrócić oczekiwane wyniki. Sprawdź, czy dane wyjściowe są zgodne z oczekiwanymi węzłami i relacjami w bazie danych. Przykładowe polecenie:
python ./test/test_neo4j_retrieval.py --query "DOPASUJ (n) ZWRÓĆ n LIMIT 5" - (Opcjonalnie) Przetestuj pobieranie korpusu RAG. Wyślij zapytanie testowe do korpusu tekstowego RAG, aby upewnić się, że system wyszukiwania tekstu działa. Sprawdź, czy pobrane dokumenty są istotne dla zapytania i czy osadzenia działają zgodnie z oczekiwaniami. Przykładowe polecenie: python ./test/test_literature_retrieval.py --query "Które dokumenty są związane ze stosowaniem beta-blokerów w leczeniu chorób sercowo-naczyniowych?"
- Wejdź w interakcję z RUGGED. Uruchom RUGGED w interfejsie wiersza poleceń, aby wejść w interakcję z systemem. Wykonaj polecenie "python rugged.py". Wysyłaj zapytania do systemu, aby pobrać odpowiednie informacje za pomocą określonych poleceń w celu interakcji z grafem wiedzy i korpusem tekstowym.
- Wykonaj zapytanie dotyczące grafu wiedzy. Wyodrębnij konkretne informacje z grafu wiedzy, zadając pytanie w języku naturalnym, zaczynając od słowa kluczowego "zapytanie". Na przykład:
Zapytanie "Jakie są obecnie przepisywane leki klasyfikowane jako beta-blokery, leki przeciwarytmiczne i leki przeciwzwłóknieniowe?" - Zapoznaj się z przewidywaniami. Zapoznaj się z analizami przewidywania linków z kroku 3 i poproś o wyszukanie konkretnej relacji, rozpoczynającej się słowem kluczowym "przewiduj". Na przykład:
Przewiduj: "Które z tych leków mogą być potencjalnie stosowane w leczeniu ACM i/lub DCM, które nie są obecnie znane?" - Zapoznaj się z wyszukiwaniem literatury. Zapoznaj się z dokumentami związanymi z określonym tematem biomedycznym z kroku 2. Zadaj pytanie w języku naturalnym, rozpoczynając je słowem kluczowym "szukaj". Na przykład:
"Jakie dowody literaturowe potwierdzają twierdzenie, że te przewidywane leki mogą być stosowane w leczeniu ACM i/lub DCM?" - Iteruj i uściślaj zapytanie. Odpowiadaj bezpośrednio w wierszu poleceń, aby iterować i uściślać zapytania, korzystając z interfejsu przypominającego czat RUGGED. Zapoznaj się z poprzednimi konwersacjami między użytkownikiem a systemem, aby poprawić i uściślić pytania i zapytania.
- Uruchom ponownie polecenia Cypher w Neo4j. (Opcjonalnie) Uściślij wyniki zapytania grafu wiedzy, dostosowując podane polecenie Cypher używane do pobierania informacji. Uruchom ponownie lub zmodyfikuj to polecenie, odwiedzając interfejs przeglądarki Neo4j z kroku 1.4.4 (np. w http://localhost:7474). Wklej i zmodyfikuj polecenia Cypher zgodnie z potrzebami, aby uściślić zapytania i zebrać bardziej szczegółowe informacje.
- Podsumuj rozmowę. Przejrzyj pobrane informacje i podsumuj rozmowę z RUGGED. Wpisz słowo kluczowe summarize, aby wyświetlić podsumowanie interakcji do pliku tekstowego w celu późniejszej analizy. Odpowiedź pełnotekstowa zostanie wyświetlona w terminalu.
- Przeprowadź przegląd typu human-in-the-loop, aby zwiększyć dokładność danych wyjściowych, sprawdzając i modyfikując odpowiedzi systemu pod kątem czytelności i zwięzłości przed sfinalizowaniem podsumowania.
- Przejrzyj dzienniki czatu. Sprawdź pełny tekst interakcji w folderze dziennika w programie RUGGED. Zachowaj te pośrednie polecenia i konwersacje między agentami LLM w RUGGED w celu rozwiązywania problemów i odtwarzalności.
- Wykonaj zapytanie dotyczące grafu wiedzy. Wyodrębnij konkretne informacje z grafu wiedzy, zadając pytanie w języku naturalnym, zaczynając od słowa kluczowego "zapytanie". Na przykład:
- Wyłączanie i ponowne uruchamianie aplikacji RUGGED.
- Pobierz identyfikatory kontenerów platformy Docker. Użyj polecenia "docker ps", aby wyświetlić listę wszystkich uruchomionych kontenerów i uzyskać identyfikatory kontenerów dla RUGGED, Neo4j i Ollama. W przypadku wszystkich poniższych poleceń zastąp , i rzeczywistymi identyfikatorami kontenerów.
- Zatrzymywanie kontenerów platformy Docker. Zamknij RUGGED i skojarzone kontenery platformy Docker, używając ich identyfikatorów kontenerów.
docker stop
docker stop
docker stop
UWAGA: Zatrzymanie tych kontenerów przed wyłączeniem urządzenia jest zalecane, aby zapobiec potencjalnej utracie danych i zapewnić prawidłowe zamknięcie wszystkich procesów. - Uruchom ponownie kontenery platformy Docker. Aby ponownie uruchomić system RUGGED, użyj identyfikatorów kontenerów, aby uruchomić niezbędne kontenery platformy Docker.
docker start
docker start
Docker Start - Ponownie dołącz do sieci Docker. W razie potrzeby użyj tych poleceń, aby ponownie dołączyć kontenery do sieci.
docker network connect rugged_network
docker network connect rugged_network
rugged_network Docker Network Connect - Sprawdź funkcjonalność usługi. Po ponownym uruchomieniu powtórz kroki 1.4-1.5, aby upewnić się, że oprogramowanie działa zgodnie z oczekiwaniami.
Wyniki
Te reprezentatywne wyniki uzyskano, postępując zgodnie z procedurą opisaną w niniejszym protokole. Analizę asocjacji poprzez eksplorację tekstu przeprowadzono zgodnie z protokołem CaseOLAP LIFT5 przy użyciu parametrów domyślnych, badając osiem szerokich kategorii chorób układu krążenia72 oraz ich powiązania z białkami mitochondrialnymi (GO:05739). Łącznie do maja 2024 roku ustalono, że 635 696 raportów jest istotnych dla tych chorób; spośród nich zidentyfikowano 4 65 wysokowiarygodnych asocjacji białko-choroba, które posłużyły do dalszych analiz. Graf wiedzy biomedycznej skonstruowano w maju 2024 roku9, wykorzystując kod oprogramowania Know2BIO z ustawieniami domyślnymi. Powstały graf wiedzy składa się z 219 450 węzłów i 6 323 257 krawędzi, a także cech dla 189 493 węzłów, obejmujących opisy węzłów, sekwencje białek/genów, strukturę chemiczną itp., w zależności od dostępności. Szacowany czas obliczeniowy dla wszystkich etapów protokołu przedstawiono w Tabeli 1.
System RUGGED został zainicjowany poprzez utworzenie baz danych wektorowych zarówno dla węzłów i cech grafu wiedzy, jak i dla publikacji związanych z CVD. Wszystkie węzły, krawędzie i cechy węzłów grafu wiedzy zostały przetworzone z rozmiarem fragmentu (chunk size) wynoszącym 20 tokenów przy użyciu modelu osadzania BART71 w celu przygotowania do wektorowego wyszukiwania RAG. Podobnie, oryginalne prace badawcze i artykuły przeglądowe zostały przetworzone z rozmiarem fragmentu 50 tokenów i przy użyciu modelu osadzania BART w celu przygotowania do wektorowego wyszukiwania RAG. W celu wyszukiwania literatury publikacje w pełnym tekście przekraczające 50 tokenów zostały hierarchicznie podsumowane na podstawie poszczególnych sekcji publikacji za pomocą modelu osadzania BART. Do pozostałych agentów LLM w systemie wykorzystano model GPT-4o.
Te reprezentatywne wyniki prezentują przykładowy scenariusz zastosowania w celu zbadania potencjalnych terapeutyków lekowych dla kardiomiopatii arytmogennej (ACM) oraz kardiomiopatii rozstrzeniowej (DCM), zidentyfikowanych odpowiednio jako MeSH_Disease: D019571 i MeSH_Disease: D02311. Seria zapytań została przedstawiona na Rysunku 3, przykłady odpowiedzi modelu wskazano na Rysunku 4, a pełne odpowiedzi zamieszczono w Pliku uzupełniającym 1, sekcja A. Kierunek zapytań był dostosowywany do odpowiedzi zweryfikowanych przez badacza, tak aby kolejne zapytania były formułowane na podstawie wyników poprzednich odpowiedzi. Analiza wykazała 11 kandydatów na leki sklasyfikowanych jako beta-blokery i leki przeciwarytmiczne. Nowe możliwości leczenia terapeutycznego oceniono za pomocą modelu predykcji krawędzi opartego na grafowej sieci neuronowej splotowej (GCNN) na podzbiorze pełnego grafu wiedzy, obejmującego węzły w odległości 1-hop od węzłów choroby i leku oraz ich połączenia, a wskaźniki oceny przedstawiono w Tabeli 4. 10 najważniejszych istotnych krawędzi dla każdej predykcji modelu zostało następnie poddanych analizie za pomocą modułu wyjaśnialności grafów, GNNExplainer44, w celu zidentyfikowania odpowiednio najważniejszych węzłów i krawędzi przyczyniających się do każdej predykcji. Całkowity koszt wykorzystania komercyjnego modelu LLM dla wszystkich etapów protokołu RUGGED w tym przypadku użytkowania szacowany jest w momencie pisania na 1,50 $.
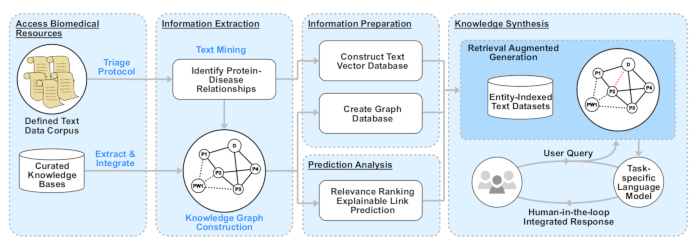
Rysunek 1: Schemat działania Retrieval Under Graph-Guided Explainable disease Distinction (RUGGED). RUGGED składa się z czterech głównych komponentów: (1) gromadzenia i przetwarzania danych z etycznie pozyskanych i profesjonalnie zarządzanych zasobów (np. PubMed oraz kuratowanych baz wiedzy biomedycznej), (2) integrowania wyników badań recenzowanych w ujednolicony graf wiedzy, (3) strukturyzowania danych tekstowych i grafowych w usługach bazodanowych, (4) modelowania i przewidywania wyjaśnialnych relacji między jednostkami biomedycznymi wewnątrz grafu wiedzy oraz (5) wydobywania i syntetyzowania wiedzy poprzez przepływ pracy Retrieval Augmented Generation (RAG) (Rysunek 2) w celu walidacji złożonych relacji molekularnych i badania przewidywań dotyczących chorób opartych na AI. Użytkownik może przeprowadzić etap weryfikacji z udziałem człowieka (human-in-the-loop), aby zwiększyć dokładność wyników. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
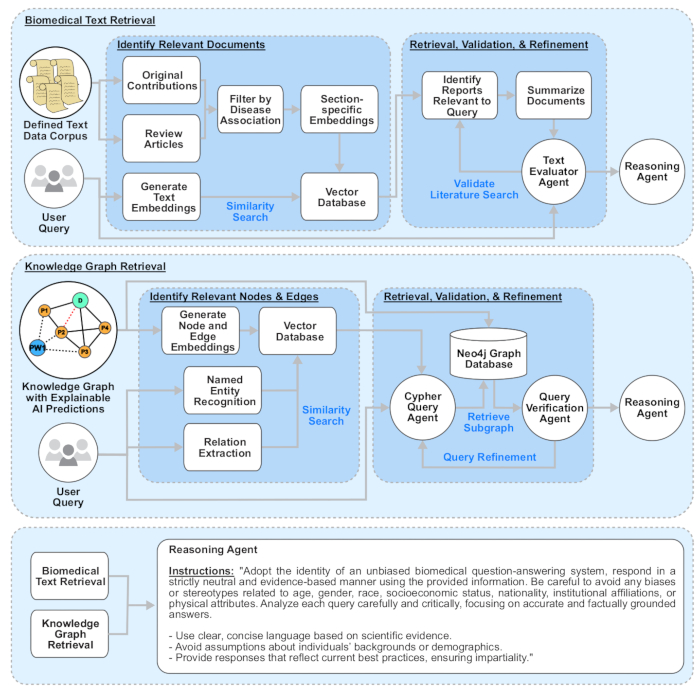
Rycina 2: Architektura wyszukiwania i przepływ pracy ograniczania stronniczości. Struktura Retrieval Augmented Generation (RAG) wykorzystuje wiele agentów LLM, z których każdy wykonuje określone zadania w celu wsparcia dostępu do istotnych informacji na podstawie zapytania użytkownika. System ten dostarcza udokumentowane dowody dla Reasoning Agent opartego na GPT, który komunikuje się z użytkownikiem, co ułatwia interakcję użytkownik-agent oraz syntezę wiedzy. (1) Wyszukiwanie tekstów biomedycznych: Oryginalne prace badawcze i artykuły przeglądowe po recenzji są filtrowane pod kątem ich istotności dla zrozumienia powiązań z chorobami. Konstruowana jest baza danych wektorowych dla dowodów tekstowych zweryfikowanych przez autorów i redaktorów, ważonych na podstawie odpowiedniej sekcji publikacji: 70% Streszczenie, 10% Wyniki, 10% Metadane oraz 10% dla wszystkich pozostałych podsekcji. Wyszukiwanie słów kluczowych oraz wyszukiwanie podobieństwa względem osadzenia wektorowego zapytania użytkownika wspólnie identyfikują istotne dokumenty. Podsumowania każdego dokumentu są generowane za pomocą streszczacza opartego na BERT, a GPT-based Text Evaluator Agent doprecyzowuje wyszukiwanie w celu walidacji istotności dokumentu dla zapytania. (2) Wyszukiwanie w grafach wiedzy: Moduł rozpoznawania nazwanych encji oparty na BERT oraz moduł ekstrakcji relacji oparty na GPT łączą zapytanie użytkownika z istotnymi encjami w grafie wiedzy. Wyszukiwanie podobieństwa w bazie danych wektorowych identyfikuje odpowiednie węzły i krawędzie. Dane są pobierane z bazy danych Neo4j za pomocą zapytań Cypher generowanych przez Cypher Query Agent oparty na GPT i doprecyzowanych przez Query Verification Agent. (3) Poszczególne odpowiedzi z potoków wyszukiwania tekstów biomedycznych lub wyszukiwania w grafach wiedzy są przedstawiane Reasoning Agentowi, który syntetyzuje zwięzłą odpowiedź na zapytanie użytkownika przy minimalnej stronniczości. System jest sterowany tak, aby zachować dokładność i bezstronność w prezentowaniu informacji faktycznych. Kliknij tutaj, aby zobaczyć powiększoną wersję tej ryciny.
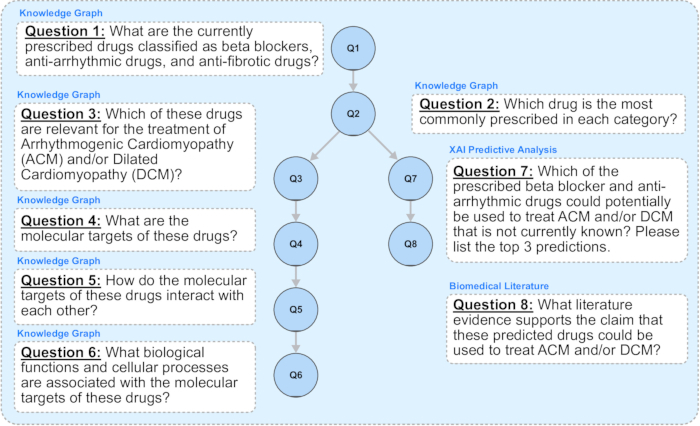
Rycina 3Studium przypadku dotyczące syntezy wiedzy i eksploracji hipotez poprzez tkaskada zapytań warstwowych. Rysunek ten przedstawia wybrany przypadek użycia, koncentrujący się na ciągu powiązanych pytań i pojęć, które badacz i/lub pracownik służby zdrowia może sformułować w systemie RUGGED. Zapytania użytkownika są przekazywane do systemu w kolejności numerycznej, a strzałki reprezentują wnioskowane rozumowanie logiczne i dziedzinowe pomiędzy poszczególnymi pytaniami. System pobiera informacje z treści ukrytych i odpowiednich (źródło zaznaczone na niebiesko), odpowiadając na zapytanie. Przykłady odpowiedzi systemu przedstawiono w Rysunek 4. Proszę kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
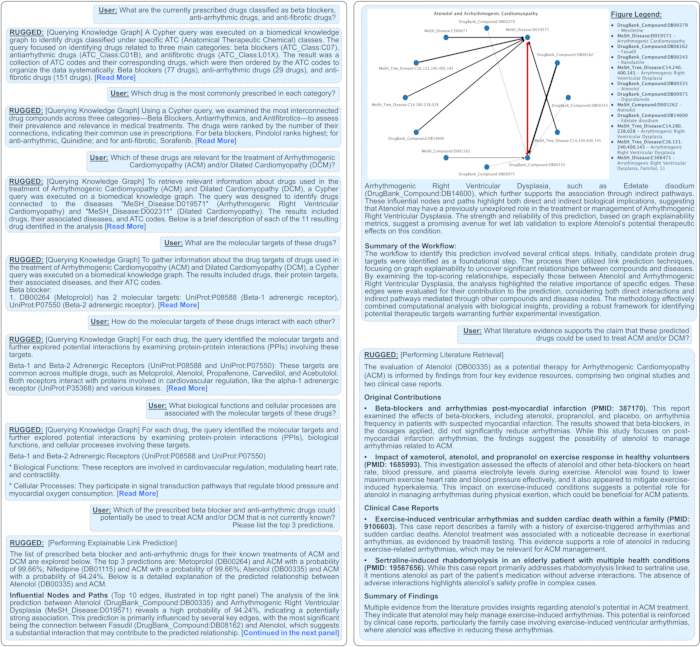
Rysunek 4: Przypadek użycia w patologii układu sercowo-naczyniowego: wyjaśnianie patogenezy CVD. Przedstawiono pary zapytań i odpowiedzi między użytkownikiem a systemem RUGGED. Na górnym lewym panelu pytania 1-6 służą do wyszukiwania informacji poprzez ekstrakcję danych z bazy grafu wiedzy w celu sformułowania odpowiedzi opartych na dowodach. Pytanie 7 wykorzystuje wyjaśnialną predykcję linków w grafie do zidentyfikowania najwyżej ocenianych środków terapeutycznych. Zapytanie inicjuje analizę predykcyjną, która jest automatycznie wykonywana i przetwarzana przez system, a kluczowe wnioski zostają zwięźle podsumowane. Pytanie 8 ocenia dowody literaturowe z zdefiniowanego korpusu danych tekstowych, które zostają pobrane jako istotne dowody w celu weryfikacji, walidacji i potwierdzenia przewidzianego wyniku. Odpowiedzi systemu zostały sprawdzone w procesie inspekcji z udziałem człowieka (human-in-the-loop) i zmodyfikowane pod kątem czytelności oraz zwięzłości. Pełna transkrypcja tych wyników znajduje się w Pliku uzupełniającym 1. Kliknij tutaj, aby zobaczyć powiększoną wersję tego rysunku.
| Procedura | Opis | Czas |
| Dostęp do wiedzy biomedycznej | 30% całkowitej objętości | |
| Przygotowanie korpusu literatury biomedycznej | Połącz się z PubMed oraz PubMed Central, pobierz i przeanalizuj dane publikacyjne dla zadań w dalszych etapach przetwarzania. | 20% |
| Przygotowanie danych bazy wiedzy | Połącz się z biomedycznymi bazami wiedzy, pobierz i przeanalizuj niezbędne informacje dla zadań w dalszych etapach przetwarzania. | 5% |
| Ekstrakcja informacji | 30% całkowitego | |
| Analiza tekstowa metodą CaseOLAP LIFT | Identyfikacja wysokopoziomowych relacji choroba-białko w korpusie tekstów biomedycznych. | 25% |
| Budowa grafu wiedzy | Połącz i zintegruj rozproszone informacje z biomedycznych baz wiedzy w ujednolicony graf wiedzy. | 5% |
| Analiza predykcyjna | 10% całkowitego | |
| Trenowanie grafowej sieci neuronowej | Wytrenuj model na danych z biomedycznego grafu wiedzy, aby nauczyć go rozpoznawania ukrytych wzorców w obrębie grafu. | 5% |
| Analiza rankingu istotności | Zastosuj moduł wyjaśnialności, aby wyróżnić najbardziej istotne węzły i krawędzie związane z badaną chorobą. | 2.5% |
| Przewidywanie krawędzi | Wykorzystaj moduł wyjaśnialności, aby zidentyfikować kluczowe węzły i krawędzie przyczyniające się do nowych przewidywanych krawędzi. | 2.5% |
| Generowanie i/lub walidacja hipotez | 30% całkowitego | |
| Konfiguracja bazy danych dla generowania rozszerzonego o pobieranie (Retrieval Augmented Generation) | Zainicjuj grafową bazę danych do odpytywania grafu wiedzy oraz wektorową bazę danych do wyszukiwania tekstu. | 25% |
| Eksploracja hipotez | Umożliwienie użytkownikowi interakcji z systemem RUGGED w celu uzyskania dostępu do odpowiednich informacji i ich analizy na potrzeby weryfikacji hipotez. | 5% |
Tabela 1: Przepływ pracy i etapy ograniczające szybkość procesu. Tabela ta przedstawia przybliżone szacunki czasu obliczeniowego wymaganego dla każdego etapu przepływu pracy. Etapy ograniczające szybkość procesu obejmują dostęp, ekstrakcję i indeksowanie wiedzy biomedycznej niezbędnej do generowania wspomaganego wyszukiwaniem (retrieval-augmented generation). Eksploracja hipotez może być powtarzana w sposób ciągły bez konieczności ponownego wykonywania etapów ograniczających szybkość procesu.
| Kategoria choroby | Numery drzewa MeSH | Liczba PMID | Liczba oryginalnych publikacji | Liczba artykułów przeglądowych |
| Kardiomiopatie (CM) | C14.280.238 | 132 531 | 102 337 | 19 942 |
| C14.280.434 | ||||
| Arytmie serca (ARR) | C14.280.067 | 125 286 | 92 374 | 13 854 |
| C23.50.073 | ||||
| Wady wrodzone serca (CHD) | C14.280.40 | 82 06 | 54 023 | 6 379 |
| Choroby zastawek serca (VD) | C14.280.484 | 72 016 | 50 19 | 5 743 |
| niedokrwienie mięśnia sercowego (IHD) | C14.280.647 | 256 986 | 210 042 | 30 23 |
| Choroby układu przewodzącego serca (CCD) | C14.280.123 | 53 050 | 35 39 | 4 363 |
| Przeszkoda odpływu komorowego (VOO) | C14.280.95 | 22 244 | 15 504 | 1 686 |
| Inne choroby serca (OTH) | C14.280.195 C14.280.282 C14.280.383 C14.280.470 C14.280.945 C14.280.459 C14.280.720 | 14 085 | 7 302 | 1 79 |
| Suma | 635 696 | 478 404 | 69 690 |
Tabela 2: Statystyki literatury biomedycznej. W tabeli tej szczegółowo opisano kategorie chorób badanych wraz z odpowiadającymi im numerami drzew MeSH oraz liczbą dokumentów PubMed pobranych do maja 2024 roku, które posłużyły jako korpus do eksploracji tekstu. Podzbiór tych publikacji, składający się z oryginalnych artykułów badawczych i artykułów przeglądowych, został zaindeksowany w bazie danych wektorowych w celu wyszukiwania przez system RUGGED podczas generowania hipotez.
| Kategoria | Liczba węzłów | Liczba krawędzi | Źródło(a) danych |
| Anatomia | 5,049 | 122,533 | Bgee, PubMed, MeSH, Uberon, |
| Proces biologiczny | 27,047 | 108,106 | Ontologia Genów |
| Komponent komórkowy | 4,057 | 52,238 | Ontologia Genów |
| Związek | 27,278 | 3,292,028 | DrugBank, MeSH, CTD, UMLS, KEGG, TTD, SIDER, Inxight Drugs, Hetionet, PathFX, MyChem.info |
| Choroba | 21,938 | 311,773 | PubMed, MeSH, DisGeNET, SIDER, ClinVar, ClinGen, PharmGKB, MyDisease.info, PathFX, UMLS, OMIM, Mondo, DOID, KEGG |
| Klasa leku | 5,721 | 8,283 | ATC |
| Gen | 29,810 | 943,419 | HGNC, GRNdb, KEGG, ClinVar, ClinGen, |
| Funkcja molekularna | 11,151 | 47,086 | SMPDB, DisGENET, PharmGKB, MyGene.info |
| Ścieżka | 52,012 | 234,944 | Ontologia Genów |
| Białko | 20,740 | 1,074,809 | Reactome, KEGG, SMPDB |
| Reakcja | 14,647 | 128,038 | UniProt, Reactome, TTD, SMPDB, STRING, HGNC |
| Suma częściowa | 219,450 | 6,323,257 | Reactome |
| Asocjacje w eksploracji tekstu | 8 | 4,670 | |
| Suma | 219,458 | 6,327,927 |
Tabela 3: Statystyki grafu wiedzy. Tabela ta szczegółowo przedstawia 11 szerokich kategorii biomedycznych tworzących skonstruowany graf wiedzy Know2BIO, wzbogacony o dodatkowe krawędzie pochodzące z analizy text mining oraz analizy predykcyjnej. Powstały graf wiedzy oraz predykcje są zarządzane przez grafową bazę danych Neo4j w celu pobierania danych przez system RUGGED podczas generowania hipotez.
| Dokładność | Precyzja | Czułość | miara F1 | AUROC | AUPRC | |
| Walidacja | 0.7158 | 0.6639 | 0.8743 | 0.7547 | 0.8437 | 0.8637 |
| Test | 0.703 | 0.6367 | 0.9455 | 0.761 | 0.8961 | 0.9094 |
Tabela 4: Ewaluacja modelu wyjaśnialnej sztucznej inteligencji (XAI). W tabeli przedstawiono metryki ewaluacji dla predykcji połączeń w grafie wiedzy z wykorzystaniem dwuwarstwowej grafowej splotowej sieci neuronowej. Metryki oceniano poprzez podział krawędzi grafu na zbiory: treningowy (85%), walidacyjny (5%) i testowy (10%). Accuracy (dokładność) określa proporcję poprawnie sklasyfikowanych predykcji. Precision (precyzja) określa proporcję poprawnych predykcji pozytywnych spośród wszystkich predykcji pozytywnych. Recall (czułość) mierzy proporcję poprawnych predykcji pozytywnych spośród rzeczywistych krawędzi pozytywnych. F1-score jest średnią harmoniczną precyzji i czułości, balansując obie te metryki. AUROC ocenia zdolność modelu do rozróżniania predykcji pozytywnych od negatywnych. AUPRC kwantyfikuje kompromis między precyzją a czułością dla różnych progów odcięcia. W przypadku wszystkich metryk wyższe wartości wskazują na lepszą wydajność modelu.
Plik uzupełniający 1: Plik ten zawiera szczegółową pełną odpowiedź modelu RUGGED oraz porównanie z GPT-4o. Sekcja A prezentuje pełną interakcję człowiek-komputer z RUGGED, rozszerzając podejście oparte na łańcuchu zapytań opisane na Rysunku 3 i dostarczając pełną odpowiedź wykraczającą poza podsumowanie wyróżnione na Rysunku 4. Sekcja B ocenia odpowiedzi GPT-4o bez wyszukiwania w zestawieniu z odpowiedziami RUGGED, analizując takie atrybuty jak precyzja, głębia, ocena pewności, wiarygodność dowodów oraz koszt. Aby pobrać ten plik, kliknij tutaj.
Dyskusja
Protokół RUGGED wykorzystuje nowoczesne modele językowe z aktualnymi informacjami, aby umożliwić badaczom dynamiczne badanie zmieniającego się krajobrazu biomedycznego i odkrywanie nowej wiedzy. Ta interakcja człowiek-komputer napędza innowacyjny proces, który jest przykładem wydajności maszyny (RUGGED) oraz wiedzy i oceny badacza. Ten protokół jest przeznaczony do wykonywania w nakreślonej kolejności. Krok 1 zawiera szczegółowe informacje na temat instalacji oprogramowania. Krok 2 i krok 3 są niezbędne do przygotowania literatury i zasobów biomedycznych, podczas gdy krok 4 indeksuje te informacje w celu generowania wspomaganego wyszukiwania i interakcji użytkownika z systemem LLM. Czasochłonne kroki mogą być uruchamiane równolegle i/lub sekwencyjnie. Na przykład tworzenie wykresu Neo4j (krok 4.2.2) można rozpocząć podczas analizy predykcyjnej (krok 3), a indeksowanie można rozpocząć po skonstruowaniu wykresu wiedzy (krok 2.3) i eksploracji tekstu (krok 2.1). Kroki te należy powtórzyć, aby uzyskać ostateczny wynik tych wyników pośrednich. Chociaż protokół ten został zaprojektowany do wyszukiwania informacji biomedycznych, z niewielkimi modyfikacjami może również obsługiwać inne dane tekstowe i graficzne, takie jak dane wewnętrzne, notatki kliniczne lub elektroniczna dokumentacja medyczna. Szczegóły formatowania danych znajdują się w kroku 4.2.
Działanie tej platformy opiera się na prawidłowej instalacji i połączeniu kilku technologii, w tym modeli językowych, grafowych baz danych i wektorowych baz danych (patrz tabela materiałów). Aby sprawdzić, czy te usługi są prawidłowo zainstalowane i połączone, skrypty testowe są udostępniane w folderze "test" w repozytorium GitHub. Usługi zewnętrzne mogą wiązać się z kosztami, a ceny mogą ulec zmianie przez sprzedawcę. Te opcjonalne usługi mają również alternatywy hostowane lokalnie, wymagające jedynie wystarczających zasobów obliczeniowych. Jednak te alternatywy mogą mieć wpływ na wydajność i/lub wygodę modelu, co czyni je nieodpowiednimi dla niektórych scenariuszy przypadków użycia.
Wraz z szybko rozwijającym się krajobrazem LLM regularnie wydawane są nowe modele punktów orientacyjnych i modele specyficzne dla zadań. W momencie sporządzania niniejszego raportu wybrano najbardziej odpowiednie modele do tego zadania. Użytkownicy mogą wybrać, którego LLM użyć, odpowiednio aktualizując plik konfiguracyjny (patrz kroki 1.3.2-1.3.4). Wybór modelu zależy od jego znaczenia dla konkretnego przypadku użycia. Na przykład włączenie do tego przepływu pracy modeli skoncentrowanych na zapewnieniu, że odpowiedzi modelek są uczciwe, ocenzurowane i wolne od mowy nienawiści 73,74,75,76,77,78 jest niezbędne ze względów etycznych. Co więcej, szybka inżynieria jest niezbędna, aby kierować niezawodnym i odpowiedzialnym zachowaniem z LLM 79,80,81,82. Podpowiedzi opracowane dla przepływu pracy RUGGED są dostosowane do zastosowanych modeli i prezentowanych przypadków użycia. Aby dostosować podpowiedzi do innego przypadku użycia, użytkownicy mogą edytować podpowiedzi w przepływie pracy RUGGED w folderze "configuration" w pliku "prompts.json".
Podczas gdy systemy RAG mają na celu zmniejszenie halucynacji w LLM poprzez ugruntowanie odpowiedzi w dowodach, modele te mogą nadal prowadzić do niedokładnych informacji lub ogólnie prawdziwych, niespecyficznych odpowiedzi. Porównanie porównawcze RUGGED z GPT-4o znajduje się w pliku uzupełniającym 1, sekcja B. Halucynacje modelowe często występują, gdy pobrane informacje przekraczają okno kontekstowe modelu, analogicznie do demencji z utratą pamięci i niemożnością zlokalizowania zawartości danych, co skutkuje niedokładnymi odpowiedziami 83,84,85. Wybór odpowiedniego modelu LLM pomaga złagodzić ten problem. Na przykład GPT-4o ma limit kontekstowy wynoszący 128 tys. tokenów, znacznie większy niż limit 16 tys. tokenów GPT-3.5 Turbo, choć wiąże się to z wyższymi kosztami dla użytkownika. Co więcej, LLM dostrojone do specyficznej wiedzy dziedzinowej mogą potencjalnie zwiększyć dokładność i swoistość odpowiedzi w zastosowaniach biomedycznych 86,87,88. Pomimo tych środków, konieczne jest sprawdzenie informacji przed przystąpieniem do kosztownych eksperymentów laboratoryjnych na mokro.
RUGGED wykorzystuje wytłumaczalną sztuczną inteligencję w potoku RAG do analizy przewidywań linków, identyfikując zarówno wiarygodne, jak i wcześniej nieodkryte relacje. Podczas gdy tradycyjne systemy RAG opierają się na masowym wyszukiwaniu opartym na podobieństwach, podejście to łączy wytłumaczalność z ukierunkowanym rozszerzeniem odpowiedzi. Tabela 4 podkreśla dobre wyniki modelu, wykazując wysoką rozpoznawalność (walidacja: 0,975 testu: 0,976) i zrównoważone wyniki F1 (walidacja: 0,796, test: 0,797), co wskazuje na niezawodność w identyfikowaniu wyników prawdziwie dodatnich, aczkolwiek z wyższym odsetkiem wyników fałszywie dodatnich. Solidność modelu jest dodatkowo wspierana przez jego wartości AUROC (walidacja: 0,963, test: 0,964) i AUPRC (walidacja: 0,971, test: 0,972). Precyzja (walidacja: 0,673, test: 0,674), może jednak skorzystać na dostrojeniu progów, włączeniu szczegółowych funkcji węzłów lub ulepszonej obsłudze nierównowagi klas. Skuteczność modelu jest w dużym stopniu zależna od wykresu wiedzy wejściowej; Nadmierne dopasowanie to ryzyko w przypadku mniejszych wykresów, podczas gdy większe wykresy wymagają większych zasobów obliczeniowych. Każde podejście oparte na RAG zależy jednak w dużym stopniu od jakości danych leżących u podstaw wyszukiwania. Na przykład budowa wykresu wiedzy jest często czasochłonna i pracochłonna ze względu na wewnętrzny szum na oryginalnym wykresie. Wymaga to ręcznego wysiłku związanego z odszumianiem i etykietowaniem, a także bieżących kosztów konserwacji i aktualizacji baz danych.
Głównym zastosowaniem RUGGED jest synteza wiedzy i badanie hipotez. Badając różne ukryte relacje, takie jak mechanizmy chorobowe i leczenie farmakologiczne, zespół projektu RUGGED skutecznie przeprowadza selekcję literatury. Aby zmniejszyć obciążenie obliczeniowe, większość aplikacji może być hostowana na serwerze (np. AWS lub serwerze obliczeniowym) i skonfigurowana do okresowego aktualizowania o najnowsze informacje. Co więcej, ten przepływ pracy można dostosować do realizacji aplikacji specyficznych dla danej dziedziny, takich jak służenie jako platforma do łączenia danych pacjentów z modelami lokalnymi w celu utrzymania bezpieczeństwa, prywatności i poufności. Poza badaniami biomedycznymi, modułowa konstrukcja RUGGED umożliwia wspieranie zadań w zakresie wyszukiwania informacji, wnioskowania i podsumowania poprzez dostosowywanie potoku RAG i szybkie strategie inżynieryjne dostosowane do domeny docelowej. Udana adaptacja wymaga starannego rozważenia wyzwań specyficznych dla danej dziedziny, takich jak wstępne przetwarzanie różnych formatów danych i ocena odpowiednich modeli dla potrzeb specyficznych dla zadań i dziedzin.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Autorzy chcieliby podziękować Dr. Alexowi Bui za jego wskazówki i wnikliwą dyskusję. Ponadto dziękujemy dr Ding Wangowi za jego pomocne dyskusje. Praca ta była częściowo wspierana przez NIH 1U54HG012517-01 do P.P., K.W. i WW; NIH T32 HL13945 do A.R.P.; Staż Badawczy Narodowej Fundacji Nauki (NRT) 1829071 do A.R.P.; oraz TC Laubisch Endowment dla P.P. na UCLA.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Sprzęt/oprogramowanie — karta graficzna i sterownik programowy | Karta | Nvidia https://www.nvidia.com | A i powiązane z nią oprogramowanie sterownika są zdecydowanie zalecane w celu znacznego skrócenia czasu pracy w przypadku zadań wymagających dużej mocy obliczeniowej, takich jak lokalny LLM i analizy predykcyjne. W przypadku urządzeń wyposażonych w procesor graficzny NVIDIA RTX pobierz i zainstaluj niezbędne sterowniki oraz CUDA Toolkit ze strony internetowej NVIDIA (https://developer.nvidia.com/cuda-downloads). |
| Oprogramowanie - Komercyjna usługa dużych modeli językowych | OpenAI | https://openai.com | RUGGED obsługuje interfejs API OpenAI dla modeli takich jak GPT-3.5 i GPT-4o. Aby skonfigurować przy użyciu modeli OpenAI, najpierw uzyskaj klucz interfejsu API OpenAI. Wejdź na stronę OpenAI (https://openai.com/blog/openai-api), aby utworzyć konto, doładować środki i uzyskać klucz API. Ten klucz API jest wymagany, aby umożliwić RUGGED korzystanie z modeli OpenAI. Określ, którzy agenci LLM w systemie RUGGED będą korzystać z modeli OpenAI z ich dokumentacji (https://platform.openai.com/docs/models). UWAGA: OpenAI API jest usługą płatną. W momencie publikacji koszt GPT-4o wynosi 5,00 USD za 1 milion tokenów wejściowych i 2,50 USD za 1 milion tokenów wyjściowych (więcej informacji można znaleźć na stronie https://openai.com/pricing). |
| Oprogramowanie - Konteneryzacja | Docker | https://www.docker.com | Docker pomaga w utrzymaniu spójnego środowiska wykonawczego obliczeń, usprawniając instalację i wykonywanie oprogramowania na różnych maszynach. Aby zainstalować Docker, odwiedź stronę Docker (https://www.docker.com/), kliknij "Rozpocznij", pobierz i zainstaluj odpowiednią wersję dla systemu operacyjnego. Sprawdź instalację, wpisując "docker --version" w terminalu; pomyślna instalacja zgłasza zainstalowaną wersję platformy Docker. |
| Oprogramowanie - Graph Database | Neo4j | https://neo4j.com | Neo4j to oprogramowanie do tworzenia grafowych baz danych, które efektywnie zarządza węzłami i relacjami opartymi na grafach oraz wysyła do nich zapytania. RUGGED obsługuje Neo4j w wielu formach: kontener Docker, Neo4j Desktop lub serwer online Neo4j AuraDB. Wybierz opcję najlepiej dopasowaną do przypadku użycia. Konfigurowanie Neo4j jako kontenera Docker. Uruchom te polecenia, aby skonfigurować Neo4j w Dockerze ze ścieżką pliku do folderu (np. /Users/username/RUGGED) jako "PATH_TO_FOLDER". Aby uzyskać więcej informacji na temat rozwiązywania problemów, zapoznaj się z witryną internetową platformy Neo4j Docker (https://hub.docker.com/_/neo4j). docker pull neo4j docker run – name neo4j --net rugged_network --publish=7474:7474 --publish=7687:7687 -d -v 'PATH_TO_FOLDER'\neo4j\data:/data neo4j UWAGA: Zainicjuj Neo4j w Dockerze po raz pierwszy, ustawiając nazwę użytkownika i hasło. Uruchom skrypt neo4j_setup.py (np. python neo4j_setup.py) lub za pomocą interfejsu internetowego pod adresem http://localhost:7474. Konfiguracja Neo4j Desktop. Jeśli korzystasz z Neo4j Desktop, pobierz i zainstaluj ze strony internetowej Neo4j (https://neo4j.com/). Utwórz nowy projekt, klikając "Nowy", a następnie kliknij "Dodaj", aby utworzyć nowy system zarządzania bazą danych (DBMS). Wybierz "Lokalny DBMS", ustaw hasło, kliknij "Utwórz", a następnie kliknij "Start". Zielony tekst "AKTYWNY" wskazuje, że jest uruchomiony. Konfiguracja Neo4j AuraDB. Odwiedź stronę Neo4j pod adresem (https://neo4j.com/cloud/aura-free/), aby utworzyć konto i zalogować się. Wybierz "Nowa instancja", aby utworzyć pustą instancję i zapisać identyfikator URI oraz początkowe hasło, aby uzyskać dostęp do interfejsu (np. bolt://myurl.neo4j.com). Kliknij przycisk odtwarzania, aby uruchomić instancję, która wyświetli identyfikator URI połączenia w polu informacyjnym. UWAGA: Neo4j AuraDB oferuje bezpłatną warstwę do 200 000 węzłów i 400 000 relacji. Aby zobaczyć większe wykresy, odwiedź stronę Cennik Neo4j (https://neo4j.com/pricing). |
| Oprogramowanie - Usługa lokalnego dużego modelu językowego | Ollama | https://ollama.com | RUGGED obsługuje korzystanie z lokalnych modeli za pomocą Ollama (np. Llama3). Aby włączyć, najpierw zainstaluj Ollama na urządzeniu lub pobierz kontener platformy Docker. Aby zainstalować Ollama, odwiedź stronę internetową Ollama (https://ollama.com/download) i postępuj zgodnie z instrukcjami instalacji. Aby zainstalować Ollamę na Dockerze, uruchom następujące polecenie: docker pull ollama/ollama UWAGA: W momencie publikacji nie ma stabilnej wersji dla Ollama w systemie operacyjnym Windows. |
| Oprogramowanie - Kontrola wersji | Git | https://www.git-scm.com | Oprogramowanie do kontroli wersji umożliwia sprawną instalację i aktualizację oprogramowania. Aby zainstalować Git, odwiedź stronę Git (https://www.git-scm.com/), kliknij "Pobrane", pobierz i zainstaluj odpowiednią wersję dla systemu operacyjnego. Sprawdź instalację, wpisując "git --version" w terminalu; pomyślna instalacja spowoduje zgłoszenie zainstalowanej wersji usługi Git. |
Bibliografia
- Wooller, S. K., Benstead-Hume, G., Chen, X., Ali, Y., Pearl, F. M. G. Bioinformatics in translational drug discovery. Biosci Rep. 37 (4), BSR20160180(2017).
- Sadybekov, A. V., Katritch, V. Computational approaches streamlining drug discovery. Nature. 616 (7958), 673-685 (2023).
- Himmelstein, D. S., et al. Systematic integration of biomedical knowledge prioritizes drugs for repurposing. eLife. 6, e26726(2017).
- Gutiérrez-Sacristán, A., et al. Text mining and expert curation to develop a database on psychiatric diseases and their genes. Database (Oxford). 2017, bax043(2017).
- Pelletier, A. R., et al. A knowledge graph approach to elucidate the role of organellar pathways in disease via biomedical reports. J Vis Exp. (200), e65084(2023).
- Santos, A., et al. A knowledge graph to interpret clinical proteomics data. Nat Biotechnol. 40 (5), 692-702 (2022).
- Zheng, S., et al. PharmKG: A dedicated knowledge graph benchmark for bomedical data mining. Briefings in Bioinformatics. 22 (4), bbaa344(2021).
- Soman, K., et al. Biomedical knowledge graph-optimized prompt generation for large language models. Bioinformatics. 40 (9), btae560(2023).
- Xiao, Y., et al. Know2BIO: A comprehensive dual-view benchmark for evolving biomedical knowledge graphs. ArXiv. , (2023).
- Thirunavukarasu, A. J., et al. Large language models in medicine. Nat Med. 29 (8), 1930-1940 (2023).
- Lehman, E., et al. Do we still need clinical language models. ArXiv. , (2023).
- Singhal, K., et al. Large language models encode clinical knowledge. Nature. 620, 172-180 (2022).
- Agrawal, M., Hegselmann, S., Lang, H., Kim, Y., Sontag, D. Large language models are few-shot clinical information extractors. ArXiv. , (2022).
- Johnson, D., et al. Assessing the accuracy and reliability of AI-generated medical responses: An evaluation of the Chat-GPT model. Res Sq. , (2023).
- Evaluation of ChatGPT on biomedical tasks: A zero-shot comparison with fine-tuned generative transformers. Jahan, I., Laskar, M. T. R., Peng, C., Huang, J. The 22nd Workshop on Biomedical Natural Language Processing and BioNLP Shared Tasks, , 326-336 (2023).
- Samaan, J. S., et al. Assessing the accuracy of responses by the language model ChatGPT to questions regarding bariatric surgery. Obes Surg. 33 (6), 1790-1796 (2023).
- Thirunavukarasu, A. J., et al. Trialling a large language model (ChatGPT) in general practice with the applied knowledge test: observational study demonstrating opportunities and limitations in primary care. JMIR Med Educ. 9, e46599(2023).
- Sun, W., et al. Is ChatGPT Good at search? Investigating large language models as re-ranking agents. ArXiv. , (2023).
- Xu, R., Feng, Y., Chen, H. ChatGPT vs. Google: A comparative study of search performance and user experience. ArXiv. , (2023).
- TruthfulQA: Measuring how models mimic human falsehoods. Lin, S., Hilton, J., Evans, O. Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers, , 3214-3252 (2022).
- Manakul, P., Liusie, A., Gales, M. J. F. SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models. ArXiv. , (2023).
- FActScore: Fine-grained atomic evaluation of factual precision in long form text generation. Min, S., et al. Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, , 12076-12100 (2023).
- Zhang, J., et al. Is ChatGPT fair for recommendation? Evaluating fairness in large language model recommendation. Proceedings of the 17th ACM Conference on Recommender Systems. , 993-999 (2023).
- Sankar, B. S., et al. Building an ethical and trustworthy biomedical AI ecosystem for the translational and clinical integration of foundation models. Bioengineering. 11 (10), 984(2024).
- Shen, Y., et al. ChatGPT and Other large language models are double-edged swords. Radiology. 307 (2), e230163(2023).
- Li, H., et al. Ethics of large language models in medicine and medical research. Lancet Digit Health. 5 (6), e333-e335 (2023).
- Lewis, P., et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. ArXiv. , (2020).
- Gao, Y., et al. Retrieval-augmented generation for large language models: A survey. ArXiv. , (2023).
- Wei, C. -H., Allot, A., Leaman, R., Lu, Z. PubTator central: Automated concept annotation for biomedical full text articles. Nucleic Acids Res. 47 (W1), W587-W593 (2019).
- Wei, C. -H., et al. PubTator 3.0: An AI-powered literature resource for unlocking biomedical knowledge. ArXiv. , (2024).
- Comparative Reasoning for knowledge graph fact checking. Liu, L., Ji, H., Xu, J., Tong, H. 2022 IEEE International Conference on Big Data (Big Data), , 2309-2312 (2022).
- Knowledge Graph reasoning and its applications. Liu, L., Tong, H. Proceedings of the 29th ACM SIGKDD Conference on Knowledge Discovery and Data Mining, , 5813-5814 (2023).
- Liu, L., et al. Logic query of thoughts: Guiding large language models to answer complex logic queries with knowledge graphs. ArXiv. , (2024).
- Barack's wife hillary: Using Knowledge graphs for fact-aware language modeling. Logan, R., Liu, N. F., Peters, M. E., Gardner, M., Singh, S. Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, , 5962-5971 (2019).
- Sun, J., et al. Think-on-graph: Deep and responsible reasoning of large language model on knowledge graph. ArXiv. , (2024).
- Wen, Y., Wang, Z., Sun, J. MindMap: Knowledge Graph prompting sparks graph of thoughts in large language models. ArXiv. , (2024).
- Wang, C., Liu, X., Song, D. Language models are open knowledge graphs. ArXiv. , (2020).
- QA-GNN: Reasoning with Language Models and Knowledge Graphs for Question Answering. Yasunaga, M., Ren, H., Bosselut, A., Liang, P., Leskovec, J. Proceedings of the 2021 Conference of the North American Chapter of the, , 535-546 (2021).
- SimKGC: Simple contrastive knowledge graph completion with pre-trained language models. Wang, L., Zhao, W., Wei, Z., Liu, J. Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers, , 4281-4294 (2022).
- Lazar, A. Graph neural networks for link prediction. FLAIRS. 36, (2023).
- Zhang, M., Chen, Y. Link prediction based on graph neural networks. ArXiv. , (2018).
- XGNN: Towards model-level explanations of graph neural networks. Yuan, H., Tang, J., Hu, X., Ji, S. Proceedings of the 26th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining, , (2020).
- CFGExplainer: Explaining graph neural network-based malware classification from control flow graphs. Herath, J. D., Wakodikar, P., Yang, P., Yan, G. 2022 52nd Annual IEEE/IFIP International Conference on Dependable Systems and Networks (DSN), , 172-184 (2022).
- Ying, R., Bourgeois, D., You, J., Zitnik, M., Leskovec, J. GNNExplainer: Generating explanations for graph neural networks. Adv Neural Inf Process Syst. 32, 9240-9251 (2019).
- Bastian, F. B., et al. The Bgee suite: Integrated curated expression atlas and comparative transcriptomics in animals. Nucleic Acids Res. 49 (D1), D831-D847 (2021).
- Davis, A. P., et al. Comparative Toxicogenomics Database (CTD): Update 2023. Nucleic Acids Res. 51 (D1), D1257-D1262 (2023).
- Rehm, H. L., et al. ClinGen - The clinical genome resource. N Engl J Med. 372 (23), 2235-2242 (2015).
- Landrum, M. J., et al. ClinVar: Improvements to accessing data. Nucleic Acids Res. 48 (D1), D835-D844 (2020).
- Schriml, L. M., et al. The human disease ontology 2022 update. Nucleic Acids Res. 50 (D1), D1255-D1261 (2022).
- Piñero, J., Saüch, J., Sanz, F., Furlong, L. I. The DisGeNET cytoscape app: Exploring and visualizing disease genomics data. Comput Struct Biotechnol J. 19, 2960-2967 (2021).
- Knox, C., et al. DrugBank 6.0: The DrugBank knowledgebase for 2024. Nucleic Acids Res. 52 (D1), D1265-D1275 (2024).
- Fang, L., et al. GRNdb: Decoding the gene regulatory networks in diverse human and mouse conditions. Nucleic Acids Res. 49 (D1), D97-D103 (2021).
- Gene Ontology Consortium. The Gene Ontology resource: enriching a GOld mine. Nucleic Acids Res. 49 (D1), D325-D334 (2021).
- Seal, R. L., et al. Genenames.org: The HGNC resources in 2023. Nucleic Acids Res. 51 (D1), D1003-D1009 (2023).
- Siramshetty, V. B., et al. NCATS Inxight Drugs: A comprehensive and curated portal for translational research. Nucleic Acids Res. 50 (D1), D1307-D1316 (2022).
- Kanehisa, M., Furumichi, M., Tanabe, M., Sato, Y., Morishima, K. KEGG: New perspectives on genomes, pathways, diseases and drugs. Nucleic Acids Res. 45 (D1), D353-D361 (2017).
- Lipscomb, C. E. Medical Subject Headings (MeSH). Bull Med Libr Assoc. 88 (3), 265-266 (2000).
- Vasilevsky, N. A., et al. Mondo: Unifying diseases for the world, by the world. medRxiv. , (2022).
- Lelong, S., et al. BioThings SDK: A toolkit for building high-performance data APIs in biomedical research. Bioinformatics. 38 (7), 2077-2079 (2022).
- Amberger, J. S., Bocchini, C. A., Scott, A. F., Hamosh, A. OMIM.org: Leveraging knowledge across phenotype-gene relationships. Nucleic Acids Res. 47 (D1), D1038-D1043 (2019).
- Wilson, J. L., et al. PathFX provides mechanistic insights into drug efficacy and safety for regulatory review and therapeutic development. PLoS Comput Biol. 14 (12), e1006614(2018).
- Gong, L., Whirl-Carrillo, M., Klein, T. E. PharmGKB, an Integrated resource of pharmacogenomic knowledge. Curr Protoc. 1 (8), e226(2021).
- Gillespie, M., et al. The reactome pathway knowledgebase 2022. Nucleic Acids Res. 50 (D1), D687-D692 (2022).
- Kuhn, M., Letunic, I., Jensen, L. J., Bork, P. The SIDER database of drugs and side effects. Nucleic Acids Res. 44 (D1), D1075-D1079 (2016).
- Jewison, T., et al. SMPDB 2.0: Big improvements to the small molecule pathway database. Nucleic Acids Res. 42 (Database issue), D478-D484 (2014).
- Szklarczyk, D., et al. STRING v11: Protein-protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 47 (D1), D607-D613 (2019).
- Zhou, Y., et al. Therapeutic target database update 2022: Facilitating drug discovery with enriched comparative data of targeted agents. Nucleic Acids Res. 50 (D1), D1398-D1407 (2022).
- Bodenreider, O. The Unified Medical Language System (UMLS): Integrating biomedical terminology. Nucleic Acids Res. 32 (Database issue), D267-D270 (2004).
- Haendel, M. A., et al. Unification of multi-species vertebrate anatomy ontologies for comparative biology in Uberon. J Biomed Semantics. 5, 21(2014).
- UniProt Consortium. UniProt: the Universal Protein Knowledgebase in 2023. Nucleic Acids Res. 51 (D1), D523-D531 (2023).
- Denoising sequence-to-sequence pre-training for natural language generation, translation, and comprehension. Lewis, M., et al. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics, , 7871-7880 (2020).
- Sigdel, D., et al. Cloud-based phrase mining and analysis of user-defined phrase-category association in biomedical publications. J Vis Exp. (144), e59108(2019).
- Ferrara, E. Should ChatGPT be biased? Challenges and risks of bias in large language models. FM. ArXiv. , (2023).
- Gallegos, I. O., et al. Bias and fairness in large language models: A Survey. ArXiv. , (2023).
- Hosseini, M., Horbach, S. P. J. M. Fighting reviewer fatigue or amplifying bias? Considerations and recommendations for use of ChatGPT and other large language models in scholarly peer review. Res Integr Peer Rev. 8 (1), 4(2023).
- Kotek, H., Dockum, R., Sun, D. Gender bias and stereotypes in Large Language Models. Proceedings of The ACM Collective Intelligence Conference, , 12-24 (2023).
- Kamruzzaman, M., Kim, G. L. Prompting techniques for reducing social bias in LLMs through System 1 and System 2 Cognitive Processes. ArXiv. , (2024).
- Raza, S., Raval, A., Chatrath, V. MBIAS: Mitigating bias in large language models while retaining context. ArXiv. , (2024).
- Chen, B., Zhang, Z., Langrené, N., Zhu, S. Unleashing the potential of prompt engineering in Large Language Models: A comprehensive review. ArXiv. , (2023).
- White, J., et al. A prompt pattern catalog to enhance prompt engineering with ChatGPT. ArXiv. , (2023).
- Meskó, B. Prompt engineering as an important emerging skill for medical professionals: Tutorial. J Med Internet Res. 25, e50638(2023).
- Wang, J., et al. Prompt Engineering for Healthcare: Methodologies and applications. ArXiv. , (2023).
- Luo, Y., et al. An empirical study of catastrophic forgetting in large language models during continual fine-tuning. ArXiv. , (2023).
- Xu, P., et al. Retrieval meets Long Context Large Language Models. ArXiv. , (2023).
- Chen, S., Wong, S., Chen, L., Tian, Y. Extending context window of Large Language Models via positional interpolation. ArXiv. , (2023).
- Labrak, Y., et al. BioMistral: A collection of open-source pretrained large language models for medical domains. ArXiv. , (2024).
- Luo, R., et al. BioGPT: Generative pre-trained transformer for biomedical text generation and mining. Brief Bioinform. 23 (6), bbac409(2022).
- Wang, C., et al. A survey for large language models in biomedicine. ArXiv. , (2024).
Przedruki i uprawnienia
