Ten raport przedstawia WonderPeaks, nowatorskie narzędzie obliczeniowe do analizy danych sekwencyjnych RNA i ChIP. Narzędzie to z powodzeniem identyfikuje piki (odczyt pileupów) w danych sekwencjonowania, umożliwiając charakterystykę granic regionów nieulegających translacji w sekwencji RNA i wykrywanie wzbogacenia chromatyny w ChIP-seq, dostarczając cennych informacji do badań nad patogenami grzybowymi.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Algorytmy wywoływania pików (WonderPeaks i PeakStream) jako narzędzia do poprawy sekwencji ChIP i analizy transkryptomicznej w patogenach grzybowych
W tym artykule
Podsumowanie
Streszczenie
Charakteryzowanie zmian w ekspresji genów poprzez transkryptomikę i aktywność regulatora transkrypcji stało się podstawowym podejściem do zrozumienia różnorodnych reakcji związanych z patogenezą grzybów. W artykule przedstawiono dwa narzędzia obliczeniowe zaprojektowane w celu sprostania kluczowym wyzwaniom w badaniu regulacji transkrypcji w patogenach grzybowych, w szczególności w przypadku patogenów niemodelowych z ograniczoną adnotacją genomiczną. Po pierwsze, przedstawiamy WonderPeaks, nowatorski algorytm wywoływania pików, który wykorzystuje pierwszą pochodną zmapowanych danych genomowych z eksperymentów sekwencjonowania nowej generacji (NGS) do identyfikacji wzbogaconych pików w immunoprecypitacji chromatyny, a następnie sekwencjonowania (ChIP-seq). Po drugie, wprowadzamy PeakStream, rozszerzenie WonderPeaks do opisywania 3' nietranslowanych regionów (UTR) w danych transkryptomicznych generowanych przy użyciu przygotowania biblioteki poli(A). Razem narzędzia te zapewniają kompleksową analizę danych, oferując przyjazne dla użytkownika rozwiązanie dla naukowców badających regulację transkrypcji u grzybów. Wykazujemy ich skuteczność za pomocą danych z patogenu grzybowego Candida albicans, z powodzeniem identyfikując zweryfikowane piki w danych ChIP-seq i dodając adnotacje do zwalidowanych UTR poprzez porównanie z całkowitymi danymi sekwencjonowania RNA w tych samych warunkach. Omawiamy również ograniczenia WonderPeaks dla danych ChIP-seq w porównaniu z obecnymi najnowocześniejszymi metodami i proponujemy kierunki przyszłych ulepszeń. Ostatecznie, prace te dostarczają praktycznych wskazówek i potężnych zasobów do badania regulacji transkrypcji, co ma bezpośrednie znaczenie dla grzybów chorobotwórczych i potencjalnych zastosowań w szerszych badaniach genomicznych.
Wprowadzenie
Patogeny grzybowe stanowią narastający problem w zakresie globalnej ochrony zdrowia, a liczba infekcji wzrosła w ostatnich latach1. Wiele z tych patogenów wykazuje wysoką oporność na środki przeciwgrzybicze i wiąże się ze znacznymi wskaźnikami śmiertelności2. Jednak w porównaniu z modelowymi organizmami grzybowymi, wiele grzybów patogennych pozostaje słabo scharakteryzowanych, co podkreśla potrzebę dalszych badań nad mechanizmami ich patogenności. Techniki sekwencjonowania następnej generacji (NGS), takie jak sekwencjonowanie immunoprecypitacji chromatyny (ChIP-Seq) oraz sekwencjonowanie RNA (RNA-Seq), odgrywają kluczową rolę w odkrywaniu molekularnych mechanizmów ekspresji genów leżących u podstaw patogenności grzybów.
Jakość wniosków wyciągniętych z danych NGS w dużym stopniu zależy od dokładności oprogramowania wykorzystywanego do analizy surowych danych. Jednym z kluczowych wyzwań w analizie danych NGS jest wyznaczanie pików (peak calling) – czyli precyzyjna identyfikacja regionów z wzbogaconymi odczytami NGS – co jest szczególnie skomplikowane ze względu na szeroką różnorodność technik przygotowania bibliotek i sekwencjonowania, co sprawia, że opracowanie uniwersalnego rozwiązania jest niepraktyczne. Algorytm MACS3, w tym jego nowsza wersja MACS3, jest powszechnie uważany za złoty standard w analizie zbiorów danych ChIP-seq. Jednak MACS opiera się na parametrach definiowanych przez użytkownika – takich jak minimalna długość piku i maksymalna przerwa (gap) – które mogą nie być uniwersalne i często są trudne do określenia przed analizą. Warto zauważyć, że najnowsza wersja MACS3 zawiera funkcję analizy punktu odcięcia (cut-off analysis), która pozwala użytkownikom oszacować parametry przed właściwym wyznaczaniem pików. Aby zwiększyć wydajność, użytkownicy mogą również dostarczyć listę „czarnych list” (blacklisted) regionów genomowych, o których wiadomo, że wprowadzają błąd ze względu na strukturę chromatyny lub zmienność liczby kopii. Choć MACS pozostaje najczęściej stosowanym i najbardziej zaufanym narzędziem do wyznaczania pików w danych ChIP-seq, dostępnych jest kilka alternatywnych algorytmów, szczególnie w przypadkach wymagających bardzo ściśle dostosowanych ustawień parametrów.
RNA-Seq jest nieocenioną techniką badania odpowiedzi ekspresji genów grzybów patogennych podczas wzrostu in vivo, na przykład w hodowlach tkankowych lub modelach infekcji myszy4,5,6,7. Do dokładnej analizy ekspresji różnicowej w tych warunkach wymagana jest wysoka głębokość sekwencjonowania, co może być kosztowne i nadmiernie obciążające zasoby8,9. Metody przygotowania bibliotek, takie jak sekwencjonowanie z inicjacją poliaadenylacją (poly(A))-priming Sequencing (3'RNA-Seq), w którym wykorzystuje się primery zaprojektowane do przyłączania się do ogonów poly(A) mRNA w celu generowania cDNA, mogą pomóc w zmniejszeniu głębokości sekwencjonowania potrzebnej do analizy ekspresji genów10. Podejście to opiera się jednak na wysokiej jakości adnotacjach genomu, w szczególności 3' niekodujących regionów nietranslacyjnych (UTRs), w których zazwyczaj znajdują się piki wynikające z zdarzeń inicjacji poly(A)11. Adnotacje genomów wielu słabo zbadanych grzybów patogennych są pozbawione adnotacji UTR, co utrudnia zastosowanie 3'RNA-Seq u tych organizmów. Ponadto długość UTR dla pojedynczego genu może być dynamiczna w zależności od różnych warunków wzrostu i typów komórek12,13. Choć opracowano szereg nowych narzędzi analitycznych do identyfikacji i adnotacji UTR, wiele z nich jest przeznaczonych dla zbiorów danych ssaków, których organizacja genów znacznie różni się od organizacji u grzybów, lub wymagają danych z niezależnych eksperymentów sekwencjonowania, takich jak sekwencjonowanie pojedynczych komórek lub odwrócone sekwencjonowanie mRNA, co może zwiększyć czas i koszty dla badacza dążącego do przeprowadzenia analizy transkryptomu12,14,15.
W niniejszej pracy przedstawiamy WonderPeaks, nowe oprogramowanie do wyznaczania pików (peak-calling), opracowane w oparciu o zasady pierwszej pochodnej, które może być wykorzystywane do dynamicznego wyznaczania pików w zestawach danych NGS (Rycina 1). WonderPeaks identyfikuje piki poprzez obliczanie pierwszej pochodnej sygnału pokrycia i wykorzystywanie tej wartości – nachylenia piku – do definiowania potencjalnych pików. Algorytm wyszukuje przypadki, w których pierwsza pochodna wykazuje lokalne maksimum powyżej określonego przez użytkownika lub wywnioskowanego z danych progu nachylenia (co wskazuje na sygnał rosnący), a następnie lokalne minimum powyżej tego samego progu (co wskazuje na sygnał malejący), wykrywając w ten sposób wszystkie kandydackie piki w zestawie danych. W zastosowaniach ChIP-seq program WonderPeaks porównuje wszystkie kandydackie piki pomiędzy próbkami testowymi a kontrolnymi, aby zidentyfikować piki o unikalnym wzbogaceniu. Stosując WonderPeaks do wcześniej opublikowanego zestawu danych ChIP-seq dla czynnika transkrypcyjnego u grzyba chorobotwórczego Candida albicans16, wykazaliśmy jego zdolność do skutecznego identyfikowania pików powyżej kluczowych genów wskazanych w oryginalnym badaniu, omawiając jednocześnie obecne ograniczenia algorytmu w tym zastosowaniu.
Przedstawiamy również PeakStream, narzędzie programistyczne wykorzystujące WonderPeaks do identyfikacji pików w zbiorach danych 3'RNA-Seq. Biblioteki 3'RNA-Seq zależą od dokładnych adnotacji 3' UTR, ponieważ odczyty generowane poprzez primery poly(A) często wykraczają poza kodon stop sekwencji kodujących (CDS) genów, przez co nie są zliczane przy użyciu standardowych adnotacji skupionych wyłącznie na regionach kodujących. Potok analizy PeakStream został zaprojektowany w celu tworzenia nowych adnotacji genomowych przy użyciu danych 3' RNA-Seq, z koncentracją na regionach znajdujących się poniżej sekwencji kodujących (CDS) genów. PeakStream przypisuje te piki do genów, generując nową adnotację genomu do wykorzystania w programach do zliczania odczytów w dalszych etapach analizy. Wykazujemy, że zastosowanie PeakStream pozwala na dokładną identyfikację i przypisanie pików generowanych przez poly(A) w regionach downstream do odpowiedniego genu w zbiorze danych 3'RNA-Seq dla C. albicans. PeakStream adnotuje również piki, które prawdopodobnie nie są powiązane z żadnymi obecnymi adnotacjami genów, co ułatwia odkrywanie potencjalnych nowych transkryptów. Wspólnie PeakStream i WonderPeaks stanowią potężny zestaw przyjaznych dla użytkownika narzędzi do detekcji piki w zbiorach danych sekwencjonowania następnej generacji (NGS).

Rycina 1: Schemat wykrywania pików za pomocą programów WonderPeaks i PeakStream. Lewo: Wykrywanie pików z wykorzystaniem pierwszej pochodnej. Prawy górny róg: Wykrywanie pików w zbiorach danych ChIP-Seq przy użyciu WonderPeaks. Prawy dolny róg: Wykrywanie pików w zbiorach danych RNA-Seq przy użyciu PeakStream. Kliknij tutaj, aby zobaczyć powiększoną wersję tej ryciny.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
1. Instalacja (pomiń, jeśli została wykonana)
- Wymagania wstępne
- Zainstaluj Anaconda lub Miniconda, aby wczytać wymagania do uruchomienia wstępnego przetwarzania (rozdział 5) oraz WonderPeaks (rozdział 6 lub rozdział 7).
UWAGA: Przewodnik użytkownika dla Anaconda znajduje się w odniesieniu16. - Zainstaluj język Python: Python w ramach Anaconda lub Miniconda.
- Zainstaluj Jupyter Notebooks, aby wykonać wszystkie funkcje w tej metodzie.
UWAGA: Podręcznik dla początkujących użytkowników Jupyter Notebooks znajduje się w odniesieniu17.
OSTRZEŻENIE: W przypadku genomów grzybów (≤100 Mbp) należy zapewnić środowisko obliczeniowe z co najmniej 20 rdzeniami, 8 GB pamięci RAM i 30 GB wolnego miejsca na dysku.
- Zainstaluj Anaconda lub Miniconda, aby wczytać wymagania do uruchomienia wstępnego przetwarzania (rozdział 5) oraz WonderPeaks (rozdział 6 lub rozdział 7).
- Instalacja funkcji wstępnego przetwarzania.
- W terminalu wykonaj: conda create -n WP_preprocessing
- W terminalu wykonaj: conda activate WP_preprocessing
- W terminalu wykonaj: conda env update --file environment.yml --name <current_environment_name>
UWAGA: environment.yml to plik zawierający wszystkie zależności pakietów, który należy pobrać z https://github.com/mgarber21/WonderPeaks_preprocessing.git. - W terminalu wykonaj: pip install WonderPeaks-preprocessing
- W terminalu wykonaj: conda deactivate WP_preprocessing
- Instalacja funkcji WonderPeaks:
- W terminalu wykonaj: conda create -n WonderPeaks
- W terminalu wykonaj: conda activate WonderPeaks
- W terminalu wykonaj: conda env update --file environment.yml --name <current_environment_name>
UWAGA: environment.yml to plik zawierający wszystkie zależności pakietów, który należy pobrać z https://github.com/mgarber21/WonderPeaks.git. - W terminalu wykonaj: pip install WonderPeaks
- W terminalu wykonaj: conda deactivate WonderPeaks
UWAGA: Kroki 1.2 i 1.3 służą do następujących czynności: tworzą dedykowane środowisko Conda dla wstępnego przetwarzania (rozdział 5) i WonderPeaks (rozdziały 6 i 7), izolując zależności, aby uniknąć konfliktów z innym oprogramowaniem. Aktywują środowisko, przygotowując je do instalacji i uruchamiania funkcji WP_preprocessing lub specyficznych funkcji WonderPeaks. Instalują zależności oprogramowania i narzędzia wymagane do wstępnego przetwarzania danych. Dezaktywują środowisko, gdy nie jest ono używane, aby zapobiec przypadkowej modyfikacji i zwolnić zasoby systemowe.
- Pobierz Jupyter Notebooks i szablony z repozytorium GitHub WonderPeaks. Prześlij pobrane pliki WonderPeaks do systemu operacyjnego zawierającego surowe dane (katalog zostanie utworzony w rozdziale 2).
UWAGA: Jupyter Notebooks zawierają gotowe skrypty i szablony niezbędne do uruchomienia przepływów pracy wstępnego przetwarzania, WonderPeaks oraz PeakStream. Przesłanie ich do tego samego systemu, w którym znajdują się surowe dane, zapewnia prawidłową zgodność ścieżek i katalogów.
2. Utworzenie katalogu danych
UWAGA: Przepływy pracy WonderPeaks i PeakStream wymagają, aby wszystkie dane (surowe i przetworzone) były przechowywane w tym samym katalogu. Ten krok wyjaśnia, jak utworzyć ten nowy katalog ({data_directory} = /path/to/your/data) oraz jak przenieść surowe dane eksperymentalne (nieprzetworzone odczyty z sekwencjonowania) do folderu w tym katalogu o nazwie raw_data.
- Utwórz katalog danych.
- W terminalu wykonaj polecenie mkdir {data_directory} (np. mkdir /path/to/your/data)
- Utwórz podkatalog danych surowych dla nieprzetworzonych odczytów sekwencjonowania.
- W terminalu wykonaj polecenie mkdir {data_directory}/raw_data (np. mkdir /path/to/your/data /raw_data)
- Przenieś nieprzetworzone odczyty sekwencjonowania do katalogu danych surowych.
- W terminalu wykonaj polecenie mv {current_path_to_raw_data}/*fastq* {data_directory}/raw_data (np. mv current/data/path/*fastq* /path/to/your/data /raw_data
3. Utwórz plik danych wejściowych użytkownika (NGS_user_input.csv)
UWAGA: Plik wejściowy określa konfiguracje utworzone przez użytkownika do uruchomienia preprocessingu oraz programu WonderPeaks.
- Pobierz szablon NGS_user_inputs.csv z repozytorium WonderPeaks na GitHubie.
- Zaktualizuj pola w pliku NGS_user_inputs.csv. Pola należy uzupełnić w następujący sposób:
Katalog danych (Data directory): /path/to/your/data
Katalog genomu (Genome directory): /path/to/your/genome
Plik fasta genomu (Genome fasta): genome.fasta
Adnotacja genomu (Genome annotation): genome_annotation.gtf (należy podać nazwę pliku z adnotacją genomu w formacie GTF) - Zapisz zaktualizowany plik NGS_user_inputs.csv w katalogu danych utworzonym w sekcji 2.
UWAGA: Nie zmieniaj nazwy pliku; WonderPeaks rozpozna ten plik tylko wtedy, gdy będzie on nazywał się NGS_user_input.csv.
4. Utworzenie pliku metadanych (NGS_user_metadata.csv)
UWAGA: Plik metadanych służy do przechowywania wszelkich informacji istotnych dla eksperymentu. Można dodać dodatkowe kolumny w celu opisania warunków eksperymentu, jednak nie będą one wpływać na kolejne kroki.
- Pobierz szablon NGS_user_metadata.csv z repozytorium WonderPeaks na GitHubie.
- Zaktualizuj pola w pliku NGS_user_metadata.csv. Pola te są następujące:
- file: Upewnij się, że nazwa pliku nie zawiera spacji, zawiera rozszerzenie pliku (np. fastq, fastq.gz) i nie zawiera pełnej ścieżki dostępu.
- bedgraph: Określ, czy plik powinien zostać uwzględniony w PeakStream, ustawiając to pole na TRUE lub FALSE.
- Ustaw pole bedgraph na FALSE, gdy plik może zostać zasadnie pominięty w analizie PeakStream. Na przykład w eksperymencie RNAseq ustaw parametr bedgraph=FALSE dla mutantów lub w innych przypadkach, w których nie spodziewano się różnic w UTR między próbkami. Należy jednak pamiętać, aby ustawić pole bedgraph na TRUE dla wszystkich plików kontrolnych w eksperymencie RNAseq oraz dla wszystkich plików w eksperymencie ChIPseq.
- designfactor
- designfactor1: Określ czynnik projektowy istotny dla projektu eksperymentalnego (np. treatment lub sample_type).
- designfactor2: Określ drugi czynnik projektowy istotny dla projektu eksperymentalnego (np. strain lub epitope). W przypadku eksperymentu RNAseq jako typowe czynniki projektowe należy wprowadzić treatment i strain. Kolumna treatment zawiera listę zastosowanych zabiegów (np. control, drug1), a kolumna strain zawiera informacje o szczepie (np. wildtype, mutant). W przypadku eksperymentu ChIPseq jako typowe czynniki projektowe należy wprowadzić sample_type i epitope. Kolumna sample_type określa, czy białko było oznakowane, czy nieoznakowane, a kolumna epitope zawiera nazwę użytego epitopu.
UWAGA: designfactors to atrybuty specyficzne dla projektu eksperymentalnego.
WonderPeaks jest kompatybilny z kontrolami nieoznakowanymi lub kontrolami wejściowymi (input controls) jako linią bazową. - Upewnij się, że kolumny czynników projektowych nie zawierają unikalnych numerów powtórzeń (np. sample_type: [tagged, tagged, untagged_control, untagged_control], a nie sample_type: [tagged_1, tagged_2, untagged_control _1, untagged_control _2]). Podanie unikalnych numerów powtórzeń spowoduje błąd podczas uruchamiania.
- W nazwach czynników projektowych należy używać podkreślników (_) zamiast spacji.
- W zastosowaniach ChIPseq upewnij się, że kolumna sample_type (lub nazwa własna) w pliku metadanych zawiera terminy obejmujące słowa tag oraz control.
UWAGA: Na przykład poprawnymi wpisami mogą być tagged i untagged_control. Podanie kolumny sample_type bez tych terminów spowoduje błąd podczas uruchamiania.
OSTRZEŻENIE: W zastosowaniach ChIP użytkownik musi określić dwa czynniki projektowe. - Dodaj czynniki projektowe do odpowiedniego wiersza pliku NGS_user_inputs.csv. Upewnij się, że nazwy kolumn użyte dla czynników projektowych są wymienione jako ciąg znaków oddzielonych średnikami (np. treatment;strain lub sample_type;epitope).
OSTRZEŻENIE: Czynniki projektowe w pliku NGS_user_inputs.csv muszą dokładnie odpowiadać kolumnom w pliku NGS_user_metadata.csv. Jakiekolwiek niezgodności spowodują błąd podczas uruchamiania (Rysunek 2, Tabela uzupełniająca S1 oraz Tabela uzupełniająca S2).
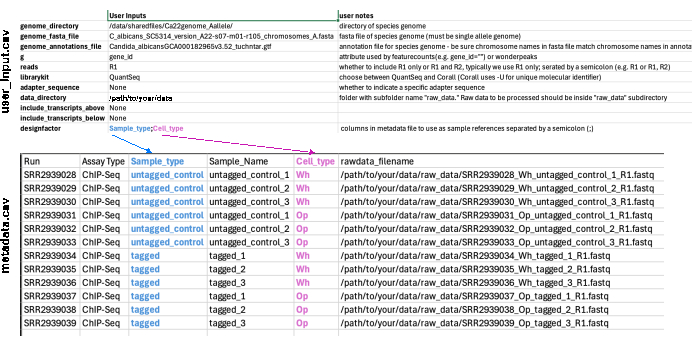
Rysunek 2: Przykład plików NGS_user_input.csv i NGS_user_metadata.csv. Przykłady plików NGS_user_input.csv (panel górny) i NGS_user_metadata.csv (panel dolny), z zaznaczoną różowym lub niebieskim tekstem oraz strzałkami zgodnością między kolumnami designfactor. Kliknij tutaj, aby zobaczyć powiększoną wersję tego rysunku.
5. Wstępna obróbka danych NGS
UWAGA: Przejdź do sekcji 5 lub sekcji 6, jeśli stosujesz niestandardowe przetwarzanie wstępne.
- Otwórz Notatnik Jupyter do wstępnego przetwarzania NGS (NGS_Preprocessing.ipynb).
- Aktywuj środowisko WP_preprocessing (utworzone w kroku 1.2) w prawym górnym rogu interfejsu notatnika.
- Uruchom pierwszą komórkę, przytrzymując klawisz Shift i naciskając Enter (Shift+Enter).
- W drugiej komórce Notatnika Jupyter zaktualizuj ścieżkę do katalogu, ustawiając Directory = "path/to/your/data", gdzie path/to/your/data/ to katalog utworzony w sekcji 2.
- Wygeneruj pliki dopasowania (alignment). Funkcje wstępnego przetwarzania wykonają trimowanie za pomocą FastP18; kontrolę jakości za pomocą FastQC19 i MultiQC20; dopasowanie za pomocą STAR21. Wynikowe pliki dopasowania są zapisywane w podkatalogu o nazwie startout wewnątrz katalogu danych (np. path/to/your/data/starout); filtrowanie (opcjonalne) za pomocą samtools view22, aby przefiltrować plik dopasowania i zachować tylko odczyty powyżej progu określonego w pliku NGS_user_inputs.csv.
UWAGA: Funkcje te będą przetwarzać tylko pojedyncze odczyty (np. R1) zbioru danych naraz. Użytkownicy mogą określić opcje uruchomienia dla FastP i STAR w pliku NGS_user_inputs.csv (np. FastP: adapter_sequence (opcjonalnie); STAR: genomeDir, genomeFastaFiles, sjdbGTFfil). - Uruchom funkcje wstępnego przetwarzania w drugiej komórce za pomocą Shift + Enter.
UWAGA: Zadania w drugiej komórce mogą zająć kilka godzin. Jeśli proces zostanie przerwany, powtórz kroki 5.3-5.6, aby go wznowić. Postępy z poprzednich kroków nie zostaną nadpisane, a proces będzie kontynuowany od miejsca przerwania. - Wygeneruj pliki śladów (trace files) pokrycia dopasowania za pomocą BamCoverage23 (patrz kroki 5.7.1 i 5.7.2).
UWAGA: Dla ChIPseq, program WonderPeaks wymaga pojedynczych plików bedgraph zawierających pokrycie dla odczytów w kierunku prostym (forward) i odwrotnym (reverse). Dla RNAseq z primingiem Poly(A), PeakStream wymaga dwóch plików bedgraph: jednego dla odczytów w kierunku prostym (_fwd.bedgraph) i jednego dla odczytów w kierunku odwrotnym (_rev.bedgraph). Odczyty w kierunku prostym i odwrotnym są generowane za pomocą parametru filterRNAstrand w narzędziu BamCoverage23.- ChIPseq przy użyciu następujących parametrów: outfilfeformat="bedgraph", strand=None, binsize=20, smoothLength=60, minMappingQuality=255, normalizeUsing="CPM".
UWAGA: Wynik: Generuje pojedyncze pliki bedgraph zawierające pokrycie dla odczytów w kierunku prostym i odwrotnym. Wynik jest przechowywany w /path/to/your/data/bedgraphout (Rysunek 3).- Uruchom funkcję BamCoverage w trzeciej komórce za pomocą Shift + Enter.
- RNAseq przy użyciu następujących parametrów: outfilfeformat="bedgraph", strand="forward" lub "reverse", binsize=20, smoothLength=60, minMappingQuality=255, normalizeUsing="CPM".
OSTRZEŻENIE: Należy upewnić się, że funkcja zostanie wykonana dwukrotnie z parametrem strand ustawionym odpowiednio na forward lub reverse, aby wygenerować pliki dla odczytów w obu kierunkach.
UWAGA: Wynik: Generuje dwa pliki bedgraph: jeden dla odczytów w kierunku prostym (_fwd.bedgraph) i jeden dla odczytów w kierunku odwrotnym (_rev.bedgraph). Wynik jest przechowywany w /path/to/your/data/ bedgraphout (Rysunek 3).- Uruchom funkcję BamCoverage w trzeciej komórce za pomocą Shift + Enter.
- ChIPseq przy użyciu następujących parametrów: outfilfeformat="bedgraph", strand=None, binsize=20, smoothLength=60, minMappingQuality=255, normalizeUsing="CPM".
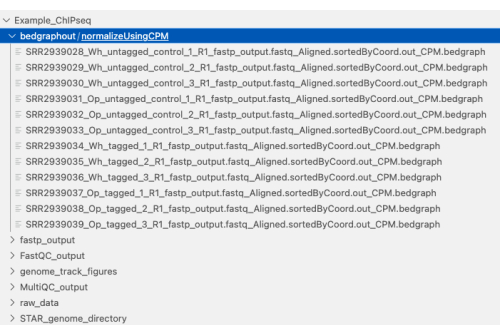
Rysunek 3: Organizacja plików dla programu WonderPeaks. Zrzut ekranu folderu danych z plikami bedgraph w katalogu bedgrapghout/normalizeUsingCPM. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
6. WonderPeaks dla ChIPseq
- Wstępna kontrola
- Potwierdź wszystkie pliki bedgraph za pomocą deskryptora pliku .bedgraph znajdują się w podfolderze wewnątrz katalogu danych o nazwie bedgraphout (Rycina 3).
- Potwierdź, że czynniki projektowe w pliku user_inputs (NGS_wejścia_użytkownika.csv) (Rysunek 2) dopasuj kolumny w pliku metadanych (NGS_metadane_użytkownika.csv) i że wiersze w kolumnach czynników projektu nie są unikalne (patrz ostrożnie w kroku 4.2.4).
- Otwórz notatnik Jupyter do preprocessingu NGS (WP4ChIP.ipynb).
- Aktywuj WonderPeaks (środowisko utworzone w kroku 1.3) w prawym górnym rogu interfejsu notatnika.
- Uruchom komórki za pomocą Shift+Enter aż do punktu przerwania w celu uruchomienia wywołania szczytów (peak calling). Po zakończeniu zapis zostanie utworzony i przechowywany w podkatalogu wewnątrz katalogu danych o nazwie WonderPeaks
- Szukaj WOnder_init.csvkonkatenacja całego surowego pokrycia oraz wyników obliczenia pierwszej pochodnej.
- Uwaga WOnder_nieprzefiltrowane_piki.csvkonkatenacja wszystkich niefiltrowanych pików wyznaczonych na podstawie pierwszej pochodnej.
- Obserwuj podsumowanie_bedgraph.csvpodsumowanie statystyk wyników po pogrupowaniu każdego pliku i chromosomu.
- Zdefiniuj parametry uruchomienia:
- Uruchom 1Proszę podać tekst źródłowy do tłumaczenia. komórka poniżej punktu przerwania markdown
UWAGA: Wykres przedstawiający surowe dane podzielone według określonych czynniki projektowe oraz pojawi się tabela przedstawiająca czynniki planowania; należy wykorzystać tę tabelę i wykres do wyznaczenia wartości w kolejnych krokach (Rycina 4). - W następnej komórce określ wartości dla próg odcięcia wyniku, krotność zmiany, i czynnik projektowy (Rycina 4).
- punkt odcięcia jest wartością progową wykorzystywaną do określenia, czy dany piki powinien zostać uwzględniony w wynikach. Aby wyznaczyć score_cut, należy przeanalizować wykres i wybrać wartość zbliżoną do mediany danych oznaczonych (patrz linia przerywana, Rycina 4). Wprowadź tę wartość w następujący sposób: score_cut= wartość.
- zmiana krotności wartość progowa stosunku wyników z próbek znakowanych do nieznakowanych służy do określenia, czy dany piki należy uznać za rzeczywisty. Aby wyznaczyć zmianę krotności (fold_change), należy przeanalizować wykres i wybrać wartość powyżej stosunku median danych nieznakowanych i znakowanych. Wprowadź tę wartość w następujący sposób: fold_change= wartość.
- wartość_czynnika_projektowego zostało określone jako część planu eksperymentalnego. Możliwe czynniki planowania wymieniono w czerwony w wydrukowanej tabeli. Aby określić współczynnik projektu (design factor), należy wybrać jedną z wartości zaznaczonych na czerwono. Wprowadź tę wartość w cudzysłowie w następujący sposób: wartość_czynnika_projektowego ="{ wartość}".
- Uruchom 1Proszę podać tekst źródłowy do tłumaczenia. komórka poniżej punktu przerwania markdown
- Uruchom następne komórki za pomocą Shift + Enter do przeprowadzenia filtrowania i mapowania pików. Dane oraz wykresy podsumowujące zostaną zapisane w podkatalogu wewnątrz katalogu danych o nazwie WonderPeaks.
- Obserwować {designfactor_value}_oznaczoneVnieoznaczone.csvTabela przestawna wszystkich nakładających się pikułów z kolumną dla każdej z próbek znakowanych i nieznakowanych.
- Uwaga {designfactor_value}_wszystkie_oznaczone_piki.csvTabela podsumowująca wszystkie rzeczywiste piki, opracowana na podstawie parametrów użytkownika (krok 6.5).
- Obserwować {designfactor_value}_peaks2gtf.csvMapowanie rzeczywistych pików, w oparciu o parametry użytkownika (krok 6.5), do genów w określonym przez użytkownika pliku z adnotacjami.
- OpcjonalneZmień parametry w kroku 6.5, ponownie wykonując kroki 6.5-6.6. W przypadku korzystania z tych samych wartość_czynnika_projektowegopliki wygenerowane zgodnie z opisem w kroku 6.6 zostaną nadpisane.
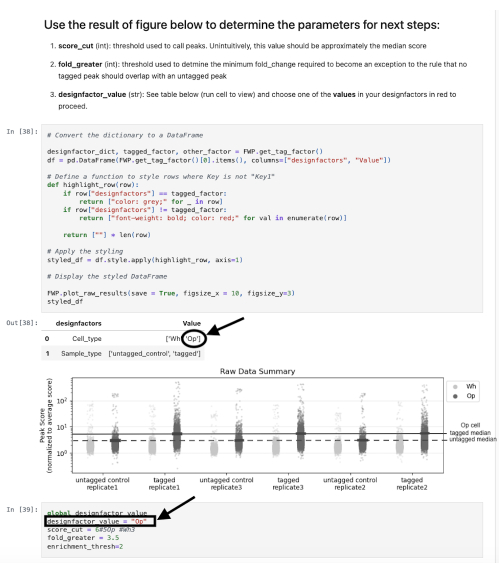
Rysunek 4: Zrzut ekranu przedstawiający designfactor_value oraz progi określone przez użytkownika w programie WonderPeaks dla ChIP-seq. Zrzut ekranu z notatnika Jupyter w programie WonderPeaks, wyróżniający możliwe opcje designfactor_value z wyświetlonej tabeli oraz sposób implementacji designfactor_value w następnej komórce. Górna czarna strzałka wskazuje tabelę z możliwymi wpisami designfactor_value; wartość Op jest zakreślona kółkiem i przedstawiona jako wybrany przez użytkownika parametr wejściowy dla designfactor_value w komórce opcji (dolna czarna strzałka). Na wykresie linie ciągłe i przerywane wskazują przybliżone mediany wyników szczytów odpowiednio dla próbek oznakowanych i nieoznakowanych w eksperymentach z komórkami nieprzezroczystymi. Mediany te są wykorzystywane do zdefiniowania parametrów score_cut (mediana próbek oznakowanych) oraz fold_change (stosunek mediany próbek oznakowanych do nieoznakowanych). Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
7. PeakStream dla 3'RNAseq
- Wstępna kontrola:
- Upewnij się, że wszystkie pliki bedgraph znajdują się w podkatalogu wewnątrz katalogu danych o nazwie bedgraphout (Rycina 2).
- Otwórz Notatnik Jupyter do wstępnego przetwarzania danych NGS (PeakStream.ipynb)
- W prawym górnym rogu interfejsu notatnika aktywuj środowisko WonderPeaks (utworzone w kroku 1.3).
- Uruchamiaj komórki za pomocą Shift+Enter aż do punktu przerwania, aby przeprowadzić wyznaczanie i mapowanie pików (peak calling i peak mapping). Po zakończeniu zostanie zapisany i przechowywany w podkatalogu wewnątrz katalogu danych o nazwie PeakStream (Rycina 5) nowy plik adnotacji z przewidywanymi 3' UTR oraz pliki z liczbą odczytów FeatureCounts24.
UWAGA: Domyślnie plik wyjściowy będzie zawierał adnotacje tylko dla biotypów kodujących białka, ale można to zmienić za pomocą opcji biotype.
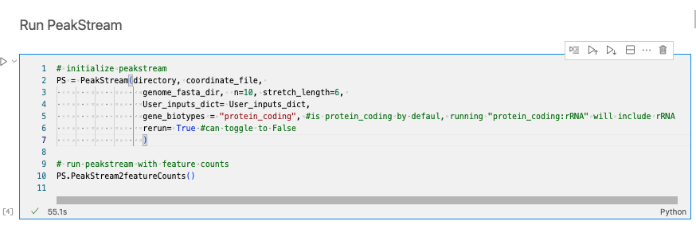
Rycina 5: Organizacja plików dla programu PeakStream. Zrzut ekranu folderu danych z plikami bedgraph w katalogu bedgrapghout. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
WonderPeaks
Po przeprowadzeniu eksperymentu ChIP-seq badacze powszechnie wykorzystują programy do wyznaczania pików (peak callers), takie jak MACS3, aby zidentyfikować regiony genomowe wzbogacone o białko wiążące DNA z etykietą epitopową. Opracowaliśmy WonderPeaks jako przyjazny dla użytkownika program do wyznaczania pików, zaprojektowany do identyfikacji pików przy użyciu opisanej powyżej metody.
Program WonderPeaks identyfikuje piki, obliczając ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Techniki sekwencjonowania nowej generacji (NGS) zapewniają niezrównany wgląd w regulację i ekspresję genów w patogenach grzybowych. W związku z tym narzędzia obliczeniowe muszą być zarówno wszechstronne – przechwytujące wszystkie dane wygenerowane w eksperymencie – jak i dostępne dla ogółu użytkowników, zwłaszcza naukowców zajmujących się badaniami laboratoryjnymi. W tym raporcie przedstawiliśmy dwa narzędzia, WonderPeaks i PeakStream, które zaspokajają te potrzeby badaczy patogenów grzybowych w przepływach pracy ChIP-se...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy nie mają do zadeklarowania konfliktu interesów.
Podziękowania
Ta praca była wspierana przez granty National Institutes of Health (NIH) RO1AI175080 i R01GM037049 (dla Alexandra D. Johnsona) oraz NIH T32 Training Grant Award T32 AI 60537-20 (dla H.G.). Dziękujemy Alexandrowi Johnsonowi, Matthew Lohse, Jenny Zhang i Brianowi Wangowi za pomocne dyskusje i rady. Dziękujemy również członkom Carol Gross' Lab za opinie. Dziękujemy Anandzie Mendozie za wsparcie techniczne. Sekwencjonowanie przeprowadzono w UCSF CAT, przy wsparciu grantów UCSF PBBR, RRP IMIA i NIH 1S10OD028511-01. Potwierdzamy korzystanie z ChatGPT firmy OpenAI w celu uzyskania pomocy w rozwiązywaniu problemów z kodem i dostarczania sugestii dotyczących edycji rękopisu.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Zestaw CORALL Total RNA-seq V1 | Lexogen | 095 | Mokry materiał laboratoryjny |
| Grzyby strzępkowe ryboPOOL | siTOOLs | dp-P096-6 | Mokry materiał laboratoryjny |
| Taśma ekranowa RNA o wysokiej czułości | Agilent | 5067-5579 | Mokry materiał laboratoryjny |
| Drabinka taśmowa RNA o wysokiej czułości | Agilent | 5067-5581 | Wet lab material |
| Bufor do próbek RNA ScreenTape o wysokiej czułości | Agilent | 5067-5580 | Wet lab material |
| lista zależności dla WonderPeaks | |||
| https://github.com/mgarber21/WonderPeaks_preprocessing/blob/main/environment.yml | lista zależności dla WonderPeaks_preprocessing | ||
| Monarch Spin RNA Cleanup Ki | NEB | T2040L | Wet lab material |
| pygenometracks (3.9) | |||
| QuantSeq 3′ mRNA-Seq FWD Zestaw do przygotowania biblioteki V1 | Lexogen | 015 | Mokry materiał laboratoryjny |
| Zestaw do oznaczania wysokiej czułości RNA kubitu (HS) | Invitrogen | Q32852 | Mokry materiał laboratoryjny |
| RNA Czyste & Concentrator-5 | Zymo Research | R1016 | Mokry materiał laboratoryjny |
| Zestaw TURBO bez DNA | ThermoFisher | AM1907 | Mokry materiał laboratoryjny |
| WonderPeaks(0.1.14) | |||
| WonderPeaks_preprocessing(0.2.3) |
Bibliografia
- fungal priority pathogens list to guide research, development and public health action. , WHO. https://www.who.int/publications/i/item/9789240060241 (2022).
- Fisher, M. C., Denning, D. W. The WHO fungal priority pathogens list as a game-changer. Nat Rev Microbiol. 21 (4), 211-212 (2023).
- Gaspar, J. M. Improved peak-calling with MACS2. bioRxiv. 496521, (2018).
- Muñoz, J. F., et al. Coordinated host-pathogen transcriptional dynamics revealed using sorted subpopulations and single macrophages infected with Candida albicans. Nat Commun. 10 (1), 1607(2019).
- Miramón, P., Pountain, A. W., Lorenz, M. C. Candida auris-macrophage cellular interactions and transcriptional response. Infect Immun. 91 (11), e0027423(2023).
- Lindemann-Perez, E., Rodríguez, D. L., Pérez, J. C. An approach to analyze spatiotemporal patterns of gene expression at single-cell resolution in Candida albicans-infected mouse tongues. mSphere. 9 (9), e0028224(2024).
- Mo, X., et al. In vivo RNA sequencing reveals a crucial role of Fus3-Kss1 MAPK pathway in Candida glabrata pathogenicity. mSphere. 9 (11), e0071524(2024).
- Haas, B. J., Chin, M., Nusbaum, C., Birren, B. W., Livny, J. How deep is deep enough for RNA-Seq profiling of bacterial transcriptomes. BMC Genomics. 13, 734(2012).
- Zaheer, R., et al. Impact of sequencing depth on the characterization of the microbiome and resistome. Sci Rep. 8 (1), 5890(2018).
- Xiong, Y., et al. A comparison of mRNA sequencing with random primed and 3′-directed libraries. Sci Rep. 7 (1), 14626(2017).
- Ma, F., et al. A comparison between whole transcript and 3' RNA sequencing methods using Kapa and Lexogen library preparation methods. BMC Genomics. 20, 9(2019).
- Fansler, M. M., Mitschka, S., Mayr, C. Quantifying 3′UTR length from scRNA-seq data reveals changes independent of gene expression. Nat Commun. 15 (1), 4050(2024).
- Tuch, B. B., et al. The transcriptomes of two heritable cell types illuminate the circuit governing their differentiation. PLoS Genet. 6, e1001070(2010).
- Shenker, S., Miura, P., Sanfilippo, P., Lai, E. C. IsoSCM: improved and alternative 3′ UTR annotation using multiple change-point inference. RNA. 21 (1), 14-27 (2015).
- Haese-Hill, W., Crouch, K., Otto, T. D. peaks2utr: a robust Python tool for the annotation of 3′ UTRs. Bioinformatics. 39 (3), btad112(2023).
- Anaconda - Getting started. , https://docs.anaconda.com/anaconda/getting-started/ (2025).
- Pryke, B. Jupyter Notebook tutorial. , https://www.dataquest.io/blog/jupyter-notebook-tutorial/ (2025).
- Chen, S., Zhou, Y., Chen, Y., Gu, J. fastp: an ultra-fast all-in-one FASTQ preprocessor. Bioinformatics. 34 (17), i884-i890 (2018).
- Andrews, S. FastQC: a quality control tool for high throughput sequence data. , https://www.bioinformatics.babraham.ac.uk/projects/fastqc/ (2010).
- Ewels, P., Magnusson, M., Lundin, S., Käller, M. MultiQC: summarize analysis results for multiple tools and samples in a single report. Bioinformatics. 32 (19), 3047-3048 (2016).
- Dobin, A., et al. STAR: ultrafast universal RNA-seq aligner. Bioinformatics. 29 (1), 15-21 (2013).
- Danecek, P., et al. Twelve years of SAMtools and BCFtools. Gigascience. 10 (2), giab008(2021).
- Ramírez, F., et al. deepTools2: a next generation web server for deep-sequencing data analysis. Nucleic Acids Res. 44 (W1), W160-W165 (2016).
- Liao, Y., Smyth, G. K., Shi, W. featureCounts: an efficient general purpose program for assigning sequence reads to genomic features. Bioinformatics. 30 (7), 923-930 (2014).
- Lohse, M. B., Johnson, A. D. Identification and characterization of Wor4, a new transcriptional regulator of white-opaque switching. G3 (Bethesda). 6 (3), 721-729 (2016).
- Nagalakshmi, U., et al. The transcriptional landscape of the yeast genome defined by RNA sequencing. Science. 320 (5881), 1344-1349 (2008).
- Diaz, A., Park, K., Lim, D. A., Song, J. S. Normalization, bias correction, and peak calling for ChIP-seq. Stat Appl Genet Mol Biol. 11 (3), Article 9(2012).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
Ten artykuł został opublikowany
Film wkrótce dostępny