To badanie łączy strategię opartą na regułach z uczeniem maszynowym i pomocą ekspertów w celu dodawania adnotacji do tekstu w języku Hinglish i angielskim. Dane są testowane na 19 000 tweetów z 81% dokładnością i są znacznie tańsze niż robienie tego ręcznie. Może być przydatny do śledzenia emocji podczas kryzysu.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Uczenie maszynowe i oparte na regułach leksykalnych, ekonomiczne adnotacje emocji wypowiedzi Hinglish
W tym artykule
Podsumowanie
Streszczenie
Adnotacja emocji w językach mieszanych, takich jak Hinglish (hindi-angielski), stawia wyjątkowe wyzwania ze względu na złożoność lingwistyczną i ograniczone zasoby. Niniejsze badanie wprowadza hybrydowy schemat aktywnego uczenia, który łączy reguły leksykalne, uczenie maszynowe i iteracyjne informacje zwrotne od ekspertów, aby osiągnąć kosztowo efektywną i wysoką dokładność adnotacji emocji. Oparty na psychologicznych teoriach emocji, w tym na teorii dyskretnych emocji i teorii poznawczej oceny, schemat wykorzystuje dwujęzyczne słowniki emocji (np. mapowanie słów gussa i rage na gniew), tokenizację podsłów dla terminów złożonych (np. podział  na
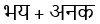 ) oraz aktywne uczenie w celu nadania priorytetu próbkom niejednoznacznym. Ewaluowany na zbiorze 19 0 tweetów w języku Hinglish dotyczących wojen i konfliktów, schemat osiągnął dokładność 81% (F-score: 0,76), redukując jednocześnie koszty operacyjne o 40% w porównaniu z adnotacją ręczną. Reguły leksykalne rozwiązały 89% niejednoznaczności wynikających z przełączania kodów, a iteracyjne ulepszenia pozwoliły na stopniowy wzrost dokładności z 72% do 81%. Efektywność systemu wynika z ograniczenia nakładu pracy ludzkiej do 73% zbioru danych, przy zautomatyzowanym przetwarzaniu wstępnym emoji, hashtagów i slangu. Badanie to opiera się na hipotezie, że integracja metod opartych na regułach leksykalnych z aktywnym uczeniem i uczeniem maszynowym może zwiększyć dokładność adnotacji emocji w tekstach w języku Hinglish, jednocześnie redukując ręczne etykietowanie i całkowny wysiłek związany z adnotacją.
Wprowadzenie
Gdy dwa lub więcej języków jest zmieszanych ze sobą w jednym wierszu lub mowie, nazywa się to językiem mieszanym z kodem. Jest to powszechne w swobodnych dialogach, takich jak Hinglish. Istnieje wiele sposobów, w jakie ludzkie emocje mogą być zrozumiane, a obliczeniowe modelowanie serii emocjonalnych stwierdzeń polega na dodawaniu do nich adnotacji przez osoby, które wypowiedziały te zdania. Można to rozumieć w kategoriach poziomu biologicznego, fizjologicznego, psychologicznego i tak dalej. Według naukowców, takich jak Roger Penrose, wiele zjawisk w naszym świecie nie jest obliczeniowych, a naukowcy tacy jak Wolfram uważają, że wszystko (każde zjawisko) można modelow....
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
W tej sekcji wyjaśniono również, w jaki sposób skonstruowano multimodalny model dla adnotacji 8 emocji. Sekcja rozpoczyna się od omówienia właściwości zbioru danych, po których następują kolejne procedury. W celu lepszego zrozumienia procedury badawczej należy zapoznać się z Rysunkiem 1.

Rysunek 1: Systematyczne ramy adnotacji emocji. Rysunek przedstawia efektywny proces adnotacji emocji w tekście w języku hinglish, który łączy uczenie masz....
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Wyniki niniejszego badania sugerują, że zintegrowanie reguł leksykalnych z uczeniem maszynowym oraz technikami uczenia aktywnego stanowi skuteczny sposób zwiększenia efektywności i dokładności adnotacji emocji w tekstach w języku hinglish o mieszanym kodzie. Dzięki iteracyjnemu udoskonalaniu i sugestiom ekspertów, zaproponowana struktura pozwoliła na znaczne zmniejszenie nakładów pracy ręcznej, przy jednoczesnym zachowaniu wysokiej wydajności w macierzach ewaluacyjnych. Wyniki wskazują na.......
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Zbiór danych do niniejszego badania został opracowany przy użyciu kombinacji ręcznej adnotacji i aktywnego uczenia (active learning). Początkowo 10 040 tweetów w języku Hinglish dotyczących wojny i konfliktów zostało ręcznie oznakowano ośmioma zdefiniowanymi emocjami. Następnie zbiór danych rozszerzono do 19 00 tweetów, stosując podejście półautomatyczne. Aktywne uczenie umożliwiło selektywną interwencję ekspercką, co zredukowało nakład pracy ręcznej o 40% przy zachowaniu wysokiej dokładności adnotacji na poziomie 81% z .......
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy deklarują brak konfliktu interesów.
Podziękowania
Badania te nie otrzymały żadnego zewnętrznego finansowania.
....Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| fastText (szybki tekst | Sztuczna inteligencja Facebooka | N/A | Reprezentacja i klasyfikacja słów |
| Współpraca z Google | Wyszukiwarka Google | N/A | Oparte na chmurze środowisko Jupyter Notebook |
| Procesor graficzny/TPU Google Colab | Wyszukiwarka Google | N/A | Akceleracja sprzętowa oparta na chmurze |
| Intel Core i5/i7 lub AMD Ryzen 5/7 | Intel / AMD | N/A | Procesor do wykonywania lokalnego (jeśli jest wymagany) |
| biblioteka matplotlib | Oprogramowanie typu open source (oprogramowanie typu open source) | N/A | Biblioteka wizualizacji danych |
| NLTK (Biblioteka NLTK) | Oprogramowanie typu open source (oprogramowanie typu open source) | N/A | Zestaw narzędzi języka naturalnego do przetwarzania tekstu |
| NumPy | Oprogramowanie typu open source (oprogramowanie typu open source) | N/A | Biblioteka obliczeń numerycznych |
| NVIDIA GTX 1650 lub lepsza (opcjonalnie) | Technologia NVIDIA | N/A | Procesor graficzny do zadań głębokiego uczenia |
| Pandy | Oprogramowanie typu open source (oprogramowanie typu open source) | N/A | Biblioteka manipulacji danymi |
| Język Python | Fundacja oprogramowania Python | N/A | Język programowania dla ML i NLP |
| Pochodnia PyTorch | Meta Sztuczna inteligencja | N/A | Struktura głębokiego uczenia |
| Pamięć RAM (minimum 8 GB, zalecane 16 GB) | Rozmaity | N/A | Wymagania dotyczące pamięci dla zadań uczenia maszynowego |
| Scikit-naucz się | Oprogramowanie typu open source (oprogramowanie typu open source) | N/A | Biblioteka uczenia maszynowego |
| Urodzony na morzu | Oprogramowanie typu open source (oprogramowanie typu open source) | N/A | Wizualizacja danych statystycznych |
| SpaCy | Sztuczna inteligencja eksplozji | N/A | Biblioteka NLP o sile przemysłowej |
| Pamięć SSD (minimum 256 GB, zalecane 512 GB) | Rozmaity | N/A | Magazyn do przetwarzania zestawu danych |
| Technologia TensorFlow | Wyszukiwarka Google | N/A | Struktura głębokiego uczenia |
Bibliografia
- Herce, R. Non-locality of the phenomenon of consciousness according to Roger Penrose. Dialogo. 3 (2), 127-134 (2016).
- Wolfram, S. The future of computation. Math J. 10 (2), 329-362 (2006).
- Kusal, S., et al.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
Ten artykuł został opublikowany
Film wkrótce dostępny