To badanie bada białka biorące udział lub przewidywane jako zaangażowane w 3D zamianę domen z różnych genomów roślin leczniczych. Wykorzystuje modele uczenia maszynowego do dokładnego przewidywania białek 3D zamieniających domeny oraz przewidywania ich funkcji i znaczenia dla produkcji metabolitów wtórnych.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Przewidywanie przez uczenie maszynowe białek 3D z zamianą domen w roślinach leczniczych
W tym artykule
Podsumowanie
Streszczenie
3D zamiana domen to zjawisko strukturalne białka, w którym dwie lub więcej podjednostek białkowych wymienia identyczne podjednostki strukturalne i tworzy oligomery. Białka, które wykazują zamianę domen 3D, odgrywają kluczową rolę w różnych funkcjach biologicznych, takich jak biosynteza metabolitów wtórnych oraz w radzeniu sobie z kilkoma stresami biotycznymi i abiotycznymi w roślinach leczniczych. W tym badaniu zbadano zdolność do przewidywania wzorców zamiany domen 3D między genomami roślin leczniczych przy użyciu modeli losowych lasów i klasyfikatorów K-najbliższego sąsiada, wykazując dokładność odpowiednio 91,6% i 88,7%. W sumie przewidywano, że 420 (31%) sekwencji będzie przypuszczalnie zaangażowanych w zamianę domen 3D. Przeprowadzono również badania wzbogacające przewidywane sekwencje białek 3D z zamianą domen z różnych roślin leczniczych do adnotacji funkcji w oparciu o terminy Gene Ontology (GO), analizę szlaków Kyoto Encyclopedia of Genes and Genomes (KEGG) oraz ich rozkład domen w szlakach biosyntezy metabolitów wtórnych. Funkcjonalna adnotacja przewidywanych sekwencji sugeruje, że sekwencje zamienione domeną 3D były zaangażowane w różne funkcje molekularne, takie jak fotosyntetyczny transport elektronów w fotosystemie II i transportery elektronów, przenoszenie elektronów w ramach cyklicznego szlaku transportu elektronów aktywności fotosyntezy, fosforylacja oksydacyjna i regulacja genów stresów środowiskowych (biotycznych i abiotycznych) poprzez syntezę metabolitów wtórnych (terpenoidów, alkaloidy i poliaminy). Odkrycia te podkreślają zdolność uczenia maszynowego do przewidywania udziału białek w zjawisku zamiany domen 3D, ich odpowiednich funkcji oraz potencjału w zakresie ułatwiania odkrywania leków i inicjatyw bioinżynieryjnych.
Wprowadzenie
Metody obliczeniowe zrewolucjonizowały badania nad białkami, umożliwiając szczegółową analizę oraz tworzenie przewidywań dotyczących struktur, funkcji i oddziaływań białek. Precyzyjna identyfikacja i adnotacja funkcji białek są niezbędne do zrozumienia molekularnych mechanizmów życia i mają ogromne znaczenie dla postępów w medycynie oraz opracowywaniu leków. Jednakże przyrodzona złożoność i wysoki koszt metod eksperymentalnych ograniczają ich skalowalność w kontekście ogromnych zbiorów danych sekwencyjnych. W rezultacie opracowanie metod obliczeniowych do przewidywania funkcji białek stało się kluczowym obszarem biologii obliczeniowej i molekularnej, wypełniając tę lukę za pomocą innowacyjnych podejść na szeroką skalę1.
Wymiana domen 3D (3D domain swapping)2 jest zjawiskiem strukturalnym w białkach, w którym segmenty wspólnej struktury są wymieniane między poszczególnymi łańcuchami. W 1994 roku wstępna dokumentacja dotycząca mechanizmu wymiany domen 3D została odnaleziona w dimerze toksyny błoniczej3. Jednak podstawowe zasady wymiany domen 3D można wywieść z badań sprzed czterech dekad. Zaobserwowano, że rybonukleaza A z trzustki bydlęcej (RNase A) tworzy dimery podczas liofilizacji w kwasie octowym, co wykazano w ramach zaawansowanych eksperymentów z modyfikacjami chemicznymi4. W procesie oligomeryzacji białek dwa lub więcej łańcuchów białkowych wymienia identyczne elementy strukturalne poprzez elastyczne regiony zawiasowe. Część białka wymieniana między podjednostkami monomerycznymi nazywana jest domeną wymienioną, która w niektórych białkach może składać się z całej domeny globularnej, pętli lub elementu struktury drugorzędowej. Z kolei regiony, które pozostają niezmienione w swoich pierwotnych pozycjach w obrębie monomerów, określa się mianem domen niewymienionych5. Połączenie między domenami niewymienionymi definiuje się jako interfejs domen niewymienionych (NSDI), przedstawiony na Rysunku 1. W wymianie domen 3D relacja między domeną niewymienioną jednej podjednostki białkowej a już wymienioną domeną drugiej podjednostki nazywana jest interfejsem domeny wymienionej (SDI). Innym istotnym aspektem tego zjawiska jest region zawiasowy, czyli elastyczny segment łącznika, który łączy domeny niewymienione i wymienione. Region zawiasowy pełni kluczową funkcję, wspomagając ruch podczas wymiany domen 3D i służąc jako przełącznik konformacyjny, który umożliwia rekonfigurację strukturalną niezbędną do zajścia wymiany domen. Wymiana domen 3D jest zaangażowana w różne procesy biologiczne, w tym w składanie białek i regulację funkcjonalną5. Jest ona również powiązana z niektórymi chorobami wynikającymi z błędnego zwijania białek, gdzie aberracyjna wymiana może prowadzić do powstawania agregatów lub włókien amyloidowych.
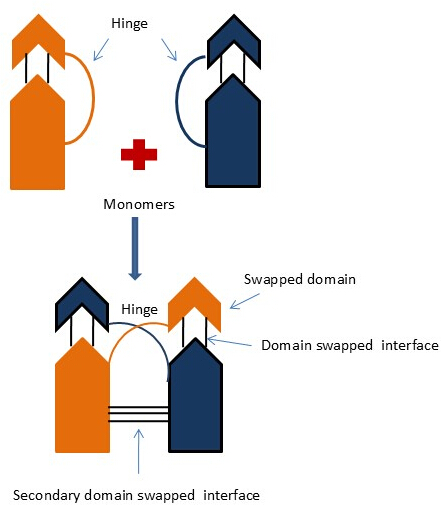
Rysunek 1: Przedstawienie strukturalne wymiany domen 3D. Schemat ilustruje wymianę identycznych elementów strukturalnych między dwoma monomerami białkowymi za pośrednictwem elastycznego regionu zawiasowego, co prowadzi do powstania dimeru lub kompleksu oligomerycznego z wymianą domen Proszę kliknąć tutaj, aby wyświetlić powiększoną wersję tego rysunku.
W zależności od charakteru wymienionych domen oraz powstałych struktur oligomerycznych zidentyfikowano różne typy zamiany domen 3D6. W 2002 roku Eisenberg i współpracownicy wyróżnili trzy rodzaje zamiany domen 3D: właściwą zamianę domen (BDS), quasi-zamianę domen (QDS) oraz kandydata do zamiany domen 3D (CDS)7. Najpowszechniejszą klasą białek jest właściwa zamiana domen. Odnosi się ona do stanu, w którym zarówno cząsteczki dimeru, jak i monomeru występują w formie stabilnej, przy czym dimer przyjmuje konfigurację z zamienionymi domenami, natomiast monomer przyjmuje konfigurację zamkniętą. W przypadku quasi-zamiany domen wiadomo, że białko występuje w stanie oligomerycznym, lecz jego struktura homologiczna występuje w stanie monomerycznym. W przypadku CDS potwierdzono jedynie klasyfikację białka w kategoriach zamiany domen, podczas gdy informacje strukturalne o zaangażowanych monomerach lub ich monomerycznych homologach nie są dostępne8. W tej procedurze monomery lub ich monomeryczne homologi są nieobecne; zamiast nich występują heterologiczne cząsteczki białek. Tabela 1 przedstawia przykład tych trzech kategorii9.
Tabela 1: Rodzaje zamiany domen 3D wraz z przykładem. Kliknij tutaj, aby pobrać tę tabelę.
Kolejne badania ujawniły liczne struktury z zamianą domen, co utorowało drogę do zrozumienia koncepcji trójwymiarowej zamiany domen. Pierwsze dowody strukturalne potwierdzające to zjawisko zaobserwowano w cząsteczce białka represora Cro z bakteriofaga λ, która tworzy strukturę dimeryczną poprzez wymianę swoich nici C-końcowych. W 1996 roku badacz odkrył, że monomer cząsteczki Cro bierze udział w trójwymiarowej wymianie domen (domain swapping).10Inna struktura11takich jak βkrystalina B212, ludzkie CksHs213, katalaza z wątroby wołowej14oraz rekombinowaną ludzką interleukinę-515zgłoszono również jako możliwe struktury z wymianą domen 3D. W zależności od położenia wymienionej domeny w cząsteczkach białek, wymianę domen 3D kategoryzuje się na trzy typy: wymianę domeny C-końcowej, wymianę domeny N-końcowej oraz stosunkowo rzadką wymianę domeny centralnej. Autorzy wykorzystali kompletny ludzki genom do przewidywania przypadków wymiany domen. Jako klasyfikatory binarne zastosowano Random Forest oraz Support Vector Machine, które osiągnęły dokładność odpowiednio 81,7% i 73,9%. W ludzkim genomie niemal 44% sekwencji białkowych zostało przewidzianych jako struktury z wymianą domen 3D.6Przeprowadzono analizę wzbogacenia przewidywanych przypadków pod kątem rozkładu domen, rozkładu chorób oraz adnotacji funkcjonalnych w oparciu o ontologię genów (Gene Ontology, GO). Inne podejście bada pełną analizę całego genomu (Genome-Wide Analysis of *Ocimum tenuiforum* stosując podejście Random Forest, stwierdzono, że blisko 25% sekwencji białkowych u Ocimum tenuiforum wykazuje przewidywane zaangażowanie w zamianę domen 3D. Badacze przeprowadzili również adnotację funkcjonalną z wykorzystaniem powiązań z terminami GO oraz przynależności do rodzin domen białkowych, wykazując, że jedynie 1158 sekwencji było zaangażowanych w stres abiotyczny16.
Rośliny wykazują różnorodność charakterystycznych rodzin białek, wśród których niektóre specyficzne białka są znane z umiejętności przechodzenia reorganizacji strukturalnych, w tym trójwymiarowej wymiany domen (3D domain swapping). Trójwymiarowa wymiana domen może wpływać na reakcje na stres biotyczny i abiotyczny poprzez produkcję metabolitów wtórnych lub inne biologicznie istotne szlaki, które mają wiele zastosowań farmakologicznych; dlatego stanowią one istotny punkt skupienia niniejszego badania. Struktura krystaliczna Wal1 wykazała dimeryczną konfigurację z wymianą domen, charakteryzującą się obecnością dwóch dimerów w jednostce asymetrycznej oraz reorganizacją strukturalną spotykaną w cystatynie C. Fitocystatyny odgrywają istotną rolę w stresie abiotycznym, a także zwiększają odporność upraw. Na podstawie dostępnej literatury oraz z różnych odpowiednich repozytoriów zidentyfikowano łącznie 20 121 przewidywanych białek z trójwymiarową wymianą domen, z czego 17 552 pochodzi z roślin, a 2569 z organizmów niebędących roślinami17,18.
W literaturze opisano różne inne przykłady przewidywania zamiany domen 3D u różnych roślin z wykorzystaniem uczenia maszynowego. Przykładowo dla Arabidopsis thaliana wyniosło to 33,7% (4058 z 12 033 przeanalizowanych sekwencji), dla Medicago truncatula 20,9% (39 z 186 przeanalizowanych sekwencji), dla Solanum tuberosum 36,5% (146 z 400 przeanalizowanych sekwencji), dla Solanum lycopersicum 25,5% (108 z 423 przeanalizowanych sekwencji) oraz dla Ocimum tenuiforum 15,5% (5706 z 36 841 przeanalizowanych sekwencji)6. Metody obliczeniowe stały się nieocenione w badaniu aspektów strukturalnych i funkcjonalnych białek z zamianą domen 3D. Podejścia te ułatwiają przewidywanie sekwencji na podstawie najlepszych możliwych cech19, adnotację i analizę wzbogacenia, dostarczając wiedzy o podstawowych mechanizmach molekularnych. Przewidywanie zamiany domen 3D w różnych sekwencjach białkowych zrealizowano za pomocą klasyfikatora opartego na maszynach wektorów wspierających (SVM). Podejście to opracowano poprzez integrację cech sekwencyjnych i strukturalnych, co pozwoliło uzyskać dokładność przewidywań na poziomie 76,33% dla zbioru treningowego i 73,81% dla zbioru testowego, co wskazuje na jego potencjał w identyfikowaniu tendencji do zamiany domen w białkach20. Głównym powodem wyboru algorytmu KNN zamiast SVM jest znacznie prostszy proces uczenia w przypadku KNN. Wymaga on ustawienia tylko jednego głównego parametru, K (liczby najbliższych sąsiadów uwzględnianych podczas dokonywania przewidywania), podczas gdy SVM wymaga starnego dostrojenia kilku parametrów, takich jak typ jądra, C i gamma. Ponadto KNN łatwiej radzi sobie z klasyfikacją wieloklasową, podczas gdy SVM zazwyczaj wymaga bardziej złożonych strategii, takich jak strategie jeden-przeciw-jednemu.
Uczenie maszynowe w przewidywaniu struktury białek
Przewidywanie struktury białek polega na wnioskowaniu o trójwymiarowym kształcie białka na podstawie jego sekwencji FASTA. Niedawne postępy w tej dziedzinie były w znacznym stopniu napędzane przez zastosowanie różnych technik uczenia maszynowego do danych ewolucyjnych21,22. Wczesne podejścia do wyodrębniania informacji z danych koewolucyjnych opierały się na metodach uczenia maszynowego. Jednak nowsze strategie, w szczególności te wykorzystujące głębokie sieci rezdualne, wykazały wyższą skuteczność w przewidywaniu potencjalnych celów23. Alphafold jest bazą danych opartą na głębokim uczeniu, podczas gdy Rosetta jest narzędziem wykorzystującym funkcję energii opartą na prawach fizyki. Narzędzia te służą do przewidywania pełnej trójwymiarowej struktury atomowej, która może być zbliżona do struktur eksperymentalnych. Dostarczają one jedynie współrzędnych strukturalnych w rozdzielczości atomowej, ale nie określają zdarzeń zamiany domen 3D. W przeciwieństwie do nich, proponowane podejście nie jest pełnym predyktorem struktury 3D, lecz jedynie przewiduje, czy białko prawdopodobnie przejdzie proces zamiany domen 3D, czy nie24,25.
Rośliny lecznicze od wieków są wykorzystywane jako naturalne zasoby do zapobiegania i leczenia różnych chorób, co przypisuje się zawartym w nich związkom bioaktywnym. Odgrywają one kluczową rolę w medycynie tradycyjnej i przyczyniają się do opracowywania nowoczesnych leków farmaceutycznych. Niemniej jednak w dziedzinie zamiany domen białkowych u roślin leczniczych w celu poszukiwania nowych leków nie przeprowadzono dotychczas znaczących prac. Algorytmy, w tym uczenie maszynowe i ich modele zespołowe, rozpoznają wzorce i zależności w danych sekwencyjnych, aby przewidywać trójwymiarową (3D) zamianę domen. Powodem wyboru roślin leczniczych do niniejszego badania jest możliwość wykrycia różnorodności funkcjonalnej białek roślinnych biorących udział w 3D zamianie domen, co prowadzi do lepszego zrozumienia odpowiedzi na stres, obrony przed patogenami oraz biosyntezy metabolicznej. Wyzwania techniczne związane z określaniem 3D zamiany domen białkowych w dużych liczbach oraz w złożonych, zaawansowanych konformacjach oligomerycznych przy użyciu technik NMR lub krystalografii podkreślają konieczność opracowania zaawansowanych podejść obliczeniowych.
Ogólnym celem proponowanej pracy badawczej jest zastosowanie metodologii obliczeniowej z wykorzystaniem algorytmów Random Forest (RF)26 oraz K-nearest neighbor (KNN)27 do zadania przewidywania struktury sekwencji białkowych oraz przeprowadzenie pełnej analizy całogenomowej przypadków zamiany domen w sekwencjach różnych roślin leczniczych. Random Forest (RF) jest klasyfikatorem binarnym; jest to odporny i wszechstronny algorytm uczenia maszynowego szeroko stosowany w analizie sekwencji białkowych. Działa on poprzez konstrukcję zespołu drzew decyzyjnych (DT) i osiąga dość wysoką dokładność zarówno w zbiorach treningowych, jak i testowych. W zadaniach dotyczących sekwencji białkowych RF może analizować różnorodne cechy, w tym właściwości fizykochemiczne, skład sekwencji, strukturę drugorzędową oraz informacje ewolucyjne pochodzące z dopasowań lub profili sekwencji. Doskonale radzi sobie z dużymi, zaszumionymi zbiorami danych i dostarcza metryki istotności cech28. Klasyfikator K-Nearest Neighbors (KNN) to prosty, a zarazem skuteczny algorytm uczenia maszynowego szeroko stosowany w analizie sekwencji białkowych. Działa on poprzez klasyfikowanie sekwencji wejściowej na podstawie klasy większościowej jej k najbliższych sąsiadów w przestrzeni cech. W analizie sekwencji białkowych KNN może być wykorzystywany do przewidywania kategorii funkcjonalnych, właściwości strukturalnych i lokalizacji subkomórkowej. Cechy dla klasyfikacji KNN często obejmują skład aminokwasowy, motywy sekwencyjne, profile ewolucyjne lub atrybuty fizykochemiczne. KNN jest popularnym wyborem w analizie białek ze względu na swoją prostotę; interpretowalność i skuteczność czynią go cennym narzędziem w analizie sekwencji białkowych29. Razem algorytmy te zapewniają komplementarne zalety, umożliwiając stworzenie kompleksowych ram obliczeniowych do badania zamiany domen 3D w sekwencjach różnych roślin leczniczych. Te dwa modele przewidują jedynie możliwe przypadki, które mogą przejść proces zamiany domen; nie przewidują one pełnych współrzędnych strukturalnych 3D ani tego, która część lub reszta jest szczególnie zaangażowana w ten proces zamiany. Jest to kwestia dalszych badań, ponieważ identyfikacja konkretnych regionów lub reszt zaangażowanych w zamianę pozwoliłaby wyjaśnić mechanizmy i aspekty funkcjonalne zdarzeń zamiany domen 3D. Zamiana domen 3D obejmuje szereg strukturalnie odmiennych zjawisk, takich jak konfiguracje w pętli zamkniętej, zamiany otwarte oraz inne różnice, obejmujące różne regiony zawiasowe i architektury domen. W związku z tym sugerowane podejście kategoryzuje wszystkie rodzaje zdarzeń zamiany domen 3D w ramach jednolitej klasyfikacji. Wybór ten był początkowo podyktowany ograniczoną dostępnością adnotowanych danych, które mogłyby określić konkretną klasę zamiany domen 3D. Jest to pierwsza próba zastosowania tej metody w odniesieniu do zbiorów danych opartych na różnych roślinach leczniczych i uważamy, że rozróżnienie między różnymi mechanizmami zamiany mogłoby zwiększyć dokładność predykcyjną modelu.
Analiza wzbogacenia w roślinach leczniczych pomaga zidentyfikować kluczowe geny, białka i szlaki zaangażowane w syntezę związków bioaktywnych oraz odpowiedź na stres. Dostarcza ona wiedzy na temat mechanizmów molekularnych. Analizy te w roślinach leczniczych badają istotne geny, białka i procesy biologiczne powiązane z syntezą substancji chemicznych o działaniu biologicznym, odpornością na stres oraz odpornością na choroby. Adnotacja funkcjonalna wybranych białek, taka jak analiza ontologii genów (GO) i szlaków KEGG, ujawnia mechanizmy molekularne leżące u podstaw produkcji metabolitów wtórnych i reakcji na stres środowiskowy. Podejście to znacząco wspomaga proces odkrywania leków, poprawia odporność upraw oraz wyjaśnia szlaki metaboliczne roślin w celu rozwoju zrównoważonego rolnictwa i postępów w medycynie.
Nowe wkład badania
Niniejsze badanie podkreśla możliwości uczenia maszynowego w tworzeniu bardziej precyzyjnych i wydajnych modeli do przewidywania wzorców strukturalnych białek w zbiorach danych biologicznych.
Niniejsze badanie integruje nowe cechy z algorytmami uczenia maszynowego, zwiększając ich zdolność do przewidywania funkcji białek z większą precyzją. Cechy te zapewniają lepsze zrozumienie zależności między strukturą a funkcją białek, co wspomaga bardziej dokładne projektowanie i optymalizację białek w inżynierii białek.
Analiza wzbogacenia przewidywanych białek pomaga zidentyfikować kluczowe szlaki biologiczne, procesy komórkowe i funkcje molekularne, dostarczając cennych celów dla odkrywania biomarkerów, projektowania leków oraz zrozumienia mechanizmów chorób. Analiza ta zwiększa precyzję interwencji opartych na szlakach sygnałowych oraz identyfikacji celów terapeutycznych.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
UWAGA: Ten segment przedstawia szczegółowy zarys sugerowanej metodologii, która obejmuje sześć głównych kroków: (a) gromadzenie danych, (b) wybór cech, (c) wstępne przetwarzanie danych, (d) końcowe przetwarzanie danych, (e) opracowanie modelu, (f) ewaluację wyników zaproponowanego modelu oraz (g) analizę wzbogacenia na różnych poziomach sekwencji przewidzianych pozytywnie. W pracy badawczej wykorzystano procesor 10. generacji Core i5-10500. Posiada on sześć rdzeni i 12 wątków, z częstotliwością bazową 3.10 GHz i maksymalną częstotliwością turbo 4.50 GHz. Jest wyposażony w 12 MB pamięci Intel Smart Cache, obsługuje pamięć DDR4-2666 i posiada zintegrowany układ graficzny UHD Graphics 630. Zaprojektowany z myślą o wydajnej wielozadaniowości i produktywności, jest kompatybilny z gniazdem LGA 1200 i pracuje przy TDP 65W.
1. Gromadzenie danych
- Należy użyć 3d3dswap-pred (https://caps.ncbs.res.in/3dswap-pred/3dswap-pred.html) oraz 3DSwap+ (https://caps.ncbs.res.in/3Dswapplus/index.html)3030 Tabela uzupełniająca 1, Tabela uzupełniająca 2, Plik uzupełniający 1, Plik uzupełniający 2). Wykorzystano łącznie 573 ręcznie wyselekcjonowanych wpisów z bazy PDB dotyczących cząsteczek z zamienionymi domenami (domain-swapped), pochodzących głównie z roślin leczniczych.
- Zastosuj metodę najlepszego profilu reprezentatywnego (Best Representative Profile – BRP) w celu stworzenia zbioru danych negatywnych poprzez przypisanie najlepszej sekwencji reprezentatywnej (Best Representative Sequence – BRS) do każdej rodziny Pfam31 rodzina białek (http://pfam.xfam.org/). Przeszukano łącznie 10 112 sekwencji strukturalnych w odniesieniu do wszystkich BRP Pfam przy użyciu programu HMMER32 (https://www.ebi.ac.uk/Tools/hmmer/) z progiem wartości E rzędu 0,001. Przetworzyć otrzymaną sekwencję za pomocą narzędzia DIAL w celu zidentyfikowania domen strukturalnych (https://bioinformaticshome.com/db/tool/DIAL). Uwzględnić 575 wpisów PDB jako negatywny zestaw danych (treningowy).
- W ramach zbioru danych negatywnych należy uwzględnić 314 sekwencji białek uzyskanych metodą BRP oraz 261 ręcznie wyselekcjonowanych sekwencji bez zamiany domen 3D, zidentyfikowanych za pomocą narzędzia 3DSwap+.
- Pobierz łącznie 1355 zweryfikowanych wpisów sekwencji białek z różnych roślin leczniczych z bazy UniProt33 (https://www.uniprot.org/). W badaniu ujęto 13 roślin leczniczych (zbiór danych testowych/predykcyjnych): Citrus sinensis (RS-102), Vitis vinifera (RS-226), mięta (RS-28), Cannabis sativa (RS-21), Acorus clamus (RS-511), Coffea arabica (RS-104), Papaver somniferum (RS-58), hibiskus (RS-88), jaśmin (RS-89), tymianek (RS-30), Thymus (RS-14), Illicium oligandrum (RS-72) oraz Citrus limon (RS-12)Drzewo filogenetyczne przedstawiono w Rycina uzupełniająca 1.
2. Wykorzystanie funkcji do tworzenia modelu
- Wykorzystaj kompleksowy zestaw 453 cech do przewidywania sekwencji białek w roślinach leczniczych. Uwzględnij 439 cech uznanych oraz 16 nowych cech, starannie dobranych na podstawie szczegółowego przeglądu literatury.
- Użyj bazy danych AAindex34(https://www.genome.jp/aaindex/) do określenia fizykochemicznych właściwości aminokwasów. Wykorzystaj platformę uczenia maszynowego WEKA35 (https://www.waikato.ac.nz/int/research/institutes-centres-entities/institutes/artificial-intelligence-institute/research/software/) do selekcji cech. Nowo wprowadzone cechy przedstawiono w Tabeli 2.
Tabela 2: Lista nowo dodanych cech wraz z ich opisami. Tabela ta podsumowuje nowe cechy opracowane podczas fazy ekstrakcji cech w celu poprawy wydajności modelu w przewidywaniu zamiany domen 3D. Każda cecha oddaje specyficzne właściwości sekwencyjne, fizykochemiczne lub strukturalne białek, które według hipotezy wpływają na ich skłonność do zamiany domen. Przedstawiono szczegółowe opisy, aby wyjaśnić znaczenie biologiczne oraz sposób obliczeniowego wyprowadzenia każdej cechy. Kliknij tutaj, aby pobrać tę tabelę.
3. Przetwarzanie wstępne i końcowe danych
UWAGA: Przetwarzanie wstępne danych. Przetwarzanie wstępne danych jest kluczowym etapem w uczeniu maszynowym, który polega na przygotowaniu surowych danych do analizy. Obejmuje ono oczyszczanie danych (np. usuwanie duplikatów, obsługę brakujących wartości itp.).
- Użyj Supplementary Coding File 1 do kodowania zmiennych kategorycznych w formie numerycznej, co obejmuje cztery główne etapy: (1) zdefiniowanie słowników punktowych (score dicts), (2) przetworzenie sekwencji fasta za pomocą seq I0. parse, (3) utworzenie ramki danych (data frame), (4) analiza numeryczna cech 3D domain-swapped.
- Udoskonal i zinterpretuj wyniki modelu poprzez postprocessing danych. Przeprowadź rekalibrację predykcji, zagreguj wyniki i zastosuj próg klasyfikacji. Klasyfikuj bimodalny zbiór danych dotyczacy 3D domain swapping, stosując wartość progową β = 0.5 (zakres 0-1), zgodnie z wynikami wcześniejszych badań36,37,38.
- Podziel zbiór danych w stosunku 70:30 na zbiór treningowy i testowy, przeznaczając 70% danych na trenowanie modelu i 30% na niezależną ewaluację.
- Zestandaryzuj dane treningowe za pomocą metody Standard Scaler, aby dostosować wartości cech do średniej 0 i odchylenia standardowego 1, co zapewni lepszą kompatybilność z estymatorami uczenia maszynowego. Przeprowadź selekcję cech w celu zidentyfikowania zmiennych o największym wpływie.
UWAGA: Standaryzacja zbioru danych jest powszechnie stosowanym wymogiem wstępnym dla wielu algorytmów uczenia maszynowego w celu zapewnienia optymalnej wydajności. Dane znacznie odbiegające od rozkładu normalnego mogą negatywnie wpływać na działanie modeli uczenia maszynowego39. - Przeprowadź walidację. Aby zapewnić rzetelną i nieobciążoną ewaluację modelu, zastosowano również K-krotną walidację krzyżową (K-fold cross-validation) Supplementary Table 3.
- Podziel zbiór danych na K podzbiorów. Trenuj i oceniaj model iteracyjnie na K=5 podzbiorach, wykorzystując pozostały podzbiór do niezależnego testowania.
4. Tworzenie i implementacja modelu
- Wdrożyć i zoptymalizować algorytmy Random Forest (RF) oraz K-Nearest Neighbors (KNN) w celu poprawy wydajności predykcyjnej. Przeprowadzić trenowanie, walidację i testowanie modeli, wykorzystując 573 i 575 sekwencji białek do trenowania oraz 1 355 sekwencji białek do testowania.
- Użyć skryptu w języku Python (Supplementary Coding File 1) do wyodrębnienia numerycznych wartości cech na podstawie wybranej sekwencji białek. Zapisać wartości numeryczne dla obu zbiorów danych w plikach CSV i przekazać je do klasyfikatorów RF oraz KNN w celu wygenerowania modelu klasyfikacji binarnej.
- Wykorzystać te modele do rozróżnienia białek z 3D domain-swapping od białek bez tej cechy. Ogólny schemat przewidywania 3D domain swapping przedstawiono na Ryc. 2 oraz Ryc. 3.
- Zastosować hiperparametry takie jak n_estimators=20, max_depth=4 oraz random_state=42 dla modelu RF.
- Zastosować hiperparametr neighbors=5 dla modelu klasyfikatora KNN.
UWAGA: Ustawienia tych parametrów zostały zoptymalizowane w celu zwiększenia wydajności modeli na ręcznie opracowanym zbiorze danych roślin leczniczych.
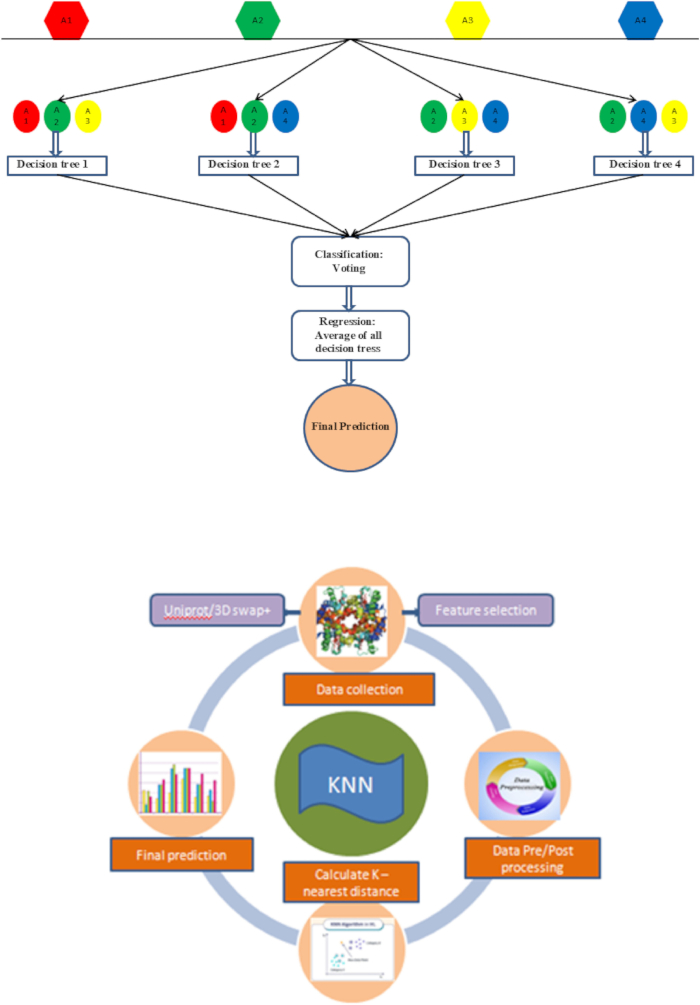
Rysunek 2: Ilustracyjny schemat przedstawiający proces. Schemat przedstawia modele uczenia maszynowego Random Forest oraz K-Nearest Neighbor (KNN), ukazując ich strukturę algorytmiczną i funkcjonalny przepływ pracy w kontekście zadań klasyfikacji binarnej Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
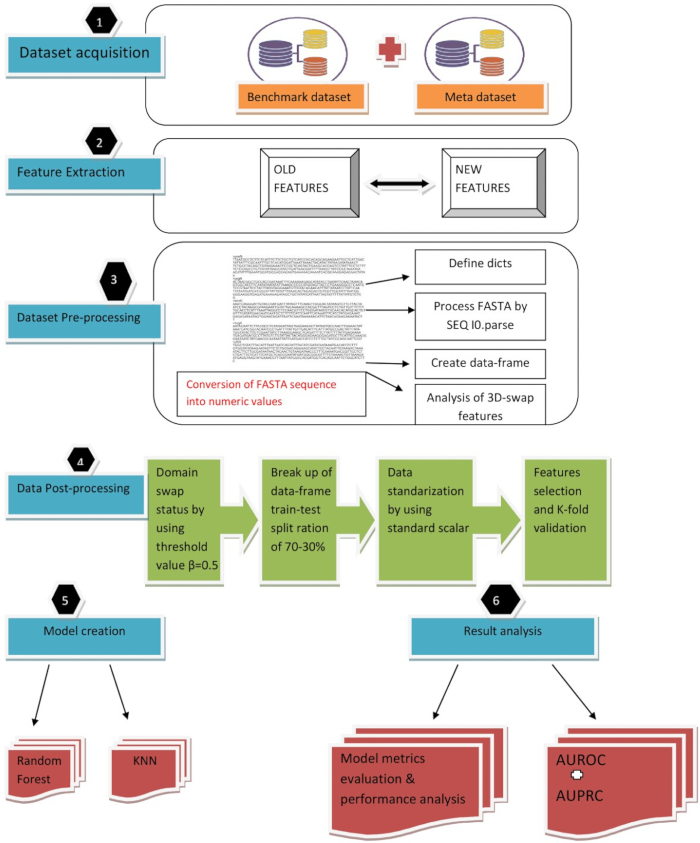
Rycina 3: Przepływ pracy oparty na uczeniu maszynowym.Schemat przedstawia przepływ pracy oparty na uczeniu maszynowym w celu przewidywania zamiany domen 3D w białkach roślin leczniczych. Proces rozpoczyna się od pozyskania zbiorów danych, łącząc zbiory referencyjne (benchmark) i meta-zbiory. Ekstrakcja cech obejmuje wyprowadzanie zarówno istniejących, jak i nowych cech z sekwencji białek. W etapie wstępnego przetwarzania danych sekwencje FASTA są konwertowane na wartości numeryczne za pomocą analizy sekwencji i mapowania słownikowego w celu utworzenia ustrukturyzowanych ramek danych, w tym specyficznych cech zamiany domen 3D. Przetwarzanie końcowe obejmuje przypisanie statusu zamiany domen przy użyciu progu (β = 0,5), podział danych na zbiory treningowe i testowe (stosunek 70-30), standaryzację cech oraz wybór cech z walidacją k-krotną. Trenowane są dwa modele uczenia maszynowego: Random Forest (RF) oraz K-Nearest Neighbors (KNN), a ich wydajność jest oceniana za pomocą metryk modelu wraz z AUROC i AUPRC w celu oceny dokładności i odporności predykcyjnej Proszę kliknąć tutaj, aby zobaczyć powiększoną wersję tej ryciny.
5. Statyczna ocena i ewaluacja modeli klasyfikatorów ML
- Zaimplementuj i zoptymalizuj algorytmy Random Forest (RF) oraz K-Nearest Neighbors (KNN), aby zmaksymalizować ich wydajność predykcyjną. Wytrenuj, zwaliduj i przetestuj modele, wykorzystując 573 i 575 sekwencji białek do uczenia oraz 1 355 sekwencji białek do testowania.
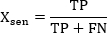 (1)
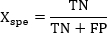 (2)
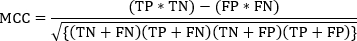 (3)
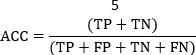 (4)
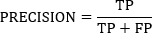 (5)
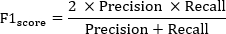 (6)
UWAGA: Przyjmij TP (True Positive – prawdziwie dodatnie) jako odsetek sekwencji prawidłowo zidentyfikowanych przez modele jako białka z zamianą domen (domain-swapped). Przyjmij TN (True Negative – prawdziwie ujemne) jako odsetek sekwencji prawidłowo zidentyfikowanych jako białka bez zamiany domen. Przyjmij FP (False Positive – fałszywie dodatnie) jako przypadki, w których białka bez zamiany domen zostały błędnie zaklasyfikowane jako białka z zamianą domen. Przyjmij FN (False Negative – fałszywie ujemne) jako przypadki, w których białka z zamianą domen zostały błędnie zaklasyfikowane jako białka bez zamiany domen. - Oblicz Xsen jako stosunek prawidłowo zidentyfikowanych wyników prawdziwie dodatnich oraz Xspe jako stosunek prawidłowo zidentyfikowanych wyników prawdziwie ujemnych w modelu.
UWAGA: Użyj wskaźnika MCC do oceny jakości klasyfikacji binarnych poprzez analizę wyników TP, TN, FP i FN z macierzy pomyłek. - Oblicz dokładność (ACC), aby określić proporcję poprawnych predykcji w stosunku do wszystkich wykonanych predykcji.
UWAGA: Precyzja (Precision) ocenia proporcję prawidłowo zidentyfikowanych wyników dodatnich spośród wszystkich przewidzianych wyników dodatnich, natomiast wskaźnik F1-score jest średnią harmoniczną precyzji i czułości (Sensitivity), co pozwala na zrównoważenie wyników fałszywie dodatnich i fałszywie ujemnych. - Użyj AUC do oceny wydajności modeli klasyfikacji w zadaniach klasyfikacji binarnej. Oblicz AUC (Area Under the Curve – pole pod krzywą) przy użyciu biblioteki Scikit-learn języka Python40, w oparciu o białka zaklasyfikowane pozytywnie i negatywnie.
- Wykorzystaj dane testowe do oceny powyższych parametrów.
6. Wdrożenie modelu do przewidywania zamiany domen 3D u różnych gatunków roślin leczniczych
- Zastosuj algorytmy RF oraz KNN na łącznej liczbie 1 355 zweryfikowanych sekwencji (zbiór predykcyjny) pochodzących z 13 różnych roślin leczniczych, w tym Citrus sinensis, Mentha, Vitis vinifera, Thyme, Thymus vulgaris, Jasmine, Hibiscus, Papaver somniferum, Illicium oligandrum, Citrus limon, Acorus calamus, Cannabis sativa oraz Coffea arabica.
UWAGA: Białka te są związane z różnymi funkcjami; na przykład Citrus sinensis, Mentha oraz tymianek pomagają w trawieniu. Vitis vinifera, Jasmine oraz Hibiscus są bardzo bogatym źródłem przeciwutleniaczy i poprawiają również stan skóry. Illicium oligandrum jest znane ze swoich właściwości przeciwgrzybiczych i przeciwbakteryjnych itp.
7. Badanie wzbogacenia białek z roślin leczniczych z pozytywnie przewidzianą zamianą domen 3D
- Przypisz kody dostępu tych sekwencji białkowych do kategorii metabolitów wtórnych, korzystając z danych z UniProt.
- Wyodrębnij ID genów z przewidzianych sekwencji.
- Otwórz serwer internetowy KEGG41 (https://www.genome.jp/kegg/), aby przeprowadzić analizę wzbogacenia szlaków KEGG, wklejając poszczególne ID genów lub nazwy białek w celu sprawdzenia ich odpowiednich szlaków.
- Przeprowadź analizę porównawczą, przeciwstawiając przewidziane białka z wymianą domen 3D zestawowi danych predykcyjnych, aby wykryć statystycznie istotną nadrzeczywistość konkretnych terminów ontologii genów (GO) i szlaków biologicznych. Wklej ID genów przewidzianej sekwencji do programu ShinyGO v0.742 (https://bioinformatics.sdstate.edu/go74/) i wybierz żądaną kategorię funkcji lub szlaków (funkcja biologiczna, komponent komórkowy, funkcja molekularna, KEGG itp.).
UWAGA: Zwizualizuj te adnotacje za pomocą platformy w chmurze43, która umożliwia użytkownikom pisanie i wykonywanie kodu Python.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Białka wykazujące zjawisko wymiany domen 3D (3D-domain swapping) są często powiązane z różnorodnymi funkcjami biologicznymi. Niemniej jednak systematyczna analiza sekwencji białkowych uczestniczących w wymianie domen 3D w skali całego genomu pozostaje w dużej mierze niezbadana. W niniejszej pracy przeprowadzono wstępne badanie w celu potencjalnego przewidzenia białek podlegających wymianie domen 3D u 13 roślin leczniczych, koncentrując się na ich powiązaniu z domenami metabolitów wtórnych, szlakami KEGG oraz terminami Ge...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Zrozumienie zamiany domen 3D w białkach w całym ich genomie ma istotne znaczenie w różnych dziedzinach. Podejścia oparte na uczeniu maszynowym, zwłaszcza las losowy i najbliższy sąsiadK 26,27, zostały wykorzystane do przewidywania zamiany domen 3D bezpośrednio na podstawie danych sekwencji białek na poziomie genomu. Te dwa modele uczenia maszynowego obejmują różne kroki, takie jak zbieranie zestawów danych, wybór funkcji, przetwarzanie wstępne/końcowe danych, imp...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy oświadczają, że nie są im znane żadne konkurencyjne interesy finansowe ani powiązania osobiste, które mogłyby mieć wpływ na pracę opisaną w tym artykule.
Podziękowania
Nie otrzymano żadnych funduszy na te badania.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| 3DSwap+ | https://caps.ncbs.res.in/3Dswapplus/index.html | ||
| Pfam | EMBL-EBI | http://pfam.xfam.org/: | |
| HMMER | EMBL-EBI | ; | |
| Aaindex | https://www.genome.jp/aaindex/: | ||
| TARCZA | Bioinformaticshome.com | https://bioinformaticshome.com/db/tool/DIAL: | |
| WEKA | Uniwersytet Wekato | https://www.waikato.ac.nz/int/research/institutes-centres-entities/institutes/artificial-intelligence-institute/research/software/ | |
| KEGG | https://www.genome.jp/kegg/ : | ||
| ShinyGO | https://bioinformatics.sdstate.edu/go/ : | ||
| uniprot | Uniprot | https://www.uniprot.org/ : |
Bibliografia
- Radivojac, P., et al. A large-scale evaluation of computational protein function prediction. Nat Methods. 10 (3), 221-227 (2013).
- Bennett, M. J., et al. 3D domain swapping: a mechanism for oligomer assembly. Protein Sci. 4, 2455-2468 (1995).
- Bennett, M. J., et al. Domain swapping: entangling alliances between proteins. Proc Natl Acad Sci U S A. 91, 3127-3131 (1994).
- Liu, Y., et al. The crystal structure of a 3D domain-swapped dimer of RNase A at a 2.1-Å resolution. Proc Natl Acad Sci U S A. 95 (7), 3437-3442 (1998).
- Straub, J. E., et al. Principles governing oligomer formation in amyloidogenic peptides. Curr Opin Struct Biol. 20, 187-195 (2010).
- Upadhyay, A. K., et al. Genome-wide prediction and analysis of 3D domain-swapped proteins in the human genome from sequence information. PLoS One. 11 (7), e0159627(2016).
- Liu, Y., et al. 3D domain swapping: as domains continue to swap. Protein Sci. 11, 1285-1299 (2002).
- Schlunegger, M. P., et al. Oligomer formation by 3D domain swapping: a model for protein assembly and misassembly. Adv Protein Chem. 50, 61-122 (1997).
- Rousseau, F., et al. Implications of 3D domain swapping for protein folding, misfolding and function. Adv Exp Med Biol. 747, 137-152 (2012).
- Anderson, W. F., et al. Structure of the Cro repressor from bacteriophage λ and its interaction with DNA. Nature. 290 (5809), 754-758 (1981).
- Albright, R. A., et al. High-resolution structure of an engineered Cro monomer shows changes in conformation relative to the native dimer. Biochemistry. 35, 735-742 (1996).
- Bax, B., et al. X-ray analysis of beta B2-crystallin and evolution of oligomeric lens proteins. Nature. 347, 776-780 (1990).
- Parge, H. E., et al. Human CksHs2 atomic structure: A role for its hexameric assembly in cell cycle control. Science. 262, 387-395 (1993).
- Fita, I., et al. The NADPH binding site on beef liver catalase. Proc Natl Acad Sci U S A. 82 (6), 1604-1608 (1985).
- Milburn, M. V., et al. A novel dimer configuration revealed by the crystal structure at 2.4 Å resolution of human interleukin-5. J Biol Chem. 268, 2117-2120 (1993).
- Upadhyay, A. K., et al. Genome-wide analysis of domain-swap predicted products in the genome of anti-stress medicinal plant: Ocimum tenuiflorum. Bioinformat Biol Insights. 13, 1177932218821362(2019).
- Simpson, G. A., et al. Crystal structure and interconversion of monomers and domain-swapped dimers of the walnut tree phytocystatin. Biochim Biophys Acta Prot Proteom. 1872 (2), 140975(2024).
- Tran, L. H., et al. 3D domain swapping dimerization of the receiver domain of cytokinin receptor CRE1 from Arabidopsis thaliana and Medicago truncatula. Front Plant Sci. 24 (12), 756341(2021).
- Shameer, K., et al. Insights into protein sequence and structure-derived features mediating 3D domain swapping mechanism using support vector machine-based approach. J Bioinform Comput Biol. 4, 33-42 (2010).
- Shameer, K., et al. 3dswap-pred: prediction of 3D domain swapping from protein sequence using Random Forest approach. Protein Pept Lett. 19, 1010-1020 (2012).
- Tasnim, F. Protein sequence classification through deep learning and encoding strategies. Proc Comp Sci. 238, 876-881 (2024).
- Xu, Y., et al. Deep dive into machine learning models for protein engineering. J Chem Info Modeling. 60 (6), 2773-2790 (2020).
- Lilhore, U. K., et al. Optimizing protein sequence classification: integrating deep learning models with Bayesian optimization for enhanced biological analysis. BMC Med Inform Decis Mak. 24, 236(2024).
- Jumper, J., et al. Highly accurate protein structure prediction with AlphaFold. Nature. 596 (7873), 583-589 (2021).
- Du, Z., et al. The trRosetta server for fast and accurate protein structure prediction. Nat Protoc. 16 (12), 5634-5651 (2021).
- Genuer, R., et al. Random forests: Some methodological insights. arXiv. , (2008).
- Guo, G., et al. KNN model-based approach in classification. Lect Notes Comput Sci. 2888, 986-996 (2003).
- Kathuria, C., et al. Predicting the protein structure using random forest approach. Procedia Comput Sci. 132, 1654-1662 (2018).
- Gui, Y., et al. Application of K-nearest neighbors in protein-protein interaction prediction. Highlights Sci Eng Technol. 2, 125-131 (2022).
- Joseph, A. P., Shingate, P., Upadhyay, A. K., Sowdhamini, R. 3PFDB+: improved search protocol and update for the identification of representatives of protein sequence domain families. Database. 2014, bau026(2014).
- Finn, R. D., et al. The Pfam protein families database. Nucl Acids Res. 41, D211-D222 (2013).
- Mistry, J., et al. Challenges in homology search: HMMER3 and convergent evolution of coiled-coil regions. Nucl Acid Res. 41, e121(2013).
- Apweiler, A. UniProt: The universal protein knowledgebase. Nucl Acids Res. 46 (5), 2699-2699 (2018).
- Kawashima, S., et al. AAindex: amino acid index database, progress report 2008. Nucl Acids Res. 36, D202-D205 (2008).
- Frank, E., et al. Data mining in bioinformatics using WEKA. Bioinformatics. 20, 2479-2481 (2004).
- Pedregosa, F., et al. Scikit-learn: Machine Learning in Python. J Mach Learn Res. 12, 2825-2830 (2011).
- Wu, C., et al. Prediction of DNA methylation site status based on fusion deep learning algorithm. IEEE AEMCSE Proc. 5, 180-183 (2022).
- Wilhelm, T., et al. Phenotype prediction based on genome-wide DNA methylation data. BMC Bioinform. 15, 1-15 (2014).
- Uddin, S., et al. Dataset meta-level and statistical features affect machine learning performance. Sci Rep. 14 (1), 1F670(2024).
- Pedregosa, F., et al. Scikit-learn: Machine Learning in Python. J Mach Learn Res. 12, 2825-2830 (2011).
- Kanehisa, M., et al. Kyoto encyclopedia of genes and genomes. Nucl Acid Res. 28 (1), 27-30 (2000).
- Ge, S. X., et al. ShinyGO: a graphical gene-set enrichment tool for animals and plants. Bioinformatics. 36 (8), 2628-2629 (2020).
- Bisong, E. Google Colaboratory. Building Machine Learning and Deep Learning Models on Google Cloud Platform. , Apress. Berkeley, CA. (2019).
- Kirby, G. W. Biosynthesis of the morphine alkaloids. Science. 155 (3759), 170-173 (1967).
- Toffolatti, S. L., et al. Role of terpenes in plant defence to biotic stress. Biocont Agents Sec Metabol. , 401-417 (2021).
- Boncan, D. A. T., et al. Terpenes and terpenoids in plants: interactions with environment and insects. Int J Mol Sci. 21 (19), 7382(2020).
- Mansouri, H., et al. The response of terpenoids to exogenous gibberellic acid in Cannabis sativa L. at vegetative stage. Acta Physiol. Plant.33, 1085-1091 (2011).
- Pál, M., et al. Speculation: Polyamines are important in abiotic stress signalling. Plant Sci. 237, 16-23 (2015).
- Mattoo, A. K., et al. Higher polyamines restore and enhance metabolic memory in ripening fruit. Plant Sci. 174 (4), 386-393 (2008).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
Ten artykuł został opublikowany
Film wkrótce dostępny