To badanie przedstawia oparty na Transformerze system sztucznej inteligencji do rozpoznawania zachowań w klasie w edukacji medycznej i pielęgniarskiej. Korzystając z danych multimodalnych, system ocenia zaangażowanie i stany emocjonalne uczniów. Wyniki wykazują wyższą dokładność w porównaniu z tradycyjnymi modelami, umożliwiając przekazywanie informacji zwrotnych w czasie rzeczywistym i lepsze wsparcie dla jakości nauczania i zdrowia psychicznego uczniów.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Rozpoznawanie zachowań w klasie za pomocą transformatora i mechanizmu uwagi: zastosowanie w ocenie jakości nauczania w edukacji medycznej opartej na sztucznej inteligencji
W tym artykule
Podsumowanie
Streszczenie
To badanie wprowadza oparty na Transformerze system sztucznej inteligencji przeznaczony do rozpoznawania zachowań w klasie, mający na celu poprawę oceny jakości nauczania i monitorowania zdrowia psychicznego w edukacji medycznej i pielęgniarskiej. Model wykorzystuje dane multimodalne, w szczególności wideo, audio i ruch szkieletu, do oceny kluczowych wskaźników zaangażowania uczniów, takich jak koncentracja uwagi, częstotliwość interakcji i wahania emocjonalne. Nowatorska strategia fuzji multimodalnej, w połączeniu z mechanizmami uwagi czasoprzestrzennej, umożliwia systemowi rejestrowanie złożonych zachowań w klasie z większą precyzją i niezawodnością. Wyniki eksperymentów na zestawach danych EduSense i SBU Kinect pokazują, że proponowana metoda znacznie przewyższa tradycyjne modele zarówno pod względem dokładności, jak i wskaźnika fałszywych alarmów. Ponadto badania ablacyjne potwierdzają wkład modułów uwagi przestrzennej i czasowej w zdolność rozpoznawania systemu. Platforma obsługuje informacje zwrotne w czasie rzeczywistym i wizualne mapowanie zachowań, oferując praktyczną wartość w środowiskach uczenia się opartego na doświadczeniu. Podejście to zapewnia skalowalne i adaptacyjne rozwiązanie do monitorowania zachowania w klasie i wspiera strategie wczesnej interwencji w edukacji medycznej.
Wprowadzenie
Wraz z rosnącymi wyzwaniami związanymi ze zdrowiem psychicznym wśród studentów pielęgniarstwa i medycyny z powodu stresu akademickiego i klinicznego, integracja sztucznej inteligencji w środowisku klasowym może zapewnić nie tylko monitorowanie jakości nauczania, ale także wsparcie psychologiczne w czasie rzeczywistym. To badanie pozycjonuje rozpoznawanie zachowań w edukacji medycznej w celu wspierania uczenia się przez doświadczenie i promowania dobrego samopoczucia uczniów1. Inteligentna klasa odnosi się do nowego i wysokiej jakości modelu edukacyjnego, który łączy inteligentne i spersonalizowane procesy nauczania poprzez zastosowanie najnowocześniejszych technologii, takich jak technologia informacyjna, sztuczna inteligencja, duże zbiory danych i Internet rzeczy, aby wspomóc zarządzanie nauczaniem i interakcję w klasie2,3,4. Obecnie, wraz z rozwojem technologii, takich jak kamery i czujniki, dane behawioralne zbierane w klasie obejmują nie tylko filmy, ale także dane multimodalne, takie jak głos i audio5. Jednak radzenie sobie z tymi złożonymi informacjami i danymi czasoprzestrzennymi oraz dokładne wydobywanie z nich cennych cech behawioralnych to główne wyzwania stojące przed dziedziną inteligentnego rozpoznawania zachowań w klasie6,7. Istniejące podejścia do rozpoznawania zachowań opierają się głównie na wyodrębnianiu cech z jednomodalnych źródeł danych, takich jak strumienie wideo w klasie lub sekwencyjne obrazy8. Chociaż metody te mogą wykrywać zgrubne zdarzenia behawioralne, często nie są w stanie modelować ewolucji czasowej i niuansów przestrzennych gestów, wyrażeń lub czynników częstotliwości interakcji uczniów, które mają kluczowe znaczenie dla zrozumienia samopoczucia i skupienia ucznia9. Co więcej, obecne modele nie mają solidnych mechanizmów łączenia heterogenicznych źródeł danych, takich jak sygnały dźwiękowe i ruchy szkieletu, co ogranicza ich wrażliwość na afektywne lub niezaangażowane zachowanie10. Aby zaradzić tym ograniczeniom, w niniejszym badaniu zaproponowano oparty na transformatorach system rozpoznawania zachowań w klasie, wzbogacony o mechanizmy uwagi przestrzenno-czasowej. Wykorzystując zdolność Transformera do modelowania zależności dalekiego zasięgu i łącząc ją ze strategiami fuzji cech multimodalnych, proponowany system ma na celu poprawę precyzji klasyfikacji zachowań, umożliwiając jednocześnie wizualizację wskaźników zaangażowania i emocji w czasie rzeczywistym. Ostatecznym celem jest wspieranie dynamicznej oceny jakości nauczania i wbudowanych informacji zwrotnych na temat zdrowia psychicznego w edukację medyczną, oferując skalowalne, adaptacyjne rozwiązanie do monitorowania i zwiększania zarówno skuteczności nauczania, jak i dobrostanu uczniów.
Ocena proponuje nowatorski system rozpoznawania zachowań oparty na transformatorach, który łączy mechanizmy uwagi czasoprzestrzennej z multimodalną fuzją danych (wideo i szkieletowe) dostosowaną do inteligentnej obserwacji w klasie w edukacji medycznej i pielęgniarskiej. W przeciwieństwie do istniejących modeli, nowy model ułatwia dokładne wykrywanie uwagi uczniów i stanów emocjonalnych w czasie rzeczywistym, co jest cenne zarówno dla oceny jakości nauczania, jak i dobrego samopoczucia psychicznego.
Powiązane prace
Inteligentna klasa to nowe środowisko nauczania, które wykorzystuje nowoczesną technologię informacyjną w celu usprawnienia interakcji w nauczaniu, spersonalizowanego uczenia się i zarządzania nauczaniem. Może wykorzystywać inteligentne metody nauczania w celu poprawy efektywności i jakości nauczania, zapewniając jednocześnie uczniom bogatsze i bardziej spersonalizowane doświadczenia edukacyjne. Dlatego wielu naukowców na całym świecie prowadziło badania nad inteligentną technologią i nauczaniem w klasie. Radosavljevic i in. zaproponowali inteligentny model klasy oparty na inteligencji środowiskowej, który ocenia poziom zmęczenia uczniów i dostosowuje strategie uczenia się, analizując dane dotyczące ich codziennej aktywności akademickiej w celu optymalizacji wyników uczenia się11. Tai T. Y badał wpływ inteligentnych asystentów osobistych na poprawę umiejętności mówienia w językach obcych i odkrył, że korzystanie z Asystenta Google znacznie poprawiło umiejętności mówienia osób, dla których język obcy nie jest językiem ojczystym, z podobnymi efektami jak w przypadku native speakerów w communication12. Chen i in. odkryli w swoich badaniach, że wykorzystanie chatbotów jako narzędzi dydaktycznych może szybko reagować na potrzeby uczniów, zwiększać interaktywność i demonstrować potencjalne zastosowanie inteligentnej technologii w klasie13. Badania wykazały metodę oceny efektywności nauczania w klasie opartą na inteligentnym trybie nauczania, która poprawiła dokładność oceny dzięki zastosowaniu algorytmu wyszukiwania kukułki i ekstremalnej maszyny uczącej się14.
Rozpoznawanie zachowań w inteligentnych klasach jest kluczową technologią do osiągnięcia spersonalizowanego nauczania i optymalizacji zarządzania klasą. Może monitorować stan zachowania uczniów w czasie rzeczywistym i dostarczać skutecznych informacji zwrotnych. Dzięki rozpoznawaniu zachowań nauczyciele mogą dokładnie zrozumieć uczestnictwo i koncentrację uczniów, poprawiając w ten sposób efektywność nauczania i pomagając w podejmowaniu decyzji. W tym kontekście naukowcy na całym świecie przeprowadzili szeroko zakrojone badania nad inteligentnym rozpoznawaniem zachowań w klasie. W ramach badań zaproponowano system monitorowania wizualnego w czasie rzeczywistym oparty na sztucznej inteligencji, który wykorzystywał uczenie maszynowe do trenowania modeli rozpoznawania zachowań uczniów, aby pomóc nauczycielom lepiej monitorować uczestnictwo uczniów i interakcje w klasie, optymalizując w ten sposób jakość nauczania15. Chonggao P osiągnął rozpoznawanie zachowań uczniów w czasie rzeczywistym i poprawił dokładność analizy zachowania w klasie w zdalnym nauczaniu, łącząc analizę klastrów i algorytm losowego lasu, a także model ludzkiego szkieletu16. Wu S opracował model rozpoznawania zachowań uczniów, który łączy optymalizację roju cząstek i algorytm K-najbliższego sąsiada, promując dokładność rozpoznawania emocji, aby sprostać praktycznym potrzebom nauczania w klasie17. System ACORN zaproponowany przez Ramakrishnana i in. wykorzystywał multimodalne uczenie maszynowe i połączone konwolucyjne sieci neuronowe do analizy danych dźwiękowych, mimicznych i obrazu. Integracja tych cech za pomocą czasowych sieci konwolucyjnych pozwoliła na automatyczną ocenę atmosfery w klasie i poczynienie wstępnych postępów18.
Podsumowując, istniejące badania proponują różne techniki oparte na uczeniu maszynowym i głębokim uczeniu do inteligentnego rozpoznawania zachowań w klasie, obejmujące takie obszary jak wykrywanie zmęczenia uczniów, analiza nastrojów i monitorowanie interakcji w klasie. Jednak nadal istnieją pewne niedociągnięcia w obecnych badaniach, a wielu metodom brakuje wystarczającego czasu rzeczywistego i skalowalności w praktycznych zastosowaniach, co utrudnia dostosowanie się do złożonych i zmieniających się scenariuszy w klasie. W związku z tym w badaniu zaproponowano inteligentną metodę rozpoznawania zachowań w klasie za pomocą Transformera i AM. Innowacyjność badań polega na wykorzystaniu potężnych możliwości modelowania czasowego Transformera w połączeniu z czasoprzestrzennym AM w celu dokładnego uchwycenia kluczowych momentów i regionów behawioralnych w klasie oraz integracji wielu źródeł informacji, takich jak wideo i audio, poprzez multimodalną fuzję danych w celu zwiększenia kompleksowości i dokładności rozpoznawania zachowań.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
W niniejszym badaniu wykorzystano publicznie dostępne zestawy danych, które nie zawierają żadnych danych osobowych. Wszystkie dane użyte w badaniu zostały zanonimizowane w celu zapewnienia prywatności uczestników. Świadoma zgoda została uzyskana od wszystkich uczestników w momencie zbierania danych, a badanie jest zgodne z wytycznymi etycznymi. Protokół wyjaśnia metodę inteligentnego rozpoznawania zachowań w klasie, która składa się z ekstrakcji cech w oparciu o fuzję danych multimodalnych oraz czasoprzestrzennego rozpoznawania zachowań w oparciu o model Transformer i mechanizm uwagi. Wydajność całej metody jest optymalizowana poprzez wspólne trenowanie.
1. Wielomodalne gromadzenie danych
Multimodalne gromadzenie danych polegało na zbieraniu zsynchronizowanych danych o zachowaniach w klasie z dwóch zbiorów danych: zbioru EduSense oraz zbioru SBU Kinect Interaction. EduSense zawierał nagrania z rzeczywistych sal wykładowych na uniwersytecie, natomiast SBU Kinect rejestrował sekwencje szkieletowe oparte na interakcjach. Zbiory danych obejmowały strumienie wideo, sygnały audio oraz informacje o 3D stawach szkieletowych w celu modelowania postaw i ruchów studentów. Wstępne przetwarzanie danych zapewniło wyrównanie czasowe oraz usuwanie szumów w celu oczyszczenia materiału. Ta konwergencja umożliwiła kompleksowe monitorowanie zachowań, rejestrując gesty wizualne i ruchy ciała w wielu sytuacjach edukacyjnych.
2. Ekstrakcja cech oparta na fuzji danych multimodalnych
W odpowiedzi na problem rozpoznawania zachowań uczniów w inteligentnych salach lekcyjnych zaproponowano metodę inteligentnego rozpoznawania zachowań w klasie z wykorzystaniem Transformer i AM. Ze względu na złożony charakter sal lekcyjnych z liczną grupą uczniów, zmiany czynników wewnątrz sceny mogą zakłócać rozpoznawanie zachowań uczniów. Ponadto ekstrakcja pojedynczej cechy posiada ograniczenia, takie jak niepełne informacje, podatność na zakłócenia środowiskowe oraz trudności w uchwyceniu złożonych zachowań19,20. W związku z tym w badaniu zaproponowano najpierw metodę ekstrakcji cech uczniów w klasie opartą na fuzji danych multimodalnych. Metoda ta łączy dane z modalności wideo i szkieletowej, wykorzystując ich komplementarność do osiągnięcia bardziej kompleksowej i dokładnej ekstrakcji cech zachowań uczniów. W szczególności każda wejściowa sekwencja wideo jest dzielona na klatki. Klatki są wprowadzane do wstępnie wytrenowanego modelu Faster R-CNN w celu lokalizacji obszarów zainteresowania (ROI) postaci ludzkich. Wykryte obszary są przekazywane do głównej sieci neuronowej splotowej (backbone) w celu uzyskania czasowych cech wizualnych. W przypadku modalności szkieletowej, trójwymiarowe pozycje stawów są traktowane jako sekwencje i kodowane przy użyciu wstępnie wytrenowanego modelu BERT w celu uzyskania zależności czasowych i przestrzennych. Są one normalizowane i osadzane przed wprowadzeniem do sieci fuzji multimodalnej. Przy tym modalność wideo odpowiada głównie za przechwytywanie cech wizualnych, takich jak ruchy i ekspresja uczniów, podczas gdy modalność szkieletowa dokładnie opisuje zmiany postawy uczniów poprzez informacje o punktach stawowych. Podczas gdy modalność wideo opiera się na globalnych cechach percepcji wizualnej w celu reprezentacji ludzkich zachowań, modalność szkieletowa koncentruje się na dynamicznych zmianach pozycji stawów, co prowadzi do znaczących różnic semantycznych między nimi21. Dlatego konieczne jest opracowanie wyspecjalizowanej sieci fuzji multimodalnej, aby skutecznie modelować korelację między obiema modalnościami. Sieć fuzji multimodalnej przedstawiono na Ryc. 1.
Na Rysunku 1 sieć jest podzielona głównie na trzy moduły. Wśród nich wejściem dla modułu przetwarzania modalności wideo jest sekwencja wideo, która jest przetwarzana za pomocą szybszej splotowej sieci neuronowej opartej na regionach (Faster R-CNN) w celu ekstrakcji cech. Przetwarzanie modalności wideo rozpoczyna się od przekształcenia ujęć wideo z sali lekcyjnej w wejścia klatka po klatce do ekstrakcji cech. Klatki są przetwarzane przez szybszą splotową sieć neuronową opartą na regionach (Faster R-CNN) z bazą ResNet-50 trenowaną na zbiorze ImageNet. Sieć przetwarza klatki RGB zmienione rozmiarem do 224 × 224 pikseli, co daje wysokopoziomowe mapy cech wizualnych z cechami przestrzennymi i obiektowymi aktywności studenta. Cechy te są następnie wprowadzane do modułu samoatencji (self-attention), który uczy się zależności czasowych między klatkami przed zakodowaniem ich w osadzenia czasowo-przestrzenne via warstwę Transformera. Pozwala to na zachowanie słabych sygnałów behawioralnych, takich jak pochylenia głowy czy podnoszenie rąk, w reprezentacjach osadzeń do późniejszej fuzji. Wyekstrahowane cechy wideo są przechwytywane przez moduł samoatencji w celu uchwycenia relacji czasowych i przestrzennych w obrębie modalności wideo, a następnie dodatkowo modelowane przez transformer w celu wygenerowania wektorów osadzeń dla informacji czasowo-przestrzennych sekwencji wideo. Wejściem dla modułu przetwarzania modalności szkieletowej jest sekwencja szkieletowa, która jest przetwarzana przez dwukierunkową reprezentację koderów z transformerów (BERT) w celu ekstrakcji cech czasowych i przestrzennych stawów szkieletowych. W przypadku danych szkieletowych poza każdego studenta jest modelowana jako sekwencja 2D współrzędnych stawów z filmów z sali lekcyjnej przy użyciu estymatora pozy opartego na OpenPose. Sekwencje te są konwertowane na tokeny osadzeń, w których każdy token odpowiada klatce z 18 punktami kluczowymi. Kontekst czasowy i zależności tych sekwencji stawów są modelowane przy użyciu modelu dwukierunkowych reprezentacji koderów z transformerów (BERT). Model wykorzystuje 12 warstw transformera, 8 głowic uwagi i ukrytą wielkość 768, co stanowi standardową architekturę BERT-base. Model jest dostrajany podczas treningu, aby nabyć wzorce stawów specyficzne dla danego zachowania. Wyjściowe osadzenia reprezentują cechy strukturalne i związane z ruchem zachowań studenta, które są następnie łączone z cechami modalności wideo. Następnie cechy szkieletowe są dalej agregowane w cechy przestrzenne i czasowe poprzez operacje 3D CNN i pooling, generując wektory osadzeń szkieletu jako reprezentacje cech modalności szkieletowej.
3. Moduł fuzji z mechanizmem cross-attention
W module fuzji cross-attention zastosowano mechanizm wielogłowicowej uwagi (multi-head attention mechanism, MHAM) w celu zbudowania relacji interakcji między modalnością wideo a modalnością szkieletową, a następnie wyekstrahowano bardziej zwarte cechy fuzji z wygenerowanych multimodalnych cech fuzji za pomocą operacji 3D CNN i poolingu. Proces fuzji jest realizowany przy użyciu dwustrumieniowej sieci uwagi, w której osadzenia czasowe każdej modalności są przekazywane przez sieci 3D CNN i dwukierunkowe jednostki GRU. Strumienie danych multimodalnych są wyrównywane za pomocą modułów wielogłowicowej uwagi (MHAM) z wykorzystaniem mechanizmu scaled dot-product attention w celu uzyskania zależności między modalnościami. Następnie osadzenia są redukowane poprzez pooling, aby rozwiązać problem złożoności wymiarowej, i przesyłane do w pełni połączonej warstwy Softmax w celu klasyfikacji.
W sieciach fuzji multimodalnej moduł self-attention jest wykorzystywany do modelowania zależności czasowych i przestrzennych w obrębie pojedynczego trybu, podczas gdy moduł fuzji cross-attention służy do ustanawiania powiązań i interakcji informacyjnych między różnymi trybami. W związku z tym oba są bardzo ważne. Moduł self-attention przechwytuje wewnętrzne zależności sekwencji wejściowej poprzez obliczanie relacji między zapytaniem Q, kluczem K a wartością V. Obliczenia Q, klucza K i wartości V przedstawiono w równaniu (1). Gdzie 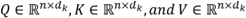 to odpowiednio macierze zapytania, klucza i wartości; dk jest wymiarem wektora klucza, a dk wymiarem wektorów wartości. Współczynnik wymiaru dk jest stosowany, aby zapobiec nadmiernemu wzrostowi wartości iloczynów skalarnych, co mogłoby wpłynąć na stabilność gradientów podczas trenowania.
 (1)
W równaniu (1)  reprezentuje cechy wejściowe, gdzie n jest długością sekwencji wejściowej, dmodel jest wymiarem cech, a WQ, WK i WV reprezentują trzy zestawy uczących się macierzy projekcji. Poprzez te odwzorowania macierzowe cechy wejściowe są przekształcane w zapytania (queries), klucze (keys) i wartości (values). Iloczyn skalarny zapytania Q i klucza K jest wykorzystywany do obliczenia i przeskalowania wag uwagi, jak pokazano w równaniu (2).
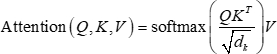 (2)
W równaniu (2) dk reprezentuje wymiar zapytania Q oraz klucza K, a softmax oznacza funkcję softmax wykorzystywaną do uzyskania macierzy wag uwagi. Skalowanie może skutecznie zapobiegać problemowi zbyt małego gradientu wynikającego z nadmiernych wartości iloczynu skalarnego spowodowanych wymiarowością. Macierz wag uwagi jest aplikowana do wartości V w celu uzyskania wyniku Z modułu self-attention, jak pokazano w równaniu (3).
 (3)
W równaniu (3), aij oznacza wagę uwagi i -tego wektora zapytania względem j-tego wektora klucza. Szczegółowa struktura modułu fuzji uwagi krzyżowej (cross attention fusion module) przedstawiona jest na Rysunku 2.
Zgodnie z Rysunkiem 2, moduł ten rozpoczyna przede wszystkim przetwarzanie cech wejściowych z modalności szkieletowej i wideo. W pierwszej kolejności sekwencja szkieletu i sekwencja wideo są oddzielnie poddawane działaniu warstw splotowych 3D w celu ekstrakcji cech czasoprzestrzennych, a następnie cechy te są modelowane przy użyciu dwukierunkowych jednostek bramkowanych (Bi-GRUs) w celu modelowania czasowego. Następnie cechy obu modalności są dalej ekstrahowane poprzez MHAMs, aby wyodrębnić korelacje wewnątrz modalności. Każda modalność uzyskuje wewnętrzną reprezentację cech poprzez mechanizmy zapytań (queries), kluczy (keys) i wartości (values). Następnie na wyjściowych cechach wykonuje się uśrednianie czasowe (time-averaged pooling), aby zmniejszyć złożoność wymiaru czasowego. Po uśrednianiu multimodalne cechy są statystycznie agregowane w celu obliczenia średniej i odchylenia standardowego dla każdej modalności, a na koniec rozpoznawanie i klasyfikacja działań ucznia są generowane poprzez warstwę w pełni połączoną (FCL) oraz klasyfikator Softmax. Zatem zaproponowana w badaniu ekstrakcja cech oparta na fuzji danych multimodalnych wykorzystuje mechanizmy self-attention oraz cross AMs, aby precyzyjnie przechwycić i zamodelować cechy czasoprzestrzenne zachowań ucznia poprzez fuzję danych z modalności wideo i szkieletowej, co zwiększa dokładność i kompleksowość rozpoznawania zachowań uczniów w inteligentnych klasach.
4. Rozpoznawanie zachowań czasoprzestrzennych w oparciu o Transformer i mechanizm uwagi
Ekstrakcja cech oparta na fuzji danych multimodalnych pozwala na wstępną poprawę kompleksowości i dokładności analizy zachowań uczniów poprzez łączenie danych z modalności wideo i szkieletowej. Jednakże w kontekście inteligentnych klas zachowania uczniów często zmieniają się w czasie, a to samo zachowanie może wykazywać różne charakterystyki w różnych punktach czasowych i obszarach przestrzennych. Opieranie się wyłącznie na statycznych informacjach wynikających z fuzji cech multimodalnych nie pozwala na pełne uchwycenie złożonych czasowo-przestrzennych relacji dynamicznych w sekwencji zachowań.22,23W związku z tym w dalszych badaniach zaproponowano modelowanie zachowań czasoprzestrzennych oraz mechanizm uwagi (AM) oparty na architekturze Transformer. W badaniu wybrano Vision Transformer (ViT) jako architekturę sieci, która dzięki mechanizmowi samo-uwagi (self AM) pozwala modelować globalne informacje czasoprzestrzenne danych wejściowych i wykazuje większą zdolność do wychwytywania zależności czasoprzestrzennych. Po fuzji multimodalnej połączone cechy są ponownie reprezentowane za pomocą Vision Transformera (ViT) w celu prognozowania zachowań czasoprzestrzennych. Mapy cech w danych wejściowych są dzielone na rozłączne 16 × 16 patchy, liniowo osadzonych w wektorach jednowymiarowych i zakodowanych pozycyjnie w celu zachowania kolejności przestrzennej. Struktura ViT składa się z 12 bloków kodera Transformera, zbudowanych z mechanizmu wielogłowicowej uwagi własnej (8 głowic) oraz warstw przejścia w przód o wymiarze ukrytym wynoszącym 768. Aby zwiększyć istotność behawioralną, zaproponowano moduły uwagi przestrzennej (SA) i uwagi czasowej (TA). Moduł SA zwiększa istotność cech w obszarach przestrzennych poprzez aktywacja Tanh, podczas gdy moduł TA wyróżnia istotne klatki czasowe poprzez aktywacja ReLU. Te dwa strumienie uwagi są następnie łączone z główną strukturą (backbone) ViT poprzez dwuetapowa metoda trenowania, dzięki której model uczy się efektywnie rejestrować dynamiczną ewolucję zachowań w klasie. Struktura ViT została przedstawiona w Rysunek 3.
Na Rysunku 3 przedstawiono architekturę ViT, w której oryginalnym wejściem jest obraz podzielony na wiele małych bloków o stałym rozmiarze; każdy z nich reprezentuje fragment obrazu i zostaje liniowo spłaszczony do wektora jednowymiarowego. Ponieważ Transformer nie potrafi postrzegać informacji o lokalizacji, każdy mały blok jest wzbogacany o informacje pozycyjne przed wprowadzeniem do Transformera, aby zapewnić możliwość uchwycenia relacji przestrzennych pomiędzy poszczególnymi blokami. Głównym modułem ViT jest koder Transformer, który składa się z wielu ułożonych kaskadowo bloków kodujących Transformer. Bloki kodujące składają się z MHAM oraz sieci neuronowej typu feed-forward. MHAM przechwytuje zależności między sekwencjami wejściowymi w sposób równoległy, podczas gdy sieć feed-forward wykonuje nieliniowe przekształcenia wyników w celu zwiększenia zdolności modelu do wychwytywania i wyrażania informacji globalnych. Po przetworzeniu wszystkich małych fragmentów informacji przez koder Transformer, wyjście z ostatniej warstwy kodującej jest przekazywane do wielowarstwowego perceptrona (MLP Head), który generuje końcowe wyniki rozpoznawania i klasyfikacji czynności studenta.
W praktyce każda klatka jest dzielona na niezachodzące na siebie fragmenty (patche) o wymiarach 16 × 16, spłaszczana i poddawana osadzaniu pozycyjnemu w celu zachowania relacji przestrzennych. Osadzenia fragmentów są przetwarzane sekwencyjnie przez stosowane koderami transformera w architekturze ViT. Moduł uwagi przestrzennej (Spatial Attention, SA) wykorzystuje funkcję aktywacji tanh do różnicowania uwagi w obszarach zainteresowania w obrębie każdej klatki, natomiast moduł uwagi czasowej (Temporal Attention, TA) wykorzystuje funkcję ReLU do wyróżnienia klatek istotnych czasowo. Ten dwuskładnikowy mechanizm uwagi umożliwia efektywne modelowanie dynamiki zachowań w przestrzeni i czasie.
Aby dodatkowo zwiększyć wydajność ViT w złożonych sekwencjach behawioralnych, wprowadzono uwagę przestrzenną (SA) oraz uwagę czasową (TA), co pozwala modelowi ViT nie tylko na autonomiczny wybór istotnych stawów przestrzennych, ale także na skupienie się na zachowaniach w różnych punktach czasowych, co lepiej oddaje czasoprzestrzenne zmiany dynamiczne zachowania. Moduł SA i moduł TA przedstawiono na Rysunku 4.
Na Ryc. 4A moduł SA przetwarza informacje o wymiarze przestrzennym danych wejściowych, przekazując cechy bieżącej klatki do warstwy ViT w celu wyodrębnienia stanów ukrytych. Są one łączone z cechami poprzedniej klatki i wspólnie przekazywane do FCL. FCL wykonuje transformację liniową cech w celu wygenerowania latentnych reprezentacji cech. Następnie są one przekazywane do funkcji aktywacji Tanh, aby zmapować wyjście do zakresu [-1,1], co zwiększa nieliniowość i pozwala lepiej odróżnić cechy istotne od nieistotnych. Na koniec cechy są normalizowane za pomocą warstwy normalizacji, aby zapewnić relatywnie stabilną skalę cech wyjściowych. Na Ryc. 4B moduł TA koncentruje się bardziej na kluczowych informacjach zawartych w każdej klatce w wymiarze czasowym. W przeciwieństwie do funkcji Tanh w SA, moduł TA wykorzystuje funkcję aktywacji ReLU do tłumienia wartości ujemnych i zachowuje jedynie wyjścia z wartości dodatnich, co skutecznie usuwa negatywne informacje szumowe i wzmacnia zdolność modelu do przechwytywania informacji w czasie.
5. Metoda wspólnego treningu
Aby skutecznie rozwiązać problem stronniczych i redundantnych cech czasoprzestrzennych, wynikających z wzajemnego wpływu ViT, modułu SA oraz modułu TA w rozpoznawaniu zachowań czasoprzestrzennych opartym na Transformerze i mechanizmach uwagi, zastosowano metodę wspólnego trenowania w celu optymalizacji tych trzech modułów. Szczegółowy proces przedstawiono na Rysunku 5.
Na Rysunku 5 przedstawiono strategię wspólnego trenowania, która w pierwszej kolejności wprowadza parametry trenowania modelu, definiuje strukturę sieci oraz hiperparametry. Następnie przeprowadzane jest oddzielne wstępne trenowanie modułów SA i TA w celu lepszego wyuczenia cech lokalnych. Należy zauważyć, że podczas wstępnego trenowania jednego modelu, wagi drugiego modelu pozostają stałe i nie są aktualizowane. Po zakończeniu indywidualnego wstępnego trenowania, warstwa ViT zostaje połączona w celu trenowania. Następnie dwa modele uwagi zostają zamrożone, a główna sieć ViT jest trenowana osobno. Ostatecznie, poprzez wspólne trenowanie głównej sieci ViT oraz modułów SA i TA, optymalizowana jest cała sieć w celu wygenerowania końcowego modelu do inteligentnego rozpoznawania zachowań w klasie. Procedura trenowania jest realizowana etapowo: (1) autonomiczne wstępne trenowanie modułów SA i TA przy zamrożonych parametrach ViT, (2) etapowe trenowanie ViT przy zamrożonych wagach modułów uwagi oraz (3) dostrajanie end-to-end wszystkich komponentów razem przy użyciu optymalizatora Adam (learning rate = 0.001, batch size = 64, epochs = 100). Podejście to stabilizuje uczenie cech i redukuje interferencje między modułami podczas optymalizacji.
Ogólnie rzecz biorąc, proponowana metoda rozpoznawania zachowań w inteligentnej klasie łączy modalności wideo i szkieletowe, aby modelować relacje czasoprzestrzenne za pomocą mechanizmów self-attention oraz modułów cross AM. Dzięki wykorzystaniu globalnej zdolności modelowania czasoprzestrzennego ViT oraz połączeniu modułów przestrzennych i TA, model został zoptymalizowany pod kątem wychwytywania kluczowych zachowań i dynamiki czasowej, co pozwala na bardziej kompleksowe i dokładne rozpoznawanie zachowań uczniów. W rozważanej architekturze przeprowadzane są krytyczne operacje fuzji, w których łączone są multimodalne reprezentacje cech. W szczególności cechy przestrzenne wyuczone przez CNN są łączone z cechami czasowymi Bi-LSTM. Wynik ten jest następnie łączony z cechami wzmocnionymi przez mechanizm uwagi MHAM przed wykonaniem zadania klasyfikacji. Operacje fuzji te są kluczowe dla połączenia komplementarnych widoków danych behawioralnych i zostały podkreślone na Rysunku 1 oraz Rysunku 5.
Algorytm 1 ilustruje połączenie multimodalnych danych: informacji szkieletowych, tekstowych i wideo, przy użyciu modeli opartych na ViT, BERT i GCN w celu wyodrębnienia informacyjnych cech w danej klasie. Następnie wspólna reprezentacja jest etykietowana w celu identyfikacji zachowań studenta, co pozwala uzyskać wyższą dokładność dzięki uczeniu między-modalnemu.
Algorytm 1: Proces multimodalnego rozpoznawania zachowań z wykorzystaniem ViT, BERT i GCN.
Inicjalizacja:
Wstępnie wytrenowany model BERT
Wstępnie wytrenowany model Faster R-CNN
Wstępnie wytrenowany model ViT
Model GCN dla danych szkieletowych
Klasyfikator (np. MLP lub Transformer)
Wczytaj zestaw danych:
Dla każdej próbki w zbiorze danych multimodalnych:
Wyodrębnij klatki wideo
Wyodrębnij transkrypcję audio
Wyodrębnianie danych szkieletowych (OpenPose lub MediaPipe)
Krok 1: Przetwarzanie modalności wideo
Dla każdej klatki w filmie:
Zastosuj Faster R-CNN w celu wykrycia obiektów/uczestników
Zastosuj Vision Transformer (ViT) w celu wyodrębnienia cech na poziomie klatki
Agregowanie cech w czasie w celu reprezentacji temporalnej
Krok 2: Przetwarzanie modalności tekstowej
Wstępne przetwarzanie tekstu transkrypcji:
Wykonaj tokenizację przy użyciu tokenizera BERT
Prześlij tokeny przez model BERT
Wyodrębnij osadzenia kontekstowe (contextual embeddings) z tokenu [CLS] lub poprzez średnie pulowanie (average pooling)
Krok 3: Przetwarzanie modalności szkieletowej
Dla każdej sekwencji szkieletowej:
Normalizacja współrzędnych
Przeprowadź przez GCN lub ST-GCN w celu wyodrębnienia cech ruchu
Krok 4: Fuzja cech
Łączenie (konkatenacja) lub fuzja z mechanizmem uwagi:
Funkcje wideo
Funkcje tekstu
Cechy szkieletowe
Uzyskanie jednolitej reprezentacji multimodalnej
Krok 5: Klasyfikacja
Przekaż połączoną reprezentację do końcowego klasyfikatora
Przewidywanie etykiety zachowania w klasie (np. skupiony, rozproszony)
Krok 6: Ocena
Porównaj wyniki predykcji z prawdą obiektywną
Oblicz metryki: dokładność (Accuracy), precyzja (Precision), czułość (Recall), wynik F1 (F1 Score)
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
W celu oceny skuteczności i wyższości ulepszonej metody rozpoznawania zachowań w inteligentnej klasie z wykorzystaniem Transformer i AM, przeprowadzono weryfikację i analizę wyników eksperymentalnych. W pierwszej kolejności skonfigurowano środowisko i parametry eksperymentalne, zgodnie z danymi przedstawionymi w Tabeli 1.
Na podstawie Tabeli 1 w badaniu wybrano zbiory danych EduSense Dataset oraz SBU Kinect Interaction Dataset jako zbiory eksperymentalne, nazw...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Zaproponowano metodę rozpoznawania zachowań dla inteligentnych sal lekcyjnych opartą na Transformer i AM, aby sprostać wyzwaniom związanym ze złożonym zachowaniem uczniów i rozpoznawaniem danych multimodalnych. Sieć ViT z możliwością globalnego modelowania czasoprzestrzennego została skonstruowana poprzez integrację danych z modalności wideo i szkieletowych, a także wykorzystano samouwagę i krzyżowe AM do uchwycenia czasoprzestrzennych cech zachowania. Poprzez zintegrowanie danych wideo i audio z nową ramą Intelligent Se...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Brak.
WKŁAD AUTORA:
Liu Lei: Odpowiedzialny za koncepcję i projekt badań; zaproponowano opartą na transformatorze metodę multimodalnej fuzji danych do inteligentnego rozpoznawania zachowań w klasie. Kierował opracowaniem modelu i projektu eksperymentalnego, zarządzał gromadzeniem i przetwarzaniem danych oraz sporządził wstępny manuskrypt. Przyczynił się do analizy i dyskusji nad wynikami eksperymentów.
He Zhihua: Zapewnił ogólne wytyczne i nadzór nad badaniem; przyczynił się do stworzenia ram badawczych i wsparcia metodologicznego. Brał udział w optymalizacji modelu i analizie eksperymentalnej, recenzował i poprawiał manuskrypt, zapewniał zgodność ze standardami etycznymi i wydał ostateczną zgodę na złożenie. Osoba odpowiedzialna za korespondencję.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| 128 GB pamięci RAM DDR4 | Wielu dostawców | https://www.crucial.com/memory/ddr4 | Wystarczająca ilość pamięci do multimodalnego przetwarzania danych |
| 2 TB pamięci masowej SSD | Wielu dostawców | https://www.samsung.com/ssd | Do przechowywania zestawów danych i modeli |
| (konfiguracja podstawowa) | Hugging Face | https://huggingface.co/-base-uncased | osadzania sekwencji szkieletowych |
| Zestaw narzędzi CUDA 11.1 | NVIDIA | https://developer.nvidia.com/cuda-toolkit | Umożliwia akcelerację GPU dla biblioteki PyTorch |
| cuDNN 8.0 | NVIDIA | https://developer.nvidia.com/cudnn | akcelerowana przez GPU dla głębokich sieci neuronowych |
| Zestaw danych EduSense | Carnegie Mellon University | https://www.cs.cmu.edu/~./edusense | Rzeczywisty zestaw danych |
| w klasie uniwersyteckiejSzybszy R-CNN (ResNet-50) | Open Source (PyTorch) | https://github.com/facebookresearch/detectron2 | Detektor obiektów używany do wyodrębniania cech wideo |
| Procesor Intel Xeon E5-2680 v4 | https://www.intel.com/products/xeon-e5-2680-v4 | Wysokowydajny procesor do trenowania modelu | |
| Matplotlib | Open Source | https://matplotlib.org | Służy do kreślenia metryk wydajności |
| Karta graficzna NVIDIA Tesla V100 | https://www.nvidia.com/en-us/data-center/tesla-v100 | Służy do trenowania i wnioskowania; obsługuje rozpoznawanie zachowań w czasie rzeczywistym | |
| https://github.com/CMU-Perceptual-Computing-Lab/openpose OpenPose | CMU | Wyodrębnia szkieletowe punkty kluczowe 2D z klatek wideo | |
| Platforma PyTorch 1.8 | Open Source | https://www.pytorch.org | Biblioteka głębokiego uczenia używana do Opracowanie modelu |
| SBU Kinect Interaction Dataset | Stony Brook University | https://www3.cs.stonybrook.edu/~kyunghan/sbu_kinect | Zestaw danych szkieletowych oparty na interakcjach |
| TensorBoard | Open Source (Google) | https://www.tensorflow.org/tensorboard | Służy do wizualizacji treningowej |
| System operacyjny Ubuntu 20.04 LTS | Canonical | https://www.ubuntu.com/download | System operacyjny Linux używany jako środowisko programistyczne |
| Vision Transformer (ViT) | Google / Przytulanie twarzy | https://huggingface.co/google/vit-base-patch16-224 | Służy do globalnego modelowania zachowań czasoprzestrzennych |
Bibliografia
- He, F., Yuan, X. An analysis of ways to optimize teacher-student relationship in ideological and political wisdom classroom teaching in senior high school. Int J Educ Humanit. 14 (1), 40-44 (2024).
- Tambunan, M. A., Sirait, J., Silitonga, I. Implementation of the Glasser model with the help of animation media based on local wisdom to improve the writing skills of UHNP Indonesian language education program students. IDEAS J Engl Lang Teach Learn Linguist Lit. 12 (2), 1110-1117 (2024).
- Munisa, M., Putri, U. N., Sari, W. V., Fitri, N. A. Digital literacy based on local wisdom in inclusive education. Pionir J Pendidik. 13 (1), 120-124 (2024).
- Intelligent classroom perception system based on artificial intelligence. Eur Alliance Innov. Zhang, T. EAI Urb-IoT 2021: Proc 6th EAI Int Conf IoT Urban Space, 20-21 Dec 2021, Shenzhen, China, 51, (2022).
- Badawi, H. Exploring classroom discipline strategies and cultural dynamics: Lessons from the Japanese education system. Tafkir Interdiscip J Islam Educ. 5 (1), 1-12 (2024).
- Yang, F. A spatio-temporal attention-based method for detecting student classroom behaviors. arXiv. , (2023).
- Wang, Z., Wang, M., Zeng, C., Li, L. Multi-scale deformable transformers for student learning behavior detection in smart classroom. Xiv. , (2024).
- Lin, L., Yang, H., Xu, Q., Xue, Y., Li, D. Research on student classroom behavior detection based on the real-time detection transformer algorithm. Appl Sci. 14 (14), 6153(2024).
- Wang, Z., Yao, J., Zeng, C., Li, L., Tan, C. Students' classroom behavior detection system incorporating deformable DETR with Swin transformer and lightweight feature pyramid network. Systems. 11 (7), 372(2023).
- Lyons, J., Tarc, P. How might IB classroom pedagogy 'make a better world?' (Toward) illuminating a promising IBDP teacher praxis. Globalisation Soc Educ. 22 (4), 605-624 (2024).
- Radosavljevic, V., Radosavljevic, S., Jelic, G. Ambient intelligence-based smart classroom model. Interact Learn Environ. 30 (2), 307-321 (2022).
- Tai, T. Y. Effects of intelligent personal assistants on EFL learners' oral proficiency outside the classroom. Comput Assist Lang Learn. 37 (5-6), 1281-1310 (2024).
- Chen, Y., Jensen, S., Albert, L. J., Gupta, S., Lee, T. Artificial intelligence (AI) student assistants in the classroom: Designing chatbots to support student success. Inf Syst Front. 25 (1), 161-182 (2023).
- Chen, J., Lu, H. Evaluation method of classroom teaching effect under intelligent teaching mode. Mob Netw Appl. 27 (3), 1262-1270 (2022).
- Trabelsi, Z., Alnajjar, F., Parambil, M. M. A., Gochoo, M., Ali, L. Real-time attention monitoring system for classroom: A deep learning approach for student's behavior recognition. Big Data Cogn Comput. 7 (1), 48-56 (2023).
- Chonggao, P. Simulation of student classroom behavior recognition based on cluster analysis and random forest algorithm. J Intell Fuzzy Syst. 40 (2), 2421-2431 (2021).
- Wu, S. Simulation of classroom student behavior recognition based on PSO-kNN algorithm and emotional image processing. J Intell Fuzzy Syst. 40 (4), 7273-7283 (2021).
- Ramakrishnan, A., Zylich, B., Ottmar, E., LoCasale-Crouch, J., Whitehill, J. Toward automated classroom observation: Multimodal machine learning to estimate class positive climate and negative climate. IEEE Trans Affect Comput. 14 (1), 664-679 (2021).
- Lee, J., Kim, H. Discrete cosine transformed images are easy to recognize in vision transformers. IEIE Trans Smart Process Comput. 12 (1), 48-54 (2023).
- Rachman, R. K., Setiadi, D. R. I. M., Susanto, A., Nugroho, K., Islam, H. M. M. Enhanced vision transformer and transfer learning approach to improve rice disease recognition. J Comput Theor Appl. 1 (4), 446-460 (2024).
- Wu, H., Triebe, M. J., Sutherland, J. W. A transformer-based approach for novel fault detection and fault classification/diagnosis in manufacturing: A rotary system application. J Manuf Syst. 67 (1), 439-452 (2023).
- Zhong, X., Gu, Y., Luo, Y., Zeng, X., Liu, G. Bi-hemisphere asymmetric attention network: Recognizing emotion from EEG signals based on the Transformer. Appl Intell. 53 (12), 15278-15294 (2023).
- Jamali, A., Roy, S. K., Bhattacharya, A., Ghamisi, P. Local window attention transformer for polarimetric SAR image classification. IEEE Geosci Remote Sens Lett. 20 (1), 1-5 (2023).
- Zhao, X. M., Yusop, F. D. B., Liu, H. C., Prilanita, Y. N., Chang, Y. X. Classroom student behavior recognition using an intelligent sensing framework. IEEE Access. 13, 49767-49776 (2025).
- Huang, Y., et al. A method for classroom behavior state recognition and teaching quality monitoring. Int J Intell Comput Cybern. 18 (2), 382-396 (2025).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
Ten artykuł został opublikowany
Film wkrótce dostępny