PreventativeTestPro to oparte na AI ramy testowe, które wykorzystują dane obserwowalności oraz duże modele językowe do automatyzacji analizy przyczyn źródłowych, generowania testów i ciągłej walidacji, z celem poprawy niezawodności oprogramowania oraz optymalizacji zapewnienia jakości zarówno dla systemów frontendowych, jak i backendowych, aby ułatwić bardziej efektywne zarządzanie zgłoszeniami wsparcia.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
PreventativeTestPro: Skalowalny hybrydowy framework testowy wykorzystujący obserwowalność i generatywną sztuczną inteligencję do proaktywnej inżynierii jakości oprogramowania
W tym artykule
Podsumowanie
Streszczenie
Niniejszy artykuł wprowadza zaawansowany, skalowalny system testowania, który integruje automatyzację opartą na obserwowalności z proaktywną inżynierią jakości wspieraną przez AI, aby sprostać współczesnym wyzwaniom dostarczania oprogramowania. Sugerowany system ulepsza PreventativePro, otwartoźródłową, hybrydową platformę testową łączącą metodologie black-box i white-box, poprzez innowacyjną warstwę orkiestracji testów opartą na obserwowalności. Platforma wykorzystuje logi, metryki, zdarzenia i śledzenia wraz z monitorowaniem po stronie przeglądarki i serwera, aby szybko identyfikować anomalie, ulepszać wybór przypadków testowych oraz automatyzować tworzenie funkcjonalnych, wydajnościowych i testowych zestawów bezpieczeństwa. Charakterystyczną cechą jest włączenie dużych modeli językowych (LLM), które dostarczają wglądu w przyczyny źródłowe i autonomicznie konstruują nowe przypadki testowe na podstawie zachowań produkcyjnych i zidentyfikowanych nieprawidłowości, zapewniając tym samym pokrycie regresją adaptacyjną i inteligentną remediację.
System umożliwia jednoczesne wykonywanie testów z natychmiastową analizą logów opartą na AI, tworząc ciągłą pętlę zwrotną między operacjami a testami. Został zweryfikowany w kilku scenariuszach korporacyjnych, w tym na platformach SaaS opartych na mikroserwisach oraz ekosystemach SAP BTP. Wyniki empiryczne z czterech wdrożeń produkcyjnych oraz grupy beta liczącej 49 inżynierów wskazują na spadek średniego czasu do rozwiązania o nawet 30%, ponad 95% zgodności z SLA oraz znaczącą poprawę zarówno w zakresie pokrycia testów, jak i śledzenia wad. Bezwysiłkowe połączenie z narzędziami standardowymi w branży ilustruje jego zdolność do podłączania i używania.
Badania te przedstawiają kompleksową, niezależną od narzędzi i perspektywiczną metodologię inżynierii jakości, zgodną z zasadami agile i DevOps. Przyszłe przedsięwzięcia obejmują dynamiczną klasyfikację anomalii poprzez uczenie maszynowe, rozszerzenie na systemy mobilne i zorientowane na doświadczenie użytkownika oraz rozszerzone możliwości dużych modeli językowych do opracowywania testów specyficznych dla dziedziny i prognozowania awarii.
Wprowadzenie
Rosnąca popularność paradygmatu agile w firmach programistycznych doprowadziła do rosnącego zainteresowania środowiskami ciągłej integracji. Zaletą takich systemów jest płynna integracja regularnych modyfikacji programów, co skutkuje przyspieszoną i opłacalną ewolucją oprogramowania. W konsekwencji będzie efektywnie zarządzać zadaniami takimi jak budowa procedur, realizacja testów oraz raportowanie wyników testów. Testowanie oprogramowania jest wdrażane od początku inżynierii oprogramowania. Praktyka testowania oprogramowania została wprowadzona w celu oceny jakości oprogramowania1. Testowanie obejmuje szereg działań mających na celu wykrycie i usunięcie potencjalnych błędów w oprogramowaniu przed jego wdrożeniem dla użytkowników końcowych. Testowanie oprogramowania to kosztowny etap w procesie tworzenia2. Koszt testowania i debugowania oprogramowania stanowi ponad 50 procent całkowitych kosztów rozwoju i wynosi 3,4. Koszt związany z testami regresyjnymi zależy od złożoności aplikacji oraz skali zestawu testów5.
Metodologia agile prowadzi do szybkich zmian w produkcji, co z kolei powoduje dużą liczbę problemów ze wsparciem wynikających z opinii. Zarządzanie problemami z obsługą klienta to bardzo istotna i kluczowa odpowiedzialność, o czym świadczy fakt, że 68% konsumentów wyraża gotowość do zapłacenia wyższej ceny za produkty i usługi firmy znanej z doskonałej obsługi klienta6. Według badania, 86% klientów, którzy otrzymują doskonałą obsługę, jest bardziej skłonnych stać się lojalnymi rzecznikami firmyw dłuższej perspektywie. Według badania, 89% kupujących jest bardziej skłonnych do ponownych zakupów, jeśli mieli pozytywne doświadczenia z obsługą klienta8. Według badania, 93% klientów jest skłonnych do ponownych zakupów u firm oferujących wyjątkową obsługę klienta9. Aby zapewnić doskonałą obsługę klienta, niezbędne jest szybkie i skuteczne rozwiązywanie zgłoszeń do obsługi na wysokim poziomie jakości. Element jakości jest kluczowy, gdy dążymy do szybszej dostawy, ponieważ koszty rozwiązywania problemów z wsparciem rosną wraz z czasem i poziomem eskalacji10.
Aby uzyskać wysoką jakość, konieczne jest zlokalizowanie i rozwiązanie problemów z wsparciem, jednocześnie zapewniając kompleksowe pokrycie testów regresji na zgłoszeniu. To zadanie jest złożone i powoduje wzrost trudności operacyjnych, zwłaszcza w szybkim wykrywaniu i rozwiązywaniu problemów ze wsparciem. Trudności ze wsparciem, obejmujące szeroki zakres problemów, takich jak spadek wydajności systemu czy nieprzewidziane awarie, często pojawiają się na etapie operacyjnym systemów oprogramowania. Jeśli te trudności nie zostaną szybko wykryte i rozwiązane, mogą prowadzić do długotrwałych okresów bezczynności, niezadowolenia konsumentów oraz problemów finansowych. Obecne metody wykorzystywania informacji o obserwowalności do testowania są często ograniczone przez procedury manualne, taktyki responsywne zamiast proaktywnych oraz brak integracji wykrywania anomalii z realizacją testów. Wyraźnie brakuje proaktywnego wykrywania problemów ze wsparciem przy użyciu danych obserwacji w czasie rzeczywistym oraz automatycznego wykonywania odpowiednich przypadków testowych, aby zapobiec prawdopodobnym awariom z wyprzedzeniem.
Brak kompleksowego, zintegrowanego rozwiązania prowadzi do wielu negatywnych konsekwencji dla utrzymania i niezawodności oprogramowania. Czynniki te obejmują długotrwałe okresy bezczynności systemu spowodowane opóźnieniem w identyfikacji problemów, zwiększoną pracę ręczną przy lokalizowaniu odpowiednich przypadków testowych oraz obniżone zaufanie do niezawodności systemu. Co więcej, brak dokładnego powiązania zidentyfikowanych nieprawidłowości z przypadkami testowymi prowadzi do niedoborów w zasięgu testów, co może prowadzić do nierozwiązanych istotnych problemów.
Podstawową przyczyną tej dysproporcji można przypisać rozproszonej strukturze istniejących systemów monitorowania i testowania. Wiele obecnych systemów nie ma możliwości płynnej integracji analizy danych obserwowalności z wykonywaniem odpowiednich przypadków testowych. Ponadto zależność od stałych regulacji i procedur ludzkich związanych z przypisywaniem nieprawidłowości do przypadków testowych utrudnia szybkie i precyzyjne rozwiązywanie nowych problemów.
Aby zrozumieć, jak branża radzi sobie z problemami wsparcia i prowadzi testy profilaktyczne, przeprowadziliśmy szczegółowe badanie badawcze, przeprowadzając wywiady z profesjonalistamiz tej dziedziny. Na podstawie danych z wywiadów podkreślono, że największą przeszkodą napotykaną podczas wdrażania jakiegokolwiek rozwiązania jest niewystarczający czas na zapewnienie jakości. Podczas rozmowy zwrócono uwagę na kilka obaw, w tym podnoszenie kwalifikacji osób, koszty utrzymania, niski zwrot z inwestycji oraz wybór i integrację narzędzi11. Informacje te zostały również zweryfikowane w raporcie Katalon "The State of Quality Report 2024"12.. Przed przedstawieniem jakichkolwiek rozwiązań problemów wymienionych w wywiadach przeprowadziliśmy porównawczą ocenę narzędzi, aby sprawdzić, czy istnieją narzędzia lub algorytmy odpowiadające na wspomniane problemy13,14. Obecnie brakuje nam niezbędnych narzędzi lub algorytmów specjalnie zaprojektowanych do rozwiązania trudności omawianych podczas wywiadów.
Prace te wprowadzają innowacyjną metodę wykorzystującą dane obserwowalności do wykrywania problemów z wsparciem na wczesnym etapie (nawet zanim zostaną one zgłoszone) oraz przeprowadzenia odpowiednich przypadków testowych, co zwiększa niezawodność i odporność systemów oprogramowania. Strategia ta opiera się na wykorzystaniu danych obserwowalności do identyfikacji nieprawidłowości, nawiązania powiązań z prawdopodobnymi problemami oraz inicjowania przeprowadzania ukierunkowanych przypadków testowych, które z dużym prawdopodobieństwem ujawnią przyczynę problemu. Proponowane rozwiązanie ma na celu zmniejszenie podziału między operacjami programistycznymi a testowaniem, umożliwiając proaktywną i szybką reakcję na potrzeby wsparcia. Proponowane rozwiązanie pozwala na tworzenie nowych przypadków testowych, jeśli brakuje ich w zestawie, co poprawia zasięg testów. Sugerowana strategia ma również na celu odpowiedź na obawy wyrażone w wywiadach oraz w raporcie Katalon 11,12,13,14.
Obserwowalność, w kontekście teorii sterowania, odnosi się do stopnia, w jakim stany wewnętrzne układu można wyprowadzić na podstawie jego zewnętrznych wyjść. W dziedzinie inżynierii oprogramowania pojęcie obserwowalności odnosi się do zdolności monitorowania i rozumienia stanu systemu oprogramowania poprzez wykorzystanie wyników takich jak logi, metryki, ślady oraz zdarzenia 15,16,17. Nasza analiza literatury obejmuje analizę obserwowalności i jej zastosowania w testowaniu oprogramowania. Jednak znaleźliśmy ograniczoną dostępną literaturę na ten temat. Dlatego uwzględniliśmy także dyskusje na temat innowacyjnych testów profilaktycznych i powiązanych badań. Nasz przegląd literatury jest dalej podzielony na 3 różne grupy.
Bogatinovski i in.18 przedstawiają CLog, kontekstową sieć neuronową i technikę klastrowania, zaprojektowaną do radzenia sobie z niestabilnymi danymi logowymi i niewystarczającym pokryciem awarii poprzez identyfikację istotnych podprocesów i wykrywanie awarii w nagłych przejściach kontekstowych. Busby i in.19 proponują metodologię opartą na logach do generowania anonimowych przypadków testowych, przewidując sekwencje użytkowników do replikacji bez danych osobowych; jednak różnice w współbieżności i poziomie loggera pozostają istotnymi ograniczeniami. Lee i Kang20 proponują wdrożenie architektury testowej do testowania linii produktów programowych, aby poprawić obserwowalność i kontrolowalność w obecności mechanizmów zmienności. Model QEX21 łączy dane z różnych źródeł testowania, aby dostarczyć jasnych, użytecznych informacji podczas wykonywania testów. Lal iKumar 22 podkreślają znaczenie możliwości widzenia i kontrolowania inteligentnych testów. Sugerują wykorzystanie automatyzacji opartej na AI, aby testy były szybsze, bardziej efektywne i dokładne. Briand i in.23 ilustrują zastosowanie programowania aspektowego w Javie do efektywnej instrumentacji kontraktów i inwariantów, podczas gdy Baral iOffutt 24 podkreślają problem błędnych twierdzeń testowych, które skutkują "ślepymi testami", które nie identyfikują nieprawidłowego zachowania.
Rott25 omawia, że nowoczesne analizy i wizualizacje w Teamscale kładą nacisk na proces testowania oprogramowania, umożliwiając testerom dostęp do przetworzonych artefaktów specyficznych dla wymaganych problemów i sytuacji. Collins i Lucena26 podkreślają znaczenie przeprowadzenia wielu testów w pipeline CI przed wdrożeniem produkcyjnym. Mówią, że testy warstwowe to dobry sposób, by upewnić się, że produkt jest wysokiej jakości i ograniczyć problemy ze wsparciem.
BugSwarm27 oferuje metodę analizy niepowodzeń testów CI poprzez powiązanie przyczyn źródłowych z ich odpowiednimi rozwiązaniami. Dudila iLetia, 28 lat, analizują metody testowania white-box i black-box, sugerując spójną strategię ograniczającą wysiłki związane z debugowaniem podczas procesu tworzenia. Fushihara i in.29 badali "testowe zapachy" w aplikacjach Pythona, analizując ich postęp poprzez modyfikacje kodu w celu usprawnienia zarządzania kodem testowym. SUPERNOVA30 to system do wyboru testów i zapobiegania błędom, który wykorzystuje dane, automatyzację i uczenie maszynowe do poprawy zapewnienia jakości. Araujo31 proponuje strategię utrzymania skoncentrowaną na starzeniu się oprogramowania. Strategia ta wykorzystuje konserwację korekcyjną, gdy zmiany kodu są możliwe, oraz strategie zapobiegawcze, gdy zmiany mogą powodować przestoje systemu, co zmniejsza liczbę awarii usług. Andrew i in.32 badają równoległe testowanie mutacji, proces, w którym klasy są wielokrotnie mutowane, testowane i ponownie ładowane, aż wszystkie warianty zostaną ocenione. Dunn i in.33 proponują metryki podatności bezpieczeństwa, które przydzielają wagi komponentom, podkreślając znaczenie dokładnego testowania. Na koniec Huo i in.34 używają sekwencyjnego indeksu zbiorów do wyszukiwania lokalizacji defektów i potwierdzania problemów. Pokazuje to, że przyczyny źródłowe często są powiązane z większością nieudanych przypadków testowych w aplikacjach programowych.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Architektura systemu i podsumowanie prototypu:
Niniejsza praca przedstawia ulepszony i adaptacyjny prototyp systemu PreventativeTestPro, który egzemplifikuje proaktywne podejście do inżynierii jakości, wykorzystujące dane z obserwowalności oraz duże modele językowe (LLM) w celu dalszej poprawy procesu rozwiązywania zgłoszeń problemów technicznych. System ma na celu rozwiązanie współczesnych problemów związanych z dostarczaniem oprogramowania poprzez automatyzację wykrywania anomalii, analizę przyczyn źródłowych oraz inteligentne opracowywanie i wykonywanie przypadków testowych dla obszarów nieobjętych pokryciem, z wykorzystaniem syntetycznego monitorowania, danych z obserwowalności oraz integracji z GenAI. Architektura jest modułowa i składa się z trzech głównych komponentów: Kolektora i Analizatora Danych Obserwowalności, Warstwy Inteligencji opartej na GenAI oraz Silnika Orkiestracji i Wykonywania Testów, co zostało szczegółowo określone na Rysunku 1.
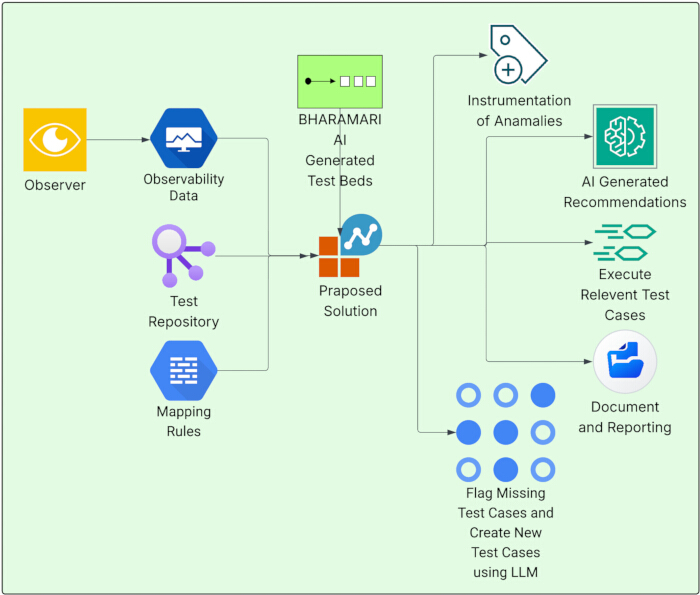
Rycina 1Wejście-wyjście proponowanego systemu. Dane dotyczące obserwowalności, wraz z wynikami obserwatora, repozytorium testów i reguł mapowania, są dostarczane jako dane wejściowe wraz z platformami testowymi BHRAMARI, które konstruują sterowane przez AI środowiska testowe w celu zwiększenia odporności przypadków testowych. Proponowany system generuje instrumentację anomalii, rekomendacje generowane przez AI, wykonanie odpowiednich przypadków testowych, dokumentację i raportowanie, a także identyfikację i tworzenie brakujących przypadków testowych. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Rysunek 2 przedstawia architekturę proponowanego podejścia. Rysunek ilustruje wejście, przetwarzanie i wyjście systemu. Stanowi on również kompleksowy opis systemu, który został następnie przełożony na wyjaśnienie w celu lepszego zrozumienia podstawowych funkcji.
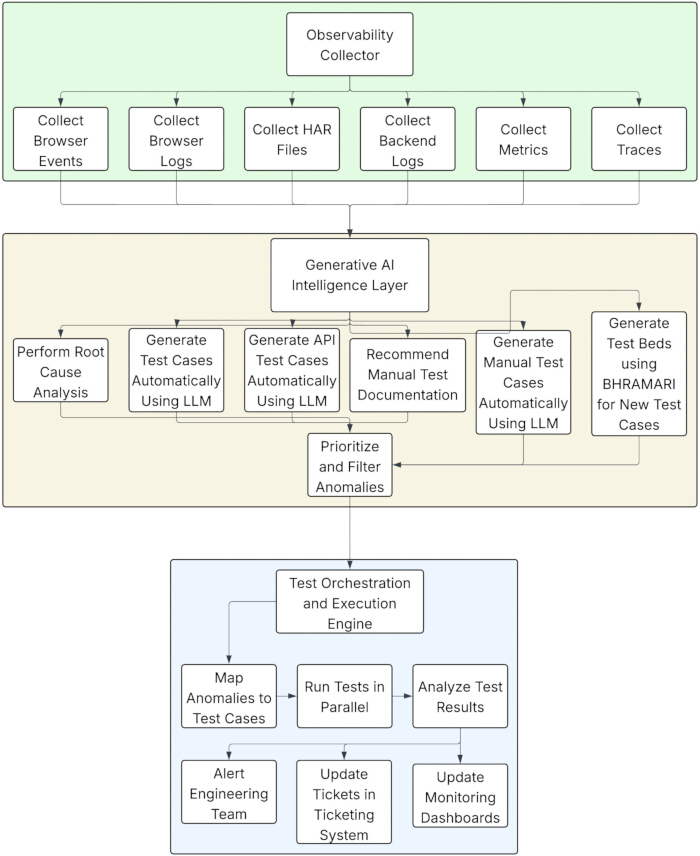
Rysunek 2Architektura proponowanego systemu z kolektorem i analizatorem danych obserwowalności, warstwą inteligencji opartą na GenAI oraz silnikiem orkiestracji i wykonywania testów. Rysunek ten przedstawia wewnętrzną architekturę systemu PreventativeTestPro, podzieloną na trzy warstwy: Warstwa Kolektora Obserwowalności (Observability Collector Layer) agreguje dane z wielu źródeł, w tym zdarzenia przeglądarki, logi, pliki HAR, logi backendowe, metryki oraz ślady. Warstwa Inteligencji Generatywnej AI (Generative AI Intelligence Layer) wykorzystuje te dane do przeprowadzania analizy przyczyn źródłowych, priorytetyzowania anomalii oraz autonomicznego tworzenia przypadków testowych (UI, API, manualnych) i dokumentacji przy użyciu modeli LLM. Moduł BHARAMARI ustanawia również nowe środowiska testowe. Silnik Orkiestracji i Wykonywania Testów (Test Orchestration and Execution Engine) przypisuje rozbieżności do przypadków testowych, wykonuje testy równolegle, ocenia wyniki i informuje zespoły inżynieryjne, systemy zgłoszeniowe oraz pulpity nawigacyjne w celu nadzoru w czasie rzeczywistym i monitorowania rozwiązywania problemów. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Moduł kolektora i analizatora danych obserwowalności pełni funkcję systemu sensorycznego platformy, w sposób ciągły gromadząc na dużą skalę wieloaspektowe dane dotyczące ocenianej aplikacji. W przypadku monitorowania frontendu wdrażane są syntetyczne agenty monitorujące, które śledzą zdarzenia po stronie przeglądarki, takie jak struktury Document Object Model (DOM), akcje użytkownika (np. kliknięcia, najechania kursorem i wprowadzanie danych) oraz pliki HAR rejestrujące informacje o żądaniach i odpowiedziach sieciowych oraz API. W celu zwiększenia możliwości przeglądarek, w systemie OBSERVER zaimplementowano również rozwiązanie PreventativeTestPro. Monitorowanie backendu koncentruje się na analizie logów, w ramach której żądane i przetwarzane są informacje o obserwowalności po stronie serwera, obejmujące logi aplikacji, komunikaty błędów, informacje i debugowanie, logi wyjątków i ślady stosu (stack trace), metryki wydajności, takie jak czasy odpowiedzi, a także śledzenie (tracing) z wykorzystaniem technologii takich jak OpenTelemetry lub New Relic. System współpracuje z agentami syntetycznymi symulującymi ruch i interakcje użytkowników, a kolektory logów kondensują przychodzące dane w czasie rzeczywistym. Zebrane dane są następnie normalizowane do formatów strukturalnych i przekazywane do innych jednostek przetwarzających w celu dalszej analizy.
Istotą PreventativeTestPro jest warstwa inteligencji oparta na GenAI, która wykorzystuje duże modele językowe (LLM), takie jak GPT, do odczytywania i analizowania danych z obserwowalności oraz kontekstualizacji i generowania odpowiedzi. Moduł ten przeprowadza analizę przyczyn źródłowych (root cause analysis): proces interpretacji logów i śladów przyczyn źródłowych w celu wyjaśnienia błędów technicznych w zrozumiały sposób, na przykład wskazując NullPointerException w konkretnej linii kodu oraz przypuszczalną przyczynę problemu, taką jak nie zainicjowana zmienna. W zakresie generowania przypadków testowych system wykorzystuje autotesty tworzone poprzez konwersję wzorców wyjątków lub sekwencji zdarzeń na wykonywalne skrypty testowe, np. testy Selenium lub API, a także generuje zrozumiałe dla człowieka procedury testowe, które może przeprowadzić personel zapewnienia jakości (QA). Testy API ewoluowały poprzez transformację logów HAR i śladów w sekwencje żądań API z oczekiwanymi asercjami, a wszystkie wygenerowane przypadki testowe są dodatkowo wzbogacane o efektywne środowiska testowe dzięki integracji z BHRAMARI. System rekomendacji sugeruje dalsze ulepszenia, zwiększenie pokrycia testami oraz możliwości integracji z CI/CD, w zależności od analizowanego zachowania systemu. Silnik AI wykorzystuje strukturalne dane z obserwowalności za pomocą inżynierii promptów (prompt engineering) i wzbogacania kontekstu, aby przedstawić kontekst logów przy użyciu szablonów promptów przekazujących ustrukturyzowane zapytania do modelu LLM, a ostatecznie generuje wyniki w formie funkcjonalnej, takiej jak fragmenty kodu, specyfikacje przypadków testowych i dokumentacja w języku naturalnym.
Moduł silnika orchestracji i wykonywania testów zarządza priorytetami, harmonogramowaniem i wykonywaniem testów, umożliwiając zautomatyzowaną walidację w oparciu o szczegóły pokrycia zmian w kodzie, tagi oraz mapowanie anomalii. Mapowanie i wybór testu polega na powiązaniu anomalii w mapach lub wzorcach instrumentacji ze znanymi przypadkami testowymi za pomocą silnika reguł mapowania, a następnie uruchomieniu przypadków testowych zgodnie z ustalonym mapowaniem. Funkcje równoległego wykonywania testów pozwalają na jednoczesne uruchamianie wielu rodzajów testów, takich jak testy funkcjonalne, wydajnościowe lub bezpieczeństwa w różnych środowiskach, oraz koordynację wykorzystania Selenium, JMeter i ZAP jako instrumentów w potokach automatyzacji. Implementacja pętli sprzężenia zwrotnego zapewnia rejestrowanie wyników wykonania, a w przypadku niepowodzenia testu – przekazywanie informacji o zmianach do systemów wsparcia, w tym Jira i Azure DevOps, w celu ich śledzenia i rozwiązania.
Hipoteza:
H1 (Efektywność operacyjna): Postuluje się, że połączenie danych z obserwowalności i inteligencji opartej na AI poprawi wskaźniki operacyjne, w szczególności poprzez skrócenie średniego czasu rozwiązania problemu (H1a), średniego czasu analizy (H1b), średniego czasu wykrywania problemów produkcyjnych (H1c) oraz średniego czasu wdrażania poprawek na produkcji (H1d). Zmiany te powinny ułatwić spełnienie wymogów umowy o poziomie usług (SLA) (H1e) poprzez przyspieszenie wykrywania, analizy i wdrażania, przy jednoczesnym zminimalizowaniu czasu przestoju systemu.
H2 (Badanie skuteczności): Przyjmuje się również, że skuteczność testowania oprogramowania wzrośnie wraz z szerszym zakresem testów (H2a), równoległym uruchamianiem przypadków testowych (H2b) oraz inteligentną priorytetyzacją testów (H2c). Oczekuje się również, że rekomendacje generowane przez AI (H2d) pomogą zarówno w procesach testowania, jak i w przepływach operacyjnych. Pozwoli to na szybsze wykrywanie błędów, przyspieszenie pętli zwrotnych oraz wsparcie praktyk zapewniania jakości o charakterze prewencyjnym i długofalowym.
Zakres i odbiorcy:
Ten prototyp przedstawia ogólny projekt systemu, główną koncepcję oraz instrukcję krok po kroku dotyczącą konfiguracji i uruchamiania frameworka PreventativeTestPro. Szczegółowo opisano w nim również sposób przygotowania odpowiednich stanowisk testowych/danych wejściowych oraz podano wskazówki dotyczące rozwiązywania problemów. Treść jest skierowana do inżynierów jakości oprogramowania, którzy znają podstawy języka Java i chcą dowiedzieć się, jak wykorzystać testowanie zapobiegawcze (preventative testing) w celu zwiększenia niezawodności i wydajności oprogramowania.
Konfiguracja środowiska:
Plik uzupełniający 1 zawiera szczegółowy opis krok po kroku oraz program wymagany do komunikacji z PreventativeTestPro. Obejmuje on instrukcje instalacji niezbędnego środowiska, sposób uruchamiania i zatrzymywania usług narzędzia oraz jasne wyjaśnienie podstawowego zastosowania narzędzia. Aby uzyskać bardziej szczegółową dokumentację, wraz z instrukcjami dotyczącymi korzystania z zaawansowanych narzędzi, instrukcjami konfiguracji i innymi szczegółami organizacyjnymi, należy zapoznać się z oficjalnymi źródłami GitHub dedykowanymi projektowi: konkretną stroną Wiki pod adresem https://github.com/sohambpatel/PreventativeTests/wiki oraz głównym plikiem README pod adresem https://github.com/sohambpatel/PreventativeTests?tab=readme-ov-file/readme.
Przykładowe dane wejściowe:
Przykładowe pliki wejściowe znajdują się w repozytorium GitHub: https://github.com/sohambpatel/PreventativeTests/tree/main/preventativetestframework/Inputs. Framework może natychmiast uruchomić predefiniowane przypadki testowe i zestawy danych z tych plików. Służą one jako dane wejściowe referencyjne do weryfikacji konfiguracji środowiska oraz w celu uzyskania wyników opisanych w niniejszym protokole.
Przykładowe wyniki:
Repozytorium GitHub (https://github.com/sohambpatel/PreventativeTests/tree/main/preventativetestframework/SampleOutputs) zawiera konkretne przykłady danych wyjściowych z ram testów zapobiegawczych w formacie surowym. Dzięki tym plikom użytkownicy mogą bezpośrednio zapoznać się z układem i szczegółami wygenerowanych raportów oraz metryk, co obrazuje wyniki osiągnięte przez narzędzie podczas jego pracy. Niniejszy przewodnik jest istotny dla zrozumienia potoku danych i potwierdzenia oczekiwanego zachowania ram podczas odtwarzania procesu eksperymentalnego.
Prototyp wykonania:
Niniejsza sekcja zawiera szczegółowy przewodnik krok po kroku dotyczący korzystania z frameworka PreventativeTestPro. Aby pomóc użytkownikom w odtworzeniu przepływu pracy, każdy etap został opisany w odpowiedniej kolejności. W tej sekcji kroki wykonawcze przedstawiono w ustrukturyzowanej formie, aby ułatwić reprodukcję wyników, wskazać kluczowe punkty kontrolne oraz zapewnić spójne stosowanie frameworka PreventativeTestPro w różnych warunkach eksperymentalnych lub operacyjnych.
Na tym etapie można użyć interfejsu graficznego PreventativeTestPro GUI do wyboru optymalnego przepływu pracy dla testów zapobiegawczych. Rysunek 3 przedstawia pięć opcji, z których każda odpowiada innemu etapowi procesu testowania: uruchamianiu testów równolegle, tworzeniu zestawu testów na podstawie wyników monitorowania poprzez priorytetyzację istniejących przypadków testowych, tworzeniu manualnych przypadków testowych, tworzeniu zautomatyzowanych przypadków testowych oraz znajdowaniu przyczyny źródłowej. Po dokonaniu wyboru przez użytkownika uruchamiany jest wyznaczony przepływ pracy. Następnie w późniejszych etapach można dodać dodatkowe tryby (takie jak generowanie przypadków testowych oparte na AI lub analiza przyczyn źródłowych). Ten dobrze zorganizowany interfejs umożliwia przeprowadzanie badań testów zapobiegawczych, które mogą być powtarzalne i dzielone na mniejsze części.
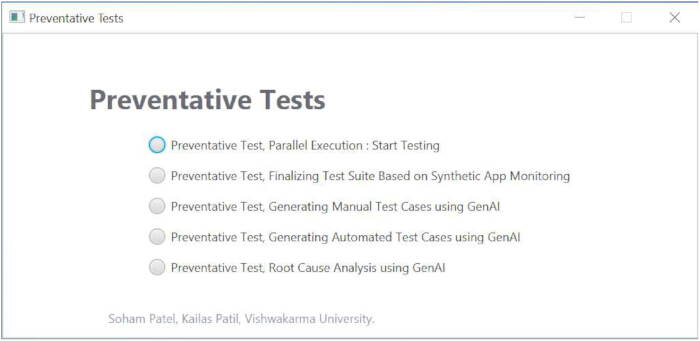
Rysunek 3Interfejs użytkownika 1 systemu. Rysunek ten przedstawia interfejs użytkownika PreventativeTestPro, który umożliwia wybór jednej z pięciu różnych metod przeprowadzania testów zapobiegawczych: 1. Test zapobiegawczy, równoległe wykonanie: rozpocznij testowanie, 2. Test zapobiegawczy, finalizacja zestawu testowego na podstawie monitorowania syntetycznego aplikacji, 3. Test zapobiegawczy, generowanie ręcznych przypadków testowych przy użyciu GenAI, 4. Test zapobiegawczy, generowanie zautomatyzowanych przypadków testowych przy użyciu GenAI, 5. Test zapobiegawczy, analiza przyczyn źródłowych przy użyciu GenAI. W danej chwili można wybrać tylko jedną opcję. Modułowa konstrukcja ułatwia przeprowadzanie testów zapobiegawczych oraz wprowadza tworzenie testów i diagnostykę opartą na sztucznej inteligencji. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Rysunek 4 przedstawia interfejs równoległego wykonywania (Parallel Execution) frameworka. Na tym etapie użytkownik wprowadza adres URL aplikacji, którą chce przetestować, oraz pełną ścieżkę do pliku właściwości zawierającego ustawienia konfiguracji. Po wprowadzeniu danych użytkownik może rozpocząć jednoczesne uruchamianie testów, klikając przycisk Start Testing, który monitoruje również testowaną witrynę i generuje logi bezpieczeństwa, wydajności, konsoli oraz JavaScript. Trwające wykonywanie można zatrzymać, klikając przycisk Stop Testing. Przycisk Get Recommendation umożliwia uzyskanie opartych na AI wniosków z zapisanych logów. Taka konstrukcja zapewnia jednoczesne uruchomienie wielu kategorii testów (funkcjonalnych, wydajnościowych i bezpieczeństwa), co ułatwia szybsze wykrywanie problemów.
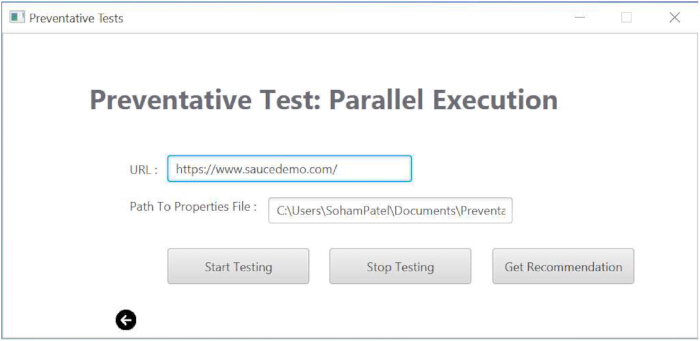
Rycina 4Interfejs użytkownika 2 systemu. Rysunek ten przedstawia tryb równoległego wykonywania (Parallel Execution) frameworka PreventativeTestPro. Użytkownik określa adres URL docelowej aplikacji oraz ścieżkę do pliku właściwości zawierającego szczegóły konfiguracji. Dostępne opcje obejmują Start Testing (w celu równoległego uruchomienia testów funkcjonalnych, bezpieczeństwa i wydajności oraz zarejestrowania logów), Stop Testing (w celu zatrzymania wykonywania) oraz Get Recommendation (w celu uzyskania analiz opartych na sztucznej inteligencji na podstawie logów i metryk). Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Rysunek 5 przedstawia interfejs Finalizacji Testów w oparciu o Monitorowanie w ramach frameworka PreventativeTestPro. Na tym etapie użytkownik określa ścieżkę do pliku wyjściowego monitorowania, zapytanie JSON path w celu pobrania węzłów błędów lub wyjątków oraz ścieżkę do repozytorium testów, aby zapisać utworzone przypadki. Po ustawieniu danych wejściowych użytkownik może najpierw pobrać nazwy klasy i metody z nimi powiązane, a następnie posortować przypadki testowe pobrane z testów na podstawie znalezionych klas i metod. Ten krok priorytetyzacji pokazuje, jak wykorzystać dane z monitorowania do efektywnego rankingowania przypadków testowych.
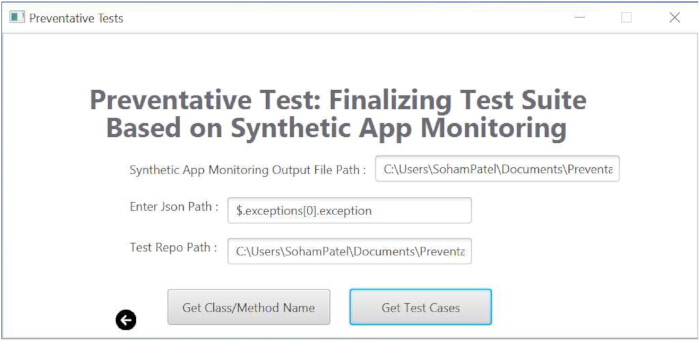
Rysunek 5Interfejs użytkownika 3 systemu. Rysunek ten przedstawia sposób priorytetyzacji zestawu testów w frameworku PreventativeTestPro z wykorzystaniem wyników monitorowania syntetycznego. Użytkownik wprowadza ścieżkę do pliku z wynikami monitorowania, ścieżkę JSON służącą do pobierania wyjątków/błędów oraz ścieżkę do repozytorium testów (offline). Opcje „Get Class/Method Name” i „Get Test Cases” mogą zostać wykorzystane do przekształcenia anomalii mapowania w przypadki testowe gotowe do uruchomienia. Zapewnia to uwzględnienie problemów występujących w czasie wykonania w procesie testowania. Aby wyświetlić powiększoną wersję tej ilustracji, kliknij tutaj.
Rysunek 6 przedstawia interfejs ręcznego generowania przypadków testowych w programie PreventativeTestPro. Na tym etapie użytkownik wskazuje programowi lokalizację pliku ze śladem stosu (stack trace) wykazującego anomalię, podając bezwzględną ścieżkę do pliku śladu stosu oraz ścieżkę do pliku właściwości konfiguracji. Po ustawieniu danych wejściowych można uruchomić opcję Generuj przypadki testowe, która przekształci anomalię w ustrukturyzowane, ręczne przypadki testowe. Zapewnia to, że błędy czasu wykonania, które wystąpiły w przeszłości, są zawsze uwzględniane w procesie testowania. Framework ułatwia tworzenie przypadków testowych poprzez automatyzację tego procesu. Pozwala to ograniczyć pracę ręczną, zwiększyć pokrycie testami oraz poprawić niezawodność testów, zapobiegając ponownemu wystąpieniu tego samego problemu. Krok ten stanowi bardzo ważny łącznik między wykrywaniem problemów a zapewnieniem wysokiej jakości przed ich wystąpieniem.
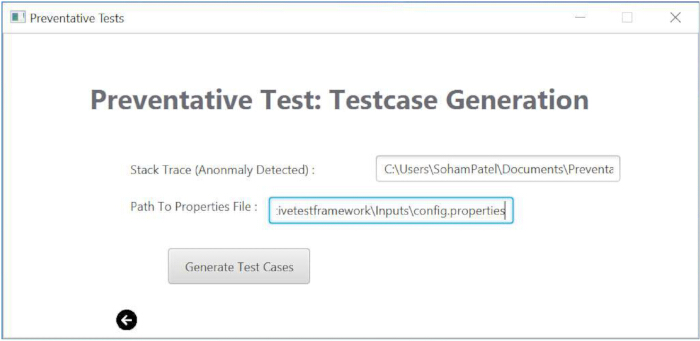
Rycina 6interfejs użytkownika 3 systemu. Rysunek przedstawia interfejs generowania przypadków testowych programu PreventativeTestPro. Narzędzie to przekształca ślady stosu (stack traces) anomalii w manualne przypadki testowe w formacie Behavior Driven Development (BDD), które mogą zostać wykorzystane w dalszych pracach. Użytkownik podaje ścieżki do pliku ze śladem stosu oraz pliku właściwości, a następnie klika przycisk „Generate Test Cases”, aby automatycznie utworzyć przypadki odpowiadające wykrytemu błędowi. Zapewnia to, że problemy występujące podczas działania programu są zawsze przekształcane w powtarzalne testy regresyjne. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Rysunek 7 przedstawia interfejs automatycznego generowania przypadków testowych w systemie PreventativeTestPro. Na tym etapie użytkownik podaje bezwzględną ścieżkę do pliku wyjściowego JSON z danymi obserwowalności oraz ścieżkę do pliku konfiguracyjnego właściwości. Po kliknięciu przycisku Generate Automated Test Cases system przetwarza dane z monitorowania i tworzy przypadki testowe, które można uruchomić, aby odtworzyć zaobserwowane problemy.
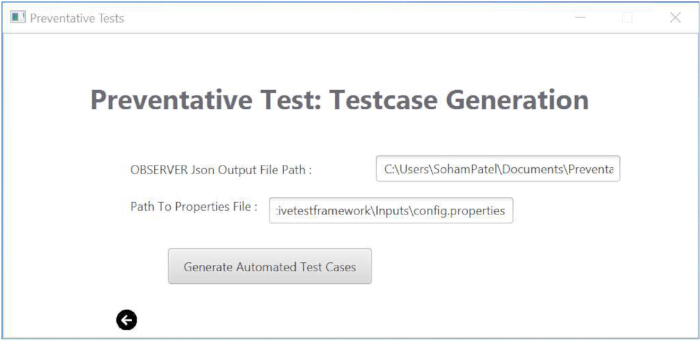
Rycina 7Interfejs użytkownika 4 systemu. Rysunek przedstawia interfejs automatycznego generowania przypadków testowych narzędzia PreventativeTestPro, które tworzy testy możliwe do uruchomienia w oparciu o dane obserwowalności (observability data). Użytkownik podaje ścieżkę do pliku właściwości oraz pliku wyjściowego JSON z danymi obserwowalności. Następnie klika przycisk „Generate Automated Test Cases”, aby stworzyć skrypty możliwe do uruchomienia (w formacie Selenium i TestNG). Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
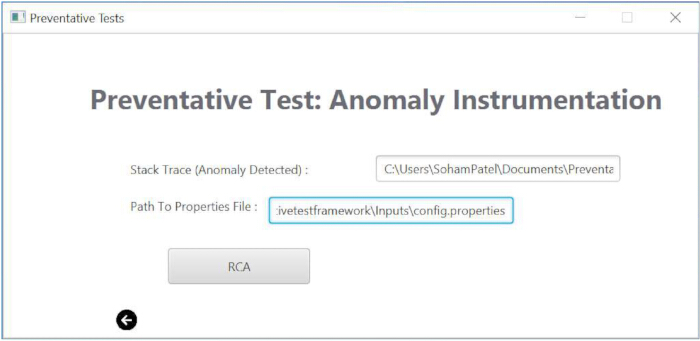
Rycina 8Interfejs użytkownika 5 systemu. Rysunek przedstawia interfejs instrumentacji anomalii programu PreventativeTestPro służący do analizy przyczyn źródłowych (RCA). Użytkownik podaje ścieżkę do pliku właściwości oraz pliku śladu stosu, a następnie wybiera opcję RCA, aby rozpocząć analizę opartą na sztucznej inteligencji. Krok ten przekształca wykryte anomalie w ustrukturyzowane wnioski diagnostyczne, co zapewnia możliwość naprawy błędów w sposób powtarzalny i specyficzny dla danego problemu. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Rozwiązywanie problemów:
Tabela 1 przedstawia najważniejsze punkty dotyczące rozwiązywania problemów, które dotyczą wyłącznie kodu aplikacji. Punkty te stanowią szybki sposób na przypomnienie sobie, jak naprawiać błędy na poziomie kodu, które pojawiają się podczas uruchamiania frameworka PreventativeTestPro. Dokumentacja projektu zawiera więcej informacji i instrukcje krok po kroku dla czytelników, którzy potrzebują dodatkowej pomocy w rozwiązywaniu problemów wpływających na ogólną funkcjonalność aplikacji. Pełny zasób jest dostępny pod linkiem: https://github.com/sohambpatel/PreventativeTests/wiki/How-to-use%3F. Ta dodatkowa referencja zapewnia, że użytkownicy nie tylko naprawiają błędy w kodzie, ale także uczą się, jak diagnozować funkcje, co umożliwia im bardziej efektywne korzystanie z frameworka.
| Zachowanie w przypadku błędów | Przyczyna źródłowa | Jak naprawić? |
| Aplikacja nie uruchamia się | Ścieżka Java nie została ustawiona | W zmiennej środowiskowej ustaw JAVA_HOME |
| Błąd uruchamiania serwera | Port 8080/9090 jest używany (w szczególności podczas korzystania z Docker) | Aktualizacja mapowania portów w Dockerze |
| Treść GenAI jest pusta | Token mógł wygasnąć | Wygeneruj token i zaktualizuj plik config.properties przed podaniem go jako dane wejściowe |
| Instancja przeglądarki wygenerowana przez framework nie łączy się z siecią | Serwer ZAP nie działa lub dane uwierzytelniające ZAP są nieprawidłowe | Włącz ZAP przed uruchomieniem aplikacji; w przypadku, gdy aplikacja jest uruchomiona, a problem nadal występuje, zaktualizuj dane uwierzytelniające ZAP w pliku config.properties przed przekazaniem go jako danych wejściowych. |
Tabela 1: Typowe proponowane błędy systemowe i szybkie rozwiązania. W tabeli przedstawiono typowe błędy specyficzne dla danej aplikacji, sposoby rozwiązywania problemów oraz szybkie poprawki, które można zastosować w celu wyeliminowania tych problemów.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
W pierwszej kolejności udostępniliśmy w czasie rzeczywistym wyniki uzyskane z analiz przypadków przeprowadzonych we współpracy z różnymi przedsiębiorstwami. Ponadto przedstawiliśmy wyniki otrzymane od testerów beta, którzy korzystali z tej struktury i algorytmu, wraz z końcowymi spostrzeżeniami dotyczącymi potencjalnych zagrożeń dla ważności wyników.
Wyniki studium przypadku z przemysłu:
W oparciu o nasze badania, które koncentrują się na zastosowan...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Badania te prezentują PreventativeTestPro, kompleksową platformę testową i obserwacyjną, która integruje syntetyczne monitorowanie, dane obserwowalności oraz automatyzację opartą na generatywnej sztucznej inteligencji w celu poprawy zapewnienia jakości oprogramowania. System składa się z trzech podstawowych modułów: zbieracza i analizatora danych obserwowalności, generatywnej warstwy inteligencji opartej na AI oraz silnika orkiestracji i wykonywania testów. Łącznie te komponenty tworzą pętlę zwrotną, w której zachowania ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy deklarują, że nie mają znanych konkurujących ze sobą interesów finansowych ani relacji osobistych, które mogłyby wpłynąć na prace opisane w tym artykule. Potwierdzamy, że Gemini był stosowany jedynie w kontekście dopracowywania gramatyki i przeformułowywania zdań, aby były łatwiejsze do czytania. Aby być poprawnym i etycznie słusznym, autorzy starannie zrewidowali wszystkie zmiany sugerowane przez AI, aby zachować pierwotne naukowe konotacje.
Podziękowania
Autor wyraża wdzięczność za znaczące wsparcie i współpracę udzieloną przez następujące organizacje podczas tych badań. Wspólne eksperymentalne studia przypadków z tymi firmami były kluczowe dla potwierdzenia proponowanego narzędzia i metody. Wdzięczność składana jest GazonTech, Lopa Engineering, Afour Technologies, QJ Technologies oraz SecureLayer7 za udostępnienie praktycznego otoczenia, technicznych wskazówek i cennych informacji podczas fazy eksperymentalnej. Ich aktywne zaangażowanie znacznie zwiększyło praktyczne znaczenie i użyteczność wyników badań. Autor wyraża głęboką wdzięczność za gotowość do udziału w badaniach naukowych oraz za zaangażowanie w innowacje i ciągły rozwój w dziedzinach inżynierii oprogramowania i cyberbezpieczeństwa.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Apache Maven | Fundacja Oprogramowania Apache | 3.9.6 | Narzędzie do zarządzania zależnościami i projektami dla projektów Java |
| ChatGPT (GPT-3.5 Turbo API) | OpenAI | https://platform.openai.com/api-keys | Do generowania rekomendacji testowych opartych na AI na podstawie logów, generowania ręcznych przypadków testowych, generowania zautomatyzowanych przypadków testowych oraz analizy przyczyn podstawowych |
| Komputer (maszyna rozwojowa/testowa) | Standardowy komputer stacjonarny/laptop | - | Używany do tworzenia, wykonywania i testowania PreventativeTestPro |
| Miejsce na dysku | - | - | Zalecane jest co najmniej 10 GB wolnej przestrzeni na dysku na logi, raporty i artefakty testowe |
| Docker | Docker Inc. | 27 (https://docs.docker.com/desktop/setup/install/windows-install/) | Wykorzystywane do konteneryzacji w celu zapewnienia powtarzalności w różnych środowiskach |
| Git | Git SCM | git version 2.45.2.windows.1 | System kontroli wersji używany do tworzenia i współpracy |
| Repozytorium GitHub | GitHub | https://github.com/sohambpatel/PreventativeTests | Publiczne repozytorium zawierające kod źródłowy, dokumentację, zbiory danych i przykłady |
| Google Chrome | 140.0.7339.128 | Główna przeglądarka używana do syntetycznego monitorowania i testowania | |
| Java | Oracle / OpenJDK | 21.0.2 | Wykorzystywane do tworzenia oprogramowania i wdrażania PreventativeTestPro |
| System operacyjny | Niezależna platforma | - | Narzędzie działa na dowolnym systemie operacyjnym z zainstalowanymi Java i Maven (Windows, Linux, macOS) |
| OWASP ZAP | Fundacja OWASP | 2.14.0 | Narzędzie do skanowania i wykrywania luk bezpieczeństwa |
| Procesor | - | - | Intel i5 lub nowszy (lub równoważny) zalecany do wykonywania równoległego i przetwarzania AI |
| RAM | - | - | Minimalne 8 GB RAM zalecane do przeprowadzania testów i monitorowania w przeglądarce |
Bibliografia
- A novel approach to multiple criteria based test case prioritization. Abid, R., Nadeem, A. 2017 13th International Conference on Emerging Technologies (ICET), Islamabad, Pakistan, , (2017).
- Khatibsyarbini, M., Isa, M. A., Jawawi, D. N., Tumeng, R. Test case prioritization approaches in regression testing: A systematic literature review. Inf Softw Technol. 93, 74-93 (2017).
- Enhanced weighted method for test case prioritization in regression testing using unique priority value. Ammar, A., Baharom, S., Ghani, A. A. A., Din, J. 2016 International Conference on Information Science and Security (ICISS), Pattaya, Thailand, , (1109).
- Using artificial bee colony for code coverage based test suite prioritization. Konsaard, P., Ramingwong, L. 2015 2nd International Conference on Information Science and Security (ICISS), Seoul, Korea, 10, Forthcoming.
- Rosero, R. H., Gómez, O. S., Rodríguez, G. Regression testing of database applications under an incremental software development setting. IEEE Access. 5, 18419-18428 (2017).
- Customer Service Expectations 2018. , Gladly. Available at: https://www.gladly.com/blog/2018-customer-service-expectations-survey/ (2018).
- Must-Know Customer Service Statistics. , Khoros. Available at: https://khoros.com/blog/must-know-customer-service-statistics (2025).
- State of the Connected Customer, 4th Ed. , Salesforce. Available at: https://c1.sfdcstatic.com/content/dam/web/en_us/www/documents/research/salesforce-state-of-the-connected-customer-4th-ed.pdf (2025).
- Customer Acquisition Study. , HubSpot. Available at: https://blog.hubspot.com/service/customer-acquisition-study (2025).
- IT Ticket Handling Best Practices. , Ivanti. Available at: https://www.ivanti.com/blog/it-ticket-handling-best-practices (2025).
- Patel, S., Patil, K., Chumchu, P. Quantitative data set on test prioritization and preventative tests. Mendeley Data. V2, (2023).
- State of Software Quality Report 2024. , Katalon. Available at: https://katalon.info/hubfs/download-content/ebook/State%20of%20Software%20Quality%20Report%202024.pdf (2025).
- Patel, S., Patil, K., Chumchu, P. OBSERVER: Observing Browser Synthetic Environments for Robotization, Verification, Efficiency, and Resilience. Softw Impacts. 24, 100752(2025).
- Patel, S., Patil, K., Chumchu, P. Comparative analysis of software solutions for preventative testing and test prioritization. Mendeley Data. V2, (2024).
- Intro to Synthetic Monitoring . , New Relic. Available at: https://docs.newrelic.com/docs/synthetics/synthetic-monitoring/using-monitors/intro-synthetic-monitoring (2025).
- Observability Glossary. , SolarWinds. Available at: https://www.solarwinds.com/resources/it-glossary/observability (2025).
- Patel, S., Patil, K., Chumchu, P. BHRAMARI: Bug driven highly reusable automated model for automated test bed generation and integration. Softw Impacts. 21, 100687(2024).
- Failure identification from unstable log data using deep learning. Bogatinovski, J., Nedelkoski, S., Wu, L., Cardoso, J., Kao, O. 2022 22nd IEEE International Symposium on Cluster, Cloud and Internet Computing (CCGrid), Taormina, Italy, , (2022).
- Creating test cases for testing software using anonymized log data. U.S. Patent. , US11709764B2. USPTO (2023).
- Towards test architecture based software product line testing. Lee, J., Kang, S. 2014 IEEE 38th Annual Computer Software and Applications Conference (COMPSAC), Vasteras, Sweden, , (2014).
- QEX: Automated testing observability and QA developer experience framework. Locke, H. L., Ting Keshia, Y. K., Yu, J. C. K., Chua, H. Y. 2023 IEEE Conference on Software Testing, Verification and Validation (ICST), Dublin, Ireland, , (1109).
- Intelligent testing in software industry. Lal, A., Kumar, G. 2021 12th International Conference on Computing Communication and Networking Technologies (ICCCNT), Kharagpur, India, , (2021).
- Instrumenting contracts with aspect-oriented programming to increase observability and support debugging. Briand, L. C., Dzidek, W. J., Labiche, Y. 2005 21st IEEE International Conference on Software Maintenance (ICSM), Budapest, Hungary, , (1109).
- An empirical analysis of blind tests. Baral, K., Offutt, J. 2020 IEEE 13th International Conference on Software Testing, Validation and Verification (ICST), Porto, Portugal, , (1109).
- Rott, J. Test intelligence: How modern analyses and visualizations in Teamscale support software testing. 2022 1st International Workshop on Visualization in Testing of Hardware, Software, and Manufacturing (TestVis), Oklahoma City, OK, USA, , (2022).
- Collins, E. F., de Lucena, V. F. Software test automation practices in agile development environment: An industry experience report. 2012 7th International Workshop on Automation of Software Test (AST), Zurich, Switzerland, , (2012).
- BugSwarm: Mining and continuously growing a dataset of reproducible failures and fixes. Tomassi, D. A., Dmeiri, N., Wang, Y., Bhowmick, A., Liu, Y. C., Devan, P. T. 2019 IEEE/ACM International Conference on Software Engineering (ICSE), Montreal, Canada, , (2019).
- Towards combining functional requirements tests and unit tests as a preventive practice against software defects. Dudila, R., Letia, I. A. 2013 International Conference on Control Systems and Computer Science (ICCP), Sinaia, Romania, , (2013).
- Fushihara, Y., Aman, H., Amasaki, S., Yokogawa, T., Kawahara, M. A trend analysis of test smells in Python test code over commit history. 2023 49th Euromicro Conference on Software Engineering and Advanced Applications (SEAA), Durres, Albania, , (2023).
- SUPERNOVA: Automating test selection and defect prevention in AAA video games using risk-based testing and machine learning. Senchenko, A., Patterson, N., Samuel, H., Ispir, D. 2022 IEEE Conference on Software Testing, Verification and Validation (ICST), Valencia, Spain, , (2022).
- A software maintenance methodology: An approach applied to software aging. Araujo, J., Melo, C., Oliveira, F., Pereira, P., Matos, R. 2021 IEEE International Systems Conference (SysCon), Vancouver, BC, Canada, , Forthcoming.
- Mutual Automobile Insurance Company. Mutation Testing in Parallel Threads. U.S. Patent. , US11163675B1. USPTO (2021).
- Machine learning-based decision-making for autonomous systems communication. U.S. Patent. , US11366748B1. USPTO (2022).
- Use sequential set index for root cause location and problem detection. U.S. Patent. Huo, Z. P., et al. , US11645142B1. USPTO (2023).
- Selenium WebDriver. , Selenium. https://www.selenium.dev (2025).
- The Katalon Platform. , Katalon. Available from: https://katalon.com (2025).
- Apache JMeter. , Apache Software Foundation. Available from: https://jmeter.apache.org (2024).
- OWASP ZAP (Zed Attack Proxy). , OWASP Foundation. Available from: https://www.zaproxy.org/ (2025).
- Xray by Xpand IT. Xray - Test Management for Jira. , Xray. Available from: https://www.getxray.app (2025).
- Tricentis Copilot. , Tricentis. Available from: https://www.tricentis.com/products/copilot/ (2025).
- SmartQ Tech Products. , SmartQ Technologies. Available from: https://www.thesmartq.com/smartq-tech-products/ (2025).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.