Obecne badanie opisuje przepływ pracy dla sekwencjonowania nanoporami plazmidów, gdy sekwencja chromosomowa jest już znana lub nie jest istotna. Początkowy krok wzbogacania DNA plazmidowego zapewnia optymalną głębokość sekwencji plazmidu i maksymalizuje liczbę próbek, które mogą być sekwencjonowane na jednej komórce przepływowej.
Artykuł metodologiczny
Sekwencjonowanie i montaż długich plazmidów za pomocą przepływów opartych na sekwencjonowaniu Nanopore
* These authors contributed equally
W tym artykule
Podsumowanie
Streszczenie
Niniejsze badanie opisuje proces sekwencji nanopore przeznaczony do maksymalizacji wydajności DNA plazmidowego i dokładności sekwencjonowania. Badacze omawiają każdy krok procesu, który obejmuje ekstrakcję DNA plazmidowego, przygotowanie biblioteki z szybką kodowaniem kreskowym i ligowaniem adapterów, załadowanie biblioteki na komórkę przepływową do sekwencjonowania, wyznaczanie zasad (w czasie rzeczywistym lub pocztowy) oraz montaż sekwencji przy użyciu Autocycler. Autorzy określają również wymagania sprzętowe, które w dużej mierze zależą od tego, czy wyznaczanie zasad odbywa się w czasie rzeczywistym. Autorzy sekwencjonowali plazmidy oczyszczone z dziesięciu szczepów klinicznych przy użyciu tego procesu. Aby wyeliminować różnice pomiędzy szczepami komórek gospodarza jako zmienną, autorzy również sprzężyli te kliniczne szczepy ze wspólnym szczepem odbiorczym i sekwencjonowali transkonjugaty. Eksperymenty te wyprodukowały montaże plazmidowe, które pasują do wielkości plazmidów wywnioskowanych z mobilności w żelu i które, w 2/3 przypadków, pasują również do krótkich, wypolerowanych montaży czyli są w granicach 0,05% identyczności par sekwencji. Wzbogacanie sekwencji DNA plazmidowego maksymalizuje również wydajność sekwencjonowania plazmidów, pozwalając na równoległe sekwencjonowanie do 24 próbek przy optymalnym pokryciu. Ten protokół jest odpowiedni dla plazmidów o wielkości od 4 do 174 kb i toleruje do 72% zanieczyszczenia chromosomowego bez wpływu na dokładność. Ten protokół jest idealny w sytuacjach, gdy sekwencja chromosomowa jest już znana lub nie jest interesująca, na przykład dla weryfikacji sekwencji plazmidowych, poprawy dokładności plazmidowych sekwencji już uzyskanych przez WGS, lub sekwencjonowania plazmidów uchwyconych przez koniugację. Organizmem użytym do zilustrowania tej pracy jest Escherichia coli, który jest reprezentatywny dla gospodarzy stosowanych do rekombinowanej ekspresji genów i dla uchwycenia plazmidów przez koniugację.
Wprowadzenie
Plazmidy są samoreplikującymi się fragmentami DNA, powszechnie występującymi u bakterii. Ich wielkość jest bardzo zmienna, waha się od <800 bp do 2,5 Mbp, a zazwyczaj mają rozkład dwuizbowy, z mniejszym szczytem odpowiadającym wielokopianym, niekoniugacyjnym plazmidom i większym szczytem odpowiadającym plazmidom o niskiej kopii, często koniugacyjnych1,2. Plazmidy odgrywają kluczowa rolę w ekologii mikrobiologicznej, przenosząc geny, które pomagają ich gospodarzom przystosować się do wyzwań środowiskowych lub uzyskać dostęp do nowych nisz ekologicznych. Plazmidy służą również jako platformy dla przyspieszonej ewolucji, zapewniając zwiększoną plastyczność genetyczną i pośrednicząc w poziomym przenoszeniu genów między szczepami, gatunkami, rodzajami, a nawet rodzinami3,4. Analizy sieciowe i porównawcze genomów potwierdziły rolę środowiskowego rezystomatu jako trwałego rezerwuaru klinicznie istotnych genów odporności na antybiotyki (ARG), ułatwiając w ten sposób ich utrzymanie i rozprzestrzenianie się w różnych środowiskach ekologicznych5. Śledzenie plazmidów i ich zawartości, czyli genów odporności na antybiotyki i genów wirulencji, pomaga w identyfikacji ścieżek transmisji6. Dlatego identyfikacja i charakterystyka plazmidów jest bardzo istotna dla wielu zastosowań w zdrowiu publicznym, mikrobiologii klinicznej i biotechnologii.
Wprowadzenie technologii sekwencjonowania nowej generacji (NGS), które umożliwiają wysokowydajne sekwencjonowanie nieznanych szablonów DNA, otworzyło drogę do genomowej charakterystyki izolowanych mikrobów. Sekwencjonowanie całego genomu (WGS) umożliwia śledzenie pojawiania się, rozprzestrzeniania się i przenoszenia nowych patogenów, szczepów odpornych na leki i wariantów unikających szczepionek. Jest również coraz częściej wykorzystywane do pomocy w identyfikacji ścieżek transmisji podczas klinicznych wybuchów epidemii, potencjalnie informując o interwencjach w celu zapobiegania przyszłym wybuchom7. Wreszcie, WGS pozwala na profilowanie genów ARG, które mogą informować o decyzjach terapeutycznych8, chociaż łączenie ARG z jakościowymi i ilościowymi fenotypami odporności na antybiotyki jest nadal w trakcie realizacji9.
Jednak krótkie dane sekwencjonowania (SR), które są zazwyczaj produkowane przez WGS w skali, są ogólnie w zakresie 400–500 bp. Ta wielkość jest krótsza niż wielkość większości Mobilnych Elementów Genetycznych (MGEs) i dlatego nie może ich rozdzielić10. In silico identyfikacja sekwencji plazmidów w danych WGS jest dalsza skomplikowana przez niekompletne pokrycie i ze względu na wspólne sekwencje między plazmidami a także między bakteriami chromosomami i innymi plazmidami10. W konsekwencji, skomplikowane złożenia są często rozbite i niekompletne, co sprawia, że ich subgenomowa lokalizacja (chromosomalna lub plazmidowe) jest niemożliwa do przypisania10.
Technologia sekwencjonowania długich odczytów (LR) generuje bardzo ciągłe złożenia, które rozciągają się na większą liczbę powtórzeń, co znacznie ułatwia produkcję kompletnych złożeń plazmidowych. Są zasadniczo dwa rodzaje długich, jednocząsteczkowych technologii sekwencjonowania11,12. Jedna z tych metod, sekwencjonowanie nanoporowe, staje się popularna w mikrobiologii ze względu na niski koszt, szybkie czasy realizacji i przydatność dla środowisk o ograniczonych zasobach13,14.
Urządzenia sekwencjonowania nanoporowego używają komórek przepływowych zawierających tablice tysięcy nanoporów. DNA jest wczytywane do komórki przepływowej, otwierane przez białko motoryczne z aktywnością helikazy i przepływa przez nanopory napędzane różnicą prądu. Gdy nukleotydy w danym pojedynczym łańcuchu przechodzą przez pojedyncze nanopory, prąd jest zakłócany, co wytwarza charakterystyczny sygnał, który jest mierzony przez elektroniczny czujnik podłączony do każdego poru. Ten sygnał jest dekodowany za pomocą algorytmów basecallingu, a wynikowe dane są zbierane i analizowane dalej przy użyciu różnych narzędzi bioinformatycznych.
W porównaniu z podejściami SR-sekwencjonowania, sekwencjonowanie nanoporowe ma tendencję do produkowania niższej jakości odczytów (niższe wyniki Q) i generowania wstawień/delecji w sekwencjach homopolimerów podczas analizy danych elektrycznych (basecallingu)15. Zauważono również, że pobliska metylacja w natywnym DNA może powodować systematyczne błędy w basecallingu16. Powszechnie stosowanym rozwiązaniem jest dołączenie danych SR do korekcji błędów po montażu. Jednak ten proces (znany jako “polerowanie”) zwiększa koszt i kompleksowość17. Zwiększenie pokrycia sekwencjonowania może również poprawić dokładność, ale nie zawsze jest to technicznie osiągalne.
Protokół
1. Ekstrakcja DNA plazmidowego
UWAGA: Ten protokół został użyty do ekstrakcji DNA plazmidowego z klinicznej szczepu Escherichia coli oraz jego odpowiednich transkonjugantów za pomocą komercyjnego zestawu do ekstrakcji DNA plazmidowego35. Szczegółowe protokoły dotyczące koniugacji można znaleźć w36. Protokół nadaje się zarówno do plazmidów wysoko-kopiowych, jak i nisko-kopiowych, o wielkości od ~3 kb do ~200 kb. Duże plazmidy wymagają szczególnej uwagi, ponieważ mają tendencję do posiadania niskiego wskaźnika kopii (nawet 1-2 kopie na komórkę), co ogranicza wydajność DNA. Aby to kompensować, protokół zaleca zwiększenie masy komórkowej i objętości buforów lizy i neutralizacji, aby zapewnić wystarczającą ilość DNA plazmidowego do wiązania z kolumną. Plazmidy do 200 kb wciąż mogą być odzyskane przy użyciu tego protokołu; jednak, jego przydatność do megaplazmidów (>200 kb) jest ograniczona.
- Ekstrakcja plazmidów
- Dzień 1: Rozmazać próbki na agarowych płytkach Luria-Bertani (LB) uzupełnionych odpowiednim antybiotykiem w celu wyboru odpowiedniego markera oporu plazmidowego i inkubacji w 37 °C przez 24 h.
UWAGA: Dodać karbenicylinę (lub odpowiedni antybiotyk) do LB w końcowej koncentracji 100 µg/mL poprzez dodanie 1 µL 100 mg/mL roztworu początkowego na 1 mL pożywki. - Dzień 2: Zainokuować 3-5 mL LB z odpowiednim antybiotykiem kulturą pojedynczej kolonii izolowanych z Dnia 1. Inkubować z mieszaniem w 37 °C przez ~8 h lub do osiągnięcia OD600 1-2.
UWAGA: Pomiar OD600: Wyzerować spektrofotometr świeżą pożywką LB zawierającą odpowiedni antybiotyk, a następnie przenieść 1 mL kultury do czystej kulwetki i zmierzyć OD przy 600 nm. Jeśli odczyt przekracza zakres liniowy, rozcieńczyć próbkę i ponownie zmierzyć. - Zainokować 400 mL LB uzupełnionego odpowiednim antybiotykiem z 400 µL starteru z Dnia 2. Inkubować z mieszaniem w 37 °C przez 8-12 h lub do osiągnięcia OD600 1-2 (jak opisano wcześniej).
UWAGA: Zwiększyć objętość kultury powyżej 400 mL, jeśli OD600 nie osiągnie 1-2 w ciągu 12 h. Aby zmniejszyć ryzyko utraty plazmidu lub rearanżacji, ogranicz przelewanie w kulturze tak bardzo, jak to możliwe, i utrzymuj selekcję antybiotykową na wszystkich etapach wzrostu. Zwiększ objętość kultury tylko wtedy, gdy pożądana jest wyższa wydajność DNA. - Dzień 3: Przenieść kulturę do odpowiednich butelek do wirówki dla objętości kultury. Wirować przez 10 min. w 4200 x g, a następnie ponownie zawiesić osadek za pomocą objętości reagentów zalecanych przez producenta według następującego wzoru:
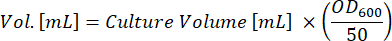
UWAGA: Przykład: Do zlizania 400 mL kultury bakterii o niskiej kopii (OD600 = 2) odpowiednie objętości buforów lizy RES, LYS i NEU wynoszą po 16 mL.
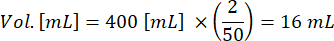
UWAGA: Jeśli objętości reagentów do zawieszenia, lizy lub neutralizacji nie są odpowiednio skalowane do całkowitej biomasy kultury (OD600 × Objętość, czyli ODV), liza może być niekompletna, neutralizacja nieefektywna, a tworzenie osadu nadmiernie intensywne. Może to prowadzić do niższej wydajności plazmidu, zmniejszonej czystości i potencjalnego zatykania kolumn oczyszczających. Proporcjonalne skalowanie objętości buforów, zgodnie z wzorem producenta (krok 1.1.4.), zapewnia efektywną lizję, pełną neutralizację i spójne odzyskiwanie wysokiej jakości DNA plazmidowego. - Wykonać liza komórek, zwilżenie filtra za pomocą odpowiedniego buforu i neutralizację zgodnie z instrukcjami zestawu.
UWAGA: Ułożyć dwa filtry, jeśli objętość osadu jest duża, dostosowując bufor proporcjonalnie. Wykonać dodatkowe kroki wirowania, jeśli nadstan pozostaje mętny. Po neutralizacji, duża objętość osadu może wymagać dodatkowych kroków wirowania. Jest to przypadek większości klinicznych próbek E. coli, prawdopodobnie ze względu na skłonność do tworzenia biofilmu w kulturze37, co wiąże się z wydzielania grubszego podłoża38. Nadmiar osadu w lizacie może zatykać kolumnę, przedłużać czas sączenia i potencjalnie zanieczyszczać próbkę białkami. Jeśli nadstan jest czysty, te dodatkowe kroki mogą nie być konieczne. - Wirować lizat w 4200 x g przez 30 min. Przenieść nadstan do nowej probówki i ponownie wirować przez 30 min. Jeśli nadstan pozostaje mętny po tych wirowaniach (Rysunek 2), wykonać dodatkowe wirowanie w 4200 x
- Dzień 1: Rozmazać próbki na agarowych płytkach Luria-Bertani (LB) uzupełnionych odpowiednim antybiotykiem w celu wyboru odpowiedniego markera oporu plazmidowego i inkubacji w 37 °C przez 24 h.
Wyniki
Kliniczne szczepy E. coli
Aby zilustrować zastosowanie ONT do sekwencjonowania plazmidów z klinicznych szczepów, autorzy sekwencjonowali 10 szczepów, które były hojnym darem Dr. Stephen Salipante z University of Washington. Te szczepy były częścią kolekcji 312 szczepów pochodzących z krwi lub moczu, szczepów E. coli patogennego poza przewodem pokarmowym (ExPEC), uzyskanych w trakcie rutynowej opieki klinicznej w University of Washington Medical Center45.
Koniugacja plazmidów i charakterystyka przez test mobilności w żelu
Badaczom przeprowadzili także test koniugacji za pomocą szczepu E. coli LMB100 jako odbiorcy. Koniugacja to proces prowadzący do transferu plazmidu obecnego w komórce (dawcy) do innej komórki (zwanej odbiorcą)46. Transfer wymaga kontaktu fizycznego między dwoma komórkami i jest zwykle wykrywany za pomocą markerów wskazujących na obecność plazmidu koniugacyjnego w komórkach odbiorczych. Pozwoliło to autorom wyeliminować różnice w szczepie żywiciela jako zmienną i przedstawić zastosowanie protokołu do sekwencjonowania plazmidów uzyskanych przez przechwytywanie plazmidów (metoda stosowana do profilowania plazmidów z danej niszy ekologicznej). Wszystkie testy koniugacji wyprodukowały transkonjuganty, potwierdzając obecność koniugacyjnego plazmidu w dawcy. Protokół, którego autorzy zastosowali, jest opisany w36. Grupa zidentyfikowała plazmidy obecne w szczepach dawcy i odbiorcy i oszacowała ich mobilność za pomocą elektroforezy w polu pulsującym (PFGE). Lista dziesięciu reprezentatywnych szczepów dawcy jest przedstawiona w Tabeli 8, a oszacowane rozmiary plazmidów obecnych w nich są wymienione w trzeciej kolumnie. Plazmidy spoza zakresu rozdzielczości żelu PFGE są wykluczone z tej tabeli, ale badacze byli w stanie skonstruować kilka mniejszych plazmidów o wielkości około 4kb (nie pokazano).
| Szczep dawcy | Plazmida | Oszacowany rozmiar PFGE | Długość montażu | Średnia głębokość | głębokość 0 bp | Pokrycie % | Zmienione pozycje | Dokładność przed SR % |
| blood_08 _0081 | pblood_08_ 0081_1 | 170000 | 171829 | 100 | 99.941803 | 54 | 0.0314 | 99.9686 |
| blood_08 _0081 | pBlood_08_ 0081_2 | 82000 | 85576 | 46.9 | 0 | 100 | 2 | 99.9977 |
| blood_d-08 _0094 | pBlood_d-08 _0094 | 179000 | 173334 | 382.6 | 3121 | 98.19943 | 2,347 | 98.646 |
| blood_08 _1447 | pBlood_08 _1447 | 97000 | 99624 | 36.2 | 0 | 100 | 0 | 100 |
| blood_10 _0913 | pBlood_10 _0913_1 | 70000 | 71788 | 49 | 4 | 99.994428 | 188 | 99.7381 |
| blood_10 _0913 | pBlood_10 _0913_2 | 112000 | 118727 | 41.2 | 126 | 99.893874 | 276 | 99.7675 |
| blood_1 1_184 | pBlood_11 _184_1 | 150000 | 146583 | 65.1 | 287 | 99.804206 | 134 | 99.9086 |
| blood_11_184 | pBlood_11 _184_2 | 75000 | 74263 | 82.1 | 0 | 100 | 32 | 99.9569 |
| blood_2011 _0238 | pBlood_ 2011_0238 | 170000 | 167286 | 110.9 | 0 | 100 | 0 | 100 |
| upec_108 | pUPEC_108 | 130500 | 131039 | 103.9 | 0 | 100 | 0 | 100 |
| upec_134 | pUPEC_134 | 160500 | 157 |
Dyskusja
Identyfikacja i charakterystyka plazmidów ma duże znaczenie dla zdrowia publicznego, mikrobiologii klinicznej i ekologii mikroorganizmów, ponieważ ułatwiają one utrzymanie i rozprzestrzenianie genów adaptacyjnych w różnych środowiskach ekologicznych1,5 i służą jako platformy dla przyspieszonej ewolucji4. Wprowadzenie technologii NGS pozwoliło na sekwencjonowanie w wysokiej przepustowości genomów izolatów mikroorganizmów i populacji, chociaż identyfikacja po montażu kompletnych plazmidów lub kontigów pochodzących z plazmidów wymaga ogólnie długich sekwencji, ponieważ krótkie dane sekwencjonowania nie są w stanie rozdzielić obszarów powtarzających się większych niż wielkość odczytów. ONT stało się bardzo popularnym podejściem do sekwencjonowania długich odczytów, z zastosowaniami, które wykraczają poza sekwencjonowanie całych genomów i metagenomikę, a które obejmują weryfikację sekwencji plazmidów, wykrywanie i charakteryzację modyfikacji epigenetycznych, sekwencjonowanie RNA i ocenę właściwej niestabilności tandemowych tablic genów (przegląd w12,49).
Poniżej, badacze przedstawiają przepływ pracy dla sekwencjonowania plazmidów za pomocą ONT, zaprojektowany dla sytuacji, w których sekwencja chromosomowa jest już znana lub nie jest istotna. Powodem jest to, że ekstrakcja plazmidów jest pracochłonna, kosztowna i czasochłonna (ponieważ populacja gospodarza musi być hodowana w kulturze i przetworzona), a sekwencjonowanie całego genomu za pomocą technologii nanoporowej jest często wystarczające, aby uzyskać kompletne montaże plazmidów, zapewniając ich kontekst genomowy. Przykłady, w których protokół jest pomocny, obejmują weryfikację sekwencji plazmidów w kontekście inżynierii genetycznej plazmidów50,51, poprawę dokładności sekwencji plazmidów już uzyskiwanych przez WGS24, lub charakteryzację plazmidów, które zostały przechwycone z próbek klinicznych lub środowiskowych przez koniugację.
Ekstrakcja DNA z próbek klinicznych i środowiskowych może wymagać niektórych dostosowań. Tutaj autorzy raportują, że niektóre z użytych szczepów klinicznych produkowały matrycę biofilmu, która zasłaniała filtry, wymagając wielokrotnych etapów osadzania i czasami wymagająca dodania dwóch filtrów. Również, aby sekwencjonować plazmidy koniugacyjne, potrzebna jest większa objętość kultury względem sekwencjonowania plazmidów wielokopianych, ponieważ naturalnie występujące średnie i duże plazmidy mają tendencję do posiadania niskiego liczby kopii plazmidów2.
Protokół pozwolił na sekwencjonowanie plazmidów o wielkości od 4 kb do 173 kb. Ten zakres leży w całości w specyfikacjach producenta (od 2 do 200 kb). Niedawno, badanie spojrzeć na 23 000 sekwencji plazmidów zdeponowanych w NCBI i znaleźć znaczące różnice wielkości w zależności od źródła, przy czym plazmidy pochodzenia ludzkiego mają najmniejszą średnią wielkość (76 kb), a plazmidy z gleby i roślin największą (odpowiednio 215 i 427 kb); plazmidy ze wszystkich pozostałych źródeł miały średnią wielkość od 79 do 147 kb, więc ten protokół powinien obejmować większość plazmidów, z możliwym wyjątkiem megaplazmidów52 i plazmidów pochodzenia gleby lub roślinnego3.
Autorzy dołączyli krok wzbogacania DNA plazmidowego, aby poprawić dokładność montażu DNA plazmidowego. Obecność dużych ilości DNA chromosomowego zasypuje pory komórkowe na komórce przepływowej sekwencjonowania niecelowymi odczytami, znacznie zmniejszając głębokość DNA plazmidowego. Krok wzbogacania DNA plazmidowego był już wdrożony w celu całkowitego montażu DNA plazmidowego w próbkach klinicznych dla wykrycia ARGs24. To pokazało znaczne poprawy w efektywności ukończenia montażu plazmidu z nanopore-only sekwencjonowaniem (78% kompletnych montażów względem benchmarku). Inne przykłady wystąpiły50,53,54.
Aby poprawić dokładność odczytu, dwa z tych badań użyło techniki opracowanej przez nanopore, nazywanej “paired basecalling na pseudopaired odczytach”50,53. To podejście polega na wyrównaniu surowych sygnałów elektrycznych z nićmi sense i antisense tej samej cząsteczki DNA, co prowadzi do poprawy dokładności o około rząd wielkości. Paired basecalling na pseudopaired odczytach jest kompatybilny z multiplexowaniem, o ile strategia pozwala na identyfikację nić przednich i tylnych tej samej cząsteczki. W ten sposób nie może być używany w plazmidach oczyszczonych z próbek o nieznanym komplecie plazmidów lub zawierających mieszaninę plazmidów. Należy zauważyć, że liczba plazmidów w genomie zazwyczaj waha się od 0 do 7 plazmidów (szczególnie w izolatów klinicznych)2,55.
Badacze
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Jesteśmy bardzo wdzięczni Steve Salipante (University of Washington) za hojne udostępnienie zestawu klinicznych szczepów E. coli opublikowanych w45. Ta praca została częściowo wsparta funduszami na badania nad mianowaniem na stanowisko Dyrektora ds. Innowacyjności i Rozwoju Przedsiębiorczości od UCSC dla MC oraz grantem University of California Alianza MX “Profilowanie genomowe izolowanych szczepów gruźlicy wśród populacji wysokiego ryzyka i podatnych na Meksyk: wgląd w transmisję i oporność na leki” dla MC.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| 1.5 mL Eppendorf DNA LoBind tube | Sigma Aldrich | EP022431081 | Może być zastąpiony inną marką |
| 1.5 mL tube racks | Thermo Fisher Scientific | 22-313630 | Może być zastąpiony inną marką |
| 15 mL conical tubes | FALCON | 352096 | Może być zastąpiony inną marką |
| 15 mL tube racks | Thermo Fisher Scientific | 8850 | Może być zastąpiony inną marką |
| 2.0 mL microcentrifuge tubes | Fisherbrand | 05-408-138 | Może być zastąpiony inną marką |
| 250 mL sterile flasks | PYREX | 5320 | Może być zastąpiony inną marką |
| Carbenicillin | GOLD BIOTECHNOLOGY | C-103-50 | Może być zastąpiony inną marką |
| Centrifuge | Eppendorf | 5424R-PR-R | Może być zastąpiony inną marką |
| Centrifuge | Eppendorf | 5810R-P-R | Może być zastąpiony inną marką |
| Centrifuge bottles | Sigma Aldrich | B1283-4EA | Może być zastąpiony inną marką |
| Disposable Inoculating Loops: 1 µL | Fisherbrand | 22-363-595 | Może być zastąpiony inną marką |
| Electronic Digital Scale | Denver Instrument | APX-2001 | Może być zastąpiony inną marką |
| Ethanol | Fisher Scientific | 04-355-720 | Może być zastąpiony inną marką |
| Ethanol-resistant markers | Sharpie | 37001; 37002; 37003 | Może być zastąpiony inną marką |
| Flow cell (R10.4.1) | Oxford Nanopore Technologies | FLO-MIN114 | |
| Flow Cell Wash Kit | Oxford Nanopore Technologies | EXP-WSH004 | |
| Gloves | X-GEN | 44-100M | Wszelkie rękawiczki nitrylowe działają |
| Ice bucket | Thermo Fisher Scientific | 432128 | Może być zastąpiony inną marką |
| Isopropanol | Fisher Scientific | BP26184 | Może być zastąpiony inną marką |
| MinION Sequencing Device | Oxford Nanopore Technologies | MIN-101B | |
| Native Barcoding Kit 96 V14 | Oxford Nanopore Technologies | SQK-NBD114.96 | |
| NucleoBond Xtra MIDI Plasmid DNA Extraction Kit | Takara | 740410.5 | |
| PCR tube racks | AXYGEN | R96PCRFSP | Może być zastąpiony inną marką |
| PCR tubes: (0.2 mL) | AXYGEN | PCR-02-C | Może być zastąpiony inną marką |
| Program autocycler v0.5.2 | Ryan Wick / University of Melbourne | ||
| Program bcftools v1.22 | Wellcome Sanger Institute (HTSlib / Samtools team) | ||
| Program bwa v0.7.19 | Heng Li, originally at the Broad Institute | ||
| Program canu v2.3 | University of California, Davis & Pacific Biosciences collaborators | ||
| Program flye v2.9.6 | University of California, San Diego (Pavel Pevzner lab) | ||
| Program medaka v2.1.1 | Oxford Nanopore Technologies | ||
| Program metamdbg v1.2 | INRIA | ||
| Program miniasm v0.3 | Heng Li | ||
| Program minimap2 v2.28 | Heng Li | ||
| Program minipolish v0.2.0 | Ryan Wick / University of Melbourne | ||
| Program porechop v0.2.4 | Ryan Wick / University of Melbourne | ||
| Program racon v1.5.0 | Genome Institute of Singapore | ||
| Program samtools v1.22.1 | Wellcome Sanger Institute (HTSlib / Samtools project) | ||
| Qubit™ 4 Fluorometer | Invitrogen | Q33226 | |
| Qubit™ Assay Tubes | Invitrogen | Q32856 | |
| Rapid Barcoding Kit 24 and 96 V14 | Oxford Nanopore Technologies | SQK-RBK114.96 | |
| Set of micropipettes that dispense between 1 – 10 μL (P10), 2 – 20 μL (P20), 20 – 200 μL (P200) and 200 – 1000 μL (P1000) | RAININ | 17008648; 17008650; 17008652; 17008653 | Micropipety powinny być skalibrowane |
| Spectrophotometer | Thermo Scientific | 335905P | Może być zastąpiony inną marką |
| Sterilized tips for 10 μL, 200 μL and 1000 μL | Eclipse | 1011-260-000-9; 1018-260-000; 1019-260-000-9 | |
| Thermal cycler C1000 Touch | Bio-Rad | 1851196 | Może być zastąpiony inną marką |
| Water bath | Thermo Scientific | 51221052 | Może być zastąpiony inną marką |
Bibliografia
- Finks, S. S., Martiny, J. B. H. Plasmid-encoded traits vary across environments. mBio. 14 (1), e0319122(2023).
- Ramiro-Martinez, P., de Quinto, I., Lanza, V. F., Gama, J. A., Rodriguez-Beltran, J. Universal rules govern plasmid copy number. Nat Commun. 16 (1), 6022(2025).
- Redondo-Salvo, S., et al. Pathways for horizontal gene transfer in bacteria revealed by a global map of their plasmids. Nat Commun. 11 (1), 3602(2020).
- Rodriguez-Beltran, J., DelaFuente, J., Leon-Sampedro, R., MacLean, R. C., San Millan, A. Beyond horizontal gene transfer: the role of plasmids in bacterial evolution. Nat Rev Microbiol. 19 (6), 347-359 (2021).
- Castaneda-Barba, S., Top, E. M., Stalder, T. Plasmids, a molecular cornerstone of antimicrobial resistance in the one health era. Nat Rev Microbiol. 22 (1), 18-32 (2024).
- Robertson, J., Bessonov, K., Schonfeld, J., Nash, J. H. E. Universal whole-sequence-based plasmid typing and its utility to prediction of host range and epidemiological surveillance. Microb Genom. 6 (10), (2020).
- Conlan, S., et al. Single-molecule sequencing to track plasmid diversity of hospital-associated carbapenemase-producing Enterobacteriaceae. Sci Transl Med. 6 (254), 254ra126(2014).
- Zankari, E., et al. Identification of acquired antimicrobial resistance genes. J Antimicrob Chemother. 67 (11), 2640-2644 (2012).
- Eyre, D. W., et al. WGS to predict antibiotic MICs for Neisseria gonorrhoeae. J Antimicrob Chemother. 72 (7), 1937-1947 (2017).
- Arredondo-Alonso, S., Willems, R. J., van Schaik, W., Schurch, A. C. On the (im)possibility of reconstructing plasmids from whole-genome short-read sequencing data. Microb Genom. 3 (10), e000128(2017).
- Rhoads, A., Au, K. F. PacBio sequencing and its applications. Genomics Proteomics Bioinformatics. 13 (5), 278-289 (2015).
- Zhang, T., et al. Nanopore sequencing: flourishing in its teenage years. J Genet Genomics. 51 (12), 1361-1374 (2024).
- González, A., Fullaondo, A., Odriozola, A. Why are long-read sequencing methods revolutionizing microbiome analysis? Microorganisms. 13 (8), (2025).
- Wick, R. R., Holt, K. E. Polypolish: Short-read polishing of long-read bacterial genome assemblies. PLoS Comput Biol. 18 (1), e1009802(2022).
- Delahaye, C., Nicolas, J. Sequencing DNA with nanopores: Troubles and biases. PLoS One. 16 (10), e0257521(2021).
- Watson, M., Warr, A. Errors in long-read assemblies can critically affect protein prediction. Nat Biotechnol. 37 (2), 124-126 (2019).
- De Maio, N., et al. Comparison of long-read sequencing technologies in the hybrid assembly of complex bacterial genomes. Microb Genom. 5 (9), (2019).
- Lerminiaux, N., Fakharuddin, K., Mulvey, M. R., Mataseje, L. Do we still need Illumina sequencing data? Evaluating Oxford Nanopore Technologies R10.4.1 flow cells and the Rapid v14 library prep kit for Gram-negative bacteria whole genome assemblies. Can J Microbiol. 70 (5), 178-189 (2024).
- Dabernig-Heinz, J., et al. A multicenter study on accuracy and reproducibility of nanopore sequencing-based genotyping of bacterial pathogens. J Clin Microbiol. 62 (9), e0062824(2024).
- Sereika, M., et al. Oxford Nanopore R10.4 long-read sequencing enables the generation of near-finished bacterial genomes from pure cultures and metagenomes without short-read or reference polishing. Nat Methods. 19 (7), 823-826 (2022).
- Wick, R. R., Judd, L. M., Holt, K. E. Assembling the perfect bacterial genome using Oxford Nanopore and Illumina sequencing. PLoS Comput Biol. 19 (3), e1010905(2023).
- Paterson, D. L. Resistance in gram-negative bacteria: enterobacteriaceae. Am J Med. 119 (1), discussion S62-70 S20-S28 (2006).
- Peter, S., et al. Tracking of antibiotic resistance transfer and rapid plasmid evolution in a hospital setting by nanopore sequencing. mSphere. 5 (4), (2020).
- George, S., et al. Resolving plasmid structures in Enterobacteriaceae using the MinION nanopore sequencer: assessment of MinION and MinION/Illumina hybrid data assembly approaches. Microb Genom. 3 (8), e000118(2017).
- Dong, N., Yang, X., Zhang, R., Chan, E. W., Chen, S. Tracking microevolution events among ST11 carbapenemase-producing hypervirulent Klebsiella pneumoniae outbreak strains. Emerg Microbes Infect. 7 (1), 146(2018).
- Lemon, J. K., Khil, P. P., Frank, K. M., Dekker, J. P. Rapid nanopore sequencing of plasmids and resistance gene detection in clinical isolates. J Clin Microbiol. 55 (12), 3530-3543 (2017).
- Linde, J., et al. Comparison of Illumina and Oxford Nanopore Technology for genome analysis of Francisella tularensis, Bacillus anthracis, and Brucella suis. BMC Genomics. 24 (1), 258(2023).
- Bickhart, D. M., et al. Generating lineage-resolved, complete metagenome-assembled genomes from complex microbial communities. Nat Biotechnol. 40 (5), 711-719 (2022).
- Koren, S., et al. Canu: scalable and accurate long-read assembly via adaptive k-mer weighting and repeat separation. Genome Res. 27 (5), 722-736 (2017).
- Vaser, R., Sikic, M. Time-and memory-efficient genome assembly with Raven. Nat Comput Sci. 1 (5), 332-336 (2021).
- Lynch, M. D., Neufeld, J. D. Ecology and exploration of the rare biosphere. Nat Rev Microbiol. 13 (4), 217-229 (2015).
- Kruasuwan, W., et al. Comparative evaluation of commercial DNA isolation approaches for nanopore-only bacterial genome assembly and plasmid recovery. Sci Rep. 14 (1), 27672(2024).
- Ulrich, J. U., et al. Nanopore adaptive sampling effectively enriches bacterial plasmids. mSystems. 9 (3), e0094523(2024).
- Wick, R. R., Howden, B. P., Stinear, T. P. Autocycler: long-read consensus assembly for bacterial genomes. Bioinformatics. 41 (9), (2025).
- NucleoBond Xtra Plasmid DNA Purification User Manual. , Takara Bio USA. Available from: https://www.takarabio.com/documents/User%20Manual/NucleoBond%20Xtra%20Plasmid%20DNA%20Purification%20User%20Manual_Rev_15.pdf?srsltid=AfmBOorkdYVlr34yclNUgmBCn4imrn-gbvTafmkD2Yrnnch6fH-K_VwZ (2019).
- Mota-Bravo, L., et al. Detection of horizontal gene transfer mediated by natural conjugative plasmids in E. coli. J Vis Exp. (193), (2023).
- Hancock, V., Witso, I. L., Klemm, P. Biofilm formation as a function of adhesin, growth medium, substratum, and strain type. Int J Med Microbiol. 301 (7), 570-576 (2011).
- Hung, C., et al. Escherichia coli biofilms have an organized and complex extracellular matrix structure. mBio. 4 (5), e00645-e00713 (2013).
- Qubit 4 assays quick reference (Pub. No. MAN0017210 C.0). , Thermo Fisher Scientific. (2025).
- Rapid barcoding sequencing kit 96 v14. , Oxford Nanopore Technologies. Available from: https://store.nanoporetech.com/us/rapid-barcoding-sequencing-kit-96-v14.html (2026).
- Schwengers, O., et al. Bakta: rapid and standardized annotation of bacterial genomes via alignment-free sequence identification. Microb Genom. 7 (11), (2021).
- Seemann, T. Prokka: rapid prokaryotic genome annotation. Bioinformatics. 30 (14), 2068-2069 (2014).
- Singh, H., et al. Integrons: the hidden architects of bacterial adaptation, evolution, and the challenges of antimicrobial resistance. Antonie Van Leeuwenhoek. 118 (7), 90(2025).
- Redondo-Salvo, S., et al. COPLA, a taxonomic classifier of plasmids. BMC Bioinformatics. 22 (1), 390(2021).
- Salipante, S. J., et al. Large-scale genomic sequencing of extraintestinal pathogenic Escherichia coli strains. Genome Res. 25 (1), 119-128 (2015).
- Couturier, A., et al. Real-time visualisation of the intracellular dynamics of conjugative plasmid transfer. Nat Commun. 14 (1), 294(2023).
- Wick, R. R., Schultz, M. B., Zobel, J., Holt, K. E. Bandage: interactive visualization of de novo genome assemblies. Bioinformatics. 31 (20), 3350-3352 (2015).
- Grant, J. R., et al. Proksee: in-depth characterization and visualization of bacterial genomes. Nucleic Acids Res. 51 (W1), W484-W492 (2023).
- MacKenzie, M., Argyropoulos, C. An Introduction to nanopore sequencing: past, present, and future considerations. Micromachines (Basel). 14 (2), (2023).
- Emiliani, F. E., Hsu, I., McKenna, A. Multiplexed assembly and annotation of synthetic biology constructs using long-read nanopore sequencing. ACS Synth Biol. 11 (7), 2238-2246 (2022).
- Brown, S. D., Dreolini, L., Wilson, J. F., Balasundaram, M., Holt, R. A. Complete sequence verification of plasmid DNA using the Oxford Nanopore Technologies' MinION device. BMC Bioinformatics. 24 (1), 116(2023).
- Hall, J. P. J., Botelho, J., Cazares, A., Baltrus, D. A. What makes a megaplasmid? Philos Trans R Soc Lond B Biol Sci. 377 (1842), 20200472(2022).
- Brown Kav, A., Benhar, I., Mizrahi, I. A method for purifying high-quality and high-yield plasmid DNA for metagenomic and deep sequencing approaches. J Microbiol Methods. 95 (2), 272-279 (2013).
- Mumm, C., et al. Multiplexed long-read plasmid validation and analysis using OnRamp. Genome Res. 33 (5), 741-749 (2023).
- Balbuena-Alonso, M. G., et al. Genomic analysis of plasmid content in food isolates of E. coli strongly supports its role as a reservoir for the horizontal transfer of virulence and antibiotic resistance genes. Plasmid. 123-124, 102650(2022).
- Zhao, W., et al. Oxford nanopore long-read sequencing enables the generation of complete bacterial and plasmid genomes without short-read sequencing. Front Microbiol. 14, 1179966(2023).
- Wick, R. R., et al. Trycycler: consensus long-read assemblies for bacterial genomes. Genome Biol. 22 (1), 266(2021).
- Johnson, J., Soehnlen, M., Blankenship, H. M. Long read genome assemblers struggle with small plasmids. Microb Genom. 9 (5), (2023).
- Boostrom, I., Portal, E. A. R., Spiller, O. B., Walsh, T. R., Sands, K. Comparing long-read assemblers to explore the potential of a sustainable low-cost, low-infrastructure approach to sequence antimicrobial resistant bacteria with Oxford Nanopore sequencing. Front Microbiol. 13, 796465(2022).
Przedruki i uprawnienia
