Niniejszy artykuł przedstawia szczegółowy protokół wysokoprecyzyjnego gromadzenia danych eyetrackingowych w eksperymentach nad czytaniem u ludzi, obejmujący wybór sprzętu i ekranu, konfigurację laboratorium, zarządzanie uczestnikami, kalibrację i walidację, kontrolę jakości w czasie rzeczywistym oraz przetwarzanie wstępne (wykrywanie zdarzeń i korekcję dryftu) w celu uzyskania dokładnych, precyzyjnych danych i powtarzalnych wyników.
Artykuł metodologiczny
Protokół metodologiczny w zakresie wysokiej jakości gromadzenia danych podczas badania okulometrycznego procesu czytania u ludzi
W tym artykule
Podsumowanie
Streszczenie
Okulografia (eye tracking) jest centralnym podejściem metodologicznym w badaniu uwagi i przetwarzania języka podczas czytania. Trafność i powtarzalność wyników zależą od jakości danych, przejrzystej metodologii oraz spójnego przetwarzania wstępnego. Niniejszy artykuł przedstawia kompleksowy, szczegółowy protokół gromadzenia wysokiej jakości danych okulograficznych w badaniach nad czytaniem. Protokół rozpoczyna się od przygotowania środowiska laboratoryjnego i konfiguracji sprzętu, następnie przechodzi do wyboru i konfiguracji sprzętu oraz oprogramowania do okulografii, a następnie do przygotowania bodźców i projektu eksperymentalnego. Przeprowadzane jest zarządzanie uczestnikami, pozyskiwanie świadomej zgody oraz dokumentacja charakterystyki lingwistycznej i psychometrycznej. Następnie wykonywane są procedury kalibracji i walidacji, przy ścisłym monitorowaniu online komfortu uczestnika i jakości danych podczas gromadzenia danych. Potok przetwarzania wstępnego obejmuje eksport surowych danych w standardowych formatach, czyszczenie danych, detekcję fiksacji i sakad (z wykorzystaniem algorytmów opartych na prędkości i rozproszeniu) z jasno określonymi parametrami, wizualną inspekcję pod kątem utraty sygnału i kontroli szumów, korekcję dryftu pionowego dla tekstu wieloliniowego oraz ekstrakcję standardowych miar czytania (czas trwania fiksacji, metryki sakad, pomijanie słów i wskaźniki regresji). W całym protokole szczególną uwagę poświęcono spójności między pytaniami badawczymi a specyfikacją sprzętową, zarządzaniu dryftem poprzez regularne kontrole oraz szczegółowemu raportowaniu wszystkich krytycznych parametrów i decyzji. Prawidłowe gromadzenie danych zazwyczaj skutkuje stabilną dokładnością walidacji w określonych granicach, niskim wskaźnikiem utraty danych oraz interpretowalnymi rozkładami czasu trwania fiksacji i zachowania sakad, które odtwarzają dobrze znane efekty związane z długością słowa, częstotliwością i przewidywalnością. Protokół jest kompatybilny z naziemnymi okulografami, powszechnymi środowiskami programowymi oraz układami ze stabilizacją głowy i bez niej, rozwiązując praktyczne problemy, takie jak warunki oświetleniowe, odblaski od okularów i zmiany w postawie uczestnika. Niniejsze opracowanie przedstawia jasny, praktyczny protokół, który konsoliduje wytyczne metodologiczne w jednolity przepływ pracy. Jego celem jest wsparcie niezawodnego gromadzenia danych okulograficznych w badaniach nad czytaniem, promowanie replikowalności i metaanaliz, poprawa spójności między laboratoriami i grupami oraz w ostateczności wzmocnienie wiarygodności naukowej badań nad czytaniem.
Wprowadzenie
Śledzenie wzroku jest kluczową metodą badania uwagi i przetwarzania języka podczas czytania, ponieważ fiksacje i sakady wskazują na momentalny rozdział zasobów wizualnych i poznawczych skierowanych na bodźce. Klasyczne i współczesne przeglądy literatury dokumentują silne powiązania między ruchami gałek ocznych a konstruktami teoretycznymi, takimi jak rozpiętość percepcyjna, korzyść z podglądu oraz modele kontroli ruchów oczu1,2. Aby przeprowadzić wiarygodne badania analizujące te zależności, niezbędna jest rygorystyczna metodologia w zakresie wyboru sprzętu, projektu eksperymentalnego, kalibracji i walidacji oraz wstępnego przetwarzania danych; w przeciwnym razie spadek jakości danych zniekształca oszacowania i podważa replikowalność badań3.
W ciągu ostatniej dekady kilka podręczników oraz publikacji dotyczących dobrych praktyk skonsolidowało wiedzę metodologiczną w tej dziedzinie. Niedawna seria opracowań fundamentalnych łączy teorię z miarami, omawia operacjonalizację i zmienność algorytmiczną oraz dostarcza wytycznych dotyczących wyboru okulografów do konkretnych pytań badawczych4,5,6,7,8. Uzupełniające wytyczne przedstawiają najlepsze praktyki w zakresie wyboru sprzętu, zapewnienia dokładności i precyzji, definiowania miar oraz raportowania, wraz z zaleceniami dotyczącymi ograniczania zagrożeń dla trafności9. Materiały wprowadzające do badań nad czytaniem oferują również przystępne przeglądy projektowania eksperymentów, powszechnych miar oraz procesów analitycznych10,1. W lingwistyce stosowanej i badaniach nad czytaniem przeglądy specyficzne dla danej dziedziny podsumowują dobór miar i okulografów oraz wskazują na ograniczenia zależne od rodzaju zadania12,13,14,15,16,17.
Niniejszy artykuł przekłada wspomniane wytyczne na sformalizowany, etapowy protokół wysokoprecyzyjnego gromadzenia danych z okulografii w badaniach nad czytaniem. W przeciwieństwie do istniejących zasobów, które oferują głównie ogólne, teoretyczne wskazówki dotyczące najlepszych praktyk lub koncentrują się wąsko na konkretnych technikach analitycznych, niniejszy protokół operacjonalizuje te koncepcje w formie kompleksowego, praktycznego procesu roboczego. Jego celem jest ułatwienie codziennej praktyki laboratoryjnej poprzez dostarczenie konkretnych, sekwencyjnych instrukcji. Pod względem zastosowania, protokół ten został zoptymalizowany specjalnie dla ściśle kontrolowanych laboratoryjnych eksperymentów czytania z wykorzystaniem stacjonarnych okulografów o wysokiej częstotliwości próbkowania (np. 50-200 Hz) z systemami stabilizacji głowy (podpórki pod brodę lub czoło). Jest on najlepiej dopasowany do badań wymagających rygorystycznych ograniczeń dotyczących jakości danych, wysokiej dokładności przestrzennej i precyzji — takich jak badania analizujące precyzyjne fiksacje na poziomie pojedynczych słów lub szczegółowe parametry sakad.
Coraz większą popularność zyskują również układy bezunieruchomionej głowy lub naturalistyczne, także w badaniach nad czytaniem, jednak w niniejszym artykule ograniczamy zakres do badań laboratoryjnych. Omówimy wybór sprzętu i oprogramowania, konfigurację laboratorium, przygotowanie bodźców, zarządzanie uczestnikami, kalibrację i walidację, kontrolę jakości w czasie rzeczywistym oraz przetwarzanie wstępne (w tym detekcję zdarzeń i korekcję dryftu). Postępując zgodnie z protokołem, badacze mogą dokumentować i osiągać jakość danych zgodną z aktualnymi standardami, co zwiększa przejrzystość, wiarygodność i powtarzalność wyników badań nad czytaniem.
Protokół
Zgoda etyczna na gromadzenie danych w ramach COST CA2131 została udzielona przez Komisję Etyki Badań na Wydziale Filozoficznym Uniwersytetu Jagiellońskiego w Polsce, pod numerem protokołu 21.042.18_2024. Od wszystkich uczestników uzyskano świadomą zgodę.
1. Przygotowanie środowiska laboratoryjnego i konfiguracja sprzętu
- Przygotowanie środowiska laboratoryjnego
- Sprawdzić warunki oświetlenia i hałas w otoczeniu. Okna w laboratorium mogą powodować nagłe zmiany rozszerzenia źrenic oraz refleksy świetlne na kamerze eye-trackera i monitorze. Jeśli to możliwe, zbierać dane w pomieszczeniu bez okien lub użyć zasłon zaciemniających, aby zablokować światło słoneczne. Stosować oświetlenie sztuczne i wyeliminować odblaskowe źródła światła. Zweryfikować, czy na monitorze nie pojawiają się żadne odbicia; regulować żaluzje/kąty nachylenia, aż do całkowitego ich usunięcia. Zadbać o ciszę w pomieszczeniu i zapobiec zakłóceniom (np. poprzez tabliczki informacyjne, blokady drzwi). Stosować sygnały zewnętrzne, aby uniknąć przerw (np. umieścić na zewnątrz komunikat: „Trwa eksperyment. Prosimy nie pukać do drzwi ani nie wchodzić do pomieszczenia”).
- Sprawdzić ergonomię fizyczną. Użyć stabilnego krzesła bez funkcji obrotowej; dostosować wysokość stołu (jeśli jest regulowany), aby zachować prawidłową postawę i uniknąć utraty kalibracji spowodowanej obrotem krzesła.
- Unikać obecności osób trzecich. Obecność eksperymentatora w tym samym pomieszczeniu może rozpraszać uczestnika. Oddzielić pomieszczenie kontrolne od pomieszczenia z uczestnikiem lub zapewnić, aby eksperymentator znajdował się poza zasięgiem wzroku, w celu zminimalizowania efektów obecności społecznej.
- Sprawdzić wentylację powietrza. Przeprowadzić wietrzenie pomieszczenia przed i po sesjach eksperymentalnych. Sprawdzić temperaturę w pokoju, ponieważ uczestnicy będą musieli pozostawać w bezruchu przez pewien czas.
- Wybór sprzętu do okulografii (eye-trackingu)
- Sprawdzić zgodność między celami badawczymi a miernikami. Cele konkretnego badania, a tym samym mierniki docelowe (zmienne zależne), powinny być zgodne z możliwościami sprzętu do eye-trackingu. Dostępność sprzętu w danej instytucji może wprowadzać ograniczenia w zakresie planowanego badania. Sprawdzić trzy główne charakterystyki komponentów systemu eye-trackingu (częstotliwość próbkowania, precyzję i dokładność) oraz ich potencjał w zaspokojeniu potrzeb badawczych. Kluczowe jest zapewnienie, że możliwości sprzętu do eye-trackingu są kompatybilne z celami badania.
UWAGA: Częstotliwość próbkowania = Częstotliwość próbkowania wyrażona jest w Hz i odzwierciedla liczbę próbek zbieranych przez eye-tracker w danym czasie: eye-tracker 60 Hz zbiera próbki co 16 ms, podczas gdy eye-tracker 50 Hz zbiera próbki co 1 ms. Wpływa to na różne rodzaje pomiarów, ponieważ eye-trackery o niskiej częstotliwości mogą błędnie zaklasyfikować sakady rozpoczynające się w okresie 16 ms jako fiksacje lub odwrotnie. Próbkowanie jest czasem mylone z dokładnością danych, ale są to odrębne właściwości.
Precyzja = Spójność, z jaką eye-tracker jest w stanie zbierać dane w czasie.
Dokładność = Wielkość błędu między punktem spojrzenia wykrytym przez eye-tracker a rzeczywistym punktem spojrzenia.
Na przykład badanie miejsc lądowania fiksacji na słowach, które są opisywane w kategoriach pozycji spojrzenia na literach słowa, wymaga znacznie wyższej częstotliwości próbkowania (≥50-20 Hz), precyzji i dokładności niż badanie skupiające się wyłącznie na procencie sakad regresywnych (w porównaniu do sakad progresywnych) podczas czytania. - Określić metodologię rejestracji ruchów gałek ocznych. Użyć stacjonarnego eye-trackera o wysokiej częstotliwości próbkowania, precyzji i dokładności. Zastosować stabilizację głowy za pomocą podbródka lub podpórki czołowej. W przypadku stosowania eye-trackingu bez stabilizacji głowy (remote eye tracking), użyć naklejek (jeśli są dostępne) na czole uczestnika, aby poprawić śledzenie twarzy; należy również unikać naklejek odblaskowych, chyba że zaleci to producent urządzenia.
UWAGA: Stosowanie mobilnego sprzętu do eye-trackingu (wearable) było rzadkie w badaniach nad czytaniem ze względu na stosunkowo niską częstotliwość próbkowania, precyzję i dokładność w porównaniu do eye-trackerów stacjonarnych, a także trudności w analizie danych o ruchach gałek ocznych. Jednak w ostatniej dekadzie konfiguracje bez stabilizacji głowy lub naturalistyczne zyskały na popularności dzięki poprawie jakości danych i zautomatyzowanym potokom analizy, co rozszerzyło zakres badań nad ruchami gałek ocznych podczas czytania w stronę ustawień naturalistycznych i czytania w środowiskach VR.
- Sprawdzić zgodność między celami badawczymi a miernikami. Cele konkretnego badania, a tym samym mierniki docelowe (zmienne zależne), powinny być zgodne z możliwościami sprzętu do eye-trackingu. Dostępność sprzętu w danej instytucji może wprowadzać ograniczenia w zakresie planowanego badania. Sprawdzić trzy główne charakterystyki komponentów systemu eye-trackingu (częstotliwość próbkowania, precyzję i dokładność) oraz ich potencjał w zaspokojeniu potrzeb badawczych. Kluczowe jest zapewnienie, że możliwości sprzętu do eye-trackingu są kompatybilne z celami badania.
- Konfiguracja sprzętu i oprogramowania
- Skonfigurować sprzęt. Zmierzyć odległości między twarzą uczestnika, monitorem a eye-trackerem. Ustawić odległość widzenia zgodnie z zaleceniami producenta (np. ~60–70 cm) i wymaganą geometrią konfiguracji, najlepiej używając płaskiego monitora LCD 21–27 cali (np. 24 cale przy 60 cm, pole widzenia ~48° x 28°), aby cały tekst znajdował się w centralnym polu widzenia i w skutecznym zakresie działania trackera. Sprawdzić nachylenie i obrót monitora oraz wyrównanie wektora spojrzenia z odpowiadającą mu lokalizacją na ekranie. Ustawić rozmiar monitora i częstotliwość odświeżania na wartości docelowe. Ustawić rozdzielczość ekranu na określoną wartość. Zmierzyć luminancję monitora na białym tle w określonej odległości. Zapisać wartość luminancji w raporcie z sesji.
- W razie potrzeby preferować monitory LCD o wysokiej częstotliwości odświeżania (120 Hz lub wyższej, np. 14–240 Hz), szczególnie w przypadku zadań zależnych od spojrzenia (gaze-contingent tasks) i zweryfikowanego timingu. Wyłączyć technologie zmiennej częstotliwości odświeżania (G-Sync/FreeSync). Jeśli eye-tracker jest używany przez różnych badaczy do różnych eksperymentów, ważne jest monitorowanie wszelkich zmian wprowadzonych podczas każdego etapu zbierania danych. Po zakończeniu każdego etapu zbierania danych konfiguracja powinna zostać przywrócona do stanu pierwotnego z początku sesji lub zgodnie z protokołem laboratoryjnym.
- Skonfigurować oprogramowanie. Większość producentów eye-trackerów dostarcza odpowiednie oprogramowanie, zestawy narzędzi programistycznych (SDK) i/lub biblioteki w celu zapewnienia kompatybilności i integracji z oprogramowaniem open-source.
UWAGA: W ostatnim czasie niektóre specyficzne konfiguracje pozostają wyzwaniem technicznym wymagającym niestandardowych rozwiązań. Na przykład synchronizacja czasowa eye-trackera z uzupełniającymi metodami pomiarowymi, takimi jak EEG i fNIRS, wymaga specjalnych rozwiązań sprzętowych i/lub programowych, aby zapewnić odpowiedni poziom blokady czasowej (time-locking) między zegarem eye-trackera a zegarem prezentacji bodźców i/lub uniknąć desynchronizacji odświeżania ekranu. Dlatego większość narzędzi producentów zapewnia środowisko do projektowania eksperymentów, które zaspokaja podstawowe potrzeby badaczy, takie jak prezentacja bodźców i rejestracja ruchów gałek ocznych. Lista aktualnie dostępnych pakietów oprogramowania znajduje się w Tabeli materiałów.
- Skonfigurować sprzęt. Zmierzyć odległości między twarzą uczestnika, monitorem a eye-trackerem. Ustawić odległość widzenia zgodnie z zaleceniami producenta (np. ~60–70 cm) i wymaganą geometrią konfiguracji, najlepiej używając płaskiego monitora LCD 21–27 cali (np. 24 cale przy 60 cm, pole widzenia ~48° x 28°), aby cały tekst znajdował się w centralnym polu widzenia i w skutecznym zakresie działania trackera. Sprawdzić nachylenie i obrót monitora oraz wyrównanie wektora spojrzenia z odpowiadającą mu lokalizacją na ekranie. Ustawić rozmiar monitora i częstotliwość odświeżania na wartości docelowe. Ustawić rozdzielczość ekranu na określoną wartość. Zmierzyć luminancję monitora na białym tle w określonej odległości. Zapisać wartość luminancji w raporcie z sesji.
2. Projektowanie i pilotaż eksperymentu
- Przygotowanie bodźców
- Przygotuj materiały do czytania. Materiały do czytania są zazwyczaj prezentowane w formie zdań lub akapitów, w zależności od celów badania. Rozważ wyjęcie fragmentów materiałów z dostępnych źródeł zamiast ręcznego tworzenia tekstu, o ile metoda ta jest zgodna z celem badania.
- Sprawdź warunki licencjonowania w zakresie ponownego wykorzystania tekstu. Sprawdź warunki licencjonowania dla wszystkich tekstów. Jeśli materiały z opublikowanych eksperymentów są otwartym źródłem i tym samym publicznie dostępne dla każdego, kto chce z nich skorzystać, zgoda nie jest wymagana. W przeciwnym razie uzyskaj niezbędne zgody przed użyciem. Ważne jest sprawdzenie, czy bodźce mogą być wykorzystane w eksperymencie i czy mogą być udostępnione jako materiały uzupełniające.
- Przygotuj sformatowane bodźce. Formatowanie bodźców tekstowych wymaga zastosowania odpowiednich właściwości czcionki (rodzaju, rozmiaru oraz odstępów między literami, słowami i wierszami). Użyj czcionki monospaced o odpowiednim rozmiarze i odstępach, biorąc pod uwagę ustawienia stosowane w literaturze.
UWAGA: Czcionki monospaced, takie jak Courier New, są rekomendowane w eksperymentach czytania, które wykorzystują oparte na słowach obszary zainteresowania (AOIs), ponieważ czcionki te zapewniają taki sam rozmiar piksela dla różnych znaków alfanumerycznych i symboli w obrębie alfabetu łacińskiego. Badacz powinien sprawdzić kompatybilność czcionki, interfejsu i specyficznych właściwości bodźców, takich jak prezentacja bodźców w znakach nielacińskich lub kierunki czytania od prawej do lewej, a także to, czy narzędzia oprogramowania eksperymentalnego zapewniają metodologię automatycznego określania IA (Interest Area) lub AOI (Area of Interest).
- Zaprojektowanie procedury eksperymentalnej
- Przygotowanie instrukcji
UWAGA: Instrukcje są ważne, ponieważ mają istotny wpływ na ruchy gałek ocznych podczas czytania. Stosowanie instrukcji zadania, nawet w minimalnej formie, jest kluczowe. Brak wyraźnych instrukcji może spowodować niezamierzone konsekwencje wpływające na zachowanie wzroku uczestników. Na przykład jeden uczestnik może mieć utajone założenie o uważnym czytaniu, podczas gdy inny może stosować skanowanie tekstu zamiast naturalnego czytania w celu zrozumienia treści.- Przedstaw ustandaryzowane instrukcje na ekranie i zarejestruj czas rozpoczęcia oraz czas trwania instrukcji; unikaj poleceń słownych podczas rejestracji. Powszechną praktyką jest poproszenie uczestnika o czytanie w celu zrozumienia treści. W przypadku, gdy oczekuje się, że uczestnicy będą czytać tak, jak robią to w codziennych sytuacjach, poinformuj ich, że powinni czytać naturalnie; to znaczy, że nie muszą unikać mrugania ani ponownego czytania fragmentów. Poinformuj również uczestników, jeśli istnieje jakiekolwiek dodatkowe zadanie, takie jak pytania sprawdzające zrozumienie (które są ważne dla zagwarantowania, że uczestnicy czytają w celu zrozumienia treści). Instrukcje mogą różnić się nie tylko w zależności od zadania, ale także od fazy eksperymentu (np. trening vs. zadanie główne). Aby to zilustrować, poniżej przedstawiono przykład instrukcji stosowanej podczas fazy treningowej18.
Rozpoczniemy teraz sesję treningową. Do tego będziesz potrzebować czterech zaznaczonych klawiszy (A, B, C, D). Dalsze instrukcje zostaną wyświetlone wkrótce. Po treningu Twoje wyniki zostaną ocenione, co zajmie od jednej do dwóch minut. Jeśli wyniki treningu będą niewystarczające, ostatnia część treningu zostanie powtórzona. Jeśli będą wystarczające, wrócę do pomieszczenia. Gdy będziesz gotowy, po prostu naciśnij pasek spacji. - To od badacza zależy, czy użyje takich instrukcji podczas sesji treningowych w eksperymentach zaprojektowanych do badania czytania. Niemniej jednak należy stosować instrukcje podczas sesji eksperymentalnej. Przykład instrukcji dla fazy eksperymentalnej stosowanej w warunku instrukcji ogólnej istotności (zarówno z pytaniem w tekście, jak i bez) może wyglądać następująco19.
Przeczytaj zestaw krótkich tekstów ekspozycyjnych. Chcemy, abyś przeczytał tekst uważnie, rozumiejąc go w jak największym stopniu. Później, po przeczytaniu, zostaniesz poproszony o ustne podsumowanie głównych idei tekstu, aby sprawdzić, jak dobrze zrozumiałeś to, co przeczytałeś.
Kolejny przykład instrukcji podano poniżej dla eksperymentu wykorzystującego zadania czytania zdań20.
Witamy w naszym badaniu nad czytaniem. W tym badaniu zostaną zaprezentowane około sto zdań. Zostały one wybrane losowo z różnych źródeł i będą prezentowane w losowej kolejności. Czytaj je w myślach, aby zrozumieć ich znaczenie, we własnym, naturalnym tempie czytania, w podobny sposób, w jaki czytasz zdania w książce. Po niektórych zdaniach możesz zostać poproszony o odpowiedź na pytania sprawdzające zrozumienie. Prosimy o odpowiadanie na te pytania. Jeśli nie znasz odpowiedzi, pomiń pytanie. W połowie sesji przewidziana jest przerwa. Możesz poprosić o przerwę lub opuścić sesję w dowolnym momencie, jeśli poczujesz dyskomfort. Jeśli masz jakieś pytania, poinformuj eksperymentatora. W przeciwnym razie naciśnij przycisk, aby rozpocząć procedurę.
- Przedstaw ustandaryzowane instrukcje na ekranie i zarejestruj czas rozpoczęcia oraz czas trwania instrukcji; unikaj poleceń słownych podczas rejestracji. Powszechną praktyką jest poproszenie uczestnika o czytanie w celu zrozumienia treści. W przypadku, gdy oczekuje się, że uczestnicy będą czytać tak, jak robią to w codziennych sytuacjach, poinformuj ich, że powinni czytać naturalnie; to znaczy, że nie muszą unikać mrugania ani ponownego czytania fragmentów. Poinformuj również uczestników, jeśli istnieje jakiekolwiek dodatkowe zadanie, takie jak pytania sprawdzające zrozumienie (które są ważne dla zagwarantowania, że uczestnicy czytają w celu zrozumienia treści). Instrukcje mogą różnić się nie tylko w zależności od zadania, ale także od fazy eksperymentu (np. trening vs. zadanie główne). Aby to zilustrować, poniżej przedstawiono przykład instrukcji stosowanej podczas fazy treningowej18.
- Zaprojektowanie prób i bloków. Zaprojektuj przebieg eksperymentu, biorąc pod uwagę prezentację prób w blokach oraz randomizację kolejności prób wewnątrz i pomiędzy blokami. Przed każdą próbą zastosuj krzyżyk fiksacyjny (50-800 ms), aby upewnić się, że początkowe fiksacje uczestników znajdują się w tym samym miejscu na wyświetlaczu i z dala od jakiejkolwiek części tekstu.
Projekt eksperymentu eyetrackingowego, w którym rozmiar źrenicy jest zmienną zależną, wymaga odpowiedniego dostosowania przebiegu eksperymentu, ponieważ rozmiar źrenicy nie jest reakcją chwilową, taką jak sekwencja fiksacja-sakkada. Konkretnie, w przypadku wykorzystania rozmiaru źrenicy jako zmiennej zależnej, konieczne jest wprowadzenie okna bazowego przed pojawieniem się bodźca (pre-onset baseline window) oraz interwałów czarnego ekranu o odpowiednim czasie trwania, aby zapewnić stabilizację rozmiaru źrenicy przed prezentacją bodźca i kolejną próbą. Badacz powinien zapoznać się z aktualnymi badaniami dotyczącymi wytycznych w pupilometrii, aby upewnić się, że zarejestrowane dane o źrenicy mogą być odpowiednio zinterpretowane jako zmienna zależna21,2. - Zaprojektowanie przerw między blokami. Wprowadź ekrany korekcji dryftu i opcjonalne krótkie przerwy między blokami eksperymentu, aby zapewnić jakość danych i zmniejszyć zmęczenie. Wstaw sprawdzanie dryftu po określonej liczbie prób lub gdy dokładność wyraźnie spada (sprawdź, czy istnieją skróty klawiszowe wymuszające kalibrację/walidację podczas eksperymentu); przeprowadź ponowną walidację, jeśli dryft wynosi >1° kąta widzenia (średnia z współrzędnych x i y).
- Identyfikacja docelowych zmiennych niezależnych. W badaniach nad czytaniem głównymi docelowymi zmiennymi niezależnymi są specyficzne właściwości tekstu, takie jak częstotliwość słów i przewidywalność słów w zdaniu. Wypisz zmienne niezależne eksperymentu w zależności od celów badania. W analizach statystycznych miary zmiennych niezależnych mogą wymagać normalizacji wartości. Oceń istotność każdej zmiennej na podstawie właściwości bodźców.
- Wyklucz z analizy słowa na początku linii tekstu, ponieważ fiksacje na tych słowach są zazwyczaj niedokładne: mogą one odzwierciedlać pierwszą próbną fiksację w tekście/zdaniu lub pierwszą fiksację po przejściu do nowej linii (tzw. return-sweep), które w żadnym przypadku nie są dokładne i zazwyczaj następują po nich fiksacje korygujące. Wyklucz ostatnie słowo z każdej linii, ponieważ słowa te podlegają mniejszemu tłoczeniu wizualnemu (przez kolejne słowa) oraz dlatego, że fiksacje na słowach na końcu linii często odzwierciedlają zakończenie próby lub programowanie powrotu do następnej linii tekstu.
UWAGA: Czas trwania pierwszej fiksacji może być mniej istotny w językach z wieloma słowami funkcyjnymi, takimi jak przedimki przed rzeczownikami (region analizy powinien obejmować przedimek i rzeczownik, ale pierwsza fiksacja będzie mniej ważna, ponieważ może odzwierciedlać jedynie przetwarzanie przedimka).
- Wyklucz z analizy słowa na początku linii tekstu, ponieważ fiksacje na tych słowach są zazwyczaj niedokładne: mogą one odzwierciedlać pierwszą próbną fiksację w tekście/zdaniu lub pierwszą fiksację po przejściu do nowej linii (tzw. return-sweep), które w żadnym przypadku nie są dokładne i zazwyczaj następują po nich fiksacje korygujące. Wyklucz ostatnie słowo z każdej linii, ponieważ słowa te podlegają mniejszemu tłoczeniu wizualnemu (przez kolejne słowa) oraz dlatego, że fiksacje na słowach na końcu linii często odzwierciedlają zakończenie próby lub programowanie powrotu do następnej linii tekstu.
- Identyfikacja docelowych zmiennych zależnych. W badaniach nad czytaniem głównymi docelowymi zmiennymi zależnymi w powiązaniu z celami badania jest zestaw miar ruchów gałek ocznych, takich jak czas trwania pierwszej fiksacji, czas trwania pojedynczej fiksacji, czas trwania spojrzenia (gaze duration), procent regresji i prawdopodobieństwo pominięcia słowa. Określ miary ruchów gałek ocznych, które mają zostać przeanalizowane. Wykorzystaj te miary jako podstawę analizy statystycznej.
UWAGA: Unikaj zadań wymagających od uczestnika pisania na klawiaturze, ponieważ może to wymagać opuszczenia podparcia dla brody, co prowadzi do utraty kalibracji. Zamiast tego uczestnicy mogą używać myszki do zaznaczenia odpowiedzi. W przypadkach, gdy podczas rejestracji ruchów gałek ocznych konieczna jest ustna informacja zwrotna od uczestnika, użyj podparcia dla czoła zamiast podparcia dla brody i poproś uczestnika o odpowiedź ustną lub zezwól na odpowiedzi za pomocą jednego klawisza podczas pozostania na podparciu dla czoła.
- Przygotowanie instrukcji
- Implementacja procedury eksperymentalnej
- Wybór oprogramowania do prezentacji bodźców. Skonfiguruj eksperyment przy użyciu odpowiedniego oprogramowania do prezentacji bodźców. Do prezentacji tekstu i rejestracji ruchów gałek ocznych można używać zarówno narzędzi dostarczonych przez producenta, jak i ogólnych narzędzi do projektowania eksperymentów. Przy wyborze oprogramowania weź pod uwagę dostępne integracje sprzętowe (np. natywne wsparcie dla danego eytrackera), wymagany stopień dokładności czasowej oraz preferowany poziom skryptowania w stosunku do projektowania opartego na interfejsie graficznym (GUI). Niezależnie od platformy, oprogramowanie musi zapewniać niezawodną synchronizację między zdarzeniami bodźca (np. pojawienie się słowa, pojawienie się zdania) a strumieniem danych eytrackingu, aby fiksacje i sakkady mogły zostać dopasowane do odpowiadających im elementów tekstowych podczas analizy. W przypadku korzystania z oprogramowania zewnętrznego sprawdź kompatybilność między oprogramowaniem eytrackera a oprogramowaniem zewnętrznym, zwłaszcza w zakresie wizualizacji i eksportu danych.
UWAGA: Przykłady oprogramowania: Experiment Builder (SR Research, dla systemów EyeLink) zapewnia interfejs graficzny z wbudowanym wsparciem dla kontroli dryftu, procedur kalibracji i komunikatów o zdarzeniach wysyłanych do komputera rejestrującego. Platformy open-source, takie jak PsychoPy i OpenSesame, oferują podobną funkcjonalność i są niezależne od sprzętu, ponieważ pozwalają na projektowanie prób za pomocą interfejsu graficznego lub skryptowania (np. Python w przypadku PsychoPy), kontrolę czasu prezentacji bodźców oraz definiowanie regionów zainteresowania, znanych jako Interest Areas IA lub Areas of Interest AOI, wokół słów lub linii tekstu. Czasami powiązanie wizualizacji i eksportu danych nie jest oczywiste dla badaczy na początku ich kariery, dlatego łatwiejsze może być skorzystanie z oprogramowania producenta. W konsekwencji ważnym czynnikiem przy wyborze eytrackera jest poziom wsparcia zapewniany przez różnych producentów lub społeczność programistów. - Przeprowadzenie badania pilotażowego. Przetestuj zaimplementowaną procedurę eksperymentalną i sprawdź zarejestrowane dane, aby upewnić się, że eksperyment przebiega zgodnie z oczekiwaniami. Przeprowadź badania pilotażowe w środowisku laboratoryjnym, aby upewnić się, że eksperyment działa prawidłowo, monitorując zdefiniowane kryteria sukcesu. Sprawdź zarejestrowane dane, aby potwierdzić, że wszystkie informacje niezbędne do badania są rejestrowane.
- Wybór oprogramowania do prezentacji bodźców. Skonfiguruj eksperyment przy użyciu odpowiedniego oprogramowania do prezentacji bodźców. Do prezentacji tekstu i rejestracji ruchów gałek ocznych można używać zarówno narzędzi dostarczonych przez producenta, jak i ogólnych narzędzi do projektowania eksperymentów. Przy wyborze oprogramowania weź pod uwagę dostępne integracje sprzętowe (np. natywne wsparcie dla danego eytrackera), wymagany stopień dokładności czasowej oraz preferowany poziom skryptowania w stosunku do projektowania opartego na interfejsie graficznym (GUI). Niezależnie od platformy, oprogramowanie musi zapewniać niezawodną synchronizację między zdarzeniami bodźca (np. pojawienie się słowa, pojawienie się zdania) a strumieniem danych eytrackingu, aby fiksacje i sakkady mogły zostać dopasowane do odpowiadających im elementów tekstowych podczas analizy. W przypadku korzystania z oprogramowania zewnętrznego sprawdź kompatybilność między oprogramowaniem eytrackera a oprogramowaniem zewnętrznym, zwłaszcza w zakresie wizualizacji i eksportu danych.
3. Rekrutacja i informowanie uczestników
- Wybór uczestników
- Określić wymagania dotyczące stanu wzroku. Rekrutować uczestników z prawidłowym wzrokiem lub wzrokiem skorygowanym do normy. Można dopuścić stosowanie okularów i soczewek kontaktowych, które wykazują minimalne odblaski (powłoki antyrefleksyjne, kąt monitora) zgodnie z wytycznymi producenta. Dokumentować rodzaj korekcji (okulary, soczewki kontaktowe) na potrzeby weryfikacji współzmiennych.
UWAGA: Zazwyczaj sztywne soczewki kontaktowe (które nie są już zbyt powszechne) są bardzo trudne do śledzenia. Chociaż soczewki kontaktowe nie stanowią problemu, czasami między soczewką a rogówką może powstać pęcherzyk powietrza, powodując odblaski zakłócające śledzenie. Okulary z błyszczącymi oprawkami również mogą zakłócać śledzenie. W przypadku błyszczących oprawek okularowych należy zmniejszyć obszar detekcji pola widzenia w oprogramowaniu eye-trackera. - Dokonać przesiewu uczestników na podstawie konkretnych cech indywidualnych, takich jak wiek, biegłość w czytaniu, zaplecze językowe, lateralizacja; powszechne kryteria wykluczenia i włączenia, takie jak dysleksja, dwujęzyczność lub zaburzenia czytania, mogą wpływać na dane dotyczące ruchów gałek ocznych. Dlatego, w zależności od celów badawczych, należy określić warunki, w których czytelnik jest odpowiednim uczestnikiem eksperymentu, a tym samym ustalić kryteria włączenia i wykluczenia (patrz: Dyskusja).
- Sprawdzić występowanie wad wzroku. Upewnić się, że uczestnik nie ma żadnych niekorygowalnych wad wzroku, takich jak zaćma (nawet po operacji), jaskra lub zwyrodnienie plamki żółtej.
- Sprawdzić stan neurologiczny. Upewnić się, że uczestnik nie cierpi na żadną dolegliwość, która sprawiałaby, że rejestracja ruchów gałek ocznych byłaby dla niego niekomfortowa. Większość eye-trackerów wykorzystuje diody LED/lasery bliskiej podczerwieni (NIR) lub certyfikowane oświetlenie NIR LED/VCSEL, które są uznawane za bezpieczne dla oczu. Potwierdzić certyfikację bezpieczeństwa urządzenia dla oczu (np. Klasa 1 IEC 60825-1, IEC/EN 62471 lub podobne). Poinformować uczestnika o przepisach bezpieczeństwa dotyczących sprzętu (takich jak dostępność certyfikatu CE od producenta, powszechnie znanego jako Deklaracja Zgodności UE, która jest dokumentem wystawionym przez producenta w celu potwierdzenia, że produkt jest zgodny ze wszystkimi niezbędnymi europejskimi przepisami dotyczącymi zdrowia, bezpieczeństwa i ochrony środowiska).
- Określić wymagania dotyczące stanu wzroku. Rekrutować uczestników z prawidłowym wzrokiem lub wzrokiem skorygowanym do normy. Można dopuścić stosowanie okularów i soczewek kontaktowych, które wykazują minimalne odblaski (powłoki antyrefleksyjne, kąt monitora) zgodnie z wytycznymi producenta. Dokumentować rodzaj korekcji (okulary, soczewki kontaktowe) na potrzeby weryfikacji współzmiennych.
- Zasady higieny
- Zachować środki ostrożności związane z dystansem osobistym. W razie potrzeby stosować jednorazowe rękawiczki i maseczkę, ponieważ protokoły eksperymentalne mogą wymagać zmniejszenia dystansu osobistego.
- Zdezynfekować sprzęt. Zdezynfekować podpórkę pod brodę i inne akcesoria za pomocą chusteczek nasączonych alkoholem, zgodnie z aktualnymi wytycznymi instytucjonalnymi. Należy uważać, aby nie używać chemikaliów, które mogą uszkodzić sprzęt. Sprawdzić specyfikacje producenta. Uczestnicy mogą czuć się bardziej komfortowo, jeśli czyszczenie odbywa się w ich obecności, w szczególności w przypadku podpórki pod brodę i zagłówka, myszki lub jakiejkolwiek innej części sprzętu, z którą będą mieli kontakt.
- Instruktaż uczestnika
- Poinformować uczestnika o środowisku laboratoryjnym. Zaplanować sesję instruktażu słownego, podczas której eksperymentator zapozna uczestnika ze środowiskiem laboratoryjnym i sprzętem do eye-trackingu.
- Poinformować uczestnika o eksperymencie. Przedstawić jasne wyjaśnienie kontekstu eksperymentu (cel i przybliżony czas trwania badania; powinno to zostać sprawdzone podczas badań pilotażowych), procedurę zachęty lub płatności, wkład uczestnika w eksperyment oraz jego prawo do uzyskania informacji o wynikach badania w dłuższej perspektywie. Poinformować uczestnika o zasadach postępowania podczas sesji rejestracyjnej. Poprosić uczestnika, aby starał się nie poruszać zbyt mocno głową podczas rejestracji (w przypadku braku stabilizatora głowy) lub nie odrywać brody od podpórki, wyjaśniając, że środki ostrożności te służą wysokiej jakości rejestracji danych (w przeciwnym razie uczestnicy mogą w każdej chwili przerwać eksperyment i zakończyć sesję bez podania przyczyny).
- Uzyskać świadomą zgodę. Przekazać uczestnikom dokumenty dotyczące zatwierdzenia etycznego i zgody oraz wyjaśnić je przed rozpoczęciem sesji. W przypadku osób dorosłych uzyskać pisemną świadomą zgodę po upewnieniu się, że rozumieją cel badania, przebieg oraz swoje prawa, w tym możliwość dobrowolnego udziału, prywatność danych i prawo do wycofania się. W przypadku uczestniczących osób nieletnich uzyskać pisemną zgodę rodzica lub opiekuna oraz zgodę osoby nieletniej. Przejść do kalibracji i rejestracji dopiero po wypełnieniu wszystkich wymaganych formularzy zgody. Procedury świadomej zgody różnią się znacznie w zależności od tego, czy uczestnik jest osobą dorosłą, czy nieletnią. Dlatego badacz powinien postępować zgodnie z lokalnymi wytycznymi instytucjonalnymi.
UWAGA: Jeśli podczas eksperymentu nastąpi przerwa, wymagana jest rewalidacja kalibracji; jeśli rewalidacja nie powiedzie się, wymagana jest rekalibracja.
4. Przeprowadzanie kalibracji i walidacji
- Ustawienie uczestnika i regulacja sprzętu
- Ustawienie uczestnika. Poproś uczestnika o wygodne usiądnięcie. Dostosuj krzesło/stół i/lub podpieranie brody, aby utrzymać stabilną pozycję głowy. Poinformuj uczestnika, że jest to oczekiwana pozycja głowy podczas faz kalibracji, walidacji i rejestracji.
- Regulacja sprzętu. Dostosuj sprzęt do okulografii (eye-tracking), ustawiając kamerę okulografu tak, aby źrenice uczestnika były wyraźnie widoczne i wykrywalne. Niektóre systemy okulograficzne wykonują to wyrównanie automatycznie, podczas gdy inne mogą wymagać ręcznego ustawienia ostrości kamery.
UWAGA: Eksperymentator powinien przećwiczyć regulację sprzętu i kalibrację przed rozpoczęciem rzeczywistej zbiórki danych, aby nie obciążać uczestnika tymi krokami.
- Przeprowadzenie kalibracji
- Poinformowanie uczestnika. Poinformuj uczestnika o procedurze kalibracji (np. stwierdzając, że wyświetlona zostanie seria znaczników celu i że uczestnik będzie musiał śledzić je przez około minutę).
UWAGA: Zaleca się ostrożność w doborze słownictwa podczas dokonywania regulacji. Przykładowo, eksperymentator powinien podkreślić, że procedura służy do kalibracji okulografu pod kątem uczestnika, a nie do kalibracji uczestnika pod kątem okulografu. Ponadto ważne jest zapewnienie, że sprzęt do okulografii nie rejestruje żadnego wideo/obrazu. Mimo że oko uczestnika jest widoczne, rejestrowana będzie jedynie pozycja oka przekonwertowana na współrzędne. - Uruchomienie procedury kalibracji. Poinstruuj uczestnika, aby śledził znaczniki celu i utrzymywał stałą pozycję głowy; na przykład, aby nie odchylał się do tyłu po zakończeniu procedury kalibracji. Poinstruuj uczestników, aby fiksowali wzrok na środku symbolu kalibracyjnego i nie poruszali oczami, dopóki symbol się nie przemieści. Uczestnicy mają tendencję do antycypowania ruchu symbolu, szczególnie podczas walidacji, co może zwiększyć liczbę błędów i prowadzić do niepotrzebnych kroków kalibracyjnych. Uwzględnij to wyjaśnienie w instrukcjach lub w opisie procesu kalibracji/walidacji.
UWAGA: Producenci oferują różne rodzaje symboli do procesu kalibracji (kropki, symbole przyjazne dzieciom, symbole statyczne lub kurczące się itp.) oraz różne konfiguracje kalibracji (tj. liczbę punktów kalibracyjnych). Ważne jest sprawdzenie różnic w kalibracji przy różnych konfiguracjach i wybranie tej, która najlepiej odpowiada potrzebom konkretnego badania. Na przykład, jeśli bodźce zajmują cały ekran (np. tekst z wieloma akapitami), ważne jest zastosowanie konfiguracji zapewniającej dobrą kalibrację od góry dołu, w tym w narożnikach. Jednak jeśli bodźcami są zdania prezentowane w centrum ekranu, może wystarczyć konfiguracja z mniejszą liczbą punktów. Dodatkowo, dokładność kalibracji dla współrzędnej poziomej (x) jest ważniejsza w drugim przypadku niż w pierwszym, który wymaga wysokiej dokładności zarówno w współrzędnych pionowych, jak i poziomych. - Zakończenie procedury kalibracji. Po zakończeniu procedury kalibracji poinformuj uczestnika o procedurze walidacji.
UWAGA: W przypadku uporczywego niepowodzenia kalibracji należy sprawdzić wyrównanie kamery okulografu, warunki oświetleniowe i pozycjonowanie uczestnika. U dorosłych uczestników makijaż refleksyjny, okulary lub soczewki kontaktowe mogą zakłócać śledzenie. Uspokój uczestnika, pozwól na krótkie przerwy lub powtórz kalibrację w razie potrzeby. Jeśli problemy nadal występują, rozważ ponowne uruchomienie systemu okulograficznego. Jeśli problemy nie ustąpią po restarcie systemu, a po weryfikacji parametrów konfiguracji nie znaleziono przyczyny niepowodzenia kalibracji, poinformuj uczestnika, że technologia okulograficzna nie została jeszcze wystarczająco rozwinięta i że jest to problem związany ze stanem technologii, a nie z uczestnikiem.
- Poinformowanie uczestnika. Poinformuj uczestnika o procedurze kalibracji (np. stwierdzając, że wyświetlona zostanie seria znaczników celu i że uczestnik będzie musiał śledzić je przez około minutę).
- Przeprowadzenie walidacji
- Uruchomienie procedury walidacji. Uruchom procedurę walidacji bezpośrednio po kalibracji.
- Sprawdzenie błędów. Sprawdź średni błąd pozycji spojrzenia i upewnij się, że mieści się on w dopuszczalnych granicach. Zazwyczaj pożądany jest kąt wizualny mniejszy niż 1 stopień (<1°), co odpowiada około 4 znakom (oznacza to, że 0,5 odpowiada ~2 znakom). Przeprowadź rekalibrację, jeśli błędy wykraczają poza te granice. Przykładowo: zaakceptuj kalibrację, jeśli średni błąd wynosi ≤0,5–1,0° i maksymalny błąd na punkt wynosi ≤1,5–2,0°; w przeciwnym razie przeprowadź rekalibrację. Określ częstotliwość ponownej walidacji (np. po każdym bloku lub przerwaniu). Aby zilustrować kryteria oceny jakości kalibracji producenta SR Research: błędy uznaje się za akceptowalne dla większości zadań w przypadku średniego błędu <1° i maksymalnego błędu <1,5°; za zadowalające w przypadku średniego błędu <1°-1,5° i maksymalnego błędu <1,5°-2°; i za słabe, gdy wartości te są wyższe.
- Poinformowanie uczestnika. Poinstruuj uczestnika, aby utrzymał pozycję możliwie najbardziej zbliżoną do poprzedniej i poinformuj go o rozpoczęciu sesji rejestracyjnej.
5. Gromadzenie danych
- Procedura gromadzenia danych
- Rozpoczęcie sesji nagrywania. Rozpocznij sesję nagrywania i unikaj zakłócania pracy uczestnika podczas wykonywania zadania, na przykład poprzez udzielanie instrukcji słownych.
- Monitorowanie uczestnika. Monitoruj komfort uczestnika podczas nagrywania danych. Upewnij się, że uczestnik utrzymuje stabilną postawę bez napięcia lub zmęczenia. Zwracaj uwagę na oznaki rozproszenia, suchość oczu lub dyskomfort spowodowany podparciem brody/czoła.
- Monitorowanie zapisu danych. Monitoruj jakość danych podczas nagrywania. Przeprowadź ponowną kalibrację, jeśli średni błąd walidacji lub dokładność online przekroczy 1° (lub wcześniej określony próg dokładności) lub jeśli uczestnik zmieni postawę.
- Prowadzenie dziennika. Prowadź dziennik sesji nagrywania, notując wszelkie anomalie zaobserwowane podczas eksperymentu (np. nietypowo długa procedura kalibracji lub niezamierzona przerwa podczas nagrywania) do późniejszej analizy, korzystając ze schematu dziennika sesji w celu monitorowania czasu zdarzeń, przerw, liczby wykonanych ponownych kalibracji i związanych z nimi błędów, kontroli dryftu oraz zmian oświetlenia.
- Zakończenie sesji
- Zapisywanie danych. Zapisz surowe dane dotyczące spojrzenia na koniec sesji eksperymentalnej, najlepiej stosując systematyczną metodę etykietowania sesji (np. datę eksperymentu i numer uczestnika, na przykład 25071801 lub 250718-P01 dla uczestnika 01 w dniu 18 lipca 2025 r.; unikaj używania danych osobowych uczestnika).
- Pożegnanie. Podziękuj uczestnikowi i odpowiedz na wszelkie pytania dotyczące eksperymentu; zdezynfekuj sprzęt (patrz krok 3.2.2).
- Weryfikacja danych. Sprawdź dane oraz dzienniki, aby upewnić się, że sesja została zakończona prawidłowo.
6. Przetwarzanie wstępne danych i kontrola jakości
- Eksport, organizacja i czyszczenie surowych danych
- Eksport danych. Eksportuj surowe dane o spojrzeniu w standardowym formacie (np. .csv, .tsv, .edf) i ustandaryzuj identyfikator sesji (np. 25071801 lub 250718-P01, patrz 5.2.1).
- Czyszczenie danych. Wyczyść surowe dane, stosując algorytmy wykrywania mrugnięć oraz wykrywania brakujących danych, korzystając z wbudowanych narzędzi dostarczonych przez oprogramowanie producenta lub z własnych skryptów, dostosowanych do urządzenia lub częstotliwości próbkowania.
UWAGA: Twórz kopie zapasowe surowych danych podczas uruchamiania procedur czyszczenia.
- Wykrywanie zdarzeń związanych z ruchami oczu
- Wybór algorytmu wykrywania zdarzeń związanych z ruchami oczu. Wybierz i uruchom procedury wykrywania fiksacji, dostosowując parametry algorytmów w razie potrzeby. Reprezentatywne algorytmy identyfikacji fiksacji obejmują głównie algorytmy oparte na prędkości (np. I-VT Velocity-Threshold Identification) oraz algorytmy oparte na dyspersji (np. I-DT Dispersion-Threshold Identification) i inne23. Każdy algorytm posiada własne parametry.
UWAGA: Oprogramowanie producentów zazwyczaj domyślnie zakłada konkretny algorytm i określony zestaw najczęściej stosowanych parametrów. Obowiązkiem badacza jest wybór odpowiedniego algorytmu oraz jego parametrów i opisanie ich w metodologii badania, np. progów dyspersji/prędkości, minimalnego progu czasu trwania fiksacji (np. 60 ms lub 10 ms) w celu usunięcia fiksacji krótszych od tej wartości, maksymalnego progu czasu trwania fiksacji (np. 10 ms) w celu usunięcia fiksacji dłuższych od tej wartości, zastosowanego okna wygładzania oraz reguł łączenia sąsiednich fiksacji23. - Identyfikacja nieprawidłowych fiksacji. Usuń lub oznacz fiksacje znajdujące się poza obszarem wyświetlania. Usuń lub oznacz fiksacje krótsze niż zdefiniowany próg minimalny oraz dłuższe niż zdefiniowany próg maksymalny.
- Wizualna inspekcja danych. Przeprowadź wizualną inspekcję danych za pomocą dostępnych narzędzi wizualizacyjnych, aby zapewnić poprawność danych. Sprawdź, czy nie występuje utrata sygnału, nadmierny szum, brak próbek lub przesunięcia fiksacji. Po każdej sesji nagraniowej sprawdź wizualnie dane za pomocą narzędzi wizualizacyjnych dostarczonych z oprogramowaniem do eye-trackingu (np. wykresy spojrzeń, ścieżki skanowania, przebiegi szeregów czasowych). Krok ten pozwala upewnić się, że dane są wystarczającej jakości przed przejściem do wstępnego przetwarzania i analizy.
- W szczególności sprawdź utratę sygnału i problemy z trackingiem, szukając długich przerw w wzorcach spojrzeń lub obszarów na bodźcach, w których nie zarejestrowano żadnych próbek spojrzeń. Częsta lub przedłużająca się utrata trackingu może oznaczać, że sesja powinna zostać wykluczona lub powtórzona.
- Aby sprawdzić występowanie nadmiernego szumu, przeanalizuj surowe przebiegi pozycji x/y pod kątem nagłych skoków lub błędnych próbek, które nie odpowiadają układowi bodźca. Nadmierny szum może wskazywać na słabą kalibrację, niestabilną pozycję głowy lub problemy sprzętowe.
- Aby wykryć brakujące lub nieregularne próbki, sprawdź, czy częstotliwość próbkowania jest zbliżona do oczekiwanej (np. 50 Hz) i czy występują nieoczekiwane skupiska brakujących próbek poza normalnymi mrugnięciami.
- Aby wykryć przesunięcia fiksacji, nałóż fiksacje na prezentowane bodźce i zweryfikuj, czy przypadają one na zamierzone linie i słowa. Systematyczne przesunięcia (np. fiksacje konsekwentnie poza tekstem) mogą wskazywać na dryft kalibracji lub nieprawidłowe mapowanie współrzędnych spojrzenia na współrzędne ekranu. Zarejestrowane wzorce spojrzeń powinny mniej więcej podążać za strukturą tekstu (np. progresja od lewej do prawej, linia po linii), z koncentracją fiksacji na słowach i stosunkowo płynnymi sakadami między nimi. Systematyczne odchylenie od tego wzorca lub częsta utrata użytecznych danych może wymagać wykluczenia dotkniętych danych z dalszej analizy.
- Korekcja dryftu. W razie potrzeby przeprowadź korekcję błędu dryftu pionowego. Zastosuj liniową korekcję dryftu pionowego dla tekstu wielowierszowego. Sprawdź możliwość zastosowania zwalidowanych metod21.
UWAGA: Rysunek 1 przedstawia schemat etapów projektowania konfiguracji eksperymentu eye-trackingowego oraz potoku analizy danych, zgodnie z opisem w sekcji protokołu. Następna sekcja przedstawia reprezentatywne wyniki z zarejestrowanych sesji.
- Wybór algorytmu wykrywania zdarzeń związanych z ruchami oczu. Wybierz i uruchom procedury wykrywania fiksacji, dostosowując parametry algorytmów w razie potrzeby. Reprezentatywne algorytmy identyfikacji fiksacji obejmują głównie algorytmy oparte na prędkości (np. I-VT Velocity-Threshold Identification) oraz algorytmy oparte na dyspersji (np. I-DT Dispersion-Threshold Identification) i inne23. Każdy algorytm posiada własne parametry.
Wyniki
Jakość i walidacja danych
W przypadku pomyślnych sesji dokładność walidacji zazwyczaj wykazuje średni błąd ≤0,5–1,0° oraz maksymalny błąd na punkt <1,0–1,5° dla wszystkich celów; należy raportować zarówno wartości średnie, jak i wartości dla poszczególnych punktów. Należy przedstawić histogram błędu na punkt oraz tabelę podsumowującą średnią ± SD i maksymalny błąd dla każdej sesji. Kryteria te są zgodne z powszechną praktyką i zaleceniami producentów; sesje przekraczające te progi powinny zostać częściowo lub całkowicie wykluczone, zgodnie z zasadami badania. Rycina 2 przedstawia przykładowy histogram błędu na punkt dla dokładności kalibracji w przypadku kalibracji 9-punktowej, obejmującej trzy próby kalibracji.
Precyzja i utrata danych
Należy raportować precyzję (np. RMS –Root Mean Square– rozproszenie między próbkami podczas fiksacji) oraz utratę danych (% brakujących próbek na próbę/sesję). Prawidłowo przeprowadzone próby zazwyczaj wykazują niskie rozproszenie podczas fiksacji i niską utratę danych (np. <5–10%, w zależności od sprzętu i konfiguracji systemu eyetrackingu). Należy przedstawić rozkłady procentowych wartości utraty danych oraz wykres rozrzutu precyzji względem utraty danych w poszczególnych próbach, aby zidentyfikować wartości odstające. Zaleca się sprawdzenie aktualnej literatury w zakresie definicji i minimalnych wymagań dotyczących raportowania3,4,5,6,7,8,9,10,11.
Zachowanie dryfu (przed/po korekcji)
Prawidłowe serie prób charakteryzują się niewielkimi, niemal stałymi przesunięciami pionowymi, które są znacząco redukowane przez korekcję liniową, przeprowadzaną albo za pomocą zautomatyzowanych algorytmów korekcji dryfu21, albo ręcznie. Z kolei serie problematyczne wykazują dryf nieliniowy lub duże pozostałe przesunięcia. Należy podać medianę bezwzględnego błędu pionowego przed i po korekcji. Należy sprawdzić przydatność zautomatyzowanych metod korekcji dryfu.
Rozkłady powszechnych miar czytania
Należy przedstawić rozkłady podsumowujące dla czasu trwania pierwszej fiksacji (FFD), czasu trwania pojedynczej fiksacji (SFD), czasu trwania pierwszego przejścia (FP) oraz całkowitego czasu fiksacji/czasu spojrzenia (GD), czasu przejścia dalej (go-past time), prawdopodobieństwa pominięcia (skipping probability) oraz prawdopodobieństwa regresji (regression-in probability). W przypadku sprawnego czytania tekstu alfabetycznego przez osoby dorosłe, czasy trwania fiksacji zazwyczaj koncentrują się wokół ~200–250 ms (z wyraźną asymetrią), a sakady obejmują średnio ~7–9 znaków. Wartości znacznie wykraczające poza te zakresy lub silnie bimodalne rozkłady sakad powinny zostać zweryfikowane pod kątem tego, czy wskazują one na oczekiwane sakady progresywne i regresywne wynikające z ograniczeń zadania lub trudności w przetwarzaniu, a nie na błędy pomiaru czasu. Dobór i zakres miar mogą się odpowiednio różnić w zależności od populacji, konkretnych języków i ortografii. Rysunek 3 przedstawia przykładowy protokół rozkładu czasu trwania fiksacji z reprezentatywnej sesji.
Kontrole poprawności
Zwiększenie długości słowa (długie słowa) zazwyczaj prowadzi do zmniejszenia częstości pomijania oraz dłuższego czasu fiksacji na tych słowach. Z drugiej strony, słowa funkcyjne (np. przedimki lub przyimki) są zazwyczaj pomijane. Słowa o wysokiej częstotliwości występowania oraz słowa wysoce przewidywalne na podstawie kontekstu językowego (w obrębie tekstu lub zdania) zazwyczaj skutkują krótszym czasem pierwszej fiksacji i całkowitym czasem patrzenia, a także wyższą częstością pomijania (odwrotnych efektów oczekuje się w przypadku słów o niskiej częstotliwości i niskiej przewidywalności). Należy sprawdzić, czy dane odzwierciedlają niektóre z tych wzorców, przynajmniej w jednym kierunku. Znaczne odwrócenie tych zależności może wskazywać na błędy dryftu, błędne dopasowanie słów do fiksacji lub błędy w przetwarzaniu danych.
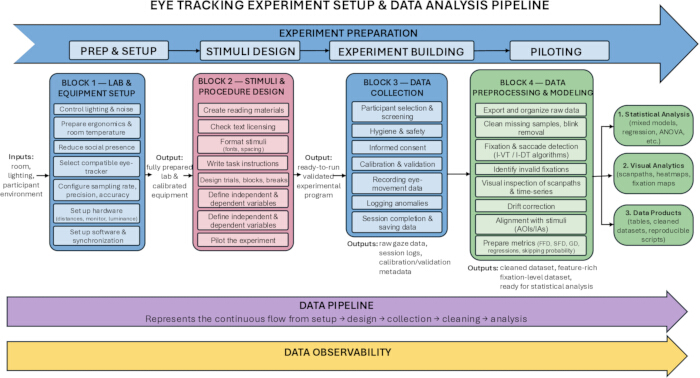
Rycina 1. Przedstawienie kroków zaangażowanych w projektowanie konfiguracji eksperymentu eye-trackingu oraz potoku analizy danych. Aby zobaczyć powiększoną wersję tej ryciny, kliknij tutaj.
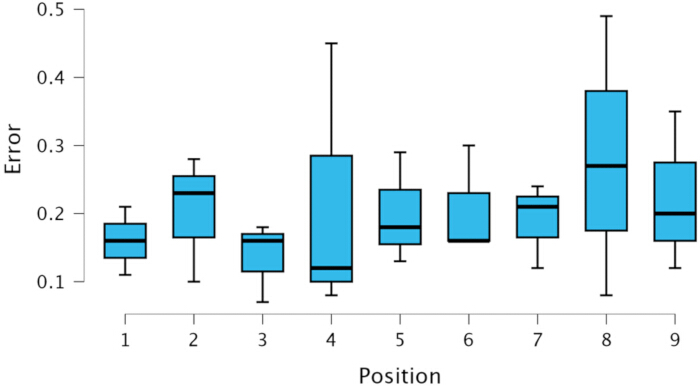
Rycina 2. Histogram błędu dla każdego punktu w odniesieniu do dokładności kalibracji dla kalibracji 9-punktowej, obejmującej trzy próby kalibracji. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
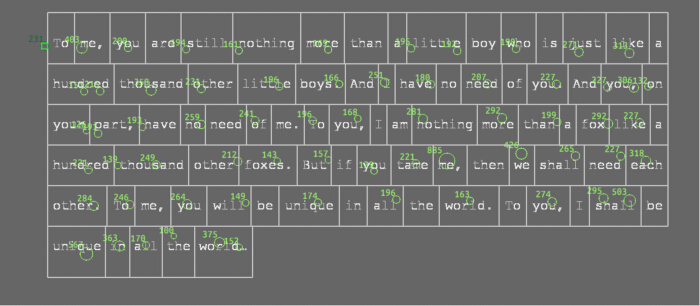
Rycina 3. Protokół rozkładu czasu trwania fiksacji z reprezentatywnej sesji; jeden uczestnik czytający fragment powieści Mały Książę. Położenie i rozmiar okręgów wskazują odpowiednio miejsca fiksacji oraz czas ich trwania. Liczby obok okręgów przedstawiają czas trwania fiksacji w ms. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Dyskusja
Przedstawiony tutaj protokół podsumowuje główne kroki niezbędne do uzyskania wiarygodnych danych z okulografii (eye-tracking) w badaniach nad czytaniem. Chociaż wiele z tych etapów może być dobrze znanych doświadczonym badaczom, często są one rozproszone w osobnych pracach metodologicznych, dokumentacji dostawców oraz nieformalnych praktykach laboratoryjnych. Poprzez zorganizowanie ich w jeden spójny proces – od przygotowania laboratorium po wstępne przetwarzanie danych – dążymy do zapewnienia praktycznego przewodnika dla badaczy, którzy rozpoczynają pracę z okulografią w badaniach nad czytaniem. W przeciwieństwie do ogólnych wytycznych dotyczących eye-trackingu lub zasobów skupiających się głównie na algorytmach wykrywania ruchów gałek ocznych, niniejszy protokół oferuje kompleksowe ramy postępowania jako odpowiedź na potrzeby badań nad czytaniem, które wymagają rejestracji danych o wysokiej rozdzielczości przestrzennej i częstotliwości próbkowania.
Centralnym motywem na wszystkich etapach procesu jest znaczenie proaktywnego zarządzania jakością danych, począwszy od kontroli środowiska i konfiguracji sprzętu. Drobne problemy, takie jak odblaski na monitorze, niestabilność krzesła czy niezmienne odległości widzenia, mogą prowadzić do systematycznych błędów w lokalizacji lub precyzji fiksacji. Wczesne wyeliminowanie tych czynników minimalizuje potrzebę szeroko zakrojonej korekty post-hoc i sprzyja bardziej spójnej dokładności walidacji (średni błąd ≤ 0,5–1°).
Protokół podkreśla również znaczenie zgodności między pytaniami badawczymi a charakterystyką sprzętu. Wiele badań nad czytaniem opiera się na precyzyjnym pomiarze przestrzennym i czasowym fiksacji, pozycji lądowania sakkad oraz regresji1,2. Wybór eyetrackera o odpowiedniej częstotliwości próbkowania, precyzji i dokładności jest zatem niezbędny, szczególnie w przypadku pomiarów takich jak pozycja lądowania czy podgląd parafovealny, które są wrażliwe na niewielkie błędy przestrzenne. W zależności od konkretnych ograniczeń badania metody te można modyfikować. Na przykład podczas pracy z populacjami neuroatypowymi, które nie tolerują podpórki pod brodę, badacze mogą przejść na zdalne trackery bez stabilizacji głowy i zrekompensować utratę precyzji przestrzennej, stosując większe czcionki, szersze odstępy między wierszami i szersze Obszary Zainteresowania (Interest Areas). Przy użyciu systemów bez stabilizacji głowy badacze muszą uwzględnić zwiększoną ruchliwość i potencjalną utratę danych. Chociaż zdalne trackery umożliwiają bardziej naturalne ustawienia, stabilizacja głowy pozostaje obecnie preferowanym rozwiązaniem dla większości zadań związanych z czytaniem.
Projekt eksperymentu jest kolejnym kluczowym czynnikiem wpływającym zarówno na jakość danych, jak i ich interpretowalność. Standaryzowane instrukcje wyświetlane na ekranie, randomizacja prób oraz odpowiednia struktura blokowa pomagają utrzymać stabilne zachowanie uczestników podczas całej sesji. Wprowadzenie kontroli dryftu w regularnych odstępach czasu jest szczególnie istotne w eksperymentach dotyczących czytania, ponieważ nawet niewielkie, stopniowe przesunięcia mogą kumulować się w kolejnych liniach tekstu. Protokół ten wspiera również stosowanie zależnych od języka norm leksykalnych oraz przejrzyste raportowanie zmiennych niezależnych i zależnych, co ułatwia replikację i porównywanie wyników między badaniami.
Podczas zbierania danych ciągłe monitorowanie dokładności, postawy i komfortu uczestnika pomaga zapobiegać znacznej utracie danych. Często konieczne jest aktywne rozwiązywanie typowych problemów. Na przykład, jeśli kalibracja zawiedzie w rogach ekranu, dostosowanie monitora lub wysokości krzesła może wyeliminować utratę śledzenia peryferyjnego. Problemy wynikające z odblasków okularów lub soczewek kontaktowych można czasem rozwiązać poprzez regulację oświetlenia otoczenia lub zmianę kąta ustawienia monitora. Prowadzenie szczegółowego dziennika sesji ułatwia późniejszą analizę błędów i zwiększa przejrzystość poprzez dokumentowanie przerw, rekalibracji i nieoczekiwanych zdarzeń. Jest to coraz bardziej istotne, ponieważ wiele publikowanych obecnie badań wymaga wyraźnego raportowania metryk jakości, w tym precyzji oraz procentowej utraty danych.
Sekcja preprocessingu kładzie nacisk na spójne i dobrze udokumentowane wybory w zakresie detekcji zdarzeń, korekcji dryftu oraz procedur czyszczenia danych. Ponieważ algorytmy i progi klasyfikacji fiksacji mogą silnie wpływać na wynikowe miary, badacze powinni określić wszystkie ustawienia parametrów i uzasadnić je w przypadku, gdy różnią się one od powszechnych ustawień domyślnych. Inspekcja wizualna pozostaje krytycznym krokiem, nawet w sytuacjach, gdy stosowane są narzędzia zautomatyzowane. Protokół zachęca również do raportowania standardowych wskaźników jakości, takich jak dokładność walidacji, precyzja, utrata danych oraz charakterystyka dryftu, aby badania można było porównywać w sposób bardziej wiarygodny.
Ponadto protokół zaleca proste testy spójności zachowań podczas czytania, takie jak wpływ długości słowa, jego częstotliwości występowania lub przewidywalności. Powielenie tych kanonicznych wzorców stanowi dodatkowe zabezpieczenie przed niezauważonymi problemami z dopasowaniem danych, problematycznym dryftem lub błędami w przetwarzaniu wstępnym. Kontrole te nie zastępują pełnej analizy statystycznej, lecz oferują szybką informację zwrotną na temat tego, czy dane zachowują się zgodnie z oczekiwaniami w przypadku sprawnego czytania.
Oprócz wspomnianych już szczegółów protokołu eksperymentalnego ważne jest opisanie cech językowych i psychometrycznych uczestników. Głównym uzasadnieniem tego wymogu jest wyzwanie, przed którym stają badacze eksperymentalni w kwestii porównywalności różnych badań. Jest to szczególnie istotne w erze otwartej nauki, w której publicznie dostępne zestawy danych mogą być wykorzystywane przez badaczy, którzy nie gromadzili pierwotnie tych danych, a w związku z tym mogą nie być świadomi potencjalnych specyficznych cech wynikających z różnic w (socjo)lingwistycznym pochodzeniu uczestników.
W odniesieniu do tła językowego należy odnotować język ojczysty uczestników oraz zebrać informacje o używanych przez nich dialektach, aby uwzględnić wszelkie różnice dialektalne, które mogą wpłynąć na wyniki. Jeśli uczestnicy posługują się więcej niż jednym językiem – co jest powszechną sytuacją w dzisiejszym świecie – należy zarejestrować poziom biegłości w drugim języku. W badaniach nad dwujęzycznością lub przetwarzaniem drugiego języka biegłość w tym języku powinna być oceniana przy użyciu zwalidowanych testów poziomujących. Dodatkowo można zarejestrować istotne aspekty statusu socjoekonomicznego (np. nawyki czytelnicze uczestników).
Należy przeprowadzić testy w celu oceny charakterystyki psychometrycznej uczestników, takiej jak pojemność pamięci roboczej i elastyczność poznawcza (szczególnie w badaniach nad osobami dwujęzycznymi). Z perspektywy metodologicznej należy rozważyć, które testy wybrać, jakie są ich wymagania poznawcze i czasowe, oraz kiedy przeprowadzić te pomiary w ramach protokołu eksperymentalnego – czy przed, po sesji eye-trackingu, czy w oddzielnej sesji.
Należy pamiętać, że w badaniach nad czytaniem zachowania językowe są mierzone i wyjaśniane z wykorzystaniem zarówno cech lingwistycznych bodźca, jak i cech psychometrycznych czytelników (lub wszelkich innych cech istotnych dla zachowań językowych uczestników)1,12,17,20. Aby umożliwić porównywanie wyników między różnymi badaniami, należy uwzględnić wszystkie czynniki, które mogą mieć znaczenie dla interpretacji danych. Wybór cech do uwzględnienia będzie zależał od celu badania. Dane muszą być porównywalne. Podsumowując, dane powinny być gromadzone i opisane w stopniu wystarczająco szczegółowym, aby zapewnić potencjalnemu użytkownikowi jak największą elastyczność w ich wykorzystaniu. Rozważania te mogą nie być częścią samego protokołu, ale są istotne dla każdego indywidualnego badania. W dzisiejszym globalnym środowisku naukowym takie szczegóły zwiększają potencjał przyszłego wykorzystania zgromadzonych danych.
Niniejszy protokół posiada pewne ograniczenia, z których najważniejszym jest kompromis między jakością danych a trafnością ekologiczną, ponieważ czytanie na statycznym monitorze przy unieruchomionej głowie nie oddaje w pełni naturalnych zachowań podczas czytania, a rygorystyczne kryteria włączenia wizualnego mogą ograniczać reprezentatywność próby. Ponadto okulary do okulografii (eye trackery) różnią się znacząco pod względem skalowania współrzędnych, precyzji znaczników czasu oraz klasyfikacji zdarzeń. Ograniczeniem obecnego protokołu jest brak wyjaśnienia, w jaki sposób ta zmienność wpływa na powtarzalność wyników pomiędzy różnymi laboratoriami lub markami sprzętu. Stworzenie wytycznych dotyczących walidacji międzyurządzeniowej oraz realistycznych przyszłych zastosowań, takich jak adaptacja paradygmatów laboratoryjnych do immersyjnych środowisk czytania wirtualnej rzeczywistości (Virtual Reality) lub rozszerzonej rzeczywistości (Augmented Reality), a także opracowanie cyfrowych biomarkerów zaburzeń poznawczych lub uwagi, pozwoliłoby wypełnić istotną lukę.
Podsumowując, protokół ten konsoliduje istniejące wytyczne metodologiczne w przejrzysty i transparentny schemat postępowania w celu gromadzenia wysokiej jakości danych z okulografii w badaniach nad czytaniem. Przestrzegając tych kroków i raportując powiązane wskaźniki jakości, badacze mogą poprawić odtwarzalność i wiarygodność badań nad czytaniem oraz pomóc w ustanowieniu większej spójności metodologicznej w całej dziedzinie.
Podziękowania
Finansowanie: Projekt ten był wspierany przez COST–European Cooperation in Science and Technology (CA2131–Enabling multilingual eye-tracking data collection for human and machine language processing research (MultiplEYE), https://www.cost.eu/actions/CA2131)24, The Foundation for Science and Technology, Portugalia (granty: UID/214/2025, UI/BD/15450/2022) oraz Strategiczny Program Inicjatywy Doskonałości Uniwersytetu Jagiellońskiego w obszarze priorytetowych badań DigiWorld (ID.UJ) w ramach projektu „Cognitive Aspects of Interaction and Communication in Natural and Artificial Agents”. Dziękujemy Annie Marii Wilkosz za pomoc techniczną.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Chusteczki nasączone alkoholem (70% isopropyl) | Materiał do czyszczenia | Lokalny dostawca laboratoryjny | |
| Podpórka pod brodę z regulacją wysokości | Urządzenie do stabilizacji głowy | Różni dostawcy laboratoryjni | |
| Formularz zgody i materiały do debriefingu | Dokumentacja | Zatwierdzone instytucjonalnie szablony | |
| Okulograf (np. SR Research EyeLink 10 Plus, Tobii Pro Fusion) | Sprzęt do okulografii | SR Research Ltd., Tobii AB | |
| Oprogramowanie do analizy danych okulograficznych (Data Viewer, Tobii Pro Lab) | Oprogramowanie do analizy danych o ruchach gałek ocznych | SR Research Ltd., Tobii AB | |
| Oprogramowanie do okulografii (np. Experiment Builder, Tobii Pro Lab, PsychoPy) oraz powiązane SDK | Oprogramowanie do prezentacji bodźców i zestawy narzędzi programistycznych | SR Research Ltd., Tobii AB, Open source | |
| Ogólne oprogramowanie do analizy danych (R z lme4, ggplot2, JASP, Python z Pandas, NumPy, Matplotlib) | Preprocessing i analiza danych | Open source, https://www.python.org, https://www.r-project.org, https://www.jasp.org | |
| Ogólne oprogramowanie do projektowania eksperymentów (PsychoPy) | Oprogramowanie do prezentacji bodźców | Open source, https://www.psychopy.org | |
| Inne oprogramowanie zewnętrzne (np. E-Prime) | Oprogramowanie do prezentacji bodźców | Psychology Software Tools, Inc. | |
| Pomieszczenie wygłuszone | Kontrola środowiska | Zaplecze instytucjonalne | |
| Standardowy monitor LCD 24 cale (lub mniejszy) | Urządzenie wyświetlające | Dowolny producent zgodny z normami ISO |
Bibliografia
- Rayner, K. Eye movements in reading and information processing: 20 years of research. Psychol Bull. 124, 372-422 (1998).
- Rayner, K. Eye movements and attention in reading, scene perception, and visual search. Q J Exp Psychol. 62, 1457-1506 (2009).
- Carter, B. T., Luke, S. G. Best practices in eye tracking research. Behav Res Methods. 52, 278-295 (2020).
- Hessels, R. S., et al. The fundamentals of eye tracking part 1: The link between theory and research question. Behav Res Methods. 56, 16(2024).
- Hooge, I. T. C., et al. The fundamentals of eye tracking part 2: From research question to operationalization. Behav Res Methods. 57, 73(2025).
- Nyström, M., et al. The fundamentals of eye tracking part 3: How to choose an eye tracker. Behav Res Methods. 57, 67(2025).
- Niehorster, D. C., et al. The fundamentals of eye tracking part 4: Tools for conducting an eye tracking study. Behav Res Methods. 57, 46(2025).
- Hessels, R. S., et al. The fundamentals of eye tracking part 5: The importance of piloting. Behav Res Methods. 57, 216(2025).
- Dunn, M. J., et al. Minimal reporting guideline for research involving eye tracking (2023 edition). Behav Res Methods. 56, 4351-4357 (2024).
- Eskenazi, M. A. Best practices for cleaning eye movement data in reading research. Behav Res Methods. 56, 2083-2093 (2024).
- Schotter, E. R., Dillon, B. A beginner’s guide to eye tracking for psycholinguistic studies of reading. Behav Res Methods. 57, 68(2025).
- Conklin, K., Pellicer-Sánchez, A. Using eye tracking in applied linguistics and second language research. Second Lang Res. 32 (3), 453-468 (2016).
- Pellicer-Sánchez, A. Eye-tracking in vocabulary research: Introduction to the special issue. Res Methods Appl Linguist. 3 (1), 100095(2024).
- Hutton, S. B. Eye-tracking methodology. Eye movement research: An introduction to its scientific foundations and applications. , Springer International Publishing. 277-308 (2019).
- Pokhoday, M. Y., et al. Eye tracking methods in psycholinguistics and parallel EEG recording. Neurosci Behav Physi. 53, 220-229 (2023).
- Azman, H., Mihat, W., Soh, O. K. Analyzing stimuli presentations and exit-interview protocols to improve wearable eye-tracking data collection guidelines for reading research. IJCALLT. 11 (2), 51-65 (2021).
- Papadopoulos, T. C., et al. Eye-tracking in reading research: A systematic review of studies with children of varying reading ability. Eur Psychol. , (2026).
- Garlichs, A., Lustig, M., Gamer, M., Blank, H. Protocol to study how expectations guide predictive eye movements and information sampling in humans. STAR Protoc. 6 (2), 103737(2025).
- Moreno, J., León, J., Kaakinen, J. K., Hyönä, Relevance instructions combined with elaborative interrogation facilitate strategic reading: Evidence from eye movements. J Psicol Educ. 27 (1), 51-65 (2020).
- Acartürk, C. Eyes on Text: Eye movements in reading and language processing. , John Benjamins. (2025).
- Steinhauer, S. R., Bradley, M. M., Siegle, G. J., Roecklein, K. A., Dix, A. Publication guidelines and recommendations for pupillary measurement in psychophysiological studies. Psychophysiology. 59 (4), e14035(2022).
- Papesh, M. H., Goldinger, S. D. Modern pupillometry: Cognition, neuroscience, and practical applications. , Springer. (2024).
- Salvucci, D. D., Goldberg, J. H. Identifying fixations and saccades in eye-tracking protocols. Proc Symposium Eye Tracking Res Appl, , 71-78 (2000).
- Jakobi, D. N., et al. MultiplEYE: creating a multilingual eye-tracking-while-reading corpus. Proc Symposium Eye Tracking Res Appl, , ACM. 111(2025).