Niniejsza praca proponuje metodę monitorowania bezpieczeństwa linii produkcyjnej integrującą algorytm You Only Look Once w wersji 11 (YOLOv11) z konwolucyjnymi sieciami neuronowymi. Osiągnięto średnią precyzję przy progu nakładania się obszarów 0,5 (mAP@0.5) na poziomie 0,91, mAP@0.5:0.95 na poziomie 0,82 oraz wydajność 120 klatek na sekundę przy użyciu jednostki przetwarzania graficznego, co przewyższa wyniki ewaluowanych modeli bazowych.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Monitorowanie bezpieczeństwa linii produkcyjnej w czasie rzeczywistym z wykorzystaniem detekcji obiektów opartej na głębokim uczeniu i wzmacnianiu cech
W tym artykule
Podsumowanie
Streszczenie
Wraz z rozwojem Przemysłu 4.0 poziom automatyzacji i inteligentnego sterowania linii produkcyjnych uległ znaczącej poprawie, co zwiększyło wymagania dotyczące wydajności w czasie rzeczywistym, dokładności i bezpieczeństwa monitoringu. Tradycyjne systemy monitorowania, opierające się na inspekcjach manualnych lub prostych decyzjach opartych na progach, charakteryzują się zazwyczaj powolnym czasem reakcji, wysoką częstotliwością fałszywych alarmów i ograniczoną inteligencją. W związku z tym w niniejszej pracy zaproponowano system monitorowania bezpieczeństwa linii produkcyjnej, który integruje model You Only Look Once w wersji 11 (YOLOv11) z konwolucyjną siecią neuronową (CNN). W pierwszej kolejności poddano wstępnej obróbce pozyskane obrazy. Następnie wykorzystano YOLOv11 do identyfikacji pracowników, urządzeń i potencjalnych zagrożeń w czasie rzeczywistym. Kolejno wprowadzono ulepszoną sieć CNN z wieloskalową fuzją cech oraz mechanizmami uwagi, aby poprawić możliwości ekstrakcji cech dla małych i przesłoniętych obiektów. Na koniec wyniki detekcji połączono z cechami wzmocnionymi przez CNN w celu oceny stanu bezpieczeństwa. Eksperymenty przeprowadzono z wykorzystaniem własnego zbioru danych dotyczących bezpieczeństwa linii produkcyjnej, stosując optymalizator stochastycznego spadku gradientu (SGD) z pędem (momentum) 0,9, początkową prędkością uczenia 0,01, zanikaniem wag (weight decay) 0,0005, korektą prędkości uczenia metodą cosinusową (cosine-annealed), rozmiarem partii 32 oraz trenowaniem przez 200 epok. Jako metryki ewaluacyjne do porównania z analizowanymi algorytmami bazowymi wykorzystano mAP@0.5 oraz prędkość detekcji wyrażoną w klatkach na sekundę (FPS). Wyniki pokazują, że zaproponowany system osiągnął mAP@0.5 na poziomie 0,91 oraz prędkość detekcji 120 FPS. Wykazał on również stabilną wydajność w złożonych warunkach, takich jak zacienienie i zmienne oświetlenie, co potwierdza jego skuteczność i potencjał praktycznego zastosowania w monitorowaniu bezpieczeństwa linii produkcyjnych.
Wprowadzenie
W nowoczesnej produkcji przemysłowej bezpieczeństwo jest fundamentem zapewnienia wydajności produkcji oraz dobrostanu personelu. Środowisko linii produkcyjnej zazwyczaj obejmuje szybkie urządzenia mechaniczne, złożone procesy technologiczne oraz operacje kooperacyjne angażujące wiele zadań. Każde niewielkie potencjalne zagrożenie bezpieczeństwa może doprowadzić do poważnych wypadków produkcyjnych, skutkujących znacznymi stratami ekonomicznymi, a nawetThough ofiatarami. Dlatego kluczowe jest ustanowienie wydajnego, inteligentnego i działającego w czasie rzeczywistym systemu monitorowania bezpieczeństwa, aby zwiększyć poziom bezpieczeństwa w produkcji przemysłowej1,2.
Tradycyjne metody monitorowania bezpieczeństwa opierają się głównie na ręcznym nadzorze wideo oraz różnych czujnikach (takich jak czujniki podczerwieni, dymu i wibracji)3. Monitorowanie ręczne jest nie tylko nieefektywne, ale również podatne na pominięcia w detekcji z powodu zmęczenia personelu nadzorującego i nie zapewnia ciągłego oraz kompleksowego pokrycia obszarem. Choć czujniki mogą pełnić określoną funkcję wczesnego ostrzegania, ich zasięg detekcji jest ograniczony i są one wrażliwe na zakłócenia środowiskowe, co prowadzi do istotnych problemów z fałszywymi alarmami4. Inteligentne systemy monitorowania stają się coraz ważniejszym obszarem badań. Analiza strumienia wideo w czasie rzeczywistym z wykorzystaniem algorytmu głębokiego uczenia pozwala na automatyczną identyfikację nieprawidłowych zdarzeń, niebezpiecznych zachowań i potencjalnych zagrożeń, co znacznie zwiększa inteligentność systemu monitorowania4,5.
Detekcja obiektów jest kluczową technologią w inteligentnym monitoringu. Algorytmy z serii You Only Look Once (YOLO), będące reprezentantami jednowarstwowych detektorów obiektów, wykazują znaczące zalety. Od YOLOv1 do YOLOv8 zbiór tych algorytmów podlegał ciągłemu rozwojowi, obejmującemu między innymi ulepszenia w architekturze sieci, funkcji straty oraz metodologii treningu6,7. W szczególności YOLOv11 osiągnął wyższą dokładność detekcji przy zachowaniu wysokiej liczby klatek na sekundę, zwłaszcza w przypadku złożonego tła i gęsto rozmieszczonych celów8.
Jednakże, pomimo doskonałych wyników w ogólnych zadaniach detekcji obiektów, YOLOv11 wciąż napotyka trudności w specyficznych scenariuszach monitorowania bezpieczeństwa na liniach produkcyjnych9. Na przykład dokładność detekcji YOLOv11 może spaść, gdy pracownicy są częściowo zasłonięci przez urządzenia lub gdy znaki bezpieczeństwa są małe i ściśle przypominają kolor tła. Wymaga to od modelu silniejszych możliwości ekstrakcji cech oraz zrozumienia semantycznego10.
Splotowe sieci neuronowe (CNN) posiadają potężne możliwości w zakresie ekstrakcji cech obrazu11. Dzięki projektowaniu głębszych i bardziej złożonych architektur sieci, CNN mogą uczyć się bogatszych i bardziej abstrakcyjnych cech obrazu. Połączenie CNN z YOLOv11 pozwala wykorzystać szybkie możliwości detekcji YOLOv11 oraz głęboką ekstrakcję cech CNN, co umożliwia budowę bardziej wytrzymałego i inteligentnego systemu monitorowania bezpieczeństwa.
W związku z powyższym, niniejsza praca proponuje system monitorowania bezpieczeństwa linii produkcyjnej z wykorzystaniem YOLOv11 oraz sieci CNN. Innowacyjne aspekty niniejszego badania obejmują: (1) zaproponowanie architektury głębokiej fuzji YOLOv11 i ulepszonej sieci CNN; (2) wprowadzenie wieloskalowej fuzji cech oraz złożonego mechanizmu uwagi w celu usprawnienia rozpoznawania kluczowych cech bezpieczeństwa; oraz (3) weryfikację przewagi wydajności modelu na bazie własnego zbioru danych z kompleksowych scen.
Rozwój algorytmów z serii YOLO
Od momentu ich pierwszego wprowadzenia przez Redmona i współpracowników w 2015 roku12, algorytm You Only Look Once (YOLO) wzbudził znaczne zainteresowanie. W przeciwieństwie do detektorów dwuetapowych, które opierają się na propozycjach regionów, YOLO traktuje detekcję obiektów jako zadanie regresji. Poprzez bezpośrednie przewidywanie klas i pozycji obiektów na obrazie, YOLO znacząco zwiększa prędkość detekcji, co czyni go odpowiednim do zastosowań w czasie rzeczywistym13.
Jako pionierska praca w tej serii, YOLOv1 po raz pierwszy umożliwia detekcję obiektów w systemie end-to-end14. YOLOv1 polega na podziale obrazu wejściowego na strukturę siatki, w której każda komórka siatki, zazwyczaj ułożona w formacie S × S, odpowiada za wykrywanie obiektów znajdujących się w jej granicach.
Konkretnie, wynikiem YOLOv1 jest tensor. W ramach S × S × (B × 5 + C), predykcja każdego pola ograniczającego (bounding box) zawiera 5 elementów: współrzędne punktu centralnego (x,y), szerokość w, wysokość h oraz pewność c. Proces obliczeniowy zilustrowano w równaniu (1):
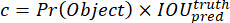 (1)
Wśród nich, Pr(Object) reprezentuje prawdopodobieństwo występowania celu w siatce, a IOU oznacza stosunek części wspólnej do sumy obszarów (intersection over union) między przewidzianym prostokątem ograniczającym a prostokątem rzeczywistym (ground-truth). Każda komórka siatki przewiduje również zestaw prawdopodobieństw klas, Pr reprezentujących prawdopodobieństwo, że cel należy do i-tej klasy w przypadku obecności celu. Funkcja straty YOLOv1 składa się z trzech głównych komponentów: straty dla predykcji współrzędnych, straty dla szacowania pewności oraz straty dla predykcji kategorii15.
YOLOv2 wprowadza normalizację wsadową (Batch Normalization), klasyfikator o wysokiej rozdzielczości oraz strategię trenowania wieloskalowego, co poprawia stabilność i dokładność16. YOLOv3 wykorzystuje sieć Darknet-53 jako sieć szkieletową (backbone) i czerpie inspirację z koncepcji sieci piramidalnej cech (Feature Pyramid Network, FPN), aby usprawnić detekcję obiektów17.
YOLOv4 wprowadził liczne optymalizacje w stosunku do YOLOv3, implementując takie technologie jak Cross Stage Partial Network (CSPNet)18, Path Aggregation Network (PANet)19 oraz wzbogacanie danych metodą Mosaic, aby dodatkowo poprawić wydajność modelu. YOLOv5 wniósł istotny wkład w obszarze inżynieryjnym, oferując łatwiejszą w obsłudze i bardziej efektywną implementację20.
W ostatnich latach seria YOLO stale ewoluuje, a kolejne wersje, takie jak YOLOv6, YOLOv7 i YOLOv8, są wydawane jedna po drugiej. Dzięki wprowadzeniu struktury Extended Efficient Layer Aggregation Network (E-ELAN) oraz technik reparametryzacji modelu, YOLOv7 osiąga nowe przełomy zarówno w zakresie szybkości, jak i dokładności. Udoskonalenia te nie tylko poprawiają efektywność uczenia cech, ale także optymalizują wydajność wnioskowania sieci, co pozwala YOLOv7 przewyższyć poprzednie wersje oraz wiele głównych detektorów w różnych zadaniach detekcji obiektów w czasie rzeczywistym. YOLOv8 dodatkowo optymalizuje strukturę sieci, przyjmuje konstrukcję anchor-free, upraszcza model i poprawia jego zdolność do generalizacji21.
Opierając się na zaletach poprzednich wersji, YOLOv11, wykorzystane w niniejszym badaniu, zostało zoptymalizowane pod kątem złożonych scenariuszy przemysłowych. Główne ulepszenia obejmują sieć ekstrakcji cech, bardziej wydajny moduł fuzji cech oraz bardziej odporną konstrukcję funkcji straty. Udoskonalenia te pozwalają YOLOv11 na lepsze radzenie sobie z przesłonami, małymi celami i złożonym tłem w środowiskach produkcyjnych. YOLOv11 to wersja z serii YOLO wydana przez Ultralytics. W porównaniu z YOLOv8 udoskonalono moduł C3K2 oraz ścieżkę fuzji cech, a także wprowadzono strategię adaptacyjnych ramek zakotwiczenia (anchor boxes), co zapewnia większą odporność detekcji w scenariuszach przemysłowych.
Podstawy i rozwój splotowych sieci neuronowych (CNN)
Splotowa sieć neuronowa (CNN) to kluczowy model, który w znacznym stopniu wpłynął na sukces głębokiego uczenia w dziedzinie komputerowego rozpoznawania obrazów. Działa ona poprzez wyodrębnianie lokalnych cech obrazu za pomocą operacji splotu, a następnie redukcję wymiarowości cech poprzez operacje poolingu, osiągając w ten sposób hierarchiczną abstrakcję obrazu22.
Typowa sieć CNN składa się z wielu warstw splotowych, warstw poolingowych oraz warstw w pełni połączonych. Warstwa splotowa skanuje obraz wejściowy za pomocą jądra splotu, oblicza iloczyny skalarne w obszarach lokalnych i generuje mapę cech. Proces obliczeniowy przedstawiono w równaniu (2):
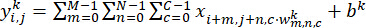 (2)
Gdzie x to obraz wejściowy, wk i bk to odpowiednio waga i obciążenie (bias) jądra splotu, a  to wartości wyjściowej mapy cech w pozycji (i,j). W warstwie poolingu zazwyczaj stosuje się Max Pooling lub Average Pooling. Warstwa w pełni połączona odpowiada za ekstrakcję cech i przewidywanie prawdopodobieństw klasyfikacji.
Na tej podstawie w niniejszej pracy zaprojektowano moduł wzmacniania cech CNN dla modelu YOLOv11, który składa się z dwóch równoległych gałęzi: gałęzi konwolucji wieloskalowej, wykorzystującej jądra splotu 3 × 3 oraz 5 × 5 do ekstrakcji cech w różnych skalach, oraz gałęzi uwagi, która sekwencyjnie łączy moduły uwagi kanałowej (Squeeze-and-Excitation) i uwagi przestrzennej w celu wzmocnienia cech dyskryminacyjnych kluczowych obiektów. Wyniki obu gałęzi są łączone poprzez dodawanie elementowe, a odpowiadająca im funkcja straty wzmocnienia cech przedstawiona jest w formule (3):
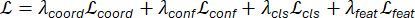 (3)
Lwspółrzędne jest to strata regresji współrzędnych ramki ograniczającej; Lkonfiguracja celową stratą pewności; Lcls jest to strata klasyfikacji kategorii; Lcecha jest to strata wzmocnienia cech, stosowana w celu ograniczenia cech dyskryminacyjnych małych i przysłoniętych celów wyekstrahowanych przez moduł wzmocnienia CNN; λwspółrzędne, λkonfiguracja, λwyczyść ekran, λcecha są współczynnikami wagowymi odpowiadających im składników funkcji straty. Dla tego zadania λcecha ustawiono wartość 0,05, a pozostałe wagi zrównoważono zgodnie z wymaganiami zadania detekcji.
Klasyczne struktury CNN, takie jak VGGNet23 i ResNet24, odniosły wielki sukces w zadaniach klasyfikacji obrazów. Wśród tych architektur ResNet skutecznie łagodzi problem zanikającego gradientu podczas trenowania głębokich sieci, co ułatwia konstruowanie głębszych i bardziej złożonych struktur sieciowych.
W zadaniach detekcji obiektów sieci CNN są zazwyczaj wykorzystywane jako ekstraktory cech (backbone). Na przykład Darknet, cross-stage partial Darknet (CSPDarknet) i inne w serii algorytmów YOLO są oparte na sieciach CNN25. Aby zwiększyć możliwości ekstrakcji cech, badacze zaproponowali liczne ulepszone struktury CNN. Przykładowo, moduł Inception ekstrahuje cechy równolegle za pomocą wieloskalowych jąder splotowych. DenseNet zwiększa ponowne wykorzystanie cech dzięki gęstym połączeniom. Sieć Squeeze-and-Excitation adaptacyjnie dostosowuje istotność kanałów cech za pomocą mechanizmów uwagi26.
W niniejszym badaniu zaprojektowano ulepszony moduł CNN w celu zwiększenia możliwości ekstrakcji cech modelu YOLOv11. Moduł ten łączy wieloskalową fuzję cech z mechanizmem uwagi, aby skuteczniej wychwytywać kluczowe informacje dotyczące bezpieczeństwa w scenariuszach linii produkcyjnych.
Zastosowanie głębokiego uczenia w monitorowaniu bezpieczeństwa przemysłowego
Głębokie uczenie zyskało znaczną popularność w monitorowaniu bezpieczeństwa przemysłowego. Algorytmy oparte na sieciach CNN są wykorzystywane do określania, czy pracownicy prawidłowo noszą kaski ochronne, wykrywania nieautoryzowanych wtargnięć do stref niebezpiecznych oraz monitorowania stanu urządzeń ulegających awarii27.
W zakresie rozpoznawania zachowań stosuje się trójwymiarowe konwolucyjne sieci neuronowe (3D CNN) oraz rekurencyjne sieci neuronowe do analizy zachowań operacyjnych pracowników i identyfikacji potencjalnie niebezpiecznych działań. Na przykład poprzez analizę sekwencji postaw pracowników można ustalić, czy naruszają oni procedury bezpiecznej eksploatacji28.
YOLO i Faster R-CNN są szeroko stosowane do wykrywania personelu i sprzętu w materiałach wideo z nadzoru w czasie rzeczywistym. Na przykład w literaturze zaproponowano system wykrywania kasków w czasie rzeczywistym oparty na YOLOv5, który skutecznie zwiększa poziom inteligentnego zarządzania bezpieczeństwem na placach budowy29.
Mimo postępów poczynionych w dotychczasowych badaniach, nadal pozostaje kilka wyzwań. Po pierwsze, sceny przemysłowe zazwyczaj charakteryzują się złożonym oświetleniem, przesłonięciami oraz zakłóceniami tła, co stawia rygorystyczne wymagania w zakresie odporności algorytmu. Po drugie, kluczowym wymogiem jest wydajność w czasie rzeczywistym, a algorytm musi zapewniać szybką inferencję przy jednoczesnym zachowaniu dokładności. Wreszcie, istniejące badania koncentrują się głównie na detekcji jednozadaniowej i brakuje w nich eksploracji fuzji informacji z wielu źródeł oraz analizy kompleksowej30.
W niniejszym badaniu zaproponowany model fuzji YOLOv11 i CNN ma na celu rozwiązanie powyższych problemów oraz zapewnienie kompleksowego monitorowania ryzyk związanych z bezpieczeństwem linii produkcyjnej w czasie rzeczywistym poprzez usprawnienie możliwości ekstrakcji i fuzji cech.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Algorytm YOLOv11 i CNN
Ogólna architektura systemu
Zaproponowany w niniejszej pracy system monitorowania bezpieczeństwa linii produkcyjnej wykorzystuje architekturę hybrydową, łączącą model YOLOv11 z ulepszoną siecią CNN, aby zapewnić wysokoprecyzyjne i szybkie monitorowanie bezpieczeństwa w czasie rzeczywistym. Jak pokazano w Rycina 1System składa się głównie z modułu wstępnego przetwarzania danych wejściowych, modułu detekcji obiektów YOLOv11, modułu wzmacniania cech CNN oraz modułu decyzji fuzyjnej. Obraz wejściowy jest najpierw normalizowany i augmentowany przez moduł wstępnego przetwarzania w celu poprawy zdolności do generalizacji modelu. Następnie cechy są ekstrahowane przez główną sieć (backbone) CSPDarknet, a pole recepcyjne jest rozszerzane przez moduł szybkiego próbkowania piramidalnego (SPPF). Cechy wieloskalowe są łączone po operacji nadpróbkowania, a do połączonych cech sekwencyjnie stosowana jest uwaga kanałowa i uwaga przestrzenna, aby dodatkowo wzmocnić reprezentację dyskryminacyjną kluczowych celów. Moduł wzmacniania cech CNN został wstawiony po wyjściach warstw C3, C4 i C5 sieci głównej YOLOv11, przyjmując wieloskalowe mapy cech o rozmiarach odpowiednio 80 × 80 × 256, 40 × 40 × 512 oraz 20 × 20 × 1 024. Moduł wzmacniania cech CNN dodatkowo usprawnia ekstrakcję cech dla obiektów małych i przesłoniętych. Na koniec moduł decyzji fuzyjnej łączy wyniki detekcji YOLOv11 z cechami wzmocnionymi przez CNN i optymalizuje je wspólnie za pomocą zaprojektowanej funkcji straty, aby wygenerować precyzyjną lokalizację, kategorię oraz wynik ufności celu.
System detekcji YOLOv11
W modelu YOLOv11 wprowadzono kilka kluczowych ulepszeń, które wykorzystują zalety jednotapowego systemu detekcji serii YOLO. Jego architektura podzielona jest na trzy główne komponenty: sieć szkieletową (backbone), sieć fuzji cech oraz głowicę detekcji. Sieć szkieletowa wykorzystuje ulepszoną strukturę CSPDarknet. Sieć fuzji cech zawiera lokalne połączenia międzyetapowe oraz sploty separowalne w głąb (depthwise separable convolutions), czerpiąc inspirację z sieci piramidalnych cech (feature pyramid networks) i sieci agregacji ścieżek (path aggregation networks) w celu efektywnego łączenia cech w wielu skalach.
Moduł wzmacniania cech
Moduł wzmacniania cech ma na celu zwiększenie czułości modelu na kluczowe cechy bezpieczeństwa. Przetwarza on mapy cech generowane przez każdą warstwę sieci szkieletowej YOLOv11, łącząc informacje z różnych skal za pomocą operacji upsamplingu i downsamplingu. W szczególności gałąź wieloskalowa przechwytuje różnorodność skal przestrzennych, podczas gdy gałąź uwagi dynamicznie wzmacnia kluczowe kanały i odpowiedzi pozycyjne. Dwie te gałęzie nie działają niezależnie, lecz wzajemnie się uzupełniają i są łączone poprzez połączenia rezydualne oraz rekalibrację cech. Mapa cech przetworzona przez moduł wzmacniania w każdej skali jest dostosowywana do liczby kanałów oryginalnej mapy cech za pomocą splotu 1 × 1, a następnie łączona z oryginalną mapą cech YOLOv11 poprzez dodawanie element po elemencie. Połączona mapa cech jest następnie przekazywana do kolejnej sieci piramidy cech (FPN) w celu fuzji wieloskalowej, co tworzy hierarchiczną reprezentację cech bezpieczeństwa. Aby zapewnić bezproblemową integrację między modułami, zastosowano strategię wspólnego trenowania end-to-end, w której funkcja straty składa się ze straty detekcji YOLOv11 oraz straty wzmacniania cech modułu CNN.
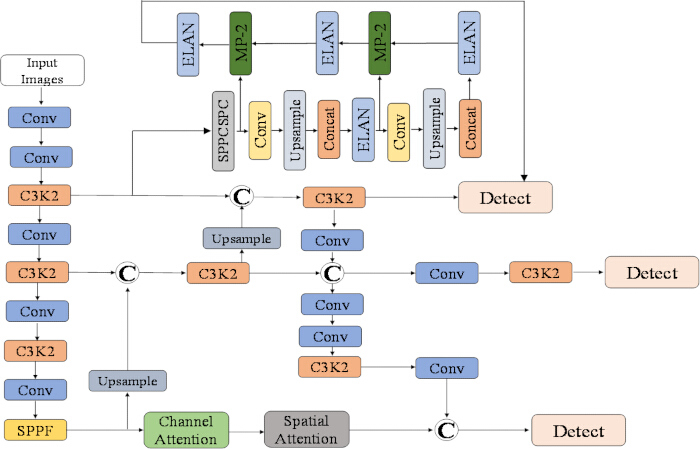
Rysunek 1. Algorytm YOLOv11-CNN. Moduł wzmacniania cech ma na celu zwiększenie czułości modelu na krytyczne cechy bezpieczeństwa. Przetwarza on mapy cech z różnych warstw szkieletu (backbone) YOLOv11, łącząc cechy o różnych skalach poprzez operacje nadpróbkowania (upsampling) i podpróbkowania (downsampling). Dodatkowo włącza on mechanizmy uwagi kanałowej i przestrzennej. Aby zapewnić płynną integrację między modułami YOLOv11 i CNN, zastosowano strategię wspólnego treningu. Podczas uczenia parametry obu modułów są optymalizowane w trybie end-to-end. Funkcja straty łączy stratę detekcji YOLOv11 ze stratą wzmacniania cech modułu CNN. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Aby zweryfikować skuteczność proponowanego modelu fuzji YOLOv11 i CNN w monitorowaniu bezpieczeństwa linii produkcyjnej, skonstruowano zbiór danych obejmujący różne scenariusze zagrożeń bezpieczeństwa. Zbiór ten zawiera 12 000 obrazów scen linii produkcyjnej, podzielonych na zbiory treningowy, walidacyjny i testowy w proporcji 7:1,5:1,5, z ustalonym ziarnem losowym (random seed) wynoszącym 42. Obejmuje on różne warunki pracy, w tym standardowe oświetlenie, słabe oświetlenie, częściowe zasłonięcie, znaczne zasłonięcie, ro...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Wyniki eksperymentalne pokazują, że proponowany model hybrydowy YOLOv11–CNN poprawia dokładność detekcji oraz wydajność w czasie rzeczywistym w zakresie monitorowania bezpieczeństwa linii produkcyjnej. Wykorzystując efektywną detekcję jednoetapową modelu YOLOv11 oraz wzmocnienie cech przez moduł CNN, system zidentyfikował pracowników, sprzęt i obszary niebezpieczne w trudnych warunkach oświetleniowych oraz przy obecności przeszkód. Wieloskalowa fuzja cech i mechanizmy uwagi zwiększyły zdolność do skupienia się na kluczow...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy nie deklarują żadnych konfliktów interesów.
Podziękowania
Praca ta została częściowo sfinansowana przez Fundację Badań Naukowych Uniwersytetu w Taizhou dla Wybitnych Talentów w ramach projektu „Badania nad kluczowymi technologiami precyzyjnego detekcji dla inteligentnej produkcji” (TZXY2020QDJJ006).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| COCO API | N/D | Narzędzie oceniające wykorzystywane do ewaluacji dokładności wykrywania celu i analizy statystycznej. | |
| CUDA 11.4 | NVIDIA | N/D | Platforma obliczeń równoległych wykorzystywana z frameworkiem PyTorch 1.12. |
| Edge TPU | N/D | Platforma wdrożeniowa wykorzystywana do testowania opóźnień i zużycia energii; zgłoszona latencja wyniosła 18 ms, a zużycie energii 15 W. | |
| Urządzenie edge computing Jetson Xavier | NVIDIA | Urządzenie do obliczeń krawędziowych wykorzystywane do testowania przepustowości; zgłoszona prędkość przetwarzania wyniosła 70 FPS, przy latencji 99. percentyla poniżej 50 ms. | |
| GPU NVIDIA Tesla V100 | NVIDIA | GPU wykorzystywane w serwerze do trenowania i ewaluacji. | |
| PyTorch 1.12 | N/D | Framework głębokiego uczenia wykorzystywany do trenowania i ewaluacji modelu. | |
| scikit-learn | N/D | Narzędzie do oceny/analizy statystycznej wykorzystywane do ewaluacji modelu. | |
| Własny zbiór danych bezpieczeństwa linii produkcyjnej | N/D | N/D | Zbiór 12 000 obrazów scen z linii produkcyjnej w formacie VOC, obejmujący standardowe oświetlenie, słabe oświetlenie, częściowe przesłonięcie, znaczne przesłonięcie, rozmycie ruchu i złożone tła; sześć kategorii adnotacji: pracownicy, kaski ochronne, ramiona robotyczne, obszary niebezpieczne, narzędzia i pojazdy. |
| Serwer treningowy | Serwer wyposażony w GPU NVIDIA Tesla V100 i system operacyjny Ubuntu 20.04. | ||
| System operacyjny Ubuntu 20.04 | N/D | System operacyjny wykorzystywany w serwerze do trenowania i ewaluacji. | |
| Format adnotacji VOC | N/D | N/D | Format adnotacji wykorzystywany dla własnego zbioru danych bezpieczeństwa linii produkcyjnej. |
| Model detekcji obiektów YOLOv11 | Ultralytics | N/D | Model detekcji obiektów wykorzystywany do wykrywania pracowników, sprzętu i potencjalnych zagrożeń w czasie rzeczywistym. |
Bibliografia
- Ramadan MNA, Ali MAH, Jaber H, Alkhedher M. Blockchain-secured IoT-federated learning for industrial air pollution monitoring: a mechanistic approach to exposure prediction and environmental safety. Ecotoxicol Environ Saf. 2025;300:118442.
- Ahn J, et al. SafeFac: video-based smart safety monitoring for preventing industrial work accidents. Expert Syst Appl. 2023;215:119397.
- Natha S, et al. A scalable and generalized deep ensemble model for road anomaly detection in surveillance videos. Comput Mater Contin. 2024;81(3):3707-3729.
- Diallo AR, Homri L, Dantan JY. Reducing false alarms in fault detection: a comparative analysis between conformal prediction and classical methods applied to PCA and autoencoders. J Process Control. 2025;152:103495.
- Cheng X, Han Y, Zhang W. Development of intelligent monitoring system for soil erosion in pipeline engineering based on deep learning. Comput Electr Eng. 2025;126:110432.
- Yan H, et al. A global feature fusion and adaptive optimization method to enhance detection accuracy and computational efficiency based on YOLOv8. Alexandria Eng J. 2025;129:538-552.
- Samma H, Al-Azani S, El-Ferik S. UAV-based real-time face detection using YOLOv7. Transp Res Procedia. 2025;84:331-338.
- Gong X, Yu J, Zhang H, Dong X. AED-YOLO11: a small object detection model based on YOLO11. Digit Signal Process. 2025;166:105411.
- Li R, Xiao K, Lin S, Wu Z. Enhancing aquatic ecosystem monitoring through fish jumping behavior analysis and YOLOv5: applications in freshwater fish identification. J Environ Manage. 2025;391:126413.
- Zhang D, Gao Q, Chen Z, Lin Z. Semantic feature refinement of YOLO for human mask detection in dense crowded. J Vis Commun Image Represent. 2025;107:104399.
- Choi MJ, Ku DG, Lee SJ. Integrated YOLO and CNN algorithms for evaluating degree of walkway breakage. KSCE J Civ Eng. 2022;26(8):3570-3577.
- Li Y, et al. Underwater acoustic intelligent spectrum sensing with multimodal data fusion: an Mul-YOLO approach. Future Gener Comput Syst. 2025;173:107880.
- Jiang D, et al. Real-time tracker of chicken for poultry based on attention mechanism-enhanced YOLO-Chicken algorithm. Comput Electron Agric. 2025;237:110640.
- Yang X, et al. Automated concrete bridge damage detection using an efficient Vision Transformer-enhanced anchor-free YOLO. Engineering. 2025;51:311-326.
- Fuertes D, et al. People detection with omnidirectional cameras using a spatial grid of deep learning foveatic classifiers. Digit Signal Process. 2022;126:103473.
- Deepak GD, Bhat SK. Maximizing YOLOv2 efficiency: a study on multiclass detection of indoor objects. Results Eng. 2025;26:105405.
- Zhang C, et al. Personnel target detection in infrared environment based on YOLOv3-tinier network and its FPGA implementation. Infrared Phys Technol. 2025;150:106015.
- Zhou Y. A YOLO-NL object detector for real-time detection. Expert Syst Appl. 2024;238:122256.
- Asadollahpour E, Rahmannejad R, Asghari A, Abdollahipour A. Back analysis of closure parameters of Panet equation and Burger's model of Babolak water tunnel conveyance. Int J Rock Mech Min Sci. 2014;68:159-166.
- Anguchamy KK, Palanisamy V. Real-time object detection using improvised YOLOv4 and feature mapping technique for autonomous driving. Expert Syst Appl. 2025;280:127452.
- Khan AT, Jensen SM, Khan AR. Advancing precision agriculture: a comparative analysis of YOLOv8 for multi-class weed detection in cotton cultivation. Artif Intell Agric. 2025;15(2):182-191.
- Raushan R, Singhal V, Jha RK. Damage detection in concrete structures with multi-feature backgrounds using the YOLO network family. Autom Constr. 2025;170:105887.
- Zarboubi M, Bellout A, Chabaa S, Dliou A. CustomBottleneck-VGGNet: advanced tomato leaf disease identification for sustainable agriculture. Comput Electron Agric. 2025;232:110066.
- Xie F, et al. Wine variety traceability by data fusion of near-infrared spectroscopy and mid-infrared spectroscopy combined with GAF and ResNet. Chemom Intell Lab Syst. 2025;264:105468.
- Huang J, et al. Estimation of the orientation of potatoes and detection bud eye position using potato orientation detection you only look once with fast and accurate features for the movement strategy of intelligent cutting robots. Eng Appl Artif Intell. 2025;142:109923.
- Huang Y, et al. Human intrusion detection with distributed fiber optic data based on Squeeze-Excitation and hierarchical connection enhancement network. Opt Fiber Technol. 2025;94:104297.
- Qi R, et al. Mechanical fault diagnosis of on-load tap changers using time-frequency vibration analysis and a lightweight YOLO model. Measurement. 2025;256:118441.
- Yan J, Wang Z. YOLO V3+VGG16-based automatic operations monitoring and analysis in a manufacturing workshop under Industry 4.0. J Manuf Syst. 2022;63:134-142.
- Nazli NANM, et al. A real-time system for detecting personal protective equipment compliance using deep learning model YOLOv5. Procedia Comput Sci. 2024;245:647-656.
- Xiao Y, et al. The prediction of kiwi quality attributes based on multi-source data fusion comprehensive analysis model using HSI and FHSI. J Food Compos Anal. 2025;144:107645.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.